dekko
gerador rápido, offline e sem dependências de mapas de código estáticos e indexador de base de código para agentes de codificação de LLM.
Documentação




Você já viu seu agente de codificação procurar às cegas em um repositório, abrir três arquivos que não precisava e queimar quinze mil tokens só para responder "quem chama essa função"? Esse é o problema que o dekko existe para resolver.
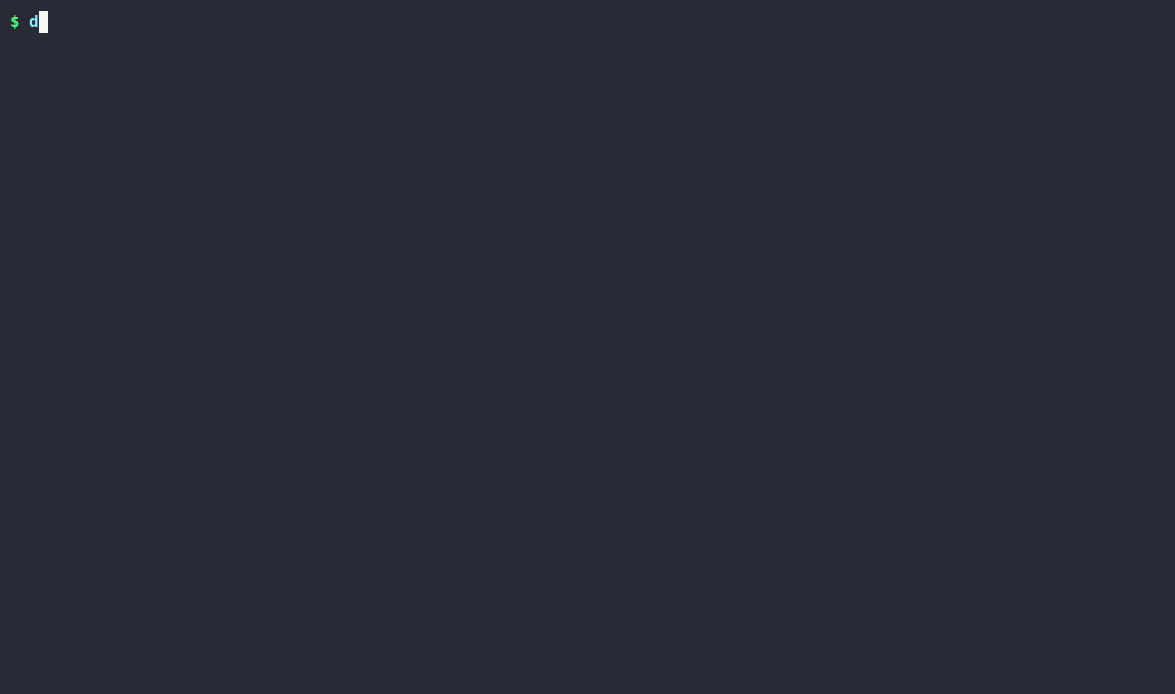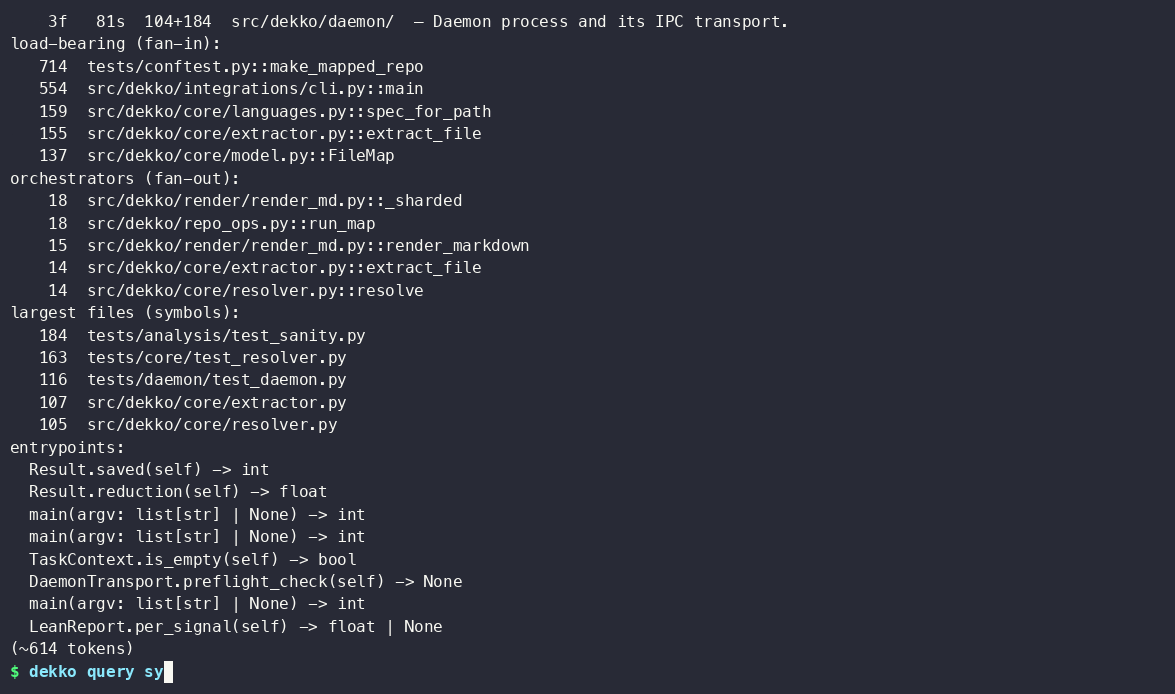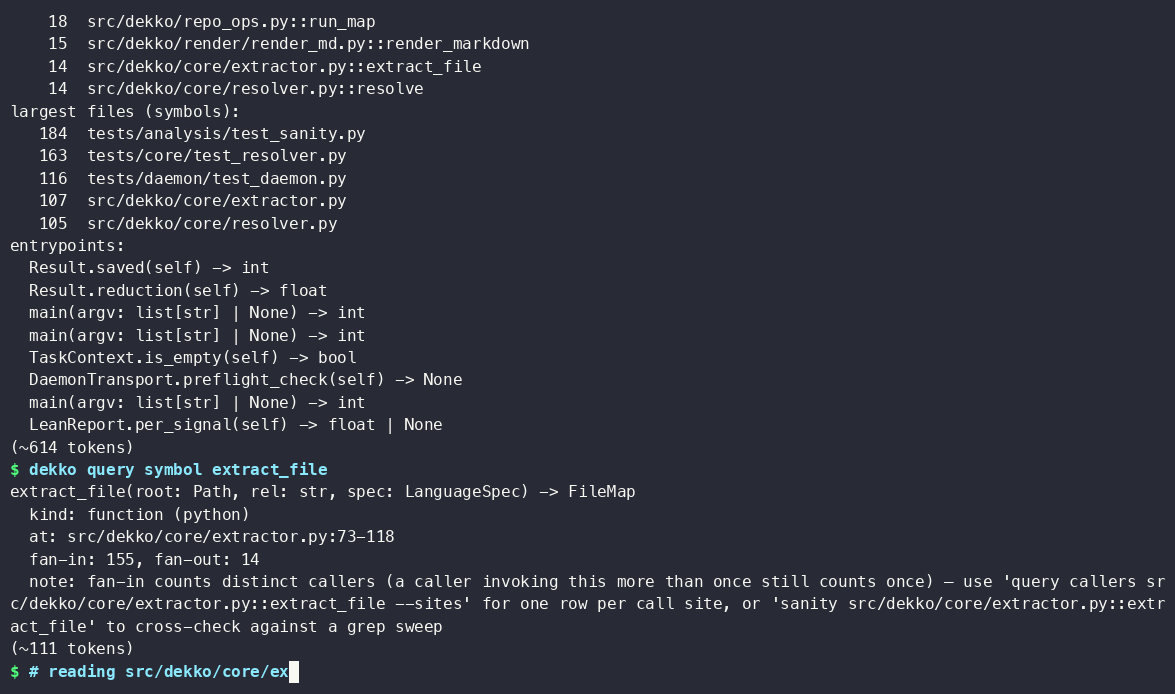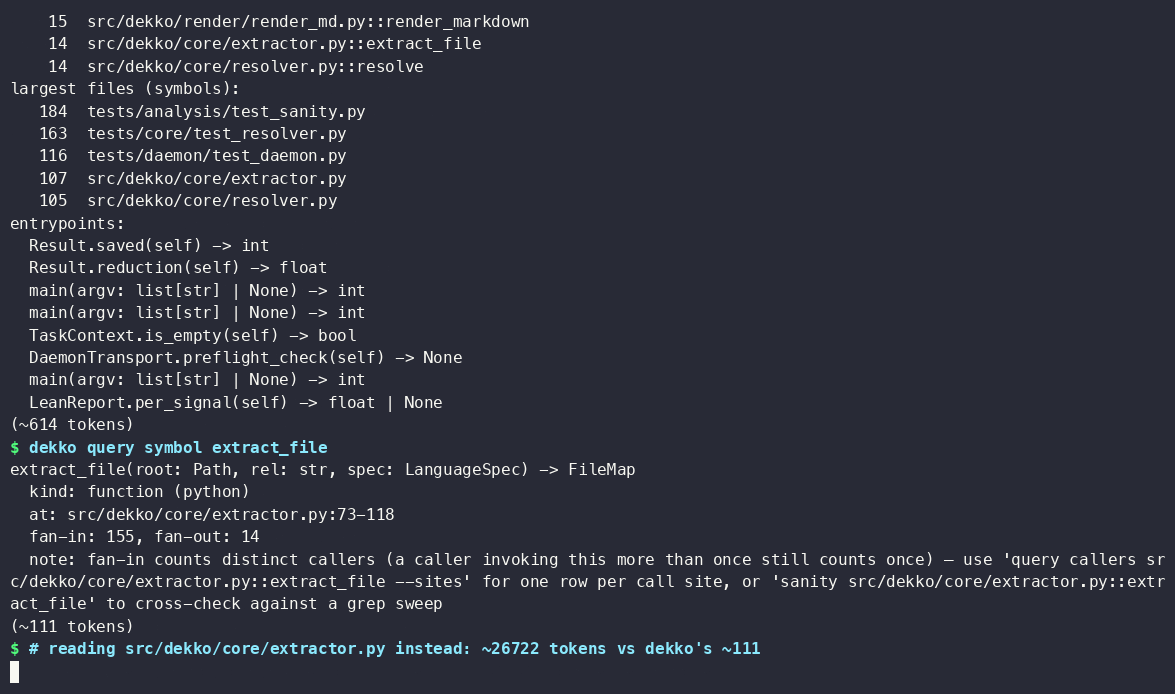
Esta demonstração roda no próprio repositório do dekko (commit 835733c) — clone-o e execute os mesmos três comandos você mesmo.
dekko é um gerador de mapa de código estático rápido, offline e sem dependências, além de um indexador de codebase para agentes de codificação LLM. Ele escaneia um repositório com tree-sitter (sem gastar tokens de modelo no parsing) e escreve:
MAP.md— um mapa legível por humanos: uma visão geral por diretório, um diagrama de arquitetura embutido, rankings de arquivos críticos/orquestradores, e então as funções/métodos de cada arquivo com assinaturas, linhas de documentação, e quem chama e é chamado por quem.map.json— o mesmo grafo em formato legível por máquina.
Além do mapa, o dekko dá ao agente uma forma barata em tokens de responder
perguntas como "o que este arquivo contém", "quem chama essa função",
e "o que preciso para mudar isso com segurança" — sem ler arquivos inteiros.
Ele é distribuído como CLI, um plugin /map do Claude Code + servidor MCP
(Model Context Protocol), e
funciona também com Cline.
O resultado: 10x-300x menos tokens do que um fluxo de trabalho simples de Read/Grep nas tarefas do dia a dia (orientação, esboço de um arquivo grande, chamadores de um símbolo), medido em 7 repositórios open-source reais e não modificados no dekko 0.43.77. O piso, um símbolo local pequeno e amigável a grep, é cerca de 2,5x. O detalhamento completo está logo abaixo.
Por que dekko?
A maioria dos fluxos de trabalho de agentes coleta contexto lendo arquivos inteiros ou fazendo grep
em um repositório — caro, e descarta a estrutura (quem chama
o quê, como é o fan-in/fan-out de uma função). O dekko, em vez disso,
analisa o repositório uma vez em um grafo de chamadas e responde perguntas direcionadas
com base nele. Medido em 7 repositórios open-source reais e não modificados
(Go, TypeScript, Java, Rust, Python/C++ — até 14 mil arquivos, 172 mil
símbolos) no dekko 0.43.77, as consultas estruturadas do dekko usaram 10x–300x
menos tokens do que o fluxo de trabalho equivalente de Read/Grep para a mesma
tarefa (orientação de repositório, esboço de um arquivo grande, rastreamento dos chamadores de um
símbolo).
| Tarefa | Exemplo de repositório (escala) | dekko | Read/Grep | Economia |
|---|---|---|---|---|
Orientação de repositório (summary) | awesome-go (10 arquivos) | 359 tok | ~16.328 tok | ~45x |
Orientação de repositório (summary) | claude-buddy (57 arquivos) | ~349 tok | ~113.514 tok (todos os arquivos-fonte) | ~325x |
| Esboço de um arquivo grande | claude-code REPL.tsx (5.005 linhas) | ~1.154 tok | ~223.963 tok | ~194x |
| Esboço de um arquivo grande | cline SdkController.ts (84 KB) | 1.803 tok | ~21.023 tok | ~11,7x |
| Esboço de um diretório | zed crates/git_ui/src (32 arquivos) | ~35.778 tok | ~418.520 tok | ~11,7x |
| Chamadores de um símbolo | claude-code errorMessage | ~602 tok | ~18.521 tok (323+ resultados de grep) | ~31x |
| Chamadores de um símbolo | zed MultiWorkspace.new (22 locais, 8 arquivos) | ~809 tok | ~381.446 tok (ler os arquivos chamadores) | ~471x |
| Uso de API externa | claude-code chalk | ~798 tok | ~8.099 tok | ~10x |
Contexto agrupado (workset) | awesome-go ToHTML | 263 tok | 4.104 tok | ~16x |
O custo do dekko permanece aproximadamente constante por consulta, enquanto Read/Grep escala
com o tamanho do arquivo/repositório, então a proporção cresce com a escala. Também é rápido em
termos de tempo real: mapear a própria codebase do dekko com ~4.300 símbolos a partir de um
cache frio leva cerca de 5 segundos em todos os núcleos, um remapeamento incremental
após uma edição fica bem abaixo de um segundo, e consultas contra o mapa resultante
retornam instantaneamente. A vantagem não é universal — arquivos pequenos e
autocontidos e símbolos locais já amigáveis a grep veem pouco benefício (o
piso medido foi de cerca de 2,5x). Veja
benchmarks/real-world-repos/
para o detalhamento completo por tarefa, metodologia, o estudo original de 2026-08,
e as ressalvas de correção que ele levantou e como foram resolvidas.
Comparado a ferramentas de índice de tags como ctags/gtags, o dekko resolve arestas de chamada reais
(não apenas definições), classifica arquivos por importância estrutural,
e fala diretamente com agentes via MCP ou CLI — sem necessidade de plugin de editor.
Instalação
uv tool install dekko      # or: pip install dekko / pipx install dekko
dekko --claude-install     # add the /map command + MCP server to Claude Code, then restart
Extras (dekko[all] para ~55 idiomas adicionais, dekko[search] para
busca por embeddings), instalação a partir de um clone local e desinstalação estão
em docs/install.md.
Início rápido
cd my-project
dekko map                  # writes .dekko/MAP.md + .dekko/map.json
dekko summary               # ~40-line digest: dirs, hotspots, entry points
.dekko/ é ignorado pelo git por padrão; o mapa é regenerado sob demanda, então
raramente você precisa executar dekko map novamente manualmente. Se seu repositório tiver
idiomas fora do conjunto padrão Tier-1 (Python, C, C++, JS/TS, Go,
Java, Rust), dekko map avisará por arquivo; instale dekko[all] para
~55 idiomas adicionais (veja Instalação) e execute novamente.
Documentação
- docs/install.md — instalação, extras, clone local, desinstalação
- docs/cli.md — todos os comandos da CLI, alvos de símbolos, exclusão de arquivos, notas, modo daemon, suporte a idiomas
- docs/claude-code.md — o plugin
/map, hooks de push, habilidades do Claude Code, o servidor MCP e o Cline
Saiba mais
- CHANGELOG.md — histórico por versão
- CONTRIBUTING.md — configuração de desenvolvimento, testes, lançamentos
- benchmarks/ — medições de eficiência de tokens, incluindo uma comparação real de 7 repositórios contra um fluxo de trabalho simples de Read/Grep