Scrapeless
공식실시간 Scrapeless Google SERP(Google 검색, Google 항공편, Google 지도, Google 채용 등) 결과를 LLM 애플리케이션에 통합합니다. 이 서버는 AI 워크플로우, 챗봇 및 연구 도구를 위한 동적 컨텍스트 검색을 가능하게 합니다.
Scrapeless MCP(으)로 무엇을 할 수 있나요?
- Google 검색 및 트렌드 —
google_search및google_trends를 통해 실시간 검색 결과나 트렌드 데이터를 요청하세요. - 브라우저 자동화 —
browser_goto및browser_click같은 도구를 사용하여 클라우드 브라우저를 지시해 탐색, 클릭, 입력, 스크롤, 스크린샷 캡처를 수행하세요. - 모든 URL 스크래핑 —
scrape_html,scrape_markdown또는scrape_screenshot으로 페이지의 HTML, Markdown 또는 스크린샷을 가져오세요. - 전체 사이트 크롤링 —
crawl_start로 비동기 크롤링 작업을 시작한 다음,crawl_result로 결과를 폴링하세요. - AI 기반 추출 —
ai_scraper를 사용하여 ChatGPT, Gemini 또는 Perplexity 같은 엔진용 구조화된 스크래핑 작업을 생성하세요.
문서
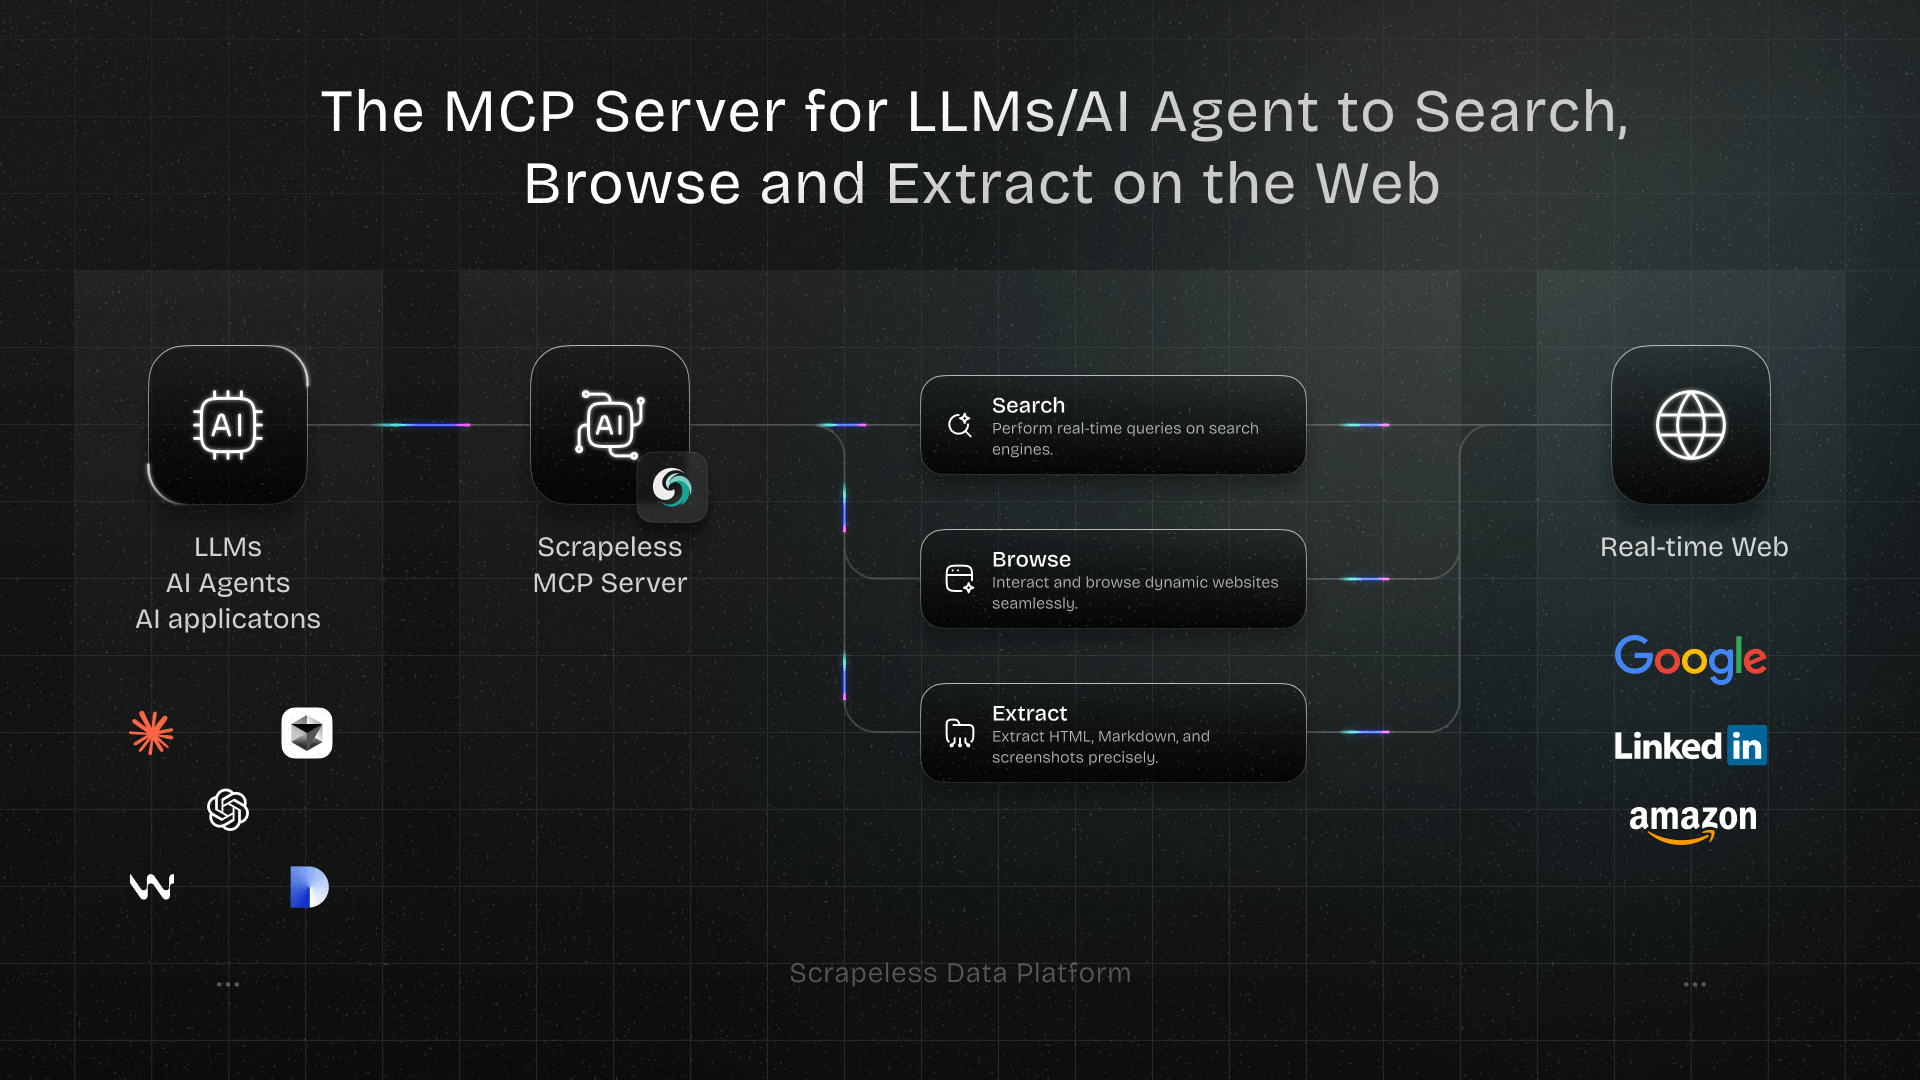
Scrapeless MCP 서버
Scrapeless 공식 Model Context Protocol (MCP) 서버에 오신 것을 환영합니다 — LLM, AI 에이전트, AI 애플리케이션이 실시간으로 웹과 상호작용할 수 있게 해주는 강력한 통합 레이어입니다.
오픈 MCP 표준을 기반으로 구축된 Scrapeless MCP 서버는 ChatGPT, Claude와 같은 모델과 Cursor, Windsurf와 같은 도구를 다양한 외부 기능에 원활하게 연결합니다:
- Google 서비스 통합 (검색, 트렌드)
- 페이지 수준 탐색 및 상호작용을 위한 브라우저 자동화
- 동적이고 JS가 많은 사이트를 스크래핑 — HTML, Markdown 또는 스크린샷으로 내보내기
- 링크를 따라가며 전체 웹사이트를 크롤링하고 각 페이지를 여러 형식으로 캡처
- AI 스크래퍼 ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok 또는 Alexa용 AI 스크래퍼 작업 생성
AI 연구 어시스턴트, 코딩 코파일럿 또는 자율 웹 에이전트를 구축하든, 이 서버는 워크플로우에 필요한 동적 컨텍스트와 실제 데이터를 제공합니다 — 차단 없이.
사용 예시
- Claude를 사용한 자동화된 웹 상호작용 및 데이터 추출
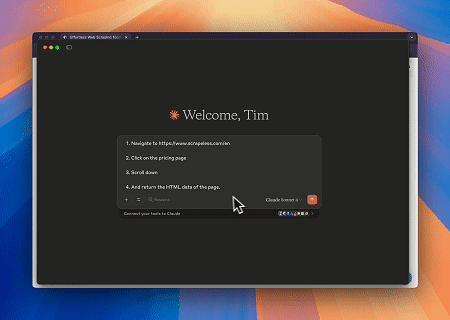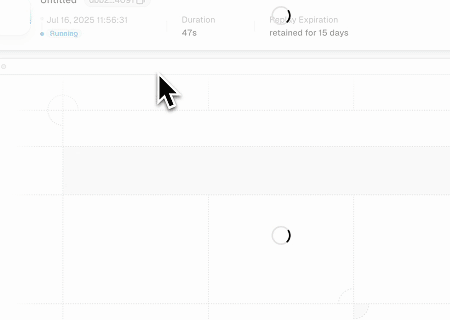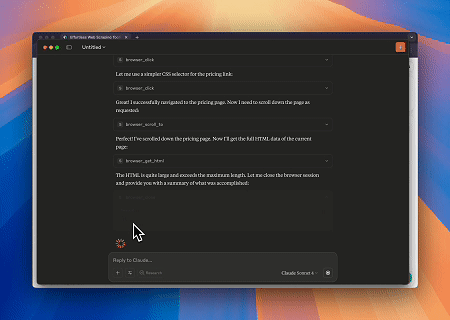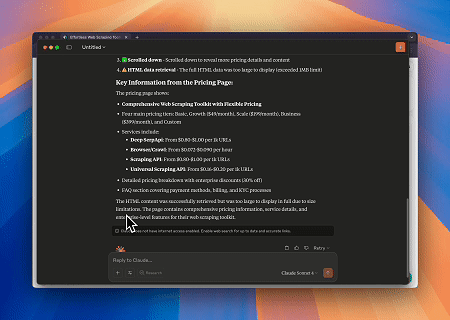
Scrapeless MCP 브라우저를 사용하면 Claude는 대화형 명령을 통해 웹 탐색, 클릭, 스크롤, 스크래핑과 같은 복잡한 작업을 수행할 수 있으며, live sessions을 통해 웹 상호작용 결과를 실시간으로 미리 볼 수 있습니다.
- Cloudflare 우회하여 대상 페이지 콘텐츠 검색
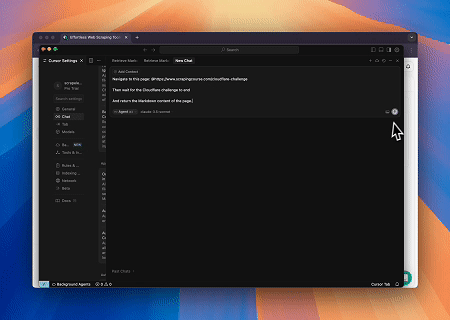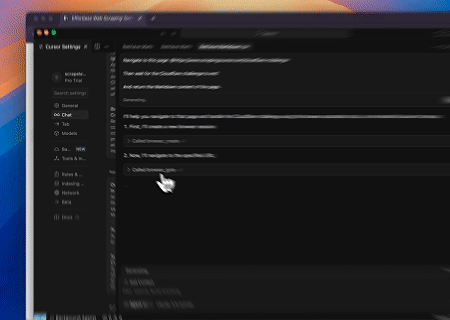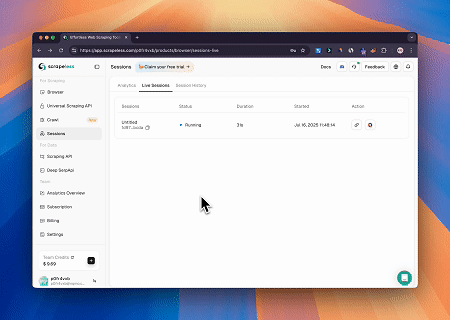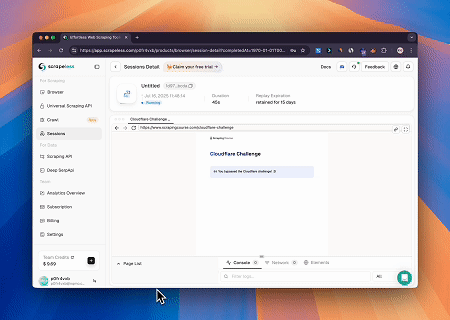
Scrapeless MCP 브라우저 서비스를 사용하면 Cloudflare 페이지에 자동으로 접근하고, 프로세스가 완료된 후 페이지 콘텐츠를 추출하여 Markdown 형식으로 반환합니다.
- 동적으로 렌더링된 페이지 콘텐츠 추출 및 파일에 쓰기
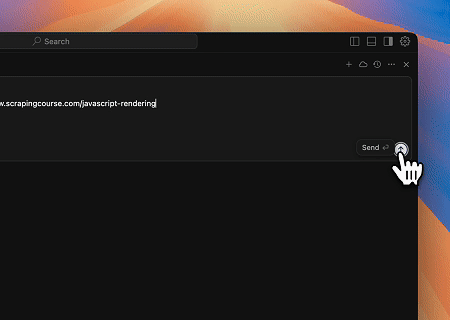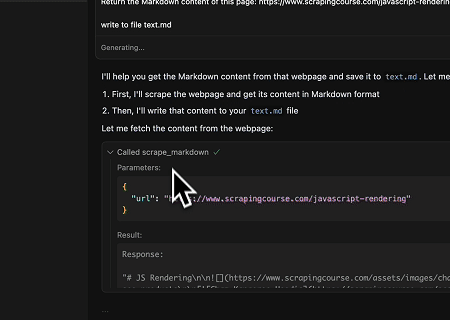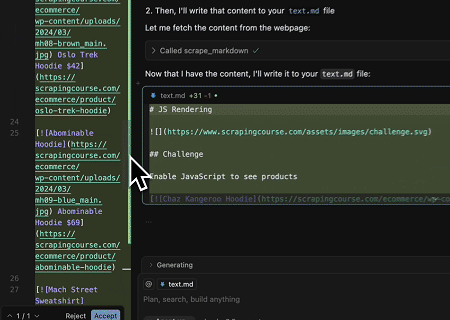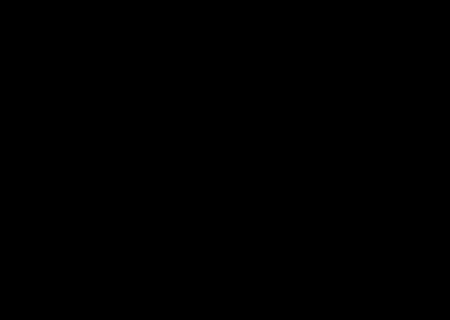
Scrapeless MCP 범용 API를 사용하여 위 대상 페이지의 JavaScript 렌더링 콘텐츠를 스크래핑하고, Markdown 형식으로 내보낸 후 최종적으로 **text.md**이라는 로컬 파일에 작성합니다.
- 자동화된 SERP 스크래핑
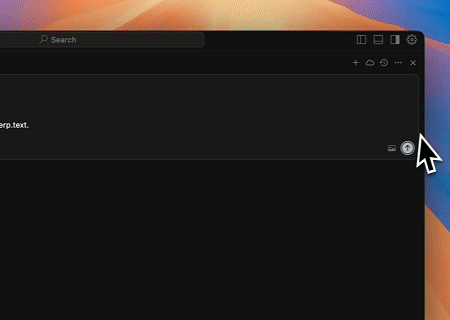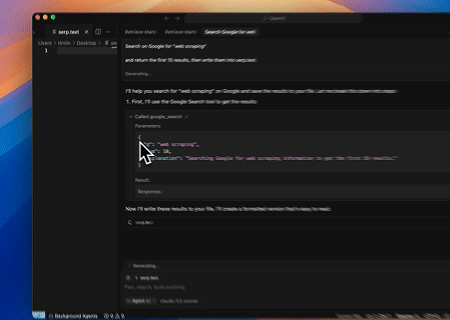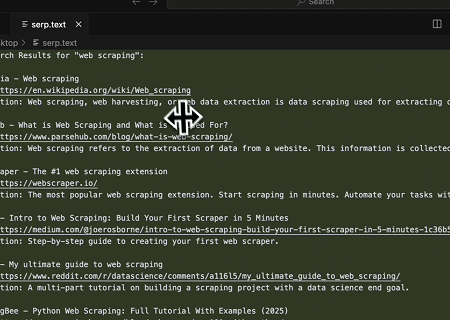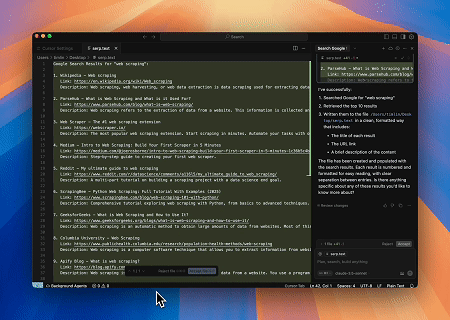
Scrapeless MCP 서버를 사용하여 Google 검색에서 "web scraping" 키워드를 쿼리하고, 처음 10개의 검색 결과(제목, 링크, 요약 포함)를 검색한 후 serp.text이라는 파일에 콘텐츠를 작성합니다.
다음은 이러한 서버를 사용하는 방법에 대한 추가 예시입니다:
| 예시 |
|---|
| Google 검색으로 scrapeless를 검색합니다. |
| 지난 1년간 "AI"에 대한 검색 관심도를 찾습니다. |
| 브라우저를 사용하여 chatgpt.com을 방문하고, "오늘 날씨가 어때?"를 검색한 후 결과를 요약합니다. |
| scrapeless.com 페이지의 HTML 콘텐츠를 스크래핑합니다. |
| scrapeless.com 페이지의 Markdown 콘텐츠를 스크래핑합니다. |
| scrapeless.com의 스크린샷을 가져옵니다. |
설정 가이드
- Scrapeless 키 받기
- Scrapeless 대시보드에 로그인합니다 (무료 체험 가능)
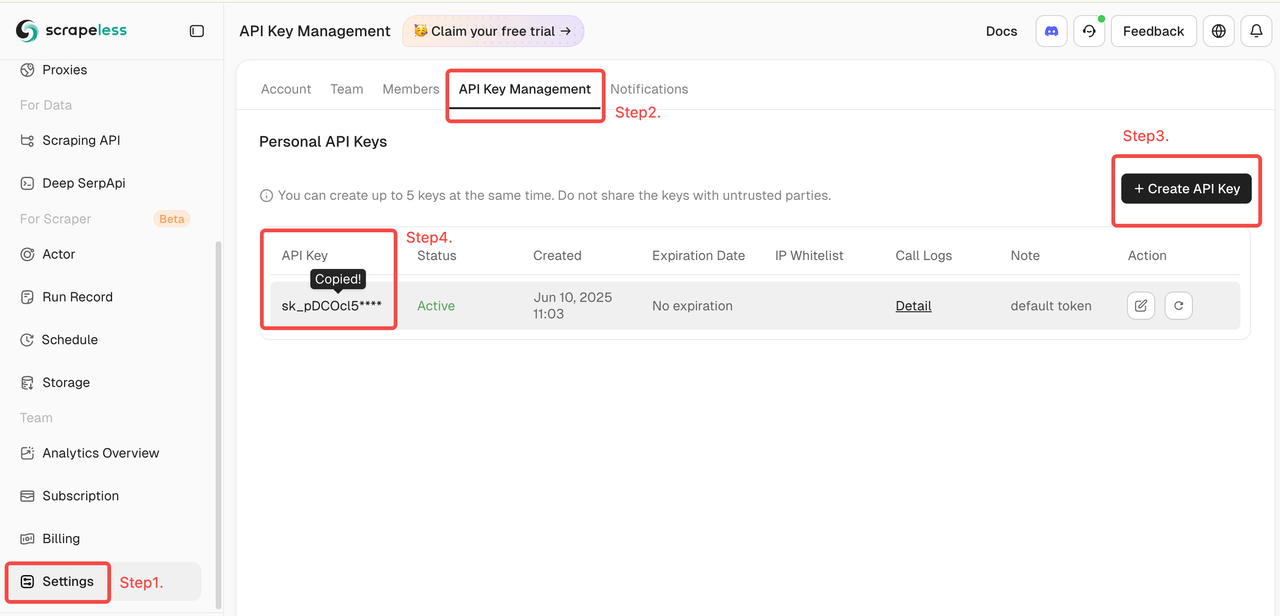
- 그런 다음 왼쪽에서 "설정"을 클릭 -> "API 키 관리"를 선택 -> "API 키 생성"을 클릭합니다. 마지막으로 생성한 API 키를 클릭하여 복사합니다.
- MCP 클라이언트 구성
Scrapeless MCP 서버는 Stdio 및 Streamable HTTP 전송 모드를 모두 지원합니다.
🖥️ Stdio (로컬 실행)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (호스팅 API 모드)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
고급 옵션
선택적 매개변수로 브라우저 세션 동작을 사용자 지정합니다. 이러한 매개변수는 환경 변수(Stdio용) 또는 HTTP 헤더(Streamable HTTP용)를 통해 설정할 수 있습니다:
| Stdio (환경 변수) | Streamable HTTP (HTTP 헤더) | 설명 |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | 세션 연속성을 위한 재사용 가능한 브라우저 프로필 ID를 지정합니다. |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | 쿠키, 로컬 저장소 등에 대한 영구 저장을 활성화합니다. |
| BROWSER_SESSION_TTL | x-browser-session-ttl | 최대 세션 제한 시간을 초 단위로 정의합니다. 이 시간 동안 비활성 상태가 지속되면 세션이 자동으로 만료됩니다. |
Claude Desktop과 통합
- Claude Desktop을 엽니다
- 다음으로 이동합니다:
Settings→Tools→MCP Servers - **"MCP 서버 추가"**를 클릭합니다
- 위의
Stdio또는Streamable HTTP구성을 붙여넣습니다 - 저장하고 서버를 활성화합니다
- 이제 Claude는 Scrapeless를 사용하여 웹 쿼리를 실행하고, 콘텐츠를 추출하며, 페이지와 상호작용할 수 있습니다
Cursor IDE와 통합
- Cursor를 엽니다
Cmd + Shift + P를 누르고 다음을 검색합니다:Configure MCP Servers- 위 형식을 사용하여 Scrapeless MCP 구성을 추가합니다
- 파일을 저장하고 Cursor를 다시 시작합니다 (필요한 경우)
- 이제 Cursor에게 다음과 같은 질문을 할 수 있습니다:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- 그러면 백그라운드에서 Scrapeless를 사용합니다.
지원되는 MCP 도구
| 이름 | 설명 |
|---|---|
| google_search | 범용 정보 검색 엔진입니다. |
| google_trends | Google 트렌드에서 인기 검색 데이터를 가져옵니다. |
| browser_create | Scrapeless를 사용하여 클라우드 브라우저 세션을 생성하거나 재사용합니다. |
| browser_close | 클라우드 브라우저 연결을 끊어 현재 세션을 종료합니다. |
| browser_goto | 브라우저를 지정된 URL로 이동합니다. |
| browser_go_back | 브라우저 기록에서 한 단계 뒤로 이동합니다. |
| browser_go_forward | 브라우저 기록에서 한 단계 앞으로 이동합니다. |
| browser_click | 페이지의 특정 요소를 클릭합니다. |
| browser_type | 지정된 입력 필드에 텍스트를 입력합니다. |
| browser_press_key | 키 입력을 시뮬레이션합니다. |
| browser_wait_for | 특정 페이지 요소가 나타날 때까지 기다립니다. |
| browser_wait | 고정된 시간 동안 실행을 일시 중지합니다. |
| browser_screenshot | 현재 페이지의 스크린샷을 캡처합니다. |
| browser_get_html | 현재 페이지의 전체 HTML을 가져옵니다. |
| browser_get_text | 현재 페이지의 모든 표시 텍스트를 가져옵니다. |
| browser_scroll | 페이지 하단으로 스크롤합니다. |
| browser_scroll_to | 특정 요소가 보이도록 스크롤합니다. |
| scrape_html | URL을 스크래핑하고 전체 HTML 콘텐츠를 반환합니다. |
| scrape_markdown | URL을 스크래핑하고 콘텐츠를 Markdown으로 반환합니다. |
| scrape_screenshot | 모든 웹페이지의 고품질 스크린샷을 캡처합니다. |
| crawl_start | 기본 URL에서 비동기 크롤링 작업을 시작하고 작업 ID를 반환합니다. |
| crawl_cancel | 진행 중인 크롤링 작업을 ID로 취소합니다. |
| crawl_result | 크롤링 작업을 ID로 폴링하여 완료될 때까지 기다린 후 크롤링된 데이터를 반환합니다. |
| ai_scraper | ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok 또는 Alexa용 AI 스크래퍼 작업을 생성합니다. |
보안 모범 사례
LLM(예: ChatGPT, Claude 또는 Cursor)과 함께 Scrapeless MCP 서버를 사용할 때는 스크래핑되거나 추출된 모든 웹 콘텐츠를 주의해서 처리하는 것이 중요합니다. 웹 데이터는 기본적으로 신뢰할 수 없으며, 부적절한 처리는 애플리케이션을 프롬프트 인젝션 또는 기타 보안 취약점에 노출시킬 수 있습니다.
✅ 권장 사항
- 원시 스크래핑 콘텐츠를 LLM 프롬프트에 직접 전달하지 마십시오. 원시 HTML, JavaScript 또는 사용자 생성 텍스트에는 숨겨진 인젝션 페이로드가 포함될 수 있습니다.
- 추출된 모든 콘텐츠를 정리하고 검증하십시오. 다운스트림 로직이나 AI 모델에서 콘텐츠를 사용하기 전에 잠재적으로 유해한 태그와 스크립트를 제거하거나 이스케이프 처리하십시오.
- 자유 형식 텍스트보다 구조화된 추출을 선호하십시오.
scrape_html,scrape_markdown또는 알려진 안전한 선택자를 사용한 대상browser_get_text도구를 사용하여 신뢰할 수 있는 콘텐츠만 추출하십시오. - 동적으로 생성된 페이지를 스크래핑할 때 도메인 또는 선택자 화이트리스트를 적용하여 데이터 흐름을 알려진 신뢰할 수 있는 소스로 제한하십시오.
- 브라우저 또는 스크래핑 도구를 통해 이루어진 모든 아웃바운드 요청을 기록하고 모니터링하십시오. 특히 민감한 데이터, 토큰 또는 내부 네트워크 액세스를 처리하는 경우 더욱 중요합니다.
🚫 피해야 할 사항
- 스크래핑된 HTML을 프롬프트에 직접 주입
- 검증 없이 사용자가 임의의 URL 또는 CSS 선택자를 지정하도록 허용
- 향후 프롬프트 사용을 위해 필터링되지 않은 스크래핑 콘텐츠 저장
커뮤니티
문의하기
질문, 제안 또는 협업 문의가 있으시면 다음을 통해 연락해 주십시오:
- 이메일: market@scrapeless.com
- 공식 웹사이트: https://www.scrapeless.com
- 커뮤니티 포럼: https://discord.gg/Np4CAHxB9a