dbt
公式dbt(データビルドツール)向けの公式MCPサーバーで、dbt Core/Cloud CLIとの統合、プロジェクトメタデータの検出、モデル情報、セマンティックレイヤーのクエリ機能を提供します。
Dbt MCPで何ができますか?
- dbtメトリクスのクエリ —
list_metrics、get_dimensions、またはget_metrics_compiled_sqlを使用して、メトリクス定義、ディメンション、またはコンパイル済みSQLを問い合わせます。 - プロジェクトの系統探索 —
get_lineageまたはget_related_modelsを使用して、モデルの依存関係と上流/下流の関係を追跡します。 - dbtコマンドの実行 —
run、test、またはbuildを実行して、モデルを具体化し、データを検証し、プロジェクトを構築します。 - ボイラープレートコードの生成 —
generate_source、generate_model_yaml、またはgenerate_staging_modelを使用して、ソースYAML、モデルYAML、またはステージングSQLを作成します。 - ジョブ実行の監視 —
get_job_run_details、get_job_run_error、またはlist_job_run_artifactsを使用して、実行ステータス、エラー、またはアーティファクトを確認します。 - ノード詳細の検査 —
get_node_detailsを使用して、モデル、ソース、テストなど、任意のリソースタイプの完全なメタデータを取得します。
ドキュメント
dbt MCP サーバー
このMCP(Model Context Protocol)サーバーは、dbtと連携するためのさまざまなツールを提供します。このMCPサーバーを使用して、dbt Core、dbt Fusion、dbt PlatformのプロジェクトのコンテキストをAIエージェントに提供できます。
詳細については、こちらのドキュメントをお読みください。dbt MCPサーバーで可能なことの詳細は、こちらのブログ記事をご覧ください。
実験的なMCPバンドル
各リリースで実験的なModel Context Protocolバンドル(dbt-mcp.mcpb)を公開しており、MCPB対応クライアントは追加設定なしでこのサーバーをインポートできます。最新リリースのアセットからバンドルをダウンロードし、Anthropicのmcpb CLIドキュメントに従ってインストールまたは検査してください。
フィードバック
コメントや質問がある場合は、GitHub Issueを作成するか、コミュニティSlackの#tools-dbt-mcpチャンネルに参加してください。
アーキテクチャ
dbt MCPサーバーのアーキテクチャにより、エージェントはさまざまなツールに接続できます。
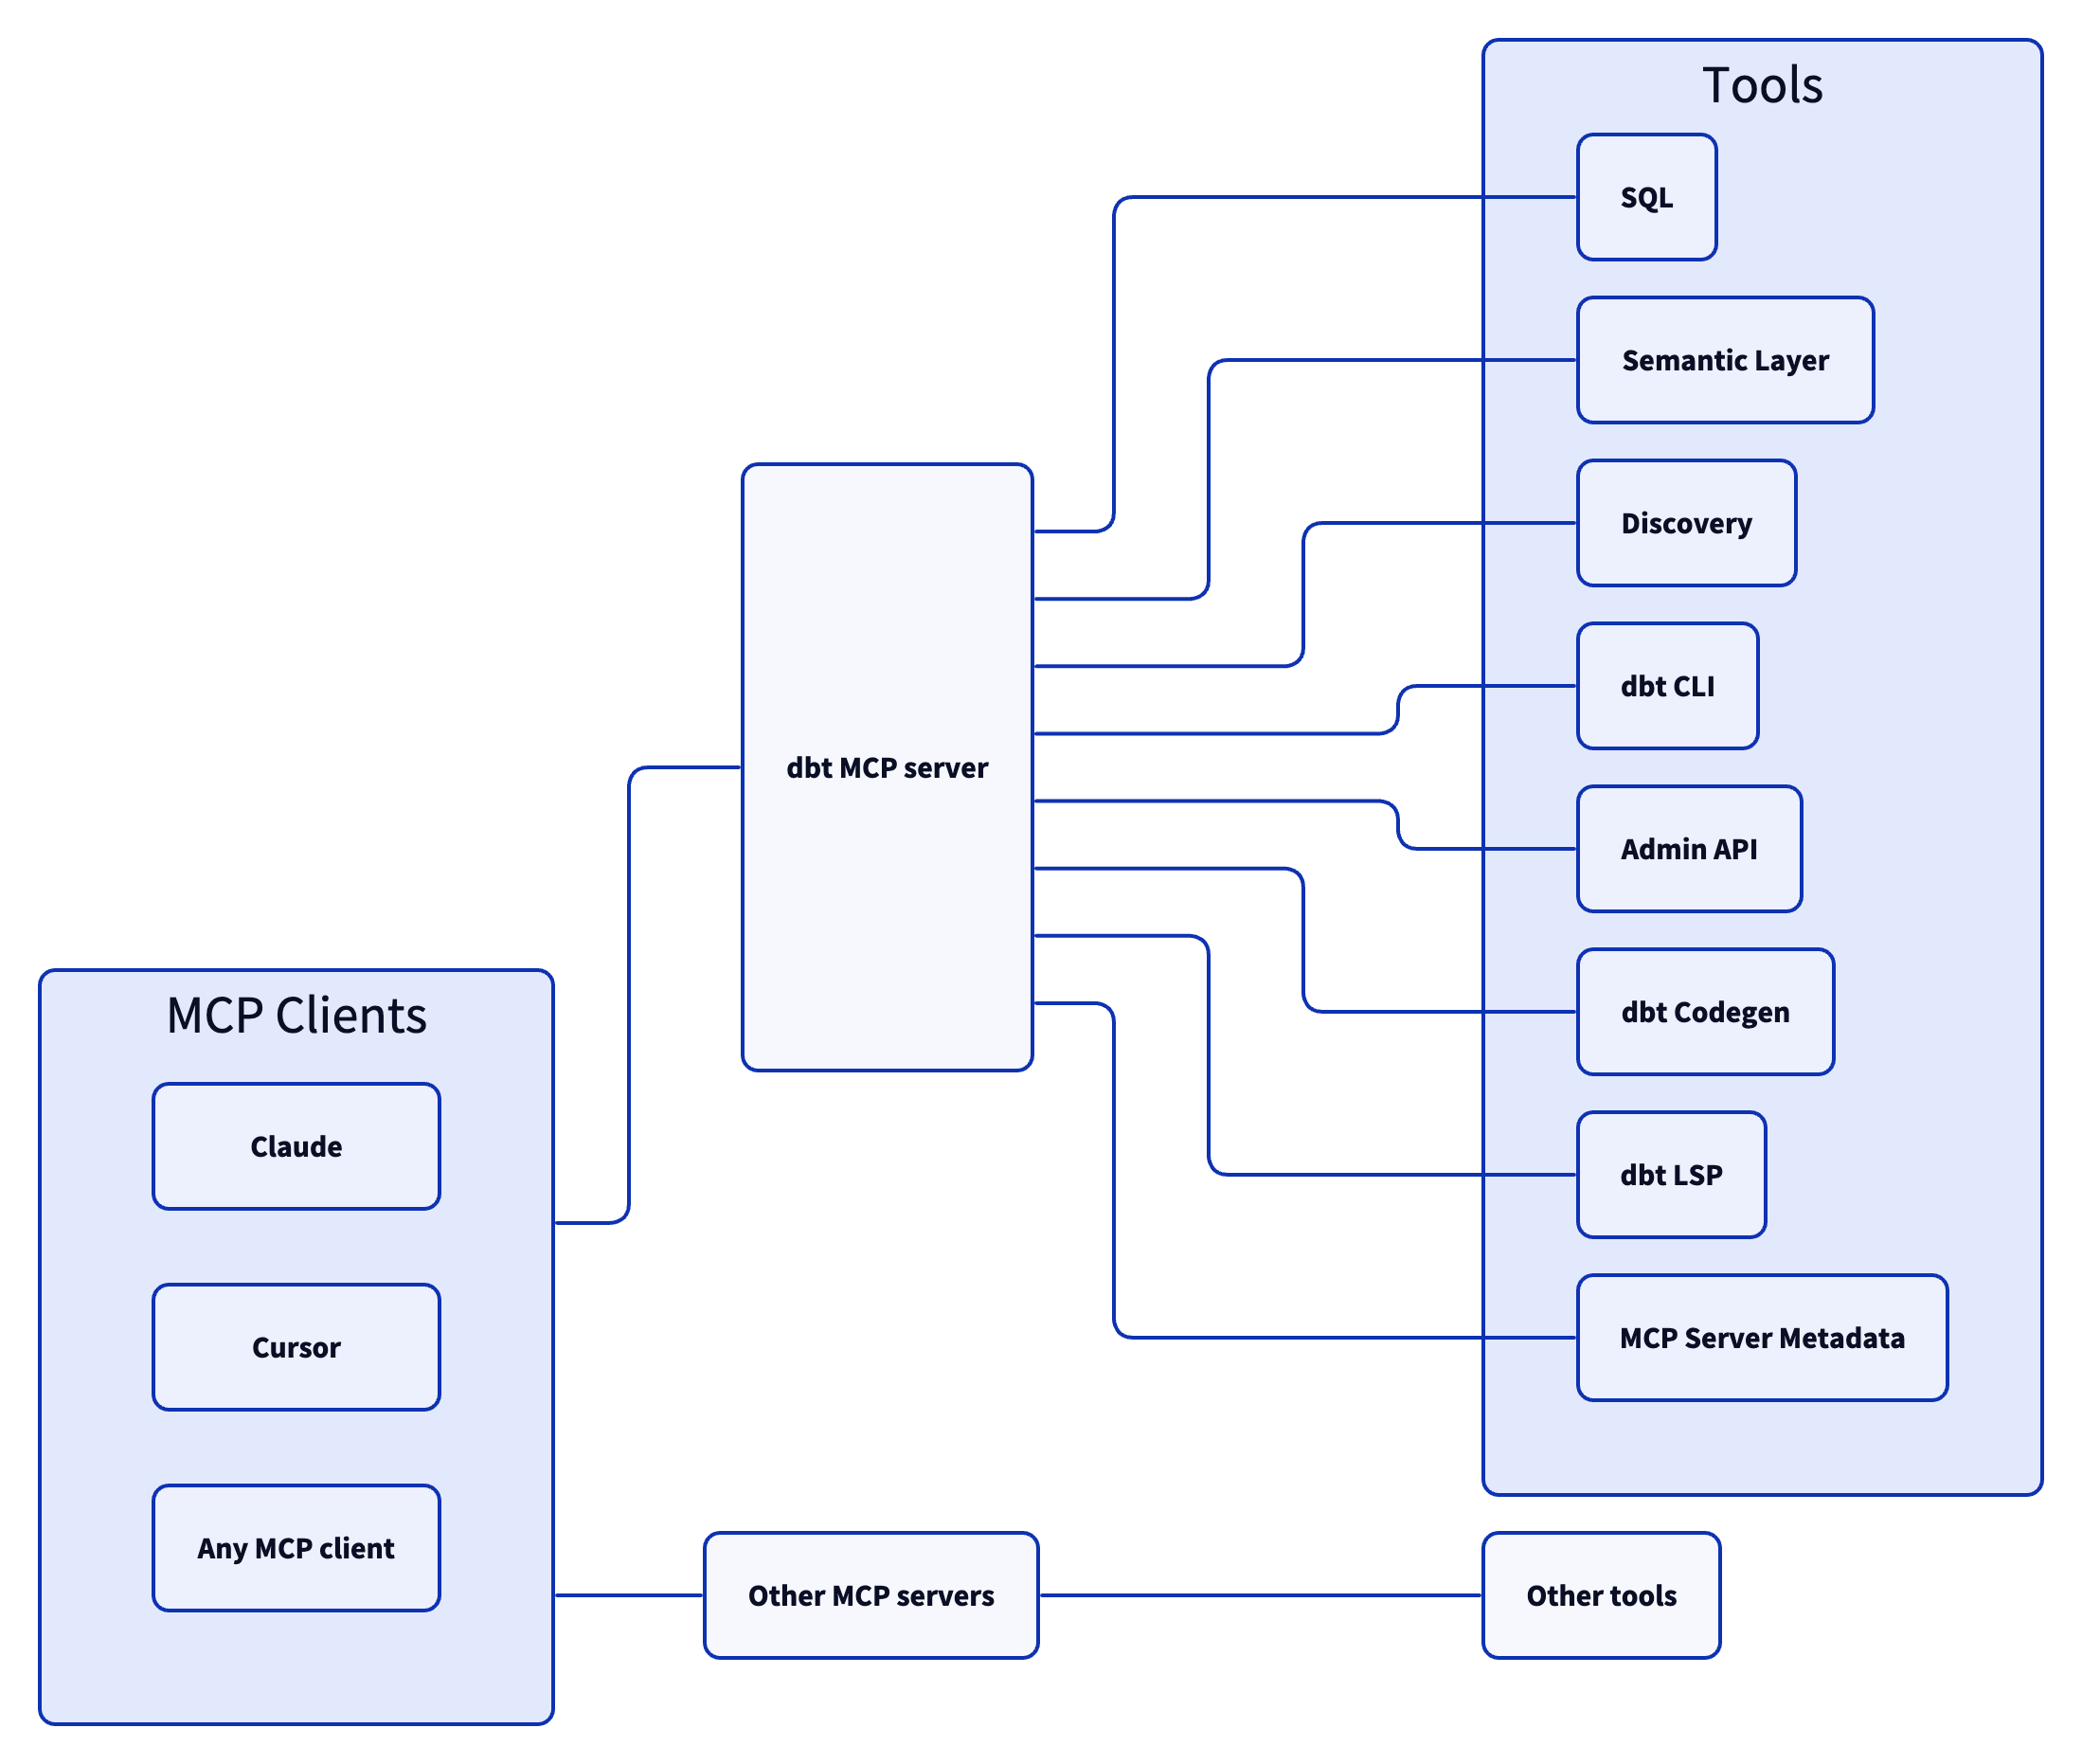
ツール
SQL
dbt Platformインフラストラクチャ上でSQLを実行および生成するためのツールです。
execute_sql: Semantic Layerサポート付きでdbt Platformインフラストラクチャ上でSQLを実行します。text_to_sql: プロジェクトコンテキストを使用して自然言語からSQLを生成します。
Semantic Layer
dbt Semantic Layerの詳細については、こちらをクリックしてください。
get_dimension_values: ディメンションの個別値を取得します。特定のメトリクスにスコープを絞るオプションがあります。get_dimensions: 指定されたメトリクスのディメンションを取得します。get_entities: 指定されたメトリクスのエンティティを取得します。get_metrics_compiled_sql: クエリを実行せずにメトリクスのコンパイル済みSQLを返します。list_metrics: 定義されたすべてのメトリクスを取得します。list_saved_queries: 保存されたすべてのクエリを取得します。query_metrics: フィルタリングおよびグループ化オプション付きでメトリクスクエリを実行します。
Discovery
dbt Discovery APIの詳細については、こちらをクリックしてください。
get_all_macros: マクロを取得します。パッケージでフィルタリングするか、パッケージ名のみを返すオプションがあります。get_all_models: すべてのモデルの名前と説明を取得します。get_all_sources: フレッシュネスステータス付きですべてのソースを取得します。ソース名でフィルタリングするオプションがあります。get_exposure_details: (非推奨 — 代わりにget_node_detailsを使用してください)get_exposures: すべてのエクスポージャー(下流のダッシュボード、アプリ、分析)を取得します。get_lineage: タイプ、深さ、方向のフィルタリング付きで境界付きリネージグラフを取得します。get_macro_details: (非推奨 — 代わりにget_node_detailsを使用してください)get_mart_models: すべてのマートモデルを取得します。get_model_children: (非推奨 — 代わりにget_lineageを使用してください)get_model_details: (非推奨 — 代わりにget_node_detailsを使用してください)get_model_health: ヘルスシグナル(実行ステータス、テスト結果、上流ソースのフレッシュネス)を取得します。get_model_parents: (非推奨 — 代わりにget_lineageを使用してください)get_model_performance: モデルの実行履歴を取得します。テスト結果を含めるオプションがあります。get_node_details: 任意のdbtリソースタイプ(モデル、ソース、エクスポージャー、テスト、シード、スナップショット、マクロ、セマンティックモデル)の完全な詳細を取得します。get_related_models: セマンティック検索を使用して類似モデルを検索します。get_seed_details: (非推奨 — 代わりにget_node_detailsを使用してください)get_semantic_model_details: (非推奨 — 代わりにget_node_detailsを使用してください)get_snapshot_details: (非推奨 — 代わりにget_node_detailsを使用してください)get_source_details: (非推奨 — 代わりにget_node_detailsを使用してください)get_test_details: (非推奨 — 代わりにget_node_detailsを使用してください)search: [アルファ] dbtプロジェクト全体でリソースを検索します(一般提供はされていません)。
dbt CLI
クライアントがMCPツールを通じてdbtコマンドを利用できるようにすると、データモデル、ソース、ウェアハウスオブジェクトが変更される可能性があります。クライアントを信頼し、潜在的な影響を理解している場合にのみ続行してください。
build: DAG順にモデル、テスト、スナップショット、シードを実行します。clone: 指定された状態から選択されたノードをターゲットスキーマにクローンします。compile: モデル/テスト/分析から実行可能なSQLを生成します。Jinjaロジックの検証に役立ちます。docs: dbtプロジェクトのドキュメントを生成します。get_lineage_dev: ローカルのmanifest.jsonからタイプと深さのフィルタリング付きでリネージを取得します。get_node_details_dev: ローカルのmanifest.jsonからノードの詳細(モデル、シード、スナップショット、ソース)を取得します。list: セレクターサポート付きでタイプ別にdbtプロジェクト内のリソースを一覧表示します。parse: 構文の正確性を検証するためにプロジェクトファイルを解析および検証します。run: モデルを実行してデータベースにマテリアライズします。show: データベースに対してSQLを実行し、結果を返します。test: データとモデルの整合性を検証するためにテストを実行します。
Admin API
dbt管理APIの詳細については、こちらをクリックしてください。
cancel_job_run: 実行中のジョブをキャンセルします。get_job_details: トリガー、スケジュール、dbtコマンドを含むジョブ設定を取得します。get_job_run_artifacts: ジョブ実行から特定のアーティファクトをダウンロードします。大きなアーティファクトの場合は、jq_filterを使用して再試行するように案内メッセージが返されます。対象を絞った抽出のためのjqフィルタリングをサポートしています。get_job_run_details: ステータス、タイミング、ステップ、アーティファクトを含む実行の詳細を取得します。get_job_run_error: ジョブ実行のエラーおよび/または警告の詳細を取得します。警告のみを含めるか表示するオプションがあります。list_job_run_artifacts: ジョブ実行から利用可能なアーティファクトを一覧表示します。list_jobs: dbt Platformアカウント内のジョブを一覧表示します。プロジェクトまたは環境でフィルタリングするオプションがあります。list_jobs_runs: ジョブ実行を一覧表示します。ジョブ、ステータス、または並べ替えフィールドでフィルタリングするオプションがあります。list_projects: dbt Platformアカウント内のすべてのプロジェクトを一覧表示します。retry_job_run: 失敗したジョブ実行を再試行します。trigger_job_run: ジョブ実行をトリガーします。gitブランチ、スキーマ、その他の設定を上書きするオプションがあります。
dbt Codegen
これらのツールは、dbtプロジェクトファイルの定型コード生成を自動化するのに役立ちます。
generate_model_yaml: 列付きのモデルYAMLを生成します。上流の説明を継承するオプションがあります。generate_source: データベーススキーマをイントロスペクトしてソースYAMLを生成します。列を含めるオプションがあります。generate_staging_model: ソーステーブルからステージングモデルSQLを生成します。
dbt LSP
Fusionエンジンを活用して高度なSQLコンパイルと列レベルのリネージ分析を行うツールセットです。
fusion.compile_sql: dbt Platformを介してプロジェクトコンテキストでSQLをコンパイルします。fusion.get_column_lineage: dbt Platformを介して列レベルのリネージをトレースします。get_column_lineage: ローカルで列レベルのリネージをトレースします(dbt Labs VSCE経由のdbt-lspが必要です)。
製品ドキュメント
docs.getdbt.comの公式dbtドキュメントからコンテンツを検索および取得するためのツールです。
get_product_doc_pages: パスまたはURLで1つ以上のdocs.getdbt.comページの完全なMarkdownコンテンツを取得します。search_product_docs: クエリに一致するページをdocs.getdbt.comで検索します。関連性でランク付けされたタイトル、URL、説明を返します。完全なコンテンツを取得するにはget_product_doc_pagesを使用してください。
MCPサーバーメタデータ
これらのツールは、MCPサーバー自体に関する情報を提供します。
get_mcp_server_branch: 実行中のdbt MCPサーバーの現在のgitブランチを返します。get_mcp_server_version: dbt MCPサーバーの現在のバージョンを返します。
例
一般的には、dbt MCPサーバーをClaudeやCursorなどのエージェント製品に接続します。ただし、独自のエージェントを作成することに興味がある場合は、examplesディレクトリで開始方法を確認してください。
依存関係
依存関係は特定のバージョンに固定されており、自動的には更新されません。セキュリティ関連の依存関係の更新のみが自動プルリクエストで提出されます。
貢献
参加方法については、CONTRIBUTING.mdをお読みください!