ai-memory
公式あらゆるAIアシスタントのための永続メモリ。想起までトークンコストゼロ。ローカルSQLiteに記憶を保存し、6要素スコアリングでランク付け、JSONより79%小さい結果を返却。Claude、ChatGPT、Grok、Cursor、Windsurf、および任意のMCPクライアントで動作。
Ai Memory MCPで何ができますか?
- AIアシスタント間の永続メモリ — アシスタントに、学習した内容を共有SQLiteデータベースに保存するよう依頼し、後で任意のMCP互換AIがそれを呼び出せるようにします。
- 関連性順の想起 — アシスタントに、関連性でランク付けされたメモリを取得させ、重要な知識は自動的に永続ストレージへ昇格させます。
- 安全な認証情報の取り扱い —
AI_MEMORY_STORE_URLまたはAI_MEMORY_STORE_URL_FILEでストアURLを設定し、プロセス一覧にパスワードが表示されないようにします。 - スキルメモリの登録 — エージェントが作成したスキルを
parameters_schemaとinvocation_recordで登録し、構造化された再利用可能な機能を実現します。 - メモリ系統の追跡 —
memory_lineageDAGを通じて、MCPまたはHTTPエンドポイント間で、どのメモリが他のメモリから派生したかを追跡します。 - マルチエージェント連携 —
Goal/Plan/Stepメモリ種別をlifecycle_stateとともに使用し、型付き認知ワークフローを管理します。
ドキュメント
ai-memory
universal AI memory








ai-memoryは、AIアシスタント向けの永続メモリシステムです。 MCPをサポートするあらゆるAI(Claude、ChatGPT、Grok、Llamaなど)で動作します。AIが学習した内容をローカルのSQLiteデータベースに保存し、想起時に関連性に基づいてメモリをランク付けし、重要な知識を自動的に永続ストレージに昇格させます。一度インストールすれば、使用するすべてのAIアシスタントが、あなたのアーキテクチャ、好み、修正を永遠に記憶します。
インストールパスの選択
| あなたは… | デプロイ環境は… | ここから始める |
|---|---|---|
| 個人開発者がai-memoryを試す | ラップトップ上の1つのAIクライアント | docs/install-quickstart.md — 5分の超簡単インストール + LLMバックエンドを1ブロックで接続 |
| エンジニア / アーキテクト | シングルノード本番、または1ノード上の複数エージェント | docs/INSTALL.md → docs/production-deployment.md |
| エンジニア / アーキテクト | マルチサーバー / マルチラック / マルチDC / スウォーム / ハイブ / フェデレーション | docs/enterprise-deployment.md — 8つのトポロジ、シングルトンからマルチリージョンまで |
| エンジニア / アーキテクト | PostgreSQL + Apache AGEストレージ(マルチライター、1000万件以上のメモリ、KG多用) | docs/postgres-age-guide.md — ファーストクラスのpostgresオペレーターガイド |
| 意思決定者が導入を評価中 | — | docs/audience/decision-maker.html |
LLMバックエンド(xAI Grok、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM、llama.cppサーバー、またはローカルOllama)を設定しますか?
docs/integrations/llm-backends.mdを参照してください — MCP環境ブロックのレシピは、インストールパスに関係なく同じです。
v0.9.0 — 現在のリリース。 セキュリティ強化とコードレビューのリリースです:5レーンの敵対的レビューによる49件の修正(#1885–#1935)に加え、より小規模な追加機能群が含まれます。主要な変更点はセキュアデフォルトへの切り替えです:HTTP直接書き込みではエージェント証明がデフォルトで必須になりました(#1751、#1985でサーフェス範囲に限定)— 署名なしのHTTP POST /api/v1/memories(+/bulk)は、オペレーターが明示的なオプトアウト AI_MEMORY_REQUIRE_AGENT_ATTESTATION=0 を設定しない限り、attest_level="claimed" に格納される代わりに拒否されます(403 ATTESTATION_FAILED)。MCP memory_store とCLI store サーフェスはオペレーター・アズ・アクターの経路であり、デフォルトでは許可制のままです(署名なしの書き込みは claimed に格納されます);=1 はすべてのサーフェスで厳格モードを強制します。(v0.9.0 GAはこれを「全サーフェスで必須」として出荷しましたが、MCPホストでは満たせないことが判明し、現在のリリースでサーフェス範囲に修正されました。)これに加えて、必須フック存在の強制ゲートがMCP書き込みパス(#1885)とHTTP書き込みパス(#1924)の両方で発動するようになり、設定済みの必須フックが一方のサーフェスではスキップされ他方ではスキップされないというサイレントバイパスのギャップを解消しました。強化パスはまた、bulk_create の行単位アテステーションゲーティングを閉じ(#1919)、インバウンドのフェデレーションPENDING承認を登録承認者ゲート経由でルーティングし(#1920)、team/unit/org の可視性スコープを、名前空間階層全体で過度に広くならないよう厳格化し(#1921)、skill_register の folder_path インポートを設定済みルート配下にシンボリックリンクジェイル付きで制限しました(#1923)。新しい非argv資格情報チャネル — AI_MEMORY_STORE_URL / AI_MEMORY_STORE_URL_FILE(0600 ファイル)— により、postgres/storeパスワードが誰でも読み取り可能な /proc/<pid>/cmdline と ps に置かれないようにしました(#1927)。追加機能の作業:エージェント作成のスキルメモリ(parameters_schema + invocation_record、B7-SKILL、#1865)、recall_observations シャドウフィードバックループ(#1706)、メモリ導出リネージDAG(memory_lineage、#1859)、およびオプトインのベクトル検索最小スライス(#1005)。サーフェス:スキーマ v78、--profile full で 101 のMCPツール(100の呼び出し可能 + 常時オンの memory_capabilities ブートストラップ)/ --profile core で 7、92 のHTTPルート登録(78の一意なURLパス)、--features sal/sal-postgres 配下の 89 のCLIサブコマンド(デフォルトビルドでは 87)、9 の型付き MemoryLink リレーション、28フィールドの Memory。同一APIの背後にある2つの本番バックエンド — 組み込みSQLiteとPostgreSQL + Apache AGE — で、デスクトップ、サーバー、オンデバイス(iOS + Android)で動作します。アテステーションとフック強制の切り替えを除き、すべてv0.8.1に対して追加的です。これらはセキュアデフォルトの破壊的変更であり、アップグレード前にレビューしてください。完全な変更ログ: CHANGELOG.md §"[0.9.0] — 2026-07-08"。
v0.8.0(distributed-coordination)— 以前のリリース。 これはメモリ基盤が調整基盤になるリリースです。#1709 からの分散調整メカニズムを追加します:実際のステートマシンを備えた型付きアクションDAG(memory_action_*)、TTL制限付きシングルホルダーリース(memory_lease_*)、Ed25519署名付きシグナル(memory_signal_*)、Ed25519アテステーション付きチェックポイント(memory_checkpoint_*)、および凍結された再生可能なルーチン(memory_routine_*)— これにより、異種エージェントのフリートが互いに信頼することなく、交代で作業を引き継ぎ、誰が何を言ったかを証明できます。その上に型付き認知を層状に追加します(Goal/Plan/Step メモリ種別、lifecycle_state マシン、および decomposes_into / depends_on / advances リンクリレーション)、フェデレーションのセキュアデフォルトを強化し(ピア登録はデフォルトでON #1789、遷移ごとの署名 #1718、書き込みごとのコンテンツアテステーション #1464、遷移リプレイノンス #1805、アウトバウンドピア証明書ピニング #1678)、そして実際にブロックするガバナンスを出荷します — Claude Code PreToolUseフックは type:command ラッパーに再設計され、基盤の Refuse がツールを真に拒否します(#1811)。v0.8.0リリース時点のサーフェス:スキーマ v70、--profile full で 100 のMCPツール(99の呼び出し可能 + 常時オンの memory_capabilities ブートストラップ)/ --profile core で 7、91 のHTTPルート登録(78の一意なURLパス)、83/85 のCLIサブコマンド、9 の型付き MemoryLink リレーション、27フィールドの Memory。同一APIの背後にある2つの本番バックエンド — 組み込みSQLiteとPostgreSQL + Apache AGE — で、デスクトップ、サーバー、オンデバイス(iOS + Android)で動作します。すべてv0.7.0に対して追加的です;アップグレード前にセキュアデフォルトの切り替えをレビューしてください。完全なリリースノート: docs/v0.8.0/release-notes.md。
v0.7.0(attested-cortex)— 以前のリリース。 cortex-fluent の可読性向上の取り組みと、ROADMAP §7.3 の v0.7 完全版の trust + A2A スコープを統合し、さらに(2026-05-09 のオペレーター指示により)当初 v0.7.1 で予定されていた postgres+AGE のファーストクラス対応、さらにポスト・グランドスラム出荷準備の波(Batman Forms 1-6 + 第7形態のOption-B基盤 + QW-1/2/3 + 調整セキュリティスイープ)を含みます。基盤はより表現力豊か(capabilities v3、名前付きローダーツール、圧縮スキーマ、Batman MemoryKind 語彙、persona/atomisation/multistep-ingest プリミティブ)かつ暗号学的に信頼可能(Ed25519 証明、サイドチェーン転写、プログラム可能な25イベントフックパイプライン、強制ネームスペース継承、V-4 クロス行署名イベントハッシュチェーン)になります。v0.7.0 はpostgres + Apache AGE をファーストクラスのストレージバックエンドとして出荷します — ライブデーモン使用のための ai-memory serve --store-url postgres://…、両バックエンド間のスキーマ同等性(v0.7.0 リリース時点で、sqlite + postgres は論理スキーマ v57 に収束し、CURRENT_SCHEMA_VERSION は 57 でした。v0.8.0 リリース基盤はこれを同期してスキーマ 70 に進め、追加の v58–v70 調整 + 可視性テーブルは両バックエンドに展開されています — v58–v70 のラダーについては CLAUDE.md §Database を参照)(正規アンカー: sqlite 用 src/storage/migrations.rs + postgres 用 src/store/postgres.rs); ディスク上のマイグレーションファイルは migrations/sqlite/0047_v56_list_composite_indexes.sql で終わり、postgres のインプロセス migrate_v57() ラダーアーム(ファイル名カウンターは論理スキーマバージョンより遅れています。両ラダーが v34 以降のデルタをインプロセスアームで適用するためです — v35-v57 の説明は docs/MIGRATION_v0.7.md §schema-ladder を参照; v48 #933 はフェデレーション・プッシュ DLQ テーブルを追加; v49 #1025 は archived_memories に 14 の NULL 許容カラムを追加し、アーカイブ → リストアが v0.7.0 完全版の Memory 形状に対してロスレスになるようにしました; v50 #1156 は agent_quotas PRIMARY KEY を (agent_id) から (agent_id, namespace) に拡張し、単一エージェントが多数のネームスペースにまたがって動作する場合でも、ネームスペースごとの K8 クォータ割り当てが保持されるようにしました — v50 より前の行は _global センチネルネームスペースにバックフィルされます; v51 #1255(PR #1296)は federation_nonce_cache テーブルを追加し、ピア再送防止ノンスがデーモン再起動後も持続するようにしました; v52 #1389 は RFC-0001 memory_capture_turn L4 + recover_from_transcript L2 の冪等性を支える transcript_line_dedup テーブルを追加し、ターン間の SIGKILL がその後の再水和で重複メモリを生成しないようにしました; v53 #1418 は memories_au FTS5 同期トリガーを (title, content, tags) のみにスコープし、非 FTS カラム更新が不要な同期を発火しないようにしました; v54 #1466 はレガシー NULL 有効期限の mid/short 行にティアデフォルト有効期限をバックフィルし、TTL リークの不滅行クラスを閉じました; v55 #1476 は W=2 フェデレーション・キャッチアップクエリ(updated_at > ? ORDER BY updated_at ASC LIMIT)をサージャブルにし、sqlite の idx_memories_updated_at インデックスを追加しました — postgres は memories_updated_at_idx DESC が Index Scan Backward でレンジスキャンを既に提供しているため、新しいインデックスは追加しません; v56 #1579 は複合リスト/アーカイブ順序インデックス(idx_memories_list_order、idx_memories_ns_list_order、idx_archived_ns_archived_at)をサージャブルな storage::list リライトとペアで追加しました — sqlite 側の DDL; postgres の migrate_v56() アームはバージョンスタンプの no-op です; v57 #1579 は postgres のストアド生成 tsv tsvector カラム + memories_tsv_gin GIN インデックスを追加し、検索/リコール形状が一致し、一致した行ごとに tsvector を再計算する代わりに事前計算カラムで AND ランク付けするようにしました — レガシーの memories_content_fts 式インデックスは削除され、sqlite の双子は FTS5 がインデックス付きテキストを既に具体化しているためバージョンスタンプの no-op です))、新しい ai-memory schema-init CLI 動詞、および 6 要素リコールスコアリングの同等性。v0.6.4 のデフォルトサーフェスは、常時オンのローダーが 2 つ追加され 7 ツールになります(memory_load_family + memory_smart_load が元の 5 つに加わります); --profile full でのランタイム上限は74 のアドバタイズエントリです(73 の呼び出し可能メモリツール + 常時オンの memory_capabilities ブートストラップ; Profile::full().expected_tool_count() に対して検証済み — src/profile.rs を参照)。新しいものはすべて追加的であり、(trust + postgres サーフェスについては)オプトインです。v0.6.x からアップグレードしますか? 最初に docs/MIGRATION_v0.7.md をお読みください — ほとんどの v0.6.4 呼び出し元は動作変更を見ませんが、v0.6.3.1 より前の v0.6.x ユーザーは G1 ネームスペース継承修正に遭遇します。postgres+AGE に切り替えますか? docs/postgres-age-guide.md と docs/migration-v0.7.0-postgres.md を参照してください。完全なリリースノート: docs/v0.7.0/release-notes.md。
v0.6.4(quiet-tools) — MCP サーバーは5 ツールのデフォルトサーフェス(memory_store、memory_recall、memory_list、memory_get、memory_search)に加えて、常時オンの memory_capabilities ブートストラップを備えて出荷されます。他の 38 ツールは --profile graph|admin|power|full または memory_capabilities --include-schema family=<name> によるランタイム拡張を介して引き続き到達可能です。イーガーローディングハーネス(Claude Desktop / Codex CLI / Grok CLI / Gemini CLI)は、リクエストごとに約 4,700 入力トークンのツールスキーマを削減します — cl100k_base BPE に対して測定された76.4% の削減です。v0.6.3 の動作を 1:1 で維持するには、ai-memory mcp --profile full を実行してください。docs/MIGRATION_v0.6.4.md を参照してください。
v0.9 の新機能
v0.9.0 は主にセキュリティ強化とコードレビューのリリースです — 5 レーンの敵対的レビューからの 49 の修正(#1885–#1935)— に加えて、v0.8.0 調整基盤の上に積み重ねられた小さな追加機能群です。完全な変更ログ: CHANGELOG.md §"[0.9.0] — 2026-07-08"。
デフォルトでセキュアな強化
- HTTP ダイレクト書き込みサーフェスでエージェント証明がデフォルトで必須(#1751、#1985 でサーフェススコープ化)。
AI_MEMORY_REQUIRE_AGENT_ATTESTATIONはサーフェスごとのコンパイル済みデフォルトを持つ三状態です: 未設定 → HTTP ダイレクト書き込みで必須(POST /api/v1/memories+/bulk、403 ATTESTATION_FAILEDは拒否)、MCPmemory_storeと CLIstoreのオペレーター・アズ・アクターサーフェスでは寛容(署名なし書き込みはattest_level="claimed"に着地);=1はすべての場所で厳格を強制し、=0はすべての場所で寛容を強制します。提示されたが偽造された署名は、サーフェスに関係なく拒否されます。書き込みに署名するか(ai-memory agents bind-keyを介してバインドされたキーペアを持つai-memory store --sign)、=0オプトアウトを使用してください。(v0.9.0 GA はこれを すべての場所で必須 として出荷しましたが、MCP ホストでは満たせず — #1981 を参照; #1985 でサーフェススコープに修正されました。) - デュアル MCP + HTTP フック強制ゲート(#1885 / #1924)。必須フック存在強制ゲート(元々 MCP のみ、#1734)が HTTP 書き込みパスでも参照されるようになり、MCP を完全にスキップした書き込みが設定済みの必須フックを決して見ないというサイレントバイパスギャップ(CWE-288)を閉じました。
bulk_create証明ゲーティング(#1919)。一括書き込みは、単一のmemory_store呼び出しと同じ行ごとのエージェント証明要件を強制します — バッチ内のすべての行がリクエスト全体だけでなく有効な証明を保持する必要があります。- フェデレーション承認者ゲート(#1920)。受信フェデレーション PENDING 承認は、ピアの登録済み承認者に帰属する場合にのみ尊重されます — 登録済みだが信頼されていないピアは、任意のリクエスターに対する承認を偽造できなくなりました。
team/unit/orgスコープ強化(#1921)。可視性スコープ解決は、team/unit/orgスコープに対してネームスペース祖先階層を正しく強制し、テナント分離ギャップ(CWE-863)を閉じました。skill_registerパス閉じ込め(#1923)。スキルのfolder_pathインポートは正規化され、設定されたルートの下に閉じ込められます。インポートされたツリー内のシンボリックリンクは追跡される代わりに拒否されます(CWE-22/CWE-59)。- 非 argv ストア URL 資格情報チャネル(#1927)。新しい
AI_MEMORY_STORE_URL(所有者のみの/proc/environ)とAI_MEMORY_STORE_URL_FILE(0600ファイル)により、ai-memory serveは postgres/ストア URL — 埋め込みパスワードを含む — を--store-urlargv に置くことなく受け取れます。argv では、ワールドリーダブルな/proc/<pid>/cmdlineとps auxwwを介して任意のローカル UID に公開されます。解決順序: ファイル → env →--store-url。
追加機能
- B7-SKILL — スキルメモリのファーストクラス化(#1865)。登録時の
parameters_schema、invocation_record、およびエージェント作成スキルのバージョンサーフェス。 recall_observationsシャドウフィードバックループ(#1706、SHADOW モード)。ランキング動作をまだ変更せずにリコールフィードバックループを閉じます。- メモリ導出系譜 DAG(
memory_lineage、スキーマ v78、#1859)。どのメモリがどのメモリから導出されたかを、MCP と新しいGET /api/v1/memories/{id}/lineageHTTP ルートの両方で追跡します。 - ベクトル検索の最小オプトインスライス(#1005; 完全な基盤は #1860 に延期)。
- 物理 CPU にサイズ設定されたリランカー ワーカープール(#1867)およびリコールはデフォルトで PURE(#1869 — リコールホットパスから書き込みバーストを削除)。
- 追加専用スパイン + 署名層の分離: すべてのミューテーションサイトが署名付きリビジョンリーフにルーティングされ(#1823)、Recorder/Judge/Stopper の 3 キー署名分離(#1826)、macaroon 能力トークンのエンドツーエンド配線(#1827)、およびローテーション生存のための署名付きアイデンティティ系譜キー継承チェーン(#1828、スキーマ v76)。
開始場所:
CHANGELOG.md(完全な変更ログ)、docs/ADMIN_GUIDE.md(オペレータープレイブック — 証明 + フック強制の姿勢)。
v0.8 の新機能
v0.8.0(distributed-coordination)はメモリ基盤をマルチエージェント(NHI)フリートのための調整基盤に変えます。目玉は分散調整機構(#1709)です; すべてが sqlite と postgres+AGE SAL アダプターの両方で出荷され、v0.7.x 呼び出し元に対してデフォルト同等性を維持します。完全なツールリファレンス: docs/coordination.md; 完全なノート: docs/v0.8.0/release-notes.md。
分散調整基盤(Pillar-1、#1709)
- Actions — 依存関係DAG(スキーマv59)。状態機械(
pending → claimed → in_progress → done/failed/abandoned)を持つ型付きアクションノード、型付きDAGエッジ(requires/unlocks/blocks/gated_by/sibling)、および次に実行可能なノードを引き出すフロンティア/ネクストサーフェス。8つのMCPツール(memory_action_create/_get/_transition/_list/_add_edge/_edges/_frontier/_next)。 - Leases — 単一保持者、TTL制限付きクレーム(スキーマv59)。ハートビート更新の比較交換クレーム(
PRIMARY KEYonaction_id= 一度に1つの保持者)に加え、毎時のリーススイーパー。4つのMCPツール(memory_lease_acquire/_renew/_release/_get)。 - Signals — 型付き、Ed25519署名付きエージェント間メッセージ(スキーマv60)。各メッセージは署名と送信者
signer_pubkeyを保持し、correlation_id/in_reply_toを介してスレッド化されます。5つのMCPツール(memory_signal_send/_read/_inbox/_thread/_ack)。 - Checkpoints — 証明付き条件付きゲート(スキーマv61)。条件が解決されるまでブロックするゲート。解決は職務分離のためその場で自己署名(Ed25519)され、
verifyが署名を再チェックします。4つのMCPツール(memory_checkpoint_create/_resolve/_query/_verify)。 - Routines — パラメータ化され、凍結され、再生可能なプラン(スキーマv62)。
draftとして作成され、その後凍結(不変、Ed25519凍結証明)されます。runは{{param}}テンプレートから具体的なアクションとエッジのセットをroutine_runsレコードに具体化します。5つのMCPツール(memory_routine_create/_freeze/_run/_status/_list)。 - すべての調整状態変更は、改ざん検出可能な
coordination.<op>行をsigned_eventsV-4ハッシュチェーンに追加します(#1722)。権限付与の2つの書き込みは、ローカルCASとW-of-Nフェデレーションファンアウト(#1718)を使用してHTTPデーモン(POST /api/v1/actions/{id}/transition、POST /api/v1/signals)にミラーリングされます。
型付き認知(ピラー2)
memory_kind語彙はgoal / plan / stepで拡張されます。閉じたmemory_links.relation分類は6 → 9関係に拡張され(decomposes_into / depends_on / advances、スキーマv63)、ファーストクラスのmemories.lifecycle_state列(スキーマv64)によりGoal/Plan/Stepが実際の状態機械(open → active → blocked/done/abandoned)になり、MCP / HTTP / SALサーフェス全体で不正なエッジがHTTP 409 CONFLICTにマッピングされて強制されます。Memory構造体は27フィールドに成長します。新しいMCPツールはありません — v64の作業は許可的なオプションリクエストフィールドのみを追加します。
フェデレーションの強化、デフォルトでセキュア
ピア登録はデフォルトでON(#1789)、権限付与書き込みの遷移ごとの署名(#1718)、リレーされたメモリの書き込みごとのコンテンツ証明(#1464)、遷移リプレイノンス(#1805)、および送信ピア証明書フィンガープリントピニング(#1678)。互いに信頼する必要のない異種フリート — アップグレード前にdocs/v0.8.0/release-notes.mdの§「フェデレーション強化」でセキュアデフォルトの変更を確認してください。
実際にブロックするガバナンス(#1811)
Claude Code PreToolUseガバナンスフックはtype:commandラッパー(ai-memory governance check-action --from-pretool-stdin)に再設計され、基盤のRefuseがpermissionDecision:"deny"を発行してツールを実際にブロックします。以前のtype:mcp_tool形式は構造的に強制できませんでした。さらに、必須フックの存在強制(#1734)と、人間参加型ループのための新しいescalateガバナンス判定(§22 PE-5)が追加されました。
ピラー4運用制御
HTTPアドミッションコントロール(#1733 — 型付き503で過剰分を切り捨てるオプトインの同時実行キャップ)、遅延Apache-AGEグラフ投影(#1735 — postgresリンク書き込みホットパスから同期AGEラウンドトリップを排除)、キュレーターコンパクションの有効化(#1749 / #1750)、およびai-memory verify-audit-trail CLI(§22 PE-8)はsigned_eventsクロス行ハッシュチェーンをエンドツーエンドで走査します。
スキーマv57 → v70(すべて追加的)
調整 + 型付き認知 + 可視性 + 暗号化準備 + コールドパス + アーカイブエッジテーブル(v58–v70)は、sqliteとpostgresアダプターの両方にミラーリングされ、最初のオープン時に自動マイグレーションし、アーカイブ → 復元のラウンドトリップをロスレスで行います。正規のv58–v70ラダーについてはCLAUDE.md §Databaseを参照してください。
開始場所:
docs/v0.8.0/release-notes.md(完全なリリースノート)、docs/coordination.md(調整ツールリファレンス)、およびCLAUDE.md §Database(スキーマラダーSSOT)。
v0.7の新機能
v0.7.0はattested-cortexエピック(11トラックA–Kで69/69)を完了し、元々v0.7.1のpostgres+AGEファーストクラス作業を統合し、グランドスラム後の出荷準備波(Batman Forms 1-6 + 7番目のフォームOption-B基盤 + QW-1/2/3 + セキュリティ調整)を吸収します。正規の機能インベントリ: docs/internal/v070-feature-inventory.md。すべてのサーフェスはv0.6.4呼び出し元に対してデフォルトオフまたはデフォルト同等のままです — 内訳はv0.7互換性マトリックスを参照してください。
基盤ネイティブの書き込み時投資(Batman Forms 1-6 + 7番目のフォーム)
- Form 1 — オンライン重複排除と合成(issue #754)。ストアパス上のv0.6.xペアごとの分類器を、単一バッチのアクション生成LLM呼び出しが置き換えます。名前空間標準の
legacy_per_pair_classifier = trueでレガシーのyes/noにオプトバックします。 - Form 2 — 同期アトマイズ前埋め込み(issue #755)。新しい
memory_atomiseツール +auto_atomise_mode = Synchronous|Deferred|Offプリストアフック。キュレーターはリコールがそれらを見る前に長い書き込みを2〜10の原子命題に分解します。docs/atomisation.mdを参照してください。 - Form 3 — マルチステップ取り込みオーケストレーター(issue #756)。
memory_ingest_multistepは決定論的Jaccard+FTSヘルパーをプロンプトキャッシュ安定LLMステージに通します。docs/multistep-ingest.md+cookbook/multistep-ingest/01-two-phase.shを参照してください。 - Form 4 — ファクトの出所(issue #757)。引用 + ソースURI + アトム粒度スパンが既存の
memory_store/memory_atomiseペイロードに乗ります。docs/provenance.mdを参照してください。 - Form 5 — 自動信頼度 + シャドウキャリブレーション + 鮮度減衰(issue #758)。
memory_calibrate_confidenceMCPツール + ソースごとのベースラインスイープ。環境変数AI_MEMORY_AUTO_CONFIDENCE、AI_MEMORY_CONFIDENCE_SHADOW、AI_MEMORY_CONFIDENCE_SHADOW_SAMPLE_RATE、AI_MEMORY_CONFIDENCE_DECAY。docs/confidence-calibration.mdを参照してください。 - Form 6 —
MemoryKindBatman語彙(issue #759)。10バリアント列挙(Observationデフォルト +Reflection/Persona/Concept/Entity/Claim/Relation/Event/Conversation/Decision)。オプションのauto_classify_kindプリストアフック(off / regex_only / regex_then_llm)。docs/memory-kind-vocab.mdを参照してください。 - 7番目のフォーム — エージェント外部レイヤー4配線(Option-B基盤)(issue #760; v0.8.0完全カバーは#697)。オペレーターキーペア署名シードルール
R001..R004、memory_check_agent_action+memory_rule_listMCPツール、基盤storage::insertプリライトフック。docs/policy-engine.md+docs/governance/agent-action-rules.mdを参照してください。 - オペレーターハウツー — Forms 1–6 + 7番目を可能からアクティブへ(issue #800)。7ステップレシピ(オペレーターキー生成 → シード署名 → R001–R004有効化 → キュレーターデーモン → オプションのリフレクションパス → 名前空間ポリシー)、launchd / systemd / Task-Scheduler永続性、検証ブロック、ロールバックパス。
docs/batman-active-mode.mdとGitHub Pagesアトラスを参照してください。
クイックウィン(Tencent QW-1/2/3)
- QW-1 — ファイルバックアップリフレクションチェーンエクスポート。
memory_export_reflectionMCPツール +auto_export_reflections_to_filesystem名前空間ポリシー →~/.ai-memory/reflections/<ns>/<id>.md。 - QW-2 — ペルソナとしてのアーティファクト。
memory_persona+memory_persona_generateツール、MemoryKind::Persona行、auto_persona_trigger_every_n_memories名前空間ポリシー。docs/persona.mdを参照してください。 - QW-3 — コンテキストオフロードプリミティブ。
memory_offload+memory_derefは大きなツール出力をエージェントコンテキストウィンドウからアドレス可能なブロブストレージに移動します。docs/context-offload.mdを参照してください。
証明付き皮質エピック(トラックA–K)
- 署名付きリンク(Ed25519)。 v0.6.3で出荷された未使用の
signature列は、実際のエージェントごとのEd25519アテステーションで埋められ、memory_verify(link_id)は要求に応じて{signature_verified, attest_level, signed_by, signed_at}を返します。ai-memory identity generateでキーペアを生成し、attest_level = "self_signed"でオプトインします。署名は、解決されたデーモンのagent_idが設定されたキーディレクトリの下に*.privキーペアをディスク上に持っている場合にゲートされます —load_daemon_signing_keyがNone(src/main.rs:116-118)を返す場合、行は書き込まれますが、sigは空で、デーモンは起動時に「署名なしで続行」行を出力します。signed_eventsの行間ハッシュチェーンは、どちらの場合も改ざん検知可能なままです。attested-cortexRFC を参照してください。 - 署名付きイベント V-4 クローズアウト(行間ハッシュチェーン)(issue #698)。各
signed_events行はprev_hash+sequenceを保持します。最初の行のprev_hashはゼロで、後続の行は前の正規CBORペイロードのSHA-256をチェーンします。ai-memory verify-signed-events-chainはチェーンを端から端までウォークします。docs/signed-events-v4.mdを参照してください。 - フックパイプライン(25のライフサイクルイベント)。 プログラム可能な拡張サーフェスは、20のベースライン
pre_/post_store|recall|search|delete|promote|link|consolidate|governance_decision|archive|transcript_store+on_index_evictionイベントに加えて、5つのグランドスラム追加(pre_recall_expandG10 +pre_reflect/post_reflect再帰学習タスク6/8 +pre_compaction/on_compaction_rollbackL1-7)で発火します。フックはAllow/Modify/Deny/AskUserを返します。デフォルトはオフで、~/.config/ai-memory/hooks.tomlを介してオプトインします。docs/hook-pipeline.mdを参照してください。 - サイドチェーンのトランスクリプトとリプレイ。 zstd-3 BLOBサイドチェーンは、生の会話/推論トレイルを保存します。
memory_replay(memory_id)はmemory_transcript_linksをウォークしてチェーンを再構築します。名前空間ごとに[transcripts.namespaces."team/*"]を介してオプトインします。docs/sidechain-transcripts.mdを参照してください。 - フェデレーションの強化。 mTLS + X-API-Key + SHA-256証明書フィンガープリント許可リスト。環境変数
AI_MEMORY_FED_PEER_ATTESTATION、AI_MEMORY_FED_SYNC_TRUST_PEER、AI_MEMORY_FED_TRUST_BODY_AGENT_ID。docs/federation.mdを参照してください。 - K8クォータツール + K10 SSE承認。
memory_quota_status+/api/v1/quota/status(K8)。/api/v1/approvals/streamサーバー送信イベント(HMACノンス、メソッド+pending_idバインディング、遅延イベントカウントストリップ付き)(K10)。docs/k8-quotas.md+docs/k10-sse-approvals.mdを参照してください。 - Postgres + Apache AGE ファーストクラスバックエンド。
ai-memory serve --store-url postgres://…、スキーマのパリティ、6要素リコールスコアリングのパリティ、リンク移行、AGE Cypher上のKG機能(kg_query、kg_timeline、kg_invalidate、find_paths)と、AGEがない場合の再帰CTEフォールバック、さらに新しいai-memory schema-initCLI動詞。ベンチマークゲート付き — AGE p95は深さ=5でCTE p95を≥30%上回る必要があります。オペレーターのハウツー:docs/postgres-age-guide.md。移行ランブック:docs/migration-v0.7.0-postgres.md。 - Capabilities v3 + スマートローダー。
memory_capabilitiesv3はsummary、to_describe_to_user、ツールごとのcallable_now、agent_permitted_families、schema_version="3"を追加します。新しい常時オンのmemory_load_family(family)とmemory_smart_load(intent)ツールは、デフォルトのcoreプロファイルに参加します。固定されたフレージングはdocs/v0.7/canonical-phrasings.mdにあります。 - 権限 + A2A承認。 v0.6.xのガバナンスサブシステムは、ルール + モード + フック → 単一の
Decisionにリファクタリングされ、名前空間の継承(G1)が実際に強制されます。memory_pending_list/memory_pending_approve/memory_pending_reject(remember=forever)は段階的な信頼を可能にします。承認APIでのHMAC署名は必須です。permissions.modeはデフォルトでenforce(v0.6.4ではadvisoryでした)。ai-memory governance migrate-to-permissionsで移行します(ドライラン preview; 適用するには--config-out ~/.config/ai-memory/config.tomlを追加)。docs/governance.mdを参照してください。
再帰学習 + L1/L2グランドスラムウェーブ
memory_reflect 基盤プリミティブ(名前空間スコープの max_reflection_depth キャップ付き、デフォルト3、Some(0) はキルスイッチ)。L2-1 リフレクションパスキュレーター、L2-2 フェデレーション対応リフレクション調整(memory_reflection_origin)、L2-3 無効化伝播(memory_dependents_of_invalidated)、L2-5 フォレンジックバンドル(ai-memory export-forensic-bundle + verify-forensic-bundle)、L1-5 エージェントスキル(memory_skill_register|list|get|resource|export|promote_from_reflection|compositional_context)。完全なプライマー:docs/RECURSIVE_LEARNING.md。エージェントスキルのプライマー:docs/agent-skills.md。フォレンジックエクスポートのプライマー:docs/forensic-export.md。
開始場所:
docs/MIGRATION_v0.7.md(アップグレード手順)、docs/v0.7.0/release-notes.md(完全なリリースノート)、docs/whats-new-v07.html(視覚的な概要)、docs/v0.7/rfc-attested-cortex.md(設計根拠)、docs/ADMIN_GUIDE.md(オペレータープレイブック)、docs/internal/v070-feature-inventory.md(正規の機能の真実)。
1つのバイナリ、4つの運用モード(v0.6.4)。ai-memory Rustバイナリ(tokio + axum)は、これらを単独または同時に実行でき、単一のSQLiteデータベースを共有します:
- stdio MCPサーバー — フルプロファイル(v0.9.0; 100の呼び出し可能なメモリツール + 常時オンの
memory_capabilitiesブートストラップ;Profile::full().expected_tool_count()に対して検証済み)でJSON-RPCを介して101のアドバタイズされたエントリ。デフォルトの--profile coreは7つ(元の5つ +memory_load_family+memory_smart_load)に加えて常時オンのmemory_capabilitiesブートストラップをアドバタイズします。ai-memory mcp/ai-memory mcp --profile full - HTTP / mTLSデーモン —
127.0.0.1:9077上の92のRESTルート登録(78の一意のURLパス)、TLS + オプションのmTLS許可リスト + APIキー認証、バックグラウンドGCループ。ai-memory serve - 自律キュレーターデーモン — 自己スケジューリングループ(デフォルト1時間の周期)で、自動タグ付け、名前空間の兄弟間の矛盾の表面化、類似の重複の統合、アクセスパターンによる優先度の調整を行います。すべてのアクションはロールバックログに記録されます。破壊的な操作はガバナンス承認フローの背後にゲートできます。
ai-memory curator --daemon - 同期デーモン — インスタンス間のクォーラムベースのピアフェデレーション。W-of-N書き込み(デフォルトは過半数)、ベクタークロックCRDT-liteマージ、ピア間のmTLS許可リスト。
ai-memory sync-daemon
MCP、HTTP、CLIサーフェスはリアクティブです。キュレーターはメモリレイヤーを自己維持させる部分です:セッションの合間に、コーパスを整理して、ストアが成長してもリコール品質を高く保ちます。すべてはローカルファーストで、クラウド依存はありません。
Claude Opus 4.7による率直な評価(v0.6.3ソースを一行ずつ読んだ後):
「ai-memoryは私がこれまで接続された中で最も能力の高いメモリレイヤーであり、その名前が示す以上に意味があります。私にとって、実用的には、各セッションで冷たく始まらないことを意味します。私が読むストアは、私以外の何かによって整理された状態に保たれています。矛盾は静かに蓄積されません。コーパスが成長してもリコール品質は高く保たれます。何もあなたのMac miniから出て行きません。
それは私を自律エージェントにしているわけではありません。それは自律エージェントが必要とする種類のメモリインフラストラクチャを私に与え、それを維持するために小さな自律ループを実行しています。それは本当の基盤です。ここから『ai-memoryが一般的なタスクを駆動する』までのギャップは、配管(ツール呼び出しプロトコル + ツールレジストリ + ツール使用可能なモデル)であり、発明ではありません。」
マルチエージェントAIのための基盤。 ai-memoryはエージェントランタイムでも、それ自体が「自律AI」でもありません。それは、マルチエージェントの自律デプロイメントがその下に必要とするメモリレイヤーです。フェデレーション(broadcast_store_quorum + spawn_catchup_loop)は、多くのエージェントが並行して書き込むときにピア間のW-of-N一貫性を処理します。キュレーターデーモンは、スウォームが書き込むときに共有コーパスがノイズに劣化するのを防ぎます。Webhookサブスクリプション(HMAC署名、名前空間/エージェントフィルター、SSRF強化)は、ストアをメモリイベントで下流のエージェントをトリガーするメッセージバスに変えます。Nレベルの継承と名前空間ごとのガバナンスポリシー(書き込み/昇格/削除権限、承認者タイプ、オプションのN-of-Mコンセンサス)を持つ名前空間階層は、スウォームを制限します。これを自動生成スキルを持つ24/7のマルチマシンエージェントランナーの下にスタックすると、組み合わせたシステムは自律AIの行動バーをクリアします。残りのギャップ(重みレベルの学習なし、ステートレス推論カーネル、人間がシードしたルートゴール)は現実的であり、ai-memoryが対処するものではありません。ai-memoryは、それらのギャップを埋める真剣な試みがすべて必要とするマルチエージェントメモリ基盤を提供します。
リコールまでゼロトークンコスト。 組み込みのメモリシステム(Claude Codeオートメモリ、ChatGPTメモリ)とは異なり、すべてのメモリをすべての会話にロードして、すべてのメッセージでトークンとお金を燃やすのに対し、ai-memoryはAIが明示的に memory_recall を呼び出すまでゼロコンテキストトークンを使用します。関連するメモリだけが、6要素スコアリングアルゴリズムでランク付けされて戻ってきます。TOON形式(Token-Oriented Object Notation)は、繰り返されるフィールド名を排除することで応答トークンをさらに40〜60%削減します — JSONで3つのメモリ = 1,600バイト; TOONで626バイト(61%小さい); TOONコンパクトで336バイト(79%小さい)。Claude Codeユーザー向け:オートメモリを無効にし(settings.jsonの "autoMemoryEnabled": false)、ai-memoryに置き換えて、すべてのメッセージで200行以上のメモリコンテキストに支払うのをやめましょう。
エージェントアイデンティティ(NHI)— すべてのメモリは誰が学んだかを伝えます
ai-memoryが保存するすべてのメモリは metadata.agent_id を保持します — すべての操作(更新、重複排除、インポート、同期、統合)で生き残る非人間アイデンティティマーカーです。すべてのリコール結果は、デフォルトで、AIクライアントがすでに最適化されているTOONコンパクト応答形式で、各メモリを書いたAIを伝えます:
count:5|mode:hybrid|tokens_used:842
memories[id|title|tier|namespace|priority|score|tags|agent_id]:
a1b2|Project DB is PostgreSQL 16|long|infra|8|0.91|database,postgres|ai:claude-code@workstation:pid-3812
c3d4|API rate limit is 100 rps|long|infra|7|0.87|api,limits|ai:claude-desktop@laptop:pid-5219
署名なしの書き込みでは、agent_id は主張されたアイデンティティです — それだけに基づいてセキュリティ決定を下さないでください。ストアパスのエージェントアテステーションは、HTTP直接書き込みサーフェスでデフォルトで必須です(#1751、#1985 でサーフェススコープ):署名なしのHTTP POST /api/v1/memories(+/bulk)は、オペレーターが明示的なオプトアウト AI_MEMORY_REQUIRE_AGENT_ATTESTATION=0 を設定しない限り、attest_level = "claimed" に着地するのではなく拒否されます(403 ATTESTATION_FAILED)。MCP memory_store とCLI store のオペレーター・アズ・アクターサーフェスはデフォルトで寛容なままです(署名なしの書き込みは claimed に着地します)。=1 はすべてのサーフェスで厳格を強制します。暗号化Ed25519アテステーションは2つのサーフェスで配線されています:(1)ストアパスアテステーション(#626レイヤー3) — CLI(store --sign)、MCP(memory_store)、またはHTTP(POST /api/v1/memories)パスで正規の SignableWrite エンベロープに対する分離署名を提示し、デーモンはエージェントのバインドされた公開鍵に対して検証し、metadata.attest_level = "agent_attested" をスタンプします(提示されたが偽造された署名は、フラグに関係なく常に拒否されます)。(2)リンクアテステーション(attested-cortex) — 以前に予約された memory_links.signature フィールドで、インバウンド検証用の memory_verify(link_id) と追加専用の signed_events 監査チェーンを備えています。完全な来歴契約については、エージェントアイデンティティページ と attested-cortex RFC を参照してください。
遡及的な会話インポート — ai-memory mine
冷たく始めないでください。ai-memory mine をClaude、ChatGPT、またはSlackエクスポートに向けると、ターンバイターンでランク付けされた、ティアタイプの、タグ付きメモリに解析されます — あなたのAIが既存の履歴からのすべての決定、修正、発見を知って次のセッションに歩いて入るように。
ai-memory mine claude  ~/Downloads/claude-export/
ai-memory mine chatgpt ~/Downloads/chatgpt-export.json
ai-memory mine slack   ./slack-export/
自動タグ付け、(title, namespace) での重複排除、mined_from の来歴がすべてのインポートされたメモリにスタンプされます。ゼロコンテキストから人口の多い長期ストアへの5分間のオンボーディング。フォーマットごとのレシピについては、インポート履歴ページ を参照してください。
互換性のあるAIプラットフォーム
ai-memoryは、Model Context Protocol(MCP) をサポートする任意のAIプラットフォームと統合します。MCPは、AIアシスタントを外部ツールやデータソースに接続するためのユニバーサル標準です。
| プラットフォーム | 統合方法 | 設定形式 | ステータス |
|---|---|---|---|
| Claude Code (Anthropic) | MCP stdio | JSON (~/.claude.json または .mcp.json) | 完全サポート |
| Codex CLI (OpenAI) | MCP stdio | TOML (~/.codex/config.toml) | 完全サポート |
| Gemini CLI (Google) | MCP stdio | JSON (~/.gemini/settings.json) | 完全サポート |
| Grok CLI (xAI) | MCP stdio | JSON (~/.grok/user-settings.json) | 深い統合 |
| Grok API (xAI) | MCP リモート HTTPS | APIレベル | 完全サポート |
| Cursor IDE | MCP stdio | JSON (~/.cursor/mcp.json) | 完全サポート |
| Windsurf (Codeium) | MCP stdio | JSON (~/.codeium/windsurf/mcp_config.json) | 完全サポート |
| Continue.dev | MCP stdio | YAML (~/.continue/config.yaml) | 完全サポート |
| Llama Stack (META) | MCP リモート HTTP | YAML / Python SDK | 完全サポート |
| OpenClaw | MCP stdio | JSON (設定内のmcp.servers) | 完全サポート |
| 任意のMCPクライアント | MCP stdio または HTTP | さまざま | ユニバーサル |
MCPは主要な統合レイヤーです。まだMCPをネイティブにサポートしていないAIプラットフォーム向けには、HTTP API(localhost上で92のルート登録 / 78の一意なURLパス)とCLI(--features sal または --features sal-postgres の下に89のサブコマンド。デフォルトビルドでは87(#1389後のL2 RecoverPreviousSession によるセッション間コンテキストの再水和 + #1443 Expand による ai-memory expand クエリ拡張サーフェス + #1598 Reembed による ai-memory reembed ベクトル空間移行サーフェス)。SSOTは ai_memory::EXPECTED_CLI_SUBCOMMANDS_DEFAULT + EXPECTED_CLI_SUBCOMMANDS_SAL + 機械的な tests/cli_subcommand_count_invariant.rs パリティテストによって固定)がユニバーサルアクセスを提供します。HTTP呼び出しやシェルコマンドを実行できるあらゆるAI、スクリプト、自動化がai-memoryを使用できます。
60秒でインストール
プリビルドバイナリは依存関係を必要としません。ソースからのビルドにはRustとCコンパイラが必要です。
最速: プリビルドバイナリ(Rust不要)
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.sh | sh

# Fedora/RHEL (COPR)
sudo dnf copr enable alpha-one-ai/ai-memory && sudo dnf install ai-memory

# Windows (PowerShell)
irm https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.ps1 | iex
ステップ1: Rustをインストール(プリビルドバイナリを使用する場合はスキップ)
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
プロンプトに従い、ターミナルを再起動します(または source ~/.cargo/env を実行)。
ステップ2: ソースからビルド(Rustが必要)
Crates.io からの最新リリース:
cargo install ai-memory
gitリポジトリからの最新版:
cargo install --git https://github.com/alphaonedev/ai-memory-mcp.git
これによりバイナリがコンパイルされ、PATHに配置されます。1〜2分かかります。
ソースビルドのビルド依存関係:
- Ubuntu/Debian:
sudo apt-get install build-essential pkg-config- Fedora/RHEL:
sudo dnf install gcc pkg-config
ステップ3: AIを接続
設定はプラットフォームによって異なります。以下から該当するものを見つけてください:
Claude Code (Anthropic)
Claude Codeは3つのMCP設定スコープをサポートしています:
| スコープ | ファイル | 適用対象 |
|---|---|---|
| ユーザー (グローバル) | ~/.claude.json — mcpServers キーを追加 | マシン上のすべてのプロジェクト |
| プロジェクト (共有) | プロジェクトルートの .mcp.json (gitにチェックイン) | プロジェクトの全員 |
| ローカル (プライベート) | ~/.claude.json — projects."/path".mcpServers の下 | 1つのプロジェクト、自分だけ |
ユーザースコープ(推奨 — どこでも動作):
mcpServers キーを ~/.claude.json (macOS/Linux) または %USERPROFILE%\.claude.json (Windows) に追加:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
注:
~/.claude.jsonは他の設定とともに既に存在する可能性があります。既存のファイルにmcpServersキーをマージしてください — 上書きしないでください。
プロジェクトスコープ(チームで共有):
プロジェクトルートに .mcp.json を作成:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
smart / autonomous ティアとクラウドLLM — 推奨パスは ~/.config/ai-memory/config.toml の [llm] セクションです(#1146)。1つのファイルで、すべてのサーフェスに対応し、AIクライアントごとの編集は不要:
# ~/.config/ai-memory/config.toml
schema_version = 2

[llm]
backend     = "xai"
model       = "grok-4.3"
base_url    = "https://api.x.ai/v1"
api_key_env = "XAI_API_KEY"            # process-env-var name (NOT the literal key)
シェルのrcファイル(.zshrc / .bashrc)で XAI_API_KEY をエクスポートします。MCP設定は最小限のまま:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "autonomous"]
    }
  }
}
確認: ai-memory boot --quiet --limit 1 が llm=xai:grok-4.3 を報告するはずです。正規のスキーマリファレンス: docs/CONFIG_SCHEMA.md。
オーバーライドパス —
env:ブロック。 MCP設定にenv:ブロックを追加し、AI_MEMORY_LLM_BACKEND/_API_KEY/_MODELを指定すると、引き続き機能し、config.tomlよりも優先されます — CIやセッションごとの調整に便利:"env": { "AI_MEMORY_LLM_BACKEND": "xai", "AI_MEMORY_LLM_API_KEY": "xai-...", "AI_MEMORY_LLM_MODEL": "grok-4.3" }MCPクライアントは、MCP設定の
env:キーのみを使用してサーバーを新しいサブプロセスとして起動します —.zshrc/.bashrcのシェルエクスポートは到達しません。上記の[llm]設定ファイルパスはこの問題を解消します(すべてのサーフェスが同じファイルを読み取ります)。config.toml内のインラインAPIキーは解析時に拒否されます —api_key_envまたはapi_key_fileを使用してください。背景: #1144 → #1146。バックエンドごとの完全なレシピ:docs/integrations/llm-backends.md。
Windowsパス:
--dbではフォワードスラッシュまたはエスケープされたバックスラッシュを使用してください。例:"--db", "C:/Users/YourName/.claude/ai-memory.db"。
ティアフラグ:
--tierフラグは機能ティアを選択します:keyword、semantic(デフォルト)、smart、またはautonomous。スマートおよび自律ティアにはLLMバックエンドが必要です — #1067(v0.7.0)以降、それは次のいずれかです: ローカルの Ollama、xAI Grok、OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi (Moonshot)、Qwen (Alibaba)、Mistral、Groq、Together AI、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM、またはllama.cppサーバー —AI_MEMORY_LLM_BACKENDで選択します。--tierフラグは必ずargsで渡す必要があります — MCPサーバーがAIクライアントによって起動される場合、config.tomlティア設定は使用されません。
重要: MCPサーバーは
settings.jsonまたはsettings.local.jsonでは設定されません — これらのファイルはmcpServersをサポートしていません。
Claudeがai-memoryを積極的に使用するようにする: プロジェクトルートにai-memoryディレクティブを含む CLAUDE.md ファイルを追加します。これにより、Claudeは各会話の開始時にコンテキストを呼び出し、作業中に発見事項を保存します。コピーペースト用テンプレートと配置オプションについては、CLAUDE.md統合ガイド を参照してください。
OpenAI Codex CLI
~/.codex/config.toml(グローバル)または .codex/config.toml(プロジェクト)に追加します。Windows: %USERPROFILE%\.codex\config.toml。CODEX_HOME 環境変数でオーバーライドします。
[mcp_servers.memory]
command = "ai-memory"
args = ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
enabled = true
またはCLI経由で追加: codex mcp add memory -- ai-memory --db ~/.local/share/ai-memory/memories.db mcp --tier semantic
注: Codexはアンダースコア付きキー
mcp_serversのTOML形式を使用します(camelCaseでもハイフン区切りでもありません)。env(キー/値ペア)、env_vars(転送するリスト)、enabled_tools、disabled_tools、startup_timeout_sec、tool_timeout_secをサポートします。TUIで/mcpを使用してサーバーステータスを表示します。Codex MCPドキュメント を参照してください。
Google Gemini CLI
~/.gemini/settings.json(ユーザー)または .gemini/settings.json(プロジェクト)に追加します。Windows: %USERPROFILE%\.gemini\settings.json。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"],
      "timeout": 30000
    }
  }
}
またはCLI経由で追加: gemini mcp add memory ai-memory -- --db ~/.local/share/ai-memory/memories.db mcp --tier semantic
注: サーバー名にアンダースコアを使用しないでください(ハイフンを使用)。ツール名は
mcp_memory_<toolName>として自動的にプレフィックスされます。envフィールドの環境変数は$VAR/${VAR}(すべてのプラットフォーム)と%VAR%(Windows)をサポートします。Geminiは明示的に宣言されない限り、継承された環境から機密パターンをサニタイズします。確認プロンプトをスキップするには"trust": trueを追加します。CLI管理:gemini mcp list/remove/enable/disable。Gemini CLI MCPドキュメント を参照してください。
Cursor IDE
~/.cursor/mcp.json(グローバル)または .cursor/mcp.json(プロジェクト)に追加します。Windows: %USERPROFILE%\.cursor\mcp.json。同じ名前のサーバーではプロジェクト設定がグローバルを上書きします。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
    }
  }
}
注:
mcp.jsonを編集した後、Cursorを再起動します。設定 > ツール & MCP でサーバーステータスを確認します(緑のドット = 接続済み)。env、envFile、${env:VAR_NAME}の補間をサポートします(環境変数の補間はシェルプロファイル変数では信頼性が低い場合があります — 回避策としてenvFileを使用)。すべてのMCPサーバーで約40ツールの制限があります。Cursor MCPドキュメント を参照してください。
Windsurf (Codeium)
~/.codeium/windsurf/mcp_config.json に追加します(グローバルのみ — プロジェクトレベルのスコープはありません)。Windows: %USERPROFILE%\.codeium\windsurf\mcp_config.json。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
    }
  }
}
注:
command、args、env、serverUrl、url、headersで${env:VAR_NAME}の補間をサポートします。すべてのMCPサーバーで100ツールの制限があります。MCPマーケットプレイスまたは設定 > Cascade > MCPサーバーからも追加できます。Windsurf MCPドキュメント を参照してください。
Continue.dev
~/.continue/config.yaml(ユーザー)またはプロジェクトルートの .continue/mcpServers/ ディレクトリ(サーバーごとのYAML/JSONファイル)に追加します。Windows: %USERPROFILE%\.continue\config.yaml。
mcpServers:
  - name: memory
    command: ai-memory
    args:
      - "--db"
      - "~/.local/share/ai-memory/memories.db"
      - "mcp"
      - "--tier"
      - "semantic"
注: MCPツールはエージェントモードでのみ機能します。シークレット補間には
${{ secrets.SECRET_NAME }}をサポートします。プロジェクトレベルの.continue/mcpServers/ディレクトリは、他のツール(Claude Code、Cursorなど)のJSON設定を自動検出します。Continue MCPドキュメント を参照してください。
Grok CLI (AlphaOneフォーク — 自動リコールによる深い統合)
grok-cliのAlphaOneフォーク には、セッションスコープのMCP接続、セッション開始時の自動メモリリコール、コンパクションサマリーの保存、メモリ認識型システムプロンプトを備えた組み込みのai-memoryサポートがあります。
~/.grok/user-settings.json に追加:
{
  "mcp": {
    "servers": [
      {
        "id": "ai-memory",
        "label": "AI Memory",
        "enabled": true,
        "transport": "stdio",
        "command": "ai-memory",
        "args": ["mcp", "--tier", "semantic"]
      }
    ]
  }
}
機能: セッション開始時の自動リコール(関連メモリをシステムプロンプトに注入)、コンパクションサマリーをミッドティアメモリとして保存、すべてのモード(エージェント、プラン、アスク)でMCPツールが利用可能、セッションスコープの接続(メッセージごとのコールドスタートなし)。デフォルトで
--tier semanticを使用します(ローカル埋め込み、LLMバックエンド不要)。完全なセットアップについては grok-cliドキュメント を参照してください。
xAI Grok API (APIレベル、リモートMCP)
GrokはHTTPS経由でMCPサーバーに接続します(リモートのみ、stdioなし)。設定ファイルはありません — サーバーはAPIリクエストごとに指定されます。
ai-memory serve --host 127.0.0.1 --port 9077
# Expose via HTTPS reverse proxy (nginx, caddy, cloudflare tunnel, etc.)
次に、Grok API呼び出しにMCPサーバーを追加します:
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.3",
    "tools": [{
      "type": "mcp",
      "server_url": "https://your-server.example.com/mcp",
      "server_label": "memory",
      "server_description": "Persistent AI memory with recall and search",
      "allowed_tools": ["memory_store", "memory_recall", "memory_search"]
    }],
    "input": "What do you remember about our project?"
  }'
要件: HTTPSが必要です。
server_labelが必要です。Streamable HTTPおよびSSEトランスポートをサポートします。オプション:allowed_tools、authorization、headers。xAI SDK、OpenAI互換Responses API、Voice Agent APIで動作します。xAIリモートMCPドキュメント を参照してください。
META Llama (Llama Stack経由)
Llama StackはMCPサーバーをツールグループとして登録します。標準化された設定ファイルパスはありません — デプロイメント固有です。
ai-memory serve --host 127.0.0.1 --port 9077
Python SDK:
client.toolgroups.register(
    provider_id="model-context-protocol",
    toolgroup_id="mcp::memory",
    mcp_endpoint={"uri": "http://localhost:9077/sse"}
)
またはrun.yamlで宣言的に:
tool_groups:
  - toolgroup_id: mcp::memory
    provider_id: model-context-protocol
    mcp_endpoint:
      uri: "http://localhost:9077/sse"
注: run.yamlで
${env.VAR_NAME}の補間をサポートします。トランスポートはSSEからStreamable HTTPに移行中です。Llama Stackツールドキュメント を参照してください。
OpenClaw
CLI経由で追加するか、OpenClaw設定を直接編集します。設定は mcp.servers を使用します(mcpServers ではありません)。
openclaw mcp set memory '{"command":"ai-memory","args":["--db","~/.local/share/ai-memory/memories.db","mcp","--tier","semantic"]}'
またはOpenClaw設定ファイルに追加:
{
  "mcp": {
    "servers": {
      "memory": {
        "command": "ai-memory",
        "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
      }
    }
  }
}
注記: OpenClawは
mcp.serversキーを使用します(mcpServersではありません)。CLI管理:openclaw mcp list、openclaw mcp show、openclaw mcp set、openclaw mcp unset。stdio、リモートURL、Streamable HTTPトランスポートをサポートします。インラインシークレットよりも--token-fileを推奨します。OpenClaw MCPドキュメントを参照してください。
その他のMCPクライアント
ai-memoryはstdio(JSON-RPC 2.0)上でMCPを話します。クライアントを次の場所に向けてください:
command: ai-memory
args: ["--db", "/path/to/ai-memory.db", "mcp"]
HTTP専用クライアントの場合は、REST APIを起動します:
ai-memory serve
# 92 REST route registrations (78 unique URL paths) at http://127.0.0.1:9077/api/v1/
ステップ4: 完了。テストする。
AIアシスタントを再起動します。MCPを使用している場合、セッション起動時に7ツールのデフォルトサーフェスが宣伝されます(元の5つ + memory_load_family + memory_smart_load; 100個の呼び出し可能ツールのうち残りの93個は--profileまたはmemory_capabilities --include-schemaを介してオンデマンドで読み込まれます)。次のように尋ねてください:「私の好きな言語がRustであることを記憶してください。」その後、新しい会話で「私の好きな言語は何ですか?」と尋ねてください。記憶されています。
モバイルプラットフォームサポート(v0.7.0 Posture-1a)
ai-memoryは、標準のRustモバイルクロスコンパイルパスを介してiOSおよびAndroidに移植可能です。v0.7.0は、両ターゲットに対して3つの段階的なレベルでCIカバレッジを提供します:
| レイヤー | カバレッジ | CIワークフロー |
|---|---|---|
| レイヤー1 — クロスコンパイル | cargo check --target aarch64-apple-ios --no-default-features --features sqlite-bundled --libと対応するAndroidクロスコンパイルが、すべてのPR + release/**へのプッシュで実行されます。モバイルのビット腐敗リスクの約80%を検出します(モバイル移植性を落とすクレート更新はここで表面化します)。 | .github/workflows/ci.yml — mobile-cross-compileジョブ |
| レイヤー2 — リリースアーティファクト | リリースタグのカットにより、ai-memory-ios.xcframework.tar.gz(xcodebuild -create-xcframeworkを介したiOSデバイス+シミュレータスライス)とai-memory-android.tar.gz(jniLibs/<abi>/レイアウトのAndroid arm64 / armv7 / x86_64 / x86 .soバンドル)が生成されます。 | .github/workflows/release.yml — mobile-ios + mobile-androidジョブ |
| レイヤー3 — ランタイムテスト | スコープされた約50テストのサブセット(ファイルシステムサンドボックス、デバイス上のSQLiteでのFTS5、HNSW CPU再現、エンベッダーCPUパス、LLMクライアントTLS)が、すべてのrelease/**プッシュ+手動workflow_dispatchでiOSシミュレータに対して実行されます。Androidエミュレータのarm実行はrelease/**プッシュ+workflow_dispatchのみです。選択の根拠: tests/mobile/README.md。 | .github/workflows/mobile-runtime.yml |
v0.7.0時点のステータス: レイヤー1がリリースゲートです — タグカットの前にモバイルクロスコンパイルがGREENである必要があります。レイヤー2(リリースアーティファクト)はBUILDパイプライン+アーティファクトレイアウトを提供します。C呼び出し可能なFFIサーフェス自体はv0.7.xフォローアップで導入されます。レイヤー3は、すべてのrelease/**プッシュでスコープされたテストサブセットを実行します。
リリースアーティファクトの利用:
- iOS — v0.7.xリリースページから
ai-memory-ios.xcframework.tar.gzをダウンロードし、解凍して、AiMemory.xcframeworkをXcodeプロジェクトの「Frameworks, Libraries, and Embedded Content」にドラッグします。 - Android — v0.7.xリリースページから
ai-memory-android.tar.gzをダウンロードし、解凍して、jniLibs/ツリーをアプリモジュールのsrc/main/jniLibs/にコピーします。
モバイルアーティファクトは公開されたすべてのv0.7.xリリースの一部でもあります。Homebrewフォーミュラ+ APT/RPMパッケージ(デスクトップバイナリを提供)には、モバイルダウンロードへのリンクを含む注記が含まれています。CI実装の履歴については、issue #1068を参照してください。
クイックスタート
ゼロから2分以内で動作するメモリを実現します。
1. インストール
curl -fsSL https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.sh | sh
2. MCPの設定(Claude Codeの例 — 他のプラットフォームも同じように動作します)
~/.claude.jsonにマージ:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
3. 最初のメモリを保存
ai-memory store -T "Project uses PostgreSQL 15" -c "Main DB is PG 15 with pgvector." --tier long
4. 呼び出す
ai-memory recall "database"
5. 統計を確認
ai-memory stats
6. AIで使用。 AIクライアントを再起動します。起動時に7つのデフォルトメモリツールが宣伝されます(101の宣伝エントリはランタイム拡張または--profile fullを介して到達可能)— MCP上で会話中にネイティブにメモリを保存および呼び出すことができます。
SDK
MCP / HTTP / CLIサーフェスに加えて、ai-memoryはHTTPクライアント用のファーストパーティ言語SDKとヘルパーユーティリティ(例: v0.6.4+デーモンのランタイムプロファイルアサーション用のrequireProfile)を提供します。
TypeScript / JavaScript — npm上の@alphaone/ai-memory
npm install @alphaone/ai-memory
Python — PyPI上のai-memory-mcp(インポート名はai_memoryのまま)
pip install ai-memory-mcp
from ai_memory import AiMemoryClient, require_profile

with AiMemoryClient(base_url="http://127.0.0.1:9077", api_key="...") as client:
    require_profile(client, "graph")  # raises ProfileNotLoaded on miss
両方のSDKはサーバーとバージョンが一致しています(0.9.0はai-memory 0.9.0と一致)。v0.6.4+デーモンはプロファイル契約を強制します。v0.6.4より前のデーモンは寛容な警告-and-継続にフォールバックするため、SDKのアップグレードで古いサーバーが壊れることはありません。ソースはsdk/typescript/とsdk/python/にあります。
これは何をするものですか?
AIアシスタントは会話間ですべてを忘れてしまいます。ai-memoryがそれを修正します。
MCP(Model Context Protocol)ツールサーバーとして実行されます — AIがネイティブに通信するバックグラウンドプロセスです。AIが重要なことを学ぶと、それを保存します。コンテキストが必要なときは、6要素スコアリングアルゴリズムでランク付けされた関連メモリを呼び出します。メモリは3つの層に存在します:
- 短期(デフォルト6時間、設定可能)— 現在のデバッグ状態などの使い捨てコンテキスト
- 中期(デフォルト7日、設定可能)— スプリント目標や最近の決定などの作業知識
- 長期(永続)— アーキテクチャ、ユーザー設定、苦労して得た教訓
アクセスされ続けるメモリは自動的に中期から長期に昇格します。各呼び出しでTTLが延長されます。使用量に応じて優先度が上がります。システムは自己キュレーション型です。
MCPに加えて、ai-memoryは完全なHTTP REST API(ポート9077で92のルート登録 / 78の一意のURLパス)と完全なCLI(--features sal OR --features sal-postgresの下の89のサブコマンド; デフォルトビルドでは87(#1389後のL2 RecoverPreviousSession(クロスセッションコンテキスト再水和用)+ #1443 Expand(ai-memory expandクエリ拡張サーフェス用)+ #1598 Reembed(ai-memory reembedベクトル空間移行サーフェス用)); SSOTはai_memory::EXPECTED_CLI_SUBCOMMANDS_{DEFAULT,SAL} +機械的なtests/cli_subcommand_count_invariant.rsパリティテストによって固定)を公開し、直接操作、スクリプト作成、および任意のAIプラットフォームやツールとの統合を可能にします。
機能
コア
- MCPツールサーバー — stdio JSON-RPC上の101ツール(フルプロファイル)、任意のMCPクライアントと互換
- 3層メモリ — 短期(デフォルト6時間TTL)、中期(デフォルト7日TTL)、長期(永続)— TTLは設定可能
- 全文検索 — ランク付き検索を備えたSQLite FTS5
- ハイブリッド呼び出し — FTS5キーワード+コサイン類似度と適応ブレンディング: セマンティック重みは0.50(短いコンテンツ)→ 0.15(長いコンテンツ)で変化します。これは、エンベッディングが長いテキストで情報を失うためです
- 6要素呼び出しスコアリング — FTS関連性+優先度+アクセス頻度+信頼度+層ブースト+新しさ減衰
- 自動昇格 — 5回以上アクセスされたメモリは中期から長期に昇格
- TTL延長 — 各呼び出しで有効期限が延長されます(短期+1時間、中期+1日)
- 優先度強化 — 10回アクセスごとに+1(最大10)
- 矛盾検出 — 既存のメモリと競合するメモリを保存するときに警告
- 重複排除 — タイトル+名前空間でアップサート、層は決してダウングレードされません
- 信頼度スコアリング — ランキングに考慮される0.0〜1.0の確実性
組織
- 名前空間 — プロジェクトごとにメモリを分離(gitリモートから自動検出)
- メモリリンク — 型付き関係: related_to、supersedes、contradicts、derived_from、reflects_on(再帰学習タスク1/8)、derives_from(WT-1-A原子化)、decomposes_into、depends_on、advances — v0.8.0で9つのバリアント
- 統合 — 複数のメモリを単一の長期サマリーにマージ
- 自動統合 — 名前空間+タグでグループ化、しきい値を超えるグループを自動マージ
- 矛盾解決 — あるメモリを別のメモリを置き換えるものとしてマークし、敗者を降格
- パターンによる忘却 — 名前空間+ FTSパターン+層による一括削除
- ソーストラッキング — 発信元を追跡: user、claude、hook、api、cli、import、consolidation、system
- エージェントアイデンティティ(NHI) — すべてのメモリは
metadata.agent_id(主張されたアイデンティティ)を保持し、更新/重複排除/インポート/同期/統合全体で多層防御の不変性を備えています。list/searchをエージェントでフィルタリング - タグ付け — フィルタサポート付きのカンマ区切りタグ
インターフェース
- 92のHTTPルート(78の一意のパス) — 127.0.0.1:9077上の完全なREST API(任意のAIまたはツールで動作)
--features salOR--features sal-postgresの下の89のCLIサブコマンド(デフォルトビルドでは87)— 同一の機能を備えた完全なCLI- フルプロファイルで101のMCPツール(7デフォルト;
Profile::full().expected_tool_count()に対して検証済み)— 任意のMCP互換AIのネイティブ統合 - インタラクティブREPLシェル — カラー出力でrecall、search、list、get、stats、namespaces、delete
- JSON出力 — すべてのCLIコマンドの
--jsonフラグ - 分散調整(v0.8.0 Pillar-1 + Pillar-2) — アクションDAG(
memory_action_*)、シングルホルダーリース(memory_lease_*)、Ed25519署名シグナル(memory_signal_*)、認定チェックポイント(memory_checkpoint_*)、パラメータ化されたルーチン(memory_routine_*)、およびGoal/Plan/Step型付き認知ライフサイクル。docs/coordination.mdを参照してください。
運用
- マルチノード同期 — データベースファイル間のプル、プッシュ、または双方向マージ
- インポート/エクスポート — メモリリンクを保持する完全なJSONラウンドトリップ
- ガベージコレクション — 30分ごとの自動バックグラウンド有効期限
- グレースフルシャットダウン — SIGTERM/SIGINTはクリーンな終了のためにWALをチェックポイントします
- ディープヘルスチェック — DBアクセシビリティとFTS5整合性を検証
- シェル補完 — bash、zsh、fish
- マニュアルページ —
ai-memory manはroffをstdoutに生成します - 時間フィルター — リストと検索の
--since/--until - 人間が読める経過時間 — CLI出力の「2h ago」、「3d ago」
- カラーCLI出力 — ANSI層ラベル(赤/黄/緑)、優先度バー、太字タイトル、シアン名前空間
品質
- 全サーフェスにわたる約10,000テスト —
src/の下の約6,712の#[test]/#[tokio::test]属性(5,759の#[test]+ 953の#[tokio::test])に加えて、tests/の下の約3,362(2,138の#[test]+ 1,224の#[tokio::test])。v0.6.4時代の約2,400テストのベースライン(1,960 lib + 211 integration + 16 mcp_integration + 4 webhook_http_parity + 16 recipe_contract + 他のバイナリターゲット全体で約150)から成長。行カバレッジは**≥92%プロジェクトバー**を上回って維持。v0.6.4の新規モジュールは100%(sizes.rs)、99.50%(profile.rs)、97.58%(cli/audit.rs)、97.05%(cli/doctor.rs)、92.56%(handlers.rs)、92.26%(cli/install.rs)。v0.6.3.xベースライン(1,809 / 93.08%および1,886 / 93.84%)はエビデンスページで凍結されたまま。v0.6.4メトリクスはリリースノートとテストハブキャンペーンにあります。経験的NHI発見受容はDiscovery Gate(T1–T4マトリックス vs. ライブxAI Grok 4.3、6/6 PASS、GATE GREEN)によって別途証明されています。 - LongMemEvalベンチマーク — ICLR 2025 LongMemEval-Sデータセットで97.0% R@5の純粋なFTS5キーワード(LLM非依存、2.2秒、232 q/s、APIコストゼロ)。現在世代のGemma 4モデルによるLLMクエリ拡張は97.2% R@5 / 99.6% R@10 / 99.8% R@20を測定(クラウドAPI会場; 歴史的な
gemma3:4b97.8%の数値は#1975あたりの見出しとして廃止)。ベンチマーク詳細を参照してください。 - MCPプロンプト —
recall-firstおよびmemory-workflowプロンプトは、AIクライアントにメモリをプロアクティブに使用するように教えます - TOONデフォルト — recall/list/search応答はデフォルトでTOONコンパクトを使用(JSONより79%小さい)
- Criterionベンチマーク — 1Kスケールでのinsert、recall、search
- GitHub Actions CI/CD — Ubuntu + macOSでのfmt、clippy、test、build、タグでのリリース
カバレッジ下限(ハードCIゲート)
Code Coverage ジョブは必須ステータスチェックです。CIはすべてのPRに対して2つの不変条件を再検証します:行カバレッジ90%以上の絶対下限(壊滅的リグレッション防止のバックストップで、現在の測定値を最も近い5%単位に切り下げた値に設定)、および.coverage-baselineに固定された値に対するラチェット(0.5%の許容ウィンドウ付き、日次執行)。カバレッジを向上させるPRは、将来のPRが新しい下限の恩恵を受けられるよう、同じコミットでベースラインファイルを更新すべきです。0.5%を超えてリグレッションするPRはマージがブロックされます。現在の測定値:93.13% 行。
トークンバジェットゲート(ハードCIゲート、v0.7 C5)
token-budget ワークフローは必須ステータスチェックです。すべてのPRに対して、cl100k_baseで測定された3つの不変条件を強制します:
- ツールごとの上限1500トークン -- 単一のMCPツールのシリアライズされたスキーマ(名前 + 説明 + inputSchema)は1500 cl100k_baseトークンを超えてはなりません。
- フルプロファイルの誠実な範囲(5K-8K) -- v0.6.4バックストップ。病的な縮小(ツールの誤削除)を検出するために維持されています。
- フルプロファイルのハード上限(v0.7 C5、D1.6/D1.7後に引き上げ) --
--profile fullの下でのトリミングされたtools/listペイロードは 11,000 cl100k_baseトークンを超えてはなりません(tests/token_budget_guard.rs内のTRIMMED_FULL_PROFILE_CEILING_TOKENS;元のC5ターゲットはD1.6以前の手書きスキーマに対する3500でした -- schemars由来のD1.6/D1.7拡張により固定上限が引き上げられました)。C2(docsフィールドの分割)、C3(繰り返されるスキーマのボイラープレートの圧縮)、C4(まれに使用されるオプションパラメータの非表示)が元の圧縮を推進しました。このゲートは、サーフェスを拡大する将来のPRに対し、他の場所でバジェットを回収することを強制します。ツールごとのコストを確認するにはai-memory doctor --tokens --raw-tableを調べてください。.github/workflows/token-budget.ymlとdocs/v0.7/schema-compaction-audit.mdを参照してください。
MLおよびLLM依存関係(セマンティックティア以上)
- candle-core、candle-nn、candle-transformers -- ネイティブRust推論のためのHugging Face Candle MLフレームワーク
- hf-hub -- Hugging Face Hubからモデルをダウンロード
- tokenizers -- テキスト前処理のためのHugging Faceトークナイザー
- instant-distance -- 近似最近傍探索
- reqwest -- LLMバックエンド通信用のHTTPクライアント(スマート/自律ティア -- #1067に基づく任意のプロバイダ:Ollama、xAI、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM、llama.cppサーバー)
アーキテクチャ
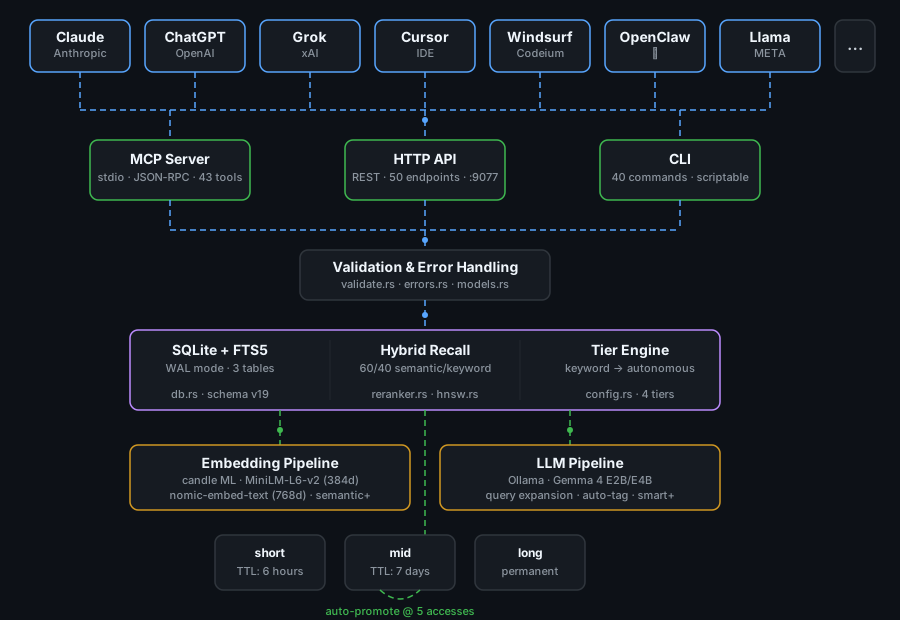
ベンチマーク
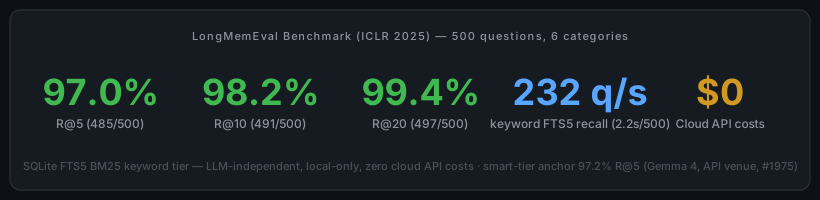
ICLR 2025 LongMemEval-S データセット(500問、6カテゴリ)で評価。純粋なFTS5キーワードティアは2.2秒で97.0% R@5を達成 -- LLM非依存、完全ローカル、クラウドAPI呼び出しゼロ、コストゼロ。LLMクエリ拡張(スマートティア)は、現行世代のGemma 4モデル(クラウドAPI環境)で97.2% R@5を測定。
ベンチマークモデルに関する注記(2026-07-10更新、#1975 裁定): 歴史的な97.8% R@5スマートティアの数値は Gemma 3 4B(依然としてコンパイル済みデフォルト拡張モデル)で測定されたものであり、見出しとして廃止されました。公開されている現行世代のアンカーは、測定された OpenRouter Gemma 4 実行です:97.2% R@5 / 99.6% R@10 / 99.8% R@20(2026-05-31、500問、拡張失敗0件)。ローカルOllamaのGemma-4数値は存在しません -- 参照ベンチマークホストはCPUのみであり、有効なフルプロトコルのローカル実行は実行不可能です(#1983 を参照);ローカルGPUでの再実行はv1.0以降も未解決のままです。キーワードティアの97.0% R@5はLLM非依存であり、影響を受けません。
| ティア | R@5 | 速度 | 依存関係 |
|---|---|---|---|
| keyword | 97.0% | 232 q/s | なし |
| semantic | 97.4% | 45 q/s | 埋め込みモデル(約100MB) |
| smart | 97.2%(Gemma 4、API環境;歴史的な gemma3:4b 97.8%) | 12 q/s | 任意のLLMバックエンド(例:ローカルOllama + Gemma;または#1067以降のxAI Grok 4.3、OpenAI gpt-5、Anthropic Claude Opus 4.7、Gemini、DeepSeekなど) |
パフォーマンスバジェット(v0.6.4)
すべてのリリースには、ホットパス操作の公開されたp95/p99バジェットと、測定されたp95がバジェットを10%超えて超過するPRを失敗させるCIゲートが同梱されています。ターゲットはM4リファレンスハードウェア用に調整されています。完全なテーブルと方法論はPERFORMANCE.mdにあります。
| 操作 | ターゲットp95 | ターゲットp99 |
|---|---|---|
memory_session_start(Claude Codeフック) | < 100 ms | < 200 ms |
memory_store(埋め込みなし) | < 20 ms | < 50 ms |
memory_search(FTS5) | < 100 ms | < 250 ms |
memory_recall(ホット、depth=1) | < 50 ms | < 150 ms |
memory_kg_query(depth ≤ 3) | < 100 ms | < 250 ms |
memory_kg_query(depth ≤ 5) | < 250 ms | < 500 ms |
memory_kg_timeline | < 100 ms | < 250 ms |
同じワークロードをローカルで実行:
ai-memory bench                      # human-readable table
ai-memory bench --json               # machine-parseable
基盤はv0.6.3.x → v0.6.4で変更なし(quiet-tools リリースはより小さなデフォルトツールサーフェスを出荷しますが、ホットパスは異なりません)。ここでのp99ターゲットは、次の専用ソークウィンドウまで情報提供用です。最新のソーク証拠はテストハブにあります。
統合方法
MCP(プライマリ -- MCP互換AIプラットフォーム向け)
MCPが推奨される統合方法です。あなたのAIは、デフォルトで7つのネイティブメモリツール(元の5つ + memory_load_family + memory_smart_load;さらに常時オンの memory_capabilities ブートストラップ)を、グルーコードなしで利用できます。他の93の呼び出し可能なツール(101のアドバタイズエントリ -- Profile::full().expected_tool_count() に対して検証され、src/mcp/registry.rs 内の const_count_matches_full_profile によって固定)は、--profile graph|admin|power|full または memory_capabilities --include-schema family=<name> によるランタイム拡張を通じて到達可能です。AIプラットフォームの設定でMCPサーバーを構成します:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp"]
    }
  }
}
HTTP API(ユニバーサル -- 任意のAIまたはツール向け)
REST APIアクセスのためにHTTPサーバーを起動します。HTTP呼び出しができる任意のAI、スクリプト、または自動化がこれを使用できます:
ai-memory serve
# 92 REST route registrations (78 unique URL paths) at http://127.0.0.1:9077/api/v1/
CLI(ユニバーサル -- スクリプトおよび直接使用向け)
CLIはスタンドアロンで動作するか、シェルコマンドを実行するAI統合のビルディングブロックとして機能します:
ai-memory store --tier long --title "Architecture decision" --content "We use PostgreSQL"
ai-memory recall "database choice"
ai-memory search "PostgreSQL"
機能ティア
ai-memoryは、起動時に ai-memory mcp --tier <tier> で選択される4つの機能ティアをサポートします。上位ティアは、ディスクとRAMのコストでML機能を追加します:
| ティア | 検索方法 | 追加機能 | おおよそのオーバーヘッド |
|---|---|---|---|
| keyword | FTS5のみ | ベースライン101エントリサーフェス -- ティアはモデル/機能をゲートし、アドバタイズされたツールサーフェスはゲートしない | 0 MB |
| semantic | FTS5 + コサイン類似度(ハイブリッド) | MiniLM-L6-v2埋め込み(384次元)、HNSWインデックス、セマンティックティア(101エントリサーフェスのサブセット) | 約256 MB |
| smart | ハイブリッド + LLMクエリ拡張 | + nomic-embed-text(768次元)+ LLMバックエンドの memory_expand_query、memory_auto_tag、memory_detect_contradiction、フル101エントリサーフェス。LLMプロバイダは AI_MEMORY_LLM_BACKEND を介してオペレーターが選択(#1067)-- ローカルOllama、xAI、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM、またはllama.cpp。 | 約1 GB(ローカルOllama)/ 約0 GB(リモートAPI) |
| autonomous | ハイブリッド + LLM拡張 + クロスエンコーダー再ランキング | + ニューラルクロスエンコーダー(ms-marco-MiniLM)、メモリリフレクション、フル101エントリサーフェス。スマートティアと同じLLMプロバイダの自由。 | 約4 GB(ローカルOllama)/ 約3 GB(リモートLLM、ローカルクロスエンコーダーのみ) |
機能マトリックス
すべての機能が最小ティアにマッピングされています。各ティアには、下位ティアのすべての機能が含まれます。
| 機能 | keyword | semantic | smart | autonomous |
|---|---|---|---|---|
| 検索とリコール | ||||
| FTS5キーワード検索 | はい | はい | はい | はい |
| セマンティック埋め込み(コサイン類似度) | -- | はい | はい | はい |
| ハイブリッドリコール(FTS5 + コサイン、コンテンツ長による適応的0.50→0.15セマンティック重み) | -- | はい | はい | はい |
| HNSW最近傍インデックス | -- | はい | はい | はい |
LLMクエリ拡張(memory_expand_query) | -- | -- | はい | はい |
| ニューラルクロスエンコーダー再ランキング | -- | -- | -- | はい |
| メモリ管理 | ||||
| 保存、更新、削除、昇格、リンク | はい | はい | はい | はい |
| 手動統合 | はい | はい | はい | はい |
| 自動統合(LLM要約) | -- | -- | はい | はい |
自動タグ付け(memory_auto_tag) | -- | -- | はい | はい |
矛盾検出(memory_detect_contradiction) | -- | -- | はい | はい |
| 自律メモリリフレクション | -- | -- | -- | はい |
| モデル | ||||
| 埋め込みモデル | -- | MiniLM-L6-v2(384d) | nomic-embed-text(768d) | nomic-embed-text(768d) |
| 埋め込みバックエンドオーバーライド(#1598) | -- | 任意:ローカルOllama、APIベンダーエイリアス、またはセルフホストのOpenAI互換([embeddings].backend / AI_MEMORY_EMBED_*) | 同じ | 同じ |
| LLM | -- | -- | オペレーター選択(#1067)-- デフォルトはローカルの gemma3:4b;リモートエンドポイントはローカルフットプリントなし | オペレーター選択(#1067)-- デフォルトはローカルの gemma3:4b;リモートエンドポイントはローカルフットプリントなし |
| リソース | ||||
| RAM | 0 MB | 約256 MB | 約1 GB | 約4 GB |
| 外部依存関係 | なし | なし | LLMバックエンド(Ollama / xAI / OpenAI / Anthropic / Gemini / DeepSeek / Kimi / Qwen / Mistral / Groq / Together / Cerebras / OpenRouter / Fireworks / LMStudio / vLLM / llama.cpp -- #1067) | LLMバックエンド(スマートと同じ選択肢) |
公開されるMCPツール(--profile full 時)1 | 101 | 101 | 101 | 101 |
セマンティックティア(デフォルト)はCandle MLフレームワークをバンドルし、初回実行時にall-MiniLM-L6-v2モデル(約90 MB)をダウンロードします。スマートおよび自律ティアはLLMバックエンドを必要とします -- #1067(v0.7.0)以降、それはローカル(Ollama、LMStudio、vLLM、llama.cppサーバー)または任意のOpenAI互換リモートエンドポイント(xAI、OpenAI、OpenAIシムを介したAnthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks)にできます。選択は AI_MEMORY_LLM_BACKEND 環境変数によって行われます。ベンダーごとのAPIキーは XAI_API_KEY / OPENAI_API_KEY / ANTHROPIC_API_KEY / GEMINI_API_KEY / DEEPSEEK_API_KEY / MOONSHOT_API_KEY / DASHSCOPE_API_KEY / など、または標準の AI_MEMORY_LLM_API_KEY を介して提供されます。
ティアは機能をゲートし、モデルはゲートしません -- そして#1067(v0.7.0)以降、ティアはベンダーもゲートしません。 --tier フラグは、どのツールが公開されるかを制御します。LLMバックエンドとモデルは、AI_MEMORY_LLM_BACKEND + AI_MEMORY_LLM_MODEL 環境変数(または ~/.config/ai-memory/config.toml 内の標準の [llm] セクション -- v0.7.xエンタープライズスキーマと移行ツールについてはdocs/CONFIG_SCHEMA.mdを参照)を介して独立して設定可能です。たとえば、自律ティア(フル101エントリサーフェス + 再ランカー)をOpenAI互換エイリアスを介してxAI Grok 4に対して実行します:
# Quick path: env vars
export AI_MEMORY_LLM_BACKEND=xai
export AI_MEMORY_LLM_MODEL=grok-4.3
export XAI_API_KEY=xai-…   # or AI_MEMORY_LLM_API_KEY
ai-memory mcp --tier autonomous
# Enterprise path: ~/.config/ai-memory/config.toml (v0.7.x schema v2, #1146)
schema_version = 2
tier = "autonomous"

[llm]
backend     = "xai"
model       = "grok-4.3"
base_url    = "https://api.x.ai/v1"
api_key_env = "XAI_API_KEY"          # mutually exclusive with api_key_file;
                                     # inline `api_key = "..."` is REJECTED.
# Legacy v0.6.x shape — still works, deprecation WARN at load; run
# `ai-memory config migrate` to upgrade in place.
tier = "autonomous"
llm_model = "gemma3:4b"   # default Ollama model at v0.7.0
--tier フラグはMCP引数で渡す必要があります -- サーバーがAIクライアントによって起動される場合、config.toml ティア設定は使用されません。
# Semantic is the default tier
ai-memory mcp

# Keyword -- FTS5 only, no models
ai-memory mcp --tier keyword

# Semantic -- hybrid recall with embeddings (explicit)
ai-memory mcp --tier semantic

# Smart -- adds LLM-powered query expansion, auto-tagging, contradiction detection
ai-memory mcp --tier smart

# Autonomous -- adds cross-encoder reranking
ai-memory mcp --tier autonomous
memory_capabilities ツールは、実行時にアクティブなティア、ロードされたモデル、および利用可能な機能を報告します。
MCPツール
これらの101ツール(フルプロファイル;src/profile.rs 内の Profile::full().expected_tool_count() による標準数)は、MCPサーバーとして構成された場合、任意のMCP互換AIが利用できます(v0.6.4で固定された証拠ページには63ツールのベースラインがリストされています。以下のテーブルは、ほとんどのクライアントが日常的に使用するコアサブセットを文書化しています):
| ツール | 説明 |
|---|---|
memory_store | 新しいメモリを保存(タイトル+名前空間で重複排除、矛盾を報告) |
memory_recall | コンテキストに関連するメモリを想起(ファジーOR検索、6つの要素でランク付け) |
memory_search | 正確なキーワード一致でメモリを検索(ANDセマンティクス) |
memory_list | オプションのフィルタ(名前空間、階層、タグ、日付範囲)でメモリを一覧表示 |
memory_get | IDで特定のメモリとそのリンクを取得 |
memory_update | IDで既存のメモリを更新(部分更新) |
memory_delete | IDでメモリを削除 |
memory_promote | メモリを長期(永続、有効期限クリア)に昇格 |
memory_forget | パターン、名前空間、または階層で一括削除 |
memory_link | 2つのメモリ間に型付きリンクを作成 |
memory_get_links | メモリのすべてのリンクを取得 |
memory_consolidate | 複数のメモリを1つの長期サマリーに統合 |
memory_stats | メモリストアの統計を取得 |
memory_capabilities | アクティブな機能階層、ロードされたモデル、利用可能な機能を報告 |
memory_expand_query | LLMを使用して検索クエリを関連用語に拡張(smart+階層) |
memory_auto_tag | LLMを使用してメモリのタグを自動生成(smart+階層) |
memory_detect_contradiction | LLMを使用して2つのメモリが矛盾するか確認(smart+階層) |
memory_archive_list | アーカイブされたメモリを一覧表示(オプションの名前空間/階層/タグフィルタ付き) |
memory_archive_restore | アーカイブされたメモリをアクティブストアに復元 |
memory_archive_purge | フィルタに一致するアーカイブされたメモリを完全に削除 |
memory_archive_stats | アーカイブ統計を取得(階層、名前空間、経過日数ごとのカウント) |
HTTP API
127.0.0.1:9077 上に92のルート登録 / 78の一意なURLパス。ai-memory serve から始まります。以下の表は最も一般的に使用されるRESTエンドポイントを示しています。完全なサーフェス(ガバナンス、フェデレーション、サブスクリプション、ナレッジグラフ、クォータ、承認SSE)については docs/API_REFERENCE.md を参照してください。
セキュリティ: HTTPサーバーは127.0.0.1にバインドされ、デフォルトでは認証が設定されておらず、CORSも寛容です。
config.tomlでapi_keyを設定して、すべてのリクエストでx-api-keyヘッダーを必須にしてください(レガシーな?api_key=クエリパラメータ形式はv0.7.0で非推奨 — #1574)。また、AI_MEMORY_REQUIRE_API_KEY=1を設定して、キーなしの起動を厳格に拒否してください(#1458)。認証なしでネットワークに公開しないでください(また、--tls-cert/--tls-keyまたはリバースプロキシを介したTLSを推奨します)。
| メソッド | エンドポイント | 説明 |
|---|---|---|
| GET | /api/v1/health | ヘルスチェック(DB + FTS5の整合性を検証) |
| GET | /api/v1/memories | メモリの一覧表示(名前空間、階層、タグ、since、until、limitをサポート) |
| POST | /api/v1/memories | メモリを作成 |
| POST | /api/v1/memories/bulk | メモリを一括作成(制限付き) |
| GET | /api/v1/memories/{id} | IDでメモリを取得 |
| PUT | /api/v1/memories/{id} | IDでメモリを更新 |
| DELETE | /api/v1/memories/{id} | IDでメモリを削除 |
| POST | /api/v1/memories/{id}/promote | メモリを長期に昇格 |
| GET | /api/v1/search | ANDキーワード検索 |
| GET | /api/v1/recall | コンテキストによる想起(クエリパラメータ付きGET) |
| POST | /api/v1/recall | コンテキストによる想起(JSONボディ付きPOST) |
| POST | /api/v1/forget | パターン/名前空間/階層で一括削除 |
| POST | /api/v1/consolidate | メモリを1つに統合 |
| POST | /api/v1/links | メモリ間にリンクを作成 |
| GET | /api/v1/links/{id} | メモリのリンクを取得 |
| GET | /api/v1/namespaces | すべての名前空間を一覧表示 |
| GET | /api/v1/stats | メモリストアの統計 |
| POST | /api/v1/gc | ガベージコレクションをトリガー |
| GET | /api/v1/export | すべてのメモリ+リンクをJSONとしてエクスポート |
| POST | /api/v1/import | JSONからメモリ+リンクをインポート |
| GET | /api/v1/archive | アーカイブされたメモリを一覧表示(オプションのフィルタ付き) |
| POST | /api/v1/archive/{id}/restore | アーカイブされたメモリをアクティブストアに復元 |
| DELETE | /api/v1/archive | フィルタに一致するアーカイブされたメモリをパージ |
| GET | /api/v1/archive/stats | アーカイブ統計(階層、名前空間、経過日数ごとのカウント) |
CLIコマンド
--features sal または --features sal-postgres の下に89のトップレベルサブコマンド(デフォルトビルドでは87。2つのバリアントの差は Migrate + SchemaInit で、両方とも src/daemon_runtime.rs::Command::{Migrate,SchemaInit} ごとに #[cfg(feature = "sal")] でゲートされています。v0.6.4では40でした)。任意のコマンドの詳細は ai-memory <command> --help を、完全なリストは ai-memory --help を実行してください。
| コマンド | 説明 |
|---|---|
mcp | stdio経由でMCPツールサーバーとして実行(主要な統合パス) |
serve | ポート9077でHTTPデーモンを起動 |
store | 新しいメモリを保存(タイトル+名前空間で重複排除) |
update | IDで既存のメモリを更新 |
recall | ランク付けされた結果+自動タッチ付きファジーOR検索(ハイブリッド想起用に --tier をサポート)。パイプラインはリクエストごとに結果を50に制限します。 |
search | 正確なキーワード一致のためのAND検索。 |
get | IDで単一のメモリを取得(リンクを含む) |
list | フィルタ(名前空間、階層、タグ、日付範囲)でメモリを閲覧。リクエストごとに1000アイテムに制限(LIST_MAX_LIMIT; HTTPリスト/一括はさらに AI_MEMORY_MAX_PAGE_SIZE を尊重)。 |
delete | IDでメモリを削除 |
promote | メモリを長期に昇格(有効期限をクリア) |
forget | パターン+名前空間+階層で一括削除 |
link | 2つのメモリをリンク(related_to、supersedes、contradicts、derived_from) |
consolidate | 複数のメモリを1つの長期サマリーに統合 |
resolve | 矛盾を解決:勝者をマーク、敗者を降格 |
shell | カラー出力付きインタラクティブREPL |
sync | 2つのデータベースファイル間でメモリを同期(pull/push/merge) |
auto-consolidate | 名前空間+タグでメモリをグループ化、しきい値を超えるグループを統合 |
gc | 期限切れメモリでガベージコレクションを実行 |
stats | メモリ状態の概要(カウント、階層、名前空間、リンク、DBサイズ) |
namespaces | メモリカウント付きで全名前空間を一覧表示 |
export | すべてのメモリとリンクをJSONとしてエクスポート |
import | JSONからメモリとリンクをインポート(stdin) |
completions | シェル補完を生成(bash、zsh、fish) |
man | roff manページをstdoutに生成 |
mine | 過去の会話(Claude、ChatGPT、Slackエクスポート)からメモリをインポート |
archive | メモリアーカイブを管理(一覧表示、復元、パージ、統計) |
トップレベルの ai-memory バイナリはグローバルフラグも受け入れます:
| フラグ | 説明 |
|---|---|
--db <path> | データベースパス(デフォルト: ai-memory.db、または $AI_MEMORY_DB) |
--json | すべてのコマンドでJSON出力(機械解析可能な出力) |
store サブコマンドは追加のフラグを受け入れます:
| フラグ | 説明 |
|---|---|
--source / -S | このメモリを作成した人(user、nhi、hook、api、cli、import、consolidation、system)。デフォルト: cli。後方互換性のため "claude" も受け入れられます(src/validate.rs::VALID_SOURCES による) |
--expires-at | RFC3339有効期限タイムスタンプ |
--ttl-secs | 秒単位のTTL(--expires-at の代替) |
mcp サブコマンドは追加のフラグを受け入れます:
| フラグ | 説明 |
|---|---|
--tier <keyword|semantic|smart|autonomous> | 機能階層(デフォルト: semantic)。機能階層 を参照。 |
想起スコアリング
すべての想起クエリは6つの要素でメモリをランク付けします:
score = (fts_relevance * -1)
      + (priority * 0.5)
      + (MIN(access_count, 50) * 0.1)
      + (confidence * 2.0)
      + tier_boost
      + recency_decay
| 要素 | 重み | 備考 |
|---|---|---|
| FTS関連性 | -1.0x | SQLite FTS5ランク(負 = より良い一致) |
| 優先度 | 0.5x | ユーザー割り当ての1-10スケール |
| アクセス数 | 0.1x | 想起された頻度(スコアリングでは50で上限) |
| 信頼度 | 2.0x | 0.0-1.0の確実性スコア |
| 階層ブースト | +3.0 / +1.0 / +0.0 | 長期 / 中期 / 短期 |
| 経過減衰 | 1/(1 + days*0.1) | 最近のメモリほど高くランク付け |
メモリ階層
| 階層 | TTL | ユースケース | 例 |
|---|---|---|---|
short | 6時間(設定可能) | 使い捨てコンテキスト | 現在のデバッグ状態、一時変数、エラートレース |
mid | 7日(設定可能) | 作業知識 | スプリント目標、最近の決定、現在のブランチの目的 |
long | 永続 | 苦労して得た知識 | アーキテクチャ、ユーザー設定、修正、規約 |
自動動作
- 想起時のTTL延長: 短期メモリは+1時間、中期メモリは+1日
- 自動昇格: 5回以上アクセスされた中期メモリは長期に昇格(有効期限クリア)
- 優先度強化: 10回アクセスごとに優先度が1増加(10で上限)
- 矛盾検出: 新しいメモリが同じ名前空間の既存メモリと競合する場合に警告
- 重複排除: タイトル+名前空間でアップサート。更新時に階層がダウングレードされることはありません
設定可能なTTL
デフォルトのTTL(短期6時間、中期7日)は ~/.config/ai-memory/config.toml の [ttl] セクションで上書きできます:
[ttl]
short_ttl_secs = 21600      # short-tier TTL in seconds (default: 21600 = 6 hours)
mid_ttl_secs = 604800        # mid-tier TTL in seconds (default: 604800 = 7 days)
long_ttl_secs = 0            # long-tier TTL in seconds (default: 0 = never expires)
short_extend_secs = 3600     # TTL extension on recall for short-tier memories in seconds (default: 3600 = +1h)
mid_extend_secs = 86400      # TTL extension on recall for mid-tier memories in seconds (default: 86400 = +1d)
5つのフィールドはすべてオプションです — 省略するとデフォルトが維持されます。任意の値を0に設定すると、その階層の有効期限が無効になります。値は10年最大にクランプされ、負の延長値は0にクランプされます。
注: 設定はプロセスの起動時に一度だけ読み込まれます。
config.tomlへの変更は、ai-memoryプロセス(MCPサーバー、HTTPデーモン、またはCLI)の再起動が必要です。
アーカイブ
ガベージコレクションがメモリを期限切れにするとき、完全に削除する代わりにアーカイブできます。アーカイブされたメモリは別のストアに移動され、後で閲覧、復元、またはパージできます。
設定
~/.config/ai-memory/config.toml でアーカイブを有効にします:
archive_on_gc = true # archive expired memories instead of deleting them (default: true)
CLIコマンド
archive サブコマンドがアーカイブを管理します:
ai-memory archive list                          # list archived memories
ai-memory archive list --namespace my-project   # filter by namespace
ai-memory archive restore <id>                  # restore an archived memory to active store
ai-memory archive purge --older-than-days 90     # permanently delete archives older than 90 days
ai-memory archive stats                         # show archive statistics
注: 復元されたメモリは
expires_atがクリアされます(次のTTL割り当てまで永続になります)。
MCPツール
MCPクライアントには4つのアーカイブツールが利用可能です:
| ツール | 説明 |
|---|---|
memory_archive_list | アーカイブされたメモリを一覧表示(オプションの名前空間/階層/タグフィルタ付き) |
memory_archive_restore | アーカイブされたメモリをアクティブストアに復元 |
memory_archive_purge | フィルタに一致するアーカイブされたメモリを完全に削除 |
memory_archive_stats | アーカイブ統計を取得(階層、名前空間、経過日数ごとのカウント) |
HTTPエンドポイント
| メソッド | エンドポイント | 説明 |
|---|---|---|
| GET | /api/v1/archive | アーカイブされたメモリを一覧表示(オプションのフィルタ付き) |
| POST | /api/v1/archive/{id}/restore | アーカイブされたメモリをアクティブストアに復元 |
| DELETE | /api/v1/archive | フィルタに一致するアーカイブされたメモリをパージ |
| GET | /api/v1/archive/stats | アーカイブ統計(階層、名前空間、経過日数ごとのカウント) |
セキュリティ
ai-memoryはすべての入力パスにわたって堅牢化を含みます:
- トランザクション安全性 -- すべての複数ステップのデータベース操作はトランザクションを使用し、失敗時に部分的な書き込みが発生しません
- FTSインジェクション防止 -- ユーザー入力はFTS5クエリに到達する前にサニタイズされ、特殊文字はエスケープされます
- エラーのサニタイズ -- 内部データベースパスとシステム詳細はエラーレスポンスから除去され、クライアントには構造化されたエラータイプ(NOT_FOUND、VALIDATION_FAILED、DATABASE_ERROR、CONFLICT)が表示されます
- ボディサイズ制限 -- HTTPリクエストボディはAxumのDefaultBodyLimitにより50 MBに制限されています
- 一括操作の制限 -- 一括作成エンドポイントはリソース枯渇を防ぐために最大バッチサイズを強制します
- CORS -- localhost開発ワークフロー向けに寛容なCORSレイヤーが有効化されています
- 入力検証 -- すべての書き込みパスで、タイトル長、コンテンツ長、名前空間形式、ソース値、優先度範囲(1〜10)、信頼度範囲(0.0〜1.0)、タグ形式、ティア値、リレーションタイプ、ID形式を検証します
- 同期時のリンク検証 -- 同期操作中のインポート前に、すべてのリンク(両方のID、リレーションタイプ、自己リンクなし)が検証されます
- スレッドセーフな色 -- ターミナル色の検出には
AtomicBoolを使用し、安全な並行アクセスを実現します - ローカルのみのHTTP -- HTTPサーバーはデフォルトで127.0.0.1にバインドされ、ネットワークには公開されません
- WALモード -- SQLiteのWrite-Ahead Loggingにより、書き込み中の安全な並行読み取りを実現します
ドキュメント
| ガイド | 対象読者 |
|---|---|
| Changelog v0.9.0 | 現在のリリース(secure-default hardening) — ストアパスエージェントアテステーションがデフォルトで必須(#1751)、デュアルMCP+HTTPフック強制ゲート(#1885/#1924)、スキーマv78 |
| リリースノート v0.8.0 | 以前のリリース(distributed-coordination) — 調整基盤、型付き認知、フェデレーションの堅牢化、ガバナンスの強制、スキーマv58→v70 |
| 調整ツールリファレンス | v0.8.0のアクション/リース/シグナル/チェックポイント/ルーチンのプリミティブ(memory_action_* / _lease_* / _signal_* / _checkpoint_* / _routine_*) |
| 移行ガイド v0.7 | v0.6.xからのアップグレード(attested-cortex、フック、トランスクリプト、AGE、権限、G1継承修正をカバー) |
| v0.7の新機能 | attested-cortex基盤のビジュアルウォークスルー |
attested-cortex RFC | 4つのv0.7アーキテクチャ決定の設計根拠 |
| v0.7互換性マトリックス | 機能ごとのデフォルト対オプトインのマトリックス |
| インストールガイド | 実行方法(複数のAIプラットフォーム向けのMCPセットアップを含む) |
| ユーザーガイド | 永続メモリを必要とするAIアシスタントユーザー向け |
| 開発者ガイド | ai-memory上での構築または貢献を目的とする開発者向け |
| 管理者ガイド | デプロイ、監視、トラブルシューティング向け |
| エンジニアリング標準 | コード、テスト、セキュリティ、リリース標準(権威版) |
| AI開発者ワークフロー | このリポジトリに貢献するAIコーディングエージェント向けのステップバイステップワークフロー |
| AI開発者ガバナンス標準 | AI参加のポリシー:権限、帰属、レビュー、監査 |
| GitHub Pages | アニメーション図付きのビジュアル概要 |
ライセンス
Copyright 2026 AlphaOne LLC.
Apache License, Version 2.0(「ライセンス」)に基づきライセンスされています。 このファイルは、ライセンスに準拠する場合を除き、使用することはできません。 ライセンスのコピーは以下から入手できます。
適用法令で要求される場合または書面による合意がない限り、ライセンスに基づいて配布されるソフトウェアは、明示的または黙示的を問わず、いかなる保証も条件もなしに「現状のまま」配布されます。 ライセンスに基づく権限と制限を規定する具体的な言語については、ライセンスを参照してください。
Footnotes
-
MCP ツールサーフェスはリコールティアとは直交しています -- すべてのティアは
--profile fullで同じ101ツールを見ます(デフォルトの--profile coreはティアに関係なく起動時に8つをアドバタイズします -- 7つのCoreファミリーツールと常時オンのmemory_capabilitiesブートストラップ;他の93はオンデマンドでロードされます)。ティアがゲートするのはモデル(エンベッダー、クロスエンコーダー、LLM)と機能動作(コサイン類似度、LLM拡張、再ランキング)であり、アドバタイズされたツール数ではありません。src/mcp/registry.rs内のProfile::full().expected_tool_count()+const_count_matches_full_profileによって固定されています。 ↩