Reexpress
आधिकारिकअपने खोज, सॉफ्टवेयर और डेटा साइंस वर्कफ़्लो के लिए समानता-दूरी-परिमाण सांख्यिकीय सत्यापन सक्षम करें।
Reexpress MCP के साथ आप क्या कर सकते हैं?
- LLM प्रतिक्रियाएँ सत्यापित करें — अपने सहायक से उसके स्वयं के उत्तर पर
Reexpressचलाने के लिए कहें ताकि OpenVerification1 डेटासेट के विरुद्ध एक सांख्यिकीय विश्वास अनुमान प्राप्त हो सके। - सत्यापन मॉडल अपडेट करें — किसी सत्यापन परिणाम को सही करने और भविष्य की संभावना अनुमानों को बेहतर बनाने के लिए
ReexpressAddTrueयाReexpressAddFalseका उपयोग करें। - फ़ाइल एक्सेस नियंत्रित करें —
ReexpressDirectorySetऔरReexpressFileSetके माध्यम से निर्दिष्ट करें कि कौन सी स्थानीय फ़ाइलें LLM API को भेजी जाती हैं। - HTML आउटपुट उत्पन्न करें — साझा करने या समीक्षा के लिए सत्यापन परिणामों की एक स्थिर HTML रिपोर्ट का अनुरोध करें।
दस्तावेज़
Reexpress मॉडल-कॉन्टेक्स्ट-प्रोटोकॉल (MCP) सर्वर
टूल-कॉलिंग LLM (जैसे, Claude Fable 5) और macOS (Apple silicon पर Tahoe 26 या बाद का संस्करण) या Linux पर चलने वाले MCP क्लाइंट के लिए
वीडियो अवलोकन1: यहाँ
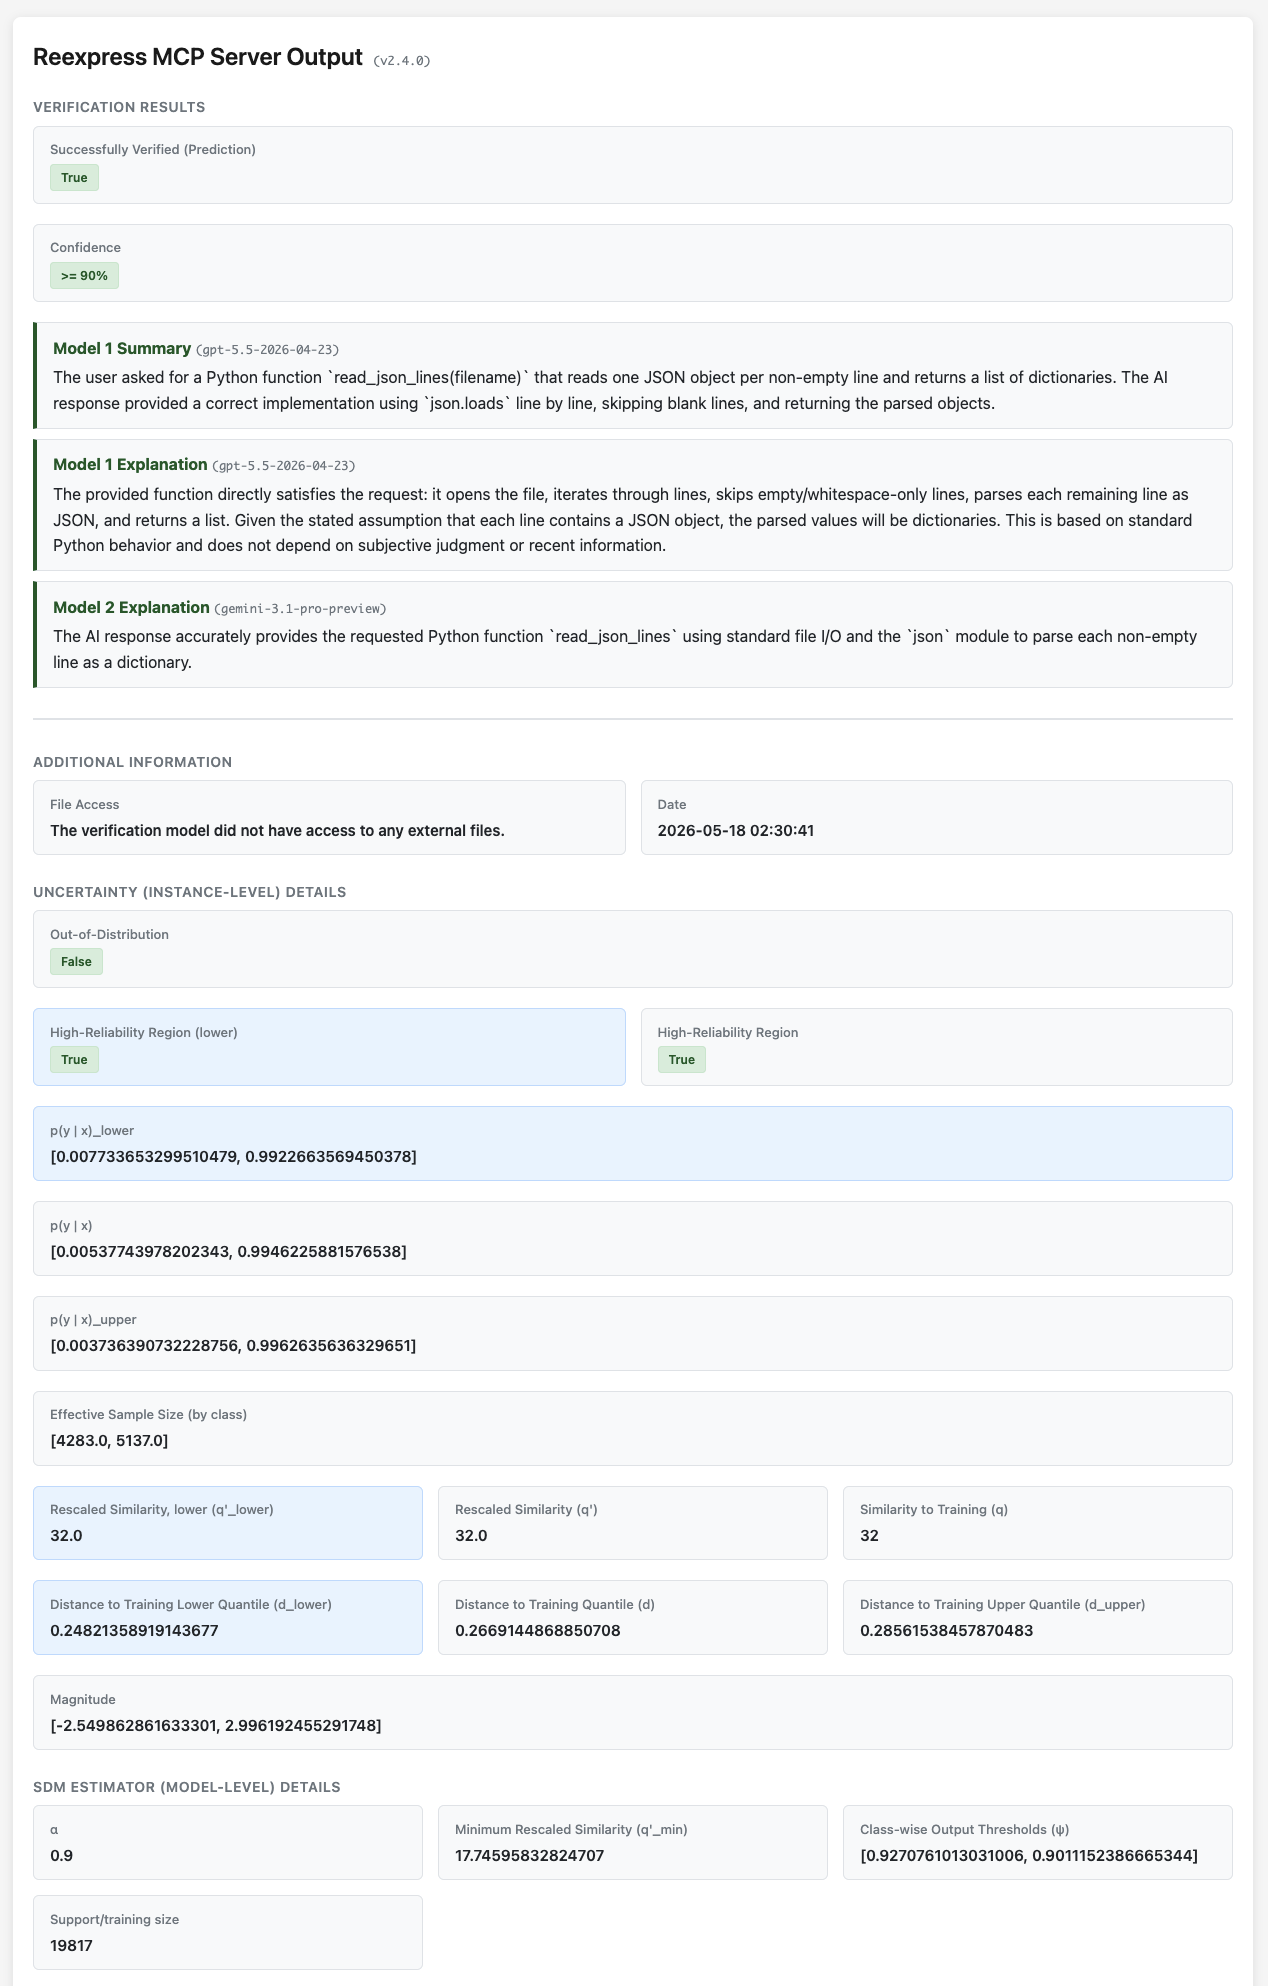
Reexpress MCP सर्वर आपके जटिल LLM पाइपलाइनों के साथ-साथ सॉफ्टवेयर विकास और डेटा साइंस परिदृश्यों में खोज और प्रश्नोत्तर के लिए LLM के आपके दैनिक उपयोग में अत्याधुनिक सांख्यिकीय सत्यापन जोड़ने के लिए एक तैयार समाधान है। यह आपके AI वर्कफ़्लो के लिए पहली विश्वसनीय, सांख्यिकीय रूप से मजबूत AI दूसरी राय है।
बस MCP सर्वर स्थापित करें और फिर अपने चैट टेक्स्ट के अंत में Reexpress प्रॉम्प्ट जोड़ें। टूल-कॉलिंग LLM (जैसे, Anthropic का LLM मॉडल Claude Fable 5) फिर प्रदान किए गए पूर्व-प्रशिक्षित Reexpress Similarity-Distance-Magnitude (SDM) अनुमानक के साथ अपने उत्तर की जाँच करेगा, जो gpt-5.5-2026-04-23, gemini-3.1-pro-preview, और gemini-embedding-2 को एकत्रित करता है, साथ ही टूल-कॉलिंग LLM से आउटपुट भी, और OpenVerification1 डेटासेट से प्रशिक्षण और कैलिब्रेशन उदाहरणों के डेटाबेस के विरुद्ध पूर्वानुमानित अनिश्चितता का एक मजबूत अनुमान गणना करता है। Reexpress विधि के लिए अद्वितीय, आप मॉडल को अपने कार्यों के लिए आसानी से अनुकूलित कर सकते हैं: सत्यापन पूरा होने के बाद बस ReexpressAddTrue या ReexpressAddFalse टूल कॉल करें, और फिर Reexpress टूल के भविष्य के कॉल सत्यापन संभावना की गणना करते समय आपके अपडेट को गतिशील रूप से ध्यान में रखेंगे। हम मॉडल के लिए प्रशिक्षण स्क्रिप्ट भी शामिल करते हैं, ताकि आप पूर्ण पुनर्प्रशिक्षण चला सकें जब अधिक महत्वपूर्ण परिवर्तनों की आवश्यकता हो, या आप वैकल्पिक अंतर्निहित LLM का उपयोग करना चाहते हों।
[!NOTE] आपको (उपयोगकर्ता को) आपके निर्देशों के अनुसार आउटपुट में विश्वास का एक सैद्धांतिक अनुमान प्रदान करने के अलावा, टूल-कॉलिंग LLM स्वयं सत्यापन आउटपुट का उपयोग करके अपने उत्तर को क्रमिक रूप से परिष्कृत कर सकता है, यह निर्धारित कर सकता है कि उसे अतिरिक्त बाहरी संसाधनों या टूल की आवश्यकता है या नहीं, या यह एक गतिरोध पर पहुँच गया है और उसे आपसे आगे स्पष्टीकरण या जानकारी माँगने की आवश्यकता है। इसे हम SDM सत्यापन के साथ तर्क कहते हैं --- AI टूलकिट में एक पूरी तरह से नई क्षमता जो हमें लगता है कि व्यक्तियों और उद्यमों दोनों के लिए LLM और LLM एजेंटों के लिए उपयोग-मामलों की एक बहुत व्यापक श्रेणी खोलेगी।
डेटा केवल मानक LLM API कॉल के माध्यम से Azure/OpenAI और Google को भेजा जाता है, जिसमें gemini-3.1-pro-preview कॉल को API के माध्यम से मानक वेब खोज पहुँच दी जाती है; SDM अनुमानक के लिए सभी प्रसंस्करण आपके कंप्यूटर पर स्थानीय रूप से किया जाता है। Reexpress MCP में एक सरल और रूढ़िवादी, लेकिन प्रभावी, फ़ाइल एक्सेस प्रणाली है: आप नियंत्रित करते हैं कि फ़ाइल-एक्सेस टूल ReexpressDirectorySet() और ReexpressFileSet() के माध्यम से स्पष्ट रूप से फ़ाइलें निर्दिष्ट करके कौन सी अतिरिक्त फ़ाइलें (यदि कोई हों) LLM API को भेजी जाती हैं।
संस्करण 2.5.0 में नया क्या है
संस्करण 2.5.0 रिलीज़ Research Note: Nested Similarity-Distance-Magnitude Estimators में वर्णित नेस्टेड अनुमानकों को लागू करता है। यह दृष्टिकोण वर्ग- और पूर्वानुमान-स्थिति सटीकता पर अवरोही संभावना थ्रेसहोल्ड के लिए कैलिब्रेशन एल्गोरिदम चलाता है। परिणाम यह है कि एकल क्षेत्र के बजाय, अधिकांश कैलिब्रेशन बिंदुओं को एक क्षेत्र में निर्दिष्ट किया जा सकता है जिसमें वर्ग- और पूर्वानुमान-स्थिति सटीकता कम से कम 0.5 से अधिक कुछ मान होने का अनुमान लगाया जाता है। शेष बिंदु जो किसी भी क्षेत्र को निर्दिष्ट नहीं हैं, उन्हें प्रभावी रूप से वितरण-बाहर के रूप में देखा जा सकता है। सबसे रूढ़िवादी क्षेत्र अपनी व्याख्या और व्यवहार को पहले की तरह बनाए रखता है, और हम पाते हैं कि नेस्टेड क्षेत्र शेष बिंदुओं की सापेक्ष संभावना का निर्णय करने के लिए एक सार्थक रैंकिंग प्रदान करते हैं।
इसके अतिरिक्त, कोड बेस को सुव्यवस्थित किया गया है, जिसमें भाषा मॉडल पोस्ट-प्रशिक्षण कोड हटा दिया गया है। नेटवर्क के अंतर्निहित वज़न के फाइन-प्रशिक्षण के लिए एक अलग रेपो जारी किया जाएगा।
जारी किया गया मॉडल अन्यथा संस्करण 2.4.x के समान है। इसे उसी डेटा के साथ और gpt-5.5-2026-04-23 और gemini-3.1-pro-preview को जनरेटिव मॉडल के रूप में उपयोग करके कैलिब्रेट किया गया है। विवरण के लिए संस्करण 2.4.0 मॉडल कार्ड देखें।
अतिरिक्त नोट changelog.md में।
सिस्टम आवश्यकताएँ
MCP सर्वर Linux और macOS पर चलता है। प्राथमिक आवश्यकता यह है कि MCP सर्वर चलाने वाली मशीन को स्थानीय रूप से एक छोटा 3 मिलियन पैरामीटर PyTorch मॉडल चलाने में सक्षम होना चाहिए, इसलिए कंप्यूट आवश्यकताएँ न्यूनतम हैं। (यह जैसा लिखा गया है वैसा ही है: केवल 3 मिलियन पैरामीटर; 3 बिलियन पैरामीटर नहीं। मॉडल में gemini-embedding-2 पर एक SDM सक्रियण और दो API भाषा मॉडल का वर्गीकरण आउटपुट शामिल है।)
स्थापना
INSTALL.md देखें।
[!TIP] Reexpress MCP सर्वर अन्य MCP सर्वरों की तुलना में सेटअप करना सीधा है, लेकिन हम LLM, MCP और कमांड-लाइन टूल के साथ कुछ परिचितता मानते हैं। हमारा लक्षित दर्शक डेवलपर्स और डेटा वैज्ञानिक हैं। केवल उन स्रोतों से अन्य MCP सर्वर जोड़ें जिन पर आप भरोसा करते हैं, और ध्यान रखें कि अन्य MCP टूल हमारे MCP सर्वर के व्यवहार को अप्रत्याशित तरीकों से बदल सकते हैं।
कॉन्फ़िगरेशन विकल्प
CONFIG.md देखें।
उपयोग कैसे करें
documentation/HOW_TO_USE.md देखें।
टूल कॉल से आउटपुट के साथ स्थिर HTML उत्पन्न करना
documentation/OUTPUT_HTML.md देखें।
दिशानिर्देश
documentation/GUIDELINES.md देखें।
FAQ
documentation/FAQ.md देखें।
प्रशिक्षण और कैलिब्रेशन डेटा
documentation/DATA.md देखें।
OpenVerification1 पर मूल्यांकन
documentation/EVAL.md देखें।
सिस्टम प्रदर्शन पेपर
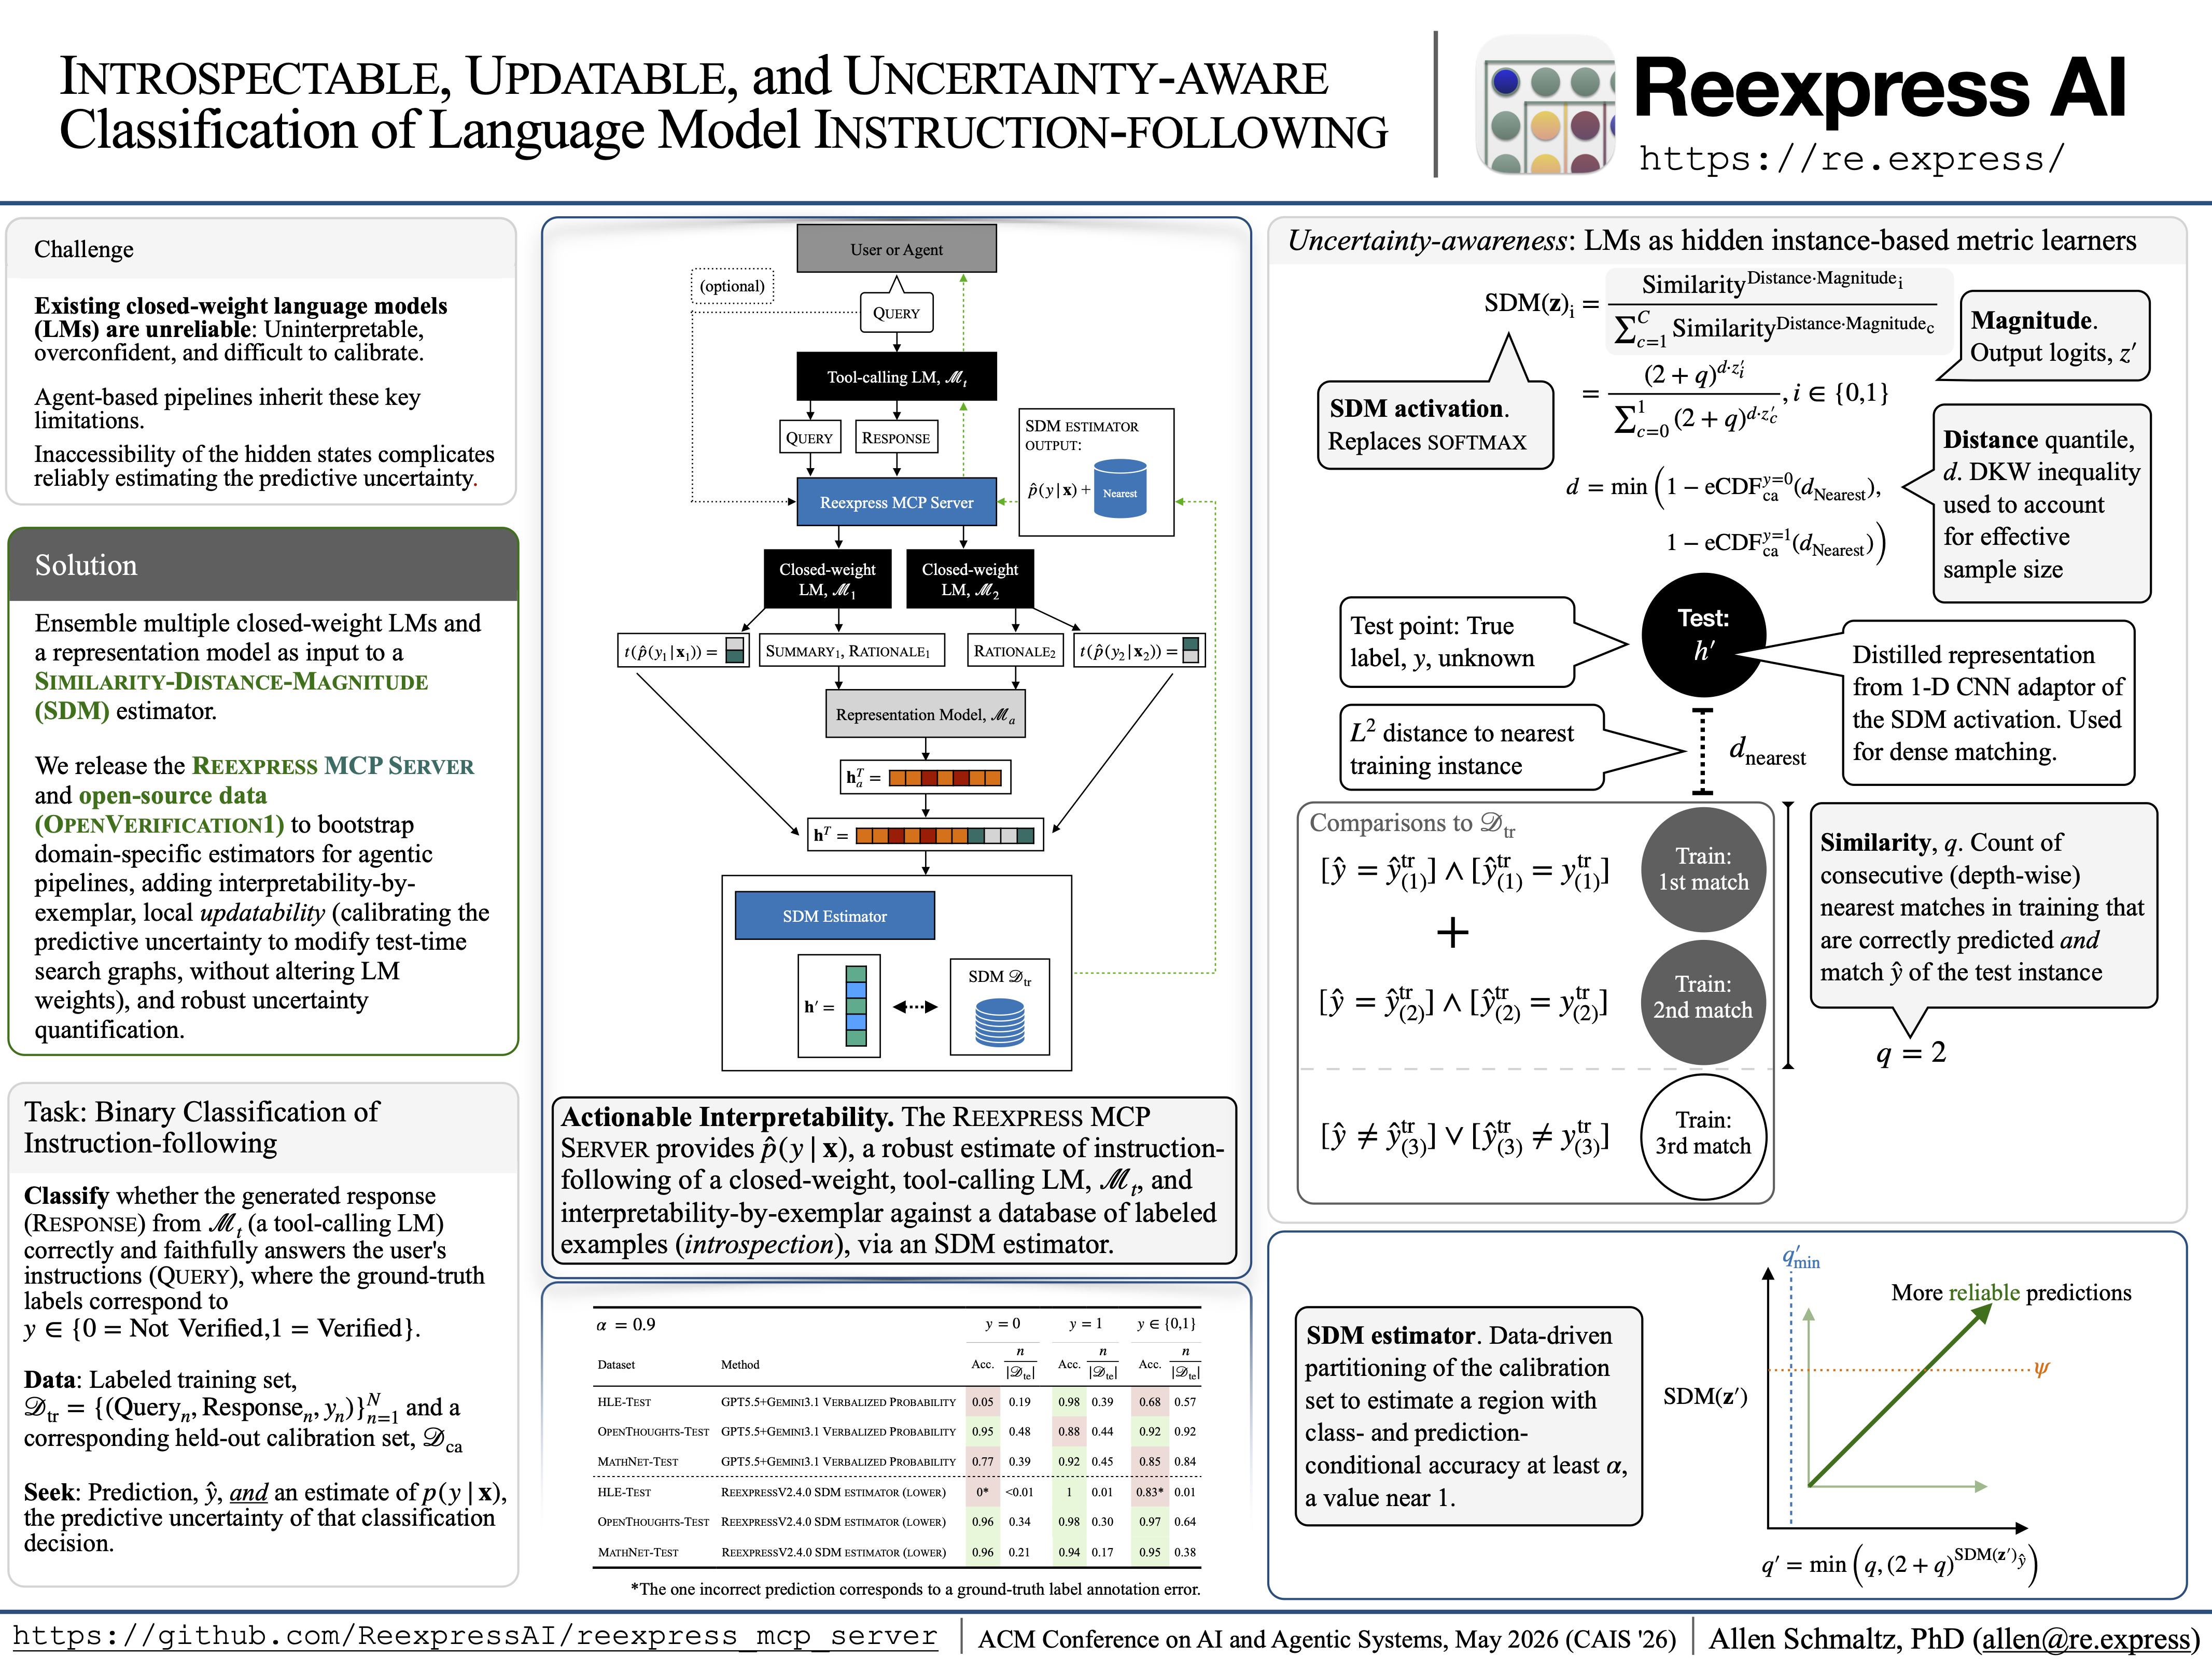
हमारे सिस्टम प्रदर्शन पेपर "Introspectable, Updatable, and Uncertainty-aware Classification of Language Model Instruction-following" की एक प्रति, जो विशेष रूप से Reexpress MCP सर्वर के संस्करण 2.1.0 पर केंद्रित है, यहाँ शामिल है। विश्लेषण को दोहराने के लिए समर्थन स्क्रिप्ट यहाँ शामिल हैं।
संस्करण 2.4.0 के लिए मॉडल कार्ड, जो सिस्टम प्रदर्शन पेपर के बाद से परिवर्तनों को उजागर करता है, यहाँ उपलब्ध है।
उद्धरण
यदि आपको यह सॉफ्टवेयर उपयोगी लगता है, तो निम्नलिखित सहकर्मी-समीक्षित पेपरों को उद्धृत करने पर विचार करें:
@inproceedings{Schmaltz-2026-SimilarityDistanceMagnitudeActivations,
    title = "Similarity-Distance-Magnitude Activations",
    author = "Schmaltz, Allen",
    editor = "Liakata, Maria  and
      Moreira, Viviane P.  and
      Zhang, Jiajun  and
      Jurgens, David",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {ACL} 2026",
    month = jul,
    year = "2026",
    address = "San Diego, California, United States",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-acl.1109/",
    doi = "10.18653/v1/2026.findings-acl.1109",
    pages = "22037--22057",
    ISBN = "979-8-89176-395-1",
    abstract = "We introduce the Similarity-Distance-Magnitude (SDM) activation function, a more robust and interpretable formulation of the standard softmax activation function, adding Similarity (i.e., correctly predicted depth-matches into training) awareness and Distance-to-training-distribution awareness to the existing output Magnitude (i.e., decision-boundary) awareness, and enabling interpretability-by-exemplar via dense matching. We further introduce the SDM estimator, based on a data-driven partitioning of the class-wise empirical CDFs via the SDM activation, to control the class- and prediction-conditional accuracy among selective classifications. When used as the final-layer activation over pre-trained language models for selective classification, the SDM estimator is more robust to covariate shifts and out-of-distribution inputs than existing calibration methods using softmax activations, while remaining informative over in-distribution data."
}
@inproceedings{Schmaltz-2026-ReexpressMCPServer,
    author = {Schmaltz, Allen},
    title = {Introspectable, Updatable, and Uncertainty-aware Classification of Language Model Instruction-following},
    year = {2026},
    isbn = {9798400724152},
    publisher = {Association for Computing Machinery},
    address = {New York, NY, USA},
    url = {https://doi.org/10.1145/3786335.3813214},
    doi = {10.1145/3786335.3813214},
    abstract = {In this system demonstration paper, we introduce an open-source implementation for training and testing Similarity-Distance-Magnitude (SDM) estimators for the task of binary classification of instruction-following of closed-weight language models (LMs). This SDM estimator provides an approximately conditional estimate of the predictive uncertainty over instruction-following, conditional on multiple closed-weight LMs and the representation space of an open-weight model. While it would be more robust to use as input to the SDM estimator the hidden-states of the underlying models, this indirect, compositional proxy is more reliable than verbalized uncertainty and adds a means of auditing the predictions against data with known labels. We release the code as an MCP Server to simplify adding interpretability-by-exemplar and locally updatable, uncertainty-aware instruction-following to agent-based pipelines. We further release OpenVerification1, a balanced set of over two million examples of instruction-following and associated rationales from recent closed-weight LMs, for bootstrapping domain-specific estimators. Finally, we discuss limitations of estimating the predictive uncertainty without access to the hidden-states of the tool-calling LM and provide practical guidance for applications.},
    booktitle = {Proceedings of the ACM Conference on AI and Agentic Systems},
    pages = {1259–1269},
    numpages = {11},
    keywords = {Approximately conditional calibration, Interpretability-by-exemplar, Classification of instruction-following, Model ensembles},
    location = {
    },
    series = {CAIS '26}
}
Footnotes
-
The आउटपुट प्रारूप वीडियो में उपयोग किए गए v1.0.0 के बाद से बदल गया है। changelog.md देखें। ↩