AginxBrowser
Servidor de navegador centrado en agentes: un solo binario de Rust con V8, sin Chromium. 14 herramientas MCP (fetch/search/click/screenshot/download + sesiones persistentes), huellas TLS sigilosas.
Documentación
AginxBrowser
English | 中文
El navegador para agentes de IA. Ve la web en vivo. Léela. Actúa sobre ella. Recuérdala.

Un navegador construido para agentes desde la primera línea de código, no un navegador humano adaptado a la automatización. Ve el mundo, léelo, búscalo, actúa sobre él y conserva lo que lees: un solo binario de Rust con V8 integrado, sin necesidad de Chromium.
Los humanos tienen Chrome. Los agentes tienen AginxBrowser.
Un solo binario, cero dependencias, servicio instantáneo. La API HTTP es toda la interfaz: los agentes se conectan y listo.
La estrella que captó nuestra atención: Pierre Tachoire, cofundador de Lightpanda, el navegador headless contra el que mide nuestro benchmark, marcó el repositorio como favorito. 90 segundos sobre por qué eso nos importaba.
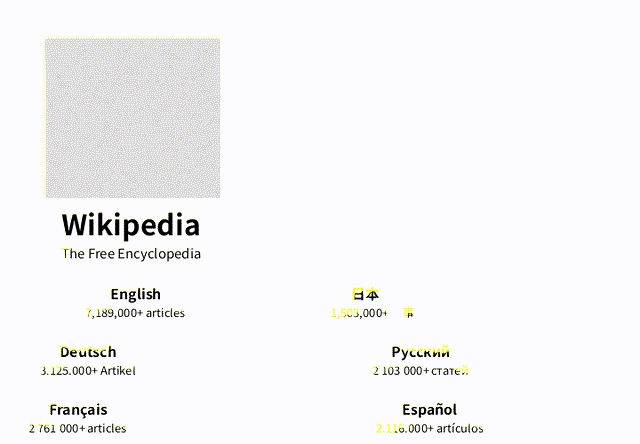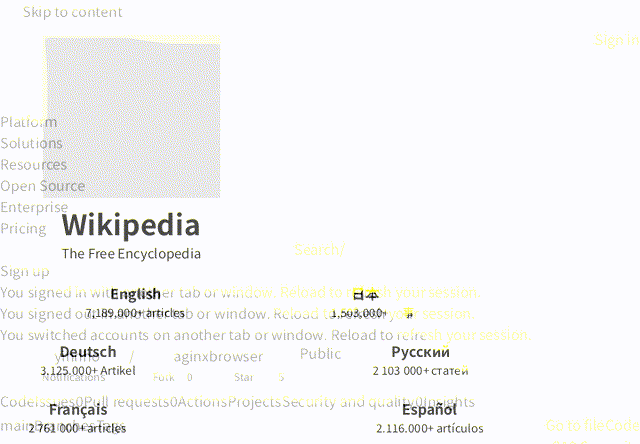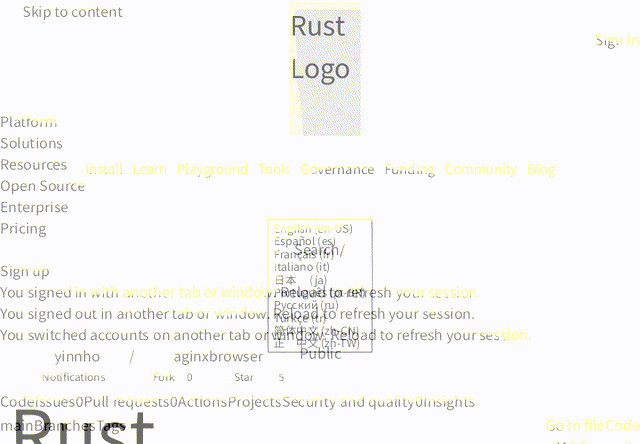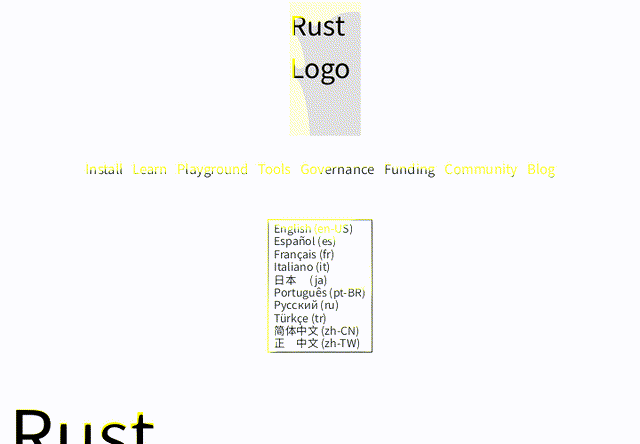
Páginas reales renderizadas por el motor diting de AginxBrowser (sin Chromium): Wikipedia, este repositorio, Rust. Toma una captura tú mismo →
Por qué los agentes necesitan su propio navegador
Medido contra Chrome headless en las mismas 20 páginas, misma red (benchmark, 2026-08-28): 7,6× más rápido para texto utilizable por agentes (p50 532 ms frente a 4 053 ms), ~10× menos memoria (227 MB para todo el proceso frente a ~2,1 GB por página de Chrome) y 0 fallos graves donde el --dump-dom de Chrome no produjo DOM en 5 de 40 cargas. Re-ejecutado en v0.5.21 (2026-09-29) en un día de red degradada mantuvo la proporción: 5,4× p50, 468 MB en toda la ejecución frente a 1,75 GB por página; ambos TSV sin procesar están confirmados. El costo total de un agente es eficiencia del navegador × eficiencia del modelo: esta es la mitad del navegador.
La "automatización de navegador" existente se construyó para humanos o para scraping de una sola pasada, no para agentes:
| AginxBrowser | Puppeteer/Playwright | Firecrawl | Browser-use | |
|---|---|---|---|---|
| Diseñado para | Agentes primero | Depuración humana | Servicio de scraping | Envoltorio de LLM |
| Dependencias | Binario único, sin Chromium | Chromium ~500MB | Docker ~1GB | Chromium |
| Ve (capturas) | ✅ motor de renderizado diting integrado | Necesita Chromium | ❌ | Necesita Chromium |
| Lee | markdown + js_extract + recibos de fetch | Hágalo usted mismo | markdown | Hágalo usted mismo |
| Escribe documentos | ✅ render_markdown: HTML determinista + diagramas SVG en línea | ❌ | ❌ | ❌ |
| Encuentra (búsqueda) | ✅ 20 motores, 7 categorías, combinados | ❌ | ❌ | ❌ |
| Actúa | interacción de sesión indexada | API DevTools | ❌ | Impulsado por LLM |
| Recuerda | ✅ caché local de fetch/búsqueda (SQLite FTS5) | ❌ | caché de rastreo | ❌ |
| Protocolo | HTTP | API de Node | HTTP | Python |
| Huellas TLS | ✅ Chrome/Firefox/Safari/Edge | Requiere plugin | ❌ | ❌ |
| CAPTCHA | ✅ detección + espera automática + 2captcha opcional | Hágalo usted mismo | ❌ | ❌ |
| Sesiones interactivas | ✅ persistentes | ✅ | ❌ | ✅ |
Motores del mismo nivel, no las herramientas de la tabla anterior. Las celdas son capacidades, no velocidad.
| AginxBrowser | Obscura | Blitz | Lightpanda | |
|---|---|---|---|---|
| Qué es | Navegador Rust, V8, pintura CSS diting | Navegador headless Rust, V8 | Motor HTML/CSS (Stylo). No es un navegador para agentes | Navegador headless Zig, V8 |
| Captura | pintura integrada, compilación opcional | capturas, screencast, PDF | pinta una ventana | la integración Hermes recurre a Chrome para capturas |
| Suite CSS pública | ninguna en CI | no publicada como WPT | WPT en CI, incluido SVG | no publicada como WPT |
| Licencia | Apache-2.0 | Apache-2.0 | Apache-2.0 y MIT | AGPL-3.0 |
Un agente necesita cinco cosas de un navegador: ver, leer, encontrar, actuar, recordar. Un solo binario las cubre todas: compatible con systemd, cero dependencias.
Ventaja principal: sin Chromium. AginxBrowser incluye un motor de navegador completo (V8 + pila HTTP de Rust + el motor de renderizado CSS/diseño/pintura diting, con el linaje Blitz/Stylo/Taffy como implementación de referencia). Sin Puppeteer, sin Chrome, sin Docker. Un binario de Rust bajo systemd es tu infraestructura de navegación para agentes.
Dos cosas que los renderizadores sin estado no pueden hacer
La mayoría de los "navegadores para agentes" nuevos son renderizadores de una sola pasada, sin estado y sin huella: buenos para páginas públicas, inútiles contra Cloudflare o flujos de inicio de sesión. AginxBrowser va en la dirección opuesta:
- 🔐 Huellas TLS reales: el modo sigiloso replica los handshakes TLS completos de Chrome145 / Firefox133 / Safari / Edge mediante BoringSSL (no solo una cadena de UA), cambiable por solicitud; los desafíos de Cloudflare Turnstile esperan automáticamente durante
cf_clearance. Los motores sin huella reciben 403: nosotros pasamos. - 🤝 Sesiones interactivas con estado: el estado de inicio de sesión es inyectable y exportable (
session_create(cookies=...)↔session_cookies), sobrevive a la paginación y a flujos de varios pasos;persistent: trueincluso sobrevive al desalojo por inactividad y a reinicios del servidor: la misma identificación de sesión vuelve con la sesión iniciada. Los motores de una sola pasada descartan el estado.
Punto de referencia: Kitesurf de Cloudflare no incluye explícitamente negociación de huella TLS real ni sesiones de autenticación persistentes: el territorio anti-bot e inicio de sesión es exactamente donde juega AginxBrowser.
Código abierto Apache-2.0, binario único: autoalójalo hoy, sin bloqueo en la nube.
Cada fetch es un recibo
Los agentes actúan sobre lo que el navegador les dice, por lo que la respuesta informa lo que realmente sucedió, no solo "obtuve un 200":
tier: qué ruta sirvió la página: HTTP simple (~100 ms) o el nivel de navegador renderizado con V8. Un agente puede ver por qué un fetch fue rápido o lento.redirected_from: el rastro completo de redirecciones.redirected_from[0]es la URL que solicitaste,urles de donde realmente vino el contenido: solicitada junto con la efectiva, cada salto visible.content_hash+changed_since_prev: cada fetch se hashea; las muestras consecutivas de la misma URL se pueden comparar. Un origen con límite de velocidad que sirve el mismo cuerpo 200 congelado durante días se lee comochanged_since_prev: false: el detector de deriva más barato que existe.captcha_event: cuando se detecta una página de desafío (y se resuelve, si hay un solucionador configurado), la respuesta lo dice en lugar de entregar una página de desafío como si fuera contenido.
La caché local se basa en la misma idea: los resultados de búsqueda vuelven con prefijos de sección [§ heading] para que un agente sepa dónde en la página aterrizó un resultado, y la clasificación fusiona relevancia de palabras clave con frescura.
Capacidades
- Renderizado por niveles: páginas estáticas sobre HTTP simple (~100 ms); V8 se activa solo cuando se necesita renderizado JS (~1-2 s): el 90% del conjunto de páginas del benchmark se sirve sin activar V8 en absoluto; cada respuesta informa qué nivel la sirvió (campo
tier) - Metabúsqueda de múltiples motores: web general (Baidu / Bing / Sogou / WeChat / DuckDuckGo / Wikipedia / Hacker News), noticias (Bing News), código (Stack Overflow, GitHub, MDN), paquetes (npm, PyPI, RubyGems), académico (arXiv, OpenAlex), modelos de IA (Hugging Face): 20 motores en 7 categorías, consultados simultáneamente, combinados y deduplicados. Los operadores pueden conectar un índice Meilisearch privado al mismo
/search. Búsqueda → lectura en un solo paso - Búsqueda de imágenes:
categories=imagesconsulta los índices de imágenes de Baidu/Bing y devuelve enlaces binarios directosimage_url(descargables directamente como jpg/png) además de procedenciasource_url - Sesiones interactivas: sesiones de navegador persistentes con interacción indexada (
state/click/input/scroll/eval): los agentes navegan como humanos, ysession_exportconvierte lo que un agente descubrió en un script de reproducción curl ejecutable (cero tokens de modelo al re-ejecutar); o, conformat=json, en un documento de flujo (flow_runlo reproduce en el servidor con sustitución de{{var}}, compuertaswait/expecty salidas guardadas; los flujos instalados viven enworkflow/<name>/flow.json, se colocan sin recompilar). Las herramientas de sesión también cubren la parte de actuar:session_viewportsimula viewports de dispositivos (las consultas de medios responden),session_waitbloquea en un selector o predicado con tiempo de espera,session_screenshotrenderiza el estado en vivo,session_consolereproduce el anillo de consola de la página ysession_storageexporta/restaura cookies además de localStorage para el traspaso de inicio de sesión - Detector de enlaces de reproducción:
session_network(filter=media)extrae las URLs m3u8/mp4/dash que el reproductor de una página realmente solicitó en tiempo de ejecución: los enlaces que solo se encuentran en el HTML de la página suelen ser señuelos, por lo que el registro de solicitudes es la fuente de verdad.GET /session/{id}/harexporta el mismo tráfico como HAR 1.2 (incluidos los cuerpos retenidos) - Descarga de archivos: transmisión a disco (sin almacenamiento en memoria), integridad SHA-256, reanudación de transferencias interrumpidas: para binarios, archivos, conjuntos de datos
- Caché local que recuerda: cada fetch/búsqueda aterriza en SQLite (FTS5) en
~/.aginxbrowser/cache.db: una re-búsqueda dentro del TTL responde desde lo que el agente ya leyó en lugar de volver a pagar tiempo de red, con coincidencia de subcadenas CJK, fragmentos conscientes de sección[§ heading], hashes de contenido por URL para detección de deriva y alcance por sesión para implementaciones compartidas - Manejo de CAPTCHA: detección de tipo con espera automática de desafío de Cloudflare e integración opcional de 2captcha: la búsqueda nunca se detiene en páginas de verificación
- Extracción de datos JS:
js_extractextraewindow.__INITIAL_STATE__y otros datos estructurados de SPA - Generación de documentos:
POST /render_markdownconvierte markdown en un artefacto HTML determinista y autocontenido: la capa de documentos, para que los agentes nunca escriban HTML a mano. La prosa viaja en un shell simple sin conexión (sin fuentes, sin scripts); los bloquesarchifycon delimitadores llevan JSON de diagrama tipado con coordenadas cero (familias de secuencia / flujo de trabajo / arquitectura / flujo de datos / ciclo de vida) y se renderizan como SVG en línea mediante el motor de diseño. Misma entrada, mismos bytes: el recibo lleva el sha256 para que el determinismo sea verificable.theme(claro/oscuro) ypreset(clásico / flujo de señales / plano / editorial) hornean colores en el momento de la generación;quality: "showcase"es la compuerta de entrega, que califica cruces de rutas, espacio de etiquetas y ritmo sin tocar los bytes del artefacto. Pestañas de vista guiada máswindow.agxViewer(focus/ ego /route/reach) hacen que el artefacto sea interactivo. Las fuentes de Mermaid son trabajo del agente traducirlas a JSON de archify, no del motor. Vocabulario de diagramas adaptado de archify (MIT) - Renderizado de capturas: endpoint
/screenshot(compilación opcional--features screenshot) pinta el DOM renderizado con JS usando el motor de renderizado diting: CPU pura, sin Chromium, a PNG. Entrada de visión para agentes - Video de línea de tiempo:
/videorenderiza las líneas de tiempo de animación de una página a MP4: los scripts de la página registran líneas de tiempo estilo GSAP enwindow.__timelines(duration()+pause(t)), cada cuadro buscat=i/fpsy pinta el viewport, y los cuadros se canalizan a ffmpeg (H.264, yuv420p). Determinista por construcción: sin reloj de pared en los valores de píxeles, mismo renderizado dos veces = mismo MP4. Necesita ffmpeg en PATH - Conjunto de páginas (PDF/PNG/PPTX/DOCX):
/pdfcorta una página renderizada en páginas y las empaqueta: el modo de impresión pagina en límites de bloques de nivel superior (A4 predeterminado a 96 dpi, sin texto cortado a la mitad donde un salto puede caer en un borde de bloque), el modo de diapositivas hace una página por coincidencia de selector CSS dimensionada al elemento (una presentación HTML con un.slidepor página se exporta como una presentación real). PDF basado en imágenes: JPEG por página mediante DCTDecode, escritor PDF 1.4 hecho a mano, cero dependencias nuevas. PPTX empaqueta las mismas páginas como una diapositiva por página; DOCX como una sección del tamaño de página por página: ambos OOXML hechos a mano (escritor ZIP almacenado, marcas de tiempo fijas), byte-deterministas, cero dependencias nuevas - Suplantación de huella TLS: el modo sigiloso imita Chrome145/Firefox133/Safari/Edge, cambiable por solicitud
- Compatible con Firecrawl: endpoint
/v1/scrape: los clientes existentes de Firecrawl migran cambiando la URL base - Protección contra rebinding de DNS: guardia SSRF integrada + validación de IP posterior a la resolución
Un navegador, no un rastreador
AginxBrowser existe para recuperación en tiempo real: un agente llega con una pregunta, lee un puñado de páginas, se va con la respuesta. No es una herramienta de rastreo, y el producto está diseñado para que no pueda convertirse silenciosamente en una:
- robots.txt no es nuestra puerta de entrada. El verificador RFC 9309 viene integrado, pero una capa de consulta en tiempo real no es un rastreador y no sigue la etiqueta de rastreadores por defecto; los operadores que lo deseen configuran
AGINXBROWSER_HONOR_ROBOTS=1. - Sin API de recorrido de sitios. No hay endpoint de rastreo ni recursión de seguimiento de enlaces: cada carga de página ocurre porque un agente la solicitó.
- Presupuestos integrados. Por dominio: 20 páginas/minuto. Por sesión interactiva: 200 páginas. Se alternan mediante
AGINXBROWSER_DOMAIN_RATE_PER_MIN/AGINXBROWSER_SESSION_PAGE_LIMIT(0los desactiva en tu propia instancia). Generoso para un agente que revisa documentación o una consola; fatal para el patrón de rastreo página tras página, incluida la rotación de subdominios (un dominio registrable, un presupuesto). - La instancia alojada (browser.aginx.net) ejecuta presupuestos más estrictos. Cada usuario comparte una IP de salida, y mantener los sitios cómodos con esa IP es parte del servicio. Auto-aloja si quieres números diferentes.
- ¿Necesitas rastrear un sitio en masa? Usa un rastreador. Esto no lo es, y no lo será.
Para Qué Sirve
No demos: trabajos reales que los navegadores de agentes hacen hoy:
- Recorrer consolas de administración — AWS / App Store Connect / Google Play, docenas de capas de menú por tarea. Deja que el agente haga clic; vuelve solo cuando se necesita autorización.
- Acciones por lotes tras el inicio de sesión — llenar carritos, revisar historial de pedidos, ver páginas que solo se renderizan con sesión iniciada. Inyecta cookies, opera, exporta para reutilizar.
- Superar muros anti-bot — protección Cloudflare, desafíos Turnstile, verificaciones de huella TLS. El modo sigiloso avanza en lugar de retroceder ante un 403.
- El internet chino — meta-búsqueda Baidu / Sogou / WeChat en 5 motores, renderizado correcto de páginas chinas. No solo web en inglés.
- Scripting en el momento — el agente lee la página, escribe JS, lo evalúa: tablas de comparación resaltadas, contenido reestructurado, filtros de productos en parámetros ocultos. GreaseMonkey con esteroides.
- Visión multimodal — capturas de pantalla como entrada visual para flujos de mirar y juzgar: elegir asientos, reconocer diseños, verificar renderizado.
Dónde Encaja en la Pila de Uso de Computadora
Los agentes de uso de computadora vienen en dos capas. Las pilas de capa GUI (Cua, agentes CUA de escritorio) manejan una máquina completa: capturas de pantalla de una pantalla, eventos de mouse/teclado X11, una VM o contenedor por sesión. Los navegadores de capa de motor omiten el escritorio: la página misma es la máquina. AginxBrowser es la capa de motor:
| Capa GUI (CUA de escritorio) | AginxBrowser (capa de motor) | |
|---|---|---|
| Espacio de acción | píxeles de pantalla → eventos de entrada del SO | DOM: clic por coordenadas o selector, despacho de eventos real |
| Lectura de estado | captura de pantalla de una pantalla | DOM estructurado / árbol de accesibilidad, captura opcional |
| Costo por sesión | Xvfb + VM/contenedor | un proceso, sin servidor de pantalla |
| Marcos | aplanados en píxeles | de primera clase: hit-testing desciende a iframes, evaluate con ámbito de marco |
| Reproducción | mejor esfuerzo (tiempo de compositor) | registros de acciones exportados como curl ejecutable / JSON de flujo |
Inicio Rápido
Instalación completa con un comando (superficie de activación SKILL.md + verificación):
# Download -> inspect the contents -> run only after review (never blind-run network scripts)
curl -fsSL https://raw.githubusercontent.com/yinnho/aginxbrowser/main/skill.sh -o skill.sh
less skill.sh
bash skill.sh
Instala la superficie de activación de habilidades mediante skills.sh:
npx skills add yinnho/aginxbrowser
O simplemente entrega este bloque a tu agente de IA — se configura solo:
Set up aginxbrowser as your web access layer:
1. Install it locally and verify it is healthy:
   brew trust yinnho/aginxbrowser   # Homebrew 7+ tap-trust gate; older brew skips this
   brew install yinnho/aginxbrowser/aginxbrowser
   aginxbrowser doctor   # then start: aginxbrowser (listens on 0.0.0.0:8089)
   curl http://127.0.0.1:8089/health
2. From now on, route web tasks through http://127.0.0.1:8089 instead of raw curl:
   - read a page / scrape a URL  -> POST /fetch {"url":...}        (markdown output, Cloudflare bypassed by default)
   - search the web              -> POST /search {"q":...,"fetch_top":3}
   - see a page                  -> POST /screenshot {"url":...}
   - login / form / click-through-> POST /session/create -> /session/{id}/state -> /input /click -> /close
Auto-alojamiento:
# macOS / Linux via Homebrew (7+ needs the trust line first)
brew trust yinnho/aginxbrowser
brew install yinnho/aginxbrowser/aginxbrowser
aginxbrowser doctor   # features + fonts + egress self-check

# Or the prebuilt binary (platform detect + sha256 + mirror fallback + doctor self-check)
# macOS / Linux / Windows (git-bash; prebuilt Windows ships from v0.3.1, full `stealth`+`screenshot` feature set from v0.4.0)
# Cautious: download -> inspect -> run (never blind-run network scripts)
curl -fsSL https://browser.aginx.net/install.sh -o install.sh
less install.sh && bash install.sh
# Or straight in, if you trust the repo:
#   curl -fsSL https://browser.aginx.net/install.sh | sh
# GitHub slow/blocked? AGINXBROWSER_GH_PROXY=https://ghfast.top/ bash install.sh
aginxbrowser doctor   # features + fonts + egress self-check

# Or build from source (--features stealth,screenshot or you lose both)
cargo build --release --features stealth,screenshot

# Start the service
./target/release/aginxbrowser
# → Listening on 0.0.0.0:8089

# Verify
curl http://127.0.0.1:8089/health
# → {"status":"ok","engine":"diting"}

# Fetch a page
curl -sS -X POST http://127.0.0.1:8089/fetch \
  -H "Content-Type: application/json" \
  -d '{"url":"https://example.com"}'

# Search (snippets only by default; fetch_top grabs page bodies for the top N)
curl -sS -X POST http://127.0.0.1:8089/search \
  -H "Content-Type: application/json" \
  -d '{"q":"macbook price","max_results":5,"fetch_top":2,"max_chars_per":2000}'

# Create an interactive session
curl -sS -X POST http://127.0.0.1:8089/session/create \
  -H "Content-Type: application/json" \
  -d '{"url":"https://example.com"}'
# → {"session_id":"s_1","url":"https://example.com/"}
Rutas REST
Cada capacidad es HTTP simple: no se requiere SDK. No hay /openapi.json (las rutas son pocas para listarlas aquí); los campos completos de solicitud/respuesta para cada ruta están en docs/API.md.
| Método | Ruta | Qué hace |
|---|---|---|
| GET | /health | Liveness + commit de compilación, UA, TLS, capacidades |
| GET | /doctor | Autoverificación profunda: motores activos, fuentes, salida |
| GET | /engines | Catálogo de motores de búsqueda con estado de suspensión en vivo |
| POST | /fetch | Obtener una página → texto/markdown/html. Parámetros: render_tier (auto/http/browser), max_chars, capture_xhr, … |
| POST | /search | Meta-búsqueda multi-motor. Parámetros: engines, categories, max_results, time_range (day/week/month/year), fetch_top, max_chars_per, wait_secs |
| POST | /click | Hacer clic en un selector CSS en una página |
| POST | /eval | Evaluar JavaScript en una página |
| POST | /download | Transmitir un archivo a disco (sha256, reanudar) |
| POST | /screenshot | Renderizar página → PNG (característica screenshot) |
| POST | /video | Renderizar líneas de tiempo de animación → MP4 (característica screenshot) |
| POST | /pdf | Paginar página → PDF/PNG/PPTX/DOCX (característica screenshot) |
| POST | /v1/scrape | Scrape compatible con Firecrawl (+ actions) |
| POST | /flow/run | Ejecutar un flujo JSON grabado/editado hasta completarse — cero tokens de modelo (name ejecuta un workflow/<name>/flow.json instalado, flow es en línea, vars sustituye {{placeholders}}, session_id compone con estado de inicio de sesión importado) |
| POST | /session/create | Iniciar una sesión interactiva (cookies/UA se mantienen entre llamadas) |
| POST | /import/curl | Crear una sesión con inicio de sesión desde "Copiar como cURL" de DevTools |
| GET | /session/list | Sesiones activas |
| POST | /session/{id}/navigate · /state · /click · /click_xy · /drag · /input · /scroll · /eval · /wait · /dialog · /viewport · /screenshot · /clone · /close | Acciones de sesión |
| GET | /session/{id}/cookies · /storage · /console · /network · /har · /export | Inspección de sesión |
| POST | /render_markdown | Markdown → artefacto HTML determinista autocontenido (+ diagramas SVG en línea) |
Cada capacidad está a un POST de distancia: sin SDK, sin adaptador de protocolo.
Estructura del Proyecto
aginxbrowser/
├── ARCHITECTURE.md       # Layering legislation (authoritative)
├── Cargo.toml            # Workspace root (members = crates/diting)
├── crates/
│   └── diting/           # Engine crate: DOM/CSS/layout/paint/JS/net/Page
│       ├── build.rs      # V8 snapshot generation
│       ├── js/           # bootstrap.js + companion scripts
│       └── src/          # diting_{dom,css,net,js,layout,fonts,browser}
├── workflow/             # Flow + recipe assets (drop-in, no rebuild)
├── README.md
├── docs/
│   └── API.md            # Full API reference (HTTP)
├── bench/                # Benchmark harness + results (vs headless Chrome)
│   ├── README.md         #   methodology + numbers
│   ├── pages.txt         #   fixed 20-page set
│   ├── run.py            #   harness
│   ├── summarize.py      #   TSV → results table
│   └── results/          #   raw run data
└── src/
    ├── main.rs              # HTTP/CLI assembly (thin face)
    ├── routers/             # HTTP handlers: acquisition/sessions/outputs/render
    ├── server/              # Acquire façade by job: browser/fetch/outputs/search
    ├── session/             # Interactive sessions (manager/interact/state/…)
    ├── flow/                # Flow interpreter + install
    ├── search/              # Metasearch orchestration + per-engine adapters
    ├── store/               # Local fetch/search cache (SQLite FTS5)
    ├── docgen/              # Document layer: markdown → HTML + SVG diagrams
    ├── screenshot.rs        # Eye-side HTML→PNG (keep monolithic)
    ├── render.rs            # Tiered rendering (HTTP direct → diting)
    ├── download.rs          # Streaming file download (sha256, resume)
    ├── robots.rs            # RFC 9309 robots.txt checker (opt-in gate)
    ├── rate.rs              # Per-domain + per-session budgets
    ├── captcha.rs           # CAPTCHA detection & auto-solve
    ├── firecrawl_compat.rs  # Firecrawl-compatible /v1/scrape endpoint
    ├── video.rs             # Timeline video pump (__timelines → ffmpeg → MP4)
    ├── pages.rs             # Page pump (print/slides → PDF/PNG)
    ├── ooxml.rs             # OOXML containers (PPTX/DOCX)
    ├── doctor_cli.rs        # `aginxbrowser doctor` self-check
    ├── browser.rs           # Product Page adapter: Browser, BrowserBuilder
    ├── page.rs              # Product Page/Element wrapper over diting
    ├── config.rs            # BrowserConfig
    ├── cookie.rs            # Cookie helpers
    └── error.rs             # Error types
Compilación
# Standard build (no stealth; TLS fingerprint features inactive)
cargo build --release

# With stealth (requires go + cmake + C++ toolchain; enables TLS fingerprint spoofing)
cargo build --release --features stealth

# With screenshot rendering (enables /screenshot; adds the rendering stack, +30-40MB)
cargo build --release --features screenshot

# Full featured (recommended for production)
cargo build --release --features stealth,screenshot
Requisitos: Rust 1.78+; la biblioteca estática V8 se descarga automáticamente en la primera compilación. La característica de sigilo además necesita go, cmake y un compilador C++. La característica de captura de pantalla incluye un subconjunto de fuentes CJK empaquetado (GB2312 + símbolos comunes): no se requieren fuentes del sistema para el renderizado correcto de chino.
Si tu red no puede alcanzar el CDN de rusty_v8 (la compilación se cuelga sin progreso después de "descargando v8"), precarga ~/.cache/rusty_v8 con el librusty_v8.a.gz para tu versión (obténlo de cualquier mirror/host alcanzable y descomprímelo en su lugar) y el script de compilación omite la descarga.
Variables de Entorno en Tiempo de Ejecución
| Variable | Predeterminado | Descripción |
|---|---|---|
AGINXBROWSER_BIND | 0.0.0.0:8089 | Dirección de escucha |
AGINXBROWSER_STEALTH | habilitado | 0 desactiva el sigilo (para diagnósticos) |
AGINXBROWSER_UA | Linux Chrome145 | User-Agent suplantado |
AGINXBROWSER_ACCEPT_LANGUAGE | zh-CN,zh;q=0.9,en;q=0.8 | Encabezado Accept-Language |
AGINXBROWSER_PROXY | ninguno | Proxy de respaldo opcional. Los motores de fuentes bloqueadas (Wikipedia, Bing News, Hugging Face, RubyGems) se conectan directamente primero y recurren a este proxy solo cuando el intento directo falla: los despliegues en el extranjero no necesitan proxy en absoluto; use_proxy:true por solicitud también enruta fetch/búsqueda a través de él. Las navegaciones de navegador/sesión a dominios conocidos bloqueados (wikipedia.org, github.com, …) se enrutan automáticamente a través de él. Los HTTP_PROXY/HTTPS_PROXY/ALL_PROXY estándar son deliberadamente ignorados por el motor (configúralos libremente para otras herramientas); el registro de inicio advierte cuando ve uno |
AGINXBROWSER_NAV_CHAIN_LIMIT | 10 | Límite de cadena de navegación JS: documentos que una página puede encadenar mediante location/saltos de formulario antes de que la navegación se aborte. El conteo incluye el documento solicitado (10 = documento inicial + 9 saltos). Auméntalo para cadenas largas legítimas (traspaso SSO entre proveedores); los redireccionamientos HTTP 3xx tienen presupuesto separado (20, según la especificación Fetch / paridad de navegador) |
AGINXBROWSER_CACHE_TTL_SECS | 600 | TTL de caché /fetch, 0 desactiva |
AGINXBROWSER_HONOR_ROBOTS | sin configurar | robots.txt no se consulta por defecto en /fetch, /screenshot, /download; configura 1 para optar (decisión del operador) |
AGINXBROWSER_ALLOW_FILE_ACCESS | sin configurar | Opta por lecturas de file:// — navegación, subrecursos, /fetch. Igual que el indicador CLI --allow-file-access. Desactivado por defecto: el servidor se vincula a 0.0.0.0, por lo que una puerta abierta entrega archivos locales a cualquiera que pueda alcanzar el puerto. Configúralo en una instancia de desarrollo local, no en una alojada |
AGINXBROWSER_ALLOW_PRIVATE_NETWORK | sin configurar | Opta por fetchs de loopback/RFC1918/link-local (la puerta SSRF). Igual que el indicador CLI --allow-private-network — solo máquinas de desarrollo |
AGINXBROWSER_ALLOW_NETWORK | sin configurar | Alternativa con ámbito: lista de permitidos CIDR separada por comas (p. ej. 10.20.0.0/16,192.168.1.0/24) que abre solo esos rangos — los endpoints de metadatos de nube (169.254.169.254, 100.100.100.200) y todo lo demás permanecen bloqueados. Igual que --allow-network <cidrs> |
AGINXBROWSER_FONT_DIR | sin configurar | Directorio de fuentes adicionales (.ttf/.otf/.ttc) cargadas como respaldos finales para scripts que el subconjunto CJK empaquetado no cubre (coreano, tailandés, árabe, …). Igual que el indicador CLI --font-dir <path>. Las caras que el paquete ya cubre mantienen el renderizado del paquete: las fuentes del directorio son colas de cobertura, no anulaciones de familias nombradas |
AGINXBROWSER_ROBOTS_TTL_SECS | 3600 | TTL de caché de política robots.txt por host |
AGINXBROWSER_DOMAIN_RATE_PER_MIN | 20 | Presupuesto de páginas por dominio registrable por minuto (los subdominios comparten un presupuesto); las solicitudes por encima del presupuesto reciben 429 con el mensaje de postura. 0 desactiva. Ver "Un Navegador, No un Rastreador" |
AGINXBROWSER_SESSION_PAGE_LIMIT | 200 | Total de páginas que una sesión interactiva puede recorrer (los clics que causan navegación cuentan); las navegaciones por encima del presupuesto se rechazan, la página actual permanece interactiva. 0 desactiva |
AGINXBROWSER_STORE | on | Caché local de fetch/búsqueda; 0/false/off desactiva |
AGINXBROWSER_STORE_PATH | ~/.aginxbrowser/cache.db | Ubicación de la base de datos SQLite (creada 0600) |
AGINXBROWSER_STORE_TTL_HOURS | 720 | TTL de página en caché |
AGINXBROWSER_STORE_SEARCH_TTL_HOURS | 168 | TTL de conjunto de resultados de búsqueda en caché |
AGINXBROWSER_STORE_SCOPE | global | session limita la caché por sesión en lugar de un grupo compartido |
CAPTCHA_SOLVER_API_KEY | ninguno | Clave API de 2captcha; habilita la resolución automática de CAPTCHA |
CAPTCHA_SOLVER_SERVICE | 2captcha | Proveedor de resolución de CAPTCHA |
AGINXBROWSER_MEILI_URL | ninguno | URL base de Meilisearch; configúrala para habilitar el motor de índice privado |
AGINXBROWSER_MEILI_INDEX | ninguno | UID de índice de Meilisearch a consultar |
AGINXBROWSER_MEILI_KEY | ninguno | Clave Bearer opcional para la instancia de Meilisearch |
AGINXBROWSER_CAPTCHA_BACKOFF_SECS | 300,600,1800,3600 | Escalera de suspensión por CAPTCHA (segundos). Valor único = duración plana para cada golpe |
AGINXBROWSER_CAPTCHA_POLICY | suspend | suspend = escalera temporizada; demote/skip = evaluar el motor durante la vida del proceso después de un CAPTCHA |
AGINXBROWSER_DISABLE_ENGINES | ninguno | Nombres de motores separados por comas para dejar sin registrar (p. ej. bing_news) |
AGINXBROWSER_BING_NEWS | on | 0/false/off desactiva la pierna bing_news (ruido de doble ruta Object-moved de CN) |
Documentación de la API
Referencia completa de la API → docs/API.md
Notas de auditoría de seguridad → docs/skills-sh-audit.md — por qué skills.sh muestra "Riesgo Crítico", y a qué característica real del producto corresponde cada advertencia
Cubre:
- Todos los endpoints HTTP (
/fetch,/search,/screenshot,/video,/pdf,/download,/render_markdown,/v1/scrape,/flow/run,/doctor, los endpoints de sesión) - Variables de entorno, códigos de error, ejemplos de scraping por sitio
Integración con Otros Sistemas
AginxBrowser es infraestructura pura de conexión lateral — como un navegador real, se ejecuta como un servicio independiente que cualquier cosa puede llamar, sin incrustar código del host ni contaminar la configuración del host. Implementa una instancia por máquina (bajo systemd) y cada aplicación que necesite capacidad de "renderizar + extraer" la comparte.
El punto de conexión es HTTP — /fetch, /search, /screenshot, /download, /render_markdown para cualquier lenguaje con un cliente HTTP.
Integración: lee la variable de entorno AGINXBROWSER_URL=http://127.0.0.1:8089. Sin definir → comportamiento sin cambios; definida → los sitios con control de riesgo se enrutan automáticamente a través de AginxBrowser para renderizar, con una degradación elegante en caso de fallo.
Limitaciones conocidas
- Las capturas de pantalla son opcionales:
/screenshotrequierecargo build --release --features screenshot(añade la pila de renderizado diting). El motor de renderizado predeterminado (y único) en esa compilación es diting — nuestra propia pila de CSS+layout+pintura, cero código Blitz/Stylo. La canalización de referencia Blitz de revisión fija es una opción separada,--features blitz-reference, para renderizados comparativos y las pruebas de verificación cruzada de doble motor. El CSS de sitios complejos es aproximado en ambos (no perfecto en píxeles como Chromium) - Coordenadas de elementos compatibles:
/screenshotconselectordevuelve coordenadas de página del elemento (selector_rects, px CSS);selectorsolo recorta directamente a ese elemento. Los elementos en línea (<a>text</a>) también obtienen un rect en el motor diting predeterminado — una unión de su contenido en línea aplanado, expandido con puntal a la propialine-heightdel elemento como Chrome informa para elementos en línea solo reemplazados (<a><img></a>→ altura de la caja de línea, no la altura de la imagen). Los elementos en línea vacíos aún no tienen rect — elige un ancestro de bloque allí - La interacción con JS funciona en general; las páginas con huellas digitales pesadas pueden fallar: La delegación de eventos de React/Vue funciona normalmente (los atributos de reflexión de URL como
src/hrefse resuelven a URLs absolutas para que Next.js/webpack hidraten y los clics activen los manejadores). Las páginas de autenticación con huellas digitales pesadas (WorkOS/Cloudflare) que sondeannavigator.plugins, canvas WebGL, etc., pueden seguir fallando hasta que se complete la cobertura de huellas digitales sigilosas - Soporte de proxy: HTTP/HTTPS/SOCKS5 a través de
AGINXBROWSER_PROXY - Sitios con control de riesgo difícil: Baidu Wenku no compatible; los artículos de Zhihu necesitan un
__zse_ckválido
Historial de estrellas
Si AginxBrowser te ahorró una flota de headless-Chrome o un dolor de cabeza con el scraping, una estrella es cómo otros agentes (y sus humanos) encuentran el proyecto.
Licencia
Apache-2.0.