Longhand
Memoria local persistente para Claude Code, cero llamadas a API, cero resúmenes, cero IA decidiendo qué es importante.
Documentación
Longhand
¿También usas Codex? Comparte un archivo de memoria entre Claude Code y Codex.



Memoria local persistente para Claude Code. Cada llamada a una herramienta, cada edición de archivo, cada bloque de pensamiento de cada sesión de Claude Code — almacenado textualmente en tu máquina. Buscable, reproducible y recuperable mediante preguntas difusas en lenguaje natural. Cero llamadas a API. Cero resúmenes. Cero decisiones tomadas por una IA sobre qué vale la pena recordar.
Claude Code rota silenciosamente tus archivos de sesión después de unas semanas. Longhand los captura en SQLite antes de que desaparezcan. Una vez ingeridos, tu historial permanece para siempre — incluso después de que los archivos JSONL de origen se eliminen. Instala temprano; el pasado que no capturas es irrecuperable.
Si tienes 20 o más sesiones de Claude Code en
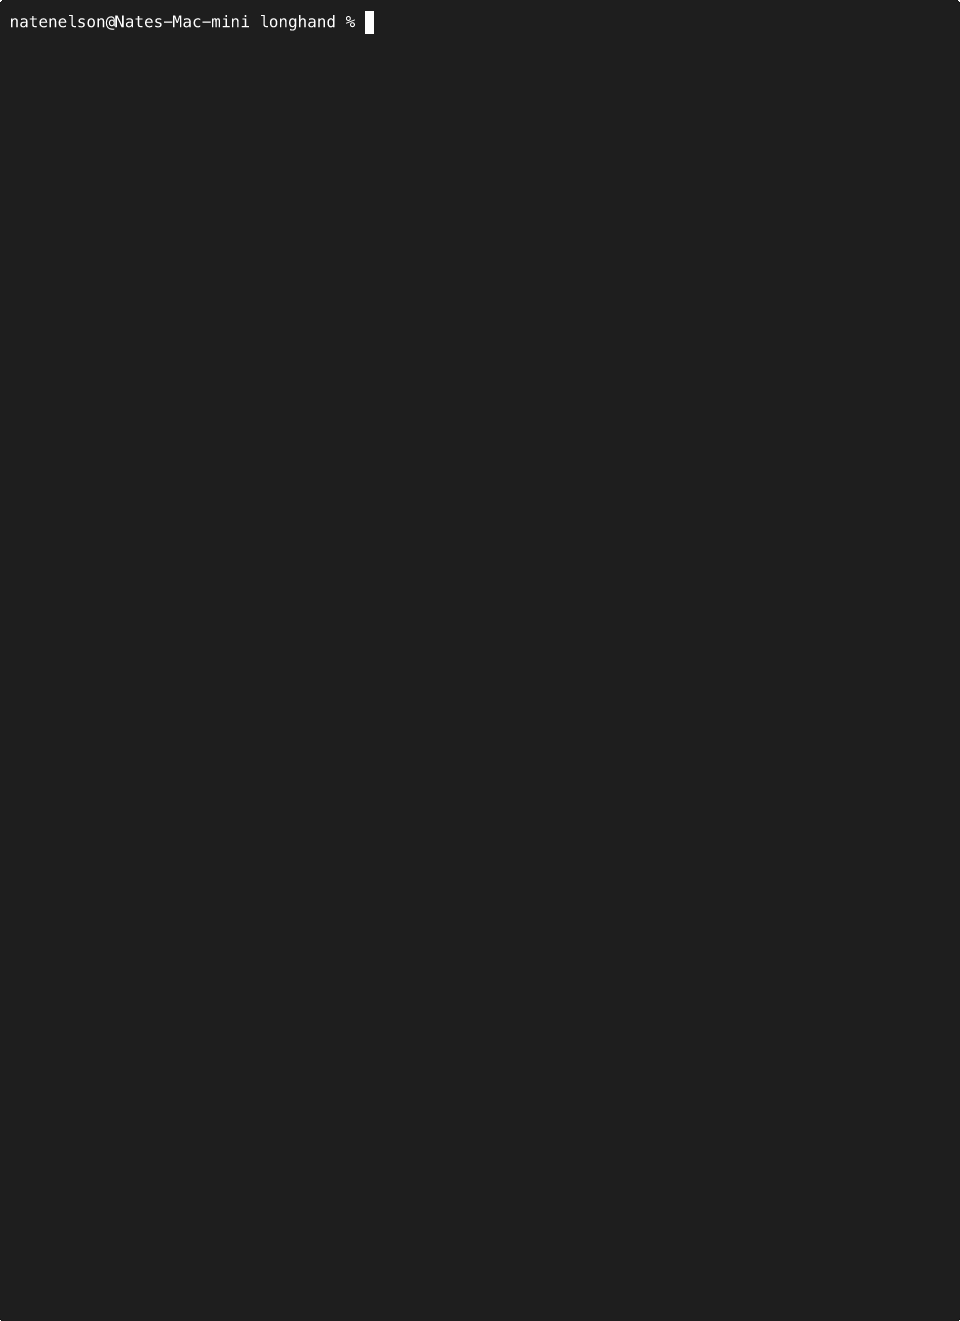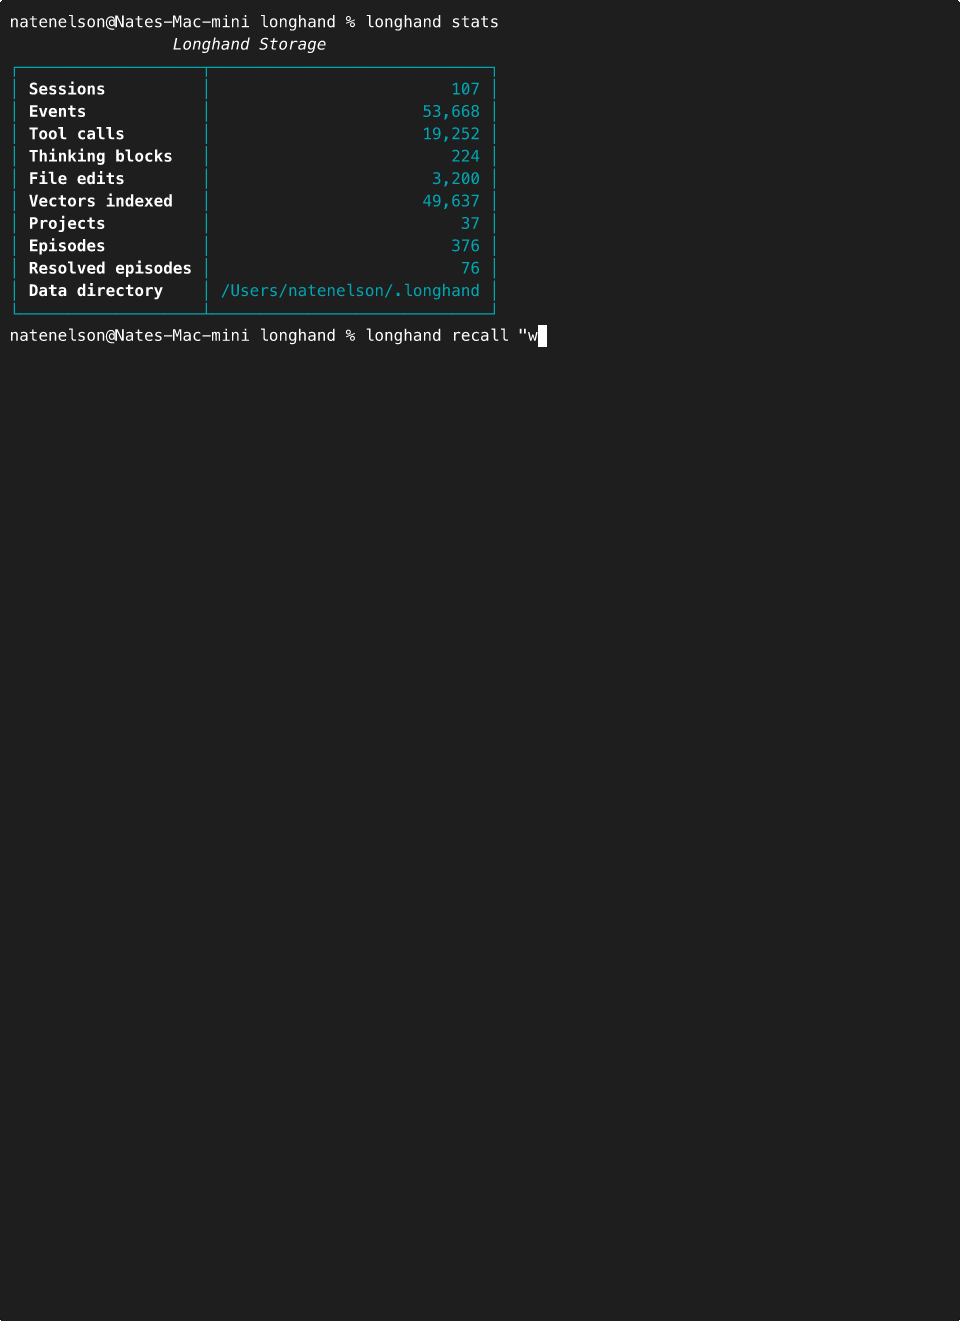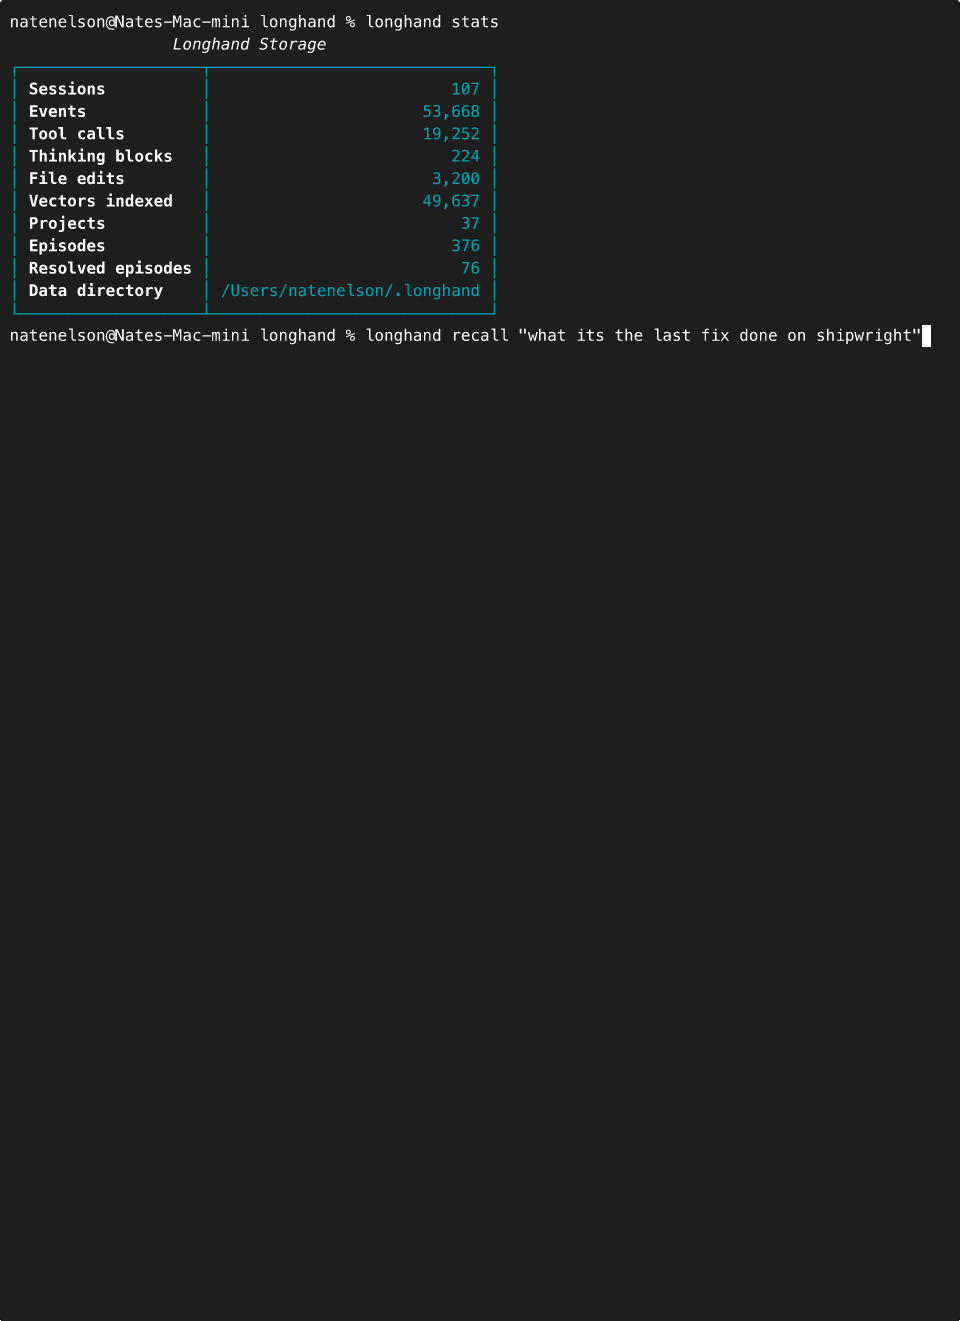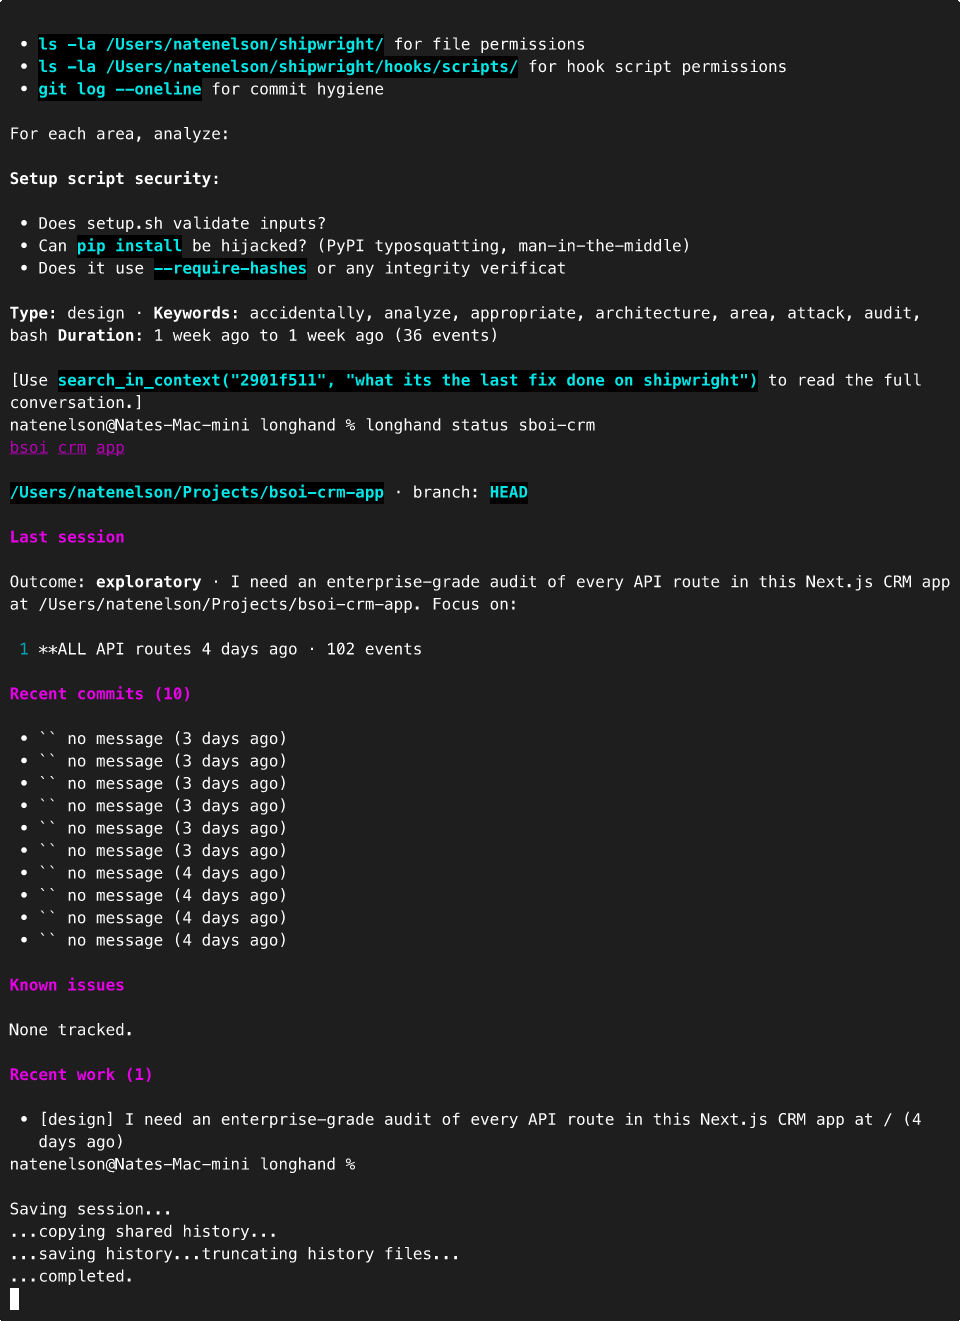
~/.claude/projects/, Longhand puede buscar en cada corrección, decisión y conversación que has tenido en ~29ms — sin una sola llamada a la API.
¿Usa muchos tokens? No — las herramientas que usarás más están limitadas por diseño. Un
recallcompleto en más de 100 sesiones devuelve ~4K tokens. Leer un JSONL de sesión crudo cuesta 10–50× más. Consulta Presupuesto de tokens para ver qué herramientas limitan la salida y cuáles no.
pip install longhand
longhand setup        # ingest history + install hooks + configure MCP
longhand recall "that stripe webhook bug from last week"
¿Quieres probarlo primero? Ejecuta longhand demo para un recorrido de 60 segundos en un corpus de muestra falso de 3 sesiones — tu ~/.claude y ~/.longhand reales no se tocan. La demo siembra un almacén aislado con un bug de webhook de Stripe + migración de autenticación de Supabase + corrección de 401 posterior, y luego ejecuta recuperación entre sesiones y estado del proyecto para que veas cómo se ve la salida antes de comprometerte.
pip install longhand
longhand demo         # sandboxed; cleans up afterwards (pass --keep to explore)
¿Actualizando a 1.0.0? Esta es la versión que cierra la ventana de deprecación que abrió 0.13. Todo lo eliminado aquí ha estado advirtiendo desde 0.13.0:
- Cuatro alias de CLI han desaparecido:
patterns→recall "<topic>",recap→status --days N,continue→status --session <prefix>,reanalyze→analyze --all. - La herramienta MCP
reconcileahora usa una ejecución de prueba por defecto. Si tienes un bucle de agente que dependía de la corrección implícita, pasafix=trueexplícitamente. Las ejecuciones de prueba te lo indican en la carga útil. - Seis herramientas MCP retiradas salieron de la lista (19 → 13) pero siguen respondiendo para siempre con una nota de migración — los nombres retirados viven en los archivos
CLAUDE.mdde los propios usuarios y nunca deben fallar de forma dura. - Nuevo: COMPATIBILITY.md establece qué garantiza 1.x y qué no.
Tu base de datos no necesita nada. Las migraciones son automáticas y un almacén 0.11+ se abre en cualquier 1.x posterior — esa es la Promesa 2, y hay un fixture real de esquema 0.11 en la suite de pruebas que lo demuestra.
¿Actualizando a 1.2.x? Sin eliminaciones, solo correcciones que vale la pena conocer:
- 1.2.3: El
taildeget_session_timelinede MCP ahora devuelve los últimos N eventos reales en sesiones de más de 5,000 eventos — antes devolvía el medio. La pista de cierre desetupdejó de sugerirrecap(eliminado en 1.0) y ahora sugierestatus --days 7. Los pies de página de Recall y la propia descripción de herramienta deget_session_timelinedejaron de nombrar asearch_in_context(retirado de la lista de herramientas en 1.0, aunque todavía responde) y ahora apuntan asearch— los pies de página detallan la llamada,search(session_id=…, query=…, context_events=5). - 1.2.2:
recalllo indica cuando su mejor coincidencia es mucho más antigua que las alternativas en lugar de dejar que una corrección obsoleta se lea como actual (ver Ejemplo de Recall). Un registro de compactación de contexto de Codex (compacted) ya no activa la advertencia de desviación de formato de transcripción dedoctor. - 1.2.1:
get_session_timelinede MCP tenía un bug de centinela que hacía que cada llamada devolviera exactamente un evento, ignorandolimit/offset, a menos quetailse pasara explícitamente — corregido. El auto-ámbito de proyecto desearchya no anula unsession_idexplícito.
¿Actualizando a 0.13.0? Nada se rompe — esa versión abrió la ventana de deprecación de v1.0, así que cada nombre antiguo siguió funcionando mientras apuntaba a su reemplazo:
statuses ahora el único comando de reanudación:statussimple = resumen reciente (antesrecap),status <project>sin cambios,status --session <prefix>= cola de sesión (antescontinue). Los comandos antiguos aún se ejecutan e imprimen un puntero; se eliminan en v1.0.- Seis herramientas MCP se fusionaron en seis supervivientes con parámetros idénticos (
search_in_context→search+context_events,get_episode→find_episodes+episode_id, etc. — tabla completa en el CHANGELOG). Los nombres retirados aún responden, con un prefijo de nota de migración. - Los hooks ya no pueden salir con código distinto de cero — los fallos se convierten en migas de pan en
~/.longhand/logs/y dos nuevas filas dedoctor(Hook errors,Transcript format) los mantienen visibles. - Las ventanas de recuperación "Hoy"/"Ayer" ahora siguen tu día calendario local en lugar del UTC; las clasificaciones pueden cambiar una vez si no estás en UTC.
- Usuarios de Windows: esta versión corrige un bug grave donde la verificación de actividad del bloqueo de ingesta podía terminar otros procesos de longhand.
- Nuevo:
LONGHAND_DATA_DIRreubica el almacén para la CLI, los hooks y el servidor MCP en un solo movimiento — exceptolonghand config --set, que siempre escribe~/.longhand/config.jsonindependientemente del almacén reubicado (#96;--editactualmente es un no-op, mismo problema).status --json/doctor --jsonpara scripting.
¿Actualizando a 0.9.0? La ingesta en vivo captura sesiones en curso, el historial de planes se preserva como datos de primera clase, y un trabajo de reconciliación opcional mantiene el índice honesto en segundo plano:
- El nuevo comando
longhand ingest-livese ejecuta desde el hookStopde Claude Code para seguir la transcripción activa entre turnos del asistente. La sesión en curso se vuelve consultable inmediatamente mediantelist_sessions,get_session_timeline/timeline,get_file_historyyreplay_file— escribe solo eventos, sin incrustaciones, así querecally elsearchsemántico aún necesitan el pase de SessionEnd (o un pase dereconcile --fix, que re-ingiere con análisis) para verla. - El nuevo comando
longhand plans listy la herramienta MCPlist_plansexponen cada Write/Edit a~/.claude/plans/*.mden todo tu historial. Los planes ahora se extraen como su propia entidad junto a los episodios. - El nuevo
longhand schedule install-reconcilerinstala un trabajo launchd opcional que ejecutareconcile --fixperiódicamente — captura cualquier cosa que los hooks en vivo y post-sesión hayan omitido sin que tengas que pensar en ello. - El hook Stop coexiste con el hook SessionEnd existente: el en vivo sigue la transcripción mientras crece; SessionEnd hace el pase de análisis completo cuando la sesión se cierra.
¿Actualizando a 0.8.1? Las señales de obsolescencia ahora se propagan a donde pertenecen, y reconcile es una herramienta MCP — Claude puede auto-corregir el índice desde dentro de una sesión:
searchylist_sessionsahora envuelven la respuesta constale: true+stale_reasoncuando el proyecto al que están limitados tiene transcripciones en disco aún no ingeridas. Antes de v0.8.1 devolvían resultados vacíos de apariencia limpia (la misma forma de fallo silencioso querecall_project_statusfue construido para detectar — solo una capa más arriba).- La nueva herramienta MCP
reconcileenvuelvelonghand reconcile --fix. Después de que se dispara un banner de obsolescencia, Claude llama areconciledirectamente en lugar de pedir al usuario que ejecute un comando CLI. - El
limitpredeterminado delist_sessionsse elevó de 20 a 50 — los días activos cruzan rutinariamente 5+ proyectos en 5+ sesiones; el antiguo predeterminado truncaba las revisiones silenciosamente.
¿Actualizando desde 0.7.x o anterior? Narrativas de recuperación más limpias, más una capa real de pruebas de detección de bugs debajo (desde 0.8.0):
- El
_compose_fix_summaryanterior a v0.8 anteponía una etiqueta literal"Intent:"a la mitad de todos los episodios extraídos (49% del corpus de referencia). La etiqueta se filtraba en cada narrativa de recuperación para esos episodios. La migración v4 la elimina de las filas existentes en la primera apertura del almacén — no se necesita ningún comando. - El contenido de diff en
fix_summaryahora se trunca en los límites de espacios en blanco con un…visible, en lugar de caer a mitad de token (phoneNum',family?:',strin'). Solo hacia adelante. - Las líneas de pie de página "Otras coincidencias" de la narrativa ahora incluyen el id de sesión para que puedas profundizar.
- Nuevo arnés canario (
tests/fixtures/corpus/) ancla las pruebas de regresión a bugs reales enviados. Nuevo validador de recuperación (scripts/recall_diff.py) captura y compara resultados de clasificación contra tu corpus en vivo — detecta regresiones que pytest no puede ver.
pip install --upgrade longhand
longhand recall "..."   # migration runs transparently on first open
Si también vienes de 0.5.x, ejecuta longhand reconcile --fix una vez para re-atribuir sesiones multi-proyecto según las mejoras de inferencia de v0.6 (las sesiones de cd-en-proyecto ahora se atribuyen al proyecto donde ocurrió la mayor parte del trabajo, no al cwd del primer evento). Si estás en 0.5.8 o anterior, encadénalos: longhand reconcile --fix && longhand analyze --all. Ambos son idempotentes.
¿Historial grande? (>1 GB de ~/.claude/projects) Espera que el relleno inicial tome 10–30 minutos en una Mac clase M — la mayor parte de ese tiempo de pared es el modelo de incrustación ejecutándose en todos tus núcleos (por eso verás CPU de triple dígito; eso es ONNX haciendo su trabajo, no un cuelgue). --skip-analysis difiere el otro pase — extracción de episodios/segmentos y vectores a nivel de proyecto/sesión — no la incrustación de eventos, que siempre se ejecuta, así que recorta algo de tiempo pero no el costo dominante:
longhand setup --skip-analysis   # events stored + embedded; episodes/segments deferred
longhand analyze --all           # fill in episodes + segments + project/session vectors whenever, safe to background
search, líneas de tiempo, historial de archivos y búsqueda de commits funcionan inmediatamente después de --skip-analysis — cada evento se incrusta independientemente de esta bandera. La narrativa de episodios/segmentos de recall y recall_project_status necesitan que el pase de analyze --all tenga datos de los que extraer. El rendimiento típico en una Mac clase M es de ~1–2 sesiones/segundo para análisis completo.
Estado: v1.2.3 — estable, probado como controlador diario, auditado en seguridad (cero hallazgos críticos), en PyPI, disponible como plugin de Claude Code. Validado contra 792 sesiones reales (786 Claude Code, 6 Codex) en 45 proyectos inferidos (medido 2026-09-27). 617 pruebas unitarias pasando.
Documentación completa: Wiki de Longhand — inicio rápido, referencia de CLI, referencia de herramientas MCP, arquitectura y solución de problemas.
La Inversión
Todos están resolviendo la memoria de la IA haciendo la ventana de contexto más grande. 1M tokens. 2M tokens. Contexto infinito. Toda la industria corre en la misma dirección: hacer que el modelo cargue más estado.
Longhand va en la otra dirección. El modelo no necesita cargar la memoria. El disco lo hace.
| Ventanas de contexto más grandes | Longhand | |
|---|---|---|
| Dónde vive | Alquilado de un proveedor de modelos | Un archivo SQLite + ChromaDB en tu portátil |
| Costo por consulta | Tokens × dólares | Cero |
| Privacidad | Pasa por los servidores de alguien más | Nunca sale de tu máquina |
| Velocidad | Segundos a minutos para contextos grandes | ~29ms búsqueda · ~128ms recuperación completa (caliente; ver Estadísticas) |
| Pérdida | La atención se degrada en medio de contextos largos | Nada se resume — mensajes, ediciones y bloques de pensamiento almacenados textualmente† |
| Persistencia | Muere cuando la ventana se cierra | Vive hasta que elimines el archivo |
| Entre versiones de modelo | No se transfiere | Mismos datos, cualquier modelo |
| Sin conexión | No | Sí |
| Escala con | El precio del proveedor | Tu disco duro |
† Nueve tipos de entrada de Claude Code (KNOWN_SKIP_ENTRY_TYPES) y, en el lado de Codex, tres tipos de registro de nivel superior (CODEX_SKIP_RECORD_TYPES) más diez tipos de event_msg (CODEX_SKIP_EVENT_MSG_TYPES: los espejos de interfaz de los mensajes canónicos y el registro de turnos) — en su mayoría contabilidad pura del arnés (marcadores de cola, pings de progreso, instantáneas de uso y estado) — se reconocen y se omiten en lugar de almacenarse. Eso no es exactamente "cero contenido descartado", sin embargo: uno de esos tipos, attachment, puede llevar un mensaje de seguimiento en cola en su propio campo attachment.prompt, y los registros de razonamiento cifrado y compactación de contexto (compacted) de Codex se descartan por completo. Todo lo demás con contenido real — cada mensaje ordinario, llamada de herramienta, edición de archivo y bloque de pensamiento — se conserva textualmente. |
La "crisis de memoria" en la IA fue una restricción artificial. El almacenamiento está resuelto. SQLite es del año 2000. ChromaDB es un almacén de vectores de código abierto maduro. Ambos funcionan en una laptop. Longhand evita la crisis ignorándola: tus sesiones pasadas ya están en el disco, escritas por el propio Claude Code, en archivos JSONL que contienen cada evento individual textualmente. Longhand lee esos archivos, los indexa localmente y te brinda recuperación semántica de todo tu historial sin enviar jamás un token a través de la API de otra persona.
Local. Completo. Tuyo.
Huella de almacenamiento: ~7.5GB para un usuario intensivo (792+ sesiones, 269k+ eventos, meses de uso diario de Claude Code en 45 proyectos inferidos — medido el 2026-09-27, ver Estadísticas). Usuarios típicos: 200–400MB. Una vez que Claude Code rota los archivos fuente fuera del disco, Longhand no es un duplicado: es la única copia.
Soporte de plataformas
Python 3.10 – 3.14 están totalmente soportados y controlados en CI — la protección de ramas requiere que la suite completa pase en las cinco versiones antes de que un PR se fusione (los administradores pueden omitirlo — ver CONTRIBUTING.md).
Longhand fija chromadb<1.0 para cada versión de Python, no solo 3.14. La fijación se originó con los enlaces Rust más nuevos de chromadb que fallaban con segfault en 3.14 (#4, ahora cerrado), y permanece hasta que un chromadb 1.x se verifique en toda la matriz.
Windows no está soportado. Usa WSL2. Una etapa de windows-latest × py3.12 se ejecuta en cada PR, pero es un paso de continue-on-error no bloqueante — y falla. 12 pruebas principales fallan en cada ejecución (idempotencia de instalación/desinstalación de hooks, rutas de archivos de configuración, redacción, conteo de líneas de ingesta en vivo, limpieza de demostración, y más — rastreado en #112), no casos límite intermitentes. El trabajo se muestra en verde en la interfaz de GitHub solo porque continue-on-error se traga el paso fallido; es recopilación de evidencia, no una afirmación de que Longhand funciona allí. Linux (3.10–3.14) es la única plataforma que CI realmente controla; no hay etapa de macOS. macOS es el sistema operativo diario del autor y donde se valida manualmente (ver Estadísticas), pero no se verifica de forma independiente en CI.
Dos cosas son específicas de macOS independientemente de la matriz de CI: schedule install-reconciler instala un trabajo de launchd y es una no operación en otros lugares (usa cron/systemd-user en Linux; en Windows, usa WSL2). mcp install también solo escribe la ruta de configuración de macOS de Claude Desktop (#105) — no hay una versión de Claude Desktop para Linux, y Windows no está soportado (#112); conectar un Claude Desktop de Windows a una instalación de WSL2 significaría editar manualmente su configuración para lanzar Longhand a través de wsl.exe, lo cual no está probado.
Codex Desktop y Codex CLI los hilos se capturan en el mismo archivo desde 1.1.0 — ver Funciona con Codex.
Compatibilidad
Longhand 1.0 hace cinco promesas, cada una respaldada por un artefacto de cumplimiento en el repositorio. El texto completo está en COMPATIBILITY.md; la versión corta:
- Superficie estable — CLI y MCP congelados hasta 1.x. Eliminaciones solo en una versión mayor, y solo después de advertir durante una versión menor completa.
- Compatibilidad de datos hacia adelante — una base de datos escrita por 0.11+ se abre en cualquier 1.x posterior. Las migraciones son automáticas, únicas, nunca renumeradas. El código más antiguo rechaza una base de datos más nueva de manera ruidosa en lugar de operar a ciegas.
- Garantías de hooks — los hooks nunca lanzan excepciones, nunca tocan la red, nunca bloquean tu mensaje.
- La deriva ascendente nunca es silenciosa — las entradas de transcripción desconocidas se conservan, se muestran en
doctor, y se controlan por regresión. - Métricas honestas — los conteos reflejan señales reales, y
doctornunca recomienda un remedio que no pueda funcionar.
Política de deprecación: cualquier cosa programada para eliminación advierte durante al menos una versión menor completa primero, y la advertencia nombra su reemplazo. Los nombres de herramientas MCP retirados son lo único que nunca desaparece — salen de la lista de herramientas pero siguen respondiendo para siempre con una nota de migración, porque esos nombres viven en los propios archivos CLAUDE.md de los usuarios.
Longhand vs claude-mem
thedotmack/claude-mem es la herramienta de memoria de Claude Code más popular en GitHub (55k+ estrellas). Es una buena herramienta. También está resolviendo el problema de memoria en la dirección opuesta a Longhand, y la diferencia vale la pena entenderla antes de elegir una.
| claude-mem | Longhand | |
|---|---|---|
| Qué se almacena | Resúmenes generados por IA / "observaciones" | Eventos textuales del JSONL crudo |
| Quién decide qué se conserva | Un LLM, en el momento de escritura | Nadie — ningún resumidor lo filtra |
| Compresión | Semántica (con pérdida, por diseño) | Ninguna (sin pérdida) |
| Llamadas API por sesión | Una o más (llama a Claude para resumir) | Cero |
| Bloques de pensamiento | Típicamente integrados en resúmenes | De primera clase, almacenados textualmente |
| Reproducción determinista | No — los resúmenes no pueden reconstruir el estado de archivos | Sí — cada diff se conserva y es reproducible |
| Portabilidad del modelo | Ligado a la salida del resumidor | Los mismos datos funcionan con cualquier modelo, para siempre |
| Tiempo de ejecución | TypeScript, Bun, trabajador HTTP en :37777 | Python, sin servidor |
| Licencia | AGPL-3.0 | MIT |
La división filosófica: claude-mem le pregunta a una IA qué fue importante y conserva eso. Longhand conserva los bytes reales y te deja decidir después. Si confías en el juicio de un modelo sobre su propio pasado, el enfoque de claude-mem es más barato en el momento de la consulta (pre-resumido) y más fácil en almacenamiento. Si alguna vez te ha quemado un resumen que omitió lo que resultó ser importante, Longhand es la herramienta que nunca tira nada.
Ambos pueden coexistir en la misma máquina — operan en los mismos archivos JSONL sin interferir.
Los Principios
Longhand se basa en un puñado de principios. Si no estás de acuerdo con ellos, probablemente quieras una herramienta diferente.
1. La información no desaparece — se mueve.
Cuando los datos "faltan", casi nunca están realmente perdidos. Se comprimieron, resumieron, archivaron en otro lugar o se renombraron. Encuentra la fuente cruda y la verdad todavía está allí esperando. Claude Code ya escribe cada sesión en el disco como JSONL. Ese archivo es la fuente cruda. Longhand solo lo lee.
2. Resumir es una decisión con pérdida disfrazada de conveniencia.
La mayoría de los sistemas de memoria de IA leen una conversación y le piden a la IA que escriba "lo que importaba". La IA ahora es la guardiana de su propia memoria, y la IA tiene incentivos — brevedad, confianza, coherencia — que no son los mismos que la verdad. Terminas con una historia sobre lo que pasó en lugar de lo que pasó.
Longhand nunca resume. Almacena el registro completo y te permite consultarlo.
3. El registro crudo es barato. Actuar como si no lo fuera lo desperdicia.
Un archivo JSONL completo de Claude Code es de kilobytes a pocos megabytes. Un año de sesiones diarias son cientos de megabytes. Eso no es nada en hardware moderno. No hay razón de ingeniería para tirar los datos. La memoria basada en resúmenes no está ahorrando espacio — está regalando información que era gratuita.
4. El pensamiento es la parte más valiosa.
Cuando Claude produce un bloque thinking, ese es el razonamiento detrás de la decisión — generalmente invisible para el usuario, casi siempre más útil que la respuesta final. La memoria basada en resúmenes tira los bloques de pensamiento porque son "internos". Longhand los trata como eventos de primera clase. "¿Qué estaba pensando cuando elegí usar una actualización condicional?" extrae el bloque de pensamiento textual que contiene la respuesta.
5. Una solución que no puedes reproducir es una solución que no conservaste.
Si arreglaste un error en marzo, el estado de ese archivo cuando se arregló el error es un hecho. Longhand lo reconstruye de manera determinista aplicando cada edición en secuencia desde el JSONL de la sesión. Sin adivinanzas, sin inferencia de IA, solo aplicación literal de los diffs. Puedes ver el estado exacto de cualquier archivo en cualquier punto de cualquier sesión pasada.
6. La memoria debe ser proactiva, no solo buscable.
Un archivo buscable es útil pero pasivo. La memoria real responde preguntas difusas. "Hace un par de meses estaba construyendo un juego que seguía rompiéndose, luego lo arreglaste — trae esa solución adelante." Longhand analiza la frase de tiempo, coincide con el proyecto, encuentra el episodio problema→solución, y devuelve el diff. No tienes que saber el ID de la sesión. Solo tienes que recordar que sucedió.
7. Lo determinista vence a lo ingenioso.
Todo en el análisis de Longhand se basa en reglas. Detección de errores con regex. IDs de proyecto basados en hash. Extracción de episodios con recorrido hacia adelante. Sin LLMs en el pipeline central. Eso significa rápido (~128ms de recuperación cálida mediana — medido el 2026-09-27, ver Estadísticas), reproducible (misma entrada → misma salida), y completamente local (sin claves API, sin nube). Una capa de LLM podría ir encima más tarde, pero la base funciona con leyes, no con la opinión de un modelo.
8. Local o nada.
Tu historial de Claude Code es tuyo. Va a un archivo SQLite y un directorio ChromaDB en ~/.longhand/. Sin telemetría. Sin sincronización. Sin cuenta. Si tu laptop está sin conexión, Longhand funciona. Si Anthropic se cae, Longhand funciona. Si eliminas el directorio, se ha ido.
Una excepción aburrida, divulgada por completo: el CLI interactivo verifica pypi.org para una versión más nueva de Longhand. La mayoría de los comandos respetan un caché de 24 horas e imprimen cualquier aviso solo después de su propia salida, para que nada de lo que esperas se retrase. doctor (y setup, que lo ejecuta) es la excepción — fuerza una búsqueda fresca y síncrona cada vez, con un tiempo de espera de 2 segundos, antes de imprimir su tabla. La solicitud no lleva nada más que sí misma — sin telemetría, sin identificadores, nada sobre tu corpus. Está excluida de los hooks de Claude Code y del punto de entrada mcp-server que mcp install realmente configura para Claude Desktop, pero aún no de longhand shared-mcp, mcp serve, o demo — esos actualmente ejecutan la misma verificación al salir como cualquier otro comando (#101). LONGHAND_NO_UPDATE_CHECK=1 apaga todo eso. "Cero llamadas API" significa lo que siempre significó: ningún LLM o servicio en la nube toca jamás tus datos.
Lo Que Realmente Hace
Cuando usas Claude Code, cada sesión escribe un archivo JSONL en ~/.claude/projects/<project>/<session-id>.jsonl. Ese archivo contiene cada mensaje, cada llamada de herramienta, cada bloque de pensamiento, cada edición de archivo con contenido completo antes/después, y una marca de tiempo precisa al milisegundo para cada evento.
Longhand lee esos archivos. Luego te da:
- Búsqueda semántica en cada evento que hayas generado
- Búsqueda filtrable — por herramienta, archivo, sesión, proyecto y tipo de evento — todos los filtros combinables (MCP
search; el comandosearchde la CLI tiene filtros de herramienta/archivo/sesión/tipo pero no de proyecto, y ninguno tiene filtro de rango de tiempo) - Arqueología de llamadas a herramientas — "muéstrame comandos Bash que tocaron Supabase" — ordenados por relevancia, no literalmente cada coincidencia; limita a una sesión o proyecto para reducir el ruido
- Historial de archivos entre sesiones — cada edición a un archivo específico, cronológicamente, en todas tus sesiones
- Reproducción de sesión — reconstruye el estado de cualquier archivo en cualquier punto de cualquier sesión pasada
- Recuperación de razonamiento — consulta los bloques de pensamiento verbatim de Claude
- Vista de línea de tiempo — reproducción cronológica con paginación (offset, tail, modo de escaneo solo-resumen)
- Recuerdo difuso — preguntas en lenguaje natural sobre trabajo pasado ("ese arreglo de condición de carrera de la semana pasada")
- Inferencia de proyectos — detección automática de en qué proyectos has trabajado, con categorías y alias
- Extracción de episodios — detección automática de secuencias problema→solución en tus sesiones
- Segmentos de conversación — agrupación por temas (historias, discusiones de diseño, depuración, planificación) para que el recuerdo encuentre el porqué, no solo el qué
- Recuerdo de proyectos consciente de Git — pregunta "¿dónde lo dejamos en X?" y obtén commits recientes, problemas sin resolver, resultado de la última sesión en una sola llamada
- Extracción de commits de Git — extracción estructurada de cada commit, push, merge, checkout de git de las sesiones, vinculados a episodios
- Servidor MCP — 13 herramientas que permiten a Claude consultar Longhand directamente durante conversaciones en vivo
- Hook de ingesta automática — se integra en el hook
SessionEndde Claude Code para que las nuevas sesiones se indexen automáticamente - Ingesta en vivo — el hook
Stop(instalado junto conSessionEndporhook install; no opcional por separado) sigue la transcripción activa entre turnos para que una sesión en curso sea consultable inmediatamente víalist_sessions, línea de tiempo, historial de archivos y reproducción. Almacena solo eventos, sin embeddings — la búsqueda semánticarecall/searchaún espera el pase deSessionEnd, o un pase dereconcile --fixpara recogerlo (el seguimiento en vivo nunca estableceproject_id, por lo que reconcile lo trata como si necesitara una re-ingesta completa) - Historial de planes — cada Write/Edit a
~/.claude/plans/*.mdse captura como una entidad de primera clase, consultable víalonghand plans listy la herramienta MCPlist_plans - Redacción de secretos (opt-in) —
longhand config --set redact.enabled=trueenmascara cadenas con forma de secreto (claves API, tokens, JWTs, contraseñas de BD) en la ingesta antes de que lleguen al índice;longhand redact --applyenmascara retroactivamente datos ingeridos anteriormente (consulta SECURITY.md para la brecha actual en la cobertura de mensajes de commit de git, #110) - Reconciliador en segundo plano — trabajo opcional de launchd (
longhand schedule install-reconciler) mantiene el índice honesto sin ejecuciones manuales dereconcile --fix - Inyección de contexto — el hook
UserPromptSubmitinyecta automáticamente contexto pasado relevante antes de que Claude vea tu mensaje (umbral y límite de presupuesto configurables); imprime la misma línea de brecha de edadNote: …querecallcuando el contexto inyectado es antiguo y parece obsoleto en relación con trabajo más reciente - Configurable —
longhand configpara ajustar la relevancia de inyección, el presupuesto de tokens y el comportamiento sin editar código
Instalación
pip install longhand
longhand setup
Eso es todo. longhand setup rellena tu historial existente de Claude Code, instala los hooks que lo mantienen actualizado automáticamente, registra Longhand como servidor MCP para Claude Desktop, imprime el comando de una línea para añadirlo a Claude Code (claude mcp add longhand -s user -- longhand mcp-server) y verifica que todo funciona. Unos dos minutos la primera vez, cero mantenimiento después.
Para actualizar más tarde: pip install -U longhand.
Instalación para desarrolladores (desde el código fuente)
git clone https://github.com/Wynelson94/longhand.git
cd longhand
pip install -e .
longhand setup
O ejecuta los comandos individuales tú mismo
longhand ingest                       # ingest all your existing Claude Code history
longhand analyze --all                # run analysis (projects, outcomes, episodes, segments)
longhand hook install                 # wires both SessionEnd and Stop hooks (installed together)
longhand prompt-hook install          # (optional) auto-inject past context into new prompts
longhand mcp install                  # register Longhand as an MCP server for Claude Desktop
claude mcp add longhand -s user -- longhand mcp-server  # ...and for Claude Code
longhand schedule install-reconciler  # (optional, macOS-only) launchd job to run reconcile --fix periodically
longhand config                       # view/tune hook behavior (relevance threshold, injection size)
longhand doctor                       # verify everything is wired up
longhand ingest-live no está en esta lista a propósito — es principalmente el punto de entrada oculto que llama el hook Stop (leyendo transcript_path del JSON de stdin), aunque también acepta --transcript <path> directamente si quieres ejecutarlo a mano.
Inicio rápido
# What's in the archive?
longhand stats
longhand sessions
longhand projects

# Daily-use commands — status is the single resume command (git-status shape)
longhand status                             # what have I been up to (recent digest)
longhand status --days 30 -p bsoi           # filtered digest
longhand status <project-name>              # where did we leave off on a project (git-aware)
longhand status --session <session-id>      # pick up where a session left off
longhand history src/app/route.ts           # every edit ever to a file
# (recap / continue / patterns / reanalyze were deprecated aliases through
#  0.13 and were removed at 1.0 — use status, recall, and analyze --all)

# Semantic search
longhand search "race condition"
longhand search "stripe webhook" --tool Edit
longhand search "why did we" --type assistant_thinking

# Proactive recall (the fun one)
longhand recall "that clerk type error I fixed a couple weeks ago"
longhand recall "the python missing module bug last month"

# Session inspection
longhand timeline <session-id-prefix>
longhand replay <session-id> /path/to/file.ts
longhand diff <event-id>

# Git history
longhand git-log                            # recent git operations across all sessions
longhand git-log <session-id>               # git ops in a specific session
longhand git-log --type commit              # only commits
longhand git-log --query "fix parser"       # search commit messages

# Export
longhand export latest-fix                  # most recent resolved episode
longhand export ep_<id> --out fix.md        # specific episode to file
longhand export <session-id-prefix>         # full session timeline

# Configuration
longhand config                             # show current hook settings
longhand config --set hook.min_relevance=3.0  # tune injection threshold
longhand config --set hook.max_inject_chars=1000  # cap token usage

# Plans + background maintenance
longhand plans list                         # every plan-mode plan you've written
longhand plans list --limit 100             # raise the row cap (default 50)
longhand schedule install-reconciler        # background launchd job (macOS); runs reconcile --fix
longhand reattribute                        # dry-run: find sessions attributed to the wrong project
longhand reattribute --fix                  # apply the moves (idempotent)
longhand db vacuum --prune-aux              # reclaim disk space; --prune-aux deletes ALL event_type='unknown' rows —
                                             #   not just harness noise, but doctor's drift records and the deliberately
                                             #   preserved summary/pr-link/worktree-state/frame-link rows too
Los IDs de sesión aceptan coincidencias de prefijo — longhand timeline cf86 es suficiente si solo una sesión comienza con eso.
Ejemplo de recuerdo
$ longhand recall "that stripe webhook I was fixing"

╭─ Project matches ───────────────────────────────────────╮
│ new-product (nextjs web app) · alias: 'stripe' · 1.52   │
╰─────────────────────────────────────────────────────────╯

You asked: that stripe webhook I was fixing

Found it: new-product · 2 weeks ago · session a4ba29d1

### What went wrong
Type error: Property 'current_period_end' does not exist on type 'Subscription'.

### How it was diagnosed
En las definiciones de tipos de Stripe, current_period_end se movió fuera de la interfaz Subscription. Sigue en el payload real de la API pero los tipos no lo exponen. Necesitamos hacer un cast a través de Record<string, unknown> para acceder a él.
### The fix
Edit on route.ts: 'const periodEnd = sub.current_period_end' → 'const periodEnd
= (sub as Stripe.Subscription & Record<string, any>).current_period_end as number'

Diff:
- const periodEnd = sub.current_period_end
+ const periodEnd = (sub as Stripe.Subscription & Record<string, any>).current_period_end as number

✓ Verified — a test or command succeeded after the fix.

Other candidates (4)
• 2 weeks ago: Type error: Module '"@/lib/utils"' has no exported member 'getInitials'.
• 2 weeks ago: Type error: Property 'role' does not exist on type 'User'.
Eso es un comando local. Sin llamada a API. La solución vino de un archivo de sesión que Claude Code escribió en tu disco hace semanas y Longhand había estado esperando con la respuesta todo ese tiempo.
Dos cosas no mostradas arriba. Primero, la advertencia de brecha de edad se activa solo cuando la mejor coincidencia tiene al menos 30 días y al menos 30 días más antigua que el subcampeón más reciente, sin frase de tiempo en la consulta — no solo "semanas más antigua". Cuando se activa, aparece una línea justo después de "Found it:" — Older than the other matches — the best match is from 6 months ago, but newer related work exists from 2 months ago. If you meant current work, add a time phrase like "this week" or "this month". La clasificación no cambia; es una advertencia, no un reordenamiento. Segundo, cuando un candidato proviene de segmentos de conversación en lugar de un episodio limpio, su pie de página nombra la llamada de seguimiento exacta con el ID de sesión real completado: search(session_id="a4ba29d1", query="...", context_events=5). El pie de página más débil "Also possibly relevant" (lo que muestra el recuerdo de episodios cuando existen segmentos en otras sesiones) actualmente imprime esa misma forma de llamada con un marcador literal session_id="<session>" en su lugar — copia el ID real de la viñeta de arriba.
Integración MCP
Las 13 herramientas de Longhand son las mismas independientemente del cliente; cómo registras el servidor difiere.
Claude Code:
claude mcp add longhand -s user -- longhand mcp-server
O instala el plugin de Claude Code (incluye el .claude-plugin/plugin.json de este repositorio y un .mcp.json empaquetado que registra el servidor por ti) — consulta la documentación del marketplace/plugin para el flujo de instalación actual. longhand setup el paso 4 imprime el comando claude mcp add de arriba; no lo ejecuta por ti.
Claude Desktop: ejecuta longhand mcp install para conectar Longhand en la configuración de Claude Desktop (longhand setup también hace esto, a menos que --skip-mcp). Esto escribe solo el archivo de configuración de Claude Desktop — no tiene efecto en Claude Code.
Después de reiniciar el cliente, tiene trece herramientas:
Núcleo (archivo consultable):
search— búsqueda semántica con filtros de sesión, proyecto, herramienta, archivo y tipo de evento (todos combinables); pasacontext_eventscon unsession_idpara obtener cada coincidencia envuelta en su conversación circundante. Cuando el texto de la consulta nombra un proyecto y no se da ningúnproject_id/project_name/session_idexplícito, los resultados se limitan automáticamente a ese proyecto (el payload se convierte en{auto_scoped_to, auto_scope_hint, hits}) — pasa unsession_idexplícito para suprimirlo, o un filtro de proyecto para hacer el alcance deliberado; actualmente no hay otra anulación (#102)list_sessions— sesiones recientes con filtros de proyecto/tiempo; pasaproject_id(mássince/untilopcionales) para una línea de tiempo de sesión de un proyecto enriquecida con resultadosget_session_timeline— vista cronológica con paginación offset/tail y modo de escaneo solo-resumen (tail: Ncubre "los últimos eventos / cómo terminó")replay_file— reconstruye el estado de un archivo en un punto en el tiempoget_file_history— cada edición a un archivo en todas las sesionesget_stats— estadísticas de almacenamiento (su descripción actualmente promete un campodata_dirque no devuelve — #106)
Memoria proactiva:
recall— recuerdo difuso en lenguaje natural (usa esto primero): una narrativa construida a partir de segmentos de conversación y líneas de tiempo de sesión, con episodios problema→solución de alta precisión cuando el trabajo dejó evidencia clara. Desde 1.2.2, una consulta sin tiempo cuya mejor coincidencia tiene 30+ días y 30+ días más antigua que el subcampeón más reciente recibe una nota inicial diciéndolo (la clasificación no cambia) — añade una frase de tiempo para omitir la verificaciónrecall_project_status— "¿dónde lo dejamos en X?" — resumen de proyecto consciente de Git con commits, problemas, último resultadofind_episodes— búsqueda estructurada de pares problema→solución; pasaepisode_idpara detalle completo de un episodio (eventos referenciados, diff, estado del archivo post-solución)list_projects— explora proyectos inferidos; pasamatchpara candidatos difusos con razones puntuadaslist_plans— cada Write/Edit a~/.claude/plans/*.mden todo tu historial
Historial de Git:
find_commits— búsqueda en todas las sesiones por mensaje de commit, prefijo de hash o nombre de rama; o pasa unsession_idsin consulta para la historia cronológica de git de una sesión
Autocuración:
reconcile— envuelvelonghand reconcilepara que Claude pueda re-atribuir y re-ingerir desde dentro de una sesión después de un banner de obsolescencia; por defecto es una ejecución de prueba (pasafix=truepara aplicar — ese valor por defecto cambió en v1.0)
Salió de la lista de herramientas en v1.0, aún responde para siempre con un preámbulo de migración: search_in_context → search(context_events) · get_latest_events → get_session_timeline(tail) · get_project_timeline → list_sessions(project_id) · get_session_commits → find_commits(session_id) · get_episode → find_episodes(episode_id) · match_project → list_projects(match)
El límite de salida es desigual, no universal: search, get_session_timeline, recall, recall_project_status y find_commits aceptan max_chars (pasa 0 o un negativo para desactivarlo, aunque rara vez es lo que quieres); list_sessions y list_projects truncan a 16,000 caracteres fijos solo en sus modos predeterminados — list_sessions(project_id=…) y list_projects(match=…) están en la ruta sin límite de abajo; get_file_history, replay_file, get_stats, find_episodes (su modo de lista devuelve hasta limit — predeterminado 20, máximo 1000 — no un episodio; solo el modo de detalle episode_id está limitado a uno), list_plans y reconcile devuelven lo que produzca la consulta, sin límite (#103). Consulta Presupuesto de tokens para el desglose completo.
Una vez instalado, puedes preguntarle a Claude cosas como "¿qué decidimos sobre el middleware de autenticación en la sesión de la semana pasada?" y realmente buscará su propio trabajo pasado.
Ingesta automática
longhand hook install añade dos hooks a ~/.claude/settings.json — Stop para seguimiento en vivo entre turnos, SessionEnd para el pase de análisis completo al cierre de la sesión. Ambos se instalan juntos; no hay bandera para añadir uno sin el otro. El instalador resuelve longhand a su ruta absoluta y envuelve cada comando en el esquema de hooks de Claude Code:
{
  "hooks": {
    "Stop": [
      {"matcher": "", "hooks": [{"type": "command", "command": "/abs/path/to/longhand ingest-live"}]}
    ],
    "SessionEnd": [
      {"matcher": "", "hooks": [{"type": "command", "command": "/abs/path/to/longhand ingest-session"}]}
    ]
  }
}
Ambos comandos leen transcript_path del JSON de stdin del hook, por lo que no se necesitan banderas en la entrada del hook en sí.
- Hook de detención (
ingest-live) se ejecuta después de cada turno del asistente. Lee el archivo de transcripción y almacena nuevos eventos (además del emparejamiento de llamadas a herramientas y estadísticas de sesión) de forma incremental, de modo que una sesión en curso se pueda consultar mediantelist_sessions, la línea de tiempo, el historial de archivos y la reproducción mientras aún trabajas en ella. Nunca incorpora, por lo que la semánticarecall/searchaún necesita el paso deSessionEnd— o un paso dereconcile --fix, que vuelve a ingerir con análisis completo, ya que una sesión con seguimiento en vivo nunca recibió unproject_idy cae en el bucket denull_projectdel reconciliador. Un fallo aquí es silencioso por diseño — sin stdout, sin breadcrumb — ya que nunca debe arriesgarse a interrumpir tu turno;SessionEndyreconcileson el respaldo. - Hook de fin de sesión (
ingest-session) se ejecuta una vez cuando una sesión se cierra. Realiza el paso de análisis completo: inferencia de proyectos, resultados, episodios, segmentos, incrustaciones. Un fallo aquí imprime una línea en stderr y deja un breadcrumb enlogs/hook-errors-YYYY-MM-DD.log(superficie pordoctor), y luego sale con 0.
Ambos son no bloqueantes y se ejecutan en uno o dos segundos. No tienes que pensar en ninguno de ellos de nuevo.
Reconciliador de fondo opcional: longhand schedule install-reconciler agrega un plist de launchd que ejecuta reconcile --fix en un horario. Captura sesiones que los hooks omitieron si la transcripción aún está en disco — reconcile enumera desde ~/.claude/projects/, por lo que una transcripción que Claude Code ya ha rotado es invisible para él, igual que cualquier otra herramienta aquí.
Funciona con Codex
¿Usas también Codex Desktop o la CLI de Codex? Longhand captura esos hilos en el mismo archivo, de modo que una pregunta hecha en Claude Code puede responderse desde el trabajo realizado en Codex, y viceversa.
pip install -U longhand
longhand codex-sync                                                  # capture Codex threads on this machine (up to 50/run)
claude mcp add --scope user longhand-shared -- longhand shared-mcp   # keyword search across both clients, from Claude
codex mcp add longhand -- longhand shared-mcp                        # the same server from Codex (Desktop: config.toml, see the docs)
A partir de entonces, reconcile --fix también captura nuevos hilos de Codex, por lo que un reconciliador programado mantiene ambos clientes actualizados. Un hilo se almacena solo con registro exacto mientras se escribe — verbatim y buscable, sin modelo cargado — y recibe el pipeline completo 30 minutos después de que se quede en silencio, de modo que recall lo ve sin que vuelvas a ejecutar nada, siempre que algo esté sondeando en un horario (el reconciliador de launchd, un bucle de codex-sync --watch, o la plantilla de launchd de codex-sync a continuación) — codex-sync --semantic ejecuta el pipeline completo inmediatamente si nada lo hace. Los hilos que Codex genera para sí mismo se omiten por defecto, los espejos de UI nunca se almacenan dos veces, y las formas de registro desconocidas aparecen en doctor como cualquier otra deriva. Configuración, límites y la plantilla de launchd de macOS: docs/codex.md.
Arquitectura
longhand/
├── parser.py           — JSONL → typed Events (a short list of known harness-bookkeeping entry types is skipped, not stored)
├── codex.py            — Codex rollout capture + 30-minute-quiet finalizer, shared archive
├── replay.py           — deterministic file state reconstruction
├── redaction.py        — opt-in secret-shaped-string masking
├── update_check.py     — best-effort pypi.org freshness check (most commands; the hooks and the hidden `mcp-server` are excluded)
├── types.py            — Pydantic models
├── storage/
│   ├── migrations.py      — version-aware schema evolution
│   ├── sqlite_store.py    — structured data + full raw JSON preserved
│   ├── vector_store.py    — ChromaDB: events, sessions, projects, segments, episodes (5 collections)
│   └── store.py           — unified ingest pipeline
├── extractors/         — per-event (errors, file refs, topics, git ops)
├── analysis/           — per-session (project, outcomes, episodes, embeddings)
├── recall/             — per-query (time parsing, project match, narrative)
├── demo/               — sandboxed sample corpus for `longhand demo`
├── cli/                — Typer CLI with Rich output (`_commands.py`, `helpers.py`)
├── mcp_server.py       — Model Context Protocol server (13 tools)
├── lightweight_mcp.py  — `longhand-shared`: 4-tool keyword-only server, no model loaded
└── setup_commands.py   — hook install, mcp install, config, doctor
Fuente de verdad: SQLite. Cada JSON crudo de evento se conserva como un blob. ChromaDB es el índice de búsqueda — solo contiene lo necesario para la recuperación semántica.
Capa de análisis: Se ejecuta en el momento de la ingesta, no en el de la consulta. Precalcula proyectos, resultados de sesión y episodios para que las consultas de recuerdo sean rápidas. Totalmente determinista, sin LLM.
Pipeline de recuerdo: query → time parse → project match → episode search → rank → load artifacts → narrative. Una llamada completa de recall realiza varias búsquedas vectoriales (eventos, proyectos, episodios, segmentos, más reintentos de relajación), luego carga artefactos y compone la narrativa. Medido el 2026-09-27 en el corpus en vivo del autor, cálido y en proceso (ver Stats): una sola búsqueda vectorial es ~29ms de mediana; una llamada completa de recall es ~128ms de mediana.
Comparación
| Longhand | Basado en resúmenes (Mem0, MemPalace, LangMem) | |
|---|---|---|
| Fuente | JSONL crudo de Claude Code | Resúmenes generados por IA |
| Llamadas a herramientas capturadas | Cada una, verbatim | Lo que el resumidor conservó |
| Ediciones de archivos | Diffs completos antes/después | Generalmente no capturadas |
| Bloques de pensamiento | Eventos de primera clase | Generalmente descartados |
| Reproducción de estado de archivos | Determinista | No posible |
| Extracción problema→solución | Basado en reglas, en la ingesta | Depende del resumidor |
| Recuerdo difuso | Sí, con artefactos | Búsqueda de texto sobre resúmenes |
| Qué se "decide" | Nada — almacena todo | La IA decide qué importa |
| Local-first | Sí | La mayoría |
| Completitud | Cada mensaje, edición y bloque de pensamiento, verbatim† | Lo que el resumidor conservó |
| Llamadas LLM para funcionar | Cero | Varía |
La memoria basada en resúmenes y Longhand resuelven problemas diferentes. La memoria basada en resúmenes es buena para asistentes personales a largo plazo que necesitan contexto comprimido en muchas conversaciones. Longhand es bueno para desarrolladores que necesitan acceso forense a su trabajo pasado con Claude Code — el tipo de acceso donde necesitas el diff exacto, no una paráfrasis.
Estadísticas
Corpus, medido el 2026-09-27 contra el almacén en vivo del autor (Apple M4, macOS, código en main):
- 792 sesiones (6 de ellas de Codex)
- 269,067 eventos
- 45 proyectos inferidos automáticamente
- 1,809 episodios de problema→solución extraídos
- 6,632 segmentos de conversación (diseño, historia, depuración, discusión, planificación)
- 3,723 operaciones de git extraídas
- Huella de almacenamiento: 5.9 GB SQLite + 1.6 GB ChromaDB
Latencia, comparada en el mismo corpus y fecha — cálido, en proceso, las 8 consultas de scripts/recall_diff:
recall(pipeline completo): ~128ms de mediana (16 ejecuciones)- Búsqueda vectorial: ~29ms de mediana (24 ejecuciones)
- Lectura de línea de tiempo SQL: ~1.6ms de mediana (24 ejecuciones)
- Primera llamada de
recallen un proceso nuevo (carga de modelo + índice, arranque en frío): ~0.6s
Presupuesto de tokens
La pregunta más común: ¿Longhand consume muchos tokens cuando Claude lo usa?
Mayormente no — pero el límite no es universal, así que lee esta tabla. Cinco de las 13 herramientas truncan su salida y agregan una pista de paginación antes de que Claude la vea; dos más limitan a un tamaño fijo, pero solo en su modo predeterminado; seis devuelven lo que la consulta produce, sin límite (#103). En la práctica, get_file_history/replay_file están naturalmente limitados a un archivo (aunque un historial de ediciones largo o un archivo grande aún pueden volver grandes); find_episodes es el que hay que vigilar — su modo lista predeterminado no tiene alcance natural y puede devolver hasta limit (máx. 1000) filas de episodios completas sin límite, mientras que solo su modo detalle de episode_id está limitado a un solo episodio.
| Herramienta | Límite de salida predeterminado | ¿Ajustable? |
|---|---|---|
search | 12,000 caracteres | max_chars |
search en modo contexto (context_events) | 20,000 caracteres | max_chars |
get_session_timeline | 16,000 caracteres | max_chars |
recall, recall_project_status | 16,000 caracteres | max_chars |
find_commits | 12,000 caracteres | max_chars |
list_sessions, list_projects (modo predeterminado) | 16,000 caracteres | no — fijo |
list_sessions(project_id=…), list_projects(match=…) | ninguno | no — sin límite |
get_file_history, replay_file, get_stats, find_episodes, list_plans, reconcile | ninguno | no — sin límite |
Tope en el parámetro max_chars (MAX_OUTPUT_CHARS) | 200,000 caracteres | pasa 0 o negativo para deshabilitar el truncamiento por completo |
Por qué esto importa — la comparación:
- Leer un JSONL de sesión cruda directamente: 50K–200K tokens por sesión (las sesiones de Claude Code suelen tener 1–5MB cada una).
- Enfoques de ventana de contexto más grande: cada prompt paga el historial completo, cada vez.
- Herramientas de memoria basadas en resúmenes: baratas por consulta, pero ya descartaron los bloques de pensamiento.
Longhand tiene costo plano: el límite es por llamada, no por corpus. Recordar en 10 sesiones y recordar en 1,000 sesiones vuelven en el mismo sobre de tokens. Y Longhand en sí mismo hace cero llamadas API — los únicos tokens consumidos son el payload de MCP que Claude lee. No hay LLM entre tú y tus datos.
Ajuste: las cinco herramientas listadas arriba aceptan un parámetro max_chars que se puede reducir por llamada. summary_only: true en get_session_timeline elimina el campo content y reduce los payloads ~10×.
617 pruebas unitarias pasando, cubriendo el listado y despacho de las 13 herramientas MCP (solo el manejador de list_plans no se prueba por separado con llamadas). Auditoría de seguridad completa: cero hallazgos críticos, cero hallazgos altos. ~/.longhand/ se crea con permisos 0700 en la ruta principal de apertura del almacén (varias rutas de escritura temprana aún no aplican ese modo — #99); todo SQL está parametrizado; todas las entradas están limitadas. Dependencias: chromadb, posthog, typer, rich, pydantic, mcp.
Autor
Nate Nelson. Idaho Falls. Sin título en ciencias de la computación. Catorce industrias de construir software describiendo lo que veo y dejando que la traducción ocurra.
GitHub: Wynelson94
Licencia
MIT. Haz lo que quieras con ello.