Flama
El framework de producción para IA Predictiva y Generativa. Sirve cualquier modelo como API en una línea, con endpoints compatibles con OpenAI/Anthropic/Ollama, una interfaz de chat integrada y MCP nativo.
Documentación
Ilumina tus modelos 🔥


Flama
El framework de producción para IA predictiva y generativa.
Convierte cualquier modelo en una API de producción con una sola línea de código. Sirve modelos predictivos y generativos sobre un núcleo impulsado por Rust, y expón tus herramientas a agentes de IA mediante el Protocolo de Contexto de Modelos (MCP).
Flama es el framework para Aplicaciones Ligeras, Modelos de inteligencia artificial y Automatización. Empaqueta un modelo de cualquiera de los frameworks principales en un formato portátil único (el archivo .flm), de modo que cada modelo se ve igual para tu API sin importar de dónde provenga, y lo sirve por HTTP en segundos.
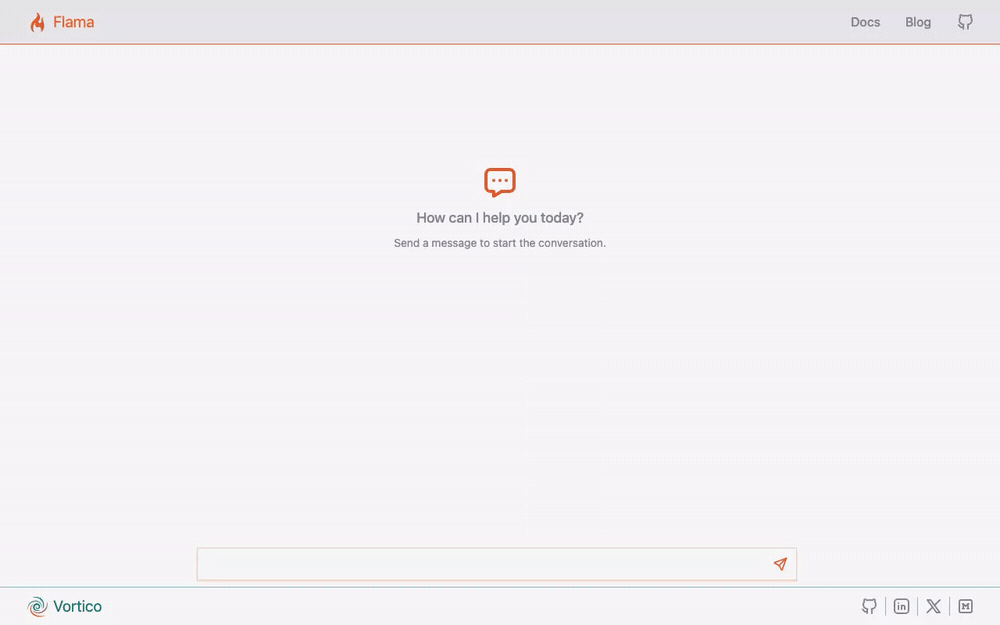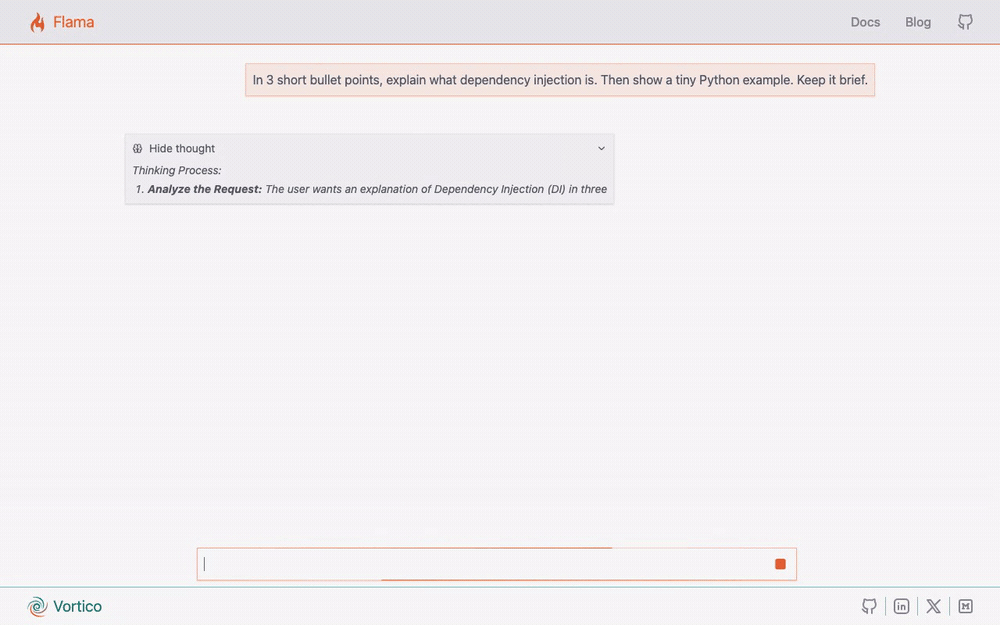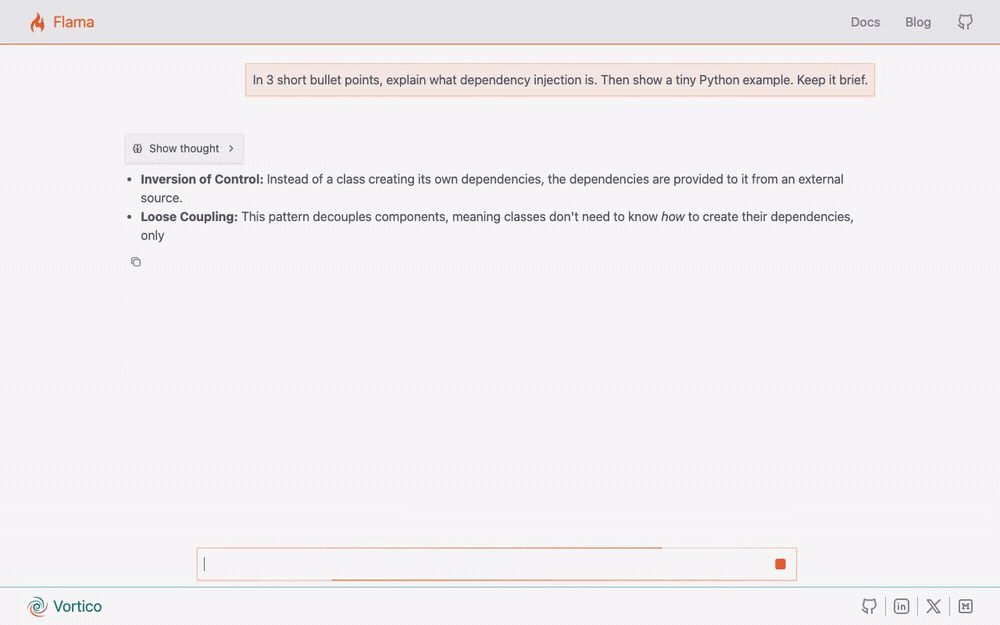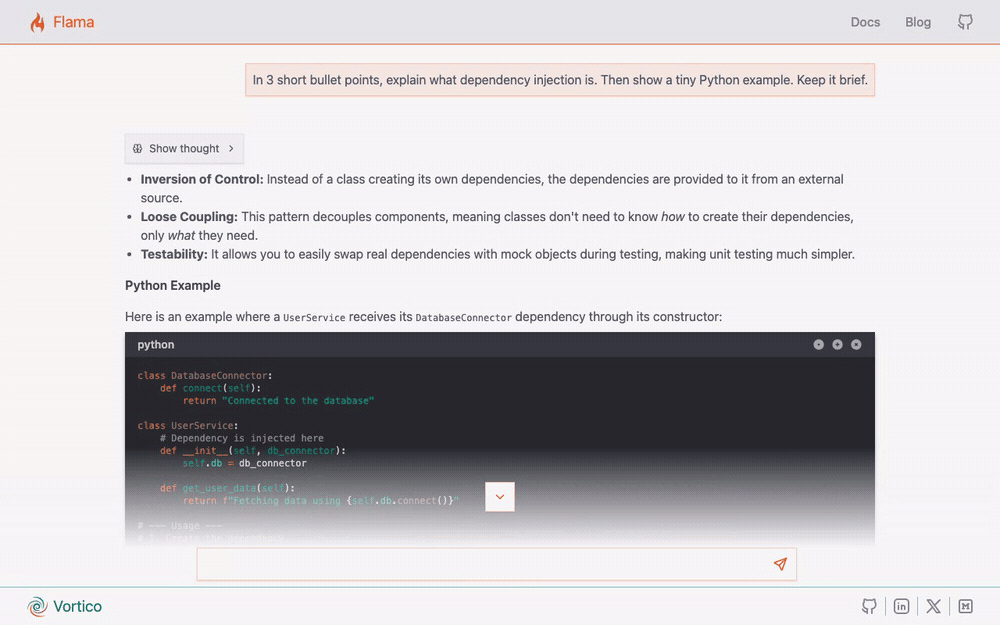
- 📦 Cualquier framework, un solo formato. Empaqueta scikit-learn, TensorFlow, PyTorch o un LLM en un artefacto portátil
.flm. - ⬇️ Modelos bajo demanda. Descarga y empaqueta cualquier modelo del HuggingFace Hub con un solo comando.
- 🤖 Servicio de IA generativa. Sirve LLMs con endpoints compatibles con OpenAI, Anthropic y Ollama, lado a lado.
- 💬 Chatbot listo para usar. Cada modelo servido incluye una interfaz de chat en streaming pulida en
/chat/, con Markdown, LaTeX y Mermaid. - 🔌 MCP nativo. Expón herramientas, recursos y prompts a agentes de IA con un solo decorador; los esquemas se derivan de tus anotaciones de tipo.
- ⚡ Núcleo impulsado por Rust. Enrutamiento, codificación JSON, análisis de solicitudes y compresión compilados a código nativo, distribuidos como wheels simples.
- 🚀 Listo para producción desde el inicio. Pasa de un modelo empaquetado a un servicio en ejecución mediante la CLI, en Python, con un archivo de especificación o dentro de un contenedor.
Instalación
Flama se publica en PyPI e incluye wheels nativos para cada versión de Python compatible (3.10 a 3.14) en Linux, macOS y Windows. No se requiere cadena de herramientas de Rust.
pip install flama
El soporte de esquemas, bases de datos y LLM son extras opcionales, por lo que instalas solo lo que necesitas:
pip install "flama[pydantic]"      # schema validation (also: typesystem, marshmallow)
pip install "flama[database]"      # SQLAlchemy-backed resources
pip install "flama[llm]"           # generative AI serving (vLLM on Linux, MLX on Apple Silicon)
pip install "flama[full]"          # everything
Consulta la documentación de instalación para más detalles.
Inicio rápido
Los mismos dos comandos sirven ambas familias de modelos: empaquétalo en un .flm y luego apunta flama serve al archivo. Sin código de aplicación en ninguno de los casos.
Servir un modelo predictivo
Empaqueta un modelo entrenado en cualquier framework principal:
import flama
from sklearn.neural_network import MLPClassifier

model = MLPClassifier(activation="tanh", hidden_layer_sizes=(10,))
# ... training ...
flama.dump(model, family="ml", path="model.flm", metrics={"accuracy": 0.947})
O descarga uno directamente del Hub y luego sírvelo:
flama get --family ml --source huggingface scikit-learn/Fish-Weight
flama serve --model file=scikit-learn_Fish-Weight.flm,url=/model,name=fish
Obtienes dos endpoints, un esquema OpenAPI en /schema/ y la interfaz Swagger en /docs/.
GET /model/ devuelve los metadatos del artefacto; POST /model/predict/ ejecuta la inferencia:
curl -X POST http://127.0.0.1:8000/model/predict/ \
  -H "Content-Type: application/json" \
  -d '{"input": [[23.2, 25.4, 30.0, 11.52, 4.02]]}'
{"output": [242.0]}
Aprende más en la documentación de IA predictiva.
Servir un modelo generativo
De cero a una API de producción con interfaz de chat integrada en tres comandos:
pip install "flama[llm,pydantic]"

# 1. Download and package a model from HuggingFace into a portable .flm
flama get --family llm --source huggingface mlx-community/gemma-4-E2B-it-qat-4bit

# 2. Try it straight from your terminal, no server needed
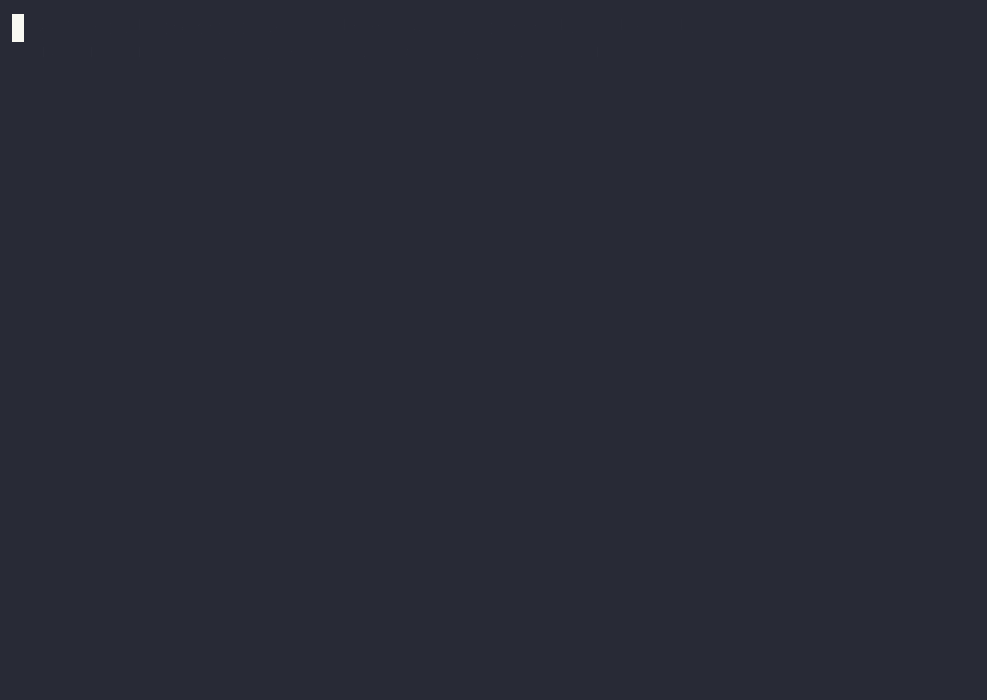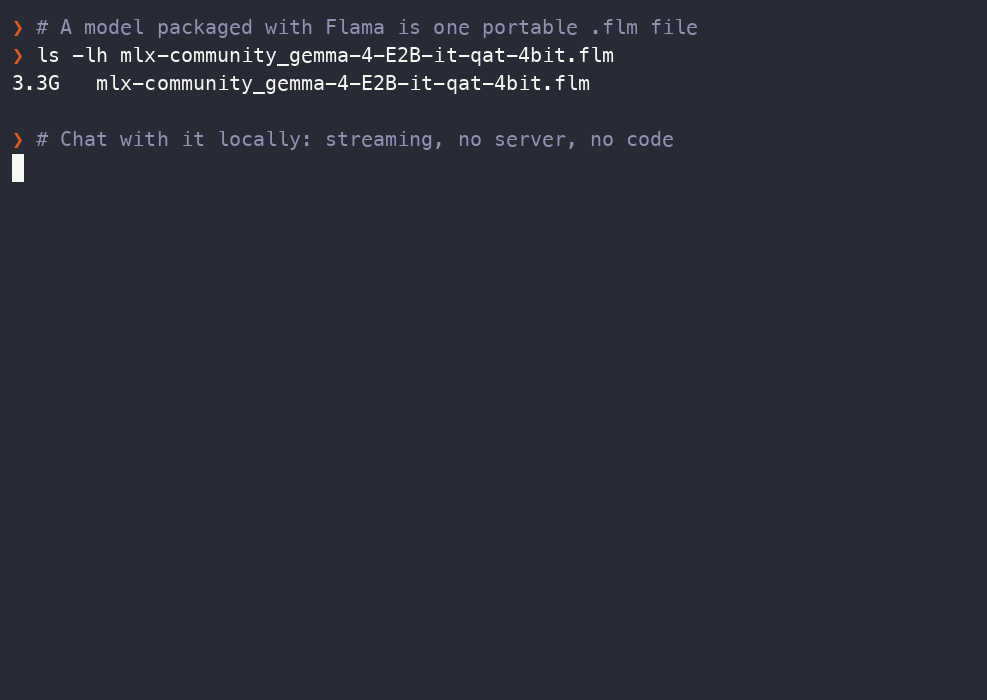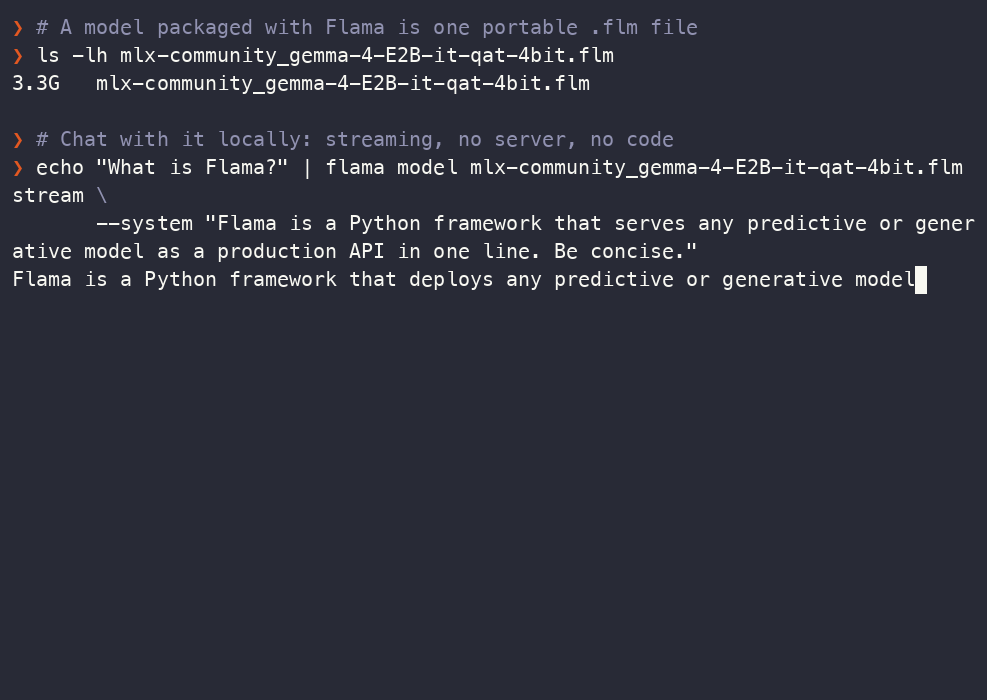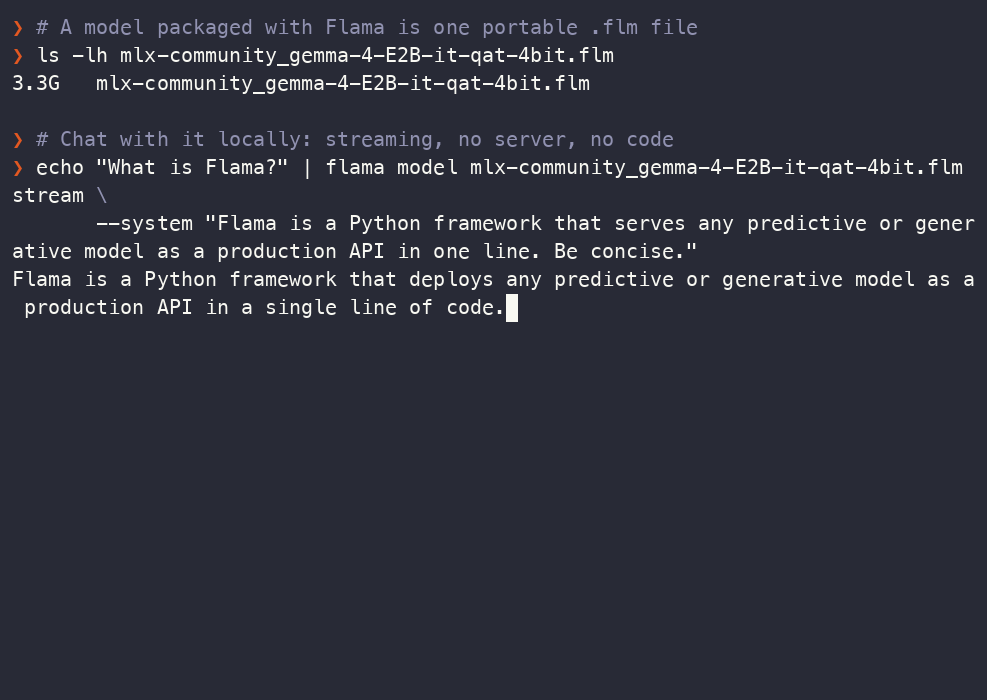
echo "What is Flama?" | flama model mlx-community_gemma-4-E2B-it-qat-4bit.flm stream --system "Be concise."

# 3. Serve it over HTTP
flama serve --model file=mlx-community_gemma-4-E2B-it-qat-4bit.flm,url=/,name=gemma
Eso es todo: una API HTTP completa, una interfaz de chat en streaming en
http://127.0.0.1:8000/chat/ y endpoints multidialecto.
El mismo archivo .flm se ejecuta en vLLM (Linux con CUDA) o MLX (Apple Silicon), y Flama selecciona el backend en el momento de la carga.
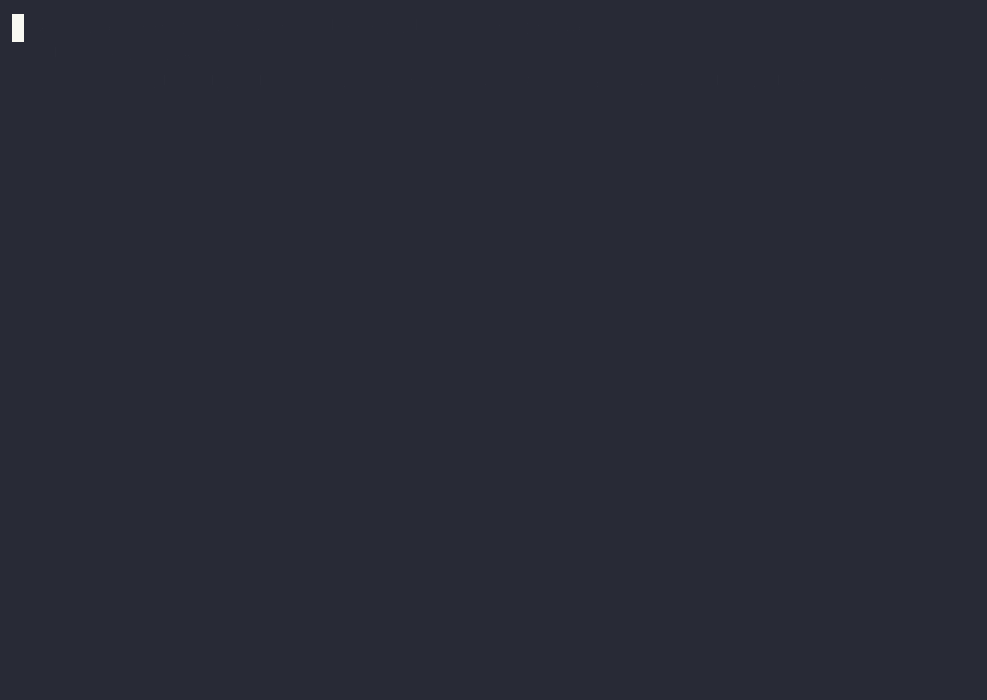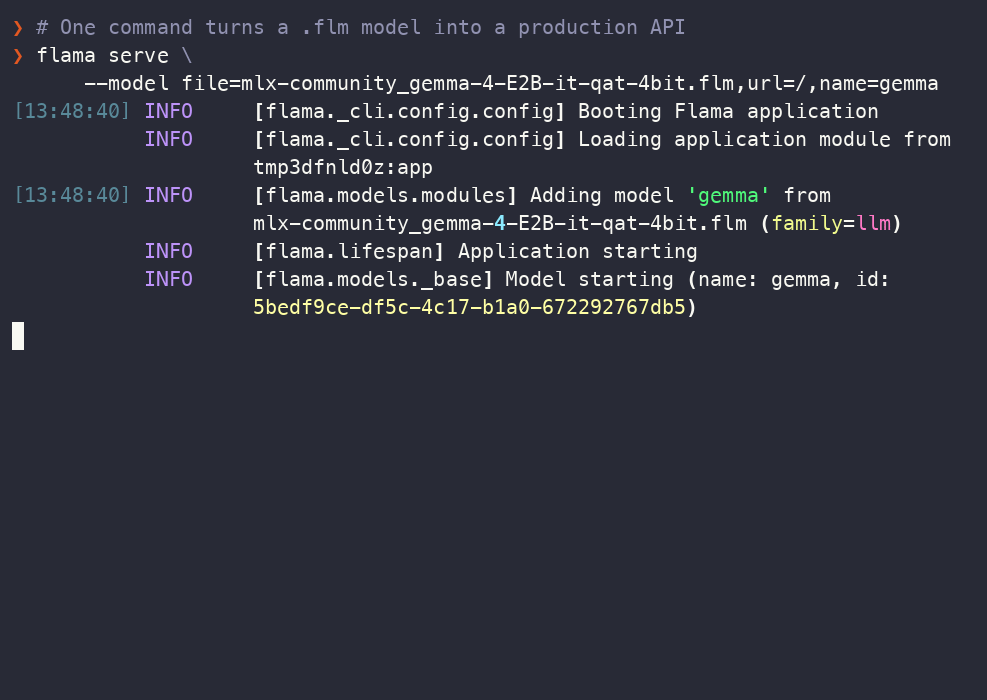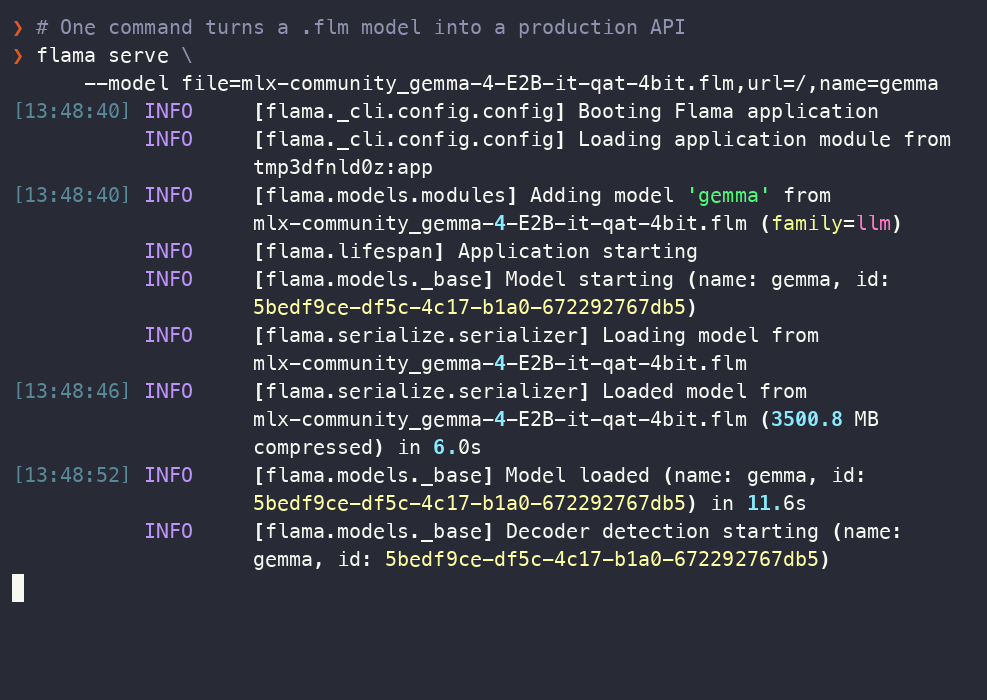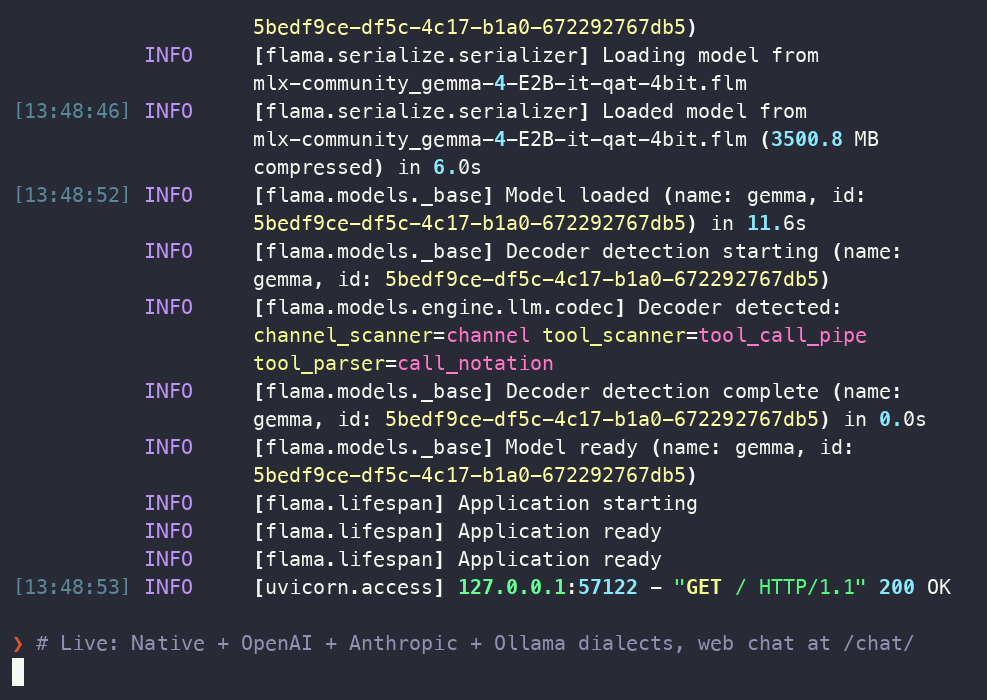
El paso 2 anterior no necesita servidor en absoluto. Envía un prompt a flama model ... stream y la respuesta se transmite directamente a tu terminal:
Aprende más en la documentación de IA generativa.
Habla los protocolos que tus clientes ya usan
Un solo modelo puede servir múltiples protocolos de red simultáneamente, de modo que los clientes existentes de OpenAI, Anthropic y Ollama funcionan sin cambios de código; solo apúntalos a tu servidor.
| Dialecto | Prefijo | Rutas representativas |
|---|---|---|
| Nativo | (ninguno) | /query/, /stream/, /chat/ |
| OpenAI | /openai | /v1/chat/completions, /v1/completions, /v1/responses, /v1/models |
| Anthropic | /anthropic | /v1/messages, /v1/models |
| Ollama | /ollama | /api/chat, /api/generate, /api/tags |
Inspecciona, prueba y despliega
Cada archivo .flm es autodescriptivo. Junto con los pesos, incluye el framework y la versión, la clase del modelo, sus hiperparámetros, las métricas de entrenamiento y cualquier archivo auxiliar necesario en el momento de la inferencia. Los metadatos se ubican antes de los pesos, por lo que leerlos es un análisis de cabecera en lugar de una descompresión completa, incluso en un artefacto de varios gigabytes.
flama model model.flm inspect --pretty
{
  "meta": {
    "id": "42342016-bade-48d4-a185-0a3352fb7561",
    "timestamp": "2026-09-15T10:30:00",
    "framework": {"family": "ml", "lib": "sklearn", "version": "1.9.1", "config": null},
    "model": {
      "obj": "RandomForestClassifier",
      "params": {"n_estimators": 100, "max_depth": 8},
      "metrics": {"accuracy": 0.947, "f1": 0.932}
    },
    "extra": {"dataset": "prod-2024-q3", "author": "team-ml"},
    "capabilities": {"kind": "ml"}
  },
  "manifest": []
}
Debido a que las métricas viajan dentro del archivo, un trabajo de CI puede condicionar la promoción según ellas sin levantar un servidor. El mismo grupo de comandos ejecuta la inferencia sin conexión, de modo que un conjunto de referencia se puntúa exactamente con la misma ruta de código que usaría el servidor:
flama model model.flm run -i reference.json -o predictions.json
Desplegar varios modelos desde un solo archivo
flama start lee un flama.json que describe la aplicación y los modelos que sirve, lo que hace que un despliegue sea revisable en una solicitud de extracción:
{
  "app": {
    "title": "ML Platform",
    "models": [
      {"url": "/sentiment", "path": "models/sentiment.flm", "name": "sentiment"},
      {"url": "/assistant", "path": "models/assistant.flm", "name": "assistant",
       "serving": ["native", "openai"]}
    ]
  },
  "server": {"host": "0.0.0.0", "port": 8000, "workers": 4}
}
flama start --create-config full   # write a template to start from
flama start                        # run it
Cada opción también se vincula a una variable de entorno FLAMA_*, de modo que una sola imagen sirve para todos los entornos. Las imágenes oficiales se distribuyen por versión de Python y biblioteca de esquemas, lo que deja el Dockerfile como un FROM y dos COPY:
FROM vortico/flama:latest-python3.12-pydantic
COPY models/ models/
COPY flama.json .
CMD ["start"]
Aprende más en la documentación de la CLI.
Expón herramientas a agentes de IA con MCP
Flama incluye soporte nativo y de primera clase para el Protocolo de Contexto de Modelos. Declara una capacidad con un solo decorador, monta el servidor, y Flama deriva el JSON Schema de tus anotaciones de tipo y lo sirve mediante un protocolo sin estado:
from flama import Flama

app = Flama()
app.mcp.add_server("/mcp/tools/", "tools")


@app.mcp.tool("add", description="Add two integers", mcp="tools")
def add(a: int, b: int) -> int:
    return a + b
Cualquier cliente compatible con MCP (Claude, Cursor, VS Code Copilot o un agente personalizado) puede descubrirlo e invocarlo. Se incluyen Tareas, Elicitación y Aplicaciones MCP. Aprende más en la documentación de MCP.
Y un framework de API con todas las funciones
Flama también es un kit completo para construir APIs de producción:
- Recursos con métodos CRUD estándar sobre tablas SQLAlchemy.
- Inyección de dependencias mediante
Component, la base del ecosistema de plugins. - Esquemas adaptables con Pydantic, Typesystem o Marshmallow, todos como extras opcionales.
- Esquema OpenAPI autogenerado más Swagger UI y ReDoc.
- Paginación, tareas en segundo plano, eventos de ciclo de vida y autenticación JWT.
- HTTP con streaming prioritario con Server-Sent Events y respuestas NDJSON.
- Patrones de Diseño Dirigido por Dominio: repositorios, workers y modelos de dominio.
- Codemods
flama upgradeque reescriben importaciones y símbolos renombrados entre versiones principales.
Ejemplos
Un conjunto curado de ejemplos ejecutables alineados con la documentación vive en vortico/flama-examples, que cubre fundamentos, la CLI, temas avanzados, IA predictiva, IA generativa y diseño dirigido por dominio.
Documentación
Visita https://flama.dev/docs/ para la documentación completa, incluido el inicio rápido y la guía de la CLI.
Usa Flama con tu asistente de IA
Coloca skill.md en tu asistente de codificación de IA y deja que
construya aplicaciones Flama con conocimiento completo del framework.
Autores
- José Antonio Perdiguero López (@perdy)
- Miguel Durán-Olivencia (@migduroli)
Contribuciones
Este proyecto está totalmente abierto a contribuciones, así que si tienes una buena idea, lee nuestra documentación de contribuciones antes de enviar una solicitud de extracción. Las preguntas e ideas son bienvenidas en GitHub Discussions.
Soporte
Si encuentras útil a Flama para construir APIs robustas de Aprendizaje Automático e IA Generativa, la mejor manera de apoyar nuestro trabajo es darnos una ⭐ en GitHub, es el mejor combustible para nuestros esfuerzos de desarrollo. También puedes seguir a Vortico para actualizaciones.
Historial de Estrellas
Licencia
Flama se publica bajo la licencia Apache 2.0.