Hindsight
Hindsight: Memoria de agente que funciona como la memoria humana
Documentación


¿Qué es Hindsight?
Hindsight™ es un sistema de memoria para agentes, diseñado para crear agentes más inteligentes que aprenden con el tiempo. La mayoría de los sistemas de memoria para agentes se centran en recordar el historial de conversaciones. Hindsight se centra en hacer que los agentes aprendan, no solo que recuerden.
Elimina las deficiencias de técnicas alternativas como RAG y los grafos de conocimiento, y ofrece un rendimiento de vanguardia en tareas de memoria a largo plazo.
Contenido
- Rendimiento y precisión de la memoria
- Inicio rápido — servidor · clientes · plataformas · embebido
- Añadir Hindsight a tu agente — LLM Wrapper · integraciones · agentes de codificación · MCP
- Conceptos principales — tipos de memoria · retener / recordar / reflexionar · observaciones · modelos mentales y páginas de conocimiento · bancos
- Casos de uso
- Ejecución en producción
- Recursos
Rendimiento y precisión de la memoria
Según el rendimiento en benchmarks, Hindsight es el sistema de memoria para agentes más preciso jamás probado. Ha logrado un rendimiento de vanguardia en el benchmark LongMemEval, ampliamente utilizado para evaluar el rendimiento de los sistemas de memoria en una variedad de escenarios de IA conversacional. El rendimiento actual reportado de Hindsight y otras soluciones de memoria para agentes, a enero de 2026, se muestra aquí:
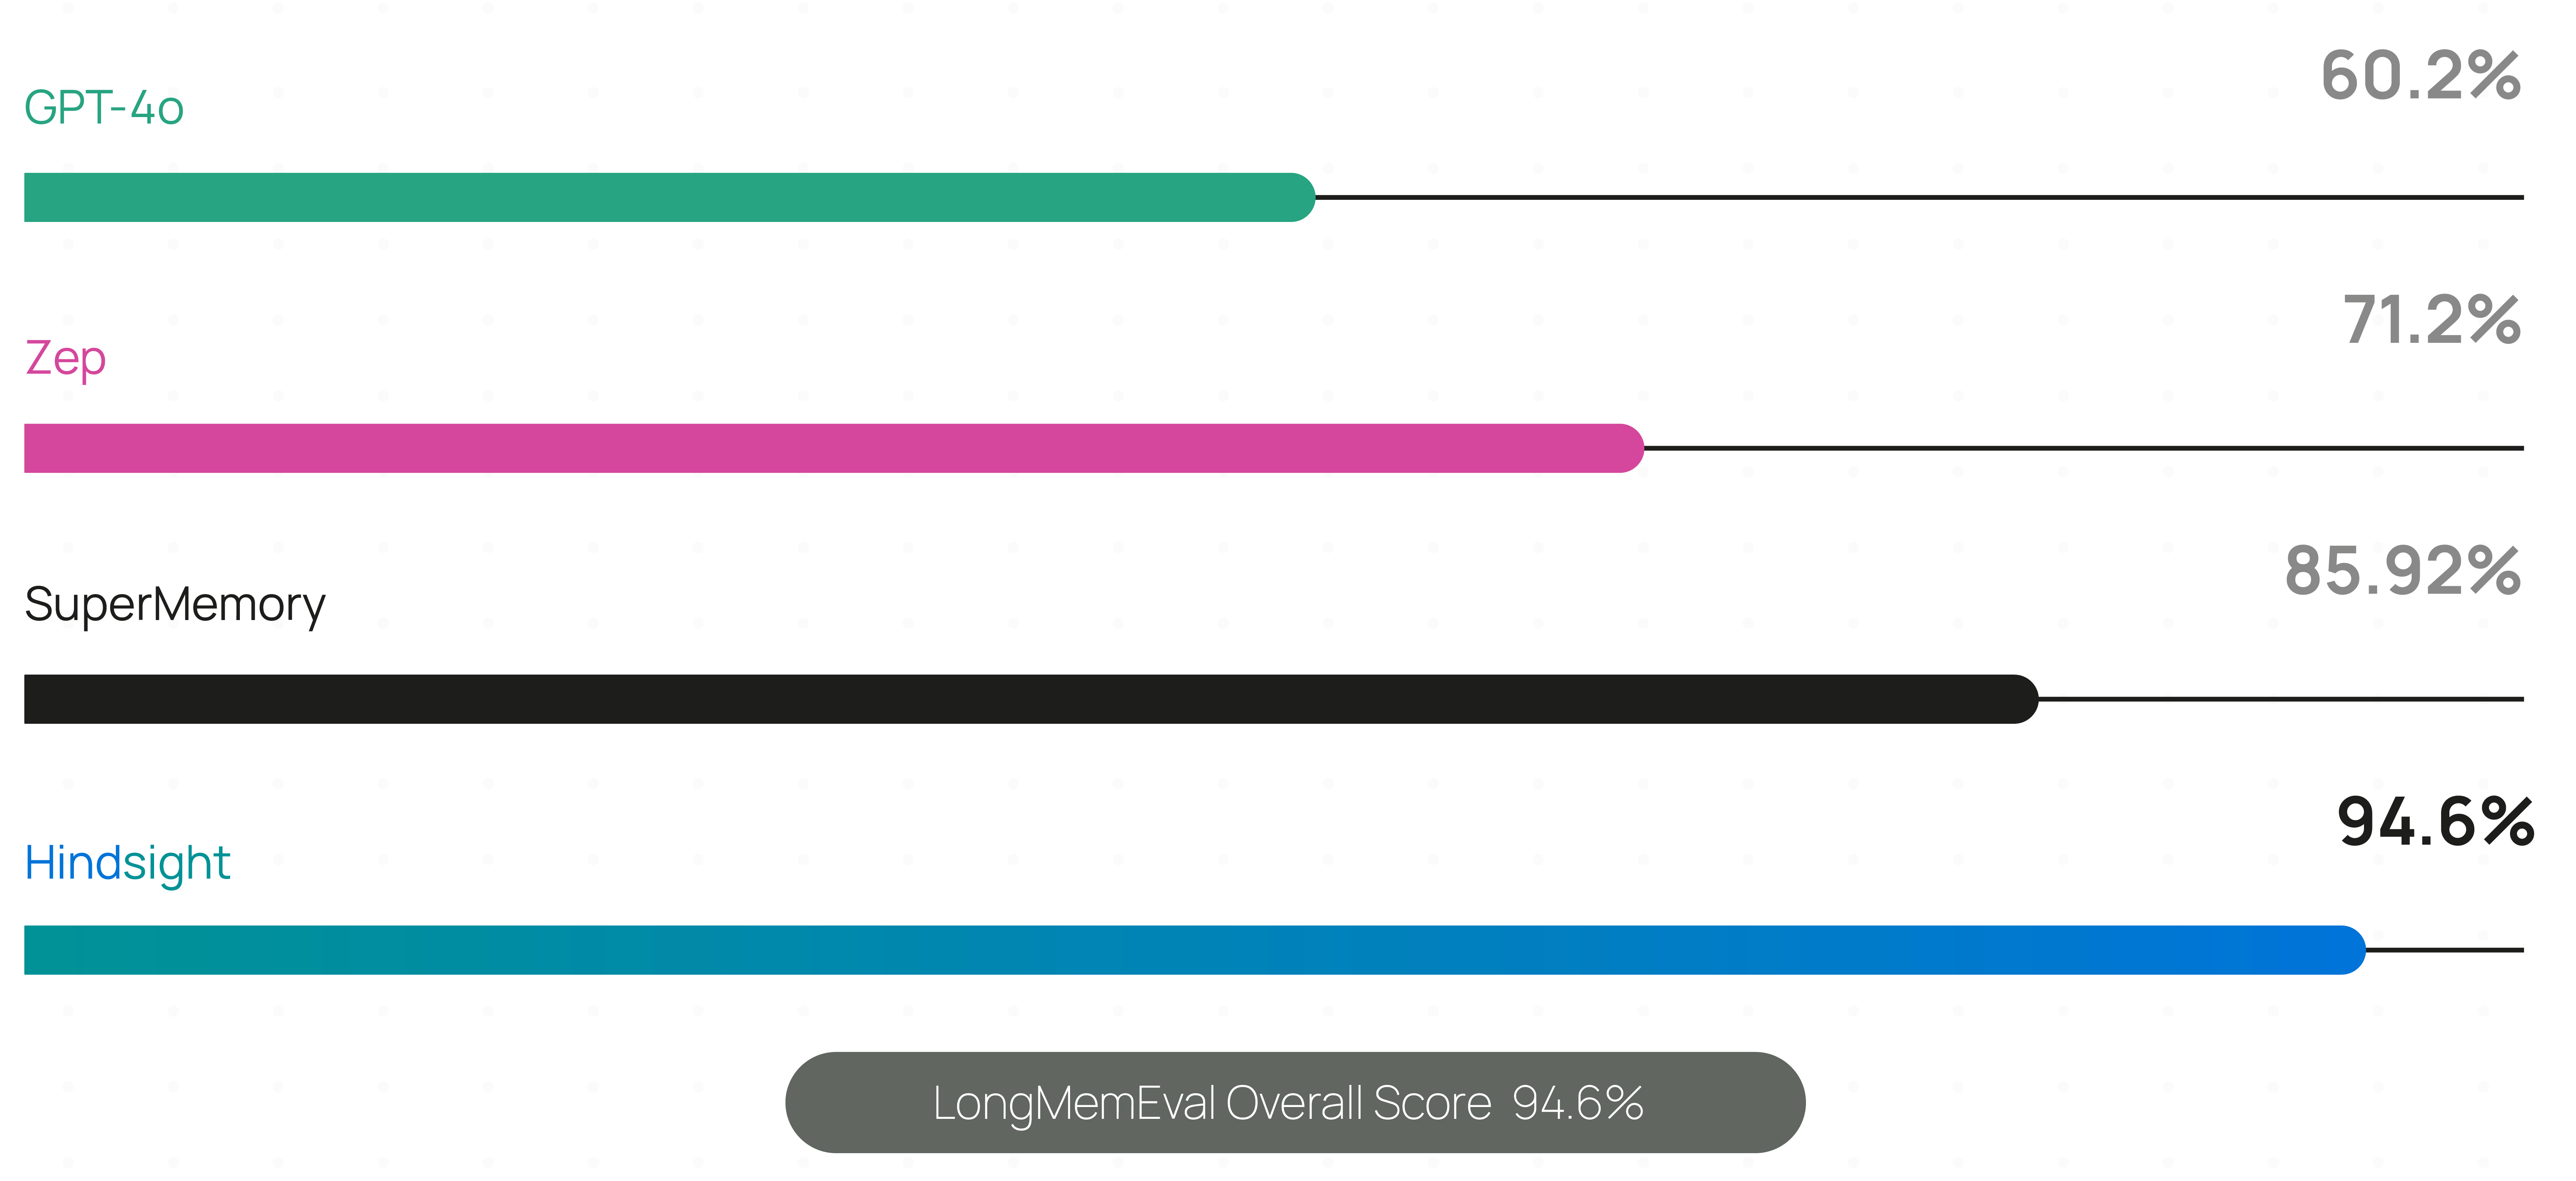
Resultados en vivo y actualizados continuamente — incluyendo precisión por modelo, latencia y costo — se publican en benchmarks.hindsight.vectorize.io.
Los datos de rendimiento del benchmark para Hindsight han sido reproducidos de forma independiente por colaboradores de investigación del Sanghani Center for Artificial Intelligence and Data Analytics de Virginia Tech y por The Washington Post. Otras puntuaciones son auto-reportadas por los proveedores de software.
Hindsight se utiliza en producción en empresas Fortune 500 y por un número creciente de startups de IA.
🤖 ¿Usas un agente de codificación? Instala la skill de documentación de Hindsight para acceder instantáneamente a los docs mientras programas:
npx skills add https://github.com/vectorize-io/hindsight --skill hindsight-docsFunciona con Claude Code, Cursor y otros asistentes de codificación con IA.
Inicio rápido
1. Inicia un servidor
Docker (recomendado)
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
Hindsight funciona con más de 25 proveedores de LLM a través de HINDSIGHT_API_LLM_PROVIDER — alojados (openai, anthropic, gemini, groq, bedrock, vertexai, minimax, deepseek, atlas, meta, …), totalmente locales (ollama, lmstudio, llamacpp), cualquier endpoint compatible con OpenAI, y pasarelas (litellm, litellmrouter) que llegan al resto. Las suscripciones existentes también funcionan: openai-codex (ChatGPT Plus/Pro), claude-code (Claude Pro/Max) y github-copilot (GitHub Copilot) no necesitan clave API. Consulta los modelos compatibles.
Docker (PostgreSQL externo)
export OPENAI_API_KEY=sk-xxx
export HINDSIGHT_DB_PASSWORD=choose-a-password
cd docker/docker-compose
docker compose up
Oracle AI Database también es compatible para despliegues empresariales con paridad total de funciones. Consulta la documentación de almacenamiento para más detalles.
Bare metal (pip)
pip install hindsight-api
export HINDSIGHT_API_LLM_API_KEY=sk-xxx

hindsight-api
Kubernetes (Helm)
helm install hindsight oci://ghcr.io/vectorize-io/charts/hindsight \
  --set api.llm.provider=openai \
  --set api.llm.apiKey=sk-xxx \
  --set postgresql.enabled=true
Gestionado (sin servidor)
Hindsight Cloud es la opción alojada: infraestructura gestionada que se escala automáticamente, además de un panel de control, copias de seguridad, colaboración en equipo y un SLA de disponibilidad del 99,9%. La facturación se basa en el uso, con créditos gratuitos para empezar — sin cuota mensual fija ni por asiento. Apunta cualquier cliente a https://api.hindsight.vectorize.io con tu clave API y omite el despliegue por completo.
Comparar autogestionado, Cloud y Enterprise → · Registrarse →
Todas las opciones, incluidas las configuraciones para Windows y entornos aislados, se cubren en la guía de instalación.
2. Conecta un cliente
pip install hindsight-client -U                                  # Python
npm install @vectorize-io/hindsight-client                        # Node.js / TypeScript
go get github.com/vectorize-io/hindsight/hindsight-clients/go     # Go
curl -fsSL https://hindsight.vectorize.io/get-cli | bash          # CLI
Python
from hindsight_client import Hindsight

client = Hindsight(base_url="http://localhost:8888")

# Retain: Store information
client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")

# Recall: Search memories
client.recall(bank_id="my-bank", query="What does Alice do?")

# Reflect: Generate disposition-aware response
client.reflect(bank_id="my-bank", query="Tell me about Alice")
Node.js / TypeScript
const { HindsightClient } = require('@vectorize-io/hindsight-client');

const main = async () => {
  const client = new HindsightClient({ baseUrl: 'http://localhost:8888' });

  await client.retain('my-bank', 'Alice loves hiking in Yosemite');

  const results = await client.recall('my-bank', 'What does Alice like?');
  console.log(results);
}

main();
Referencia completa: Python · Node.js · Go · CLI · API REST
Plataformas compatibles
| Plataforma | Docker | Bare Metal (pip) | BD embebida (pg0) |
|---|---|---|---|
| Linux (x86_64, ARM64) | ✅ | ✅ | ✅ |
| macOS (Apple Silicon / arm64) | ✅ | ✅ | ✅ |
| macOS (Intel / x86_64) | ✅ | ⚠️ | ✅ |
| Windows (x86_64) | ✅ | ✅ | ✅ |
⚠️ Macs Intel: usa hindsight-all-slim — consulta la guía de instalación para más detalles.
Python embebido (sin servidor requerido)
pip install hindsight-all -U
En Macs Intel (x86_64), instala hindsight-all-slim en su lugar — consulta Plataformas compatibles.
import os
from hindsight import HindsightServer, HindsightClient

with HindsightServer(
    llm_provider="openai",
    llm_model="gpt-5-mini",
    llm_api_key=os.environ["OPENAI_API_KEY"]
) as server:
    client = HindsightClient(base_url=server.url)
    client.retain(bank_id="my-bank", content="Alice works at Google")
    results = client.recall(bank_id="my-bank", query="Where does Alice work?")
También están disponibles un equivalente para Node.js y un CLI de daemon.
Añadir Hindsight a tu agente
LLM Wrapper (2 líneas de código)
La forma más fácil de añadir memoria a un agente existente es el LLM Wrapper. Cambia tu cliente LLM por uno envuelto — las memorias se almacenan y recuperan automáticamente en cada llamada, sin otros cambios en tu código.
pip install hindsight-litellm
from openai import OpenAI
from hindsight_litellm import wrap_openai

# Wrap your existing LLM client and you're done.
# Defaults to Hindsight Cloud; pass hindsight_api_url for a self-hosted server.
client = wrap_openai(
    OpenAI(),
    bank_id="user-123",
    hindsight_api_url="http://localhost:8888",
)

# Hindsight recalls relevant memories before the call
# and retains the conversation after it.
response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "What do you know about me?"}],
)
wrap_anthropic() hace lo mismo para el SDK de Anthropic, y cada ajuste — banco, presupuesto de recuerdo, tipos de hechos, reflexionar en lugar de recordar — se puede sobrescribir por llamada con los kwargs de hindsight_*. LiteLLM está debajo, por lo que la misma integración cubre más de 100 modelos. Consulta la integración con LiteLLM.
Si necesitas control explícito sobre cuándo se almacenan y recuperan las memorias, usa directamente los SDKs o la API REST.
Integraciones
Más de 60 integraciones — la mayoría no requieren cambios de código.
| Agentes de codificación | Claude Code · Codex · Cursor · GitHub Copilot · opencode · Cline · Aider · Zed · Continue · Roo Code · OpenHands |
| Frameworks de agentes | LangGraph / LangChain · LlamaIndex · CrewAI · Pydantic AI · OpenAI Agents SDK · Google ADK · Agno · Strands · AutoGen · Microsoft Agent Framework · Vercel AI SDK · Haystack |
| No-code / low-code | n8n · Zapier · Dify · Flowise |
| Apps y herramientas | ChatGPT · Perplexity · Obsidian · Pipecat · Vapi |
👉 Explorar todas las integraciones
Agentes de codificación
Un solo paquete proporciona a los agentes de codificación CLI memoria de proyecto a largo plazo: un banco por repositorio construido automáticamente a partir del historial de git y sesiones pasadas, inyectado en el agente cuando comienza a trabajar, además de páginas de conocimiento curadas que cubren arquitectura, convenciones y trabajo en curso.
npx @vectorize-io/hindsight-coding-agents install all          # every detected agent, wired natively
npx @vectorize-io/hindsight-coding-agents install claude-code  # or just one
Compatible con Claude Code, Codex CLI, Cursor CLI, GitHub Copilot CLI, opencode, Kilo CLI, Cline CLI, Antigravity CLI, Devin CLI, pi, Prime Agent, Grok Build y DeepSeek Harness. La ingesta es automática — no hay comando de configuración. Consulta la integración con agentes de codificación.
Servidor MCP
Cada servidor incluye un endpoint integrado de Model Context Protocol, uno por banco, habilitado por defecto:
http://localhost:8888/mcp/{bank_id}/
Apunta cualquier cliente MCP hacia él para exponer retener, recordar y reflexionar como herramientas. Consulta los docs del servidor MCP.
Conceptos principales
Tipos de memoria
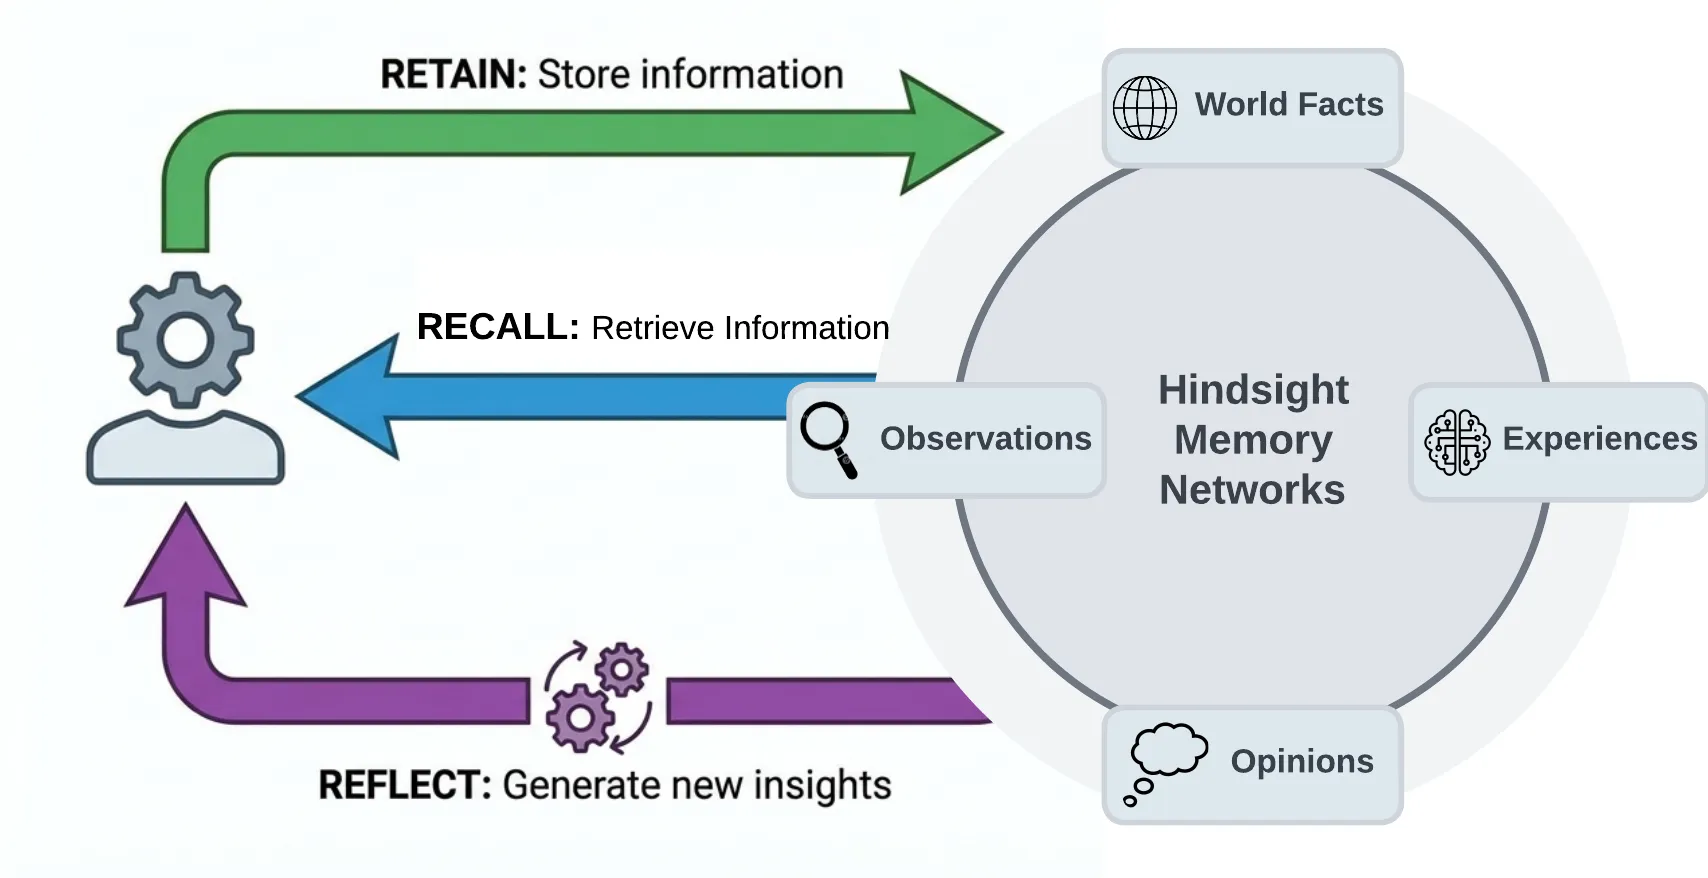
La mayoría de las implementaciones de memoria para agentes dependen de la búsqueda vectorial básica o a veces usan un grafo de conocimiento. Hindsight utiliza estructuras de datos biomiméticas para organizar las memorias de los agentes de una manera más parecida a cómo funciona la memoria humana:
- Hechos del mundo: hechos sobre el mundo ("La estufa se calienta")
- Experiencias: las propias experiencias del agente ("Toqué la estufa y realmente me dolió")
- Observaciones: creencias consolidadas y respaldadas por evidencia, formadas a partir de muchas memorias
- Modelos mentales: comprensión aprendida del mundo del agente, sintetizada a partir de observaciones y hechos
Las memorias viven en bancos. Cuando se añaden memorias, se empujan hacia la vía de hechos del mundo o de experiencias, y luego se representan como una combinación de entidades, relaciones y series temporales con representaciones vectoriales dispersas/densas para ayudar en el recuerdo posterior.
Las tres operaciones
Retener
La operación retain se utiliza para empujar nuevas memorias hacia Hindsight. Le dice a Hindsight que retenga la información que pasas como entrada.
client.retain(
    bank_id="my-bank",
    content="Alice got promoted to senior engineer",
    context="career update",
    timestamp="2025-06-15T10:00:00Z",
)
Detrás de escena, retener utiliza un LLM para extraer hechos clave, datos temporales, entidades y relaciones. Los pasa a través de un proceso de normalización para transformar los datos extraídos en entidades canónicas, series temporales e índices de búsqueda junto con metadatos. Estas representaciones crean las vías para una recuperación precisa de memorias en las operaciones de recordar y reflexionar.

Recordar
La operación de recordar se utiliza para recuperar memorias. Estas memorias pueden provenir de cualquiera de los tipos de memoria (mundo, experiencias, etc.)
client.recall(bank_id="my-bank", query="What does Alice do?")
client.recall(bank_id="my-bank", query="What happened in June?")   # temporal
Recordar ejecuta 4 estrategias de recuperación en paralelo:
- Semántica: Similitud vectorial
- Palabras clave: Coincidencia exacta BM25
- Grafo: Vínculos de entidad/temporales/causales
- Temporal: Filtrado por rango de tiempo

Los resultados individuales se fusionan, se ordenan por relevancia usando fusión de rango recíproco y un modelo de reordenamiento cross-encoder, y luego se recortan según sea necesario para ajustarse al límite de tokens.
Reflexionar
La operación de reflexionar realiza un análisis más exhaustivo de las memorias existentes. Esto permite al agente formar nuevas conexiones entre memorias y construir una comprensión más profunda de su mundo — o responder una pregunta que necesita pensamiento profundo en lugar de una búsqueda.
client.reflect(bank_id="my-bank", query="What should I know about Alice?")
Por ejemplo, reflexionar admite casos de uso como:
- Un Gerente de Proyecto de IA reflexionando sobre qué riesgos necesitan mitigación en un proyecto.
- Un Agente de Ventas reflexionando sobre por qué ciertos mensajes de divulgación han recibido respuestas mientras que otros no.
- Un Agente de Soporte reflexionando sobre oportunidades donde los clientes tienen preguntas no respondidas por la documentación actual del producto.

Observaciones
Los hechos retenidos no permanecen como un montón plano. En segundo plano, Hindsight consolida hechos relacionados en observaciones — creencias deduplicadas que el banco ha construido con el tiempo. Cada observación mantiene su evidencia de respaldo con citas exactas y un recuento de pruebas, y se refina en lugar de sobrescribirse cuando llega nueva evidencia, de modo que la información nueva fortalece, debilita o extiende una creencia existente en lugar de reemplazarla silenciosamente.
Modelos mentales y páginas de conocimiento
Un modelo mental es una respuesta permanente a una pregunta sobre un banco ("¿Cuáles son las preferencias de este usuario?"). Tú defines la pregunta una vez; Hindsight escribe la respuesta, la almacena y la reescribe en segundo plano a medida que el banco aprende más. Leer uno es una lectura de base de datos — sin recuperación, sin llamada a LLM — por lo que un agente puede iniciar con una página de conocimiento establecido en lugar de redescubrirlo en cada sesión.
Las páginas de conocimiento son modelos mentales con la mecánica oculta: documentos vivos que un banco escribe sobre sí mismo, organizados en carpetas como una wiki, buscables y proyectables en disco como markdown ordinario. Proporciona un nombre y una pregunta; cualquier otra decisión es un valor predeterminado que puedes anular.
Modelos mentales → · Páginas de conocimiento →
Bancos de memoria
Un banco es un almacén de memoria aislado — un "cerebro" para un usuario, agente o proyecto. El aislamiento es estricto: sin fugas entre bancos. Los bancos llevan contexto de fondo y rasgos de disposición (escepticismo, literalismo, empatía) que moldean cómo reflect razona sobre sus memorias, y pueden crearse a partir de plantillas de banco declarativas.
Dos cosas más que vale la pena saber:
- Multilingüe por defecto. El idioma de entrada se detecta y se preserva de extremo a extremo — los hechos permanecen en su idioma original y las entidades mantienen su escritura nativa (张伟 sigue siendo 张伟, no "Zhang Wei"). Docs →
- Defensa de memoria. Una política opcional por banco que escanea cada retención en busca de secretos y PII contra 45 patrones y ya sea redacta la coincidencia (
[REDACTED:github_token]) o bloquea el elemento antes de que llegue al almacenamiento. Docs →
Casos de uso
Hindsight está diseñado para soportar agentes de IA conversacionales, así como agentes destinados a realizar tareas de forma autónoma. El caso de uso ideal para Hindsight son agentes que requieren una combinación de estas características, como empleados de IA que necesitan manejar tareas abiertas, cambiar su comportamiento según los comentarios del usuario y aprender a realizar tareas complejas para automatizar el trabajo a un nivel que se aproxime al trabajo humano. Hindsight puede usarse con flujos de trabajo de IA simples como los construidos con n8n y otras herramientas similares, pero puede ser excesivo para tales aplicaciones.
Memorias por usuario e historial de chat
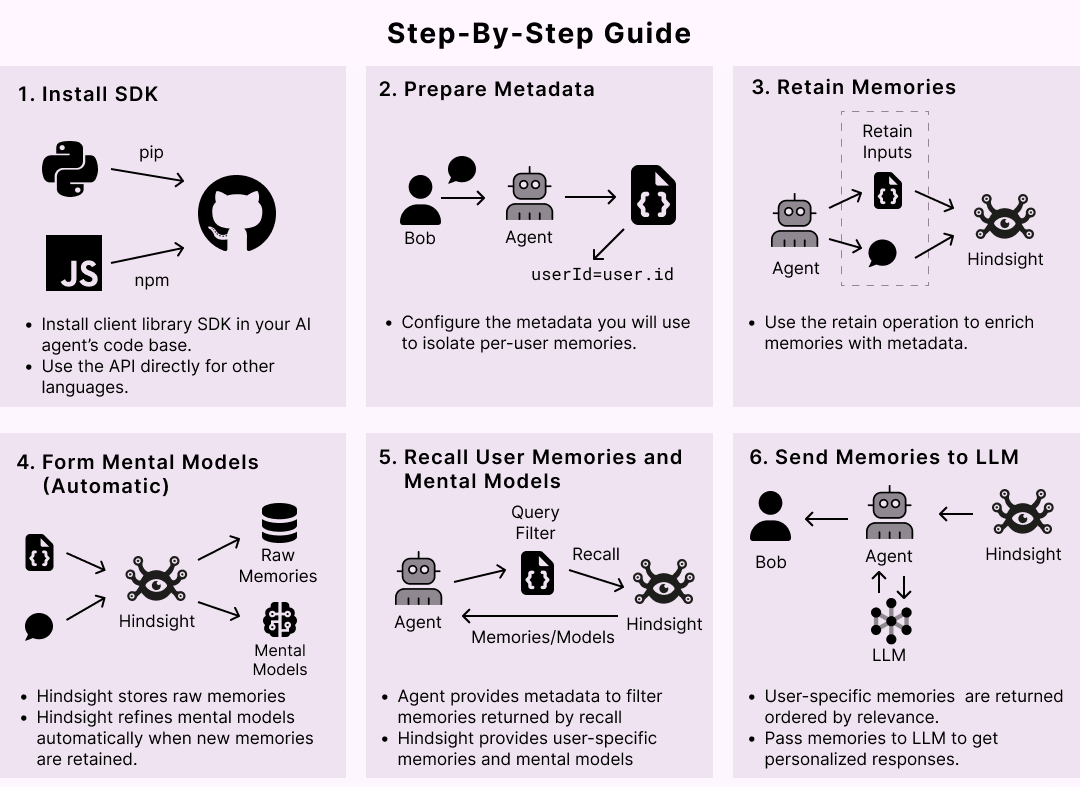
Uno de los casos de uso más simples para Hindsight es personalizar chatbots de IA y otros agentes conversacionales almacenando y recordando memorias asociadas con usuarios individuales.
Los requisitos para este caso de uso generalmente se ven así:
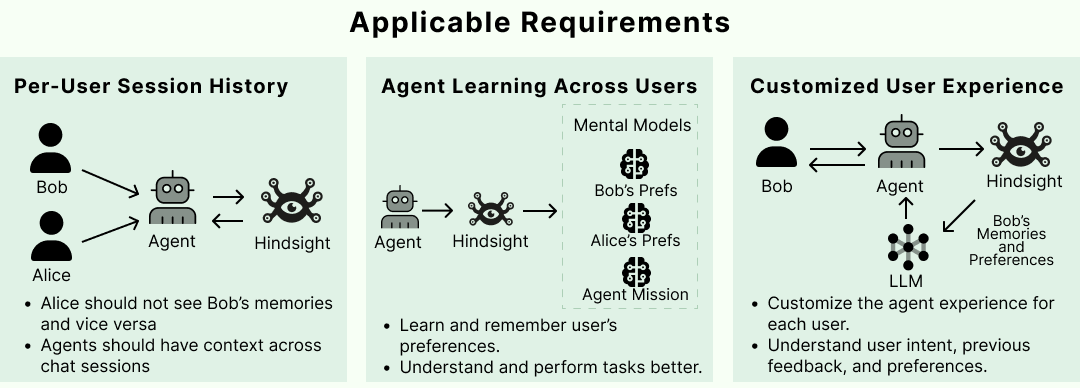
Satisfacer estos requisitos en Hindsight es sencillo. Cuando nuevas entradas de usuario y llamadas a herramientas se ingieren en Hindsight mediante la operación de retención, los metadatos personalizados pueden usarse para enriquecer las nuevas memorias. Los metadatos proporcionan una forma conveniente de aislar memorias que necesitan restringirse a un usuario determinado. Una vez que se alimentan a la operación de retención, cualquier memoria cruda y modelo mental que se cree puede filtrarse al recuperar memorias relevantes.
Más patrones en el Cookbook y Best Practices.
Ejecución en producción
| Almacenamiento | PostgreSQL + pgvector, o Oracle AI Database 23ai con paridad total de funciones — storage |
| Configuración | Jerárquica: variables de entorno globales → por inquilino → por banco — configuration |
| Monitoreo | Métricas y paneles de Prometheus para llamadas LLM, tokens y latencia — monitoring |
| Operaciones | CLI de administración para migraciones, reparación de bancos y operaciones atascadas — admin CLI |
| Eventos | Webhooks para eventos del ciclo de vida de retención, consolidación y actualización — webhooks |
| Extensibilidad | Puntos de extensión de inquilino, autenticación y almacenamiento — extensions |
| Gestionado | Omite todo esto con Hindsight Cloud — gestionado, basado en uso, SLA de disponibilidad del 99.9% |
Recursos
Documentación:
- Docs · FAQ · Best Practices · Cookbook · Blog
- Paper · Benchmarks · RAG vs Memory
Clientes:
Comunidad:
Historial de estrellas
Contribuciones
Consulta CONTRIBUTING.md.
Licencia
MIT — consulta LICENSE
Construido por Vectorize.io