Myco Brain
Servidor MCP de memoria y grafo de conocimiento autoalojado para agentes de IA. TypeScript sobre Postgres 16 + pgvector, 11 herramientas brain_*. Funciona sin claves: búsqueda de texto completo y semántica, ingesta, deduplicación por hash de contenido, procedencia mediante brain_why, y el grafo de conocimiento funcionan sin claves API mediante Ollama local. Apache-2.0.
Documentación

Memoria persistente y trazable hasta su fuente para agentes de IA — autoalojada en tu propio Postgres, sin necesidad de claves API para ejecutarla.




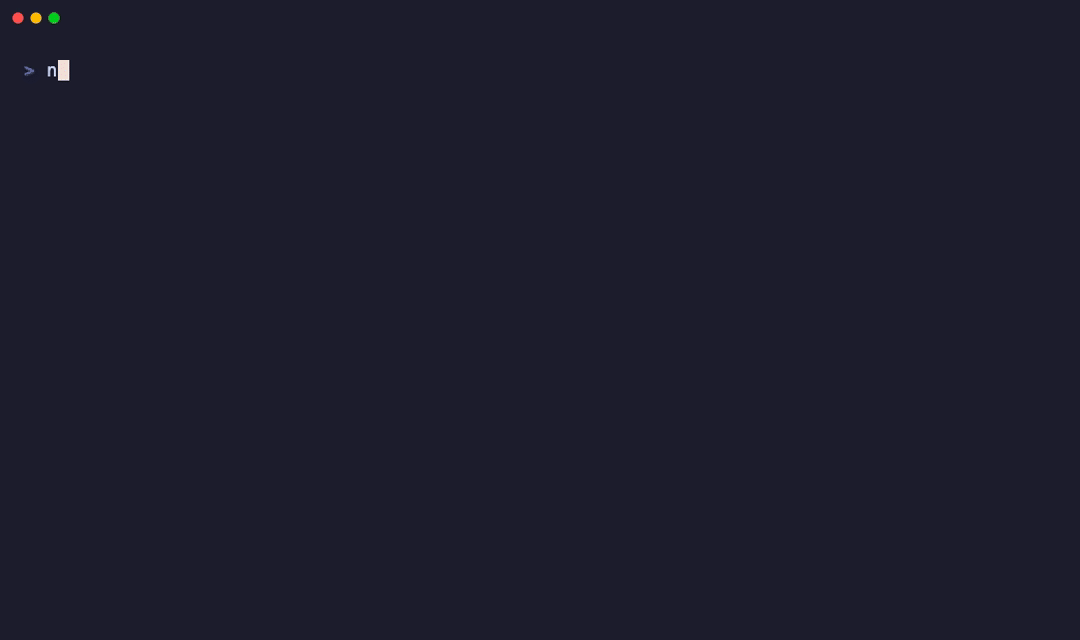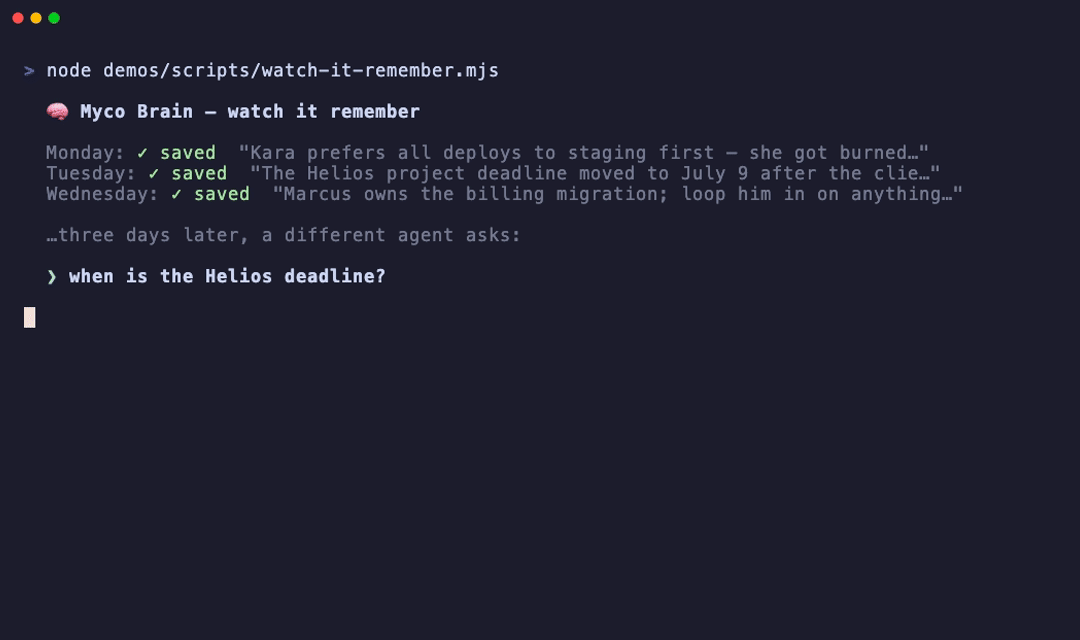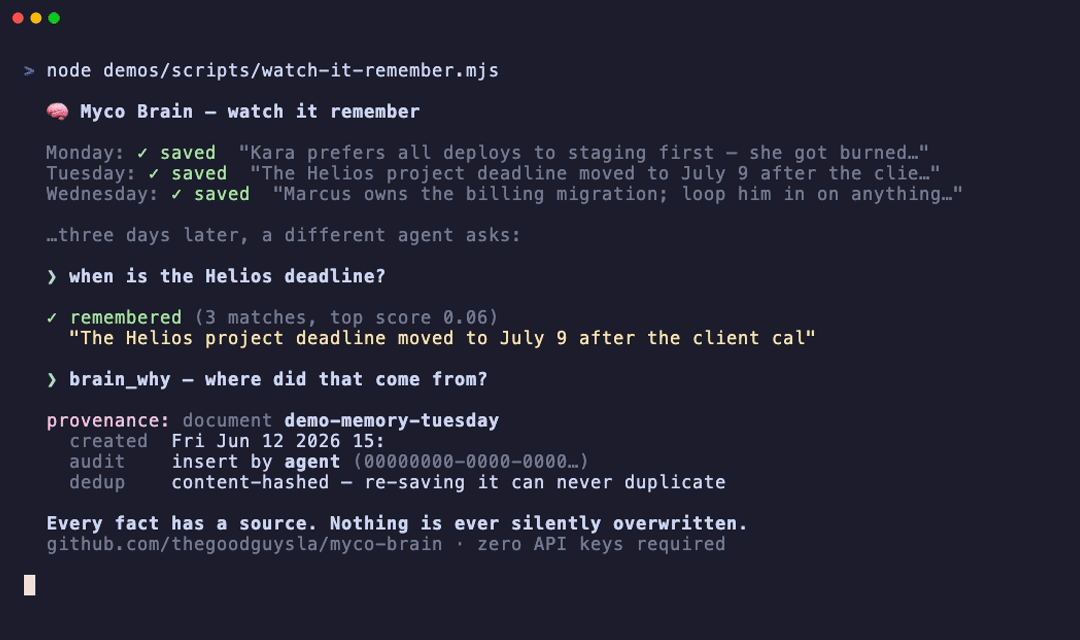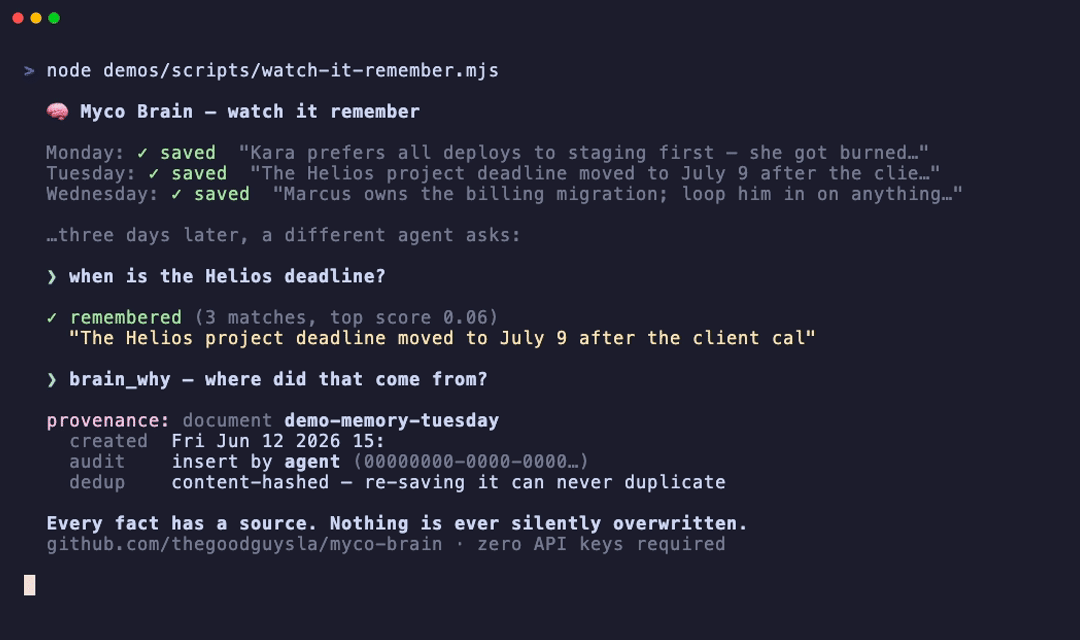
- Trazable hasta su fuente. Cada hecho se remonta al documento del que proviene (
brain_why) — nada de resúmenes de "confía en mí". - Confianza que se acumula. La corroboración independiente aumenta la confianza de un hecho; una contradicción lo reemplaza — se conserva y audita, nunca se sobrescribe en silencio.
- Sin claves y local primero. Búsqueda de texto completo + semántica y el grafo de conocimiento funcionan sin dependencia alojada — añade una clave de Anthropic solo para el grafo más preciso.
- Tuyo. Apache-2.0, tablas Postgres simples, 13 herramientas MCP. Funciona con Claude, Cursor, Windsurf, Continue, Zed.
Para quién es: equipos de desarrollo que ejecutan agentes que necesitan una memoria compartida · agencias que necesitan aislamiento estricto por cliente · cualquiera que quiera que su asistente recuerde entre sesiones — importa tu historial de ChatGPT / Claude (desde tu exportación de datos) y tu IA te conoce desde el primer día.
Construido en solitario por un especialista en growth marketing — no un ingeniero de carrera — dirigiendo agentes de codificación de IA durante ~3 meses. Cómo se construyó ↓
La solución habitual para la amnesia de los agentes — dejar que un LLM mantenga su propia memoria — la llena de duplicados, resúmenes alucinados y respuestas seguras que nadie puede rastrear. Myco Brain se basa en el contrato opuesto:
El LLM propone. Las reglas deterministas deciden qué se convierte en un hecho. Tú estableces el estándar — desde la auto-promoción controlada por corroboración (la predeterminada) hasta la revisión humana estricta de cada hecho (
BRAIN_REQUIRE_HUMAN_REVIEW=1).
Claude, Cursor, Windsurf, Continue, Zed y agentes personalizados comparten una memoria respaldada por tu propio Postgres.
⭐ Si el modelo de confianza resuena contigo, una estrella ayuda a que otros lo encuentren.
# 1. Boot the stack (Postgres + MCP server + extraction worker)
git clone https://github.com/thegoodguysla/myco-brain.git && cd myco-brain
docker compose up -d

# 2. Give your agent a memory — point it at any repo or folder
#    (no env needed: it finds the quickstart stack on localhost)
npx -y -p @mycobrain/mcp-server mycobrain-ingest github:your-org/your-repo

# 3. Connect your client (one-liner below), then ask across sessions:
#    "what did we decide about auth, and where is that documented?"
#    → answered from your docs, with the source cited.
[!TIP] Cero claves API, hasta el final. Búsqueda de texto completo, búsqueda semántica (incrustaciones locales) y el grafo de conocimiento (extracción local) funcionan sin dependencia alojada. Añade una clave de Anthropic solo si quieres el grafo más preciso.
Nativo de MCP por diseño — tu agente sabe cuándo usar la memoria, no solo cómo.
La mayoría de los servidores MCP exponen herramientas y esperan que el modelo las llame. Myco envía un contrato
de uso a través del canal instructions de MCP: en el momento en que se conecta, tu agente
sabe extraer contexto antes de una tarea, guardar decisiones duraderas y citar fuentes
con brain_why — sin necesidad de indicaciones por proyecto. Ajusta la política en un bloque de copiar y pegar:
Enseña a tu agente a usarlo bien.
Enlaces rápidos: Inicio rápido en 10 minutos · Enseña a tu agente a usarlo bien · El motor de confianza · Benchmark — pruébalo tú mismo · Ejecuta cada prueba · Para quién es · Variables de entorno · Arquitectura · Hoja de ruta · Lista de espera en la nube
Memoria que se vuelve más confiable (confianza que se acumula)
La mayoría de la memoria de los agentes sobrescribe los hechos en silencio. Myco Brain los acumula:
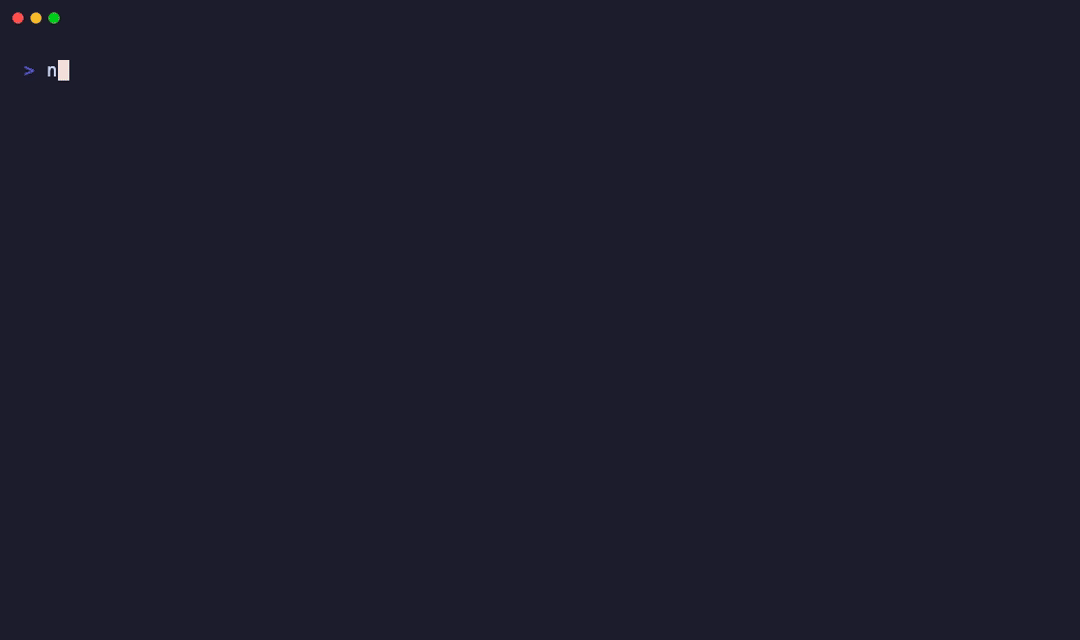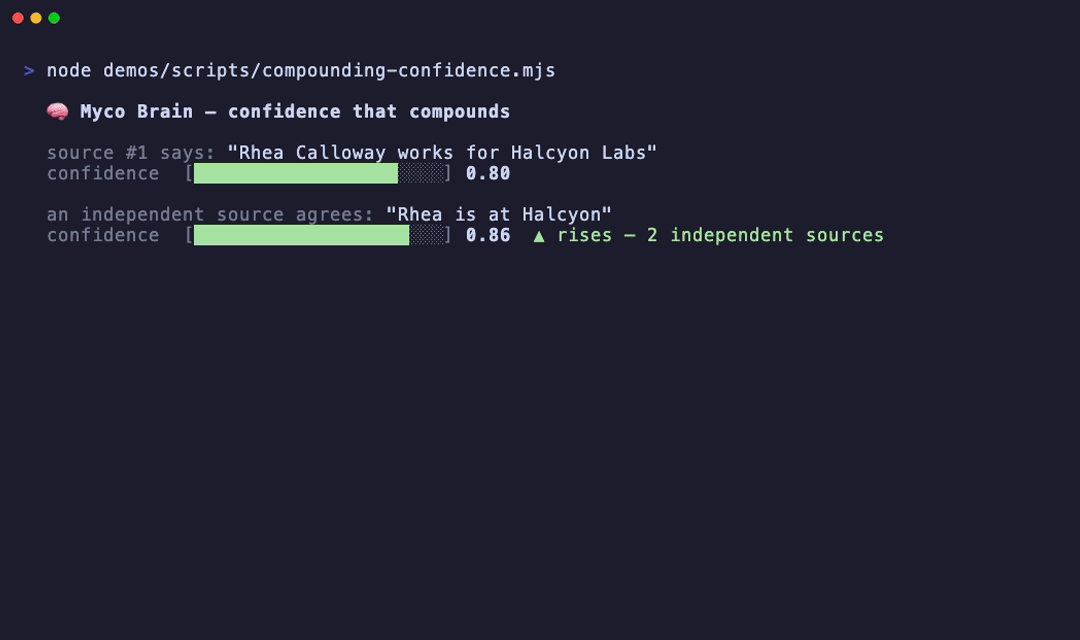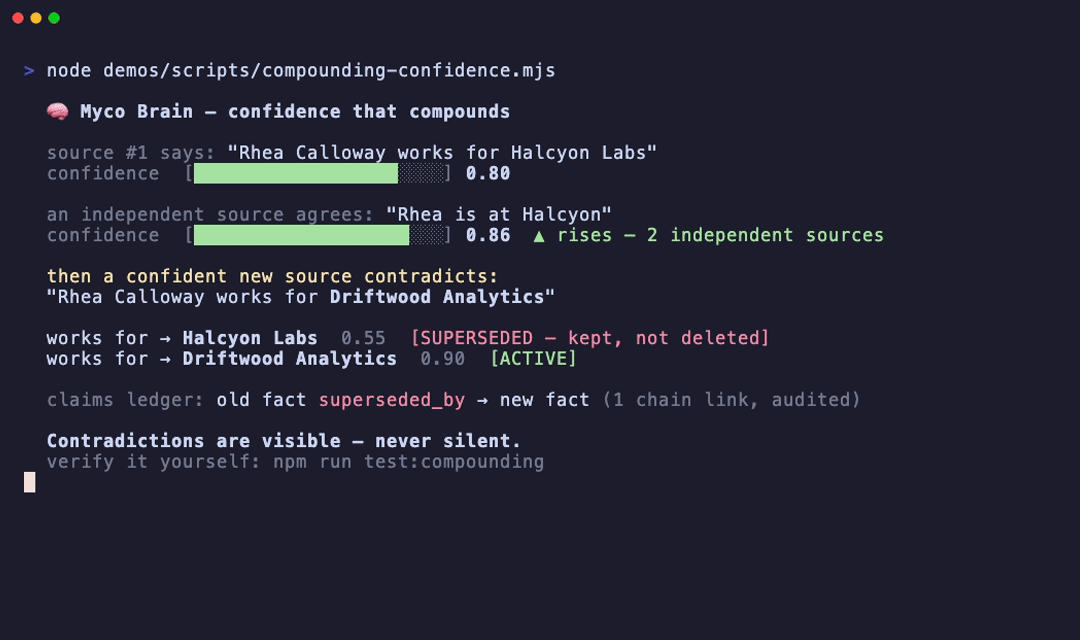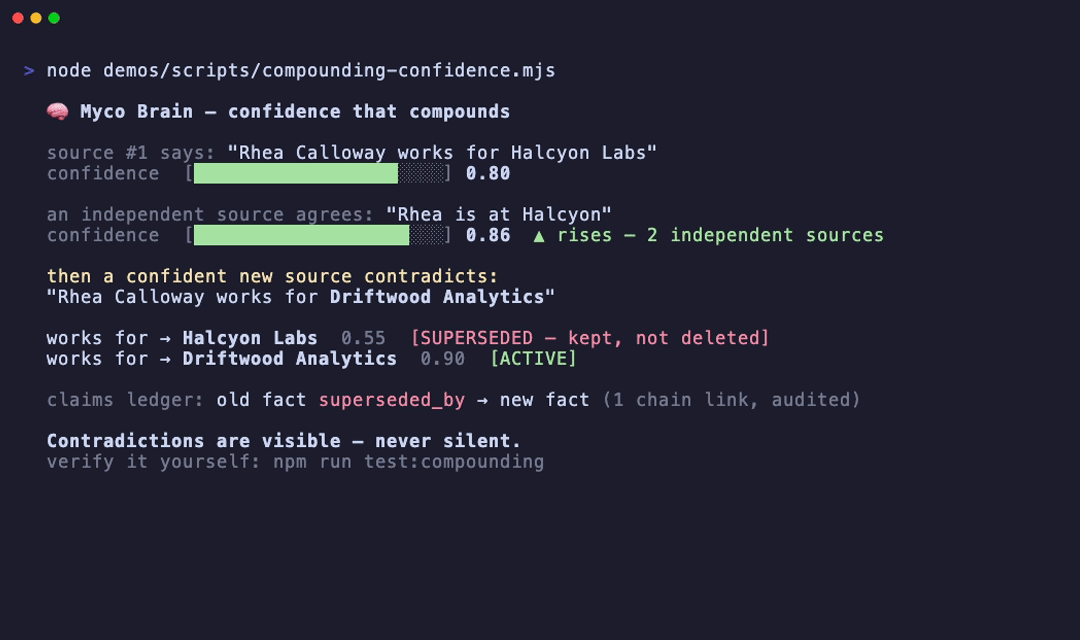
- Una fuente independiente que coincide con un hecho aumenta su confianza (OR ruidoso amortiguado — diez fragmentos de un documento no corroboran nada; solo cuentan las fuentes distintas).
- Una contradicción segura en una relación de valor único (para quién trabajas, dónde está ubicado algo) reemplaza el hecho antiguo: se cierra y debilita — se conserva, nunca se elimina — con el reemplazo registrado en un libro de contabilidad de afirmaciones auditado.
- Pregunta a
brain_whysobre cualquier hecho y obtienes su recuento de fuentes distintas (por relación, no por mención), su tendencia de confianza a lo largo del tiempo ("0.8 → 0.86"), y cualquier historial reemplazado. Las contradicciones permanecen visibles. Tu memoria no puede engañarte.
works for → Halcyon Labs           0.55  [SUPERSEDED — kept, not deleted]
works for → Driftwood Analytics    0.90  [ACTIVE]
claims ledger: old fact superseded_by → new fact (audited)
Prueba: npm run test:compounding — el ciclo de vida completo se ejecuta contra una base de datos
en vivo en segundos, sin necesidad de LLM.
El esquema evoluciona con tus datos (esquema dinámico)
- El trabajador de extracción nota tipos de entidades y relaciones que tu catálogo
aún no tiene y los propone (
brain_stats: "Brain propuso 3 nuevos tipos a partir de tus datos"). - La promoción es tuya por defecto — o opta por la auto-promoción para tipos
corroborados en suficientes documentos fuente distintos
(
BRAIN_SCHEMA_AUTO_PROMOTE=1), contados por documento, no por mención, así que dos documentos pasados de un lado a otro no pueden fabricar consenso. Un documento hablador nunca puede promover nada. - Un tipo promovido permanece limitado al espacio de trabajo que lo ganó — el vocabulario de un cliente nunca se filtra al catálogo de otro (consulta aislamiento por cliente).
Pruebas: npm run test:dynamic-schema, npm run test:schema-promotion.
Tú eliges el dial de confianza:
| Modo | Comportamiento |
|---|---|
| Predeterminado | Los hechos seguros se auto-promueven; los tipos nuevos esperan revisión |
BRAIN_REQUIRE_HUMAN_REVIEW=1 | Curaduría estricta — nada de lo que el LLM propone toca el grafo canónico sin una decisión humana |
BRAIN_SCHEMA_AUTO_PROMOTE=1 | Los tipos nuevos corroborados se promueven solos, auditados |
Cuando algo espera por ti — tipos nuevos en modo predeterminado, o todo en modo estricto — revísalo desde la línea de comandos:
mycobrain review                 # list pending entities, relationships, types
mycobrain review approve <id>    # promote it into the graph
mycobrain review reject  <id>    # reject it (kept and audited, never deleted)
Prueba: npm run test:review — aprobar realmente coloca la entidad / arista /
tipo en el grafo canónico; rechazar nunca lo hace.
Memorias privadas, conocimiento compartido
Los equipos multi-agente obtienen aislamiento real: los documentos marcados como private son legibles
solo por el agente que los creó — aplicado en cada herramienta de lectura, además
de la seguridad a nivel de fila del espacio de trabajo. La memoria del espacio de trabajo permanece compartida. Prueba:
npm run test:sharing (una matriz de visibilidad de dos agentes). Como el
aislamiento del espacio de trabajo, solo se aplica bajo el rol de brain_app de menor privilegio
(nota de seguridad).
Un espacio de trabajo aislado por cliente — hecho para agencias
Coloca a cada cliente en su propio espacio de trabajo, comparte un manual de toda la agencia, y
la garantía que vendes es seguridad a nivel de fila de Postgres — una sesión limitada
al Cliente A no puede devolver filas del Cliente B. El
kit de inicio para agencias lo aprovisiona (un comando) e incluye
el rol de base de datos de menor privilegio que hace que el aislamiento realmente se aplique. Prueba:
npm run test:agency — el Cliente A ve cero hechos del Cliente B.
[!IMPORTANT] El aislamiento solo se aplica bajo el rol de menor privilegio. RLS no restringe a un superusuario de Postgres, y el rol
brainpredeterminado del inicio rápido de configuración cero es un superusuario (está bien para un autoalojamiento de un solo espacio de trabajo — no hay nada que aislar). Antes de poner más de un cliente en una base de datos, ejecuta la aplicación como el rolNOSUPERUSERbrain_appque incluye el kit de agencias;mycobrain-doctormarca una conexión de superusuario. El aislamiento multi-tenant es una garantía debrain_app, no del rol predeterminado del inicio rápido.
Avanzado — puertas de enlace multi-tenant: ¿quién es el llamador? (BRAIN_TRUST_REQUEST_IDENTITY)
RLS decide qué filas puede leer un tenant; esta configuración decide qué tenant es una
solicitud — el paso antes de RLS. En el servidor stdio, la identidad se toma
solo del entorno del servidor por defecto: un workspace_id, agent_id,
o api_key proporcionado en los argumentos de la llamada a la herramienta se ignora, así que incluso un
agente con inyección de prompt no puede pasar workspace_id: "<someone-else>" para alcanzar
otro espacio de trabajo. (Para claves brain_, la identidad proviene de la cadena de la clave y
nada más.)
Establece BRAIN_TRUST_REQUEST_IDENTITY=1 solo cuando coloques el servidor detrás de una
puerta de enlace multi-tenant real que autentique cada solicitud y la asigne a un
tenant por sí misma — entonces se honra la identidad por solicitud (y un JWT de rol de servicio
debe ser igual a BRAIN_SERVICE_ROLE_KEY, no solo parecerse a uno). Los autoalojamientos
de un solo tenant no necesitan nada de esto — su identidad ya se deriva del entorno.
Consulta sobre HTTP (solo lectura)
No todo habla MCP. Para una aplicación web, una automatización o un backend de socio,
mycobrain-rest coloca una pequeña API de solo lectura frente al cerebro — exactamente dos
herramientas, search y why, más salud:
mycobrain-rest                                  # → http://127.0.0.1:8787

curl -s localhost:8787/search \
  -H "Authorization: Bearer brain_<ws>_<agent>_<secret>" \
  -d '{"query":"what did we decide about pricing?","limit":5}'
- Alcance: la clave limita cada consulta a su espacio de trabajo (mismo RLS que MCP), y
no hay rutas de escritura. Como MCP, esto solo se aplica bajo el rol de menor privilegio
brain_app(nota de seguridad) — nunca expongas REST como el superusuariobrainpredeterminado (mycobrain-doctorlo marca). - Verificación de clave: las instalaciones migradas a
…_agent_api_key_verification.sqlverifican el<secret>de cada clave contraagent_api_keysuna vez que un secreto está registrado (registrar/rotar víabrain_set_agent_api_key_secret(...)). Hasta entonces, la clave actúa como un token de portador; estableceBRAIN_REQUIRE_API_KEY_SECRET=1para requerir un secreto registrado antes de exponer REST. - Vinculación: loopback por defecto — establece
BRAIN_REST_HOST=0.0.0.0detrás de tu propio TLS/proxy solo cuando quieras exponerlo, y trata la clave como una contraseña.
Prueba: npm run test:rest.
Cinco demos verificadas
1. Recuerdo entre sesiones
Guarda un hecho en una conversación:
Save a memory: the board meeting is every Wednesday at 9 AM Pacific.
Inicia una conversación nueva y pregunta:
What time is the board meeting?
Resultado esperado: la nueva sesión recupera el hecho almacenado en lugar de depender del historial del chat.
2. Memoria compartida entre agentes
Escribe desde un cliente:
Save a memory: Acme's renewal call is on October 15 with Jordan.
Lee desde otro cliente:
What is Acme's renewal date?
Resultado esperado: ambos clientes leen la misma memoria compartida porque la fuente de verdad es Postgres, no un hilo de chat único.
3. Procedencia de las respuestas
Pregunta a brain_why sobre cualquier hecho y obtén la cadena de fuentes — no un resumen de "confía en mí".
Salida real para una entidad construida a partir del corpus de demostración:
{
  "subject": { "kind": "entity", "name": "Mara Quinn" },
  "evidence": {
    "mention_count": 4,
    "source_document_count": 4,
    "summary": "Supported by 4 mentions across 4 source documents."
  },
  "source_proposals": [
    { "extracted_by": "ollama:llama3.2:3b", "confidence": 1, "state": "auto_promoted",
      "source_hyobject_id": "8e31414c-…" }
  ]
}
Cada hecho aceptado se remonta al(los) documento(s) del que proviene y cómo se extrajo.
4. Ingesta de documentos con fuentes
Ingesta un archivo o URL:
Ingest ./docs/customer-handbook.pdf and summarize the onboarding checklist with sources.
Resultado esperado: el documento se divide en fragmentos, se indexa y se cita de vuelta a través de la recuperación.
5. Relaciones del grafo
Pregunta:
Show related entities for Acme and explain how they connect.
Resultado esperado: las consultas de relaciones muestran personas, documentos y entidades conectados — y las aristas de entidad a entidad que el trabajador de extracción construye (p. ej. Mara Quinn —gestiona→ Northwind Coffee) — en lugar de coincidencias vectoriales planas. Construye este grafo localmente con Ollama, sin necesidad de clave API.
Todas las demos son código, no grabaciones de pantalla —
demos/las re-renderiza de manera determinista contra una pila nueva (npm run demo:render -- all).
Cómo se compara Myco
Diferentes herramientas hacen diferentes concesiones; esto compara enfoques arquitectónicos, no enfrentamientos con benchmarks — cuando la recuperación es alta, el modelo de respuesta se convierte en el cuello de botella, así que las comparaciones de puntuación entre sistemas engañan (consulta la sección de benchmark).
| Memoria típica mantenida por LLM | Memoria de framework (ej. LangChain) | Myco Brain | |
|---|---|---|---|
| Benchmark reproducible | Auto-reportado | — | El harness se incluye en el repo — reproduce el número tú mismo |
| Extracción de hechos | Basado en LLM | Basado en LLM | Ruta de escritura determinista; la salida del LLM entra solo mediante colas de propuestas con compuerta |
| Hechos contradictorios | Coexisten como registros independientes | Posible | Reemplazados, nunca sobrescritos — libro de reclamaciones auditado |
| Confianza del hecho | Estática | — | Se acumula con evidencia independiente, cae ante contradicción |
| Hechos alucinados | Posible | Posible | Restringidos fuera de la ruta de escritura |
| Procedencia | Parcial | Parcial | De primera clase vía brain_why (fuente + rastro de auditoría + tendencia de confianza) |
| Memoria compartida | Depende del cableado de la app | Depende del cableado de la app | Fuente de verdad nativa en Postgres, multi-agente con privacidad por objeto |
| Portabilidad de datos | Forma de proveedor / framework | Forma de framework | Tablas Postgres simples |
Comienza en menos de 10 minutos
Ruta local verificada: Docker Compose desde un clon nuevo.
git clone https://github.com/thegoodguysla/myco-brain.git
cd myco-brain
docker compose up -d
Qué se inicia:
- Postgres 16 + pgvector
- Servidor MCP
- Trabajador de extracción
No se requieren claves API para arrancar — esto es lo que necesita cada capacidad:
| Capacidad | ¿Listo de fábrica? | Para habilitar |
|---|---|---|
| Búsqueda de texto completo (BM25) | ✅ inmediatamente | nada |
| Búsqueda semántica | necesita embeddings | BRAIN_EMBED_PROVIDER=ollama (local, sin clave) |
| Grafo de conocimiento | necesita un extractor | Ollama local (sin clave) o BRAIN_ANTHROPIC_API_KEY (más preciso) |
Confirma que está sano con un comando. mycobrain-doctor no solo verifica que las variables de entorno estén configuradas — para la ruta local de Ollama verifica en vivo la configuración (hace ping a Ollama, confirma que los modelos de embedding y extracción están descargados, y ejecuta un embedding y generación reales), luego revisa el backlog de extracción y la cola de revisión. Sale con código no cero solo ante un fallo real (una línea roja), así que verde significa que funciona:
npx -y -p @mycobrain/mcp-server mycobrain-doctor
Agrega --fix para que ofrezca descargar cualquier modelo de Ollama que falte:
npx -y -p @mycobrain/mcp-server mycobrain-doctor --fix
Conecta tu cliente
Recomendado — configuración guiada. Un comando te guía para conectar un agente, con consentimiento en cada paso:
npx -y -p @mycobrain/mcp-server mycobrain-setup
Ejecuta comprobaciones previas (cada una con una solución ofrecida), verifica pgvector y una escritura real en tu base de datos, configura tu cliente MCP (Claude Code, Claude Desktop, Cursor, Codex, Windsurf), y ofrece una importación con un clic de tu exportación de datos de ChatGPT o Claude si el zip ya está en ~/Downloads. Cada cliente conectado obtiene su propia identidad de agente, así que los recuerdos posteriores muestran de qué herramienta proviene una memoria. ¿Prefieres hacerlo tú mismo? Los caminos manuales están abajo.
Claude Code — a mano (usa las credenciales públicas de desarrollo local del stack de inicio rápido):
claude mcp add myco-brain \
  --env DATABASE_URL=postgresql://brain:brain@localhost:5432/brain \
  --env BRAIN_API_KEY=brain_00000000-0000-0000-0000-000000000001_00000000-0000-0000-0000-0000000000a1_localdev \
  -- npx -y @mycobrain/mcp-server
Reinicia Claude Code y las herramientas brain_* están activas — el servidor entrega a cada agente conectado su contrato de uso automáticamente (cuándo recordar, guardar y citar), así que funciona bien de fábrica.
Claude Desktop — agrega esto a ~/Library/Application Support/Claude/claude_desktop_config.json (Cursor y Windsurf toman el mismo bloque mcpServers en .cursor/mcp.json / sus configuraciones MCP):
{
  "mcpServers": {
    "myco-brain": {
      "command": "npx",
      "args": ["-y", "@mycobrain/mcp-server"],
      "env": {
        "DATABASE_URL": "postgresql://brain:brain@localhost:5432/brain",
        "BRAIN_WORKSPACE_ID": "00000000-0000-0000-0000-000000000001",
        "BRAIN_API_KEY": "brain_00000000-0000-0000-0000-000000000001_00000000-0000-0000-0000-0000000000a1_localdev"
      }
    }
  }
}
Nota:
BRAIN_WORKSPACE_IDse deriva de tu clave API debrain_, así que es opcional — el one-liner de Claude Code lo omite y funciona igual.
Luego prueba el camino feliz:
Save a memory: the launch checklist lives in the ops folder.
Abre una nueva sesión y pregunta:
Where does the launch checklist live?
Guía completa de configuración: docs/quickstart.md
Primera ejecución — el camino más rápido a tu momento mágico
Myco se envía vacío. El 'wow' impacta más con tus propios datos, así que el primer paso recomendado es traer tu historial:
# Guided getting-started — leads with importing your own history
npx -y -p @mycobrain/mcp-server mycobrain-onboard
# Import your ChatGPT or Claude export (~30s), then ask your agent about your past
mycobrain-ingest --from chatgpt-export ~/Downloads/<your-export>.zip
mycobrain-ingest --from claude-export  ~/Downloads/<your-export>.zip
#   → "what did I decide about <topic>?" answered from your own conversations.
¿Prefieres omitirlo? Solo empieza a usarlo — Brain recuerda mientras trabajas. O toma un tour en vivo de 60 segundos con datos de muestra que se limpian solos (tu espacio de trabajo queda intacto):
mycobrain-onboard --tour
Verlo funcionar con el corpus de demostración (sandbox opcional)
¿Quieres un ejemplo guiado más rico? Carga el corpus de demostración incluido — un pequeño conjunto de documentos interconectados para una agencia ficticia y su cliente:
npx -y -p @mycobrain/mcp-server mycobrain-ingest ./examples/demo-corpus
Luego pregunta a cualquier agente conectado:
- "¿Cuándo lanza el rebranding de Northwind y quién es el dueño de la cuenta?"
- "¿Qué modelo de precios elegimos para Northwind y por qué?"
- "Muéstrame la fuente de eso." — procedencia vía
brain_why - "Muestra mis estadísticas de memoria de Myco." — instantánea de salud vía
brain_stats
Cada respuesta se rastrea hasta el documento del que proviene. No se requiere clave API.
El final: el corpus contiene una contradicción deliberada — un documento dice que Devin Osei trabaja para Lumen, uno posterior dice que se fue a Harbor & Co. Con el grafo local sin clave ejecutándose, pregunta:
- "¿Para quién trabaja Devin Osei? ¿Qué cambió y cómo lo sabes?"
El hecho antiguo vuelve reemplazado — conservado, no eliminado — con ambos documentos fuente citados. Ese es el motor de confianza trabajando con tus datos, no un script de demostración.
¿Terminaste de explorar? Limpia solo los datos de muestra incluidos (tus importaciones y memorias nunca se tocan) con:
mycobrain-onboard --reset-demo
Ingesta masiva de una carpeta o repo
Apunta Brain a un directorio o un repo de GitHub e indexa cada archivo de texto — buscable entre sesiones, con cada respuesta rastreable a su archivo fuente.
npx -y -p @mycobrain/mcp-server mycobrain-ingest ./docs        # a local folder
npx -y -p @mycobrain/mcp-server mycobrain-ingest github:owner/repo   # a GitHub repo
No se necesita entorno contra el stack de inicio rápido — el CLI usa sus valores por defecto. Para tu propio Postgres o espacio de trabajo, configura las mismas variables de entorno que usa el servidor MCP (DATABASE_URL, BRAIN_WORKSPACE_ID, BRAIN_API_KEY).
Luego pregunta a cualquier agente conectado: "busca en mis archivos ingeridos el flujo de autenticación" o "muestra mis estadísticas de memoria de Myco". Configura GITHUB_TOKEN para repos privados.
Construye el grafo de conocimiento — localmente, sin claves API
Lo que separa a Myco de un almacén vectorial es el grafo. El trabajador de extracción lee tus documentos ingeridos y:
- extrae las entidades — personas, empresas, proyectos, lugares;
- colapsa duplicados para que "Priya" y "Priya Raman" se conviertan en un solo nodo;
- los conecta con relaciones dirigidas — Mara Quinn —trabaja para→ Northwind Coffee, nunca al revés (el prompt incluido es consciente de la dirección, y los extremos que el modelo olvida listar se recuperan automáticamente);
- y propone nuevos tipos que observa, para que el esquema crezca con tu dominio.
Tú eliges qué modelo hace la extracción. Nada sale de tu máquina con Ollama; Anthropic produce el grafo más preciso.
Dos medidas de calidad distintas, a menudo confundidas, en el fixture de oro de 14 aristas (prueba: npm run test:direction):
| Métrica | Qué mide | Puntaje |
|---|---|---|
| Precisión dirigida | las aristas apuntan en la dirección correcta | 86% (12/14, llama3.2:3b) |
| Supervivencia de aristas | extremos recuperados, no descartados | ~80% (11–12/14, con compuerta ≥75%) |
Opción A — Local y gratis (Ollama, sin clave API)
# Install Ollama (https://ollama.com/download), then pull a model:
ollama pull llama3.2:3b

# Point the worker at it and restart:
echo "BRAIN_OLLAMA_BASE_URL=http://host.docker.internal:11434" >> .env
docker compose up -d
Opción B — Más preciso (Anthropic, trae tu clave)
echo "BRAIN_ANTHROPIC_API_KEY=sk-ant-..." >> .env
docker compose up -d
Si ambos están configurados, Anthropic se usa automáticamente (es más preciso); fuerza una elección con BRAIN_EXTRACTION_PROVIDER=ollama|anthropic.
Pruébalo
Ingiere algunos documentos, dale un momento al trabajador, y luego pregunta a un agente conectado:
- "¿Qué entidades hay en mis documentos de Northwind?" —
brain_neighbors - "¿Cómo se conecta Mara Quinn con Northwind?" — relaciones entidad-a-entidad
- "Muestra mis estadísticas de memoria de Myco." — observa crecer el grafo (
brain_stats)
De cualquier manera, el grafo canónico vive en tu Postgres — el modelo solo propone; la base de datos decide qué se convierte en un hecho duradero.
Benchmark — ejecútalo tú mismo
El punto aquí es reproducibilidad, no un puntaje único — el harness de LongMemEval se incluye en este repo, así que tú ejecutas los números; nosotros no los afirmamos.
| Métrica | Subconjunto (500q) | Config | Puntaje |
|---|---|---|---|
| QA de extremo a extremo | oracle | lector gpt-4o-mini · juez gpt-4o | 73.6% |
| QA de extremo a extremo | oracle | lector fuerte (gpt-4o) | 71.8% |
Recall de evidencia@5 (Ev@5) | longmemeval_s | híbrido (vector + BM25) | 89.2% |
Recall de evidencia@5 (Ev@5) | longmemeval_s | reranker de recencia sin clave | 91.6% |
| Recall de evidencia@10 | longmemeval_s | híbrido → recencia | 90.2% → 93.2% |
QA de extremo a extremo usa el subconjunto oracle, que entrega al lector solo las sesiones de evidencia dorada — así que aísla el razonamiento, no la recuperación (eso es Ev@5, abajo). La configuración de lector fuerte puntúa más bajo (gpt-4o, 71.8%): con la evidencia ya en contexto, la capa de memoria está saturada, así que el lector no es la restricción vinculante — exactamente por qué las comparaciones de un solo titular entre sistemas engañan. Los números que otros citan en el rango de ~90% suelen ser un subconjunto, lector y juez diferentes; no reclamamos una victoria cara a cara, solo te entregamos el harness para puntuar cualquier sistema en el mismo terreno.
cd evals/longmemeval && python3 -m venv .venv && .venv/bin/pip install -r requirements.txt && cd ../..
OPENAI_API_KEY=sk-... DATABASE_URL=postgresql://brain:brain@localhost:5432/brain \
  evals/longmemeval/.venv/bin/python3 -m evals.longmemeval.run \
  --examples 500 --subset longmemeval_oracle --judge-model gpt-4o
Calidad de recuperación (Ev@5 en la tabla) es la métrica de recuperación real — el subconjunto oracle de arriba no la prueba — medida en el subconjunto completo longmemeval_s con distractores. El reranker de recencia (brain_search(reranker: 'recency')) es determinista: sin clave API, sin llamada de red. La recuperación híbrida necesita un proveedor de embeddings (sin clave vía Ollama local, o OpenAI); la búsqueda solo con BM25 puntúa más bajo. Reproduce (solo embeddings, sin juez): python -m evals.longmemeval.run --subset longmemeval_s -n 500 --no-qa.
Metodología, ambas configuraciones, desglose por categoría (incluyendo las categorías que son difíciles para nosotros — reportadas, no ocultas), y comandos de muestra más baratos: evals/longmemeval/README.md.
Cada afirmación tiene una verificación
Nada en esta página pide tu confianza — cada capacidad nombra la prueba ejecutable que la controla en desarrollo. (Ejecuta las comprobaciones npm run y node test/ desde mcp-server/ después de npm install; las rutas node examples/ y evals/ son relativas a la raíz del repo.)
| Afirmación | Verificación |
|---|---|
| El inicio rápido funciona de extremo a extremo | node test/quickstart-e2e.mjs (también se ejecuta en CI contra el stack Docker real) |
| Los duplicados no pueden ocurrir; la procedencia es total | node examples/benchmark/run.mjs |
| La búsqueda semántica sin clave encuentra significado, no palabras | npm run test:local-embeddings |
| Las relaciones son conscientes de la dirección; las aristas sobreviven | npm run test:direction |
| La confianza aumenta con la evidencia, la contradicción reemplaza | npm run test:compounding |
| Se proponen nuevos tipos (y se auto-promueven solo cuando están corroborados y con opt-in) | npm run test:dynamic-schema · npm run test:schema-promotion |
| El modo de curación estricta bloquea toda auto-promoción | npm run test:strict-mode |
| Los documentos privados son privados | npm run test:sharing |
| Las 13 herramientas caben en tu contexto (~2.5K tokens, no inflado) | npm run audit:tokens |
| Agencia: el Cliente A no puede leer al Cliente B (RLS de espacio de trabajo) | npm run test:agency |
| Revisar una propuesta realmente la promueve/rechaza | npm run test:review |
| API REST de solo lectura: autenticación, solo lectura, limitada contra DoS | npm run test:rest |
| El número del benchmark | evals/longmemeval/ (harness completo en el repo) |
Para quién es
Myco es la capa de memoria para cualquier equipo cuyos agentes de IA necesiten recordar, con recibos. Cada página a continuación lo reformula para tu audiencia y recorre los mismos casos de uso en todas las industrias (FinTech, Salud, Legal, Contabilidad, Seguros, SaaS, soporte al cliente, e-commerce).
- Desarrolladores que construyen agentes para producción: un servidor MCP, una ruta de escritura determinista y procedencia que tú posees.
- Vibecoders que envían rápido: memoria persistente en una línea, sin clave y gratis, sin infraestructura que construir.
- Equipos que ponen IA en un producto: memoria del cliente, aislada por inquilino, en Postgres que tú posees.
- Agencias: cada cliente en un espacio de trabajo aislado y auditable.
Arquitectura

El diseño es simple a propósito: la base de datos es autoritativa, la ruta de escritura es programática y los LLM asisten sin convertirse en el almacén de memoria.
Superficie de herramientas
Myco Brain expone 13 herramientas MCP:
brain_context_packbrain_searchbrain_whybrain_neighborsbrain_ingestbrain_propose_factbrain_annotatebrain_save_memorybrain_recall_memorybrain_get_relatedbrain_statsbrain_set_modebrain_self_check
Entradas, salidas y ejemplos completos para cada herramienta: docs/api-reference.md.
Variables de entorno
El inicio rápido con Docker no necesita ninguna de estas — viene con credenciales locales precargadas y la búsqueda BM25 funciona de inmediato. Esta es la referencia para tu propio despliegue. Lista anotada completa con umbrales de ajuste:
.env.example. ¿No estás seguro de qué está activo? Ejecuta mycobrain-doctor.
Requeridas
| Variable | Predeterminado | Qué hace |
|---|---|---|
DATABASE_URL | — | Cadena de conexión a Postgres. El único requisito estricto. |
BRAIN_API_KEY | precargada | Clave brain_<workspace>_<agent>_<secret>; el inicio rápido incluye una clave de desarrollo local. |
BRAIN_WORKSPACE_ID | de la clave | Derivada de BRAIN_API_KEY; se establece explícitamente solo para autenticación de rol de servicio. |
Búsqueda semántica (opcional — sin ella, la búsqueda de texto completo BM25 sigue funcionando)
| Variable | Predeterminado | Qué hace |
|---|---|---|
BRAIN_EMBED_PROVIDER | auto | ollama o openai; selecciona automáticamente según qué credencial esté configurada. |
BRAIN_OLLAMA_EMBED_MODEL | nomic-embed-text | Modelo de embeddings local (sin clave, nada sale de tu máquina). |
BRAIN_OPENAI_API_KEY | — | Usa embeddings de OpenAI en lugar de los locales. |
Grafo de conocimiento (opcional)
| Variable | Predeterminado | Qué hace |
|---|---|---|
BRAIN_OLLAMA_BASE_URL | — | Endpoint local de extracción/embeddings (p. ej., http://localhost:11434). |
BRAIN_OLLAMA_MODEL | llama3.2:3b | Modelo de extracción local. |
BRAIN_ANTHROPIC_API_KEY | — | Grafo más preciso; se usa automáticamente si está configurado. |
BRAIN_EXTRACTION_PROVIDER | auto | Fuerza ollama o anthropic. |
Dial de confianza (gobernanza)
| Variable | Predeterminado | Qué hace |
|---|---|---|
BRAIN_REQUIRE_HUMAN_REVIEW | 0 | Curaduría estricta — nada de lo que proponga el LLM entra al grafo sin una decisión humana. |
BRAIN_SCHEMA_AUTO_PROMOTE | 0 | Permite que los nuevos tipos corroborados se promuevan solos, auditados y limitados al espacio de trabajo. |
Servicio
| Variable | Predeterminado | Qué hace |
|---|---|---|
BRAIN_REST_HOST | 127.0.0.1 | Host de enlace para mycobrain-rest. Usa 0.0.0.0 solo detrás de tu propio TLS/proxy. |
BRAIN_REST_PORT | 8787 | Puerto REST de solo lectura. |
BRAIN_HEALTH_PORT | 8080 | Puerto de verificación de salud. |
Identidad y seguridad
| Variable | Predeterminado | Qué hace |
|---|---|---|
BRAIN_REQUIRE_API_KEY_SECRET | 0 | Requiere un <secret> registrado para cada clave de agente antes de que la autenticación tenga éxito. |
BRAIN_TRUST_REQUEST_IDENTITY | 0 | Solo stdio, puertas de enlace multiinquilino. Desactivado: la identidad proviene únicamente del entorno, por lo que un workspace_id/api_key proporcionado por el llamador se ignora (resistente a inyección de prompts). Establece 1 solo detrás de una puerta de enlace que autentique cada solicitud. Detalles ↑ |
BRAIN_AGENT_ID | de la clave | Identidad del agente para autenticación de rol de servicio; derivada de BRAIN_API_KEY en caso contrario. |
BRAIN_SERVICE_ROLE_KEY | — | JWT de rol de servicio de Supabase para llamadores de servicio de confianza (alternativa a una clave brain_). |
Los umbrales de ajuste (
BRAIN_SCHEMA_PROMOTE_MIN_SEEN,BRAIN_EXTRACTION_LEASE_MS,BRAIN_FUNCTIONAL_PREDICATES, …) están en.env.example.
Estructura del repositorio
myco-brain/
├── mcp-server/              # TypeScript MCP server + bulk-ingest CLI
├── supabase/migrations/     # versioned SQL migrations
├── demos/                   # demos-as-code (VHS + ffmpeg + narration pipeline)
├── docs/quickstart.md       # setup guide
├── evals/
│   └── longmemeval/         # LongMemEval benchmark harness (run it yourself)
├── examples/
│   ├── demo-corpus/         # sample interconnected docs to ingest
│   └── benchmark/           # reproducible dedup + provenance benchmark
├── docker-compose.yml       # local quickstart
├── ROADMAP.md               # where this is headed
└── LICENSE                  # Apache-2.0
Importa tu historial de ChatGPT / Claude
Meses de conversaciones de asistente se convierten en memoria rastreable por procedencia, deduplicada y buscable — un documento por conversación:
# Official OpenAI data export (zip, extracted folder, or conversations.json)
mycobrain-ingest --from chatgpt-export ./chatgpt-export.zip

# claude.ai data export
mycobrain-ingest --from claude-export ./claude-export.zip
- Reimportar nunca duplica — cada conversación es un documento con clave de hash de contenido, por lo que una re-ejecución es una operación sin efecto. Continúa una conversación y vuelve a exportarla, y la transcripción más larga se importa como una nueva versión junto a la anterior.
- Los hilos ramificados de ChatGPT importan la rama ACTIVA — la transcripción que realmente conservaste, no las regeneraciones rechazadas.
- Procedencia completa —
brain_whyrastrea cada hecho importado hasta su archivo de exportación.
Prueba: npm run test:export-import.
Sin intervención — observa tus Descargas. Solicita tu exportación y deja que Myco la importe en cuanto llegue, sin ruta que copiar y sin que nada salga de tu máquina:
# Poll ~/Downloads and auto-import a ChatGPT/Claude export the second it arrives (Ctrl-C to stop)
mycobrain-ingest --watch-downloads

# Already downloaded it? Import whatever export is there, then exit
mycobrain-ingest --watch-downloads --once
Opt-in y deduplicado como cualquier otra importación; apúntalo a una carpeta diferente con BRAIN_WATCH_DIR (necesita unzip en tu PATH).
Lista de espera en la nube
El autoalojamiento es la opción predeterminada. Si prefieres alojamiento gestionado, únete a la lista de espera:
Esa página es el punto de entrada canónico de la lista de espera. Este README intencionalmente no incluye un formulario.
Archivos OSS
Recursos
- Inicio rápido
- Paquete npm
- Registro de cambios
- Audiencia + casos de uso por industria
- Rastreador de problemas
- Lista de espera en la nube
Quién construyó esto
Myco Brain fue construido por Nick Taylor — un especialista en growth marketing, no un ingeniero de carrera — dirigiendo un equipo de agentes de codificación con IA. Aproximadamente tres meses y unos $6k en gasto de modelos, construido con ingeniería asistida por IA. El punto no es el precio; es que una visión clara de producto más herramientas modernas de agentes pueden ahora producir infraestructura de nivel de producción — y este repositorio es el resultado: cada afirmación en esta página nombra una verificación ejecutable (ver Cada afirmación tiene una verificación), para que puedas juzgarlo tú mismo en lugar de tomar la historia de origen por fe.
¿Te gusta? Una ⭐ ayuda a otros a encontrarlo, y Watch → Releases (arriba de la página) te avisará cuando lleguen nuevas capacidades — consulta la hoja de ruta para lo que viene.
¿Lo quieres para tu equipo? Si tu empresa quiere a alguien que pueda construir sistemas de agentes, automatización e ingeniería de growth como esto, eso es lo que hace The Good Guys — escribe a nick@thegoodguys.la o reserva una llamada.