LLMSlim Memory
Memoria a largo plazo para clientes MCP sin llamada a LLM. Almacena mensajes palabra por palabra en SQLite local y recupera los que responden a una pregunta dentro de un presupuesto de tokens.
Documentación



La capa de contexto para agentes de IA en producción. Este repositorio es LLMSlim Core (v0.11.1, MIT): planificación y compresión de contexto local-first que ajusta prompts, historial de conversación, RAG, memoria y esquemas de herramientas a presupuestos de tokens reales, preservando las instrucciones y los límites de ejecución.
Live Studio Playground • Documentación • Integración con Sarvam • Benchmarks • Changelog
Pruébalo en 60 segundos
1. Instala LLMSlim Core desde PyPI (Python 3.9+). Ejecutarlo no requiere clave de API, modelo ni llamada de red:
pip install llmslim
2. Ejecuta este fragmento:
from llmslim import compress

ticket = """
Hi team, I hope you are all doing well and had a good weekend.
I am writing about invoice INV-2291, which charged us $480 instead of $240.
We upgraded to the Pro plan on 3 September, but the old Basic plan was billed as well.
Our finance lead was asking about this during the weekly sync, which ran long as usual.
Please refund the duplicate $240 charge to the card ending 4417.
Thanks so much, and let me know if you need anything else from me.
"""

result = compress(ticket, target_ratio=0.6)  # target: keep about 60% of the tokens
print(result.compressed_text)
print(f"{result.original_tokens} -> {result.compressed_tokens} tokens ({result.reduction_percent:.1f}% fewer)")
3. Lo que deberías ver (llmslim 0.11.1, instalación base):
Hi team, I hope you are all doing well and had a good weekend. I am writing about invoice INV-2291, which charged us $480 instead of $240. We upgraded to the Pro plan on 3 September, but the old Basic plan was billed as well. Please refund the duplicate $240 charge to the card ending 4417.
112 -> 72 tokens (35.7% fewer)
Se descartan dos de las seis oraciones; se conservan el número de factura, los importes, el cambio de plan
y la solicitud de reembolso. El modo extractivo predeterminado solo selecciona oraciones
de tu entrada, por lo que la misma entrada siempre produce la misma salida. La instalación base
estima los tokens a aproximadamente 4 caracteres por token e imprime una advertencia de una línea
indicándolo. Con pip install "llmslim[fast-tokens]", los tokens se cuentan con
tiktoken en su lugar: en esta entrada se conservan las mismas cuatro oraciones y el recuento
muestra 107 -> 72 tokens (32.7% fewer).
Siguiente: Docs • Plataforma beta • Issues
Si LLMSlim te resulta útil, considera darle una estrella al repositorio o abrir un issue con tus comentarios.
LLMSlim Core y LLMSlim Platform
| LLMSlim Core | LLMSlim Platform | |
|---|---|---|
| Versión | 0.11.1 | 0.9.1 beta |
| Licencia | MIT, este repositorio | Propietaria, beta privada |
| Instalación | pip install llmslim | Por invitación; no publicada en PyPI |
| Qué hace | Comprime, planifica y traza el contexto visible para el modelo dentro de tu proceso de Python | Se basa en Core: una línea de tiempo verificable del estado del agente, decisiones de contexto explicables y reproducibles, y políticas de contexto orientadas a resultados que comienzan en modo sombra |
Core es y seguirá siendo totalmente de código abierto. Platform es un producto separado que depende de Core; nada de su código reside en este repositorio. Lee más y solicita acceso a la beta en llmslim.app/platform.
Novedades en Core: el runtime de contexto para agentes (v0.7.0) y el runtime de contexto con reconocimiento de caché (v0.7.1). Ambos están en el paquete de PyPI a partir de la 0.7.1; la 0.7.0 se etiquetó pero no se publicó en PyPI.
Planificador de contexto adaptativo (v0.6.0)
LLMSlim ya no es solo un compresor de prompts de ratio fijo. El Planificador de
Contexto Adaptativo elige representaciones seguras para cada elemento de contexto y luego usa
un asignador restringido determinista para ajustar el contexto de mayor valor a un
presupuesto de modelo finito. La API original compress() sigue siendo totalmente compatible.
La versión v0.6.0 añade decisiones explicables por elemento, informes explícitos de inviabilidad, validación posterior a la planificación, telemetría de tokens y costes, presets de políticas e integraciones opcionales con Sarvam AI, Zoho y MongoDB, manteniendo la instalación base local-first y neutral respecto al proveedor.
from llmslim import plan_context

plan = plan_context(
    messages=[
        {"role": "system", "content": "Answer only from verified context."},
        {"role": "user", "content": "When does Acme renew?"},
    ],
    documents=[{"content": "CRM: Acme renews on 2026-11-30."}],
    query="Acme renewal date",
    model="sarvam-105b",
    max_input_tokens=8_000,
    reserve_output_tokens=512,
)
assert plan.feasible
print(plan.final_context)
print(plan.metrics.planned_tokens, plan.metrics.estimated_input_cost_after)
La planificación funciona sin conexión con la instalación base. Las integraciones opcionales están aisladas detrás de extras:
pip install "llmslim[sarvam]"   # Sarvam provider (official sarvamai SDK)
pip install "llmslim[zoho]"     # CRM and WorkDrive context sources
pip install "llmslim[mongodb]"  # explicit memory and Atlas retrieval
Consulta la arquitectura, el algoritmo, el modelo de seguridad, la CLI y el benchmark offline medido.
Programas de startups
LLMSlim forma parte de 15 programas de startups. Proporcionan créditos, herramientas y orientación; ninguno de ellos es inversor, y la pertenencia no implica respaldo.
| Programa | Empresa |
|---|---|
| Sarvam Startup Program | Sarvam AI |
| Zoho for Startups | Zoho |
| MongoDB for Startups | MongoDB |
| Claude for Startups | Anthropic |
| OpenAI for Startups | OpenAI |
| Auth0 for Startups | Okta (Auth0) |
| Zendesk for Startups | Zendesk |
| Mixpanel for Startups | Mixpanel |
| Sentry for Startups | Sentry |
| Descope Hello World Startup Program | Descope |
| Pulumi for Startups | Pulumi |
| Honeycomb for Builders | Honeycomb |
| Exa Startup Grants | Exa |
| Neo4j Startup Program | Neo4j |
| Cartesia Startups Grant Program | Cartesia |
Los logotipos son marcas comerciales de sus propietarios e identifican cada programa.
Sarvam Startup Program e integración con Sarvam
✦ Aceptados en el Sarvam Startup Program
LLMSlim ha sido aceptado en el Sarvam Startup Program. Esto es únicamente pertenencia a un programa: no es una asociación y no implica un respaldo por parte de Sarvam AI.
Por separado, LLMSlim Core incluye una integración opcional con Sarvam (llmslim[sarvam])
construida sobre el SDK oficial de Python sarvamai. Planificas y comprimes el contexto localmente
y luego envías solo el contexto planificado a un modelo de Sarvam como sarvam-105b.
- Planificación local: los documentos recuperados se planifican y comprimen en tu proceso de Python antes de enviar cualquier solicitud.
- Local-first: el contexto recuperado sensible permanece local; solo el contexto planificado se envía al modelo.
- Tu aplicación mantiene el control: LLMSlim es un preprocesador. Tu aplicación es propietaria de las claves de API, los prompts y la inferencia, y no se envía nada a Sarvam a menos que tu código llame al proveedor.
Inicio rápido: Planificación adaptativa + Sarvam
pip install "llmslim[sarvam]"
export SARVAM_API_KEY="..."   # your own Sarvam API key
from llmslim import plan_context
from llmslim.integrations.sarvam import SarvamProvider

documents = [
    {"content": "Q3 filing: new data-localisation rules take effect in April 2027."},
    {"content": "Q3 filing: two pending licence renewals carry a regulatory risk of delay."},
]

plan = plan_context(
    messages=[{"role": "system", "content": "Answer from verified context."}],
    documents=documents,
    query="Summarize the key regulatory risks.",
    model="sarvam-105b",
    max_input_tokens=8_000,
    reserve_output_tokens=256,
)
provider = SarvamProvider.from_env(model="sarvam-105b", max_tokens=256)
answer = provider.chat([{"role": "user", "content": plan.final_context}])
print(answer, provider.last_usage)
👉 Lee la guía de integración con Sarvam (también en docs/integrations/SARVAM.md)
🔮 ¿Qué es LLMSlim?
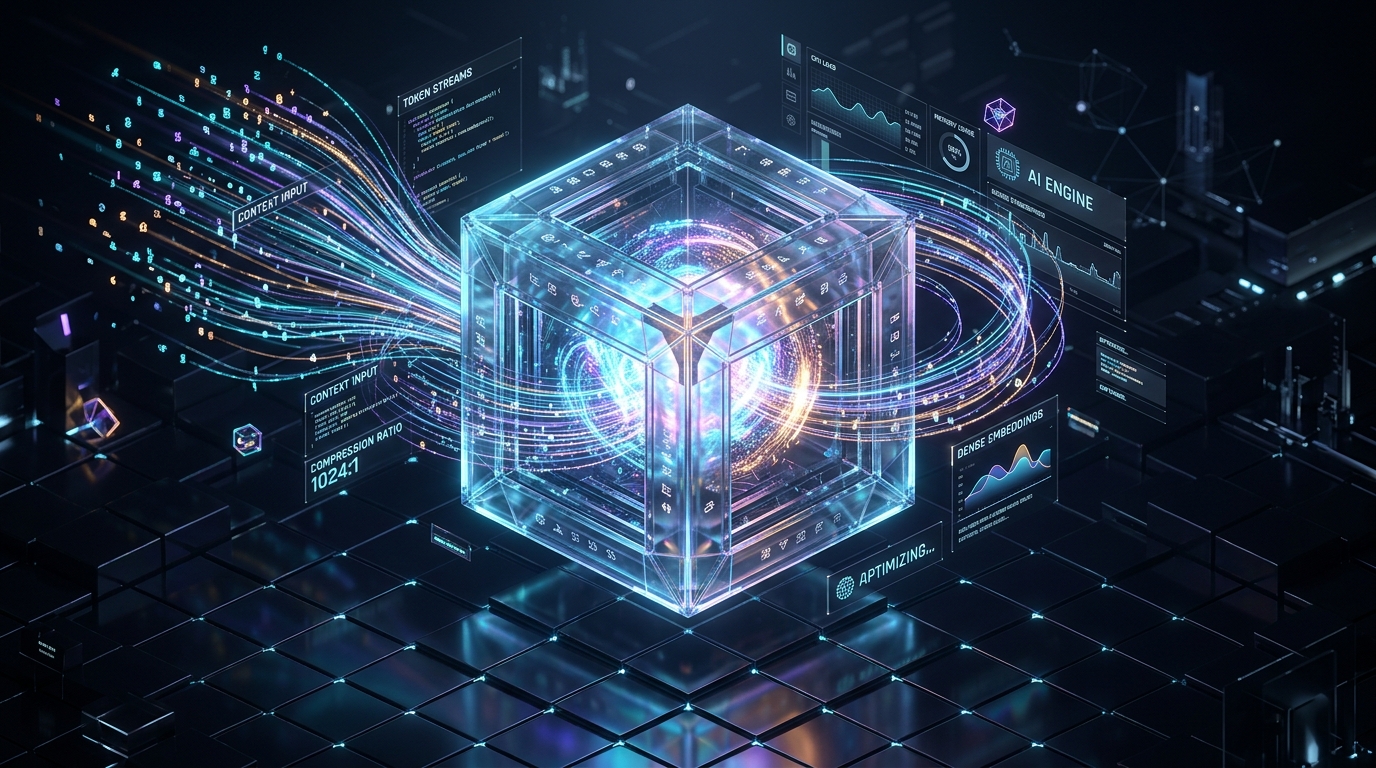
LLMSlim Holographic Engine: compresión de tokens en múltiples etapas que condensa flujos de contexto dispersos en núcleos de información densos sin mutación del contrato.
Los sistemas LLM modernos sufren el Dilema de la Ventana de Contexto:
- Impuesto financiero: reenviar prompts grandes en cada turno significa que pagas por los mismos tokens de entrada una y otra vez.
- Cuello de botella de latencia: los prompts grandes inflan el Time-To-First-Token (TTFT) y los tiempos de cola.
- Síndrome de lo perdido en el medio: los modelos pueden pasar por alto o usar mal información enterrada en medio de contextos largos.
- Riesgos de seguridad: el contenido RAG no confiable puede introducir inyecciones de prompt indirectas en las instrucciones del sistema.
LLMSlim lo soluciona en el origen. Proporciona una compresión determinista que preserva el contrato y se ejecuta de forma nativa en la capa de tu aplicación antes de llamar a cualquier modelo.
💎 Pilares arquitectónicos fundamentales
| Pilar | Cómo lo resuelve LLMSlim |
|---|---|
| 🏎️ Sobrecarga ultrabaja | Python puro + NumPy/Scikit-learn. Mediana de 0.026 ms por muestra (p95 1.889 ms) en la evaluación de Fase 2 de 24 muestras, en su mayoría de texto corto, sin llamadas a modelos en la ruta predeterminada. Las entradas más largas tardan más. |
| 🔒 Determinista por defecto | El modo extractivo predeterminado solo selecciona oraciones de tu entrada, por lo que la salida es reproducible y no contiene texto generado. Aun así puede descartar un dato que necesites, así que verifica los resultados para tu caso de uso. Los modos de reescritura e híbrido llaman a tu propio LLM. |
| 🛡️ Seguridad de procedencia | La jerarquía de ContextRole aísla el texto no confiable de RAG/herramientas para que las inyecciones de prompt no puedan escalar a la prioridad system. |
| 🧩 Esquemas de herramientas seguros para el contrato | Normalización JSON canónica, huellas de contrato SHA-256 y cero reescrituras de ejecución para las herramientas del agente. |
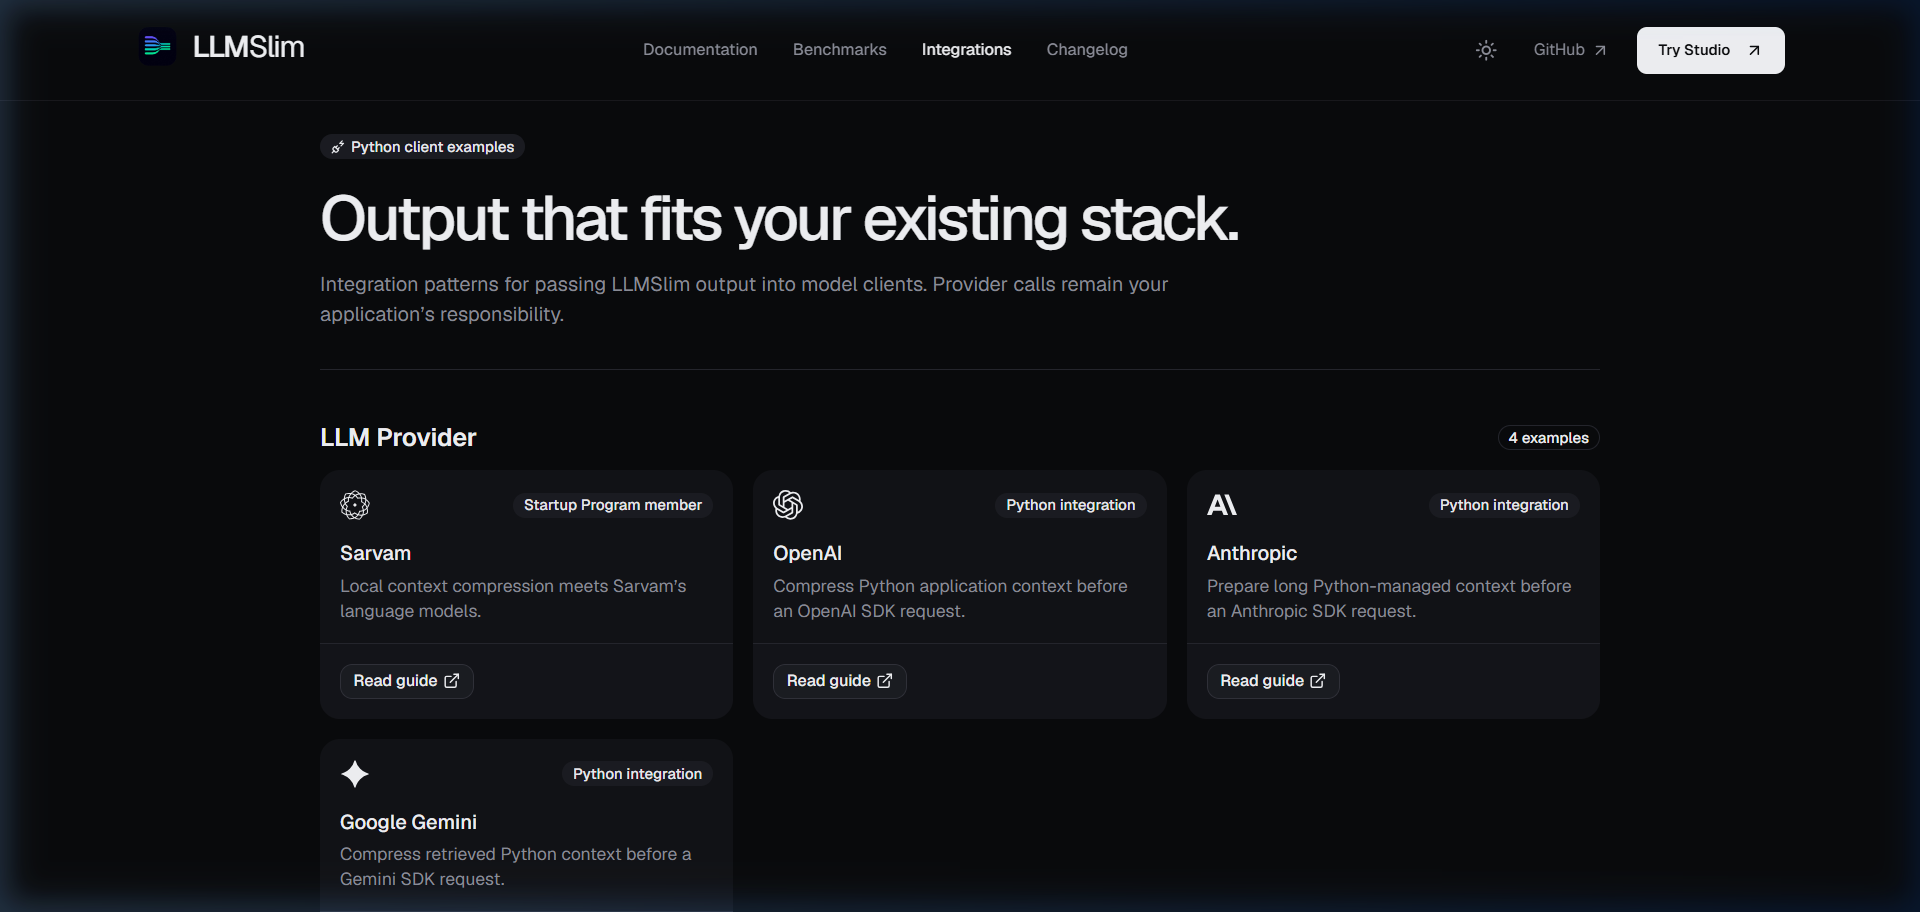
| 🔌 Neutral respecto al proveedor | Constructores de solicitudes sin ejecución para Sarvam, OpenAI, Anthropic, Gemini y vLLM, además de un puente para el OpenAI Agents SDK. Funciona con cualquier framework que pueda pasar listas simples de mensajes o documentos. |
🖥️ Live Studio Playground (www.llmslim.app)
Pega un chat largo, un montón de resultados de búsqueda o un log de CI, haz una pregunta y observa cómo LLMSlim conserva lo que la responde. El Studio muestra los tokens y el coste ahorrados, si la respuesta sobrevivió y qué habría conservado en su lugar un truncado simple al mismo tamaño.
- Escenarios listos para usar: un chat de soporte de seis meses, resultados de búsqueda del centro de ayuda y un log de CI con un fallo, cada uno con una pregunta cuya respuesta se conoce.
- Tu propio texto: pega hasta unos 16.000 tokens y elige cuánto conservar.
- En contexto: las líneas conservadas se resaltan dentro del original, junto al texto exacto que recibiría el modelo.
- Sin llamada al modelo: el Studio ejecuta Core en el servidor y no llama a ningún proveedor. Nada de lo que pegues se almacena.
Consulta el despliegue del Studio y la política de seguridad.
🌐 Sitio web y documentación modernos para desarrolladores
Explora nuestro sitio de documentación rediseñado en modo oscuro/claro que cubre patrones de integración de extremo a extremo:
📦 Instalación
# Core package (Deterministic extractive engine, 0 external LLM dependencies)
pip install llmslim

# With optional Model Context Protocol (MCP) catalog ingestion (Python 3.10+)
pip install "llmslim[mcp]"

# With optional OpenAI Agents SDK host bridge (Python 3.10+)
pip install "llmslim[agents]"

# With optional local multilingual semantic retrieval
pip install "llmslim[semantic]"

# Sarvam: chat providers, language tools and document source (official sarvamai SDK)
pip install "llmslim[sarvam]"

# Exa web search as an untrusted RAG context source (spend capped in USD)
pip install "llmslim[exa]"

# Neo4j temporal agent memory with auditable supersession
pip install "llmslim[neo4j]"

# Read-only Zoho CRM and WorkDrive context sources
pip install "llmslim[zoho]"

# Explicit MongoDB context memory and Atlas retrieval
pip install "llmslim[mongodb]"

# LangChain, LlamaIndex (Python 3.10+) and Haystack adapters
pip install "llmslim[langchain]"
pip install "llmslim[llamaindex]"
pip install "llmslim[haystack]"

# Agent history: gptme (0.34+) and Pydantic AI adapters (Python 3.10+).
# Hermes Agent needs no extra: install llmslim into Hermes's environment.
pip install "llmslim[gptme]"
pip install "llmslim[pydantic-ai]"

# All optional extensions
pip install "llmslim[all]"
Requisitos: Python 3.9 o superior. La instalación predeterminada no requiere SDK de proveedor, PyTorch, sentence-transformers ni ningún servicio en la nube.
⚡ Inicio rápido y patrones de uso
1. Compresión extractiva básica (predeterminada)
from llmslim import ContextRole, compress

text = """
The Apollo program was conceived in 1960 during the Eisenhower administration.
NASA announced the program as a follow-up to Project Mercury.
The spacecraft was designed to carry three astronauts.
Apollo succeeded in landing the first humans on the Moon in 1969.
Funding for the program peaked in 1966 with over $4.5 billion appropriated.
"""

result = compress(
    text,
    target_ratio=0.5,                    # Target: keep about 50% of the tokens
    strategy="extractive",               # Deterministic sentence selection
    context_role=ContextRole.GENERAL,
)

print("Compressed Output:")
print(result.compressed_text)
print(f"Original: {result.original_tokens} tokens | Compressed: {result.compressed_tokens} tokens")
print(f"Saved: {result.tokens_saved} tokens ({result.reduction_percent:.1f}%)")
print(f"Sentences kept: {result.sentences_kept} of {result.sentences_total}")
La selección extractiva conserva oraciones completas, no el significado: comprueba siempre que
las oraciones que necesitas hayan sobrevivido. En este texto, la instalación base 0.7.1 conserva tres de
las cinco oraciones y descarta la oración del alunizaje de 1969; con
llmslim[fast-tokens] (recuentos de tiktoken) conserva esa oración y descarta otra.
2. Compresión RAG multidocumento
Comprime cada fragmento recuperado antes de construir el prompt. compress_documents
acepta cadenas simples y devuelve un resultado por documento, en orden:
from llmslim import compress_documents

documents = [
    "Q3 revenue grew 23% year-over-year to $1.2B. "
    "Growth came mainly from enterprise subscriptions in India and Southeast Asia. "
    "The board met twice during the quarter. "
    "The office cafeteria menu was updated in August. "
    "A new logo was unveiled at the annual offsite. "
    "Net revenue retention reached 118%, up from 109% a year earlier.",
    "Operating expenses rose 11% because of AI research infrastructure. "
    "Most of the increase was GPU capacity for model evaluation. "
    "Travel costs were flat. "
    "The parking garage was repainted in September. "
    "Employees voted on a new name for the meeting rooms. "
    "Headcount in engineering grew by 40 people.",
]

results = compress_documents(
    documents,
    query="What drove Q3 revenue and cost changes?",
    target_ratio=0.5,
)

context = "\n\n".join(r.compressed_text for r in results)
print(context)
print(f"Saved {sum(r.tokens_saved for r in results)} tokens across {len(results)} documents")
Con una consulta, los documentos comparten un presupuesto y este se dirige hacia donde apunta la consulta. La relevancia es léxica por defecto (BM25 con retroalimentación: sin modelo, determinista, decenas de milisegundos en un contexto de 3k tokens). Para RAG y memoria de chat largo, donde la respuesta a menudo comparte pocas palabras con la pregunta, añade el reranker opcional:
# pip install "llmslim[semantic]"   (sentence-transformers; uses a GPU when there is one)
results = compress_documents(documents, query=question, target_ratio=0.25, relevance="semantic")
relevance también acepta cualquier scorer(query, texts) -> scores invocable, como una API de reranking alojada.
¿Recuperas con LangChain, LlamaIndex o Haystack? Usa los
adaptadores de framework en lugar de llamar a
compress_documents tú mismo.
[!NOTE]
compress_documentstrata los documentos como no confiables (ContextRole.RAG) por defecto, por lo que la redacción imperativa dentro de un documento recuperado nunca se conserva a la fuerza como una instrucción protegida. No elimina el texto inyectado: una oración inyectada aún puede sobrevivir a la compresión. Para marcar el contenido recuperado como no confiable en el prompt final, usaplan_contextoContextRuntime, que envuelven cada documento en una etiqueta de procedenciatrusted="false"e ignoran cualquier rol que un documento se atribuya a sí mismo.
3. Compresión de conversaciones de chat multiturno
Comprime los turnos anteriores largos mientras dejas pasar sin cambios las instrucciones system y las preguntas del usuario:
from llmslim import compress_chat_messages

review = (
    "Here are my suggestions for your schema. First, add a composite index on "
    "(customer_id, created_at) because most of your queries filter by customer and sort by "
    "date. Second, the orders table stores the shipping address inline, which duplicates "
    "data across rows; move it to an addresses table. Third, the status column is a "
    "free-text string, so use an enum or a lookup table instead. Fourth, the price column "
    "uses FLOAT, which loses precision for money; use DECIMAL(12, 2). Finally, add ON "
    "DELETE RESTRICT to the foreign key from orders to customers so that deleting a "
    "customer cannot silently orphan their orders."
)

messages = [
    {"role": "system", "content": "You are a specialized code review engineer."},
    {"role": "user", "content": "Can you review my database schema design?"},
    {"role": "assistant", "content": review},
    {"role": "user", "content": "What about the foreign key constraint on line 42?"},
]

compressed_messages = compress_chat_messages(
    messages,
    target_ratio=0.5,
    compressible_roles=("assistant",),  # Only compress assistant turns; system and user pass through
    min_tokens=60,                      # Turns shorter than this are never compressed
)

for message in compressed_messages:
    print(f"{message['role']}: {message['content']}")
4. Optimización híbrida de prompts (extractiva + reescritura)
Combina el prefiltrado extractivo ultrarrápido con tu propio proveedor de LLM para una paráfrasis semántica profunda:
from llmslim import CallableProvider, compress
import openai

client = openai.OpenAI()  # reads OPENAI_API_KEY; requires `pip install openai`

long_raw_text = """
The Apollo program was conceived in 1960 during the Eisenhower administration.
NASA announced the program as a follow-up to Project Mercury.
The spacecraft was designed to carry three astronauts.
Apollo succeeded in landing the first humans on the Moon in 1969.
Funding for the program peaked in 1966 with over $4.5 billion appropriated.
"""

# Define your own provider callback (LLMSlim does not bundle vendor SDKs).
# The callback receives a RewriteRequest with ready-made prompts and returns text.
provider = CallableProvider(
    lambda req: client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": req.system_prompt},
            {"role": "user", "content": req.user_prompt},
        ],
    ).choices[0].message.content
)

result = compress(
    long_raw_text,
    target_ratio=0.3,
    strategy="hybrid",                   # 1. Extractive filter -> 2. LLM semantic rewrite
    provider=provider,
)

meta = result.rewrite_metadata
print(result.compressed_text)
print(f"Strategy: {meta.strategy} | Rewrite accepted: {meta.accepted} | Fell back to extractive: {meta.fallback_used}")
print("Validation failures:", meta.failure_reasons)
Cada reescritura se valida en cuanto a estructura, retención de instrucciones, retención de entidades y similitud. Si una reescritura híbrida no supera la validación, LLMSlim devuelve el resultado extractivo en su lugar e informa por qué en rewrite_metadata.failure_reasons.
Agentes de programación: llmslim wrap claude
Claude Code reenvía toda la conversación en cada turno. Así, los registros de pruebas largos, la salida de compilación, los resultados de búsqueda y las páginas web se pagan una y otra vez, y además se suman al contexto que Claude Code acaba compactando.
llmslim wrap claude ejecuta Claude Code a través de un proxy local:
- Reduce esa salida la primera vez que el modelo la ve. Las líneas que parecen errores, fallos o advertencias van primero, y después las líneas relacionadas con el comando.
- Envía exactamente los mismos bytes en cada solicitud posterior, de modo que la caché de prompts sigue acertando y el razonamiento de Claude sigue siendo válido.
- La salida de las propias herramientas de Claude Code
Read,EdityWritenunca se toca. Un archivo impreso a través del shell (cat,head) cuenta como salida del shell.
pip install "llmslim[proxy]"
llmslim wrap claude
llmslim proxy stats
Qué efecto tiene en la factura, medido en Claude Code 2.1.296 real con Claude Haiku 5.5, en ocho tareas sintéticas pequeñas. Contamos dólares a precio de lista a partir del uso de la API, con las lecturas de caché valoradas por separado, y publicamos las 572 ejecuciones en benchmarks/claude_code_cost. El resultado principal tiene ambos brazos en el modo de permisos predeterminado de Claude Code; una segunda ejecución tiene ambos en modo automático.
- Registros largos: una ejecución de CI fallida simulada (unos 12 KB de registro, con la causa en el medio) costó entre un 26 y un 32 % menos, y una ejecución de lint con tres errores entre 240 advertencias, entre un 17 y un 21 % menos.
- Ejecuciones de pruebas: alrededor de un 4 % menos en modo predeterminado, dentro del ruido para cada tarea; entre un 2 y un 15 % menos en modo automático. Los agentes ya recortan la salida de las pruebas con
tail. - En 8 tareas: +5,3 % en modo predeterminado (intervalo del 95 %: +1,5 % a +9,4 %), sobre todo por una tarea en la que el JSON acortado costó aproximadamente el doble; -5,1 % en modo automático. El JSON se deja intacto de forma predeterminada desde la 0.11.1.
- Sesiones reales: en una reproducción sin conexión de las propias transcripciones del mantenedor (32 sesiones y las 412 ejecuciones de subagentes que iniciaron, casi todas con Claude Opus 5.5, a precios de lista), la salida de herramientas fue una parte pequeña de la factura: con los mismos turnos, si toda la salida de shell, búsqueda y web hubiera costado cero, se habría reducido un 13,4 %. La relectura de contexto largo fue la parte grande. El ajuste
/autocompactde Claude Code decide cuándo compacta; qué efecto tiene eso en el coste no se mide aquí.
Sin la reproducción byte a byte, un historial editado invalida el razonamiento de Claude: en nuestra comprobación de API con Claude Haiku 5.5, la solicitud fue rechazada con HTTP 400, el valor predeterminado para cuentas creadas el 31 de agosto de 2026 o después. Con la reproducción, las lecturas de caché crecieron en cada solicitud de una prueba de API de 7 solicitudes. Consulta docs/PROXY.md para saber qué se comprime, los límites y la seguridad.
Como plugin de Claude Code. El plugin añade el servidor de memoria de LLMSlim (más abajo) y dos comandos:
/llmslim:wrap-claudete guía para iniciar Claude Code a través del proxy;/llmslim:savingsmuestra cuántos tokens de salida de herramientas mantuvo el proxy fuera de tus solicitudes: una estimación contada antes de los descuentos de la caché de prompts, no dólares ahorrados.
/plugin marketplace add Thanatos9404/llmslim
/plugin install llmslim@llmslim
En Claude Code 2.1.275 o posterior, /plugin install llmslim --marketplace Thanatos9404/llmslim hace ambas cosas en un solo paso.
El servidor de memoria se ejecuta con uvx, así que necesita uv.
Memoria para agentes, sin LLM en el bucle
llmslim.memory almacena cada turno literalmente y selecciona, en el momento de la lectura, los turnos que responden a una pregunta dentro de un presupuesto de tokens. No hay modelo de extracción a la entrada ni llamada a modelo a la salida.
from llmslim.memory import Memory

memory = Memory("memory.db")  # SQLite, built into Python
memory.add([{"role": "user", "content": "I'm allergic to peanuts."}], user_id="asha")
context = memory.search("Am I allergic to anything?", user_id="asha", budget=1500)
print(context.text)  # put it in the prompt as untrusted data
Ejecuta el pipeline que hay detrás de los benchmarks de la ronda 3. En las propias preguntas de LongMemEval de Mem0, ese pipeline (con su reranker) respondió un 78,3 % por 1,04 $ por cada 1.000 preguntas, frente a un 76,7 % por 220,88 $ de Mem0. ¿Vienes de Mem0? from llmslim.memory.compat import Mem0Memory as Memory conserva los nombres de métodos de Mem0. Consulta docs/MEMORY.md para ámbitos, almacenes, evidencias y límites, y la hoja de ruta 1.0.
En Claude, Cursor o cualquier cliente MCP
llmslim mcp sirve esta memoria a través de MCP, con una herramienta fit_context para texto largo. Necesita pip install "llmslim[mcp]" en Python 3.10+.
claude mcp add llmslim -- llmslim mcp
- Herramientas:
remember,recall,list_memories,forgetyfit_context. - Ámbito: el servidor lo fija con
--user-id, de modo que el modelo no puede leer la memoria de otro usuario. - Almacenamiento: un archivo SQLite local; el servidor no hace llamadas de red.
- Más: las configuraciones de cliente y las opciones están en docs/MCP.md.

Por HTTP, desde cualquier lenguaje
llmslim serve pone la misma memoria y un endpoint de ajuste de contexto detrás de una pequeña API JSON. Se ejecuta como un solo proceso con un solo archivo SQLite y sin llamadas a modelos. Instálalo con pip install "llmslim[server]", o compila el Dockerfile.
curl -s localhost:8080/v1/memories/search -H 'content-type: application/json' -d '{"user_id": "asha", "query": "Where did I move to?", "budget": 1500}'
Necesita una clave de API de portador para escuchar más allá de localhost. Las rutas, los límites y la configuración de Docker están en docs/SERVER.md.
El cliente de TypeScript, npm install llmslim (clients/typescript), envuelve esta API sin dependencias. También proporciona al Vercel AI SDK las herramientas recall_memory y remember y un middleware que guarda los turnos. Ninguno de ellos modifica tu prompt, así que las cachés de prompts siguen acertando y el razonamiento preservado de Claude sigue siendo válido.
Uso con LangChain / LlamaIndex / Haystack
Cada adaptador ejecuta compress_documents sobre los documentos recuperados, con el mismo presupuesto compartido cuando hay una consulta. Los documentos conservados mantienen sus metadatos, y los documentos que se comprimen hasta quedar vacíos se descartan. Se ejecutan localmente sin modelo.
| Framework | Instalación | Clase | Úsalo donde usarías |
|---|---|---|---|
| LangChain | llmslim[langchain] | llmslim.integrations.langchain.LLMSlimCompressor | LLMLinguaCompressor, p. ej. en ContextualCompressionRetriever |
| LlamaIndex | llmslim[llamaindex] (Python 3.10+) | llmslim.integrations.llama_index.LLMSlimPostprocessor | LongLLMLinguaPostprocessor, en node_postprocessors |
| Haystack | llmslim[haystack] | llmslim.integrations.haystack.LLMSlimDocumentCompressor | un componente entre el recuperador y el constructor de prompts |
from langchain_classic.retrievers.contextual_compression import ContextualCompressionRetriever
from llmslim.integrations.langchain import LLMSlimCompressor

retriever = ContextualCompressionRetriever(
    base_compressor=LLMSlimCompressor(target_ratio=0.25),
    base_retriever=your_retriever,
)
Ejemplos ejecutables con su salida: LangChain, LlamaIndex, Haystack.
Uso con gptme / Hermes Agent / Pydantic AI
Estos adaptadores ajustan el historial de mensajes de un agente a un presupuesto de tokens. Mantienen el prompt del sistema, las llamadas a herramientas y los turnos más recientes tal como están, comprimen localmente la salida de herramientas y los turnos antiguos (los fallos y tracebacks en la salida de herramientas se conservan), y mantienen cada llamada a herramienta emparejada con su resultado. No hay llamada a modelo.
| Agente | Instalación | Clase o función | Cómo se integra |
|---|---|---|---|
| gptme | llmslim[gptme] (gptme 0.34+) | llmslim.integrations.gptme.LLMSlimContextProvider | proveedor de contexto de gptme llmslim; [plugin.llmslim] compaction = true lo convierte en el que usa la compactación de gptme |
| Hermes Agent | llmslim en el entorno de Hermes | llmslim.integrations.hermes.LLMSlimContextEngine | plugin ContextEngine de llmslim; selecciónalo con context.engine: llmslim |
| Pydantic AI | llmslim[pydantic-ai] (1.0+) | llmslim.integrations.pydantic_ai.llmslim_history_processor | procesador de historial, en ProcessHistory(...) o history_processors=[...] |
from pydantic_ai import Agent
from pydantic_ai.capabilities import ProcessHistory
from llmslim.integrations.pydantic_ai import llmslim_history_processor

agent = Agent(
    "openai:gpt-5",
    capabilities=[ProcessHistory(llmslim_history_processor(max_tokens=8_000))],
)
Configuración y ejemplos ejecutables con su salida: gptme, Hermes Agent, Pydantic AI.
🛡️ Arquitectura de seguridad: aislamiento de procedencia
Los algoritmos de compresión que puntúan las frases de forma ingenua según palabras clave imperativas ("Must", "Always", "Action Required") introducen una vulnerabilidad grave: la amplificación de inyección de prompts indirecta. Un atacante que inyecta instrucciones maliciosas en un documento RAG recuperado puede engañar al compresor para que conserve la carga del ataque y descarte contexto legítimo.
Encontramos este problema en LLMSlim internamente y lo corregimos en la v0.3.1. No se publicó ningún CVE ni aviso de seguridad, y el problema no tiene una puntuación CVSS oficial.
LLMSlim lo resuelve mediante un límite de confianza de rol de contexto explícito:
 ┌────────────────────────────────────────────────────────┐
 │           HIGHEST TRUST (Priority Tier 4)              │
 │  System & Developer Prompts (Strictly Protected)       │
 ├────────────────────────────────────────────────────────┤
 │           INTERMEDIATE TRUST (Priority Tier 2-3)       │
 │  Direct User Input                                     │
 ├────────────────────────────────────────────────────────┤
 │           PROVENANCE-LOCKED (Priority Tier 0-1)        │
 │  RAG Documents • Assistant History • Tool Outputs     │
 │  *Cannot reach Tier 4 through imperative patterns*     │
 └────────────────────────────────────────────────────────┘
- Bloqueo de prioridad reforzado: el contenido marcado como
ContextRole.RAG,ContextRole.TOOLoContextRole.ASSISTANTno puede alcanzar la prioridad de nivel 4, independientemente de su sintaxis imperativa. - Delimitadores de reescritura protegidos con nonce: cuando la entrada contiene un token similar a una valla como
---END TEXT---, las vallas de la plantilla de reescritura reciben un nonce aleatorio por llamada, de modo que el token incrustado no puede cerrar la región de texto. La entrada en sí nunca se modifica. - No confiable por defecto, no filtrado: estas protecciones impiden que el texto inyectado gane prioridad. No lo eliminan.
plan_contextyContextRuntimelo etiquetan comotrusted="false"en el contexto final para que tu modelo y tu aplicación puedan tratarlo en consecuencia.
🧩 Esquemas de herramientas seguros para contratos e ingesta MCP
Los catálogos grandes de agentes (decenas o cientos de definiciones de herramientas) desperdician miles de tokens antes de que un agente empiece siquiera a razonar. LLMSlim introduce la infraestructura de herramientas segura para contratos (v0.4.0 y v0.5.0):
from llmslim.tools import (
    canonical_json,
    contract_equivalent,
    fingerprint_tool_schema,
    from_mcp_tool,
    optimize_tool_schema,
)

# 1. Ingest authoritative raw tool definition
raw_tool = {
    "name": "enterprise.search_ledger",
    "description": "Searches financial transaction records by date range.",
    "inputSchema": {
        "type": "object",
        "properties": {"account_id": {"type": "string"}, "limit": {"type": "integer"}},
        "required": ["account_id"],
    },
}

# 2. Parse and safely optimize schema formatting
tool = from_mcp_tool(raw_tool, namespace="finance")
result = optimize_tool_schema(tool)

# 3. Mathematically verify exact contract equivalence
assert result.equivalence.status.value == "EXACT"
assert fingerprint_tool_schema(tool) == fingerprint_tool_schema(result.optimized)

print("Canonical Fingerprint:", fingerprint_tool_schema(result.optimized))
print(canonical_json(result.optimized.raw))
Origen de catálogo MCP asíncrono (v0.5.0)
Requiere pip install "llmslim[mcp]" (Python 3.10+) y un servidor MCP que ejecutes tú:
import asyncio

from llmslim.mcp import MCPToolCatalogSource, PlanMode, plan_catalog_context


async def main() -> None:
    # Streamable HTTP MCP source with bounded pagination and stale-cache detection
    source = MCPToolCatalogSource.from_streamable_http(
        "http://127.0.0.1:8000/mcp",
        headers={"Authorization": "Bearer local-token"},
    )

    snapshot = await source.list_tools()
    plan = plan_catalog_context(snapshot, mode=PlanMode.FULL)

    print(f"Catalog contains {len(snapshot.tools)} tools ({plan.metrics.catalog_tokens} tokens)")


asyncio.run(main())
📊 Benchmarks y transparencia radical
Muchas bibliotecas hacen afirmaciones sin fundamento sobre una compresión de prompts del 90 %. En LLMSlim practicamos la transparencia radical en los benchmarks:
Ronda 3: Core 0.9.0 frente a sistemas de memoria y compresores, el coste primero
Medido el 13-15 de octubre de 2026 sobre preguntas de prueba reservadas. Cada sistema es leído por Claude Haiku 5.5 con el mismo prompt de respuesta y los mismos jueces. Mem0 y Zep se ejecutaron a través de sus propios arneses de benchmark, y LLMLingua-2 y LongLLMLingua (LLaMA-2-7B en float16) con sus ajustes publicados. El contexto de cada compresor se construyó en cuadernos públicos de Kaggle fijados a un commit. Cada celda es la precisión y lo que cuesta 1.000 preguntas de extremo a extremo a precios de lista: la llamada de respuesta, las llamadas de construcción de memoria de Mem0 y Zep, y el cómputo de cada sistema. Tablas completas, intervalos de confianza, puntos débiles y todas las respuestas: benchmarks/live/round3.
| Benchmark | LLMSlim 0.9 + reranker | LLMSlim 0.9 (sin modelo) | Mem0 | Zep | LongLLMLingua | LLMLingua-2 | Línea base de recuperación* | Contexto completo |
|---|---|---|---|---|---|---|---|---|
| LoCoMo, 1.307 preguntas, ~2.500 tokens | 93,0 % · 0,95 $ | 91,7 % · 0,89 $ | 91,0 % · 2,66 $ | 74,4 % · 6,24 $ | 73,3 % · 7,01 $ (300 preguntas) | 34,1 % · 0,43 $ | 85,2 % · 0,90 $ | 95,1 % · 0,83 $ en caché |
| LongMemEval-S, 180 preguntas, ~10.000 tokens | 74,4 % · 2,21 $ | 77,8 % · 2,13 $ | no ejecutado | 15,6 % · 8,43 $ | 80,6 % · 4,45 $ | 77,8 % · 90,21 $ | ||
| LongMemEval-S, 60 preguntas de Mem0, ~2.500 tokens | 78,3 % · 1,04 $ | 71,7 % · 0,96 $ | 76,7 % · 220,88 $ | 80,0 % · 3,36 $ | 78,3 % · 90,20 $ | |||
| LongMemEval-S, 24 preguntas de Zep, ~2.500 tokens | 87,5 % · 1,01 $ | 87,5 % · 0,94 $ | 87,5 % · 219,48 $ | 58,3 % · 697,56 $ | 83,3 % · 3,28 $ | 91,7 % · 90,22 $ | ||
| NaturalQuestions, 2.255 preguntas, 25 % de los tokens | 73,5 % · 0,33 $ | 60,6 % · 0,30 $ | 70,5 % · 1,32 $ (1.000 preguntas) | 52,5 % · 0,87 $ | 73,9 % · 0,30 $ | 78,4 % · 0,65 $ | ||
| HotpotQA, 2.000 preguntas, 40 % de los tokens (coincidencia exacta) | 52,2 % · 0,15 $ | 52,4 % · 0,13 $ | 50,4 % · 0,77 $ (1.000 preguntas) | 46,7 % · 0,47 $ | 50,5 % · 0,13 $ | 58,0 % · 0,24 $ |
* Recuperación densa sobre turnos (Qwen3-Embedding-0.6B) en LoCoMo y LongMemEval; un reranker simple en NaturalQuestions y HotpotQA. Mem0 son sus 50 mejores memorias, excepto las 200 mejores en su propia muestra. LongLLMLingua se ejecutó sobre muestras preinscritas; en las mismas preguntas, LLMSlim con su reranker obtiene un 93,3 % en LoCoMo (+20,0, IC del 95 % +15,0 a +25,0) y un 72,7 % en NaturalQuestions, y el LLMSlim predeterminado un 53,3 % en HotpotQA. Un historial completo en caché cuesta 4,48 $ por cada 1.000 preguntas de LoCoMo cuando la caché falla. Dónde pierde LLMSlim:
- NaturalQuestions sin el reranker. El modo léxico predeterminado obtiene un 60,6% frente al 73,9% de un reranker simple: las preguntas parafraseadas necesitan coincidencia semántica, así que usa el reranker para la recuperación de dominio abierto.
- Recuperación densa en LongMemEval. 80,6% frente al 77,8% de LLMSlim con 10.000 tokens y 76,1% frente a 74,4% con 2.500, a aproximadamente el doble de coste. Ninguna de las diferencias es significativa con 180 preguntas, pero ambas apuntan en la misma dirección. Una corrección que la redujo en preguntas de desarrollo no se mantuvo en la prueba, por lo que no está en 0.9.0.
- Preguntas multi-hop y temporales con 1.000 tokens. Las 20 mejores memorias de Mem0 superan al LLMSlim predeterminado en las preguntas multi-hop (88,7% vs 80,3%) y temporales (93,4% vs 85,7%) de LoCoMo. Con su reranker, LLMSlim va por delante en conjunto (90,5% vs 88,7%).
- Un historial completo en caché. Cuando las preguntas de una conversación se suceden, el historial en caché (95,1% por 0,83 $) supera a todos los contextos comprimidos en LoCoMo.
Documentos largos y agentes: ronda 2, Core 0.8.0
Mismo modelo y prompt para cada configuración; el truncado recibe exactamente el mismo número de tokens que LLMSlim, y cada suite se volvió a ejecutar una vez sobre una muestra nueva tras congelar el código (benchmarks/live). 0.9.0 cambia solo cómo se seleccionan las transcripciones de chat en texto plano.
| Benchmark | Contexto completo | LLMSlim 0.8 + reranker | LLMSlim 0.8 (sin modelo) | Truncado, mismo presupuesto | Tokens (completo → LLMSlim) |
|---|---|---|---|---|---|
| LongBench v1, 210 muestras (macro) | 54,9 | 54,2 | 54,9 | 45,2 | 15.532 → 5.232 |
| … 210 muestras nuevas | 55,1 | 55,4 | 55,0 | 46,8 | |
| LongBench v2, 180 preguntas (precisión) | 60,0 | 55,6 | 53,9 | 48,3 | 30.493 → 8.469 |
| SWE-bench Verified Mini, 50 issues (resueltos) | 36-38 | no ejecutado | 38 | no ejecutado | 48-58k → 51k por tarea |
El reranker es opcional (relevance="semantic", un cross-encoder de 22M de parámetros del extra semantic); sin
él, LLMSlim no ejecuta ningún modelo.
[!NOTE] La medición del impuesto de esquema: En nuestro benchmark v0.4.0 sobre 375 esquemas de herramientas sintéticos en 18 catálogos escritos para este repositorio (véase la ficha del conjunto de datos), la compresión de esquemas sin pérdidas ahorró 0 tokens (0,00%) cuando la línea base ya era JSON canónico compacto. Publicamos este resultado con transparencia: nunca afirmamos ahorros imaginarios donde no existen.
Planificador adaptativo v0.6 (suite offline congelada)
| Método | Éxito de presupuesto | Reducción de contexto | Hechos requeridos | Restricciones duras | Latencia media* |
|---|---|---|---|---|---|
| Contexto completo sin procesar | 71,4% | 0,0% | 100% | 100% | solo medición |
| Prefijo ingenuo | 100% | 9,2% | 100% | 100% | 2,21 ms |
| Compresor de ratio fijo | 78,6% | 9,6% | 94,0% | 96,4% | 26,55 ms |
| Planificador adaptativo | 96,4% | 11,4% | 100% | 100% | 208,02 ms |
El corpus de 28 casos cubre chat, RAG, herramientas, mixto, fuente externa y casos multilingües en 12 idiomas. La única inviabilidad adaptativa es un caso de catálogo completo intencionadamente imposible; se informa explícitamente. Estas comprobaciones basadas en tareas no son una afirmación de calidad por juez LLM ni universal. La latencia es específica de la ejecución registrada y del hardware. Véanse los resultados de la puerta de publicación, resultados sin procesar y el conjunto de datos congelado. El arnés en vivo de Sarvam no se ejecutó sin la aceptación explícita y las credenciales.
🖥️ Interfaz de línea de comandos (CLI)
Comprime archivos, flujos o prompts directamente desde tu terminal:
# Compress a document to 50% ratio
llmslim document.txt -o compressed.txt --ratio 0.5

# Pipeline integration with jq / curl
cat input.txt | llmslim --ratio 0.4 --mode rag > rag_context.txt

# Inspect token count differences
llmslim document.txt --stats
📋 Registro de cambios
Las notas de publicación de cada versión, incluida la 0.11.1, están en CHANGELOG.md y en GitHub Releases.
🤝 Integraciones del ecosistema
LLMSlim funciona como un preprocesador de contexto sin opiniones. Estas integraciones se incluyen en Core; ninguna de ellas envía una solicitud por ti. Toda integración que gaste un crédito de proveedor es verificada por un UsageGuard antes de que la solicitud salga del proceso (tasa por minuto, límite de solicitudes de por vida y un límite de unidades en INR, USD o consultas, configurable con variables LLMSLIM_<VENDOR>_*; véase .env.example):
| Proveedor / Framework | Qué se incluye en Core | Patrón |
|---|---|---|
| Sarvam AI | llmslim[sarvam]: SarvamProvider/AsyncSarvamProvider, SarvamLanguageTools, SarvamDocumentSource, annotate_languages()/normalize_scripts(), sarvam_messages() | Planificación local + SDK oficial de Python sarvamai, protegido con precios en INR con fecha |
| Exa | llmslim[exa]: ExaSearchSource, WebSearchSource neutral respecto al proveedor | Elementos de contexto RAG no confiables con procedencia de URL, fecha y rango; gasto limitado en USD |
| Neo4j | llmslim[neo4j]: Neo4jContextStore | Memoria temporal explícita con ámbito de inquilino: supersede(), recall(as_of=...), history(), conflicts() |
| OpenAI | openai_compatible_request(), openai_responses_request() | Constructores de solicitudes sin ejecución; tu código envía la solicitud |
| Anthropic Claude | anthropic_messages_request() | Constructor de solicitudes sin ejecución con marcadores opcionales de caché de prompt |
| Google Gemini | gemini_generate_request(), gemini_cached_content_request() | Constructores de solicitudes sin ejecución |
| vLLM / autoalojado | vllm_chat_request() | Constructor de solicitudes sin ejecución |
| OpenAI Agents SDK | llmslim[agents]: make_openai_agents_input_filter(), to_openai_agents_tools() | Filtro de entrada de modelo solo de texto; el SDK conserva la ejecución y la propiedad de las herramientas |
| LangChain | llmslim[langchain]: LLMSlimCompressor | BaseDocumentCompressor para ContextualCompressionRetriever |
| LlamaIndex | llmslim[llamaindex]: LLMSlimPostprocessor | BaseNodePostprocessor para motores de consulta |
| Haystack | llmslim[haystack]: LLMSlimDocumentCompressor | Componente de pipeline entre el recuperador y el constructor de prompts |
| gptme | llmslim[gptme]: LLMSlimContextProvider | Proveedor de contexto para la compactación de gptme (punto de entrada llmslim) |
| Hermes Agent | LLMSlimContextEngine (sin extra) | Plugin ContextEngine; sin llamada a LLM, prefijo estable en caché |
| Pydantic AI | llmslim[pydantic-ai]: llmslim_history_processor() | Procesador de historial que mantiene las llamadas a herramientas y las devuelve emparejadas |
Para otros frameworks no hay adaptador dedicado. LLMSlim funciona con cualquier framework
que pueda pasar listas de mensajes simples (dicts de {"role": ..., "content": ...}) o cadenas de documentos;
tú escribes las pocas líneas de pegamento que pasan la salida de LLMSlim a tu cliente.
📜 Licencia y citación
LLMSlim es software de código abierto bajo la Licencia MIT. Véase LICENSE para todos los detalles.
Si usas LLMSlim en tus sistemas de investigación o producción, cita:
@software{llmslim2026,
  author = {Yashvardhan Thanvi},
  title = {LLMSlim: Deterministic Context Compression and Contract-Safe Tool Schemas for LLMs},
  year = {2026},
  publisher = {GitHub},
  url = {https://github.com/Thanatos9404/llmslim}
}
Agent Context Runtime (v0.7.0)
La versión 0.7.0 añadió una ruta de contexto por turno para aplicaciones de agentes (la 0.7.0 no se publicó en PyPI; instala 0.7.1 o posterior). El host proporciona mensajes, documentos recuperados, memorias, resultados de herramientas y esquemas de herramientas autorizados; LLMSlim devuelve una entrada de modelo verificada en calidad y una traza local explicable. Las llamadas al modelo y la ejecución de herramientas permanecen en el host.
from llmslim import ContextRuntime, generic_request

runtime = ContextRuntime(model="sarvam-105b", max_input_tokens=8_000)
prepared = runtime.prepare_sync(
    user_input="When does Acme renew?",
    messages=[{"role": "system", "content": "Use verified dates."}],
    documents=[{"id": "contract", "content": "Acme renews on 9 November 2026."}],
)
if prepared.feasible:
    request = generic_request(prepared)  # the host sends this to its model
    print(request["messages"])
    print(prepared.trace.explain())
El runtime incluye ContextEnvelope, ContextGraph, ContextPolicy,
planificación progresiva, puertas de calidad, sesiones en memoria acotadas y
adaptadores sin ejecución para aplicaciones genéricas, Sarvam, compatibles con OpenAI y OpenAI Agents solo de texto. ContextTrace omite los cuerpos de los prompts por defecto.
Las API existentes compress() y plan_context() siguen funcionando.
Véanse la arquitectura, modelo de seguridad, integraciones, guía de migración, benchmark e informe de ingeniería.
Cache-Aware Context Runtime (v0.7.1)
La planificación de caché es una capa opcional para turnos repetidos de agentes. LLMSlim identifica
prefijos estables visibles para el proveedor, mantiene el contexto de conversación de solo adición cuando
es seguro, toma huellas de configuraciones sensibles a la caché e informa estimaciones locales de caché
por separado del uso informado por el proveedor. Un CacheManager con ámbito de inquilino almacena
metadatos y referencias del proveedor, nunca cuerpos de prompts ni tensores KV.
from llmslim import CacheManager, CachePolicy, ContextRuntime

runtime = ContextRuntime(
    model="generic-128k",
    cache_policy=CachePolicy(mode="auto", provider="openai", tenant_id="my-workspace"),
    cache_manager=CacheManager(),
)
prepared = runtime.prepare_sync(
    session_id="conversation-1",
    messages=[{"role": "system", "content": "Use verified sources."}],
    user_input="What changed?",
)
print(prepared.trace.to_dict()["cache"])
Los constructores de solicitudes sin ejecución cubren OpenAI Responses, Anthropic Messages, recursos en caché de Gemini y vLLM autoalojado. Un adaptador avanzado de Transformers en proceso valida el estado de continuación KV. La continuación con estado del proveedor OpenAI y la creación de recursos en caché de Gemini requieren la aceptación explícita del host. El almacenamiento en caché de prompts de Sarvam sigue sin verificarse y está deshabilitado por defecto. El Context Inspector muestra la segmentación de prefijos y el diagnóstico de caché sin llamar a un proveedor. Véanse la guía de caché, benchmark multiturno e informe de ingeniería.
Herramientas de seguridad de código abierto
Snyk proporciona herramientas de seguridad para desarrolladores en proyectos de código abierto. Más información sobre su Secure Developer Program.