HKEx Filings
Extrae más de 25 años de presentaciones regulatorias de HKEx (Bolsa de Valores de Hong Kong) en nueve bases de datos, consultables en vivo por agentes de IA.
Servidor MCP alojado
npx add-mcp 'https://hkex-listco-updates.ascent-partners.com/api/mcp'Se instala en Claude Code, Codex, Cursor y más
Documentación
Rastreador de Presentaciones de HKEx
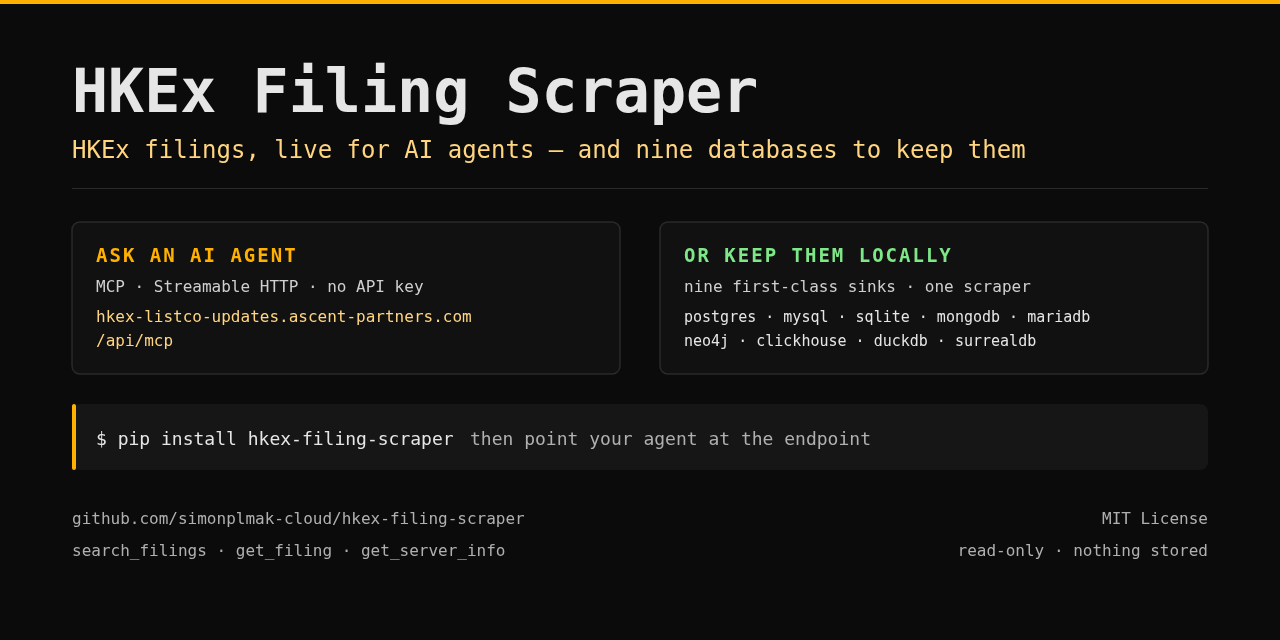





Una herramienta Python de código abierto que extrae más de 25 años de presentaciones regulatorias de la Bolsa de Valores de Hong Kong (HKEx) y las ingiere en cualquier combinación de nueve bases de datos — con extracción de texto completo y tablas, cobertura a nivel de fragmentos, vinculación opcional de grafos, y un servidor MCP de solo lectura para que los agentes de IA puedan consultar el corpus o el sitio en vivo.
Habla directamente con la API JSON no documentada de HKEx, lo cual es más rápido y más resistente que manejar un navegador.
Proveedores e integraciones
Bases de datos — nueve destinos de primera clase, en orden de popularidad documentado (consulta la matriz de soporte):
- PostgreSQL — relacional de código abierto de grado de producción
- MySQL / MariaDB — servidores relacionales GPL, un solo controlador
- SQLite — base de datos de archivos sin servidor, sin instalación necesaria
- MongoDB — base de datos de documentos
- Neo4j — base de datos de grafos de propiedades
- ClickHouse — motor de análisis columnar
- DuckDB — motor analítico en proceso
- SurrealDB — base de datos multimodelo de grafos + documentos
Clientes de IA — cualquier agente compatible con MCP; configuración lista para Claude, ChatGPT, Cursor, VS Code/Copilot, Gemini CLI, opencode, Manus y Perplexity.
Disponible en — PyPI · Glama · Registro MCP · puerta de enlace alojada.
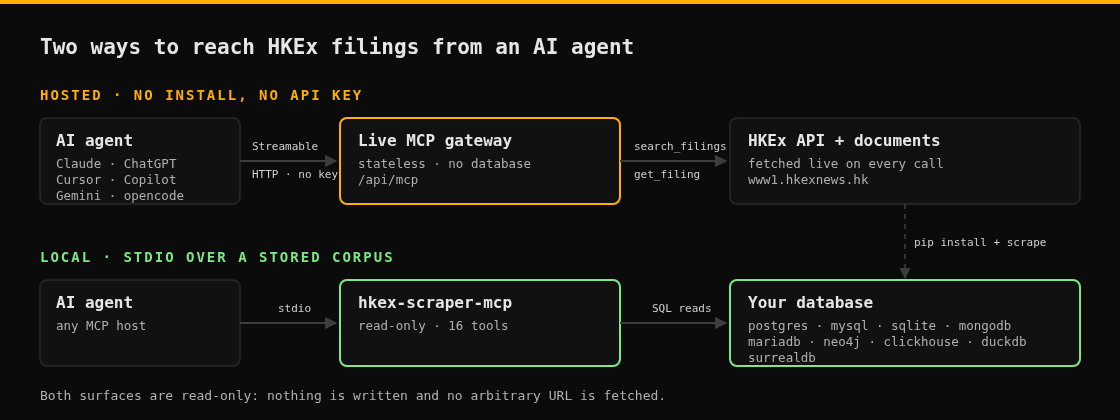
Dos formas de usarlo
| Puerta de enlace MCP alojada | Pipeline local | |
|---|---|---|
| Qué es | Un endpoint público al que apuntas un agente de IA | La CLI hkex-scraper |
| Configuración | Ninguna — pega una URL | pip install + una variable de entorno |
| Datos | En vivo desde HKEx, nada almacenado | Almacenados en tu(s) base(s) de datos |
| Documentación | Puerta de enlace MCP en vivo · Soporte para agentes de IA | Primeros pasos |
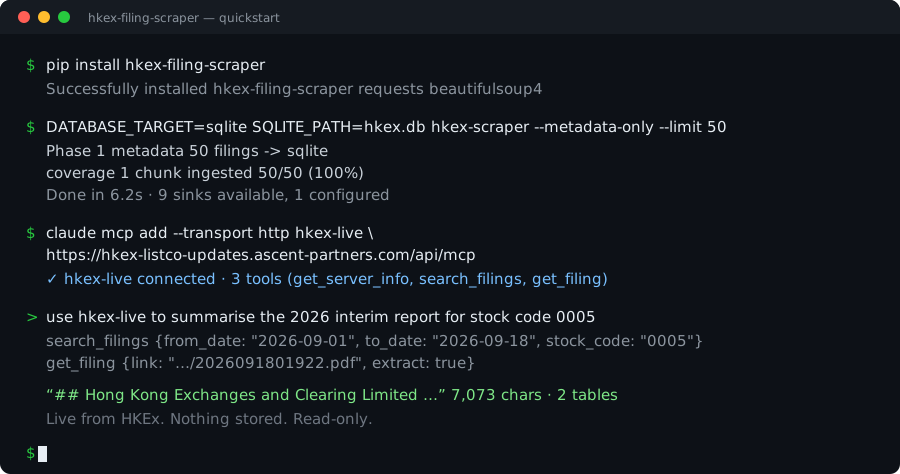
Usa la puerta de enlace MCP alojada
POST, HTTP Streamable, sin clave API:
https://hkex-listco-updates.ascent-partners.com/api/mcp
Tres herramientas de solo lectura: get_server_info, search_filings (una ventana de como máximo 31 días), y
get_filing (descarga un documento y extrae su texto y tablas).
Apunta un cliente hacia ella — por ejemplo, opencode:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "hkex-live": {
      "type": "remote",
      "url": "https://hkex-listco-updates.ascent-partners.com/api/mcp"
    }
  }
}
Luego pregunta:
Use hkex-live to list the filings published between 2026-09-01 and 2026-09-18,
then summarise the interim report.
La configuración lista para Claude, ChatGPT, Cursor, VS Code/Copilot, Gemini CLI, opencode,
Manus y Perplexity está en Soporte para agentes de IA — y para un corpus
almacenado, el servidor MCP stdio expone un catálogo de herramientas más amplio
y está publicado en Glama. La puerta de enlace está listada
en el Registro MCP oficial como
io.github.simonplmak-cloud/hkex-filings.
Destacado en Glama — el servidor MCP stdio de solo lectura también está publicado en Glama, donde Glama escanea el servidor construido y califica la calidad de las definiciones de herramientas (actualmente 4.7/5).

Inicio rápido (local)
pip install hkex-filing-scraper        # core; SQLite needs no server
pip install "hkex-filing-scraper[all]" # Excel + dotenv + every driver + the MCP server
cp .env.example .env                   # then set DATABASE_TARGET (below)
hkex-scraper --metadata-only --limit 100
Extras opcionales: excel, postgres, mysql, duckdb, mongodb, clickhouse, neo4j,
mcp, pdf, all, dev.
DATABASE_TARGET es una lista ordenada y separada por comas de identificadores de sumideros; el orden decide qué
sumidero sirve las lecturas. Para comenzar sin servidor:
DATABASE_TARGET=sqlite
SQLITE_PATH=hkex.db
hkex-scraper ejecuta el pipeline completo (metadatos + documentos + grafo); hkex-scraper --full-history cubre todo desde abril de 1999. El esquema se crea automáticamente.
Las opciones completas de instalación y la configuración por sumidero están en Primeros pasos.
Soporte de bases de datos
Cada sumidero es un destino de primera clase; las filas están en orden de popularidad documentado. La matriz completa — licencias, diferencias de capacidades, notas por motor — está en Sumideros de bases de datos.
| Sumidero | Modelo | Licencia | Extra | Upsert idempotente |
|---|---|---|---|---|
postgres | relacional | Licencia PostgreSQL | postgres | ON CONFLICT DO UPDATE |
mysql / mariadb | relacional | GPLv2 | mysql | ON DUPLICATE KEY UPDATE |
sqlite | relacional | Dominio público | — | ON CONFLICT DO UPDATE |
mongodb | documento | SSPL¹ | mongodb | update_one(upsert=True) |
neo4j | grafo | GPLv3 (Comunidad) | neo4j | MERGE |
clickhouse | columnar | Apache-2.0 | clickhouse | ReplacingMergeTree + fusión de lectura |
duckdb | relacional | MIT | duckdb | ON CONFLICT DO UPDATE |
surrealdb | grafo + documento | BSL 1.1¹ | — | UPSERT / RELATE |
¹ Código fuente disponible, no aprobado por OSI — excepciones etiquetadas según ADR 0003.
Identificadores de sumidero válidos, en orden documentado: postgres, mysql, sqlite, mongodb, mariadb, neo4j, clickhouse, duckdb, surrealdb. Establece una variable y la misma ejecución alimenta cada sumidero:
# Order sets read precedence.
DATABASE_TARGET=postgres,sqlite
POSTGRES_DSN=postgresql://user:password@localhost:5432/hkex
SQLITE_PATH=hkex.db
Cómo funciona
flowchart LR
    A[HKEx JSON API] --> B[Phase 1: metadata]
    B --> C[Canonical record]
    C --> D{DATABASE_TARGET}
    D --> E[(PostgreSQL)]
    D --> F[(MySQL / MariaDB)]
    D --> G[(SQLite)]
    D --> H[(MongoDB)]
    D --> I[(Neo4j)]
    D --> J[(ClickHouse)]
    D --> K[(DuckDB)]
    D --> L[(SurrealDB)]
    B --> M[Graph linking]
    M --> D
    B --> N[Phase 2: download and extract]
    N --> C
- Fase 1 extrae los metadatos de las presentaciones a través de una sesión JSF, dividiendo el rango en fragmentos
mensuales y deduplicando con un MD5 de 16 caracteres
filingId. - Fase 2 descarga el documento PDF/HTML/Excel de cada presentación, extrae texto y tablas a Markdown, y escribe la carga útil.
- Vinculación de grafos (opcional) escribe aristas
has_filingyreferences_filingcuandoCOMPANY_TABLEestá establecido. - Aislamiento de fallos — un fallo en un sumidero se registra y cuenta pero nunca bloquea a otro; la ejecución sale con código distinto de cero si algún sumidero configurado falló.
Detalle más profundo: Arquitectura · ADR 0002.
Características
- Extracción rápida de API — API JSON directa de HKEx; sin navegador ni Selenium.
- Historial completo — cada presentación desde abril de 1999 hasta hoy, con verificaciones de cobertura a nivel de fragmentos.
- Procesamiento de documentos — texto de PDF/HTML/Excel y tablas estructuradas, extraídos a Markdown.
- Multi-sumidero — cualquier combinación ordenada de nueve bases de datos, cada una con upserts idempotentes nativos.
- Listo para IA — una puerta de enlace MCP alojada en vivo más un servidor MCP stdio local.
- Reanudable y observable — procesamiento por lotes, descargas paralelas, detección de trabajos estancados, contadores
por sumidero, y
--coverage-report/--parity-report/--verify. - Dependencias opcionales — el núcleo es
requests+beautifulsoup4; los controladores y la extracción de documentos son extras con respaldos elegantes.
Documentación
- Primeros pasos · Configuración · CLI
- Sumideros de bases de datos (matriz) — PostgreSQL, MySQL/MariaDB, SQLite, MongoDB, Neo4j, ClickHouse, DuckDB, SurrealDB
- Puerta de enlace MCP en vivo · Soporte para agentes de IA · Servidor MCP
- Arquitectura · Solución de problemas · Pruebas
- Hoja de ruta · Registro de mitigación de riesgos · Actualización
- Novedades · Publicación de versiones · Legal y Términos de uso · Registro de cambios
- Sitio de documentación: https://hkex-listco-updates.ascent-partners.com/ · Pruébalo localmente (
examples/)
Desarrollo
pip install -e ".[dev,all]"
ruff check           # lint (py310, line-length 100)
ruff format --check  # formatting
pytest               # unit tests (no DB or network required)
Las pruebas son pruebas unitarias puras; las pruebas de contrato de SQLite y DuckDB se ejecutan en proceso, y las pruebas de integración que necesitan un servidor se omiten a menos que ese sumidero esté configurado. Consulta Pruebas.
Contribuciones
Consulta CONTRIBUTING.md; reporta problemas de seguridad según SECURITY.md. Las ideas y preguntas son bienvenidas en Discusiones.
Si esto te ahorra tiempo, una estrella ayuda a otros a encontrarlo.
Licencia
MIT — consulta LICENSE. Eso cubre solo el código de este proyecto; las dependencias opcionales
tienen sus propias licencias, notablemente el extra pdf (PyMuPDF / pymupdf4llm), que es
AGPL-3.0 y está deliberadamente excluido de .[all]. Consulta
docs/legal.md.
Datos y Términos de uso: esta es una herramienta de investigación para la API JSON no documentada de HKEx, y no está afiliada ni respaldada por HKEx. La redistribución comercial de datos de HKEx puede requerir una fuente de datos de HKEx con licencia; consulta docs/legal.md.