transcriptor-mcp
Un servidor MCP (stdio + HTTP/SSE) que obtiene transcripciones/subtítulos de videos mediante yt-dlp, con paginación para respuestas grandes. Compatible con YouTube, Twitter/X, Instagram, TikTok, Twitch, Vimeo, Facebook, Bilibili, VK, Dailymotion. Whisper como alternativa: transcribe audio cuando no hay subtítulos disponibles (local o API de OpenAI). Funciona con Cursor y otros hosts MCP.
Documentación
🎬 ¡Ahora tu asistente de IA puede ver videos!
Conecta un servidor. Luego pregúntale a Claude, ChatGPT, etc. sobre un video: la transcripción, los capítulos, los metadatos o un fotograma individual. Funciona con 11 plataformas, no solo YouTube.


Conectar · Qué preguntar · Widgets · Plataformas · Autoalojamiento
⚡ Conéctate en 30 segundos
El endpoint alojado es:
https://transcriptor.gateway.mcpal.io/mcp
🖱️ Un clic

⌨️ Un comando, para Claude Code
claude mcp add --transport http transcriptor https://transcriptor.gateway.mcpal.io/mcp
Luego ejecuta /mcp y aprueba el inicio de sesión en el navegador. Después de esto, claude mcp list muestra ✔ Connected.
🧭 Sin terminal
| Cliente | Qué hacer |
|---|---|
| Claude (web y escritorio) | Abre Configuración → Personalizar → Conectores. Selecciona Agregar → Agregar conector personalizado, pega https://transcriptor.gateway.mcpal.io/mcp, luego selecciona Agregar. |
| ChatGPT | Abre Transcriptor en el directorio de plugins de ChatGPT y selecciona Instalar plugin; inicia sesión cuando se te pida. O en ChatGPT abre Plugins, busca Transcriptor, selecciona Instalar plugin. Luego menciona @Transcriptor en un chat. |
| Codex | Mismo directorio, una instalación: ChatGPT y Codex lo comparten. En una tarea de Codex abre Fuentes → Usar plugins → Transcriptor; en la CLI, /plugins. |
Nota: una nueva lista del directorio puede tardar hasta 6 horas en aparecer en Codex (Plugins en ChatGPT y Codex).
🧩 Cualquier otro cliente MCP
Si tu cliente no está en la lista anterior, agrega el servidor con esta configuración:
{
  "mcpServers": {
    "transcriptor": {
      "url": "https://transcriptor.gateway.mcpal.io/mcp"
    }
  }
}
Si quieres ejecutar el servidor tú mismo, lee Autoalojamiento. Las herramientas son las mismas y no necesitas cuenta.
🧰 Qué puedes preguntar
| Pide esto | Herramienta |
|---|---|
| "Resume este video para mí" | get_transcript |
| "Dame los subtítulos como archivo SRT" | get_raw_subtitles |
| "¿Hay una pista en alemán para este video?" | get_available_subtitles |
| "¿Quién publicó esto y cuántas vistas tiene?" | get_video_info |
| "Ve a la parte sobre precios" | get_video_chapters |
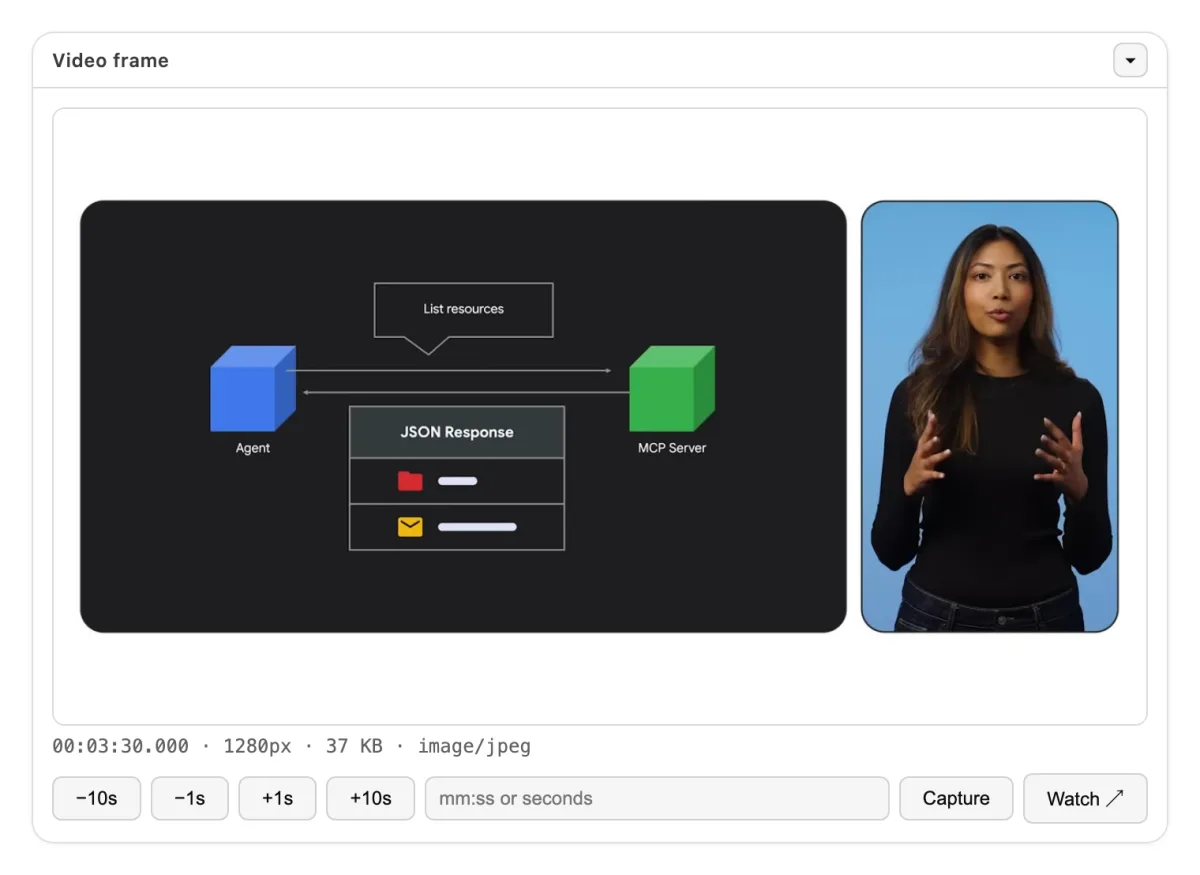
| "Muéstrame la pantalla en 4:12" | get_video_frame |
| "Obtén transcripciones en inglés para los primeros 5 videos de esta lista de reproducción" | get_playlist_transcripts |
| "Encuentra videos recientes sobre X" | search_videos (YouTube) |
Las transcripciones largas vienen en partes. Cada respuesta da un cursor para la siguiente parte, así no se pierde texto.
Referencia completa de herramientas (entrada y respuesta estructurada)
Cada herramienta que acepta un video admite url. Esto es un enlace de una plataforma compatible o un ID de YouTube simple. Cada herramienta devuelve content (texto para el chat) y structuredContent (JSON tipado para tu código).
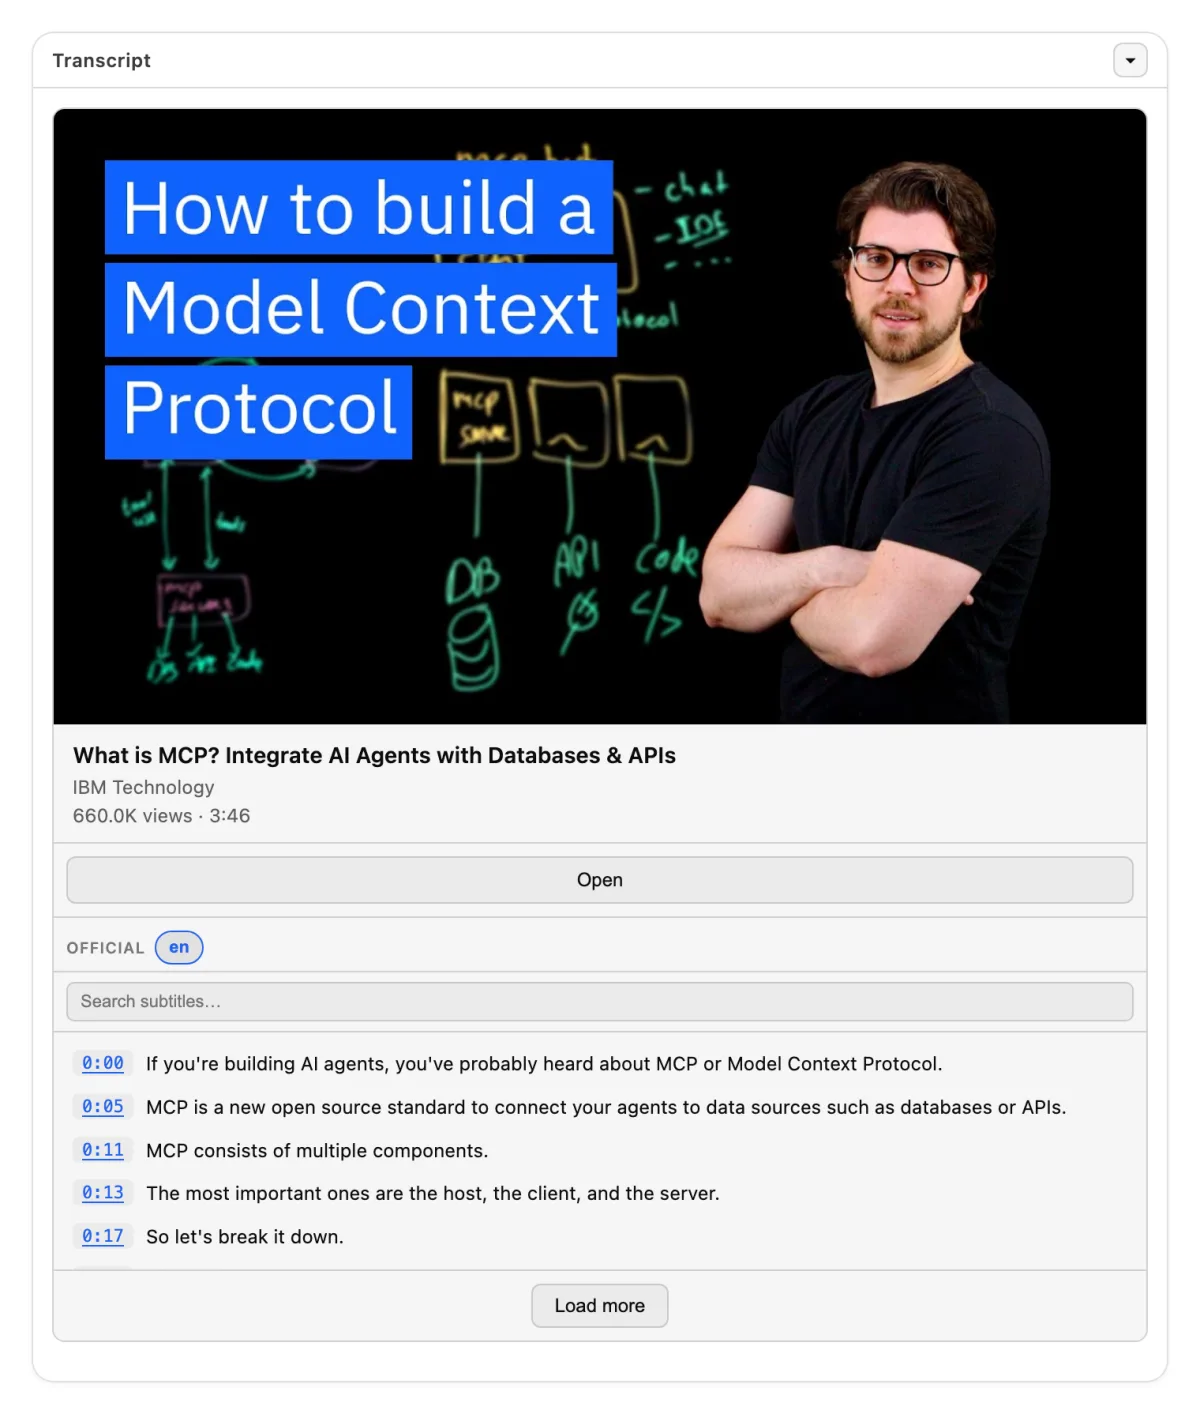
get_transcript
Texto plano limpio, sin marcas de tiempo, HTML ni nombres de hablantes. Sin lang, la herramienta devuelve la pista en el idioma original del video. La mayoría de las plataformas que no son YouTube no indican en qué idioma está un video; cuando la herramienta no puede determinar qué pista es, responde con la lista de pistas, y la llamas de nuevo con type y lang. Las entradas son las mismas que para get_raw_subtitles.
Respuesta: videoId, url (la página del video, tal como el servidor la resolvió), type, lang, text, is_truncated, total_length, start_offset, end_offset. Cuando hay más texto disponible, la respuesta también tiene next_cursor.
get_raw_subtitles
Contenido SRT o VTT sin procesar, en partes.
Entrada:
type—officialoauto. Sinlang, la herramienta elige una pista de este tipolang— un código de idioma o nombre de pista, tal comoget_available_subtitleslo lista. Sin esto, el idioma original del video, como paraget_transcriptresponse_limit— predeterminado50000, mínimo1000, máximo200000next_cursor— el cursor de la respuesta anterior
Respuesta: los campos de get_transcript, más format (srt o vtt) y content.
get_available_subtitles
Respuesta: official y auto. Cada campo es una lista ordenada de códigos de idioma. Usa esta herramienta primero, luego da type y lang a las herramientas anteriores.
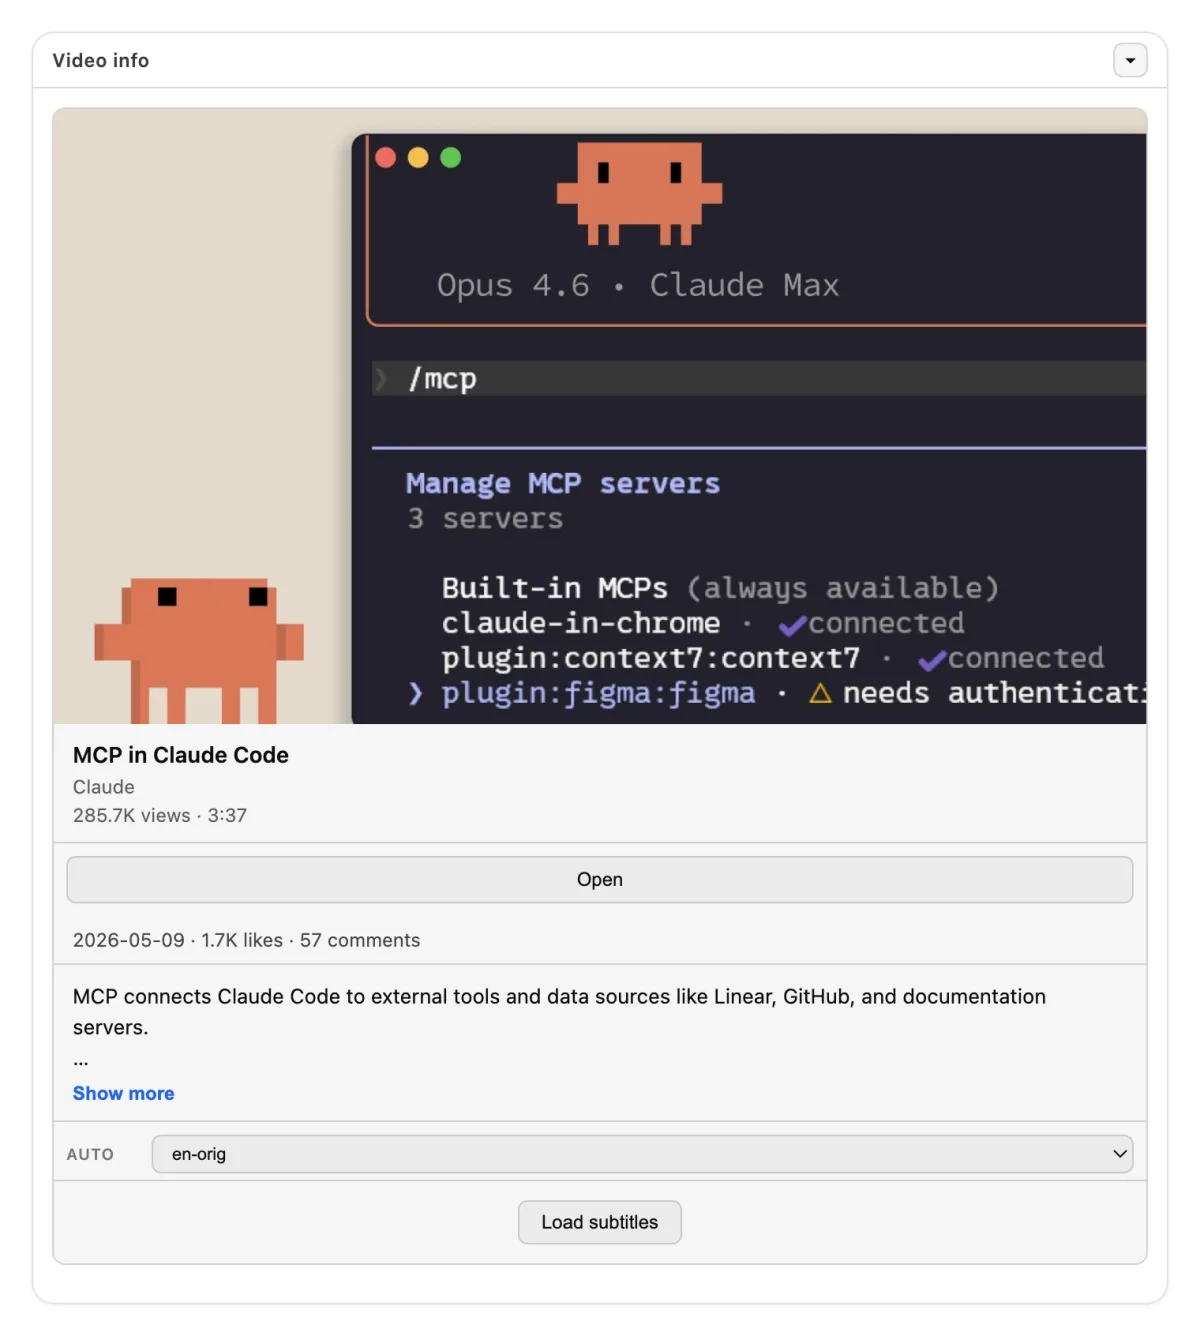
get_video_info
Metadatos extendidos de yt-dlp:
- identidad —
videoId,title,description,webpageUrl - autor —
uploader,uploaderId,channel,channelId,channelUrl - números —
duration,uploadDate,viewCount,likeCount,commentCount - clasificación —
tags,categories,liveStatus,isLive,wasLive,availability - imágenes —
thumbnailythumbnails
get_video_chapters
Respuesta: chapters. Cada elemento tiene startTime, endTime y title. Cuando el video no tiene capítulos, la lista está vacía.
get_video_frame
Entrada:
timecode—"MM:SS"o"HH:MM:SS.mmm"seconds— una alternativa atimecode. Da uno de los dos, no ambosformat—jpeg(predeterminado) opngwidth— predeterminado1280, máximo1920, nunca mayor que la fuentequality—2a31, solo para jpeg
Respuesta: un bloque de imagen, más url, timestampSeconds, timestamp, mimeType, sizeBytes y width. Esta herramienta necesita ffmpeg. La imagen de Docker lo incluye.
get_playlist_transcripts
Entrada:
url— una URL de lista de reproducción, o una URL de visualización conlist=type,lang,format— lo mismo queget_raw_subtitles, excepto quelanges obligatorio: el idioma original se elige solo para un video a la vezplaylistItems— un valor de-Ide yt-dlp como1:5,1,3,7o-1maxItems— el número máximo de videos
Respuesta: results. Cada elemento tiene videoId y text.
search_videos
Entrada:
query— el texto de búsquedalimit— predeterminado 10, máximo 50offset— el número de resultados a omitiruploadDateFilter—hour,today,week,monthoyearresponse_format—json(predeterminado) omarkdown
Respuesta: results. Cada elemento tiene videoId, title, url, duration, uploader, viewCount y thumbnail.
📺 Widgets
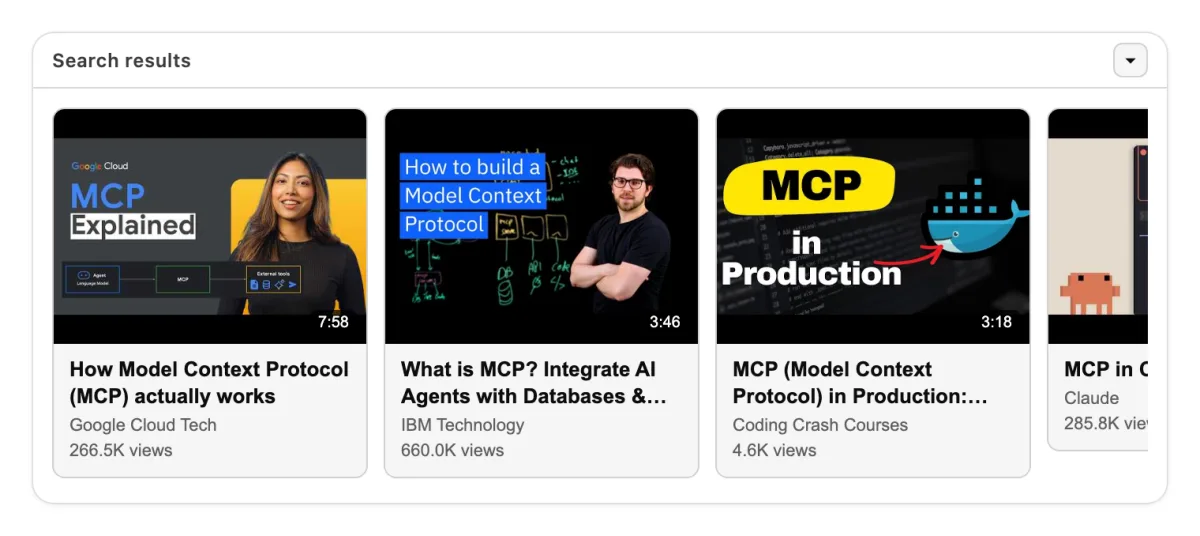
Cuatro herramientas tienen una interfaz interactiva: get_transcript, get_video_info, get_video_frame y search_videos. Los clientes que admiten MCP Apps y el SDK de ChatGPT Apps muestran esta interfaz en el chat. Otros clientes obtienen los mismos datos como texto y JSON.
|
|
|
|
🌍 Plataformas
YouTube · Twitter/X · Instagram · TikTok · Twitch · Vimeo · Facebook · Bilibili · VK · Dailymotion · Reddit
Cada herramienta que acepta un video admite un enlace de estas 11 plataformas. La herramienta search_videos funciona solo con YouTube, a través de yt-dlp ytsearch.
El servidor no descarga archivos de video o audio por ti. Devuelve texto, metadatos y fotogramas individuales.
🐳 Autoalojamiento
Las herramientas son las mismas que en el endpoint alojado. No necesitas cuenta.
Ejecuta el servidor con Docker. La imagen sirve Streamable HTTP en el puerto 4200:
docker run --rm -p 4200:4200 artsamsonov/transcriptor-mcp:latest
Luego apunta tu cliente a http://localhost:4200/mcp.
Para stdio, dale a la imagen un comando explícito:
docker run --rm -i artsamsonov/transcriptor-mcp:latest npm run start:mcp
{
  "mcpServers": {
    "transcriptor": {
      "command": "docker",
      "args": ["run", "--rm", "-i", "artsamsonov/transcriptor-mcp:latest", "npm", "run", "start:mcp"]
    }
  }
}
El servidor se inicia sin variables de entorno. Cada variable a continuación es opcional.
| Variable | Predeterminado | Función |
|---|---|---|
MCP_PORT y MCP_HOST | 4200 y 0.0.0.0 | El listener HTTP |
COOKIES_FILE_PATH | — | Un archivo de cookies Netscape para videos que requieren cuenta. Consulta cookies.example.txt |
WHISPER_MODE | off | Establece local o api para transcribir el audio cuando un video no tiene subtítulos. Luego establece WHISPER_BASE_URL o WHISPER_API_KEY. WHISPER_MAX_DURATION_SECONDS omite videos más largos y transmisiones en vivo; un video cuya duración la plataforma no informa se mide con ffprobe después de la descarga del audio |
CACHE_MODE | off | Establece redis y CACHE_REDIS_URL para almacenar en caché subtítulos y metadatos |
YT_DLP_MAX_CONCURRENCY | 4 | Cuántos procesos de yt-dlp/ffmpeg pueden ejecutarse a la vez. YT_DLP_MAX_QUEUE (8) es cuántas llamadas pueden esperar; más allá de eso, una llamada se rechaza de inmediato con "servidor ocupado". Una llamada alcanza un máximo de ~40 MiB, por lo que el límite acota la limitación de la plataforma y la latencia, no la memoria |
SUBTITLES_RATE_LIMIT_HOLD_MS | 600000 | Después de que una plataforma responda 429 a una descarga de subtítulos, el servidor deja de pedir subtítulos a esa plataforma durante este tiempo y responde rate_limited de inmediato. Cada repetición duplica la espera, hasta una hora; una descarga exitosa lo limpia. Los metadatos no se retienen |
CANARY_INTERVAL_MS | 900000 | Con qué frecuencia el servidor HTTP obtiene una transcripción para demostrar que la ruta sigue funcionando. 0 lo desactiva; CANARY_URL elige el video |
YT_DLP_* | — | Tiempos de espera, proxy y tiempos de ejecución de JS. Consulta .env.example |
El mismo puerto sirve GET /health y GET /metrics. Las métricas están en formato Prometheus e incluyen los contadores mcp_*.
Transporte, API REST y desarrollo
Transporte. El servidor acepta POST /mcp únicamente. GET y DELETE devuelven 405. El servidor no tiene estado y no envía Mcp-Session-Id.
El proceso de Node no verifica tokens de portador. Coloca un proxy inverso o una puerta de enlace delante para autenticación y TLS. El endpoint alojado funciona de esta manera.
API REST. Una segunda imagen ofrece la misma extracción sobre HTTP simple:
docker run --rm -p 3000:3000 artsamsonov/transcriptor-mcp-api:latest
La interfaz de Swagger está en http://localhost:3000/docs. Para una pila completa con la API y el servidor MCP, lee docker-compose.example.yml.
Desarrollo.
npm ci
npm run build
npm run start:mcp        # stdio
npm run start:mcp:http   # Streamable HTTP on port 4200
npm test
Necesitas Node.js 22 o posterior (20 todavía funciona, pero llegó al final de su vida útil en abril de 2026), y yt-dlp en tu PATH. La captura de fotogramas necesita ffmpeg, y WHISPER_MAX_DURATION_SECONDS necesita ffprobe (ambos se incluyen en el mismo paquete, y en la imagen de Docker). Otros scripts: lint, type-check, format, test:coverage, test:e2e:api y test:e2e:mcp.
Lanzamientos. El mantenedor los crea. Los pasos están en .claude/skills/release/SKILL.md. La versión proviene de package.json en tiempo de ejecución, a través de src/version.ts. Al enviar una etiqueta v*, CI compila ambas imágenes y publica la entrada del Registro MCP desde server.json.
Estructura. src/mcp.ts (entrada stdio), src/mcp-http.ts (HTTP Streamable), src/mcp-core.ts (herramientas, prompts, widgets), src/youtube.ts (yt-dlp), src/whisper.ts, src/cache.ts, src/index.ts (API REST), load/ (k6) y src/e2e/ (pruebas de humo de Docker).
🤝 Contribuciones
Las solicitudes de extracción son bienvenidas. Lee primero CONTRIBUTING.md: describe el ciclo desde el problema hasta la revisión, tanto para personas como para agentes de codificación.
⚖️ Legal
El endpoint alojado en transcriptor.gateway.mcpal.io se rige por los Términos de Servicio y la Política de Privacidad.
Un servidor que alojes tú mismo no está cubierto por esos documentos. Se rige únicamente por la Licencia MIT.
📄 Licencia
MIT © 2026 samson-art. Lee LICENSE.