Compendio MCP
Indexa la documentación markdown de un proyecto y la expone a los agentes: búsqueda híbrida en lenguaje natural (BM25 + semántica), un mapa de todo el corpus de documentos y lecturas a nivel de sección, para que los agentes encuentren los documentos correctos sin cargar archivos completos en el contexto.
Documentación
La documentación de tu proyecto, servida a cualquier agente en la menor cantidad posible de tokens.
Una capa de recuperación RAG local expuesta como servidor MCP. Tu agente deja de hacer grep y de volcar archivos completos: llega al párrafo correcto.



Qué hace • Requisitos • Inicio rápido • Configuración • Herramientas MCP • CLI • Cómo funciona • Sincronización incremental • Multilingüe • Documentación completa
El problema
Tu agente no conoce tu documentación. Así que hace lo que puede: grep, luego cat un archivo de 400 líneas para responder una pregunta que vivía en un solo párrafo. Tres archivos después, la ventana de contexto está llena de ruido y la respuesta sigue siendo una suposición.
Adjuntar toda la carpeta docs/ no lo soluciona — solo traslada el desperdicio más adelante. Tampoco lo soluciona la búsqueda por palabras clave: nadie escribe preguntas usando las palabras exactas que usa el documento.
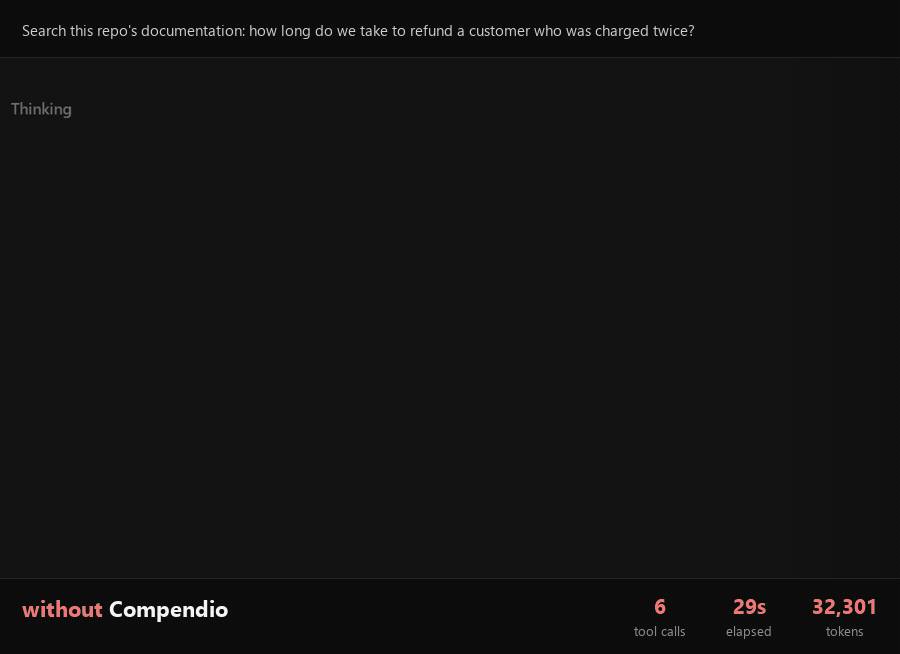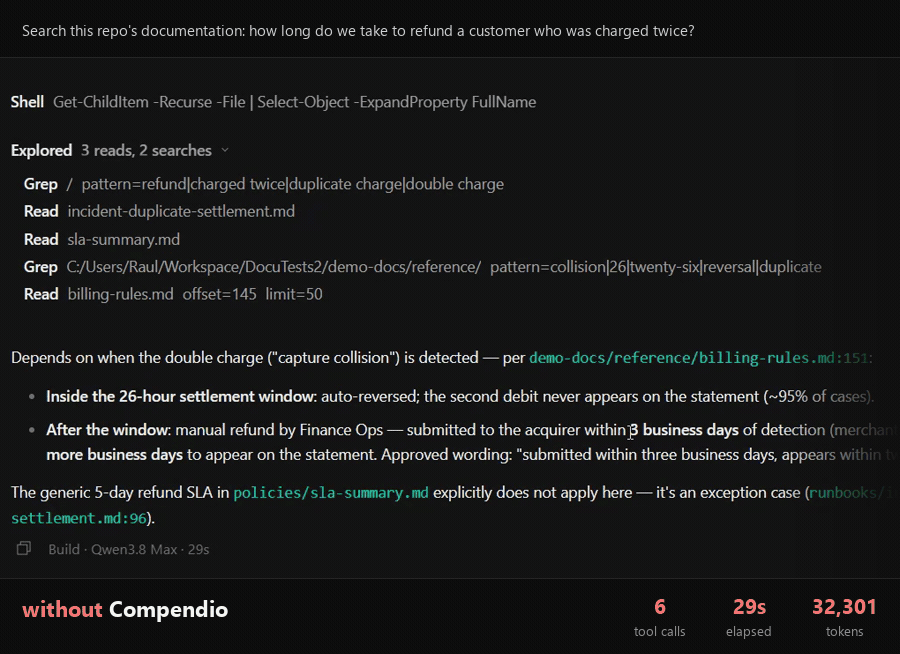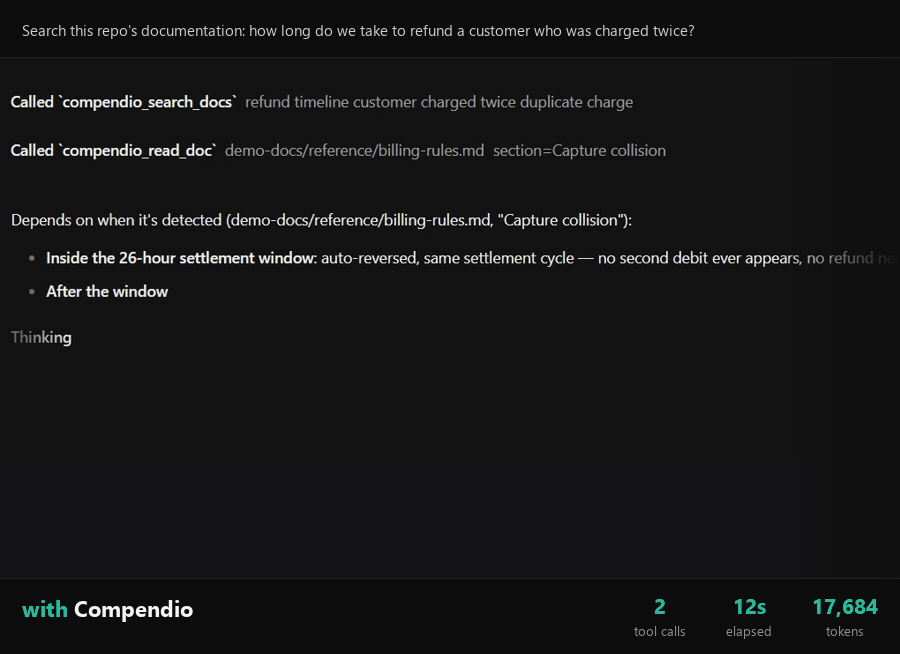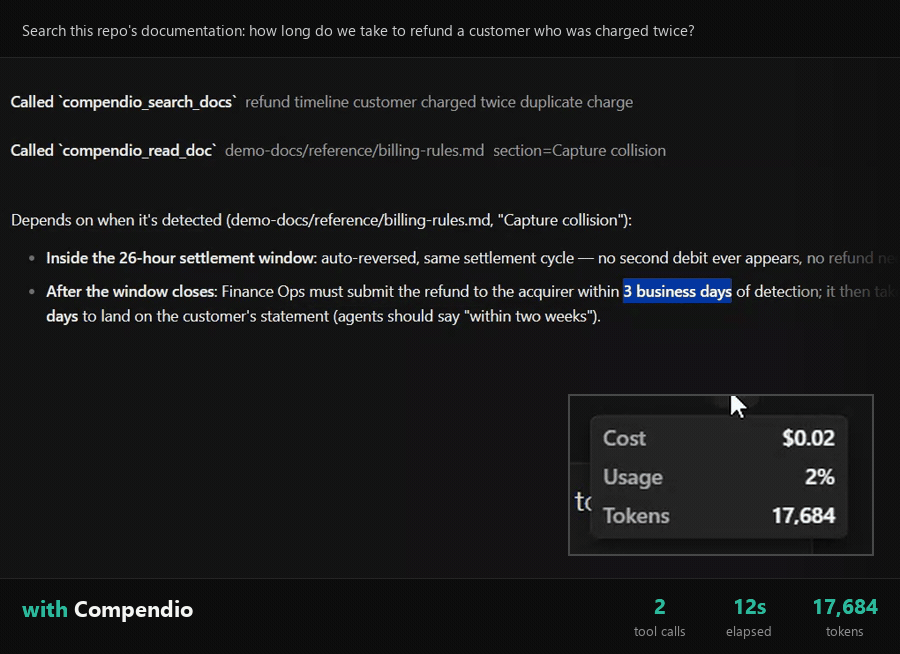
Misma pregunta, mismo modelo, y ambas respuestas son correctas — la diferencia es lo que costó llegar allí.
6 llamadas a herramientas • 29s • 32.301 tokens → 2 llamadas a herramientas • 12s • 17.684 tokens.
Cifras leídas de la etiqueta de tiempo transcurrido y la información de costo de OpenCode, sobre un corpus de 81 documentos.
Qué hace Compendio
Compendio indexa tu documentación en Markdown y le da a cualquier agente de IA tres herramientas para encontrar y leer exactamente lo que necesita.
- 🔍 Recuperación híbrida, no grep — la búsqueda por palabras clave encuentra el término exacto, la búsqueda semántica encuentra la paráfrasis. Compendio ejecuta ambas y fusiona los resultados.
- ✂️ Frugal en tokens por diseño — orientación con ~10 tokens por documento, búsqueda de unos pocos fragmentos, lectura de una sola sección. Nunca el corpus completo.
- 🔒 100% local — un solo archivo SQLite, embeddings en CPU, cero llamadas de red en tiempo de consulta. Sin claves API, sin Docker, sin servicios, nada sale de tu máquina.
- ♻️ Se mantiene actualizado — un servidor en ejecución detecta tus ediciones de documentación por sí solo. Sin proceso de vigilancia, sin bucle de reconstrucción manual.
- 🗣️ Multilingüe — indexa documentación en cualquier idioma. El modelo de embeddings es multilingüe y la búsqueda es insensible a diacríticos. Ver Multilingüe.
- 🧩 Cero configuración — funciona en cualquier carpeta de archivos
.md. Sin frontmatter obligatorio, sin archivo de configuración. Una convención de documentación opcional está disponible si tu equipo ya tiene una taxonomía que imponer.
Requisitos
- Node.js ≥ 22.12.
- Nada más.
Inicio rápido
1. Instálalo.
npm install -g compendio-mcp
Para actualizar Compendio más tarde, ejecuta ese mismo comando de nuevo — siempre obtiene la última versión publicada.
2. Regístralo como servidor MCP en tu cliente, apuntando a la raíz de tu proyecto.
Claude Code (.mcp.json en la raíz del repositorio o {USER_FOLDER} .claude.json para instalación global):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Claude Desktop (~/Library/Application Support/Claude/claude_desktop_config.json en macOS, %APPDATA%\Claude\claude_desktop_config.json en Windows — o Configuración → Desarrollador → Editar configuración):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
OpenCode (opencode.json):
{
  "mcp": {
    "compendio": {
      "type": "local",
      "command": ["compendio", "serve"],
      "enabled": true
    }
  }
}
VS Code / Copilot (.vscode/mcp.json):
{
  "servers": {
    "compendio": {
      "type": "stdio",
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Cursor (.cursor/mcp.json):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Codex (.codex/config.toml):
[mcp_servers.compendio]
command = "npx"
args = ["compendio-mcp", "serve"]
enabled = true
startup_timeout_sec = 60
Windsurf (~/.codeium/windsurf/mcp_config.json):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Zed (settings.json, o Configuración → IA → Servidores MCP → Añadir servidor personalizado):
{
  "context_servers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"],
      "env": {}
    }
  }
}
Cline (icono de Servidores MCP → Configurar → Configurar servidores MCP; la CLI lee ~/.cline/mcp.json):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Gemini CLI (.gemini/settings.json en el proyecto, o ~/.gemini/settings.json):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
3. Construye el índice una vez, desde la raíz del proyecto:
compendio index
Eso es todo. Sin archivo de configuración, Compendio auto-descubre las carpetas de nivel superior que contienen archivos Markdown — sin necesidad de un docs/ oculto por defecto. Añade .compendio/ a tu .gitignore.
Por qué existe este paso. El servidor también indexa al iniciar, así que estrictamente podrías omitirlo — pero la primera ejecución descarga y almacena en caché el modelo de embeddings (decenas de MB), y quien lo active espera. Ejecutarlo aquí paga ese costo en tu terminal, con una barra de progreso, en lugar de dentro de la primera llamada a herramienta de tu agente. A partir de entonces todo es offline, y el índice se mantiene actualizado por sí solo (abajo).
Nota para Windows. Algunos clientes MCP no pueden lanzar el shim
compendio.cmddirectamente. Si el servidor falla al iniciar conENOENT, usa"command": "npx"con"args": ["compendio-mcp", "serve"].
Configuración
Totalmente opcional — Compendio funciona sin ningún archivo de configuración. Crea compendio.config.json en la raíz de tu proyecto solo para sobrescribir lo que necesites:
{
  "docsDir": ["docs"],
  "exclude": ["INDEX.md"],
  "db": ".compendio/compendio.db",
  "embeddings": { "provider": "local", "model": "Xenova/multilingual-e5-small" },
  "chunk": { "minTokens": 100, "maxTokens": 480 },
  "search": { "k": 5 },
  "sync": { "throttleMs": 30000 },
  "convention": {
    "mode": "loose",
    "excludedStatuses": [],
    "frontmatterFields": { "type": "type", "module": "module", "status": "status" }
  }
}
| Clave | Para qué sirve |
|---|---|
docsDir | Una o más raíces de documentación explícitas, relativas a la raíz del proyecto. Siempre es un array — no existe la forma de cadena única. Omítela o establece [] para usar el modo de descubrimiento |
exclude | Entradas a omitir al indexar: una ruta exacta, un nombre de archivo simple (coincide en cualquier lugar), o un prefijo de directorio (p. ej., "adr/superseded" omite todo lo que esté debajo) |
db | Dónde se escribe el archivo de índice SQLite |
search.k | Número predeterminado de fragmentos devueltos por búsqueda |
chunk | Límites de tamaño de fragmento, en tokens |
sync.throttleMs | Tiempo mínimo entre pasadas de sincronización automática, en ms (30000 = 30 s). Un mínimo, no un temporizador — solo limita los disparadores automáticos de serve, no un compendio sync ejecutado manualmente — ver Sincronización incremental |
convention | Taxonomía de documentación opcional — ver abajo |
Declarar solo parte del bloque convention se fusiona con los valores predeterminados campo por campo; nunca borra los hermanos que no mencionaste. frontmatterFields mapea type/module/status a claves de frontmatter no estándar (p. ej., { "status": "estado" } lee el campo estado: de un documento en español como status).
Cada clave numérica (search.k, chunk.minTokens, chunk.maxTokens, sync.throttleMs) solo se respeta cuando es un número finito mayor que 0 — search.k debe además ser un número entero. Cualquier otra cosa, incluido un número entre comillas como "480", vuelve al valor predeterminado exactamente como lo haría una clave ausente, y el valor de respaldo se informa: en stderr para cada comando CLI, y en la respuesta de docs_overview para un cliente MCP. Una clave no reconocida bajo embeddings, chunk o convention.frontmatterFields (un error tipográfico como maxtokens) se informa de la misma manera. Una configuración sin nada incorrecto no informa nada.
Múltiples raíces de documentación
Declara más de una raíz para indexar varias carpetas — adr/, rfcs/, un directorio de especificaciones — como un solo corpus buscable:
{ "docsDir": ["docs", "openspec"], "exclude": ["INDEX.md", "openspec/changes/archive"] }
Cada documento path se prefija con el alias de su raíz — el nombre del propio directorio, así que docs/x.md y openspec/specs/y.md se leen ambos como la ruta real relativa al proyecto. Esto se mantiene con una sola raíz explícita y también con raíces descubiertas: openspec/specs/y.md, no specs/y.md. search_docs, docs_overview, read_doc y el INDEX.md generado usan todos esta forma prefijada; pasar un path de vuelta a read_doc exactamente como se devolvió siempre se resuelve.
Las raíces declaradas no pueden colisionar: dos raíces que resuelven al mismo directorio, una anidada dentro de otra (en cualquier orden de declaración), o dos raíces que comparten el mismo nombre de directorio (y por tanto el mismo alias) se rechazan antes de indexar nada. Una raíz que se declara pero no se puede leer (un error tipográfico, o una carpeta que solo algunos checkouts tienen) se informa y se omite — la ejecución continúa con las raíces restantes, y solo falla si todas las raíces declaradas fallan. Eliminar una raíz de docsDir borra sus documentos en la siguiente pasada de sincronización, igual que eliminar los archivos mismos.
En modo de descubrimiento, Compendio vuelve a escanear las carpetas de nivel superior en cada pasada de sincronización de index, sync y serve, selecciona aquellas con archivos .md en cualquier lugar debajo de ellas, omite contenido con enlaces simbólicos y carpetas generadas/internas como .git, .compendio, node_modules, dist, build y coverage, y escribe INDEX.md en la raíz del proyecto. El descubrimiento falla de forma segura: JSON de configuración de nivel superior malformado, árboles candidatos ilegibles, fallos de recorrido/lectura, o una raíz descubierta previamente indexada que desaparece o se convierte en enlace simbólico/junction antes de la sincronización abortan antes de mutar el índice. Una raíz previamente indexada que sigue siendo un directorio legible se sigue recorriendo incluso después de que se elimine su último archivo Markdown, para que las eliminaciones legítimas se reconcilien normalmente. Las comprobaciones de enlaces simbólicos usan lstat/realpath en el momento del escaneo/recorrido, pero no son un sandbox a nivel de kernel; una condición de carrera del sistema de archivos entre la comprobación y la lectura queda fuera de alcance. --dir <path> (abajo) es el modo explícito: reemplaza todo el conjunto de raíces declaradas/descubiertas con ese único directorio y escribe INDEX.md dentro de él.
Funciona con tu framework de SDD
Los frameworks de desarrollo guiado por especificaciones mantienen sus artefactos de planificación en Markdown, que es exactamente lo que Compendio indexa. Apunta docsDir a las carpetas donde tu framework escribe:
| Framework | Configuración | Indexa |
|---|---|---|
| Spec Kit | { "docsDir": ["specs", ".specify"] } | Especificaciones de características, planes y tareas bajo specs/NNN-feature/, además de la constitución en .specify/memory/constitution.md |
| OpenSpec | { "docsDir": ["openspec"] } | openspec/project.md, especificaciones de capacidades y cambios en curso |
| Kiro | { "docsDir": [".kiro"] } | requirements.md/design.md/tasks.md por característica bajo .kiro/specs/, además de .kiro/steering/ |
| BMAD | { "docsDir": ["docs"] } | PRD, arquitectura, épicas fragmentadas e historias |
| Framework + tus propios docs | { "docsDir": ["docs", "openspec"] } | Ambos, como un solo corpus buscable |
Los directorios ocultos como .specify/ y .kiro/ se indexan normalmente, tanto como raíces declaradas como en modo de descubrimiento — las entradas con prefijo de punto dentro de una raíz son lo que se omite, no la raíz misma. Así que sin ningún archivo de configuración, un proyecto Spec Kit o Kiro ya se indexa.
Tres cosas que vale la pena saber antes de copiar una línea:
- El alias de una raíz es su nombre de directorio, no la ruta que declaraste.
.kiro/specstiene el aliasspecs, por lo que sus documentos aparecen comospecs/auth/design.md. Eso también significa que colisiona con una raízspecs/de nivel superior y no se puede combinar con la de Spec Kit — declara.kiroen su lugar, que es lo que hace la tabla. - La carpeta de salida de BMAD es configurable.
docses el valor predeterminado; BMAD v6 leeoutput_folderde su propia configuración, así que declara el valor que tengas configurado. - Las plantillas son ruido.
.specify/templates/contiene andamiaje de marcadores de posición, no conocimiento del proyecto. Añade"exclude": [".specify/templates", ".specify/scripts"]si prefieres que no aparezcan en los resultados de búsqueda.
Convención de documentación (opcional)
Dos modos, seleccionados por convention.mode:
loose(predeterminado, sin configuración) — nunca rechaza un archivo por falta de metadatos. El título proviene del primer H1 (con respaldo a un nombre de archivo humanizado), el módulo se infiere de la carpeta, ytype/statusse leen del frontmatter cuando están presentes y se omiten en caso contrario.strict(opt-in) — un linter: cada documento necesita un H1 ytype/module/statusno vacíos, validados contra las listas que declara tu proyecto. Los archivos que fallan se omiten y se reportan, sin romper nunca la ejecución.
{
  "convention": {
    "mode": "strict",
    "types": ["functional", "adr", "api", "qa", "guide"],
    "statuses": ["draft", "current", "deprecated"],
    "excludedStatuses": ["draft", "deprecated"]
  }
}
excludedStatuses oculta documentos de la búsqueda según el estado del ciclo de vida — los borradores y las páginas obsoletas dejan de contaminar los resultados. Consulta docs/documentation-convention.md para ver la convención completa que siguen los propios documentos de este repositorio.
Herramientas MCP
Diseñadas como divulgación progresiva: orientarse de forma económica → buscar de forma económica → leer solo lo necesario.
1. docs_overview() — el mapa del corpus. Conteos por tipo y módulo, más una línea por documento. Aproximadamente 10 tokens por documento.
2. search_docs({ query, type?, module?, tags?, k?, include_excluded? }) — los k fragmentos principales (5 por defecto, como máximo 2 por documento), cada uno con ruta, sección, extracto y puntuación. type es una cadena abierta definida por el proyecto, no una lista fija.
3. read_doc({ path, section? }) — una sección, o el documento completo. Un documento grande con secciones (por encima de ~6,000 tokens estimados) devuelve un esquema compacto de sus encabezados H2/H3 en lugar del cuerpo, para que el agente lea solo las secciones que necesita. Una ruta que no existe devuelve las 3 rutas más similares en lugar de un error, para que el agente se autocorrija en lugar de reintentar a ciegas.
CLI
| Comando | Qué hace |
|---|---|
compendio serve | Inicia el servidor MCP sobre stdio |
compendio index | Reconstrucción completa del índice |
compendio sync | Ejecuta una pasada de sincronización incremental desde la terminal — sincroniza solo los documentos cuyo contenido cambió, con progreso en vivo. Consulta Sincronización incremental |
compendio search "..." | Búsqueda híbrida con filtros: --type, --module, --tags, -k, --all |
compendio overview | Mapa del corpus indexado |
compendio index-md | Genera o actualiza un INDEX.md combinado: INDEX.md en la raíz del proyecto en modo descubrimiento, o INDEX.md dentro de la primera raíz explícita/--dir — una línea por documento |
compendio eval | Mide la calidad de recuperación contra un conjunto dorado |
Opción global -C, --root <dir>: raíz del proyecto. Añade --lexical a index, sync o search para omitir los embeddings por completo. --dir <path> en index/index-md reemplaza el docsDir configurado con ese único directorio — no lo añade, y el índice que produce aún tiene la forma de ruta prefijada (<dirname>/x.md). sync no tiene --dir: bajo una pasada incremental, eliminar una raíz de esta manera borraría sus documentos en lugar de simplemente omitirlos (consulta compendio sync --help).
Cómo funciona
docs/**/*.md
     │
     ├─▶ split into fragments at heading boundaries, then bounded to maxTokens
     │
     ├─▶ index each fragment twice ─┬─ full-text (keywords)
     │                              └─ embeddings (meaning)
     │
     └─▶ one file: .compendio/compendio.db
En el momento de la consulta, ambos índices se buscan de forma independiente y sus clasificaciones se fusionan con Fusión de Rango Recíproco — una fusión basada en rango sin pesos que ajustar a ciegas. El agente recibe el conjunto más pequeño de fragmentos relevantes.
Compendio es la mitad de recuperación de RAG. Nunca llama a un LLM y no genera nada: encuentra los párrafos correctos y se aparta.
Si el modelo de embeddings no está disponible, Compendio no se bloquea — degrada a búsqueda solo por palabras clave y lo indica en sus respuestas.
Sincronización incremental
La documentación cambia mientras trabajas, y Compendio se mantiene al día por sí solo — o cuando se lo pidas. Hay cuatro formas de actualizar el índice:
| Disparador | Qué sucede |
|---|---|
Inicio del servidor (compendio serve) | Una pasada de sincronización incremental, iniciada antes de que el transporte se conecte. La primera llamada a una herramienta espera a que termine, para que nunca se responda contra un índice frío |
Cualquier llamada a herramienta MCP (search_docs, docs_overview, read_doc) | Una pasada de sincronización incremental — pero solo si han transcurrido 30 s desde la última (sync.throttleMs, 30000 por defecto). De lo contrario, la llamada procede contra el índice actual |
compendio sync | Una pasada de sincronización incremental, ejecutada manualmente desde la terminal, con progreso en vivo. sync.throttleMs no la limita — cada invocación ejecuta una pasada nueva sin importar cuán reciente haya sido la anterior. Recomendado ejecutarlo si has añadido una gran cantidad de documentos de una vez. |
compendio index | Reconstrucción completa desde cero: el índice se elimina y se recrea |
No es un temporizador. No hay intervalo en segundo plano ni observador de archivos. La sincronización se impulsa por las llamadas a herramientas de tu agente, o por ti ejecutando compendio sync, y el límite es un piso entre los dos disparadores automáticos, no un horario: un servidor que nadie consulta no sincroniza, y una ráfaga de diez llamadas en un segundo aún dispara como máximo una pasada. Las llamadas concurrentes se unen a la pasada ya en curso en lugar de iniciar una segunda.
Cada pasada de sincronización incremental compara los hashes de contenido contra lo ya indexado, por lo que solo los documentos nuevos, modificados y eliminados hacen trabajo — un corpus sin cambios no cuesta nada. Dentro de serve, si una pasada falla, se registra en stderr y la herramienta aún responde contra el índice actual; compendio sync no tiene ese respaldo, por lo que la misma falla sale del proceso con código distinto de cero.
Cuándo necesitas la reconstrucción completa. compendio index es el único comando que reindexa: elimina y recrea toda la base de datos, y es el autoritativo. Úsalo después de una reestructuración grande, si sospechas que el índice se ha desviado, o — el caso que sorprende a la gente — después de cambiar chunk.minTokens/chunk.maxTokens. Una pasada de sincronización incremental, ya sea automática o ejecutada manualmente mediante compendio sync, identifica un documento solo por su hash de contenido, por lo que un documento que no has editado conserva sus límites de fragmento antiguos sin importar lo que diga ahora la configuración. Solo una reindexación completa (compendio index) aplica el nuevo fragmentado a archivos sin cambios — consulta compendio sync --help para la misma advertencia en el punto donde es más probable que la necesites.
Multilingüe
Escribe tu documentación en el idioma que use tu equipo. A Compendio no le importa:
- El contrato es en inglés, el corpus no tiene que serlo. Los parámetros de las herramientas (
path,type,module,tags,section), los campos de respuesta y las descripciones de herramientas están en inglés, para que cualquier agente los lea sin fricción. Eso es independiente del idioma en que estén escritos tus documentos: las claves de frontmatter se eliminan antes de indexar, y el tokenizador FTS5 no lleva un stemmer específico de idioma. - Las claves de frontmatter no inglesas se mapean de vuelta. Si tus documentos usan
estado:en lugar destatus:,convention.frontmatterFieldslas traduce. - Los acentos se manejan correctamente. La búsqueda es insensible a diacríticos, por lo que validación y validacion coinciden. La búsqueda sensible a acentos pierde resultados silenciosamente.
- El modelo de embeddings es multilingüe (
Xenova/multilingual-e5-small), por lo que los corpus de un solo idioma o mixtos se indexan y recuperan igual.
El corpus de referencia y el conjunto de evaluación incluidos en ejemplos/ están en español — deliberadamente, como prueba de que un código base y un contrato de herramientas en inglés recuperan documentación no inglesa sin pérdida.
¿Cuánto añade la semántica sobre grep?
Medido con compendio eval en el corpus de ejemplo (ejemplos/: 11 documentos, 29 fragmentos, sin archivo de configuración — el camino de cero configuración en sí) y su conjunto dorado de 22 preguntas reales:
| modo | recall@5 | MRR | fallos |
|---|---|---|---|
| híbrido | 1.00 | 0.943 | 0 |
| solo palabras clave | 0.95 | 0.856 | 1 |
- La búsqueda por palabras clave ya es fuerte cuando la pregunta usa la terminología del corpus.
- La brecha se abre con paráfrasis y sinónimos: «¿Qué endpoint hay que llamar para crear un lead?» sale del top 5 sin embeddings, y la pata semántica lo recupera. Las preguntas con cero solapamiento de palabras con el documento coincidente se resuelven solo con semántica.
- Velocidad: con el modelo caliente, la búsqueda híbrida responde en 5–20 ms.
compendio eval reproduce esta tabla en cualquier momento — también es el instrumento para ajustar el fragmentado y k sin adivinar.
Arquitectura
Hexagonal: el núcleo no sabe nada de SQLite, transformers.js o el sistema de archivos.
src/
├── domain/            # pure, no dependencies: model, chunking, ranking, convention policy
├── application/       # use cases
├── infrastructure/    # adapters: SQLite, markdown parsing, filesystem, embeddings
├── composition.ts     # composition root — start here to see the whole app
├── cli.ts             # input adapter: commander
└── server.ts          # input adapter: MCP server (stdio)
Cada dependencia externa está detrás de un puerto en src/domain/ports.ts. Cambiar el almacén de vectores o el proveedor de embeddings es un cambio local en un adaptador, no una reescritura.
Desarrollo
npm install
npm run build       # compiles to dist/
npm test            # vitest: domain, adapters and integration
npm run typecheck   # tsc --noEmit
npm run dev -- ...  # CLI without compiling (tsx)
Las pruebas de integración usan un proveedor de embeddings determinista (sin descargas) contra el corpus real de ejemplos/.
Prueba la CLI contra el corpus de ejemplo incluido sin instalar el paquete:
node dist/cli.js --root ejemplos index
node dist/cli.js --root ejemplos search "¿cuándo se considera duplicado un lead?"
Este repositorio incluye un .mcp.json que sirve el corpus de ejemplos/, para que puedas probar las herramientas desde Claude Code con cero configuración.
Licencia
MIT © Raúl García Barciela