code context engine
Un servidor MCP local para agentes de codificación de IA. Indexación consciente de AST, búsqueda semántica y compresión automática. Tu agente deja de releer todo tu código base en cada sesión.
Documentación

Code Context Engine
Indexa tu código. La IA busca en lugar de volver a leer archivos.
94% de ahorro de tokens, evaluado de forma reproducible.
Sitio web · Documentación · ¿Por qué CCE? · Benchmark · GitHub




Python 3.11+ · macOS · Linux · Windows




Un solo comando. Detecta tu editor automáticamente. Cero nube, cero configuración.
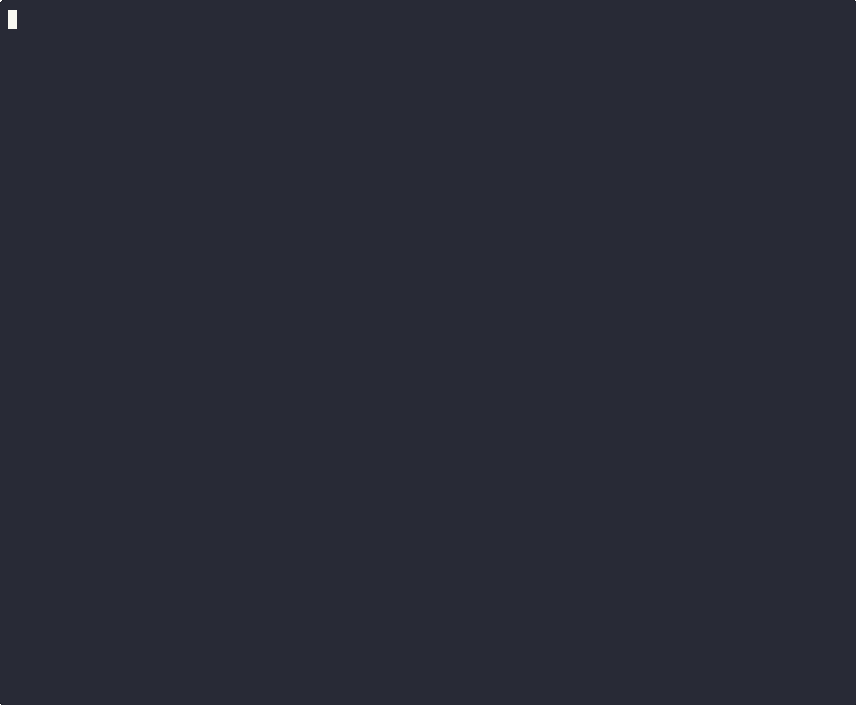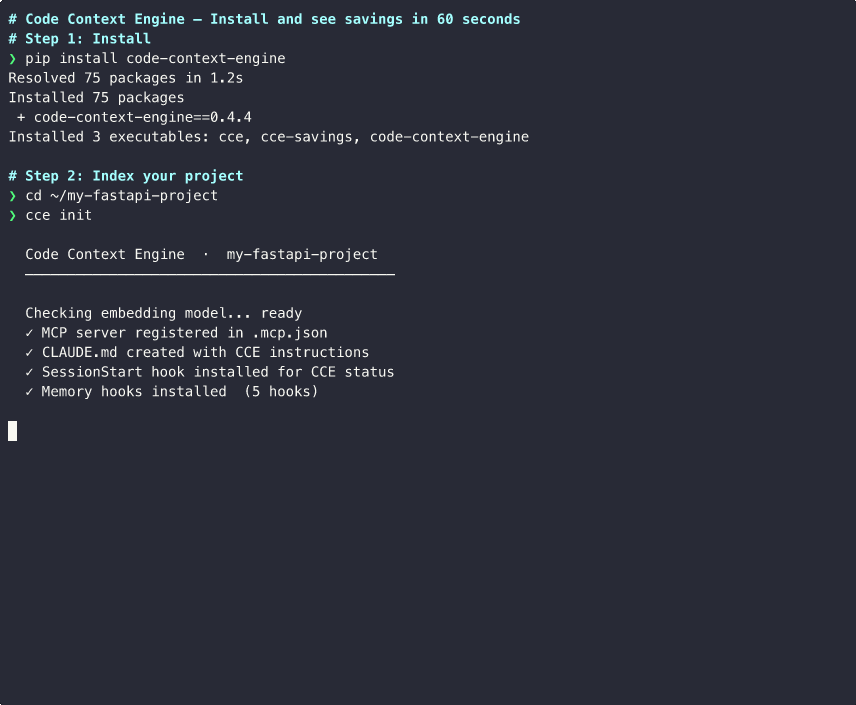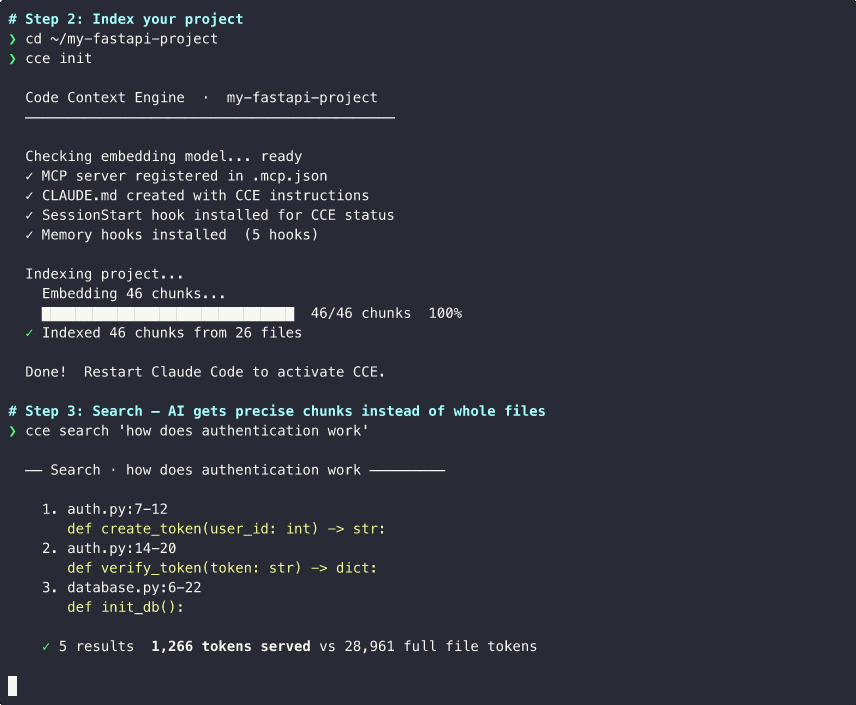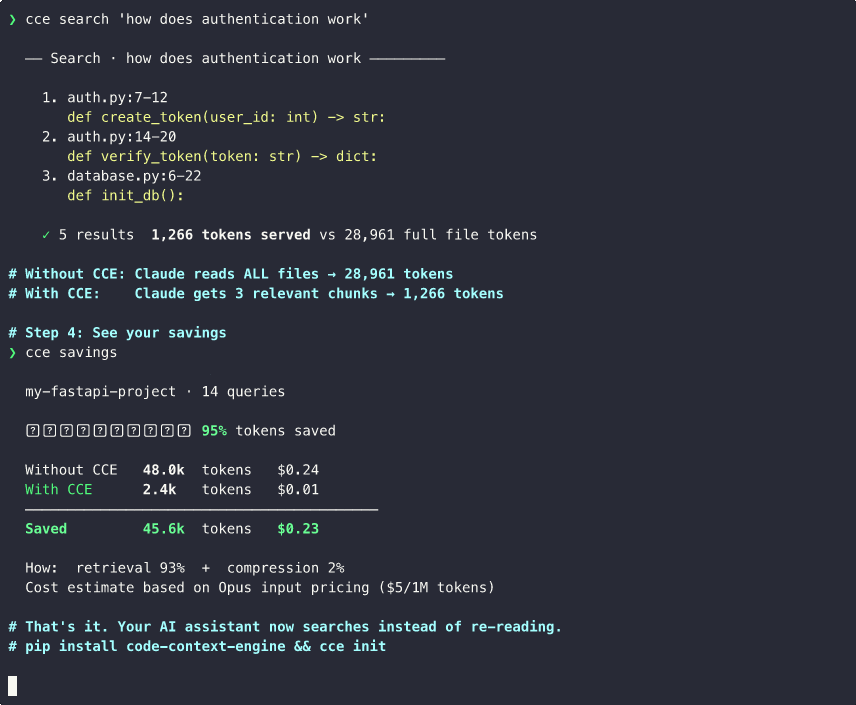
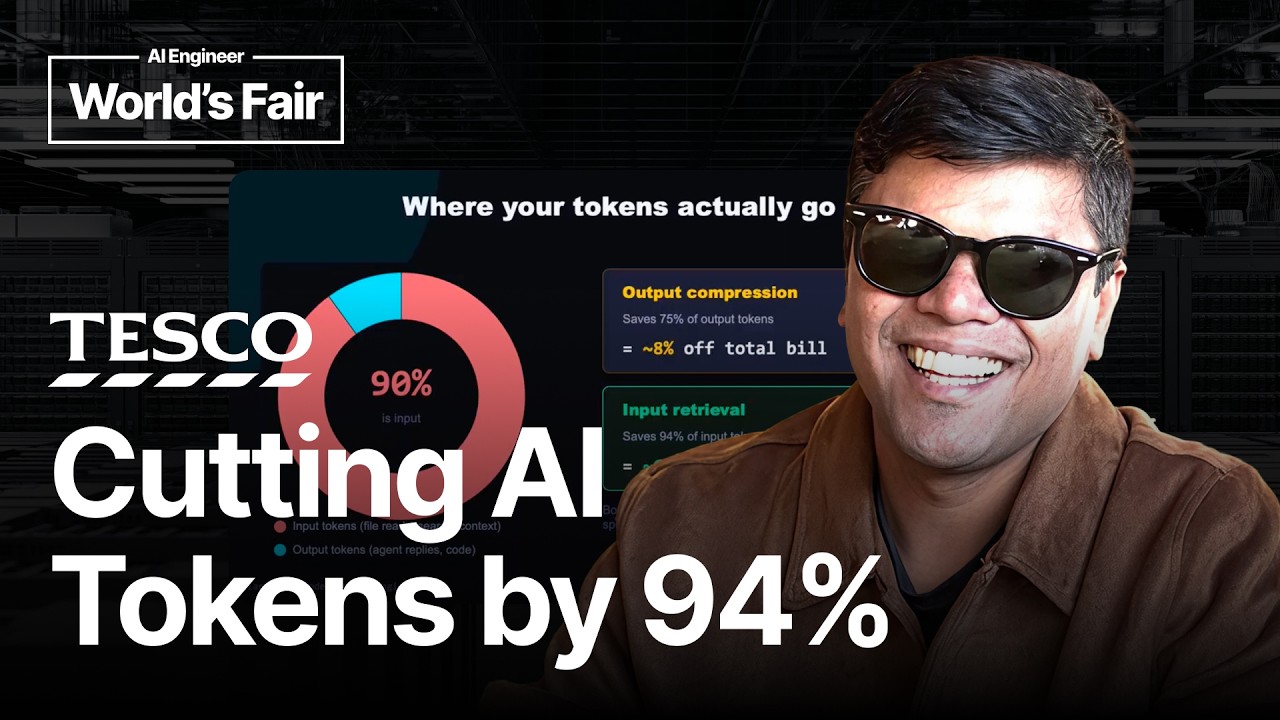
Charla: Redujimos el 94% de los Tokens de Codificación con IA — AI Engineer World's Fair 2026
Casos de uso
| Caso de uso | Cómo ayuda CCE | |
|---|---|---|
| 💰 | Reducir costos de Claude Code | 94% menos tokens de entrada por sesión |
| 🔒 | Mantener el código privado | Todo local, sin indexación en la nube |
| 🔄 | Equipos multi-editor | Un índice compartido entre Claude Code, Cursor, VS Code, Gemini CLI |
| 🧠 | Memoria entre sesiones | Las decisiones y el contexto sobreviven a los reinicios |
| ⚡ | Respuestas más rápidas | Menos contexto = respuestas más rápidas de Claude |
| 📊 | Seguimiento del ahorro real | Montos en dólares, no estimaciones |
Inicio rápido
Un comando. 30 segundos.
uvx --from "code-context-engine[local]" cce init # install + index + configure, one shot
O si prefieres una instalación persistente:
uv tool install "code-context-engine[local]"    # or: pipx install "code-context-engine[local]"
cd /path/to/your/project
cce init
Reinicia tu editor. Listo. Cada pregunta ahora consulta el índice en lugar de volver a leer archivos.
Compatibilidad con Plugins de Agente: Ejecuta
cce init --pluginpara generar un directorio de Agent Plugin portátil que funciona con VS Code, Cursor, Copilot, Codex, ChatGPT y Kiro. El plugin usauvxpara iniciar CCE bajo demanda, así los usuarios no necesitan instalar previamente el paquete de Python. Consulta Agent Plugin más abajo.
¿Ya tienes Ollama? Omite
[local]y usauv tool install code-context-engineen su lugar. CCE detecta automáticamente Ollama en localhost:11434 y usanomic-embed-text.
Requisitos del sistema
Python 3.11+ y un compilador de C (para las gramáticas de tree-sitter).
| Plataforma | Configuración |
|---|---|
| macOS | xcode-select --install |
| Ubuntu/Debian | sudo apt install build-essential cmake |
| Fedora/RHEL | sudo dnf install gcc gcc-c++ cmake |
| Windows | Visual Studio Build Tools (carga de trabajo C++) + CMake |
Probado en macOS, Linux y Windows con Python 3.11/3.12/3.13.
cce init detecta automáticamente tu editor y escribe la configuración correcta. Para apuntar a un
agente específico, usa --agent claude, --agent codex, --agent copilot, --agent pi o
--agent all.
| Editor | Configuración escrita | Instrucciones |
|---|---|---|
| Claude Code | .mcp.json | CLAUDE.md |
| VS Code / Copilot | .vscode/mcp.json | .github/copilot-instructions.md |
| Cursor | .cursor/mcp.json | .cursorrules |
| Gemini CLI | .gemini/settings.json | GEMINI.md |
| OpenAI Codex | ~/.codex/config.toml (global de usuario, sección por proyecto) | AGENTS.md |
| OpenCode | opencode.json | |
| Tabnine | .tabnine/agent/settings.json | TABNINE.md |
| Pi | .mcp.json | AGENTS.md |
¿Varios editores en el mismo proyecto? Todos se configuran con un solo comando.
Nota sobre Codex: Codex CLI lee los servidores MCP solo desde ~/.codex/config.toml —
no tiene configuración por proyecto. cce init agrega una sección de [mcp_servers.cce-<project>-<hash>]
por proyecto para que varios proyectos coexistan; cce uninstall elimina únicamente
la sección del proyecto actual.
Nota sobre Pi: Pi no admite MCP de forma nativa. Para usar CCE con Pi, necesitas una
extensión adaptadora de pi MCP (por ejemplo, pi-mcp-adapter)
que consuma la configuración de .mcp.json y exponga las herramientas de CCE al agente Pi.
cce init configura tanto .mcp.json como AGENTS.md (Pi carga este último
automáticamente para las instrucciones de inicio).
  my-project · 38 queries · last query 5m ago

  ⛁ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶  88% tokens saved

  Input savings   1.9M  tokens   $27.78
  Output savings  4.8k  tokens   $0.36
  ──────────────────────────────────────────
  Total saved   1.9M  tokens   $28.15

  Breakdown:
    retrieval              84%  ▰▰▰▰▰▰▰▰▰▰    1.8M   $26.76 · 12 calls
    chunk compression       3%  ▰▱▱▱▱▱▱▱▱▱   68.5k    $1.03 · 12 calls
    output compression*    <1%  ▰▱▱▱▱▱▱▱▱▱    4.8k    $0.36 · 12 calls

  Cost estimate based on Opus pricing (input $15.0/1M, output $75.0/1M)
Compatible con los precios de modelos de Anthropic, OpenAI y Google. Configúralo mediante pricing.model en ~/.cce/config.yaml.
Por qué esto importa
Los tokens de entrada representan el 85-95% de tu factura de Claude Code. CCE los reduce en un 94% (evaluado en FastAPI).
Without CCE:    Claude reads payments.py + shipping.py   = 45,000 tokens
With CCE:       context_search "payment flow"            =    800 tokens
| Sin CCE | Con CCE | |
|---|---|---|
| Inicio de sesión | Vuelve a leer archivos cada vez | Consulta el índice |
| Encontrar una función | Lee el archivo completo de 800 líneas | Obtén la función de 40 líneas |
| Memoria entre sesiones | Ninguna | Decisiones + áreas de código persistidas |
| Costo de tokens (Sonnet, proyecto mediano) | ~$0.14/sesión | ~$0.04/sesión |
Benchmark: FastAPI (reproducible)
Evaluamos CCE contra FastAPI (53 archivos fuente, 180K tokens) con 20 preguntas reales de codificación. Sin selección selectiva, sin consultas sintéticas.
Metodología: Para cada consulta, "sin CCE" significa leer el contenido completo de cada archivo que la consulta toca. "Con CCE" significa los fragmentos relevantes después de la compresión.
Nota importante sobre la línea base: El número del 94% se mide contra lecturas de archivos completos, no contra lo que Claude Code realmente hace. En la práctica, Claude Code ya usa grep, lecturas parciales de archivos y herramientas específicas, por lo que el ahorro en el mundo real comparado con el comportamiento normal de Claude Code será menor al 94%. Usamos el archivo completo como línea base porque es reproducible y determinista (sin variabilidad en el comportamiento del agente). El benchmark mide la eficiencia de recuperación de CCE, no una comparación directa con la exploración integrada de Claude Code.
| Métrica | Resultado |
|---|---|
| Ahorro de recuperación | 94% (83,681 → 4,927 tokens/consulta) |
| Compresión (adicional, sobre fragmentos recuperados) | 89% (4,927 → 523 tokens/consulta) |
| Recall@10 (encontró los archivos correctos) | 0.90 |
| Latencia p50 | 0.4ms |
| Consultas probadas | 20 |
Ahorro por capa (cada una medida de forma independiente)
| Capa | Qué hace | Ahorro | Método |
|---|---|---|---|
| Recuperación | Archivos completos → fragmentos de código relevantes | 94% | medido |
| Compresión de fragmentos | Fragmentos crudos → firmas + docstrings | 89% | medido |
| Gramática | Elimina artículos/relleno del texto de memoria | 13% | medido |
La compresión de salida (reducir la longitud de la respuesta de Claude) proporciona ahorros adicionales (~65% estimado) pero no se incluye en el número principal anterior.
Benchmarks multilenguaje
| Repo | Lenguaje | Archivos | Ahorro de recuperación | Recall@10 |
|---|---|---|---|---|
| FastAPI | Python | 53 | 94% | 0.90 |
| Django | Python (grande) | 2,347 | 93% | 0.95 |
| Express | JavaScript | 6 | 94% | 1.00 |
| chi | Go | 94 | 76% | 0.67 |
| fiber | Go (monorepo) | 396 | 93% | 0.07 |
Django (2,347 archivos, 5.4M tokens) demuestra que CCE escala a códebas grandes con un recall de 0.95. Los archivos más cortos de Go reducen el margen de recuperación (línea base más pequeña). Los monorepos diluyen el recall en el top-10 (fiber). Las consultas de middleware con una función por archivo alcanzan R=1.00 de forma consistente.
Reprodúcelo tú mismo:
pip install code-context-engine
python benchmarks/run_benchmark.py --repo https://github.com/fastapi/fastapi.git --source-dir fastapi
python benchmarks/run_benchmark.py --repo https://github.com/go-chi/chi.git --source-dir .
Resultados completos en benchmarks/results/. Consultas y metodología en benchmarks/.
Lo que obtienes
11 herramientas MCP que Claude usa automáticamente:
| Herramienta | Qué hace |
|---|---|
context_search | Búsqueda híbrida vectorial + BM25 con expansión de grafo |
expand_chunk | Código fuente completo para un resultado comprimido |
related_context | Encuentra código mediante aristas del grafo (llamadas, imports) |
session_recall | Recupera decisiones de sesiones anteriores |
session_timeline | Recorre resúmenes de turnos de una sesión (profundiza en coincidencias de recall) |
session_event | Inspecciona la entrada/salida cruda de herramientas para un evento específico |
record_decision | Guarda una decisión para sesiones futuras |
record_code_area | Registra en qué archivos se trabajó |
index_status | Verifica la actualización del índice |
reindex | Re-indexa un archivo o el proyecto completo |
set_output_compression | Ajusta la verbosidad de las respuestas (off / lite / standard / max) |
Panel en vivo con gráficos de dona, salud de archivos e historial de sesiones:
cce dashboard
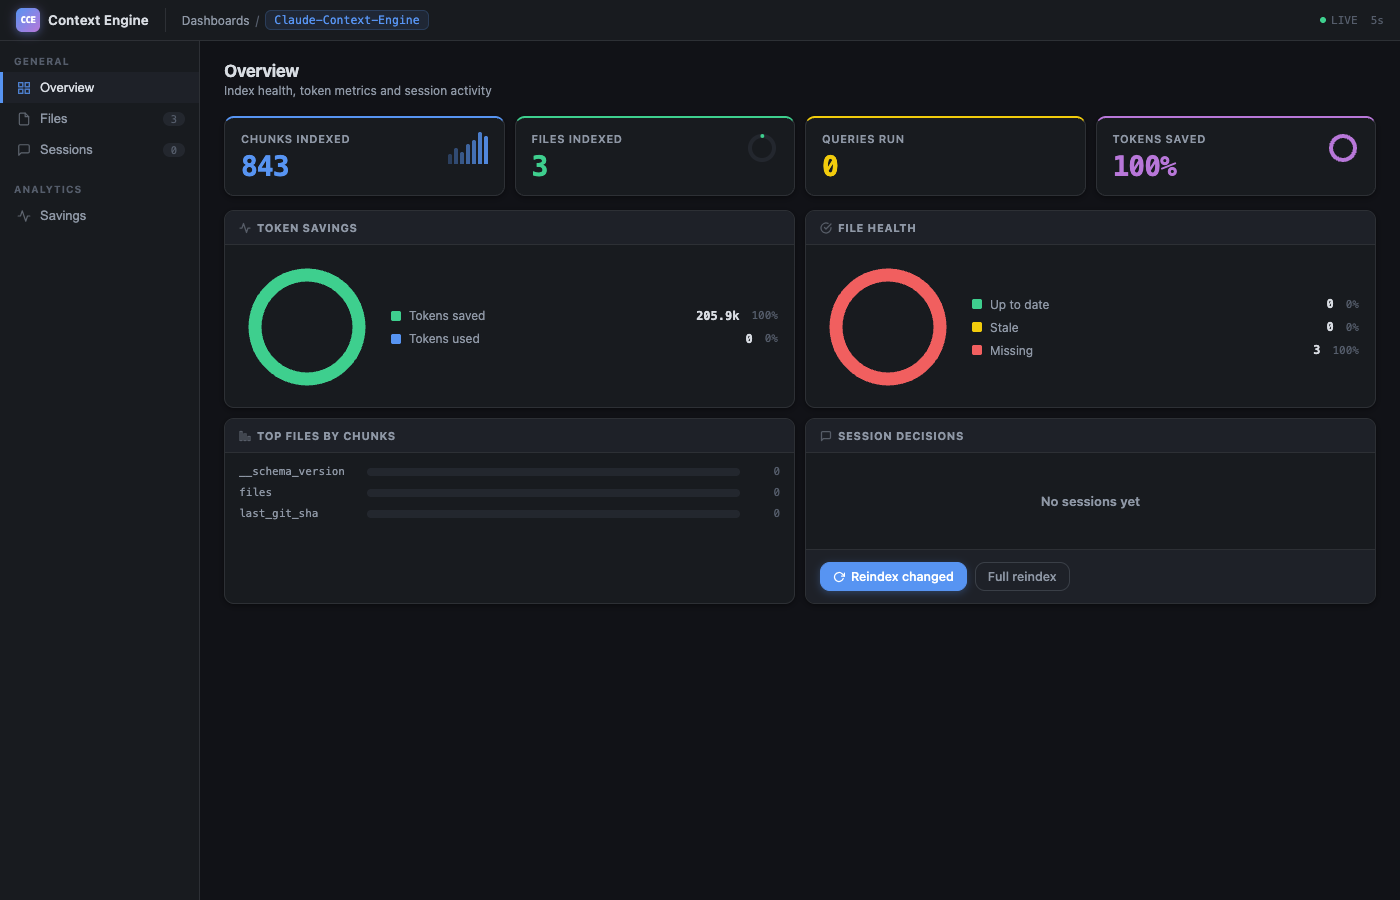
Estimaciones en dólares con precios de múltiples proveedores (Anthropic, OpenAI, Google):
cce savings --all # see savings across all projects
Cómo funciona
- Índice: Tree-sitter analiza tu código en fragmentos semánticos (funciones, clases, módulos). Se almacenan como embeddings vectoriales localmente.
- Búsqueda: Claude llama a
context_search. La recuperación híbrida vectorial + BM25 encuentra los fragmentos correctos. El grafo de código agrega archivos relacionados automáticamente. - Compresión: Los fragmentos se truncan a firmas + docstrings (o se resumen con LLM si Ollama está en ejecución).
- Memoria: Las decisiones y áreas de código persisten entre sesiones mediante
session_recall. - Seguimiento: Cada consulta se registra.
cce savingsmuestra exactamente cuánto ahorraste.
La re-indexación tras ediciones toma menos de 1 segundo (96% de tasa de acierto de caché de embeddings). Los hooks de Git mantienen el índice actualizado automáticamente.
Qué hace diferente a CCE
Ahorra donde está el dinero
Las herramientas de compresión de salida (como Caveman) ahorran 20-75% en tokens de salida. La salida es el 5-15% de tu factura. Ahorro neto: ~11%.
CCE ahorra en tokens de entrada (94% de ahorro de recuperación en FastAPI, evaluado de forma reproducible). La entrada es el 85-95% de tu factura.
Realmente entiende tu código
No es una búsqueda de texto. El análisis AST de Tree-sitter crea fragmentos semánticos. La recuperación híbrida combina similitud vectorial con coincidencia de palabras clave BM25 mediante Reciprocal Rank Fusion. Un puntuador de confianza combina similitud (50%), coincidencia de palabras clave (30%) y actualidad (20%). La expansión de grafo recorre las aristas CALLS/IMPORTS para incluir código relacionado.
Recuerda
record_decision("use JWT for auth", reason="session tokens flagged by legal") se almacena en SQLite y se muestra mediante session_recall en la siguiente sesión. Sin necesidad de volver a explicar tu arquitectura.
Realiza seguimiento del ahorro real
No estimaciones. Tokens reales servidos frente a la línea base de archivos completos, desglosados por categorías (recuperación, compresión, salida, memoria, gramática). Los costos en dólares se obtienen de la página de precios de Anthropic. Resumen de ahorro mostrado al inicio de cada sesión.
Es seguro por defecto
Los archivos secretos (.env, *.pem, credentials.json) nunca se indexan. El contenido se escanea en busca de claves de AWS, tokens de GitHub, tokens de Slack, claves de Stripe, JWTs y credenciales genéricas. La PII (correos electrónicos, IPs, SSNs, tarjetas de crédito) se elimina de las escrituras de memoria. Todas las rutas de archivos MCP se validan contra el path traversal.
Bajo el capó
Caché de Embeddings por Hash de Contenido
Huella SHA-256 por fragmento, con sal basada en el nombre del modelo. El re-indexado omite código sin cambios. Almacenamiento binario float32 (10 veces más pequeño que JSON). Re-indexado típico: 96% de aciertos de caché, en menos de 1 segundo.
sqlite-vec: 2 MB en lugar de 217 MB
Se reemplazó LanceDB por sqlite-vec. Misma calidad de similitud coseno, instalación 99% más pequeña. Modo WAL + PRAGMA NORMAL para una velocidad de escritura 80% mayor. Vectores, FTS5, grafo de código y caché de compresión, todo en tres archivos SQLite.
Compresión Gramatical Determinista
Las entradas de memoria se comprimen sin llamadas a LLM. Elimina artículos, muletillas y pronombres. Tres niveles (lite/full/ultra, ahorro del 20-60%). El código, las rutas y las URLs se conservan byte a byte. La misma entrada siempre produce la misma salida.
Diseño de Hooks con Cierre Seguro
5 hooks del ciclo de vida de Claude Code capturan el contexto de la sesión. Cada hook se ejecuta curl ... || true, por lo que un servidor bloqueado nunca bloquea al usuario. SessionStart inyecta el contexto de arranque; los demás capturan en silencio.
Precios Multi-Proveedor
Las estimaciones en dólares en cce savings admiten más de 15 modelos de Anthropic, OpenAI y Google. Los precios estáticos se incluyen con CCE, los precios en vivo de Anthropic se obtienen y se almacenan en caché durante 7 días. Configura pricing.model (p. ej., gpt-4o, gemini-2.5-pro, sonnet) o anula con pricing.input / pricing.output para tarifas personalizadas.
Regulador de Recursos (Seguridad Multi-Instancia)
Ejecutar decenas de procesos cce serve (uno por proyecto y por sesión de IA) puede agotar la memoria del sistema. El regulador de recursos limita los hilos de ONNX Runtime por proceso, utiliza bloqueos de archivo con asesoramiento para que solo un proceso indexe un proyecto determinado a la vez, reduce la actividad bajo presión de memoria de Linux (PSI) y apaga automáticamente los servidores inactivos después de 30 minutos. Configúralo mediante serve.idle_timeout_minutes y serve.max_ort_threads.
Recordatorios de Memoria
La memoria entre sesiones de CCE depende de que el agente llame a record_decision y record_code_area. Los recordatorios de memoria hacen que el registro sea ambiental: después de N búsquedas sin un registro, los resultados de context_search incluyen un recordatorio breve. Al final de la sesión, el hook Stop resume la actividad no registrada. Los recordatorios se reactivan después del primer registro para que sigan siendo útiles sin ser molestos.
Endpoint de Búsqueda HTTP
cce serve --http expone un endpoint POST /search para integraciones de agentes personalizados que hablan HTTP en lugar de MCP stdio. Misma canalización de recuperación híbrida, respuesta JSON estructurada con puntuaciones de confianza. La validación de entrada limita top_k (1..100) y confidence_threshold (0.0..1.0).
Registro de Ahorros Solo-Anexar
7 categorías rastrean cada token ahorrado: recuperación, compresión de fragmentos, compresión de salida, recuerdo de memoria, gramática, resumen de turnos, divulgación progresiva. Sobrevive a los reinicios. Alimenta el CLI y los análisis del panel.
Plugin de Agente
Agent Plugins es un estándar abierto (v1.0.0) respaldado por Amazon, Cursor, Microsoft, OpenAI y Vercel para empaquetar habilidades de IA y servidores MCP en paquetes portátiles de instalación cero. CCE puede generar un directorio de plugin que los editores compatibles puedan descubrir y cargar automáticamente.
cce init --plugin                          # Generate at .cce/plugin/
cce init --plugin --plugin-dir ~/plugins/cce  # Custom location
cce init --agent claude --plugin           # Both: agent config + plugin
Qué se genera
.cce/plugin/
├── plugin.json                       # Agent Plugins v1.0.0 manifest
├── mcp.json                          # MCP server config (uvx + stdio)
├── skills/
│   └── code-context/
│       ├── SKILL.md                  # Agent instructions (frontmatter + body)
│       └── references/
│           └── tools.md              # Per-tool parameter docs (loaded on demand)
└── LICENSE
Editores compatibles
VS Code, GitHub Copilot, ChatGPT, Codex, Cursor y Kiro. El plugin utiliza uvx para lanzar CCE bajo demanda, por lo que los usuarios no necesitan preinstalar el paquete de Python. El servidor MCP descubre automáticamente la raíz del proyecto subiendo desde su directorio de trabajo, buscando .context-engine.yaml o .git/.
Cuándo usar --plugin vs --agent
--agent (predeterminado) | --plugin | |
|---|---|---|
| Método de instalación | Escribe archivos de configuración específicos del editor | Genera un directorio de plugin portátil |
| Instalación cero | No, CCE debe estar en PATH | Sí, uvx obtiene CCE bajo demanda |
| Actualizaciones de instrucciones | Obsoletas hasta que se vuelva a ejecutar cce init | Obsoletas hasta que se vuelva a ejecutar cce init --plugin |
| Mejor para | Tu propia máquina | Compartir con un equipo o distribuir |
Ambos se pueden usar juntos. --agent maneja la configuración MCP por editor, --plugin proporciona una alternativa portátil.
CLI de un vistazo
cce init                    # Index + install hooks + register MCP
cce init --plugin           # Generate Agent Plugin for VS Code, Cursor, etc.
cce                         # Status banner
cce savings                 # Token savings with dollar estimates
cce savings --all           # All projects
cce dashboard               # Web dashboard with live charts
cce search "auth flow"      # Test a query
cce status                  # Index health + config
cce services                # Ollama + dashboard + MCP status
cce commands add-rule '...' # Project rules for Claude
cce uninstall               # Clean removal of all CCE artifacts
Ejecuta cce list para la referencia completa de comandos.
Configuración
Configuración cero por defecto. Anula lo que necesites en ~/.cce/config.yaml o .context-engine.yaml:
compression:
  level: standard          # minimal | standard | full
  output: standard         # off | lite | standard | max
  ollama_url: http://localhost:11434   # point at a remote Ollama if desired

retrieval:
  top_k: 20
  confidence_threshold: 0.5

pricing:
  model: opus              # opus | sonnet | haiku | gpt-4o | gemini-2.5-pro | ...
  # input: 15.0            # override $/1M input tokens
  # output: 75.0           # override $/1M output tokens
Ollama remoto: Si ejecutas Ollama en otra máquina de tu red, establece compression.ollama_url (p. ej., http://nas.local:11434) o exporta CCE_OLLAMA_URL (la variable de entorno tiene prioridad). CCE sondea el endpoint y recurre a la compresión solo por truncamiento cuando no está disponible, por lo que un enlace inestable no romperá la indexación.
Compresión de Salida
CCE también comprime las respuestas de Claude (mismo concepto que Caveman):
| Nivel | Estilo | Ahorro |
|---|---|---|
off | Salida completa | 0% |
lite | Sin relleno ni evasivas | ~30% |
standard | Fragmentos, elimina artículos | ~65% |
max | Telegráfico | ~75% |
Dile a Claude: "cambia a compresión máxima" o "desactiva la compresión". Los bloques de código y los comandos nunca se comprimen.
Huella de Disco
| Componente | Tamaño |
|---|---|
| Instalación principal (backend Ollama) | ~17 MB |
Con el extra [local] (fastembed + ONNX) | ~189 MB |
| Modelo de incrustación (descarga única) | ~60 MB (fastembed) o gestionado por Ollama |
| Índice por proyecto (pequeño/mediano/grande) | 5-60 MB |
No se requiere GPU. Con Ollama, las incrustaciones las maneja el servidor Ollama. Con el extra [local], el modelo de incrustación se ejecuta en CPU mediante ONNX Runtime.
Idiomas Soportados
Fragmentación consciente de AST (analizado con tree-sitter, 11 extensiones):
| Idioma | Extensiones |
|---|---|
| Python | .py |
| JavaScript | .js, .jsx |
| TypeScript | .ts, .tsx |
| PHP | .php |
| Go | .go |
| Rust | .rs |
| Java | .java |
| C# | .cs |
Fragmentación de respaldo consciente del idioma (más de 40 extensiones):
| Categoría | Idiomas |
|---|---|
| Web | HTML, CSS, SCSS, LESS, Vue, Svelte |
| Sistemas | C, C++, Zig, Nim |
| Móvil | Swift, Kotlin, Dart |
| Funcional | Haskell, Scala, Clojure, Elixir, Erlang, F# |
| Scripting | Ruby, Perl, Lua, R, Bash/Zsh |
| Datos/Config | JSON, YAML, TOML, XML, SQL, GraphQL, Protobuf |
| DevOps | Terraform, HCL, Dockerfile |
| Documentos | Markdown |
Todos los demás archivos de texto se fragmentan por rango de líneas. Los archivos binarios se omiten.
Documentación
| Página | Contenido |
|---|---|
| ¿Cuánto estás gastando en tokens de codificación de IA? | Las matemáticas de tokens de entrada vs salida |
| ¿Qué es CCE? (Guía completa) | Configuración, herramientas, cómo funciona, preguntas frecuentes |
| Cómo ahorrar tokens de Claude Code | Desglose de costos y guía de ahorro |
| Análisis profundo de benchmarks | Metodología completa de benchmarks de FastAPI |
| Comparación con alternativas | CCE vs Cursor, Aider, Continue, Greptile |
| Ejemplos | Conversaciones reales con Claude |
| Cómo funciona | Canalización completa de 9 etapas |
| Referencia CLI | Cada comando con su salida |
| Configuración | Todas las opciones de configuración |
Preguntas Frecuentes
¿CCE afecta la calidad de las respuestas?
No. La calidad se mantiene igual o mejora ligeramente.
CCE reemplaza "volcar el archivo completo" por "buscar la función relevante". El modelo sigue obteniendo el código que necesita (0.90 Recall@10 en benchmarks). Menos contexto irrelevante significa menos ruido compitiendo por la atención, lo que puede mejorar el enfoque del modelo en tu pregunta real.
¿Cómo funciona el ahorro de tokens de salida?
CCE escribe reglas de compresión de salida directamente en los archivos de instrucciones de tu agente (CLAUDE.md, AGENTS.md, .cursorrules, etc.) durante cce init. Estas reglas se aplican a toda la sesión, no solo a las respuestas de las herramientas de CCE, por lo que cada respuesta del agente las sigue.
Establece el nivel en ~/.cce/config.yaml o .context-engine.yaml:
compression:
  output: max       # off | lite | standard | max
Luego vuelve a ejecutar cce init para actualizar los archivos de instrucciones. O cámbialo en tiempo de ejecución:
set_output_level output_level=max
| Nivel | Ahorro | Qué hace |
|---|---|---|
off | 0% | Sin compresión |
lite | ~25% | Elimina relleno/evasivas/cortesías + solo diferencias para cambios de código |
standard | ~70% | Elimina artículos, fragmentos, sinónimos cortos + solo diferencias para código |
max | ~80% | Estilo telegráfico + solo diferencias para código |
El valor predeterminado es standard. Todos los niveles incluyen reglas de salida de código que le indican al modelo que muestre solo las líneas cambiadas (no reescrituras completas de archivos), que es donde se gastan la mayoría de los tokens de salida en sesiones de codificación. El nivel max produce prosa muy concisa (similar al "modo cavernícola"). Los bloques de código, las rutas y los comandos nunca se comprimen independientemente del nivel.
¿De dónde provienen los ahorros?
La mayoría de los ahorros son tokens de entrada (lo que entra al modelo):
| Capa | Tipo | Ahorro típico |
|---|---|---|
| Recuperación | Entrada | 94% (archivos completos → fragmentos relevantes) |
| Compresión de fragmentos | Entrada | 89% (fragmentos → firmas) |
| Compresión gramatical | Entrada | 13% (eliminación de artículos/muletillas) |
| Resumen de turnos | Entrada | varía (historial de sesión) |
| Divulgación progresiva | Entrada | varía (cargas útiles de herramientas) |
| Compresión de salida | Salida | 25-80% (depende del nivel) |
Los tokens de salida cuestan 5 veces más por token (p. ej., Opus: $15/1M de entrada vs $75/1M de salida), por lo que incluso una pequeña reducción de salida tiene un impacto de costo desproporcionado.
Hoja de Ruta
- Benchmarks multi-repositorio (FastAPI, chi, fiber)
- Más benchmarks (Django, Express)
- Soporte de tree-sitter para C, C++, Ruby, Swift, Kotlin
- Soporte de Docker para modo remoto
- Portar a la API mcp 2.x
Consulta CHANGELOG.md para las funciones publicadas.
Contribuciones
Las contribuciones son bienvenidas. Consulta https://github.com/elara-labs/code-context-engine/blob/main/CONTRIBUTING.md para la configuración.
Licencia
MIT. Consulta LICENSE.
Autores
Agradecimientos
Claude Code · MCP · sqlite-vec · Tree-sitter · fastembed · Ollama
Si CCE te ahorra tokens, dale una estrella.