ownvoice
Servidor MCP que envuelve la CLI de ownvoice para verificaciones de voz e identidad.
Documentación
OwnVoice
Entrena un adaptador de voz LoRA para pocket-tts y conserva el resultado: un archivo en tu propio disco, no una suscripción a una API.


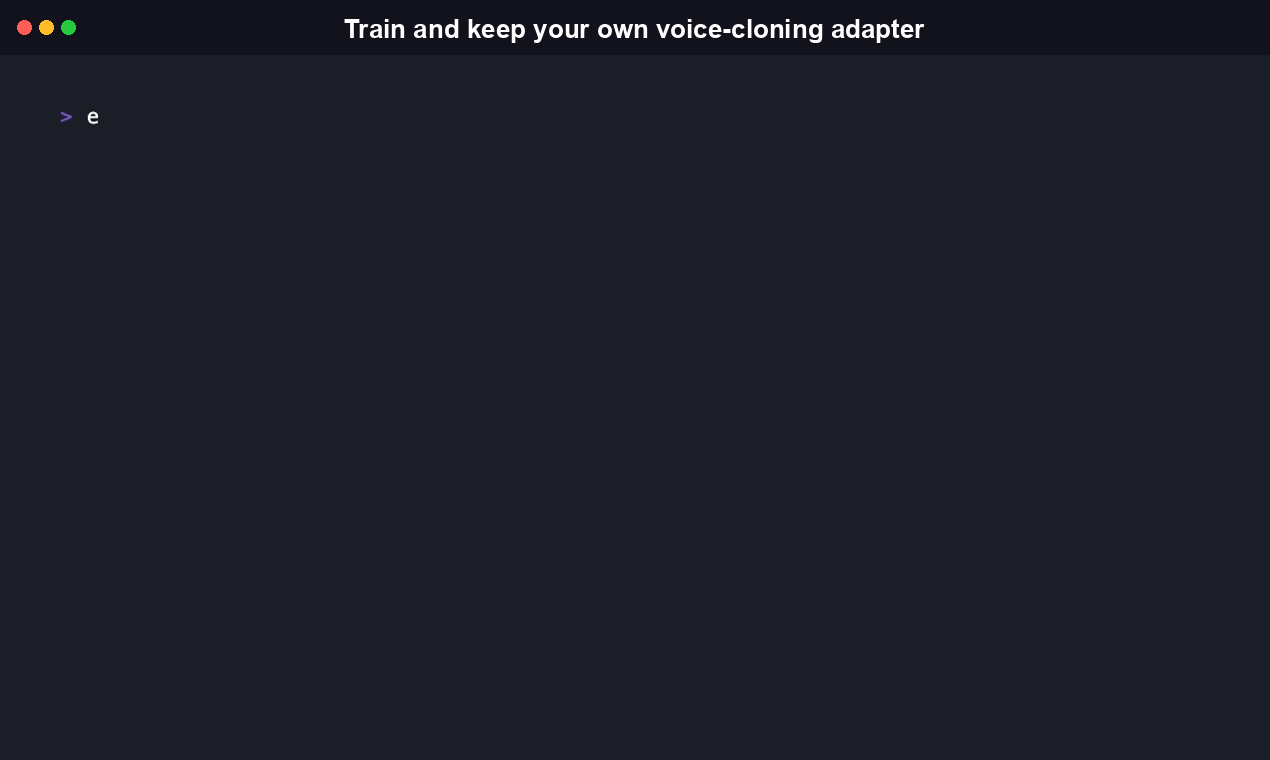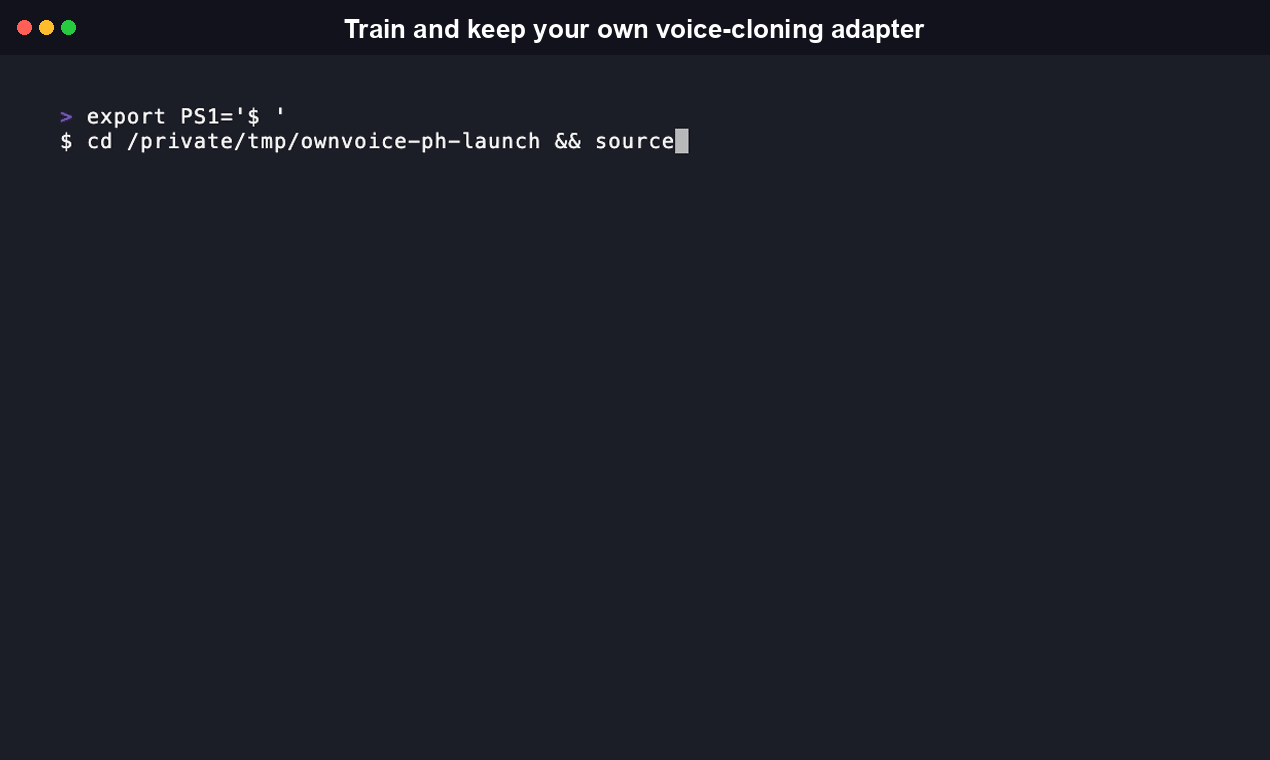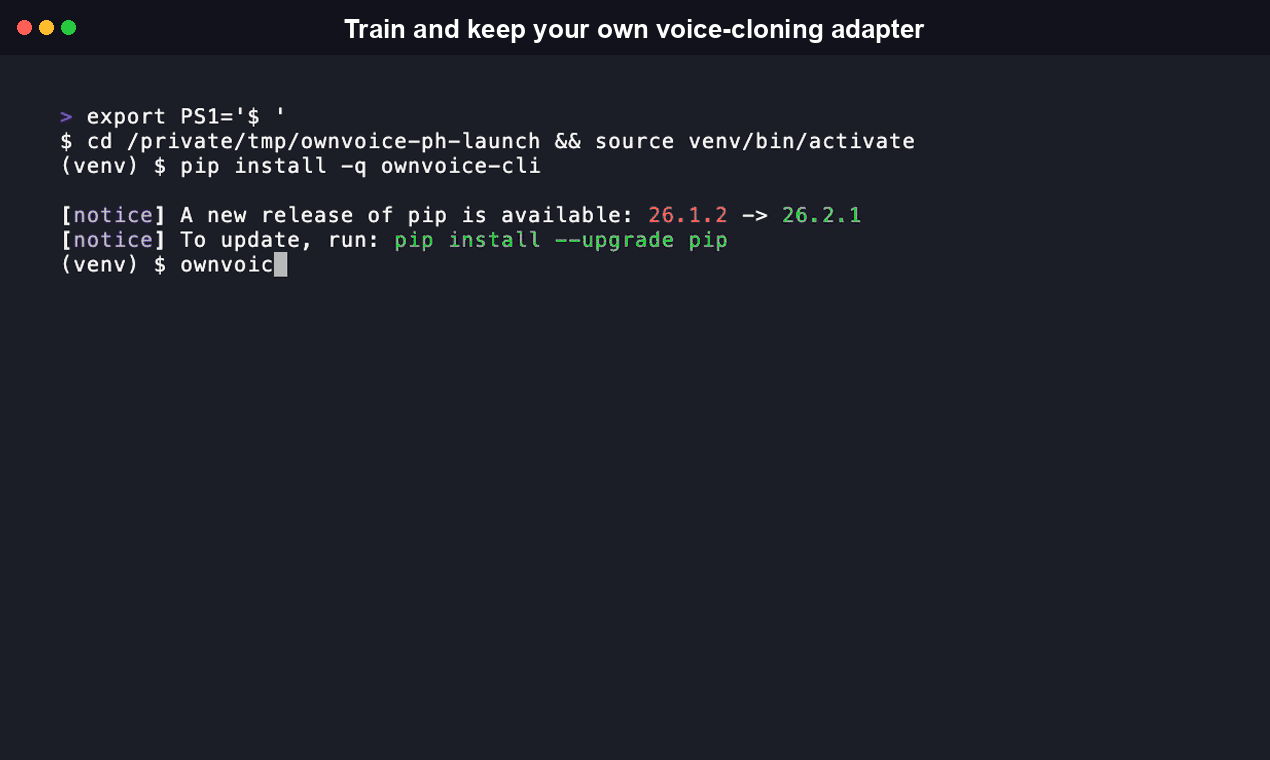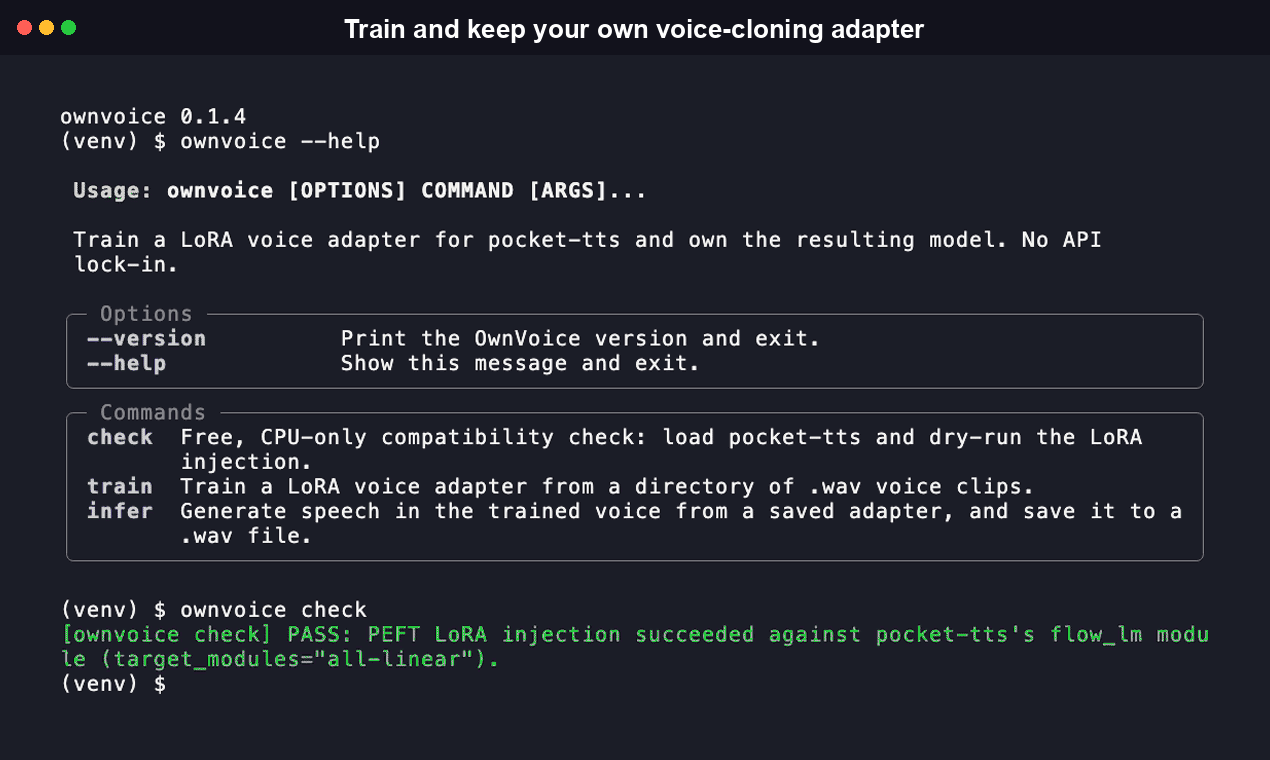
pip install ownvoice-cli
Requiere Python 3.11 o superior. Consulta Instalación a continuación para la ruta de npx / agent-sandbox.
Tabla de contenidos
- Instalación
- Inicio rápido
- Referencia de CLI
- Características
- Cómo funciona
- Benchmark de tiempo de configuración frente a herramientas comparables
- Por qué existe OwnVoice
- Lo que OwnVoice no es
- Consentimiento y uso indebido
- Estado de implementación
- Preguntas frecuentes
- Contribuciones
- Licencia
Instalación
pip install ownvoice-cli
Entornos npx / agent-native: OwnVoice es una CLI de Python/PyTorch, por lo que el paquete npm es un envoltorio fino, no una reimplementación en Node. Arranca en la CLI real a través de uv o pipx, el que ya esté en PATH, útil para sandboxes de agentes de codificación y runners de CI que usan por defecto un toolchain de Node. El paquete npm se renombró a ownvoice-cli (antes el antiguo ownvoice, ahora obsoleto) para coincidir con su contraparte en PyPI.
npx ownvoice-cli check
Tanto el envoltorio npm como el paquete PyPI (ownvoice-cli) están activos, por lo que el comando anterior funciona hoy.
Torch y CUDA: ownvoice check no necesita GPU en absoluto y funciona en CPU, coincidiendo con el diseño de pocket-tts que también es compatible con CPU. Entrenar un adaptador real es mucho más rápido en una GPU NVIDIA. Si tienes una, instala primero la versión CUDA de PyTorch siguiendo pytorch.org/get-started/locally, y luego instala OwnVoice encima, para que pip no descargue silenciosamente la rueda solo-CPU. En Apple Silicon o en una máquina solo-CPU, el pip install por defecto de torch es suficiente: ownvoice check y ownvoice infer funcionan con normalidad, ownvoice train solo tarda más por época.
Inicio rápido
1. ownvoice check, la validación gratuita del día cero
Antes de grabar nada o alquilar una GPU, confirma que la inyección LoRA de PEFT funciona realmente contra la estructura real del modelo de pocket-tts. Esto es totalmente gratuito: solo CPU, sin entrenamiento, sin GPU.
$ ownvoice check
[ownvoice check] PASS: PEFT LoRA injection succeeded against pocket-tts's flow_lm module (target_modules="all-linear").
Si falla, OwnVoice imprime el árbol de módulos real del modelo en lugar de un stack trace crudo, para que puedas ver exactamente qué no coincidió y reportarlo con precisión:
$ ownvoice check
[ownvoice check] FAIL: PEFT LoRA injection failed against pocket-tts's flow_lm module structure: <error detail>. Please post an honest blocker (this error plus the module tree above) as a comment on https://github.com/kyutai-labs/pocket-tts/issues/30 rather than working around it silently, that issue is exactly where this gap needs to be visible.

Module tree (for debugging / for the issue #30 blocker post):
<root>: FlowLMModel
input_linear: Linear
transformer: StreamingTransformer
transformer.layers.0.self_attn.in_proj: Linear
transformer.layers.0.self_attn.out_proj: Linear
...
2. ownvoice train
Graba de 5 a 10 minutos de audio limpio de la voz que quieres entrenar (tu propia voz, con tu propio consentimiento, consulta Consentimiento y uso indebido), dividido en unos pocos clips .wav en un directorio, y luego apunta OwnVoice a ese directorio:
$ ownvoice train --voice-clips ./my-voice-clips
[ownvoice train] USABLE ADAPTER
Usable adapter (similarity 0.812 >= 0.75). Try it now:
  ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "This is my own voice, trained with OwnVoice."
Solo --voice-clips es obligatorio. Todos los demás flags tienen un valor por defecto razonable (consulta la Referencia de CLI completa a continuación).
Una ejecución que termina pero no supera el umbral de similitud aún sale con 0. Es un resultado etiquetado con un siguiente paso concreto, no un fallo:
$ ownvoice train --voice-clips ./my-voice-clips
[ownvoice train] BELOW THRESHOLD
Below threshold (similarity 0.612 < 0.75). The adapter was still saved, try more/cleaner voice clips, more epochs, or a higher --lora-rank, then re-run. You can still listen to it:
  ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "This is my own voice, trained with OwnVoice."
Solo un problema de carga de datos (sin clips utilizables) o un fallo capturado de inyección PEFT sale con código distinto de cero. Una ejecución terminada siempre escribe adapter.safetensors y metadata.json (configuración de entrenamiento, puntuación de similitud, una marca de tiempo) en el directorio de salida: dos archivos que conservas, sin necesidad de ida y vuelta al servidor para volver a usarlos.
3. ownvoice infer
$ ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "Hello, this is my own voice."
[ownvoice infer] Wrote ownvoice-output.wav
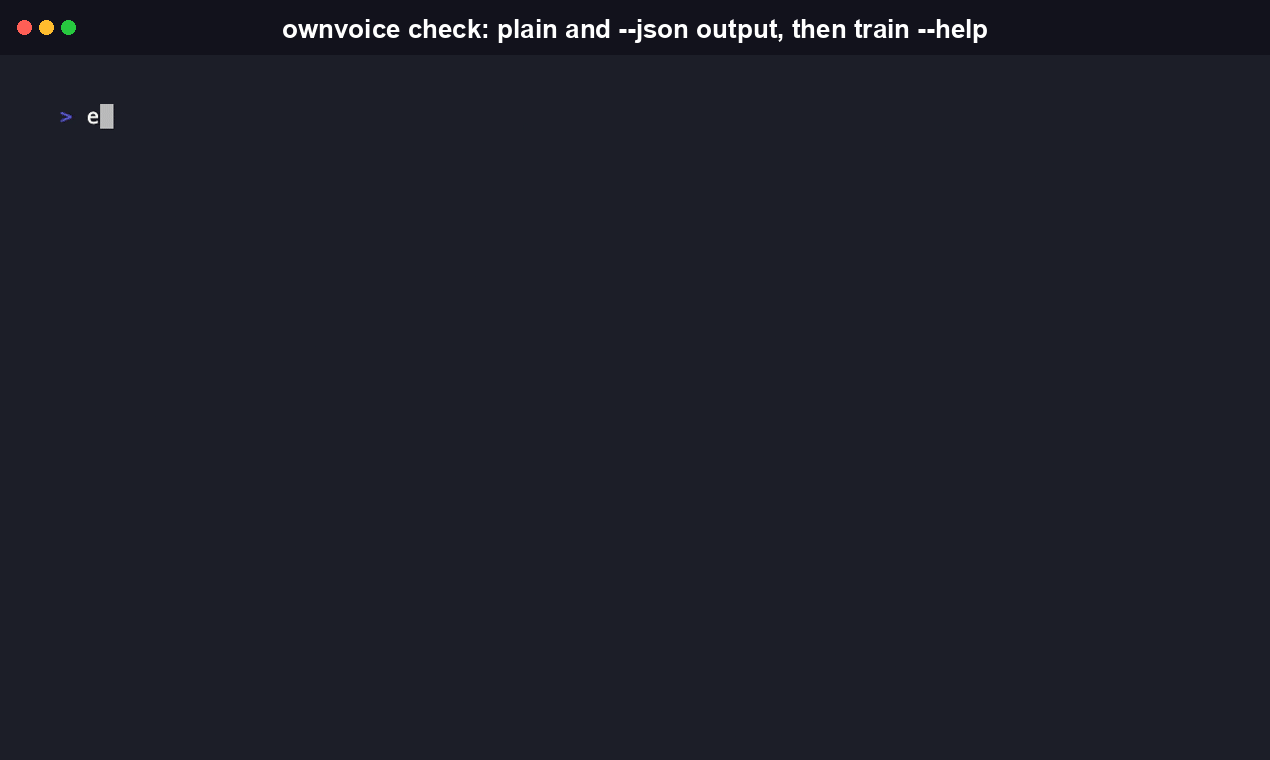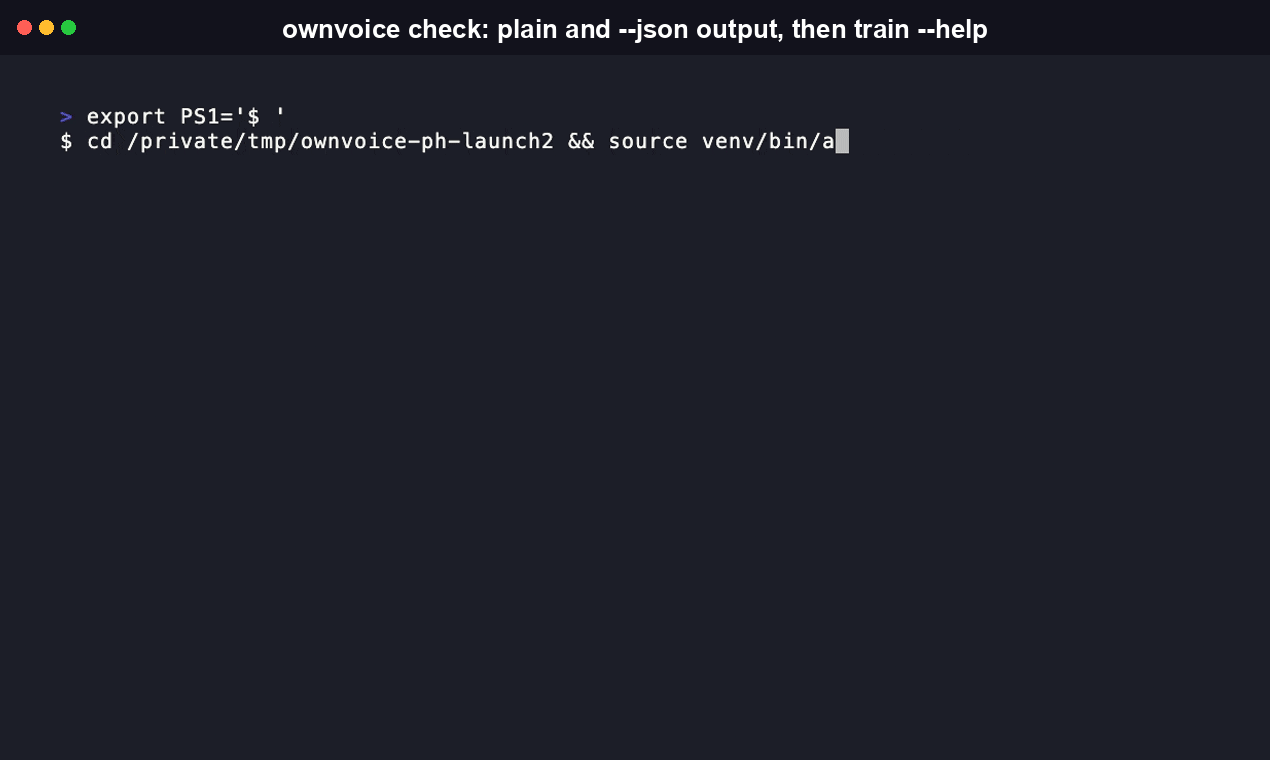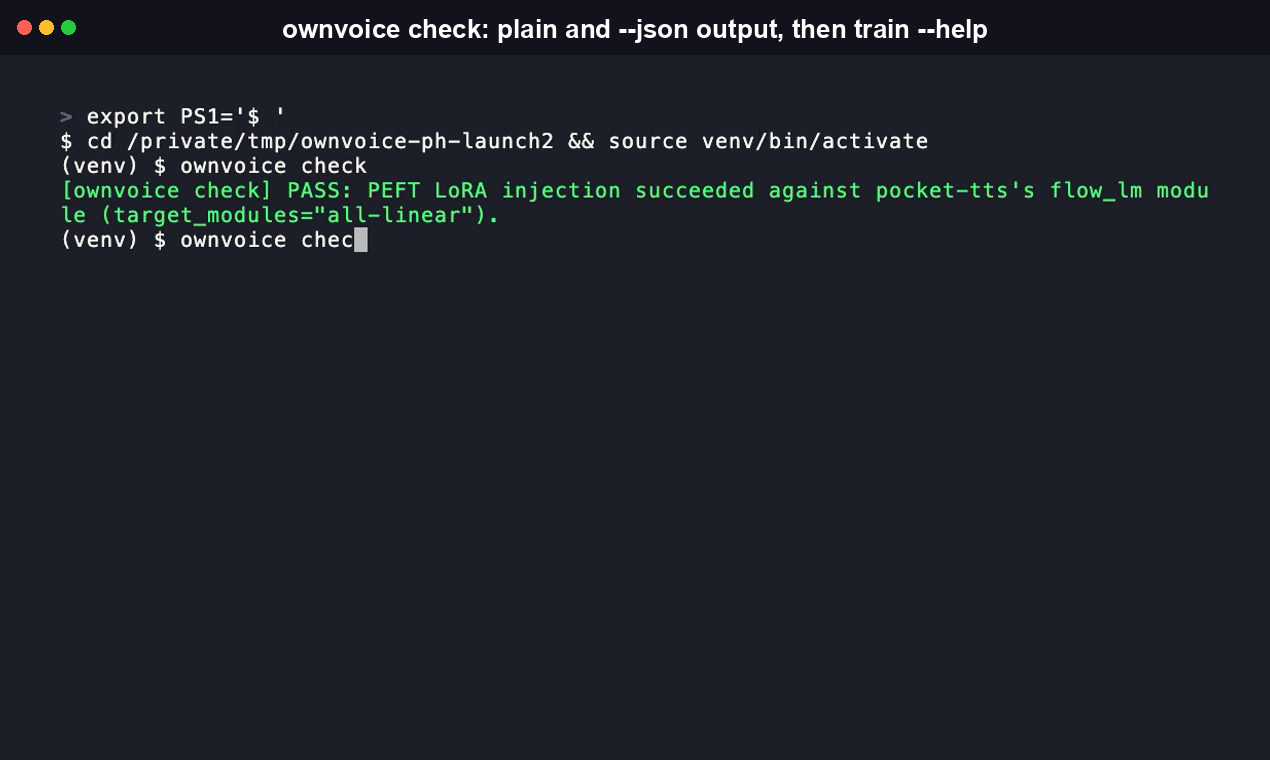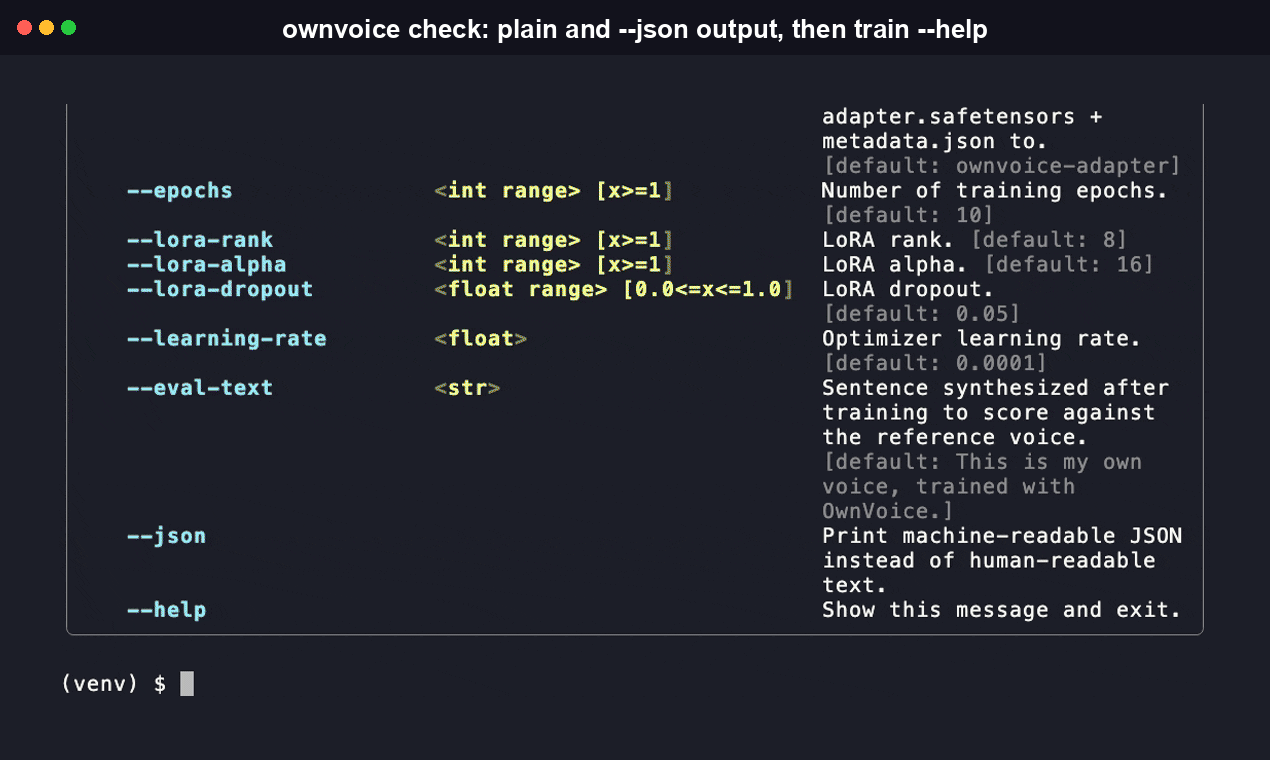
Cada subcomando también admite --json para un modo de salida estructurado y analizable por máquina, útil si un script o un agente llama a ownvoice programáticamente en lugar de que una persona lea la terminal:
$ ownvoice check --json
{"success": true, "message": "PEFT LoRA injection succeeded against pocket-tts's flow_lm module (target_modules=\"all-linear\").", "module_tree": null}
Referencia de CLI
La referencia a continuación se toma directamente de la salida real de --help de cada subcomando (ownvoice-cli 0.1.2 en PyPI).
Global
ownvoice [OPTIONS] COMMAND [ARGS]...
| Flag | Descripción |
|---|---|
--version | Imprime la versión de OwnVoice y sale. |
--help | Muestra el mensaje de ayuda y sale. |
ownvoice check
Comprobación de compatibilidad gratuita y solo-CPU: carga pocket-tts y haz una prueba en seco de la inyección LoRA. No requiere GPU ni entrenamiento.
| Flag | Descripción |
|---|---|
--json | Imprime JSON legible por máquina en lugar de texto legible por humanos. |
--help | Muestra el mensaje de ayuda y sale. |
ownvoice train
Entrena un adaptador de voz LoRA a partir de un directorio de clips de voz .wav. Solo --voice-clips es obligatorio.
| Flag | Tipo | Por defecto | Descripción |
|---|---|---|---|
--voice-clips | directorio, obligatorio | – | Directorio de grabaciones de clips de voz .wav para entrenar. |
--out | ruta | ownvoice-adapter | Directorio donde escribir adapter.safetensors + metadata.json. |
--epochs | int, >=1 | 10 | Número de épocas de entrenamiento. |
--lora-rank | int, >=1 | 8 | Rango LoRA. |
--lora-alpha | int, >=1 | 16 | Alpha LoRA. |
--lora-dropout | float, 0.0–1.0 | 0.05 | Dropout LoRA. |
--learning-rate | float | 0.0001 | Tasa de aprendizaje del optimizador. |
--eval-text | string | "This is my own voice, trained with OwnVoice." | Frase sintetizada tras el entrenamiento para puntuar contra la voz de referencia. |
--json | flag | off | Imprime JSON legible por máquina en lugar de texto legible por humanos. |
--help | flag | – | Muestra el mensaje de ayuda y sale. |
ownvoice infer
Genera voz con la voz entrenada a partir de un adaptador guardado, y guárdala en un archivo .wav.
| Flag | Tipo | Por defecto | Descripción |
|---|---|---|---|
--adapter | ruta, obligatorio | – | Ruta a un archivo adapter.safetensors entrenado. |
--text | string, obligatorio | – | Texto a sintetizar con la voz entrenada. |
--out | ruta | ownvoice-output.wav | Ruta del archivo .wav de salida. |
--reference-audio | ruta | referencia grabada | Sobrescribe el clip de referencia que OwnVoice grabó en metadata.json durante el entrenamiento. |
--json | flag | off | Imprime JSON legible por máquina en lugar de texto legible por humanos. |
--help | flag | – | Muestra el mensaje de ayuda y sale. |
Características
- Una comprobación de compatibilidad gratuita antes de gastar nada en una GPU.
ownvoice checkcarga pocket-tts y hace una prueba en seco de la inyección LoRA de PEFT contra su árbol de módulosflow_lmreal, solo CPU, sin entrenamiento. En caso de fallo imprime el árbol de módulos real en lugar de un stack trace, para que un bloqueo real sea reportable en lugar de silencioso. - Una señal objetiva de usable/no usable, no una suposición. Cada ejecución de entrenamiento remuestrea la frase de prueba generada a 16 kHz mono y la puntúa contra tus clips de referencia con similitud coseno de Resemblyzer.
0.75o superior se etiqueta comoUSABLE ADAPTER; cualquier valor inferior esBELOW THRESHOLD, un resultado etiquetado y no un fallo, código de salida0en ambos casos. - Salida estructurada en cada subcomando.
check,trainyinferaceptan todos--json, devolviendo un objeto analizable por máquina en lugar de texto de terminal coloreado: confirmado directamente,ownvoice check --jsondevuelve{"success": true, "message": "...", "module_tree": null}. - Dos archivos que conservas, sin ida y vuelta al servidor. Una ejecución de entrenamiento terminada escribe
adapter.safetensors(los pesos entrenados, unos pocos megabytes con el--lora-rank 8por defecto) ymetadata.json(la configuración completa de entrenamiento, puntuación de similitud, pérdida por época y una marca de tiempo) en disco. Cárgalos de nuevo en cualquier momento conownvoice infer, sin necesidad de llamada de red. - Un solo modelo base, a propósito. OwnVoice envuelve únicamente a pocket-tts. No hay capa de abstracción para un segundo modelo base, coincidiendo con la nota de arquitectura de objetivo único por diseño del propio código: la ruta de inyección LoRA (
target_modules="all-linear"contra las capasflow_lmreales de pocket-tts) se mantiene exacta en lugar de genérica.
Cómo funciona
voice clips (wav)
      |
      v
  data.py   --validate format/duration-->  clean clip set
      |
      v
  train.py  --PEFT LoRA (target_modules="all-linear")--> adapter.safetensors + metadata.json
      |
      v
  infer.py  --generate test utterance--> synthesized audio
      |
      v
  score.py  --resample to 16kHz mono--> Resemblyzer cosine similarity
      |
      v
  CLI report (>= 0.75 = usable adapter, below triggers a labeled next-step message)
ownvoice/data.py carga y valida el directorio de clips de voz. ownvoice/train.py carga el modelo base congelado de pocket-tts, inyecta un adaptador LoRA en su transformer flow_lm con PEFT (target_modules="all-linear"), ejecuta el bucle de entrenamiento y guarda el adaptador junto con un manifiesto. ownvoice/infer.py carga un adaptador guardado de nuevo sobre el modelo base y genera voz. ownvoice/score.py remuestrea el audio a 16 kHz mono con torchaudio.transforms.Resample y puntúa la similitud del hablante con Resemblyzer.
OwnVoice es intencionadamente de un solo modelo: envuelve únicamente a pocket-tts, sin capa de abstracción para un segundo modelo base, ya que ninguno está en el alcance.
Benchmark de tiempo de configuración frente a herramientas comparables
| Herramienta | Tiempo hasta la primera configuración funcional | Decisión de diseño destacada | Fuente |
|---|---|---|---|
| kokoro-tts | menos de 2 minutos | pip install git+..., síntesis CLI instantánea, sin fine-tuning | README de kokoro-tts |
| Unsloth | menos de 1 minuto para iniciar una ejecución | inicio de entrenamiento con un solo comando (uv pip install) | docs de Unsloth |
| pocket-tts | segundos | --voice <wav> clonación zero-shot, sin entrenamiento disponible | README de pocket-tts |
| OwnVoice | menos de 2 minutos hasta un entorno de entrenamiento confirmado | ownvoice check: validación gratuita, instantánea y solo-CPU de compatibilidad PEFT antes de gastar nada en una GPU | este repo |
La propia ejecución de entrenamiento de OwnVoice es tiempo real de GPU, etiquetado honestamente y no oculto tras una barra de progreso falsa, la misma norma de categoría que usa Unsloth. Lo que OwnVoice comprime a menos de dos minutos es todo lo anterior a eso: confirmar que tu entorno realmente funciona.
Por qué existe OwnVoice
pocket-tts es un modelo local de texto a voz genuinamente bueno, con licencia MIT y compatible con CPU, de Kyutai. Sus propios mantenedores han dejado claro que el código de fine-tuning no llegará pronto: en issue #30, el mantenedor @vvolhejn escribió "No planeamos publicar código de fine-tuning para nuestros modelos TTS y STT en un futuro cercano", y 18 personas reaccionaron a ese hilo pidiendo exactamente esto. OwnVoice es una CLI pequeña e independiente que llena ese vacío específico: apúntala a un puñado de tus propias grabaciones de voz, y entrena un adaptador LoRA que conservas y ejecutas tú mismo.
No es un servicio alojado, no tiene facturación y no rastrea el uso. Es un script de entrenamiento, un script de inferencia y un script de puntuación, conectados detrás de tres comandos de CLI.
Lo que OwnVoice no es
pocket-tts ya incluye clonación de voz zero-shot de serie: pasa un archivo .wav a --voice (o llama a get_state_for_audio_prompt() desde Python) y clona esa voz sin ningún paso de entrenamiento. Si eso es todo lo que necesitas, usa pocket-tts directamente, es más simple y rápido.
OwnVoice existe para un caso más específico: integrar una voz permanentemente en pesos entrenados, de modo que la generación ya no dependa de distribuir o reprocesar un clip de audio de referencia en tiempo de ejecución, con (basado en el objetivo de entrenamiento, aún no evaluado de forma independiente a escala) una salida más consistente en muchas generaciones de lo que tiende a producir un embedding zero-shot de un solo clip. Ese es el vacío específico que describían los 18 que reaccionaron en el issue #30, y es lo único que OwnVoice añade sobre lo que pocket-tts ya hace bien.
Consentimiento y uso indebido
Esta herramienta clona una voz a partir de audio que tienes derecho a usar. No clones la voz de otra persona, ni la de una figura pública, sin su consentimiento explícito. OwnVoice no incluye ninguna función de generación masiva ni autoescalado en esta versión, manteniendo pequeño el radio de impacto de cualquier caso de uso indebido.
Estado de implementación
Esta es una versión joven, en etapa temprana. ownvoice check, el análisis de argumentos de CLI, la validación de clips de voz, el cálculo de similitud y la ruta de guardado/carga de adaptadores y manifiestos están implementados y cubiertos por la suite de pruebas (pytest). La inyección de LoRA se verificó estructuralmente contra el código fuente real de pocket-tts y luego se confirmó de verdad: ownvoice check se ejecutó contra los pesos reales descargados de pocket-tts, en CPU, y la inyección de target_modules="all-linear" de PEFT realmente funcionó. La ruta completa de entrenamiento y generación se ha verificado de extremo a extremo de verdad también: una ejecución real de entrenamiento LoRA de 2 épocas contra los pesos cargados de pocket-tts produjo una pérdida de flujo-matching finita y no NaN, y el adaptador resultante produjo un archivo .wav generado real y no silencioso mediante ownvoice infer. Esa validación reveló dos brechas reales en el enfoque ingenuo y las corrigió: (1) el paquete PyPI publicado de pocket-tts, solo para inferencia, no expone realmente una forma de calcular la pérdida de entrenamiento a través de FlowLMModel.forward() a pesar de que su propio docstring lo afirma, por lo que OwnVoice calcula la pérdida de flujo-matching directamente desde los submódulos reales de flow_lm; (2) intercambiar base_model.flow_lm por el modelo envuelto con PEFT antes de llamar a generate_audio() rompe la búsqueda interna del estado de caché KV de pocket-tts — no se necesita ningún intercambio, ya que la inyección LoRA de PEFT ya muta base_model.flow_lm en su lugar. Una limitación externa real a tener en cuenta: los pesos de pocket-tts descargables públicamente (kyutai/pocket-tts-without-voice-cloning) rechazan una ruta/URL de clip de referencia cruda directamente; OwnVoice lo soluciona precargando y remuestreando el clip por sí mismo, pero la fidelidad de clonación de voz de ese checkpoint es una limitación conocida del modelo base, no un error de OwnVoice — para los pesos de clonación de mejor calidad de kyutai, solicita acceso restringido en huggingface.co/kyutai/pocket-tts. Ejecuta ownvoice check tú mismo y lee el código fuente antes de confiar más en ello; ese es el nivel correcto de escepticismo para un proyecto tan temprano.
Preguntas frecuentes
¿Qué es OwnVoice y por qué no usar solo pocket-tts?
OwnVoice entrena un adaptador LoRA para pocket-tts y lo guarda en tu propio disco como adapter.safetensors más metadata.json. Existe porque los propios mantenedores de pocket-tts han dicho que el código de ajuste fino no está en su hoja de ruta a corto plazo (ver issue #30). Una vez que tienes un adaptador entrenado, nunca más necesitas OwnVoice para usarlo: ownvoice infer simplemente carga el adaptador de vuelta al modelo base.
¿En qué se diferencia esto del clonado zero-shot integrado de pocket-tts, --voice <wav>?
pocket-tts ya clona una voz a partir de un solo clip de referencia sin paso de entrenamiento, --voice <wav> en la CLI o get_state_for_audio_prompt() en Python. OwnVoice intercambia esa velocidad por un adaptador entrenado permanentemente, de modo que la generación ya no depende de llevar un clip de referencia en tiempo de ejecución, con (según el objetivo de entrenamiento, aún no evaluado de forma independiente a escala) una salida más consistente entre generaciones repetidas que la que suele dar una incrustación zero-shot de un solo clip. Si el zero-shot es suficiente para tu caso de uso, usa pocket-tts directamente; es más simple y rápido.
¿Qué necesito para instalarlo y funciona en Apple Silicon o en una máquina solo con CPU?
Python 3.11 o más reciente, luego pip install ownvoice-cli. ownvoice check y ownvoice infer no necesitan GPU en absoluto y funcionan bien en Apple Silicon o en una máquina solo con CPU, coincidiendo con el diseño de pocket-tts que también es capaz de funcionar en CPU. ownvoice train también funciona en CPU, solo tarda más por época; instala la compilación CUDA de PyTorch primero si tienes una GPU NVIDIA y quieres que el entrenamiento vaya más rápido.
¿Cómo se compara OwnVoice con kokoro-tts y Unsloth?
kokoro-tts te permite sintetizar voz en menos de 2 minutos, pero no tiene ningún paso de ajuste fino. Unsloth inicia una ejecución de entrenamiento en menos de un minuto, pero es un marco general de ajuste fino de LLM, no específico de TTS. OwnVoice es más limitado que ambos: un modelo base (solo pocket-tts), un trabajo (un adaptador de voz), más un paso gratuito de ownvoice check que confirma que la inyección LoRA de PEFT realmente funciona en tu entorno antes de gastar algo en una GPU, una verificación que ninguna de esas herramientas tiene equivalente.
Mi ejecución de entrenamiento terminó pero imprimió "BELOW THRESHOLD", ¿es un error?
No. Es un resultado etiquetado, no un fallo; ownvoice train sale con 0 de cualquier manera. Por debajo del umbral de similitud coseno de 0.75, el adaptador aún se guarda en disco y OwnVoice te dice claramente que pruebes con más clips de voz o más limpios, más épocas o un --lora-rank más alto, y luego vuelvas a ejecutar. Solo dos cosas hacen fallar el comando con un código de salida distinto de cero: no hay clips utilizables para cargar, o un fallo de inyección PEFT capturado.
¿Puedo usar OwnVoice y los adaptadores que produce comercialmente?
El código propio de OwnVoice es MIT (ver LICENSE). El paquete de código de pocket-tts también es MIT, pero los pesos del modelo que OwnVoice realmente descarga y entrena, kyutai/pocket-tts-without-voice-cloning y el restringido kyutai/pocket-tts, están licenciados bajo CC-BY-4.0, no MIT. CC-BY-4.0 permite uso comercial pero requiere atribución a Kyutai. Dado que cualquier adaptador que entrenes se deriva de esos pesos, verifica ese requisito de atribución antes de lanzar un producto comercial basado en él.
¿De quién puedo clonar la voz realmente con esto? Solo de ti mismo, o de otra persona con su consentimiento explícito y verificado, nunca de la voz de una figura pública sin él. Ver Consentimiento y mal uso arriba. OwnVoice no incluye ninguna función de generación masiva o autoescalado en esta versión, lo que mantiene pequeño el radio de impacto de cualquier caso de mal uso individual.
Servidor MCP
OwnVoice incluye un servidor de Protocolo de Contexto de Modelo, de modo que un agente compatible con MCP puede manejar ownvoice check / train / infer directamente a través de stdio en lugar de ejecutar comandos externos y analizar texto por sí mismo.
pip install "ownvoice-cli[mcp]"
Agrégalo a la configuración de un cliente MCP (por ejemplo, el claude_desktop_config.json de Claude Desktop):
{
  "mcpServers": {
    "ownvoice": {
      "command": "ownvoice-mcp"
    }
  }
}
El servidor expone una única herramienta, run(args: list[str]) -> dict, que ejecuta la CLI real de ownvoice con los argv dados y devuelve su resultado como JSON estructurado, de modo que el llamador obtiene exactamente el mismo comportamiento que la CLI orientada a humanos, incluido el modo --json. Ejemplo de llamada: run(args=["check", "--json"]) devuelve {"result": {"success": true, "message": "...", "module_tree": null}}. Una salida distinta de cero, un fallo de lanzamiento o un tiempo de espera del subproceso siempre se devuelven como {"error": "..."} en lugar de lanzarse.
Contribuciones
Las incidencias y las solicitudes de extracción son bienvenidas, todo con licencia MIT. Si quieres ayudar a cerrar la brecha real que este proyecto aborda, la contribución más útil es ascendente: un script de entrenamiento de adaptador LoRA ligero que se devuelva a kyutai-labs/pocket-tts mismo, discutido en issue #30.
Licencia
MIT. Ver LICENSE.