cogvault
Memoria local para agentes de IA sobre archivos Markdown simples: recuperación híbrida vectorial + BM25 (RRF), una memoria aislada por directorio de agente, totalmente offline sin LLM en el bucle.
Documentación




Comenzar · Por qué · Comparación · Cómo funciona · Benchmark · Instalación · Inicio rápido · MCP · Fleets
Comienza en 30 segundos
Plugin de Claude Code — servidor MCP más una skill que le indica al agente cuándo recordar y cuándo guardar:
/plugin install cogvault --marketplace NBibikov/cogvault
Claude Code anterior a 2.1.275: /plugin marketplace add NBibikov/cogvault, luego
/plugin install cogvault@cogvault.
La memoria vive en ~/.cogvault/memory (configura COGVAULT_TENANT para cambiarlo). El plugin
añade /cogvault:remember.
Cualquier cliente MCP, en una línea (requiere uv):
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
Claude Desktop, Cursor, Windsurf, Cline — configuración JSON
Añade a claude_desktop_config.json, ~/.cursor/mcp.json, o la configuración MCP de tu cliente:
{
  "mcpServers": {
    "cogvault": {
      "command": "uvx",
      "args": ["cogvault", "mcp", "--tenant", "~/agent/memory"]
    }
  }
}
¿Ya tienes memoria en Markdown? Apunta el tenant hacia ella — no hay nada que importar. La
memoria automática de Claude Code funciona tal cual (frontmatter type, [[links]] y todo):
M=~/.claude/projects/<project>/memory
uvx cogvault index  --tenant $M --ignore MEMORY.md   # first pass embeds, later passes are incremental
uvx cogvault search --tenant $M "how do we deploy"
El servidor MCP indexa por sí mismo al iniciar; el CLI search lee el índice existente.
--ignore MEMORY.md evita que el archivo de índice compita con las tarjetas a las que apunta.
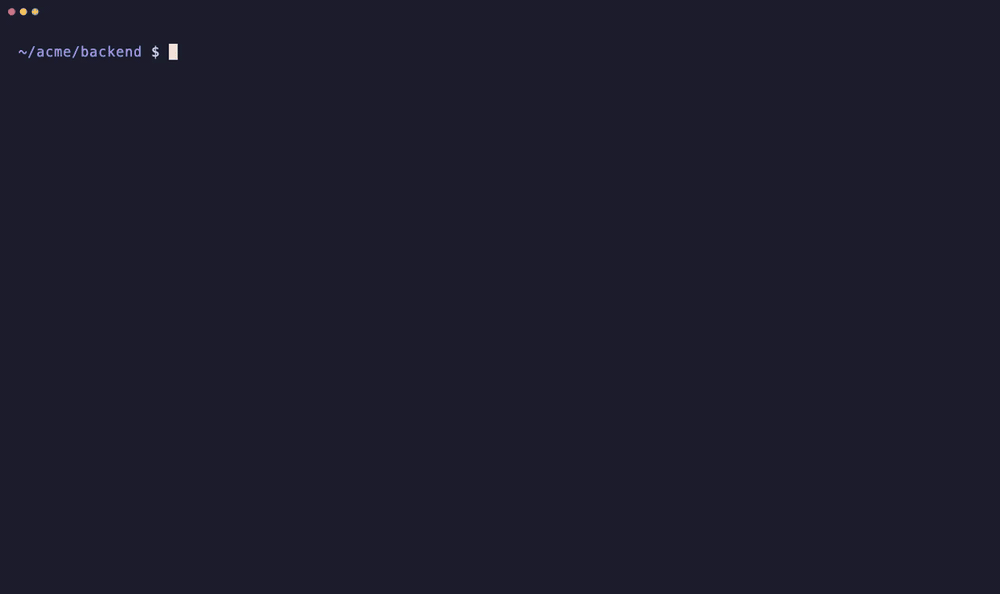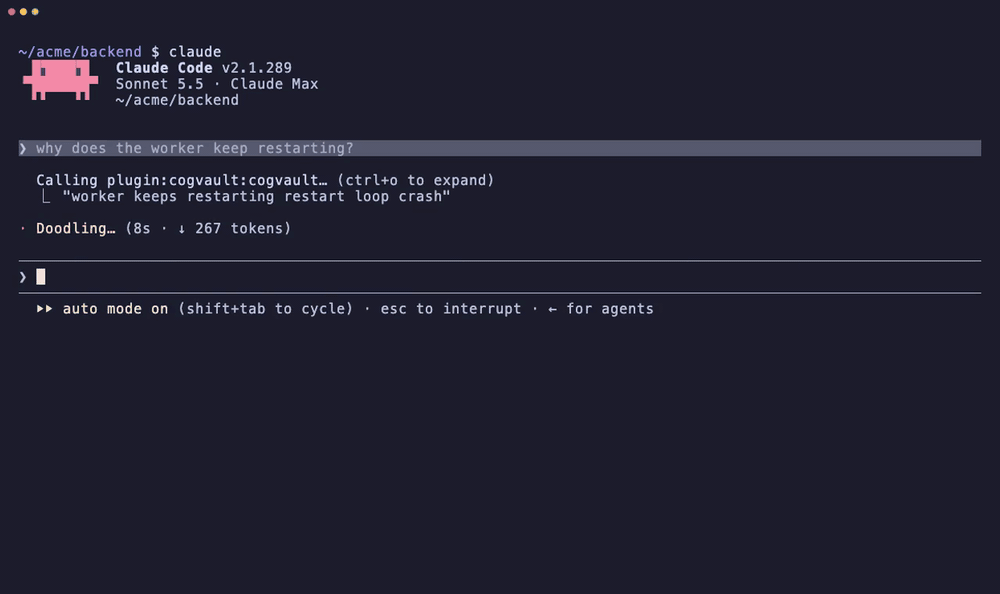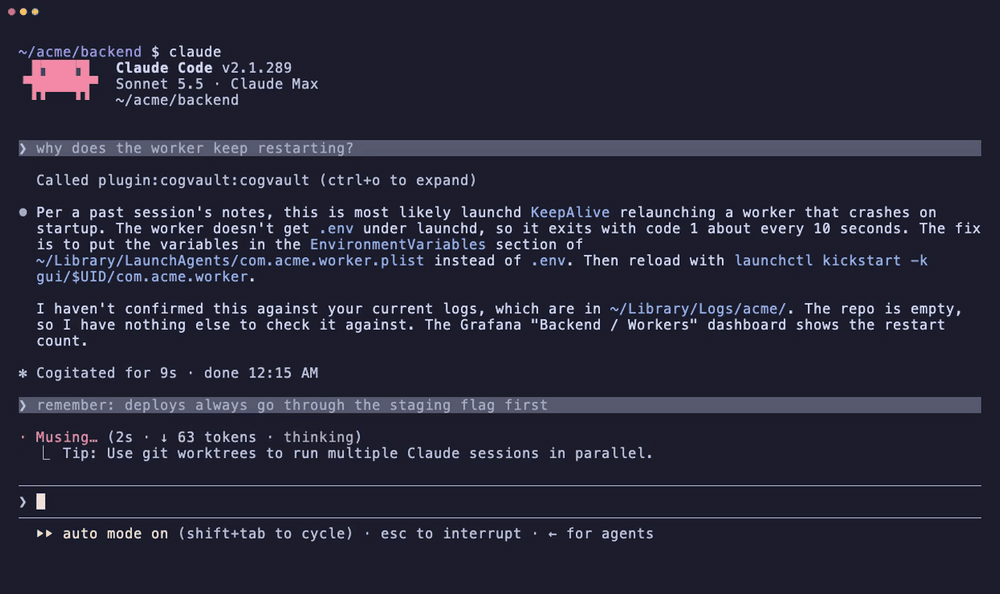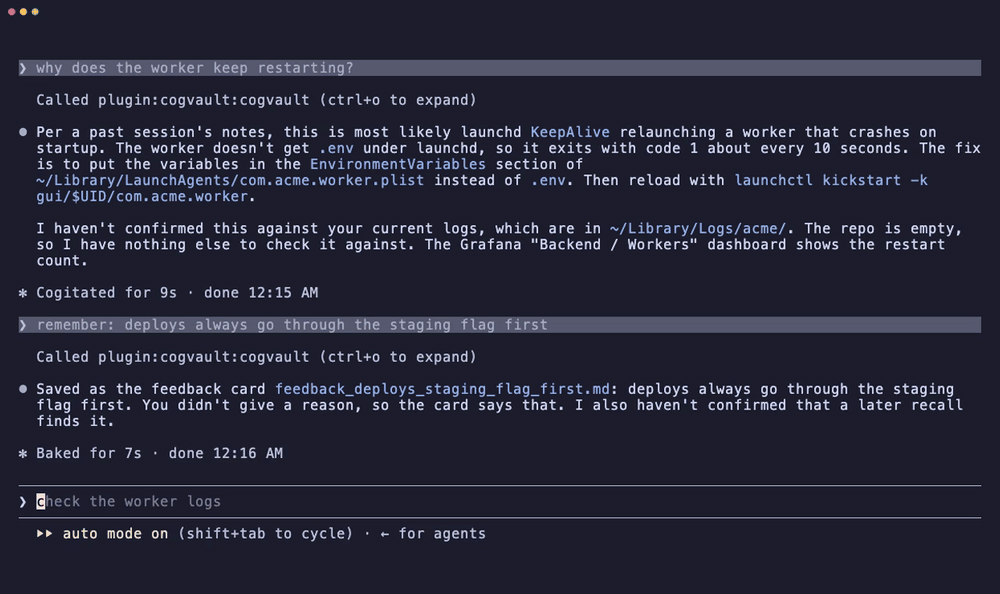
Respuestas sin editar de una sesión real (Sonnet, plugin instalado, una memoria demo de seis tarjetas); solo se recortó el tiempo de espera.
Por qué
La mayoría de las herramientas de "memoria para agentes de IA" quieren ser un daemon LLM autónomo que resume tu trabajo en una base de datos opaca o un grafo que no puedes leer. Para una flota de agentes de código que solo necesitan recordar de forma fiable una decisión, una corrección de bug o un detalle de infraestructura, ese es el intercambio equivocado.
cogvault apuesta por lo contrario:
- Tus archivos Markdown son la fuente de verdad. Ábrelos, edítalos,
git diffellos. El índice SQLite es una caché derivada — bórralo y se reconstruye desde los archivos. - Una biblioteca, muchos tenants. Cada agente obtiene un espacio de memoria aislado mediante su propio directorio. Un proceso carga cada modelo de embeddings una vez y lo comparte entre todos los tenants que toca; con el servidor MCP stdio eso significa un proceso pequeño por sesión de agente, no un daemon central.
- Sin LLM en el bucle. La ingesta y la recuperación son deterministas. Tu agente es el LLM — no necesita un segundo para recordar.
- Local, privado, sin conexión. FastEmbed se ejecuta en el dispositivo. Nada sale de tu máquina.
Comparado con
Verificado contra el README y la documentación de cada proyecto el 2026-10-05.
| cogvault | basic-memory | mem0 | Graphiti | Letta Code | |
|---|---|---|---|---|---|
| Fuente de verdad | Archivos Markdown | Archivos Markdown | Base de datos vectorial (Qdrant / pgvector) | Base de datos de grafos (Neo4j, FalkorDB, …) | Markdown en un repo git por agente |
| LLM necesario para guardar o recordar | No | No (reranker opcional) | Sí por defecto (add() extrae hechos) | Sí para ingesta | Sí — el agente edita su memoria |
| Recuperación | Vectorial + BM25, RRF, decaimiento, MMR | Texto completo + vectorial, rerank opcional | Semántica + BM25 + entidades | Semántica + BM25 + grafo | Búsqueda de archivos; híbrido opcional |
| Infraestructura | Un proceso, archivo SQLite | Un proceso, SQLite (Postgres opcional) | Biblioteca, o Docker + servidor Postgres | Una base de datos de grafos | Backend de Letta |
Elige otra cosa cuando: quieras que un LLM destile y fusione hechos por ti (mem0), las relaciones entre entidades sean el punto (Graphiti), quieras que el agente gestione su propia memoria (Letta), o quieras una app de notas más rica alrededor de la misma idea de Markdown, con sincronización con Obsidian y una opción alojada (basic-memory — la más cercana a cogvault).
Elige cogvault cuando: ejecutes varios agentes y quieras que la memoria de cada uno esté aislada en su
propio directorio detrás de un solo proceso; quieras que la recuperación sea determinista y sin conexión; y
quieras medirla — cogvault eval puntúa la recuperación sobre las consultas reales de tus agentes y
cogvault analyze lista lo que intentaron recordar y no pudieron.
Cómo funciona

Anatomía de una recuperación

La recuperación híbrida fusiona la clasificación semántica (vectorial) y por palabras clave (BM25/FTS5) con Fusión de Rango Recíproco, luego aplica decaimiento temporal opcional (la memoria reciente supera a la obsoleta) y MMR (resultados diversos en la parte superior, no cinco casi duplicados). Cada tarjeta contribuye solo con su mejor fragmento, así un archivo largo no puede llenar toda la lista de resultados.
Benchmark

Medido sobre tráfico de recuperación real, no preguntas sintéticas: 66 consultas muestreadas de los
registros de consultas de 6 tenants de agentes en vivo (58% ucraniano, el resto inglés), cada una juzgada contra
las tarjetas reales — incluyendo respuestas que ninguna configuración devolvió. Una consulta no tiene
respuesta en la memoria y cuenta como una brecha, así que 65 se puntúan. Cada configuración se re-indexó
desde cero sobre copias de los mismos tenants con cogvault 0.11.0.
| Configuración | hit@1 | hit@5 | MRR@10 |
|---|---|---|---|
multilingual-e5-small, chunk_chars = 700, fragmento de resumen | 0.57 | 0.91 | 0.70 |
multilingual-e5-small, chunk_chars = 700, sin fragmento de resumen | 0.55 | 0.86 | 0.69 |
paraphrase-multilingual-MiniLM-L12-v2 (predeterminado integrado) | 0.54 | 0.80 | 0.66 |
bge-small-en-v1.5 (solo inglés) | 0.57 | 0.77 | 0.65 |
Lo que los números dicen y no dicen:
- hit@1 es un empate. Los cuatro caen dentro de 0.54–0.57, y los intervalos de bootstrap al 95% se superponen casi por completo. Las consultas reales de agentes se leen como títulos de tarjetas, así que la tarjeta correcta suele ganar solo por su nombre.
- La brecha está en el top 5. e5-small con el fragmento de resumen pone la respuesta en el top 5 para el 91% de las consultas frente al 80% del MiniLM predeterminado y el 77% del bge solo inglés en esta memoria de idioma mixto. Eso es lo que un agente que lee 5 resultados realmente siente.
- 65 consultas siguen siendo una muestra pequeña. Trata las diferencias por debajo de ~0.1 como ruido. Los
números agregados están en
assets/benchmark.json; las consultas son privadas y permanecen en cada tenant.
Reranking
Un cross-encoder lee la consulta y cada tarjeta candidata juntas, así que puede decir qué
tarjeta responde la pregunta, no solo cuál trata sobre el mismo tema. Con
rerank = "BAAI/bge-reranker-v2-m3-int8", cogvault puntúa el top 10 híbrido por los primeros
800 caracteres de cada archivo de tarjeta y los reordena. Sobre las mismas 65 consultas
(cogvault 0.12.0, e5-small + fragmento de resumen):
| hit@1 | hit@5 | MRR@10 | |
|---|---|---|---|
| solo híbrido | 0.60 | 0.88 | 0.70 |
| híbrido + reranker | 0.80 | 0.91 | 0.85 |
El reranker mejoró 17 consultas y empeoró 3. El intervalo de bootstrap al 95% de la ganancia en hit@1
es +0.09 a +0.34. El costo es ~2 GB de RAM y 1–2 s por recuperación en una CPU Apple M-series,
así que se ejecuta solo en el daemon compartido y en cogvault eval
(--no-rerank puntúa sin él).
Ejecuta la misma verificación en tu propia memoria: pon consultas juzgadas en
<tenant>/.cogvault-golden.jsonl ({"query": "...", "relevant": ["file.md"]}, vacío
relevant = una brecha conocida) y ejecuta cogvault eval --tenant DIR.
Elegir un modelo de embeddings
La memoria de agentes a menudo no es solo inglés. El predeterminado es multilingüe para que nada
se rompa de fábrica — pero elige el modelo que coincida con la mezcla de idiomas de tu flota
(configura COGVAULT_MODEL, o Config(model=...)). Cambiar de modelo reconstruye el índice automáticamente.
Modelo (COGVAULT_MODEL) | Dim | Tamaño | hit@5 en consultas reales* | Cirílico / multilingüe | Cuándo |
|---|---|---|---|---|---|
paraphrase-multilingual-MiniLM-L12-v2 (predeterminado) | 384 | 0.22 GB | 0.80 | ✅ funciona | Flotas de idioma mixto; predeterminado seguro |
BAAI/bge-small-en-v1.5 | 384 | 0.13 GB | 0.77 | ❌ los vectores cirílicos se rompen | Memoria solo inglés |
intfloat/multilingual-e5-small | 384 | 0.47 GB | 0.91 | ✅ mejor por GB (ventana de 512 tokens) | Flotas de idioma mixto; usa chunk_chars = 700 |
intfloat/multilingual-e5-large | 1024 | 2.24 GB | no medido | ✅ mejor | Máxima calidad, RAM de sobra |
*Del benchmark anterior: 65 consultas reales sobre memoria mixta EN/UK,
cogvault 0.11.0. En memoria solo inglés bge-small-en es una buena opción; en contenido ucraniano
devuelve un margen de relevancia negativo (un distractor supera a la respuesta),
así que no es seguro para memoria no inglesa. Ejecuta cogvault eval en tu propio vault para decidir.
COGVAULT_MODEL=BAAI/bge-small-en-v1.5 cogvault index --tenant ~/agent/memory
Fija el modelo por tenant para que viaje con los datos en lugar de depender de que cada
comando exporte COGVAULT_MODEL (olvídalo una vez y un desajuste de modelo re-embediza
silenciosamente todo el índice). Coloca un .cogvault.toml en la raíz del tenant:
# ~/agent/memory/.cogvault.toml
model = "BAAI/bge-small-en-v1.5"
# optional: recursive = true, strip_frontmatter = true, ignore_globs = ["Templates/*"]
Ahora cogvault search --tenant ~/agent/memory "…" usa el modelo correcto sin variable de entorno.
Precedencia: --model / $COGVAULT_MODEL explícito > .cogvault.toml > predeterminado integrado.
Instalación
uv tool install cogvault        # CLI on PATH
# or
pip install cogvault
O salta la instalación y ejecútalo bajo demanda con uvx cogvault …. La primera ejecución descarga
el modelo de embeddings (~0.2–0.5 GB, una vez por máquina).
Añádelo a Claude Code como servidor MCP en una línea:
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
También está listado en el Registro MCP oficial
como io.github.NBibikov/cogvault. Las ruedas están adjuntas a cada
release de GitHub.
Inicio rápido
# index a tenant's markdown memory
cogvault index --tenant ~/agent/memory

# search (hybrid semantic + keyword)
cogvault search --tenant ~/agent/memory "how do I restart the worker service"

# enable temporal decay (recent wins) and tune diversity
cogvault search --tenant ~/agent/memory "deployment steps" --half-life 30 --mmr 0.5

# only cards of one frontmatter type (user / feedback / project / reference / …)
cogvault search --tenant ~/agent/memory "hard rules for deploys" --type feedback
Tarjetas de memoria
cogvault entiende dos convenciones ligeras de Markdown (ambas opcionales — los archivos planos se indexan bien):
- Frontmatter
type— ya sea plano (type: reference) o anidado (metadata:→type: reference). Se analiza en el momento de indexar y es filtrable al buscar (--type, parámetro MCPtype,search(card_type=...)). Cada acierto lleva un campotype; las tarjetas sin frontmatter obtienennull. [[wiki-links]]— los destinos de los enlaces se indexan, y el mejor resultado de búsqueda incluye una listarelatedde tarjetas enlazadas que existen en el índice (los enlaces fantasma se descartan; la coincidencia es por el nombre exacto del archivo sin extensión).
Como servidor MCP (Claude Code, Cursor, cualquier cliente MCP)
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
Expone dos herramientas:
cogvault_recall— búsqueda híbrida en lenguaje natural sobre la memoria de este agente. El parámetro opcionaltypefiltra a un tipo de tarjeta de frontmatter; el mejor resultado incluye una líneaRelated:construida desde su[[wiki-links]].cogvault_record— guarda un hecho; se escribe como una tarjeta Markdown y se indexa
Indexar un árbol de carpetas (vaults de Obsidian, bases de conocimiento)
Por defecto un tenant es un directorio plano de archivos .md. Para un vault anidado
(por ejemplo Obsidian, con 01-Projects/…, frontmatter y carpetas a omitir), opta por:
cogvault index --tenant ~/vault \
  --recursive \
  --strip-frontmatter \
  --ignore ".obsidian/*" --ignore ".trash/*" --ignore "Templates/*"
--recursiverecorre subdirectorios; los archivos mantienen su ruta relativa al tenant, así que dos notas llamadasTasks.mden carpetas diferentes nunca colisionan.--strip-frontmatterelimina un bloque YAML--- … ---inicial para que sus claves no contaminen el embedding.--ignore GLOB(repetible) omite rutas relativas a la raíz del tenant.
Las mismas banderas existen en search y mcp, y como Config(recursive=True, strip_frontmatter=True, ignore_globs=(...)) para la biblioteca. La indexación es
incremental: la primera pasada embediza todo, las pasadas posteriores solo re-embedizan los archivos
cambiados. (Referencia: un vault de ~3,500 notas → ~9,500 fragmentos, primer índice ≈ 3–4 min,
luego recuperación en caliente en milisegundos de un solo dígito.)
Como biblioteca
from cogvault import Vault, Config

vault = Vault("~/agent/memory", Config(half_life_days=30))
vault.reindex()
for hit in vault.search("where are credentials stored"):
    print(hit["score"], hit["file"], hit["snippet"])
Mantener un tenant saludable
cogvault doctor --tenant DIR informa sobre lo que degrada silenciosamente la recuperación: tarjetas sin
frontmatter ni tipo, nombres de archivo con marcas de tiempo heredadas, frontmatter anidado dentro de
frontmatter, slugs duplicados de name: y [[links]] que no resuelven a nada.
Los enlaces se resuelven mediante name: del frontmatter, el nombre base del archivo, cualquiera de los dos estilos de separador, y
con o sin el prefijo de tipo de tarjeta; los enlaces dentro de código y las rutas a archivos fuera
del tenant no se cuentan.
cogvault repair --tenant DIR corrige la parte mecánica (simulación por defecto,
--apply para escribir): desenvuelve frontmatter anidado, infiere un tipo faltante, renombra
card-<timestamp>-….md a <type>_<slug>.md y reescribe cada referencia a él
(incluido MEMORY.md), y añade frontmatter mínimo a las tarjetas <type>_*.md que
carecen de él. Las tarjetas saludables se dejan intactas, y las tarjetas reparadas conservan su mtime para que
la decadencia temporal no se reinicie.
Registro de efectividad
Cada recuperación se registra (una línea JSONL) para que puedas medir si la memoria está
realmente ayudando. cogvault analyze convierte el registro en un informe:
cogvault analyze            # recalls, latency, per-tenant hit distance, weakest hits, card writes
cogvault analyze --json     # machine-readable
cogvault analyze --since 7  # only the last 7 days (or --since 2026-10-05)
La sección que importa es aciertos más débiles: el peor decil de cada tenant por distancia
vectorial — consultas donde la recuperación devolvió algo (la búsqueda híbrida casi siempre lo hace)
pero probablemente no la respuesta. Esa lista es lo que tus agentes intentaron recuperar y no pudieron,
es decir, los vacíos de memoria a llenar. Establece COGVAULT_LOG=off para desactivar, o
COGVAULT_LOG=/path.jsonl para reubicar.
Flotas multi-tenant
Apunta un proceso a muchos tenants — cada directorio es un espacio de nombres aislado, probado por
la suite de pruebas (test_multi_tenant_isolation). El Agente B nunca puede recuperar la memoria del
Agente A a menos que apuntes B al directorio de A.

Daemon compartido
Cada cliente MCP inicia su propio cogvault mcp. Sin un daemon, cada uno de estos procesos
carga el modelo de incrustación (~1 GB), y ninguno puede permitirse el reranker. cogvault daemon
carga cada modelo una vez para todos los tenants y los sirve a través de un socket Unix
(~/.cache/cogvault/daemon.sock, modo 600). cogvault mcp y cogvault search lo encuentran
automáticamente y reenvían a él; el proceso MCP se mantiene entonces en ~40 MB. Cuando el daemon está
caído, buscan en proceso como antes, sin el reranker, y registran un
evento daemon-fallback en el registro de consultas.
cogvault daemon            # run in the foreground
cogvault daemon --status   # ping it: version, loaded models, tenants served
El daemon descarga un modelo después de 10 minutos sin una búsqueda o reindexación, y lo carga
de nuevo en la siguiente recuperación (~1.5 s extra en esa llamada). Establece --idle-unload SECONDS o
$COGVAULT_IDLE_UNLOAD (0 mantiene los modelos cargados). Medido con e5-small y el
reranker: ~1.8 GB cargados, ~0.4 GB descargados. ONNX Runtime usa 4 hilos
($COGVAULT_THREADS, 0 = todos los núcleos) y sin arena de memoria de CPU, por lo que una reindexación completa alcanza un pico
de ~1 GB en lugar de mantener varios GB después. Un shim que arrancó mientras el daemon estaba
caído espera hasta 60 s por él antes de cargar un modelo por sí mismo, y descarta un modelo que cargó
tan pronto como el daemon responde de nuevo.
El reranker tiene su propio número de hilos ($COGVAULT_RERANK_THREADS, por defecto = los núcleos de
rendimiento en Apple silicon, si no 4). Se ejecuta solo en el momento de la recuperación y es la mayor parte de
la latencia de recuperación: en 10 núcleos P, la recuperación p50 pasó de 2.3 s (4 hilos) a 1.65 s, y a 1.05 s
con onnxruntime 1.31 (esa versión también redujo la recuperación de 4 hilos a 1.5 s).
En macOS, ejecútalo bajo launchd con RunAtLoad y KeepAlive (argumentos del programa
cogvault daemon). Después de actualizar cogvault, reinicia el daemon:
launchctl kickstart -k gui/$(id -u)/<label>.
Notas de diseño
| Decisión | Por qué |
|---|---|
| Markdown = fuente de verdad | Legible por humanos, versionable con git, editable, nunca bloqueado en una BD |
SQLite + sqlite-vec + FTS5 | Búsqueda híbrida sin infraestructura; un archivo .db portátil; reconstruible |
| FastEmbed (MiniLM multilingüe por defecto, 384-d) | ONNX en proceso, sin servidor, sin clave API, ~220 MB |
| Caché de hash de contenido | La reindexación solo incrusta fragmentos cambiados |
| RRF + decadencia + MMR | Precisión, actualidad y diversidad sin una BD de grafos |
| Un proceso, muchos tenants | Infraestructura de flota, no un sidecar de escritorio de un solo usuario |
| WAL + reindexación incremental | Agentes concurrentes leen mientras uno escribe; solo los archivos cambiados se reincrustan |
| Daemon compartido opcional | Una copia de cada modelo para la flota; los clientes recurren al proceso cuando está caído |
Hoja de ruta
- Importadores (migrar memoria existente de otros almacenes)
- Incrustadores conectables (Ollama, endpoint compatible con OpenAI)
-
valid_untilvalidez temporal por tarjeta - Transporte FastMCP opcional
Licencia
MIT — tu memoria, tus archivos, tu infraestructura. Para siempre.
Las figuras son SVG construidas a mano desde assets/make_graphics.py — python assets/make_graphics.py --png las regenera.