distil
Optimización de contexto para agentes LLM: registro de herramientas, enmascaramiento de resultados, presupuestación y compactación.
Documentación



claude mcp add distil -- npx -y @munhq/distil
Sin cuenta, sin clave de API, nada que configurar. El paquete es un pequeño envoltorio que
descarga el binario para tu plataforma y lo verifica contra las sumas de verificación
publicadas; install.sh y un binario precompilado permanecen para quienes no tienen Node.
Las escrituras de caché son el 2% de tus tokens y el 28% de tu factura
Eso no es una afirmación, es una medición: 13,814 sesiones reales de agente, 410,742 turnos de asistente, re-ejecutado el 2026-08-29. Cada token único en ellas se facturó 550 veces, porque una solicitud reenvía todo el historial.
Lo que significa que el movimiento obvio — comprimir el historial — suele ser el equivocado. Editar el historial invalida el prefijo en caché desde la edición en adelante y convierte lecturas a 0.1x en escrituras a 1.25x o 2.0x. No puedes comprimir para salir del costo de contexto. Solo puedes negarte a admitir tokens.
Cada herramienta en este espacio publica un porcentaje de ahorro medido en sus propios
entornos de prueba. Lo que ninguna publica es el denominador: qué proporción de una sesión
real se le permite tocar, y cuánto cuesta esa proporción una vez aplicado el precio de
caché de prompt. distil mide ambos en transcripciones que un agente realmente escribió.
Qué es arte previo y qué no lo es. La aritmética de caché a continuación no es un
descubrimiento. Los https://platform.claude.com/docs/en/build-with-claude/context-editing de Anthropic
afirman que borrar resultados de herramientas invalida el prefijo en caché, e incluyen
clear_at_least para que un borrado solo se active cuando es lo suficientemente grande como para pagar por ello.
La regla de punto de equilibrio también está publicada: en una caché de 5 minutos, los tokens
borrados multiplicados por las solicitudes antes del siguiente borrado deben superar 11.5 veces
los tokens que conservas. La tabla en este README reproduce esa regla exactamente — se derivó
de forma independiente, lo cual es una verificación de la aritmética, no una contribución.
La brecha es empírica. Cada fuente dice calibrar contra tu propia carga de trabajo,
y ninguna incluye una forma de hacerlo ni publica cuáles resultan ser los valores. Eso
es para lo que sirve este crate: medir los números que necesitas para elegir
clear_at_least, o para decidir no borrar en absoluto.
La medición completa
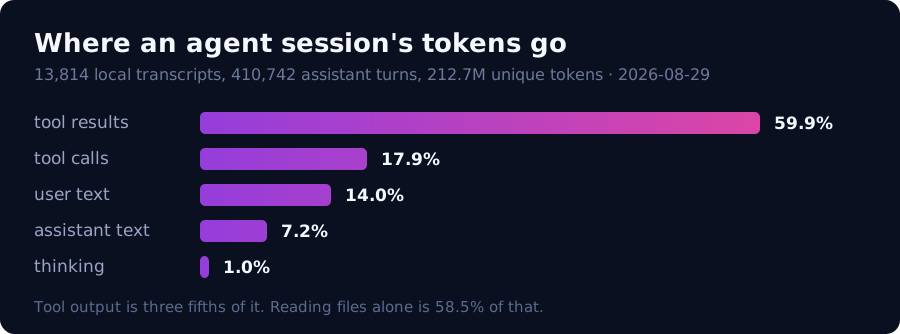
Medido el 2026-08-29 sobre 13,814 transcripciones locales de Claude Code — 410,742
turnos de asistente, 212.7M de tokens de texto único. Reprodúcelo en tu propio corpus
con distil-bench ~/.claude/projects; un corpus crece, así que la fecha importa más que los decimales.
| tokens | proporción | |
|---|---|---|
| resultados de herramientas | 127,371,430 | 59.9% |
| llamadas a herramientas | 38,065,121 | 17.9% |
| texto de usuario | 29,818,536 | 14.0% |
| texto de asistente | 15,402,077 | 7.2% |
| pensamiento | 2,076,716 | 1.0% |
Esos 212.7M de tokens únicos se facturaron como 116.9 mil millones de tokens de entrada — cada token se pagó 550 veces, porque una solicitud reenvía todo el historial.
Precio eso con multiplicadores de caché reales (lectura 0.1x, escritura 1.25x para el TTL de 5 minutos y 2.0x para el de 1 hora):
| proporción de tokens | proporción de costo | |
|---|---|---|
| lectura de caché | 97.9% | 71.8% |
| escrituras de caché | 2.0% | 27.6% |
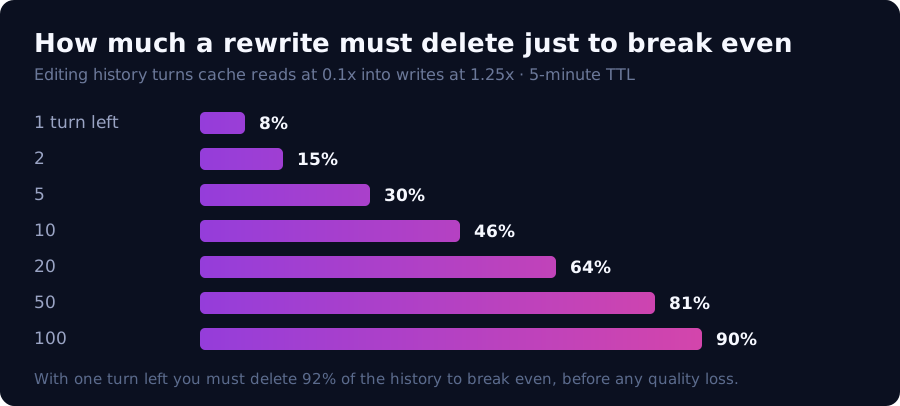
Las escrituras de caché son el 2% de los tokens y el 28% de la factura. Editar el historial invalida el prefijo en caché desde la edición en adelante, convirtiendo lecturas a 0.1x en escrituras a 1.25x o 2.0x. Así que una reescritura debe reducir lo que invalida por debajo de:
| turnos restantes | TTL 5m | TTL 1h |
|---|---|---|
| 1 | 8.0% | 5.0% |
| 10 | 46.5% | 34.5% |
| 20 | 63.5% | 51.3% |
| 100 | 89.7% | 84.0% |
Esa tabla es la regla de punto de equilibrio publicada en otra forma: en cada fila,
cleared x turns / kept equivale a 11.5 para el nivel de 5 minutos. Úsala para elegir un
valor de clear_at_least, y usa distil-bench para encontrar el número de turnos y el tamaño
de cola para poner en él — esas son propiedades de la carga de trabajo, y son la parte
que nadie publica.
Por unidad de historial, con 10 turnos restantes: conservarlo cuesta 1.00, comprimirlo cuesta 2.15, y nunca admitirlo cuesta 0. No puedes comprimir para salir del costo de contexto. Solo puedes negarte a admitir tokens.
Qué significa eso para usar este crate
Las capas que no tocan el historial están del lado correcto de esa aritmética:
CacheAlignLayer (ordena el contenido para que el prefijo estable siga siendo cacheable) y
ScratchpadLayer (mantiene el estado de trabajo fuera de la ventana).
Las capas que reescriben el historial — MaskingLayer, SummarizationLayer,
CompactionLayer — cuestan más de lo que ahorran en el caso común. Recurre a ellas
solo en un límite: desbordamiento de contexto, donde la alternativa es una solicitud
fallida y el precio de caché deja de ser la comparación. BudgetLayer existe para
exactamente ese momento.
RegistryLayer y CodeModeLayer preceden a la Herramienta de Búsqueda de Herramientas y a la
Llamada Programática de Herramientas de Anthropic, que hacen los mismos trabajos de forma nativa y mejor.
Prefiere las funciones nativas.
Para borrar resultados antiguos de herramientas, prefiere la edición de contexto clear_tool_uses
del proveedor sobre MaskingLayer: se ejecuta en el lado del servidor, toma clear_at_least, y
es un parámetro de API frente a una dependencia. Recurre a una capa aquí solo cuando
necesites un comportamiento que la API no ofrece.
Medición
cargo build --features bench --release

# Where tokens are, what they cost, and the break-even table
./target/release/distil-bench ~/.claude/projects --json baseline.json

# Sessions that called a given tool, against those that did not
./target/release/distil-bench ~/.claude/projects --split-by-tool mcp__codeindex__

# Export real traffic so other compressors run on the same input
./target/release/distil-bench ~/.claude/projects --export-sessions ./sessions --min-turns 40
Consulta bench/README.md para la comparación de herramientas externas, las
reglas de equidad, y los dos errores de arnés que produjeron números incorrectos primero.
Retención
Un ahorro solo es un ahorro si el modelo aún puede responder lo que el contexto original podía responder.
# No LLM judge: file paths checked against ground truth from the transcript
python bench/artifact_retention.py ./sessions 12

# LLM-graded probes (recall / artifact / continuation / decision)
cargo build --features probe --release
./target/release/distil-probe <session.jsonl> --probes 6 --model qwen2.5:3b
La taxonomía de sondas es de Factory.ai;
su artículo la define y no incluye ningún arnés. El juez es un Completer,
nunca un Summarizer — un resumidor puede imponer un marco de resumen, lo que
reescribe tanto el formato de la sonda como la instrucción de calificación.
Uso como biblioteca
use distil::{CacheAlignLayer, Ctx, EstimateCounter, Pipeline};

let pipeline = Pipeline::builder()
    .counter(EstimateCounter)
    .layer(CacheAlignLayer::generic())
    .build();

let mut ctx = Ctx::new(messages, tools, turn);
let result = pipeline.optimize(&mut ctx);
println!("{result}");
Este ejemplo se mantiene compilable como
examples/readme_quickstart.rs — ejecútalo con
cargo run --example readme_quickstart.
Cada capa implementa Layer e informa tokens_before, tokens_after y una línea
de detalle, para que cada una pueda medirse por sí misma.
Características
| característica | qué añade |
|---|---|
corpus | cargador de transcripciones (sin dependencias adicionales) |
bench | distil-bench, necesita tiktoken |
probe | distil-probe, necesita proxy para el juez HTTP |
tiktoken | conteos BPE precisos en lugar de la estimación chars/3.5 |
proxy | servidor HTTP distil-proxy |
mcp | servidor MCP distil-mcp |
metrics | /metrics de Prometheus |
Instalación
./install.sh                       # binaries, the skill, and the MCP server
/plugin marketplace add munhq/distil
/plugin install distil             # Claude Code: skill and server in one step
install.sh instala ambos binarios, coloca la habilidad en cada hogar de Claude que
encuentra, y registra el servidor MCP en el ámbito de usuario. Cuando el plugin ya está
instalado, instala solo el binario, ya que el plugin declara el servidor e
incluye la habilidad por sí mismo.
El plugin lanza el servidor con npx -y @munhq/distil, así que necesita Node.
No puede usar una ruta relativa al plugin: Claude Code expande ${CLAUDE_PLUGIN_ROOT}
y nada más lo hace, así que un plugin que declara una le da a cada otro cliente una
ruta literal que no existe. install.sh y los binarios precompilados permanecen
para quienes no tienen Node.
Soporte de plataformas
| plataforma | binarios | scripts |
|---|---|---|
| Linux x86_64 / arm64 | publicados, probados | sí |
| macOS x86_64 / arm64 | publicados, compilados en CI | sí |
| Windows x86_64 / arm64 | publicados, compilados en CI | necesita un shell: Git Bash, MSYS2 o WSL |
La versión publica seis objetivos y plugin/test_platform.sh mantiene tanto el
instalador como el lanzador del plugin en esa matriz, para que un nombre de activo y el nombre
solicitado no puedan divergir. install.sh y el lanzador son scripts bash, así que
en Windows necesitan un shell — cmd y PowerShell no pueden ejecutarlos. Los binarios
de Linux son compilaciones estáticas de musl, así que no necesitan un glibc coincidente.
Advertencias
El corpus es la máquina de un desarrollador. Las proporciones son el hallazgo; los
totales absolutos son personales. Los conteos usan cl100k_base, que aproxima
el tokenizador de Claude dentro de unos pocos por ciento. El modelo de punto de equilibrio asume un
único punto de ruptura de caché, así que una reescritura confinada a la cola cuesta menos de lo que
muestra la tabla — eso lo refina, no lo revierte.
Contribuciones
Instrucciones de compilación y prueba, las reglas que un cambio de referencia debe seguir, y lo que
una solicitud de extracción necesita antes de la revisión: CONTRIBUTING.md.
Informa una vulnerabilidad de forma privada — SECURITY.md.
Licencia
MIT. Consulta LICENSE.