MCP Lucene Server
El MCP Lucene Server es un servidor del Protocolo de Contexto de Modelo (MCP) que expone las capacidades de búsqueda de texto completo de Apache Lucene a través de una interfaz conversacional. Permite que asistentes de IA (como Claude) ayuden a los usuarios a buscar, indexar y gestionar colecciones de documentos sin requerir conocimientos técnicos de Lucene o motores de búsqueda.
Documentación
MCP Lucene Server

Un servidor de Model Context Protocol (MCP) que expone capacidades de búsqueda de texto completo de Apache Lucene con rastreo e indexación automática de documentos. Este servidor admite tanto transporte STDIO (para integración con Claude Desktop) como transporte HTTP (para clientes web y acceso remoto).
Características
Rastreo Automático de Documentos
- Indexa automáticamente documentos PDF, Microsoft Office y OpenOffice
- Rastreo multihilo para indexación rápida
- Monitoreo de directorios en tiempo real para actualizaciones automáticas
- Indexación incremental con reconciliación completa (omite archivos sin cambios, elimina huérfanos)
Búsqueda Potente
- Búsqueda simple por palabras clave (sin necesidad de sintaxis Lucene) y búsqueda con sintaxis completa de consultas Lucene
- Filtrado por campo específico (por autor, idioma, tipo de archivo, etc.)
- Pasajes estructurados con metadatos de calidad para consumo por LLM
- Resultados paginados con sugerencias de filtros
Búsqueda Semántica
- Búsqueda semántica opcional basada en embeddings KNN puros utilizando embeddings multilingual-e5 con Late Chunking
- Encuentra documentos semánticamente relacionados incluso sin coincidencias exactas de palabras clave
- Requiere que
VECTOR_MODELesté configurado. Consulte SEMANTICSEARCH.md para más detalles.
Perfilado y Depuración de Consultas
- Análisis y perfilado profundo de consultas (herramienta
profileQuery) - Comprenda por qué las consultas devuelven ciertos resultados y cómo funciona la puntuación
- Análisis de impacto de filtros que muestra la reducción de documentos por filtro
- Explicaciones de puntuación de documentos con desglose BM25
- Estadísticas de términos (IDF, rareza, frecuencia de documentos)
- Recomendaciones de optimización accionables
- Salida estructurada optimizada para LLM para facilitar la interpretación
Extracción Enriquecida de Metadatos
- Detección automática de idioma
- Extracción de autor, título y fecha de creación
- Información de tipo y tamaño de archivo
- Hash de contenido SHA-256 para detección de cambios
Enriquecimiento de Metadatos JDBC
- Cargar metadatos adicionales desde PostgreSQL, MySQL o cualquier base de datos compatible con JDBC al momento de la indexación
- Metadatos basados en JSON con tipos de campo explícitos (keyword, text, int, long, date)
- Soporte de campos multivalor, registro automático de facetas
- Trabajo de sincronización en segundo plano para actualizaciones incrementales de metadatos (intervalo configurable)
- Todos los campos provenientes de la base de datos con prefijo
dbmeta_para evitar colisiones de esquema
Normalización de Texto
- Eliminación automática de caracteres rotos/inválidos (caracteres de reemplazo, caracteres de control, caracteres de ancho cero)
- Normalización de espacios en blanco (múltiples espacios colapsados a un solo espacio)
- Garantiza resultados de búsqueda y pasajes limpios y legibles
Rendimiento Optimizado
- Procesamiento por lotes para indexación eficiente
- Búsqueda NRT (Near Real-Time) con optimización dinámica
- Grupos de hilos configurables para procesamiento paralelo
- Notificaciones de progreso durante operaciones masivas
Integración Fácil
- Soporte de transporte dual: STDIO (predeterminado) y HTTP
- Transporte STDIO para integración perfecta con Claude Desktop
- Transporte HTTP para clientes web y acceso remoto
- Herramientas MCP integrales para búsqueda y control del rastreador
- Configuración flexible mediante YAML y propiedades del sistema
- Notificaciones multiplataforma (Centro de Notificaciones de macOS, Windows Toast, notify-send de Linux)
Tabla de Contenidos
- Documentación
- Inicio Rápido
- Herramientas MCP
- Configuración de Exposición de Herramientas
- Esquema de Campos del Índice
- Ejemplos de Uso
- Características del Rastreador de Documentos
- Solución de Problemas
- Consideraciones de Seguridad
- Opciones de Configuración
- Enriquecimiento de Metadatos JDBC
- Desarrollo
Documentación
Documentación técnica adicional:
- PIPELINE.md — Cadenas de analizadores, pipeline de consultas y detalles de tokenización
- SEMANTICSEARCH.md — Arquitectura de búsqueda semántica: Late Chunking, indexación Block Join, puntuación KNN y configuración
- ONNX.md — Exportación de modelos ONNX, optimización y guía de cuantización INT8 para e5-base y e5-large
Inicio Rápido
Ponga en marcha MCP Lucene Server en tres pasos.
Requisitos Previos
- Java 25 o posterior - Requerido para ejecutar el servidor
- Maven 3.9+ (solo si se compila desde el código fuente)
Paso 1: Obtener el Servidor
Opción A: Descargar JAR Precompilado (Recomendado)
- Vaya a la pestaña Actions
- Haga clic en la ejecución de flujo de trabajo exitosa más reciente
- Desplácese hasta "Artifacts" y descargue
luceneserver-X.X.X-SNAPSHOT - Extraiga el archivo ZIP para obtener el JAR
Para versiones etiquetadas, también puede descargar desde la página de Releases.
Opción B: Compilar desde el Código Fuente
./mvnw clean package -DskipTests
Esto crea un JAR ejecutable en target/luceneserver-0.0.1-SNAPSHOT.jar.
Opción C: Usar Docker (Solo está disponible el transporte HTTP)
docker run -v ./lucene-data-dir:/userdata -p 9000:9000 -it mirkosertic42/mcpluceneserver:main
Esto inicia un contenedor Docker con el servidor escuchando en el puerto 9000. Todos los datos de configuración, incluidos los archivos de índice, se almacenan en el directorio ./lucene-data-dir en la máquina host. Tenga en cuenta que el indexador Lucene solo puede acceder a archivos que sean visibles para el contenedor Docker, por lo que todos los archivos deben colocarse en el directorio ./lucene-data-dir o en un subdirectorio del mismo. La configuración de JVM se puede ajustar mediante la variable de entorno JAVA_OPTS, que se puede modificar usando la CLI de Docker o un archivo Docker Compose. El tamaño máximo predeterminado del heap de JVM (-Xmx) es de 2GB.
Para habilitar la búsqueda semántica, configure la variable de entorno VECTOR_MODEL:
docker run -v ./lucene-data-dir:/userdata -p 9000:9000 \
  -e VECTOR_MODEL=e5-base \
  -e JAVA_OPTS="-Xmx4g" \
  -it mirkosertic42/mcpluceneserver:main
| Variable de Entorno | Predeterminado | Descripción |
|---|---|---|
VECTOR_MODEL | (ninguno) | Modelo de embeddings ONNX: e5-base (768 dimensiones, más rápido) o e5-large (1024 dimensiones, mayor calidad). Configúrelo para habilitar la búsqueda semántica. |
JAVA_OPTS | -Xmx2g | Opciones de JVM. Auméntelas a -Xmx4g o más al usar búsqueda semántica. |
Paso 2: Configurar Claude Desktop
Localice su archivo de configuración de Claude Desktop:
- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json - Linux:
~/.config/Claude/claude_desktop_config.json
Agregue el servidor MCP de Lucene a la sección mcpServers:
{
  "mcpServers": {
    "lucene-search": {
      "command": "java",
      "args": [
        "--enable-native-access=ALL-UNNAMED",
        "-Xmx2g",
        "-Dspring.profiles.active=deployed",
        "-jar",
        "/absolute/path/to/luceneserver-0.0.1-SNAPSHOT.jar"
      ]
    }
  }
}
Importante: Reemplace /absolute/path/to/luceneserver-0.0.1-SNAPSHOT.jar con la ruta absoluta real a su archivo JAR.
El indicador -Dspring.profiles.active=deployed es necesario para una comunicación STDIO limpia (deshabilita el registro de consola y el banner de inicio).
Paso 3: Comenzar a Usarlo
- Reinicie Claude Desktop para cargar la nueva configuración
- Verifique que el servidor esté ejecutándose en la configuración de desarrollador de Claude Desktop
- Dígale a Claude que agregue sus documentos:
"Add /Users/yourname/Documents as a crawlable directory and start crawling"
¡Eso es todo! La configuración se guarda en ~/.mcplucene/config.yaml y persiste entre reinicios. Ahora puede buscar sus documentos a través de Claude.
Ejemplos de búsquedas:
- "Buscar artículos sobre aprendizaje automático"
- "Encontrar todos los PDF de John Doe"
- "¿Qué documentos mencionan informes trimestrales?"
Herramientas MCP
Las herramientas están organizadas en grupos. Use LUCENE_TOOLS_INCLUDE y LUCENE_TOOLS_EXCLUDE para controlar qué herramientas se exponen (consulte Configuración de Exposición de Herramientas).
Herramientas de Búsqueda (grupo: search)
simpleSearch
Busque en el índice de texto completo de Lucene usando búsqueda por palabras clave en texto plano. Los caracteres especiales se tratan como literales: no se requiere conocimiento de sintaxis Lucene. Utiliza BM25 con derivación (stemming) en alemán e inglés.
Parámetros:
query(opcional): Consulta de búsqueda en texto plano. Puede sernullo"*"para coincidir con todos los documentos (útil con filtros).filters(opcional): Matriz de filtros estructurados para filtrado preciso a nivel de campo (consulte Filtros Estructurados más abajo)page(opcional): Número de página, basado en 0 (predeterminado: 0)pageSize(opcional): Resultados por página (predeterminado: 10, máximo: 100)sortBy(opcional): Campo de ordenación:_score(predeterminado),modified_date,created_date,file_sizeo cualquier campo de metadatosdbmeta_*(INT/LONG/DATE/KEYWORD) registrado desde el enriquecimiento JDBCsortOrder(opcional): Orden de ordenación:ascodesc(predeterminado:desc)
extendedSearch
Busque en el índice de texto completo de Lucene usando la sintaxis completa de consultas Lucene. Admite operadores booleanos, comodines, consultas de proximidad y consultas específicas de campo. Utiliza BM25 con derivación (stemming) en alemán e inglés.
Parámetros:
query(opcional): La consulta de búsqueda usando sintaxis de consultas Lucene. Puede sernullo"*"para coincidir con todos los documentos (útil con filtros).filters(opcional): Matriz de filtros estructurados para filtrado preciso a nivel de campo (consulte Filtros Estructurados más abajo)page(opcional): Número de página, basado en 0 (predeterminado: 0)pageSize(opcional): Resultados por página (predeterminado: 10, máximo: 100)sortBy(opcional): Campo de ordenación:_score(predeterminado),modified_date,created_date,file_sizeo cualquier campo de metadatosdbmeta_*(INT/LONG/DATE/KEYWORD) registrado desde el enriquecimiento JDBCsortOrder(opcional): Orden de ordenación:ascodesc(predeterminado:desc)
Ordenación de Resultados:
De forma predeterminada, los resultados se ordenan por puntuación de relevancia (los más relevantes primero). Puede ordenar por campos de metadatos:
| Campo de Ordenación | Descripción | Orden Predeterminado |
|---|---|---|
_score | Puntuación de relevancia (predeterminado) | Descendente (mejor coincidencia primero) |
modified_date | Fecha de última modificación | Descendente (más reciente primero) |
created_date | Fecha de creación | Descendente (más reciente primero) |
file_size | Tamaño del archivo en bytes | Descendente (más grande primero) |
dbmeta_* | Cualquier campo de metadatos JDBC de un solo valor con tipo INT, LONG, DATE o KEYWORD | Ascendente o descendente |
Ejemplos de Ordenación:
// Most recently modified documents
{ "query": "contract", "sortBy": "modified_date", "sortOrder": "desc" }

// Oldest documents first
{ "query": "contract", "sortBy": "created_date", "sortOrder": "asc" }

// Smallest files (for quick review)
{ "query": "summary", "sortBy": "file_size", "sortOrder": "asc" }

// Combine sorting with filters
{
  "query": "*",
  "sortBy": "modified_date",
  "sortOrder": "desc",
  "filters": [
    { "field": "file_extension", "value": "pdf" },
    { "field": "modified_date", "operator": "range", "from": "2024-01-01" }
  ]
}
Nota: Al ordenar por campos de metadatos, las puntuaciones de relevancia aún se calculan y se utilizan como criterio de ordenación secundario para desempatar.
Filtros Estructurados:
La matriz filters acepta objetos con estos campos:
| Campo | Obligatorio | Descripción |
|---|---|---|
field | sí | Nombre del campo sobre el que filtrar |
operator | no | eq (predeterminado), in, not, not_in, range |
value | para eq/not | Valor único para coincidencia exacta o exclusión |
values | para in/not_in | Matriz de valores (semántica OR dentro del campo) |
from | para range | Inicio del rango (inclusive) |
to | para range | Fin del rango (inclusive) |
addedAt | no | Marca de tiempo del cliente — se devuelve tal cual en la respuesta activeFilters |
Referencia de operadores:
| Operador | Descripción | Ejemplo |
|---|---|---|
eq | Coincidencia exacta (predeterminado) | {field: "language", value: "en"} |
in | Coincidir con cualquiera de los valores | {field: "file_extension", operator: "in", values: ["pdf", "docx"]} |
not | Excluir valor | {field: "language", operator: "not", value: "unknown"} |
not_in | Excluir múltiples valores | {field: "language", operator: "not_in", values: ["unknown", ""]} |
range | Rango numérico/de fecha | {field: "modified_date", operator: "range", from: "2024-01-01", to: "2025-12-31"} |
Campos filtrables:
- Con facetas (DrillSideways):
language,file_extension,file_type,author - Cadena (coincidencia exacta):
file_path,content_hash - Numérico/fecha (rango):
file_size,created_date,modified_date,indexed_date
Formato de fecha: ISO-8601 — "2024-01-15", "2024-01-15T10:30:00", o "2024-01-15T10:30:00Z"
Reglas de combinación de filtros:
- Los filtros sobre campos diferentes usan lógica AND
- Múltiples filtros
eqo valoresinsobre el mismo campo con facetas usan lógica OR (DrillSideways) - Los filtros
not/not_inse aplican como cláusulas MUST_NOT
Expansión de sinónimos impulsada por IA:
Este servidor está diseñado para trabajar con asistentes de IA como Claude. En lugar de usar archivos de sinónimos Lucene tradicionales, la IA genera sinónimos apropiados al contexto automáticamente mediante la construcción de consultas OR.
Por qué esto es mejor que los sinónimos tradicionales:
- Consciente del contexto: La IA comprende tu intención y selecciona sinónimos relevantes (p. ej., "contrato" en contexto legal frente a "contrato" en construcción)
- Sin mantenimiento: No es necesario mantener archivos de configuración de sinónimos estáticos
- Adaptable al dominio: Funciona automáticamente en lenguaje legal, técnico, médico o informal
- Multilingüe: Genera sinónimos en cualquier idioma sin configuración
Cuando le pides a Claude que "encuentre documentos sobre automóviles", automáticamente busca (car OR automobile OR vehicle) — lo que te da mejores resultados que una lista de sinónimos estática.
Detalles técnicos (coincidencia léxica):
El servidor utiliza un pipeline de indexación multi-analizador y un pipeline de consulta ponderada de múltiples campos para una búsqueda exhaustiva:
- Normalización Unicode — normalización NFKC, plegado de diacríticos, expansión de ligaduras mediante ICUFoldingFilter
- Optimización de comodines iniciales — el campo
content_reversedalmacena tokens invertidos para consultas eficientes de tipo*vertrag - Comodines sin distinción de mayúsculas — los términos con comodín/prefijo se convierten automáticamente a minúsculas
- Lematización OpenNLP — lematización basada en diccionario para alemán e inglés, incluidas formas irregulares (ran→run, ging→gehen, paid→pay, analyses→analysis)
- Indexación bilingüe — se indexan campos de lema tanto en alemán como en inglés para todos los documentos, lo que permite coincidencias en idiomas mixtos
- Transliteración de diéresis alemanas — el campo sombra
content_translit_deasigna dígrafos (Mueller→Müller) - Expansión automática de frases — las frases exactas se expanden automáticamente para incluir coincidencias de proximidad (ver más abajo)
- Puntuación adaptativa de prefijos — puntuación BM25 para prefijos específicos (>= 4 caracteres)
Consulta PIPELINE.md para obtener documentación completa de la cadena de analizadores, ejemplos concretos y detalles del pipeline de consultas.
El asistente de IA compensa las limitaciones restantes (sin expansión de sinónimos, sin coincidencia fonética) expandiendo las consultas de forma inteligente.
Mejores prácticas para obtener mejores resultados:
-
Genera tus propios sinónimos: Usa OR para combinar términos relacionados:
- En lugar de:
contract - Usa:
(contract OR agreement OR deal)
- En lugar de:
-
Usa comodines para variaciones: Maneja diferentes formas de palabras:
- En lugar de:
contract - Usa:
contract*(coincide con contracts, contracting, contracted)
- En lugar de:
-
Aprovecha las facetas: Usa los valores de faceta devueltos para descubrir términos exactos en el índice:
- Revisa
facets.authorpara encontrar nombres de autor exactos - Revisa
facets.languagepara ver los idiomas disponibles - Usa estos valores exactos para filtrar
- Revisa
-
Combina técnicas:
(contract* OR agreement*) AND (sign* OR execut*) AND author:"John Doe"
Sintaxis de consulta admitida (extendedSearch):
- Términos simples:
hello world(AND implícito entre términos) - Consultas de frase:
"exact phrase"(preserva el orden de las palabras) - Operadores booleanos:
term1 AND term2,term1 OR term2,NOT term - Comodín final:
contract*coincide con contracts, contracting, contracted - Comodín inicial:
*vertragencuentra eficientemente Arbeitsvertrag, Kaufvertrag (optimizado mediante el campo de tokens invertidos) - Comodín infijo:
*vertrag*encuentra tanto Vertragsbedingungen como Arbeitsvertrag - Comodín de un solo carácter:
te?tcoincide con test, text - Búsqueda difusa:
term~2encuentra términos dentro de una distancia de edición Levenshtein de 2 (predeterminado: 2) - Búsqueda de proximidad:
"term1 term2"~5encuentra términos dentro de 5 palabras entre sí - Búsqueda específica de campo:
title:hello content:world - Agrupación:
(contract OR agreement) AND signed - Consultas de rango:
modified_date:[1609459200000 TO 1640995200000](marcas de tiempo en milisegundos)
Expansión automática de proximidad de frases:
Las consultas de frases de varias palabras se expanden automáticamente: "Domain Design" se convierte en ("Domain Design")^2.0 OR ("Domain Design"~3). Las coincidencias exactas obtienen la puntuación más alta (impulso 2.0x), mientras que las coincidencias cercanas (dentro de 3 palabras) también aparecen con puntuaciones más bajas. Las frases de una sola palabra y el deslizamiento especificado por el usuario no se expanden.
Consulta PIPELINE.md para ver ejemplos detallados y configuración.
Puntuación adaptativa de consultas de prefijo:
Las consultas de prefijo con >= 4 caracteres (vertrag*, design*) usan puntuación BM25 real, clasificando términos más cortos/frecuentes por encima de compuestos largos. Los prefijos más cortos (ver*) usan puntuación constante por rendimiento. Esto equilibra automáticamente la calidad de clasificación con la velocidad.
Consulta PIPELINE.md para ver ejemplos de puntuación y detalles técnicos.
Búsqueda de palabras compuestas alemanas:
Usa comodines para compuestos alemanes: *vertrag encuentra Arbeitsvertrag, vertrag* encuentra Vertragsbedingungen. Los comodines iniciales se optimizan mediante el campo content_reversed.
Lematización automática:
La lematización OpenNLP maneja variantes morfológicas automáticamente. Alemán: "Haus" encuentra "Häuser", "gehen" encuentra "ging". Inglés: "run" encuentra "ran", "pay" encuentra "paid". Las coincidencias exactas siempre obtienen la puntuación más alta.
Soporte bilingüe:
Todos los documentos se indexan con campos de lema tanto en alemán como en inglés, lo que permite coincidencias en idiomas mixtos. Los documentos en alemán con términos técnicos en inglés ("Recommendation Engines") coinciden con consultas en singular ("Recommendation Engine") mediante el lematizador de inglés, y viceversa.
Transliteración de diéresis alemanas:
El campo content_translit_de asigna dígrafos ASCII a diéresis: "Mueller" coincide con "Müller", "Kaese" coincide con "Käse".
Consulta PIPELINE.md para ver cadenas de analizadores completas, ejemplos concretos de tokens y detalles del pipeline de consultas.
Devuelve:
- Resultados de documentos paginados, cada uno con una matriz
passagescon texto resaltado y metadatos de calidad - Puntuaciones de relevancia a nivel de documento
facets: Valores de faceta y recuentos del conjunto de resultados (usa DrillSideways cuando hay filtros de faceta activos, mostrando valores alternativos)activeFilters: Refleja la entradafilterscon unmatchCountpara cada filtro (recuento de facetas, o -1 para filtros de rango/sin facetas)- Tiempo de ejecución de la búsqueda en milisegundos (
searchTimeMs)
Ejemplos de filtros:
// Browse all English PDFs
{ "query": null, "filters": [
    { "field": "language", "value": "en" },
    { "field": "file_extension", "value": "pdf" }
]}

// Date range filter
{ "query": "contract*", "filters": [
    { "field": "modified_date", "operator": "range", "from": "2024-01-01", "to": "2025-12-31" }
]}

// Multiple values with exclusion
{ "query": "report", "filters": [
    { "field": "file_extension", "operator": "in", "values": ["pdf", "docx"] },
    { "field": "language", "operator": "not", "value": "unknown" }
]}
Herramientas de búsqueda semántica (grupo: semantic)
Las herramientas de búsqueda semántica requieren que VECTOR_MODEL esté configurado (p. ej., VECTOR_MODEL=e5-base).
semanticSearch
Búsqueda semántica pura basada en incrustaciones KNN. Encuentra documentos semánticamente relacionados incluso sin coincidencias exactas de palabras clave. Los resultados se ordenan por similitud de coseno. Requiere que VECTOR_MODEL esté configurado.
Parámetros:
query(obligatorio): Consulta en lenguaje natural — el servidor calcula una incrustación y encuentra los fragmentos de documento más cercanos.filters(opcional): Matriz de filtros estructurados (mismo formato quesimpleSearch/extendedSearch)page(opcional): Número de página, basado en 0 (predeterminado: 0)pageSize(opcional): Resultados por página (predeterminado: 10, máximo: 100)similarityThreshold(opcional): Puntuación mínima de similitud de coseno para incluir un resultado (0.0–1.0, predeterminado: 0.70). Más bajo = más resultados (coincidencia más amplia); más alto = menos resultados (coincidencia más cercana).
Usa profileSemanticSearch para ajustar similarityThreshold para tu corpus.
profileSemanticSearch
Herramienta de depuración para búsqueda semántica. Muestra el tiempo de incrustación, las puntuaciones de coseno, los fragmentos coincidentes y cuántos candidatos superaron el umbral de similitud. Úsala para ajustar similarityThreshold para tus datos.
Parámetros:
query(obligatorio): Consulta en lenguaje natural para perfilarfilters(opcional): Matriz de filtros estructuradossimilarityThreshold(opcional): Umbral a probar (0.0–1.0, predeterminado: 0.70)
Herramientas de depuración (grupo: debug)
profileQuery
Analiza y depura consultas simpleSearch / extendedSearch. Proporciona información detallada sobre cómo Lucene procesa tu consulta, qué términos contribuyen a la puntuación, cómo afectan los filtros a los resultados y dónde existen oportunidades de optimización.
Parámetros:
query(opcional): La consulta de búsqueda (igual quesimpleSearch/extendedSearch)filters(opcional): Matriz de filtros estructurados (igual que las herramientas de búsqueda)page(opcional): Número de página, basado en 0 (predeterminado: 0)pageSize(opcional): Resultados por página (predeterminado: 10, máximo: 100)sortBy(opcional): Campo de ordenación (igual que las herramientas de búsqueda)sortOrder(opcional): Orden de ordenación (igual que las herramientas de búsqueda)queryMode(opcional):SIMPLE(predeterminado) oEXTENDED— selecciona el modo del analizador de consultas para que coincida con la herramienta de búsqueda que estás perfilandoanalyzeFilterImpact(opcional): Si estrue, analiza cómo cada filtro reduce el recuento de resultados. ADVERTENCIA: Operación costosa que requiere múltiples consultas. Predeterminado:falseanalyzeDocumentScoring(opcional): Si estrue, proporciona explicaciones detalladas de puntuación para los documentos principales mediante la API de Explanation de Lucene. ADVERTENCIA: Operación costosa. Predeterminado:falseanalyzeFacetCost(opcional): Si estrue, mide la sobrecarga de cálculo de facetas. ADVERTENCIA: Operación costosa. Predeterminado:falsemaxDocExplanations(opcional): Número máximo de documentos a explicar cuandoanalyzeDocumentScoring=true(predeterminado: 5, máximo: 10)
Niveles de análisis:
Nivel 1: Análisis rápido (siempre incluido)
- Estructura de la consulta y desglose de componentes
- Identificación del tipo de consulta (BooleanQuery, TermQuery, WildcardQuery, etc.)
- Costo estimado por componente de consulta
- Estadísticas de términos (frecuencia de documentos, IDF, clasificación de rareza)
- Métricas de búsqueda (total de coincidencias, porcentaje de reducción de filtros) Nivel 2: Análisis de Impacto de Filtros (Opt-in, Costoso)
- Muestra cómo cada filtro afecta el recuento de resultados
- Calcula la selectividad (baja/media/alta/muy alta)
- Mide el tiempo de ejecución por filtro
- Ayuda a identificar filtros redundantes o ineficaces
Nivel 3: Explicaciones de Puntuación de Documentos (Opt-in, Costoso)
- Desglose detallado de puntuación para los documentos mejor clasificados
- Muestra qué términos contribuyen más a la puntuación de cada documento
- Proporciona resúmenes de puntuación legibles para humanos
- Utiliza la API de Explicación de Lucene pero analizada en un formato amigable para LLM
Nivel 4: Análisis de Costo de Facetas (Opt-in, Costoso)
- Mide la sobrecarga de cálculo de facetas
- Muestra el costo por dimensión de faceta
- Ayuda a decidir si las facetas deben desactivarse por rendimiento
Devuelve:
Un objeto de análisis estructurado que contiene:
{
  success: boolean,
  queryAnalysis: {
    originalQuery: string,
    parsedQueryType: string,
    components: [{
      type: string,              // "TermQuery", "WildcardQuery", etc.
      field: string,
      value: string,
      occur: string,             // "MUST", "SHOULD", "FILTER", "MUST_NOT"
      estimatedCost: number,
      costDescription: string    // "~450 documents (moderate)"
    }],
    rewrites: [{                 // Query optimizations performed by Lucene
      original: string,
      rewritten: string,
      reason: string
    }],
    warnings: string[]
  },
  searchMetrics: {
    totalIndexedDocuments: number,
    documentsMatchingQuery: number,
    documentsAfterFilters: number,
    filterReductionPercent: number,
    termStatistics: {
      [term: string]: {
        term: string,
        documentFrequency: number,
        totalTermFrequency: number,
        idf: number,
        rarity: string           // "very common", "common", "uncommon", "rare"
      }
    }
  },
  filterImpact?: {               // Only if analyzeFilterImpact=true
    baselineHits: number,
    finalHits: number,
    filterImpacts: [{
      filter: {...},
      hitsBeforeFilter: number,
      hitsAfterFilter: number,
      documentsRemoved: number,
      reductionPercent: number,
      selectivity: string,       // "low", "medium", "high", "very high"
      executionTimeMs: number
    }],
    totalExecutionTimeMs: number
  },
  documentExplanations?: [{      // Only if analyzeDocumentScoring=true
    filePath: string,
    rank: number,
    score: number,
    scoringBreakdown: {
      totalScore: number,
      components: [{
        term: string,
        field: string,
        contribution: number,
        contributionPercent: number,
        details: {
          idf: number,
          tf: number,
          termFrequency: number,
          documentLength: number,
          averageDocumentLength: number,
          explanation: string
        }
      }],
      summary: string            // "Score dominated by term 'contract' (60.8%)"
    },
    matchedTerms: string[]
  }],
  facetCost?: {                  // Only if analyzeFacetCost=true
    facetingOverheadMs: number,
    facetingOverheadPercent: number,
    dimensions: {
      [dimension: string]: {
        dimension: string,
        uniqueValues: number,
        totalCount: number,
        computationTimeMs: number
      }
    }
  },
  recommendations: string[]      // Actionable optimization suggestions
}
Ejemplo: Análisis Básico de Consultas
Ask Claude: "Profile my search for 'contract AND signed' to understand its performance"
Esto realiza un análisis rápido que muestra:
- Estructura de la consulta (consulta booleana AND con dos términos)
- Estadísticas de términos (qué tan comunes son "contract" y "signed")
- Estimaciones de costo (cuántos documentos serán examinados)
- Recomendaciones de optimización
Ejemplo: Análisis Profundo con Puntuación
{
  "query": "(contract OR agreement) AND signed",
  "filters": [
    { "field": "language", "value": "en" },
    { "field": "modified_date", "operator": "range", "from": "2024-01-01" }
  ],
  "analyzeDocumentScoring": true,
  "maxDocExplanations": 3
}
Esto proporciona explicaciones detalladas de puntuación para los 3 documentos principales, mostrando:
- Qué términos coincidieron en cada documento
- Cuánto contribuyó cada término a la puntuación final
- Por qué el documento A se clasificó más alto que el documento B
Ejemplo: Optimización de Filtros
{
  "query": "*",
  "filters": [
    { "field": "file_extension", "value": "pdf" },
    { "field": "language", "value": "en" },
    { "field": "file_type", "value": "application/pdf" }
  ],
  "analyzeFilterImpact": true
}
Esto analiza la efectividad de los filtros, revelando potencialmente:
file_extension=pdfreduce los resultados en un 75% (alta selectividad)file_type=application/pdfreduce los resultados en un 0% (redundante con file_extension)- Recomendación: Eliminar el filtro redundante
file_type
Ejemplo: Comprensión de la Expansión Automática de Frases
Cuando buscas una frase exacta como "Domain Design", la consulta se expande automáticamente para mejorar la recuperación mientras se mantiene la precisión:
{
  "query": "\"Domain Design\"",
  "analyzeDocumentScoring": true,
  "maxDocExplanations": 3
}
El perfilador revela cómo se expandió la consulta:
Análisis de Consulta:
- Consulta Original:
"Domain Design" - Tipo Analizado:
BooleanQuery - Reescritura: Expansión automática de proximidad de frases (coincidencia exacta potenciada + variantes de proximidad)
- Componentes de la Consulta:
PhraseQuery (boost=4.0)-"domain design"(coincidencia exacta, mayor potenciación)PhraseQuery (boost=2.0)-"domain design"~3(coincidencia de proximidad, slop=3)- Variantes adicionales con raíces derivadas con potenciaciones más bajas
Puntuación de Documentos:
- Coincidencia exacta ("Domain Design"): Puntuación 0.81 - coincide con ambas cláusulas, la cláusula exacta domina
- Coincidencia de proximidad ("Domain-driven Design"): Puntuación 0.15 - coincide solo con la cláusula de proximidad
- Coincidencia de proximidad ("Domain Effective Design"): Puntuación 0.15 - coincide solo con la cláusula de proximidad
Esto muestra:
- Las coincidencias exactas se clasifican más alto debido a la potenciación acumulada de 4.0x (2.0 de derivación x 2.0 de expansión de frase)
- Las coincidencias de proximidad aún se encuentran con slop=3 (permitiendo hasta 3 palabras entre términos)
- Separación clara de puntuaciones entre coincidencias exactas y de proximidad asegura precisión
Notas de Rendimiento:
- Análisis básico (predeterminado): Muy rápido, sobrecarga insignificante (~5-10ms)
- Análisis de impacto de filtros: Requiere consultas N+1 donde N es el número de filtros. Puede tomar segundos para conjuntos de filtros complejos.
- Análisis de puntuación de documentos: Requiere que Lucene calcule objetos de Explicación completos. El costo crece con
maxDocExplanations. - Análisis de costo de facetas: Requiere cálculo de facetas. El costo depende del número de valores de faceta únicos.
Mejores Prácticas:
- Comienza con análisis básico (sin banderas opcionales) para obtener información rápida
- Habilita análisis costoso solo al depurar problemas específicos de rendimiento
- Usa
analyzeDocumentScoringpara entender por qué ciertos documentos se clasifican alto - Usa
analyzeFilterImpactpara optimizar el orden de los filtros y eliminar filtros redundantes - Presta atención al array
recommendationspara consejos de optimización accionables
Herramientas de Rastreo (grupo: crawler)
startCrawl
Inicia el rastreo de directorios configurados para indexar documentos.
Parámetros:
fullReindex(opcional): Si es verdadero, limpia el índice antes de rastrear (predeterminado: falso). Cuando es falso yreconciliation-enabledes verdadero, se realiza un rastreo incremental en su lugar.
Características:
- Extrae automáticamente contenido de PDFs, documentos de Office y archivos de OpenOffice
- Detecta el idioma del documento
- Extrae metadatos (autor, título, fecha de creación, etc.)
- Procesamiento multi-hilo para indexación rápida
- Notificaciones de progreso durante el rastreo
- Modo incremental (predeterminado): Solo se indexan archivos nuevos o modificados; los archivos eliminados se eliminan del índice automáticamente. Vuelve a un rastreo completo si la reconciliación encuentra un error.
getCrawlerStats
Obtén estadísticas en tiempo real sobre el progreso del rastreo.
Devuelve:
filesFound: Archivos totales descubiertosfilesProcessed: Archivos procesados hasta ahorafilesIndexed: Archivos indexados exitosamentefilesFailed: Archivos que fallaron al procesarsebytesProcessed: Bytes totales procesadosfilesPerSecond: Rendimiento de procesamientomegabytesPerSecond: Rendimiento de datoselapsedTimeMs: Tiempo transcurrido desde que comenzó el rastreoperDirectoryStats: Desglose de estadísticas por directorioorphansDeleted: Número de entradas de índice eliminadas porque el archivo ya no existe en el disco (modo incremental)filesSkippedUnchanged: Número de archivos omitidos porque no se modificaron desde el último rastreo (modo incremental)reconciliationTimeMs: Tiempo dedicado a comparar el índice con el sistema de archivos (modo incremental)crawlMode: Ya sea"full"o"incremental"currentlyProcessing: Array de archivos que se están procesando actualmente (extraídos/indexados). Cada entrada contiene:filePath: Ruta completa al archivo que se está procesandoprocessingDurationMs: Cuánto tiempo ha estado procesándose el archivo (en milisegundos)
lastCrawlCompletionTimeMs: Marca de tiempo Unix (ms) de la última finalización exitosa del rastreo (nulo si no hay rastreo previo)lastCrawlDocumentCount: Número de documentos en el índice después del último rastreo exitoso (nulo si no hay rastreo previo)lastCrawlMode: Modo del último rastreo -"full"o"incremental"(nulo si no hay rastreo previo)
getCrawlerStatus
Obtén el estado actual del rastreador.
Devuelve:
state: Uno deIDLE,CRAWLING,PAUSEDoWATCHING
pauseCrawler
Pausa una operación de rastreo en curso. El rastreador se puede reanudar más tarde con resumeCrawler.
resumeCrawler
Reanuda una operación de rastreo pausada.
listCrawlableDirectories
Lista todos los directorios rastreables configurados.
Devuelve:
success: Booleano que indica el éxito de la operacióndirectories: Lista de rutas de directorio absolutas actualmente configuradastotalDirectories: Conteo de directorios configuradosconfigPath: Ruta al archivo de configuración (~/.mcplucene/config.yaml)environmentOverride: Booleano que indica si la variable de entornoLUCENE_CRAWLER_DIRECTORIESestá configurada
Ejemplo de respuesta:
{
  "success": true,
  "directories": [
    "/Users/yourname/Documents",
    "/Users/yourname/Downloads"
  ],
  "totalDirectories": 2,
  "configPath": "/Users/yourname/.mcplucene/config.yaml",
  "environmentOverride": false
}
addCrawlableDirectory
Agrega un directorio a la configuración del rastreador.
Parámetros:
path(obligatorio): Ruta absoluta al directorio a rastrearcrawlNow(opcional): Si es verdadero, comienza inmediatamente a rastrear el nuevo directorio (predeterminado: falso)
Devuelve:
success: Booleano que indica el éxito de la operaciónmessage: Mensaje de confirmacióntotalDirectories: Conteo actualizado de directorios configuradosdirectories: Lista actualizada de todos los directorioscrawlStarted(opcional): Presente sicrawlNow=true, indica que se activó el rastreo
Validación:
- El directorio debe existir y ser accesible
- La ruta debe ser un directorio (no un archivo)
- Se evitan directorios duplicados
- Falla si la variable de entorno
LUCENE_CRAWLER_DIRECTORIESestá configurada
Ejemplo:
Ask Claude: "Add /Users/yourname/Documents as a crawlable directory"
Ask Claude: "Add /path/to/research and crawl it now"
Persistencia de Configuración:
El directorio se guarda inmediatamente en ~/.mcplucene/config.yaml y se rastreará automáticamente en futuros reinicios del servidor.
removeCrawlableDirectory
Elimina un directorio de la configuración del rastreador.
Parámetros:
path(obligatorio): Ruta absoluta al directorio a eliminar
Devuelve:
success: Booleano que indica el éxito de la operaciónmessage: Mensaje de confirmacióntotalDirectories: Conteo actualizado de directorios configuradosdirectories: Lista actualizada de directorios restantes
Notas Importantes:
- Esto NO elimina documentos ya indexados del directorio eliminado
- Para eliminar documentos indexados, usa
startCrawl(fullReindex=true)después de eliminar directorios - Falla si la variable de entorno
LUCENE_CRAWLER_DIRECTORIESestá configurada - El directorio debe existir en la configuración actual
Ejemplo:
Ask Claude: "Stop crawling /Users/yourname/Downloads"
Ask Claude: "Remove /path/to/old/archive from the crawler"
Herramientas de Información del Índice (grupo: info)
getIndexStats
Obtén estadísticas sobre el índice de Lucene, incluyendo métricas de rendimiento de caché del lematizador, percentiles de tiempo de ejecución de consultas (p50-p99) y tiempos de cálculo de facetas por campo.
Devuelve:
documentCount: Número total de documentos en el índiceindexPath: Ruta al directorio del índiceschemaVersion: Versión actual del esquema del índicesoftwareVersion: Versión del software del servidorbuildTimestamp: Marca de tiempo de compilación del servidordateFieldHints: Rangos mín/máx de fechas para campos de fecha (created_date,modified_date,indexed_date) en formato ISO-8601 — útil para construir filtros de rango de fechassortableFields: Mapa de camposdbmeta_*ordenables registrados dinámicamente desde el enriquecimiento de metadatos JDBC a su tipo de ordenación ("numeric"o"keyword"). Nulo cuando no hay enriquecimiento JDBC que haya registrado campos ordenables. Usa esto para descubrir qué camposdbmeta_*se pueden pasar comosortBy. Los campos nativos (file_size,created_date,modified_date) siempre son ordenables y no se listan aquí.lemmatizerCacheMetrics: Métricas de rendimiento para los cachés del lematizador OpenNLP (uno por idioma: alemán e inglés)language: Código de idioma (de o en)hitRate: Tasa de aciertos de caché como porcentaje (ej., "85.3%")totalHits: Número de veces que un token se encontró en el cachétotalMisses: Número de veces que un token requirió lematizacióncacheSize: Número actual de entradas en el cachéevictions: Número de entradas de caché expulsadas debido a límites de tamaño
queryRuntimeMetrics: Estadísticas agregadas de rendimiento de consultas de búsqueda (nulo antes de que se ejecuten búsquedas)totalQueries: Número total de consultas de búsqueda ejecutadas desde el inicio del servidoraverageDurationMs: Duración promedio de consulta en milisegundos (ej., "12.5")minDurationMs: Duración de consulta más rápida en milisegundosmaxDurationMs: Duración de consulta más lenta en milisegundosaverageHitCount: Número promedio de documentos coincidentes por consulta (ej., "42.3")p50Ms/p75Ms/p90Ms/p95Ms/p99Ms: Percentiles de duración de consulta en milisegundos (calculados de las últimas 1000 consultas)averageFacetDurationMs: Tiempo promedio de cálculo de facetas por consulta en milisegundos (ej., "0.125")perFieldAverageFacetDurationMs: Tiempo promedio de cálculo de facetas por campo en milisegundos (ej.,{"language": "0.031", "file_extension": "0.028", ...})
Rendimiento del Caché del Lematizador:
El servidor utiliza caché de token único para la lematización OpenNLP para reducir el uso de CPU durante la indexación y consulta. Cada analizador de idioma (alemán e inglés) mantiene un caché LRU compartido con hasta 1,500,000 entradas, compartido entre todos los hilos de indexación de Lucene. El caché utiliza claves insensibles a mayúsculas para palabras comunes (ej., "Vertrag" y "vertrag" comparten la misma entrada de caché) mientras mantiene los nombres propios sensibles a mayúsculas (ej., "Berlin" vs "berlin").
Métricas Clave:
- Tasa de Aciertos: Más alta es mejor. 85-95% es típico después de indexar unos pocos miles de documentos. Tasas de aciertos más altas significan menos uso de CPU.
- Tamaño del Caché: Número actual de asignaciones (token, etiqueta POS) a lema almacenadas en caché. Crece hasta 1,500,000 entradas por idioma.
- Expulsiones: Cuántas entradas se han eliminado para hacer espacio para nuevas. Algunas expulsiones son normales con conjuntos de documentos grandes. Impacto en el rendimiento: Sin caché, la lematización puede consumir el 70-80% de la CPU durante la indexación. Con caché, el uso de CPU típicamente baja al 20-30%, resultando en un rendimiento de indexación 2-3 veces más rápido para conjuntos de documentos con vocabulario repetitivo.
listIndexedFields
Lista todos los nombres de campos presentes en el índice de Lucene.
Devuelve:
fields: Matriz de nombres de campos disponibles para búsqueda y filtrado
Ejemplo de respuesta:
{
  "success": true,
  "fields": [
    "file_name",
    "file_path",
    "title",
    "author",
    "content",
    "language",
    "file_extension",
    "file_type",
    "created_date",
    "modified_date"
  ]
}
getDocumentDetails
Recupera todos los campos almacenados y el contenido completo de un documento del índice de Lucene por su ruta de archivo. Esta herramienta recupera los detalles del documento directamente del índice sin requerir acceso al sistema de archivos - útil para examinar contenido indexado incluso si el archivo original ha sido movido o eliminado.
Parámetros:
filePath(obligatorio): Ruta absoluta al archivo (debe coincidir exactamente con elfile_pathalmacenado en el índice)
Devuelve:
success: Booleano que indica el éxito de la operacióndocument: Objeto que contiene todos los campos almacenados:file_path: Ruta completa al archivofile_name: Nombre del archivofile_extension: Extensión del archivo (p. ej.,pdf,docx)file_type: Tipo MIMEfile_size: Tamaño del archivo en bytestitle: Título del documentoauthor: Nombre del autorcreator: Aplicación creadorasubject: Asunto del documentokeywords: Palabras clave/etiquetas del documentolanguage: Código de idioma detectadocreated_date: Marca de tiempo de creaciónmodified_date: Marca de tiempo de modificaciónindexed_date: Marca de tiempo de indexacióncontent_hash: Hash SHA-256 del contenidocontent: Contenido de texto extraído completo (limitado a 500KB)contentTruncated: Booleano que indica si el contenido fue truncadooriginalContentLength: Longitud original del contenido (solo presente si fue truncado)
Límite de tamaño de contenido:
El campo content está limitado a 500,000 caracteres (500KB) para asegurar que la respuesta se mantenga por debajo del límite de respuesta MCP de 1MB. Verifique el campo contentTruncated para determinar si se devolvió el contenido completo.
Ejemplo:
Ask Claude: "Show me the indexed details of /Users/yourname/Documents/report.pdf"
Ask Claude: "What content was extracted from /path/to/contract.docx?"
Ejemplo de respuesta:
{
  "success": true,
  "document": {
    "file_path": "/Users/yourname/Documents/report.pdf",
    "file_name": "report.pdf",
    "file_extension": "pdf",
    "file_type": "application/pdf",
    "file_size": "125432",
    "title": "Annual Report 2024",
    "author": "John Doe",
    "language": "en",
    "indexed_date": "1706540400000",
    "content_hash": "a1b2c3d4...",
    "content": "This is the full extracted text content of the document...",
    "contentTruncated": false
  }
}
Herramientas de Observabilidad (grupo: observability)
suggestTerms
Sugiere términos del índice que coincidan con un prefijo. Útil para descubrir vocabulario, encontrar palabras compuestas en alemán, explorar nombres de autores o autocompletar valores de campos.
Parámetros:
field(obligatorio): Nombre del campo del cual sugerir términos (p. ej.content,author,file_extension)prefix(obligatorio): Prefijo para comparar términos (p. ej.verpara encontrarvertrag,version)limit(opcional): Número máximo de términos a devolver (predeterminado: 20, máximo: 100)
Notas:
- Para campos analizados (
content,title, etc.), el prefijo se convierte automáticamente a minúsculas para coincidir con los tokens indexados - Para StringFields (
file_extension,language), el prefijo se usa tal cual (coincidencia exacta) - Los campos numéricos/de fecha (
file_size,modified_date, etc.) no son compatibles — usegetIndexStatspara rangos de fechas - Devuelve términos ordenados por frecuencia de documentos (los más comunes primero)
- Devuelve resultados vacíos para campos inexistentes (no es un error)
Ejemplo — descubrir palabras compuestas en alemán:
{
  "field": "content",
  "prefix": "vertrag",
  "limit": 10
}
Ejemplo de respuesta:
{
  "success": true,
  "field": "content",
  "prefix": "vertrag",
  "terms": [
    {"term": "vertrag", "docFreq": 45},
    {"term": "vertrags", "docFreq": 23},
    {"term": "vertragsklausel", "docFreq": 8},
    {"term": "vertragsbedingungen", "docFreq": 5}
  ],
  "totalTermsMatched": 4
}
getTopTerms
Obtiene los términos más frecuentes en un campo. Útil para comprender el vocabulario del índice, descubrir valores comunes (idiomas, tipos de archivo, autores) e identificar términos dominantes.
Parámetros:
field(obligatorio): Nombre del campo del cual obtener los términos principales (p. ej.content,author,file_extension)limit(opcional): Número máximo de términos a devolver (predeterminado: 20, máximo: 100)
Notas:
- Devuelve términos ordenados por frecuencia de documentos (los más comunes primero)
- Para campos de contenido grandes (>100K términos únicos), se incluye una advertencia sugiriendo
suggestTermsen su lugar - Los campos numéricos/de fecha no son compatibles — use
getIndexStatspara rangos de fechas - Devuelve resultados vacíos para campos inexistentes (no es un error)
Ejemplo — explorar tipos de archivo en el índice:
{
  "field": "file_extension",
  "limit": 10
}
Ejemplo de respuesta:
{
  "success": true,
  "field": "file_extension",
  "terms": [
    {"term": "pdf", "docFreq": 234},
    {"term": "docx", "docFreq": 156},
    {"term": "txt", "docFreq": 89},
    {"term": "md", "docFreq": 45}
  ],
  "uniqueTermCount": 12
}
Ejemplo — explorar vocabulario de contenido:
{
  "field": "content",
  "limit": 20
}
Herramientas de Administración (grupo: admin)
indexAdmin
Una aplicación MCP que proporciona una interfaz de usuario visual para tareas de mantenimiento del índice directamente dentro de su cliente MCP (p. ej., Claude Desktop). Cuando se invoca, la aplicación se renderiza en línea en la conversación y ofrece acceso con un clic a operaciones administrativas sin requerir llamadas manuales a herramientas.
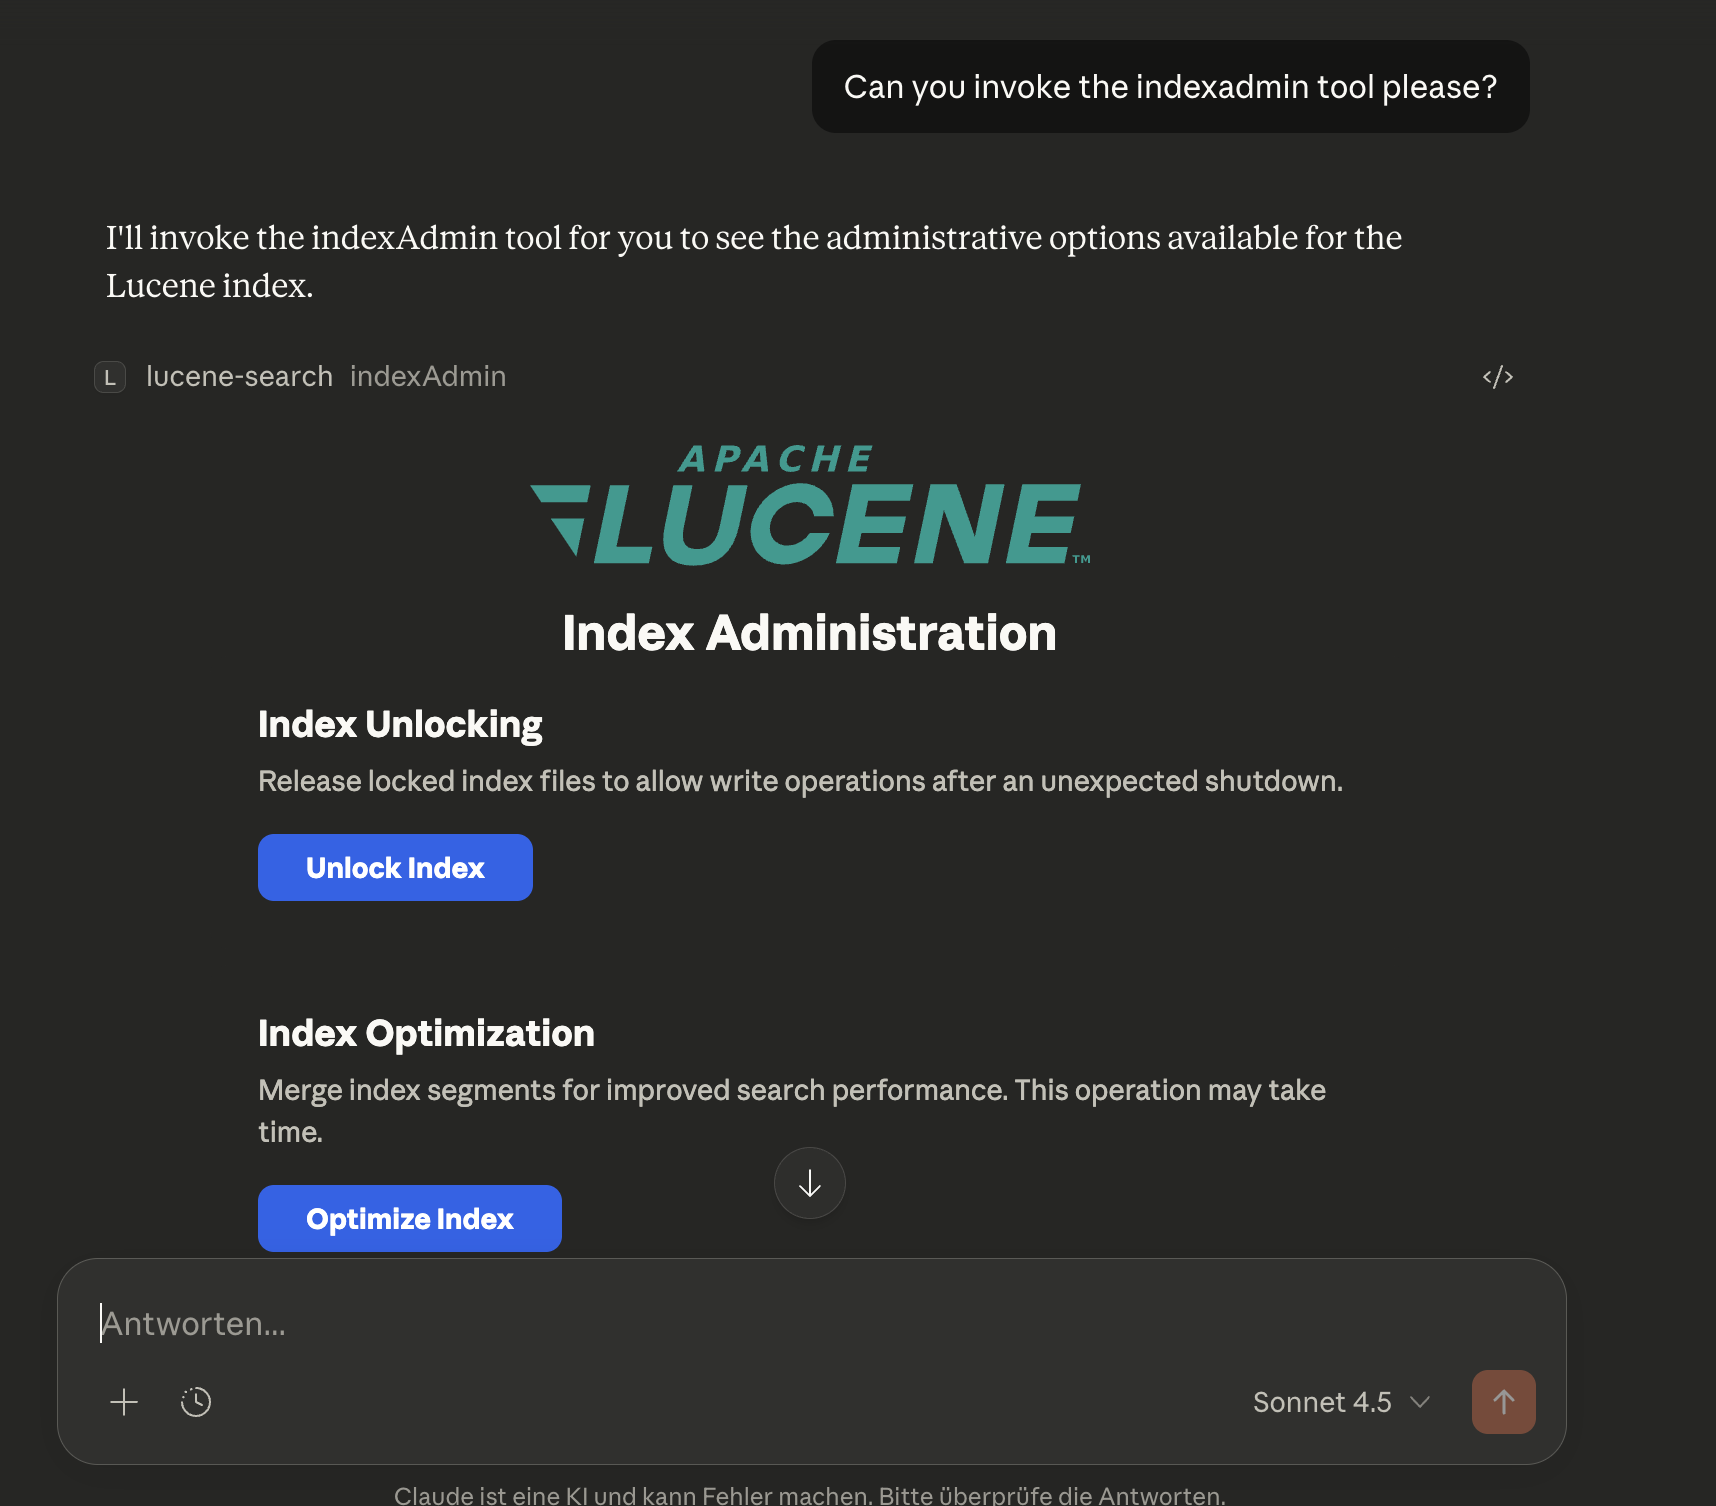
Acciones disponibles:
- Desbloquear Índice -- Elimina un archivo
write.lockobsoleto después de un cierre incorrecto (equivalente a llamar aunlockIndexconconfirm=true) - Optimizar Índice -- Fusiona segmentos del índice para mejorar el rendimiento de búsqueda (equivalente a llamar a
optimizeIndex) - Purgar Índice -- Elimina todos los documentos del índice (equivalente a llamar a
purgeIndexconconfirm=true)
Cada acción muestra retroalimentación de estado en línea (éxito, error o detalles de progreso) directamente en la interfaz de la aplicación.
Ejemplo:
Ask Claude: "Can you invoke the indexAdmin tool please?"
optimizeIndex
Optimiza el índice de Lucene fusionando segmentos. Esta es una operación de larga duración que se ejecuta en segundo plano.
Parámetros:
maxSegments(opcional): Número objetivo de segmentos después de la optimización (predeterminado: 1 para máxima optimización)
Devuelve:
success: Booleano que indica que la operación fue iniciadaoperationId: UUID para rastrear la operacióntargetSegments: El número objetivo de segmentoscurrentSegments: El número actual de segmentos antes de la optimizaciónmessage: Mensaje de estado
Comportamiento:
- Devuelve inmediatamente después de iniciar la operación en segundo plano
- Use
getIndexAdminStatuspara consultar el progreso - No puede ejecutarse mientras el rastreador está activamente rastreando
- Solo una operación de administración puede ejecutarse a la vez
Ejemplo:
Ask Claude: "Optimize the search index"
Ask Claude: "What's the status of the optimization?"
Notas de rendimiento:
- La optimización mejora el rendimiento de búsqueda al reducir el número de segmentos
- Aumenta temporalmente el uso de disco durante la fusión
- Para índices grandes, esto puede tomar desde varios minutos hasta horas
purgeIndex
Elimina todos los documentos del índice de Lucene. Esta es una operación destructiva de larga duración que se ejecuta en segundo plano.
Parámetros:
confirm(obligatorio): Debe establecerse entruepara continuar. Esta es una medida de seguridad.fullPurge(opcional): Si estrue, también elimina los archivos del índice y reinicializa (predeterminado:false)
Devuelve:
success: Booleano que indica que la operación fue iniciadaoperationId: UUID para rastrear la operacióndocumentsDeleted: Número de documentos que serán eliminadosfullPurge: Si se solicitó una purga completamessage: Mensaje de estado
Comportamiento:
- Devuelve inmediatamente después de iniciar la operación en segundo plano
- Use
getIndexAdminStatuspara consultar el progreso - Solo una operación de administración puede ejecutarse a la vez
Modos de purga:
- Purga estándar (
fullPurge=false): Elimina todos los documentos pero conserva los archivos del índice. El espacio en disco se recupera gradualmente durante futuras fusiones. - Purga completa (
fullPurge=true): Elimina todos los documentos Y los archivos del índice, luego reinicializa un índice vacío. El espacio en disco se recupera inmediatamente.
Ejemplo:
Ask Claude: "Delete all documents from the index - I confirm this"
Ask Claude: "Purge the index completely and reclaim disk space - I confirm this"
Advertencia: Esta operación no se puede deshacer. Todos los documentos indexados serán eliminados permanentemente. Necesitará volver a rastrear los directorios para repoblar el índice.
unlockIndex
Elimina el archivo write.lock del directorio del índice de Lucene. Esta es una operación de recuperación peligrosa - úsela solo si está seguro de que ningún otro proceso está usando el índice.
Parámetros:
confirm(obligatorio): Debe establecerse entruepara continuar. Esta es una medida de seguridad.
Devuelve:
success: Booleano que indica el éxito de la operaciónmessage: Mensaje de confirmaciónlockFileExisted: Booleano que indica si un archivo de bloqueo estaba presentelockFilePath: Ruta al archivo de bloqueo
Cuándo usar:
Use esta herramienta cuando el servidor no pueda iniciarse con un LockObtainFailedException después de un cierre incorrecto. Consulte Solución de problemas para más detalles.
Ejemplo:
Ask Claude: "Unlock the Lucene index - I confirm this is safe"
Advertencia: Desbloquear un índice que está siendo escrito activamente por otro proceso puede causar corrupción de datos. Úselo solo cuando esté seguro de que el bloqueo está obsoleto.
getIndexAdminStatus
Obtiene el estado de las operaciones de administración del índice de larga duración (optimizar, purgar).
Parámetros: Ninguno
Devuelve:
success: Booleano que indica que el estado fue recuperadostate: Estado actual:IDLE,OPTIMIZING,PURGING,COMPLETEDoFAILEDoperationId: UUID de la operación actual/últimaprogressPercent: Porcentaje de progreso (0-100)progressMessage: Mensaje de progreso legible por humanoselapsedTimeMs: Tiempo transcurrido desde que comenzó la operación (en milisegundos)lastOperationResult: Mensaje de resultado de la última operación completada
Ejemplo de respuesta (durante la optimización):
{
  "success": true,
  "state": "OPTIMIZING",
  "operationId": "a1b2c3d4-...",
  "progressPercent": 45,
  "progressMessage": "Merging segments...",
  "elapsedTimeMs": 12500,
  "lastOperationResult": null
}
Ejemplo de respuesta (inactivo después de completar):
{
  "success": true,
  "state": "IDLE",
  "operationId": null,
  "progressPercent": null,
  "progressMessage": "No admin operation running",
  "elapsedTimeMs": null,
  "lastOperationResult": "Optimization completed successfully. Merged to 1 segment(s)."
}
Ejemplo:
Ask Claude: "What's the status of the index optimization?"
Ask Claude: "Is the purge operation complete?"
Configuración de Exposición de Herramientas
Controle qué herramientas MCP se exponen usando dos variables de entorno:
| Variable | Predeterminado | Descripción |
|---|---|---|
LUCENE_TOOLS_INCLUDE | * (todas las herramientas) | Nombres de herramientas separados por comas o abreviaturas de grupos para exponer |
LUCENE_TOOLS_EXCLUDE | (vacío) | Nombres de herramientas separados por comas o abreviaturas de grupos para ocultar; siempre gana sobre incluir |
Grupos de Herramientas
| Grupo | Herramientas |
|---|---|
search | simpleSearch, extendedSearch |
semantic | semanticSearch, profileSemanticSearch |
debug | profileQuery |
info | getIndexStats, listIndexedFields, getDocumentDetails |
observability | suggestTerms, getTopTerms |
crawler | startCrawl, getCrawlerStats, getCrawlerStatus, pauseCrawler, resumeCrawler, listCrawlableDirectories, addCrawlableDirectory, removeCrawlableDirectory |
admin | optimizeIndex, purgeIndex, unlockIndex, getIndexAdminStatus, indexAdmin |
Se pueden usar nombres de herramientas individuales además de las abreviaturas de grupos.
Ejemplos
# Default — all tools (semantic tools require VECTOR_MODEL)
java -jar mcpluceneserver.jar

# Small LLM — search tools only
LUCENE_TOOLS_INCLUDE=search java -jar mcpluceneserver.jar

# Search + semantic search
LUCENE_TOOLS_INCLUDE=search,semantic VECTOR_MODEL=e5-base java -jar mcpluceneserver.jar

# All tools except destructive admin
LUCENE_TOOLS_EXCLUDE=purgeIndex,unlockIndex java -jar mcpluceneserver.jar

# All tools except entire admin group
LUCENE_TOOLS_EXCLUDE=admin java -jar mcpluceneserver.jar
Esquema de Campos del Índice
Cuando los documentos son indexados por el rastreador, los siguientes campos se extraen y almacenan automáticamente:
Campos de Contenido
content: Contenido de texto completo del documento (analizado, buscable)content_reversed: Tokens invertidos del contenido (analizados conReverseUnicodeNormalizingAnalyzer, no almacenados). Se utilizan internamente para consultas eficientes de comodín inicial -- no son buscables directamente por los usuarios.content_lemma_de: Tokens lematizados utilizando el lematizador alemán de OpenNLP (analizados conOpenNLPLemmatizingAnalyzer, no almacenados). SIEMPRE presentes para TODOS los documentos independientemente del idioma detectado para permitir la coincidencia en idiomas mixtos. Se utilizan internamente para la búsqueda basada en lematización -- no son buscables directamente por los usuarios.content_lemma_en: Tokens lematizados utilizando el lematizador inglés de OpenNLP (analizados conOpenNLPLemmatizingAnalyzer, no almacenados). SIEMPRE presentes para TODOS los documentos independientemente del idioma detectado para permitir la coincidencia en idiomas mixtos. Se utilizan internamente para la búsqueda basada en lematización -- no son buscables directamente por los usuarios.content_translit_de: Campo espejo de transliteración alemana que mapea dígrafos de diéresis (ae→ä, oe→ö, ue→ü) antes de la normalización Unicode estándar (analizado conGermanTransliteratingAnalyzer, no almacenado). SIEMPRE presente para TODOS los documentos. Permite que consultas con dígrafos ASCII como "Mueller" coincidan con documentos que contienen diéresis como "Müller". Se utiliza internamente -- no es buscable directamente por los usuarios.passages: Matriz de pasajes resaltados devueltos en los resultados de búsqueda (ver Formato de Respuesta de Búsqueda a continuación)
Información del Archivo
file_path: Ruta completa al archivo (ID único)file_name: Nombre del archivofile_extension: Extensión del archivo (p. ej.,pdf,docx)file_type: Tipo MIME (p. ej.,application/pdf)file_size: Tamaño del archivo en bytes
Metadatos del Documento
title: Título del documento (extraído de los metadatos)author: Nombre del autorcreator: Creador/aplicación que creó el documentosubject: Asunto del documentokeywords: Palabras clave/etiquetas del documento
Idioma y Fechas
language: Código de idioma detectado automáticamente (p. ej.,en,de,fr)created_date: Marca de tiempo de creación del archivomodified_date: Marca de tiempo de modificación del archivoindexed_date: Cuándo se indexó el documento
Técnico
content_hash: Hash SHA-256 para detección de cambios
Formato de Respuesta de Búsqueda
Los resultados de búsqueda están optimizados para respuestas MCP (< 1 MB) e incluyen:
{
  "success": true,
  "documents": [
    {
      "score": 0.85,
      "file_name": "example.pdf",
      "file_path": "/path/to/example.pdf",
      "title": "Example Document",
      "author": "John Doe",
      "language": "en",
      "passages": [
        {
          "text": "...relevant <em>search term</em> highlighted in context...",
          "score": 1.0,
          "matchedTerms": ["search term"],
          "termCoverage": 1.0,
          "position": 0.12,
          "source": "keyword"
        },
        {
          "text": "...another occurrence of <em>search</em> in a later section...",
          "score": 0.75,
          "matchedTerms": ["search"],
          "termCoverage": 0.5,
          "position": 0.67,
          "source": "keyword"
        }
      ]
    }
  ],
  "totalHits": 42,
  "page": 0,
  "pageSize": 10,
  "totalPages": 5,
  "hasNextPage": true,
  "hasPreviousPage": false,
  "searchTimeMs": 12,
  "facets": {
    "language": [
      { "value": "en", "count": 25 },
      { "value": "de", "count": 12 },
      { "value": "fr", "count": 5 }
    ],
    "file_extension": [
      { "value": "pdf", "count": 30 },
      { "value": "docx", "count": 8 },
      { "value": "xlsx", "count": 4 }
    ],
    "file_type": [
      { "value": "application/pdf", "count": 30 },
      { "value": "application/vnd.openxmlformats-officedocument.wordprocessingml.document", "count": 8 }
    ],
    "author": [
      { "value": "John Doe", "count": 15 },
      { "value": "Jane Smith", "count": 10 }
    ]
  },
  "_search": {
    "query": "contract",
    "filters": [],
    "page": 0,
    "pageSize": 10
  },
  "_actions": [
    {
      "type": "nextPage",
      "tool": "simpleSearch",
      "parameters": { "query": "contract", "filters": [], "page": 1, "pageSize": 10 }
    },
    {
      "type": "drillDown",
      "tool": "simpleSearch",
      "parameters": { "query": "contract", "filters": [{ "field": "language", "operator": "eq", "value": "en" }], "page": 0, "pageSize": 10 },
      "hits": 25
    }
  ]
}
Cada documento en documents[] también lleva su propio bloque _actions:
{
  "score": 0.85,
  "file_path": "/path/to/example.pdf",
  "_actions": [
    {
      "type": "fetchContent",
      "tool": "getDocumentDetails",
      "parameters": { "filePath": "/path/to/example.pdf" }
    }
  ]
}
_actions Estilo HATEOAS (Encadenamiento de LLM):
Cada respuesta de búsqueda incluye dos bloques de acción precalculados que permiten a un LLM encadenar llamadas a herramientas sin razonar sobre el mapeo de parámetros:
-
_search-- Captura el estado exacto de la búsqueda (consulta, filtros, página, tamaño de página) utilizado para producir esta respuesta. Útil para introspección y para construir consultas de seguimiento. -
_actionsa nivel de respuesta -- Contiene llamadas a herramientas listas para usar para navegar por el conjunto de resultados:Tipo de acción Cuándo está presente Descripción prevPagepágina > 0 Ir a la página de resultados anterior. Pase parametersdirectamente altoolnombrado.nextPagehasNextPage = true Ir a la página de resultados siguiente. Pase parametersdirectamente altoolnombrado.drillDownfacetas disponibles Reducir los resultados añadiendo un valor de faceta como filtro. El campo hitsmuestra el recuento de resultados esperado. Limitado a los 2 valores principales por dimensión de faceta; solo se incluyen los valores que no están ya activos como filtros. -
_actionsa nivel de documento -- Cada documento endocuments[]incluye:Tipo de acción Descripción fetchContentObtener el texto completo del documento y los metadatos utilizando getDocumentDetails. ElfilePathestá prellenado.
Para usar una acción, llame al tool nombrado en la acción con el mapa parameters pasado tal cual -- no se requiere transformación.
Características clave:
-
Métricas de rendimiento de búsqueda: Cada respuesta de búsqueda incluye
searchTimeMsque muestra el tiempo de ejecución exacto en milisegundos, lo que permite la monitorización y optimización del rendimiento. -
Pasajes con resaltado: El campo
contentcompleto NO se incluye en los resultados de búsqueda para mantener los tamaños de respuesta manejables. En su lugar, cada documento contiene una matrizpassagescon hastamax-passages(predeterminado: 3) extractos resaltados individualmente. Cada pasaje es un extracto separado a nivel de oración (no una cadena unida), ordenado por relevancia (mejor primero). Los pasajes largos se truncan amax-passage-char-length(predeterminado: 200) centrados alrededor de los términos resaltados, recortando el texto inicial/final irrelevante. Cada pasaje incluye:text-- El extracto resaltado con los términos coincidentes envueltos en etiquetas<em>.score-- Puntuación de relevancia normalizada (0.0-1.0), derivada de la puntuación de pasajes BM25 de Lucene. El mejor pasaje puntúa 1.0; los demás pasajes se puntúan en relación con el mejor.matchedTerms-- Los términos de consulta distintos que aparecen en este pasaje (extraídos de las etiquetas<em>). Útil para entender qué partes de una consulta de múltiples términos satisface un pasaje.termCoverage-- La fracción de todos los términos de consulta presentes en este pasaje (0.0-1.0). Un valor de 1.0 significa que todos los términos de consulta coincidieron. Los LLM pueden usar esto para preferir pasajes que aborden la consulta completa.position-- Ubicación dentro del documento fuente (0.0 = inicio, 1.0 = fin), derivada del desplazamiento de caracteres del pasaje. Útil para citas o para entender la estructura del documento.source-- Indica cómo se produjo este pasaje:"keyword"significa que el resaltador BM25 encontró coincidencias de términos en el texto del documento indexado;"semantic"significa que se utilizó el mejor fragmento vectorial coincidente como extracto (relevante porque el documento se recuperó mediante similitud vectorial, incluso si las palabras exactas de la consulta no aparecen en el texto).
-
Facetado de Lucene: El objeto
facetsutiliza SortedSetDocValues de Lucene para una búsqueda facetada eficiente. Muestra los valores de faceta reales y los recuentos de documentos de los resultados de búsqueda, no solo los campos disponibles. Solo se devuelven las dimensiones de faceta que tienen valores en el conjunto de resultados. -
Dimensiones de faceta: Los siguientes campos están indexados como facetas:
language- Idioma del documento detectado (código ISO 639-1)file_extension- Extensión del archivo (pdf, docx, etc.)file_type- Tipo MIMEauthor- Autor del documento (multivalor)
Ejemplos de Búsqueda Facetada
Use facetas para construir consultas de profundización y refinar los resultados de búsqueda:
# Filter by file type using facet values
filters: [{ field: "file_extension", value: "pdf" }]

# Filter by language using facet values
filters: [{ field: "language", value: "de" }]

# Filter by author using facet values
filters: [{ field: "author", value: "John Doe" }]

# Combine search query with facet filter
query: "contract agreement"
filters: [{ field: "file_extension", value: "pdf" }]
Flujo de trabajo impulsado por facetas:
- Realice una búsqueda inicial con una consulta amplia
- Revise
facetsen la respuesta para ver las opciones de refinamiento disponibles - Aplique filtros usando valores de faceta para reducir los resultados
- Itere para profundizar en subconjuntos específicos
Ejemplos de Uso
Ejemplo 1: Indexe su Carpeta de Documentos
- Edite
application.yaml:
lucene:
  crawler:
    directories:
      - "/Users/yourname/Documents"
    crawl-on-startup: true
- Inicie el servidor:
java -jar target/luceneserver-0.0.1-SNAPSHOT.jar
- El rastreador se inicia automáticamente e indexa todos los documentos compatibles en su carpeta de Documentos.
Ejemplo 2: Búsqueda con Filtrado
Pregunte a Claude:
Search for "machine learning" in PDF documents only
Claude utilizará:
query: "machine learning"
filters: [{ field: "file_extension", value: "pdf" }]
Ejemplo 3: Encontrar Documentos por Autor
Pregunte a Claude:
Find all documents written by John Doe
Claude utilizará:
query: "*"
filters: [{ field: "author", value: "John Doe" }]
Ejemplo 4: Monitorear el Progreso del Rastreador
Pregunte a Claude:
Show me the crawler statistics
Claude llama a getCrawlerStats() y muestra:
- Archivos procesados: 1,234 / 5,000
- Rendimiento: 85 archivos/seg
- Indexados: 1,200 (98%)
- Fallidos: 34 (2%)
Ejemplo 5: Rastreo Manual con Reindexación Completa
Pregunte a Claude:
Reindex all documents from scratch
Claude llama a startCrawl(fullReindex: true), que:
- Limpia el índice existente
- Vuelve a rastrear todos los directorios configurados
- Indexa todos los documentos desde cero
Ejemplo 6: Búsqueda Específica por Idioma
Pregunte a Claude:
Find German documents about "Technologie"
Claude utiliza:
query: "Technologie"
filters: [{ field: "language", value: "de" }]
Ejemplo 7: Búsqueda con Pasajes
Los resultados de búsqueda incluyen una matriz passages con extractos resaltados y metadatos de calidad:
{
  "file_name": "report.pdf",
  "passages": [
    {
      "text": "...discusses the impact of <em>machine learning</em> on modern software development. The study shows...",
      "score": 1.0,
      "matchedTerms": ["machine learning"],
      "termCoverage": 1.0,
      "position": 0.08,
      "source": "keyword"
    },
    {
      "text": "...<em>machine learning</em> algorithms were applied to the dataset in Section 4...",
      "score": 0.75,
      "matchedTerms": ["machine learning"],
      "termCoverage": 1.0,
      "position": 0.45,
      "source": "keyword"
    }
  ]
}
Esto le permite ver extractos relevantes sin descargar el documento completo. Los campos de metadatos ayudan a los LLM a identificar rápidamente el mejor pasaje: prefiera pasajes con termCoverage alto (cubre más de la consulta), use position para el contexto de la estructura del documento, y verifique source para entender si el pasaje se encontró por coincidencia de palabras clave ("keyword") o por similitud vectorial ("semantic").
Ejemplo 8: Gestión de Directorios Rastreables en Tiempo de Ejecución
Pregunte a Claude para gestionar directorios sin editar archivos de configuración:
"What directories are currently being crawled?"
# Claude calls listCrawlableDirectories()
# Response: Shows all configured directories and config file location

"Add /Users/yourname/Research as a crawlable directory"
# Claude calls addCrawlableDirectory(path="/Users/yourname/Research")
# Directory is added to ~/.mcplucene/config.yaml

"Add /Users/yourname/Projects and start crawling it now"
# Claude calls addCrawlableDirectory(path="/Users/yourname/Projects", crawlNow=true)
# Directory is added and crawl starts immediately

"Stop crawling /Users/yourname/Downloads"
# Claude calls removeCrawlableDirectory(path="/Users/yourname/Downloads")
# Directory is removed from config (indexed documents remain)
Persistencia de configuración:
Los directorios que agregue mediante las herramientas MCP se guardan en ~/.mcplucene/config.yaml:
lucene:
  crawler:
    directories:
      - /Users/yourname/Documents
      - /Users/yourname/Research
      - /Users/yourname/Projects
Esta configuración persiste entre reinicios del servidor -- no es necesario reconfigurar cada vez.
Anulación mediante variable de entorno:
Si establece la variable de entorno LUCENE_CRAWLER_DIRECTORIES, esta tiene prioridad:
{
  "mcpServers": {
    "lucene-search": {
      "command": "java",
      "args": ["-Dspring.profiles.active=deployed", "-jar", "/path/to/jar"],
      "env": {
        "LUCENE_CRAWLER_DIRECTORIES": "/path1,/path2"
      }
    }
  }
}
Cuando esto está establecido, addCrawlableDirectory y removeCrawlableDirectory devolverán un mensaje de error indicando que la anulación del entorno está activa.
Ejemplo 9: Trabajar con Búsqueda Léxica (Sinónimos y Variaciones)
Nota: Cuando use este servidor a través de Claude u otro asistente de IA, la expansión de sinónimos ocurre automáticamente -- la IA construye consultas OR por usted basándose en su solicitud en lenguaje natural. Los ejemplos a continuación muestran la sintaxis de consulta subyacente como referencia o para uso directo de la API.
Dado que el motor de búsqueda realiza coincidencia léxica exacta sin expansión automática de sinónimos, debe incluir explícitamente sinónimos y variaciones de palabras en su consulta:
Búsqueda básica (podría omitir resultados relevantes):
query: "car"
Esto SOLO coincidirá con documentos que contengan la palabra exacta "car", omitiendo documentos con "automobile", "vehicle", etc.
Mejor: Incluya sinónimos con OR:
query: "(car OR automobile OR vehicle)"
Mejor aún: Combine sinónimos con comodines para variaciones:
query: "(car* OR automobile* OR vehicle*)"
Esto coincide con: car, cars, automobile, automobiles, vehicle, vehicles, etc.
Ejemplo del mundo real - Encontrar contratos:
query: "(contract* OR agreement* OR deal*) AND (sign* OR execut* OR finali*)"
filters: [{ field: "file_extension", value: "pdf" }]
Esto encontrará documentos que contengan variaciones como:
- "contract signed", "agreement executed", "deal finalized"
- "contracts signing", "agreements execute", "deals finalizing"
Consejo: Use el facets en la respuesta de búsqueda para descubrir los términos exactos utilizados en sus documentos y luego refine su consulta en consecuencia.
Características del Rastreador de Documentos
Rastreo Automático
El rastreador se inicia automáticamente al iniciar el servidor (si crawl-on-startup: true) y:
- Descubre archivos que coinciden con los patrones de inclusión en los directorios configurados
- Extrae contenido usando Apache Tika (admite más de 100 formatos de archivo)
- Detecta el idioma automáticamente para cada documento
- Extrae metadatos (autor, título, fechas, etc.)
- Indexa documentos en lotes para un rendimiento óptimo
- Monitorea directorios para detectar cambios (crear, modificar, eliminar)
Indexación Incremental (Reconciliación)
De forma predeterminada (reconciliation-enabled: true), cada rastreo que no sea una reindexación completa realiza primero un paso incremental. Esto hace que los rastreos repetidos sean significativamente más rápidos porque los archivos sin cambios nunca se vuelven a procesar.
Cómo funciona:
- Instantánea del índice -- Todos los pares
(file_path, modified_date)se leen del índice de Lucene. - Instantánea del sistema de archivos -- Se recorren los directorios configurados y se recopilan los pares
(file_path, mtime)actuales (sin extracción de contenido en esta etapa). - Se calcula una comparación de cuatro vías:
- DELETE -- rutas en el índice que ya no existen en el disco (huérfanas).
- ADD -- rutas en el disco que aún no están en el índice.
- UPDATE -- rutas donde la fecha de modificación en disco es más reciente que el
modified_datealmacenado. - SKIP -- rutas que son idénticas; estas nunca se modifican.
- Las eliminaciones de huérfanos se aplican primero (eliminación masiva mediante una única consulta de Lucene).
- Solo los archivos ADD y UPDATE se rastrean, extraen e indexan.
- Al completarse con éxito, el estado del rastreo (marca de tiempo, número de documentos, modo) se persiste en
~/.mcplucene/crawl-state.yaml.
Comportamiento de respaldo: Si la reconciliación falla por cualquier motivo (error de E/S al leer el índice, fallo al recorrer el sistema de archivos, etc.), el sistema recurre automáticamente a un rastreo completo. No se pierden datos y no se requiere intervención manual.
Deshabilitar la indexación incremental:
Establezca reconciliation-enabled: false en application.yaml para realizar siempre un rastreo completo. Alternativamente, pase fullReindex: true a startCrawl para forzar un único rastreo completo sin cambiar el valor predeterminado.
Archivo de estado persistido:
~/.mcplucene/crawl-state.yaml
Este archivo registra la hora de finalización, el número de documentos y el modo del último rastreo exitoso. Solo se escribe después de que un rastreo se completa con éxito.
Gestión de la versión del esquema
El servidor realiza un seguimiento de la versión del esquema del índice para detectar cuándo cambia el esquema entre actualizaciones de software. Esto elimina la necesidad de reindexar manualmente después de las actualizaciones.
Cómo funciona:
- Cada versión incorpora una constante
SCHEMA_VERSIONque refleja el esquema de campos del índice actual. - La versión del esquema se persiste en los metadatos de confirmación de Lucene junto con la versión del software.
- Al iniciarse, el servidor compara la versión del esquema almacenada con la actual.
- Si difieren (o si un índice heredado no tiene versión), se activa automáticamente una reindexación completa.
Qué provoca un cambio de versión del esquema:
- Agregar o eliminar campos indexados
- Cambiar los analizadores de campos
- Modificar las opciones de indexación de campos (almacenados, vectores de términos, etc.)
Comprobación de la información de versión:
Use getIndexStats para ver la versión actual del esquema, la versión del software y la marca de tiempo de compilación.
Monitoreo en tiempo real
Con la supervisión de directorios habilitada (watch-enabled: true):
- Los archivos nuevos se indexan automáticamente cuando se agregan
- Los archivos modificados se reindexan con contenido actualizado
- Los archivos eliminados se eliminan del índice
Optimización del rendimiento
Multihilo:
- Rastrea múltiples directorios en paralelo (grupo de subprocesos configurable)
- Cada directorio se procesa en un subproceso separado
Procesamiento por lotes:
- Los documentos se indexan en lotes (predeterminado: 100 documentos)
- Reduce la sobrecarga de E/S y mejora la velocidad de indexación
Optimización NRT (casi en tiempo real):
- Operación normal: intervalo de actualización de 100 ms para actualizaciones rápidas de búsqueda
- Indexación masiva (>1000 archivos): se reduce automáticamente a 5 s para disminuir la sobrecarga
- Se restaura a 100 ms después de que se completa la operación masiva
Notificaciones de progreso:
- Basadas en temporizador: actualizaciones cada 30 segundos (configurable mediante
progress-notification-interval-ms) - Muestran el rendimiento (archivos/seg, MB/seg), el progreso y los nombres de archivo que se están procesando actualmente
- No bloqueantes: aparecen en el área de notificaciones del sistema sin interrumpir el flujo de trabajo
- macOS: las notificaciones aparecen en el Centro de notificaciones (esquina superior derecha)
- Windows: notificaciones toast en el área de la bandeja del sistema
- Linux: utiliza notify-send para notificaciones de escritorio
Manejo de errores
- Los archivos con errores se registran pero no detienen el rastreo
- Las estadísticas registran archivos exitosos frente a fallidos
- Los documentos grandes se indexan por completo (sin truncamiento por defecto)
- Los archivos corruptos o inaccesibles se omiten de forma controlada
Solución de problemas
¿Dónde encontrar los registros?
Cuando se ejecuta con el perfil deployed, el registro en consola está deshabilitado para garantizar una comunicación STDIO limpia con los clientes MCP. En su lugar, los registros se escriben en archivos en:
~/.mcplucene/log/mcplucene.log
El directorio de registros es ${user.home}/.mcplucene/log por defecto (configurado en logback.xml). Los archivos de registro se rotan automáticamente:
- Máximo 10 MB por archivo
- Se conservan hasta 5 archivos de registro
- Tamaño total limitado a 50 MB
Para ver los registros recientes:
# View the current log file
cat ~/.mcplucene/log/mcplucene.log

# Follow logs in real-time
tail -f ~/.mcplucene/log/mcplucene.log

# View last 100 lines
tail -n 100 ~/.mcplucene/log/mcplucene.log
Durante el desarrollo (sin el perfil deployed), los registros se escriben en la consola en lugar de en archivos.
Cambios de versión del esquema y reindexación automática
El servidor ahora incluye gestión automática de la versión del esquema. Cuando actualiza a una nueva versión que cambia el esquema del índice (por ejemplo, agrega nuevos campos, cambia analizadores o modifica las opciones de indexación de campos), el servidor detecta la discrepancia de versión al iniciarse y activa automáticamente una reindexación completa.
Qué sucede:
- Al iniciarse, el servidor compara la versión del esquema almacenada con la versión actual
- Si difieren, se activa automáticamente una reindexación completa
- Verá un mensaje de registro:
Schema version changed — triggering full reindex - La reindexación se ejecuta en segundo plano; puede comprobar el progreso con
getCrawlerStats
Reindexación manual: Si necesita forzar una reindexación manual por cualquier motivo, aún puede activarla:
Ask Claude: "Reindex all documents from scratch"
Esto llama a startCrawl(fullReindex: true), que limpia el índice existente y vuelve a rastrear todos los directorios configurados.
Información de versión:
Use getIndexStats para ver la versión actual del esquema, la versión del software y la marca de tiempo de compilación.
El archivo de bloqueo del índice impide el inicio (write.lock)
Síntoma: el servidor no se inicia con un error como Lock held by another program o LockObtainFailedException.
Causa: cuando el servidor MCP no se apaga correctamente (por ejemplo, el proceso se terminó a la fuerza, el sistema se bloqueó o Claude Desktop se cerró abruptamente), Lucene puede dejar un archivo write.lock en el directorio del índice. Este archivo de bloqueo se utiliza para evitar que varios procesos escriban en el mismo índice simultáneamente. Cuando queda después de un apagado incorrecto, bloquea el inicio del servidor porque Lucene cree que otro proceso todavía está usando el índice.
Solución: elimine el archivo de bloqueo manualmente:
# Remove the write.lock file from the index directory
rm ~/.mcplucene/luceneindex/write.lock
Después de eliminar el archivo de bloqueo, el servidor debería iniciarse normalmente.
Prevención: intente cerrar Claude Desktop correctamente cuando sea posible. Si necesita forzar la salida, tenga en cuenta que es posible que deba eliminar el archivo de bloqueo antes del siguiente inicio.
Nota: la ruta del índice predeterminada es ~/.mcplucene/luceneindex. Si ha configurado una ruta de índice personalizada mediante LUCENE_INDEX_PATH o application.yaml, busque el archivo write.lock en ese directorio en su lugar.
El servidor aparece como "en ejecución" pero las herramientas no funcionan
Esto generalmente indica problemas de comunicación STDIO:
- Asegúrese de que el argumento
-Dspring.profiles.active=deployedesté presente en la configuración - Compruebe que no se esté escribiendo otra salida en stdout
- Verifique que la ruta del JAR sea una ruta absoluta, no relativa
- Si modificó la configuración, asegúrese de que los ajustes del perfil "deployed" sean correctos
Claude Desktop no muestra el servidor
- Verifique que la ruta del archivo JAR en la configuración sea correcta y absoluta
- Compruebe que Java 25+ esté instalado:
java -version - Valide la sintaxis JSON en el archivo de configuración
- Revise los registros de Claude Desktop para ver mensajes de error
- Intente ejecutar el JAR manualmente para comprobar si hay errores de inicio:
java -jar /path/to/luceneserver-0.0.1-SNAPSHOT.jar
El servidor no se inicia
- Asegúrese de que la ruta del directorio del índice de Lucene sea válida
- Compruebe que ningún otro proceso esté bloqueando el directorio del índice
- Verifique que haya suficiente espacio en disco para el índice
Resultados de búsqueda vacíos
El índice puede estar vacío por varias razones:
- No hay directorios configurados: agregue directorios a
application.yamlbajolucene.crawler.directories - El rastreador no se ha iniciado: use la herramienta MCP
startCrawlo habilitecrawl-on-startup: true - No hay archivos coincidentes: compruebe que sus directorios contengan archivos que coincidan con los patrones de inclusión
- Archivos que no se pudieron indexar: revise los registros para ver errores, use
getCrawlerStatspara ver el número de archivos fallidos
El rastreador no indexa archivos
- Compruebe las rutas de directorio: asegúrese de que las rutas en
application.yamlsean absolutas y existan - Verifique los permisos de archivo: el servidor necesita acceso de lectura a todos los archivos
- Compruebe los patrones de inclusión: los archivos deben coincidir con al menos un patrón de inclusión
- Compruebe los patrones de exclusión: los archivos no deben coincidir con ningún patrón de exclusión
- Supervise el estado del rastreador: use las herramientas MCP
getCrawlerStatusygetCrawlerStats - Revise los registros: busque errores de análisis o excepciones de E/S
Errores de memoria insuficiente durante la indexación
Si encuentra errores OOM con documentos muy grandes:
- Establezca el límite de contenido: cambie
max-content-lengthenapplication.yaml(por ejemplo,5242880para 5 MB) - Aumente el montón de JVM: agregue
-Xmx2ga los argumentos de JVM en la configuración de Claude Desktop - Reduzca el grupo de subprocesos: baje
thread-pool-sizepara reducir el procesamiento concurrente - Reduzca el tamaño del lote: baje
batch-sizepara confirmar con más frecuencia
Rendimiento de indexación lento
- Aumente el grupo de subprocesos: suba
thread-pool-size(predeterminado: 4) - Aumente el tamaño del lote: suba
batch-sizepara menos confirmaciones (predeterminado: 100) - Desactive la detección de idioma: establezca
detect-language: falsesi no es necesario - Desactive la extracción de metadatos: establezca
extract-metadata: falsesi no es necesario - Compruebe la E/S del disco: un disco lento puede convertirse en un cuello de botella para la indexación
Consideraciones de seguridad
Contenido de documentos no confiable
El MCP Lucene Server indexa documentos de directorios rastreados y devuelve su contenido (pasajes, metadatos, texto completo) en las respuestas de las herramientas MCP. Este contenido es inherentemente no confiable: cualquier documento colocado en un directorio rastreado puede influir en lo que el cliente MCP (LLM) ve en las respuestas de las herramientas.
Riesgo de inyección indirecta de prompts
Esto crea un potencial de inyección indirecta de prompts: un documento creado maliciosamente podría contener texto diseñado para manipular un LLM que procesa los resultados de búsqueda. Por ejemplo, un documento podría incluir instrucciones que parecen texto natural pero que están destinadas a influir en el comportamiento o las respuestas del LLM.
Recomendaciones
- Los clientes MCP deben tratar todo el contenido derivado de documentos en las respuestas de las herramientas como datos no confiables
- El servidor agrega un campo
contentNotea las respuestas que contienen contenido de documentos como recordatorio - Considere el nivel de confianza de los directorios rastreados al configurar el servidor
- Tenga en cuenta que el contenido indexado puede influir en el comportamiento del LLM a través de los resultados de búsqueda
Esta es una característica inherente de los sistemas que recuperan y presentan contenido externo a los modelos de lenguaje.
Opciones de configuración
Nota: La Guía de inicio rápido anterior usa configuración cero. Esta sección cubre opciones avanzadas de personalización.
El servidor se puede configurar mediante variables de entorno y application.yaml:
Perfiles de registro
El servidor admite dos perfiles de registro (por compatibilidad con versiones anteriores, usa la misma propiedad del sistema que Spring Boot):
| Perfil | Uso | Salida de registro |
|---|---|---|
| default | Desarrollo en IDE | Registro en consola habilitado |
| deployed | Producción/Claude Desktop | Solo registro en archivo |
Perfil predeterminado (sin perfil especificado):
- Registro completo habilitado en consola
- Adecuado para depuración y desarrollo
Perfil deployed (-Dspring.profiles.active=deployed):
- Registro en consola deshabilitado (requerido para el transporte STDIO)
- Registro en archivo habilitado (
~/.mcplucene/log/mcplucene.log) - Se usa cuando se ejecuta bajo Claude Desktop u otros clientes MCP
Configuración del transporte
El servidor admite dos tipos de transporte: STDIO (predeterminado) y HTTP. El transporte se selecciona mediante la propiedad del sistema mcp.transport.
Transporte STDIO (predeterminado)
El transporte STDIO es el modo predeterminado y recomendado para la integración con Claude Desktop. No se requiere configuración adicional.
Configuración de Claude Desktop:
{
  "mcpServers": {
    "lucene-search": {
      "command": "java",
      "args": [
        "--enable-native-access=ALL-UNNAMED",
        "-Xmx2g",
        "-Dspring.profiles.active=deployed",
        "-jar",
        "/absolute/path/to/luceneserver-0.0.1-SNAPSHOT.jar"
      ]
    }
  }
}
Transporte HTTP
HTTP transport permite el acceso remoto y la integración con clientes MCP basados en web utilizando el protocolo MCP Streamable HTTP (Spec 2025-03-26). Para habilitar el transporte HTTP, establezca la propiedad del sistema mcp.transport a http.
Iniciando con el transporte HTTP:
# Minimal HTTP configuration (uses defaults: 0.0.0.0:8080/mcp/message)
java --enable-native-access=ALL-UNNAMED \
  -Xmx2g \
  -Dmcp.transport=http \
  -jar luceneserver-0.0.1-SNAPSHOT.jar
Configuración HTTP personalizada:
java --enable-native-access=ALL-UNNAMED \
  -Xmx2g \
  -Dmcp.transport=http \
  -Dmcp.http.port=9000 \
  -Dmcp.http.host=localhost \
  -jar luceneserver-0.0.1-SNAPSHOT.jar
Propiedades de configuración HTTP:
| Propiedad del sistema | Predeterminado | Descripción |
|---|---|---|
mcp.transport | stdio | Tipo de transporte: stdio o http |
mcp.http.host | 0.0.0.0 | Dirección de enlace del servidor HTTP (solo modo HTTP) |
mcp.http.port | 8080 | Puerto del servidor HTTP (solo modo HTTP) |
mcp.http.endpoint | /mcp/message | Ruta del endpoint de mensajes MCP (solo modo HTTP)* |
*El /mcp/message predeterminado es el endpoint MCP estándar y normalmente no necesita cambiarse.
Notas importantes:
- El transporte HTTP utiliza el protocolo MCP Streamable HTTP con modo asíncrono sin estado
- El transporte STDIO utiliza el modo síncrono con estado (adecuado para conexiones persistentes)
- El modo HTTP no admite HTTPS/TLS: utilice un proxy inverso (nginx, Caddy) para el cifrado
- Para uso en producción con HTTP, coloque siempre el servidor detrás de un proxy inverso con autenticación adecuada
- El perfil
deployedes opcional con HTTP (el registro en consola no interferirá)
Ejemplo: Ejecución en un puerto diferente
java -Dmcp.transport=http -Dmcp.http.port=9090 -jar luceneserver-0.0.1-SNAPSHOT.jar
Ejemplo: Solo localhost (más seguro)
java -Dmcp.transport=http -Dmcp.http.host=127.0.0.1 -jar luceneserver-0.0.1-SNAPSHOT.jar
Configuración de búsqueda semántica
La búsqueda vectorial semántica es una función opcional activada al establecer la variable de entorno VECTOR_MODEL.
Habilitando la búsqueda semántica:
java --enable-native-access=ALL-UNNAMED \
  -Xmx4g \
  -Dspring.profiles.active=deployed \
  -jar luceneserver-0.0.1-SNAPSHOT.jar
# With VECTOR_MODEL set in environment:
VECTOR_MODEL=e5-base java --enable-native-access=ALL-UNNAMED \
  -Xmx4g \
  -Dspring.profiles.active=deployed \
  -jar luceneserver-0.0.1-SNAPSHOT.jar
| Variable de entorno | Predeterminado | Descripción |
|---|---|---|
VECTOR_MODEL | (ninguno) | Modelo de incrustación: e5-base (768 dimensiones, más rápido) o e5-large (1024 dimensiones, mayor calidad). Establézcalo para habilitar las herramientas de búsqueda semántica. |
Consulte SEMANTICSEARCH.md para obtener detalles completos de la arquitectura, guía de ajuste y configuración de puntuación KNN.
Nota sobre la búsqueda semántica y la brecha semántica
La búsqueda vectorial está diseñada para cerrar la brecha semántica: encontrar documentos sobre "automóvil" cuando el usuario busca "coche", porque el modelo de incrustación mapea ambos conceptos a puntos cercanos en el espacio vectorial.
Sin embargo, al usar este servidor con un LLM (Claude, GPT, etc.), la situación cambia fundamentalmente.
Un LLM ya cubre la brecha semántica como parte de su proceso de razonamiento. Antes de llamar a la herramienta de búsqueda, un LLM bien indicado puede reescribir "encontrar documentos sobre coches" en una consulta OR explícita: (car OR automobile OR vehicle OR sedan). Esto significa que el LLM maneja la expansión de sinónimos y la reformulación de consultas — exactamente el problema que la búsqueda vectorial está diseñada para resolver.
Cuando la búsqueda semántica aporta valor genuino:
- Interfaces de búsqueda directas orientadas al usuario sin LLM en el circuito
- Pipelines por lotes o automatizados sin reformulación de consultas por LLM
- Consultas que involucran jerga específica del dominio donde los sinónimos no son obvios
- Consultas conceptuales donde la redacción exacta de los documentos relevantes es desconocida
Cuando la búsqueda semántica aporta valor marginal (casos de uso basados en LLM):
- El cliente LLM expande consultas con sinónimos antes de llamar a la herramienta
- El LLM reformula consultas vagas en expresiones Lucene precisas
- El corpus de búsqueda utiliza terminología consistente que BM25 maneja bien
Compensaciones a considerar:
- El cálculo de incrustaciones añade latencia (~31ms/documento durante la indexación, ~5ms/consulta para e5-base)
- Los modelos ONNX requieren ~100-200MB de espacio en disco y RAM adicional
- La complejidad del índice aumenta (documentos padre + documentos hijo fragmentados mediante Block Join)
Variables de entorno
| Variable de entorno | Predeterminado | Descripción |
|---|---|---|
LUCENE_INDEX_PATH | ${user.home}/.mcplucene/luceneindex | Ruta al directorio del índice Lucene |
LUCENE_CRAWLER_DIRECTORIES | (ninguno) | Lista separada por comas de directorios a rastrear (anula el archivo de configuración) |
VECTOR_MODEL | (ninguno) | Modelo de incrustación (e5-base o e5-large). Establézcalo para habilitar la búsqueda semántica. |
LUCENE_TOOLS_INCLUDE | * (todos) | Nombres de herramientas o abreviaturas de grupos separados por comas para exponer |
LUCENE_TOOLS_EXCLUDE | (vacío) | Nombres de herramientas o abreviaturas de grupos separados por comas para ocultar |
Nota sobre LUCENE_CRAWLER_DIRECTORIES:
Cuando esta variable de entorno está establecida, tiene prioridad sobre ~/.mcplucene/config.yaml y application.yaml. Las herramientas de configuración MCP (addCrawlableDirectory, removeCrawlableDirectory) se negarán a modificar la configuración mientras esta anulación esté activa. Para usar la configuración en tiempo de ejecución, elimine esta variable de entorno.
Configuración del rastreador de documentos
Los directorios del rastreador se pueden configurar de tres maneras, con la siguiente prioridad (de mayor a menor):
- Variable de entorno:
LUCENE_CRAWLER_DIRECTORIES(rutas separadas por comas) - Configuración en tiempo de ejecución:
~/.mcplucene/config.yaml(gestionada mediante herramientas MCP) - Predeterminado de la aplicación:
src/main/resources/application.yaml
Configuración en tiempo de ejecución mediante herramientas MCP (recomendado)
El servidor proporciona herramientas MCP para gestionar directorios rastreables en tiempo de ejecución sin editar archivos de configuración:
listCrawlableDirectories - Listar todos los directorios configurados
Ask Claude: "What directories are being crawled?"
addCrawlableDirectory - Añadir un nuevo directorio para rastrear
Ask Claude: "Add /Users/yourname/Documents as a crawlable directory"
Ask Claude: "Add /path/to/folder and start crawling it immediately"
removeCrawlableDirectory - Eliminar un directorio del rastreo
Ask Claude: "Stop crawling /Users/yourname/Downloads"
Beneficios de la configuración en tiempo de ejecución:
- No es necesario reconstruir el JAR ni reiniciar el servidor
- La configuración persiste entre reinicios en
~/.mcplucene/config.yaml - Fácil de distribuir JARs precompilados
- Interfaz conversacional mediante Claude
Ubicación del archivo de configuración:
~/.mcplucene/config.yaml
Ejemplo de config.yaml:
lucene:
  crawler:
    directories:
      - /Users/yourname/Documents
      - /Users/yourname/Downloads
Configuración estática mediante application.yaml
Configure el rastreador de documentos en src/main/resources/application.yaml:
lucene:
  index:
    path: ${LUCENE_INDEX_PATH:./lucene-index}
  crawler:
    # Directories to crawl and index
    directories:
      - "/path/to/your/documents"
      - "/another/path/to/index"

    # File patterns to include
    include-patterns:
      - "*.pdf"
      - "*.doc"
      - "*.docx"
      - "*.odt"
      - "*.ppt"
      - "*.pptx"
      - "*.xls"
      - "*.xlsx"
      - "*.ods"
      - "*.txt"
      - "*.eml"
      - "*.msg"
      - "*.md"
      - "*.rst"
      - "*.html"
      - "*.htm"
      - "*.rtf"
      - "*.epub"

    # File patterns to exclude
    exclude-patterns:
      - "**/node_modules/**"
      - "**/.git/**"
      - "**/target/**"
      - "**/build/**"

    # Performance settings
    thread-pool-size: 4                    # Parallel crawling threads
    batch-size: 100                        # Documents per batch
    batch-timeout-ms: 5000                 # Batch processing timeout

    # Directory watching
    watch-enabled: true                    # Monitor directories for changes
    watch-poll-interval-ms: 2000          # Watch polling interval

    # NRT optimization
    bulk-index-threshold: 1000            # Files before NRT slowdown
    slow-nrt-refresh-interval-ms: 5000    # NRT interval during bulk indexing

    # Content extraction
    max-content-length: -1                 # -1 = unlimited, or max characters
    extract-metadata: true                 # Extract author, title, etc.
    detect-language: true                  # Auto-detect document language

    # Auto-crawl
    crawl-on-startup: true                 # Start crawling on server startup

    # Progress notifications
    progress-notification-files: 100       # Notify every N files
    progress-notification-interval-ms: 30000  # Or every N milliseconds

    # Incremental indexing
    reconciliation-enabled: true           # Skip unchanged files, remove orphans (default: true)

    # Search passages
    max-passages: 3                        # Max highlighted passages per search result (default: 3)
    max-passage-char-length: 200           # Max character length per passage; longer ones are truncated (default: 200, 0 = no limit)
Formatos de archivo admitidos:
- Documentos PDF (
.pdf) - Microsoft Office: Word (
.doc,.docx), Excel (.xls,.xlsx), PowerPoint (.ppt,.pptx) - OpenOffice/LibreOffice: Writer (
.odt), Calc (.ods), Impress (.odp) - Archivos de texto plano (
.txt) - Correo electrónico: Outlook (
.msg), EML (.eml) - Marcado: Markdown (
.md), reStructuredText (.rst), HTML (.html,.htm) - Formato de texto enriquecido (
.rtf) - Libros electrónicos: EPUB (
.epub)
Ejemplo de configuración completa:
lucene:
  index:
    path: /Users/yourname/lucene-index
  crawler:
    # Add your document directories here
    directories:
      - "/Users/yourname/Documents"
      - "/Users/yourname/Downloads"
      - "/Volumes/ExternalDrive/Archive"

    # Include only these file types
    include-patterns:
      - "*.pdf"
      - "*.docx"
      - "*.xlsx"

    # Exclude these directories
    exclude-patterns:
      - "**/node_modules/**"
      - "**/.git/**"

    # Performance tuning
    thread-pool-size: 8              # Use more threads for faster indexing
    batch-size: 200                  # Larger batches for better throughput

    # Auto-start crawler
    crawl-on-startup: true

    # Real-time monitoring
    watch-enabled: true

    # No content limit (index full documents)
    max-content-length: -1
Enriquecimiento de metadatos JDBC
El servidor puede enriquecer documentos indexados con metadatos adicionales cargados desde una base de datos relacional en el momento de la indexación. Esto es útil cuando los metadatos comerciales (por ejemplo, IDs de clientes, códigos de proyecto, etiquetas) se almacenan en una base de datos en lugar de en los propios archivos.
Cómo funciona
- Para cada documento durante el rastreo, el enriquecedor ejecuta una consulta SQL configurable.
- El resultado de la consulta es una sola fila con una columna JSON que contiene la carga útil de metadatos.
- La carga útil JSON se analiza y se añaden campos tipados al documento Lucene.
- Un trabajo de sincronización en segundo plano reindexa los archivos cuando cambian sus metadatos de base de datos.
Nomenclatura de campos
Todos los campos provenientes de JDBC tienen el prefijo dbmeta_ para evitar colisiones con el esquema base del documento.
| Nombre de campo JSON | Nombre de campo Lucene |
|---|---|
customer_id | dbmeta_customer_id |
tags | dbmeta_tags |
department | dbmeta_department |
Formato de metadatos JSON
La consulta de base de datos debe devolver una columna (configurable mediante json.columnName) que contenga JSON en este formato:
{
  "fields": [
    {
      "name": "customer_id",
      "type": "keyword",
      "value": "C-42",
      "faceted": true
    },
    {
      "name": "tags",
      "type": "keyword",
      "values": ["invoice", "2024", "urgent"],
      "faceted": true
    },
    {
      "name": "description",
      "type": "text",
      "value": "Some free-text description"
    },
    {
      "name": "amount",
      "type": "long",
      "value": 9999,
      "faceted": true
    },
    {
      "name": "doc_date",
      "type": "date",
      "value": "2024-01-15T00:00:00Z"
    }
  ]
}
Tipos de campo:
| Tipo | Almacenamiento Lucene | Facetable | Notas |
|---|---|---|---|
keyword | StringField | Sí | Coincidencia exacta; usar para IDs, códigos, categorías |
text | TextField | No | Texto completo analizado; adecuado para descripciones largas |
int | IntPoint + StoredField | Sí | Entero de 32 bits; consultas de rango admitidas |
long | LongPoint + StoredField | Sí | Entero de 64 bits; consultas de rango admitidas |
date | LongPoint + StoredField | No | Cadena ISO-8601 → milisegundos epoch |
Indicadores opcionales por campo:
| Indicador | Predeterminado | Descripción |
|---|---|---|
faceted | false | Exponer como faceta de búsqueda (solo palabra clave/largo) |
stored | true | Almacenar el valor para que sea recuperable de los resultados de búsqueda |
searchable | true | Indexar el campo para consultas |
Configuración
Añada la siguiente sección a ~/.mcplucene/config.yaml:
lucene:
  crawler:
    directories:
      - /path/to/your/documents
  metadata:
    jdbc:
      enabled: true
      url: "jdbc:postgresql://localhost:5432/mydb"
      username: "myuser"
      password: "${DB_PASSWORD}"   # env-var substitution supported
      poolSize: 5
      connectionTimeout: 30000    # ms
      queryTimeout: 5000          # ms
      query: >
        SELECT metadata_json
        FROM document_metadata
        WHERE file_path = :file_path
      parameters:
        - name: file_path
          sourceField: file_path   # Lucene field to use as query parameter
      json:
        columnName: metadata_json  # Column in the result set containing the JSON

      # Optional: background sync when DB metadata changes
      sync:
        enabled: true
        intervalMinutes: 5
        query: >
          SELECT dbmeta_customer_id
          FROM document_metadata
          WHERE updated_at > :last_sync_timestamp
Ejemplo avanzado: Construcción dinámica de metadatos desde una tabla (MySQL)
Los metadatos a menudo no se almacenan como JSON preconstruido sino que están distribuidos en tablas normalizadas. Las funciones JSON_OBJECT() / JSON_ARRAY() / JSON_ARRAYAGG() de MySQL le permiten ensamblar la carga útil de metadatos directamente en la consulta SQL — sin necesidad de una vista materializada separada ni un trabajo ETL.
Escenario
Los documentos son PDFs de perfiles de freelancers. Los nombres de archivo siguen el patrón .../ABC-1234_Profile.pdf, donde ABC-1234 es un código único de freelancer. Las tablas relevantes:
-- Master data
CREATE TABLE freelancer (
    id               BIGINT PRIMARY KEY,
    code             VARCHAR(20) UNIQUE,   -- e.g. "ABC-1234"
    salary_per_day   DECIMAL(10, 2)
);

-- n:m tags
CREATE TABLE freelancer_tags (
    freelancer_id    BIGINT,
    tag_id           BIGINT
);
Configuración
lucene:
  metadata:
    jdbc:
      enabled: true
      url: "jdbc:mysql://localhost:3306/mydb"
      username: "myuser"
      password: "${DB_PASSWORD}"
      poolSize: 5
      connectionTimeout: 30000
      queryTimeout: 5000
      query: |
        SELECT JSON_OBJECT(
                      'fields', JSON_ARRAY(
                            JSON_OBJECT('name', 'daily_rate', 'type', 'long', 'value', f.salary_per_day_long, 'faceted', CAST(FALSE AS JSON)),
                            JSON_OBJECT('name', 'tags',       'type', 'long', 'values', (
                                SELECT JSON_ARRAYAGG(ft.tag_id)
                                FROM freelancer_tags ft
                                WHERE ft.freelancer_id = f.id
                            ), 'faceted', CAST(FALSE AS JSON))
                      )
              ) as metadata_json
        FROM
            freelancer f
        WHERE
            f.code = REGEXP_SUBSTR(:file_path, '[A-Z]+-[0-9]+')
      parameters:
        - name: file_path
          sourceField: file_path   # Lucene field to use as query parameter
      json:
        columnName: metadata_json  # Column in the result set containing the JSON
Cómo funciona paso a paso
1. Enlace de parámetros — la ruta del archivo como clave de búsqueda
Durante el rastreo, el indexador almacena la ruta absoluta del archivo en el campo Lucene file_path (por ejemplo, /docs/profiles/ABC-1234_Profile.pdf). Mediante parameters.sourceField: file_path, ese valor se pasa como el parámetro nombrado :file_path a la consulta SQL.
2. Extracción del código de freelancer con una expresión regular
Debido a que la ruta completa del archivo se pasa a la base de datos, el código debe extraerse allí. REGEXP_SUBSTR(:file_path, '[A-Z]+-[0-9]+') extrae ABC-1234 de /docs/profiles/ABC-1234_Profile.pdf y lo compara con freelancer.code. La base de datos no necesita conocimiento de las estructuras de directorios — la expresión regular se ejecuta completamente dentro del motor de la base de datos.
3. Ensamblaje de la carga útil JSON en SQL
JSON_OBJECT(...) produce un objeto JSON. Dentro de él, un JSON_ARRAY(...) contiene un elemento por campo de metadatos:
daily_rate(tipolong): un valor escalar único def.salary_per_day_longtags(tipolong, multivalor): un array producido por una subconsulta correlacionada —JSON_ARRAYAGG(ft.tag_id)agrega todos los IDs de etiquetas para el freelancer en un array JSON
La consulta devuelve una sola fila con una sola columna metadata_json:
{
  "fields": [
    { "name": "daily_rate", "type": "long", "value": 850,              "faceted": false },
    { "name": "tags",       "type": "long", "values": [12, 47, 103],   "faceted": false }
  ]
}
4. Procesamiento por el indexador
JdbcMetadataEnricher lee esta respuesta JSON y añade campos al documento Lucene:
dbmeta_daily_rate→LongPoint(850)+StoredField(850)+SortedNumericDocValuesField(850)(buscable, recuperable y ordenable)dbmeta_tags→ tres entradasLongPointpara los valores12,47,103(multivaluado — DocValues omitidos, por lo tanto no ordenable)
Debido a faceted: false, no se crean entradas SortedSetDocValuesFacetField. Los campos están disponibles para consultas específicas y filtros de rango sin añadir sobrecarga al cálculo de facetas en cada solicitud de búsqueda.
Ordenación por campos de metadatos JDBC: Los campos INT, LONG y DATE de un solo valor obtienen automáticamente un SortedNumericDocValuesField, y los campos KEYWORD de un solo valor obtienen un SortedDocValuesField. Esto los hace utilizables como valores sortBy en solicitudes de búsqueda. Los campos multivaluados omiten DocValues (la ordenación en campos multivaluados no está definida). Use getIndexStats para ver qué campos dbmeta_* están actualmente registrados como ordenables mediante el mapa sortableFields.
5. Consulta en tiempo de ejecución
Después del rastreo, estos campos se pueden usar como filtros en extendedSearch:
{
  "query": "Java developer",
  "filters": [
    { "field": "dbmeta_daily_rate", "operator": "range", "from": "500", "to": "1000" },
    { "field": "dbmeta_tags",       "operator": "in",    "values": ["47", "103"] }
  ]
}
Nota sobre CAST(FALSE AS JSON)
MySQL no tiene un literal booleano JSON nativo. CAST(FALSE AS JSON) produce el valor JSON false, que JsonMetadataParser interpreta correctamente como faceted: false. Use CAST(TRUE AS JSON) para faceted: true.
Ejemplo Avanzado: Sincronización en Segundo Plano mediante Búsqueda en Índice (PostgreSQL)
Escenario
La misma configuración de PDF de freelancer que en el ejemplo de enriquecimiento. Cuando la tarifa diaria o las etiquetas de un freelancer cambian en la base de datos, el servidor debe reindexar automáticamente el PDF afectado — sin que la base de datos necesite conocer las rutas de archivo.
Requisito previo: La consulta de enriquecimiento almacena customer_id como dbmeta_customer_id (tipo keyword) en el índice Lucene, y la tabla document_metadata también tiene una columna customer_id además de una marca de tiempo updated_at.
Configuración
sync:
  enabled: true
  intervalMinutes: 5
  query: >
    SELECT customer_id AS dbmeta_customer_id
    FROM document_metadata
    WHERE updated_at > :last_sync_timestamp
Cómo Funciona Paso a Paso
1. Filtro de marca de tiempo
El parámetro :last_sync_timestamp está vinculado a la última hora de sincronización exitosa (persistida en ~/.mcplucene/metadata-sync-state.yaml). En la primera ejecución, el valor predeterminado es 1970-01-01T00:00:00Z, por lo que se escanea toda la tabla.
2. Nombre de columna como campo Lucene
El conjunto de resultados tiene exactamente una columna. Su nombre — dbmeta_customer_id (establecido mediante el alias AS) — se lee desde el ResultSetMetaData JDBC. Este se convierte en el campo Lucene contra el que el servidor buscará.
3. Búsqueda TermQuery
Para cada fila (por ejemplo, el valor C-42), el servidor ejecuta un TermQuery de Lucene en dbmeta_customer_id = "C-42" restringido a documentos principales. Esto encuentra cada archivo indexado que fue enriquecido con ese ID de cliente.
4. Resolución de ruta de archivo
file_path se extrae de cada documento Lucene coincidente. El índice — no la base de datos — es la fuente de verdad para la ubicación física del archivo.
5. Reindexar o eliminar
Si el archivo aún existe en disco, se vuelve a rastrear, lo que activa nuevamente la consulta de enriquecimiento para que el documento Lucene capture los últimos metadatos de la base de datos. Si el archivo ha sido eliminado, su entrada en el índice se borra.
6. Avance de marca de tiempo
Después de una ejecución exitosa, la hora actual se guarda como el nuevo lastSyncTimestamp. La siguiente sincronización solo devuelve filas modificadas después de este punto.
Uso de una Clave de Unión Numérica
Si la clave de unión es un ID de base de datos numérico en lugar de un código de cadena, use el tipo entero SQL apropiado para que el servidor construya la consulta de punto Lucene correcta:
sync:
  enabled: true
  intervalMinutes: 5
  query: >
    SELECT freelancer_id AS dbmeta_freelancer_id
    FROM document_metadata
    WHERE updated_at > :last_sync_timestamp
Aquí freelancer_id es una columna BIGINT, por lo que el servidor usa LongPoint.newExactQuery("dbmeta_freelancer_id", …). El enriquecimiento debe haber almacenado freelancer_id como un campo de tipo long para que la consulta coincida.
| Tipo de columna SQL | Consulta Lucene | Debe coincidir con el tipo de enriquecimiento |
|---|---|---|
VARCHAR / CHAR | TermQuery | keyword |
INTEGER / SMALLINT | IntPoint.newExactQuery() | int |
BIGINT / NUMERIC | LongPoint.newExactQuery() | long |
Bases de Datos Soportadas
| Base de datos | Dependencia de controlador | Notas |
|---|---|---|
| PostgreSQL | incluida (tiempo de ejecución opcional) | jdbc:postgresql://... |
| MySQL | incluida (tiempo de ejecución opcional) | jdbc:mysql://... |
| H2 | solo ámbito de prueba | jdbc:h2:... (para pruebas) |
| Cualquier JDBC | Agregar al classpath | Establecer driverClassName explícitamente |
Integración de Facetas
Los campos declarados con "faceted": true se registran automáticamente como dimensiones de faceta dinámicas. Aparecen junto a las facetas integradas (language, file_extension, file_type, author) en los resultados de búsqueda y se pueden usar como valores de filtro.
Los campos multivaluados (usando "values": [...]) se configuran automáticamente como dimensiones de faceta multivaluadas.
Sincronización en Segundo Plano
Cuando sync.enabled: true, el servidor ejecuta un trabajo en segundo plano cada intervalMinutes minutos que:
- Consulta la base de datos en busca de registros modificados desde la última sincronización (usando
:last_sync_timestamp). - Lee el conjunto de resultados — exactamente una columna, N filas. El nombre de la columna es el campo Lucene a buscar; el valor de la columna es el término a coincidir.
- Ejecuta una consulta Lucene por fila para encontrar documentos de índice coincidentes, luego extrae sus
file_path. - Reindexa archivos que aún existen en disco con los últimos metadatos.
- Elimina entradas de índice para archivos que ya no existen.
La última marca de tiempo de sincronización se persiste en ~/.mcplucene/metadata-sync-state.yaml.
Tipos de columna soportados:
| Tipo de columna SQL | Consulta Lucene | Tipo de campo dbmeta_ compatible |
|---|---|---|
VARCHAR, CHAR, … | TermQuery | keyword |
INTEGER, SMALLINT, TINYINT | IntPoint.newExactQuery() | int |
BIGINT, NUMERIC, DECIMAL | LongPoint.newExactQuery() | long |
El tipo de consulta se infiere automáticamente del tipo de columna JDBC — no se necesita configuración adicional. El tipo de columna SQL debe coincidir con el tipo de campo Lucene utilizado durante el enriquecimiento (IntPoint y LongPoint son tipos de campo separados). Los campos text analizados no son adecuados como claves de sincronización.
Manejo de Errores
El enriquecedor sigue un patrón de resiliencia de "omitir y advertir":
- Fallos de conexión a la base de datos: el documento se indexa sin enriquecimiento, se registra una advertencia.
- Errores de consulta: mismo comportamiento de omitir y advertir.
- Cargas JSON inválidas: los errores de análisis se registran, el campo se omite.
- Valores NULL: se ignoran silenciosamente por campo.
- Colisiones de nombres de campo con el esquema base: se registra un error, el campo se omite.
Desarrollo
Ejecución para Desarrollo
Al desarrollar y depurar en su IDE, ejecute el servidor sin el perfil "desplegado" para obtener registros completos:
En su IDE (IntelliJ, Eclipse, VS Code):
# Just run the main class directly - no profile needed
# You'll see full console logging and debug output
java -jar target/luceneserver-0.0.1-SNAPSHOT.jar
Esto le proporciona:
- Salida de registro completa para depuración
- Configuración cargada desde el classpath y la configuración del usuario
- Toda la información de depuración visible en la consola
Para implementación en producción/Claude Desktop:
# Use the deployed profile for clean STDIO
java --enable-native-access=ALL-UNNAMED -Xmx2g -Dspring.profiles.active=deployed -jar target/luceneserver-0.0.1-SNAPSHOT.jar
Depuración con MCP Inspector
El MCP Inspector proporciona una interfaz de depuración visual para probar servidores MCP. Úselo para inspeccionar solicitudes, respuestas y depurar el comportamiento de las herramientas sin necesidad de un cliente MCP completo como Claude Desktop.
Ejecute el servidor con el inspector para conexión STDIO:
npx @modelcontextprotocol/inspector java -jar --enable-native-access=ALL-UNNAMED -Xmx2g -Dspring.profiles.active=deployed -jar ./target/luceneserver-0.0.1-SNAPSHOT.jar
o en caso de HTTP Streaming:
npx @modelcontextprotocol/inspector http://localhost:9000/mcp/message --transport http
Esto abre una interfaz web basada en UI donde puede:
- Probar todas las herramientas MCP de forma interactiva
- Inspeccionar cargas útiles de solicitud/respuesta JSON
- Depurar problemas de comunicación STDIO
- Verificar parámetros de herramientas y valores de retorno
Nota: El inspector requiere los mismos argumentos JVM que la implementación de producción (--enable-native-access=ALL-UNNAMED, -Dspring.profiles.active=deployed) para garantizar un comportamiento consistente.
Agregar Documentos al Índice
Enfoque recomendado: Use el rastreador de documentos configurando directorios en application.yaml. El rastreador maneja automáticamente la extracción de contenido, metadatos y detección de idioma.
Enfoque programático: Para tipos de documentos personalizados o indexación directa:
// Get the LuceneIndexService instance from your application
LuceneIndexService indexService = // ... from your application

public void addDocument(String title, String content) throws IOException {
    Document doc = new Document();
    doc.add(new TextField("title", title, Field.Store.YES));
    doc.add(new TextField("content", content, Field.Store.YES));
    doc.add(new StringField("file_path", "/custom/path", Field.Store.YES));
    indexService.getIndexWriter().addDocument(doc);
    indexService.getIndexWriter().commit();
}
Para el esquema completo de campos, consulte la sección Esquema de Campos del Índice.