cowork-semantic-search
Búsqueda semántica local sobre documentos (txt, md, pdf, docx, pptx, csv). Completamente offline, multilingüe, búsqueda híbrida vectorial + por palabras clave mediante LanceDB. Sin claves API, sin nube.
Documentación
cowork-semantic-search


Si te resulta útil, considera darle una ⭐ — ayuda a que otros descubran el proyecto.
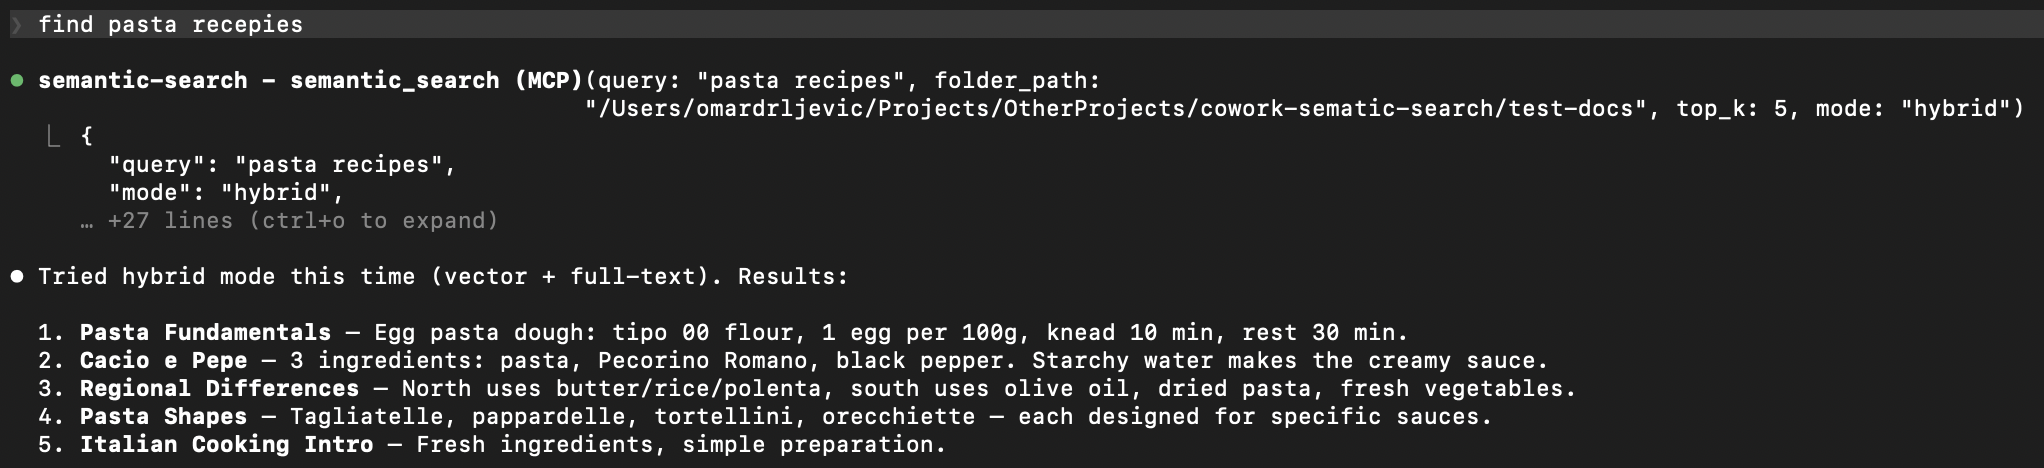
Búsqueda semántica local para tus documentos. Sin claves de API. Sin nube. Funciona con cualquier cliente MCP.
Por qué
Las herramientas de codificación con IA son potentes, pero tienen puntos ciegos cuando se trata de tus archivos locales:
- Conocimiento congelado -- los datos de entrenamiento tienen un límite. Tus informes, notas y contratos más recientes no existen en el mundo del modelo.
- Límites de la ventana de contexto -- no puedes pegar 500 documentos en un prompt.
- Sin búsqueda entre archivos -- tu herramienta de IA puede leer un archivo a la vez, pero no puede buscar en toda tu biblioteca de documentos las piezas relevantes.
Este plugin cierra esa brecha. Indexa tus documentos locales en una base de datos vectorial pequeña y rápida. Cuando haces una pregunta, recupera solo las piezas relevantes -- para que tu herramienta de IA pueda responder con tus datos reales.
Your documents --> chunked --> embedded --> local vector DB
                                                 |
         Your question --> embedded --> similarity search --> relevant chunks --> AI answers
Características
- Totalmente offline -- descarga única del modelo (~120MB), luego sin llamadas de red. Ningún dato sale de tu máquina.
- Indexación incremental -- hash de contenido SHA-256. Solo los archivos modificados se reprocesan. Re-indexar 1000 archivos donde 3 cambiaron toma segundos.
- Multilingüe -- maneja 50+ idiomas de forma nativa. Busca en un idioma, encuentra resultados en otro.
- Búsqueda híbrida -- combina similitud semántica con búsqueda de palabras clave de texto completo mediante Reciprocal Rank Fusion. Captura lo que la búsqueda vectorial pura no ve.
- Múltiples formatos -- txt, md, pdf, docx, pptx, csv de serie.
- Cualquier cliente MCP -- funciona con Claude Code, Cursor, Windsurf, Cline y cualquier otra herramienta compatible con MCP.
- Cero infraestructura -- LanceDB almacena todo como archivos locales. Sin servidor, sin Docker, sin base de datos que gestionar.
Formatos Soportados
| Formato | Extensión | Detalles |
|---|---|---|
| Texto plano | .txt | UTF-8 con respaldo |
| Markdown | .md | Texto sin procesar conservado |
.pdf | Extracción a nivel de página con metadatos | |
| Word | .docx | Extracción completa de párrafos |
| PowerPoint | .pptx | Extracción a nivel de diapositiva con metadatos |
| CSV | .csv | Extracción de texto basada en filas |
Inicio Rápido
1. Instalación
git clone https://github.com/ZhuBit/cowork-semantic-search.git
cd cowork-semantic-search
python3 -m venv .venv && source .venv/bin/activate
pip install -e ".[all]"
2. Configura tu cliente MCP
Añade el servidor a la configuración de tu cliente MCP. Reemplaza las rutas con las tuyas.
Claude Code -- .mcp.json en la raíz de tu proyecto
{
  "mcpServers": {
    "semantic-search": {
      "command": "/absolute/path/to/.venv/bin/python",
      "args": ["-m", "server.main"],
      "cwd": "/absolute/path/to/cowork-semantic-search",
      "env": {
        "PYTHONPATH": "/absolute/path/to/cowork-semantic-search"
      }
    }
  }
}
Cursor -- .cursor/mcp.json en la raíz de tu proyecto o ~/.cursor/mcp.json globalmente
{
  "mcpServers": {
    "semantic-search": {
      "command": "/absolute/path/to/.venv/bin/python",
      "args": ["-m", "server.main"],
      "env": {
        "PYTHONPATH": "/absolute/path/to/cowork-semantic-search"
      }
    }
  }
}
Windsurf -- ~/.codeium/windsurf/mcp_config.json
{
  "mcpServers": {
    "semantic-search": {
      "command": "/absolute/path/to/.venv/bin/python",
      "args": ["-m", "server.main"],
      "env": {
        "PYTHONPATH": "/absolute/path/to/cowork-semantic-search"
      }
    }
  }
}
Cline -- configuración de MCP Servers en la extensión de Cline para VS Code
Abre Cline > icono de MCP Servers > Configure > Advanced MCP Settings, y luego añade:
{
  "mcpServers": {
    "semantic-search": {
      "command": "/absolute/path/to/.venv/bin/python",
      "args": ["-m", "server.main"],
      "env": {
        "PYTHONPATH": "/absolute/path/to/cowork-semantic-search"
      }
    }
  }
}
3. Reinicia tu cliente MCP y listo
"Index all documents in ~/Documents/projects"
"Search for 'quarterly revenue report'"
La primera ejecución descarga el modelo de embeddings (~120MB), luego todo funciona offline.
Ejemplo: Busca en tu Obsidian Vault
Si guardas notas en Obsidian (o en cualquier carpeta de archivos markdown), este plugin convierte tu herramienta de IA en un motor de búsqueda para tu base de conocimiento.
You: "Index my vault at ~/Documents/ObsidianVault"
AI:  Indexed 847 files -> 3,291 chunks in 42s

You: "What did I write about API rate limiting?"
AI:  Found 6 relevant chunks across 3 files:
       - notes/backend/rate-limiting-strategies.md
       - projects/acme-api/design-decisions.md
       - daily/2025-11-03.md
       ...

You: "Find anything about the client meeting last November, use hybrid search"
AI:  Found 4 results using hybrid search (vector + keyword):
       - meetings/2025-11-12-acme-kickoff.md
       - daily/2025-11-12.md
       ...
Funciona igual con PDFs, documentos de Word, PowerPoints y CSVs -- solo apúntalo a una carpeta.
Herramientas
| Herramienta | Descripción |
|---|---|
index_folder | Indexa o re-indexa todos los documentos de una carpeta. Incremental -- omite archivos sin cambios. |
semantic_search | Busca en documentos indexados usando lenguaje natural. Soporta modos vector y hybrid. |
get_index_status | Muestra el total de chunks, el número de archivos y la lista de archivos indexados. |
reindex_file | Fuerza la re-indexación de un solo archivo, omitiendo la caché de hash. |
Cómo Funciona
- Analizar -- extrae texto de cada documento, preservando la estructura (páginas, diapositivas)
- Fragmentar -- divide en piezas superpuestas de ~400 caracteres para una recuperación precisa
- Embed -- convierte cada fragmento en un vector de 384 dimensiones usando
paraphrase-multilingual-MiniLM-L12-v2 - Almacenar -- guarda fragmentos + vectores en una base de datos LanceDB (un archivo local, sin necesidad de servidor)
- Buscar -- genera el embedding de tu consulta, encuentra los fragmentos más cercanos por similitud de coseno, opcionalmente combina con búsqueda de palabras clave de texto completo mediante RRF
Uso Avanzado
Usar como biblioteca de Python
from server.indexer import index_folder
from server.search import semantic_search

# Index a folder
result = index_folder("/path/to/docs")
print(f"{result['files_indexed']} files -> {result['total_chunks']} chunks")

# Search
results = semantic_search("project deadline", mode="hybrid")
for r in results["results"]:
    print(f"  {r['file_name']}: {r['text'][:100]}...")
Arquitectura
server/
  main.py       # MCP server + tool definitions
  parsers.py    # Per-format text extraction
  chunker.py    # Text splitting with metadata
  indexer.py    # Discovery, hashing, embedding pipeline
  store.py      # LanceDB vector store + FTS + hybrid search
  search.py     # Query embedding + search orchestration
| Componente | Elección | Por qué |
|---|---|---|
| Framework MCP | FastMCP | Definiciones de herramientas limpias, soporte async |
| Embeddings | sentence-transformers | Offline, multilingüe, rápido |
| Base de datos vectorial | LanceDB | Serverless, embebida, FTS integrado |
| Fragmentación | langchain-text-splitters | División recursiva probada en batalla |
| PyMuPDF | Extracción rápida y precisa | |
| DOCX | python-docx | Ligero, sin dependencias del sistema |
| PPTX | python-pptx | Extracción a nivel de diapositiva |
Desarrollo
source .venv/bin/activate
pytest tests/ -v
56 pruebas que cubren parsers, fragmentación, indexación, búsqueda e integración de herramientas MCP.
Las contribuciones son bienvenidas -- abre un issue o envía un PR.
Hoja de Ruta
- Runtime ONNX para embeddings más rápidos (eliminar la dependencia de PyTorch)
- Tamaño de fragmento y solapamiento configurables mediante parámetros de herramienta
- Índices nombrados de múltiples carpetas
- Filtrado por metadatos (rangos de fechas, etiquetas, campos personalizados)
- Modo de vigilancia (re-indexación automática al cambiar archivos)
Soporte
Si te resulta útil, considera darle una ⭐ — ayuda a que otros encuentren el proyecto.
Licencia
AGPL-3.0 -- libre de usar, modificar y auto-alojar. Si ofreces esto como un servicio de red, debes compartir tu código fuente. Consulta LICENSE para más detalles.