Semble
Búsqueda de código local rápida y precisa para agentes. Indexa cualquier ruta local o repositorio de GitHub bajo demanda en ~250ms y responde consultas en ~1.5ms. Funciona en CPU, sin claves API ni servicios externos.
Documentación
Búsqueda de código rápida y precisa para agentes
Usa ~99% menos tokens que grep+read


Semble es una biblioteca de búsqueda de código construida para agentes. Devuelve los fragmentos de código exactos que necesitan al instante, usando ~99% menos tokens que grep+read. Indexar y buscar un código completo de principio a fin toma menos de un segundo para la mayoría de los repositorios, igualando la calidad de recuperación de un transformador especializado en código mientras indexa ~380x más rápido y consulta ~17x más rápido (ver benchmarks). Todo se ejecuta en CPU sin claves API, GPU ni servicios externos. Úsalo como servidor MCP, herramienta CLI mediante AGENTS.md, o sub-agente dedicado, y cualquier agente de codificación (Claude Code, Cursor, Codex, OpenCode, etc.) obtiene acceso instantáneo a cualquier repositorio.
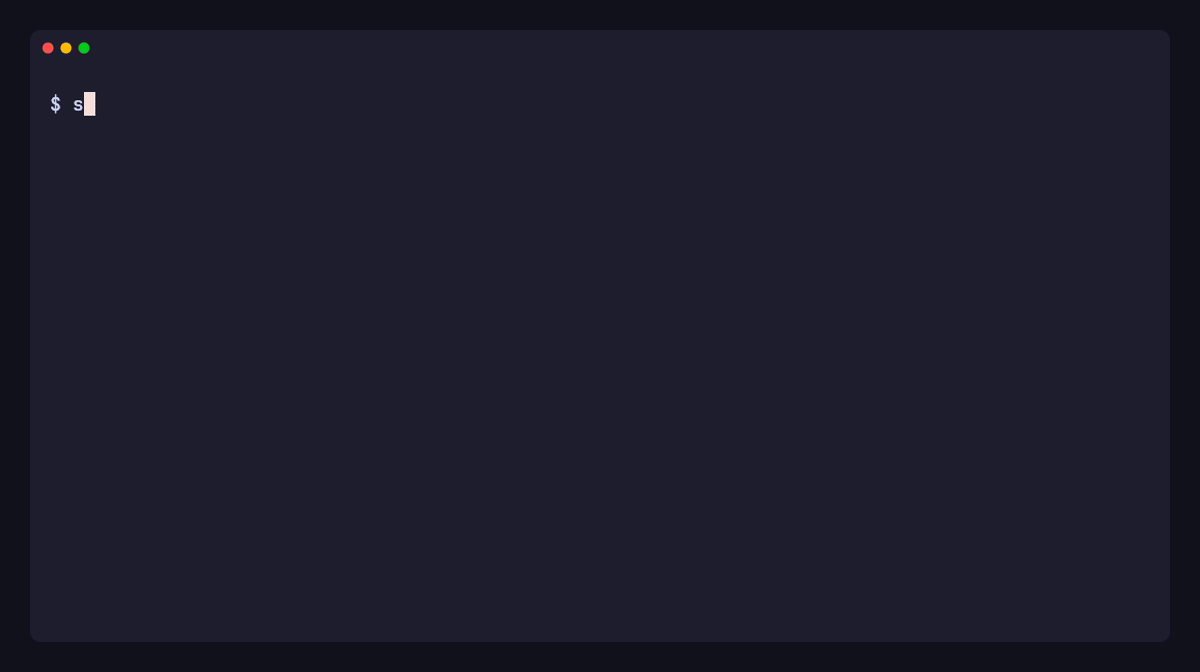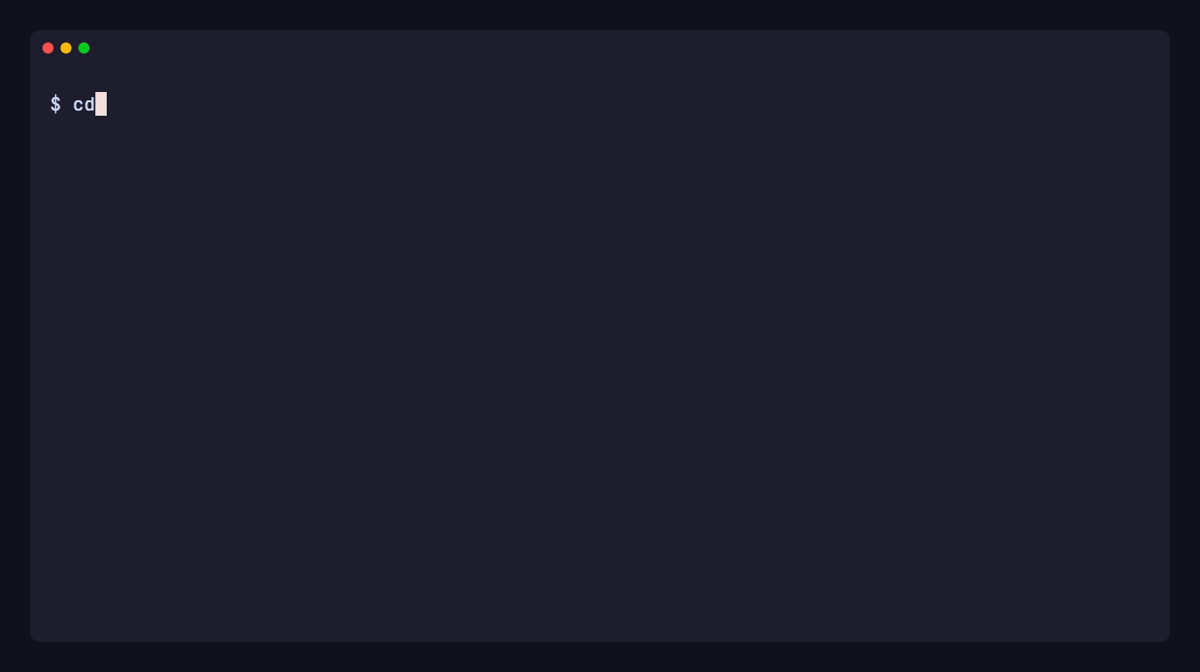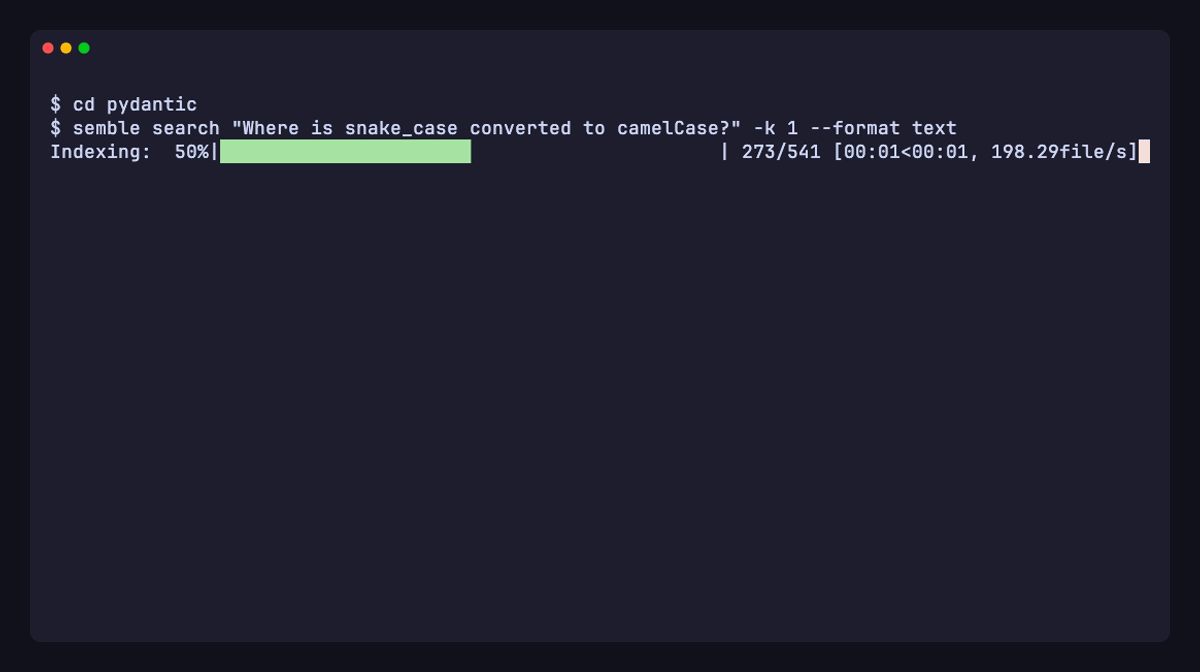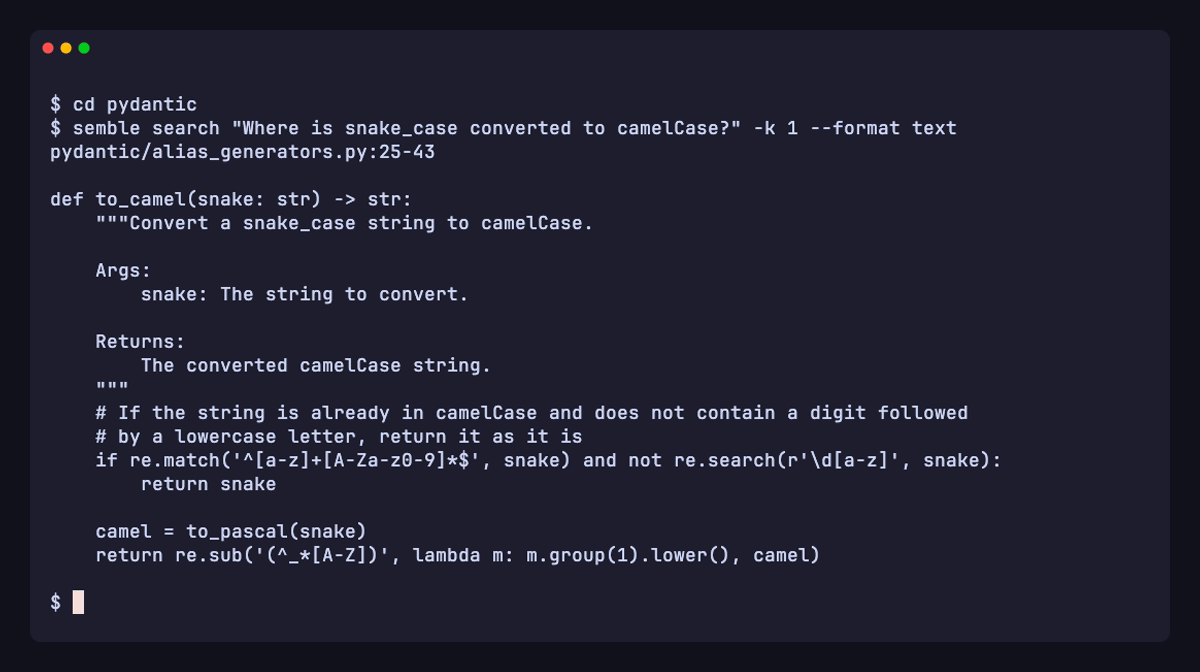
Inicio rápido
Tu agente consulta a Semble en lenguaje natural (p. ej. "How is authentication handled?") y recibe solo los fragmentos de código relevantes, sin hacer grep ni leer archivos completos.
La forma más rápida de empezar es el instalador interactivo. Instala uv y luego ejecuta:
uv tool install semble
semble install
semble install detecta agentes de codificación instalados como Claude Code, Codex y OpenCode, y luego te permite elegir qué integraciones habilitar:
- Servidor MCP: permite que el agente llame a Semble directamente como herramienta.
- Instrucciones: añade guía de uso de CLI a AGENTS.md / CLAUDE.md.
- Sub-agente: instala un sub-agente dedicado
semble-search.
Para deshacer la configuración, ejecuta semble uninstall.
Para instrucciones de configuración manual (config MCP por agente, fragmento de AGENTS.md, archivos de sub-agente), consulta la documentación de instalación.
Actualizar Semble
uv tool upgrade semble   # upgrade
uv cache clean semble    # for MCP users (restart your MCP client after)
Instalación desatendida
Para entornos en sandbox o con scripts, omite los avisos con --agent y, opcionalmente, --type:
semble install --agent claude --type mcp subagent --yes
--agent acepta uno o más IDs de agente (p. ej. claude, codex, pi); --type acepta mcp, instructions, subagent o all (predeterminado: todos); --yes omite el aviso de confirmación (requiere --agent para una ejecución completamente no interactiva).
Características principales
- Rápido: indexa un repositorio promedio en ~500 ms y responde consultas en ~1 ms, todo en CPU.
- Preciso: NDCG@10 de 0.854 en nuestros benchmarks, a la par de modelos transformadores especializados en código, a una fracción del tamaño y costo.
- Eficiente en tokens: devuelve solo los fragmentos relevantes, usando ~99% menos tokens que grep+read.
- Cero configuración: se ejecuta en CPU sin claves API, GPU ni servicios externos requeridos.
- Servidor MCP: funciona con Claude Code, Cursor, Codex, OpenCode, VS Code y cualquier otro agente compatible con MCP.
- Local y remoto: pasa una ruta local o una URL de git, o varias de ellas para buscar repositorios relacionados juntos.
CLI
Semble también se distribuye como CLI independiente. Esto es útil en scripts o en cualquier lugar donde quieras resultados de búsqueda sin una sesión MCP. Los índices se construyen y cachean en la primera ejecución, y se invalidan automáticamente cuando los archivos cambian.
# Search a local repo (index is built and cached automatically)
semble search "authentication flow" ./my-project

# Search a remote repo (cloned on demand)
semble search "save model to disk" https://github.com/MinishLab/model2vec

# Search several repos at once (results are prefixed with the repo name)
semble search "invoice endpoint" ./service-a ./service-b

# Limit results
semble search "save model to disk" ./my-project --top-k 10

# Search docs/config/everything instead of just code
semble search "deployment guide" ./my-project --content docs   # or: config, all

# Find code similar to a known location
semble find-related src/auth.py 42 ./my-project

# Show only the first N lines of each result's snippet (0 = path/line range only)
semble search "authentication flow" ./my-project --max-snippet-lines 10
--content acepta code (predeterminado), docs, config o all. --format acepta json (predeterminado) o text. path se establece por defecto en el directorio actual cuando se omite; se aceptan URLs de git. Si semble no está en $PATH, usa uvx --from "semble[mcp]" semble en su lugar. semble --version (o -V) imprime la versión instalada.
Pasar varias rutas o URLs las busca como un solo corpus, de modo que una consulta del repositorio A puede encontrar un endpoint definido en el repositorio B. Cada índice se cachea por repositorio y se fusiona en el momento de la consulta. Las rutas de resultados se prefijan con el nombre del repositorio (service-b/api/invoices.py) y la salida incluye un mapa repos de prefijo a ruta absoluta o URL. Pasa la ruta prefijada a find-related para buscar en todos los repositorios desde una ubicación conocida.
Controlar qué archivos se indexan
Semble lee los archivos .gitignore y .sembleignore para determinar qué archivos indexar. Ambos archivos usan sintaxis estándar de gitignore y sus patrones se fusionan. .sembleignore te permite añadir reglas específicas de semble sin tocar .gitignore. Las reglas se aplican recursivamente, de modo que un .sembleignore en un subdirectorio se aplica a ese subárbol.
Excluir archivos: añade patrones de la misma manera que lo harías en .gitignore:
# .sembleignore
generated/     # exclude generated dir
*.pb.go.       # exclude Go protobuf files
Incluir extensiones no predeterminadas: prefija el patrón de extensión con ! para forzar la inclusión de archivos que semble no indexaría por defecto:
# .sembleignore
!*.proto       # include Protobuf files
!*.cob         # include COBOL files
Semble también omite siempre un conjunto de directorios no fuente bien conocidos, independientemente de los archivos de ignorar (p. ej. node_modules/, .venv/, dist/, build/, __pycache__/ y similares).
Ahorros
semble savings muestra cuántos tokens ha ahorrado semble en todas tus búsquedas:
semble savings
  Semble Token Savings
  ════════════════════════════════════════════════════════════════════════

  Total saved:  ~714.2M tokens  (94%)
  Total calls:  14.3k
  Efficiency:  ███████████████████████░  94%

  By Period
  ────────────────────────────────────────────────────────────────────────
  Period             Calls           Saved  Ratio
  ────────────────────────────────────────────────────────────────────────
  Today                198    ~1.4M tokens  ███████████████████████░  95%
  Last 7 days        13.1k  ~707.2M tokens  ███████████████████████░  94%
  All time           14.3k  ~714.2M tokens  ███████████████████████░  94%

  By Call Type
  ────────────────────────────────────────────────────────────────────────
  #     Call type            Calls  Share
  ────────────────────────────────────────────────────────────────────────
  1.    search               14.1k  ████████████████    99%
  2.    find_related           205  █░░░░░░░░░░░░░░░     1%
  ════════════════════════════════════════════════════════════════════════
Los ahorros se calculan de la siguiente manera: por cada llamada, semble registra el recuento total de caracteres de los archivos únicos que contienen los fragmentos devueltos y el recuento de caracteres de los fragmentos devueltos. Los tokens ahorrados estimados son (file chars − snippet chars) / 4 (4 caracteres por token). Esta es una estimación conservadora: la línea base es leer los archivos coincidentes en su totalidad, que es como los agentes de codificación suelen explorar código desconocido.
Almacenamiento
Por defecto, tus estadísticas de ahorro de Semble y cualquier índice guardado se almacenan en la carpeta de caché del sistema operativo (~/Library/Caches/semble/ en macOS, ~/.cache/semble/ en Linux, %LOCALAPPDATA%\semble\Cache\ en Windows). Para anular esta ubicación, puedes proporcionar una variable de entorno SEMBLE_CACHE_LOCATION que debe ser la ruta completa a la ubicación de caché objetivo, p. ej. ~/my-folder/my-caches/semble.
Los archivos de más de 1 MB se omiten durante la indexación para mantener las compilaciones de índice ágiles. Los archivos omitidos se informan como advertencia en el momento de la indexación. Si trabajas con documentos grandes generados o ingeridos, puedes aumentar (o reducir) este límite con la variable de entorno SEMBLE_MAX_FILE_BYTES (en bytes).
En el primer uso, Semble también descarga el modelo de incrustación de Hugging Face y lo cachea en la caché estándar de Hugging Face (~/.cache/huggingface/ por defecto, o $HF_HOME si está configurada); esto solo ocurre una vez y requiere acceso a la red.
Usa semble clear para eliminar datos en caché: semble clear index (índices guardados), semble clear savings (estadísticas de uso), semble clear orphans (índices de repositorios que ya no están en el disco) o semble clear all (todo).
Uso como biblioteca
Semble también se puede usar como biblioteca de Python para acceso programático, útil al construir herramientas personalizadas o integrar la búsqueda directamente en tu propio código.
from semble import ContentType, SembleIndex

# Index a local directory (code only, the default)
index = SembleIndex.from_path("./my-project")

# Index docs and prose (markdown, rst, etc.)
index = SembleIndex.from_path("./my-project", content=ContentType.DOCS)

# Index everything (code, docs, and config)
index = SembleIndex.from_path("./my-project", content=[ContentType.CODE, ContentType.DOCS, ContentType.CONFIG])

# Index code and docs together
index = SembleIndex.from_path("./my-project", content=[ContentType.CODE, ContentType.DOCS])

# Index a remote git repository
index = SembleIndex.from_git("https://github.com/MinishLab/model2vec")

# Merge indexes from several repos into one (chunk paths are prefixed with the repo name)
index = SembleIndex.merge([("./service-a", SembleIndex.from_path("./service-a")), ("./service-b", SembleIndex.from_path("./service-b"))])

# Search the index with a natural-language or code query
results = index.search("save model to disk", top_k=3)

# Find code similar to a specific result
related = index.find_related(results[0], top_k=3)

# Each result exposes the matched chunk
result = results[0]
result.chunk.file_path   # "model2vec/model.py"
result.chunk.start_line  # 127
result.chunk.end_line    # 150
result.chunk.content     # "def save_pretrained(self, path: PathLike, ..."
Servidor MCP
Semble se ejecuta como servidor MCP para que los agentes puedan buscar cualquier código base directamente como una llamada de herramienta nativa. Los repositorios se indexan bajo demanda y se cachean; las rutas locales se reindexan automáticamente cuando los archivos cambian.
| Herramienta | Descripción |
|---|---|
search | Busca un código base con una consulta en lenguaje natural o código. Pasa repo como ruta local o URL de git https:// (o una lista de ellas para buscar varios repositorios juntos) y content como code, docs, config o all (predeterminado: code). |
find_related | Dada una ruta de archivo y un número de línea, devuelve fragmentos semánticamente similares al código en esa ubicación. |
Para instrucciones de configuración por agente, consulta la documentación de instalación.
Benchmarks
Evaluamos calidad y velocidad en ~1,250 consultas sobre 63 repositorios en 19 idiomas (izquierda), y eficiencia de tokens contra grep+read en niveles de recuperación equivalentes (derecha).
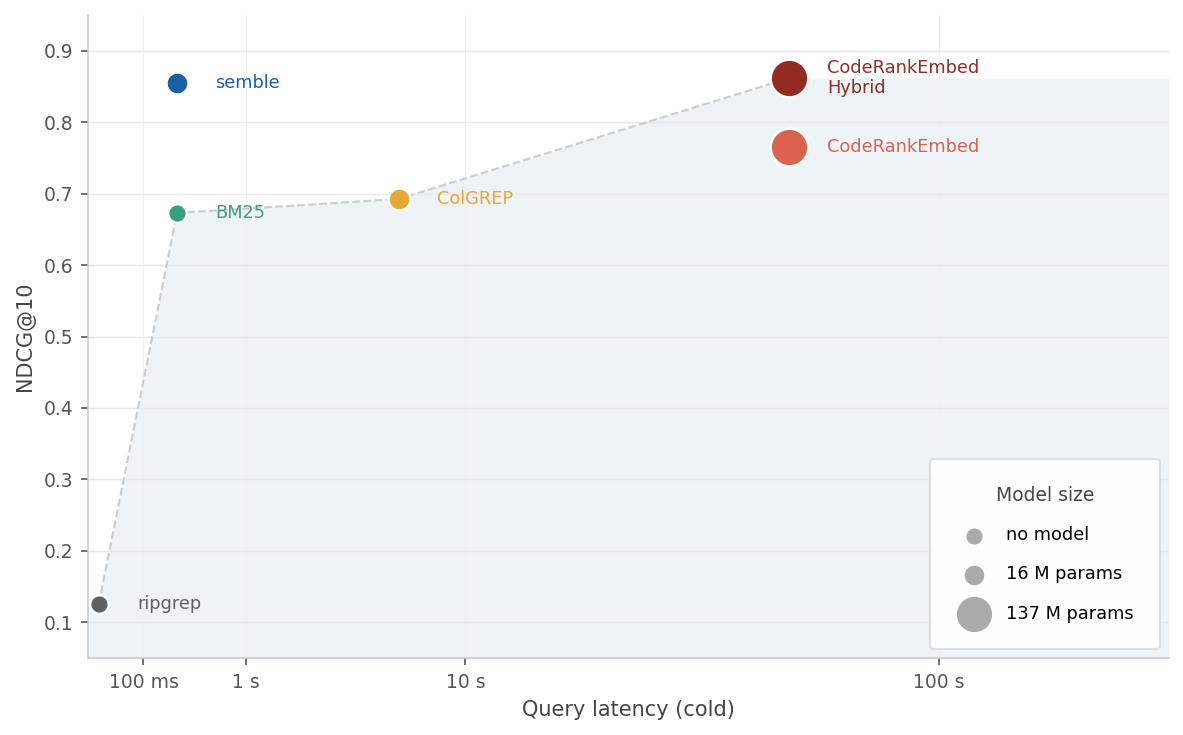 | 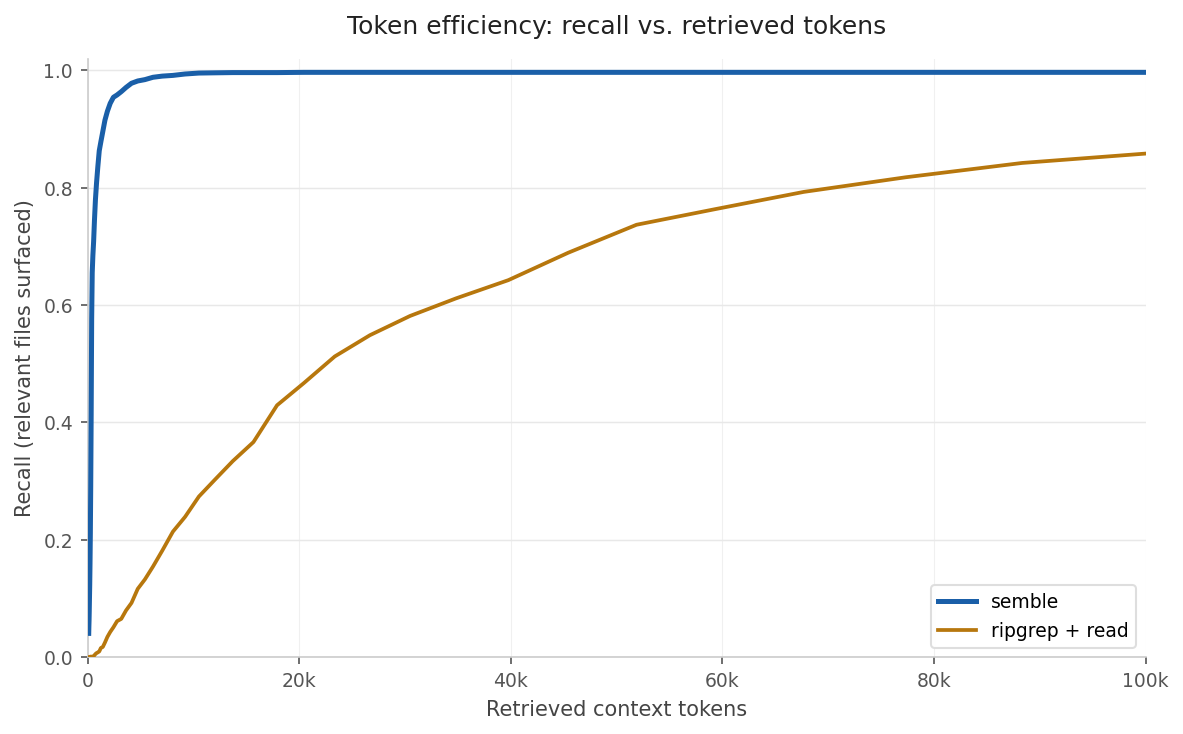 |
El benchmark de calidad (izquierda) puntúa la calidad de recuperación (NDCG@10) contra la latencia total; semble iguala la calidad del CodeRankEmbed de 137M de parámetros mientras indexa 380x más rápido. El benchmark de eficiencia de tokens (derecha) mide cuántos tokens necesita cada método para alcanzar un nivel de recuperación dado; semble usa 99% menos tokens en promedio y alcanza 97% de recuperación con solo 2k tokens, mientras que grep+read necesita una ventana de contexto completa de 100k para alcanzar 85%. Consulta benchmarks para resultados por idioma, ablaciones y metodología completa.
Cómo funciona
Semble divide cada archivo en fragmentos conscientes del código usando tree-sitter, luego puntúa cada consulta contra los fragmentos con dos recuperadores complementarios: incrustaciones estáticas Model2Vec usando el modelo especializado en código potion-code-16M-v2 para similitud semántica, y BM25 para coincidencias léxicas en identificadores y nombres de API. Las dos listas de puntuaciones se fusionan con Reciprocal Rank Fusion (RRF).
Después de la fusión, los resultados se reordenan con un conjunto de señales conscientes del código:
Señales de clasificación
- Ponderación adaptativa. Las consultas similares a símbolos (
Foo::bar,_private,getUserById) obtienen más peso léxico, mientras que las consultas en lenguaje natural permanecen equilibradas entre recuperadores semánticos y léxicos. - Refuerzos de definición. Un fragmento que define el símbolo consultado (un
class,def,func, etc.) se clasifica por encima de los fragmentos que solo lo referencian. - Raíces de identificadores. Los tokens de consulta se reducen a su raíz y se comparan con las raíces de identificadores en un fragmento, dando peso adicional a los fragmentos que los contienen. Por ejemplo, consultar
parse configrefuerza fragmentos que contienenparseConfig,ConfigParseroconfig_parser. - Coherencia de archivo. Cuando varios fragmentos del mismo archivo coinciden con la consulta, el archivo se refuerza para que el resultado principal refleje relevancia amplia a nivel de archivo en lugar de un solo fragmento fuera de contexto.
- Penalizaciones de ruido. Los archivos de prueba, los shims
compat//legacy/, el código de ejemplo y los stubs de declaración.d.tsse clasifican más abajo para que las implementaciones canónicas aparezcan primero.
Debido a que el modelo de incrustación es estático sin pase directo de transformador en el momento de la consulta, todo esto se ejecuta en milisegundos en CPU.
Los índices se cachean en disco automáticamente en la primera búsqueda. En ejecuciones posteriores, Semble recorre el árbol de archivos y compara los tiempos de modificación; los archivos añadidos, eliminados o modificados se reindexan incrementalmente, sin reconstruir el resto del índice. Una reconstrucción completa solo ocurre si cambian los ajustes de indexación (p. ej., después de una actualización de semble que cambie el modelo, la fragmentación o el formato de caché). En modo MCP, el índice se verifica y actualiza automáticamente a medida que los archivos cambian, de modo que los resultados se mantienen actualizados durante la sesión.
Usar un modelo personalizado
Si deseas usar otro modelo, puedes configurar tu variable de entorno SEMBLE_MODEL_NAME a una ruta local o repositorio de Hugging Face. Esta ruta se lee literalmente y debe contener un modelo compatible con Model2Vec. Esto es particularmente útil si no puedes acceder a Hugging Face en tiempo de ejecución.
Agradecimientos
Gracias a Greptile por proporcionar acceso gratuito a su plataforma de revisión de código con IA.
Licencia
MIT
Cómo citar
Si utilizas Semble en tu investigación, por favor cita lo siguiente:
@software{minishlab2026semble,
  author       = {{van Dongen}, Thomas and Stephan Tulkens},
  title        = {Semble: Fast and Accurate Code Search for Agents},
  year         = {2026},
  publisher    = {Zenodo},
  doi          = {10.5281/zenodo.19785932},
  url          = {https://github.com/MinishLab/semble},
  license      = {MIT}
}