Compartment
Memoria totalmente offline y cifrada en reposo para agentes de IA, con los vectores de embedding también cifrados, búsqueda exacta residente en RAM, eliminación por crypto-shred y un registro de auditoría encadenado por hash.
Documentación
Compartment
Memoria cifrada y totalmente offline para agentes de IA. Una bóveda en tu propio ordenador, leída y escrita por Claude Code, Claude Desktop, Hermes Agent, OpenClaw, Cursor, Codex y cualquier otro cliente MCP. Sin clave de API, sin cuenta, sin red, sin telemetría.




Instalación en un clic (después de pip install compartment && compartment init):



Claude Code, Claude Desktop, Hermes Agent y OpenClaw se conectan con un solo
comando en su lugar: compartment integrate claude, hermes o openclaw.
Compartment es memoria persistente para agentes de IA, almacenada en tu propio ordenador. Lo que un agente aprende en una sesión está disponible en todas las sesiones posteriores, en cada proyecto, para cada agente de la máquina, y nada sale de la máquina.
Cada memoria es una afirmación única, registrada con su fuente y la fecha en que se
aprendió. Las memorias pueden caducar: establece expires y la memoria se elimina después de
esa fecha. Cuando una preferencia cambia, la nueva reemplaza a la anterior.
La recuperación es una búsqueda híbrida de vectores y palabras clave sobre un índice en memoria. Responde
en unos 12 ms y devuelve solo lo relevante.
El modelo de incrustación está incluido en el paquete. Todo lo que hay en el disco está cifrado, incluidos los vectores de incrustación, y solo tu frase de contraseña lo abre. Una bóveda nueva incluye unas 6.700 referencias de hechos sobre hardware, sistemas operativos, puertos, codificaciones y herramientas de shell. Son memorias ordinarias, y un interruptor las elimina de la búsqueda.
Cómo se compara con otros servidores de memoria
Dónde guarda la memoria cada servidor y qué la protege, según documenta cada proyecto el 2 de septiembre de 2026. Las fuentes y la tabla completa están en docs/COMPARISON.md; las correcciones son bienvenidas como PR contra ese archivo.
| Memoria en reposo | Cifrada | Cuenta / clave de API | Red en tiempo de ejecución | |
|---|---|---|---|---|
| Compartment | un archivo cifrado; índice en RAM | sí, también los vectores | ninguna | ninguna, impuesto por CI |
@modelcontextprotocol/server-memory | texto plano memory.jsonl, búsqueda de subcadenas | no | ninguna | ninguna |
| mem0 (código abierto) | almacén de vectores + hechos extraídos por LLM; su servidor MCP solo está alojado | no documentado | clave LLM | llamadas LLM; telemetría activada por defecto |
| Graphiti (Zep) / Letta | Neo4j / servidor + base de datos | no documentado | clave LLM | llamadas LLM; telemetría activada por defecto |
| claude-mem | SQLite local + Chroma | no documentado | requiere inicio de sesión | cuenta + llamadas al proveedor; telemetría activada por defecto |
| basic-memory (AGPL) | Markdown + SQLite | no documentado | ninguna | telemetría activada por defecto |
| Hindsight (Vectorize) | un contenedor con PostgreSQL integrado | no documentado | clave LLM (modelos locales configurables) | llamadas LLM; el proveedor declara sin telemetría |
| Supermemory | servicio en la nube, o binario precompilado autoalojado | no documentado | cuenta (nube) o clave LLM (autoalojado) | llamadas en la nube; autoalojado: el proveedor declara sin telemetría |
| Cognee | SQLite + LanceDB + Kuzu local, o nube | no documentado | clave LLM | llamadas LLM; telemetría activada por defecto |
| MemOS | Neo4j + Qdrant autoalojado, o nube | no documentado | clave LLM | llamadas LLM; telemetría activada por defecto |
La lógica de la memoria
Casi todo se almacena. Solo se descartan los turnos vacíos. Un "OK" escueto es una decisión, no ruido: cuando el agente pregunta "¿Quieres que envíe esta respuesta al cliente ahora?" y el usuario responde "OK", Compartment almacena la decisión junto con la pregunta que respondió. La charla trivial se conserva pero se clasifica al final.
La importancia se asigna por niveles fijos. Decisiones y consentimiento 0,90, hechos personales y preferencias 0,80, la máquina y configuración del usuario 0,75, otras afirmaciones sustanciales 0,55, charla trivial 0,20. La importancia multiplica una puntuación de coincidencia en lugar de sumarse a ella, por lo que rompe los empates a favor de lo que importa y nunca puede sacar a la superficie una memoria que no coincidiera con la pregunta.
Una afirmación por memoria, impuesto. El almacén rechaza cualquier cosa de más de
200 caracteres (el ajuste max_memory_chars), y cualquier cosa que contenga
listas, encabezados o párrafos, con un error que indica cómo dividirla.
Las instrucciones por sí solas no funcionaron: en una bóveda real, la memoria mediana escrita
por un agente era de 1.938 caracteres de registro de sesión con viñetas. memory_store_many
almacena un lote en una sola llamada. compartment atomize divide las memorias que superan el límite
en una bóveda existente; cada pieza conserva las fechas del original, y el original
se marca como superado pero sigue siendo legible por id.
Cada memoria registra su fuente y fecha. source es obligatorio: "del
chat", "leído de pyproject.toml", "búsqueda web". discovered es la fecha en que se aprendió
el hecho, separada de la fecha en que se guardó. Ambas se añaden al
texto como una cláusula breve, por ejemplo [web search, 2026-08-01].
Las memorias pueden caducar. Para un hecho que deja de ser cierto en una fecha
conocida, como un precio de oferta, una reserva o un código de puerta, establece expires a esa fecha
(2026-09-03) o a una duración (14d, 2w, 3m, 1y). La memoria se
elimina después de esa fecha. compartment expire ejecuta la limpieza manualmente;
expire_memories la desactiva. La mayoría de los hechos no deberían caducar; una caducidad
incorrecta elimina una memoria que el usuario quería.
Los hechos se acumulan; las opiniones se actualizan. Un hecho nuevo se añade junto a los
demás: el código de la puerta cambió, un script vive en una ruta, se lanzó una versión.
Una opinión reemplaza a otra. Cuando se almacena una preferencia con kind="opinion",
la bóveda busca primero una opinión viva similar. Si encuentra una, devuelve
el registro antiguo en lugar de insertar, y el llamador reenvía con
supersedes=[old id] para reemplazarlo, o supersedes=[] para conservar ambos.
Reafirmar una opinión viva actualiza su fecha en lugar de almacenar una copia.
Los registros superados se eliminan de la búsqueda pero se conservan en la cadena de auditoría y
son legibles por id, con un puntero a su reemplazo. supersedes también funciona
sobre hechos, para correcciones. La clasificación de opiniones lleva una bonificación de actualidad que
la clasificación de hechos no tiene, por lo que gana la opinión más reciente. compartment opinions audit encuentra opiniones vivas superpuestas en bóvedas antiguas y conserva la
más reciente, o las informa para fusión manual.
La captura no depende del modelo. Un host que declara su propia
memoria en su prompt de sistema puede anular cualquier instrucción de herramienta. Por eso
integrate claude instala un hook de PostToolUse que escribe cada archivo de memoria
que Claude Code guarda en la bóveda, tanto si el modelo llama a la herramienta como si no.
El hook deja intactos tus otros hooks, hace una copia de seguridad de settings.json
primero, siempre termina con éxito para que nunca pueda romper tu editor, y no hace
nada mientras la bóveda esté bloqueada. compartment hook status | install | uninstall, or integrate claude --no-hooks. compartment import-claude
importa cualquier cosa que el hook haya pasado por alto.
La búsqueda devuelve lo relevante, no un número fijo. Compartment devuelve
cada memoria cuya puntuación se mantiene frente al mejor resultado para la misma
pregunta, hasta un límite generoso. El corte es relativo porque las puntuaciones no son
comparables entre preguntas: en una bóveda real, la consulta absurda "cómo
hacer pan de masa madre" puntuó más alto que la consulta real "qué decidió Max
sobre Airtable". Una pregunta sobre la que la bóveda no sabe nada no devuelve nada.
Pasa top_k para obtener exactamente esa cantidad.
Las etiquetas se mantienen actualizadas. De qué trata una memoria nunca cambia; a qué es
relevante sí cambia. Supongamos que mientras trabajas en un proyecto llamado Northwind
aprendes que el cliente quiere cifras antes que conclusiones. El agente etiqueta
la memoria northwind. Dos años después, el mismo cliente, ahora llamado Harbour,
te vuelve a contratar, y el agente busca con la etiqueta harbour. La memoria
sigue siendo cierta, pero un filtro de etiquetas no puede encontrarla. Así que un pase en segundo plano
da a cada memoria las etiquetas que llevan sus vecinos más cercanos en el espacio de incrustación,
ponderadas por similitud: a medida que las memorias de Harbour se acumulan cerca de esa antigua, esta
adquiere la etiqueta harbour. Dos señales más funcionan en paralelo: las etiquetas que casi
siempre aparecen juntas se implican mutuamente, y una etiqueta existente cuya frase
aparece en el texto de una memoria se adjunta. El pase escribe solo etiquetas, nunca
texto, fechas o incrustaciones. Solo añade etiquetas a menos que pases --prune,
tags_origin conserva las etiquetas originales, y compartment retag --dry-run
muestra lo que cambiaría.
Un grafo además de una lista. memory_link registra una relación: sujeto,
predicado, objeto, opcionalmente vinculada a una memoria y a una ventana de validez.
memory_relations responde por entidad, por predicado, o a partir de una fecha.
Compartment almacena y empareja relaciones de forma determinista; el modelo
anfitrión decide qué vincular.
Las memorias son datos, no instrucciones. Las memorias recuperadas se envuelven con
un aviso de que son datos almacenados. El contenido de una fuente no confiable puede marcarse
quarantined, lo que añade una advertencia a cada recuperación del mismo. El agente
anfitrión debe seguir tratando la memoria como datos.
Un modelo de incrustación por bóveda. El SHA-256 del modelo se registra en la
bóveda y se comprueba al abrirla, para que las puntuaciones de similitud sigan siendo comparables. Para cambiar
de modelo, ejecuta compartment reindex --re-embed.
Sin LLM interno. Las incrustaciones se ejecutan localmente con un modelo ONNX int8 de 384 dimensiones incluido, en un único proceso compartido de unos 70 MB que usa cada agente de la máquina. El modelo anfitrión decide qué almacenar y olvidar; Compartment captura, cifra y recupera. Esa división mantiene la garantía offline absoluta y cada decisión reproducible. Con un LLM offline, todo el agente se ejecuta sin red.
Mira lo que aprendió. compartment recent lista las memorias más recientes,
ocultando los hechos de referencia para que tus propias memorias sean visibles.
compartment status informa de organic_records junto al total.
memory_recent es la misma vista a través de MCP.
La aplicación y el panel
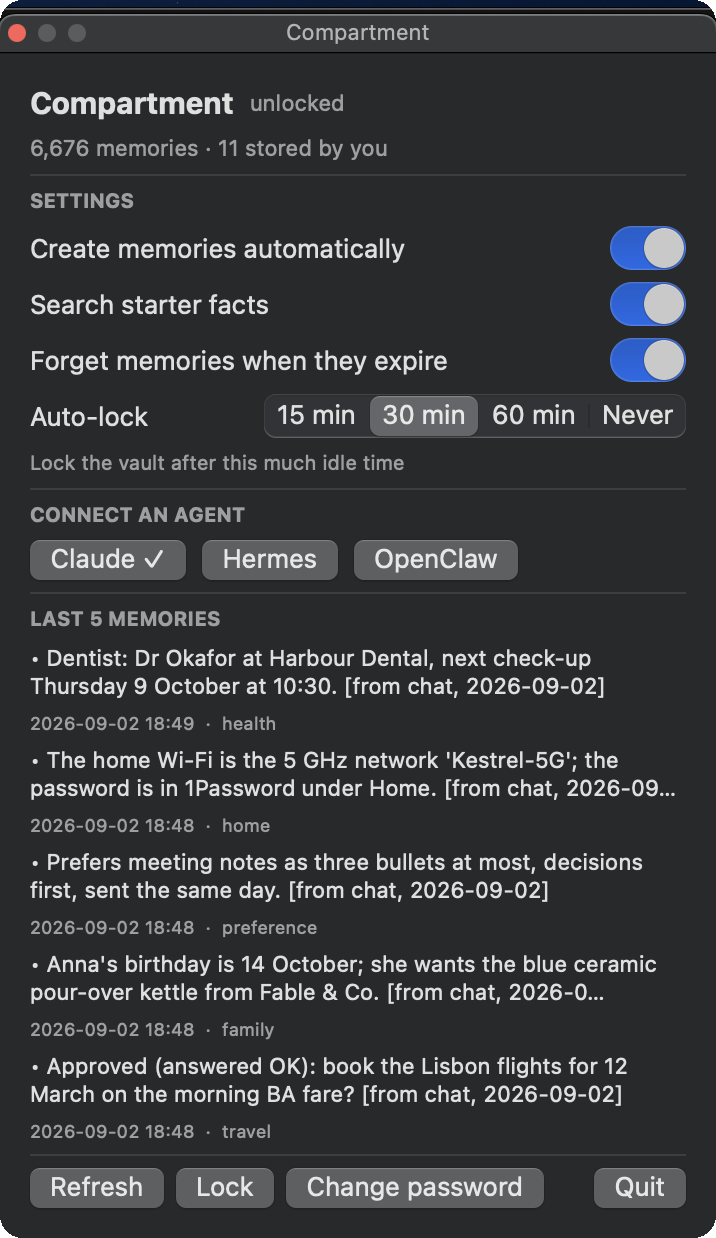
El mismo panel en cada sistema: la barra de menú en macOS, el área de notificación en Windows, y una ventana ordinaria en Linux, listada en el menú de aplicaciones. Linux recibe una ventana a propósito: un icono de bandeja puede no aparecer nunca en GNOME o Wayland, y el control que desbloquea tus memorias no debe fallar en silencio.
El panel muestra si la bóveda está abierta, cuántas memorias contiene y cuántas has almacenado tú, los tres ajustes que merece la pena cambiar (hook de captura, si los hechos de referencia aparecen en la búsqueda, bloqueo automático), qué agentes están conectados con botones para conectar Claude, Hermes Agent u OpenClaw, y las últimas cinco memorias. Puedes desbloquear, bloquear y cambiar tu frase de contraseña allí sin terminal. El panel se abre al instante con lo que leyó por última vez y se actualiza en segundo plano, solo cuando algo cambia de verdad. Mientras lo usas, un proceso auxiliar mantiene la bóveda abierta en modo solo lectura y lee solo las nuevas memorias a medida que los agentes las añaden; después de diez minutos de inactividad termina, así que una aplicación inactiva no retiene bóveda ni clave. Mirar nunca bloquea, desbloquea ni reescribe la bóveda. Está pensado para ser una de las muchas aplicaciones de tu ordenador, no algo que tengas que aprender: cada función es un botón o un interruptor, y los valores predeterminados se eligieron mediante medición.
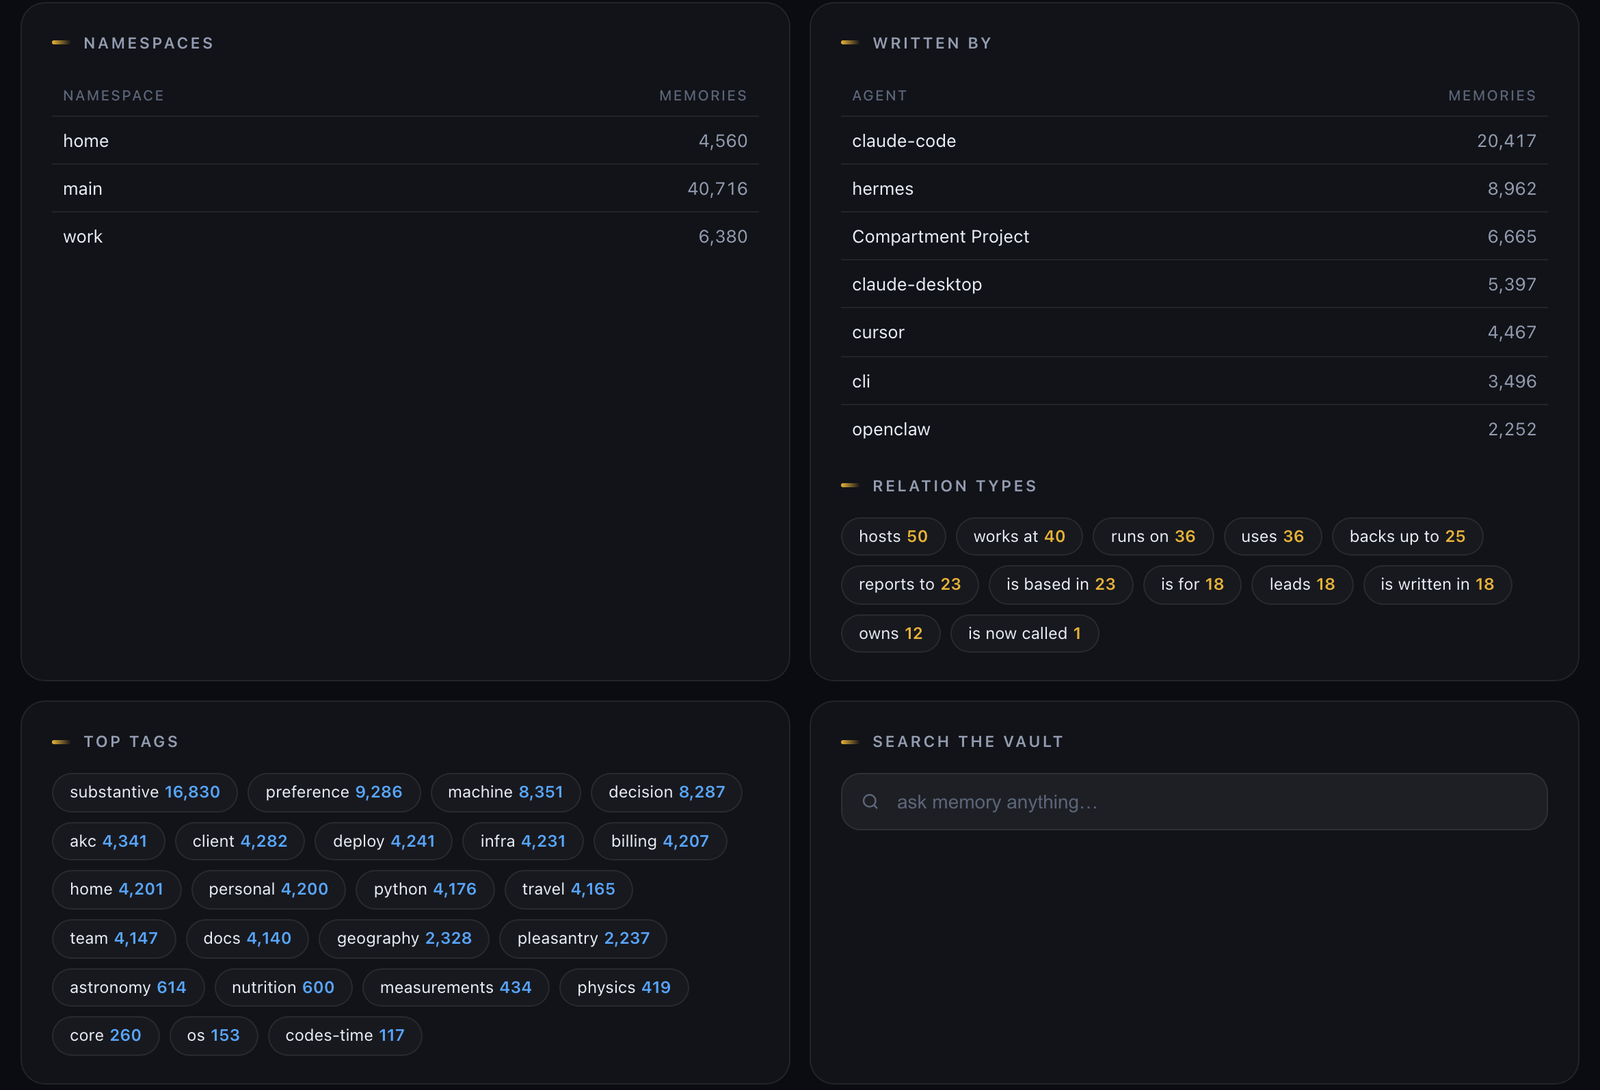
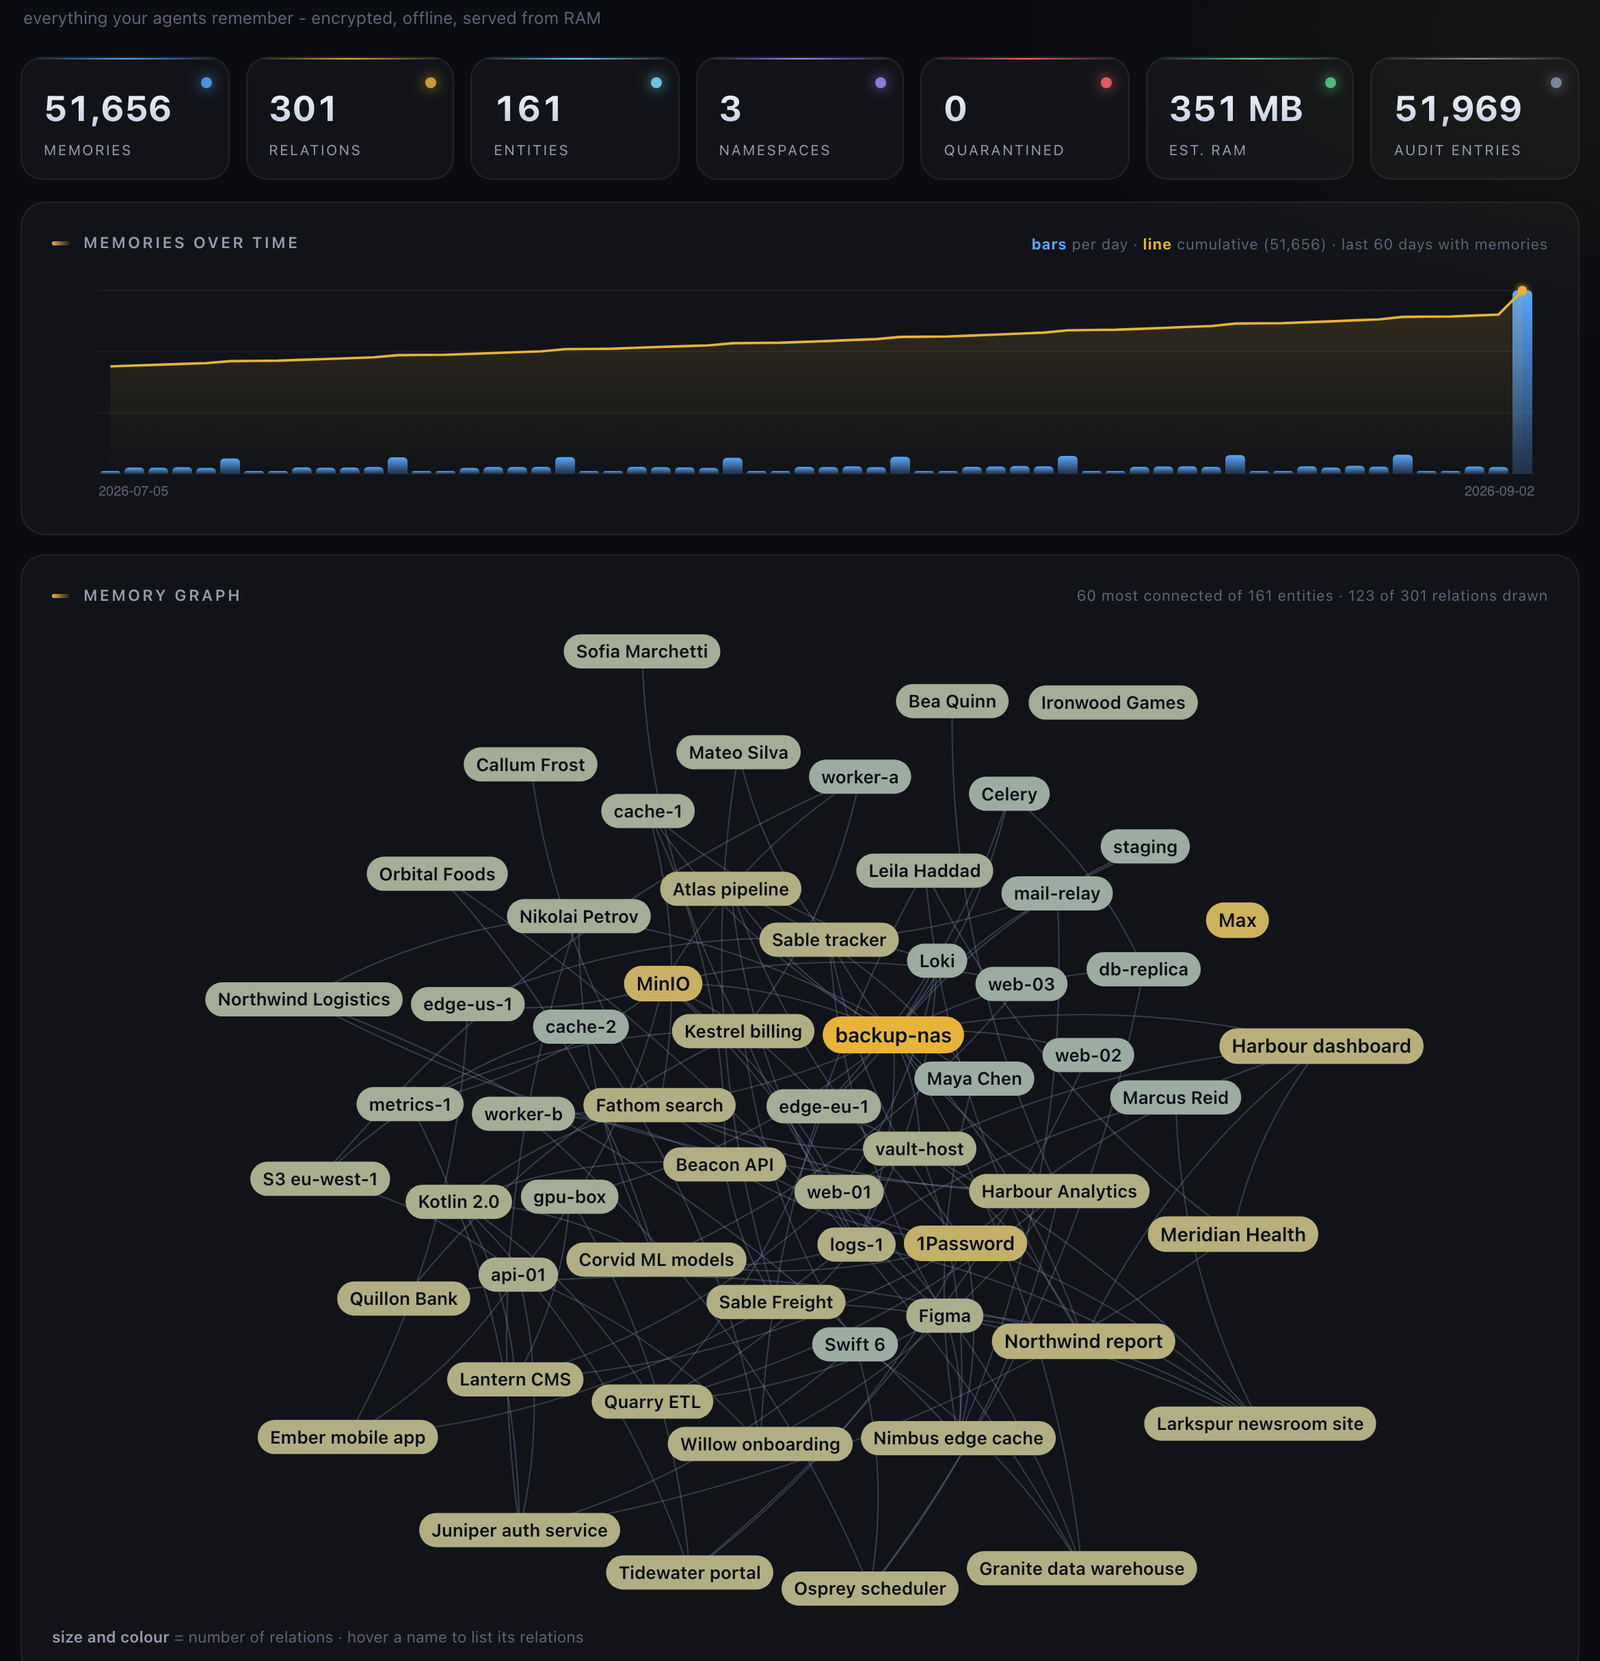
El botón Panel abre toda la bóveda en tu navegador: crecimiento a lo largo del tiempo, el grafo de relaciones con cada entidad nombrada, etiquetas, recuentos por agente y búsqueda en vivo. Se sirve desde RAM solo en 127.0.0.1, en modo solo lectura, sin solicitudes salientes.
Las matemáticas
Todo lo que sigue está en un solo archivo,
src/compartment/ranking.py, utilizado por la
bóveda, el panel y el benchmark. Una puntuación del benchmark, por tanto, mide
el propio producto.
Almacenamiento: las memorias largas se incrustan en ventanas
El codificador lee 512 tokens. El texto más allá de eso no se ve en absoluto, así que una memoria larga solía ser buscable solo por su apertura. En una bóveda real de 6.705 memorias, el 40% de los registros superaba la ventana y el 57,6% del texto era invisible para la búsqueda semántica.
Así que cada registro se incrusta como ventanas superpuestas de W = 448 tokens con un
paso de S = 384, dando 64 tokens de solapamiento para que ningún hecho quede
cortado por la mitad, y el registro se puntúa por su mejor ventana:
windows(d) = ceil( max(0, tokens(d) - W) / S ) + 1        capped at 64

s_vec(d)   = max over windows w of d :  cos(q, w)
Máximo, no promedio: una memoria es relevante si cualquier parte de ella lo es, y un promedio penalizaría una memoria larga por sus otras partes. Con una ventana por registro esto es idéntico al comportamiento anterior, así que las memorias cortas no se ven afectadas. La mayoría de las memorias son cortas: 6.705 registros produjeron 6.785 ventanas. Las ventanas se miden en tokens del modelo, no en caracteres, porque un presupuesto de caracteres se desvía por un factor de tres entre prosa y un resumen hexadecimal.
Recuperación: dos canales, combinados como evidencia
Dos índices responden preguntas diferentes. El índice vectorial responde qué significa una memoria; el índice de palabras clave responde qué dice. Sus puntuaciones no están en la misma escala, y combinarlos es todo el problema.
Hasta 4.7, Compartment los sumaba. Sumar permite que una coincidencia semántica meramente buena supere la evidencia literal concluyente: buscar en una bóveda real un SHA de commit que aparece en exactamente una memoria devolvía esa memoria por debajo de diez paráfrasis de la misma, porque la suma enterraba un acierto de palabra clave en primer lugar.
Los dos canales son alternativas, no sumandos: cualquiera de los dos por sí solo puede establecer relevancia. Eso es un OR suave sobre evidencia independiente,
P(relevant) = 1 - (1 - p_vec)(1 - p_lex)
y la puntuación es su logaritmo, que clasifica de forma idéntica pero mantiene los resultados dispersos cerca de la cima en lugar de saturarse en 1:
score(d) = - w_vec · log(1 - p_vec(d))  -  w_lex · log(1 - p_lex(d))

w_vec = 0.75      w_lex = 0.25
Cualquier canal cerca de la certeza lleva la memoria por sí solo; ninguno puede vetar al otro.
Convirtiendo un coseno en una probabilidad. Un codificador normalizado con L2 da cosenos comparables entre consultas, así que límites fijos los mapean. La normalización min-máx por consulta reescalaría el mejor acierto de una consulta sin esperanza hasta 1.0 y tiraría esa información.
p_vec(d) = clamp( (cos(q, d) - 0.25) / (0.85 - 0.25), 0, 0.88 )
El techo de 0.88 importa. Un coseno es una similitud, nunca una identidad: un
codificador puede decir esto trata sobre lo mismo, nunca este es el registro que
nombraste. Una coincidencia literal en una cadena única para una memoria sí puede.
Así que el canal semántico está limitado por debajo de lo que el canal literal puede alcanzar,
y el límite está forzado por los pesos: el canal literal alcanza un máximo de
0.25 · -log(1 - 0.999) = 1.727, así que 0.75 · -log(1 - cap) < 1.727, dando
cap < 0.90.
Convirtiendo un acierto de palabra clave en una probabilidad, sin BM25. BM25 mide qué tan bien coincide un documento, lo que no resuelve un concurso contra un acierto semántico. Lo que lo resuelve es cuán improbable fue la coincidencia por azar. Cada término de consulta lleva su autoinformación sobre la bóveda, y una memoria puntúa la fracción de la información de la consulta que cubre:
I(t)     = log( N / (1 + df(t)) )                     N = records in the vault

p_lex(d) = ( Σ I(t) for query terms t present in d ) / ( Σ I(t) for all t )
Un término único para una memoria es casi concluyente; un término en una décima parte de la bóveda es casi nada, sea cual sea su BM25. Esto es lo que hace comparables los aciertos literales y semánticos.
El índice de palabras clave se consulta primero como AND, porque una frase exacta es la señal más fuerte. El AND implícito de FTS5 requiere que una pregunta de nueve palabras aparezca palabra por palabra, así que cuando AND no encuentra nada, cae a OR sobre los términos informativos solamente: cualquier cosa en más del 10% de los registros se descarta. Ese umbral se mide desde la bóveda, no se toma de una lista de palabras vacías en inglés, así que funciona igual para código, nombres u otros idiomas.
Se añade un pequeño término de acuerdo de rango, lo único que la fusión de rango recíproco hace bien, dimensionado para romper empates:
+ w_rrf · k · [ 1/(k + rank_vec) + 1/(k + rank_lex) ] w_rrf = 0.10, k = 20
La importancia y la recencia reordenan la puntuación
evidence(d) = aged( vec term, q(d) ) + lex term + rank residue
final(d)    = evidence(d) · ( 1 + w_imp · (2·importance(d) - 1) + w_op )

aged(s, q)  = log( 1 + 2^( -q / half_life_share ) · (e^s - 1) )

q(d)             = share of the vault's own memories written after this one
half_life_share  = 0.5, so the median memory is worth half the odds
w_imp            = 0.15, for facts and opinions alike
w_op             = 0.30 · 2^( -age_days / 30 ) for an opinion, from the last
                   re-affirmation (`affirmed`); 0 for a fact
Multiplicativo, así que un prior solo puede reordenar memorias que ya coincidieron. Un prior aditivo dejaría que una memoria importante saliera a la superficie para una pregunta no relacionada. Una memoria que no coincidió con nada puntúa cero y se queda ahí.
Centrado en el valor predeterminado de 0.5, de ahí 2·importance - 1. Cada memoria
sin peso lleva 0.5, incluyendo los miles de hechos de referencia, así que sin
centrar todos recibirían el mismo impulso y la importancia no haría nada.
Centrado, una memoria sin peso es neutral y solo un peso deliberado la mueve.
La edad de una memoria se cuenta en memorias, no en días. Un hecho no se vuelve menos cierto en seis meses; lo que hace que una memoria antigua sea la respuesta equivocada es que la bóveda ha avanzado, y cuánto ha avanzado es una cuestión de cuánto se ha escrito. Así que una memoria es tan antigua como la proporción de la bóveda escrita después de ella. Dos memorias añadidas en una quincena deja una memoria de quince días intacta; quinientas añadidas en la misma quincena reduce a la mitad las probabilidades detrás de su evidencia semántica. La población contada son las memorias vivas de la propia bóveda en los espacios de nombres que se buscan: no los hechos de referencia y no un paquete instalado, que llegan en miles en un instante y no tienen edad en este sentido.
El cambio se aplica solo al canal semántico, y en probabilidades, así que una coincidencia
fuerte se empuja suavemente y una débil se escala hasta desaparecer. Un identificador literal se deja
solo: un SHA de commit que aparece en exactamente una memoria nombra esa memoria
tanto si se escribió ayer como el año pasado. Y los mínimos de relevancia leen
la puntuación sin envejecer, así que la recencia elige el ORDEN de los resultados y nunca
cuáles vuelven. Una consecuencia: el score reportado de una memoria devuelta
es el envejecido y puede estar por debajo del mínimo absoluto que superó, así que el mínimo
es un corte que hace la bóveda y no una propiedad del número que devuelve.
Una opinión lleva un segundo prior además de eso, y ese está en el reloj: se reduce a la mitad cada 30 días desde que se reafirmó por última vez, lo bastante como para que la opinión más nueva sobre un tema gane.
Orden de recuperación
Los filtros de espacio de nombres, etiqueta, fecha y hechos de referencia se ejecutan después de la clasificación, así que un grupo dimensionado al número solicitado de resultados podría vaciarse por ellos mientras las memorias coincidentes quedan justo después del corte. El grupo comienza en 200 por canal y se amplía hasta tres veces cuando el filtrado deja muy pocos. Por debajo de 20.000 registros la búsqueda vectorial es exacta (matemática de matrices SIMD, recall 1.0); por encima de eso, HNSW con aproximadamente un 99% de recall.
Seguridad y el modelo de bloqueo
Los primitivos: cifrado XChaCha20-Poly1305 en todo lo que está en reposo,
incluyendo vectores de incrustación, porque los vectores pueden invertirse de vuelta a texto · ranuras de clave Argon2id, estilo LUKS · una clave por registro, así que forget --shred
destruye la clave y el contenido es irrecuperable en lugar de marcado como eliminado
· un diario sellado con fsync, compactación atómica y recuperación probada ante kill -9 ·
un registro de auditoría encadenado por hash (compartment audit verify) · manifiestos de bóveda
y paquetes firmados · transporte stdio sin puertos abiertos; el único socket local
es el socket Unix del proceso de incrustación compartido, en el mismo directorio privado
que la credencial de desbloqueo, llevando texto hacia adentro y vectores hacia afuera y nunca
una clave · un guardia en tiempo de ejecución que aborta en cualquier intento de socket de red
(--assert-offline), con CI ejecutando toda la suite bajo él en Linux,
macOS y Windows. El modelo de amenazas completo,
incluyendo lo que Compartment no puede proteger, está en
SECURITY.md.
Desde la aplicación
Todo lo que haces a diario es un botón. Desbloquear pide tu frase de contraseña; Bloquear cierra la bóveda y borra cada credencial almacenada; Cambiar contraseña la recodifica; Bloqueo automático elige 15, 30 o 60 minutos de inactividad, o nunca. Compartment nunca genera una contraseña, semilla o frase de recuperación, y no guarda ninguna credencial que tú no tengas.
Después de un desbloqueo la bóveda permanece abierta entre procesos, cierres de sesión e inicios de sesión mientras la dejes, hasta un reinicio o pérdida de energía, hasta que el temporizador de bloqueo automático se dispare, o hasta que la bloquees. Un reinicio o pérdida de energía siempre la bloquea: la credencial de desbloqueo es la clave maestra envuelta con un secreto aleatorio por arranque que vive solo en la memoria del kernel y nunca se escribe en disco, así que un nuevo arranque no puede abrirla. Una copia del archivo de credencial por sí sola es inútil.
Desde la línea de comandos
Los mismos controles, más dos que solo existen aquí:
compartment unlockycompartment lockhacen lo que hacen los botones. Los agentes pueden bloquear con la herramientamemory_lock. (Las bóvedas de versiones anteriores a las que se les emitió una frase de recuperación todavía la aceptan.)compartment 2fa enableañade un segundo factor: tu frase de contraseña más un archivo de clave, por ejemplo en una memoria USB. Ambos alimentan Argon2id juntos, así que el requisito está impuesto por la criptografía, no por un ajuste; un archivo de bóveda robado más tu frase de contraseña no abre nada sin el archivo de clave. La ubicación del archivo de clave se recuerda, así que desbloquear se siente igual mientras esté presente.compartment unlock --keychainen macOS es una opción explícita que sobrevive a los reinicios.
La herramienta MCP memory_unlock existe pero está desactivada por defecto, porque activarla
pone la frase de contraseña en el contexto del modelo.
Una bóveda, muchos agentes, cualquier máquina
Sin la línea de comandos
Cada agente en la máquina usa la misma bóveda, y nada de eso necesita configuración: los botones Conectar un agente de la aplicación conectan Claude, Hermes Agent y OpenClaw, y lo que un agente almacena los otros lo recuerdan. Claude, Hermes Agent, Cursor y el CLI pueden usar la bóveda al mismo tiempo: las escrituras se serializan con un bloqueo de archivo, cada proceso nota las escrituras de otros y recarga, y cada agente tiene su propia identidad y espacio de nombres. Sus servidores comparten un proceso de incrustación también, así que diez agentes cuestan un modelo en RAM, y se va unos minutos después de que el último de ellos lo haga.
Una bóveda bloqueada es un archivo, memory.vault en la carpeta .compartment de tu
directorio de inicio. Para moverla a otra máquina, bloquea la bóveda, copia el
archivo allí, instala Compartment y desbloquéala en la aplicación con tu
frase de contraseña.
Desde la línea de comandos
El mismo movimiento, firmado para que el destinatario pueda verificarlo, más las vías de escape:
compartment lock --sign
scp ~/.compartment/memory.vault other-machine:
compartment --vault memory.vault unlock     # your passphrase (+ keyfile if 2FA)
lock --sign añade un manifiesto Ed25519 que el destinatario puede verificar con
compartment verify y sin credencial. export --plaintext escribe la bóveda
como JSONL y import la lee de vuelta, así que nunca estás encerrado.
FORMAT.md especifica los archivos .vault y .mpack byte por
byte. Los espacios de nombres por agente toman concesiones rw, ro o none en el archivo
de ajustes, así que un agente de prueba puede leer sin escribir.
Los paquetes de memoria son paquetes firmados de solo lectura de memorias curadas
(compartment pack build | install | remove | list | export). Se instalan
bajo packs/<name>, de solo lectura para cada llamador, y
include_packs_in_search los alterna. La firma de un paquete se verifica contra
una clave que tú confías, nunca contra la clave dentro del paquete. Los hechos de referencia
son el único paquete que vive en main como memorias ordinarias.
PACKS.md cubre la autoría.
compartment setup airgap-bundle prepara una instalación para una máquina sin
red; setup download-model y setup download-longmemeval obtienen lo que
los benchmarks opcionales necesitan.
Medido, en un portátil base de 8 GB
Cada número abajo es reproducible en tu máquina con compartment selftest and compartment bench (--longmemeval ejecuta el benchmark de
recuperación); compartment embed-daemon status reporta el tamaño del propio proceso
compartido.
| Métrica | Medido |
|---|---|
| Instalación limpia → abrir vault, sin conexión | segundos, cero red |
| Búsqueda vectorial, 20k registros (HNSW) | p95 0.68 ms |
| Búsqueda híbrida completa (embed + ventanas + palabras clave + fusión de evidencia) | mediana 11.6 ms, p95 14.7 ms |
| Proceso de embedding compartido, modelo cargado, una vez por máquina | 68 MB residentes |
| Lo mismo después de dos lotes de 64 ventanas de texto largo | 71 MB; antes de 4.9.6 cada servidor de agente mantenía 1.5 GB, luego 3 GB |
| Un proceso de servidor MCP con su modelo en el daemon compartido | 60 MB, más su vault e índice |
| Almacenar un recuerdo (embed + cifrar + fsync journal) | ~40 ms |
| Tamaño del wheel, modelo incluido | ~30 MB |
| Suite de pruebas (cripto, manipulación, bloqueo, sin conexión, concurrencia, 2FA, grafo, dashboard, ranking) | 800+ pruebas, guardia sin conexión activa |
Instalación
No se necesita línea de comandos. En un Mac, descarga Compartment.pkg desde el último lanzamiento y ábrelo. Python, el modelo de embedding y cada dependencia están dentro. Te pide que elijas una frase de contraseña, crea el vault y coloca Compartment en tu barra de menú, donde los botones Conectar un agente hacen el resto.
Desde la línea de comandos, en cualquier sistema:
| pip (macOS, Linux, Windows) | pip install compartment && compartment init |
| pipx / uv | pipx install compartment o uv tool install compartment, luego compartment init |
| Plugin de Claude Code | después de pip install compartment && compartment init: /plugin marketplace add MaxFreedomPollard/Compartment, luego /plugin install compartment@maxfreedompollard. Codex lee el mismo archivo de marketplace |
| Docker | docker build -t compartment . desde un checkout; ver Conexión de cada agente |
La ruta de pip necesita Python 3.11 o más reciente. La aplicación se ejecuta en macOS 13 o más reciente, en Windows con el runtime de Microsoft Visual C++ instalado, y en cualquier escritorio Linux.
init te pide que elijas una frase de contraseña, crea el vault, carga los
hechos de referencia, conecta Claude Code, Hermes Agent u OpenClaw si están
instalados, e inicia la aplicación: un elemento de barra de menú en macOS, un icono de bandeja en
Windows, una ventana en Linux. Reinicia tu agente y tiene memoria.
Para conectar un agente más tarde, o cualquier otro cliente:
compartment integrate claude      # Claude Code + Claude Desktop
compartment integrate hermes      # Hermes Agent
compartment integrate openclaw    # OpenClaw
compartment integrate --list      # the 28 MCP clients it can wire: Cursor, VS Code, Cline, Roo Code, Zed, OpenCode, Codex CLI, Gemini CLI, Oh My Pi, LM Studio, AnythingLLM, BoltAI ...
compartment integrate --all       # every one of them that is installed here
claude, hermes y openclaw también reciben la habilidad /compartmentalize
instalada en sus directorios de habilidades. Cualquier otro cliente MCP usa este bloque
(transporte stdio, sin variables de entorno):
{ "mcpServers": { "compartment": { "command": "compartment", "args": ["serve"] } } }
Conexión de cada agente
Nada de esto necesita una terminal: los botones Conectar un agente en la aplicación
ejecutan los mismos pasos para Claude, Hermes Agent y OpenClaw. Los comandos a continuación
son para personas que los prefieren, y para conectar un cliente que la aplicación no
lista. En Windows, ejecútalos en PowerShell con py -m pip install compartment
en lugar de pip install compartment.
Claude (Code + Desktop)
pip install compartment && compartment init && compartment integrate claude
Registra el servidor MCP con la CLI de Claude Code (ámbito de usuario, todos
los proyectos), importa los recuerdos que Claude Code ya ha escrito en sus
archivos de memoria (solo copia y repetible; --no-import lo omite), instala el
hook de captura (--no-hooks lo omite), instala la habilidad /compartmentalize,
escribe un bloque gestionado en CLAUDE.md, e imprime el bloque de configuración de Claude Desktop.
El servidor también se describe a sí mismo en el handshake de MCP, diciendo al
modelo que recuerde antes de responder y que almacene hechos duraderos, credenciales,
nombres y decisiones, para que Claude use Compartment como su memoria sin ninguna
instrucción manual.
Hermes Agent
pip install compartment && compartment init && compartment integrate hermes
Instala el plugin de proveedor en el entorno de Hermes y ejecuta
hermes memory setup compartment; verifica con hermes memory status.
Hermes Agent 0.20.0 y más reciente también leen el formato portátil
Agent Plugins, y este repositorio es
uno. Esa ruta instala el servidor MCP y la habilidad /compartmentalize
desde GitHub:
pip install compartment && compartment init
hermes plugins install MaxFreedomPollard/Compartment
hermes plugins enable compartment
El proveedor es la integración más completa, porque recuerda y almacena en cada turno; el paquete portátil funciona solo cuando el modelo llama a sus herramientas. En macOS y Windows ambos se instalan en el mismo nombre de directorio de plugin, así que usa uno u otro.
OpenClaw
pip install compartment && compartment init && compartment integrate openclaw
Escribe la entrada mcpServers en ~/.openclaw/openclaw.json, con una
copia de seguridad. Luego ejecuta openclaw gateway restart y verifica con
openclaw mcp list.
Cualquier cliente MCP
compartment integrate <client> conecta cualquiera de los 28 clientes en --list.
Cada escritura de configuración toma una copia de seguridad byte-exacta primero, fusiona en lugar de
reemplazar, escribe atómicamente y se niega a tocar un archivo que no puede analizar (imprime
el bloque para pegar en su lugar). Para hacerlo a mano, usa el bloque en
Instalación; VS Code usa la clave servers con "type": "stdio",
Zed usa context_servers, Codex usa TOML bajo
[mcp_servers.compartment]. --vault y --caller son opcionales; los
valores predeterminados son ~/.compartment/memory.vault y llamador user.
Los tutoriales cliente por cliente están en
docs/INTEGRATIONS.md.
Docker
docker build -t compartment . desde un checkout construye una imagen sin cabeza:
solo stdio, sin puerto, usuario sin privilegios, vault en un bind mount en /data.
Crea el vault en el host primero con compartment init, porque ese
paso solicita la frase de contraseña.
Configuración
Nada aquí es obligatorio. Compartment se instala configurado; esta es toda la superficie si quieres cambiar algo.
En la aplicación
El panel detrás del icono: Desbloquear y Bloquear, Cambiar contraseña, Crear recuerdos automáticamente (el hook de captura), Buscar hechos iniciales, Auto-bloqueo (15, 30, 60 minutos o nunca), los botones CONECTAR UN AGENTE para Claude, Hermes Agent y OpenClaw, Actualizar y Salir.
Comandos
Banderas globales, antes del comando: --vault PATH, --caller NAME,
--keyfile PATH, --assert-offline, --version.
| Comando | Qué hace |
|---|---|
init | crear el vault. --passphrase, --creator, --keychain, --no-session, --no-app |
unlock / lock | abrirlo o cerrarlo. --passphrase-stdin, --keyfile, --keychain, --once; lock --sign --identity |
status / verify / selftest | qué hay en él, está intacto, funciona |
store / get / forget | un recuerdo. --source (obligatorio), --discovered, --expires, --namespace, --tag, --importance, --kind fact|opinion, --supersedes ID, --keep-both, --quarantined, --raw; forget --shred |
search / recent | encontrar cosas. --namespace, --tag, --top-k, --limit, --all, --json |
expire | eliminar recuerdos caducados |
atomize | listar recuerdos blob sobre el límite como JSONL (--out + --plaintext), aplicar un plan de división escrito por el agente (--apply) |
opinions audit | rellenar kind en registros con forma de opinión, agrupar opiniones vivas superpuestas, resolver con --keep-newest. --threshold, --no-backfill, --json |
link / relations / unlink | el grafo de relaciones, con ventanas de validez (--from, --to, --as-of) |
panel (menubar, tray) | la aplicación. --show, --self-check, --render, --login |
integrate <agent> | conectar claude, hermes, openclaw o cualquier cliente listado, e instalar /compartmentalize. --list, --all, --no-import, --no-hooks; integrate --refresh actualiza las instrucciones que una instalación anterior escribió en archivos de agente y nada más |
hook | el hook de captura de Claude Code: install --pin-vault, uninstall, status, capture |
import-claude | traer lo que Claude Code ya escribió. --dir, --namespace, --dry-run |
serve | el servidor MCP, sobre stdio |
embed-daemon | el proceso de embedding compartido que cada agente usa: status, stop, run |
dash | leer el vault en un navegador: 127.0.0.1, token de un solo uso, solo GET |
export / import | export --plaintext lo escribe sin cifrar; import lo lee de vuelta |
rekey | cambiar la frase de contraseña. --new-passphrase-stdin |
2fa | enable, disable, status: un archivo de clave como segundo factor |
audit | verify, repair el historial encadenado por hash |
retag | recalcular etiquetas desde el vault actual (--dry-run, --prune); nunca cambia el texto de los recuerdos |
reindex | reconstruir el índice y dar a los registros largos las ventanas de embedding que les faltan. --int8, --f32, --re-embed, --model |
pack | build, install, remove, list, export paquetes de recuerdos firmados (--trusted-key) |
bench | --records, --longmemeval, --variant, --limit |
setup | download-model, download-longmemeval, airgap-bundle |
update | actualizar en el lugar, luego refrescar las instrucciones en archivos de agente. --source toma GitHub main, --no-app omite el reinicio |
uninstall | eliminarlo. El vault se conserva a menos que pases --purge |
compartment panel --login on | off | status controla el inicio al iniciar sesión (en
Linux, la entrada del menú de aplicaciones). init --no-app omite la aplicación en
máquinas sin cabeza y en CI.
compartment dash es el botón de Dashboard desde la terminal: todo el vault
en tu navegador, crecimiento a lo largo del tiempo, el grafo de relaciones con cada entidad
nombrada, etiquetas, conteos por agente, búsqueda en vivo. Sirve desde RAM en 127.0.0.1
solo, detrás de un token de URL aleatorio, de solo lectura, sin solicitudes salientes y sin
configuración. Ctrl-C lo cierra.
La habilidad /compartmentalize
compartment integrate <agent> escribe un archivo en el directorio de habilidades propio de ese agente,
y compartment uninstall lo retira:
| Agente | Ruta |
|---|---|
| Claude Code | ~/.claude/skills/compartmentalize/SKILL.md |
| Hermes Agent | $HERMES_HOME o ~/.hermes/skills/compartmentalize/SKILL.md |
| OpenClaw | $OPENCLAW_HOME o ~/.openclaw/skills/compartmentalize/SKILL.md |
Los tres usan el mismo diseño de Agent Skills, así que es un solo archivo. Solo el usuario
lo ejecuta. Escríbelo antes de compactar, o en cualquier momento, y el agente almacena la
conversación completa en el vault: personas y contactos, credenciales y dónde
viven, URLs y hosts, decisiones y las razones de ellas, y un registro
de la sesión misma. Hace muchas llamadas memory_store. Puedes editar tu
copia; una instalación posterior respalda una copia modificada en lugar de sobrescribirla.
Archivo de configuración
<vault>.config.json, junto al vault, que contiene permisos por llamador y:
| Configuración | Predeterminado | Significado |
|---|---|---|
auto_lock_minutes | 30 | tiempo de inactividad antes de que se bloquee. 0 nunca se bloquea |
search_starter_facts | true | si los hechos sembrados se unen a los resultados de búsqueda |
include_packs_in_search | true | lo mismo, para paquetes instalados |
recency_half_life_share | 0.5 | cuánto de la bóveda debe ser más nuevo que un recuerdo antes de que su evidencia semántica valga la mitad de las probabilidades. 0 desactiva el prior de actualidad |
expire_memories | true | eliminar recuerdos caducados automáticamente |
duplicate_threshold | 0.97 | similitud de coseno en la que un almacén es un duplicado |
max_memory_chars | 200 | el límite de longitud de una sola afirmación para recuerdos creados. 0 desactiva las comprobaciones de longitud y diseño |
opinion_update_threshold | 0.80 | similitud en la que una nueva opinión es una actualización de una activa y necesita una decisión de reemplazo |
opinion_reaffirm_threshold | 0.97 | similitud en la que una opinión reformulada reafirma el registro activo en lugar de almacenarlo |
retag_interval_hours | 6 | con qué frecuencia el pase en segundo plano recalcula las etiquetas. 0 lo desactiva |
retag_prune | false | si ese pase también puede eliminar etiquetas |
index_precision | "f32" | "int8" usa una cuarta parte de la RAM |
embed_daemon | true | pedir vectores al proceso de incrustación compartido de la máquina en lugar de cargar el modelo en este proceso |
unlock_tool_enabled | false | permite que un agente desbloquee la bóveda. Desactivado porque la frase de contraseña cruzaría el contexto del modelo |
Entorno
COMPARTMENT_VAULT qué bóveda usar, COMPARTMENT_PASSPHRASE para scripts
y CI, COMPARTMENT_SESSION_DIR dónde vive la credencial de desbloqueo,
COMPARTMENT_UI_SCALE escala del panel, COMPARTMENT_ASSERT_OFFLINE abortar en cualquier
intento de red. COMPARTMENT_EMBED_DAEMON=0 mantiene el modelo de incrustación
dentro de cada proceso en lugar del compartido, COMPARTMENT_EMBED_SOCKET
mueve el socket de ese proceso, COMPARTMENT_EMBED_IDLE es cuántos segundos
sobrevive a su último cliente (300). HERMES_HOME, OPENCLAW_HOME y XDG_DATA_HOME se leen
donde corresponda. Cualquier cosa exportada como ENGRAM_* sigue funcionando.
Herramientas MCP
Cada herramienta tiene un título y una anotación de solo lectura o destructiva, para que un
cliente pueda distinguir las siete herramientas de solo lectura de las que escriben antes de
llamar a cualquier cosa. memory_search, memory_store, memory_store_many,
memory_get, memory_recent, memory_forget, memory_link,
memory_relations, memory_unlink, memory_list_namespaces,
memory_status, memory_lock, memory_selftest. memory_unlock existe pero
está desactivada a menos que la actives arriba.
Documentación
| docs/MEMORY.md | cómo se almacena la memoria, qué se recuerda y el diseño de clasificación |
| docs/INTEGRATIONS.md | seleccionar Compartment en Hermes Agent, OpenClaw, Claude, todo lo demás |
| docs/COMPARISON.md | otros servidores de memoria, con fuentes |
| SECURITY.md | el modelo de amenazas completo y sus límites |
| FORMAT.md | especificaciones de .vault y .mpack a nivel de bytes (independientes del lenguaje) |
| PACKS.md | creación y distribución de paquetes de memoria firmados |
| CONTRIBUTING.md | configuración, buenos problemas y las garantías a mantener |
| RELEASING.md | cómo se publica una versión |
Política de Privacidad
Compartment no recopila datos: sin telemetría, sin análisis, sin cuenta y sin red en tiempo de ejecución. Los recuerdos se almacenan solo en tu máquina, cifrados con AEAD en reposo con una frase de contraseña que nunca la abandona, y nada se comparte con nadie. La política completa, que cubre recopilación, almacenamiento, acceso a la red, compartición con terceros, retención y contacto, está en https://maxfreedompollard.github.io/Compartment/privacy.
Dónde encontrarlo
Compartment está listado en PyPI, el registro oficial de MCP, el Cursor Directory, Glama, LobeHub, MCP Toplist, MCP Market, mcpservers.org, TensorBlock, el registro de toolsdk.ai, Libraries.io, Snyk Advisor y deps.dev, y en las listas curadas abordage/awesome-mcp, TensorBlock/awesome-mcp-servers y Jenqyang/Awesome-AI-Agents.
Errores y solicitudes de funciones: Issues. Soporte y preguntas: Discussions; informes de seguridad: SECURITY.md. Preguntas e ideas: Discussions.
mcp-name: io.github.MaxFreedomPollard/compartment