TinySearch
Búsqueda web eficiente en tokens para aplicaciones de chat y agentes de IA.
Documentación
TinySearch
Gasta tokens en respuestas, no en páginas web.
TinySearch busca, rastrea y reordena la web localmente, y luego le da a tu agente solo la evidencia que vale la pena poner en su contexto.
Documentación · Inicio rápido · Python · Discord





TinySearch es una herramienta de investigación web autoalojada para agentes de IA. Busca en la web, lee las mejores páginas, elimina contenido de bajo valor y devuelve evidencia compacta con URLs de origen.
Tu modelo recibe los pasajes útiles en lugar de pagar por procesar páginas web completas.
TinySearch es parte de TinySuite, un conjunto de herramientas enfocadas diseñadas para hacer que las operaciones de agentes sean más económicas al minimizar el uso de tokens mediante técnicas inteligentes de recuperación, selección y gestión de contexto.
Elige un nivel
| Nivel | Úsalo cuando | Punto de entrada | Backend de búsqueda |
|---|---|---|---|
| 1. Biblioteca Python | Estás construyendo con TinySuite o Python | pip install tinysuite-search | DDGS |
| 2. MCP de un comando | Un cliente MCP debe lanzar TinySearch por ti | uvx --from "tinysuite-search[server]" tinysearch | DDGS |
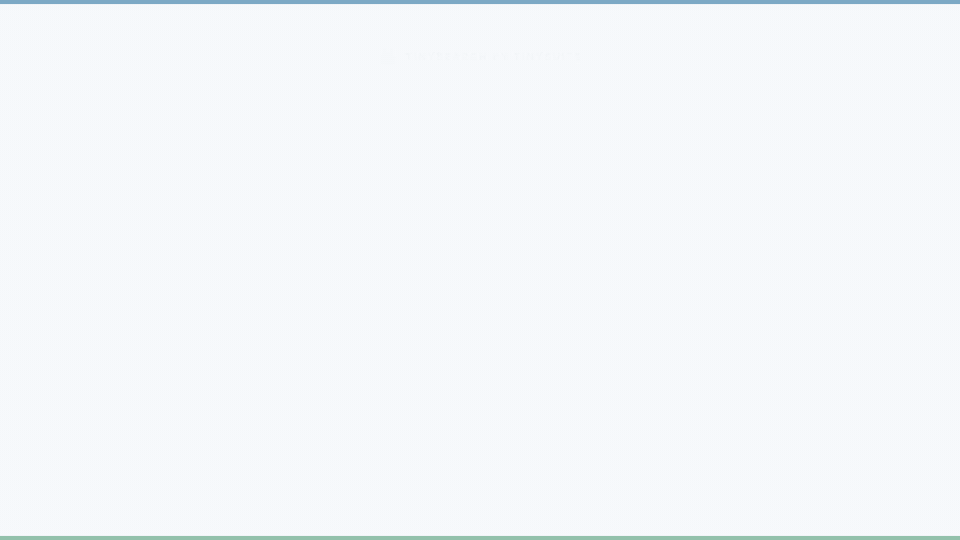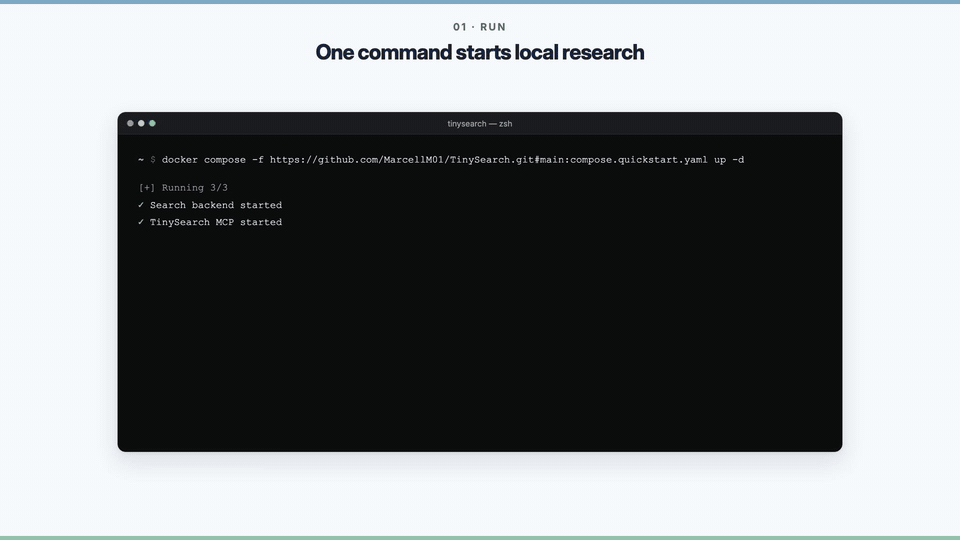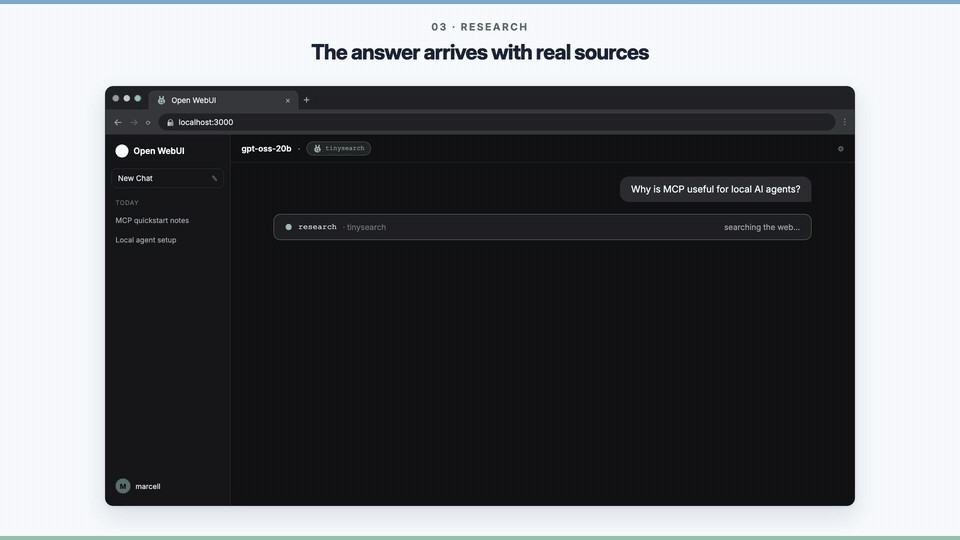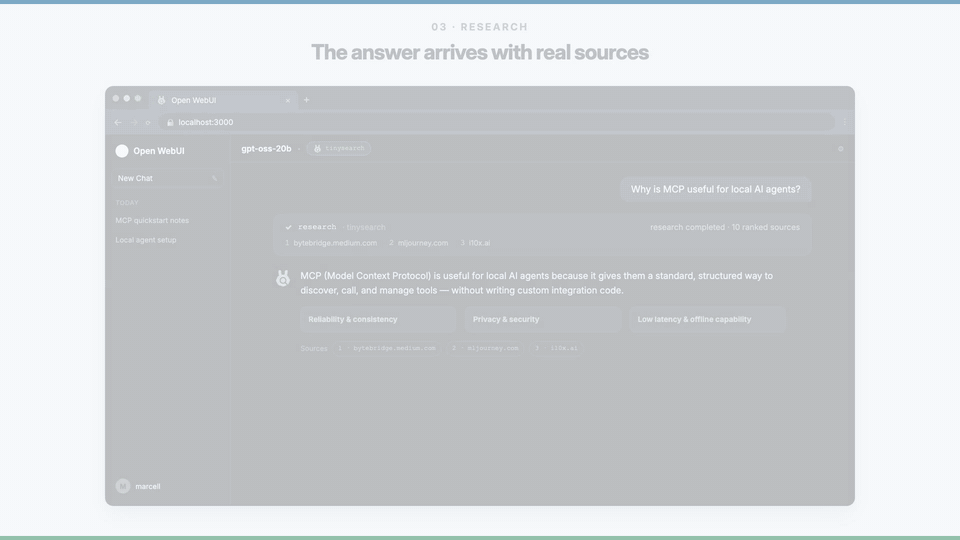
| 3. Docker + SearXNG | Quieres la pila completa autoalojada y MCP HTTP | docker compose ... up -d | SearXNG incluido |
Los niveles 1 y 2 no necesitan servicio de búsqueda. El nivel 3 añade un servicio SearXNG dedicado, almacenamiento persistente de modelos y un endpoint MCP de red. Consulta la guía de instalación para la configuración de Docker.
La parte costosa de la investigación de agentes es el contexto
Un resultado de búsqueda aún no es evidencia útil. Los agentes a menudo tienen que abrir varias páginas, ingerir navegación y texto repetitivo, y gastar tokens de entrada pagados decidiendo qué pasajes importan.
TinySearch mueve ese trabajo delante del modelo:
flowchart LR
    A[Question] --> B[Search and crawl]
    B --> C[Local hybrid reranking]
    C --> D[Compact evidence<br/>with source URLs]
    D --> E[Your agent]
Eso reduce el costo de tres maneras:
- Contexto de modelo más pequeño. Solo se devuelven los fragmentos de evidencia mejor clasificados, dentro de un presupuesto de evidencia controlado.
- Sin API de búsqueda medida por defecto. TinySearch puede buscar a través de DDGS sin un proveedor de búsqueda de pago.
- Recuperación local por defecto. Los embeddings ONNX y el reordenamiento híbrido se ejecutan en tu máquina en lugar de generar cargos de API de embeddings.
Busca ampliamente. Lee localmente. Paga al modelo solo por la evidencia que importa.
Esto es recuperación, no resumen: TinySearch selecciona los pasajes que vale la pena conservar con BM25 local y reordenamiento de embeddings; no ejecuta un modelo sobre la página para reescribirla o condensarla. Cada fragmento devuelto es el texto original de la página, sin editar, así que lo que citas es lo que la página realmente dijo. Eso mantiene el pipeline rápido y gratuito para ejecutarse localmente, a costa de no compactar tan agresivamente como podría hacerlo un modelo de reducción dedicado. Un paso de reducción aprendido es una dirección que podríamos explorar más adelante; no es parte de TinySearch hoy.
Los ahorros reales dependen de las páginas, los límites de evidencia, el modelo del cliente y los precios del proveedor. TinySearch reduce el contenido web enviado al modelo; no controla lo que el cliente hace con esa evidencia después.
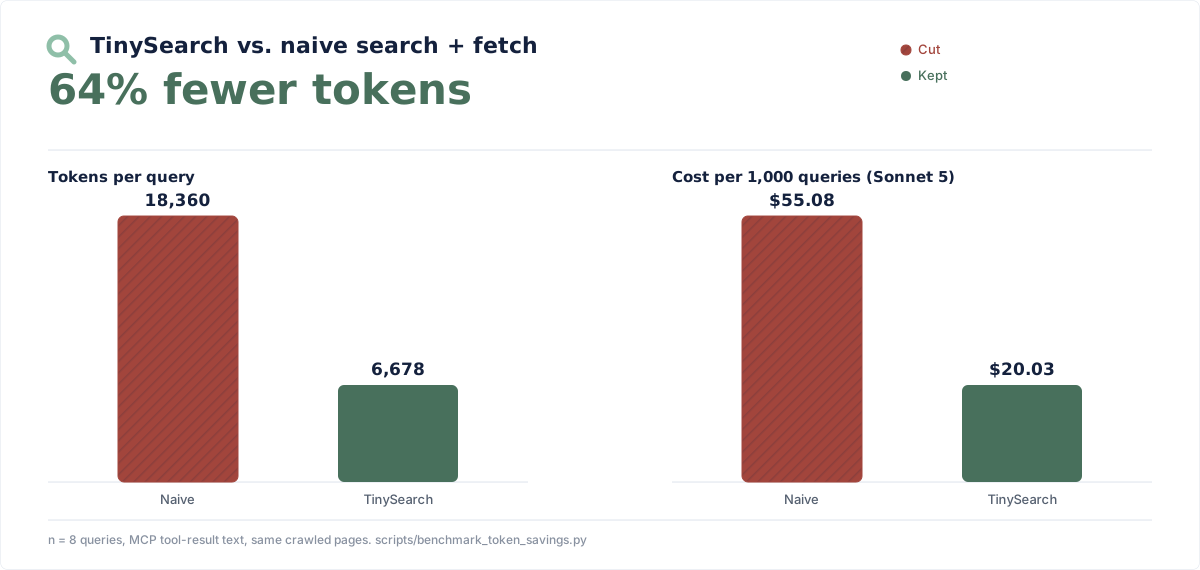
El panel de costos usa una tarifa ilustrativa de $3.00 por millón de tokens de entrada y excluye búsqueda, rastreo, salida del modelo y uso posterior del agente.
La línea base ingenua no es un producto ficticio; son las mismas páginas que TinySearch rastreó para cada consulta, alimentadas al modelo sin filtrar, como lo haría una herramienta genérica de "buscar, luego obtener la página" (un bucle simple de búsqueda web más obtención, del tipo integrado en la mayoría de los agentes de codificación). Medido contra el flujo recomendado actual (search luego scrape_urls) y contado en el texto real del resultado de la herramienta MCP, la interfaz principal de TinySearch. Reprodúcelo o vuelve a ejecutarlo tú mismo:
python scripts/benchmark_token_savings.py --json-out report.json
Inicio rápido
Con uv instalado, añade TinySearch a cualquier cliente MCP:
{
  "mcpServers": {
    "tinysearch": {
      "command": "uvx",
      "args": [
        "--python",
        "3.12",
        "--from",
        "tinysuite-search[server]",
        "tinysearch"
      ]
    }
  }
}
El cliente lanza TinySearch sobre stdio cuando lo necesita. No se requiere clonar el repositorio, cuenta alojada ni clave de búsqueda de pago.
El search rápido se inicia sin Chromium ni un modelo de embeddings. El primer raspado inicializa Chromium; el raspado enfocado también inicializa el modelo de embeddings configurado. Precalienta ambos con anticipación si usarás esos flujos de trabajo:
uvx --from "tinysuite-search[server]" tinysearch setup
Los servidores MCP y FastAPI mantienen el navegador de raspado caliente entre solicitudes cercanas, y luego lo cierran después de browser_idle_shutdown_seconds. Las llamadas directas de Python conservan su ciclo de vida de corta duración propiedad del llamador.
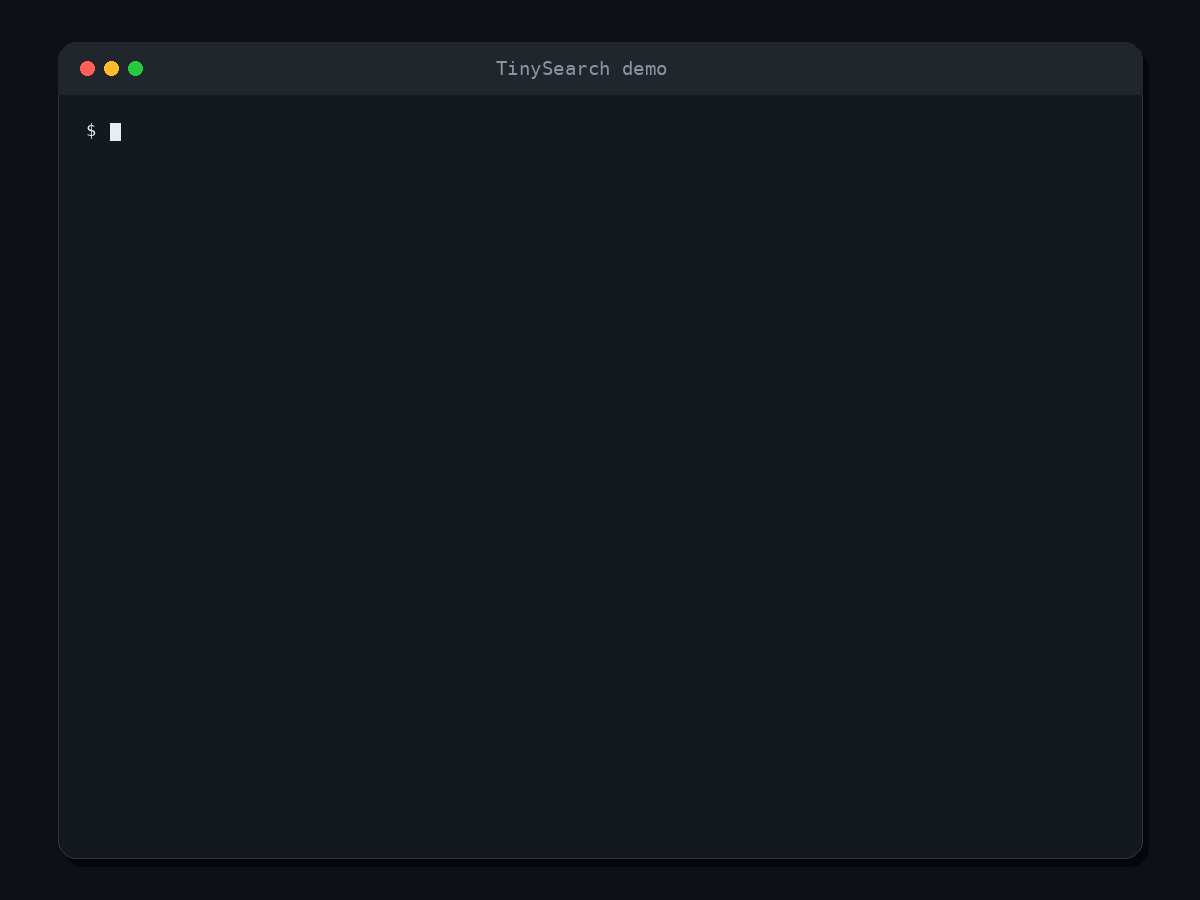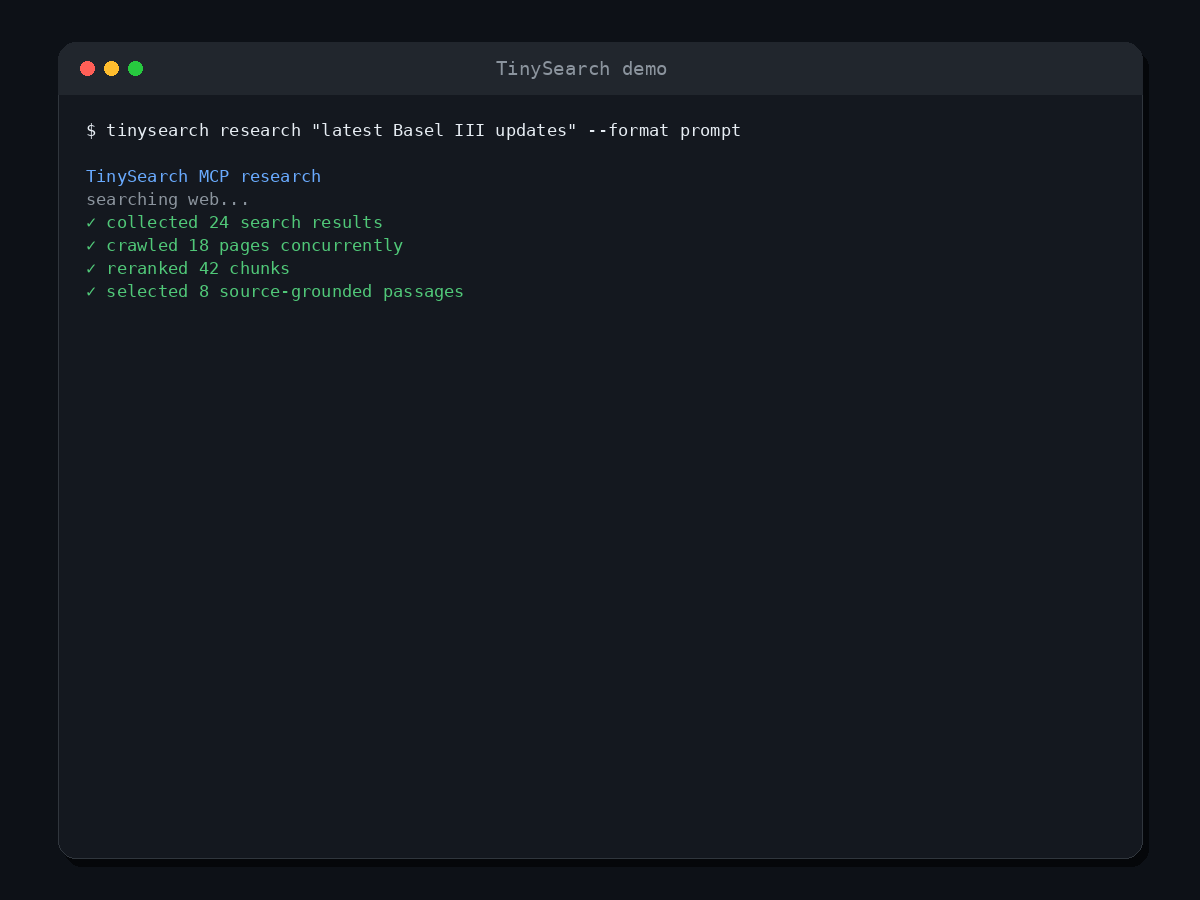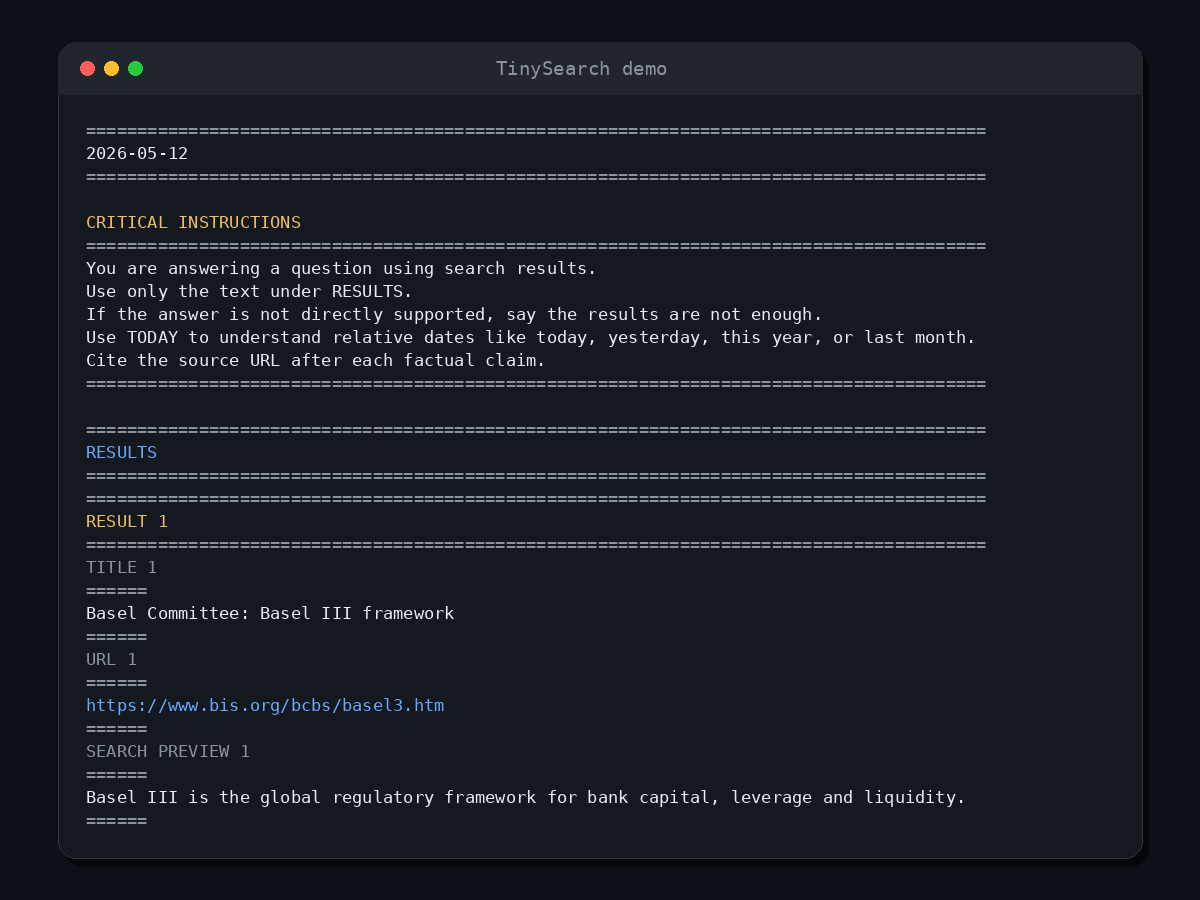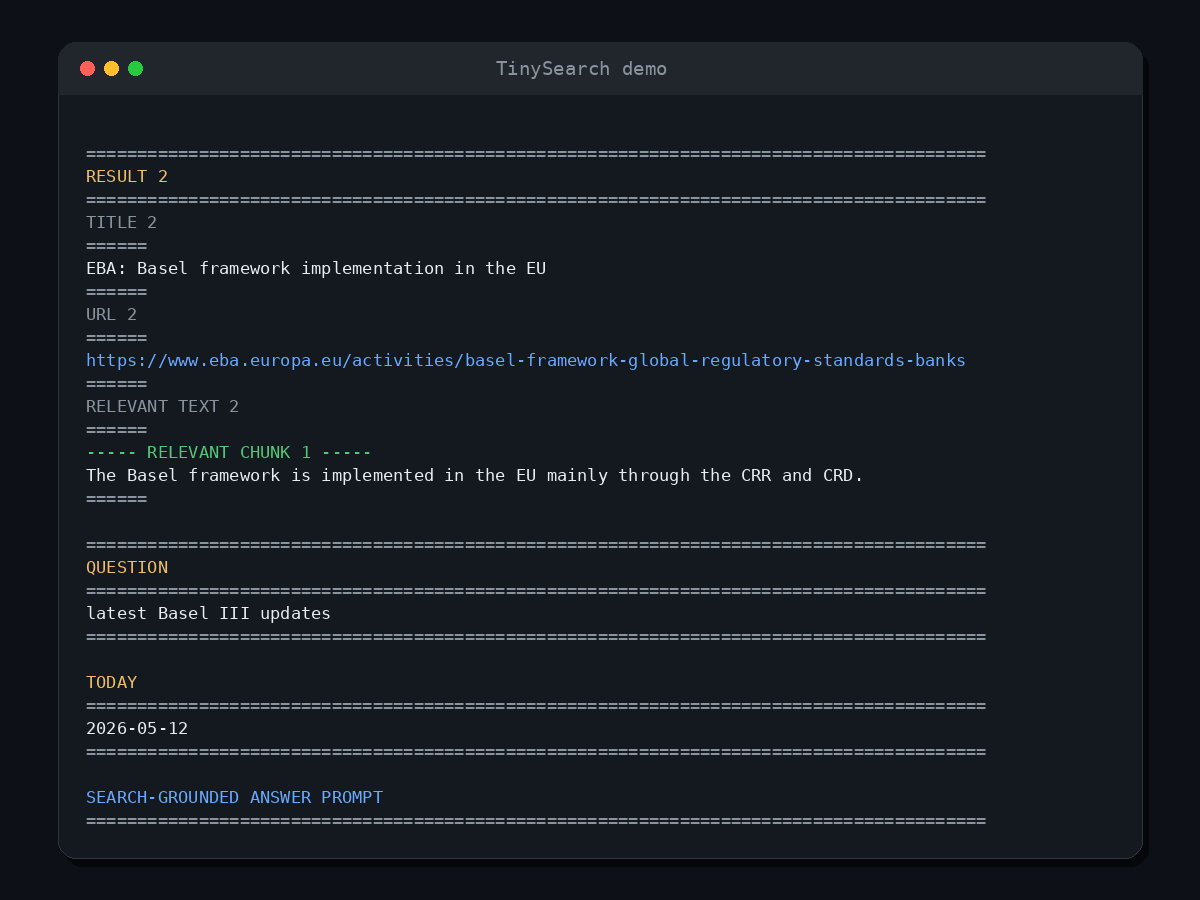
¿Prefieres Docker, un endpoint MCP remoto o una copia del código fuente? Sigue la guía de instalación.
Las herramientas MCP
| Herramienta | Úsala cuando |
|---|---|
search(items) | Necesitas descubrimiento rápido ordenado por backend sin rastreo ni reordenamiento; agrupa subpreguntas independientes cuando sea útil |
scrape_urls(items) | Conoces de una a cinco páginas; cada elemento puede usar * para su presupuesto de tokens de orden de página limpio configurado |
browser_navigate / browser_act | Una página necesita interacción antes de poder leerse; consulta Automatización del navegador |
get_current_datetime() | Una pregunta depende de la fecha o hora actual |
TinySearch se mantiene deliberadamente enfocado. Es una capa de recuperación, no otro agente, interfaz de chat, producto de búsqueda alojado o índice web permanente.
Consulta la referencia completa de herramientas MCP para parámetros y contratos de respuesta.
Lo que recibe tu agente
TinySearch no gasta otra llamada de modelo escribiendo la respuesta final. El flujo recomendado es search para descubrimiento ligero, luego scrape_urls para las páginas que valen la pena leer.
La búsqueda devuelve JSON estructurado. Usa un elemento para una consulta simple; añade múltiples elementos solo para subpreguntas independientes o estrategias de fuentes. domains es una restricción de fuente positiva estricta y acepta un dominio más sus subdominios:
{"items":[{"query":"Form 8-K Tesla","domains":["sec.gov"]}]}
Cada elemento de búsqueda informa sus propios resultados e intentos de backend compactos. Una respuesta de cero resultados es distinta de un backend bloqueado, no disponible o inválido. scrape_urls devuelve evidencia Markdown seleccionada y candidatos de navegación de enlaces relacionados separados, cada uno con techos de tokens configurados independientemente.
MCP aún usa su envoltorio de transporte JSON-RPC estándar, incluidos errores a nivel de protocolo y structuredContent opcional. Python y FastAPI mantienen sus contratos JSON estructurados para aplicaciones que necesitan almacenar, inspeccionar o transformar la evidencia.
Cómo funciona
searchdevuelve títulos, URLs, vistas previas, fechas aguas arriba y resultados de backend ordenados por backend sin iniciar Chromium ni un modelo de embeddings.scrape_urlslee de una a cinco páginas conocidas concurrentemente. Omite la consulta de un elemento o usa"*"para mantener Markdown limpio en orden de página dentro del presupuesto de tokens configurado.- Proporciona una consulta de elemento enfocada cuando TinySearch debe fragmentar y reordenar híbridamente esa página antes de devolver evidencia.
- Las herramientas
browser_*intervienen solo cuandoscrape_urlsno puede alcanzar el contenido porque necesita interacción. Consulta Automatización del navegador.
Biblioteca Python
TinySearch también funciona como un paquete Python regular:
pip install tinysuite-search
Exportación opcional de OpenTelemetry
TinySearch emite trazas y métricas neutrales al proveedor solo cuando OpenTelemetry está explícitamente configurado. El comportamiento normal de la biblioteca, MCP y FastAPI no cambia cuando la telemetría no está instalada o configurada.
Instala el soporte opcional de exportador para un servidor MCP independiente:
uvx --from "tinysuite-search[server,telemetry]" tinysearch
La imagen oficial de Docker incluye el mismo soporte opcional. Establece variables OTel estándar en cualquiera de las implementaciones; el endpoint común habilita trazas y métricas:
OTEL_SERVICE_NAME=tinysearch \
OTEL_EXPORTER_OTLP_ENDPOINT=http://collector:4318 \
OTEL_EXPORTER_OTLP_PROTOCOL=http/protobuf \
tinysearch serve
http/protobuf es el predeterminado y grpc también es compatible. Usa OTEL_TRACES_EXPORTER=none, OTEL_METRICS_EXPORTER=none o OTEL_SDK_DISABLED=true para deshabilitar la telemetría. La configuración estándar de recursos, encabezados, tiempos de espera, muestreadores y endpoints específicos de señales se pasa al SDK de OpenTelemetry; trata OTEL_EXPORTER_OTLP_HEADERS como un secreto.
TinySearch exporta tiempos de operación/etapa, resultados, conteos, estado del backend, uso del navegador, conteos de tokens y metadatos del modelo de embeddings. Nunca exporta consultas, URLs, dominios, prompts, documentos, fragmentos, encabezados de solicitud, credenciales, rutas de configuración, errores crudos, pilas de excepciones, argumentos MCP ni resultados MCP. Los usuarios directos de la biblioteca Python configuran su propio proveedor OTel; TinySearch solo autoconfigura sus puntos de entrada de servidor MCP y FastAPI independientes.
import asyncio
from tinysearch import scrape_urls, search


async def main():
    results = await search([{"query": "Python async tasks"}])
    print(results["items"][0]["results"])

    page_url = results["items"][0]["results"][0]["url"]
    evidence = await scrape_urls([{
        "url": page_url,
        "query": "How does asyncio cancellation work?",
    }])
    print(evidence["results"])


asyncio.run(main())
La API de Python devuelve resultados estables y serializables en JSON. search acepta de uno a cinco elementos y usa el límite de resultados por elemento configurado. scrape_urls acepta un presupuesto max_tokens por llamada (4,000 por defecto); omite la consulta de raspado de un elemento o usa "*" para el modo de orden de página. Renderizar evidencia estructurada en un prompt de LLM es explícito, para que las aplicaciones puedan almacenar, inspeccionar, transformar o presupuestar el resultado primero.
La aplicación FastAPI opcional refleja estas superficies. POST /search acepta el mismo contrato JSON por lotes. POST /scrape acepta de uno a cinco elementos { "url", "query" } y siempre devuelve resultados estructurados por elemento. POST /browser/navigate y POST /browser/act reflejan las dos herramientas MCP de navegador y devuelven su vista de accesibilidad como { "result": "..." }. La aplicación también expone /health, /current_datetime y /config de solo lectura; las escrituras de configuración requieren opt-in explícito de entorno.
Backends de búsqueda
TinySearch selecciona un backend de búsqueda web desde la configuración, para que puedas comenzar sin servicio de búsqueda y añadir uno después sin cambiar código.
"ddgs"(predeterminado nativo): consulta la selección automática de backend del paqueteddgsen proceso. No se requiere implementación de SearXNG."searxng"(predeterminado de Docker): consulta una instancia SearXNG autoalojada. Vuelve addgsen fallo del backend a menos quesearch_backend_fallbackesté configurado comofalse."duckduckgo": omite SearXNG y consultaddgsen modo solo DuckDuckGo."auto": intenta SearXNG, luego vuelve addgsen cualquier fallo del backend.
Establece la variable de entorno BRAVE_SEARCH_API_KEY para añadir la API oficial de Búsqueda Web de Brave como respaldo con clave para los backends ddgs y duckduckgo. Brave solo se consulta cuando la llamada principal falla o no devuelve resultados.
La referencia completa de claves, la configuración de salida JSON de SearXNG y los detalles de Compose están en la referencia de configuración.
Automatización del navegador
scrape_urls es una obtención estática. No puede ver contenido que JavaScript renderiza después de la carga, contenido detrás de un aviso de cookies, un control de "cargar más" o una interfaz de búsqueda del lado del cliente. Para esas páginas, TinySearch maneja un navegador real.
Esto no cuesta nada extra de instalar. TinySearch ya depende de Playwright a través de Crawl4AI y ya instala su Chromium para raspado, así que las herramientas de navegador reutilizan el mismo controlador y el mismo navegador: sin segundo runtime, sin segundo navegador, sin proceso hijo.
Dos herramientas: browser_navigate y browser_act, la segunda agrupando look, click, type, wait_for, tabs y close detrás de un solo parámetro action.
Esa división es deliberada. MCP no tiene forma de agrupar o anidar herramientas — tools/list
es plana y cada esquema se reenvía al modelo en cada solicitud —, por lo que siete
herramientas de navegador separadas dominarían el esquema del servidor. Publicar el punto
de entrada como su propia herramienta y plegar el ciclo de vida de una sesión de una página
detrás de un despachador mantiene el esquema de todo el servidor pequeño en cinco herramientas.
No hay una herramienta de búsqueda separada, porque buscar no es un hermano de hacer clic —
es un filtro sobre el resultado. Ambas herramientas toman un argumento find, probado como
regex primero (para que "a|b" funcione directamente) y con respaldo a una coincidencia
literal de subcadena sin distinción de mayúsculas para texto que no es regex válido —, reduciendo
el valor de retorno a los nodos coincidentes y su contexto en lugar de todo el árbol. Eso es lo
que permite que una sola llamada actúe e informe: un clic que revela una tabla regresa como la
tabla, por lo que el agente nunca gasta una segunda llamada reduciendo la respuesta de la primera.
Una versión anterior dividía esto en find y find_regex; eso costaba un viaje de ida y vuelta
desperdiciado cada vez que un modelo recurría a la sintaxis de alternancia en el parámetro de
subcadena simple y obtenía "sin coincidencias" en lugar de una pista, por lo que ambos se fusionaron.
El modelo lee un árbol de accesibilidad compacto donde cada nodo lleva una ref estable, nombra uno, y TinySearch actúa sobre él con eventos de entrada reales del navegador:
browser_navigate  -> url: "...", find: "Accept"   -> "- button \"Accept all\" [ref=e79]"
browser_act       -> action: "click", target: "e79", find: "Results"
Nada sintetiza eventos DOM ni inventa selectores CSS, y click/type
aceptan solo una ref que el modelo realmente observó, nunca un selector sin procesar.
Tres elecciones deliberadas:
- Ninguna herramienta puede ejecutar código. No hay herramienta
evaluate, ni ninguna que rellene formularios, suba archivos o arrastre. Una página que inyecta instrucciones en su propio texto renderizado no tiene nada peligroso a lo que recurrir, porque la capacidad está ausente en lugar de desaconsejada. findes la palanca de tokens,depthel respaldo. Cualquier llamada que devuelva una vista tomafind, recortándola a los nodos coincidentes y su contexto. Cuando ningún filtro puede nombrar el objetivo,depthdevuelve un árbol más superficial pero aún válido en lugar de una cadena truncada — en una página grande, ~700 caracteres frente a ~33,000.- Las cookies persisten, las sesiones no. Establece
browser_storage_state_pathy un banner de consentimiento aceptado una vez no se paga en cada navegación posterior. Las sesiones permanecen aisladas, por lo que no se toma ningún bloqueo de perfil de navegador y los clientes concurrentes no entran en conflicto. Ese archivo es una ruta del lado del servidor, nunca expuesta a un modelo ni a través de HTTP.
Para desactivar las herramientas por completo, establece "browser_backend": "off"; entonces se
eliminan de la lista de herramientas en lugar de simplemente negarse a ejecutarse.
Navegador externo a través de CDP
Para controlar un navegador que operas por separado, establece su punto final del Protocolo de Herramientas de Desarrollo de Chrome. Es utilizado por ambos, la canalización de raspado y las herramientas de navegador:
{
  "browser_cdp_url": "http://browser:9222"
}
Los procesos del servidor también aceptan TINYSEARCH_BROWSER_CDP_URL. El navegador externo
posee su ejecutable, perfil, proxy y configuración de huella digital; TinySearch
no selecciona ni instala un backend de navegador particular.
Trata un punto final CDP como control remoto privilegiado del navegador. Mantenlo en una
red privada o interfaz de bucle local, requiere autenticación cuando cruza
un límite de host, y no expongas el puerto 9222 directamente a Internet público.
Cuando TinySearch se ejecuta en Docker, localhost se refiere al contenedor
TinySearch, así que usa un punto final alcanzable desde ese contenedor.
browser_backend, browser_cdp_url y browser_storage_state_path son
gestionados por el operador y no se pueden cambiar a través del
punto final HTTP PUT /config, incluso cuando las escrituras de configuración están habilitadas.
Establécelos en el entorno de inicio (TINYSEARCH_BROWSER_BACKEND y similares) o
en el archivo seleccionado por TINYSEARCH_CONFIG_PATH, luego reinicia TinySearch. Los
clientes HTTP pueden continuar actualizando otras configuraciones omitiendo estos campos de
su actualización parcial.
Proxies
Para enrutar el rastreo a través de un proxy, establece browser_proxy_server:
{
  "browser_proxy_server": "http://gateway.proxyprovider.com:8000",
  "browser_proxy_username": "your-username",
  "browser_proxy_password": "your-password"
}
Se admiten URLs de proxy http, https y socks5, coincidiendo con lo que
Playwright acepta. Si tu proveedor entrega varios puntos finales de puerta de enlace
fijos, sepáralos con comas y TinySearch los alterna en round-robin, uno por cada nuevo
contexto de navegador:
{
  "browser_proxy_server": "http://gw1.proxyprovider.com:8000, http://gw2.proxyprovider.com:8000"
}
Usa browser_proxy_bypass para una lista separada por comas de hosts que deben
omitir el proxy. Estos cuatro campos son gestionados por el operador como las configuraciones
CDP anteriores — configurables a través de TINYSEARCH_BROWSER_PROXY_SERVER,
TINYSEARCH_BROWSER_PROXY_USERNAME, TINYSEARCH_BROWSER_PROXY_PASSWORD y
TINYSEARCH_BROWSER_PROXY_BYPASS, o el archivo de configuración, pero nunca a través de HTTP.
Por qué TinySearch
- Sin proveedor en el bucle. Sin cuenta de TinySearch, sin clave API requerida, sin facturación por solicitud, sin servicio de análisis ni caché de datos raspados alojada. La infraestructura por la que de otro modo pagarías a una API de búsqueda se ejecuta en tu máquina.
- Fundamentado en la fuente por construcción. Cada fragmento de evidencia es el texto original de la página, aún adjunto a su URL de origen, por lo que una afirmación en la respuesta de tu agente se rastrea hasta un pasaje específico en lugar de detenerse en "el modelo del proveedor dijo esto".
- Construido en torno a la eficiencia de tokens. La selección de páginas y pasajes ocurre localmente, antes de que el contenido entre en el contexto del modelo.
- Útil sin infraestructura de pago. La búsqueda DDGS y los embeddings ONNX locales son los valores predeterminados.
- Trae tu propia pila cuando sea necesario. Los proveedores de embeddings compatibles con SearXNG y OpenAI siguen siendo opcionales.
- Funciona donde los agentes ya trabajan. Usa MCP a través de stdio, Streamable HTTP, Python, FastAPI o Docker.
Parte de TinySuite
TinySuite es una suite de productos construida en torno a una idea: los agentes deberían gastar tokens en trabajo útil, no en gastos operativos.
Cada herramienta se enfoca en una parte diferente del flujo de trabajo del agente y usa técnicas dirigidas para reducir el contexto innecesario antes de que llegue al modelo. TinySearch maneja la capa de investigación web convirtiendo páginas en un paquete de evidencia pequeño, clasificado y fundamentado en la fuente.
Documentación
El README es la visión general del producto. El material detallado de configuración y operación vive en la documentación de TinySuite:
- Visión general e instalación de TinySearch
- Referencia de configuración
- Herramientas MCP
- Solución de problemas
El repositorio también contiene una configuración de ejemplo anotada en
configs/tinysearch_config.json.
Cuándo no usar TinySearch
TinySearch es intencionalmente ligero. Usa una API de búsqueda comercial, rastreador persistente o índice de búsqueda completo cuando necesites:
- cobertura de búsqueda garantizada o un SLA
- indexación a gran escala o programada
- almacenamiento a largo plazo de páginas e historial de cambios
- observabilidad empresarial y controles de acceso
Desarrollo
git clone https://github.com/TinySuiteHQ/TinySearch
cd TinySearch
python -m venv .venv
source .venv/bin/activate
pip install -e ".[server]"
python -m unittest discover tests
TinySearch admite Python 3.12 y versiones más recientes. CI prueba Python 3.12, 3.13 y 3.14 en Linux, macOS y Windows.
Puntos de entrada
tinysearch.searchytinysearch.scrape_urls: API de Python estructuradatinysearch.get_current_datetime: fecha y hora UTC estructuradastinysearch.to_prompt: renderizador de prompt de evidencia estructurada puratinysearch mcp: servidor MCP stdio (también el predeterminado sin argumentos)tinysearch serve: servidor MCP Streamable HTTPtinysearch.servers.fastapi_server:app: aplicación FastAPI opcional
Comunidad
Preguntas, ideas e informes de errores son bienvenidos:
Privacidad y licencia
TinySearch lee páginas públicas y devuelve extractos seleccionados al cliente que llama. La búsqueda, el rastreo, los embeddings locales y el reordenamiento pueden ejecutarse sin enviar contenido de páginas a un proveedor de embeddings. Si eliges un backend de embeddings compatible con OpenAI, ese proveedor recibe el texto enviado para vectorización.
TinySearch está disponible bajo la Licencia MIT. Los pesos de modelos descargados siguen sujetos a sus respectivas licencias de tarjeta de modelo. Consulta NOTICE para detalles de distribución de terceros.