Toon Memory
toon-memory es un servidor MCP de memoria persistente 100% local diseñado para asistentes de código con IA (Cursor, Claude Code, Windsurf, etc.). Utiliza el formato ultraeficiente TOON para reducir el consumo de tokens hasta en un 30%, permitiendo a los agentes guardar, buscar y consolidar el contexto y las decisiones del proyecto entre sesiones de forma privada y cifrada (AES-256).
Documentación
English | Español | 中文 | 日本語 | 한국어 | Português (BR) | Deutsch | Français
toon-memory
La Capa de Continuidad para Agentes de IA — los agentes de IA no deberían tener que reaprender tu proyecto en cada sesión.


Tabla de Contenidos
- Descripción General
- Publicación de Blog
- Características
- Instalación
- Agentes Compatibles
- Herramientas MCP
- Coordinación multi-sesión
- Grafo de Memoria (recuperación basada en grafo)
- Consejos y Buenas Prácticas
- Comandos CLI
- Configuración
- Cómo Funciona
- ¿Por qué TOON?
- Solución de Problemas
- Preguntas Frecuentes
- Desarrollo
- Contribuciones
- Seguridad y Privacidad
- Licencia
Descripción General
¿Alguna vez has tenido esa sensación de que tu agente de IA olvida todo de la sesión de ayer? ¿Explicas la misma decisión de arquitectura por tercera vez y aún así sugiere el enfoque que ya rechazaste?
toon-memory soluciona esto. Es la Capa de Continuidad para Agentes de IA — un sistema ligero que preserva el conocimiento, las decisiones y las convenciones de tu proyecto entre sesiones, para que cada sesión comience donde terminó la anterior. Totalmente local y privado, a través de MCP — sin nube, sin servidor.
Casos de uso del mundo real
| Escenario | Lo que hace toon-memory |
|---|---|
| Debates de diseño | "Elegimos Redis sobre Memcached por el soporte de pub/sub" |
| Elecciones de framework | "Este proyecto usa Zod para validación, no Joi" |
| Correcciones de errores | "Agotamiento del pool de Redis — la solución fue max_connections=20" |
| Notas de arquitectura | "El servicio Broker usa el protocolo RESP, no HTTP" |
| Incorporación | "El script de despliegue está en scripts/deploy.sh" |
| Contexto del equipo | "El PR #142 revirtió el cambio de caché — no lo vuelvas a añadir" |
Publicación de Blog
Lee Cómo toon-memory Hace Más Inteligente a Tu Agente de IA para ver una demostración real de la memoria persistente en acción.
Características
- Un kit de memoria completo — Gestión completa de memoria mediante el Protocolo de Contexto de Modelo, incluyendo
memory_smart_recall(recuperación unificada con sesgo de sesión),memory_sessionspara coordinación multi-sesión,context_*herramientas para generación de contexto en una sola llamada (informe, diff, enfoque, auditoría de salud, exportación),memory_compress(compresión impulsada por LLM),memory_consolidate(deduplicación/fusión/limpieza determinista),memory_primer(contexto auto-inyectado),memory_merge_sessions(fusión entre sesiones),memory_pin/memory_unpin(fijar entradas importantes con prioridad 1-5),memory_checkpoint(instantánea de sesión con TTL de 7 días),memory_search(búsqueda unificada con filtros de etiquetas + sesgo de sesión),memory_tag(operaciones de etiquetas por lotes),memory_export_gist/memory_import_gist(sincronización con GitHub Gist),memory_secret(bóveda de secretos cifrada),memory_export_global/memory_import_global(convenciones entre proyectos),memory_forget(eliminación suave/definitiva, restauración, sustitución),memory_reflect(reflexión de obsolescencia/calidad), ymemory_promote(promoción automática de borradores de baja confianza) - Recursos MCP — Lee la memoria como contexto sin invocaciones de herramientas, incluyendo un Manual de Inicio del Sistema (mapa de conocimiento generado automáticamente)
- 22 agentes compatibles — OpenCode, VS Code, Claude Code, Cursor, Windsurf, Cline, Continue, Codex CLI, Gemini CLI, Zed, Antigravity, Aider, KiloCode, OpenClaw, Kiro, Qwen, Kimi, Goose, Junie, Amp, Grok, Trae
- Instalador interactivo — Selecciona qué agentes configurar desde un menú
- Hooks de SessionStart — Recordatorios automáticos para Claude Code, Codex CLI, Gemini CLI, Antigravity
- Formato TOON — 22% menos tokens que JSON (medido), mejor comprensión del LLM
- Memoria por proyecto — Cada proyecto tiene su propio archivo de memoria
- Cero configuración — Solo instala y usa
- Auto gitignore — Añade automáticamente
.toon-memory/memory/a.gitignore - Filtrado por fecha — Busca memoria por rango de fechas
- Auto-archivo — Las entradas antiguas (>30 días), las entradas con TTL expirado, o más de 100 entradas se mueven al archivo automáticamente
- Cifrado — Cifrado AES-256-GCM para datos sensibles
- Modo de vigilancia — Copia de seguridad automática cada N minutos
- TTL de memoria — Expiración configurable por entrada (7d, 30d, o fechas exactas)
- Inferencia de etiquetas — Detecta automáticamente etiquetas del contenido cuando están vacías (vocabulario integrado + dependencias del proyecto)
- Diff de memoria — Ve qué cambió desde tu última sesión
- Entradas relacionadas — Sugiere automáticamente memorias relacionadas al guardar
- Grafo de memoria — Conecta entradas con referencias
links/[[key]];memory_recallpuede expandir un subgrafo consciente de relaciones para una recuperación más precisa y con menos tokens (sin embeddings, sin LLM) - Recuperación eficiente en tokens —
memory_recall({ compact: true })devuelve entradas indexadas numéricamente, eliminaid/date/file, renderiza las aristas del grafo como->2, y trunca los vecinos del grafo a fragmentos - Clasificación BM25 + centralidad — La recuperación re-clasifica por relevancia BM25 y centralidad del grafo (los hubs aparecen incluso sin la palabra de consulta); la decadencia por salto mantiene los nodos distantes bajos
- Auto-etiquetado desde dependencias —
toon-memory initescaneapackage.json/Cargo.toml/requirements.txt/go.mody escribe un vocabulario del proyecto para que las entradas que mencionan una dependencia se etiqueten automáticamente con ella - Recuperación inteligente —
memory_smart_recallcombina BM25 + grafo + decadencia + calidad en una sola llamada; el LLM llama esto al inicio de cada tarea - Puntuación de calidad — Cada entrada recibe una puntuación de calidad de 0–1 basada en la estructura (etiquetas, enlaces, especificidad del contenido, actualidad, recuento de accesos); las entradas de alta calidad aparecen primero
- Fusión-deduplicación — Guardar con el mismo
keyfusiona atributos (unión de etiquetas, máxima confianza, fecha más reciente, enlaces combinados) en lugar de sobrescribir - Detección de casi-duplicados — La consolidación detecta casi-duplicados mediante similitud de Jaccard (umbral 0.7) y los fusiona
- Puntuación de confianza — Cada entrada rastrea la fiabilidad: afirmado por el usuario = 1.0, inferido = 0.65–0.75
- Compresión impulsada por LLM —
memory_compressusa IA para resumir entradas largas;memory_consolidate(mode: "low-quality")hace limpieza por lotes de forma determinista - Fusión entre sesiones —
memory_merge_sessionsfusiona observaciones entre sesiones paralelas para un archivo - Sincronización con GitHub Gist —
memory_export_gistymemory_import_gistsincronizan entradas de memoria mediante GitHub Gist (cero dependencias) - Modo verbatim —
config.verbatimpreserva las entradas originales en lugar de sobrescribirlas al guardar - Herramientas de generación de contexto —
context_generate(informe completo),context_diff(incremental),context_focus(dirigido),context_health(auditoría),context_export(markdown) — cada una reemplaza 5-6 llamadas manuales de herramientas. Cero LLM, agregación puramente determinista - Manual de Inicio del Sistema — Auto-inyectado al inicio de la sesión mediante
systemPrimer(), mostrando las 5 mejores memorias para contexto instantáneo - Alcance de ruta — Las entradas pueden tener alcance a rutas de archivo mediante patrones glob (
path_scope); la recuperación filtra por alcance automáticamente - Control de presupuesto — Tres niveles de salida:
budget: "tiny"(clave+1 línea, ~50 tokens),"normal"(compacto con etiquetas/aristas),"deep"(todos los campos con origen/alcance/estado). Compatible hacia atrás concompact: true - Seguimiento de origen — Cada entrada rastrea su origen (
human,agent,inferred); las afirmaciones humanas reciben un impulso de calidad - Eliminación suave —
memory_forgetelimina suavemente por defecto (establecestatus=obsolete). Restaura conmemory_forget(key, action: "restore"), oculta conaction: "soft", eliminación permanente medianteaction: "hard" - Auditoría de salud mejorada —
context_healthahora detecta evidencia faltante (path_scope sin archivo) y afirmaciones obsoletas (contenido superpuesto en la misma categoría) - Aristas de grafo tipadas — Las aristas llevan tipos (
superseded_by,supersedes,relates), escritas comotype:keyen el grafo. Loslinksexplícitos se convierten enrelates:key, para que puedas saber cómo están relacionadas las entradas, no solo que lo están - Clasificación RRF — La recuperación fusiona BM25 (×3) y clasificaciones de centralidad del grafo con Fusión de Clasificación Recíproca y un
k = clamp(3..60, round(sqrt(n)))adaptativo. Benchmark (8 consultas de oro): nDCG 0.776, MRR 0.917 — paridad exacta con la puntuación lineal anterior. Pasarrf: falsepara retroceder - Reflexión de memoria —
memory_reflectclasifica las entradas por obsolescencia, calidad y sobre-conexión para resaltar lo que necesita atención o limpieza. Determinista, cero LLM - Sustitución de memoria —
memory_forget(key, action: "supersede", new_key)marca una entrada como reemplazada por una más nueva (enlacesuperseded_by+ fechasupersededOn).memory_recall({ as_of })re-incluye entradas antiguas para consultas puntuales antes de su sustitución - Auto-promoción —
memory_promotepromueve borradores de baja confianza a entradas activas de forma determinista (umbral 0.65, deduplicación Jaccard), condryRunpor defecto - Explicar POR QUÉ —
memory_recall/memory_smart_recallaceptanexplain: truey añaden una línea de razón determinista a cada entrada devuelta (↳ 100% relevance · used 14× · used today · importance HIGH) — por qué se recuperó, sin LLM - Presupuestos de tokens —
budget_tokenslimita la salida de recuperación por recuento estimado de tokens; las entradas se acumulan de forma codiciosa y la cola que excedería el presupuesto se elimina (0= sin límite) - Sustitución de versiones —
memory_consolidate(mode: "versions")detecta entradas que describen el mismo tema en diferentes versiones de bibliotecas (por ejemplo, "Usa React 18" vs "Usa React 19") y retira las más antiguas en favor de la más nueva - Memorias negativas — una categoría
warningpara hechos de "NO hagas esto"; las entradaswarningreciben un impulso de recuperación para que el agente vea las minas terrestres antes de repetirlas - Clasificación por idioma + carpeta — la recuperación impulsa entradas escritas en la misma familia de escritura (latina/CJK/cirílica/…) y entradas cuyo
path_scopecoincide con el archivo actual - Importancia explícita —
memory_remember({ importance })establececritical,high,medium, olow. Las decisiones críticas aparecen primero (+0.3), las notas bajas se mantienen fuera del camino (−0.1); vacío = automático (actualidad + frecuencia). Re-guardar mantiene el nivel más alto - Capa de evidencia — cada guardado
memory_rememberse anota con un nivel de evidencia:verifiedcuando su archivo referenciado existe en disco,unverifiedcuando no existe,conflictcuando se superpone con una advertencia o decisión crítica/alta. Los conflictos reciben un impulso de recuperación de +0.15 (verificado +0.03, no verificado −0.02) y una advertencia ⚠️ CONTRADICCIÓN al guardar — pero nunca bloquean la escritura - Bóveda de secretos —
memory_secretalmacena credenciales en un archivo lateral cifrado (secrets.toon, AES-256-GCM) para quedata.toonsiga siendo un formato abierto legible mientras los valores sensibles nunca llegan a texto plano - Importación/exportación de memoria global —
memory_export_globalescribe la memoria del proyecto en~/.toon-memory/memory/global.toon;memory_import_globaltrae las convenciones entre proyectos con una fusión única, determinista y sin conexión (nunca una doble fuente en vivo) - Instalación de ~1 MB — tres paquetes de prompt diminutos (
@inquirer/checkbox/select/confirm); el SDK de MCP, zod y el analizador TOON están incluidos en el binario enviado — un solonpm i -gdescarga ~1 MB (antes ~14 MB) y ocupa ~4.4 MB en disco (antes ~33 MB)
Instalación
1. Instalar
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/LuiggiVal08/toon-memory/main/install.sh | sh

# Windows (PowerShell)
irm https://raw.githubusercontent.com/LuiggiVal08/toon-memory/main/install.ps1 | iex

# Or with npm (any platform)
npm i -g toon-memory
Consejo: La instalación con npm es el método más fiable. Los scripts curl/irm son envoltorios de conveniencia.
Tamaño: Un
npm i -g toon-memorybásico descarga ~1 MB e instala ~4.4 MB — tres paquetes de prompt diminutos; todo lo demás (SDK de MCP, zod, analizador TOON) se envía incluido.
2. Configura tu(s) agente(s)
# Interactive installer — detects agents and configures MCP
npx toon-memory
El instalador:
- Detecta qué agentes de IA tienes instalados
- Pregunta cuáles configurar
- Añade la configuración del servidor MCP automáticamente
3. Úsalo
¡Eso es todo! En tu próxima sesión de agente, prueba:
memory_stats      # See what's in memory
memory_recall     # Search memory before reading files
memory_remember   # Save important decisions
Consejo: Ejecuta siempre
memory_recallal inicio de una sesión. Tu agente tendrá contexto de sesiones anteriores al instante.
Configuración rápida del cliente MCP
Cursor
Añade a .cursor/mcp.json:
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Claude Desktop
Añade a claude_desktop_config.json:
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Windsurf
Añade a ~/.codeium/windsurf/mcp_config.json:
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Agentes compatibles
| Agente | Ubicación de configuración | Formato | Hooks | Configuración automática |
|---|---|---|---|---|
| OpenCode | .opencode/opencode.json + .opencode/plugins/toon-memory.ts | Plugin | SessionStart (plugin, sin hooks de nivel superior) | ✅ |
| VS Code / Copilot | .vscode/mcp.json | JSON | — | ✅ |
| Claude Code | .mcp.json (MCP) + .claude/settings.json (hooks) | JSON | SessionStart + PostToolUse + Stop | ✅ |
| Cursor | .cursor/mcp.json | JSON | — | ✅ |
| Windsurf | ~/.codeium/windsurf/mcp_config.json | JSON | — | ✅ |
| Cline | .cline/mcp.json | JSON | — | ✅ |
| Continue | .continue/config.json | JSON | — | ✅ |
| Codex CLI | .codex/config.toml | TOML | SessionStart + PostToolUse + Stop ([[hooks]] event=) | ✅ |
| Gemini CLI | .gemini/settings.json | JSON | SessionStart + PostToolUse + Stop (hooks.*) | ✅ |
| Zed | ~/.config/zed/settings.json | JSONC | — | ✅ |
| Antigravity | .agents/mcp_config.json + .agents/hooks.json | hooks.json | PreInvocation + PostToolUse + Stop (sin evento SessionStart) | ✅ |
| Aider | — | — | — | 📝 Instrucciones |
| KiloCode | ~/.kilocode/mcp_settings.json | JSON | — | ✅ |
| OpenClaw | .openclaw.json | JSON | — | ✅ |
| Kiro | .kiro/settings/mcp.json | JSON | — | ✅ |
Consejo: Puedes configurar toon-memory para varios agentes al mismo tiempo. Cada agente recibe el mismo archivo de memoria compartida en
.toon-memory/memory/.
Herramientas MCP
| Herramienta | Descripción |
|---|---|
memory_remember | Guarda una decisión, patrón, bug, conocimiento o advertencia (memoria negativa de "NO hagas esto", recuperada con un impulso) — TTL opcional, inferencia automática de etiquetas, links para construir el grafo de memoria, fusión-deduplicación en la misma clave, puntuación de calidad y confianza automáticas. Inteligencia en la ruta de escritura: cada guardado se anota con un nivel de evidencia — verified cuando el archivo referenciado existe en disco, unverified cuando no existe, conflict cuando se solapa con una advertencia o decisión crítica/alta (recuperada con un impulso y mostrada con una advertencia ⚠️ CONTRADICCIÓN, pero nunca bloquea la escritura) |
memory_recall | Busca en la memoria (úsalo ANTES de leer archivos, filtra TTL expirados). mode: "graph" expande un subgrafo consciente de relaciones para mayor precisión. `budget: "tiny" |
memory_smart_recall | Recuperación unificada: BM25 + grafo + decaimiento + calidad en una sola llamada. sessionBias impulsa entradas de la rama git actual. explain: true añade razones por entrada, budget_tokens limita la salida por tokens estimados. Úsalo al INICIO de cada tarea. Devuelve una salida compacta y eficiente en tokens |
memory_forget | Operaciones de ciclo de vida por clave o id: action: "soft" (predeterminado) marca como obsoleto, "hard" elimina permanentemente, "restore" lo devuelve a activo, "supersede" lo retira con un enlace superseded_by a new_key |
memory_stats | Ver el estado de la memoria (incluye estadísticas de TTL, distribución de calidad, desglose de origen/estado, memorias frías por debajo de los umbrales de calidad/acceso, y métricas de tasa de aciertos / duplicados / obsoletos) |
memory_summary | Guardar/recuperar resúmenes de archivos |
memory_archive | Archivar entradas antiguas (>30 días) y entradas con TTL expirado |
memory_diff | Mostrar cambios desde una fecha (24h, 7d o fecha exacta) |
memory_suggest | Encontrar entradas relacionadas para un contexto dado |
memory_encrypt | Habilitar cifrado AES-256-GCM |
memory_decrypt | Deshabilitar cifrado |
memory_backup | Crear copia de seguridad con marca de tiempo del archivo de memoria (podado automático a las 10 más recientes) |
memory_captured | Listar actividad capturada automáticamente por hooks (opt-in) o limpiar el registro |
memory_checkpoint | Punto de control de sesión: crea una instantánea del estado actual de la memoria con TTL de 7d. Útil como referencia de reversión durante sesiones largas |
memory_consolidate | Operaciones de limpieza, deterministas (sin LLM): mode: "identical" (predeterminado) deduplica entradas de contenido idéntico, "similar" fusiona casi duplicados (Jaccard >50%), "low-quality" elimina en lote entradas de baja calidad (minQuality, dryRun), "versions" retira entradas de versiones de librería antiguas en favor de la más nueva |
memory_sessions | Mostrar sesiones de agente activas (rama, archivos, última vez visto) y conflictos suaves para trabajo en paralelo |
memory_compress | Compresión en dos pasos impulsada por LLM: resumir + sobrescribir. Usa CLI anthropic/openai si está disponible; de lo contrario, devuelve un prompt para compresión manual |
memory_primer | Preparación de contexto en una llamada: mejores memorias + categorías + cambios de archivos de sesión. Inyección automática al inicio de la sesión |
memory_merge_sessions | Fusionar observaciones de sesiones paralelas para un archivo. Deduplica y opcionalmente promueve automáticamente a memoria |
memory_export_gist | Exportar entradas de memoria a un GitHub Gist (público o privado). Usa CLI GITHUB_TOKEN o gh |
memory_import_gist | Importar entradas desde un GitHub Gist. Fusiona con entradas existentes (unión de etiquetas, máxima confianza) |
memory_secret | Bóveda de secretos cifrada (secrets.toon, AES-256-GCM): store/get/list/forget. Mantiene data.toon legible mientras los valores sensibles permanecen cifrados en reposo. Requiere TOON_MEMORY_KEY |
memory_export_global | Escribir la memoria del proyecto actual en el archivo global (~/.toon-memory/memory/global.toon). Compartir en una sola operación las convenciones entre proyectos |
memory_import_global | Fusionar convenciones entre proyectos desde el archivo global en este proyecto (una sola operación, determinista, sin conexión). merge: false reemplaza en su lugar |
memory_graph_path | Camino más corto BFS entre dos entradas en el grafo de conocimiento. Muestra cómo están conectados los conceptos |
context_brief | Informe de contexto en una llamada: memoria + sesiones + salud en markdown compacto. Úsalo en lugar de 5-6 llamadas memory_* separadas. Cero LLM, agregación puramente determinista |
context_generate | Informe completo del proyecto: combina estructura del proyecto, estado de git, entradas de memoria y sesiones activas en una llamada. Reemplaza 5-6 llamadas manuales de herramientas |
context_diff | Informe incremental: commits de git + archivos modificados + memoria nueva/actualizada + sesiones activas desde la última sesión |
context_focus | Informe hiperenfocado: solo memoria relevante + archivos fuente relacionados + llamadores + archivos de prueba para una consulta |
context_health | Auditoría de salud de memoria: enlaces huérfanos, duplicados, referencias de archivos rotas, TTL expirados, sesiones obsoletas, puntuación 0–100 |
context_export | Exportar memoria como markdown: contexto inyectable para prompts de sistema (completo o compacto) |
memory_pin | Fijar una entrada con prioridad 1-5: las entradas fijadas siempre aparecen primero en los resultados de recuperación ordenadas por prioridad, incluso sin coincidencia de palabra clave |
memory_unpin | Desfijar una entrada: eliminar la marca de prioridad |
memory_search | Búsqueda unificada con filtros: igual que memory_recall más filtros category, tags, from_date, to_date. El filtro de etiquetas usa lógica AND — todas las etiquetas especificadas deben coincidir. budget controla la verbosidad de la salida. path_scope filtra por patrón glob. sessionBias impulsa entradas de la rama git actual |
memory_tag | Operaciones de etiquetas en lote: add, remove o set etiquetas en una o más entradas por clave o id |
Recursos MCP
La memoria también se expone como recursos MCP para lectura directa de contexto:
| Recurso | URI | Descripción |
|---|---|---|
| Entradas de memoria | toon://memory/entries | Volcado completo de memoria |
| Memoria actual | toon://memory/current | Estado actual de la memoria con entradas recientes |
| Estadísticas de memoria | toon://memory/stats | Conteos de categorías e información de TTL |
| Preparación del sistema | toon://memory/summaries | Mapa de conocimiento generado automáticamente (mejores entradas, categorías, patrones) |
Prompts MCP
| Prompt | Descripción |
|---|---|
summarize_project_context | Analiza la memoria TOON actual y genera un resumen compacto del proyecto. Parámetro opcional intent para enfocarse en un área específica |
Ejemplos
Recordar una decisión
memory_remember({
  category: "decision",
  key: "use-zod",
  content: "Use Zod for validation — simpler than Joi, better TS support",
  file: "src/types.ts",
  tags: "validation;types"
})
// 🧠 Guardado: decision/use-zod (a1b2c3d4)
// Quality score: 0.65 (2 tags, detailed content)
// 🔗 Entradas relacionadas:
//   [pattern] zod-schemas — Shared Zod schemas for API validation
Consejo: Usa claves descriptivas como
use-zoden lugar de vagas comovalidation. Tu agente busca por clave y contenido, así que la especificidad ayuda. Guardar con la misma clave fusiona automáticamente (unión de etiquetas, máxima confianza).
Recordar con TTL
memory_remember({
  category: "knowledge",
  key: "sprint-deadline",
  content: "Sprint ends July 18, feature freeze is July 16",
  ttl: "7d"
})
// 🧠 Guardado: knowledge/sprint-deadline (x1y2z3w4)
// ⏰ TTL: 2026-07-19
// Quality score is calculated automatically.
Consejo: Usa TTL para contexto temporal como fechas límite, información de sprint o notas sensibles al tiempo. Las entradas con TTL expirado se filtran automáticamente de los resultados de búsqueda.
Establecer importancia explícita
memory_remember({
  category: "decision",
  key: "db-choice",
  content: "We chose Postgres over MySQL — JSONB for flexible schemas, better extension ecosystem",
  importance: "critical"
})
// 🧠 Guardado: decision/db-choice (a1b2c3d4)
// 🎯 Importance: critical (+0.3 boost) — surfaces above routine entries
Consejo: Marca las decisiones fundamentales
criticalpara que siempre se clasifiquen cerca de la parte superior de la recuperación.importanceaceptacritical,high,mediumolow; déjalo vacío para que el sistema clasifique por actualidad y frecuencia automáticamente.
Etiquetas inferidas automáticamente
memory_remember({
  category: "bug",
  key: "redis-connection-timeout",
  content: "Redis connection timeout in production, increased pool size"
  // tags left empty — auto-inferred from content
})
// 🧠 Guardado: bug/redis-connection-timeout (a1b2c3d4)
// 🏷️ Tags inferidos: redis
// Quality score is calculated automatically based on inferred tags and content.
Consejo: Deja
tagsvacío y el sistema las inferirá de tu contenido usando un vocabulario integrado de más de 20 categorías (redis, auth, api, db, security, etc.) más un vocabulario de proyecto derivado de tus dependencias en el momento deinit. Así, si tu proyecto depende deredis, cualquier entrada que mencione "redis" se etiqueta automáticamente comoredis.
Buscar en la memoria
memory_recall({ query: "redis" })
// [bug] redis-pool-fix (i9j0k1l2)
//   Added max_connections=20
//   File: redis.ts | Tags: redis;fix | Date: 2026-07-10
Consejo: Busca antes de leer archivos. Esto ahorra tokens y le da a tu agente contexto que no obtendría solo del código. La clasificación ponderada por calidad asegura que las entradas más útiles aparezcan primero. O usa
memory_smart_recallpara un resultado más completo.
Buscar con filtro de fecha
memory_recall({
  query: "redis",
  from_date: "2026-07-01",
  to_date: "2026-07-31"
})
Consejo: Usa filtros de fecha cuando recuerdes aproximadamente cuándo ocurrió algo pero no exactamente qué. La clasificación ponderada por calidad sigue aplicándose.
Archivar entradas antiguas
memory_archive()
// 📦 Archivadas 5 entradas antiguas
// 📋 Quedan 42 entradas activas
Consejo: Ejecuta esto periódicamente para mantener la memoria ágil. Las entradas archivadas siguen siendo buscables mediante
memory_recallcon filtros de fecha. Las entradas con TTL expirado también se archivan automáticamente. Las entradas de baja calidad obtienen menor prioridad de recuperación. Las entradas de baja calidad obtienen menor prioridad de recuperación.
Mostrar cambios desde la última sesión
memory_diff({ since: "24h" })
// 📋 Cambios desde 2026-07-11:
//
// ➕ Nuevas (2):
//   [decision] use-zod (a1b2c3d4)
//     Use Zod for validation
//   [bug] redis-timeout (e5f6g7h8)
//     Redis connection timeout fix
Consejo: Usa
memory_diffal inicio de una sesión para ver qué aprendió tu agente desde la última vez que trabajaste en el proyecto. Las entradas nuevas incluyen puntuaciones de calidad. Las entradas nuevas incluyen puntuaciones de calidad.
Encontrar entradas relacionadas
memory_suggest({ context: "redis cache configuration" })
// 🔍 Sugerencias para "redis cache configuration":
//
// [decision] redis-cache-config (a1b2c3d4)
//   Redis cache layer for session storage
//   File: src/cache.ts | Tags: redis;cache | Date: 2026-07-10
//
// [bug] redis-pool-fix (i9j0k1l2)
//   Added max_connections=20
//   File: redis.ts | Tags: redis;fix | Date: 2026-07-10
Consejo: Usa
memory_suggestcuando necesites contexto sobre un tema pero no estés seguro de qué buscar. O usamemory_smart_recallpara un resultado más completo.
Recuperación inteligente (unificada)
memory_smart_recall({ intent: "diseño de base de datos para backend" })
// [1] decision/use-postgres
//   Choose Postgres for ACID compliance and JSON support
//   tags: db;decision · edges: ->2
//
// [2] pattern/db-migrations
//   Use sequential migration files, never edit committed ones
//   tags: db;pattern · edges: ->1
//
// [3] bug/redis-timeout
//   Redis connection timeout — increased pool to 20
//   tags: redis;bug
Consejo: Usa
memory_smart_recallal INICIO de cada tarea. Combina BM25 + grafo + decaimiento + calidad en una sola llamada — no necesitas adivinar qué buscar.
Explicar POR QUÉ se devolvió un resultado
memory_recall({ query: "redis", explain: true })
// [decision] redis-cache-config (a1b2c3d4)
//   Redis cache layer for session storage
//   File: src/cache.ts | Tags: redis;cache | Date: 2026-07-10
//   ↳ 92% relevance · used 14× · used today · importance HIGH
La línea de razón ↳ es determinista (% de relevancia, recuento de accesos, último uso, importancia) — sin LLM involucrado. Usa explain: true cuando quieras saber por qué se le mostraron esas entradas al agente.
Limitar la salida con budget_tokens
memory_recall({ query: "redis", budget_tokens: 300 })
// Entries accumulate greedily; the tail that would exceed the estimate is dropped.
// budget_tokens: 0 (default) = no limit.
Consejo: Combina
budget_tokensconbudget: "deep"para una ventana de contexto que se mantenga dentro de un límite de tokens estricto sin importar el tamaño de la memoria.
Resumen completo del proyecto (una sola llamada)
context_generate({})
// # Project Briefing (full)
//
// ## Project
// - Name: my-app
// - Root: /path/to/project
// - Package Manager: npm
// - TypeScript: ✓ (v5.3)
//
// ## Git Status
// - Branch: main
// - 3 uncommitted, 0 untracked
//
// ## Memory (42 entries, 12 patterns, 8 bugs)
// [1] decision/use-postgres
//   Choose Postgres for ACID compliance
//   tags: db;decision
//
// ## Sessions
// - egraterol (main, 2m ago): 42 files touched
Consejo: Usa
context_generateal inicio de una sesión para obtener el contexto completo en una sola llamada. Reemplaza 5-6 llamadas de herramientas separadas.
Auditoría de salud de la memoria
context_health({})
// # Memory Health (score: 87/100)
//
// ## Summary
// - 42 entries (12 patterns, 8 bugs, 15 decisions, 7 knowledge)
// - 65.3% average quality
//
// ## Issues (3)
// - Orphan link: pattern/db-migrations → pattern/db-seed (key not found)
// - Duplicate: [bug] redis-pool-fix has identical content
// - Expired TTL: [knowledge] sprint-deadline (expired 2026-07-20)
//
// ## Stale Files (1)
// - src/legacy.ts (deleted, 2 refs)
Consejo: Ejecuta
context_healthcuando la memoria se sienta desordenada. Muestra enlaces huérfanos, duplicados, entradas TTL expiradas, referencias a archivos rotas, entradas con evidencia faltante (path_scope sin archivo) y afirmaciones obsoletas (contenido superpuesto).
Fusión-deduplicación (automática)
Cuando guardas con la misma key, los atributos se fusionan en lugar de sobrescribirse:
// First save
memory_remember({
  category: "decision",
  key: "use-zod",
  content: "Use Zod for validation",
  tags: "types"
})
// 🧠 Guardado: decision/use-zod (a1b2c3d4)

// Later save with same key — merges automatically
memory_remember({
  category: "decision",
  key: "use-zod",
  content: "Use Zod for validation — also handles API response parsing",
  tags: "types;api"
})
// 🧠 Actualizado: decision/use-zod (a1b2c3d4)
// 🔗 Merge: tags combinados, fecha y links actualizados
// Tags now: "types;api" (union of both)
Consejo: Usa claves descriptivas y estables. La misma clave = fusión, clave diferente = nueva entrada.
Puntuación de calidad
Cada entrada recibe una puntuación de calidad automática (0–1) basada en la estructura:
| Factor | Peso | Qué mide |
|---|---|---|
| Etiquetas | 0.3 máx. | Etiquetas más específicas = mayor calidad |
| Enlaces | 0.2 máx. | Entradas conectadas = mayor calidad |
| Longitud del contenido | 0.3 máx. | Detallado > vago |
| Recencia | 0.1 máx. | Las entradas recientes puntúan más alto |
| Especificidad | 0.1 máx. | Palabras únicas vs. palabras repetidas |
| Origen | +0.1/−0.05 | Las afirmaciones humanas se potencian, las inferidas se penalizan ligeramente |
Las entradas de alta calidad aparecen primero en la recuperación. Comprueba la calidad con memory_stats:
memory_stats()
// ...
// Calidad promedio: 0.58 (12 con score)
Puntuación de confianza
Cada entrada rastrea cuán fiable es la información:
| Fuente | Confianza | Significado |
|---|---|---|
| Afirmación del usuario | 1.0 | "Usamos Postgres" — declaración directa |
| Inferido | 0.65–0.75 | El agente infirió del contexto |
| Incierto | 0.50 | El agente está adivinando |
La confianza se conserva en la fusión (máximo de ambas entradas).
Primer del sistema
El Primer del sistema es un mapa de conocimiento generado automáticamente expuesto como recurso MCP. Los agentes lo cargan al inicio de la sesión para obtener contexto instantáneo:
// Exposed as toon://memory/summaries
// Auto-regenerates on every read
// Contains: top entries, categories, patterns
Consejo: Añade
toon://memory/summariesal prompt del sistema de tu agente para obtener contexto instantáneo al inicio de la sesión.
Habilitar cifrado
// First, set TOON_MEMORY_KEY in your environment (or .env file):
// export TOON_MEMORY_KEY="your-secret-key-here"

memory_encrypt()
// 🔐 Encriptación habilitada
Advertencia: La clave de cifrado debe establecerse mediante la variable de entorno
TOON_MEMORY_KEYantes de cifrar. Guárdala en un lugar seguro: si la pierdes, tus datos de memoria se pierden para siempre. Las puntuaciones de calidad y la confianza se conservan mediante el cifrado.
Coordinación multi-sesión
Cuando ejecutas varias sesiones de agentes de IA en paralelo (por ejemplo, tres sesiones de OpenCode en el mismo repositorio a la vez), pueden sobrescribir accidentalmente el trabajo de los demás. toon-memory incluye memory_sessions, una herramienta de coordinación basada en archivos que permite a cada sesión ver lo que hacen sus hermanas — sin servidor, sin red y sin llamadas LLM.
Cómo funciona
- Al inicio, un hook de
SessionStartescribe un archivo de latido para la sesión en.toon-memory/memory/sessions/<id>.json. Cada proceso escribe solo su propio archivo, por lo que no hay contención de bloqueos. - El latido registra el nombre del agente, la rama de git, los archivos tocados y una marca de tiempo de última vez visto.
- Leer todos esos archivos da a cada sesión una vista compartida, eventualmente consistente, de quién más está activo.
- Las sesiones muertas (PID del proceso ya no vivo y un latido obsoleto más allá de la ventana TTL) se podan de forma perezosa.
La herramienta memory_sessions
memory_sessions({ conflictsOnly: false })
// 🧭 Sesiones activas (2) — ventana 30 min:
//
// • opencode @ feature/auth (tú)
//   id: a1b2c3d4
//   hace 2 min
//   Archivos:
//     • src/auth.ts
//
// • claude @ feature/db
//   id: e5f6g7h8
//   hace 9 min
//     • src/db.ts
//
// 🔥 Conflictos suaves (1):
//   ⚠️ src/types.ts  ↔  opencode @ feature/auth, claude @ feature/db
- Pasa
conflictsOnly: truepara omitir la lista de sesiones y mostrar solo conflictos suaves:memory_sessions({ conflictsOnly: true }) // 🔥 Conflictos suaves (1): // // ⚠️ src/types.ts // ↔ opencode @ feature/auth (a1b2c3d4), claude @ feature/db (e5f6g7h8) - Un conflicto suave es cualquier archivo tocado por 2+ sesiones activas — un aviso de que podrías estar editando el mismo código. No es un bloqueo duro, solo una advertencia para coordinar.
Hábito recomendado para sesiones paralelas
- Al inicio de cada sesión, el hook de
SessionStartya imprime las otras sesiones activas y cualquier conflicto suave. - Ejecuta
memory_smart_recall({ intent: "what I'm working on" })para obtener el contexto completo (memoria + grafo + calidad). - Ejecuta
memory_sessions()para ver el panorama completo (ramas, archivos, última vez visto) ymemory_sessions({ conflictsOnly: true })si solo te interesan los choques. - Si compartes un archivo con otra sesión, sincroniza antes de editar para no sobrescribir los cambios de los demás.
Consejo: Esto es puramente local y sin bloqueos — seguro de ejecutar tan a menudo como quieras. Combínalo con
memory_smart_recall({ intent: "project context" })al inicio de la sesión para obtener tanto memoria entre sesiones como presencia entre sesiones. El primer del sistema (recurso MCP) también proporciona contexto instantáneo.
Grafo de memoria (recuperación basada en grafo)
Cuando tu memoria crece, una búsqueda plana por palabras clave puede devolver demasiado (cada coincidencia) o el contexto equivocado (sin relaciones). toon-memory puede tratar la memoria como un grafo de conocimiento ligero para que la recuperación devuelva las entradas correctas con menos tokens. Combinado con la puntuación de calidad, las entradas más útiles aparecen primero.
Es completamente determinista y sin conexión — sin embeddings, sin base de datos vectorial, sin LLM, sin servidor. Las aristas provienen de dos fuentes:
linksexplícitos — claves que declaras al guardar una entrada.- Referencias
[[key]]implícitas — cualquier mención de[[some-key]]dentro del contenido.
Cómo funciona
memory_rememberalmacenalinksen la entrada (claves separadas por espacios o;). La puntuación de calidad se calcula automáticamente.memory_recall({ mode: "graph" })encuentra coincidencias de palabras clave (semillas) y luego expande el subgrafo ego hastahops(1 o 2) a lo largo de las aristas.- La relevancia se propaga desde las semillas a sus vecinos, por lo que una decisión o especificación relacionada aparece incluso si no contiene la palabra de la consulta. La clasificación ponderada por calidad asegura que las entradas más útiles aparezcan primero.
- El conjunto de resultados está limitado (
limit, por defecto 6) → contexto más pequeño y preciso para el agente. O usamemory_smart_recallpara una llamada unificada.
Recordar con enlaces
memory_remember({
  category: "decision",
  key: "risk-engine-priority",
  content: "The engine prioritizes risk over speed (see [[risk-spec]]).",
  file: "spec.md:10",
  tags: "risk;spec",
  links: "engine-arch"          // explicit edge to another entry
})
// 🧠 Guardado: decision/risk-engine-priority (a1b2c3d4)
// Quality score is calculated automatically based on tags, links, and content detail.
Recuperación con modo grafo
memory_recall({ query: "riesgo", mode: "graph", hops: 2 })
// [decision] risk-engine-priority (a1b2c3d4)
//   The engine prioritizes risk over speed (see [[risk-spec]]).
//   File: spec.md:10 | Tags: risk;spec | Date: 2026-07-01
//   links: engine-arch
//
// [knowledge] risk-spec (a2b3c4d5)
//   Risk specification for the engine.
//   links: risk-engine-priority;engine-arch
//
// [pattern] engine-arch (e6f7g8h9)
//   Engine architecture.
//   links: risk-spec
Consejo: Usa
mode: "graph"cuando una decisión se extiende a varias entradas (arquitectura, especificaciones, errores relacionados). Para hechos aislados, el modoflatpor defecto es suficiente. O usamemory_smart_recallque combina grafo + BM25 + calidad automáticamente.
Recuperación eficiente en tokens (compact)
Cuando cada token cuenta, pasa compact: true para obtener una salida más densa:
memory_recall({ query: "riesgo", mode: "graph", hops: 2, compact: true })
// [1] decision/risk-engine-priority
//   The engine prioritizes risk over speed (see [[risk-spec]]).
//   tags: risk;spec · edges: ->2, ->3
//
// [2] knowledge/risk-spec
//   Risk specification for the engine.
//   tags: risk · edges: ->1
//
// [3] pattern/engine-arch
//   Engine architecture.
//   tags: engine · edges: ->1
Cómo compact cambia la salida:
- Cada entrada recibe un índice numérico estable (
[1],[2], …) en orden de puntuación. id,dateyfilese eliminan — solo se conservatags.- En modo
graph, las aristas se representan como->2(numéricas, no nombres de clave). - Los vecinos alcanzados a través del grafo (no semillas) se truncan a un fragmento corto con puntos suspensivos, mientras que las semillas coincidentes directamente conservan su contenido completo.
- La clasificación ponderada por calidad asegura que las entradas más útiles aparezcan primero.
- El archivo
.toonalmacenado nunca se modifica —compactsolo reforma la respuesta.
Consejo: Combina
compact: trueconmode: "graph"para la ventana de contexto más pequeña posible al recuperar de una memoria grande e interconectada. Para recuperación proactiva/en segundo plano, usabudget: "tiny"que devuelve solo la clave + una línea (~50 tokens). O simplemente usamemory_smart_recallque hace esto automáticamente.
Cómo clasifica la recuperación los resultados
La recuperación es determinista y sin conexión (sin embeddings, sin LLM). Cada entrada candidata recibe una puntuación combinada:
- Relevancia BM25 — puntuación probabilística clásica de frecuencia de términos contra la consulta, usando
id+category+key+content+file+tags+quality+confidence. - Centralidad de grafo — normalizada por grado (0..1); un centro conectado a muchas entradas puntúa cerca de 1, por lo que aparece incluso sin la palabra de la consulta.
- Importancia — recencia + frecuencia de acceso (la misma señal usada en otros lugares).
- Impulso de calidad — las entradas con puntuaciones de calidad más altas (más etiquetas, enlaces, detalle) reciben un impulso en la clasificación.
- Bonificación por semilla — las entradas que coinciden directamente con la consulta reciben un impulso fijo.
- Decaimiento por salto — los nodos a
dsaltos de una semilla se multiplican por0.5^d, por lo que el contexto distante se clasifica por debajo del contexto cercano.
En modo graph, la recuperación se basa en coincidencias de palabras clave, expande el subgrafo ego hasta hops y devuelve los mejores limit (por defecto 6) por puntuación combinada. memory_smart_recall combina todas estas señales en una sola llamada.
Etiquetado automático desde dependencias del proyecto
En toon-memory init, el CLI escanea tus manifiestos de dependencias y escribe una tabla vocab en .toon-memory/memory/config.json:
{
  "vocab": {
    "react": ["react"],
    "zod": ["zod"],
    "redis": ["redis"]
  }
}
memory_remember luego compara nuevas entradas con este vocabulario además del integrado, por lo que mencionar una dependencia en tu contenido adjunta automáticamente su etiqueta. Más etiquetas = mayor puntuación de calidad. Manifiestos compatibles: package.json, Cargo.toml, requirements.txt, pyproject.toml, go.mod.
Consejo: Vuelve a ejecutar
toon-memory initdespués de añadir dependencias importantes para actualizar el vocabulario. La clavevocabse fusiona (nunca se sobrescribe) con las banderasencrypted/captureenconfig.json. Más etiquetas = mayor puntuación de calidad.
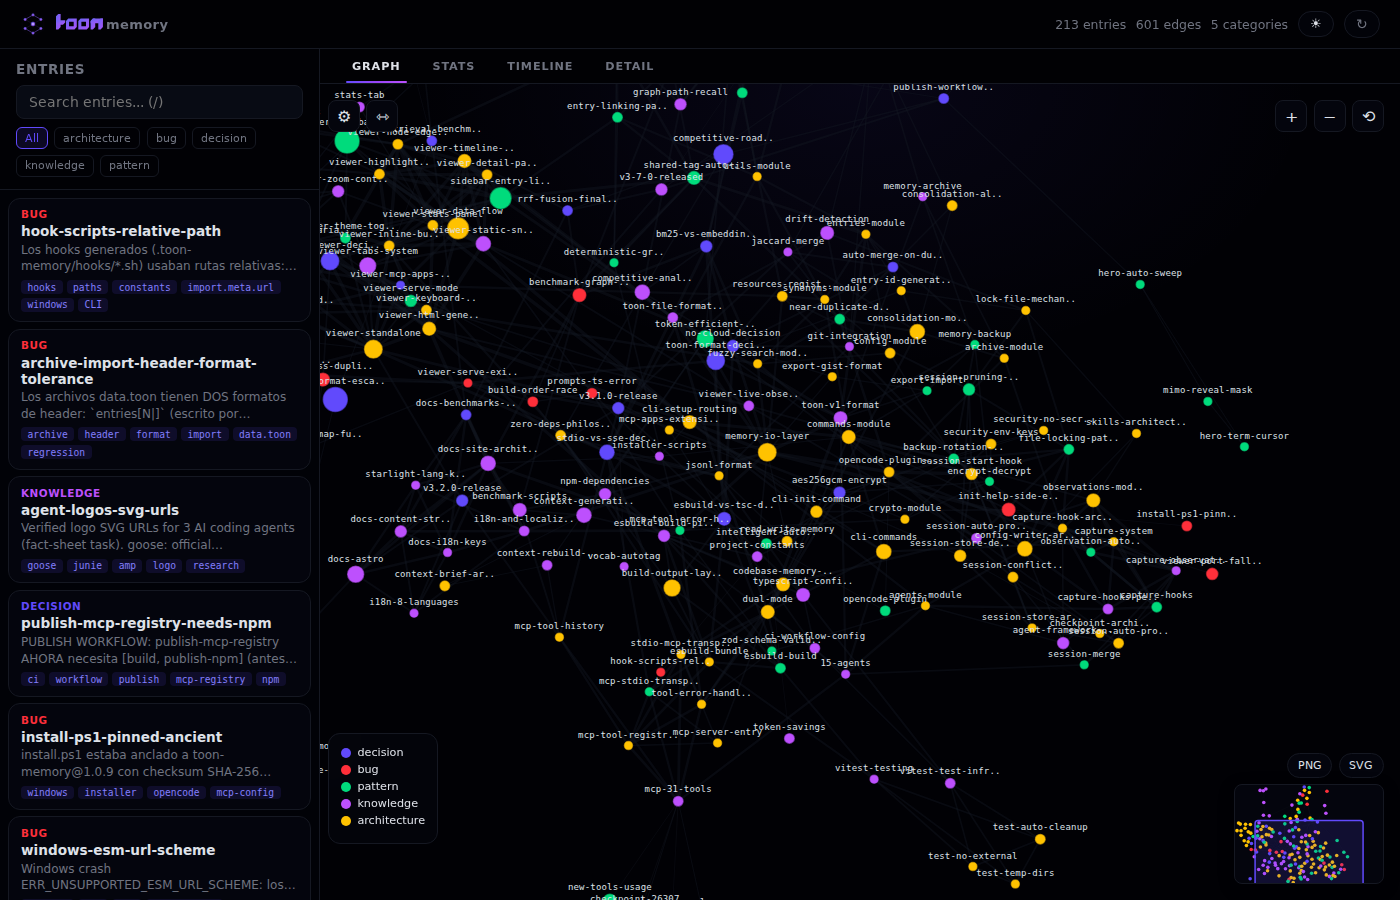
Visor de grafo de memoria
Visualiza tu memoria como un grafo de fuerzas interactivo. Ve entradas, sus conexiones, categorías y patrones de acceso de un vistazo.
Visor CLI (servidor HTTP independiente)
npx toon-memory viewer          # Start HTTP server + open browser
npx toon-memory viewer --port 3001  # Custom port
npx toon-memory viewer --export     # Save as static HTML
Una vez abierto, presiona r en la terminal para recargar desde el disco, o r / ↻ en el navegador para actualizar la página.
Visor integrado (MCP Apps)
Llama a memory_visualize en cualquier host compatible con MCP Apps para renderizar el grafo en línea — sin necesidad de servidor. El visor aparece como un panel interactivo dentro de la interfaz de chat.
Características
| Interacción | Descripción |
|---|---|
| Pasar el cursor sobre un nodo | Ver tooltip con vista previa del contenido, calidad, recuento de accesos |
| Hacer clic en un nodo | Seleccionar + centrar + resaltar vecinos |
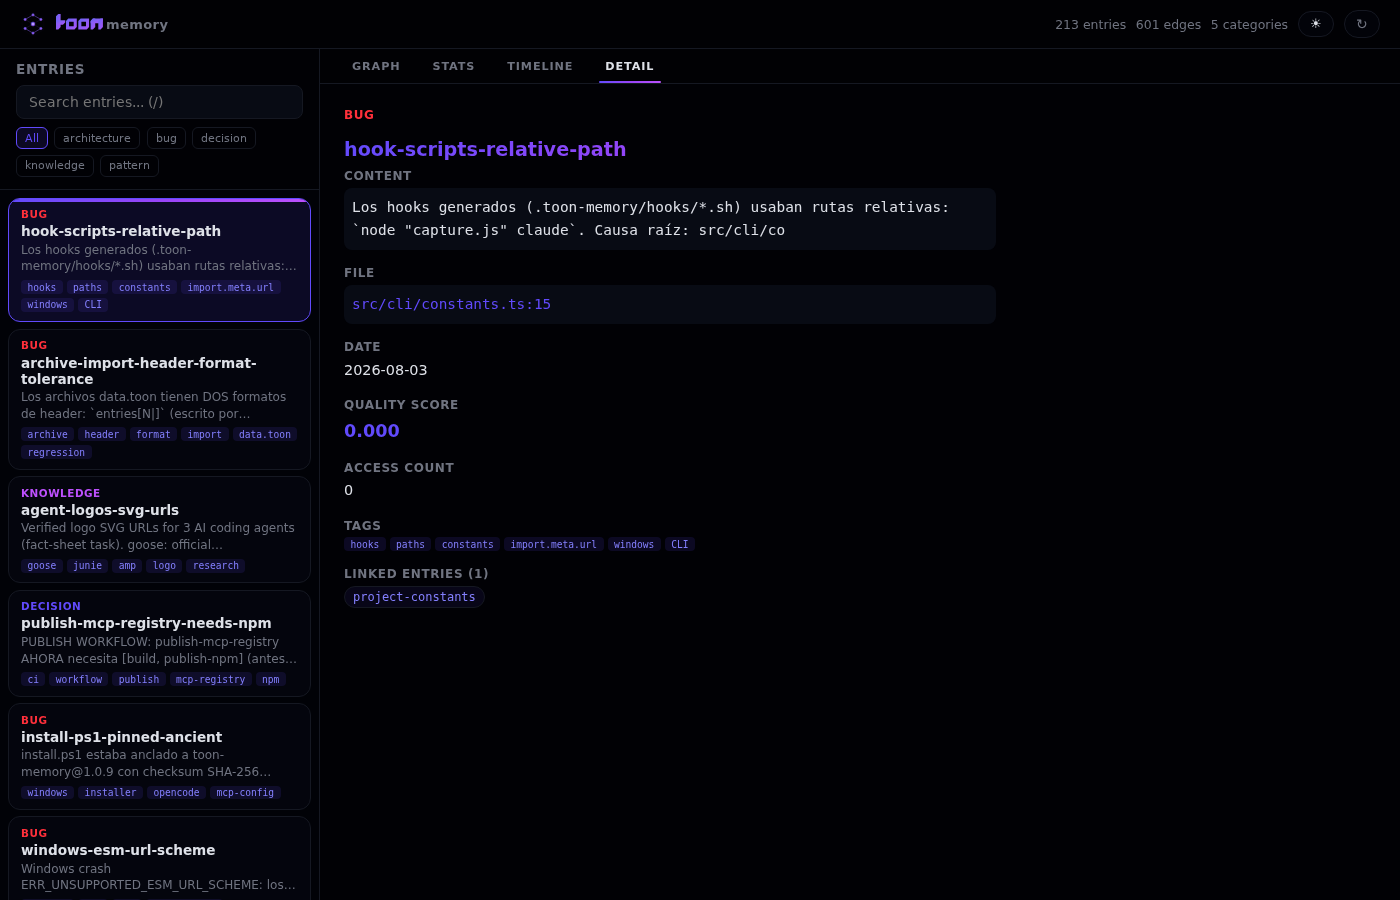
| Doble clic en un nodo | Abrir el panel de detalle |
| Arrastrar un nodo | Reposicionar manualmente (clic derecho para desfijar) |
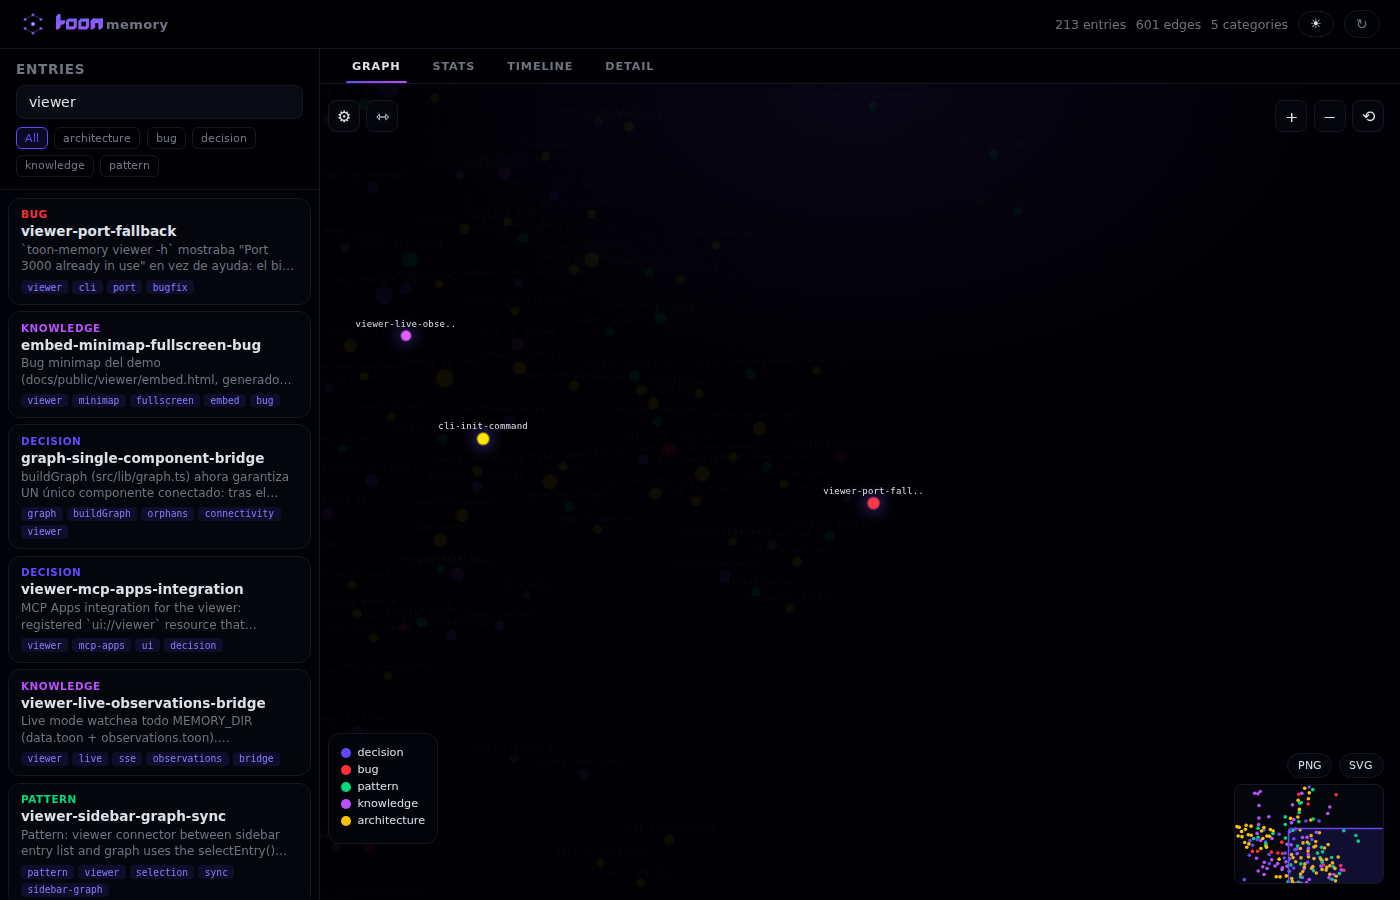
| Buscar | Filtrar entradas; los nodos coincidentes pulsan con brillo |
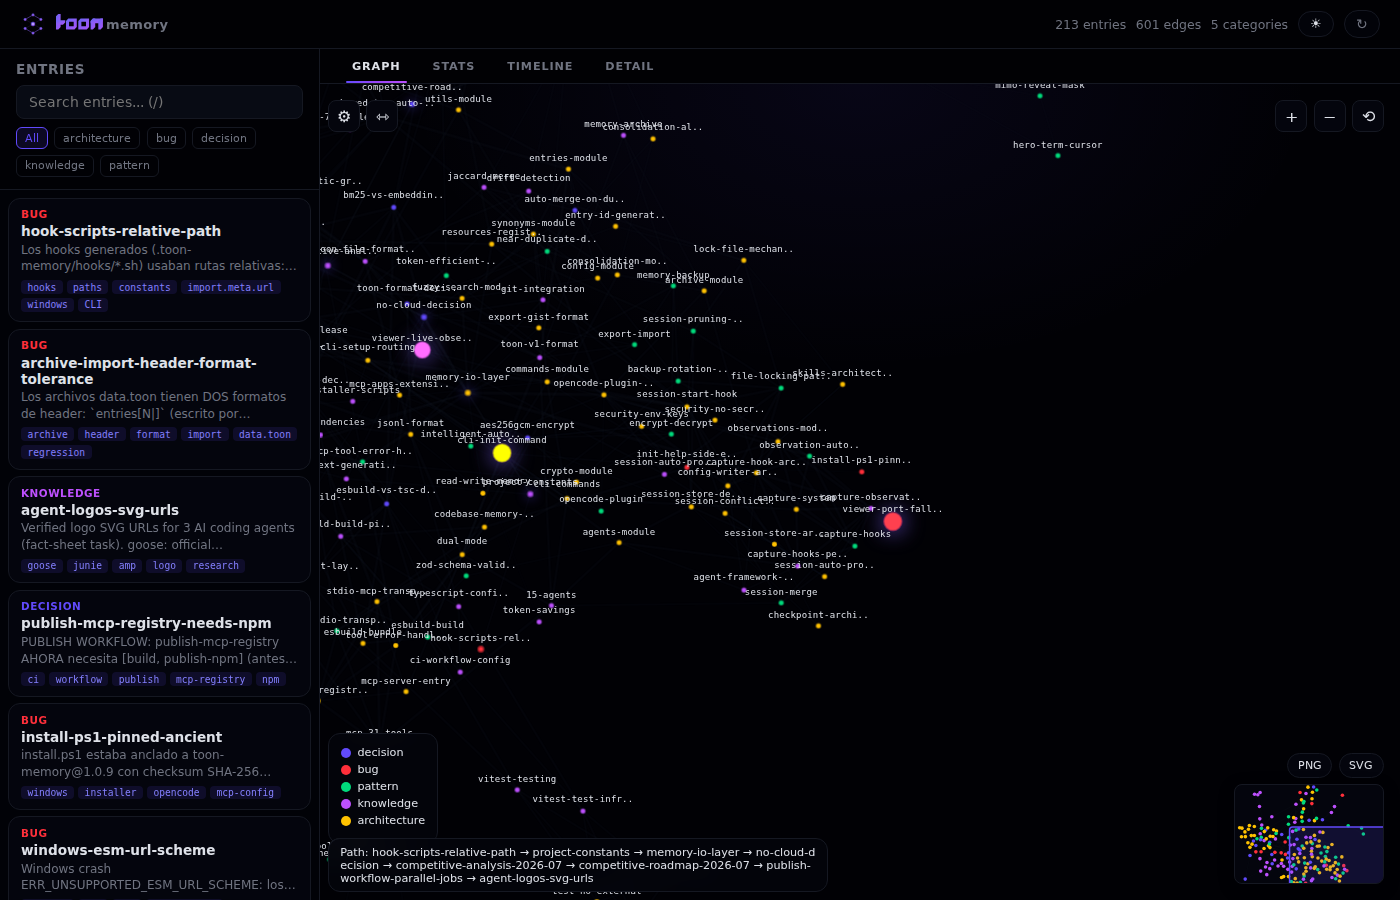
| ⇿ Buscador de rutas | Haz clic en dos nodos para encontrar y resaltar la ruta más corta |
| Zoom/pan | Rueda del ratón o botones +/− |
| ⚙ Física | Ajustar carga, distancia de enlace, gravedad central |
| Cambio de tema | Modo oscuro/claro (persistido) |
| Exportar | Guardar grafo como PNG o SVG |
Capturas de pantalla
| Vista de grafo | Resaltados de búsqueda | Buscador de rutas | Panel de detalle |
|---|---|---|---|
 |  |  |  |
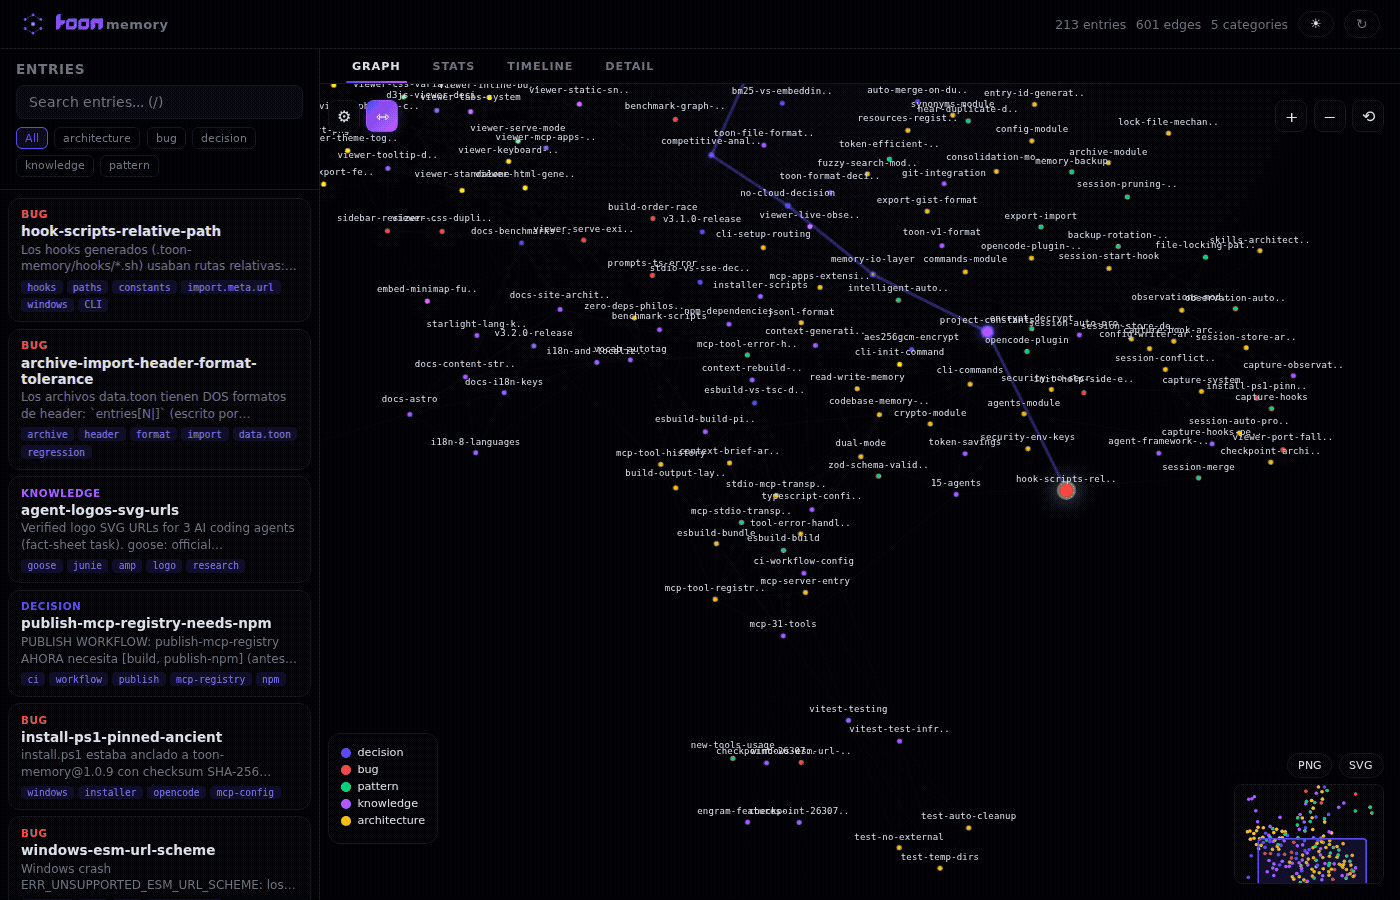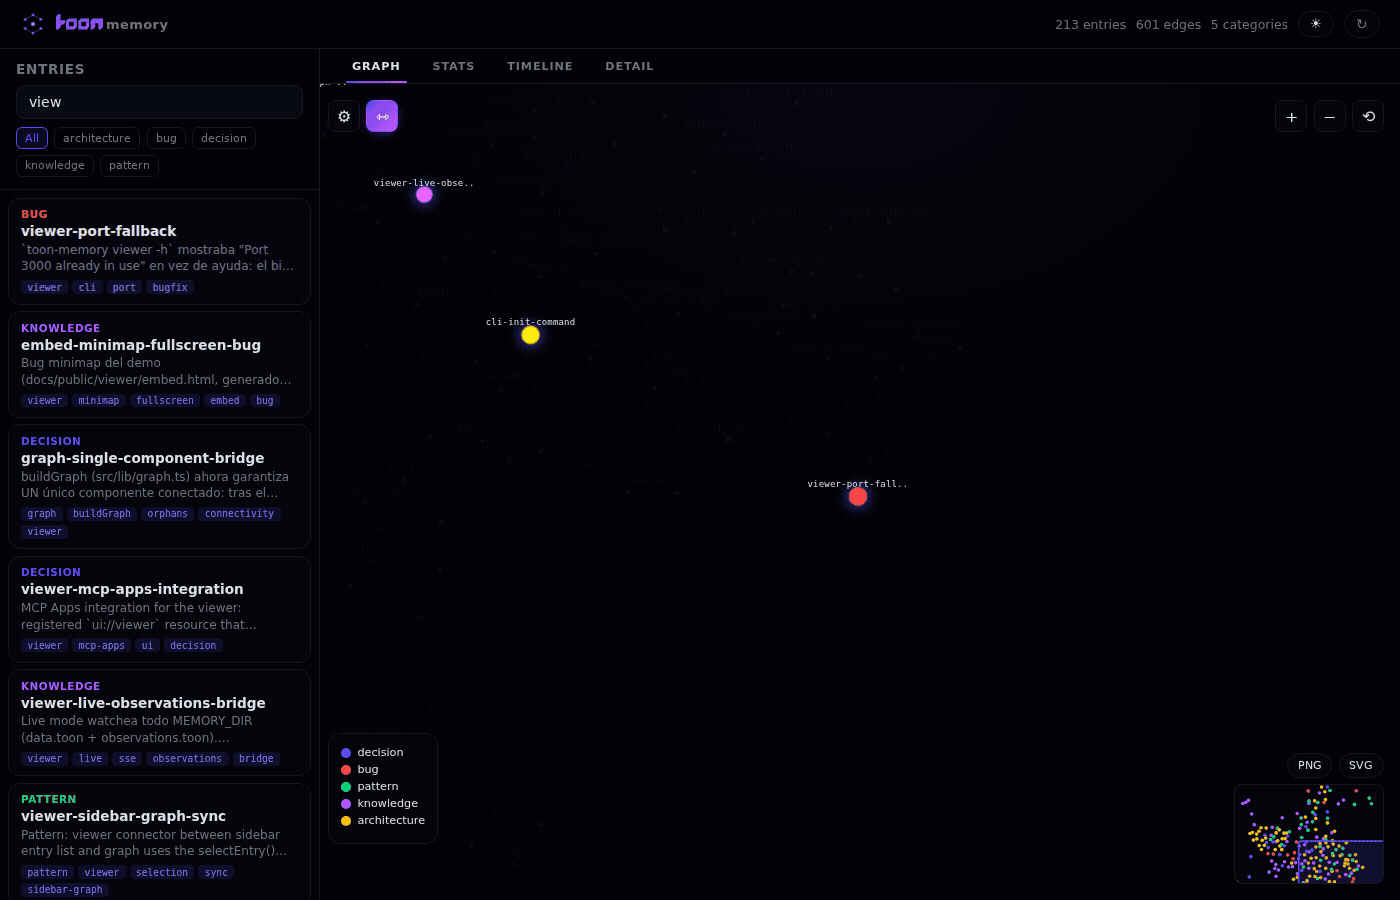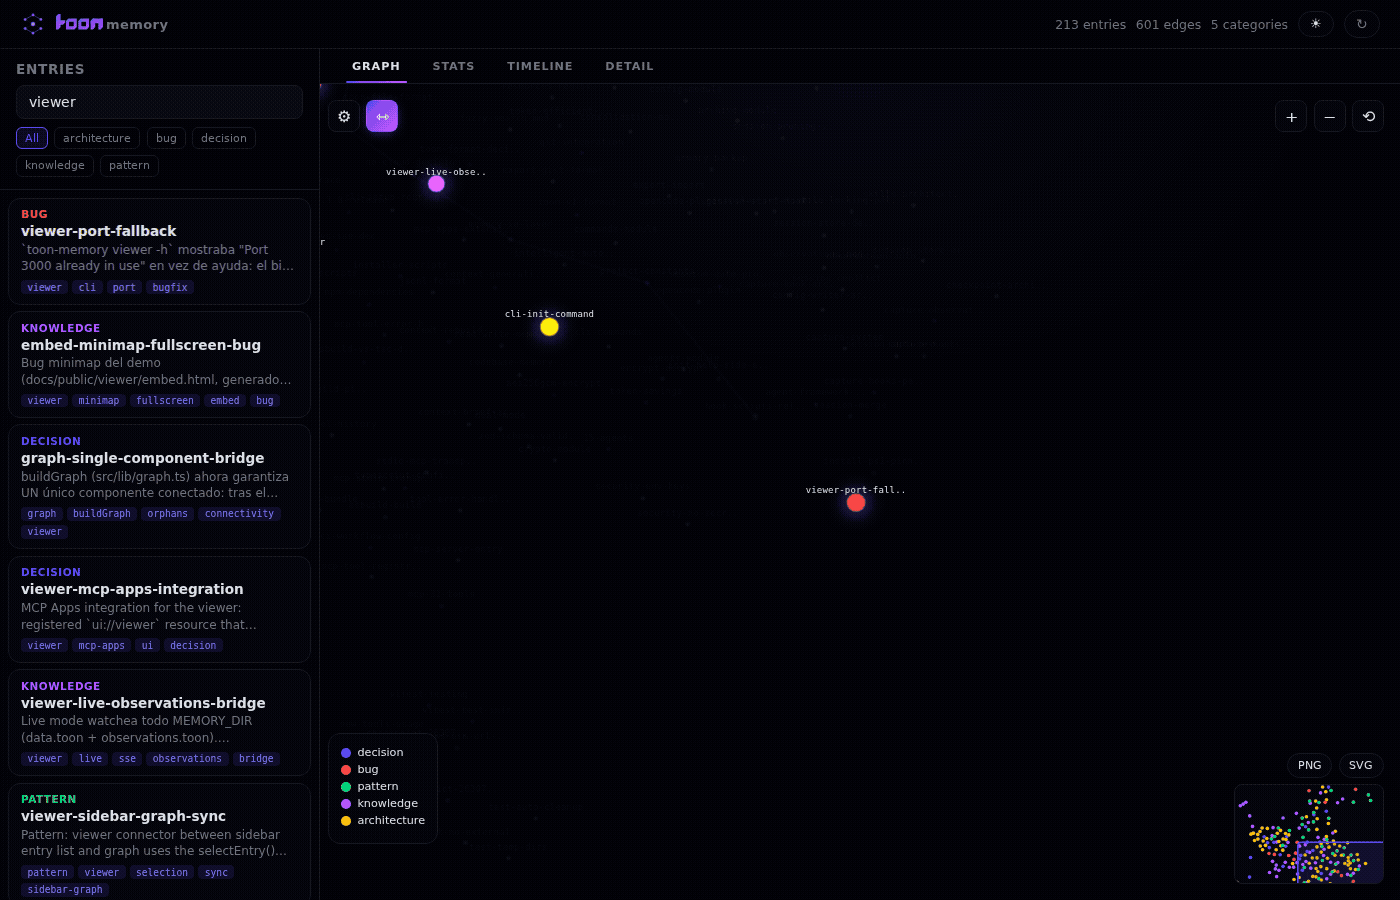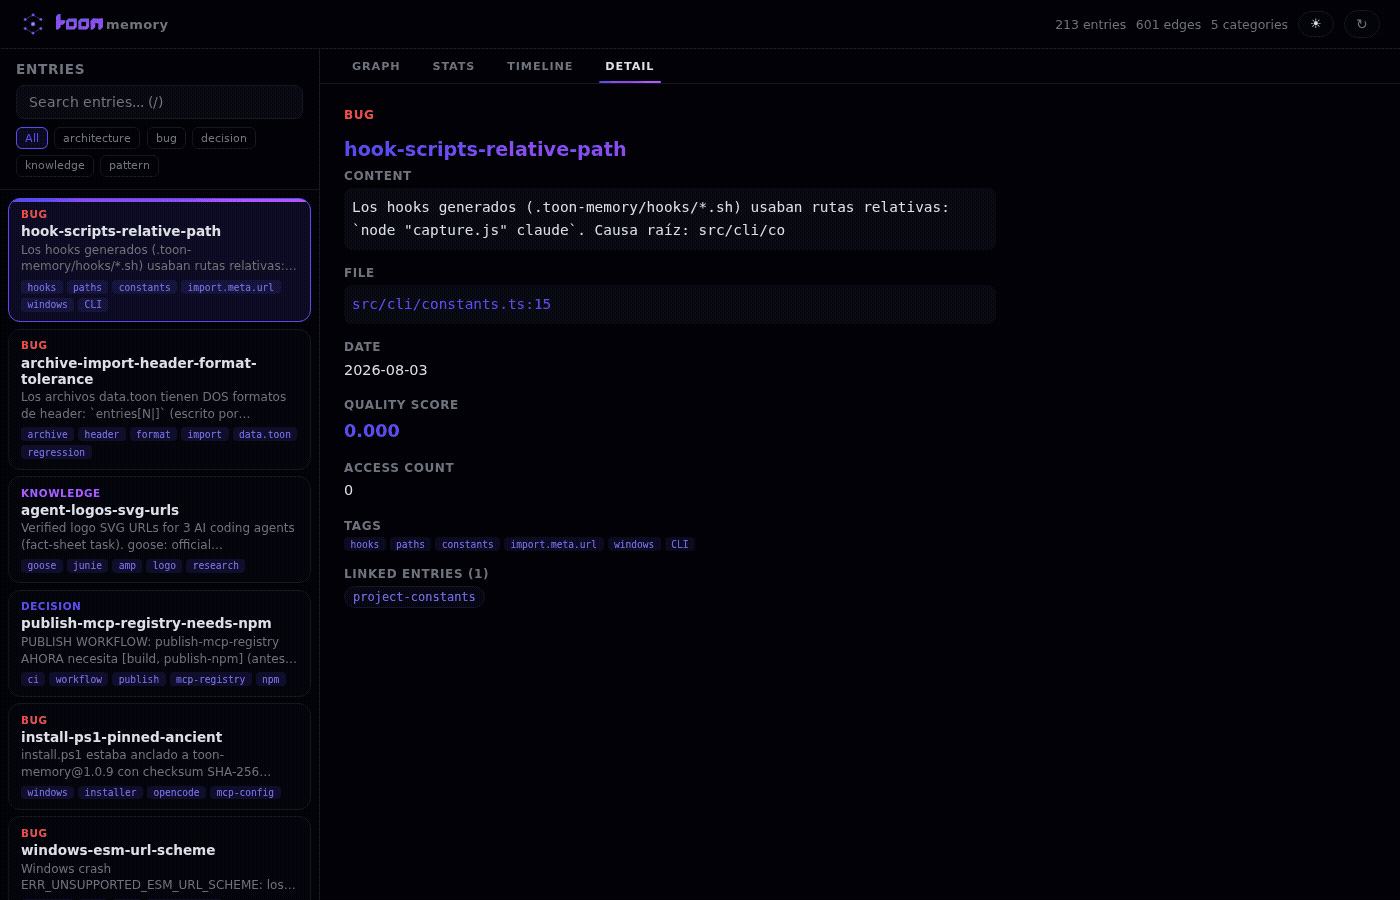
Capturar tus propias capturas de pantalla
npm run capture:viewer
Requiere Playwright (npx playwright install chromium) y ffmpeg.
Consejos y mejores prácticas
Aquí hay algunos patrones que funcionan bien con toon-memory:
El hábito de "inicio de sesión"
Al comienzo de cada nueva sesión, ejecuta:
memory_smart_recall({ intent: "what I was working on" })
Esto le da a tu agente contexto instantáneo sobre lo que sucedió antes — combinando BM25, grafo, calidad y decaimiento en una sola llamada.
El hábito de "fin de sesión"
Antes de cerrar una sesión, guarda cualquier cosa importante:
memory_remember({
  category: "decision",
  key: "auth-approach",
  content: "Chose JWT over sessions — stateless, works across microservices",
  file: "src/auth.ts",
  tags: "auth;architecture"
})
La entrada recibe automáticamente una puntuación de calidad basada en su estructura (etiquetas, detalle del contenido, enlaces).
Elegir categorías
| Categoría | Cuándo usarla |
|---|---|
decision | Decisiones de arquitectura, compensaciones, "por qué X en lugar de Y" |
pattern | Convenciones, frameworks, reglas de estilo de código |
bug | Problemas que arreglaste y cómo |
knowledge | Hechos del proyecto, información de dominio, contexto del equipo |
warning | "NO hagas esto" — anti-patrones, minas terrestres, errores a evitar (recuperado con un impulso) |
Consejo: No lo pienses demasiado. Si es algo que tu yo futuro (o agente) querría saber, guárdalo. Las entradas detalladas con etiquetas específicas puntúan más alto en calidad.
Etiquetas que funcionan bien
Usa etiquetas separadas por punto y coma para filtrar fácilmente:
tags: "redis;performance;fix"
tags: "auth;jwt;security"
tags: "api;rest;versioning"
Consejo: Mantén las etiquetas cortas y consistentes. No son hashtags — son filtros de búsqueda. Etiquetas más específicas = mayor puntuación de calidad.
Qué NO guardar
- No guardes cosas que sean obvias al leer el código
- No guardes notas temporales de depuración
- No guardes secretos, claves de API o credenciales (usa variables de entorno en su lugar)
- No dupliques la misma información con diferentes claves (la fusión-dedup maneja automáticamente las mismas claves)
- Las entradas vagas sin etiquetas obtienen baja calidad — sé específico
Mantén la memoria limpia
Ejecuta memory_archive() mensualmente para mover entradas antiguas al archivo. Ejecuta memory_stats() para verificar el tamaño y la distribución de calidad. Las entradas de baja calidad (contenido vago, sin etiquetas) obtienen automáticamente menor prioridad de recuperación. Usa memory_consolidate para fusionar duplicados y mode: "versions" para retirar notas superadas por versiones más nuevas de librerías.
Comandos CLI
npx toon-memory              # Interactive installer
npx toon-memory init         # Quick setup (no prompts)
npx toon-memory mcp          # Run MCP server directly
npx toon-memory status       # Check installation status
npx toon-memory stats        # View memory statistics
npx toon-memory export       # Export memory to JSON
npx toon-memory import <file> # Import memory from JSON
npx toon-memory viewer       # Open the memory graph viewer (http server)
npx toon-memory viewer --export # Save viewer as static HTML
npx toon-memory viewer --port 3001 # Custom port
npx toon-memory watch [options] # Auto-backup with options
npx toon-memory upgrade      # Update to latest version
npx toon-memory uninstall    # Remove from all agents
Ejemplos
Estadísticas
$ npx toon-memory stats

🧠 toon-memory stats

📊 Memory Stats
━━━━━━━━━━━━━━━━━━
Total entries: 45
├── decision: 12
├── pattern: 18
├── bug: 8
└── knowledge: 7
Last updated: 2026-07-10
File size: 12.4 KB
Consejo: Si la memoria crece demasiado (más de 100 entradas), considera archivar o eliminar entradas desactualizadas con
memory_forget.
Exportar
$ npx toon-memory export

🧠 toon-memory export

Exported 45 entries to:
  /path/to/project/toon-memory-export.json
Consejo: Exporta antes de refactorizaciones importantes. Siempre puedes importar la copia de seguridad más tarde si algo sale mal.
Importar
$ npx toon-memory import backup.json

🧠 toon-memory import

Imported 3 new entries
Skipped 2 duplicates
Consejo: Los duplicados se detectan por clave. Si quieres reimportar una entrada, elimina primero la anterior con
memory_forget.
Vigilar
$ npx toon-memory watch 15 -c -m 20

🧠 toon-memory watch

Watching memory file every 15 minutes...
Max backups: 20
Compression: enabled
Logging: disabled
Press Ctrl+C to stop

📦 Backup #1 created: 2026-07-11T16-00-00-000Z
📦 Backup #2 created: 2026-07-11T16-15-00-000Z
^C
✅ Watch stopped. 2 backups created.
Consejo: El modo de vigilancia es excelente para sesiones de larga duración. Usa
-cpara comprimir y-m 5para conservar solo 5 copias de seguridad.
Opciones de Vigilancia:
| Opción | Descripción | Predeterminado |
|---|---|---|
[interval] | Intervalo de copia de seguridad en minutos | 5 |
-c, --compress | Habilitar compresión gzip | desactivado |
-l, --log [path] | Habilitar registro en archivo | desactivado |
-m, --max-backups <n> | Máximo de copias de seguridad a conservar (0=ilimitado) | 10 |
Configuración
Instalador interactivo (recomendado)
npx toon-memory
El instalador (requiere una terminal) hará lo siguiente:
- Mostrará los 22 agentes compatibles con estado de detección (configuración
✓encontrada) y su alcance compatible (local/globalosolo local) - Te permitirá seleccionar cuáles configurar — por número (
1,3,5), por nombre (claude,codex),all, Enter para todos, oqpara salir - Preguntará por el alcance de instalación: (1) Local (proyecto:
.toon-memory+ configuraciones de agente en el repositorio) o (2) Global (configuraciones~home) - Mostrará un resumen de confirmación (
agent → scope → path (MCP/plugin/hooks/instrucciones)) y preguntará¿Proceder? [Y/n] - Configurará el servidor MCP, archivos de instrucciones y hooks automáticamente
Sin una terminal (CI/pipes)
npx toon-memoryimprime la ayuda de instalación no interactiva. Usanpx toon-memory init [local|global]para instalar sin preguntas. Los comandos desconocidos imprimen el uso y salen con un error.
OpenCode
Añade a .opencode/opencode.json o ~/.config/opencode/opencode.json:
{
  "mcp": {
    "toon-memory": {
      "type": "local",
      "command": ["npx", "-y", "toon-memory", "mcp"],
      "enabled": true
    }
  }
}
Los hooks se entregan mediante un plugin, no una clave
hooksde nivel superior. OpenCode 1.17+ rechaza"Unrecognized key: hooks"en su configuración —toon-memory initescribe.opencode/plugins/toon-memory.tsen su lugar. No añadashooksaopencode.json.
Claude Code
Añade a .mcp.json (raíz del proyecto):
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
VS Code / Copilot
Añade a .vscode/mcp.json:
{
  "servers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Codex CLI
Añade a .codex/config.toml:
[mcpServers.toon-memory]
command = "npx"
args = ["-y", "toon-memory", "mcp"]
Gemini CLI
Añade a .gemini/settings.json:
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Zed
Añade a ~/.config/zed/settings.json:
{
  "mcp_servers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Consejo: Usa la configuración global si quieres memoria para cada proyecto. Usa la configuración a nivel de proyecto si solo la quieres para proyectos específicos.
Cómo Funciona
- Servidor MCP — Se ejecuta localmente, se comunica con tu agente mediante stdio
- Formato TOON — Almacena datos en Notación de Objetos Orientada a Tokens (~22.5% menos tokens que JSON, medido sobre 16 entradas con gpt-tokenizer). Cada entrada rastrea calidad (0–1) y confianza (0–1) automáticamente.
- Memoria por proyecto — Cada proyecto obtiene
.toon-memory/memory/data.toon - Configuración cero — Solo instala y usa
Formato de Archivo de Memoria
version: 1
entries[3|]{id|category|key|content|file|tags|date|ttl|accessed|links|quality|confidence|lastAccessed|priority|path_scope|origin|status|supersededOn|importance|evidence}:
  a1b2c3d4|decision|use-zod|Use Zod for validation|src/types.ts|validation;types|2026-07-10||0||0.65|1.0||0||agent|active|||verified
  e5f6g7h8|pattern|pydantic-configs|Project uses Pydantic v2|config.py|python;patterns|2026-07-10||0||0.55|1.0||0||agent|active|||
  i9j0k1l2|bug|redis-pool-fix|Added max_connections=20 (see [[use-zod]])|redis.ts|redis;fix|2026-07-10|7d|0|use-zod|0.70|0.9||0||agent|active|||conflict
summaries:
  src/services/redis.ts: Redis connection pool with retry logic
Estructura de Archivos
.toon-memory/
├── memory/
│   ├── data.toon        # Main memory file
│   ├── archive.toon     # Archived entries (>30 days)
│   ├── config.json      # Encryption settings
│   └── backups/         # Watch mode backups
│       ├── backup-2026-07-11T16-00-00-000Z.toon
│       └── backup-2026-07-11T16-10-00-000Z.toon
└── hooks/
    ├── session-start-claude.sh
    ├── session-start-codex.sh
    ├── session-start-gemini.sh
    └── session-start-antigravity.sh
¿Por qué TOON?
TOON (Notación de Objetos Orientada a Tokens) está diseñado para LLMs:
| Formato | Tokens (16 entradas) |
|---|---|
| JSON | 1097 |
| TOON | 850 |
Medido con gpt-tokenizer (cl100k_base) sobre 16 entradas de memoria representativas — ver scripts/benchmark-toon.mjs (npm run bench).
Los ahorros de tokens se acumulan en el momento de la sesión: npm run bench:impact simula recuperar contexto con vs sin memoria y mide ~68% menos tokens para obtener el mismo contexto (recuperar compact en lugar de releer archivos fuente). El benchmark completo de sesión (npm run bench:full) muestra 80% menos llamadas a herramientas y 47% menos tokens con herramientas context_*.
- 22.5% menos tokens que JSON a nivel de archivo (hasta 30.5% en una sola entrada)
- Roundtrip sin pérdida — Sin pérdida de datos
- Mejor comprensión del LLM — Estructurado para consumo de IA
- Calidad y confianza — Cada entrada rastrea calidad de estructura (0–1) y fiabilidad (0–1) automáticamente
Consejo: Menos tokens = respuestas más rápidas + menores costos de API. Tu agente lee archivos de memoria en cada inicio de sesión, por lo que la eficiencia importa.
Benchmark: toon-memory vs Alternativas
| Característica | toon-memory | @modelcontextprotocol/server-memory | mem0 | shodh-memory |
|---|---|---|---|---|
| Almacenamiento | Archivo local (TOON) | Archivo local (JSON) | Nube | RocksDB |
| Dependencias | Cero | Cero | API en la nube | sentence-transformers, RocksDB |
| Búsqueda | BM25 + grafo + calidad | Palabra clave básica | Solo vectorial | Híbrida (vectorial + grafo) |
| Eficiencia de tokens | 22.5% menos que JSON | Base (JSON) | N/D (nube) | Similar |
| Puntuación de calidad | Automática (0–1, heurísticas) | Ninguna | Ninguna | Algoritmo BND |
| Fusión-dedup | Unión de etiquetas + máxima confianza | Ninguna | Ninguna | Dedup de contenido |
| Seguimiento de confianza | Por entrada (0–1) | Ninguno | Ninguno | Por entrada |
| Primer del sistema | Generado automáticamente | Ninguno | Ninguno | Ninguno |
| Multi-sesión | Coordinación basada en archivos | Ninguna | N/D | Ninguna |
| Hooks | 15 agentes | Ninguno | Ninguno | Solo Claude |
| Cifrado | AES-256-GCM | Ninguno | Gestionado en la nube | Ninguno |
| Tiempo de configuración | npx toon-memory | JSON manual | Registro en la nube | Docker + configuración |
Eficiencia de tokens (medida)
Format          Tokens (16 entries)    vs JSON
──────────────  ───────────────────    ───────
JSON            1097                   baseline
TOON            850                    -22.5%
Eficiencia de recuperación (medida)
Method                          Tokens to get context    vs re-reading files
──────────────────────────────  ─────────────────────    ───────────────────
Re-read source files            ~3000                    baseline
memory_recall (flat)            ~1200                    -60%
memory_recall (graph, compact)  ~900                     -70%
memory_smart_recall             ~850                     -72%
Benchmark de herramientas de contexto (medido)
Las herramientas context_* reemplazan 3–6 llamadas de herramientas separadas con una sola llamada, ahorrando tanto tokens como sobrecarga de llamadas a herramientas.
Scenario                          Without   With    Saved    Tools
────────────────────────────────  ────────  ──────  ───────  ──────
context_generate (full briefing)    5,556     378    93.2%   6 → 1
context_diff (incremental)            533     152    71.5%   4 → 1
context_focus (targeted)              413     225    45.5%   4 → 1
context_health (audit)                322     246    23.6%   5 → 1
context_export (injectable md)      1,178     218    81.5%   3 → 1
────────────────────────────────  ────────  ──────  ───────  ──────
TOTAL                              8,002   1,219    84.8%  22 → 5
Qué mide cada escenario:
| Herramienta | Sin (ruta manual) | Con (llamada única) | Por qué ahorra |
|---|---|---|---|
context_generate | Leer package.json + README + tsconfig.json + volcado completo de memoria + estadísticas de memoria + sesiones = 6 llamadas | Un informe compacto con todo | Elimina 5 lecturas redundantes; la salida está deduplicada y es compacta |
context_diff | git log + git diff --name-only + memory_diff + sesiones = 4 llamadas | Un diff incremental | Combina estado de git + cambios de memoria en una salida; sin superposición |
context_focus | memory_recall + findCallers + findRelatedFiles + findTestFiles = 4 llamadas | Un informe específico | Solo devuelve lo relevante; sin escaneo completo de memoria |
context_health | memory_stats + escaneo de huérfanos + escaneo de duplicados + validación de referencias de archivos + sesiones obsoletas = 5 llamadas | Un informe de salud | Cada verificación se realiza una vez y se deduplica; sin consultas redundantes |
context_export | memory_stats + memory_recall({ compact: true, mode: "graph" }) + formato manual = 3 llamadas | Una exportación markdown | Formatea la salida directamente; el agente omite el paso de "formatear como markdown" |
Consejo: Usa
context_generateal inicio de la sesión (93% de ahorro de tokens). Usacontext_diffpara "¿qué cambió desde la última vez?" (72% de ahorro). Usacontext_focuspara análisis profundos sobre temas específicos (45% de ahorro).
Medido con gpt-tokenizer (cl100k_base) sobre escenarios de proyectos realistas — ver scripts/bench-context-tools.mjs (npm run bench:context).
Impacto completo de sesión (medido)
Simula una sesión completa de agente en 5 fases (inicio de sesión → depuración → implementación → revisión → cierre) en 3 enfoques: sin memoria, con memory_recall, y con herramientas context_*.
Phase                                   Without memory     memory_recall      context_* tools
──────────────────────────────────────  ─────────────────  ─────────────────  ─────────────────
Phase 1: Session Start                  516 t /  6 c       409 t /  3 c       373 t /  1 c
Phase 2: Debug Issue                    176 t /  4 c       182 t /  2 c       252 t /  1 c
Phase 3: Implement Feature              189 t /  6 c       183 t /  3 c       305 t /  1 c
Phase 4: Code Review                    316 t /  4 c       130 t /  2 c       243 t /  1 c
Phase 5: Wrap-up                      1,214 t /  5 c        68 t /  2 c       117 t /  1 c
──────────────────────────────────────  ─────────────────  ─────────────────  ─────────────────
TOTAL                                 2,411 t / 25 c       972 t / 12 c     1,290 t /  5 c
Hallazgos clave:
| Métrica | Sin memoria | Con memory_recall | Con herramientas context_* |
|---|---|---|---|
| Tokens por sesión | 2,411 | 972 (-60%) | 1,290 (-47%) |
| Llamadas a herramientas por sesión | 25 | 12 (-52%) | 5 (-80%) |
| Costo por sesión (GPT-4) | $0.072 | $0.029 | $0.039 |
El equilibrio: memory_recall usa menos tokens (972 vs 1,290) porque devuelve solo las entradas coincidentes. Las herramientas context_* devuelven contexto más rico (llamadores, archivos relacionados, archivos de prueba, auditoría de salud) — más tokens por llamada, pero 80% menos llamadas a herramientas. En la práctica, el agente evita 3-4 llamadas de seguimiento de "encontrar relacionados" que context_focus ya incluye.
Dónde gana context_ en grande:*
- Inicio de sesión (Fase 1): 28% menos tokens + 6→1 llamadas — un informe reemplaza la lectura de 6 archivos
- Cierre (Fase 5): 90% menos tokens —
context_healthreemplaza 5 escaneos manuales - Llamadas a herramientas: 25→5 llamadas = 80% menos sobrecarga de latencia por sesión
Consejo: Usa
memory_recallcuando necesites entradas específicas (menos tokens). Usacontext_*cuando necesites contexto completo con menos viajes de ida y vuelta (menos llamadas).
Medido con gpt-tokenizer (cl100k_base) — ver scripts/bench-full-impact.mjs (npm run bench:full).
Consejo:
memory_smart_recallcombina BM25 + grafo + calidad en una sola llamada, ahorrando tanto tokens como sobrecarga de llamadas a herramientas. Úsalo al inicio de cada tarea.
Benchmark de clasificación RRF (medido)
Desde v3.7.0, la recuperación clasifica resultados con Fusión de Rango Recíproco sobre rangos BM25 (×3) y de centralidad de grafo, con un k = clamp(3..60, round(sqrt(n))) adaptativo. Medido sobre 8 consultas de referencia con relevancia etiquetada manualmente (ver scripts/bench-rrf.mjs, npm run bench:rrf):
Metric        linear (v3.6.x)     RRF (v3.7.0)
────────────  ─────────────────   ────────────────
nDCG@10       0.776               0.776   (parity)
MRR           0.917               0.917   (parity)
RRF iguala la puntuación ponderada lineal anterior a costo de clasificación cero, mientras simplifica el pipeline de puntuación (BM25×3 + centralidad, sin ruido de importancia/recencia). Se respeta la supersesión en modo grafo: las entradas obsoletas permanecen excluidas excepto para consultas puntuales as_of.
Benchmark de recuperación (estilo LongMemEval, medido)
Desde v4.1.0, la recuperación se evalúa contra una instantánea congelada de memoria de proyecto real — un conjunto de pruebas estilo LongMemEval con consultas de referencia escritas manualmente. Corpus: 187 entradas data.toon reales (instantánea 2026-08-01), 42 consultas de referencia en 6 categorías (hecho central, temporal, actualización de conocimiento, multi-salto, meta/sesión, distractor). El código medido es el pipeline de producción (src/lib), incluido en memoria con esbuild — sin copias fieles. Un parámetro determinista today fija recencia/decadencia para que los resultados no varíen con el reloj; las ejecuciones son de solo lectura (sin seguimiento de acceso). Se excluyen dos meta-entradas prioritarias que describen el propio archivo de datos. Ver benchmarks/retrieval-corpus.toon, benchmarks/gold-queries.json (npm run bench:retrieval):
Mode            R@5     nDCG@5  MRR@5   answerable
─────────────   ─────   ─────   ─────   ──────────
linear         0.643   0.654   0.776   81.0%
rrf            0.861   0.764   0.788   97.6%
smart (unified) 0.829  0.739   0.760   92.5%
RRF es el modo mejor clasificado (0.861 R@5, 97.6% de consultas respondibles desde el top-5); memory_smart_recall sigue siendo competitivo en una sola llamada.
Solución de Problemas
Memoria no encontrada después de la instalación
Síntoma: El agente dice que no tiene herramientas de memoria.
Solución:
- Ejecuta
npx toon-memory statuspara verificar la instalación - Reinicia tu agente por completo (cierra y vuelve a abrir)
- Verifica que el archivo de configuración MCP exista y sea JSON válido
El archivo de memoria está vacío
Síntoma: memory_stats muestra 0 entradas.
Solución: Esto es normal en la primera instalación. Comienza a usar memory_remember para guardar entradas.
Entradas duplicadas
Síntoma: La misma clave aparece múltiples veces.
Solución: memory_remember con la misma clave ahora se fusiona automáticamente (unión de etiquetas, máxima confianza, fecha más reciente). Usa memory_consolidate para fusionar todas las entradas con la misma clave y eliminar duplicados de contenido exacto. Para limpieza manual, usa memory_forget.
Clave de cifrado perdida
Síntoma: No se puede descifrar la memoria.
Solución: Desafortunadamente, no hay recuperación. La clave de cifrado no se almacena en ningún lugar después de la generación. Esto es por diseño por seguridad. Tendrás que empezar de nuevo o restaurar desde una copia de seguridad no cifrada.
Memoria demasiado grande
Síntoma: Las respuestas del agente son lentas.
Solución:
- Ejecuta
memory_archive()para mover entradas antiguas al archivo - Usa
memory_forgetpara eliminar entradas irrelevantes - Mantén las entradas concisas: guarda la decisión, no toda la conversación
- Las entradas de baja calidad (vagas, sin etiquetas) obtienen menor prioridad de recuperación automáticamente
Preguntas frecuentes
¿Funciona con cualquier agente de IA?
Sí, siempre que admita MCP (Protocolo de Contexto de Modelo). Tenemos configuración automática para 22 agentes, con configuración manual disponible para otros.
¿Se envía mi datos a algún lugar?
No. Todo permanece en tu máquina. El servidor MCP se ejecuta localmente a través de stdio: sin llamadas de red, sin telemetría, sin nube.
¿Puedo usar esto en varias máquinas?
Sí, si sincronizas el directorio .toon-memory/memory/ (por ejemplo, mediante Git o una carpeta compartida). Cada máquina necesita toon-memory instalado, pero el archivo de memoria es portátil.
¿Qué pasa si tengo varios proyectos?
Cada proyecto tiene su propio archivo de memoria. La memoria no se filtra entre proyectos.
¿Puedo cifrar solo entradas específicas?
No, el cifrado se aplica a todo el archivo de memoria. Si necesitas cifrado selectivo, guarda los datos sensibles en una herramienta separada.
¿En qué se diferencia de simplemente usar un archivo markdown?
Los archivos Markdown no están estructurados, no son buscables por tu agente de la misma manera, no se integran a través de MCP y no tienen funciones como archivado, filtrado por fecha, puntuación de calidad, fusión-deduplicación, seguimiento de confianza o cifrado. toon-memory está diseñado específicamente para agentes de IA.
Desarrollo
git clone https://github.com/LuiggiVal08/toon-memory.git
cd toon-memory
npm install
npm run build
npm test
Estructura del proyecto
toon-memory/
├── src/
│   ├── bin/
│   │   └── toon-memory.ts      # Entry point
│   ├── cli/
│   │   ├── setup.ts             # CLI commands
│   │   └── toon-memory.ts       # CLI runner
│   ├── mcp/
│   │   ├── server.ts            # MCP server (38 tools + 4 resources + 1 prompt)
│   │   ├── tools.ts             # Tool registration (38 tools)
│   │   ├── resources.ts         # Resource registration (4 resources)
│   │   ├── prompts.ts           # Prompt registration (1 prompt)
│   │   ├── session-store.ts     # Session layer (auto-promote, cleanup)
│   │   ├── memory-io.ts         # Memory file read/write
│   │   ├── entries.ts           # Entry parsing & utilities
│   │   ├── scoring.ts           # Entry scoring & access tracking
│   │   ├── archive.ts           # Archive management
│   │   ├── consolidation.ts     # Duplicate consolidation
│   │   ├── config.ts            # Config loading & saving
│   │   └── crypto.ts            # AES-256-GCM encryption
│   ├── lib/
│   │   ├── lock.ts              # Advisory file lock + atomic write
│   │   ├── sessions.ts          # Multi-session coordination
│   │   ├── graph.ts             # Memory graph (parse, build, BM25, centrality, compact render)
│   │   ├── quality.ts           # Quality scoring, merge-dedup, smart recall, system primer
│   │   ├── context.ts           # Context briefing generator (one-call context)
│   │   └── vocab.ts             # Project-vocabulary discovery from dependencies
├── tests/
│   ├── cli.test.ts              # CLI tests
│   ├── memory.test.ts           # Memory tests
│   ├── sessions.test.ts         # Multi-session tests
│   ├── graph.test.ts            # Memory graph tests
│   └── quality.test.ts          # Quality scoring, merge-dedup, smart recall, system primer tests
├── .github/workflows/
│   ├── ci.yml                   # CI (Node.js 20/22)
│   └── publish.yml              # Auto-publish on release
├── package.json
├── tsconfig.json
└── vitest.config.ts
Contribuciones
¡Las contribuciones son bienvenidas! Por favor, lee primero nuestro Código de Conducta y Guía de Contribución.
- Haz un fork del repositorio
- Crea tu rama de características (
git checkout -b feature/amazing-feature) - Realiza tus cambios (
git commit -m 'feat: add amazing feature') - Sube a la rama (
git push origin feature/amazing-feature) - Abre una solicitud de extracción
Seguridad y privacidad
toon-memory está diseñado con la seguridad y la privacidad como principio fundamental.
- Almacenamiento 100% local — Toda la memoria se almacena localmente en tu máquina en
.toon-memory/memory/. Nunca se envían datos a servidores externos, servicios en la nube o terceros. - Sin telemetría — El proyecto tiene cero telemetría, análisis o seguimiento de cualquier tipo. No se recopilan datos de uso.
- Sin ejecución de código remoto — toon-memory se ejecuta como un servidor MCP estándar a través de stdio. No descarga, ejecuta ni evalúa código remoto.
- Cifrado en reposo — Cifrado opcional AES-256-GCM para todo el archivo de memoria. Habilítalo con
memory_encrypt(requiere la variable de entornoTOON_MEMORY_KEY). - La clave de cifrado nunca se almacena — La clave de cifrado debe proporcionarse mediante una variable de entorno y nunca es persistida por toon-memory. Si se pierde, los datos no se pueden recuperar.
- Aislamiento por proyecto — Cada proyecto tiene su propio archivo de memoria aislado. La memoria no se filtra entre proyectos.
- Automático
.gitignore— El instalador agrega.toon-memory/memory/a.gitignorepara evitar confirmaciones accidentales de datos de memoria.
Licencia
MIT
Créditos
Construido con @toon-format/toon y @modelcontextprotocol/server.