LWC
Servidor MCP de solo lectura para exploración acotada de memoria de proyecto basada en el código fuente, con citas, procedencia, recuperación SQLite/FTS5 y gráficos opcionales de documentos y código.
Documentación
LWC — Memoria proactiva para agentes de IA
Impulsado por agentes · Persistente · Basado en fuentes




Inglés · 简体中文 · 日本語 · Español · Português (Brasil) · Francés · Русский
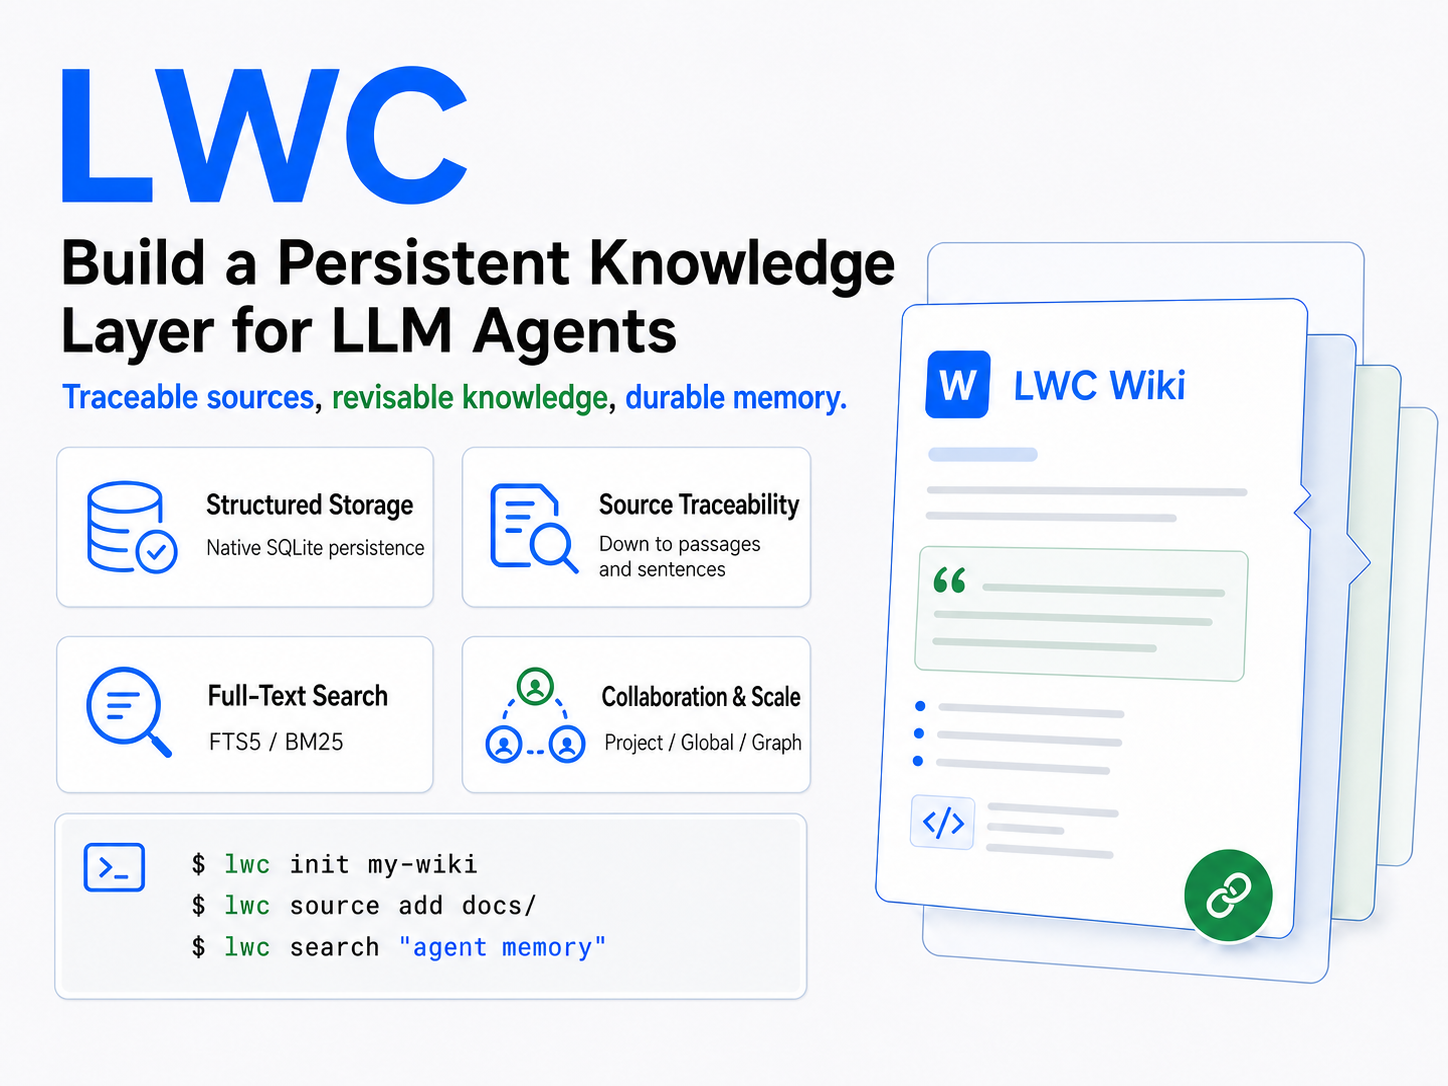
lwc es una CLI de memoria proactiva impulsada por agentes para agentes de IA. Permite que los agentes
recuperen, mantengan y evolucionen de forma autónoma conocimiento persistente y basado en fuentes
a lo largo de las sesiones.
Funciona con Claude Code, Codex, Cursor, OpenCode, Gemini CLI, Kiro, Hermes, Antigravity, GitHub Copilot en VS Code, Copilot CLI, Copilot para JetBrains y pi.
LWC convierte documentos seleccionados en una Wiki duradera. Los agentes razonan y sintetizan;
lwc preserva fuentes, páginas, citas, enlaces, índices e historial para que el
conocimiento se acumule en lugar de redescubrirse desde fragmentos en bruto en cada
consulta.
Memoria de equipo autoalojada — v0.19.3
Los espacios de equipo de LWC mantienen la memoria central en SQLite local y archivos Wiki, y la sincronizan automáticamente a través de un servidor autoalojado. Los agentes externos resuelven conflictos mediante CLI/MCP; LWC no incorpora un LLM. La consola de equipo admite inglés y chino simplificado, permisos de espacio explícitos, acceso de dispositivos/agentes y recuperación de memoria auditable. Los lectores solo en la nube pueden consultar sin crear una réplica local.
Consulta la guía de implementación, el protocolo y el diseño de acceso y recuperación. El inicio de sesión con correo electrónico, Feishu y GitHub utiliza la configuración de proveedor proporcionada por la implementación.
Inicia sesión con una clave personal generada, selecciona un espacio autorizado y aprovisiona un miembro con acceso inicial al espacio en un solo paso. Comparte enlaces de páginas con verificación de permisos y sigue enlaces de conocimiento sin salir del lector. Guía de equipo · Notas de la versión.
LWC es memoria de agente, no RAG
Tanto RAG como LWC pueden ayudar a un LLM a trabajar con documentos externos, pero mantienen el estado en lugares diferentes. Una solicitud RAG típica recupera fragmentos en bruto y construye una respuesta en el momento de la consulta:
query -> retrieve chunks -> generate answer
LWC conserva el trabajo útil entre solicitudes:
task -> recall maintained Wiki -> reason from sources and prior synthesis
     -> write durable improvements back
La recuperación es una operación dentro de LWC, no su principio organizador. El artefacto duradero es una Wiki basada en fuentes cuyas páginas, citas, enlaces, contradicciones e historial se revisan a medida que cambia el conocimiento. Por lo tanto, LWC no requiere incrustaciones ni una base de datos vectorial, y no descarta cada síntesis después de responder. Puede complementar RAG, pero no es RAG en el momento de la consulta.
El agente opera LWC
lwc es una interfaz de máquina para agentes, no una aplicación de toma de notas orientada a humanos. En
el uso normal, un humano selecciona fuentes, establece objetivos, hace preguntas y revisa
respuestas o el Markdown proyectado. El agente ejecuta la CLI, gestiona el alcance,
integra fuentes, mantiene citas y enlaces, y decide qué vale la pena recuperar
o escribir de vuelta.
No conduzcas manualmente el flujo de trabajo rutinario de lwc a menos que estés desarrollando o
depurando la herramienta. Pide a tu agente que active la habilidad canónica
using-lwc incluida en su lugar, generalmente como $using-lwc.
Recomendado: pide a tu agente que configure LWC
Pega este mensaje en el agente que uses. Instala la CLI global, delega toda la configuración de hosts compatibles al instalador idempotente AgentTarget de LWC y usa la autoconfiguración nativa solo para un agente no registrado.
Copia el mensaje de configuración completo
Configure LWC completely for this user. Perform and verify the work; do not
merely describe commands for me to run.

Source of truth:
- https://github.com/JanYork/llm-wiki-cli
- https://github.com/JanYork/llm-wiki-cli/tree/main/skills/using-lwc

Requirements:
1. Read this README, `SECURITY.md`, and `skills/using-lwc/SKILL.md`. Install the
   official checksum-verified release if `lwc` is not globally callable; never
   prefix routine commands with a private binary path or `LWC_PROJECT_ROOT`.
2. Run `lwc --version`, initialize global memory once with
   `lwc --scope global init` when missing, then run `lwc agent install --yes`.
   This command detects installed supported Agents and safely installs their
   MCP, Skill, Hook and Instructions using official locations. Do not recreate
   that logic manually or install a native package for the same Agent as well.
3. Inspect `lwc agent status --target all --location global`. Restart affected
   Agents and complete their normal Hook trust review where required. Do not
   initialize a project Wiki or either graph without explicit project consent.
4. If the current runtime is not one of LWC's registered AgentTargets, use its
   official user-level conventions to install the canonical `using-lwc` Skill,
   an additive instruction block, `lwc serve --mcp`, and a bounded session Hook
   only where those surfaces are officially supported. Preserve existing
   configuration, remain idempotent, and report unsupported surfaces instead of
   inventing paths or keys.

Finish with the LWC version, detected and configured Targets, status results,
files changed, unsupported surfaces, and any restart or trust action remaining.
Origen y agradecimientos
lwc implementa el patrón LLM Wiki
propuesto por Andrej Karpathy: un LLM construye y mantiene de forma incremental una
Wiki persistente e interconectada en lugar de reconstruir conocimiento a partir de documentos en bruto
para cada consulta. La arquitectura de la CLI y los detalles de implementación seleccionados
también se inspiran en
nashsu/llm_wiki.
Este proyecto adapta esas ideas a una CLI de Rust prioritaria para agentes respaldada por SQLite.
Diseño central
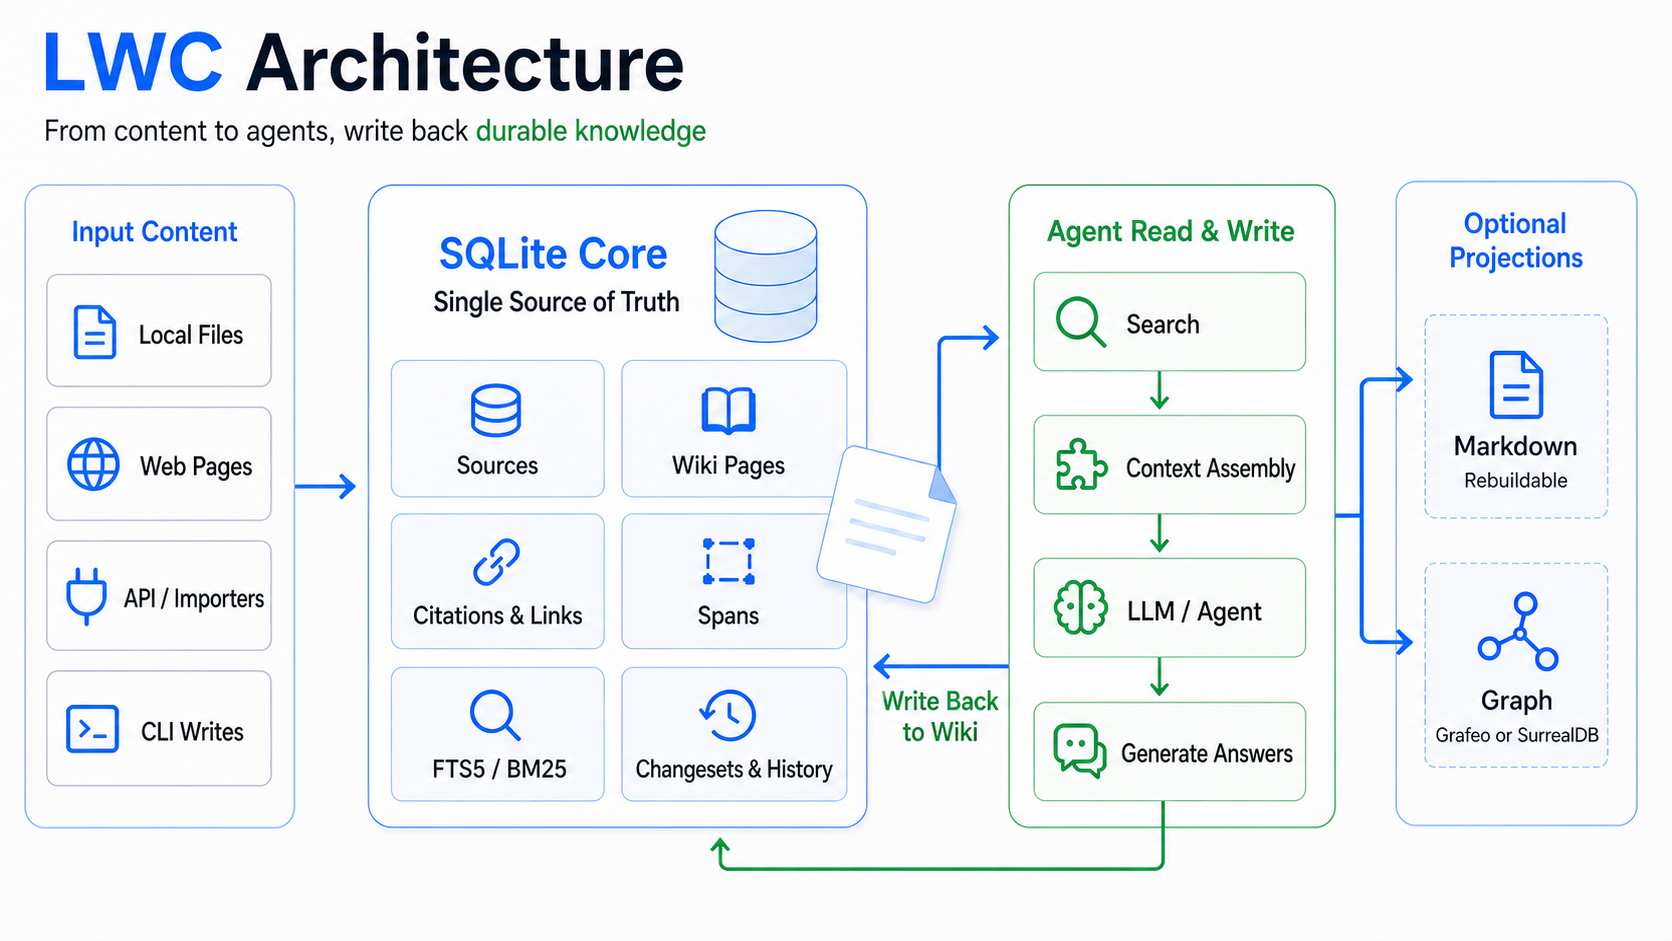
LWC mantiene cuatro capas distintas para que el conocimiento duradero siga siendo trazable:
| Capa | Propósito |
|---|---|
| Fuentes en bruto | Instantáneas inmutables de evidencia seleccionada |
| Wiki | Páginas, citas, enlaces y procedencia mantenidos por el agente |
| Memoria temporal | Registros compactos de cambios, decisiones, resultados y trabajo pendiente |
| Esquema y propósito | Reglas específicas del proyecto que guían el mantenimiento futuro |
SQLite es canónico. El Markdown, los índices de texto completo y los almacenes de grafos opcionales son proyecciones reconstruibles. Los agentes actualizan el conocimiento mediante la CLI; las operaciones exitosas devuelven JSON estructurado que se puede auditar y reanudar.
Lee la descripción general de la arquitectura →
Archivos de memoria portátiles
Los agentes pueden empaquetar una Wiki de proyecto, o una Wiki global seleccionada explícitamente, en un único archivo portátil e importarlo de forma segura o fusionarlo de forma conservadora en otro almacén de LWC. El archivo contiene la memoria de texto plano completa de la Wiki seleccionada, por lo que debes compartirlo solo con un destinatario de confianza y tratar el contenido recibido como datos no confiables, no como instrucciones.
La memoria existente nunca se reemplaza implícitamente: las importaciones preparan una fusión reanudable, mientras que la sobrescritura completa del almacén requiere confirmación humana separada. Los índices y proyecciones reconstruibles se restauran después de la publicación; Tutor, Book y Practice permanecen independientes del archivo v1.
Usa archivos de memoria portátiles de forma segura →
Recuperación jerárquica y grafo de conocimiento
LWC indexa fuentes y páginas Wiki a nivel de documento, pasaje y oración. Los agentes pueden comenzar con un contexto pequeño con forma de respuesta, expandir el intervalo exacto solo cuando sea necesario y detectar localizadores obsoletos después de cambios de contenido.
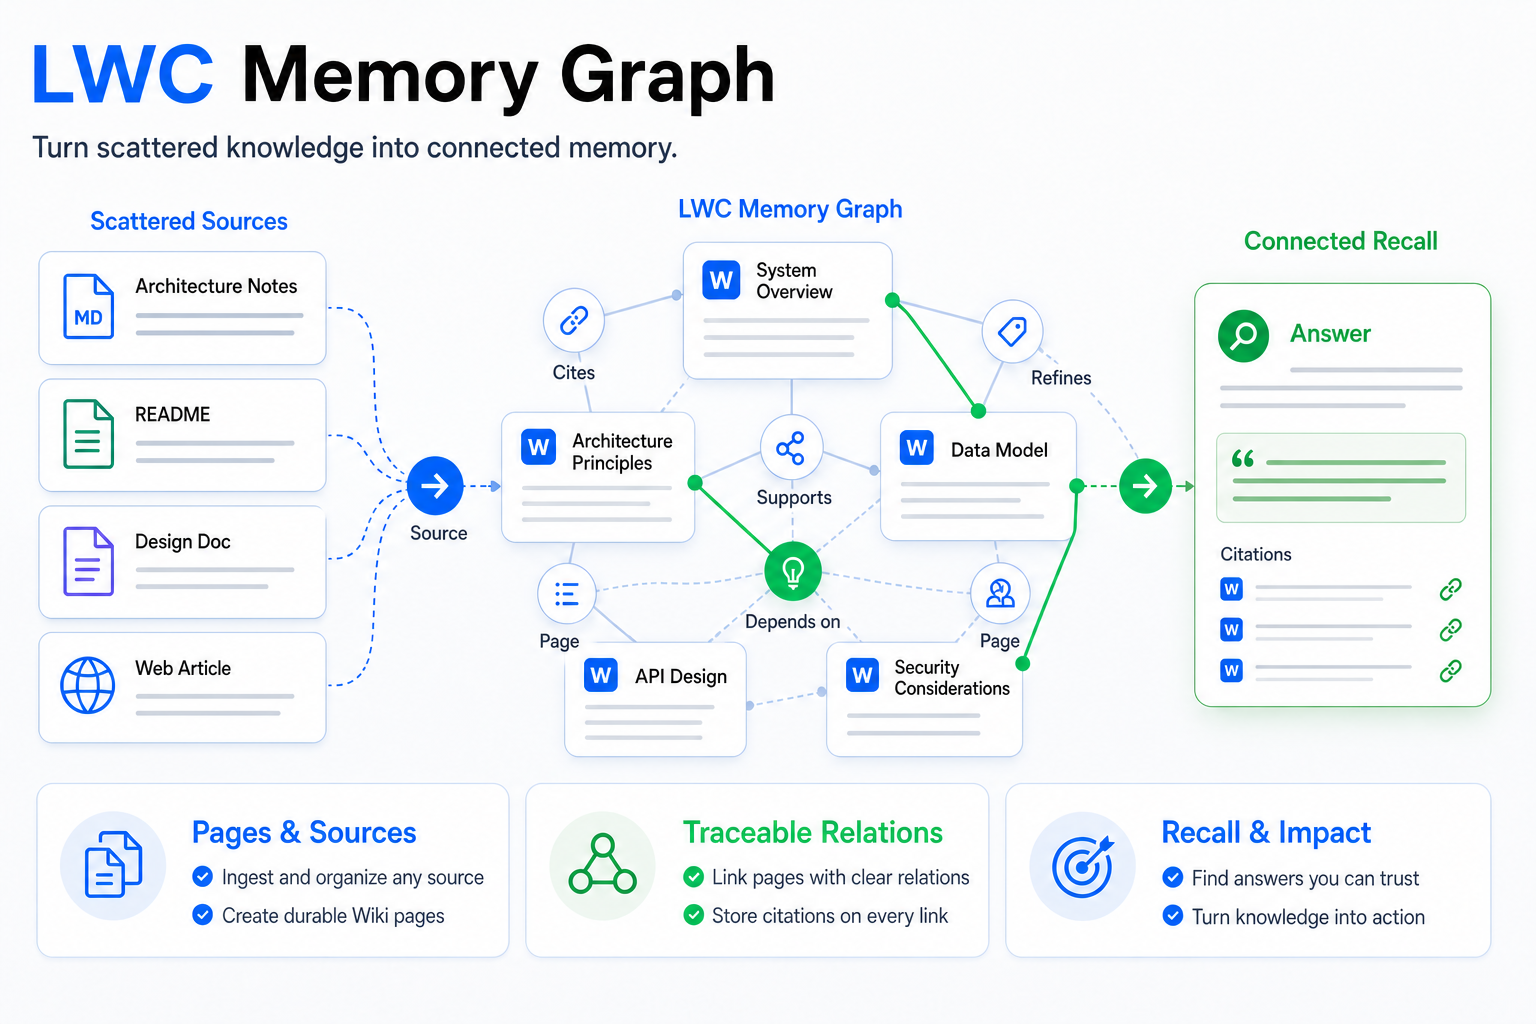
El grafo de documentos opcional conecta páginas, fuentes, citas, enlaces y relaciones semánticas explícitas. SQLite sigue siendo la autoridad, mientras que Grafeo o SurrealDB proporcionan una capa de recorrido reconstruible. Las relaciones explícitas mantienen su razón, procedencia, confianza y evidencia de fuente.
Conversión de documentos y lectura de Office
Los adaptadores opcionales Anydoc o MarkItDown convierten archivos locales compatibles en Markdown revisable antes de la ingesta. OfficeCLI proporciona una ruta separada, basada en consentimiento y de solo lectura para archivos de Word, Excel y PowerPoint. Ninguna capacidad se instala o habilita silenciosamente, y los archivos de Office de origen nunca se modifican.
La búsqueda de pasajes también indexa la ruta de encabezados H2-H6 circundante como un campo independiente. El contexto de encabezados puede mejorar la coincidencia, pero nunca se antepone al fragmento devuelto ni se incluye en su rango de bytes, por lo que las citas y los localizadores de intervalo siguen apuntando al texto canónico exacto del cuerpo. La migración 17 del almacén reconstruye solo este índice derivado de intervalo/búsqueda.
Explora la recuperación y la indexación → · Grafo de documentos → · Conversión de documentos →
Suite de aprendizaje opcional
Tutor, Book y Practice son capacidades independientes de primera parte, deshabilitadas por defecto y respaldadas por almacenes privados separados:
- Tutor conserva turnos de enseñanza, evidencia del alumno, objetivos, planes y un Soul/Wiki privado.
- Book importa libros compatibles en orden de fuente verificado para una lectura completa y fundamentada.
- Practice conserva bancos de preguntas versionados, exámenes, intentos, calificaciones, tarjetas didácticas y estado de revisión FSRS.
Cada runtime se descarga de forma diferida, se fija a la versión de LWC y se verifica mediante suma de verificación. Deshabilitar una capacidad preserva sus datos canónicos. Las habilidades del agente gestionan la recuperación y la persistencia sin exponer el mantenimiento rutinario al alumno.
Lee los contratos de la Suite de aprendizaje →
Instalación
La mayoría de los usuarios solo necesitan un comando de paquete:
npm install --global @i-xor/lwc
Homebrew, crates.io, versiones de GitHub verificadas por suma de verificación y compilaciones locales de Cargo también son compatibles.
Guía de instalación y actualización →
Habilidad de agente complementaria
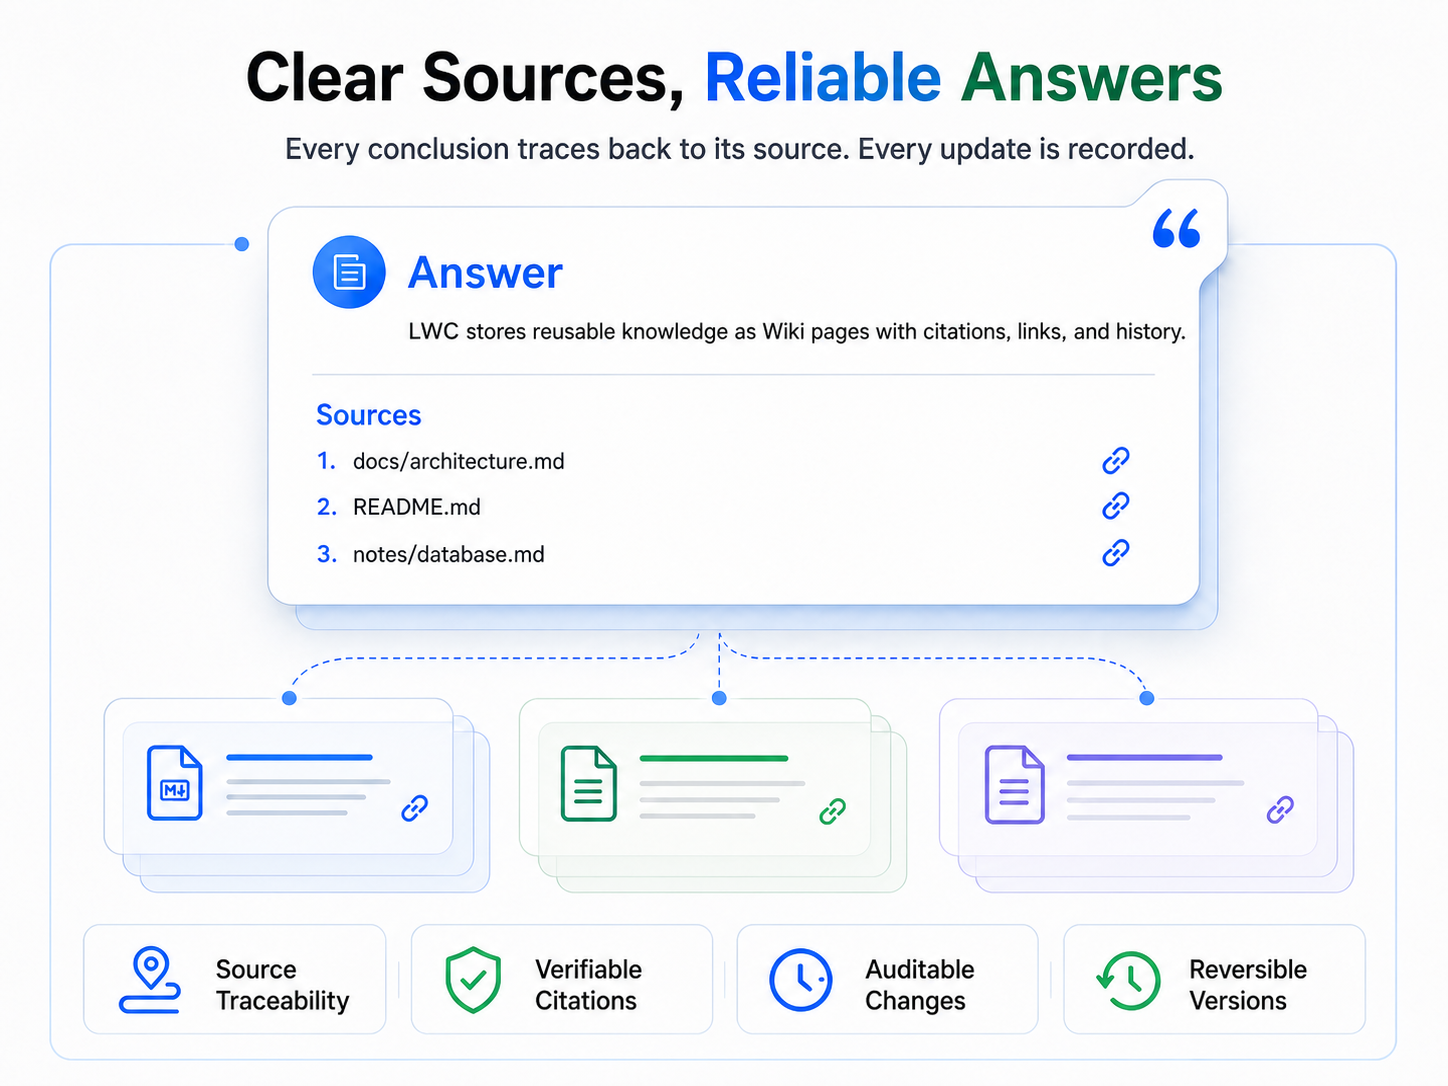
La habilidad using-lwc incluida convierte a LWC en una capa de memoria proactiva. Recuerda contexto limitado, mantiene separados el conocimiento del proyecto y el global, integra fuentes, preserva citas y escribe de vuelta solo conocimiento verificado que valga la pena reutilizar.
Instálala desde skills.sh:
npx skills add JanYork/llm-wiki-cli --skill using-lwc -g
El desencadenante canónico es $using-lwc. La habilidad es neutral en cuanto al runtime
e incluye orientación específica para memoria, grafos de documentos, Word Graph,
CodeGraph, etiquetas fuertes, conversión, incorporación, recuperación y mantenimiento.
Configuración nativa del agente
LWC detecta agentes compatibles e instala sus superficies MCP, Skill, Hook e Instructions disponibles mediante adaptadores AgentTarget idempotentes:
lwc agent install --yes
El MCP unificado de solo lectura expone memoria Wiki limitada y contexto de código opcional sin ampliar el espacio de trabajo activo. Los 12 objetivos registrados son Claude Code, Cursor, Codex, OpenCode, Hermes, Gemini CLI, Antigravity, Kiro, GitHub Copilot en VS Code, Copilot CLI, Copilot para JetBrains y pi.
agent status informa hook_capabilities verificado por separado de los eventos nativos
realmente escritos como installed_hook_events para ese ámbito. El consentimiento de shell restringido
se aplica como una solicitud solo para Claude Code, Cursor, Hermes global y
Antigravity; Codex recibe contexto adicional de asesoramiento y no puede aplicar la
solicitud. Los eventos de consentimiento no compatibles no se instalan y devuelven una no operación exacta.
Solo Claude Code y Codex pueden continuar un Plan activo procesable desde Stop,
una vez por guardia de bucle nativo; otras superficies de Stop no se simulan. La actualización y
desinstalación eliminan solo las entradas de hook propiedad de LWC, incluidas las entradas dentro de grupos
compartidos, mientras preservan la configuración de elementos hermanos y de usuario.
Las capacidades de grafo siguen siendo conscientes del consentimiento: las relaciones de documentos requieren el grafo físico, las tareas de estructura de código requieren CodeGraph, y ninguna se habilita simplemente porque su runtime exista. La lectura de Office sigue el mismo límite de consentimiento explícito.
Inicio rápido
Los humanos normalmente describen el objetivo y revisan el resultado; el agente opera la CLI. El recorrido completo se encuentra en la página Wiki de inicio rápido.
1. Inicializa una Wiki de proyecto
El agente crea una Wiki local del proyecto y define su propósito y reglas de mantenimiento. El estado del proyecto se excluye localmente de Git a menos que versionarlo fuera una elección explícita.
2. Agrega material de origen
Los archivos seleccionados se convierten en instantáneas inmutables y deduplicadas. LWC rastrea sus rutas en vivo y puede informar si el archivo actual no ha cambiado, está modificado, falta o ha sido reemplazado.
3. Analiza e integra una fuente
El agente lee la fuente limitada completa, escribe un resumen de fuente citado, actualiza el conocimiento compartido y completa la ingesta solo después de que ambas capas sean consistentes.
4. Consulta la Wiki acumulada
La búsqueda es primero por página y está basada en fuentes. Los agentes recuperan respuestas mantenidas primero, luego abren la evidencia de fuente exacta cuando una afirmación necesita verificación.
Flujo de trabajo del agente
El bucle normal es corto:
- Recupera el conocimiento mantenido relevante.
- Inspecciona las fuentes o el código actuales cuando la frescura importa.
- Realiza la actualización verificada más pequeña.
- Valida la recuperación, los enlaces y las proyecciones de grafo aplicables.
Las revisiones amplias utilizan un conjunto de cambios atómico. Consulta el flujo de trabajo completo del Agente para conocer los límites de confianza, las condiciones previas, la recuperación y la evidencia de finalización.
Memoria Temporal
La memoria temporal registra eventos compactos sobre qué cambió, por qué se tomó una decisión, qué se intentó, el resultado y qué queda sin resolver. Complementa la Wiki: el recuerdo temporal explica la historia; la Wiki representa el conocimiento estable actual.
La retención está limitada y protege los registros fijados, no resueltos y de contradicción abierta. Los eventos se normalizan en lugar de almacenarse como transcripciones de chat sin procesar, y los eventos similares nunca se fusionan en silencio.
Sincronización Multi-máquina
La sincronización reconcilia la memoria del proyecto, la memoria global o ambas a través de SSH, manteniendo el estado semántico de la Wiki separado de la publicación de Git. La fusión conserva los objetos únicos de ambos lados; los conflictos se devuelven como paquetes limitados para su resolución explícita.
Las sesiones son duraderas y reanudables. LWC nunca copia la base de datos SQLite en vivo, ni los archivos WAL o SHM, nunca restablece el árbol de trabajo y mantiene la publicación canónica separada de las proyecciones de búsqueda y grafo reconstruibles.
Flujo de trabajo de sincronización y contrato de seguridad →
Cambios Atómicos Multi-comando
Los conjuntos de cambios mantienen una actualización de conocimiento de varios pasos invisible hasta que se revisa y valida. El commit publica solo las entidades canónicas tocadas en una transacción; el trabajo en vivo no relacionado sobrevive, y los conflictos de revisión de la misma entidad fallan de forma segura.
Un commit exitoso registra un parche inverso exacto para las operaciones compatibles, lo que permite una reversión protegida sin reemplazar toda la Wiki.
Las lecturas de borrador ven las escrituras en etapas, mientras que SQLite y
Markdown en vivo permanecen sin cambios. La base de datos de borrador comienza
como una superposición dispersa pequeña; no copia ni hace checkpoint de la Wiki
en vivo. changeset show informa operaciones en etapas, revisiones y preparación
sin ejecutar lint. El commit valida y aplica solo las entidades tocadas, por lo
que las escrituras en vivo no relacionadas sobreviven; un conflicto de revisión
de la misma entidad falla sin sobrescribir ninguno de los lados. El commit
rechaza borradores vacíos y errores de lint bloqueantes; las advertencias e
información siguen siendo guía de revisión y no bloquean la publicación. No hay
fusión forzada ni automática. Usa --allow-lint-issues --reason "reviewed pre-existing debt" solo para deuda auditada
que el conjunto de cambios no introdujo. Después del commit, vuelve a ejecutar
las mismas comprobaciones de recuperación fijas contra el estado en vivo. El
commit congela el borrador revisado antes de la publicación; changeset_frozen
bloquea cualquier escritura en etapas posterior. Reintenta el mismo commit para
la recuperación, o descarta después de un conflicto informado—nunca agregues más
trabajo a un borrador congelado.
lwc --scope project changeset discard architecture-refresh
lwc --scope project changeset rollback <CHANGESET_ID>
El descarte toca solo un borrador no confirmado. El commit escribe un parche
inverso con suma de verificación que contiene solo las entidades tocadas y
devuelve el ID de reversión exacto; la reversión restaura solo esas entidades y
se niega si una cambió de nuevo. Los conjuntos de cambios de proyecto y global
son separados, --scope all es inválido, y init,
maintenance, checkpoint y los comandos de conjuntos de cambios
anidados rechazan --changeset. Los borradores nunca crean una segunda
proyección de Markdown. Si un error estructurado informa committed=true con
trabajo de limpieza o materialización pendiente, no repitas los cambios de
conocimiento; ejecuta la acción de recuperación devuelta.
El commit disperso actualmente tiene parches exactos para agregar/ingerir
Source, poner/quitar Page, esquema, propósito y operaciones de búsqueda
registradas. Las mutaciones de peso de recuperación y de relación semántica
explícita fallan antes del checkpoint o de tomar un bloqueo de escritura en vivo
con changeset_sparse_unsupported; aplícalas como transacciones directas de una sola entidad
hasta que sus parches inversos dispersos estén disponibles.
Guía de conjuntos de cambios →
Ámbitos
| Ámbito | Uso |
|---|---|
| project | Conocimiento propiedad de la Wiki del proyecto más cercano |
| global | Conocimiento reutilizable compartido entre proyectos |
| all | Recuerdo combinado de solo lectura y Sincronización coordinada |
Las escrituras siempre apuntan a un almacén explícito. LWC nunca crea citas o enlaces implícitos entre proyectos.
Ámbitos y descubrimiento de proyectos →
Búsqueda y CJK
La búsqueda es léxica, determinista y primero por página. Mantiene título, ruta, resumen, cuerpo, procedencia y evidencia de grafo distintos; admite filtros de página/fuente/tipo; y puede explicar la aritmética exacta de la puntuación.
El texto CJK usa bigramas adyacentes más unigramas útiles, mientras que el texto latino usa términos alfanuméricos en minúsculas. Este diseño sin diccionario sigue siendo estable para nombres de productos, símbolos de código, texto en idiomas mixtos y vocabulario emergente.
Pesos de recuperación explícitos y retroalimentación
Los pesos de documento auditables capturan importancia duradera. La retroalimentación específica de consulta reordena solo los candidatos coincidentes y almacena una huella digital en lugar de la consulta sin procesar. Ningún mecanismo puede hacer que aparezca contenido no relacionado.
Visor de Solo Lectura y CodeGraph
lwc view inicia un inspector de proyecto en primer plano, solo de
loopback y abre el navegador. Sirve una aplicación incrustada de TS + Lit—sin
CDN y sin runtime de Node en el momento de uso—y expone solo APIs GET/HEAD. Las
páginas, fuentes, Markdown, el grafo de conocimiento y el grafo de código
opcional se leen del proyecto actual sin migración, actualización o construcción
de grafo:
lwc view
lwc view --port 4173 --no-open
El detalle de página usa el título canónico, resumen, tipo, procedencia, citas y marcas de tiempo. El visor suprime solo un H1 de cuerpo inicial que coincida con el título canónico y deriva una tabla de contenidos local de tres o más encabezados H2-H4. Estas reglas de presentación nunca reescriben contenido canónico o Markdown proyectado.
El visor se inicia en inglés. Usa el control 中文 / EN para
cambiar de idioma; el navegador recuerda la selección mientras el contenido de la
Wiki permanece en su idioma de autoría. Los grafos usan una vista de relación 3D
única inspirada en Obsidian con nodos pequeños, etiquetas persistentes, enlaces
delgados, rotación y zoom.
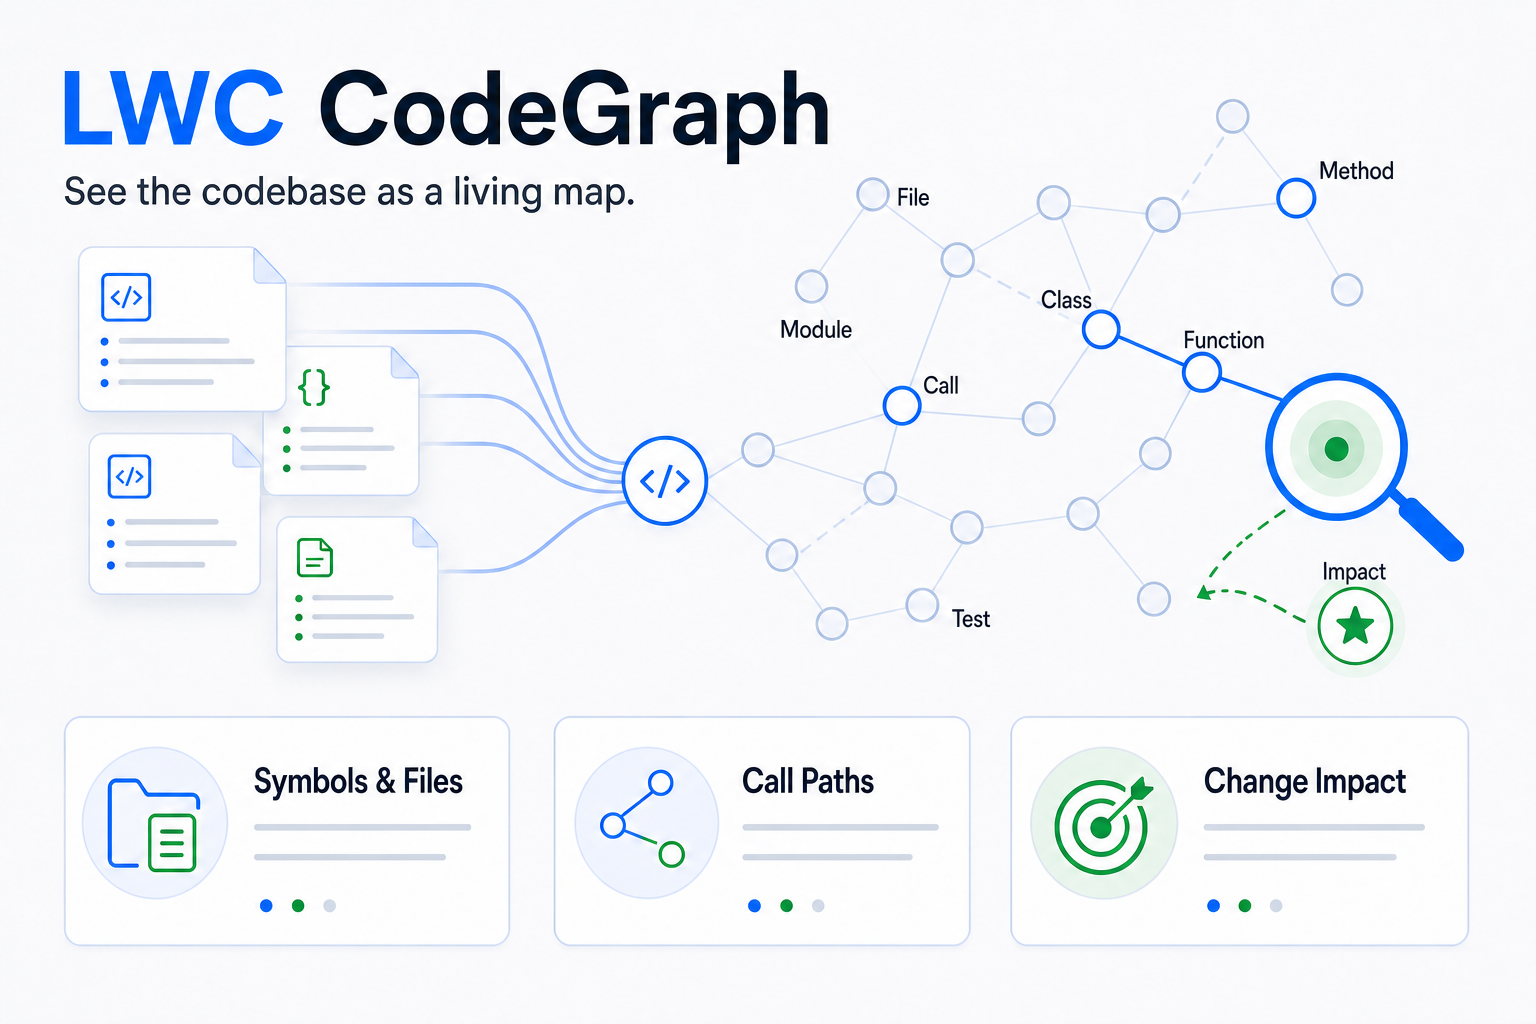
CodeGraph es solo de proyecto y se inicializa explícitamente. Responde preguntas sobre símbolos, llamadores, llamados, dependencias, archivos e impacto, mientras mantiene la telemetría deshabilitada y las escrituras de grafo atómicas por archivo propietario.
El runtime fijado reconoce TypeScript, TSX, JavaScript, JSX, ArkTS, Python, Go, Rust, Java, C, C++, C#, Razor, PHP, Ruby, Swift, Kotlin, Dart, Svelte, Vue, Astro, Liquid, Pascal, Scala, Lua, Luau, Objective-C, R, Solidity, Nix, YAML, Twig, XML, .properties, CFML, CFScript, CFQuery, COBOL, VB.NET, Erlang y Terraform.
Guía del visor → · Guía de CodeGraph →
Mantenimiento y Proyección
Lint, reindexación, materialización de Markdown, compactación, checkpoints y proyección de grafo son operaciones explícitas. El trabajo de larga duración es duradero, observable, reanudable y se aplica en unidades de documento limitadas.
SQLite sigue siendo canónico durante todo el proceso. Los índices de búsqueda, Markdown y almacenes de grafo se pueden reconstruir sin reescribir el historial de fuentes o el conocimiento actual de la Wiki.
lwc lint mantiene total y counts como campos de
compatibilidad para todos los problemas y agrega blocking_total para errores
más advisory_total para advertencias e información. La guía determinista de
Markdown actualmente informa H1 de cuerpo conflictivos o duplicados, el primer
salto de nivel de encabezado y una región de prosa larga sin secciones; solo los
errores de integridad bloquean el commit del conjunto de cambios.
Notas:
- Los comandos de mantenimiento devuelven un
workduradero de inmediato. Lee el progreso conwork status, o usawork watche inspeccionawork.resultdespués del éxito. La migración de esquema v10 a v11 usa el mismo mecanismo automáticamente, por lo que los comandos normales nunca realizan esa migración en línea. lintes de solo lectura por defecto. Agrega--recordsolo cuando la pasada de lint pertenezca al historial de operaciones duraderas.maintenance reindexreconstruye los artefactos de búsqueda derivados de SQLite.maintenance materializereconstruye el árbol de Markdown proyectado desde SQLite.maintenance compactsolo intenta un checkpoint de truncamiento WAL; no oculta una optimización FTS completa. Ejecútalo mientras la Wiki esté inactiva e inspeccionabusymásafter_bytes. Un lector ocupado regresa rápidamente sin cambiar el contenido canónico.- Las consultas de búsqueda son privadas por defecto; agrega
--recordsolo cuando quieras que la redacción de la consulta se almacene en el registro de operaciones duraderas.
lwc checkpoint create <NAME> usa la API de copia de seguridad en línea de SQLite. Restaura con
lwc checkpoint restore <NAME>; LWC primero crea un checkpoint de seguridad pre-restore-* y
luego reconstruye la proyección. Usa source remove <ID> y page remove <SLUG> para la
eliminación protegida: se rechazan las fuentes con citas y las páginas con
enlaces entrantes. Eliminar la fuente actual de una ruta rastreada detiene el
seguimiento de esa ruta en lugar de exponer silenciosamente una revisión más
antigua como actual.
Para una ingesta de múltiples fuentes o un reemplazo amplio de páginas, prefiere
un conjunto de cambios sobre un checkpoint manual: un commit exitoso escribe un
parche inverso disperso, publica solo las entidades canónicas tocadas en una
transacción y materializa incrementalmente el Markdown cambiado. El commit
intenta un truncamiento WAL después de la publicación; wal_checkpointed=false significa
que un lector activo lo impidió y no significa que el commit canónico fallara.
Para una copia de seguridad del sistema de archivos externo, detén los comandos
lwc activos y copia el directorio .lwc/ completo. No
copies solo wiki.db mientras un escritor pueda estar usando sus archivos
WAL.
Suite de Benchmarks
El benchmark opcional mide el tiempo de importación, la latencia de búsqueda, Recall@5/10, MRR y almacenamiento en un corpus sanitizado proporcionado por el llamador. Las comparaciones justas fijan la máquina, el corpus, el conjunto de consultas y las condiciones de ejecución, y luego comparan las medianas de ejecuciones repetidas.
Resultados de recuperación LongMemEval-S (v0.18.5)
Esta es una línea base de recuperación sin ajustar, no un techo sobre la efectividad de LWC con el uso continuo. En flujos de trabajo reales, el modelo puede evaluar proactivamente la evidencia y reaccionar a las correcciones del usuario o a la retroalimentación de relevancia, actualizando continuamente los pesos de documentos y la retroalimentación de consultas. Con retroalimentación confiable y ajuste sostenido, se espera que la recuperación mejore más allá de esta línea base estática; esa ganancia adicional no se cuantificó aquí. El ajuste reactivo significa actualizaciones del Agente desencadenadas por retroalimentación, no aprendizaje automático en segundo plano en cada consulta.
El 13 de septiembre de 2026, dos ejecuciones locales completas procesaron 500/500 preguntas, con 470 preguntas con puntuación de recuperación, usando el conjunto de datos fijado LongMemEval-S y cuatro trabajadores concurrentes en una Mac Apple M5 Pro. La segunda ejecución reutilizó las fuentes almacenadas de la primera; las 500 listas de resultados clasificados fueron idénticas.
| Métrica | Primera ejecución | Segunda ejecución |
|---|---|---|
| Preguntas procesadas | 500 / 500 | 500 / 500 |
| Preguntas con puntuación de recuperación | 470 | 470 |
| Preguntas de abstención excluidas | 30 | 30 |
| Recall@1 | 83.83% (394/470) | 83.83% (394/470) |
| Recall@3 | 91.49% (430/470) | 91.49% (430/470) |
| Recall@5 | 95.11% (447/470) | 95.11% (447/470) |
| Recall@10 | 97.66% (459/470) | 97.66% (459/470) |
| Recall@30 | 99.15% (466/470) | 99.15% (466/470) |
| Recall@50 | 99.15% (466/470) | 99.15% (466/470) |
| MRR | 0.883668 | 0.883668 |
| Latencia media | 509.883 ms | 679.759 ms |
| P50 | 507.697 ms | 665.454 ms |
| P90 | 663.061 ms | 931.238 ms |
| P95 | 731.766 ms | 990.375 ms |
| P99 | 888.555 ms | 1094.886 ms |
Estos resultados excluyen el ajuste proactivo. El adaptador recupera fuentes de sesión sin procesar sin curación de conocimiento dirigida por el modelo, retroalimentación de relevancia ni actualizaciones de pesos. En flujos de trabajo reales de Agent, un modelo puede evaluar evidencia de manera proactiva, curar conocimiento y ajustar explícitamente pesos de documentos o retroalimentación específica de consultas para mejorar la recuperación posterior. Este es un flujo de trabajo de Agent impulsado por evidencia, no cambios automáticos de pesos en cada búsqueda; las ganancias dependen de la calidad de la retroalimentación y no se midieron aquí. Evalúe el ajuste en preguntas reservadas en lugar de alimentar las respuestas de prueba de vuelta a la misma evaluación.
Estos son resultados de recuperación local, no puntuaciones oficiales de tablas de clasificación ni precisión de respuestas. Las latencias describen carga de cuatro trabajadores, no una comparación controlada de aceleración de versiones. Datos del primer ejecución · Datos del segundo ejecución · Reproducción y puntuación.
Todo duradero y Plan actual
Todo almacena trabajo diferido; Plan almacena el objetivo en ejecución actual, pasos ordenados, progreso y revisión. Son capacidades independientes y opcionales que nunca se convierten entre sí automáticamente.
El contexto de ciclo de vida acotado aísla el progreso de Plan y Todo por sesión de Agent y, donde el host lo expone, por subagente. Cada Agent ve solo el trabajo explícitamente rastreado para su contexto opaco; los comandos detallados y los límites de capacidades del host se encuentran en la guía de flujo de trabajo.
Flujo de trabajo de Todo y Plan →
Límites y no objetivos
Restricciones de diseño actuales:
- base de conocimiento de una sola máquina y un solo usuario;
- flujo de trabajo de texto UTF-8;
- tamaño de entrada acotado de 64 MiB por esquema, propósito, fuente o cuerpo de página;
- búsqueda léxica, no recuperación vectorial semántica.
No objetivos deliberados para este CLI:
- sin llamadas LLM integradas;
- sin base de datos vectorial;
- sin demonio ni servicio en segundo plano;
- sin interfaz web ni de escritorio;
- sin contrato de edición directa de base de datos.
Si el Markdown proyectado se desvía, reconsérvelo. Si el esquema SQLite es incorrecto, corríjalo a través del CLI y migraciones, no manualmente.
Contribuciones
Se aceptan problemas y solicitudes de extracción, especialmente en torno a:
- ergonomía de flujos de trabajo de Agent;
- comportamiento de proyección determinista;
- contratos de mantenimiento de citas y páginas duraderas;
- calidad de búsqueda para corpus técnicos multilingües.
Lea CONTRIBUTING.md antes de abrir una solicitud de extracción. Reporte problemas de seguridad según SECURITY.md.
Licencia
Licenciado bajo la Apache License 2.0.
Nuevo en 0.18.0
Los registros de Discusión duradera preservan preguntas y respuestas de aclaración visibles en SQLite con correcciones granulares y resúmenes vinculados a evidencia. CodeGraph admite paso de resultados nativo, y los contratos de Agent y la salida de recuperación son más fáciles de descubrir. Codex además admite un paquete de plugin nativo; otras rutas de instalación de host permanecen sin cambios. Consulte Discusión y Plugin de Codex.