token-save-mcp
Mantiene los archivos grandes fuera del contexto de tu agente de codificación. Delega las lecturas grandes a un modelo de trabajo económico de tu elección y devuelve solo la respuesta, además de un hook que bloquea lecturas de tamaño excesivo, de modo que el ahorro no depende de que el agente lo recuerde. Se midió un ahorro del 72-99%, según los propios datos de uso del proveedor.
Documentación
token-save-mcp
Tu agente de codificación consume su contexto leyendo archivos. Esto lo detiene — y te muestra el recibo.


Lee un archivo de 4,000 líneas y ~35,000 tokens se quedan en el contexto de tu agente durante el resto de la sesión. Lee unos cuantos más y se compacta, olvida tus instrucciones, y cada turno posterior cuesta más — porque cada uno paga por todo el contexto acumulado de nuevo.
Este servidor MCP envía esos archivos a un modelo de trabajo barato y devuelve solo la respuesta. Los bytes se pagan una vez, en el contexto del trabajador, no permanentemente en el tuyo.
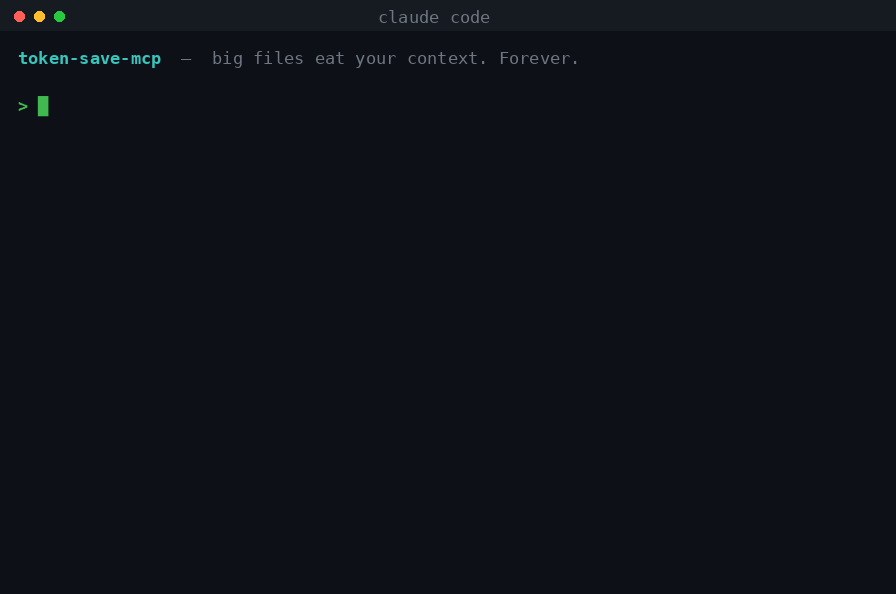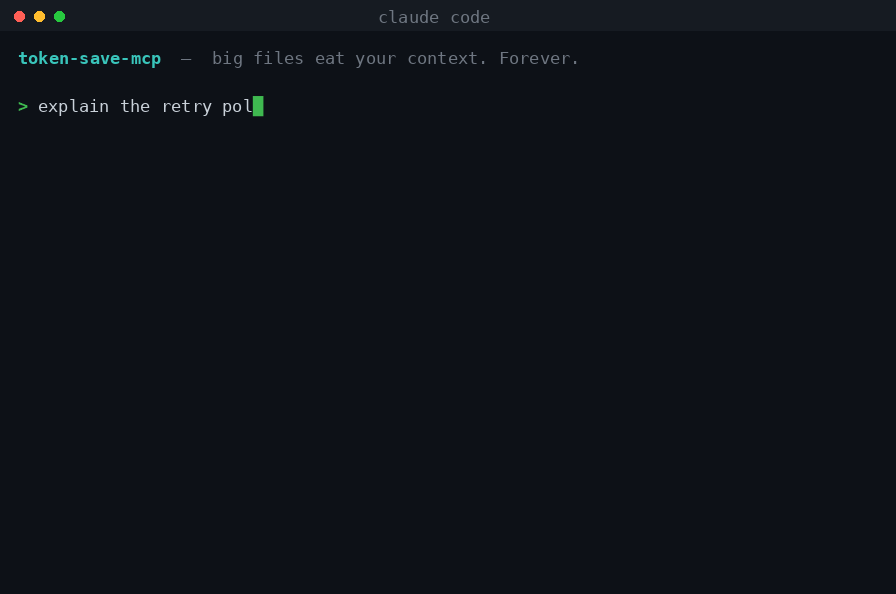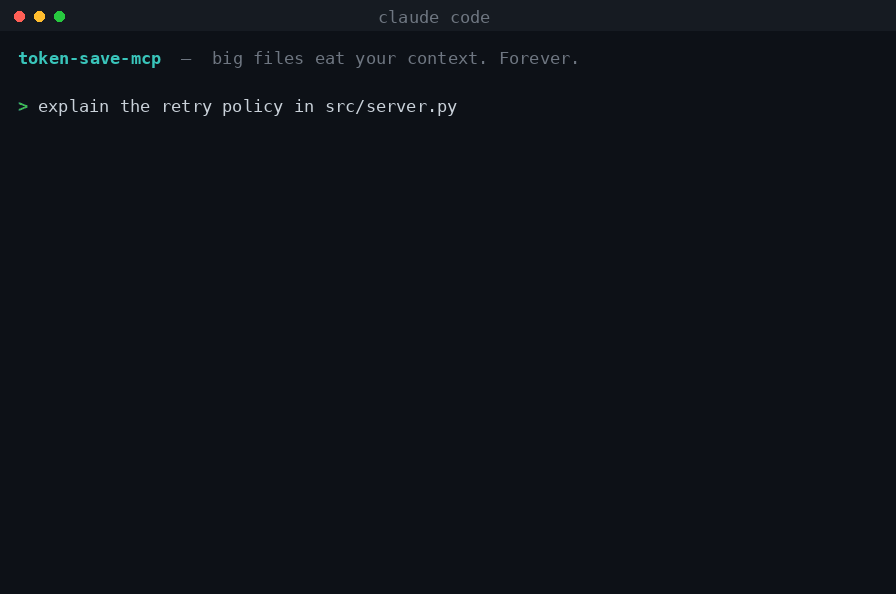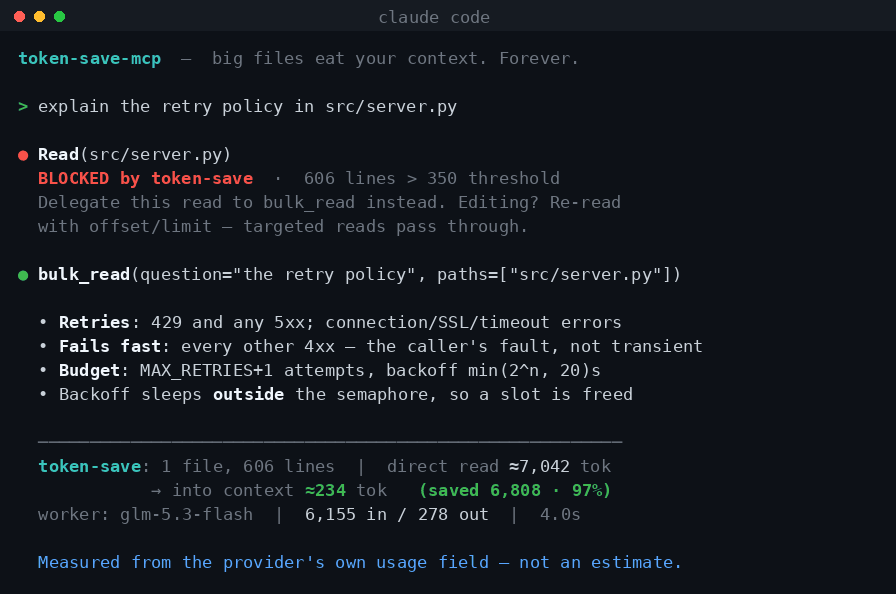
El hook bloquea la lectura costosa y la redirige. La respuesta vuelve con el uso real de tokens del trabajador desde la respuesta de la API — no una estimación, un recibo:
─────────────────────────────────────────────────────────────
token-save: 1 file, 606 lines | direct read ≈7,042 tok →
into context ≈234 tok (saved 6,808 · 97%)
worker: glm-5.3-flash | 6,155 in / 278 out | 4.0s
(glm-5.3-flash es solo el trabajador configurado en esa ejecución — tú eliges el tuyo.)
Instalación
Dos comandos, más una clave de API propia.
pip install token-save-mcp
token-save-mcp init --hook
init encuentra una clave de proveedor que ya tengas, registra el servidor MCP con
tu agente, e instala el hook. Si aún no tienes clave, imprime las
opciones y dónde conseguir una.
Un paquete, un comando. No hay un segundo servidor MCP que añadir ni una herramienta de línea de comandos externa que instalar — el hook es Python puro y viene en el wheel.
Sí necesitas una cosa propia: una clave de API de un proveedor de tu elección (o un modelo local, que requiere Ollama instalado). El trabajador es tuyo — tu clave, tu proveedor, tu factura.
¿Qué pasa si no tengo clave de API?
init te mostrará esto:
  This tool sends files to a worker model of YOUR choosing.
  Nothing is connected automatically and no key ships with it.

  openrouter  one key, hundreds of models     export OPENROUTER_API_KEY=...
  deepseek    cheap and strong on code        export DEEPSEEK_API_KEY=...
  groq        fastest responses               export GROQ_API_KEY=...
  ollama      Ollama Cloud subscription       export OLLAMA_API_KEY=...
  local       your own machine — no key       nothing to set
Elige una, exporta la clave, ejecuta init de nuevo. La clave se lee de tu
entorno y se guarda en la configuración MCP de tu agente — nunca la pegas en un
archivo tú mismo.
¿Sin clave en absoluto? --provider local se ejecuta contra un modelo en tu propia máquina
(Ollama en localhost:11434). Nada sale del ordenador.
¿Inicio de sesión por navegador en lugar de clave? No compatible. Herramientas como Kimi Code y GitHub Copilot se autentican a través de un navegador y no exponen un endpoint compatible con OpenAI, por lo que no pueden usarse como trabajador. Cada proveedor listado arriba usa una clave de API simple.
¿Usas un proveedor que no está en la lista, o quieres un modelo específico? Consulta Elegir el modelo de trabajo abajo — no hay un listado fijo.
Verifica en cualquier momento con token-save-mcp doctor — comprueba la configuración y
hace una llamada en vivo para demostrar que el trabajador responde:
✓ provider: openrouter -> https://openrouter.ai/api/v1
✓ worker model: deepseek/deepseek-chat
✓ hook script present (no external tools required)
✓ MCP server registered and connected
✓ worker replied in 1.8s (21 in / 13 out)
Requisitos
- Python 3.10+
- Un agente que hable MCP — Claude Code para la experiencia completa, ya que el hook de cumplimiento es un mecanismo de Claude Code. Cursor, Cline, Windsurf y Codex obtienen las herramientas, y las llamas tú mismo.
- Una clave de API de cualquier proveedor compatible con OpenAI — o un modelo local, que no necesita ninguna
Todo lo demás viene con el paquete.
Elegir el modelo de trabajo
No hay una lista fija. Cualquier id de modelo que sirva tu proveedor funciona — nada está codificado, porque un listado fijo se vuelve obsoleto el día que un proveedor lanza algo nuevo.
# switch provider (and get its default model)
token-save-mcp init --provider deepseek

# pick a specific model
token-save-mcp init --provider openrouter --model anthropic/claude-3.5-haiku

# per call, when one question deserves a stronger model
bulk_read(question="...", paths=[...], model="openai/gpt-4o")
Cualquier endpoint compatible con OpenAI — incluidos los que no tienen ajuste preestablecido:
export TOKENSAVE_BASE_URL=https://api.openai.com/v1
export TOKENSAVE_API_KEY=sk-...
export TOKENSAVE_MODEL=gpt-4o-mini
token-save-mcp init --provider openrouter   # provider ignored once BASE_URL is set
--model y TOKENSAVE_MODEL hacen lo mismo y funcionan con cualquier proveedor o
endpoint; la bandera gana si ambas están configuradas. --provider solo elige la URL del ajuste preestablecido
y la variable de clave, así que una vez que TOKENSAVE_BASE_URL está configurado, ya no importa
cuál nombres.
Qué modelo elegir
El trabajador lee código y responde preguntas sobre él. Ese es un trabajo mecánico, así que el nivel económico suele ser el correcto — un modelo frontera aquí cuesta más y compra poco.
| Si quieres | Recurre a |
|---|---|
| Lo más barato que funcione | Un modelo pequeño/flash de cualquier proveedor |
| Velocidad por encima de todo | Groq, cuyo punto central es la latencia |
| Grandes corpus en una sola llamada | Un modelo con una gran ventana de contexto |
| Que nada salga de la máquina | --provider local |
token-save-mcp doctor demuestra que el que elijas realmente responde antes de que
confíes en él.
A dónde va tu código
Esto importa más que las matemáticas de tokens, así que va antes.
bulk_read envía el contenido de los archivos que nombres al proveedor que
configuraste. Así es como funciona — el trabajador tiene que ver el código para responder
sobre él. No se envía nada a ningún otro lugar: sin telemetría, sin análisis, sin
llamadas a casa. El registro de ahorros es un archivo local.
Qué significa eso en la práctica:
| Tu situación | Qué hacer |
|---|---|
| Código de código abierto o personal | Cualquier proveedor está bien |
| Código del empleador, sin política en contra | Revisa primero los términos de retención de datos del proveedor |
| Código propietario o regulado | Usa --provider local — el trabajador se ejecuta en tu máquina y nada sale de ella |
Para la opción local, instalas Ollama y descargas un pequeño
modelo de codificación; entonces token-save-mcp init --provider local no necesita clave en absoluto.
Es más lento que un modelo alojado, y en un portátil notablemente, pero el código
nunca cruza la red.
Si no estás seguro, empieza local. Puedes cambiar de proveedor con un comando más tarde.
Cuánto cuesta
El trabajador es mucho más barato que tu agente principal — ese es el punto central — pero no es gratis, y los números dependen de tu proveedor.
Una forma aproximada, para un archivo de 600 líneas:
- El trabajador lee ~6,000 tokens y escribe ~300. A las tarifas típicas de modelos baratos (menos de $1 por millón de tokens de entrada) eso es una fracción de centavo por llamada.
- La misma lectura en el contexto de un agente frontera cuesta quizás 10-50× más, y sigue costando, porque cada turno posterior lo paga de nuevo.
El segundo punto es el que importa. Una lectura de archivo en el turno 20 de una sesión de 200 turnos no se paga una vez — se queda en el contexto que cada turno restante vuelve a leer. Esa acumulación es lo que esto elimina.
token-save-mcp stats muestra lo que realmente has ahorrado, a partir de números de uso
reales en lugar de estimaciones.
La parte que nadie más hace: cumplimiento
Toda herramienta de ahorro de tokens tiene el mismo modo de fallo — el agente olvida usarla. Una herramienta que el modelo puede ignorar se ignora, y tus ahorros son lo que el modelo decidió ese día.
Solo Claude Code. El hook usa el mecanismo
PreToolUsede Claude Code. En Cursor, Cline, Windsurf o Codex, las herramientasbulk_readycode_writefuncionan normalmente — solo que las llamas tú mismo en lugar de ser redirigido.install-hooklo dice si no puede encontrar Claude Code.
init --hook lo instala durante la configuración; token-save-mcp install-hook lo añade
más tarde. De cualquier manera, registra un hook de PreToolUse que bloquea
Read en archivos por encima del umbral y redirige al agente a bulk_read:
Read("src/server.py")
→ BLOCKED: This file is 606 lines (threshold: 350).
  Use bulk_read to delegate this read instead.
  Need exact content to EDIT? Re-read with offset/limit — that passes through.
Lo que aún pasa, por diseño:
- Lecturas dirigidas (
offset/limit) — editar necesita texto exacto - Archivos pequeños — por debajo del umbral, delegar cuesta más de lo que ahorra
- Binarios y archivos faltantes — no hay nada que resumir
¿No estás listo para que te digan que no? Instálalo en modo de advertencia — la lectura pasa, pero ves lo que cuesta:
token-save-mcp install-hook --hook-mode warn
El cumplimiento es opt-in y reversible: token-save-mcp uninstall-hook.
Herramientas
bulk_read(question, paths, model?, effort?)
Lee archivos sin traerlos al contexto.
bulk_read(
  question="Which methods touch the database, and where is auth enforced?",
  paths=["src/service.py", "src/handlers.py"]
)
Úsalo para: explorar código desconocido, "qué hace esto", rastrear un flujo a través de archivos, encontrar dónde se maneja algo.
No lo uses para: editar (necesitas texto exacto — usa una lectura dirigida), depuración que requiere tu propio razonamiento sobre el código crudo, o archivos de menos de ~350 líneas donde la sobrecarga de delegación supera el ahorro. La herramienta te dice cuándo has cruzado esa línea en lugar de quemar una llamada en silencio.
code_write(spec, reference, target?, model?, effort?)
Genera código repetitivo que coincida con el estilo de un archivo existente. Con target, el código
se escribe directamente al disco y solo vuelve una confirmación — el código
generado nunca entra en tu contexto en absoluto.
code_write(
  spec="pytest suite for clamp(value, lo, hi), covering both bounds and lo>hi",
  reference=["tests/test_total.py"],
  target="tests/test_clamp.py"
)
→ Wrote tests/test_clamp.py (32 lines). Not read into your context.
Nunca sobrescribe: el destino se crea con O_EXCL, que también se niega a
seguir un enlace simbólico colgante.
¿Cómo revisas código que nunca viste? Lo ejecutas. Esto es para trabajo
generado con una verificación barata — una suite de pruebas que ejecutas, una configuración que validas, un
stub que compilas. Si la corrección de la salida depende de leerla
cuidadosamente, omite target y haz que te la devuelva en su lugar.
run_command(command, question?, cwd?, timeout?, model?, effort?)
Ejecuta un comando y obtén el veredicto, no la salida.
run_command(command="pytest -q")
→ The run failed (exit 1): 3 tests failed, 197 passed in 42.11s.

  FAILED tests/test_payment.py::test_refund_partial
  E   AssertionError: assert Decimal('12.50') == Decimal('12.55')
  tests/test_payment.py:142

  Full output (168 lines): ~/.token-save/logs/run-1789759198.log
  ─────────────────────────────────────────────────────────────
  token-save: 168 lines | direct ≈2,922 tok → into context ≈202 tok (93%)
Una suite que falla imprime cientos de líneas de ruido de configuración alrededor de las cuatro que importan. Esos cientos van al trabajador; el veredicto vuelve. La salida completa se escribe en un archivo, así que si el resumen omitió algo, puedes leer la parte que necesitas — nada se descarta.
Úsalo para: suites de pruebas, compilaciones, linters, verificadores de tipos, migraciones.
No lo uses para: salida que necesitas verbatim (git diff antes de una edición),
comandos interactivos, o cualquier cosa corta — por debajo de ~400 tokens se devuelve
completa en lugar de enviarse a un trabajador en absoluto.
El comando se ejecuta en un shell con tus permisos. Es tu comando: nada se filtra ni se pone en sandbox.
status()
La versión de herramienta MCP de doctor: tu agente puede llamarla a mitad de sesión para ver
la configuración y confirmar que el trabajador responde. Usa doctor desde la
terminal al configurar; usa status() cuando una llamada falle y el agente
deba averiguar por qué.
token-save-mcp stats
Cada llamada añade una línea a un registro local, para que puedas ver lo que la herramienta ha ahorrado realmente. Ejemplo de salida después de unas semanas de uso:
$ token-save-mcp stats --badge
token-save-mcp — all time
148 calls · 71,204 lines of code read by a worker
context saved: 812,455 tokens (94%)
worker time: 612s total
Markdown badge:
También marca los archivos que sigues delegando, y distingue los dos casos:
  Files delegated repeatedly

    4×  src/server.py
       26.8K worker tokens spent  3 with an identical question
    3×  src/cli.py
       13.5K worker tokens spent  all different questions

  The same question asked twice returns the same answer. Keep the
  first answer in your notes, or ask the follow-up in the same call.
La misma pregunta dos veces es desperdicio — la respuesta ya se pagó. Preguntas diferentes sobre un archivo son legítimas, pero si sigues volviendo, preguntar todo en una sola llamada cuesta menos que cinco.
El registro es un archivo JSONL simple en ~/.token-save/ y nunca sale de tu
máquina. Registra rutas de archivo y un hash de cada pregunta — suficiente para detectar
una repetición, sin poner tus prompts en el disco. --since 7 limita la ventana;
TOKENSAVE_NO_LEDGER=1 desactiva el registro por completo.
Ahorros medidos
Ejecuciones reales, no proyecciones. Cada número es el pie de página de una llamada real:
| Qué | Tamaño | Lectura directa | Vía token-save | Ahorrado |
|---|---|---|---|---|
| server.py de este proyecto | 606 líneas | ≈7,042 tok | ≈234 tok | 97% |
| Un handler TypeScript grande | 602 líneas | ≈13,340 tok | ≈689 tok | 95% |
| Servicio Python de producción | 443 líneas | ≈5,788 tok | ≈684 tok | 88% |
| 4 archivos en un codebase | 1,910 líneas | ≈28,379 tok | ≈304 tok | 99% |
| Generación de código al disco | 58 líneas escritas | — | 0 tok | 100% |
Método: "lectura directa" es el tamaño del archivo a ~3.6 caracteres/token (el código
fuente es más denso que la prosa); "vía token-save" es la respuesta devuelta medida de la
misma manera. Los números de entrada/salida del trabajador provienen del campo usage del proveedor.
Reproduce cualquier fila ejecutando la misma llamada — el pie de página se imprime en cada una.
Dónde es más débil, honestamente: en un diff de 281 líneas el ahorro fue del 67%, porque una entrada corta con una respuesta larga es el peor caso. La herramienta lo dice en su propia salida. Los ahorros son mejores donde el archivo es grande y la pregunta es estrecha.
Cómo se compara
Diferentes herramientas resuelven "demasiados tokens" de maneras genuinamente diferentes:
| Enfoque | ¿Cumplimiento? | Cifra de ahorro | |
|---|---|---|---|
| token-save-mcp | Trabajador LLM lee, devuelve una respuesta | Sí — el hook bloquea Read | Medido por llamada |
| Herramientas AST estáticas | Analizan el árbol, devuelven símbolos exactos | No | Determinista |
| Otros MCP de delegación | Trabajador LLM, proveedor único | No | Generalmente estimado |
Las herramientas AST estáticas son mejores que esta en "dame el cuerpo exacto de
handleRequest" — son gratis, instantáneas y no pueden alucinar. Recurre a ellas
para búsqueda de símbolos.
Esta herramienta es para preguntas semánticas sobre archivos grandes — "¿qué hace este
servicio", "dónde ocurre la autenticación", "cuál de estos archivos maneja reintentos" —
donde quieres una respuesta, no un extracto. Eso cuesta una llamada de worker y unos
segundos, y un worker puede equivocarse. Usa ambos.
Configuración
| Variable | Predeterminado | Propósito |
|---|---|---|
TOKENSAVE_PROVIDER | ollama* | Preajuste: ollama, openrouter, deepseek, groq, local |
TOKENSAVE_API_KEY | — | Anula la variable clave del preajuste |
TOKENSAVE_BASE_URL | preajuste | Cualquier endpoint compatible con OpenAI |
TOKENSAVE_MODEL | preajuste | ID del modelo worker |
TOKENSAVE_MIN_LINES | 350 | Umbral del hook y la advertencia de "demasiado pequeño" |
TOKENSAVE_HOOK_MODE | block | warn permite la lectura pero señala el costo |
TOKENSAVE_HOOK_MAX_BYTES | 100000 | También bloquea por tamaño — detecta archivos minificados |
TOKENSAVE_MAX_CORPUS_BYTES | 2000000 | Límite máximo para una solicitud |
TOKENSAVE_TIMEOUT | 600 | Segundos por llamada |
TOKENSAVE_MAX_RETRIES | 4 | Reintentos en fallos transitorios |
TOKENSAVE_MAX_CONCURRENCY | 3 | Coincide con el límite de tu proveedor |
TOKENSAVE_LEDGER | ~/.token-save/ledger.jsonl | De dónde lee stats |
TOKENSAVE_NO_LEDGER | sin definir | Configúralo para deshabilitar el registro local |
* El valor predeterminado solo importa si configuras las variables tú mismo. init escribe
el proveedor que elijas en la configuración de MCP, por lo que nunca se aplica a una
configuración normal. Elimina el registro en cualquier momento con rm ~/.token-save/ledger.jsonl.
Cuándo no usar esto
Ser claro sobre esto es el punto, no un descargo de responsabilidad:
- Necesitas texto exacto para editar. Usa una lectura dirigida. El hook permite que esas pasen.
- De todos modos volverías a leer el archivo. Si no puedes actuar sobre la respuesta sin verificarla contra la fuente, has pagado por ambas. El ahorro es real solo cuando la respuesta es suficiente — lo cual es la mayoría de las preguntas de sondeo y casi ninguna depuración.
- Estás depurando un comportamiento sutil. Los resúmenes pierden el detalle que importa.
- El archivo es pequeño. Por debajo de ~350 líneas, leer directamente es más barato y rápido.
- El worker puede equivocarse. Es un LLM. Para cualquier cosa en la que actuarás a ciegas, verifica contra la fuente. Las herramientas estáticas no tienen este modo de fallo.
Desarrollo
git clone https://github.com/Habartru/token_save_mcp
cd token_save_mcp
pip install -e ".[dev]"

python tests/test_server.py    # 118 server tests — no API calls
python tests/test_cli.py       # 34 CLI tests
bash tests/test_hook.sh        # 21 hook routing tests
El conjunto de pruebas simula el transporte, por lo que no cuesta nada ejecutarlo y es seguro en CI. Cubre el bucle de reintentos, el ensamblaje del corpus, la eliminación de cercas, las protecciones de escritura en disco y cada decisión de enrutamiento del hook.
Créditos
El patrón de delegación más hook está adaptado del plugin shunt en
spotify/portal-ai-plugins
(Apache-2.0), que enruta el mismo tipo de trabajo a través del Portal CLI interno de Spotify.
Este proyecto mantiene la idea y cambia el transporte por cualquier
proveedor compatible con OpenAI, por lo que no se requiere una instancia corporativa de Portal. Los archivos
también viajan en proceso en lugar de a través de argv, lo que elimina el límite de 128 KiB
por argumento en Linux.
Licencia MIT.