agent-eval
Pruebas de regresión estadística para agentes LLM: valor p, tamaño del efecto e IC sobre el cambio de comportamiento.
Documentación

Evaluación de Agentes


Pruebas de regresión estadística para agentes LLM: ejecuta la versión A y la versión B 50 veces cada una y obtén un valor p, un tamaño del efecto y un intervalo de confianza del 95% sobre si el comportamiento realmente cambió.
pip install agent-regress-cli
(uv add y el wrapper npm/npx se cubren en Instalación más abajo.)
La prueba que todos los frameworks de evaluación omiten
Cambiaste un prompt. Tus evaluaciones siguen pasando. Pero la precisión de las herramientas de tu agente cayó del 84% al 70%.
¿Es una regresión real? ¿O es ruido de ejecución a ejecución del LLM?
Las pruebas de umbral no pueden responder esa pregunta. agent-eval sí puede.
Ejecuta tu agente 50 veces en la versión A, 50 veces en la versión B. Obtén un valor p, un tamaño del efecto y un intervalo de confianza del 95% sobre si el comportamiento realmente cambió.
p=0.003, Cohen's d=-0.61 -> REGRESSED (deploy blocked)
p=0.410, Cohen's d=0.021 -> STABLE (safe to ship)
[!NOTE] Promptfoo, uno de los frameworks de evaluación LLM de código abierto más utilizados, fue adquirido por OpenAI en marzo de 2026, permaneciendo como código abierto pero integrando su equipo en la plataforma Frontier de OpenAI. agent-eval tiene licencia Apache 2.0, es autoalojable y no tiene dependencia comercial. El núcleo estadístico (Mann-Whitney U, CI bootstrap, d de Cohen) nunca estará detrás de un muro de pago.
Instalación
pip install agent-regress-cli
# or
uv add agent-regress-cli
# or, from Node/npx (thin wrapper around the same Python CLI)
npx agent-regress-cli
Inicio rápido
En 30 segundos (CLI)
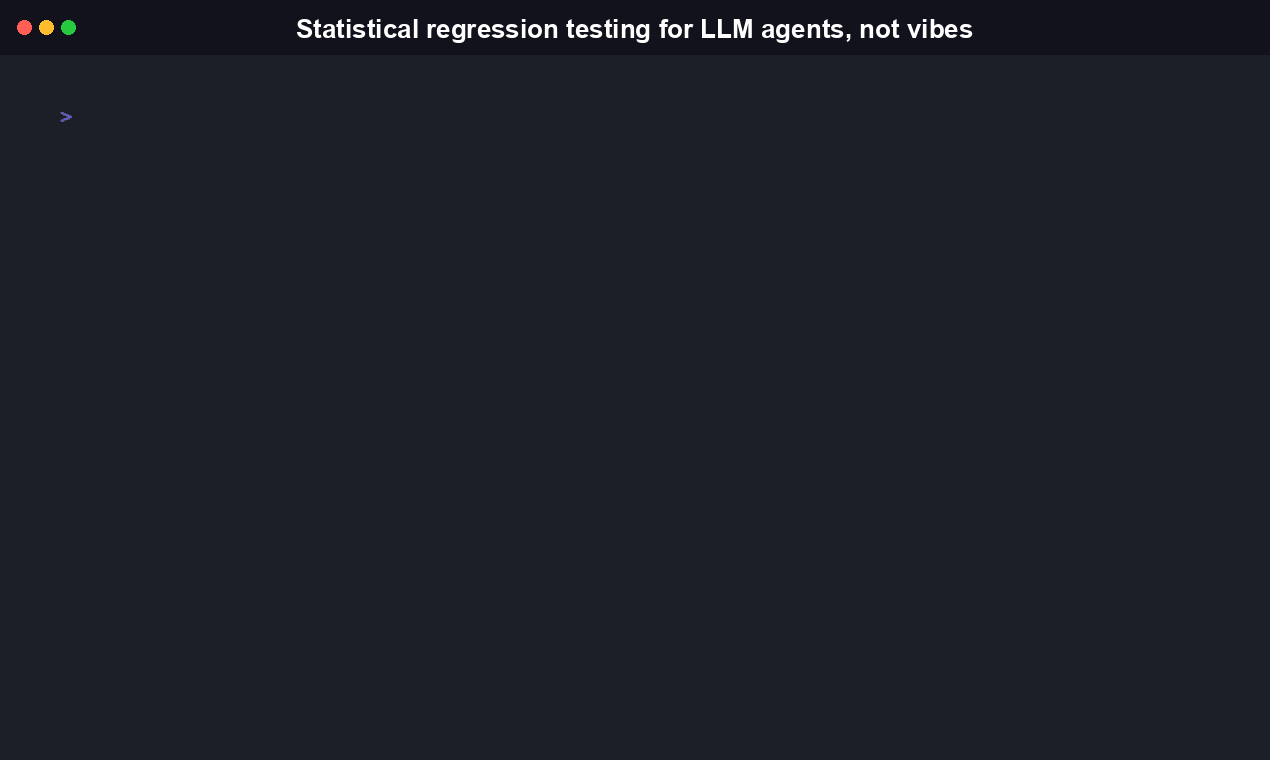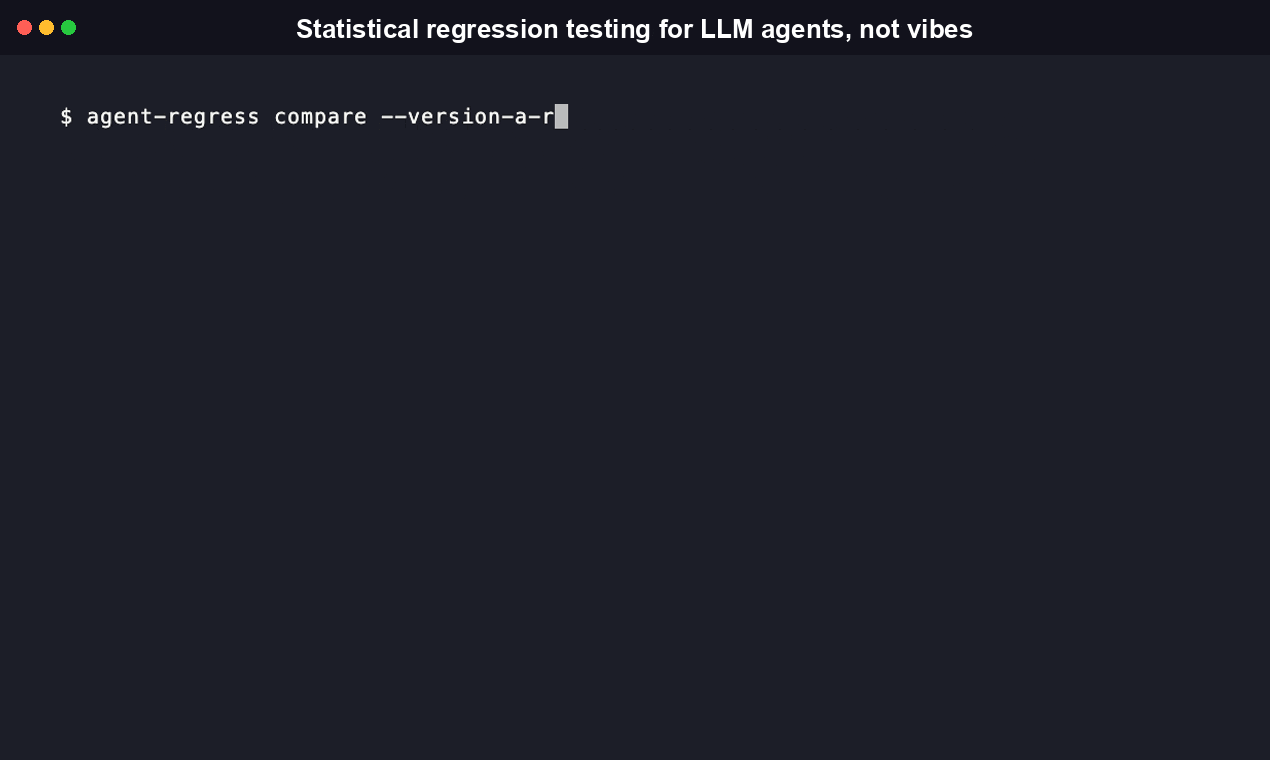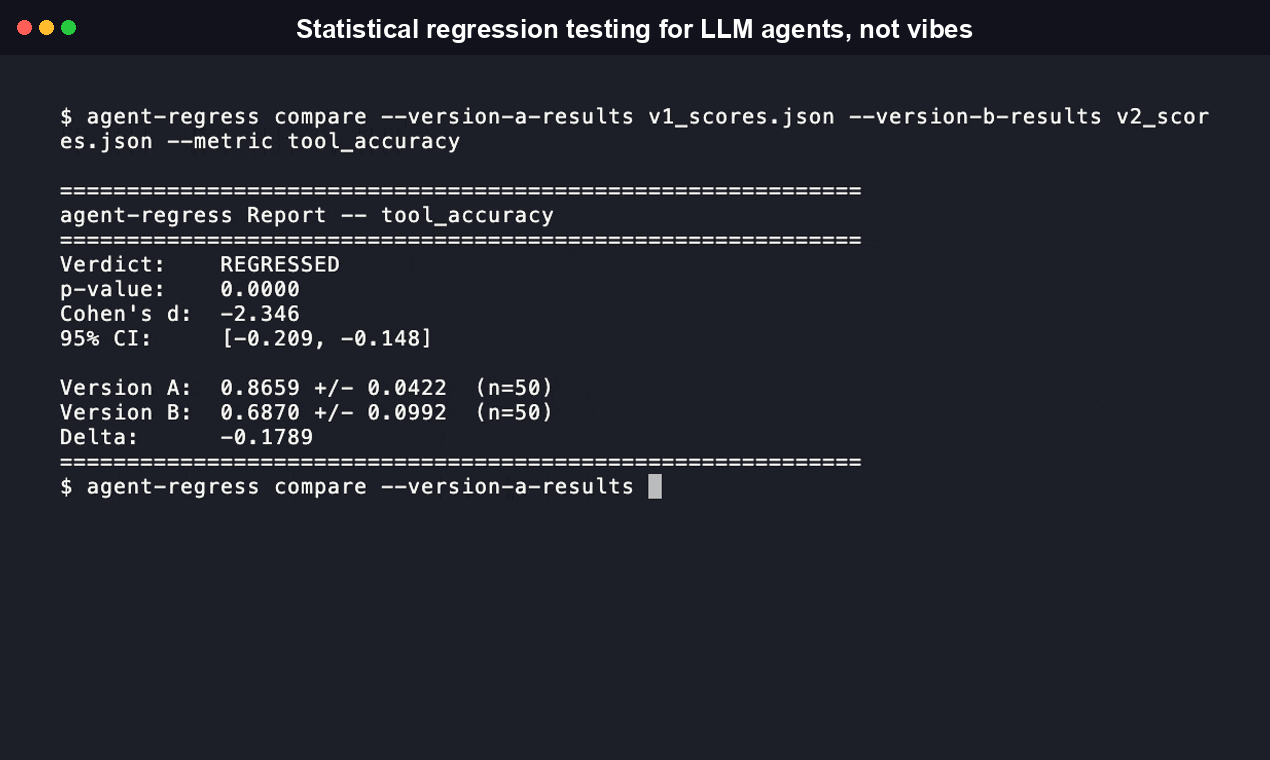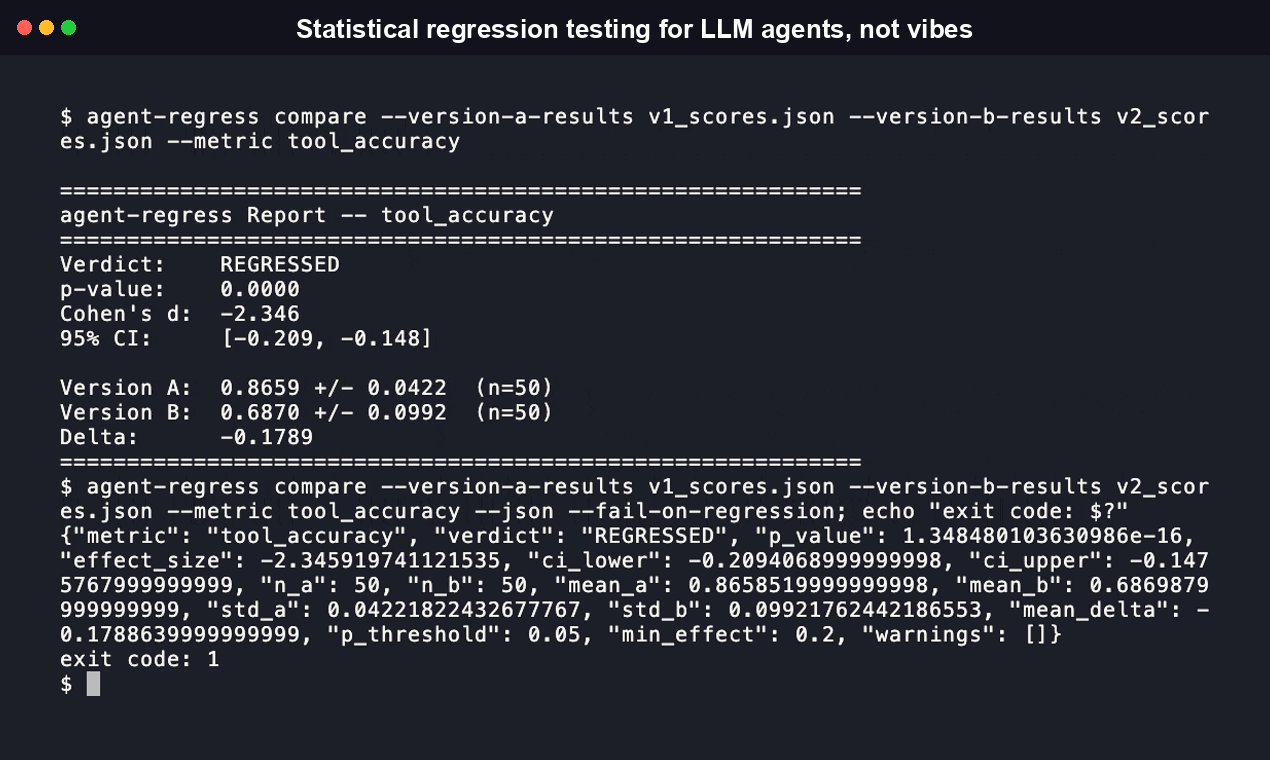
¿Ya tienes puntuaciones por ejecución de tu propio harness? Apunta la CLI a dos arrays JSON de puntuaciones, uno por versión:
pip install agent-regress-cli

agent-regress compare \
  --version-a-results v1_scores.json \
  --version-b-results v2_scores.json \
  --metric tool_accuracy

# ============================================================
# agent-regress Report -- tool_accuracy
# ============================================================
# Verdict:    REGRESSED
# p-value:    0.0000
# Cohen's d:  -2.193
# 95% CI:     [-0.213, -0.148]
#
# Version A:  0.8470 +/- 0.0525  (n=50)
# Version B:  0.6685 +/- 0.1025  (n=50)
# Delta:      -0.1786
# ============================================================
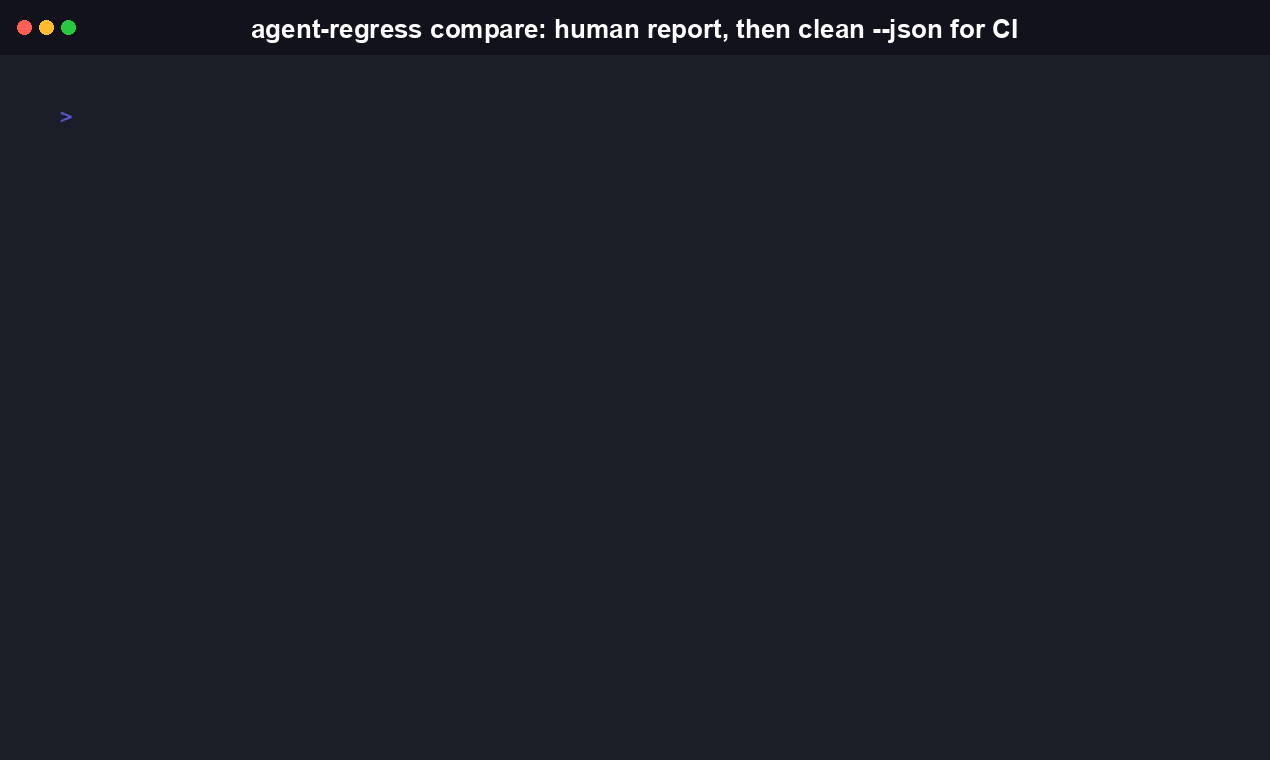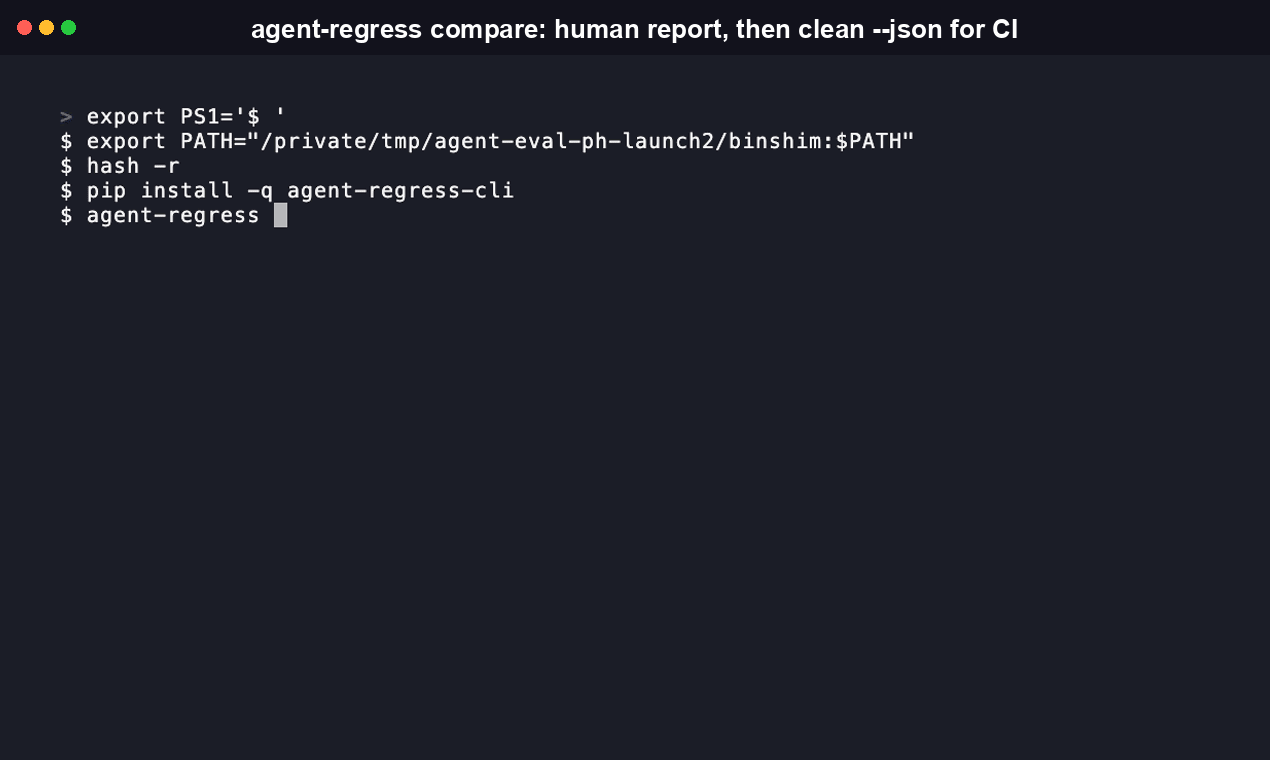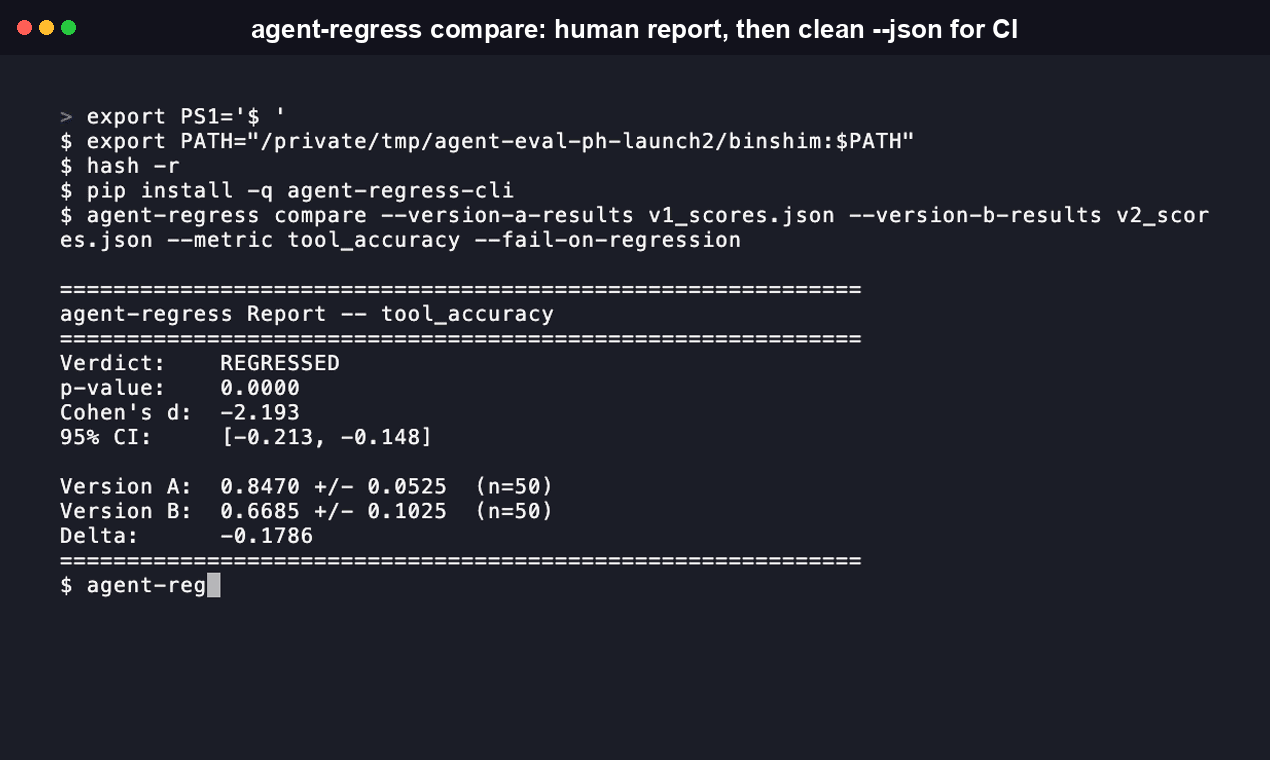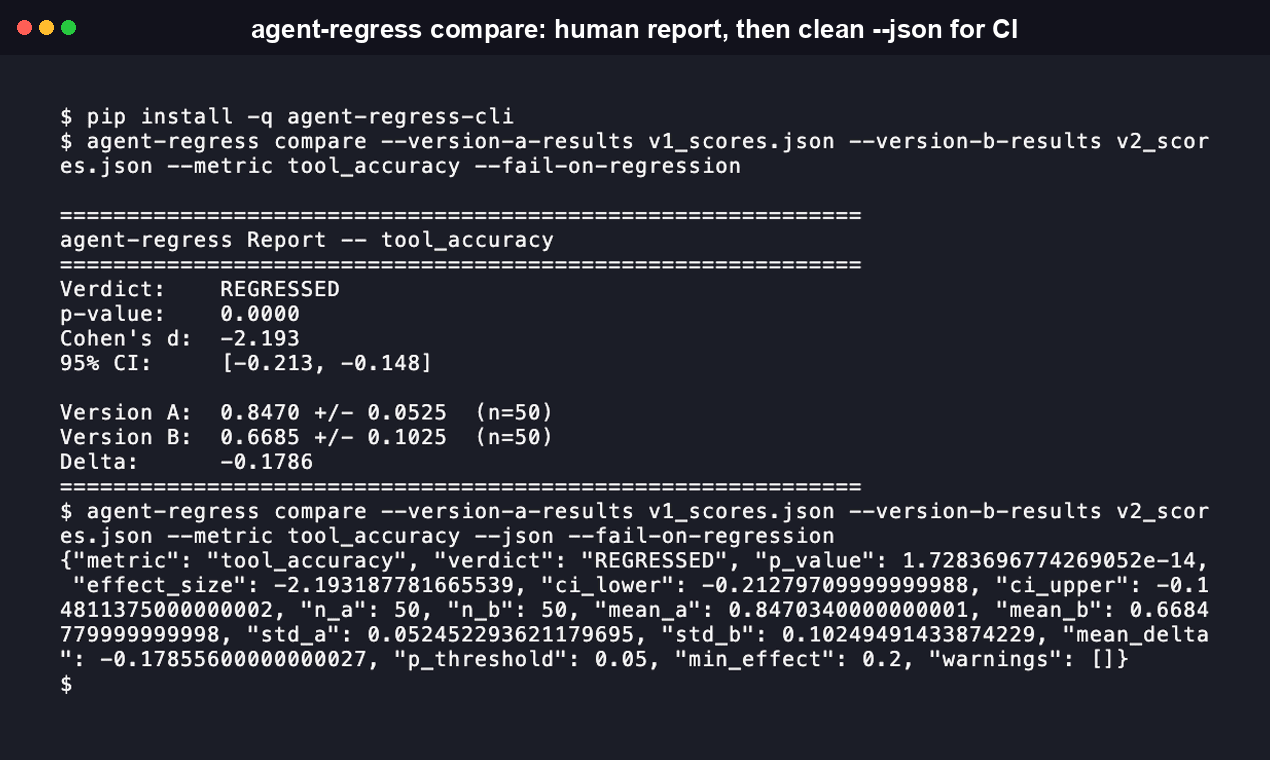
Añade --json --fail-on-regression para obtener una salida limpia y parseable y un código de salida distinto de cero en REGRESSED, para conectarlo directamente a CI.
Todas las banderas de agent-regress compare:
| Bandeira | Predeterminado | Descripción |
|---|---|---|
--version-a-results PATH | (obligatorio) | Ruta a un array JSON de puntuaciones por ejecución para la versión A (línea base). |
--version-b-results PATH | (obligatorio) | Ruta a un array JSON de puntuaciones por ejecución para la versión B (candidata). |
--metric NAME | accuracy | Nombre de la métrica que se compara, mostrado en el informe. |
--p-threshold P | 0.05 | Umbral de significancia para el valor p de Mann-Whitney U. |
--min-effect D | 0.2 | Mínimo |d de Cohen| para llamar a una diferencia estadísticamente significativa REGRESSED/IMPROVED en lugar de STABLE. |
--n-resamples N | 1000 | Número de remuestreos bootstrap utilizados para el intervalo de confianza (mínimo: 100). |
--json | off | Imprime el informe como un único objeto JSON en stdout en lugar del formato legible por humanos. Las advertencias siguen yendo a stderr, por lo que stdout permanece limpio y parseable como JSON. |
--fail-on-regression | off | Sale con estado 1 si el veredicto es REGRESSED (útil para CI). Sin esta bandera, el comando sale con 0 independientemente del veredicto. |
La bandera de nivel superior agent-regress --version imprime la versión instalada y sale.
Códigos de salida:
| Código | Significado |
|---|---|
0 | Se ejecutó correctamente. El veredicto puede ser REGRESSED, STABLE, IMPROVED o INSUFFICIENT_DATA — sin --fail-on-regression, el código de salida no refleja el veredicto. |
1 | Se pasó --fail-on-regression y el veredicto es REGRESSED. |
2 | Error de uso o de datos: argumentos inválidos o faltantes, ningún subcomando dado, un archivo --version-*-results que no existe o no es JSON válido, un array de puntuaciones vacío o no numérico, o un valor fuera de rango para --p-threshold (debe estar en (0, 1)), --min-effect (debe ser >= 0), o --n-resamples (debe ser >= 100). |
En tu código (API de Python)
¿Estás manejando el agente tú mismo en lugar de precomputar puntuaciones? Usa la API de Python:
from agent_regress import compare

# Any callable that takes a test case dict and returns a score 0.0-1.0
def agent_v1(test_case: dict) -> float:
    ...  # your existing agent

def agent_v2(test_case: dict) -> float:
    ...  # your updated agent

test_suite = [
    {"query": "find SKU for order 8823", "expected": "SKU-4492"},
    # ... more test cases
]

report = compare(
    version_a=agent_v1,
    version_b=agent_v2,
    test_suite=test_suite,
    n_runs=50,
    metric="tool_accuracy",  # use any name except "accuracy" when agents return floats
)

print(report)           # structured output with p-value, CI, effect size
report.assert_stable()  # raises AssertionError if behavior regressed
¿El agente devuelve texto? Pasa un scorer o usa los integrados:
from agent_regress import compare, exact_match_scorer, f1_scorer

# exact_match_scorer: 1.0 if str(output).strip() == str(expected).strip()
# f1_scorer: token-level F1 (multiset — handles repeated tokens correctly)
report = compare(
    version_a=agent_v1,
    version_b=agent_v2,
    test_suite=test_suite,
    n_runs=50,
    scorer=exact_match_scorer,  # test_case must have an "expected" key
)
O escribe el tuyo propio:
def my_scorer(output: str, test_case: dict) -> float:
    return 1.0 if output.strip() == test_case["expected"] else 0.0

report = compare(..., scorer=my_scorer)
Servidor MCP
agent-eval incluye un servidor de Model Context Protocol para que un agente de IA (Claude, Cursor o cualquier cliente compatible con MCP) pueda ejecutar pruebas de regresión estadística directamente, sin que un humano invoque la CLI manualmente.
Instala el extra:
pip install "agent-regress-cli[mcp]"
Añádelo a la configuración de tu cliente MCP (para Claude Desktop, claude_desktop_config.json):
{
  "mcpServers": {
    "agent-eval": {
      "command": "uvx",
      "args": ["--from", "agent-regress-cli", "agent-regress-mcp"]
    }
  }
}
El servidor expone una herramienta, run, que ejecuta la CLI agent-regress con el
subcomando y argumentos dados más --json, y devuelve el resultado JSON parseado:
run(["compare", "--version-a-results", "a.json", "--version-b-results", "b.json", "--metric", "accuracy"])
El transporte es stdio, por lo que no hay nada que alojar: el cliente MCP lanza el servidor como un
subproceso local. Fuente: src/agent_regress/mcp_server.py.
¿Por qué no DeepEval, Promptfoo o Braintrust?
| Capacidad | Agent Evaluation | DeepEval | Braintrust | Promptfoo |
|---|---|---|---|---|
| Comparación estadística de versiones (valores p) | Sí | No | No | No |
| Informe de tamaño del efecto (d de Cohen) | Sí | No | No | No |
| Intervalos de confianza bootstrap del 95% | Sí | No | No | No |
| Detección de cambio distribucional | Sí | No | No | No |
| Harness Tau-bench pass^k (k=1,4,8) | Sí | No | No | No |
| Harness de división GAIA Nivel 1-3 | Sí | No | No | No |
| Harness de puntuación de scaffold SWE-bench | Sí | No | No | No |
| Autoalojable, sin SaaS requerido | Sí | Parcial | No | Sí |
| Advertencias de tamaño de muestra | Sí | No | No | No |
| Licencia principal | Apache 2.0 | MIT | Propietaria | MIT† |
| Requiere cuenta en la nube | No | Opcional | Sí | No |
| Tipo de prueba | Distribucional | Umbral | Umbral | Umbral |
†Promptfoo adquirido por OpenAI, marzo de 2026; permanece como código abierto bajo su licencia actual.
DeepEval prueba si una respuesta individual de un agente supera un umbral de calidad. Agent Evaluation prueba si el comportamiento cambió significativamente entre dos versiones de un agente, una pregunta estadística diferente que las pruebas de umbral no pueden responder. La llamada scipy Mann-Whitney U en el núcleo es una línea, por lo que cualquier plataforma SaaS de evaluación puede añadirla. Lo que se acumula con el tiempo a través del uso en producción es el historial de regresiones específico de cada versión y un leaderboard de benchmarks mantenido por la comunidad con verificación independiente de resultados.
Regresiones reales que las pruebas estadísticas detectan y las de umbral pasan por alto
LangGraph
- #5243: una nueva API
context=tipada reemplazó aconfig['configurable']sin tipar. Una sola ejecución con cualquiera de los dos estilos de invocación sigue superando una verificación de umbral; solo una comparación versión-A-vs-B muestra si el cambio alteró el comportamiento medido. - #4486: el almacenamiento en caché de resultados a nivel de nodo/tarea puede enmascarar silenciosamente la varianza de muestreo repetido. Las verificaciones de umbral no se preocupan de si un resultado vino de la caché; una comparación estadística depende de muestras genuinamente independientes, por lo que
agent-evalañadió invalidación de caché para proteger esa suposición.
OpenAI Agents SDK
- #2463: las llamadas de agente-como-herramienta estaban descartando silenciosamente el
RunConfigde la ejecución padre. La llamada anidada sigue devolviendo una respuesta de apariencia normal, por lo que una verificación de respuesta única pasa; solo inspeccionar la propagación de configuración entre ejecuciones revela la regresión. - #2214: las salidas de herramientas de imagen/audio/archivo se degradaban silenciosamente a solo texto. Un scorer de umbral solo de texto no tiene forma de notar un adjunto eliminado.
CrewAI
- #6134: una corrección de seguridad para herramientas de archivos que filtraban rutas absolutas del sistema de archivos en las respuestas. Un scorer de calidad verifica si la respuesta es correcta, no si también filtra una ruta, por lo que la filtración supera el umbral.
- #6236: las herramientas ganaron un
output_schemaPydantic opcional, pasando de salidastr()no estructurada a JSON estructurado. Tanto el formato antiguo como el nuevo pueden parecer "razonables" para un scorer de umbral incluso aunque el esquema haya cambiado por debajo.
Estas son las regresiones que motivaron este proyecto. El detalle completo de los 14 PRs documentados individualmente (extraídos de una campaña de validación de 29 PRs y 239 filas en LangGraph, CrewAI y OpenAI Agents SDK) está en docs/pr-analysis.md.
El problema que esto resuelve
Cambiaste un prompt. O cambiaste de GPT-4o a GPT-4o-mini para reducir costos. O una dependencia se actualizó silenciosamente. Tus evaluaciones siguen pasando, porque prueban respuestas individuales contra umbrales fijos. No detectan si el comportamiento cambió en toda la distribución.
Una caída de 3 puntos en precisión podría ser ruido de la varianza del LLM. O podría ser una regresión real. Sin pruebas estadísticas no puedes distinguirlo. Los equipos o ignoran las caídas pequeñas y pierden problemas reales, o escalan todo y se ahogan en falsas alarmas.
Agent Evaluation responde la pregunta distribucional con un valor p y un tamaño del efecto:
============================================================
agent-regress Report -- tool_accuracy
============================================================
Verdict:    REGRESSED
p-value:    0.0031
Cohen's d:  -0.610
95% CI:     [-0.221, -0.067]

Version A:  0.8400 +/- 0.0601  (n=50)
Version B:  0.7000 +/- 0.0903  (n=50)
Delta:      -0.1400
============================================================
Cuando CI falla, el error de aserción da el mensaje que bloquea el despliegue:
AssertionError: REGRESSED: tool_accuracy dropped 16.7%
(p=0.003, Cohen's d=-0.61, 95% CI [-0.22, -0.07])
Version A: 0.840 +/- 0.060  (n=50)
Version B: 0.700 +/- 0.090  (n=50)
Cuando nada cambió:
Verdict:    STABLE
p-value:    0.4100
Cohen's d:  0.021
DeepEval, Promptfoo y Braintrust prueban si respuestas individuales cumplen umbrales. Ninguno responde si la distribución de comportamiento de una versión cambió significativamente respecto a la anterior. Agent Evaluation aborda esa pregunta estadística específica, que las pruebas de umbral no pueden responder.
Añadir a CI: fallar la compilación en regresión
Dos patrones. Elige uno.
report.assert_stable() — en línea, después de haber llamado ya a compare():
# test_regression.py -- add to your existing test suite
from agent_regress import compare

def test_no_regression():
    report = compare(
        version_a=production_agent,
        version_b=staging_agent,
        test_suite=load_test_suite(),
        n_runs=50,
    )
    report.assert_stable(
        p_threshold=0.05,  # act on changes at p < 0.05
        min_effect=0.2,    # Cohen's d threshold -- ignore noise below 0.2
    )
RegressionGate — objeto de compuerta reutilizable, útil cuando ejecutas múltiples comparaciones con los mismos umbrales:
from agent_regress import compare, RegressionGate

gate = RegressionGate(p_threshold=0.05, min_effect=0.2)

def test_tool_accuracy():
    report = compare(version_a=prod, version_b=staging, test_suite=suite, n_runs=50)
    gate.check(report)  # raises AssertionError on regression; warns if n < 30

def test_routing_accuracy():
    report = compare(version_a=prod, version_b=staging, test_suite=routing_suite, n_runs=50)
    gate.check(report)

Ambos patrones: advierten (no fallan) cuando n < 30 por versión, y tratan n < 10 como datos insuficientes y omiten la compuerta. Este umbral de compuerta CI (30) es intencionalmente más bajo que la advertencia general de baja potencia de compare() (n < 50, ver FAQ) — existe para evitar que una muestra genuinamente demasiado pequeña bloquee silenciosamente una compilación, no para garantizar un 80% de potencia estadística como lo hace la recomendación de 50 ejecuciones.
uv run pytest test_regression.py
Métodos estadísticos
Agent Evaluation usa tres pruebas estadísticas, aplicadas en combinación:
Mann-Whitney U compara dos distribuciones de puntuaciones sin asumir normalidad. Las puntuaciones de LLM no son gaussianas. La prueba U es libre de distribución y robusta a las colas largas y distribuciones bimodales que aparecen en salidas reales de agentes.
Intervalos de confianza bootstrap (1,000 remuestreos, semilla=42) dan un IC del 95% sobre el delta medio de puntuación. El IC te dice cuán grande fue el cambio: un IC de [-0.22, -0.07] significa que puedes tener un 95% de confianza en que la caída real de precisión por ejecución está entre 7 y 22 puntos porcentuales.
d de Cohen (desviación estándar agrupada) separa la significancia estadística de la significancia operativa. Un cambio con p=0.001 y d=0.04 es real pero insignificante. Un cambio con p=0.06 y d=0.5 es operativamente grande pero requiere más datos para confirmarse. La compuerta CI predeterminada actúa solo cuando ambos p < 0.05 and d >= 0.2.
Ver docs/statistical-methods.md para la metodología completa.
Benchmarks
La sobrecarga de las pruebas estadísticas es el tiempo de ejecutar la comparación en sí, no las llamadas al agente. Las llamadas al agente son el cuello de botella; las estadísticas no lo son.
Medido en Apple M3 Pro, Python 3.14, scipy 1.15, numpy 2.2:
| Operación | n=50 por versión | n=1,000 por versión |
|---|---|---|
| Mann-Whitney U | 0.34ms | 0.47ms |
| IC bootstrap (1,000 remuestreos) | 26ms | 31ms |
| Sobrecarga estadística completa de compare() | ~27ms | ~32ms |
Ver docs/benchmarks.md para reproducir.
Matriz de integración
| Framework | Estado | Instalación |
|---|---|---|
| LangGraph | Enviado (v0.1) | pip install agent-regress-cli[langgraph] |
| OpenAI Agents SDK | Enviado (v0.1) | pip install agent-regress-cli[openai-agents] |
| CrewAI | Enviado (v0.1) | pip install agent-regress-cli[crewai] |
| LangChain LCEL | Enviado (v0.1) | pip install agent-regress-cli[langchain] |
| AutoGen | Planificado (v0.3) | |
| Vercel AI SDK (TypeScript) | Planificado (v0.4) |
¿Comparando dos versiones instaladas del mismo framework (en lugar de dos
configuraciones en proceso)? Ver
docs/cross-version-comparison.md para el
patrón subprocess_runner().
[!WARNING] El extra
[crewai]: el backend de memoria/conocimiento/RAG propio de CrewAI puede incorporar ChromaDB, que actualmente tiene una CVE crítica sin parchear (GHSA-f4j7-r4q5-qw2c) que afecta a cualquier servidor ChromaDB ejecutado contrust_remote_code=Truey expuesto a la red.agent-evalnunca inicia, configura ni expone un servidor ChromaDB por sí mismo, por lo que esto solo importa si tu propioCrewlo hace: no ejecutes una instancia de ChromaDB expuesta a la red contrust_remote_code=Truehasta que se publique un parche.
Benchmarks estándar
Agent Evaluation incluye arneses para los tres benchmarks estándar de agentes:
Tau-bench pass^k mide la fiabilidad en k intentos independientes. Los benchmarks de una sola ejecución pasan por alto la degradación: un agente que tiene éxito el 60% de las veces en k=1 alcanza el 99,93% en k=8. La curva de k=1 frente a k=8 es la señal.
from agent_regress.benchmarks.tau_bench import TauBenchHarness

harness = TauBenchHarness(agent=my_agent, dataset=tau_bench_dataset)
results = harness.evaluate(k_values=[1, 4, 8])
División GAIA Nivel 1-3 estratifica por dificultad de la tarea. La precisión general oculta regresiones por dificultad: un cambio de prompt que ayuda al Nivel 1 a menudo perjudica al Nivel 3.
from agent_regress.benchmarks.gaia import GAIAHarness

harness = GAIAHarness(agent=my_agent, dataset=gaia_dataset)
results = harness.evaluate()  # returns list[GAIALevelResult], one per level
for r in results:
    print(f"Level {r.level}: {r.accuracy:.3f}  ({r.n_correct}/{r.n_questions})")
Puntuación de andamiaje SWE-bench aísla la contribución del framework de la contribución del modelo.
from agent_regress.benchmarks.swebench import SWEBenchHarness

harness = SWEBenchHarness(agent=my_agent, dataset=swe_dataset)
result = harness.evaluate()
print(f"scaffold pass rate: {result.scaffold_pass_rate:.3f}  ({result.n_resolved}/{result.n_instances})")
Consulta leaderboard/README.md para enviar resultados.
Pruébalo en Docker
git clone https://github.com/RudrenduPaul/agent-eval
cd agent-eval
docker compose up
Inicia dos servicios:
- web (
http://localhost:8080) — interfaz del leaderboard servida porweb/serve.py, que leeleaderboard/results/*.json - example — ejecuta
examples/01-basic-comparison/example.pye imprime el informe de comparación en stdout
Es útil para verificar que la instalación funciona y ver la interfaz del leaderboard antes de conectar agent-regress a tu propio agente.
Seguridad
- Cadena de suministro: Las versiones se compilan y publican desde un flujo de trabajo de GitHub Actions, se firman con Sigstore y se distribuyen con un SBOM CycloneDX adjunto a cada versión de GitHub. (Aún no se genera una atestación de procedencia SLSA; eso requeriría adoptar
slsa-framework/slsa-github-generator.) - Escaneo de vulnerabilidades: Trivy escanea en cada ejecución de CI (solo HIGH/CRITICAL, salida en caso de no corregido). Análisis estático CodeQL en cada push.
- Fijación de dependencias: Dependabot mantiene actualizadas todas las acciones de GitHub y las dependencias de Python.
- Divulgación: SECURITY.md — reporta vulnerabilidades de forma privada a través de GitHub Security Advisories.
Leaderboard
El directorio leaderboard/ controla versiones de los resultados de Tau-bench pass^k, GAIA y SWE-bench en todos los modelos y frameworks. Envía una PR con un archivo JSON que coincida con leaderboard/schema.json. Los resultados se reproducen de forma independiente antes de fusionarse.
Consulta leaderboard/README.md.
Preguntas frecuentes
¿Qué es agent-eval y qué lo diferencia de un framework de evaluación LLM normal?
Agent Evaluation es una biblioteca de estadísticas para detectar si el comportamiento de un agente realmente cambió entre dos versiones. Ejecuta la misma suite de pruebas 50 veces en la versión A y 50 veces en la versión B, e informa un valor p (Mann-Whitney U), un tamaño del efecto (d de Cohen) y un intervalo de confianza bootstrap del 95% sobre el delta de puntuación. La mayoría de los frameworks de evaluación comprueban si una sola respuesta supera un umbral de calidad fijo. Agent Evaluation responde en cambio a una pregunta distribucional: ¿cambió significativamente la distribución de puntuaciones, o un cambio es solo ruido de ejecución a ejecución del LLM?
¿Cómo lo instalo y qué plataformas admite?
pip install agent-regress-cli o uv add agent-regress-cli. Requiere Python 3.10 a 3.13 (según los clasificadores en pyproject.toml) y no tiene código específico del sistema operativo, por lo que se ejecuta en cualquier lugar donde se ejecuten esas versiones de Python. También está disponible un envoltorio Node/npx (npx agent-regress-cli, también publicado como agent-regress-cli en npm): este invoca al mismo paquete de Python, por lo que aún debe estar disponible un conjunto de herramientas de Python (o uv/pipx, que pueden ejecutarlo de forma efímera sin un paso manual de pip install); imprime un error procesable si no se encuentra ninguno.
¿Cómo se compara con DeepEval, Promptfoo o Braintrust?
El desglose completo está en la tabla de comparación anterior. En resumen: DeepEval, Promptfoo y Braintrust comprueban si una respuesta individual supera una barra de calidad fija. Ninguno de los tres informa un valor p, un tamaño del efecto o un intervalo de confianza bootstrap sobre si el comportamiento cambió entre dos versiones, que es la pregunta estadística específica que agent-eval está diseñado para responder.
Ejecuté una comparación y obtuve una advertencia sobre potencia estadística insuficiente, o un veredicto de INSUFFICIENT_DATA. ¿Qué significa eso?
La biblioteca advierte (pero no falla) cuando cualquiera de las versiones tiene menos de 50 ejecuciones, ya que ese es el tamaño de muestra necesario para la detección fiable de un efecto moderado (d de Cohen de 0,2) con un 80% de potencia. Por debajo de 10 ejecuciones por versión, devuelve INSUFFICIENT_DATA en lugar de un veredicto REGRESSED/STABLE/IMPROVED, ya que la muestra es demasiado pequeña para confiar en cualquier conclusión estadística. Vuelve a ejecutar con n_runs=50 o más para obtener un veredicto sobre el que puedas actuar.
¿agent-eval llama a mi LLM o gestiona claves API por mí?
No. compare() toma dos invocables que tú proporcionas, version_a y version_b, y ejecuta tu código de agente existente contra tu suite de pruebas. Agent Evaluation nunca realiza una llamada de modelo por sí mismo, y el módulo de estadísticas (src/agent_regress/stats/) debe permanecer como Python puro y scipy sin llamadas LLM, por lo que el núcleo estadístico no tiene dependencia de red ni nada que configurar para credenciales.
¿Con qué frameworks de agentes se integra hoy?
LangGraph, OpenAI Agents SDK, CrewAI y LangChain LCEL se incluyen a partir de v0.1 (consulta la matriz de integración anterior), cada uno instalable como extra, por ejemplo pip install agent-regress-cli[langgraph]. AutoGen y una integración con Vercel AI SDK (TypeScript) están planificadas pero aún no se han publicado.
¿Puedo usar agent-eval comercialmente y bajo qué licencia está?
Sí. Está licenciado bajo Apache License 2.0, que permite uso comercial, modificación y distribución, e incluye una concesión de patente explícita. Debes conservar los avisos de copyright y licencia y declarar cualquier cambio que realices; no hay garantía. Consulta LICENSE para el texto completo.
Contribuciones
- Lee CONTRIBUTING.md antes de abrir una PR
- Los primeros problemas buenos están etiquetados en GitHub
- El módulo de estadísticas (
src/agent_regress/stats/) debe permanecer como Python puro + scipy — sin llamadas LLM, nunca - Todas las PR requieren un 95% de cobertura en
stats/, 80% en general
GitHub Discussions para preguntas de diseño.
Apache 2.0. Las contribuciones son bienvenidas.
Cita este trabajo
Si usas Agent Evaluation en investigación, cita:
@software{paul2026agenteval,
  author = {Paul, Rudrendu and Nandy, Sourav},
  title = {Agent Evaluation: Statistical Regression Testing for LLM Agents},
  year = {2026},
  url = {https://github.com/RudrenduPaul/agent-eval},
  license = {Apache-2.0}
}
Construido por Rudrendu Paul y Sourav Nandy