MCP Design System Extractor
Extrae información de componentes, incluyendo HTML, estilos y metadatos, de sistemas de diseño de Storybook.
Documentación
MCP Design System Extractor
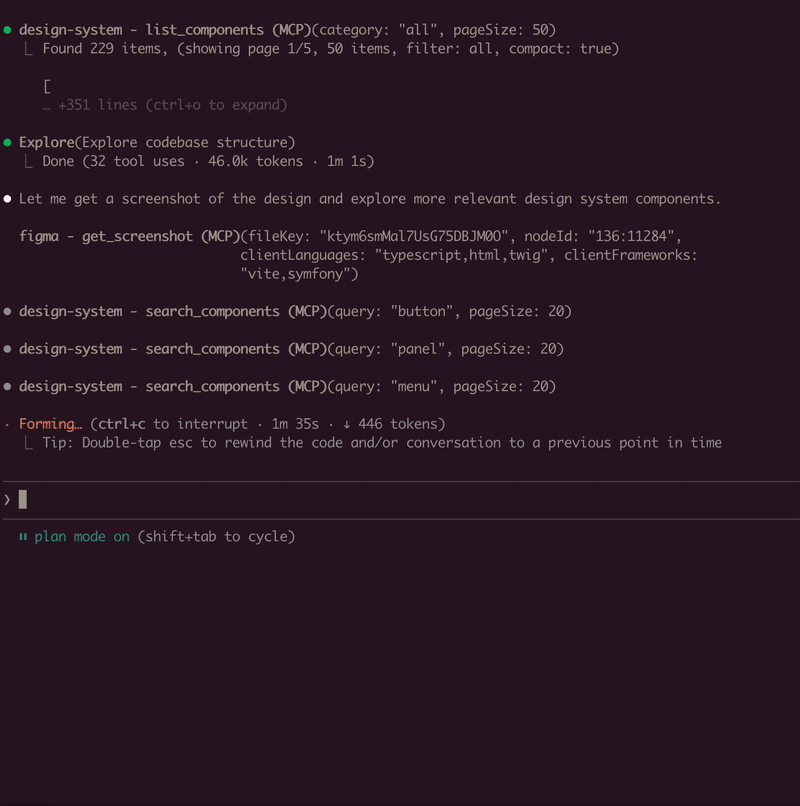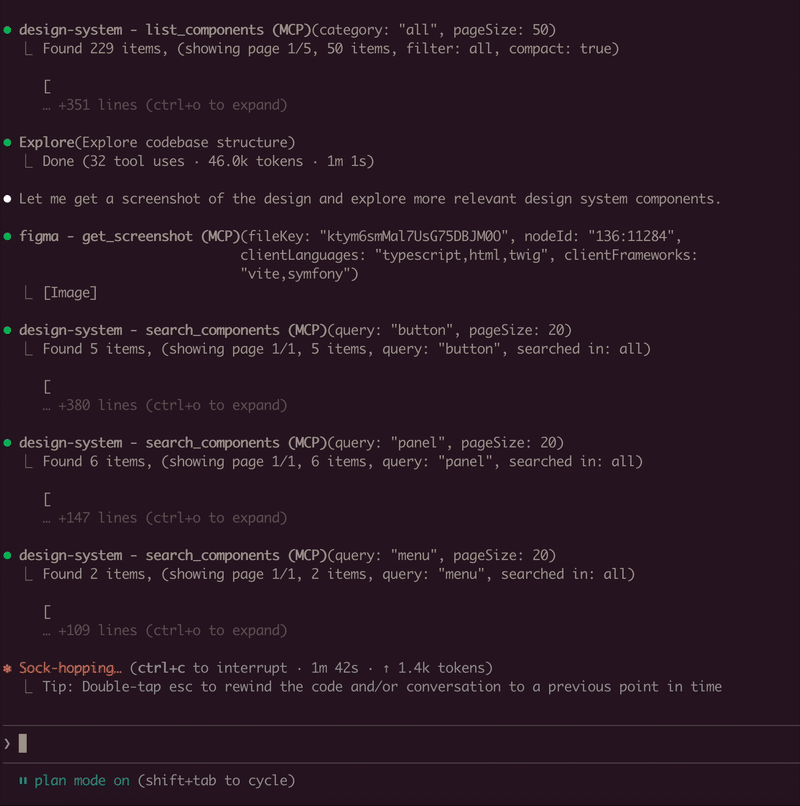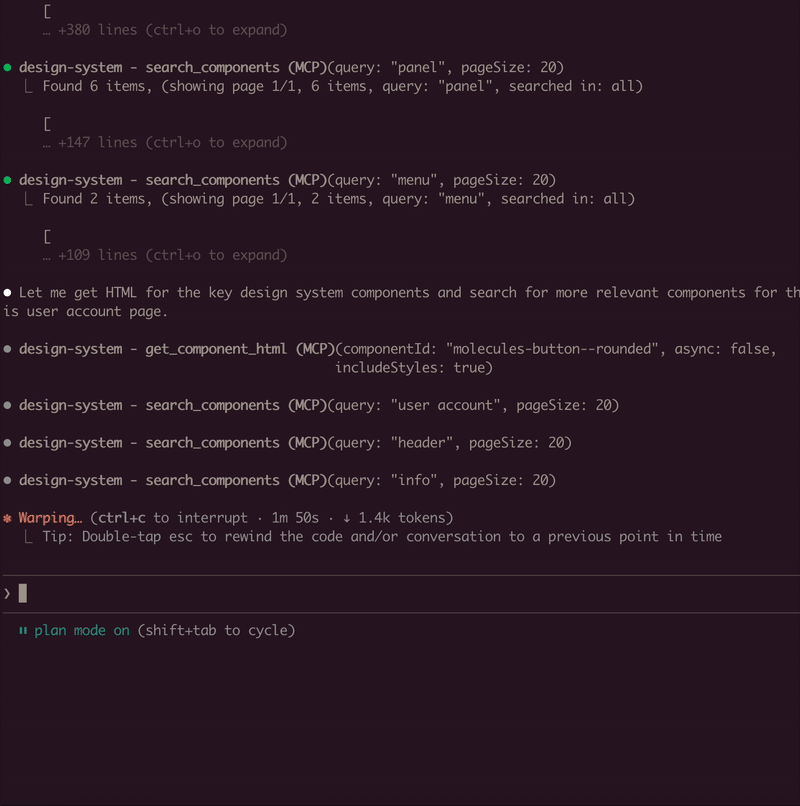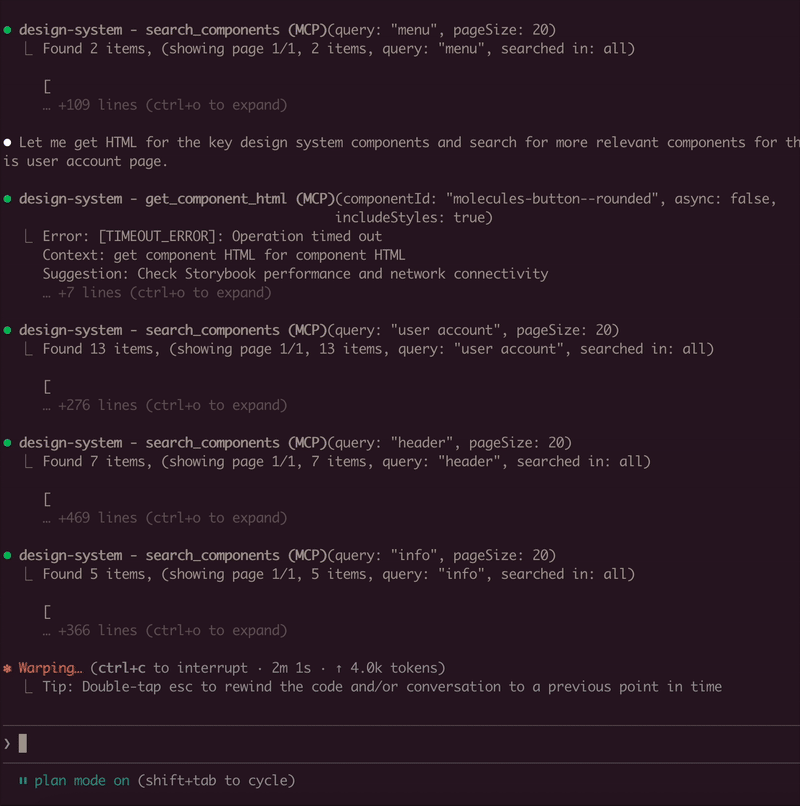
Un servidor de Model Context Protocol (MCP) que extrae información de componentes de sistemas de diseño de Storybook. Se conecta a instancias de Storybook y extrae HTML, estilos y metadatos de componentes.
Instalación
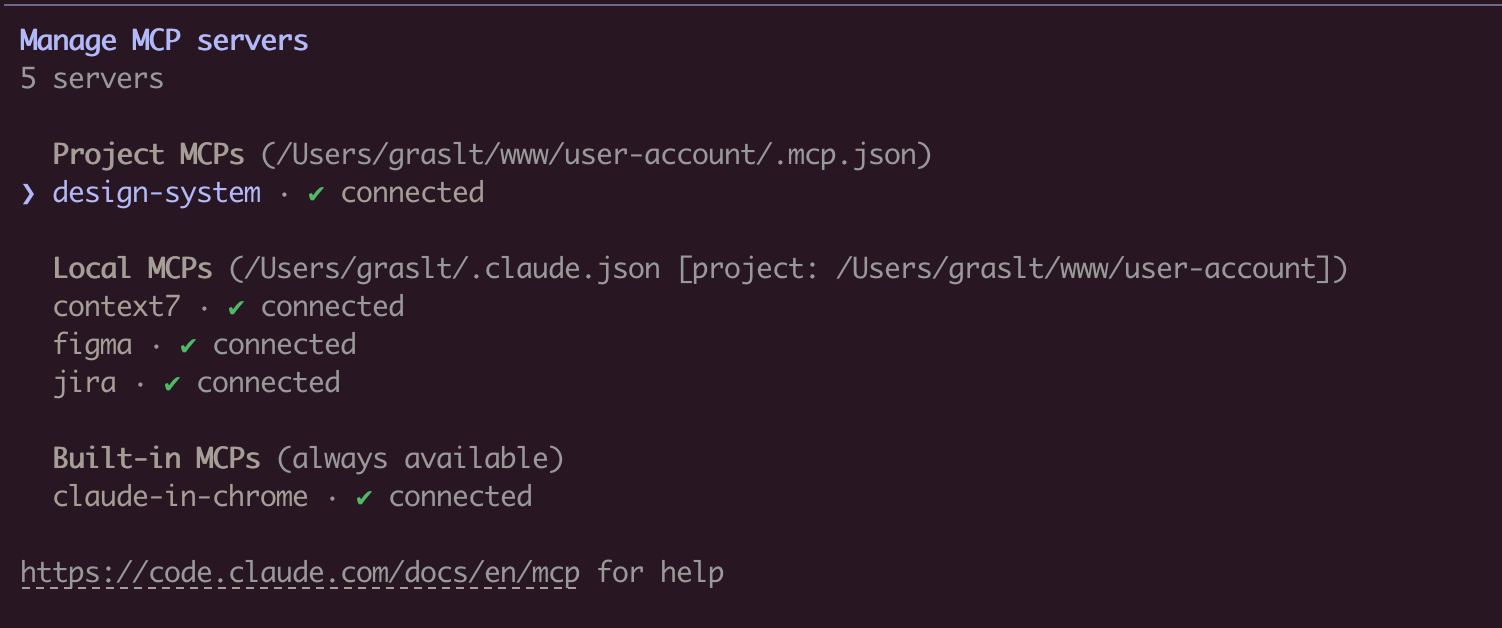
Usando Claude CLI (Recomendado)
claude mcp add design-system npx mcp-design-system-extractor@latest \
  --env STORYBOOK_URL=http://localhost:6006
Con certificado autofirmado:
claude mcp add design-system npx mcp-design-system-extractor@latest \
  --env STORYBOOK_URL=https://my-storybook.example.com \
  --env NODE_TLS_REJECT_UNAUTHORIZED=0
Usando npm
npm install -g mcp-design-system-extractor
Luego configura en tu cliente MCP (consulta Variables de Entorno).
Desde el Código Fuente
git clone https://github.com/freema/mcp-design-system-extractor.git
cd mcp-design-system-extractor
npm install && npm run build
npm run setup  # Interactive setup for Claude Desktop
Dependencias Clave
- Puppeteer: Utiliza Chrome sin interfaz gráfica para el renderizado dinámico de componentes JavaScript
- Chrome/Chromium: Requerido para Puppeteer (manejado automáticamente en Docker)
- Funciona con distribuciones de Storybook compiladas
Características
- Listar Componentes: Obtén todos los componentes disponibles de tu Storybook con modo compacto
- Extraer HTML: Obtén el HTML renderizado de cualquier componente (modo asíncrono o síncrono)
- Buscar Componentes: Encuentra componentes por nombre, título, categoría o propósito
- Dependencias de Componentes: Analiza qué componentes se utilizan dentro de otros componentes
- Información del Tema: Extrae el tema del sistema de diseño (colores, espaciado, tipografía)
- Análisis de CSS Externo: Obtén y analiza archivos CSS para extraer tokens de diseño
- Cola de Trabajos Asíncronos: Las operaciones de larga duración se ejecutan en segundo plano con seguimiento de trabajos
Variables de Entorno
| Variable | Descripción | Valor por Defecto |
|---|---|---|
STORYBOOK_URL | URL de tu instancia de Storybook | http://localhost:6006 |
NODE_TLS_REJECT_UNAUTHORIZED | Establecer a 0 para omitir la verificación de certificados SSL (para certificados autofirmados) | 1 |
Ejemplo con certificado autofirmado:
{
  "mcpServers": {
    "design-system": {
      "command": "node",
      "args": ["/path/to/dist/index.js"],
      "env": {
        "STORYBOOK_URL": "https://my-storybook.example.com",
        "NODE_TLS_REJECT_UNAUTHORIZED": "0"
      }
    }
  }
}
Uso
Consulta DEVELOPMENT.md para instrucciones detalladas de configuración.
Herramientas Disponibles (9 en total)
Herramientas Principales
-
list_components
- Lista todos los componentes disponibles de la instancia de Storybook
- Usa
compact: truepara salida mínima (reduce el tamaño de la respuesta) - Filtra por el parámetro
category - Soporta paginación con
pageypageSize(predeterminado: 20)
-
get_component_html
- Extrae HTML de una historia de componente específica
- Asíncrono por defecto: Devuelve
job_id, usajob_statuspara consultar los resultados - Establece
async: falsepara modo síncrono (usa el parámetrotimeout) - Usa
variantsOnly: truepara obtener la lista de variantes disponibles (síncrono, rápido) includeStyles: trueopcional para extracción de CSS (el CSS de Storybook se filtra)- Formato de ID de historia:
"component-name--story-name"o solo"component-name"(se resuelve automáticamente a la variante predeterminada)
-
search_components
- Busca componentes por nombre, título, categoría o propósito
query: Término de búsqueda (usa"*"para todos)purpose: Encuentra por función ("form inputs", "navigation", "feedback", "buttons", etc.)searchIn: "name", "title", "category" o "all" (predeterminado)- Soporta paginación con
pageypageSize
Herramientas de Análisis de Componentes
- get_component_dependencies
- Analiza el HTML renderizado para encontrar qué otros componentes se utilizan internamente
- Detecta componentes de React, componentes web y patrones de clases CSS
- Requiere formato de ID de historia:
"component-name--story-name"
Herramientas del Sistema de Diseño
-
get_theme_info
- Extrae el tema del sistema de diseño (colores, espaciado, tipografía, breakpoints)
- Obtiene propiedades/variables personalizadas de CSS
- Usa
includeAll: truepara todas las variables CSS
-
get_external_css
- PREDETERMINADO: Devuelve solo tokens de diseño + estadísticas de archivo (evita límites de tokens)
- Extrae y categoriza tokens: colores, espaciado, tipografía, sombras
- Usa
includeFullCSS: truesolo cuando necesites el contenido CSS completo - Protegido por seguridad: solo acepta URLs del mismo dominio que Storybook
Herramientas de Gestión de Trabajos
-
job_status
- Verifica el estado de un trabajo asíncrono
- Devuelve:
status,result(cuando se completa),error(cuando falla) - Consulta esto después de llamar a
get_component_htmlen modo asíncrono
-
job_cancel
- Cancela un trabajo en cola o en ejecución
- Devuelve si la cancelación fue exitosa
-
job_list
- Lista todos los trabajos con su estado
- Filtra por
status: "all" (predeterminado), "active" (en cola/en ejecución), "completed" - Devuelve la lista de trabajos + estadísticas de la cola
Ejemplo de Uso
// List all components (compact mode recommended)
await list_components({ compact: true });

// Search for components
await search_components({ query: "button", searchIn: "name" });

// Find components by purpose
await search_components({ purpose: "form inputs" });

// Get variants for a component
await get_component_html({
  componentId: "button",
  variantsOnly: true
});
// Returns: { variants: ["primary", "secondary", "disabled"] }

// Get HTML (async mode - default)
await get_component_html({ componentId: "button--primary" });
// Returns: { job_id: "job_xxx", status: "queued" }

// Poll for result
await job_status({ job_id: "job_xxx" });
// Returns: { status: "completed", result: { html: "...", classes: [...] } }

// Get HTML (sync mode)
await get_component_html({
  componentId: "button--primary",
  async: false,
  timeout: 30000
});
// Returns: { html: "...", classes: [...] }

// Get HTML with styles
await get_component_html({
  componentId: "button--primary",
  async: false,
  includeStyles: true
});

// Check all running jobs
await job_list({ status: "active" });

// Extract theme info
await get_theme_info({ includeAll: false });

// Get design tokens from CSS
await get_external_css({
  cssUrl: "https://my-storybook.com/assets/main.css"
});
Consejos de Uso para Asistentes de IA
- Comienza con descubrimiento: Usa
list_componentsconcompact: true - Obtén variantes primero: Usa
get_component_htmlconvariantsOnly: true - Usa asíncrono para HTML: El modo asíncrono predeterminado evita tiempos de espera en componentes grandes
- Consulta job_status: Verifica la finalización del trabajo antes de leer los resultados
- Busca por propósito: Usa
search_componentscon el parámetropurpose
Ejemplos de Prompts
Una vez conectado, puedes usar prompts de lenguaje natural con Claude:
Descubrimiento de Componentes:
Show me all available button components in the design system
Construcción de Nuevas Funcionalidades:
I need to create a user profile card. Find relevant components
from the design system and show me their HTML structure.
Análisis del Sistema de Diseño:
Extract the color palette and typography tokens from the design system.
I want to ensure my new component matches the existing styles.
Migración de Componentes:
Get the HTML and styles for the "alert" component. I need to
recreate it in a different framework while keeping the same look.
Flujo de Trabajo Multi-Herramienta:
First list all form-related components, then get the HTML for
the input and select components. I'm building a registration form.
Cómo Funciona
Se conecta a Storybook a través de los endpoints /index.json y /iframe.html. Usa Puppeteer con Chrome sin interfaz gráfica para el renderizado dinámico de JavaScript. Las operaciones de larga duración usan una cola de trabajos en memoria con un máximo de 2 trabajos concurrentes y un TTL de 1 hora para trabajos completados.
Solución de Problemas
- Asegúrate de que Storybook esté ejecutándose y que
STORYBOOK_URLsea correcto - Usa
list_componentsprimero para ver los componentes disponibles - Para componentes grandes, usa el modo asíncrono (predeterminado) y consulta
job_status - Verifica el endpoint
/index.jsondirectamente en el navegador - Errores de certificados SSL: Establece
NODE_TLS_REJECT_UNAUTHORIZED=0para certificados autofirmados - Consulta DEVELOPMENT.md para solución de problemas detallada
Requisitos
- Node.js 20+
- Chrome/Chromium (para Puppeteer)
- Instancia de Storybook en ejecución (consulta las versiones compatibles a continuación)
Versiones compatibles de Storybook
Storybook 7, 8, 9 y 10. El servidor lee el índice de historias desde
/index.json, con respaldo a /stories.json, y renderiza historias a través de
/iframe.html?id=<storyId> — endpoints que han sido estables en las cuatro
versiones principales.
Storybook 6 y versiones anteriores no son compatibles: son anteriores a /index.json y usan
un esquema de ID de historia diferente.
Tanto un servidor de desarrollo (npm run storybook) como un Storybook estático compilado
servido a través de HTTP funcionarán.
Desarrollo
Consulta DEVELOPMENT.md para instrucciones detalladas de desarrollo.
Autor
Creado por Tomáš Grasl
Licencia
MIT