Flexreport Finance
Proporciona investigación de acciones en tiempo real a agentes de IA, dándoles una visión del mercado.
Servidor MCP alojado
npx add-mcp 'https://mcp.flexreportfinapi.com/mcp'Se instala en Claude Code, Codex, Cursor y más
Documentación
flexreport-mcp
Un microservicio MCP independiente que expone el backend de acciones de FlexReport —sus eventos en vivo, artefactos de informes de investigación y la base de datos de más de 750 millones de puntos de datos— como herramientas bajo demanda para Claude (y cualquier cliente MCP).
Potencia a los agentes de IA con eventos de mercado en tiempo real y datos seleccionados de fuente dorada que abarcan fundamentales, transcripciones, presentaciones, operaciones de información privilegiada (Formularios 3, 4 y 5), ratios, datos macro, presentaciones para inversores extraídas directamente del sitio de relaciones con inversores de cada empresa, y más.
Instalación rápida
Añade el conector a Claude Code
claude mcp add --transport http flexreport https://mcp.flexreportfinapi.com/mcp
O añádelo a Codex
codex mcp add flexreport --url https://mcp.flexreportfinapi.com/mcp
Luego inicia Claude y simplemente pregunta (p. ej. "trae los mayores movimientos de flexreport").
En la primera llamada de datos, tu cliente MCP ejecuta un inicio de sesión OAuth en tu navegador:
inicia sesión o regístrate cuando se te solicite; nunca pegas un token. Añade --scope user para
disponer de él en todos los directorios. Consulta Auth para más detalles.
Demo
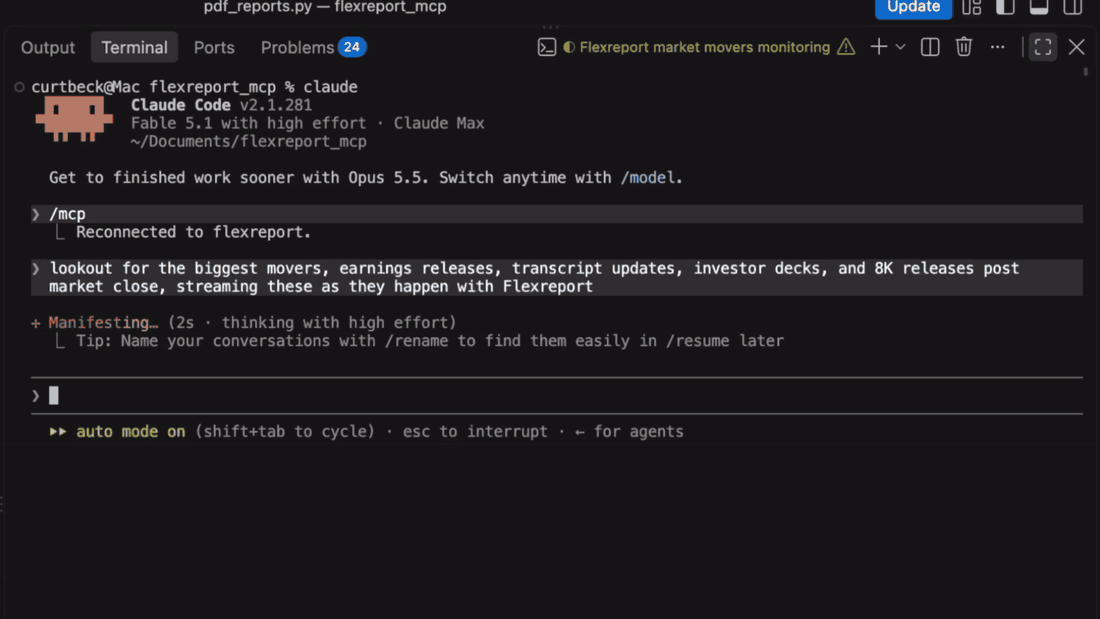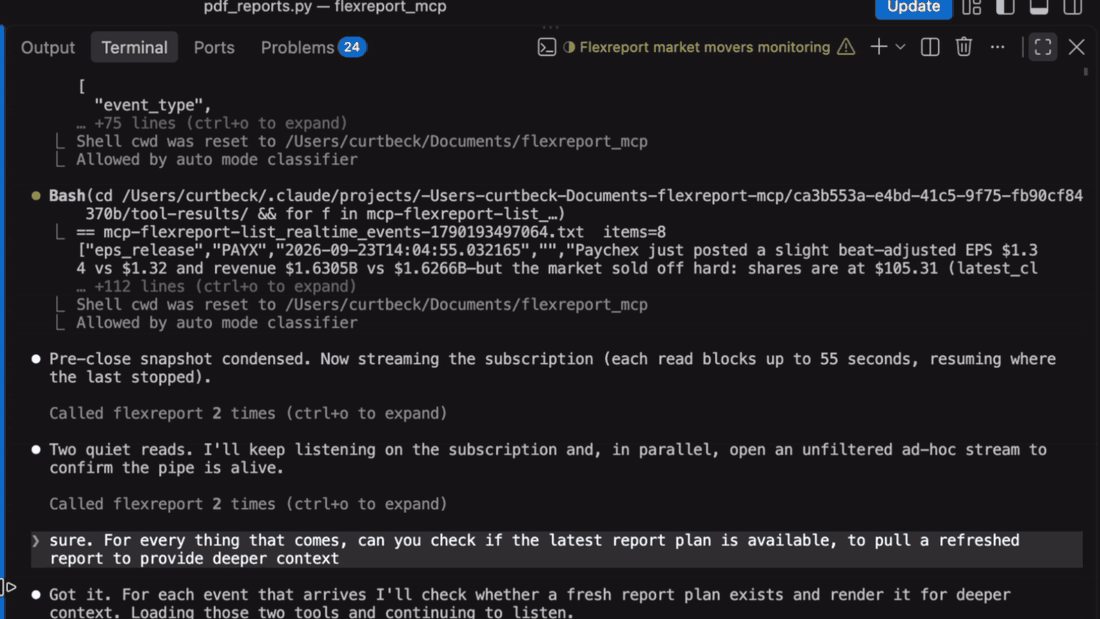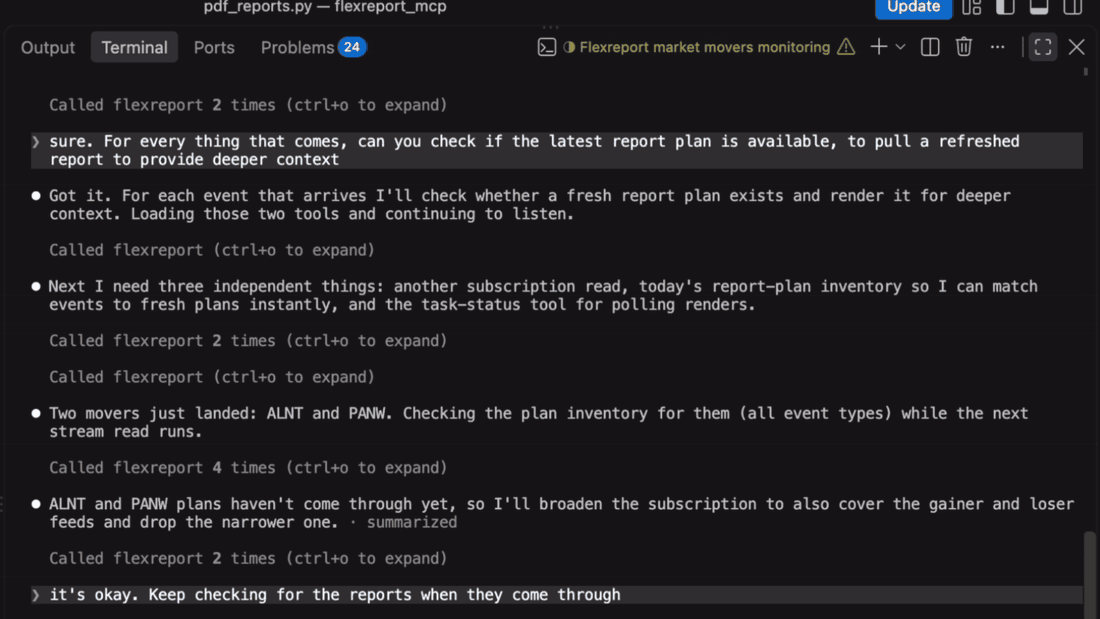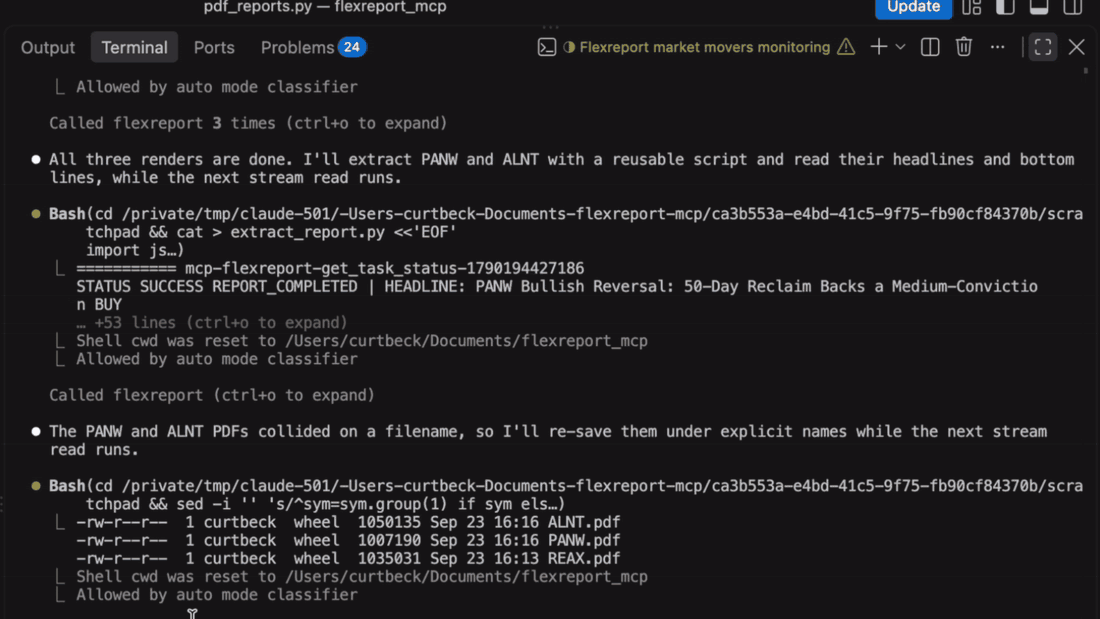
Transmite eventos en tiempo real en la terminal. Pide a Claude que observe el mercado y los eventos llegarán a medida que ocurren: movimientos, publicaciones de resultados, 8-K, presentaciones para inversores y nuevos planes de informes. A medida que cada plan de informe se guarda, Claude renderiza el informe actualizado.
"Vigila los mayores movimientos, publicaciones de resultados, actualizaciones de transcripciones, presentaciones para inversores y publicaciones 8-K tras el cierre del mercado, transmitiéndolos en tiempo real con Flexreport"
"Por cada cosa que llegue, ¿puedes comprobar si el último plan de informe está disponible, para extraer un informe actualizado y proporcionar un contexto más profundo?"
Abre el informe de investigación. Cada cifra enlaza de vuelta a la consulta que la generó, y cada titular enlaza a su fuente. Aquí tienes un informe para AAPL:
"Dame el último informe de flexreport para AAPL"
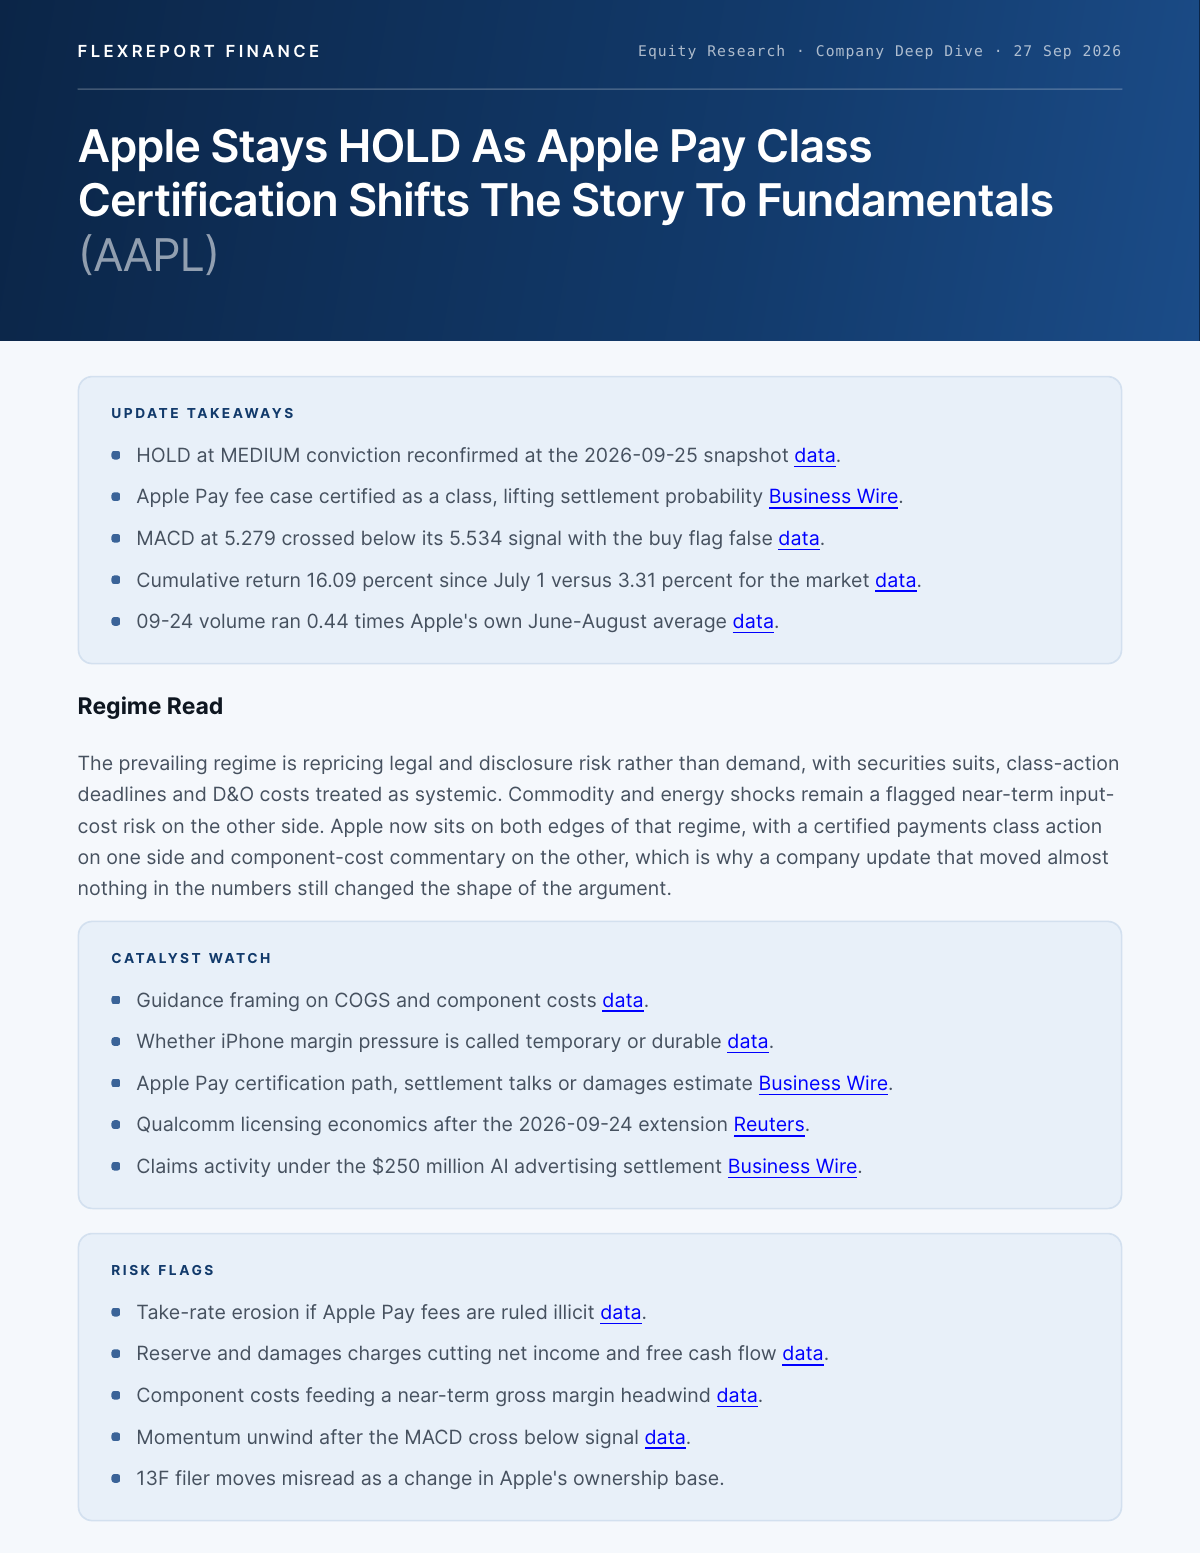
Abre el informe completo de AAPL (PDF, 13 páginas)
Casos de uso
1. Tiempo real
1a. Transmisión (eventos e informes en tiempo real). Suscríbete a eventos a medida que se publican, incluido el tema report_plan, que se activa cada vez que un informe está listo, y luego extrae el informe renderizado: "Suscríbeme a publicaciones de resultados, 8-K, publicaciones de relaciones con inversores y nuevos planes de informes para NVDA, AVGO, AMD y MU. A medida que cada uno llegue, dime qué ocurrió, revisa la cinta intradía para detectar un movimiento anómalo y extrae el informe de FlexReport cuando esté listo."
Herramientas: register_event_subscription → stream_event_subscription, o stream_events ad hoc, luego detect_intraday_outlier_jumps y get_latest_report.
Por defecto, una solicitud de transmisión en vivo genera un panel (en Claude, un Artifact) en lugar de una transcripción de chat. La página ejecuta el bucle stream_events por sí misma, llevando el cursor de lectura en lectura, de modo que un solo prompt mantiene la transmisión abierta. Si la página no puede alcanzar el servidor, el agente ejecuta el bucle y escribe cada evento en el panel. Solicita explícitamente la salida de chat si prefieres la vista de terminal mostrada en la demo anterior.
1b. Eventos de las últimas doce horas. Analiza presentaciones SEC 8-K en tiempo real, mientras también extraes presentaciones de relaciones con inversores y barras de 5 minutos para identificar rápidamente acciones con movimientos significativos: "¿Cuáles son las últimas publicaciones 8-K? Destaca las más significativas, extrae las publicaciones de relaciones con inversores asociadas vía FlexReport, grafica barras de 5 minutos para cualquier nombre con movimientos relevantes y dime cómo se alinean con el estado actual de cada empresa. Lo quiero en formato tabular: resumen del 8-K, tendencia de la empresa, enlace S3 del análisis 8-K de FlexReport, enlace de la presentación para inversores."
Herramientas: situate → list_realtime_events, luego get_aftermarket_data / detect_intraday_outlier_jumps y get_latest_report.
2. Informes
2a. El último informe de una empresa específica: "Extrae el último informe de FlexReport sobre Snowflake y resume qué cambió este trimestre: guía, márgenes y cualquier cosa que la dirección haya señalado en la llamada."
Herramientas: get_latest_report(["SNOW"]). Un plan nuevo se renderiza en ~10-20 s; un símbolo stale o missing puede reconstruirse con generate_report_for_stock.
2b. Los últimos informes de un período: "¿Qué informes han salido en el sector Energía en los últimos tres días? Extrae los nuevos y clasifícalos por la relevancia del evento subyacente."
Herramientas: list_available_reports(report_date=<3 days ago>), filtrado a nombres de Energía (list_options("sectors"), get_company_snapshot), luego get_latest_report para los fresh.
2c. Un informe personalizado basado en tus criterios: "Créame un informe sobre semiconductores estadounidenses de gran capitalización con ROIC superior al 20% y deuda neta/EBITDA inferior a 1x, que coticen por encima de su SMA de 200 días con RSI inferior a 60. Muestra los fundamentales, los técnicos y las últimas revisiones de estimaciones para cada uno, dispuestos en mi plantilla guardada."
Herramientas: screen_stocks, explore_data_catalogue (ratios, fundamentales, estimaciones), get_technical_indicator_data y get_user_template. El agente ensambla el PDF en tu plantilla; configúrala con draft_user_template → save_user_template.
3. Analítica predictiva
Predice la volatilidad de resultados próxima, incorporando medias móviles simples y exponenciales y Bandas de Bollinger, y creando un memo de inversión personalizado: "Predice la volatilidad de resultados de mañana, destacando las acciones con los mayores movimientos previstos; grafica sus medias móviles simples y exponenciales y Bandas de Bollinger; y destaca los mayores impulsores fundamentales actuales, poniendo todo esto en un memo de inversión para mi equipo."
Herramientas: list_earnings_announcements → predict_earnings_move, get_technical_indicator_data, get_company_snapshot.
4. Investigación y exploración
Realiza investigación temática sobre una narrativa de mercado: "El trade de IA se ha enfriado recientemente, en gran parte por preocupaciones de CapEx y retorno de la inversión. Creo que esto ya ocurrió antes, en el otoño de 2025. ¿Puedes confirmarlo y cuáles fueron los factores que aliviaron esas preocupaciones? ¿Fue el comentario de la dirección, la demanda continua de servicios de IA, la rentabilidad sólida y una guía más alta? Por favor, prepara un informe en profundidad con FlexReport Finance."
Herramientas: explore_data_catalogue (transcripciones, fundamentales, estimaciones), trace_data_sources / get_document_section para citas referenciadas, o generate_research_report para el informe completo.
Herramientas
50 herramientas, agrupadas por el módulo que las registra. Los clientes las ven en el orden de importación de tools/__init__.py (situate primero).
Situate y eventos en tiempo real (tools/realtime_events.py)
| Herramienta | Endpoint del backend | Qué hace |
|---|---|---|
situate(symbols, window_days, question) | GET /get-company-event-web + GET /get-event-ontology + GET /is-market-open | La primera llamada. Compone la red de eventos (qué le ocurrió a esta empresa), la ontología (qué implica ese tipo de evento, qué lo sigue, dónde vive su carga útil tras la caché de 12 h, cuándo se actualiza cada tabla) y el estado del mercado en lo que está ocurriendo ahora, más un plan ordenado de llamadas de herramientas exactas, una lista skip de llamadas que no devolverían nada y guidance con alcance a la situación. El plan comienza en el tipo de evento en tiempo real que nombra la pregunta (EVENT_VOCABULARY en situate.py cubre todos los tipos en list_options("event_types")); una pregunta que nombra solo una familia recorre su episodio, una que no nombra nada recorre todos los episodios — no hay familia por defecto, y explore_data_catalogue nunca se planifica para una pregunta de "hoy" a nivel de mercado. La composición está en situate.py (funciones puras; python tests/test_situate_routing.py); sin nueva ruta de backend. Pública, síncrona |
list_realtime_events(event_type, tickers, sector, industry, market_cap) | POST /get-realtime-events | Extrae eventos en vivo (actualizaciones de EPS, transcripciones, calificaciones, …) de la caché de 12 h |
get_company_snapshot(symbol) | GET /get-company-snapshot | Instantánea estructurada: tesis, fundamentales, técnicos, precios objetivo, propiedad, calificaciones |
get_company_event_web(symbol, window_days, max_nodes) | GET /get-company-event-web | El porqué detrás de la instantánea — el grafo de eventos recientes de la empresa: nodos de evento/data_update ordenados por tiempo con pistas fetch y aristas tipadas (same_chain_run / lineage / co_occurrence). Combínalo con get_company_snapshot y llámalo antes de encadenar una solicitud dirigida de list_realtime_events / explore_data_catalogue / informe en un símbolo |
get_event_ontology(event_type, family, relation, format) | GET /get-event-ontology | La ontología a nivel de clase detrás de la red de eventos — qué implica un tipo de evento: las tablas que se escriben cuando se activa (por capa), los eventos que suelen seguir (tasa observada / retraso), dónde vive la carga útil tras la caché en tiempo real de 12 h (persisted_in), qué flujo de trabajo actualiza cada relación y su next_run_at (la comprobación de frescura), y qué herramienta la lee. Independiente del símbolo, pública, cacheable — llámala primero en cualquier solicitud basada en eventos y únela al type / relation / family de un nodo de la red |
Transmisión de eventos (tools/event_subscriptions.py)
La entrega por defecto para una solicitud de transmisión en vivo es un panel (en Claude, un Artifact) cuya página recorre stream_events con su cursor. Las instrucciones del servidor y los docstrings de las herramientas de transmisión lo indican.
| Herramienta | Endpoint del backend | Qué hace |
|---|---|---|
stream_events(topics, symbols, cursor, max_events, max_wait_seconds) | GET /events (SSE) | Entrega push, ad hoc. Una lectura acotada del flujo de eventos en tiempo real: devuelve tras max_events eventos coincidentes o max_wait_seconds (máx. 55 s) con {events, cursor, closed} — cada evento es el mismo objeto que devuelve list_realtime_events, en el momento de su publicación. Filtra en línea por topics (tipos de evento o familias de list_options("event_types"), más el tema report_plan solo de transmisión — un marco cada vez que se guarda un plan de informe) y symbols. Sin estado en el servidor: siempre devuelve el cursor recibido o la siguiente llamada comenzará en "ahora" (autenticado) |
register_event_subscription(topics, symbols) | POST /register-subscription | Guarda un filtro en el servidor → {subscription_id, filter, cursor, created_at}. Solo se entregan eventos publicados tras el registro; conserva el id (aún no hay endpoint de listado). 30/hora (autenticado) |
stream_event_subscription(subscription_id, cursor, max_events, max_wait_seconds) | GET /event-subscription/{id} (SSE) | Entrega push, reanudable. Misma forma de lectura acotada que stream_events, pero la API guarda el cursor cuando la lectura se cierra, de modo que las llamadas repetidas ven cada evento coincidente exactamente una vez sin contabilidad de cursor; cursor solo anula la posición guardada para una conexión. closed: "subscription deleted" significa dejar de reconectar; 404 cubre tanto un id inexistente como el id de otro usuario (autenticado) |
delete_event_subscription(subscription_id) | DELETE /event-subscription/{id} | Elimina una suscripción guardada; cualquier flujo abierto en ella termina con un marco closed dentro de un ciclo de lectura (autenticado) |
Informes y plantillas PDF (tools/pdf_reports.py)
| Herramienta | Endpoint de backend | Qué hace |
|---|---|---|
get_latest_report(symbols) | POST /get-cached-reports | La vía rápida para uno o más tickers con nombre. Un símbolo con un plan guardado reciente llega a rendering ({task_id, status, symbol}): el backend extrae el JSON del plan y lo renderiza en la plantilla del usuario en ~10-20 s — consulta get_task_status para {"pdf": ...}. Cualquier otro símbolo regresa como su PDF en caché (URL prefirmada + base64 en línea, con generated_at, age_hours, latest_event_at, stale) o en missing. stale: true significa que el plan en sí está desactualizado — solo una reconstrucción generate_report_for_stock(ticker) (~10 min) lo refresca. 500/hora |
list_available_reports(event_types, report_date) | POST /list-available-reports | Inventario de planes de informes guardados creados en o después de report_date (YYYY-MM-DD, hoy por defecto; los planes permanecen renderizables durante 7 días, así que pasa una fecha anterior para el inventario en curso — una lista vacía significa que no se planeó nada en la ventana, no que no haya investigación) — cada símbolo cuyo evento material (eps_update, eps_release, 8k_release, financials_release, ir_publication, transcript_update; company_update nocturno) guardó un plan, del más reciente al más antiguo, cada uno con event_type, planned_at, queued_at, source y una bandera fresh que aplica la misma regla que usa /get-cached-reports: true → get_latest_report([ticker]) lo renderiza en ~10-20 s, false → solo una reconstrucción generate_report_for_stock (~10 min) lo refresca. Filtra por event_types; amplía con report_date (una fecha malformada es un 422). El chequeo entre list_realtime_events (lo que acaba de publicarse) y get_latest_report (tráelo), o la forma directa de ver qué investigación en tiempo real está disponible ahora |
generate_report_for_stock(ticker, user_override, financial_items, as_reported_financial_items, ratios, revenue_segment, technical_analysis_items, estimate_items, institutional_ownership, include_as_report_financials, as_reported_periods) | POST /create-full-report | Solo reconstrucción completa (~10 min) — úsalo con moderación. Estándar (solo ticker): reconstruye y guarda el plan de informe del símbolo; la llamada a hacer solo cuando get_latest_report devolvió el ticker stale o missing y el usuario quiere esperar — nunca para un símbolo en rendering. Personalizado (user_override=true + listas de configuración): una construcción completa (~10 min, no guardada) alrededor de las partidas, ratios, conceptos según lo informado, segmentos, indicadores, estimaciones o CIKs de gestores que el usuario nombró; la herramienta activa el interruptor siempre que un campo de configuración no esté vacío. Las solicitudes a medida normalmente son explorar → idear → superponer en la plantilla en su lugar. Asíncrono → {ticker: {task_id, status}} |
generate_research_report(query, delivery) | POST /generate-research-report | Inmersión profunda (~10-12 min, asíncrono) — informe de nivel analista, solo cuando el usuario pide explícitamente un informe completo → {task_id, status} |
download_pdf_from_url(url, file_name) | POST /download-pdf-from-url | Obtener una URL PDF S3 prefirmada del lado del servidor (protegida contra SSRF) y devolverla en línea como base64 — p. ej. un get_latest_report url en clientes que no pueden abrir el enlace (autenticado) |
draft_user_template(template, template_type, anchor) | POST /draft-user-template | Paso 1 de 2 para el formato PDF propio de un usuario: compila una página HTML en un plano bajo varios tratamientos y renderiza cada uno como vistas previas PNG prefirmadas del documento de muestra de la plataforma — una de cada tipo de contenido (título, encabezado, secciones, viñetas, tarjetas KPI, tablas, gráficos, figura, línea de fuente, nota al pie); un add_on a su ancho de columna en el informe, un bespoke como páginas completas — además de un draft_id. El usuario aprueba cómo el diseño trata cada tipo de contenido, no el texto de muestra. No se almacena nada — el borrador vive 24 h (autenticado, 30/min) |
save_user_template(draft_id, variant_id, template, template_type, anchor) | POST /save-user-template | Paso 2 de 2: pasa draft_id + el variant_id elegido y el tratamiento revisado se guarda; o pasa template + template_type (+ anchor) directamente para omitir las vistas previas (solo HTML — markdown es un 422). Una plantilla por usuario — upsert, guardar reemplaza la anterior. Devuelve {status: "SAVED", template_type, anchor, bytes, patterns, tones, warnings} — los tipos de contenido que el diseño estiliza y sus clases de tono (autenticado, 100/min) |
update_user_template(template, template_type, anchor, draft_id, variant_id) | PUT /update-user-template | Cambiar la plantilla guardada — cualquier campo (los campos omitidos conservan sus valores almacenados), o sin campos para recompilarla como está almacenada con el compilador actual. Asíncrono: {task_id, status: "PENDING", changed, next_step} → consulta get_task_status para {status: "SAVED", patterns, tones, warnings}. 404 = aún no hay nada guardado (guarda primero); 422 = errores de validación (autenticado) |
get_user_template() | GET /get-user-template | La plantilla guardada del llamante (template_type, template_format, anchor, template saneado, marcas de tiempo). 404 = no hay ninguna guardada; un 503 significa que la tabla del backend aún no se ha creado, no "nada guardado". También el marcado para componer un PDF elaborado por agente |
delete_user_template() | DELETE /delete-user-template | Eliminar la plantilla guardada — permanente, los PDF vuelven a los diseños estándar; la propiedad se aplica en la cláusula WHERE |
Exploración de datos, citas y consultas guardadas (tools/data_exploration.py)
| Herramienta | Endpoint de backend | Qué hace |
|---|---|---|
explore_data_catalogue(query) | POST /data-catalogue-exploration | Ruta predeterminada — EDA rápida e interactiva contra la plataforma de datos → conjuntos de resultados para renderizar como gráficos/tablas (solo panel, 20/hora) → {task_id, status} |
explore_data_coverage(query) | POST /data-coverage-exploration | Conteos de cobertura y desgloses — cuántos símbolos tienen un conjunto de datos (mazos de IR, transcripciones, 13F, información privilegiada, estimaciones…), por sector / industria / país / capitalización de mercado / año, y hasta dónde llega el historial. Público: no se necesita cuenta, así que los prospectos pueden preguntar qué cubre la plataforma |
get_signed_sql_drilldown(encrypted_query_token, prompt, values, max_rows) | GET /query-data | Seguir el signed_query_url de un nodo get_company_event_web (o su token t desnudo) hasta las filas detrás de él — nuevo registro marcado is_new_record: true, más filas de contexto; los tokens solo los acuña el servidor, nunca se construyen. values opcional (relleno de ranura tipado, sin LLM) y prompt (lenguaje natural, completa lo que values dejó fuera) reorientan un token que es un gemelo de marcador de posición hacia otras entidades; max_rows limita la carga útil, y una respuesta segmentada lleva row_count + truncated: true (autenticado) |
trace_data_sources(relation, keys, column, encrypted_query_token, prompt, values, max_documents, resolve_passages) | GET /trace-sources | Citas — resolver números de filas explore_data_catalogue / run_saved_query / get_signed_sql_drilldown de vuelta a la presentación, sección o cita verificada de la que se leyeron. Prefiere relation + keys (cada columna identificadora, incl. el período) sobre un token |
get_document_section(symbol, year, quarter, n, name) | GET /query-section | Abrir una sección numerada de un documento fuente — el turno exacto del orador en la llamada de resultados al que apunta una cita trace_data_sources. Lee los cuatro valores de la URL de la cita; year / quarter son el período fiscal de la llamada, no el trimestre calendario |
save_user_query(user_request, query_tokens) | POST /save-user-query | Guardar los query_token opacos de un resultado de explore_data_catalogue bajo las propias palabras del usuario, para que la solicitud pueda reproducirse sin replanificarla. Devuelve {msg, id, placeholder_status} — id es la clave de eliminación; PENDING significa que el backend está creando un gemelo de marcador de posición de cada consulta más el esquema de ranura metadata de la fila (~10 s a 5 min) para que la solicitud pueda rehacerse luego para otras entidades; NOT_DISPATCHED significa solo reproducción exacta (autenticado, con alcance del propietario; sin upsert — guardar dos veces crea dos filas, 100/min) |
list_saved_queries(limit) | GET /get-saved-queries | Las solicitudes guardadas del llamante, de la más reciente a la más antigua — id (lo que toma la eliminación), queries (los tokens para una reproducción exacta), query_placeholder (los tokens gemelos, alineados por índice con queries), user_request (la etiqueta propia del usuario) y metadata: el summary de la fila (una línea, ranuras entre llaves), esquema de ranura parameters ({name, type, description, example} — las claves de run_saved_query(values=…)), entities, datasets, topics, result_schema por consulta, stale, run_count, last_run_at. Empareja una pregunta por metadata, no por la etiqueta, y omite las filas stale; metadata y query_placeholder son null hasta que la tarea de marcador de posición haya corrido. Un 503 significa que la tabla del backend aún no se ha creado, no "nada guardado" |
run_saved_query(query_tokens, prompt, values, max_rows) | GET /query-data | Reproducir una solicitud guardada: cada token corre contra datos en vivo, de forma síncrona, en el orden dado (máx. 25) — solo filas, nunca SQL; segundos en lugar de un trabajo de planificación de ~1-5 min, y sin gastar el presupuesto de exploración de 20/hora. Con tokens query_placeholder, values (clave por metadata.parameters, relleno de forma determinista sin LLM — las ranuras de conjunto de entidades toman filas [{id, name}] y un nombre sin id se resuelve del lado del servidor) reorienta las consultas guardadas; prompt ("los últimos 8 trimestres de ventas de KSS") llena solo lo que values dejó fuera, y una ranura que ninguno cubre conserva su ejemplo guardado. La respuesta lleva parameters, defaulted_parameters y ignored_values; un 422 significa que la solicitud no pudo mapearse — recurre a explore_data_catalogue. Pasa siempre max_rows (p. ej. 500): el compañero _constituents de una fila devuelve 7,000–35,000 filas sin límite |
delete_saved_query(query_id) | DELETE /delete-saved-query | Eliminar una solicitud guardada por id — permanente, y los tokens se van con ella; el 404 cubre deliberadamente tanto "no existe tal id" como "no es tuyo" |
Datos de mercado (tools/market_data.py)
| Herramienta | Endpoint de backend | Qué hace |
|---|---|---|
get_technical_indicator_data(symbol, indicator, start_date, end_date) | GET /technical-indicator-endpoint | Historial diario de un indicador técnico (de list_options("technical_indicators")) en un rango YYYY-MM-DD inclusivo (autenticado) |
detect_intraday_outlier_jumps(symbol, frequency, zscore_threshold) | GET /detect-intraday-outlier-jumps | Vista en vivo de la cinta de 1 min de hoy; en frequency (de list_options("intraday_frequency")); marca barras cuyo movimiento es un valor atípico de sigma diario (síncrono, autenticado) |
get_aftermarket_data(symbols, start_datetime, end_datetime) | POST /get-aftermarket-data | Consultar barras almacenadas de 15 minutos fuera de horario (apertura/máximo/mínimo/cierre/volumen, 16:00-20:00 ET) para símbolos en un rango de fecha-hora ET; filas ordenadas por símbolo, hora de barra DESC (por defecto hoy, autenticado, 300/min) |
predict_earnings_move(symbols) | POST /predict-earnings-announcement-move | Tamaño esperado del movimiento de cada acción en su próxima reacción de resultados (p. ej. NFLX expected_move 0.10, alrededor del 10%), junto a su propio promedio histórico |
list_earnings_announcements(start_date, end_date, symbols, industry, sector, market_cap) | POST /list-upcoming-earnings-announcements | Anuncios de resultados programados en una ventana de fechas (ambos por defecto hoy), solo nombres cubiertos; sector / industry / market_cap validados del lado del servidor (422 en un valor incorrecto) |
is_market_open(exchange) | GET /is-market-open | ¿Está abierto un intercambio ahora (código sensible a mayúsculas, por defecto NYSE) — enruta entre detect_intraday_outlier_jumps (abierto) y get_aftermarket_data (cerrado). Público |
Cribado, carteras y estrategias (tools/strategies.py)
| Herramienta | Endpoint de backend | Qué hace |
|---|---|---|
screen_stocks(metrics, sectors, sub_sectors, market_cap, analyst_ratings, institutional_ownership, countries, price_performance) | POST /screen-stocks | Cribar el universo por métricas de crecimiento, sector / subindustria, capitalización de mercado, calificaciones de analistas, propiedad institucional, país y rendimiento de precio. Asíncrono → {task_id} (10/hora) |
optimize_portfolio_default(symbols, risk_tolerance) | POST /optimize-symbols-non-llm | Optimizador predeterminado — ponderaciones optimizadas por riesgo para una lista de tickers, síncrono, sin LLM; tickers no admitidos en missing, los de historial corto en dropped. Público |
optimize_portfolio(symbols, risk_tolerance, delivery) | POST /optimize-symbols | Variante más lenta curada por LLM: puntuación de múltiples señales + curación por LLM + optimización de riesgo. Asíncrono → {task_id} (10/hora) |
get_stock_picks(strategy_name) | GET /get-stock-picks | Últimas selecciones de acciones elegidas por LLM para el rebalanceo actual (opcionalmente una estrategia) |
get_strategy_performance_summary(amount) | GET /get-strategy-performance-summary | Tabla de clasificación de cada libro de estrategia vs el S&P 500 desde su inicio (retorno, exceso, Sharpe, drawdown, YTD, crecimiento de amount) — la primera parada para "¿cómo van las selecciones?" |
get_strategy_track_record(strategy_name, book, amount) | GET /get-strategy-track-record | La serie diaria desde el inicio de un libro vs el S&P 500 más estadísticas principales; book = llm (por defecto) o mechanical, strategy_name puede ser pooled |
get_strategy_swaps(strategy_name) | GET /get-strategy-swaps | Libro mayor por operación de adiciones / eliminaciones semanales, cada una medida contra el S&P 500 (eliminaciones como retorno renunciado) |
Programación (tools/scheduling.py)
| Herramienta | Endpoint de backend | Qué hace |
|---|---|---|
schedule_task(name, steps, regular_cron, delivery, description) | POST /save-user-workflow | Guarda un flujo de trabajo de 1 a 8 pasos (fetch endpoints permitidos + transform pasos) y adjunta una entrega recurrente por cron; actualiza o inserta mediante slug en minúsculas name |
list_scheduled_tasks() | GET /get-scheduled-tasks | Los trabajos cron del llamante (name, schedule, enabled, last_run_at, total_run_count); los trabajos de flujo se nombran wf:{email}:{workflow-name} |
delete_scheduled_task(task_name) | DELETE /delete-scheduled-task | Elimina un trabajo cron por el name completo de list_scheduled_tasks; la definición del flujo guardado se conserva |
Utilidades y facturación (tools/utility.py)
| Herramienta | Endpoint de backend | Qué hace |
|---|---|---|
get_task_status(task_id) | GET /task-status | Consulta un trabajo asíncrono para SUCCESS y lee su result |
list_options(kind, ticker, q, cik) | GET /list-realtime-event-options, /list-financial-items, /list-financial-ratios, /list-as-reported-items?ticker=, /list-revenue-segments?ticker=, /list-institutional-managers?q=&cik=, /get-sectors, /list-institutional-investor-types, /list-countries, /get-fiscal-quarter, /list-marketcap-options, /list-intraday-chart-options, /list-technical-indicators, /list-tickers, /list-symbols-with-names | Una herramienta de catálogo: enumera valores válidos para un parámetro (tipos de evento, partidas, ratios, conceptos XBRL propios del declarante y segmentos de ingresos (ticker), gestores institucionales por fragmento de nombre / CIK (q / cik), sectores, tipos de inversor, países, trimestre fiscal, tramos de capitalización bursátil, frecuencias intradía, indicadores técnicos y el universo de tickers con o sin nombres de empresa) |
list_sub_industries(sectors) | GET /get-sub-industries | Industrias distintas dentro del sector o sectores dados |
onboard_symbol(symbol) | POST /onboard-symbol | Solicita la incorporación de un ticker no cubierto (asíncrono, autenticado, 5/hora) |
upgrade_plan() | GET /payment/upgrade-link | Enlace de pago para actualizar o cambiar el plan del usuario (p. ej., tras alcanzar una cuota); el pago se completa en el navegador |
manage_billing() | GET /payment/portal-link | Enlace al portal de facturación de Stripe: facturas, tarjeta, cancelación |
Para una única empresa nombrada, get_company_snapshot y get_company_event_web son el par estándar: las dos mitades de la misma pregunta, normalmente llamadas juntas. La instantánea es el qué (dónde está la empresa ahora: tesis, fundamentales, técnicos, propiedad, calificaciones); la red de eventos es el porqué (el episodio detrás de ello: publicación de resultados → 8-K → actualización de transcripción → publicación de IR → reacción de analistas, con aristas que indican cómo se relaciona cada uno). Una instantánea por sí sola es un veredicto sin evidencia; la red es la evidencia. La red es también la llamada de fundamentación barata que hace preciso el resto del bucle: cada nodo lleva la llamada de seguimiento exacta, por lo que la siguiente list_realtime_events, explore_data_catalogue o solicitud de informe lleva tipos de evento y fechas reales en lugar de suposiciones.
Bucle típico de agente: por defecto usar explore_data_catalogue(query) para preguntas abiertas o exploratorias (rápido, con gráficos y tablas interactivos). Escalar solo ante una intención clarísima: get_latest_report(symbols) para el informe existente de un ticker nombrado, screen_stocks(...) para filtrar el universo, o generate_research_report(query) para una inmersión profunda explícita (~10-12 min, asíncrona — consultar con get_task_status).
¿La misma pregunta dos veces, o la misma pregunta sobre otra empresa? explore_data_catalogue replanifica su SQL cada vez, así que cuando una exploración termina el agente ofrece guardarla: save_user_query almacena sus query_token, y el backend crea un gemelo de marcador de posición de cada consulta — elevando el ticker, la lista de CIK, la fecha, el intervalo y el recuento a ranuras tipadas — junto con el metadata de la fila, que nombra esas ranuras y resume lo que pide la fila. run_saved_query reproduce entonces el queries de la fila exactamente (las mismas consultas contra datos en vivo, en segundos, sin paso de planificación, sin consultas), o toma los tokens query_placeholder de la fila más los values tipados para reorientar la solicitud hacia otras entidades: "las últimas 8 trimestres de ventas de TGT" guardado ayer responde "las últimas 8 trimestres de ventas de KSS" hoy, de forma determinista y sin modelo de lenguaje en el relleno, devolviendo el parameters sustituido (y cualquier defaulted_parameters / ignored_values) junto a las filas; un prompt sigue cubriendo lo que el agente no puede escribir. list_saved_queries es lo que hay que comprobar antes de cualquier exploración, comparando la pregunta con el metadata de cada fila — summary, parameters, datasets — en lugar de su etiqueta user_request, y omitiendo filas marcadas como stale; delete_saved_query elimina una. Pasa max_rows en cada reproducción y elige las consultas a ejecutar de metadata.result_schema para que el compañero _constituents (7.000–35.000 filas) quede fuera de la llamada. Los tokens son texto cifrado opaco que el backend acuñó: pásalos sin cambios, nunca construyas ni edites uno, y nunca lo muestres al usuario.
¿Quieres informes en tu propio formato? Un usuario proporciona una página HTML — membrete, colores, maquetación, marca — y se guarda como plano: la hoja de estilos y el marco de página del autor más un patrón de marcado por tipo de contenido, que el backend aplica automáticamente a cada PDF que renderiza para ese usuario (get_latest_report renderiza planes nuevos, generate_report_for_stock reconstrucciones, estándar y personalizadas, e informes programados). Una plantilla es estructura y estilo aplicados al contenido propio del documento: nadie rellena el marcado de la plantilla y ninguna otra llamada cambia. Es una elección visual, por lo que se aprueba mirando: draft_user_template compila la página bajo varios tratamientos y renderiza cada uno como vistas previas PNG del documento de muestra de la plataforma (un add_on reestiliza una sección del diseño estándar, nombrada por anchor; un bespoke impulsa todo el documento), el usuario elige uno y save_user_template(draft_id, variant_id) almacena ese tratamiento — una plantilla por usuario, actualizada o insertada. update_user_template cambia cualquier campo más tarde, o recompila el diseño guardado cuando se llama sin argumentos; get_user_template muestra lo que está en vigor; delete_user_template devuelve al usuario a los diseños estándar.
No hay un constructor de PDF impulsado por agente: las herramientas build_pdf_full_width / build_pdf_sidebar (backend /create-pdf y /create-pdf-sidebar) y el catálogo pdf_options se retiraron en favor de las plantillas. Cuando un usuario quiere un documento compuesto a partir de datos de Flexreport que ningún informe de backend cubre — incluida una versión a medida de un informe de empresa ("el informe de SNOW, construido en torno a ingresos de producto y RPO") — el agente explora los elementos que nombró, idea con ellos sobre los conjuntos de resultados y construye el PDF con su propia herramienta de documentos, superponiendo los resultados acordados en la plantilla guardada del usuario (get_user_template) cuando existe — y ofreciendo redactar una (borrador → vista previa → guardar, luego actualizar) cuando no existe.
Los informes son bajo demanda: nada se regenera hasta que alguien lo pide. Los dos endpoints de informe están estrictamente separados:
get_latest_report→/get-cached-reportses la vía rápida. Un plan de informe guardado es JSON — resumen, consultas, resultados, mapa de formato — construido en el momento en que un evento material se publica para un símbolo (o mediante una reconstrucción) y actualizado cada noche mientras sus entradas sigan cambiando. Cuando el plan de un símbolo está fresco (tiene un mapa de formato, tiene menos de 7 días, no es más antiguo que las últimas entradas de informe del símbolo, lee el lado correcto de la división EDGAR/FMP), el endpoint no devuelve un PDF preconstruido: renderiza ese plan en la plantilla del usuario en ~10-20 s y lista el símbolo bajorenderingcon untask_idpara consultar. Cada otro símbolo vuelve como su PDF en caché etiquetadostale(true= el plan en sí está desactualizado — una impresión, una presentación, una actualización de 13F llegó después) o cae enmissing.generate_report_for_stock→/create-full-reportes una reconstrucción completa (~10 min), usada con moderación. El agente la llama solo con el ticker únicamente cuandoget_latest_reportdevolvió el símbolostaleomissingy el usuario quiere esperar; el plan reconstruido se guarda, por lo que llamadas posteriores aget_latest_reportlo renderizan en segundos. Nunca para un símbolo enrendering, y nunca distribuido en una lista.- Las solicitudes a medida pasan por exploración, no por reconstrucción. El agente explora los elementos que el usuario nombró (
list_saved_queries, luegoexplore_data_catalogue), idea con ellos sobre los conjuntos de resultados y superpone los resultados acordados en su plantilla (get_user_template) con su propia herramienta de documentos.
list_available_reports(event_types, report_date) es el inventario de esos planes guardados, limitado a planes construidos en o después de report_date (por defecto hoy) — qué símbolos tienen investigación en tiempo real lista y si cada uno es fresh (get_latest_report lo renderiza en segundos) o requeriría reconstrucción (minutos) — para que el agente pueda pasar de list_realtime_events (un evento publicado) a un informe fresco sin adivinar, u omitir el paso de eventos y listar lo disponible directamente. Para "traer los informes más relevantes hoy", los eventos son el filtro y los planes son la verificación de disponibilidad, en ese orden: trae los tipos materiales (transcript_update, 8k_release, ir_publication, eps_release, financials_release) y la cinta (biggest_mover, biggest_loser), lee el contenido, confirma la importancia contra la acción de precios intradía (detect_intraday_outlier_jumps), compara los supervivientes con planes usando list_available_reports(event_types=[...]) y trae solo aquellos con get_latest_report. situate muestra esto como sugerencia en cada plan de todo el mercado, llevando report_date cuando la ventana de tiempo real de 12 h se abrió en una fecha UTC anterior. Solo una solicitud explícita del propio informe del pipeline reconstruido en torno a elementos nombrados lo convierte en un informe personalizado — user_override=true más las listas de configuración (financial_items, ratios, as_reported_financial_items, revenue_segment, technical_analysis_items, estimate_items, institutional_ownership CIKs, include_as_report_financials / as_reported_periods) — que es una construcción completa (~10 min) que nunca se guarda. El backend rechaza listas de configuración sin el interruptor (422), por lo que la herramienta lo establece siempre que un campo de configuración no esté vacío. Los vocabularios provienen de list_options: financial_items, financial_ratios, technical_indicators, y el as_reported_items / revenue_segments con ámbito de ticker y el institutional_managers con ámbito de q (devuelve CIKs). El contexto de eventos es propiedad del servidor: la solicitud no lleva tesis, resumen de cambios, include_* ni campos de fecha de precio.
Disposición del código
server.py            entrypoint: imports the tools package, adds /health, runs the transport
core.py              the FastMCP instance, server instructions and `_send` (backend forwarding)
client.py            shared httpx client + inbound-bearer forwarding
auth_verifier.py     OAuth resource-server token validation (RS256 via the backend JWKS)
situate.py           pure composition logic behind the `situate` tool
instructions.json    server instructions (non-code copy)
tools/
  realtime_events.py     situate, list_realtime_events, company snapshot / event web, event ontology
  event_subscriptions.py stream_events, register / stream / delete_event_subscription (SSE bounded reads)
  pdf_reports.py         get_latest_report, list_available_reports, generate_*, download_pdf_from_url, PDF templates
  data_exploration.py    explore_data_*, signed drilldowns, trace_data_sources, document sections, saved queries
  utility.py             get_task_status, list_options, list_sub_industries, onboard_symbol, billing
  market_data.py         technical indicators, intraday outliers, after-hours bars, earnings calendar + move prediction, market status
  strategies.py          screen_stocks, portfolio optimization, stock picks, strategy track records
  scheduling.py          schedule / list / delete scheduled tasks
Cada módulo hace from core import mcp, _send y se registra con @mcp.tool(...);
importar tools registra todo. tools/__init__.py fija el orden de importación,
que es el orden en que las herramientas se anuncian a los clientes (situar primero).
Ejecutar localmente
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp .env.example .env          # set API_BASE_URL, MCP_HOST, MCP_PORT
set -a && source .env && set +a
python server.py              # serves streamable-http on http://MCP_HOST:MCP_PORT/mcp
Autenticación
El servidor es un Servidor de Recursos OAuth 2.0 y sin estado (amigable con balanceadores de carga), por lo que la autenticación viaja en cada llamada. No contiene credenciales ni secreto de firma — valida el token de portador entrante y lo reenvía al backend, que aplica alcance, plan y cuota.
Cómo funciona
El inicio de sesión es un flujo estándar de código de autorización + PKCE en el navegador, ejecutado por tu cliente MCP (p. ej., Claude) contra el backend de FlexReport, que es el Servidor de Autorización. Regístrate o inicia sesión con correo electrónico + contraseña, o usa Google Sign-In — nunca pegas ni escribes un token:
- En una solicitud sin token válido, el servidor devuelve
401con un desafíoWWW-Authenticatey sirve Metadatos de Recursos Protegidos en/.well-known/oauth-protected-resource, apuntando al cliente al AS del backend. - El cliente abre tu navegador; inicias sesión / das consentimiento y recibe un token de acceso RS256 emitido por el backend.
- El servidor valida ese token en cada llamada — firma mediante el JWKS del
backend (clave pública RS256) más
aud,issyexp— y luego lo reenvía al backend. Inválido o caducado → un401limpio y el cliente vuelve a ejecutar el flujo. El servidor nunca ve tu contraseña y nunca retiene la clave de firma: permanece como un proxy sin credenciales. Solo se aceptan tokens OAuth RS256 válidos; no hay contraseña ni respaldo estático de JWT.
Configuración (env)
| Var | Default | Propósito |
|---|---|---|
OAUTH_ISSUER | https://app.flexreportfinapi.com | Token esperado iss + servidor de autorización anunciado. Debe coincidir con el iss del backend — producción usa el dominio raíz https://flexreportfinapi.com. |
OAUTH_AUDIENCE | = OAUTH_ISSUER | Token esperado aud. Configura ambos lados con la URL canónica de MCP para un enlace de audiencia real. |
OAUTH_JWKS_URL | {issuer}/.well-known/jwks.json | Dónde se obtienen las claves públicas (desacoplado del emisor para redes de contenedores). |
MCP_RESOURCE_URL | https://mcp.flexreportfinapi.com/mcp | Identificador de recurso canónico de este servidor (el PRM resource). |
Cabecera estática
Configura Authorization: Bearer <OAuth access token> en tu cliente MCP y el servidor lo valida y reenvía como cualquier otra llamada — útil para pruebas con un token emitido en otro lugar. No se almacena nada en reposo; los tokens se reenvían por llamada.
Conectar con un cliente MCP
.mcp.json (Claude Code):
{
  "mcpServers": {
    "flexreport": {
      "type": "http",
      "url": "http://localhost:8000/mcp",
      "headers": { "Authorization": "Bearer <YOUR_OAUTH_ACCESS_TOKEN>" }
    }
  }
}
Verificar con MCP Inspector
npx @modelcontextprotocol/inspector
# Connect to http://localhost:8000/mcp with header Authorization: Bearer <OAuth access token>
# Confirm the tools list loads (46 tools), then exercise:
#   list_realtime_events("eps_update")        -> events (or [])
#   get_company_event_web("NVDA")             -> event graph (or an empty/degraded web)
#   get_latest_report(["AAPL"])               -> rendering task_id, cached PDF url, or missing  [named-ticker report; max 100 symbols]
#   list_available_reports(["eps_release"])   -> plans built today with `fresh` flags (or []); report_date="YYYY-MM-DD" widens
#   explore_data_catalogue("MU EPS growth last 8 quarters")  -> task_id  [default exploratory route]
#   get_task_status(task_id)                  -> eventually SUCCESS
# Negative: connect with no/invalid token     -> 401 + WWW-Authenticate challenge
Desplegar
Construye la imagen y ejecútala como su propio contenedor (por ejemplo, un servicio ECS separado con su propia definición de tarea), independiente de la API y los workers de Celery. Configura API_BASE_URL con la URL del backend desplegado.
docker build -t flexreport-mcp .
docker run -p 8000:8000 -e API_BASE_URL=https://flexreportfinapi.com flexreport-mcp
Privacidad
La política de privacidad de FlexReport — qué se recopila, los períodos de retención y los terceros involucrados — se publica en app.flexreportfinapi.com/privacy (fuente: PRIVACY.md).