Cloudglue
Conecta Cloudglue con asistentes de IA, convirtiendo colecciones de video en datos estructurados para LLMs. Requiere una clave de API de Cloudglue.
Documentación
Cloudglue MCP Server


Conecta Cloudglue a Cursor, Claude Desktop y otros asistentes de IA para desbloquear el poder de la comprensión de colecciones de video. Cloudglue te ayuda a convertir tus videos en datos estructurados listos para LLMs.
📖 Recursos
- Model Context Protocol
- Documentación de la API de Cloudglue
- Términos de Servicio
- Política de Privacidad
- Precios
Al usar el SDK de Cloudglue y/o el servidor MCP, aceptas los Términos de Servicio de Cloudglue y reconoces nuestra Política de Privacidad.
Uso
Requisitos previos
Primero, obtén una clave de API de Cloudglue en cloudglue.dev; esta se usará para autenticar el servidor MCP con tu cuenta de Cloudglue.
A. En cualquier cliente MCP que use una configuración JSON
La mayoría de los clientes MCP almacenan su configuración como JSON. Para cloudglue-mcp-server esto se vería así:
{
  "mcpServers": {
    "cloudglue": {
      "command": "npx",
      "args": [
        "-y",
        "@cloudglue/cloudglue-mcp-server@latest",
        "--api-key",
        "<CLOUDGLUE-YOUR-API-KEY>"
      ]
    }
  }
}
Reemplaza <CLOUDGLUE-YOUR-API-KEY> con la clave de API creada anteriormente.
B. En Claude Desktop usando Extensiones de Escritorio
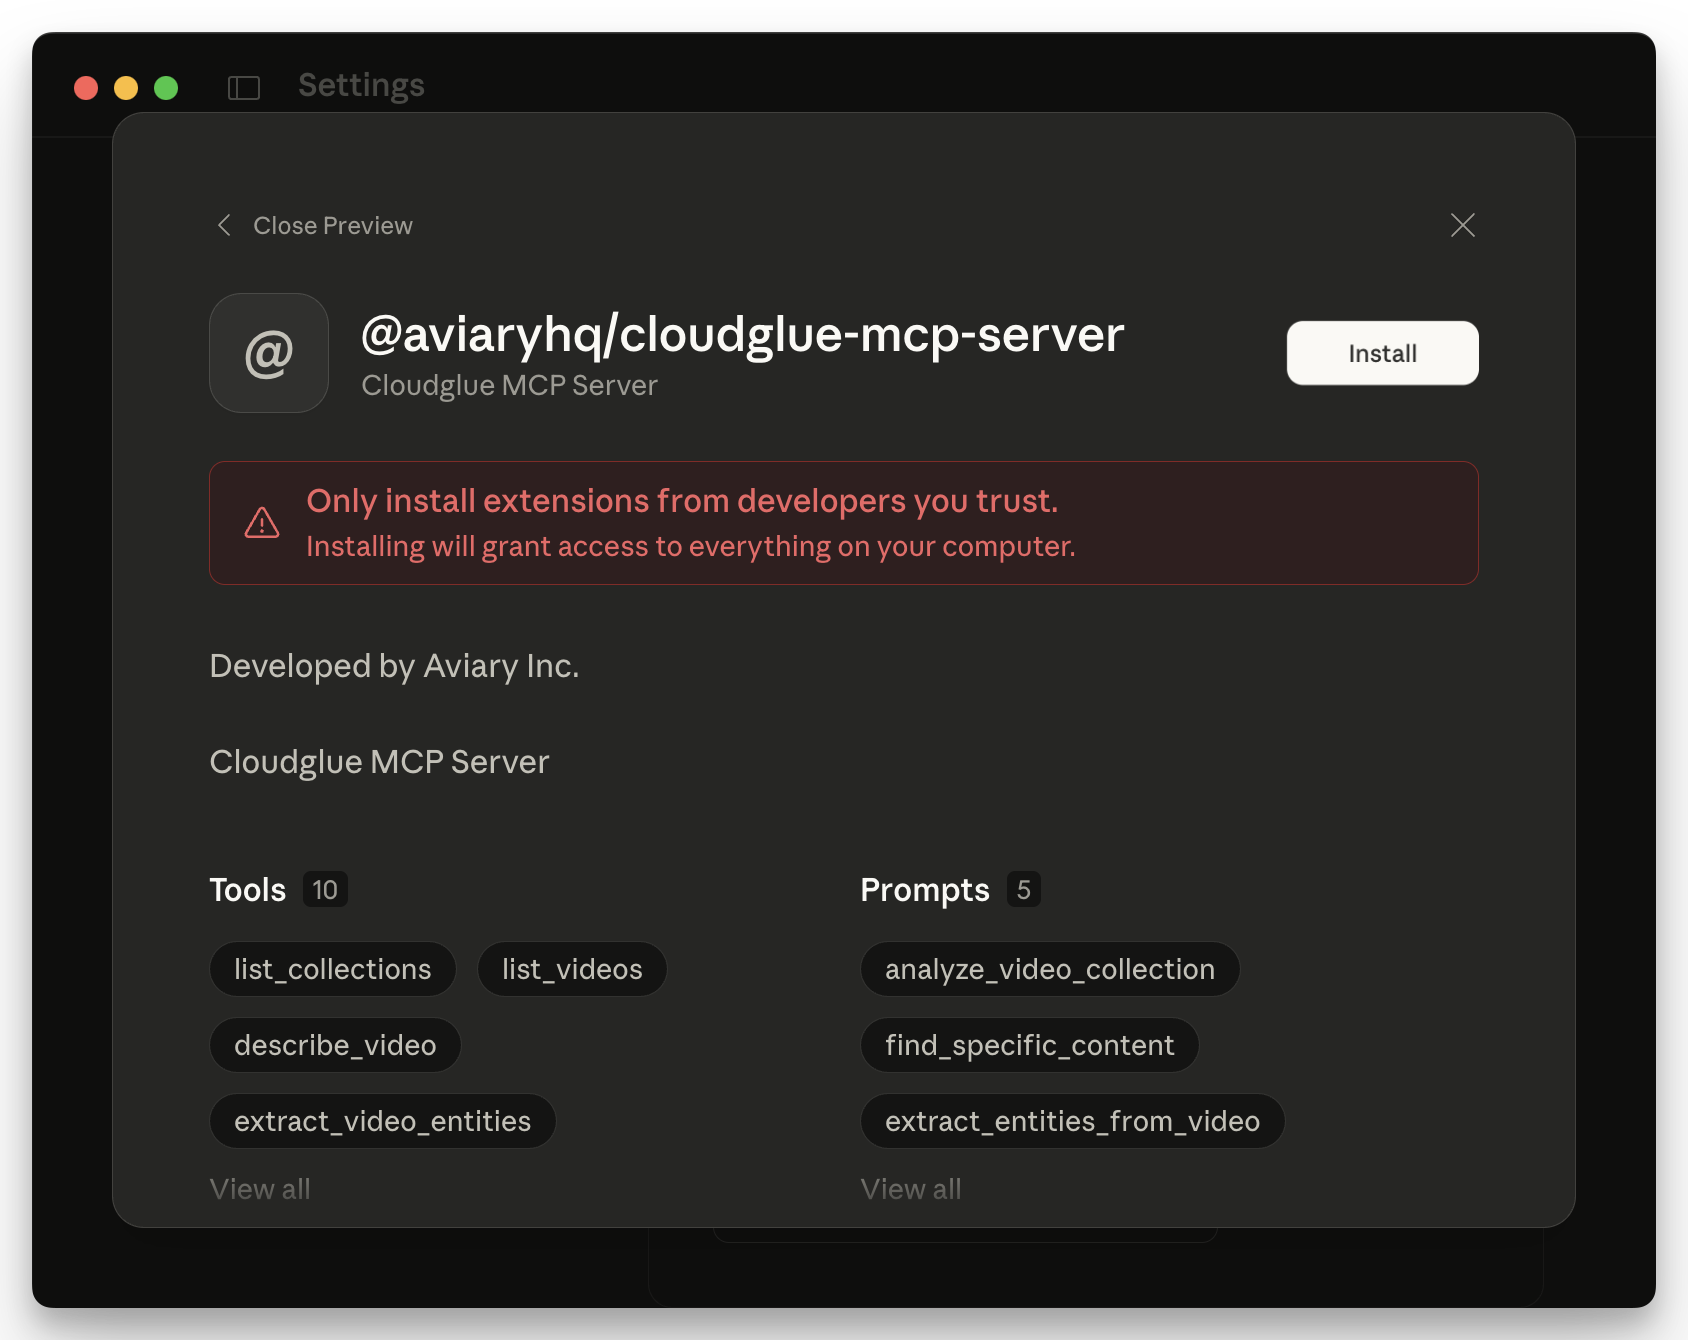
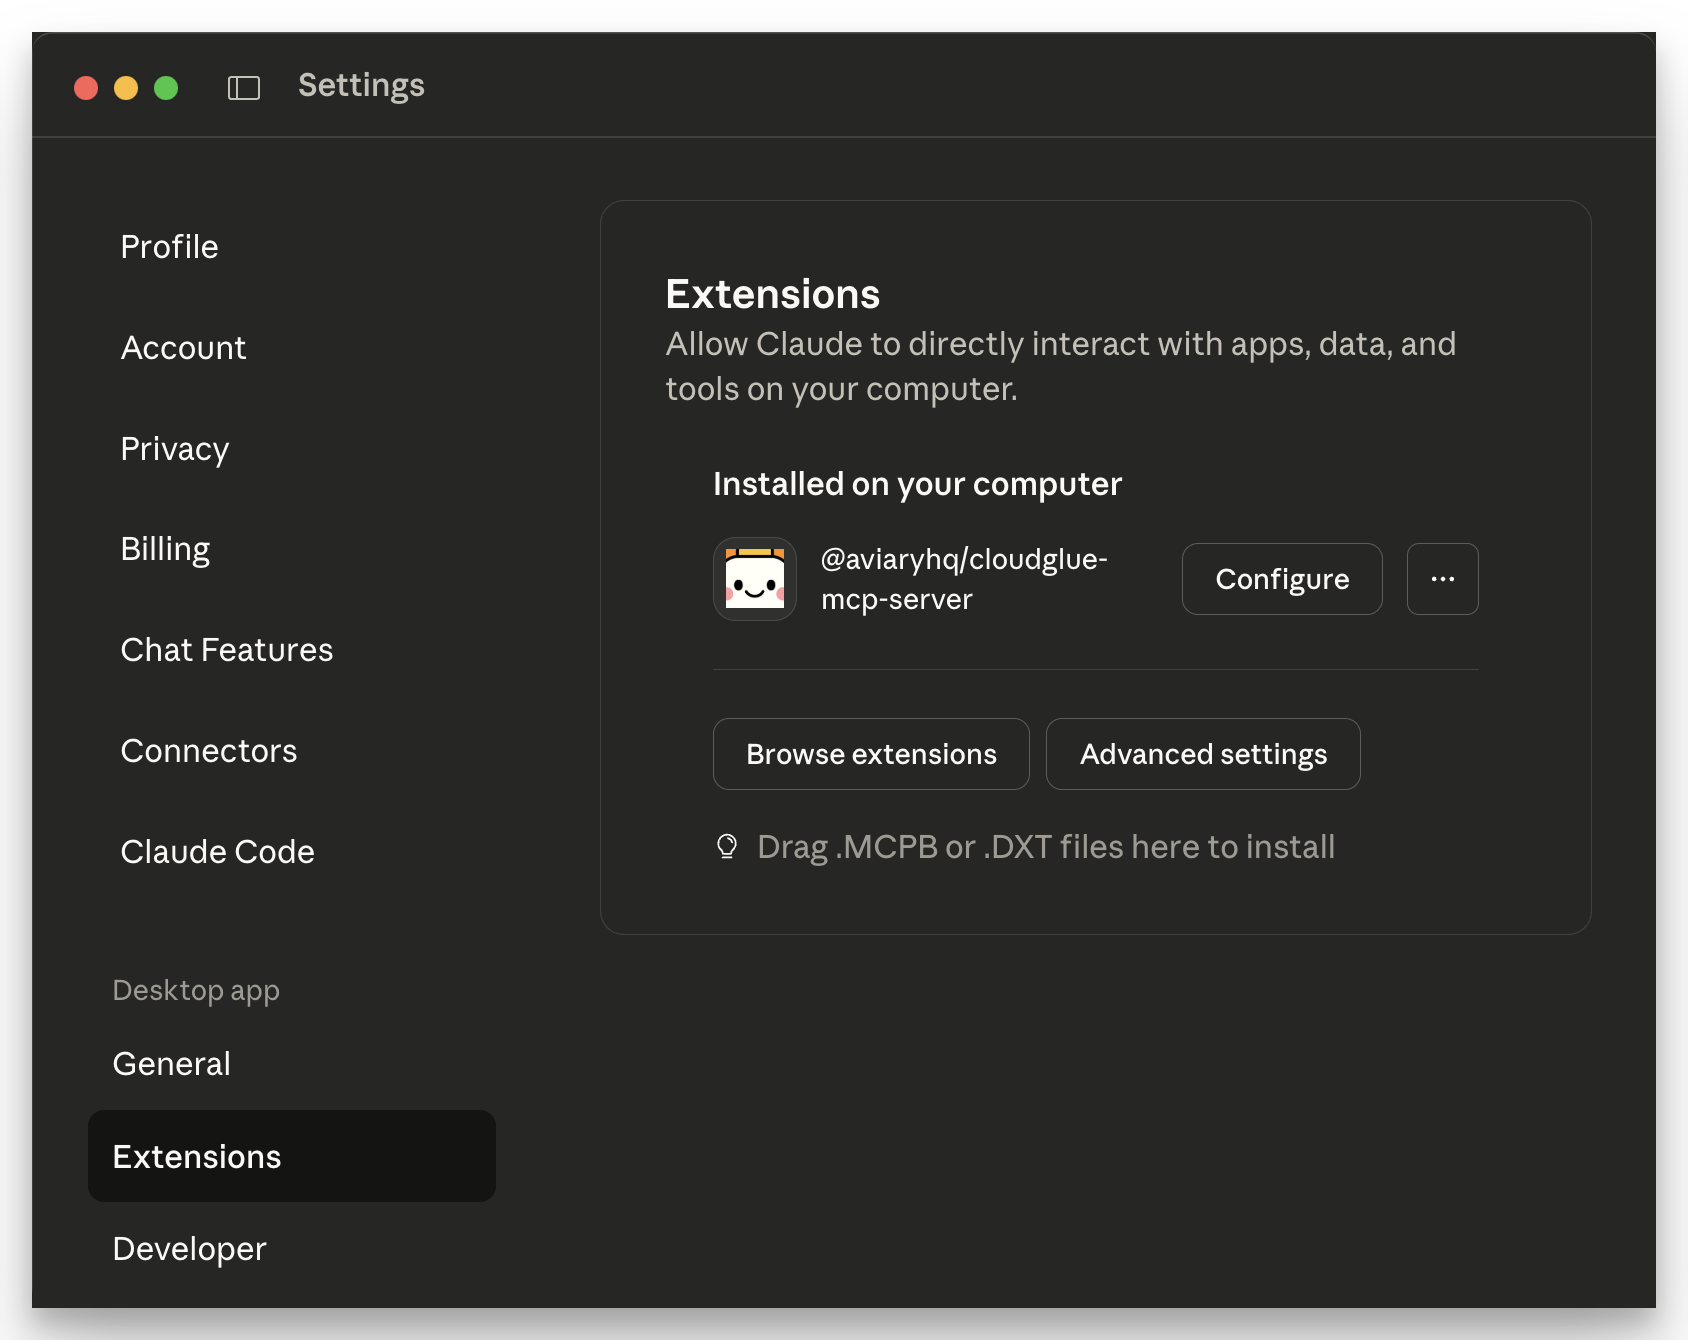
- Descarga la última extensión de Cloudglue para Claude Desktop desde la página de versiones
- Haz doble clic para abrirla con Claude Desktop (necesitas tener Claude Desktop ejecutándose antes de esto)
- Haz clic en 'Instalar'
- Cuando se te solicite, ingresa tu clave de API
- Habilita la extensión
Desarrollo Local
Requisitos previos
Primero, obtén una clave de API de Cloudglue en cloudglue.dev; esta se usará para autenticar el servidor MCP con tu cuenta de Cloudglue.
Compilar el servidor
- Clona el repositorio
- Instala las dependencias usando
npm install - Compila el servidor + la extensión de Claude Desktop usando
npm build
Configura tu cliente MCP
A continuación, configura tu cliente MCP (como Cursor) para usar este servidor. La mayoría de los clientes MCP almacenan la configuración como JSON en el siguiente formato:
{
  "mcpServers": {
    "cloudglue-mcp-server": {
      "command": "node",
      "args": [
        "/ABSOLUTE/PATH/TO/PARENT/FOLDER/cloudglue-mcp-server/build/index.js",
        "--api-key",
        "<CLOUDGLUE-YOUR-API-KEY>"
      ]
    }
  }
}
Documentación
Formatos de URL compatibles
El servidor MCP de Cloudglue admite múltiples formatos de URL para el análisis de video:
Plataforma Cloudglue (Predeterminado)
- Formato:
cloudglue://files/file-id - Uso: Usa el ID de archivo de la herramienta
list_videos - Ideal para: Videos ya subidos a Cloudglue
URLs de YouTube
- Formatos:
https://www.youtube.com/watch?v=...https://youtu.be/...
- Herramientas compatibles:
describe_video,extract_video_entities,segment_video_chapters - Nota: No compatible con
segment_video_camera_shots
URLs públicas de video HTTP
- Formato: Enlaces directos a archivos MP4 (p. ej.,
https://example.com/video.mp4) - Ideal para: Archivos de video de acceso público
URLs de conectores de datos
Requiere configuración en la cuenta de Cloudglue: consulta la Documentación de Conectores de Datos
-
Dropbox:
- Enlaces compartibles:
https://www.dropbox.com/scl/fo/SOME_ID/SOME_OTHER_ID?rlkey=SOME_KEY&st=SOME_TIME&dl=0 - Ruta directa:
dropbox://<path>/<to>/<file>
- Enlaces compartibles:
-
Google Drive:
- Formato:
gdrive://file/<file_id>
- Formato:
-
Zoom:
- UUID de reunión:
zoom://uuid/QFwZYEreTl2e6MBFSslXjQ%3D%3D - ID de reunión:
zoom://id/81586198865
- UUID de reunión:
Herramientas
Las siguientes herramientas de Cloudglue están disponibles para los LLMs a través de este servidor MCP:
Descubrimiento y Navegación
-
list_collections: Descubre las colecciones de video disponibles y sus metadatos básicos. Úsala primero para entender qué colecciones de video existen antes de usar otras herramientas específicas de colecciones. Muestra los IDs de colección necesarios para otras herramientas, los recuentos de videos y los tipos de colección. Para colecciones de tipo 'media-descriptions', usadescribe_videocon el parámetro collection_id para recuperar descripciones previamente extraídas de un archivo de Cloudglue determinado. Para colecciones de tipo 'entities', usaextract_video_entitiescon el parámetro collection_id para recuperar entidades previamente extraídas de un archivo de Cloudglue determinado. Paginación: Los resultados se paginan en 25 colecciones por página usando el parámetropage(página 0 = primeras 25 colecciones, página 1 = siguientes 25 colecciones, etc.). Cada respuesta incluye los campospageytotal_pages. Para una exploración exhaustiva, pagina a través de todas las colecciones incrementando el parámetropagehasta que hayas recuperado todas las páginas. -
list_videos: Explora y busca metadatos de video con potentes opciones de filtrado. Úsala para explorar los videos disponibles, encontrar contenido específico por fecha o ver qué hay en una colección. Devuelve información esencial del video como duración, nombre de archivo e IDs necesarios para otras herramientas. Paginación: Los resultados se paginan en 25 videos por página usando el parámetropage(página 0 = primeros 25 videos, página 1 = siguientes 25 videos, etc.). Cada respuesta incluye los campospageytotal_pages. Usa el filtrado por fecha para enfocarte en períodos de tiempo específicos y luego pagina dentro de esos resultados.
Análisis de Video Individual
-
describe_video: Obtén transcripciones y descripciones completas de videos individuales con optimización inteligente de costos y soporte de paginación. Verifica automáticamente si existen transcripciones antes de crear nuevas. Admite todos los formatos de URL: URLs de Cloudglue, URLs de YouTube, URLs públicas de video HTTP y URLs de conectores de datos (Dropbox, Google Drive, Zoom). Paginación: Los resultados se paginan en segmentos de 5 minutos usando el parámetropage(página 0 = primeros 5 minutos, página 1 = siguientes 5 minutos, etc.). Usastart_time_secondspara comenzar la paginación desde un índice de tiempo específico (por defecto 0). Combinado conpage, esto permite una navegación precisa:start_time_secondsestablece el desplazamiento base, ypageincrementa en segmentos de 5 minutos desde ese desplazamiento (p. ej.,start_time_seconds=600conpage=0devuelve 10-15 minutos,page=1devuelve 15-20 minutos). Cada respuesta incluye los campospage,total_pagesydescriptionen formato JSON. Usa la paginación para procesar eficientemente videos más largos recuperando descripciones en fragmentos manejables o apuntando a rangos de tiempo específicos. La paginación funciona de manera consistente tanto para descripciones de colecciones (al usarcollection_id) como para descripciones de videos individuales. -
extract_video_entities: Extrae datos estructurados y entidades de videos usando prompts personalizados con optimización inteligente de costos y soporte de paginación. Verifica automáticamente si existen extracciones antes de crear nuevas. Admite todos los formatos de URL: URLs de Cloudglue, URLs de YouTube, URLs públicas de video HTTP y URLs de conectores de datos (Dropbox, Google Drive, Zoom). La calidad de los resultados depende en gran medida de la especificidad de tu prompt. Paginación: Las entidades a nivel de segmento se paginan (25 segmentos por página) usando el parámetropage. Cada respuesta incluyevideo_level_entitiesysegment_level_entitiescon los camposentities,pageytotal_pagesen formato JSON. -
get_video_metadata: Obtén metadatos técnicos completos sobre un archivo de video de Cloudglue, incluidos duración, resolución, tamaño de archivo, estado de procesamiento y estadísticas calculadas. Devuelve resultados JSON estructurados con metadatos completos del archivo, información del video (resolución, fps, códec, etc.), marcas de tiempo de procesamiento y campos calculados. Úsala cuando necesites especificaciones de video, detalles del archivo o información de procesamiento en lugar de análisis de contenido. Es diferente de las herramientas centradas en contenido como describe_video. -
segment_video_camera_shots: Segmenta videos en tomas de cámara con optimización inteligente de costos. Verifica automáticamente si existen trabajos de segmentación de tomas antes de crear nuevos. Devuelve resultados JSON estructurados con una matriz de segmentos que contiene marcas de tiempo, horas formateadas y duración para cada toma de cámara detectada. Admite URLs de Cloudglue, URLs públicas de video HTTP y URLs de conectores de datos (Dropbox, Google Drive, Zoom). Nota: las URLs de YouTube no son compatibles con la segmentación de tomas de cámara. -
segment_video_chapters: Segmenta videos en capítulos con optimización inteligente de costos. Verifica automáticamente si existen trabajos de segmentación de capítulos antes de crear nuevos. Devuelve resultados JSON estructurados con una matriz de capítulos que contiene marcas de tiempo, horas formateadas y descripciones para cada capítulo detectado. Admite un parámetro opcional de prompt personalizado para guiar la detección de capítulos. Admite todos los formatos de URL: URLs de Cloudglue, URLs de YouTube, URLs públicas de video HTTP y URLs de conectores de datos (Dropbox, Google Drive, Zoom).
Análisis de Colecciones
-
retrieve_summaries: Recupera en masa resúmenes y títulos de videos de una colección para comprender rápidamente su contenido y temas. Funciona tanto con colecciones rich-transcripts como media-descriptions. Perfecta para obtener una visión general de alto nivel de lo que hay en una colección, identificar temas comunes o determinar si una colección contiene contenido relevante para una consulta específica. Úsala como primer paso al analizar una colección: es más eficiente que recuperar descripciones completas y te ayuda a determinar si necesitas información más detallada. Para el descubrimiento de contenido específico, considera usar search_video_summaries o search_video_moments en lugar de navegar por todos los resúmenes. Paginación: Los resultados se paginan en 25 resúmenes por página usando el parámetropage(página 0 = primeros 25 resúmenes, página 1 = siguientes 25 resúmenes, etc.). Cada respuesta incluye los campospageytotal_pages. Para un análisis exhaustivo de la colección, pagina a través de todos los resúmenes incrementando el parámetropagehasta que hayas recuperado todas las páginas. -
search_video_moments: Búsqueda semántica impulsada por IA para encontrar segmentos de video específicos dentro de una colección. Usa la API de búsqueda de Cloudglue para localizar momentos relevantes en el habla, el texto en pantalla y las descripciones visuales. Devuelve resultados de búsqueda estructurados con marcas de tiempo y metadatos. Perfecta para encontrar contenido hablado y visual difícil de localizar, discusiones específicas o análisis temático. Devuelve hasta 20 momentos de video relevantes por consulta. -
search_video_summaries: Búsqueda semántica impulsada por IA para encontrar videos relevantes dentro de una colección. Usa la API de búsqueda de Cloudglue para localizar videos según su contenido, resúmenes y metadatos. Funciona con colecciones rich-transcripts y media-descriptions. Devuelve resultados de búsqueda estructurados con información del video y puntuaciones de relevancia. Perfecta para descubrir videos por tema, temática o similitud de contenido. Devuelve hasta 20 videos relevantes por consulta.
Estrategia de Paginación
Cuándo paginar de forma exhaustiva:
- El usuario solicita un análisis "completo" o "de todo" de colecciones/videos
- El usuario quiere una cobertura integral o una exploración exhaustiva
- El usuario solicita minería de datos, construcción de conjuntos de datos o extracción completa de entidades
- El usuario solicita "todo" en una colección o período de tiempo
Cómo paginar:
Todas las herramientas usan paginación basada en páginas (list_collections, list_videos, describe_video, extract_video_entities, retrieve_summaries):
- Comienza con la solicitud inicial (page=0)
- Verifica el campo
total_pagesde la respuesta - Si
page < total_pages - 1, incrementapagey repite - Continúa hasta que hayas recuperado todas las páginas o tengas datos suficientes
Tamaños de página por herramienta:
list_collections: 25 colecciones por páginalist_videos: 25 videos por páginadescribe_video: 5 minutos por páginaextract_video_entities: 25 entidades de segmento por páginaretrieve_summaries: 25 resúmenes por página
Cuándo usar cada herramienta
- Para comenzar a explorar: Usa
list_collectionsylist_videospara explorar el contenido disponible - Para videos individuales: Usa
describe_video,extract_video_entities,segment_video_camera_shotsosegment_video_chapters - Para una visión general de la colección: Siempre comienza con
retrieve_summariespara comprender eficientemente qué hay en una colección - Para análisis detallado: Usa
describe_videopara videos específicos que necesiten contexto multimodal completo, identificados a través de los resúmenes - Para datos estructurados: Usa
extract_video_entitiespara la extracción de entidades de videos individuales - Para contenido específico: Usa
search_video_momentspara búsqueda dirigida de segmentos,search_video_summariespara búsqueda a nivel de video - Para especificaciones técnicas: Usa
get_video_metadataTodas las herramientas incluyen funciones inteligentes como optimización de costos, respaldos automáticos y manejo integral de errores.