MCP Context Server
Serv
Documentación
MCP Context Server
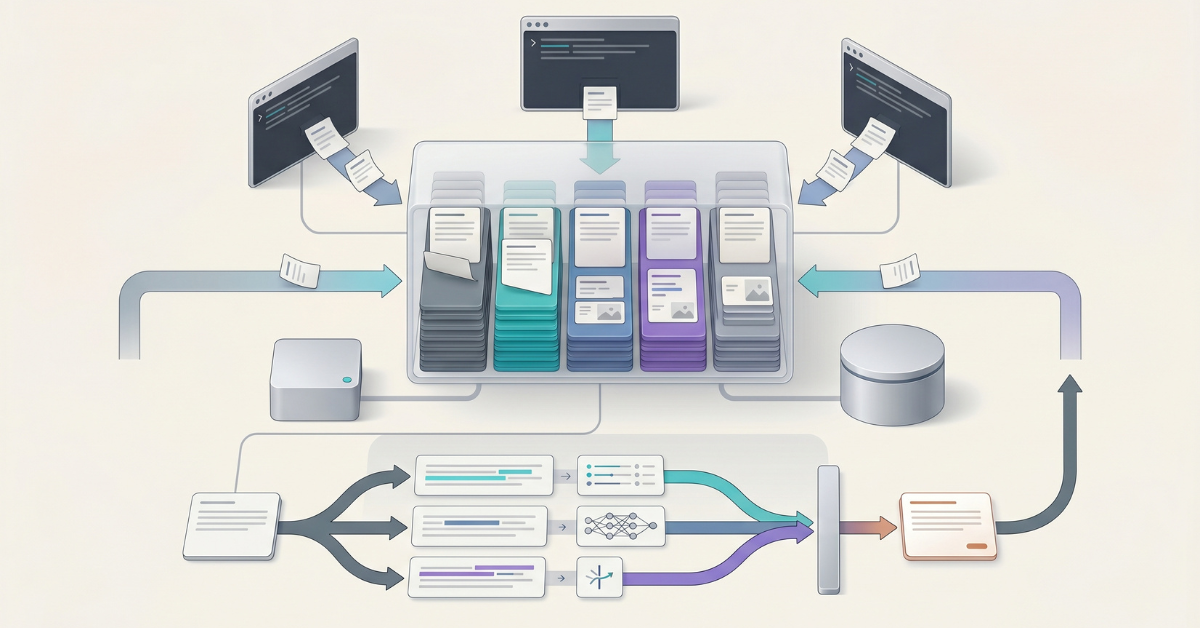



Un servidor de Protocolo de Contexto de Modelo (MCP) de alto rendimiento que proporciona almacenamiento persistente de contexto multimodal para agentes LLM. Construido con FastMCP, este servidor permite compartir contexto sin interrupciones entre múltiples agentes que trabajan en la misma tarea mediante el alcance basado en hilos.
[!WARNING] ¿Actualizando desde v2.x? La versión 3.x.x utiliza un nuevo esquema de base de datos con claves primarias UUIDv7. Las bases de datos existentes de v2.x requieren una migración de datos única antes de poder usarse con v3.x.x. La CLI opcional
mcp-context-server-migratese incluye con el servidor.Consulta la Guía de migración antes de actualizar. Las instalaciones nuevas no se ven afectadas.
Características principales
- Almacenamiento de contexto multimodal: Almacena y recupera tanto texto como imágenes
- Identificadores de contexto UUIDv7: Cada entrada de contexto se identifica con un valor UUIDv7 hexadecimal de 32 caracteres en minúsculas, lo que proporciona ID únicos globales ordenados por tiempo con un orden de cadenas lex estables
- Alcance basado en hilos: Los agentes que trabajan en la misma tarea comparten contexto a través de ID de hilo
- Filtrado flexible de metadatos: Almacena datos estructurados personalizados con cualquier campo serializable en JSON y filtra con 16 operadores potentes
- Filtrado por rango de fechas: Filtra entradas de contexto por marca de tiempo de creación usando formato ISO 8601
- Organización basada en etiquetas: Recuperación eficiente de contexto con etiquetas normalizadas e indexadas
- Generación de resúmenes: Resumen automático opcional basado en LLM devuelto junto con
text_contenttruncados en todos los resultados de herramientas de búsqueda para una mejor eficiencia del contexto del agente (habilitado por defecto con Ollama) - Búsqueda de texto completo: Búsqueda lingüística con derivación, clasificación, consultas booleanas (FTS5/tsvector) y reordenamiento con codificador cruzado. Auto-habilitada por defecto (
ENABLE_FTS=auto); no necesita dependencias adicionales - Búsqueda semántica: Búsqueda de similitud vectorial para recuperación basada en significado con reordenamiento con codificador cruzado. Auto-habilitada por defecto (
ENABLE_SEMANTIC_SEARCH=auto) siempre que haya un proveedor de incrustaciones disponible (la generación de incrustaciones está activada por defecto) - Búsqueda híbrida: Búsqueda combinada FTS + semántica usando Fusión de Rango Recíproco (RRF) con reordenamiento con codificador cruzado. Auto-habilitada por defecto (
ENABLE_HYBRID_SEARCH=auto) siempre que al menos una de las búsquedas de texto completo o semántica esté disponible - Grep del lado del servidor: Coincidencia de patrones literal/regex, orientada a líneas, sin clasificación sobre registros almacenados (
grep_context) — el complemento de localización precisa para la búsqueda de texto completo/semántica, con modos de salida estilo ripgrep y resultados limitados. Auto-habilitado por defecto (ENABLE_GREP_CONTEXT=auto), puramente en Python para que se comporte de manera idéntica en SQLite y PostgreSQL - Navegación de registros (index_tree):
navigate_contextconstruye una tabla de contenidos de encabezados Markdown bajo demanda por registro, con el resumen de la entrada como nodo raíz; los resúmenes LLM por nodo opcionales (activados por defecto) enriquecen cada sección. Combínalo conread_context_rangepara extraer cualquier sección - Lecturas parciales:
read_context_rangedevuelve un segmento de un registro por rango de caracteres, rango de líneas o esquemanode_id— para que un agente pueda leer solo el tramo relevante de un registro largo en lugar de todo - Reordenamiento con codificador cruzado: Refinamiento automático de resultados usando modelos de codificador cruzado FlashRank para mejorar la precisión de búsqueda (habilitado por defecto)
- Compresión de incrustaciones (ACTIVADA por defecto): Reduce el almacenamiento de incrustaciones aproximadamente 8 veces de fábrica en v3.0.0. Los vectores comprimidos con empaquetado de bits mantienen la búsqueda semántica e híbrida funcionando sin cambios en la superficie de herramientas, y la ruta de lectura evita el límite HNSW de pgvector de más de 2000 dimensiones. Establece
ENABLE_EMBEDDING_COMPRESSION=falsepara optar por no participar y mantener el almacenamiento fp32. Consulta la Guía de compresión de incrustaciones - Múltiples backends de base de datos: Elige entre SQLite (predeterminado, sin configuración) o PostgreSQL (alta concurrencia, nivel de producción)
- Alto rendimiento: Modo WAL (SQLite) / MVCC (PostgreSQL), indexación estratégica y operaciones asíncronas
- Cumplimiento estándar de MCP: Funciona con Claude Code, LangGraph y cualquier cliente compatible con MCP
- Listo para producción: Cobertura integral de pruebas, seguridad de tipos y manejo robusto de errores
Conexión a tu asistente de IA
La forma más rápida de conectar el MCP Context Server a Claude Code es el arranque Docker de un solo comando.
Para instrucciones paso a paso, requisitos previos, solución de problemas y comandos de actualización/desinstalación, consulta la Guía de conexión a tu asistente de IA.
Configuración de entorno
El servidor se configura completamente mediante variables de entorno, con soporte para configuración principal, transporte, autenticación, proveedores de incrustaciones, generación de resúmenes, funciones de búsqueda, ajuste de base de datos y más. Las variables se pueden establecer en la configuración de tu cliente MCP, en un archivo .env o directamente en el shell.
Para la referencia completa de todas las variables de entorno con tipos, valores predeterminados, restricciones y descripciones, consulta la Referencia de variables de entorno.
Generación de resúmenes
La generación de resúmenes crea automáticamente resúmenes concisos basados en LLM para cada entrada de contexto almacenada. Los resúmenes se devuelven en el campo summary de todos los resultados de herramientas de búsqueda junto con text_content truncados, proporcionando resúmenes densos e informativos que ayudan a los agentes a determinar la relevancia sin recuperar entradas completas.
Para instrucciones detalladas que incluyen todos los proveedores (Ollama, OpenAI, Anthropic), selección de modelos y configuración de indicaciones personalizadas, consulta la Guía de generación de resúmenes.
Búsqueda semántica
La búsqueda semántica está auto-habilitada por defecto (ENABLE_SEMANTIC_SEARCH=auto): la herramienta semantic_search_context se registra automáticamente siempre que haya un proveedor de incrustaciones disponible (la generación de incrustaciones está activada por defecto) y se omite silenciosamente en caso contrario. Para instrucciones detalladas sobre los múltiples proveedores de incrustaciones (Ollama, OpenAI, Azure, HuggingFace, Voyage) y cómo controlar el interruptor explícitamente, consulta la Guía de búsqueda semántica.
Búsqueda de texto completo
La búsqueda de texto completo está auto-habilitada por defecto (ENABLE_FTS=auto) y no necesita dependencias adicionales, utilizando el motor FTS integrado de la base de datos (FTS5 en SQLite, tsvector en PostgreSQL). Para procesamiento lingüístico, derivación, clasificación y consultas booleanas, consulta la Guía de búsqueda de texto completo.
Búsqueda híbrida
La búsqueda híbrida está auto-habilitada por defecto (ENABLE_HYBRID_SEARCH=auto): la herramienta hybrid_search_context se registra automáticamente siempre que al menos una de las búsquedas de texto completo o semántica esté disponible. Para la búsqueda combinada FTS + semántica usando Fusión de Rango Recíproco (RRF), consulta la Guía de búsqueda híbrida.
Filtrado de metadatos
Para un filtrado integral de metadatos que incluye 16 operadores, rutas JSON anidadas y optimización de rendimiento, consulta la Guía de metadatos.
Backends de base de datos
El servidor admite múltiples backends de base de datos, seleccionables mediante la variable de entorno STORAGE_BACKEND. SQLite (predeterminado) proporciona almacenamiento local sin configuración, perfecto para implementaciones de un solo usuario. PostgreSQL ofrece capacidades de alto rendimiento con un rendimiento de escritura 10 veces mayor para implementaciones multiusuario y de alto tráfico.
Para instrucciones de configuración detalladas que incluyen la configuración de PostgreSQL con Docker, integración con Supabase, métodos de conexión y solución de problemas, consulta la Guía de backends de base de datos.
Referencia de API
El MCP Context Server expone 16 herramientas MCP para la gestión de contexto:
Operaciones principales: store_context, search_context, get_context_by_ids, delete_context, update_context, list_threads, get_statistics
Herramientas de búsqueda: semantic_search_context, fts_search_context, hybrid_search_context
Herramientas de navegación (localizar / navegar / extraer): grep_context, navigate_context, read_context_range
Operaciones por lotes: store_context_batch, update_context_batch, delete_context_batch
Para documentación completa de herramientas que incluye parámetros, valores de retorno, opciones de filtrado y ejemplos, consulta la Referencia de API. Para saber cuándo usar grep frente a búsqueda de texto completo frente a semántica, index_tree y lecturas parciales, consulta Grep, navegación y lecturas parciales.
Implementación con Docker
Para implementaciones de producción con transporte HTTP y orquestación de contenedores, hay configuraciones de Docker Compose disponibles para SQLite, PostgreSQL y PostgreSQL externo (Supabase). Consulta la Guía de implementación con Docker para instrucciones de configuración y detalles de conexión del cliente.
Implementación con Kubernetes
Para implementaciones con Kubernetes, se proporciona un gráfico Helm con valores configurables para diferentes entornos. Consulta la Guía de implementación con Helm para instrucciones de instalación, o la Guía de implementación con Kubernetes para conceptos generales de Kubernetes.
Autenticación
Para implementaciones con transporte HTTP que requieran autenticación, consulta la Guía de autenticación para la configuración de tokens de portador y JWT emitidos por IdP.
Obtención de ayuda
- Informes de errores: Reportar un error
- Solicitudes de funciones: Sugerir una función
- Problemas de documentación: Reportar un problema de documentación
- Preguntas: Hacer una pregunta
Licencia
MCP Context Server está licenciado bajo la Licencia Elastic 2.0 (ELv2).
En resumen: puedes usar, copiar, modificar, distribuir y ejecutar el software libremente y sin costo — para proyectos personales, dentro de empresas de cualquier tamaño y como parte de trabajo comercial. Lo único que no puedes hacer sin un acuerdo comercial es proporcionar el software a terceros como un servicio alojado o gestionado que dé a los usuarios acceso a cualquier conjunto sustancial de sus características o funcionalidades (por ejemplo, una oferta en la nube de "memoria para agentes" construida sobre él).
Consulta Licencias comerciales para ejemplos en lenguaje sencillo de lo que está y no está permitido, y contacta con alexfeel@protonmail.com para licencias comerciales, incluidos los derechos de servicio alojado o gestionado.
Las versiones hasta la v2.2.2 inclusive se publicaron bajo la Licencia MIT y permanecen disponibles bajo ella; la Licencia Elastic 2.0 se aplica desde la v3.0.0 en adelante.