dekko
generador rápido, sin conexión y sin dependencias de mapas de código estáticos e indexador de codebases para agentes de codificación LLM.
Documentación




¿Alguna vez has visto a tu agente de codificación buscar a ciegas en un repositorio, abrir tres archivos que no necesitaba y quemar quince mil tokens solo para responder "¿quién llama a esta función?"? Ese es el problema que dekko existe para resolver.
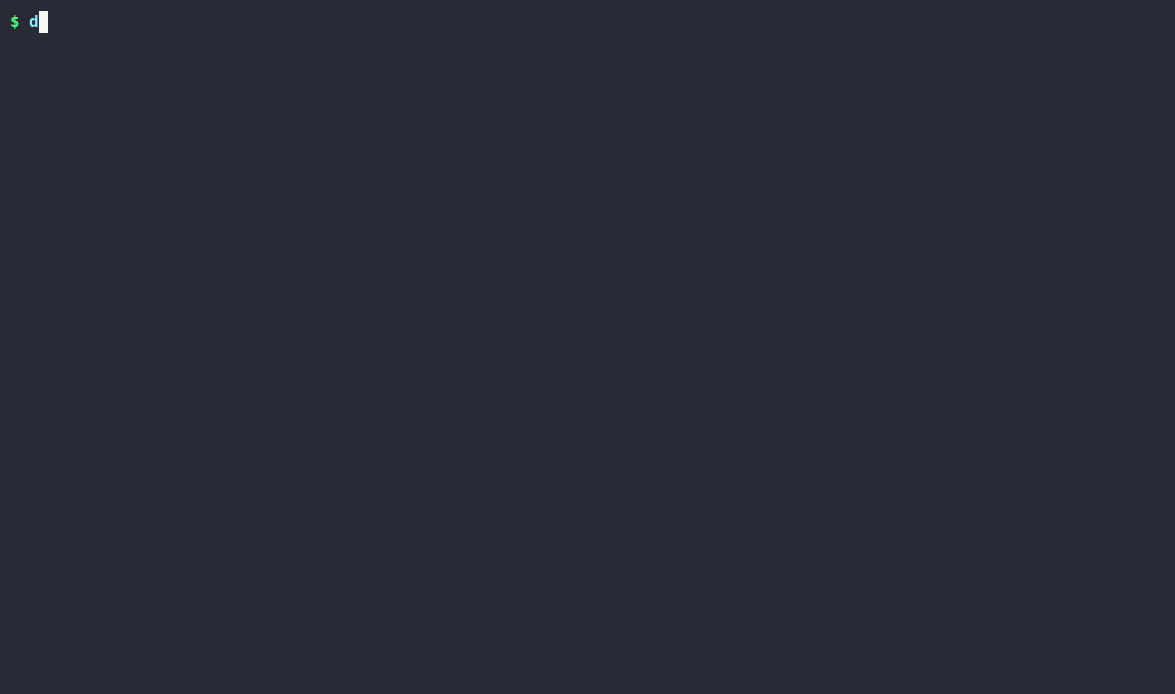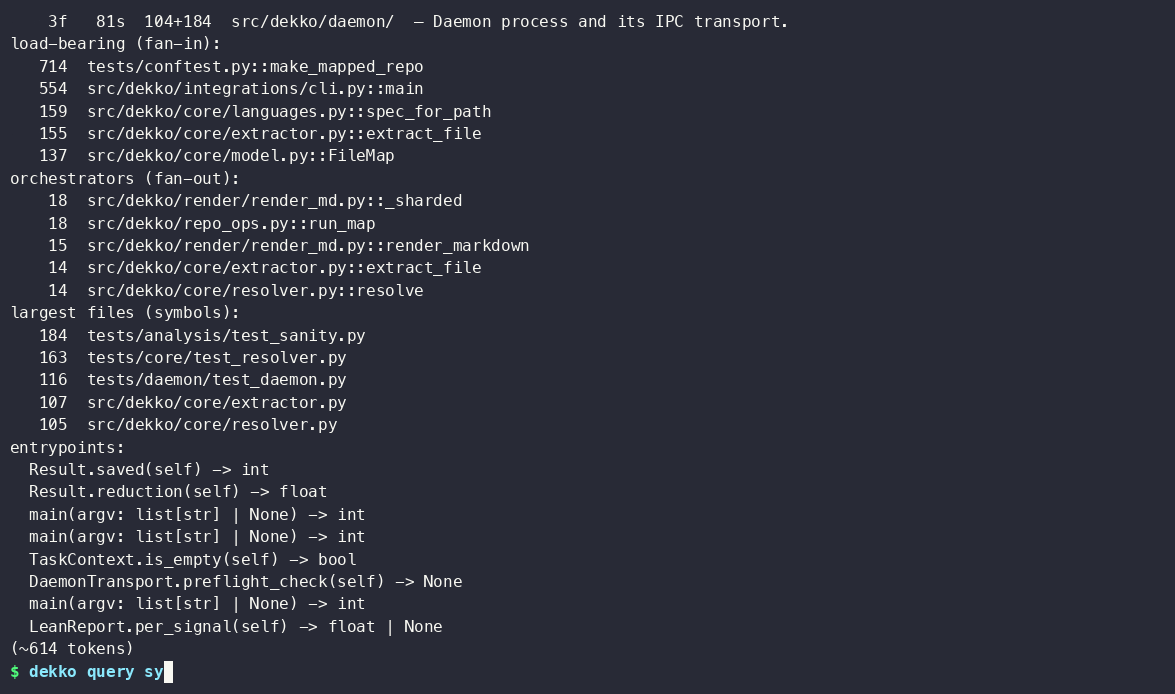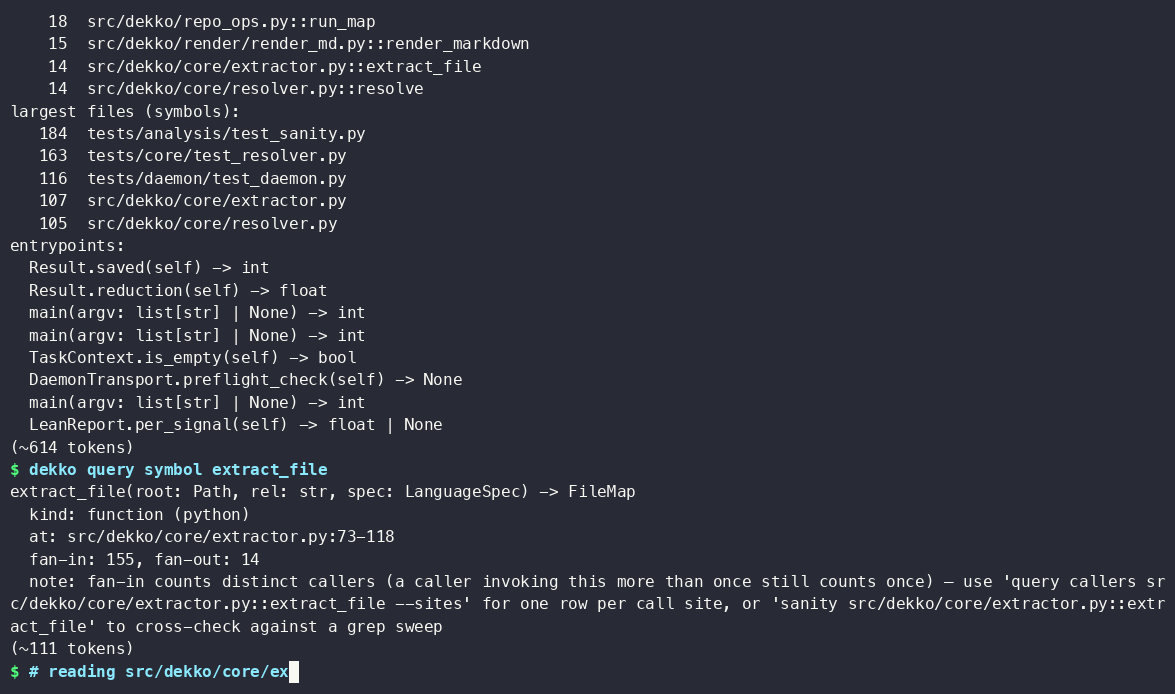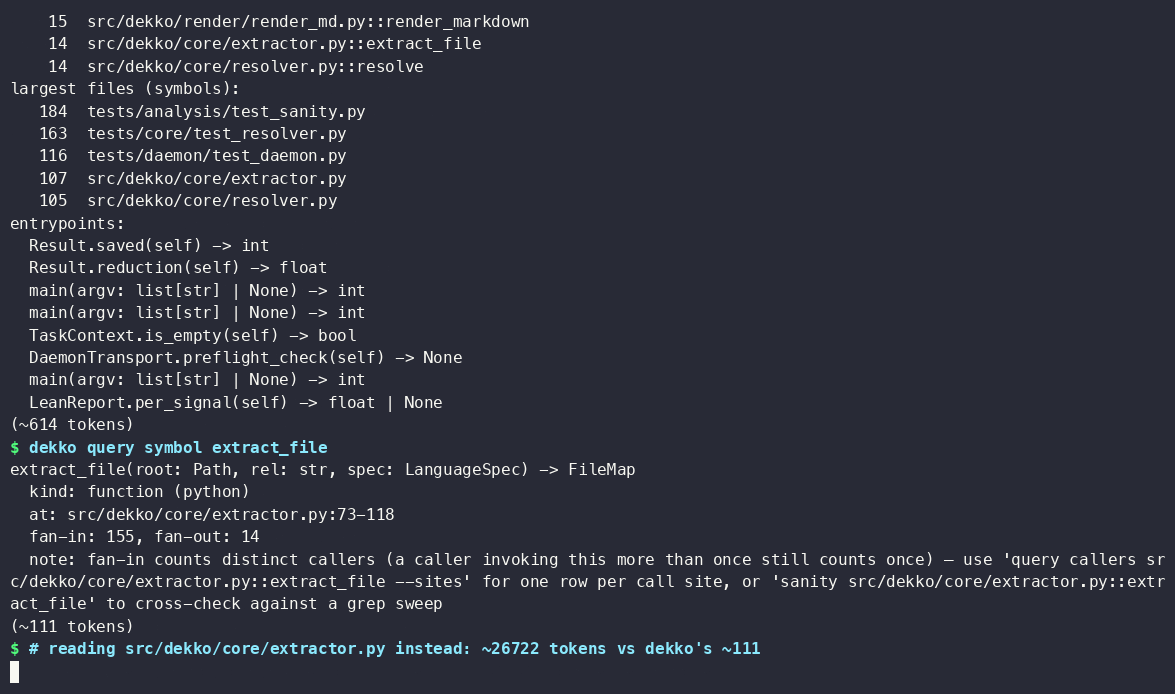
Esta demo se ejecuta en el propio repositorio de dekko (commit 835733c) — clónalo y ejecuta los mismos tres comandos tú mismo.
dekko es un generador de mapas de código estático rápido, offline y sin dependencias, además de un indexador de codebases para agentes de codificación LLM. Escanea un repositorio con tree-sitter (sin gastar tokens de modelo en el análisis) y escribe:
MAP.md— un mapa legible por humanos: una visión general por directorio, un diagrama de arquitectura integrado, clasificaciones de archivos críticos/orquestadores, y luego las funciones/métodos de cada archivo con firmas, líneas de documentación, y quién llama y es llamado por quién.map.json— el mismo grafo en forma legible por máquina.
Sobre el mapa, dekko le da a un agente una forma económica en tokens de responder preguntas como "¿qué contiene este archivo?", "¿quién llama a esta función?" y "¿qué necesito para cambiar esto de forma segura?" — sin leer archivos completos. Se distribuye como CLI, un plugin /map de Claude Code + servidor MCP (Model Context Protocol), y también funciona con Cline.
El resultado: 10x-300x menos tokens que un flujo de trabajo simple de Read/Grep en las tareas cotidianas (orientación, esquematización de un archivo grande, llamadores de un símbolo), medido en 7 repositorios reales de código abierto sin modificar en dekko 0.43.77. El mínimo, un símbolo local pequeño y fácil de buscar con grep, es aproximadamente 2.5x. El desglose completo está justo debajo.
¿Por qué dekko?
La mayoría de los flujos de trabajo de agentes recopilan contexto leyendo archivos completos o haciendo grep en todo el repositorio — costoso, y descarta la estructura (quién llama a qué, cómo es el fan-in/fan-out de una función). dekko en cambio analiza el repositorio una vez en un grafo de llamadas y responde preguntas específicas contra él. Medido en 7 repositorios reales de código abierto sin modificar (Go, TypeScript, Java, Rust, Python/C++ — hasta 14k archivos, 172k símbolos) en dekko 0.43.77, las consultas estructuradas de dekko usaron 10x–300x menos tokens que el flujo de trabajo equivalente de Read/Grep para la misma tarea (orientación del repositorio, esquematización de un archivo grande, rastreo de los llamadores de un símbolo).
| Tarea | Repositorio de ejemplo (escala) | dekko | Read/Grep | Ahorro |
|---|---|---|---|---|
Orientación del repositorio (summary) | awesome-go (10 archivos) | 359 tok | ~16,328 tok | ~45x |
Orientación del repositorio (summary) | claude-buddy (57 archivos) | ~349 tok | ~113,514 tok (cada archivo fuente) | ~325x |
| Esquematizar un archivo grande | claude-code REPL.tsx (5,005 líneas) | ~1,154 tok | ~223,963 tok | ~194x |
| Esquematizar un archivo grande | cline SdkController.ts (84 KB) | 1,803 tok | ~21,023 tok | ~11.7x |
| Esquematizar un directorio | zed crates/git_ui/src (32 archivos) | ~35,778 tok | ~418,520 tok | ~11.7x |
| Llamadores de un símbolo | claude-code errorMessage | ~602 tok | ~18,521 tok (323+ resultados de grep) | ~31x |
| Llamadores de un símbolo | zed MultiWorkspace.new (22 sitios, 8 archivos) | ~809 tok | ~381,446 tok (leer los archivos llamadores) | ~471x |
| Uso de API externa | claude-code chalk | ~798 tok | ~8,099 tok | ~10x |
Contexto agrupado (workset) | awesome-go ToHTML | 263 tok | 4,104 tok | ~16x |
El costo de dekko se mantiene aproximadamente plano por consulta mientras que Read/Grep escala con el tamaño del archivo/repositorio, por lo que la proporción crece con la escala. También es rápido en tiempo real: mapear la propia codebase de dekko de ~4,300 símbolos desde una caché fría toma unos 5 segundos en todos los núcleos, un remapeo incremental después de una edición es mucho menos de un segundo, y las consultas contra el mapa resultante regresan al instante. La ventaja no es universal — archivos pequeños y autocontenidos y símbolos locales ya fáciles de buscar con grep ven poco beneficio (el mínimo medido fue de aproximadamente 2.5x). Consulta benchmarks/real-world-repos/ para el desglose completo por tarea, la metodología, el estudio original de 2026-08, y las advertencias de corrección que planteó y cómo se cerraron.
En comparación con herramientas de índice de etiquetas como ctags/gtags, dekko resuelve bordes de llamadas reales (no solo definiciones), clasifica archivos por su importancia estructural, y habla directamente con los agentes a través de MCP o la CLI — sin necesidad de un plugin de editor.
Instalación
uv tool install dekko      # or: pip install dekko / pipx install dekko
dekko --claude-install     # add the /map command + MCP server to Claude Code, then restart
Extras (dekko[all] para ~55 idiomas más, dekko[search] para búsqueda de embeddings), instalación desde un clon local, y desinstalación están en docs/install.md.
Inicio rápido
cd my-project
dekko map                  # writes .dekko/MAP.md + .dekko/map.json
dekko summary               # ~40-line digest: dirs, hotspots, entry points
.dekko/ está ignorado por git por defecto; el mapa se regenera bajo demanda, por lo que rara vez necesitas ejecutar dekko map de nuevo manualmente. Si tu repositorio tiene idiomas fuera del conjunto predeterminado de Nivel 1 (Python, C, C++, JS/TS, Go, Java, Rust), dekko map lo indicará por archivo; instala dekko[all] para ~55 idiomas más (consulta Instalación) y vuelve a ejecutarlo.
Documentación
- docs/install.md — instalación, extras, clon local, desinstalación
- docs/cli.md — cada comando de CLI, objetivos de símbolos, exclusión de archivos, notas, modo daemon, soporte de idiomas
- docs/claude-code.md — el plugin
/map, hooks de push, habilidades de Claude Code, el servidor MCP, y Cline
Aprende más
- CHANGELOG.md — historial por versión
- CONTRIBUTING.md — configuración de desarrollo, pruebas, publicación
- benchmarks/ — mediciones de eficiencia de tokens, incluyendo una comparación del mundo real de 7 repositorios contra un flujo de trabajo simple de Read/Grep