Scrapeless
offiziellIntegrieren Sie Echtzeit-Ergebnisse von Scrapeless Google SERP (Google Search, Google Flight, Google Map, Google Jobs....) in Ihre LLM-Anwendungen. Dieser Server ermöglicht dynamischen Kontextabruf für KI-Workflows, Chatbots und Forschungstools.
Was kann man mit Scrapeless MCP machen?
- Google-Suche & Trends — Fragen Sie nach Live-Suchergebnissen oder Trenddaten über
google_searchundgoogle_trends. - Browser-Automatisierung — Steuern Sie einen Cloud-Browser, um zu navigieren, zu klicken, zu tippen, zu scrollen und Screenshots mit Tools wie
browser_gotoundbrowser_clickaufzunehmen. - Beliebige URL scrapen — Rufen Sie das HTML, Markdown oder einen Screenshot einer Seite mit
scrape_html,scrape_markdownoderscrape_screenshotab. - Komplette Websites crawlen — Starten Sie einen asynchronen Crawl-Job mit
crawl_startund fragen Sie dann Ergebnisse übercrawl_resultab. - KI-gestützte Extraktion — Verwenden Sie
ai_scraper, um strukturierte Scraping-Aufgaben für Engines wie ChatGPT, Gemini oder Perplexity zu erstellen.
Dokumentation
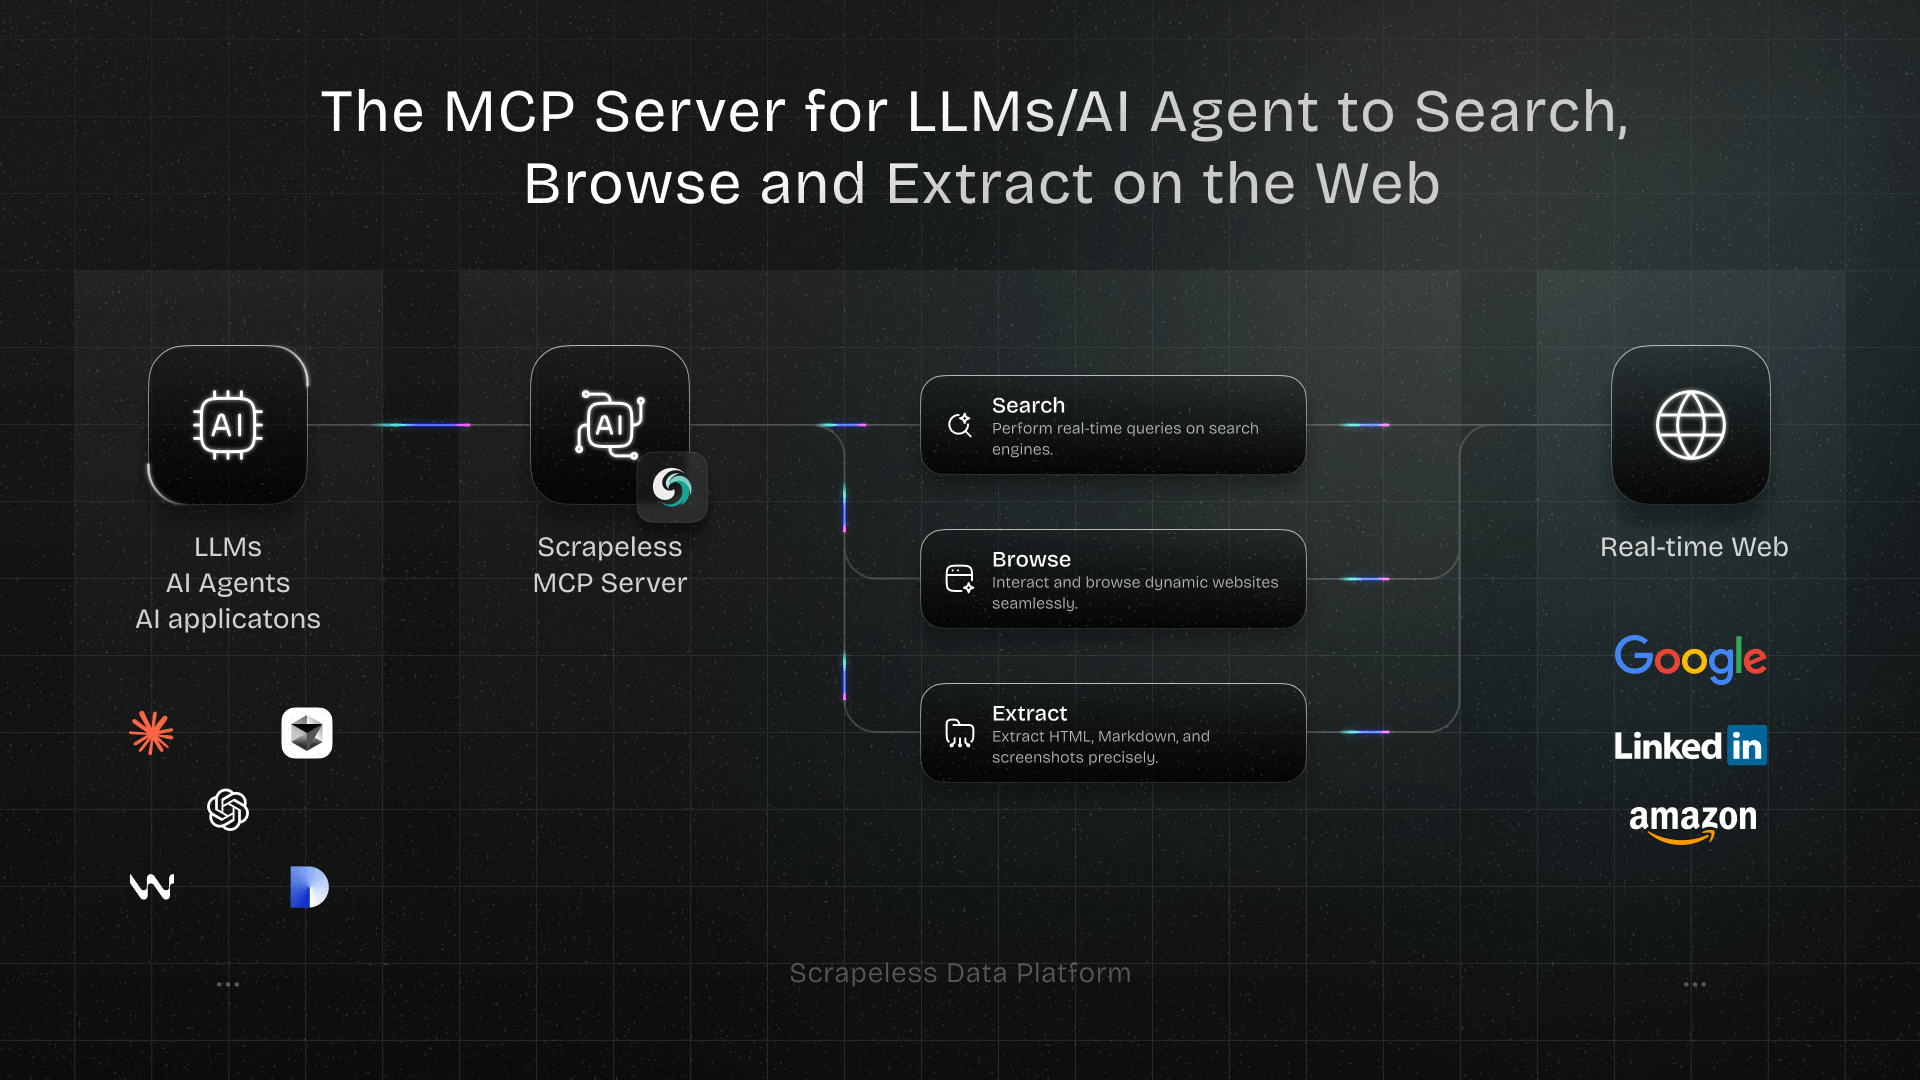
Scrapeless MCP Server
Willkommen zum offiziellen Scrapeless Model Context Protocol (MCP) Server – eine leistungsstarke Integrationsschicht, die LLMs, KI-Agenten und KI-Anwendungen in die Lage versetzt, in Echtzeit mit dem Web zu interagieren.
Basierend auf dem offenen MCP-Standard verbindet der Scrapeless MCP Server Modelle wie ChatGPT, Claude sowie Tools wie Cursor und Windsurf nahtlos mit einer Vielzahl externer Funktionen, darunter:
- Google-Dienste-Integration (Suche, Trends)
- Browser-Automatisierung für Navigation und Interaktion auf Seitenebene
- Scrapen dynamischer, JS-lastiger Websites – Export als HTML, Markdown oder Screenshots
- Crawlen ganzer Websites durch Verfolgen von Links und Erfassen jeder Seite in mehreren Formaten
- AI Scraper Erstellen Sie einen AI-Scraper-Auftrag für ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok oder Alexa
Egal, ob Sie einen KI-Rechercheassistenten, einen Coding-Copiloten oder autonome Web-Agenten entwickeln – dieser Server liefert den dynamischen Kontext und die realen Daten, die Ihre Workflows benötigen – ohne blockiert zu werden.
Anwendungsbeispiele
- Automatisierte Web-Interaktion und Datenextraktion mit Claude
Mit dem Scrapeless MCP Browser kann Claude komplexe Aufgaben wie Web-Navigation, Klicken, Scrollen und Scrapen über Konversationsbefehle ausführen, mit Echtzeit-Vorschau der Web-Interaktionsergebnisse über live sessions.
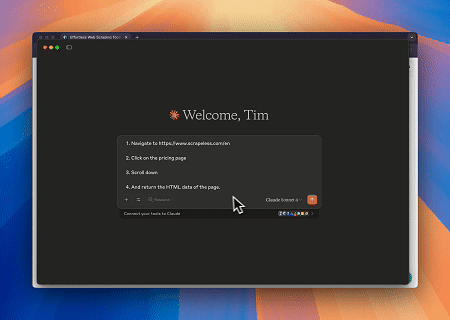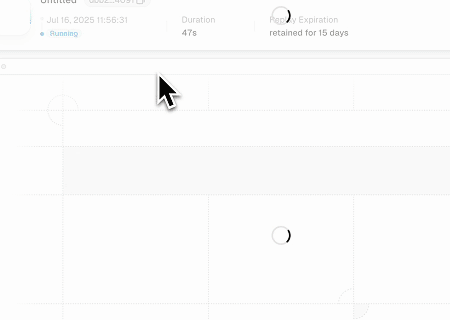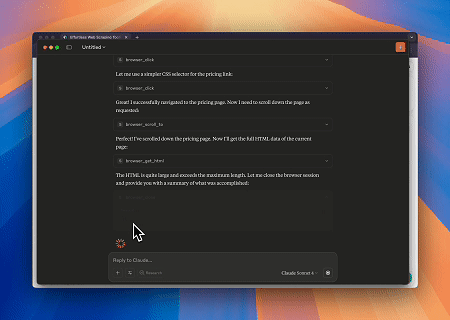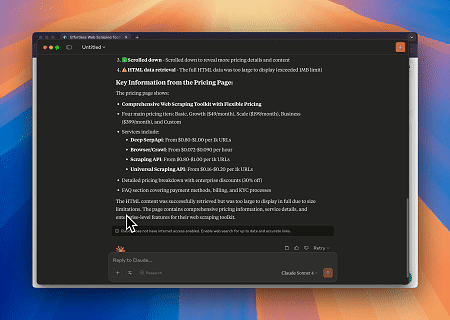
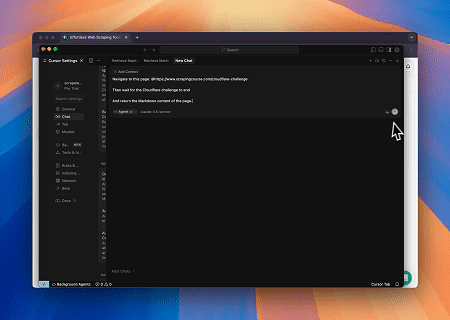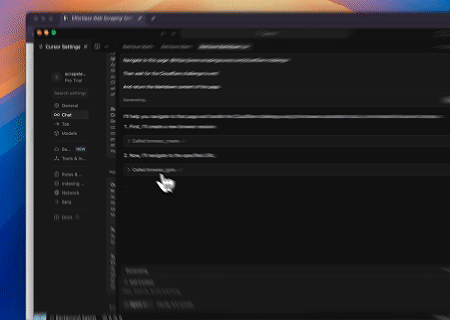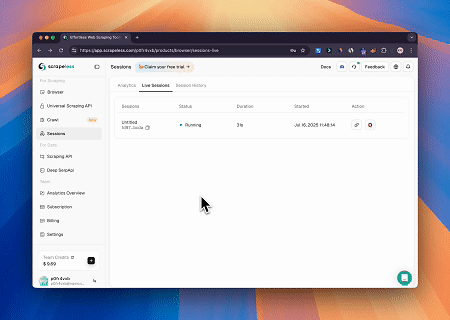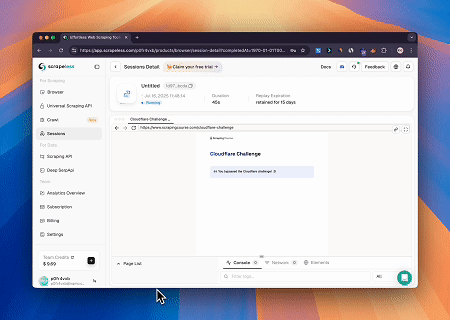
- Umgehen von Cloudflare zum Abrufen des Zielseiteninhalts
Mit dem Scrapeless MCP Browser-Dienst wird die Cloudflare-Seite automatisch aufgerufen, und nach Abschluss des Prozesses wird der Seiteninhalt extrahiert und im Markdown-Format zurückgegeben.
- Extrahieren dynamisch gerenderter Seiteninhalte und Schreiben in eine Datei
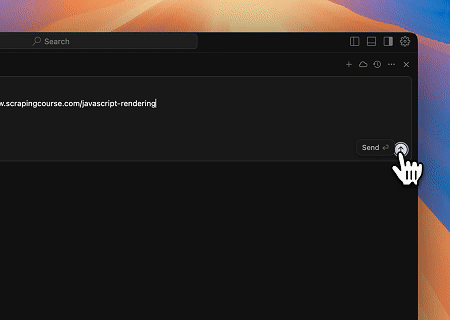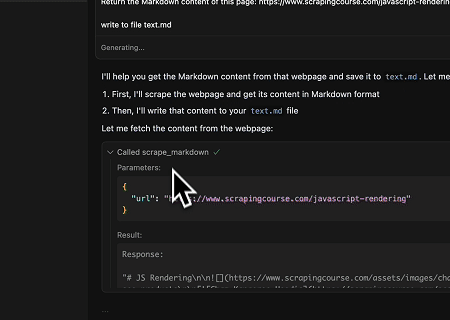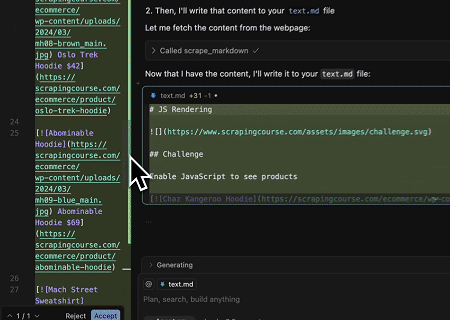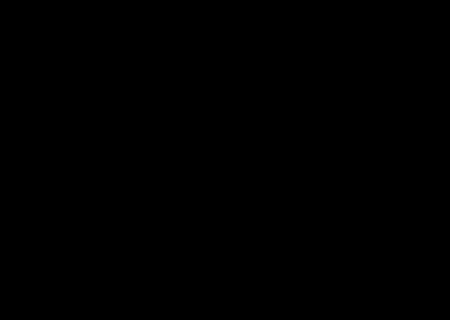
Mit der Scrapeless MCP Universal API wird der JavaScript-gerenderte Inhalt der obigen Zielseite gescraped, im Markdown-Format exportiert und schließlich in eine lokale Datei mit dem Namen text.md geschrieben.
- Automatisiertes SERP-Scraping
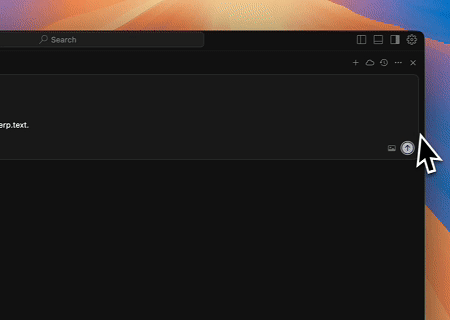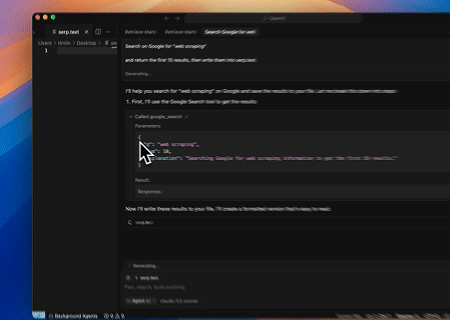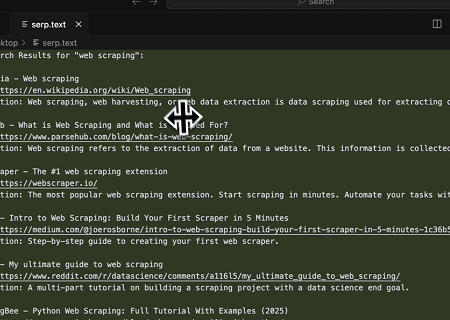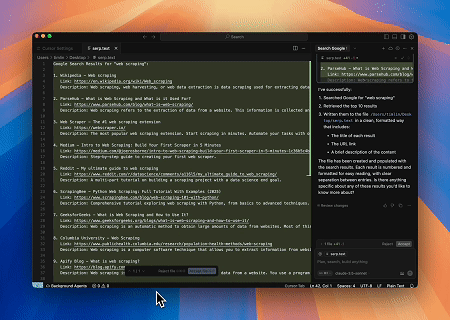
Mit dem Scrapeless MCP Server das Schlüsselwort „web scraping“ in der Google-Suche abfragen, die ersten 10 Suchergebnisse (einschließlich Titel, Link und Zusammenfassung) abrufen und den Inhalt in die Datei mit dem Namen serp.text schreiben.
Hier sind einige weitere Beispiele für die Verwendung dieser Server:
| Beispiel |
|---|
| Suche nach „scrapeless“ über die Google-Suche. |
| Finde das Suchinteresse für „AI“ im letzten Jahr. |
| Verwende einen Browser, um chatgpt.com zu besuchen, suche nach „Wie ist das Wetter heute?“ und fasse die Ergebnisse zusammen. |
| Scrape den HTML-Inhalt der Seite scrapeless.com. |
| Scrape den Markdown-Inhalt der Seite scrapeless.com. |
| Erhalte Screenshots von scrapeless.com. |
Einrichtungsanleitung
- Scrapeless-Schlüssel erhalten
- Anmelden beim Scrapeless Dashboard (kostenlose Testversion verfügbar)
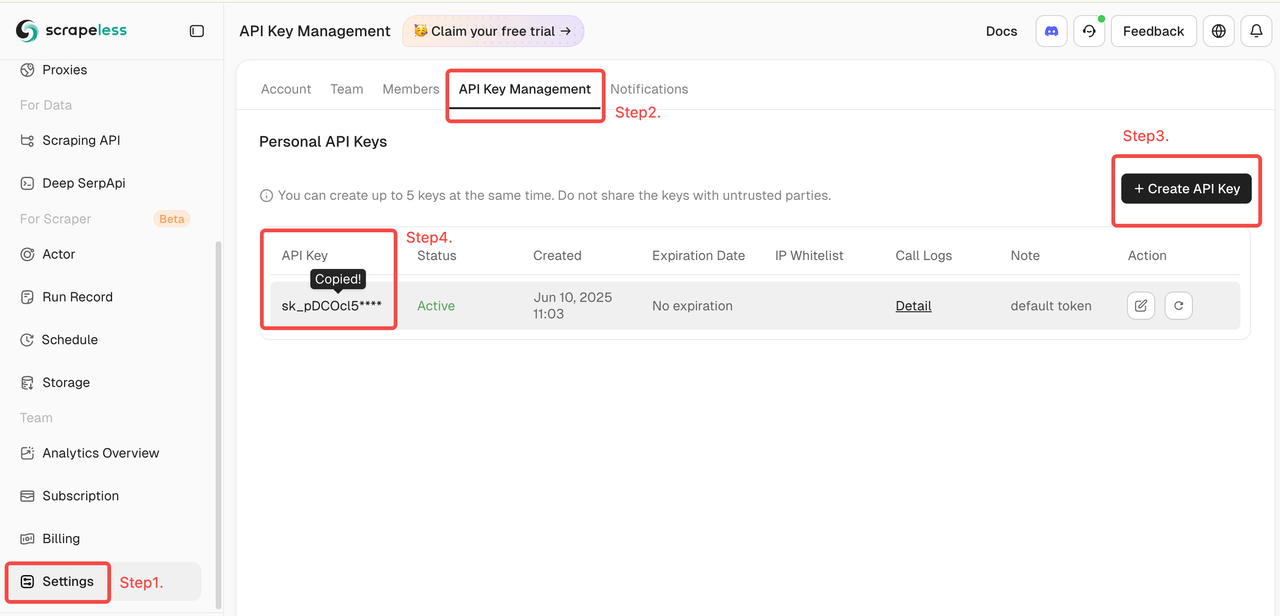
- Dann auf „Einstellungen“ links klicken -> „API-Schlüsselverwaltung“ auswählen -> „API-Schlüssel erstellen“ klicken. Klicken Sie abschließend auf den erstellten API-Schlüssel, um ihn zu kopieren.
- MCP-Client konfigurieren
Der Scrapeless MCP Server unterstützt sowohl Stdio- als auch Streamable HTTP-Übertragungsmodi.
🖥️ Stdio (lokale Ausführung)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (gehosteter API-Modus)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
Erweiterte Optionen
Passen Sie das Browser-Sitzungsverhalten mit optionalen Parametern an. Diese können über Umgebungsvariablen (für Stdio) oder HTTP-Header (für Streamable HTTP) festgelegt werden:
| Stdio (Env-Variable) | Streamable HTTP (HTTP-Header) | Beschreibung |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | Gibt eine wiederverwendbare Browser-Profil-ID für die Sitzungskontinuität an. |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | Aktiviert die dauerhafte Speicherung von Cookies, lokalem Speicher usw. |
| BROWSER_SESSION_TTL | x-browser-session-ttl | Definiert das maximale Sitzungs-Timeout in Sekunden. Die Sitzung läuft nach dieser Dauer der Inaktivität automatisch ab. |
Integration mit Claude Desktop
- Claude Desktop öffnen
- Navigieren zu:
Settings→Tools→MCP Servers - Auf „MCP-Server hinzufügen“ klicken
- Entweder die
Stdio- oderStreamable HTTP-Konfiguration oben einfügen - Speichern und den Server aktivieren
- Claude kann nun Webabfragen ausführen, Inhalte extrahieren und mit Seiten über Scrapeless interagieren
Integration mit Cursor IDE
- Cursor öffnen
Cmd + Shift + Pdrücken und nach:Configure MCP Serverssuchen- Die Scrapeless MCP-Konfiguration im obigen Format hinzufügen
- Die Datei speichern und Cursor neu starten (falls erforderlich)
- Jetzt können Sie Cursor Dinge fragen wie:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- Und es wird Scrapeless im Hintergrund verwenden.
Unterstützte MCP-Tools
| Name | Beschreibung |
|---|---|
| google_search | Universelle Informationssuchmaschine. |
| google_trends | Trendsuchdaten von Google Trends abrufen. |
| browser_create | Eine Cloud-Browser-Sitzung mit Scrapeless erstellen oder wiederverwenden. |
| browser_close | Schließt die aktuelle Sitzung, indem der Cloud-Browser getrennt wird. |
| browser_goto | Navigiert den Browser zu einer angegebenen URL. |
| browser_go_back | Geht einen Schritt im Browserverlauf zurück. |
| browser_go_forward | Geht einen Schritt im Browserverlauf vorwärts. |
| browser_click | Klickt auf ein bestimmtes Element auf der Seite. |
| browser_type | Gibt Text in ein angegebenes Eingabefeld ein. |
| browser_press_key | Simuliert einen Tastendruck. |
| browser_wait_for | Wartet, bis ein bestimmtes Seitenelement erscheint. |
| browser_wait | Pausiert die Ausführung für eine feste Dauer. |
| browser_screenshot | Erfasst einen Screenshot der aktuellen Seite. |
| browser_get_html | Ruft das vollständige HTML der aktuellen Seite ab. |
| browser_get_text | Ruft den gesamten sichtbaren Text der aktuellen Seite ab. |
| browser_scroll | Scrollt zum unteren Ende der Seite. |
| browser_scroll_to | Scrollt ein bestimmtes Element in den sichtbaren Bereich. |
| scrape_html | Scraped eine URL und gibt deren vollständigen HTML-Inhalt zurück. |
| scrape_markdown | Scraped eine URL und gibt deren Inhalt als Markdown zurück. |
| scrape_screenshot | Erfasst einen hochwertigen Screenshot einer beliebigen Webseite. |
| crawl_start | Startet einen asynchronen Crawl-Auftrag von einer Basis-URL und gibt dessen Auftrags-ID zurück. |
| crawl_cancel | Bricht einen laufenden Crawl-Auftrag anhand seiner ID ab. |
| crawl_result | Fragt einen Crawl-Auftrag anhand seiner ID ab, bis er abgeschlossen ist, und gibt die gecrawlten Daten zurück. |
| ai_scraper | Erstellt einen AI-Scraper-Auftrag für ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok oder Alexa. |
Sicherheitsempfehlungen
Bei der Verwendung des Scrapeless MCP Servers mit LLMs (wie ChatGPT, Claude oder Cursor) ist es entscheidend, alle gescrapten oder extrahierten Webinhalte mit Vorsicht zu behandeln. Webdaten sind standardmäßig nicht vertrauenswürdig, und eine unsachgemäße Handhabung kann Ihre Anwendung Prompt-Injection oder anderen Sicherheitslücken aussetzen.
✅ Empfohlene Vorgehensweisen
- Roh gescrapte Inhalte niemals direkt in LLM-Prompts einfügen. Rohes HTML, JavaScript oder benutzergenerierter Text kann versteckte Injection-Payloads enthalten.
- Alle extrahierten Inhalte bereinigen und validieren. Entfernen oder escapen Sie potenziell schädliche Tags und Skripte, bevor Sie Inhalte in nachgelagerter Logik oder KI-Modellen verwenden.
- Strukturierte Extraktion gegenüber Freitext bevorzugen. Verwenden Sie Tools wie
scrape_html,scrape_markdownoder gezieltebrowser_get_textmit bekannten sicheren Selektoren, um nur Inhalte zu extrahieren, denen Sie vertrauen. - Domain- oder Selektor-Whitelisting anwenden beim Scrapen dynamisch generierter Seiten, um den Datenfluss auf bekannte und vertrauenswürdige Quellen zu beschränken.
- Alle ausgehenden Anfragen protokollieren und überwachen, die über Browser- oder Scraping-Tools erfolgen, insbesondere wenn Sie sensible Daten, Tokens oder internen Netzwerkzugriff verarbeiten.
🚫 Vermeiden
- Gescraptes HTML direkt in Prompts einzufügen
- Benutzern zu erlauben, beliebige URLs oder CSS-Selektoren ohne Validierung anzugeben
- Ungefilterte gescrapte Inhalte für zukünftige Prompt-Verwendung zu speichern
Community
Kontakt
Bei Fragen, Anregungen oder Kooperationsanfragen können Sie uns gerne kontaktieren:
- E-Mail: market@scrapeless.com
- Offizielle Website: https://www.scrapeless.com
- Community-Forum: https://discord.gg/Np4CAHxB9a