dbt
offiziellOffizieller MCP-Server für dbt (data build tool) mit Integration in die dbt Core/Cloud CLI, Projektmetadaten-Erkennung, Modellinformationen und Abfragefunktionen für die semantische Schicht.
Was kann man mit Dbt MCP machen?
- Metriken abfragen — Bitten Sie den Assistenten, Metrikabfragen mit Filterung und Gruppierung über
query_metricsauszuführen, oder definierte Metriken mitlist_metricsaufzulisten. - Modell-Lineage erkunden — Fordern Sie einen begrenzten Lineage-Graphen mit Filtern für Typ, Tiefe und Richtung über
get_lineagean. - Modellzustand prüfen — Fragen Sie den Ausführungsstatus, Testergebnisse und die Aktualität der Upstream-Quellen für ein Modell mit
get_model_healthab. - dbt-Befehle ausführen — Lassen Sie den Assistenten
build,run,test,compileodershowfür Ihr Projekt ausführen. - Job-Ausführungen verwalten — Lösen Sie dbt Platform-Job-Ausführungen aus, wiederholen Sie sie, brechen Sie sie ab oder prüfen Sie sie samt ihrer Artefakte.
- Boilerplate generieren — Erstellen Sie Modell-YAML, Quell-YAML oder Staging-Modell-SQL mit
generate_model_yaml,generate_sourceundgenerate_staging_model.
Dokumentation
dbt MCP Server
Dieser MCP-Server (Model Context Protocol) stellt verschiedene Tools für die Interaktion mit dbt bereit. Du kannst diesen MCP-Server verwenden, um KI-Agenten mit Kontext zu deinem Projekt in dbt Core, dbt Fusion und dbt Platform zu versorgen.
Lies unsere Dokumentation hier, um mehr zu erfahren. Dieser Blogbeitrag enthält weitere Details dazu, was mit dem dbt MCP-Server möglich ist.
Experimentelles MCP-Bundle
Wir veröffentlichen mit jeder Version ein experimentelles Model Context Protocol Bundle (dbt-mcp.mcpb), damit MCPB-fähige Clients diesen Server ohne zusätzliche Einrichtung importieren können. Lade das Bundle aus den Assets der neuesten Version herunter und folge der Dokumentation zur mcpb CLI von Anthropic, um es zu installieren oder zu prüfen.
Feedback
Wenn du Anmerkungen oder Fragen hast, erstelle ein GitHub Issue oder tritt uns im Community-Slack im Kanal #tools-dbt-mcp bei.
Architektur
Die Architektur des dbt MCP-Servers ermöglicht es deinem Agenten, sich mit einer Vielzahl von Tools zu verbinden.
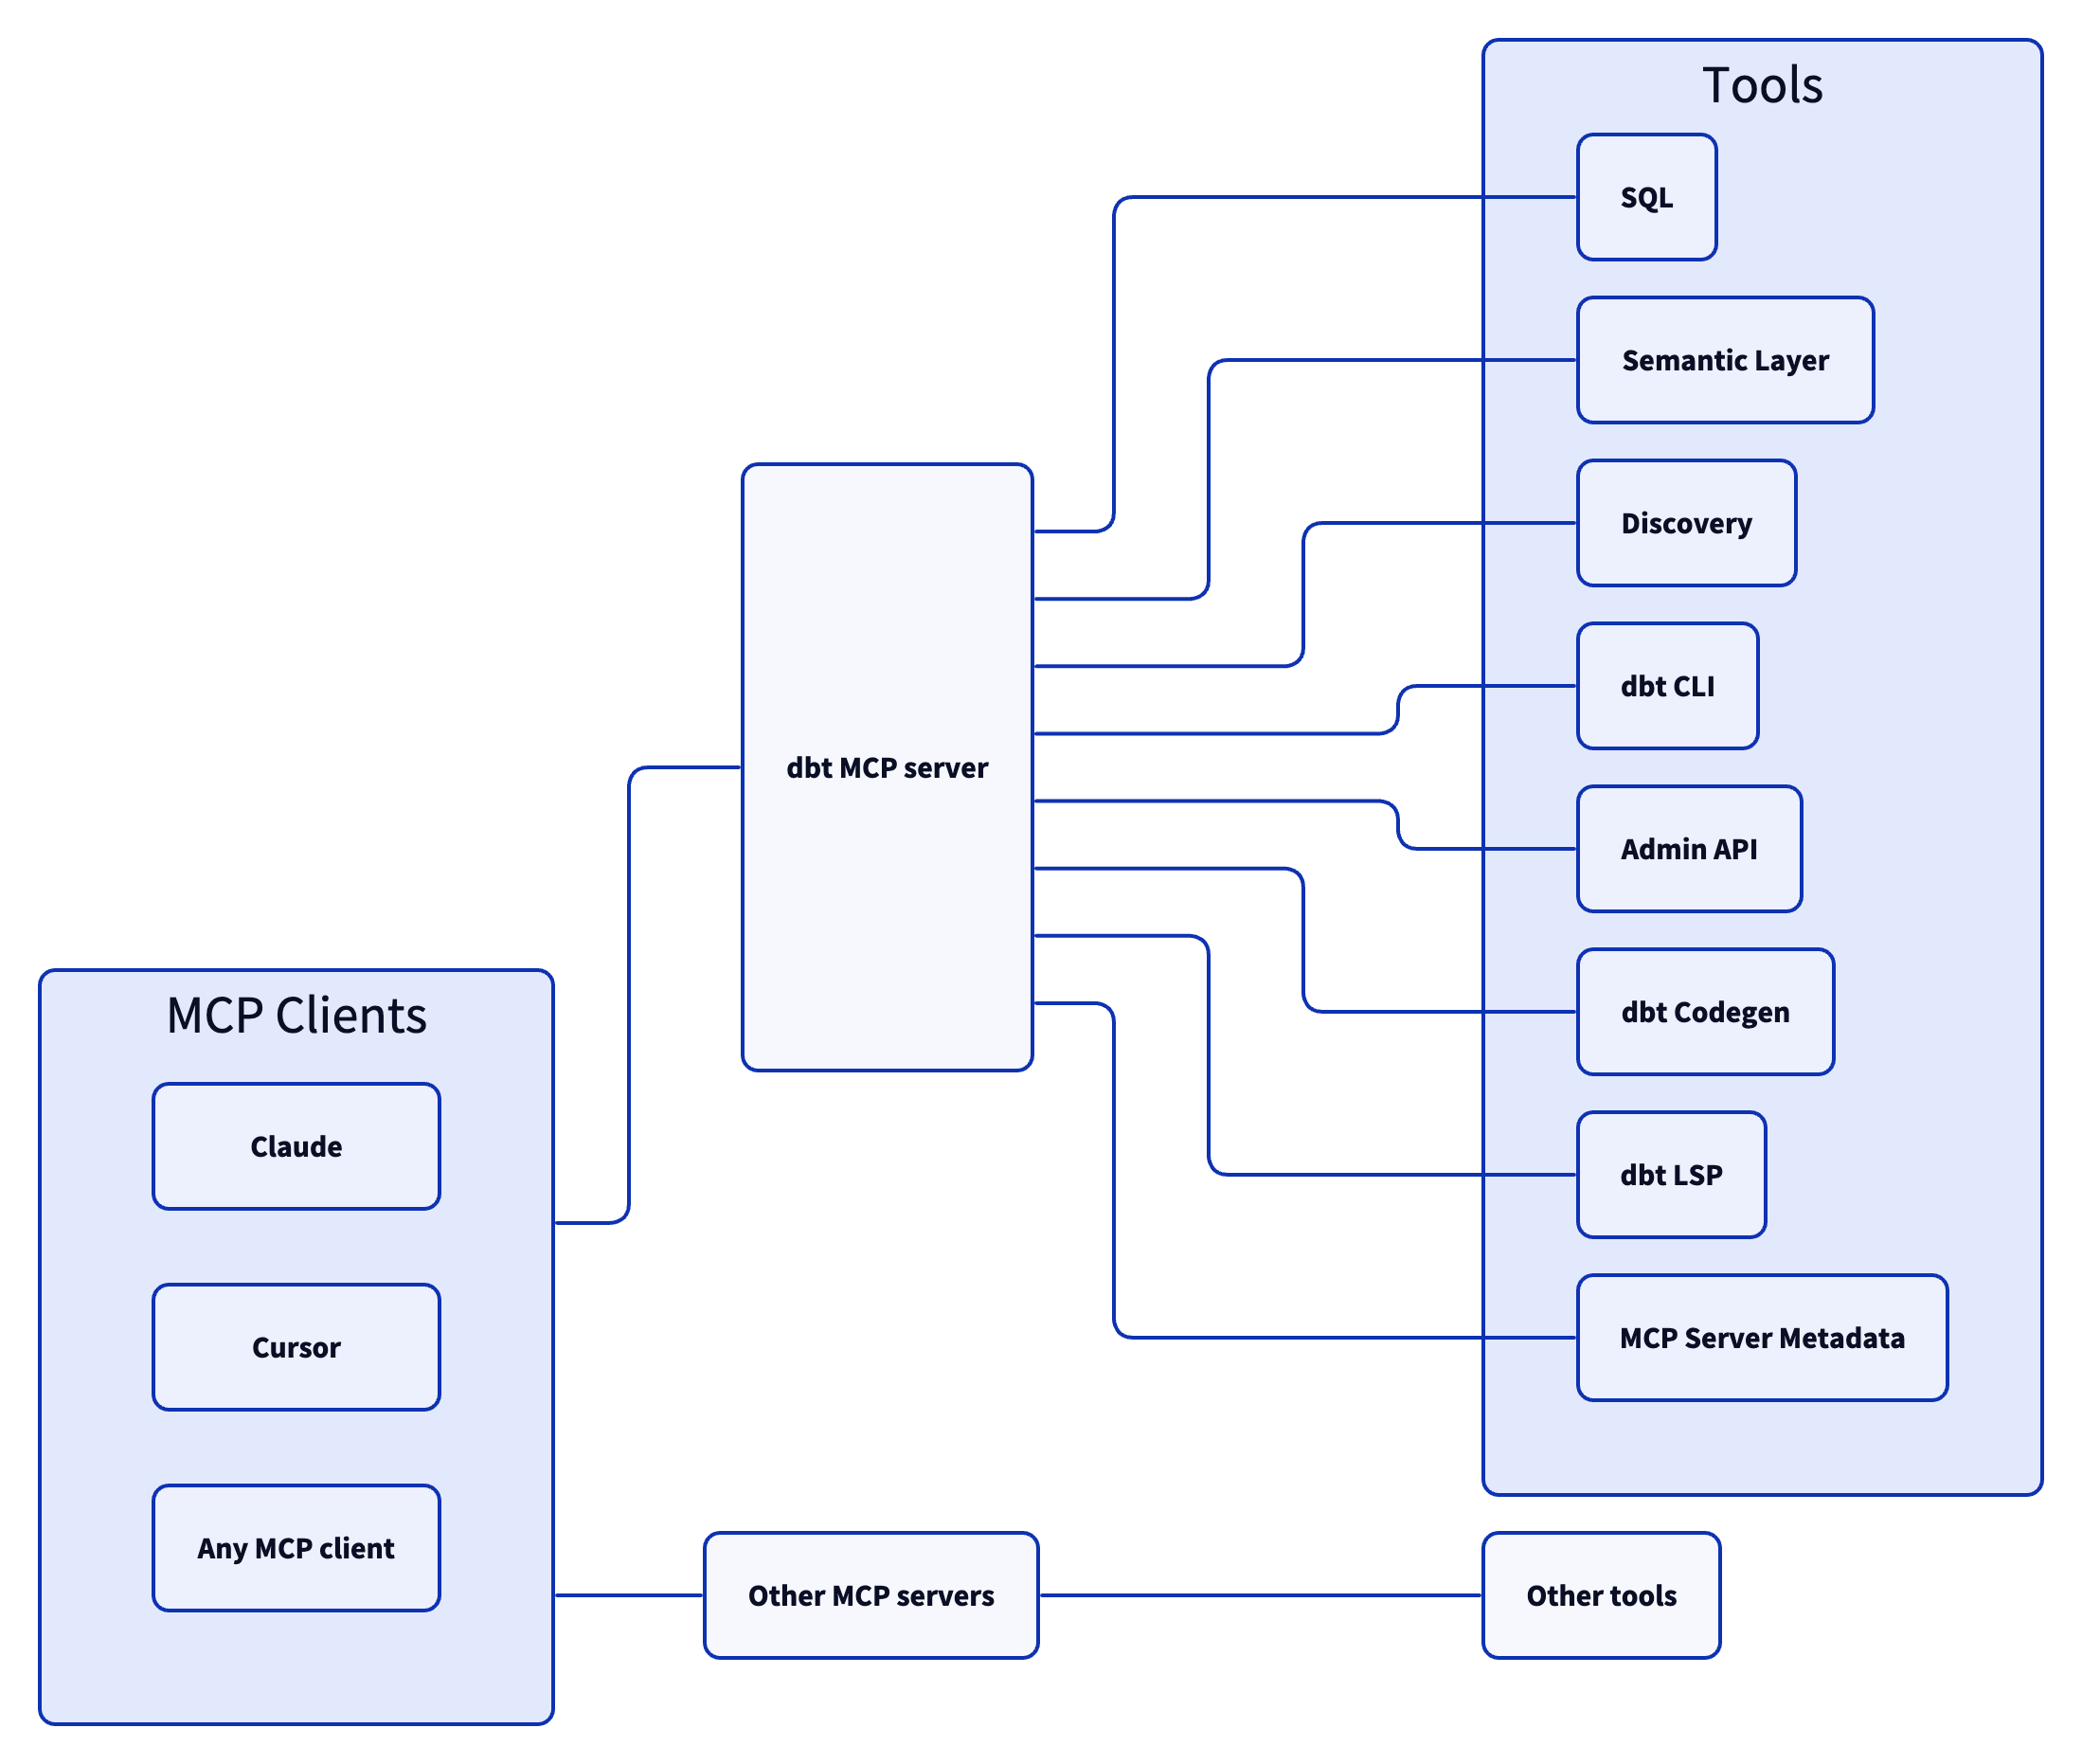
Tools
SQL
Tools zum Ausführen und Generieren von SQL auf der dbt Platform-Infrastruktur.
execute_sql: Führt SQL auf der dbt Platform-Infrastruktur mit Semantic-Layer-Unterstützung aus.text_to_sql: Generiert SQL aus natürlicher Sprache unter Verwendung des Projektkontexts.
Semantic Layer
Um mehr über den dbt Semantic Layer zu erfahren, klicke hier.
get_dimension_values: Ruft eindeutige Werte für eine Dimension ab; optional auf bestimmte Metriken beschränkbar.get_dimensions: Ruft Dimensionen für angegebene Metriken ab.get_entities: Ruft Entitäten für angegebene Metriken ab.get_metrics_compiled_sql: Gibt kompiliertes SQL für Metriken zurück, ohne die Abfrage auszuführen.list_metrics: Ruft alle definierten Metriken ab.list_saved_queries: Ruft alle gespeicherten Abfragen ab.query_metrics: Führt Metrikabfragen mit Filter- und Gruppierungsoptionen aus.
Discovery
Um mehr über die dbt Discovery API zu erfahren, klicke hier.
get_all_macros: Ruft Makros ab; optional nach Paket filtern oder nur Paketnamen zurückgeben.get_all_models: Ruft Name und Beschreibung aller Modelle ab.get_all_sources: Ruft alle Quellen mit Freshness-Status ab; optional nach Quellenname filtern.get_exposure_details: (veraltet – verwende stattdessenget_node_details)get_exposures: Ruft alle Exposures ab (nachgelagerte Dashboards, Apps oder Analysen).get_lineage: Ruft einen begrenzten Lineage-Graphen mit Filterung nach Typ, Tiefe und Richtung ab.get_macro_details: (veraltet – verwende stattdessenget_node_details)get_mart_models: Ruft alle Mart-Modelle ab.get_model_children: (veraltet – verwende stattdessenget_lineage)get_model_details: (veraltet – verwende stattdessenget_node_details)get_model_health: Ruft Gesundheitssignale ab: Ausführungsstatus, Testergebnisse und Freshness vorgelagerter Quellen.get_model_parents: (veraltet – verwende stattdessenget_lineage)get_model_performance: Ruft die Ausführungshistorie für ein Modell ab; optional einschließlich Testergebnissen.get_node_details: Ruft vollständige Details für jeden dbt-Ressourcentyp ab (Modell, Quelle, Exposure, Test, Seed, Snapshot, Makro, semantic_model).get_related_models: Findet ähnliche Modelle mithilfe semantischer Suche.get_seed_details: (veraltet – verwende stattdessenget_node_details)get_semantic_model_details: (veraltet – verwende stattdessenget_node_details)get_snapshot_details: (veraltet – verwende stattdessenget_node_details)get_source_details: (veraltet – verwende stattdessenget_node_details)get_test_details: (veraltet – verwende stattdessenget_node_details)search: [Alpha] Durchsucht Ressourcen im gesamten dbt-Projekt (nicht allgemein verfügbar).search_public_mesh_models: Findet öffentliche dbt Mesh-Modelle projektübergreifend und bestätigt die Identität des Produzenten, damit du eine verifizierte projektübergreifende Referenz erstellen kannst (nur bei Multi-Projekt-Konfigurationen).
dbt CLI
Wenn du deinem Client erlaubst, dbt-Befehle über die MCP-Tooling zu nutzen, können deine Datenmodelle, Quellen und Warehouse-Objekte verändert werden. Fahre nur fort, wenn du dem Client vertraust und die möglichen Auswirkungen verstehst.
build: Führt Modelle, Tests, Snapshots und Seeds in DAG-Reihenfolge aus.clone: Klont ausgewählte Knoten aus dem angegebenen Zustand in die Ziel-Schemas.compile: Generiert ausführbares SQL aus Modellen/Tests/Analysen; nützlich zur Validierung der Jinja-Logik.docs: Generiert Dokumentation für das dbt-Projekt.get_lineage_dev: Ruft Lineage aus der lokalen manifest.json mit Filterung nach Typ und Tiefe ab.get_node_details_dev: Ruft Knotendetails aus der lokalen manifest.json ab (Modelle, Seeds, Snapshots, Quellen).list: Listet Ressourcen im dbt-Projekt nach Typ mit Selektor-Unterstützung auf.parse: Parst und validiert Projektdateien auf syntaktische Korrektheit.run: Führt Modelle aus, um sie in der Datenbank zu materialisieren.show: Führt SQL gegen die Datenbank aus und gibt Ergebnisse zurück.test: Führt Tests aus, um Daten- und Modellintegrität zu validieren.
Admin API
Um mehr über die dbt Administrative API zu erfahren, klicke hier.
cancel_job_run: Bricht einen laufenden Job ab.get_job_details: Ruft die Job-Konfiguration ab, einschließlich Trigger, Zeitplan und dbt-Befehlen.get_job_run_artifacts: Lädt ein bestimmtes Artefakt aus einem Job-Lauf herunter; bei großen Artefakten wird eine Hinweismeldung zurückgegeben, den Vorgang mit einem jq_filter erneut zu versuchen; unterstützt jq-Filterung für gezielte Extraktion.get_job_run_details: Ruft Laufdetails ab, einschließlich Status, Zeitangaben, Schritten und Artefakten.get_job_run_error: Ruft Fehler- und/oder Warnungsdetails für einen Job-Lauf ab; optional Warnungen einschließen oder nur anzeigen.list_job_run_artifacts: Listet verfügbare Artefakte aus einem Job-Lauf auf.list_jobs: Listet Jobs in einem dbt Platform-Konto auf; optional nach Projekt oder Umgebung filtern.list_jobs_runs: Listet Job-Läufe auf; optional nach Job, Status filtern oder nach Feld sortieren.list_projects: Listet alle Projekte im dbt Platform-Konto auf.retry_job_run: Wiederholt einen fehlgeschlagenen Job-Lauf.trigger_job_run: Löst einen Job-Lauf aus; optional Git-Branch, Schema oder andere Einstellungen überschreiben.
dbt Codegen
Diese Tools helfen, die Generierung von Boilerplate-Code für dbt-Projektdateien zu automatisieren.
generate_model_yaml: Generiert Modell-YAML mit Spalten; optional Beschreibungen aus vorgelagerten Ressourcen übernehmen.generate_source: Generiert Quell-YAML durch Introspektion von Datenbank-Schemas; optional Spalten einschließen.generate_staging_model: Generiert Staging-Modell-SQL aus einer Quelltabelle.
dbt LSP
Eine Reihe von Tools, die die Fusion-Engine für erweiterte SQL-Kompilierung und spaltenbasierte Lineage-Analyse nutzen.
fusion.compile_sql: Kompiliert SQL im Projektkontext über dbt Platform.fusion.get_column_lineage: Verfolgt spaltenbasierte Lineage über dbt Platform.get_column_lineage: Verfolgt spaltenbasierte Lineage lokal (erfordert dbt-lsp über dbt Labs VSCE).
Produktdokumentation
Tools zum Durchsuchen und Abrufen von Inhalten aus der offiziellen dbt-Dokumentation unter docs.getdbt.com.
get_product_doc_pages: Ruft den vollständigen Markdown-Inhalt einer oder mehrerer Seiten von docs.getdbt.com anhand des Pfads oder der URL ab.search_product_docs: Durchsucht docs.getdbt.com nach Seiten, die einer Abfrage entsprechen; gibt Titel, URLs und Beschreibungen nach Relevanz sortiert zurück. Verwende get_product_doc_pages, um den vollständigen Inhalt abzurufen.
MCP-Server-Metadaten
Diese Tools liefern Informationen über den MCP-Server selbst.
get_mcp_server_branch: Gibt den aktuellen Git-Branch des laufenden dbt MCP-Servers zurück.get_mcp_server_version: Gibt die aktuelle Version des dbt MCP-Servers zurück.
Beispiele
Häufig verbindest du den dbt MCP-Server mit einem Agentenprodukt wie Claude oder Cursor. Wenn du jedoch daran interessiert bist, deinen eigenen Agenten zu erstellen, schaue in das Beispielverzeichnis, um zu erfahren, wie du beginnen kannst.
Abhängigkeiten
Abhängigkeiten sind an bestimmte Versionen gebunden und werden nicht automatisch aktualisiert. Nur sicherheitsrelevante Abhängigkeitsaktualisierungen werden über automatisierte Pull Requests eingereicht.
Mitwirken
Lies CONTRIBUTING.md für Anweisungen, wie du dich beteiligen kannst!
Siehe Tool-Eingaben und aufgelöster Kontext für Selektor-Deklarationen und Context-Mapper-Verträge.