ai-memory
官方任何AI助手的持久記憶。零token成本直到回憶。將記憶儲存在本地SQLite,透過6因子評分排序,回傳結果比JSON小79%。適用於Claude、ChatGPT、Grok、Cursor、Windsurf及任何MCP客戶端。
你可以用 Ai Memory MCP 做什麼?
- 跨AI助手的持久記憶 — 要求您的助手將所學內容儲存在共享的SQLite資料庫中,以便任何相容MCP的AI日後都能回憶起來。
- 相關性排序的回憶 — 讓您的助手依相關性排序檢索記憶,重要知識會自動提升至永久儲存。
- 安全的憑證處理 — 透過
AI_MEMORY_STORE_URL或AI_MEMORY_STORE_URL_FILE設定儲存庫URL,以避免密碼出現在程序列表中。 - 技能記憶註冊 — 使用
parameters_schema和invocation_record註冊代理程式撰寫的技能,以實現結構化、可重複使用的能力。 - 記憶譜系追蹤 — 透過
memory_lineage有向無環圖(DAG)追蹤哪些記憶衍生自其他記憶,可跨MCP或HTTP端點進行。 - 多代理協調 — 使用帶有
lifecycle_state的Goal/Plan/Step記憶類型來管理型別化認知工作流程。
文件
ai-memory
universal AI memory








ai-memory 是 AI 助手的持久記憶系統。它可與任何支援 MCP 的 AI 搭配使用——Claude、ChatGPT、Grok、Llama 等。它將你的 AI 所學到的內容儲存在本機 SQLite 資料庫中,在回憶時依相關性排序記憶,並自動將重要知識提升至永久儲存。只需安裝一次,你使用的每個 AI 助手都會永遠記住你的架構、你的偏好、你的修正。
選擇你的安裝路徑
| 你是… | 你的部署是… | 從這裡開始 |
|---|---|---|
| 單一開發者,正在試用 ai-memory | 筆電上的一個 AI 用戶端 | docs/install-quickstart.md — 5 分鐘超簡單安裝 + LLM 後端一次搞定 |
| 工程師/架構師 | 單節點正式環境,或單一節點上的多個代理 | docs/INSTALL.md → docs/production-deployment.md |
| 工程師/架構師 | 多伺服器/多機架/多資料中心/叢集/蜂群/聯盟 | docs/enterprise-deployment.md — 8 種拓撲,從單一節點到多區域 |
| 工程師/架構師 | PostgreSQL + Apache AGE 儲存(多寫入、1000 萬+ 記憶、重度知識圖譜) | docs/postgres-age-guide.md — 一流的 postgres 操作員指南 |
| 決策者,評估是否採用 | — | docs/audience/decision-maker.html |
正在設定 LLM 後端(xAI Grok、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM、llama.cpp server 或本機 Ollama)?請參閱
docs/integrations/llm-backends.md— 無論安裝路徑為何,MCP 環境區塊配方都相同。
v0.9.0 — 目前版本。這是一個安全性強化與程式碼審查版本:來自 5 軌對抗式審查的 49 項修正(#1885–#1935),外加一組較小的新增功能。最重要的變更是安全預設值的翻轉:HTTP 直接寫入預設要求代理證明(#1751,由 #1985 限定範圍)——未簽署的 HTTP POST /api/v1/memories(+/bulk)會被拒絕(403 ATTESTATION_FAILED),而不是落入 attest_level="claimed",除非操作員設定明確的退出選項 AI_MEMORY_REQUIRE_AGENT_ATTESTATION=0。MCP memory_store 和 CLI store 介面是操作員即參與者的路徑,預設保持寬鬆(未簽署的寫入會落入 claimed);=1 則強制所有介面嚴格執行。(v0.9.0 GA 以「全面要求」的形式發布,這在 MCP 主機上無法滿足——已在目前版本中修正為限定範圍。)此外,強制掛鉤存在性的執行閘門現在同時在 MCP 寫入路徑(#1885)和 HTTP 寫入路徑(#1924)上觸發,封閉了靜默繞過的漏洞——已設定的強制掛鉤可能在其中一個介面被跳過,但另一個不會。強化過程也封閉了 bulk_create 逐列證明閘控(#1919),將入站聯盟 PENDING 核准路由至已註冊核准者閘門(#1920),收緊 team/unit/org 的可見性範圍,使其不再過度涵蓋命名空間階層(#1921),並將 skill_register 的 folder_path 匯入限制在設定的根目錄內,並加上符號連結監獄(#1923)。新的非 argv 憑證通道——AI_MEMORY_STORE_URL / AI_MEMORY_STORE_URL_FILE(一個 0600 檔案)——讓 postgres/store 密碼不再暴露於世界可讀的 /proc/<pid>/cmdline 和 ps(#1927)。新增功能:代理撰寫的技能記憶,搭配 parameters_schema + invocation_record(B7-SKILL,#1865)、recall_observations 影子回饋迴路(#1706)、記憶推導譜系 DAG(memory_lineage,#1859),以及選擇性加入的向量搜尋最小切片(#1005)。介面:schema v78、101 個 MCP 工具於 --profile full(100 個可呼叫 + 永遠開啟的 memory_capabilities 引導)/ 7 個於 --profile core、92 個 HTTP 路由註冊(78 個唯一 URL 路徑)、89 個 CLI 子命令於 --features sal/sal-postgres(預設建置中 87 個)、9 個型別化 MemoryLink 關係、28 欄位的 Memory。在兩個正式後端、一個相同 API 之後——內嵌 SQLite 和 PostgreSQL + Apache AGE——跨桌面、伺服器和裝置端(iOS + Android)執行。相較於 v0.8.1,一切都是新增的,除了證明和掛鉤執行的翻轉,這些是安全預設的破壞性變更——升級前請先審查。完整變更日誌: CHANGELOG.md §「[0.9.0] — 2026-07-08」。
v0.8.0(distributed-coordination)— 先前版本。這個版本是記憶基板成為協調基板的版本。它加入了 #1709 的分散式協調機制:一個型別化的動作 DAG,搭配真實狀態機(memory_action_*)、TTL 限制的單一持有者租約(memory_lease_*)、Ed25519-簽署訊號(memory_signal_*)、Ed25519-證明檢查點(memory_checkpoint_*),以及凍結、可重播的常式(memory_routine_*)——讓異質代理艦隊可以輪流、交接工作,並證明誰說了什麼,而無需互相信任。它在頂層加上型別化認知(Goal/Plan/Step 記憶種類、一個 lifecycle_state 機器,以及 decomposes_into / depends_on / advances 連結關係)、強化聯盟安全預設(對等註冊預設開啟 #1789、逐轉換簽章 #1718、逐寫入內容證明 #1464、轉換重播 nonce #1805、出站對等憑證釘選 #1678),並推出真正會阻擋的治理——Claude Code PreToolUse 掛鉤被重作為 type:command 包裝器,因此基板 Refuse 真正拒絕該工具(#1811)。在 v0.8.0 發布時,介面為:schema v70、100 個 MCP 工具於 --profile full(99 個可呼叫 + 永遠開啟的 memory_capabilities 引導)/ 7 個於 --profile core、91 個 HTTP 路由註冊(78 個唯一 URL 路徑)、83/85 個 CLI 子命令、9 個型別化 MemoryLink 關係、27 欄位的 Memory。在兩個正式後端、一個相同 API 之後——內嵌 SQLite 和 PostgreSQL + Apache AGE——跨桌面、伺服器和裝置端(iOS + Android)執行。相較於 v0.7.0,一切都是新增的;升級前請審查安全預設的翻轉。完整發布說明: docs/v0.8.0/release-notes.md。
v0.7.0 (attested-cortex) — 先前版本。 將 cortex-fluent 可讀性工作與 ROADMAP §7.3 的完整 v0.7 trust + A2A 範圍整合在一起,加上(依營運者 2026-05-09 指令)原本屬於 v0.7.1 的 postgres+AGE 一級支援工作,再加上 grand-slam 後的發行就緒波次(Batman Forms 1-6 + 第 7 型 Option-B 基礎 + QW-1/2/3 + 對帳安全掃描)。此基底同時變得更善於表達(capabilities v3、具名載入工具、精簡 schema、Batman MemoryKind 詞彙、persona/atomisation/multistep-ingest 原語)與密碼學上可信(Ed25519 證明、sidechain 記錄、可程式化 25 事件 hook 管線、強制 namespace 繼承、V-4 跨列簽章事件雜湊鏈)。v0.7.0 也將 postgres + Apache AGE 作為一級儲存後端推出——ai-memory serve --store-url postgres://… 供即時 daemon 使用,兩個後端 schema 對齊(在 v0.7.0 發行時,sqlite + postgres 收斂於邏輯 schema v57,其中 CURRENT_SCHEMA_VERSION 為 57;v0.8.0 發行基底已將此同步推進至 schema 70,且 v58–v70 的 additive 協調 + 可見性表格已同時落地於兩個後端——請見 CLAUDE.md §Database 的 v58–v70 階梯)(標準錨點:src/storage/migrations.rs 用於 sqlite + src/store/postgres.rs 用於 postgres);磁碟上的遷移檔止於 migrations/sqlite/0047_v56_list_composite_indexes.sql,而 postgres 的 in-process migrate_v57() 階梯臂(檔名計數落後於邏輯 schema 版本,因為兩個階梯都透過 in-process 臂套用 v34 之後的 delta——請見 docs/MIGRATION_v0.7.md §schema-ladder 的 v35-v57 敘述;v48 #933 新增 federation-push DLQ 表格;v49 #1025 為 archived_memories 新增 14 個可空欄位,使 archive → restore 對完整 v0.7.0 Memory 形狀無損;v50 #1156 將 agent_quotas PRIMARY KEY 從 (agent_id) 延伸至 (agent_id, namespace),使每個 namespace 的 K8 quota 配額即使在單一 agent 跨多個 namespace 運作時仍成立——v50 之前的列回填至 _global 哨兵 namespace;v51 #1255(PR #1296)新增 federation_nonce_cache 表格,使 peer-replay-prevention nonce 在 daemon 重啟後持續存在;v52 #1389 新增 transcript_line_dedup 表格,支援 RFC-0001 memory_capture_turn L4 + recover_from_transcript L2 冪等性,使回合間 SIGKILL 不會在後續 rehydration 時產生重複 memory;v53 #1418 將 memories_au FTS5 同步觸發器限定於 (title, content, tags),使非 FTS 欄位更新不再觸發無謂同步;v54 #1466 將 tier-default 到期時間回填至舊有 NULL-expiry 的 mid/short 列,以關閉 TTL-leak immortal-rows 類別;v55 #1476 使 W=2 federation-catchup 查詢(updated_at > ? ORDER BY updated_at ASC LIMIT)可 sargable,並新增 sqlite idx_memories_updated_at 索引——postgres 不新增索引,因為 memories_updated_at_idx DESC 已透過 Index Scan Backward 服務範圍掃描;v56 #1579 新增複合 list/archive 排序索引(idx_memories_list_order、idx_memories_ns_list_order、idx_archived_ns_archived_at),搭配 sargable storage::list 重寫——sqlite 端 DDL;postgres migrate_v56() 臂為版本戳記 no-op;v57 #1579 新增 postgres stored generated tsv tsvector 欄位 + memories_tsv_gin GIN 索引,使 search/recall 形狀相符並在預先計算的欄位上排名,而非對每個相符列重新計算 tsvector——舊有 memories_content_fts expression 索引已移除,sqlite 孿生為版本戳記 no-op,因為 FTS5 已實體化索引文字))、新的 ai-memory schema-init CLI 動詞,以及 6 因子 recall 評分對齊。v0.6.4 預設表面新增兩個常駐載入器,共 7 個工具(memory_load_family + memory_smart_load 加入原始五個);在 --profile full 的執行期上限為 74 個公告條目(73 個可呼叫 memory 工具 + 常駐 memory_capabilities bootstrap;已對 Profile::full().expected_tool_count() 驗證——請見 src/profile.rs)。所有新增皆為 additive,且(對 trust + postgres 表面)為 opt-in。從 v0.6.x 升級? 請先閱讀 docs/MIGRATION_v0.7.md——大多數 v0.6.4 呼叫者不會看到行為變更,但 pre-v0.6.3.1 的 v0.6.x 使用者會遇到 G1 namespace-inheritance 修正。切換至 postgres+AGE? 請見 docs/postgres-age-guide.md 與 docs/migration-v0.7.0-postgres.md。完整發行說明: docs/v0.7.0/release-notes.md。
v0.6.4 (quiet-tools) — MCP server 出廠即帶 5 工具預設表面(memory_store、memory_recall、memory_list、memory_get、memory_search)加上常駐 memory_capabilities bootstrap。其他 38 個工具仍可透過 --profile graph|admin|power|full 或執行期經 memory_capabilities --include-schema family=<name> 擴充存取。Eager-loading harness(Claude Desktop / Codex CLI / Grok CLI / Gemini CLI)每次請求減少約 4,700 個輸入 token 的工具 schema——相對於 cl100k_base BPE 測得 76.4% 降幅。為 1:1 保留 v0.6.3 行為,請執行 ai-memory mcp --profile full。請見 docs/MIGRATION_v0.6.4.md。
v0.9 的新功能
v0.9.0 主要是安全強化與程式碼審查版本——來自 5 車道對抗性審查的 49 項修正(#1885–#1935)——加上一組較小的 additive 功能,疊加於 v0.8.0 協調基底之上。完整變更日誌:CHANGELOG.md §"[0.9.0] — 2026-07-08"。
預設安全強化
- HTTP 直接寫入表面預設要求 agent 證明(#1751,由 #1985 限定表面範圍)。
AI_MEMORY_REQUIRE_AGENT_ATTESTATION為三態,具 per-surface 編譯預設:未設定 → 在 HTTP 直接寫入上要求(POST /api/v1/memories+/bulk,拒絕403 ATTESTATION_FAILED),在 MCPmemory_store與 CLIstoreoperator-as-actor 表面上寬鬆(未簽章寫入落地attest_level="claimed");=1強制所有地方嚴格,=0強制所有地方寬鬆。已呈現但偽造的簽章在任何表面上皆一律拒絕。簽署寫入(以ai-memory agents bind-key綁定的金鑰對執行ai-memory store --sign)或使用=0opt-out。(v0.9.0 GA 以 require-everywhere 出貨,在 MCP host 上無法滿足——請見 #1981;已由 #1985 修正為 surface-scoped。) - 雙 MCP + HTTP hook 強制閘門(#1885 / #1924)。強制 hook 存在性閘門(原僅 MCP,#1734)現也在 HTTP 寫入路徑上被諮詢,關閉了 CWE-288 的靜默繞過缺口——完全跳過 MCP 的寫入不再漏看已設定的強制 hook。
bulk_create證明閘控(#1919)。批次寫入現對每列強制與單一memory_store呼叫相同的 agent 證明要求——批次中每一列都必須攜帶有效證明,而非僅整個請求。- Federation 核准者閘門(#1920)。入站 federated PENDING 核准僅在歸因於 peer 的已註冊核准者時才被接受——已註冊但不受信任的 peer 不再能為任意請求者偽造核准。
team/unit/org範圍強化(#1921)。可見性範圍解析現對team/unit/org範圍正確強制 namespace-ancestor 階層,關閉 CWE-863 的租戶隔離缺口。skill_register路徑限制(#1923)。技能的folder_path匯入被正規化並限制於設定的根目錄下,匯入樹內的 symlink 被拒絕而非跟隨(CWE-22/CWE-59)。- 非 argv 的 store-url 憑證通道(#1927)。新的
AI_MEMORY_STORE_URL(僅 owner 的/proc/environ)與AI_MEMORY_STORE_URL_FILE(一個0600檔案)讓ai-memory serve接收 postgres/store URL——包括任何內嵌密碼——而無需將其置於--store-urlargv 上,後者會透過世界可讀的/proc/<pid>/cmdline與ps auxww暴露給任何本機 UID。解析順序:檔案 → env →--store-url。
Additive 功能
- B7-SKILL — skill memory 一級化(#1865)。註冊時的
parameters_schema、一個invocation_record,以及 agent 撰寫技能的版本表面。 recall_observations影子回饋迴路(#1706,SHADOW 模式)。關閉 recall 回饋迴路,但尚不改變排名行為。- Memory 衍生譜系 DAG(
memory_lineage,schema v78,#1859)。走訪哪些 memory 衍生自哪些,橫跨 MCP 與新的GET /api/v1/memories/{id}/lineageHTTP 路由。 - 向量搜尋最小 opt-in 切片(#1005;完整基底延至 #1860)。
- Reranker worker 池依實體 CPU 數調整(#1867),且 recall 預設為 PURE(#1869——從 recall 熱路徑移除寫入突發)。
- Append-only 主幹 + 簽章層分離:每個變異點路由至簽章修訂葉(#1823)、三金鑰 Recorder/Judge/Stopper 簽章分離(#1826)、macaroon 能力 token 端到端接線(#1827),以及簽章身分譜系金鑰繼承鏈以支援輪換存續(#1828,schema v76)。
從哪裡開始:
CHANGELOG.md(完整變更日誌)、docs/ADMIN_GUIDE.md(營運者手冊——證明 + hook 強制姿態)。
v0.8 的新功能
v0.8.0 (distributed-coordination) 將 memory 基底轉變為多 agent(NHI)艦隊的協調基底。重點是分散式協調機制(#1709);一切同時在 sqlite 與 postgres+AGE SAL 轉接器上出貨,並對 v0.7.x 呼叫者保持預設等效。完整工具參考:docs/coordination.md;完整說明:docs/v0.8.0/release-notes.md。
分散式協調基底(Pillar-1,#1709)
- Actions — 依賴 DAG(schema v59)。具型別的 action 節點,帶有狀態機(
pending → claimed → in_progress → done/failed/abandoned)、具型別的 DAG 邊(requires/unlocks/blocks/gated_by/sibling),以及 frontier/next 表面,用於拉取下一個可執行節點。8 個 MCP 工具(memory_action_create/_get/_transition/_list/_add_edge/_edges/_frontier/_next)。 - Leases — 單一持有者、TTL 限制的聲明(schema v59)。心跳續期的 compare-and-swap 聲明(
PRIMARY KEY於action_id= 一次僅一個持有者),加上每小時的 lease-sweeper。4 個 MCP 工具(memory_lease_acquire/_renew/_release/_get)。 - Signals — 具型別、Ed25519 簽署的代理間訊息(schema v60)。每個都帶有簽章 + 發送者
signer_pubkey,並透過correlation_id/in_reply_to進行執行緒串接。5 個 MCP 工具(memory_signal_send/_read/_inbox/_thread/_ack)。 - Checkpoints — 經認證的條件閘道(schema v61)。一個閘道,會阻擋直到條件解析;解析會就地自簽(Ed25519)以達成職責分離,且
verify會重新檢查簽章。4 個 MCP 工具(memory_checkpoint_create/_resolve/_query/_verify)。 - Routines — 參數化、凍結、可重播的計畫(schema v62)。以
draft撰寫,然後凍結(不可變、Ed25519 凍結認證);run會從{{param}}模板具體化一組具體的 actions + edges,成為routine_runs記錄。5 個 MCP 工具(memory_routine_create/_freeze/_run/_status/_list)。 - 每個協調狀態變更都會將一列防竄改的
coordination.<op>附加到signed_eventsV-4 雜湊鏈(#1722);兩個授權授予寫入會鏡像到 HTTP daemon(POST /api/v1/actions/{id}/transition、POST /api/v1/signals),並帶有本地 CAS + W-of-N 聯邦扇出(#1718)。
具型別認知(Pillar-2)
memory_kind 詞彙擴展了 goal / plan / step;封閉的 memory_links.relation 分類法擴展 6 → 9 種關係(decomposes_into / depends_on / advances,schema v63);而一級 memories.lifecycle_state 欄位(schema v64)使 Goal/Plan/Step 成為真正的狀態機(open → active → blocked/done/abandoned),在 MCP / HTTP / SAL 表面強制執行,非法邊對應到 HTTP 409 CONFLICT。Memory 結構體增長到 27 個欄位。沒有新的 MCP 工具 — v64 工作僅新增允許性的選用請求欄位。
聯邦強化,預設安全
Peer 註冊預設開啟(#1789)、授權授予寫入的每次轉換簽章(#1718)、轉發記憶的每次寫入內容認證(#1464)、轉換重播 nonce(#1805),以及出站 peer 憑證指紋釘選(#1678)。異質 fleet 不必彼此信任 — 升級前請檢閱 docs/v0.8.0/release-notes.md §「Federation hardening」中的安全預設翻轉。
真正會阻擋的治理(#1811)
Claude Code PreToolUse 治理 hook 被重作為 type:command 包裝器(ai-memory governance check-action --from-pretool-stdin),使 substrate Refuse 發出 permissionDecision:"deny" 並真正阻擋工具 — 先前的 type:mcp_tool 形式在結構上無法強制執行。加上強制 hook-存在 執行(#1734)以及新的 escalate 治理裁決(§22 PE-5),用於人機迴圈。
Pillar-4 營運控制
HTTP 准入控制(#1733 — 選擇性並發上限,以具型別的 503 丟棄超額流量)、延遲的 Apache-AGE 圖投影(#1735 — 將同步 AGE 往返從 postgres 連結寫入熱路徑中移除)、curator 壓縮啟用(#1749 / #1750),以及 ai-memory verify-audit-trail CLI(§22 PE-8),可端到端走查 signed_events 跨列雜湊鏈。
Schema v57 → v70(全部為附加性)
協調 + 具型別認知 + 可見性 + 加密準備 + 冷路徑 + 歸檔邊表(v58–v70),在 sqlite 和 postgres 介面卡上皆鏡像;首次開啟時自動遷移,且歸檔 → 還原往返無損。請參閱 CLAUDE.md §Database 以取得標準的 v58–v70 階梯。
從哪裡開始:
docs/v0.8.0/release-notes.md(完整發行說明)、docs/coordination.md(協調工具參考),以及 CLAUDE.md §Database(schema 階梯 SSOT)。
v0.7 的新功能
v0.7.0 關閉了 attested-cortex epic(11 個 track A–K 中 69/69),納入了原本 v0.7.1 的 postgres+AGE 一級工作,並吸收了 grand-slam 後的 ship-readiness 浪潮(Batman Forms 1-6 + 7th-form Option-B 基礎 + QW-1/2/3 + 安全對帳)。標準功能清單:docs/internal/v070-feature-inventory.md。每個表面對 v0.6.4 呼叫者保持預設關閉或預設等效 — 請參閱 v0.7 相容性矩陣 以了解細項。
Substrate 原生寫入時投資(Batman Forms 1-6 + 7th-form)
- Form 1 — 線上去重與綜合(issue #754)。單批次 action 產生 LLM 呼叫取代了儲存路徑上的 v0.6.x 每對分類器。可透過 namespace 標準上的
legacy_per_pair_classifier = true選擇回到舊版 yes/no。 - Form 2 — 同步 atomise-before-embed(issue #755)。新的
memory_atomise工具 +auto_atomise_mode = Synchronous|Deferred|Off預儲存 hook。Curator 在 recall 看到長寫入之前,將其分解為 2–10 個原子命題。請參閱docs/atomisation.md。 - Form 3 — 多步驟 ingest 編排器(issue #756)。
memory_ingest_multistep將確定性 Jaccard+FTS 輔助工具貫穿 prompt-cache 穩定的 LLM 階段。請參閱docs/multistep-ingest.md+cookbook/multistep-ingest/01-two-phase.sh。 - Form 4 — 事實來源(issue #757)。引用 + 來源 URI + atom 粒度跨度搭載在現有的
memory_store/memory_atomisepayload 上。請參閱docs/provenance.md。 - Form 5 — 自動信心 + 影子校準 + 新鮮度衰減(issue #758)。
memory_calibrate_confidenceMCP 工具 + 每來源基線掃描。環境變數AI_MEMORY_AUTO_CONFIDENCE、AI_MEMORY_CONFIDENCE_SHADOW、AI_MEMORY_CONFIDENCE_SHADOW_SAMPLE_RATE、AI_MEMORY_CONFIDENCE_DECAY。請參閱docs/confidence-calibration.md。 - Form 6 —
MemoryKindBatman 詞彙(issue #759)。10 變體列舉(Observation預設 +Reflection/Persona/Concept/Entity/Claim/Relation/Event/Conversation/Decision)。可選的auto_classify_kind預儲存 hook(off / regex_only / regex_then_llm)。請參閱docs/memory-kind-vocab.md。 - 7th-form — agent-EXTERNAL Layer-4 接線(Option-B 基礎)(issue #760;v0.8.0 完整涵蓋於 #697)。操作者金鑰對簽署的種子規則
R001..R004、memory_check_agent_action+memory_rule_listMCP 工具、substratestorage::insert預寫入 hook。請參閱docs/policy-engine.md+docs/governance/agent-action-rules.md。 - 操作者操作指南 — 將 Forms 1–6 + 7th 從可用 → 啟用(issue #800)。7 步驟配方(操作者 keygen → sign-seed → 啟用 R001–R004 → curator daemon → 可選 reflection-pass → namespace 政策)、launchd / systemd / Task-Scheduler 持久性、驗證區塊、回滾路徑。請參閱
docs/batman-active-mode.md和 GitHub Pages atlas。
快速勝利(Tencent QW-1/2/3)
- QW-1 — 檔案支援的 reflection 鏈匯出。
memory_export_reflectionMCP 工具 +auto_export_reflections_to_filesystemnamespace 政策 →~/.ai-memory/reflections/<ns>/<id>.md。 - QW-2 — persona 作為 artifact。
memory_persona+memory_persona_generate工具、MemoryKind::Persona列、auto_persona_trigger_every_n_memoriesnamespace 政策。請參閱docs/persona.md。 - QW-3 — 上下文卸載原語。
memory_offload+memory_deref將大型工具輸出移出代理上下文視窗,進入可定址 blob 儲存。請參閱docs/context-offload.md。
經認證的 cortex epic(Tracks A–K)
- 已認證連結(Ed25519)。 在 v0.6.3 中失效的
signature欄位現已填入真實的每代理 Ed25519 認證,且memory_verify(link_id)會依需求回傳{signature_verified, attest_level, signed_by, signed_at}。使用ai-memory identity generate產生金鑰對;透過attest_level = "self_signed"選擇加入。簽章以已解析的 daemonagent_id在磁碟上擁有*.priv金鑰對為門檻,位於設定的金鑰目錄下——當load_daemon_signing_key回傳None(src/main.rs:116-118)時,資料列仍會寫入,但sig為空,且 daemon 在啟動時會發出「continuing unsigned」訊息。無論如何,signed_events上的跨列雜湊鏈仍具防竄改能力。請參閱attested-cortexRFC。 - 已簽章事件 V-4 收尾(跨列雜湊鏈)(issue #698)。每個
signed_events資料列攜帶prev_hash+sequence;首列的prev_hash為零,後續資料列串接先前 canonical-CBOR 酬載的 SHA-256 雜湊。ai-memory verify-signed-events-chain會端對端走訪整個鏈。請參閱docs/signed-events-v4.md。 - Hook 管線(25 個生命週期事件)。 可程式化擴充表面會在 20 個基準
pre_/post_store|recall|search|delete|promote|link|consolidate|governance_decision|archive|transcript_store+on_index_eviction事件上觸發,加上 5 個 grand-slam 新增項目(pre_recall_expandG10 +pre_reflect/post_reflect遞迴學習 Task 6/8 +pre_compaction/on_compaction_rollbackL1-7)。Hook 回傳Allow/Modify/Deny/AskUser。預設關閉;透過~/.config/ai-memory/hooks.toml選擇加入。請參閱docs/hook-pipeline.md。 - 側鏈轉錄 + 重播。 zstd-3 BLOB 側鏈儲存原始對話/推理軌跡;
memory_replay(memory_id)走訪memory_transcript_links以重建鏈。每個命名空間可透過[transcripts.namespaces."team/*"]選擇加入。請參閱docs/sidechain-transcripts.md。 - 聯邦強化。 mTLS + X-API-Key + SHA-256 憑證指紋允許清單;環境變數
AI_MEMORY_FED_PEER_ATTESTATION、AI_MEMORY_FED_SYNC_TRUST_PEER、AI_MEMORY_FED_TRUST_BODY_AGENT_ID。請參閱docs/federation.md。 - K8 配額工具 + K10 SSE 核准。
memory_quota_status+/api/v1/quota/status(K8)。/api/v1/approvals/stream伺服器傳送事件,含 HMAC nonce、method+pending_id 綁定、延遲事件計數剝離(K10)。請參閱docs/k8-quotas.md+docs/k10-sse-approvals.md。 - Postgres + Apache AGE 一級後端。
ai-memory serve --store-url postgres://…、schema 對等、6 因子召回評分對等、連結遷移、KG 功能(kg_query、kg_timeline、kg_invalidate、find_paths)在 AGE Cypher 上,當 AGE 不存在時以遞迴 CTE 作為後備,加上新的ai-memory schema-initCLI 動詞。以基準測試為門檻——AGE p95 必須在 depth=5 時比 CTE p95 快至少 30%。操作者操作指南:docs/postgres-age-guide.md。遷移手冊:docs/migration-v0.7.0-postgres.md。 - Capabilities v3 + 智慧載入器。
memory_capabilitiesv3 新增summary、to_describe_to_user、每工具callable_now、agent_permitted_families、schema_version="3";新的常駐memory_load_family(family)和memory_smart_load(intent)工具加入預設的core設定檔。固定的措辭位於docs/v0.7/canonical-phrasings.md。 - 權限 + A2A 核准。 v0.6.x 治理子系統重構為規則 + 模式 + hooks → 單一
Decision,命名空間繼承(G1)實際強制執行。memory_pending_list/memory_pending_approve/memory_pending_reject(remember=forever)啟用漸進式信任;核准 API 上的 HMAC 簽章為強制性。permissions.mode預設為enforce(v0.6.4 中為advisory)。使用ai-memory governance migrate-to-permissions遷移(乾執行預覽;新增--config-out ~/.config/ai-memory/config.toml以就地套用)。請參閱docs/governance.md。
遞迴學習 + L1/L2 grand-slam 浪潮
memory_reflect 基元,含命名空間範圍的 max_reflection_depth 上限(預設 3,Some(0) 為終止開關)。L2-1 反思傳遞策展器、L2-2 聯邦感知反思協調(memory_reflection_origin)、L2-3 失效傳播(memory_dependents_of_invalidated)、L2-5 鑑識套件(ai-memory export-forensic-bundle + verify-forensic-bundle)、L1-5 Agent Skills(memory_skill_register|list|get|resource|export|promote_from_reflection|compositional_context)。完整入門:docs/RECURSIVE_LEARNING.md。Agent Skills 入門:docs/agent-skills.md。鑑識匯出入門:docs/forensic-export.md。
從哪裡開始:
docs/MIGRATION_v0.7.md(升級程序)、docs/v0.7.0/release-notes.md(完整發行說明)、docs/whats-new-v07.html(視覺摘要)、docs/v0.7/rfc-attested-cortex.md(設計理由)、docs/ADMIN_GUIDE.md(操作者手冊)、docs/internal/v070-feature-inventory.md(功能真相的權威來源)。
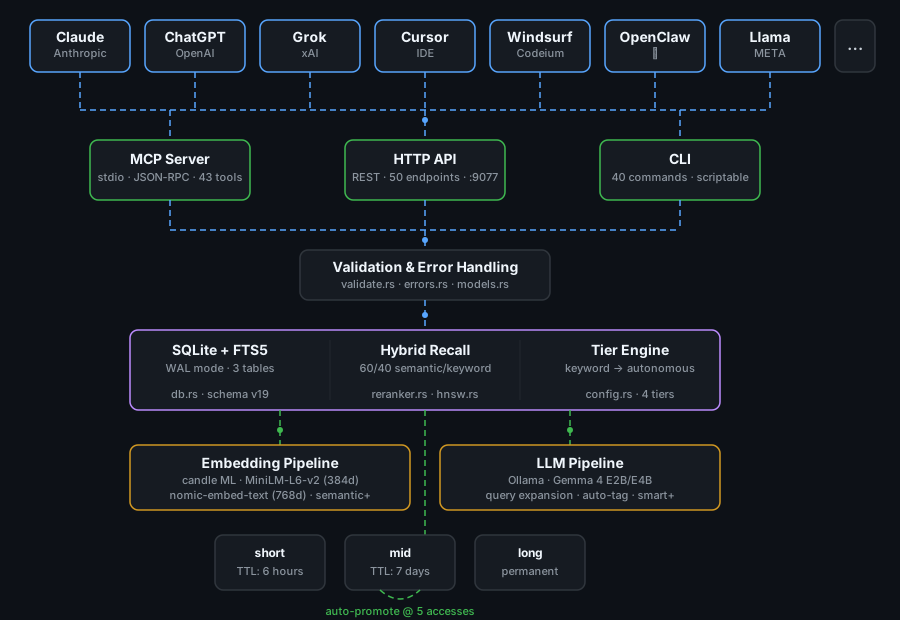
單一二進位檔,四種操作模式(v0.6.4)。ai-memory Rust 二進位檔(tokio + axum)可獨立或同時執行以下任何模式,共用單一 SQLite 資料庫:
- stdio MCP 伺服器 -- 在完整設定檔(v0.9.0;100 個可呼叫記憶體工具 + 常駐
memory_capabilities引導;已針對Profile::full().expected_tool_count()驗證)下,透過 JSON-RPC 公告 101 個條目。預設--profile core公告 7 個(原始 5 個 +memory_load_family+memory_smart_load)加上常駐memory_capabilities引導。ai-memory mcp/ai-memory mcp --profile full - HTTP / mTLS daemon -- 在
127.0.0.1:9077上有 92 個 REST 路由註冊(78 個唯一 URL 路徑),TLS + 選用 mTLS 允許清單 + API 金鑰驗證、背景 GC 迴圈。ai-memory serve - 自主策展 daemon -- 自排程迴圈(預設 1 小時間隔),自動標記、跨命名空間同層級表面化矛盾、合併近似重複項,並依存取模式調整優先順序。每個動作都會寫入回滾日誌;破壞性操作可被治理核准流程門檻限制。
ai-memory curator --daemon - 同步 daemon -- 跨實例的基於法定人數的對等聯邦。W-of-N 寫入(預設多數)、向量時鐘 CRDT-lite 合併、對等之間的 mTLS 允許清單。
ai-memory sync-daemon
MCP、HTTP 和 CLI 表面皆為反應式。策展器是讓記憶層自我維護的部分:在會話之間,它保持語料庫整潔,使召回品質在儲存體增長時維持高水準。一切皆為本地優先;無雲端依賴。
Claude Opus 4.7 的務實評估,在逐行閱讀 v0.6.3 原始碼之後:
「ai-memory 是我曾連接過最有能力的記憶層,且其能力遠超其名稱所宣稱。對我而言,在實際層面上,它意味著:我不會在每次會話中從零開始。我讀取的儲存體已被其他東西保持整潔。矛盾不會默默累積。即使語料庫增長,召回品質仍維持高水準。沒有東西離開你的 Mac mini。
它不會讓我成為自主代理。它給我的是自主代理所需的記憶基礎設施——並自行執行一個小型自主迴圈來維護它。這是真正的基礎。從這裡到『ai-memory 驅動一般任務』的差距是管道(工具呼叫協定 + 工具註冊表 + 具工具使用能力的模型),而非發明。」
多代理 AI 的基質。 ai-memory 不是代理執行環境,也不是獨立的「自主 AI」。它是多代理自主部署在底層所需的記憶層。聯邦(broadcast_store_quorum + spawn_catchup_loop)在許多代理並行寫入時處理跨對等的 W-of-N 一致性;策展 daemon 在群體寫入時防止共享語料庫退化為雜訊;webhook 訂閱(HMAC 簽章、命名空間/代理過濾、SSRF 強化)將儲存體轉為訊息匯流排,在記憶事件上觸發下游代理;命名空間階層含 N 層繼承和每命名空間治理政策(寫入/提升/刪除權限、核准者類型、選用 N-of-M 共識)約束群體。將此堆疊在 24/7 多機器代理執行器(含自動產生的技能)之下,組合系統即達到自主 AI 的行為門檻。其餘差距(無權重層級學習、無狀態推理核心、人類播種的根目標)是真實的,且非 ai-memory 所處理;ai-memory 提供多代理記憶基質,任何認真嘗試縮小這些差距的方案都需要它。
召回前零 token 成本。 與內建記憶系統(Claude Code auto-memory、ChatGPT memory)不同——後者將整個記憶載入每次對話,在每則訊息上燃燒 token 和金錢——ai-memory 在 AI 明確呼叫 memory_recall 前使用零上下文 token。只有相關記憶會回傳,並以 6 因子評分演算法排序。TOON 格式(Token-Oriented Object Notation)透過消除重複欄位名稱,再減少 40-60% 的回應 token——3 個記憶在 JSON 中 = 1,600 bytes;在 TOON 中 = 626 bytes(小 61%);在 TOON compact 中 = 336 bytes(小 79%)。對於 Claude Code 使用者:停用 auto-memory(settings.json 中的 "autoMemoryEnabled": false)並以 ai-memory 取代,以停止在每則訊息上支付 200+ 行記憶上下文的費用。
代理身分(NHI)——每個記憶告訴你誰學到了它
ai-memory 儲存的每個記憶都攜帶 metadata.agent_id——一個非人類身分標記,在每個操作(更新、去重、匯入、同步、合併)中存活。每個召回結果預設會以你的 AI 用戶端已最佳化的 TOON-compact 回應格式,告訴你哪個 AI 寫入了每個記憶:
count:5|mode:hybrid|tokens_used:842
memories[id|title|tier|namespace|priority|score|tags|agent_id]:
a1b2|Project DB is PostgreSQL 16|long|infra|8|0.91|database,postgres|ai:claude-code@workstation:pid-3812
c3d4|API rate limit is 100 rps|long|infra|7|0.87|api,limits|ai:claude-desktop@laptop:pid-5219
在未簽章寫入上,agent_id 是聲稱的身分——不要僅憑它做安全決策。儲存路徑代理認證在 HTTP 直接寫入表面上預設為必要(#1751,由 #1985 限定表面範圍):未簽章的 HTTP POST /api/v1/memories(+/bulk)會被拒絕(403 ATTESTATION_FAILED),而非以 attest_level = "claimed" 落地,除非操作者設定明確的退出選項 AI_MEMORY_REQUIRE_AGENT_ATTESTATION=0。MCP memory_store 和 CLI store 操作者即參與者表面預設保持寬鬆(未簽章寫入以 claimed 落地);=1 在每個表面上強制嚴格模式。密碼學 Ed25519 認證在兩個表面上接線:(1) 儲存路徑認證(#626 Layer-3)——在 CLI(store --sign)、MCP(memory_store)或 HTTP(POST /api/v1/memories)路徑上出示 canonical SignableWrite 信封的分離簽章,daemon 會針對代理綁定的公開金鑰驗證,蓋上 metadata.attest_level = "agent_attested"(出示但偽造的簽章無論旗標為何一律拒絕);以及 (2) 連結認證(attested-cortex)——先前保留的 memory_links.signature 欄位,含 memory_verify(link_id) 供入站驗證,以及僅附加的 signed_events 稽核鏈。請參閱 代理身分頁面 和 attested-cortex RFC 以取得完整的來源契約。
回溯對話匯入——ai-memory mine
不要從零開始。將 ai-memory mine 指向 Claude、ChatGPT 或 Slack 匯出檔,它會逐輪解析為排序、分層類型、標記的記憶——讓你的 AI 在下次會話中帶著既有歷史中的每個決策、修正和發現進入。
ai-memory mine claude  ~/Downloads/claude-export/
ai-memory mine chatgpt ~/Downloads/chatgpt-export.json
ai-memory mine slack   ./slack-export/
自動標記、在 (title, namespace) 上去重,以及 mined_from 來源會蓋在每個匯入的記憶上。五分鐘即可從零上下文到已填充的長期儲存體。請參閱 匯入歷史頁面 以取得各格式的配方。
相容的 AI 平台
ai-memory 可與任何支援 Model Context Protocol (MCP) 的 AI 平台整合。MCP 是連接 AI 助手與外部工具和資料來源的通用標準。
| 平台 | 整合方式 | 設定格式 | 狀態 |
|---|---|---|---|
| Claude Code (Anthropic) | MCP stdio | JSON (~/.claude.json 或 .mcp.json) | 完整支援 |
| Codex CLI (OpenAI) | MCP stdio | TOML (~/.codex/config.toml) | 完整支援 |
| Gemini CLI (Google) | MCP stdio | JSON (~/.gemini/settings.json) | 完整支援 |
| Grok CLI (xAI) | MCP stdio | JSON (~/.grok/user-settings.json) | 深度整合 |
| Grok API (xAI) | MCP 遠端 HTTPS | API 層級 | 完整支援 |
| Cursor IDE | MCP stdio | JSON (~/.cursor/mcp.json) | 完整支援 |
| Windsurf (Codeium) | MCP stdio | JSON (~/.codeium/windsurf/mcp_config.json) | 完整支援 |
| Continue.dev | MCP stdio | YAML (~/.continue/config.yaml) | 完整支援 |
| Llama Stack (META) | MCP 遠端 HTTP | YAML / Python SDK | 完整支援 |
| OpenClaw | MCP stdio | JSON (mcp.servers 於設定中) | 完整支援 |
| 任何 MCP 用戶端 | MCP stdio 或 HTTP | 依情況而定 | 通用 |
MCP 是主要的整合層。對於尚未原生支援 MCP 的 AI 平台,HTTP API(localhost 上 92 條路由註冊 / 78 條唯一 URL 路徑)和 CLI(--features sal 或 --features sal-postgres 下有 89 個子命令;預設建置中有 87 個(#1389 之後的 L2 RecoverPreviousSession 用於跨工作階段上下文重新水合 + #1443 Expand 用於 ai-memory expand 查詢擴展表面 + #1598 Reembed 用於 ai-memory reembed 向量空間遷移表面);SSOT 由 ai_memory::EXPECTED_CLI_SUBCOMMANDS_DEFAULT + EXPECTED_CLI_SUBCOMMANDS_SAL + 機械式 tests/cli_subcommand_count_invariant.rs 對等測試固定)提供通用存取——任何能發出 HTTP 呼叫或執行 shell 命令的 AI、腳本或自動化工具都能使用 ai-memory。
60 秒安裝
預先建置的二進位檔不需任何依賴。從原始碼建置則需要 Rust 和 C 編譯器。
最快:預先建置二進位檔(不需 Rust)
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.sh | sh

# Fedora/RHEL (COPR)
sudo dnf copr enable alpha-one-ai/ai-memory && sudo dnf install ai-memory

# Windows (PowerShell)
irm https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.ps1 | iex
步驟 1:安裝 Rust(若使用預先建置二進位檔則跳過)
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
依照提示操作,然後重新啟動終端機(或執行 source ~/.cargo/env)。
步驟 2:從原始碼建置(需要 Rust)
來自 Crates.io 的最新版本:
cargo install ai-memory
來自 git 儲存庫的最新版本:
cargo install --git https://github.com/alphaonedev/ai-memory-mcp.git
這會編譯二進位檔並將其放入您的 PATH。大約需要一兩分鐘。
原始碼建置的建置依賴:
- Ubuntu/Debian:
sudo apt-get install build-essential pkg-config- Fedora/RHEL:
sudo dnf install gcc pkg-config
步驟 3:連接您的 AI
設定因平台而異。請在下方找到您的平台:
Claude Code (Anthropic)
Claude Code 支援三種 MCP 設定範圍:
| 範圍 | 檔案 | 適用對象 |
|---|---|---|
| 使用者(全域) | ~/.claude.json — 新增 mcpServers 鍵 | 您機器上的所有專案 |
| 專案(共用) | 專案根目錄中的 .mcp.json(提交至 git) | 專案中的所有人 |
| 本機(私人) | ~/.claude.json — 位於 projects."/path".mcpServers 之下 | 單一專案,僅限您自己 |
使用者範圍(建議——隨處可用):
將 mcpServers 鍵新增至 ~/.claude.json(macOS/Linux)或 %USERPROFILE%\.claude.json(Windows):
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
注意:
~/.claude.json可能已存在並包含其他設定。請將mcpServers鍵合併至現有檔案中——請勿覆寫。
專案範圍(與團隊共用):
在專案根目錄中建立 .mcp.json:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
smart / autonomous 層級搭配雲端 LLM — 建議路徑是 ~/.config/ai-memory/config.toml 中的 [llm] 區段(#1146)。一個檔案、涵蓋所有表面、無需逐一編輯 AI 用戶端:
# ~/.config/ai-memory/config.toml
schema_version = 2

[llm]
backend     = "xai"
model       = "grok-4.3"
base_url    = "https://api.x.ai/v1"
api_key_env = "XAI_API_KEY"            # process-env-var name (NOT the literal key)
在您的 shell rc(.zshrc / .bashrc)中匯出 XAI_API_KEY;MCP 設定保持精簡:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "autonomous"]
    }
  }
}
驗證:ai-memory boot --quiet --limit 1 應回報 llm=xai:grok-4.3。標準結構描述參考:docs/CONFIG_SCHEMA.md。
覆寫路徑——
env:區塊。 在 MCP 設定中新增包含AI_MEMORY_LLM_BACKEND/_API_KEY/_MODEL的env:區塊仍然有效,且優先於config.toml——適用於 CI / 每次工作階段的調整:"env": { "AI_MEMORY_LLM_BACKEND": "xai", "AI_MEMORY_LLM_API_KEY": "xai-...", "AI_MEMORY_LLM_MODEL": "grok-4.3" }MCP 用戶端會以全新子程序啟動伺服器,僅包含 MCP 設定中的
env:鍵——.zshrc/.bashrc中的 shell 匯出無法傳遞至該子程序。上述[llm]設定檔路徑解決了這個小麻煩(每個表面都讀取同一個檔案)。config.toml中的內嵌 API 金鑰會在解析時被拒絕——請使用api_key_env或api_key_file。背景:#1144 → #1146。完整的各後端配方:docs/integrations/llm-backends.md。
Windows 路徑: 在
--db中使用正斜線或跳脫的反斜線。範例:"--db", "C:/Users/YourName/.claude/ai-memory.db"。
層級旗標:
--tier旗標選擇功能層級:keyword、semantic(預設)、smart或autonomous。智慧與自主層級需要 LLM 後端——#1067(v0.7.0)之後,可以是以下任一:本機 Ollama、xAI Grok、OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi (Moonshot)、Qwen (Alibaba)、Mistral、Groq、Together AI、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM 或 llama.cpp 伺服器——透過AI_MEMORY_LLM_BACKEND選取。--tier旗標必須在 args 中傳遞——當 MCP 伺服器由 AI 用戶端啟動時,不會使用config.toml層級設定。
重要: MCP 伺服器不會在
settings.json或settings.local.json中設定——這些檔案不支援mcpServers。
讓 Claude 主動使用 ai-memory: 在專案根目錄新增包含 ai-memory 指令的 CLAUDE.md 檔案。這可確保 Claude 在每次對話開始時回憶上下文,並在工作時儲存發現。請參閱 CLAUDE.md 整合指南 取得可直接複製貼上的範本和放置選項。
OpenAI Codex CLI
新增至 ~/.codex/config.toml(全域)或 .codex/config.toml(專案)。Windows:%USERPROFILE%\.codex\config.toml。使用 CODEX_HOME 環境變數覆寫。
[mcp_servers.memory]
command = "ai-memory"
args = ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
enabled = true
或透過 CLI 新增:codex mcp add memory -- ai-memory --db ~/.local/share/ai-memory/memories.db mcp --tier semantic
注意: Codex 使用 TOML 格式,鍵名為底線分隔
mcp_servers(非駝峰式,非連字號)。支援env(鍵/值對)、env_vars(要轉發的清單)、enabled_tools、disabled_tools、startup_timeout_sec、tool_timeout_sec。在 TUI 中使用/mcp檢視伺服器狀態。請參閱 Codex MCP 文件。
Google Gemini CLI
新增至 ~/.gemini/settings.json(使用者)或 .gemini/settings.json(專案)。Windows:%USERPROFILE%\.gemini\settings.json。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"],
      "timeout": 30000
    }
  }
}
或透過 CLI 新增:gemini mcp add memory ai-memory -- --db ~/.local/share/ai-memory/memories.db mcp --tier semantic
注意: 伺服器名稱中避免使用底線(請使用連字號)。工具名稱會自動加上前綴
mcp_memory_<toolName>。env欄位中的環境變數支援$VAR/${VAR}(所有平台)和%VAR%(Windows)。Gemini 會從繼承的環境中清除敏感模式,除非明確宣告。新增"trust": true以跳過確認提示。CLI 管理:gemini mcp list/remove/enable/disable。請參閱 Gemini CLI MCP 文件。
Cursor IDE
新增至 ~/.cursor/mcp.json(全域)或 .cursor/mcp.json(專案)。Windows:%USERPROFILE%\.cursor\mcp.json。同名伺服器以專案設定覆寫全域設定。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
    }
  }
}
注意: 編輯
mcp.json後重新啟動 Cursor。在 Settings > Tools & MCP 中驗證伺服器狀態(綠點 = 已連接)。支援env、envFile和${env:VAR_NAME}插值(環境變數插值對 shell profile 變數可能不可靠——請使用envFile作為替代方案)。所有 MCP 伺服器合計約 40 個工具上限。請參閱 Cursor MCP 文件。
Windsurf (Codeium)
新增至 ~/.codeium/windsurf/mcp_config.json(僅全域——無專案層級範圍)。Windows:%USERPROFILE%\.codeium\windsurf\mcp_config.json。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
    }
  }
}
注意: 支援
command、args、env、serverUrl、url和headers中的${env:VAR_NAME}插值。所有 MCP 伺服器合計 100 個工具上限。也可以透過 MCP Marketplace 或 Settings > Cascade > MCP Servers 新增。請參閱 Windsurf MCP 文件。
Continue.dev
新增至 ~/.continue/config.yaml(使用者)或專案根目錄中的 .continue/mcpServers/ 目錄(每個伺服器一個 YAML/JSON 檔案)。Windows:%USERPROFILE%\.continue\config.yaml。
mcpServers:
  - name: memory
    command: ai-memory
    args:
      - "--db"
      - "~/.local/share/ai-memory/memories.db"
      - "mcp"
      - "--tier"
      - "semantic"
注意: MCP 工具僅在代理模式中運作。支援
${{ secrets.SECRET_NAME }}用於密鑰插值。專案層級的.continue/mcpServers/目錄會自動偵測其他工具(Claude Code、Cursor 等)的 JSON 設定。請參閱 Continue MCP 文件。
Grok CLI (AlphaOne 分支——深度整合,具自動回憶功能)
grok-cli 的 AlphaOne 分支 內建 ai-memory 支援,具備工作階段範圍的 MCP 連接、工作階段開始時的自動記憶回憶、壓縮摘要儲存,以及具記憶感知的系統提示。
新增至 ~/.grok/user-settings.json:
{
  "mcp": {
    "servers": [
      {
        "id": "ai-memory",
        "label": "AI Memory",
        "enabled": true,
        "transport": "stdio",
        "command": "ai-memory",
        "args": ["mcp", "--tier", "semantic"]
      }
    ]
  }
}
功能: 工作階段開始時自動回憶(將相關記憶注入系統提示)、壓縮摘要儲存為中層記憶、MCP 工具在所有模式(代理、規劃、詢問)中可用、工作階段範圍的連接(無每次訊息的冷啟動)。預設使用
--tier semantic(本機嵌入,不需 LLM 後端)。完整設定請參閱 grok-cli 文件。
xAI Grok API (API 層級,遠端 MCP)
Grok 透過 HTTPS 連接 MCP 伺服器(僅限遠端,無 stdio)。無設定檔——伺服器在每次 API 請求中指定。
ai-memory serve --host 127.0.0.1 --port 9077
# Expose via HTTPS reverse proxy (nginx, caddy, cloudflare tunnel, etc.)
然後將 MCP 伺服器新增至您的 Grok API 呼叫:
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.3",
    "tools": [{
      "type": "mcp",
      "server_url": "https://your-server.example.com/mcp",
      "server_label": "memory",
      "server_description": "Persistent AI memory with recall and search",
      "allowed_tools": ["memory_store", "memory_recall", "memory_search"]
    }],
    "input": "What do you remember about our project?"
  }'
需求: 需要 HTTPS。
server_label為必填。支援 Streamable HTTP 和 SSE 傳輸。選用:allowed_tools、authorization、headers。可與 xAI SDK、OpenAI 相容的 Responses API 和 Voice Agent API 搭配使用。請參閱 xAI 遠端 MCP 文件。
META Llama (透過 Llama Stack)
Llama Stack 將 MCP 伺服器註冊為工具群組。無標準化設定檔路徑——依部署環境而定。
ai-memory serve --host 127.0.0.1 --port 9077
Python SDK:
client.toolgroups.register(
    provider_id="model-context-protocol",
    toolgroup_id="mcp::memory",
    mcp_endpoint={"uri": "http://localhost:9077/sse"}
)
或在 run.yaml 中以宣告方式設定:
tool_groups:
  - toolgroup_id: mcp::memory
    provider_id: model-context-protocol
    mcp_endpoint:
      uri: "http://localhost:9077/sse"
注意: 支援 run.yaml 中的
${env.VAR_NAME}插值。傳輸方式正從 SSE 遷移至 Streamable HTTP。請參閱 Llama Stack Tools 文件。
OpenClaw
透過 CLI 新增或直接編輯 OpenClaw 設定。設定使用 mcp.servers(非 mcpServers)。
openclaw mcp set memory '{"command":"ai-memory","args":["--db","~/.local/share/ai-memory/memories.db","mcp","--tier","semantic"]}'
或新增至您的 OpenClaw 設定檔:
{
  "mcp": {
    "servers": {
      "memory": {
        "command": "ai-memory",
        "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
      }
    }
  }
}
注意事項: OpenClaw 使用
mcp.servers金鑰(而非mcpServers)。CLI 管理:openclaw mcp list、openclaw mcp show、openclaw mcp set、openclaw mcp unset。支援 stdio、遠端 URL 與 Streamable HTTP 傳輸。偏好使用--token-file而非內嵌密鑰。請參閱 OpenClaw MCP 文件。
任何其他 MCP 用戶端
ai-memory 透過 stdio(JSON-RPC 2.0)使用 MCP 通訊。請將您的用戶端指向:
command: ai-memory
args: ["--db", "/path/to/ai-memory.db", "mcp"]
若為僅支援 HTTP 的用戶端,請啟動 REST API:
ai-memory serve
# 92 REST route registrations (78 unique URL paths) at http://127.0.0.1:9077/api/v1/
步驟 4:完成。進行測試。
重新啟動您的 AI 助理。若使用 MCP,它現在會在啟動時宣告 7 個工具的預設介面(原始 5 個加上 memory_load_family 與 memory_smart_load;其餘 93 個可呼叫工具(共 100 個)會透過 --profile 或 memory_capabilities --include-schema 按需載入)。請詢問:「儲存一則記憶:我最喜歡的語言是 Rust。」然後在新對話中詢問:「我最喜歡的語言是什麼?」它會記得。
行動平台支援(v0.7.0 Posture-1a)
ai-memory 可透過標準 Rust 行動裝置交叉編譯路徑移植至 iOS 與 Android。v0.7.0 針對兩個目標提供三個漸進層級的 CI 覆蓋:
| 層級 | 覆蓋範圍 | CI 工作流程 |
|---|---|---|
| 第 1 層 — 交叉編譯 | cargo check --target aarch64-apple-ios --no-default-features --features sqlite-bundled --lib 與對應的 Android 交叉編譯在每次 PR 與推送至 release/** 時執行。可捕捉約 80% 的行動裝置位元腐化風險(任何會在此處暴露行動裝置可攜性問題的 crate 更新)。 | .github/workflows/ci.yml — mobile-cross-compile 工作 |
| 第 2 層 — 發行產物 | 發行標籤切割會產生 ai-memory-ios.xcframework.tar.gz(透過 xcodebuild -create-xcframework 的 iOS 裝置與模擬器切片)與 ai-memory-android.tar.gz(以 jniLibs/<abi>/ 佈局的 Android arm64 / armv7 / x86_64 / x86 .so 套件)。 | .github/workflows/release.yml — mobile-ios 與 mobile-android 工作 |
| 第 3 層 — 執行期測試 | 一個約 50 項測試的子集(檔案系統沙箱、裝置端 SQLite 上的 FTS5、HNSW CPU 召回、嵌入器 CPU 路徑、LLM 用戶端 TLS)在每次 release/** 推送與手動 workflow_dispatch 時於 iOS 模擬器上執行;Android 模擬器 arm 僅在 release/** 推送與 workflow_dispatch 時執行。選擇理由:tests/mobile/README.md。 | .github/workflows/mobile-runtime.yml |
v0.7.0 狀態: 第 1 層是發行門檻 — 行動裝置交叉編譯必須在標籤切割前為 GREEN。第 2 層(發行產物)提供 BUILD 管線與產物佈局;C 可呼叫 FFI 介面本身將在 v0.7.x 後續版本中推出。第 3 層在每次 release/** 推送時執行限定的測試子集。
使用發行產物:
- iOS — 從 v0.7.x 發行頁面下載
ai-memory-ios.xcframework.tar.gz,解壓縮,然後將AiMemory.xcframework拖入您的 Xcode 專案的「Frameworks, Libraries, and Embedded Content」。 - Android — 從 v0.7.x 發行頁面下載
ai-memory-android.tar.gz,解壓縮,然後將jniLibs/目錄樹複製到您應用程式模組的src/main/jniLibs/。
行動裝置產物也是每個已發布 v0.7.x 發行版本的一部分;Homebrew formula 與 APT/RPM 套件(包含桌面二進位檔)會附上連結至行動裝置下載的說明。CI 實作歷史請參閱 issue #1068。
快速入門
在兩分鐘內從零開始建立可運作的記憶。
1. 安裝
curl -fsSL https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.sh | sh
2. 設定 MCP(以 Claude Code 為例 — 其他平台運作方式相同)
合併至 ~/.claude.json:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
3. 儲存您的第一則記憶
ai-memory store -T "Project uses PostgreSQL 15" -c "Main DB is PG 15 with pgvector." --tier long
4. 召回它
ai-memory recall "database"
5. 檢查統計資料
ai-memory stats
6. 與您的 AI 搭配使用。 重新啟動您的 AI 用戶端。它現在在啟動時會宣告 7 個預設記憶工具(101 個已宣告項目可透過執行期擴充或 --profile full 存取)透過 MCP — 它可以在對話期間原生儲存與召回記憶。
SDK
除了 MCP / HTTP / CLI 介面之外,ai-memory 還提供第一方語言 SDK,供 HTTP 用戶端與輔助工具使用(例如 requireProfile 用於對 v0.6.4+ 守護程式進行執行期設定檔斷言)。
TypeScript / JavaScript — npm 上的 @alphaone/ai-memory
npm install @alphaone/ai-memory
Python — PyPI 上的 ai-memory-mcp(匯入名稱仍為 ai_memory)
pip install ai-memory-mcp
from ai_memory import AiMemoryClient, require_profile

with AiMemoryClient(base_url="http://127.0.0.1:9077", api_key="...") as client:
    require_profile(client, "graph")  # raises ProfileNotLoaded on miss
兩個 SDK 都與伺服器同步版本化(0.9.0 對應 ai-memory 0.9.0)。v0.6.4+ 守護程式會強制執行設定檔契約;v0.6.4 之前的守護程式則回退至寬鬆的警告並繼續,因此 SDK 升級不會破壞舊伺服器。原始碼位於 sdk/typescript/ 與 sdk/python/。
它做什麼?
AI 助理會忘記對話之間的所有內容。ai-memory 解決了這個問題。
它以 MCP(模型上下文協定)工具伺服器執行 — 一個您的 AI 可以原生通訊的背景程序。當您的 AI 學到重要事項時,它會儲存。當它需要上下文時,它會召回由 6 因子評分演算法排序的相關記憶。記憶分為三個層級:
- 短期(預設 6 小時,可設定)— 暫時性上下文,例如目前的除錯狀態
- 中期(預設 7 天,可設定)— 工作知識,例如衝刺目標與近期決策
- 長期(永久)— 架構、使用者偏好、艱苦學到的教訓
持續被存取的記憶會自動從中期提升至長期。每次召回都會延長 TTL。優先級會隨使用次數增加。系統會自我策展。
除了 MCP 之外,ai-memory 還提供完整的 HTTP REST API(連接埠 9077 上有 92 個路由註冊 / 78 個唯一 URL 路徑)與完整的 CLI(--features sal 或 --features sal-postgres 下有 89 個子命令;預設建置中有 87 個(post-#1389 L2 RecoverPreviousSession 用於跨會話上下文重新水合 + #1443 Expand 用於 ai-memory expand 查詢擴充介面 + #1598 Reembed 用於 ai-memory reembed 向量空間遷移介面);SSOT 由 ai_memory::EXPECTED_CLI_SUBCOMMANDS_{DEFAULT,SAL} 與機械化 tests/cli_subcommand_count_invariant.rs 對等測試固定),供直接互動、腳本化以及與任何 AI 平台或工具整合使用。
功能
核心
- MCP 工具伺服器 — 透過 stdio JSON-RPC 提供 101 個工具(完整設定檔),相容於任何 MCP 用戶端
- 三層記憶 — 短期(預設 6 小時 TTL)、中期(預設 7 天 TTL)、長期(永久)— TTL 可設定
- 全文搜尋 — SQLite FTS5 搭配排名檢索
- 混合召回 — FTS5 關鍵字 + 餘弦相似度搭配自適應混合:語意權重會依內容長度在 0.50(短內容)→ 0.15(長內容)之間變化,因為嵌入在長文字上會遺失資訊
- 6 因子召回評分 — FTS 相關性 + 優先級 + 存取頻率 + 信心度 + 層級加成 + 近期衰減
- 自動提升 — 被存取 5 次以上的記憶會從中期提升至長期
- TTL 延長 — 每次召回都會延長到期時間(短期 +1 小時,中期 +1 天)
- 優先級強化 — 每 10 次存取 +1(上限 10)
- 矛盾偵測 — 儲存與現有記憶衝突的記憶時發出警告
- 去重 — 以標題+命名空間進行 upsert,層級絕不降級
- 信心度評分 — 0.0-1.0 的確定性會納入排名
組織
- 命名空間 — 依專案隔離記憶(可從 git remote 自動偵測)
- 記憶連結 — 型別化關係:related_to、supersedes、contradicts、derived_from、reflects_on(遞迴學習 Task 1/8)、derives_from(WT-1-A 原子化)、decomposes_into、depends_on、advances — v0.8.0 有九種變體
- 合併 — 將多則記憶合併為單一長期摘要
- 自動合併 — 依命名空間+標籤分組,自動合併超過門檻的群組
- 矛盾解決 — 將一則記憶標記為取代另一則,並降級被取代者
- 依模式遺忘 — 依命名空間 + FTS 模式 + 層級進行大量刪除
- 來源追蹤 — 追蹤來源:user、claude、hook、api、cli、import、consolidation、system
- 代理身分(NHI) — 每則記憶都帶有
metadata.agent_id(宣稱的身分),在更新/去重/匯入/同步/合併時具有縱深防禦的不可變性;依代理篩選list/search - 標籤 — 逗號分隔的標籤,支援篩選
介面
- 92 個 HTTP 路由(78 個唯一路徑) — 127.0.0.1:9077 上的完整 REST API(可與任何 AI 或工具搭配使用)
--features sal或--features sal-postgres下有 89 個 CLI 子命令(預設建置中有 87 個)— 功能完整的 CLI- 101 個 MCP 工具(完整設定檔,7 個預設;已針對
Profile::full().expected_tool_count()驗證)— 原生整合任何相容 MCP 的 AI - 互動式 REPL shell — 召回、搜尋、列出、取得、統計、命名空間、刪除,附彩色輸出
- JSON 輸出 — 所有 CLI 命令上的
--json旗標 - 分散式協調(v0.8.0 Pillar-1 + Pillar-2) — 動作 DAG(
memory_action_*)、單一持有者租約(memory_lease_*)、Ed25519 簽章訊號(memory_signal_*)、公證檢查點(memory_checkpoint_*)、參數化例程(memory_routine_*),以及 Goal/Plan/Step 型別化認知生命週期。請參閱docs/coordination.md。
操作
- 多節點同步 — 資料庫檔案之間的拉取、推送或雙向合併
- 匯入/匯出 — 保留記憶連結的完整 JSON 往返
- 垃圾收集 — 每 30 分鐘自動背景到期
- 優雅關閉 — SIGTERM/SIGINT 會檢查 WAL 以乾淨退出
- 深度健康檢查 — 驗證 DB 可存取性與 FTS5 完整性
- Shell 補全 — bash、zsh、fish
- 手冊頁 —
ai-memory man產生 roff 至 stdout - 時間篩選 — 列出與搜尋上的
--since/--until - 人類可讀年齡 — CLI 輸出中的「2h ago」、「3d ago」
- 彩色 CLI 輸出 — ANSI 層級標籤(紅/黃/綠)、優先級條、粗體標題、青色命名空間
品質
- 整個介面約 10,000 項測試 —
src/下約 6,712 個#[test]/#[tokio::test]屬性(5,759 個#[test]+ 953 個#[tokio::test]),加上tests/下約 3,362 個(2,138 個#[test]+ 1,224 個#[tokio::test]),從 v0.6.4 時代約 2,400 項測試的基準(1,960 個 lib + 211 個 integration + 16 個 mcp_integration + 4 個 webhook_http_parity + 16 個 recipe_contract + 其他二進位目標約 150 個)成長而來。行覆蓋率維持在 ≥92% 專案門檻之上;v0.6.4 新增模組為 100%(sizes.rs)、99.50%(profile.rs)、97.58%(cli/audit.rs)、97.05%(cli/doctor.rs)、92.56%(handlers.rs)、92.26%(cli/install.rs)。v0.6.3.x 基準(1,809 / 93.08% 與 1,886 / 93.84%)仍凍結在證據頁面;v0.6.4 指標在發行說明與測試中心活動中。經驗性 NHI 發現驗收已由發現閘道(T1–T4 矩陣對照實際 xAI Grok 4.3,6/6 PASS,GATE GREEN)另行證明。 - LongMemEval 基準 — 在 ICLR 2025 LongMemEval-S 資料集上,純 FTS5 關鍵字(與 LLM 無關,2.2 秒,232 q/s,零 API 成本)達到 97.0% R@5;使用目前世代 Gemma 4 模型的 LLM 查詢擴充測得 97.2% R@5 / 99.6% R@10 / 99.8% R@20(雲端 API 場域;歷史上的
gemma3:4b97.8% 數據已依 #1975 退役為標題)。請參閱基準詳細資料。 - MCP 提示 —
recall-first與memory-workflow提示會教導 AI 用戶端主動使用記憶 - TOON 預設 — 召回/列出/搜尋回應預設使用 TOON 緊湊格式(比 JSON 小 79%)
- Criterion 基準 — 1K 規模的插入、召回、搜尋
- GitHub Actions CI/CD — 在 Ubuntu + macOS 上執行 fmt、clippy、test、build,在標籤時發行
覆蓋率下限(嚴格的 CI 門檻)
Code Coverage 任務是一個必備的狀態檢查。CI 在每個 PR 上重新驗證兩項不變量:絕對下限為 >= 90% 的行覆蓋率(災難性回歸的防護措施,設定為目前測量值無條件捨去至最接近的 5%),以及相對於 .coverage-baseline 中釘選值的棘輪機制,並帶有 0.5% 的容差窗口(日常執行機制)。提高覆蓋率的 PR 應在同一個 commit 中更新基準檔案,以便未來的 PR 能受益於新的下限;回歸超過 0.5% 的 PR 將被阻止合併。目前測量值:93.13% 行。
Token 預算門檻(嚴格的 CI 門檻,v0.7 C5)
token-budget 工作流程是一個必備的狀態檢查。它在每個 PR 上強制執行三項以 cl100k_base 測量的不變量:
- 每個工具上限為 1500 個 token —— 任何單一 MCP 工具的序列化 schema(名稱 + 描述 + inputSchema)不得超過 1500 個 cl100k_base token。
- 完整設定檔的誠實範圍(5K-8K) —— v0.6.4 的防護措施,保留以偵測病態的縮減(意外移除工具)。
- 完整設定檔的硬性上限(v0.7 C5,於 D1.6/D1.7 後提高) —— 在
--profile full下修剪後的tools/list負載不得超過 11,000 個 cl100k_base token(tests/token_budget_guard.rs中的TRIMMED_FULL_PROFILE_CEILING_TOKENS;原始的 C5 目標是針對 D1.6 前的手寫 schema 設定為 3500 —— 由 schemars 衍生的 D1.6/D1.7 擴展提高了釘選的上限)。C2(拆分 docs 欄位)、C3(合併重複的 schema 樣板)和 C4(隱藏少用的可選參數)推動了最初的壓縮;此門檻迫使未來增加表面積的 PR 在其他地方收回預算。檢查ai-memory doctor --tokens --raw-table以查看每個工具的成本。請參閱.github/workflows/token-budget.yml和docs/v0.7/schema-compaction-audit.md。
ML 和 LLM 依賴項(語意層級以上)
- candle-core、candle-nn、candle-transformers —— Hugging Face Candle ML 框架,用於原生 Rust 推論
- hf-hub —— 從 Hugging Face Hub 下載模型
- tokenizers —— Hugging Face tokenizers,用於文字預處理
- instant-distance —— 近似最近鄰搜尋
- reqwest —— 用於 LLM 後端通訊的 HTTP 用戶端(智慧/自主層級 —— 任何供應商,依 #1067:Ollama、xAI、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM、llama.cpp server)
架構
基準測試
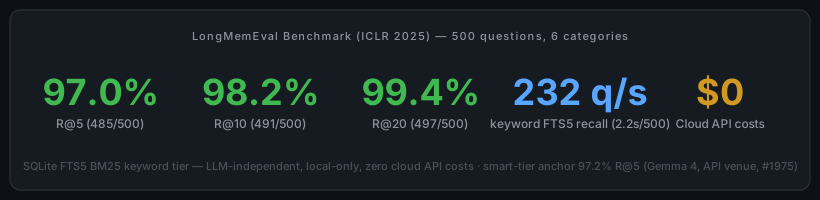
在 ICLR 2025 LongMemEval-S 資料集(500 個問題,6 個類別)上進行評估。純 FTS5 關鍵字層級在 2.2 秒內達到 97.0% 的 R@5 —— 不依賴 LLM、完全本地、零雲端 API 呼叫、零成本。LLM 查詢擴展(智慧層級)使用目前世代的 Gemma 4 模型(雲端 API 場域)測得 97.2% 的 R@5。
基準模型說明(更新於 2026-07-10,#1975 裁決): 歷史上的 97.8% R@5 智慧層級數據是以 Gemma 3 4B 測量的(仍是編譯的預設擴展模型),並已退役作為主要數據。已發布的目前世代錨點是測得的 OpenRouter Gemma 4 執行:97.2% R@5 / 99.6% R@10 / 99.8% R@20(2026-05-31,500 個問題,0 次擴展失敗)。沒有本地 Ollama Gemma-4 的數據 —— 參考基準主機僅有 CPU,在該環境下進行有效的完整協定本地執行是不可行的(請參閱 #1983);本地 GPU 重新執行將在 v1.0 之後保持開放。關鍵字層級的 97.0% R@5 不依賴 LLM,且不受影響。
| 層級 | R@5 | 速度 | 依賴項 |
|---|---|---|---|
| keyword | 97.0% | 232 q/s | 無 |
| semantic | 97.4% | 45 q/s | 嵌入模型(約 100MB) |
| smart | 97.2%(Gemma 4,API 場域;歷史 gemma3:4b 97.8%) | 12 q/s | 任何 LLM 後端(例如本地 Ollama + Gemma;或 xAI Grok 4.3、OpenAI gpt-5、Anthropic Claude Opus 4.7、Gemini、DeepSeek 等,於 #1067 之後) |
效能預算(v0.6.4)
每個版本都附有已發布的 p95/p99 預算,用於熱路徑操作,以及一個 CI 門檻,若任何 PR 的測量 p95 超過預算超過 10%,則該 PR 失敗。目標是針對 M4 參考硬體校準的;完整表格和方法論請參閱 PERFORMANCE.md。
| 操作 | 目標 p95 | 目標 p99 |
|---|---|---|
memory_session_start(Claude Code hook) | < 100 ms | < 200 ms |
memory_store(無嵌入) | < 20 ms | < 50 ms |
memory_search(FTS5) | < 100 ms | < 250 ms |
memory_recall(熱,depth=1) | < 50 ms | < 150 ms |
memory_kg_query(depth ≤ 3) | < 100 ms | < 250 ms |
memory_kg_query(depth ≤ 5) | < 250 ms | < 500 ms |
memory_kg_timeline | < 100 ms | < 250 ms |
在本地執行相同的工作負載:
ai-memory bench                      # human-readable table
ai-memory bench --json               # machine-parseable
Substrate 在 v0.6.3.x → v0.6.4 之間保持不變(quiet-tools 版本發布的是較小的預設工具表面,而非不同的熱路徑)。此處的 p99 目標在下一個專門的 soak 窗口之前仍僅供參考;最新的 soak 證據位於 test hub。
整合方法
MCP(主要 —— 適用於 MCP 相容的 AI 平台)
MCP 是推薦的整合方式。您的 AI 將獲得預設廣告的 7 個原生記憶體工具(原始的 5 個 + memory_load_family + memory_smart_load;加上永遠開啟的 memory_capabilities 引導程式),無需任何膠水程式碼。其他 93 個可呼叫工具(101 個廣告條目 —— 已針對 Profile::full().expected_tool_count() 驗證並由 src/mcp/registry.rs 中的 const_count_matches_full_profile 釘選)仍可透過 --profile graph|admin|power|full 或透過 memory_capabilities --include-schema family=<name> 的執行時期擴展來存取。在您的 AI 平台設定檔中設定 MCP server:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp"]
    }
  }
}
HTTP API(通用 —— 適用於任何 AI 或工具)
啟動 HTTP server 以進行 REST API 存取。任何可以發出 HTTP 呼叫的 AI、腳本或自動化都可以使用此功能:
ai-memory serve
# 92 REST route registrations (78 unique URL paths) at http://127.0.0.1:9077/api/v1/
CLI(通用 —— 適用於腳本化和直接使用)
CLI 可獨立運作,或作為執行 shell 命令的 AI 整合的建構區塊:
ai-memory store --tier long --title "Architecture decision" --content "We use PostgreSQL"
ai-memory recall "database choice"
ai-memory search "PostgreSQL"
功能層級
ai-memory 支援 4 個功能層級,在啟動時以 ai-memory mcp --tier <tier> 選擇。較高的層級以磁碟和 RAM 為代價增加 ML 功能:
| 層級 | 召回方法 | 額外功能 | 約略開銷 |
|---|---|---|---|
| keyword | 僅 FTS5 | 基準 101 條目表面 —— 層級門控模型/功能,而非廣告的工具表面 | 0 MB |
| semantic | FTS5 + 餘弦相似度(混合) | MiniLM-L6-v2 嵌入(384 維)、HNSW 索引、語意層級(101 條目表面的子集) | ~256 MB |
| smart | 混合 + LLM 查詢擴展 | + nomic-embed-text(768 維)+ LLM 支援的 memory_expand_query、memory_auto_tag、memory_detect_contradiction、完整 101 條目表面。LLM 供應商由操作者透過 AI_MEMORY_LLM_BACKEND 選擇(#1067)—— 本地 Ollama、xAI、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM 或 llama.cpp。 | ~1 GB(本地 Ollama)/ ~0 GB(遠端 API) |
| autonomous | 混合 + LLM 擴展 + cross-encoder 重新排序 | + 神經 cross-encoder(ms-marco-MiniLM)、記憶體反思、完整 101 條目表面。與 smart 層級相同的 LLM 供應商自由度。 | ~4 GB(本地 Ollama)/ ~3 GB(遠端 LLM,僅本地 cross-encoder) |
功能矩陣
每個功能都對應到其最低層級。每個層級都包含其下方所有層級的功能。
| 功能 | keyword | semantic | smart | autonomous |
|---|---|---|---|---|
| 搜尋與召回 | ||||
| FTS5 關鍵字搜尋 | 是 | 是 | 是 | 是 |
| 語意嵌入(餘弦相似度) | -- | 是 | 是 | 是 |
| 混合召回(FTS5 + 餘弦,依內容長度自適應 0.50→0.15 語意權重) | -- | 是 | 是 | 是 |
| HNSW 最近鄰索引 | -- | 是 | 是 | 是 |
LLM 查詢擴展(memory_expand_query) | -- | -- | 是 | 是 |
| 神經 cross-encoder 重新排序 | -- | -- | -- | 是 |
| 記憶體管理 | ||||
| 儲存、更新、刪除、提升、連結 | 是 | 是 | 是 | 是 |
| 手動合併 | 是 | 是 | 是 | 是 |
| 自動合併(LLM 摘要) | -- | -- | 是 | 是 |
自動標記(memory_auto_tag) | -- | -- | 是 | 是 |
矛盾偵測(memory_detect_contradiction) | -- | -- | 是 | 是 |
| 自主記憶體反思 | -- | -- | -- | 是 |
| 模型 | ||||
| 嵌入模型 | -- | MiniLM-L6-v2(384d) | nomic-embed-text(768d) | nomic-embed-text(768d) |
| 嵌入後端覆寫(#1598) | -- | 任何:本地 Ollama、API 供應商別名或自架 OpenAI 相容([embeddings].backend / AI_MEMORY_EMBED_*) | 相同 | 相同 |
| LLM | -- | -- | 操作者選擇(#1067)—— 預設 gemma3:4b 本地;遠端端點不佔本地空間 | 操作者選擇(#1067)—— 預設 gemma3:4b 本地;遠端端點不佔本地空間 |
| 資源 | ||||
| RAM | 0 MB | ~256 MB | ~1 GB | ~4 GB |
| 外部依賴項 | 無 | 無 | LLM 後端(Ollama / xAI / OpenAI / Anthropic / Gemini / DeepSeek / Kimi / Qwen / Mistral / Groq / Together / Cerebras / OpenRouter / Fireworks / LMStudio / vLLM / llama.cpp —— #1067) | LLM 後端(與 smart 相同的選擇) |
公開的 MCP 工具(於 --profile full)1 | 101 | 101 | 101 | 101 |
Semantic 層級(預設)捆綁了 Candle ML 框架,並在首次執行時下載 all-MiniLM-L6-v2 模型(約 90 MB)。Smart 和 autonomous 層級需要 LLM 後端 —— 於 #1067(v0.7.0)之後,可以是本地(Ollama、LMStudio、vLLM、llama.cpp server)或任何 OpenAI 相容的遠端端點(xAI、OpenAI、Anthropic 透過 OpenAI shim、Google Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks)。選擇透過 AI_MEMORY_LLM_BACKEND 環境變數進行;各供應商的 API 金鑰透過 XAI_API_KEY / OPENAI_API_KEY / ANTHROPIC_API_KEY / GEMINI_API_KEY / DEEPSEEK_API_KEY / MOONSHOT_API_KEY / DASHSCOPE_API_KEY / 等或標準的 AI_MEMORY_LLM_API_KEY。
層級門控功能,而非模型 —— 且於 #1067(v0.7.0)之後,層級也不門控供應商。 --tier 旗標控制公開哪些工具。LLM 後端和模型可透過 AI_MEMORY_LLM_BACKEND + AI_MEMORY_LLM_MODEL 環境變數(或透過 ~/.config/ai-memory/config.toml 中的標準 [llm] 區段 —— 請參閱 docs/CONFIG_SCHEMA.md 以了解 v0.7.x 企業 schema 和遷移工具)獨立設定。例如,針對 xAI Grok 4 執行 autonomous 層級(完整 101 條目表面 + 重新排序器),透過 OpenAI 相容別名:
# Quick path: env vars
export AI_MEMORY_LLM_BACKEND=xai
export AI_MEMORY_LLM_MODEL=grok-4.3
export XAI_API_KEY=xai-…   # or AI_MEMORY_LLM_API_KEY
ai-memory mcp --tier autonomous
# Enterprise path: ~/.config/ai-memory/config.toml (v0.7.x schema v2, #1146)
schema_version = 2
tier = "autonomous"

[llm]
backend     = "xai"
model       = "grok-4.3"
base_url    = "https://api.x.ai/v1"
api_key_env = "XAI_API_KEY"          # mutually exclusive with api_key_file;
                                     # inline `api_key = "..."` is REJECTED.
# Legacy v0.6.x shape — still works, deprecation WARN at load; run
# `ai-memory config migrate` to upgrade in place.
tier = "autonomous"
llm_model = "gemma3:4b"   # default Ollama model at v0.7.0
--tier 旗標必須在 MCP 參數中傳遞 —— 當 server 由 AI 用戶端啟動時,不使用 config.toml 層級設定。
# Semantic is the default tier
ai-memory mcp

# Keyword -- FTS5 only, no models
ai-memory mcp --tier keyword

# Semantic -- hybrid recall with embeddings (explicit)
ai-memory mcp --tier semantic

# Smart -- adds LLM-powered query expansion, auto-tagging, contradiction detection
ai-memory mcp --tier smart

# Autonomous -- adds cross-encoder reranking
ai-memory mcp --tier autonomous
memory_capabilities 工具在執行時期報告作用中的層級、已載入的模型和可用的功能。
MCP 工具
這 101 個工具(完整設定檔;標準計數透過 src/profile.rs 中的 Profile::full().expected_tool_count())在設定為 MCP server 時可供任何 MCP 相容的 AI 使用(v0.6.4 凍結的證據頁面列出了 63 個工具的基準;下表記錄了大多數用戶端日常使用的主要子集):
| 工具 | 說明 |
|---|---|
memory_store | 儲存新的記憶(依標題+命名空間去重,並回報矛盾) |
memory_recall | 依情境召回相關記憶(模糊 OR 搜尋,依 6 項因素排序) |
memory_search | 依精確關鍵字比對搜尋記憶(AND 語意) |
memory_list | 列出記憶,可選過濾條件(命名空間、層級、標籤、日期範圍) |
memory_get | 依 ID 取得特定記憶及其連結 |
memory_update | 依 ID 更新既有記憶(部分更新) |
memory_delete | 依 ID 刪除記憶 |
memory_promote | 將記憶提升為長期(永久保留,清除到期時間) |
memory_forget | 依模式、命名空間或層級大量刪除 |
memory_link | 在兩筆記憶之間建立具型別的連結 |
memory_get_links | 取得某筆記憶的所有連結 |
memory_consolidate | 將多筆記憶合併為一筆長期摘要 |
memory_stats | 取得記憶儲存統計資料 |
memory_capabilities | 回報目前啟用的功能層級、已載入模型及可用能力 |
memory_expand_query | 使用 LLM 將搜尋查詢擴展為相關詞彙(smart+ 層級) |
memory_auto_tag | 使用 LLM 為記憶自動產生標籤(smart+ 層級) |
memory_detect_contradiction | 使用 LLM 檢查兩筆記憶是否矛盾(smart+ 層級) |
memory_archive_list | 列出已封存的記憶(可選命名空間/層級/標籤過濾) |
memory_archive_restore | 將已封存的記憶還原至作用中儲存區 |
memory_archive_purge | 永久刪除符合過濾條件的已封存記憶 |
memory_archive_stats | 取得封存統計資料(依層級、命名空間、年齡計數) |
HTTP API
在 127.0.0.1:9077 上有 92 條路由註冊 / 78 條唯一 URL 路徑。從 ai-memory serve 開始。下表顯示最常用的 REST 端點;完整介面(治理、聯盟、訂閱、知識圖譜、配額、核准 SSE)請參閱 docs/API_REFERENCE.md。
安全性: HTTP 伺服器綁定於 127.0.0.1,預設未設定任何驗證機制,且 CORS 設定寬鬆。請在
config.toml中設定api_key,以要求每個請求都帶有x-api-key標頭(舊版?api_key=查詢參數形式已於 v0.7.0 棄用 — #1574),並設定AI_MEMORY_REQUIRE_API_KEY=1以在缺少金鑰時拒絕啟動(#1458)。未設定驗證機制時請勿暴露至網路(並建議透過--tls-cert/--tls-key或反向代理使用 TLS)。
| 方法 | 端點 | 說明 |
|---|---|---|
| GET | /api/v1/health | 健康檢查(驗證 DB + FTS5 完整性) |
| GET | /api/v1/memories | 列出記憶(支援命名空間、層級、標籤、since、until、limit) |
| POST | /api/v1/memories | 建立記憶 |
| POST | /api/v1/memories/bulk | 大量建立記憶(有限制) |
| GET | /api/v1/memories/{id} | 依 ID 取得記憶 |
| PUT | /api/v1/memories/{id} | 依 ID 更新記憶 |
| DELETE | /api/v1/memories/{id} | 依 ID 刪除記憶 |
| POST | /api/v1/memories/{id}/promote | 將記憶提升為長期 |
| GET | /api/v1/search | AND 關鍵字搜尋 |
| GET | /api/v1/recall | 依情境召回(GET 搭配查詢參數) |
| POST | /api/v1/recall | 依情境召回(POST 搭配 JSON 主體) |
| POST | /api/v1/forget | 依模式/命名空間/層級大量刪除 |
| POST | /api/v1/consolidate | 將多筆記憶合併為一筆 |
| POST | /api/v1/links | 在記憶之間建立連結 |
| GET | /api/v1/links/{id} | 取得某筆記憶的連結 |
| GET | /api/v1/namespaces | 列出所有命名空間 |
| GET | /api/v1/stats | 記憶儲存統計資料 |
| POST | /api/v1/gc | 觸發垃圾收集 |
| GET | /api/v1/export | 將所有記憶 + 連結匯出為 JSON |
| POST | /api/v1/import | 從 JSON 匯入記憶 + 連結 |
| GET | /api/v1/archive | 列出已封存記憶(可選過濾條件) |
| POST | /api/v1/archive/{id}/restore | 將已封存記憶還原至作用中儲存區 |
| DELETE | /api/v1/archive | 清除符合過濾條件的已封存記憶 |
| GET | /api/v1/archive/stats | 封存統計資料(依層級、命名空間、年齡計數) |
CLI 指令
在 --features sal 或 --features sal-postgres 下有 89 個頂層子指令(預設建置為 87 個;2 個變體的差異是 Migrate + SchemaInit,兩者皆依 src/daemon_runtime.rs::Command::{Migrate,SchemaInit} 以 #[cfg(feature = "sal")] 門控;v0.6.4 時為 40 個)。對任何指令執行 ai-memory <command> --help 以取得詳細資訊,或執行 ai-memory --help 取得完整清單。
| 指令 | 說明 |
|---|---|
mcp | 以 MCP 工具伺服器形式透過 stdio 執行(主要整合路徑) |
serve | 在連接埠 9077 上啟動 HTTP 常駐程式 |
store | 儲存新的記憶(依標題+命名空間去重) |
update | 依 ID 更新既有記憶 |
recall | 模糊 OR 搜尋,附排序結果 + 自動觸及(支援 --tier 進行混合召回)。管線將每個請求的結果上限設為 50 筆。 |
search | AND 搜尋,用於精確關鍵字比對。 |
get | 依 ID 擷取單筆記憶(包含連結) |
list | 瀏覽記憶並附過濾條件(命名空間、層級、標籤、日期範圍)。每個請求上限為 1000 筆(LIST_MAX_LIMIT;HTTP 清單/大量操作另會遵守 AI_MEMORY_MAX_PAGE_SIZE)。 |
delete | 依 ID 刪除記憶 |
promote | 將記憶提升為長期(清除到期時間) |
forget | 依模式 + 命名空間 + 層級大量刪除 |
link | 連結兩筆記憶(related_to、supersedes、contradicts、derived_from) |
consolidate | 將多筆記憶合併為一筆長期摘要 |
resolve | 解決矛盾:標記勝出者、降級落敗者 |
shell | 互動式 REPL,附彩色輸出 |
sync | 在兩個資料庫檔案之間同步記憶(pull/push/merge) |
auto-consolidate | 依命名空間+標籤分組記憶,合併超過門檻的群組 |
gc | 對已到期記憶執行垃圾收集 |
stats | 記憶狀態總覽(計數、層級、命名空間、連結、DB 大小) |
namespaces | 列出所有命名空間及記憶計數 |
export | 將所有記憶和連結匯出為 JSON |
import | 從 JSON 匯入記憶和連結(stdin) |
completions | 產生 shell 補全(bash、zsh、fish) |
man | 產生 roff 手冊頁至 stdout |
mine | 從歷史對話匯入記憶(Claude、ChatGPT、Slack 匯出) |
archive | 管理記憶封存(列出、還原、清除、統計) |
頂層 ai-memory 二進位檔也接受全域旗標:
| 旗標 | 說明 |
|---|---|
--db <path> | 資料庫路徑(預設:ai-memory.db 或 $AI_MEMORY_DB) |
--json | 所有指令皆輸出 JSON(機器可解析輸出) |
store 子指令接受額外旗標:
| 旗標 | 說明 |
|---|---|
--source / -S | 此記憶的建立者(user、nhi、hook、api、cli、import、consolidation、system)。預設:cli。為相容舊版,依 src/validate.rs::VALID_SOURCES 接受 "claude" |
--expires-at | RFC3339 到期時間戳記 |
--ttl-secs | TTL 秒數(--expires-at 的替代方案) |
mcp 子指令接受額外旗標:
| 旗標 | 說明 |
|---|---|
--tier <keyword|semantic|smart|autonomous> | 功能層級(預設:semantic)。請參閱 功能層級。 |
召回評分
每次召回查詢皆依 6 項因素對記憶排序:
score = (fts_relevance * -1)
      + (priority * 0.5)
      + (MIN(access_count, 50) * 0.1)
      + (confidence * 2.0)
      + tier_boost
      + recency_decay
| 因素 | 權重 | 備註 |
|---|---|---|
| FTS 相關性 | -1.0x | SQLite FTS5 排名(負值 = 更佳比對) |
| 優先順序 | 0.5x | 使用者指定的 1-10 等級 |
| 存取次數 | 0.1x | 被召回的頻率(評分時上限為 50) |
| 信心度 | 2.0x | 0.0-1.0 確定性分數 |
| 層級加成 | +3.0 / +1.0 / +0.0 | 長期 / 中期 / 短期 |
| 新近衰減 | 1/(1 + days*0.1) | 較新的記憶排名較高 |
記憶層級
| 層級 | TTL | 使用案例 | 範例 |
|---|---|---|---|
short | 6 小時(可設定) | 一次性情境 | 目前除錯狀態、暫存變數、錯誤追蹤 |
mid | 7 天(可設定) | 工作知識 | 衝刺目標、近期決策、目前分支用途 |
long | 永久 | 得來不易的知識 | 架構、使用者偏好、修正、慣例 |
自動行為
- 召回時延長 TTL:短期記憶 +1 小時,中期記憶 +1 天
- 自動提升:中期記憶被存取 5 次以上即提升為長期(清除到期時間)
- 優先順序強化:每存取 10 次,優先順序增加 1(上限為 10)
- 矛盾偵測:當新記憶與同一命名空間中的既有記憶衝突時發出警告
- 去重:依標題+命名空間執行 upsert;更新時層級絕不降級
可設定的 TTL
預設 TTL(短期 6 小時、中期 7 天)可在 ~/.config/ai-memory/config.toml 的 [ttl] 區段中覆寫:
[ttl]
short_ttl_secs = 21600      # short-tier TTL in seconds (default: 21600 = 6 hours)
mid_ttl_secs = 604800        # mid-tier TTL in seconds (default: 604800 = 7 days)
long_ttl_secs = 0            # long-tier TTL in seconds (default: 0 = never expires)
short_extend_secs = 3600     # TTL extension on recall for short-tier memories in seconds (default: 3600 = +1h)
mid_extend_secs = 86400      # TTL extension on recall for mid-tier memories in seconds (default: 86400 = +1d)
五個欄位皆為選填 — 省略任何欄位即保留預設值。將任何值設為 0 可停用該層級的到期機制。數值會被限制在 10 年上限;負的延長值會被限制為 0。
注意: 設定會在程序啟動時載入一次。變更
config.toml後需重新啟動 ai-memory 程序(MCP 伺服器、HTTP 常駐程式或 CLI)才會生效。
封存
當垃圾收集使記憶到期時,可選擇封存而非永久刪除。已封存的記憶會移至獨立的儲存區,之後可瀏覽、還原或清除。
設定
在 ~/.config/ai-memory/config.toml 中啟用封存:
archive_on_gc = true # archive expired memories instead of deleting them (default: true)
CLI 指令
archive 子指令管理封存:
ai-memory archive list                          # list archived memories
ai-memory archive list --namespace my-project   # filter by namespace
ai-memory archive restore <id>                  # restore an archived memory to active store
ai-memory archive purge --older-than-days 90     # permanently delete archives older than 90 days
ai-memory archive stats                         # show archive statistics
注意: 還原的記憶會清除其
expires_at(在下次指派 TTL 前成為永久記憶)。
MCP 工具
MCP 用戶端可使用四個封存工具:
| 工具 | 說明 |
|---|---|
memory_archive_list | 列出已封存記憶(可選命名空間/層級/標籤過濾) |
memory_archive_restore | 將已封存記憶還原至作用中儲存區 |
memory_archive_purge | 永久刪除符合過濾條件的已封存記憶 |
memory_archive_stats | 取得封存統計資料(依層級、命名空間、年齡計數) |
HTTP 端點
| 方法 | 端點 | 說明 |
|---|---|---|
| GET | /api/v1/archive | 列出已封存記憶(可選過濾條件) |
| POST | /api/v1/archive/{id}/restore | 將已封存記憶還原至作用中儲存區 |
| DELETE | /api/v1/archive | 清除符合過濾條件的已封存記憶 |
| GET | /api/v1/archive/stats | 封存統計資料(依層級、命名空間、年齡計數) |
安全性
ai-memory 在所有輸入路徑上皆包含強化措施:
- 交易安全性 -- 所有多步驟資料庫操作皆使用交易;失敗時不會有部分寫入
- FTS 注入防護 -- 使用者輸入在進入 FTS5 查詢前會先淨化;特殊字元會被跳脫
- 錯誤淨化 -- 內部資料庫路徑與系統細節會從錯誤回應中移除;用戶端看到的是結構化錯誤類型(NOT_FOUND、VALIDATION_FAILED、DATABASE_ERROR、CONFLICT)
- 請求體大小限制 -- HTTP 請求體透過 Axum 的 DefaultBodyLimit 限制為 50 MB
- 批次操作限制 -- 批次建立端點強制執行最大批次大小,以防止資源耗盡
- CORS -- 為 localhost 開發流程啟用寬鬆的 CORS 層
- 輸入驗證 -- 每個寫入路徑皆驗證標題長度、內容長度、命名空間格式、來源值、優先級範圍(1-10)、信心度範圍(0.0-1.0)、標籤格式、層級值、關係類型與 ID 格式
- 同步中的連結驗證 -- 同步操作期間,所有連結在匯入前皆會驗證(兩個 ID、關係類型、無自連結)
- 執行緒安全色彩 -- 終端機色彩偵測使用
AtomicBool以確保並發存取安全 - 僅限本機 HTTP -- HTTP 伺服器預設綁定至 127.0.0.1;不對外暴露於網路
- WAL 模式 -- SQLite 預寫日誌,確保寫入期間的並發讀取安全
文件
| 指南 | 對象 |
|---|---|
| 變更日誌 v0.9.0 | 目前版本(secure-default hardening) — 儲存路徑代理證明預設為必要(#1751)、雙 MCP+HTTP 鉤子強制執行閘道(#1885/#1924)、schema v78 |
| 發行說明 v0.8.0 | 先前版本(distributed-coordination)— 協調基礎、型別化認知、聯邦強化、治理強制執行、schema v58→v70 |
| 協調工具參考 | v0.8.0 的 action / lease / signal / checkpoint / routine 原語(memory_action_* / _lease_* / _signal_* / _checkpoint_* / _routine_*) |
| 遷移指南 v0.7 | 從 v0.6.x 升級(涵蓋 attested-cortex、hooks、transcripts、AGE、permissions、G1 繼承修正) |
| v0.7 新功能 | attested-cortex 基底的視覺化逐步解說 |
attested-cortex RFC | 四項 v0.7 架構決策的設計理由 |
| v0.7 相容性矩陣 | 各功能的預設值與選擇加入矩陣 |
| 安裝指南 | 讓它運作起來(包含多個 AI 平台的 MCP 設定) |
| 使用者指南 | 需要持久記憶的 AI 助理使用者 |
| 開發者指南 | 在 ai-memory 上建置或貢獻 |
| 管理員指南 | 部署、監控與疑難排解 |
| 工程標準 | 程式碼、測試、安全性與發行標準(權威性) |
| AI 開發者工作流程 | 為貢獻此儲存庫的 AI 編碼代理提供的逐步工作流程 |
| AI 開發者治理標準 | AI 參與政策:權限、歸屬、審查、稽核 |
| GitHub Pages | 含動畫圖表的視覺化總覽 |
授權
版權所有 2026 AlphaOne LLC。
依據 Apache License, Version 2.0(「授權條款」)授權; 除非遵守授權條款,否則您不得使用此檔案。 您可在下列位置取得授權條款副本:
除非適用法律要求或書面同意,否則依授權條款散布的軟體係以「現況」提供, 不提供任何明示或默示的保證或條件。請參閱授權條款,了解授權條款下的特定語言、許可與限制。
Footnotes
-
MCP 工具表面與召回層級正交 —— 每個層級在
--profile full看到相同的 101 個工具(預設的--profile core在啟動時廣告 8 個,無論層級為何 —— 7 個 Core 系列工具加上永遠開啟的memory_capabilities引導程式;其他 93 個按需載入)。層級門控的是模型(嵌入器、cross-encoder、LLM)和功能行為(餘弦相似度、LLM 擴展、重新排序),而非廣告的工具數量。由src/mcp/registry.rs中的Profile::full().expected_tool_count()+const_count_matches_full_profile釘選。 ↩