Scrapeless
chính thứcTích hợp kết quả Scrapeless Google SERP thời gian thực (Google Search, Google Flight, Google Map, Google Jobs...) vào các ứng dụng LLM của bạn. Máy chủ này cho phép truy xuất ngữ cảnh động cho các quy trình AI, chatbot và công cụ nghiên cứu.
Bạn có thể làm gì với Scrapeless MCP?
- Google 搜索与趋势 — 通过
google_search和google_trends获取实时搜索结果或趋势数据。 - 浏览器自动化 — 使用
browser_goto和browser_click等工具,指挥云端浏览器进行导航、点击、输入、滚动和截图。 - 抓取任意 URL — 使用
scrape_html、scrape_markdown或scrape_screenshot获取页面的 HTML、Markdown 或截图。 - 爬取整个网站 — 使用
crawl_start启动异步爬取任务,然后通过crawl_result轮询获取结果。 - AI 驱动的提取 — 使用
ai_scraper为 ChatGPT、Gemini 或 Perplexity 等引擎创建结构化抓取任务。
Tài liệu
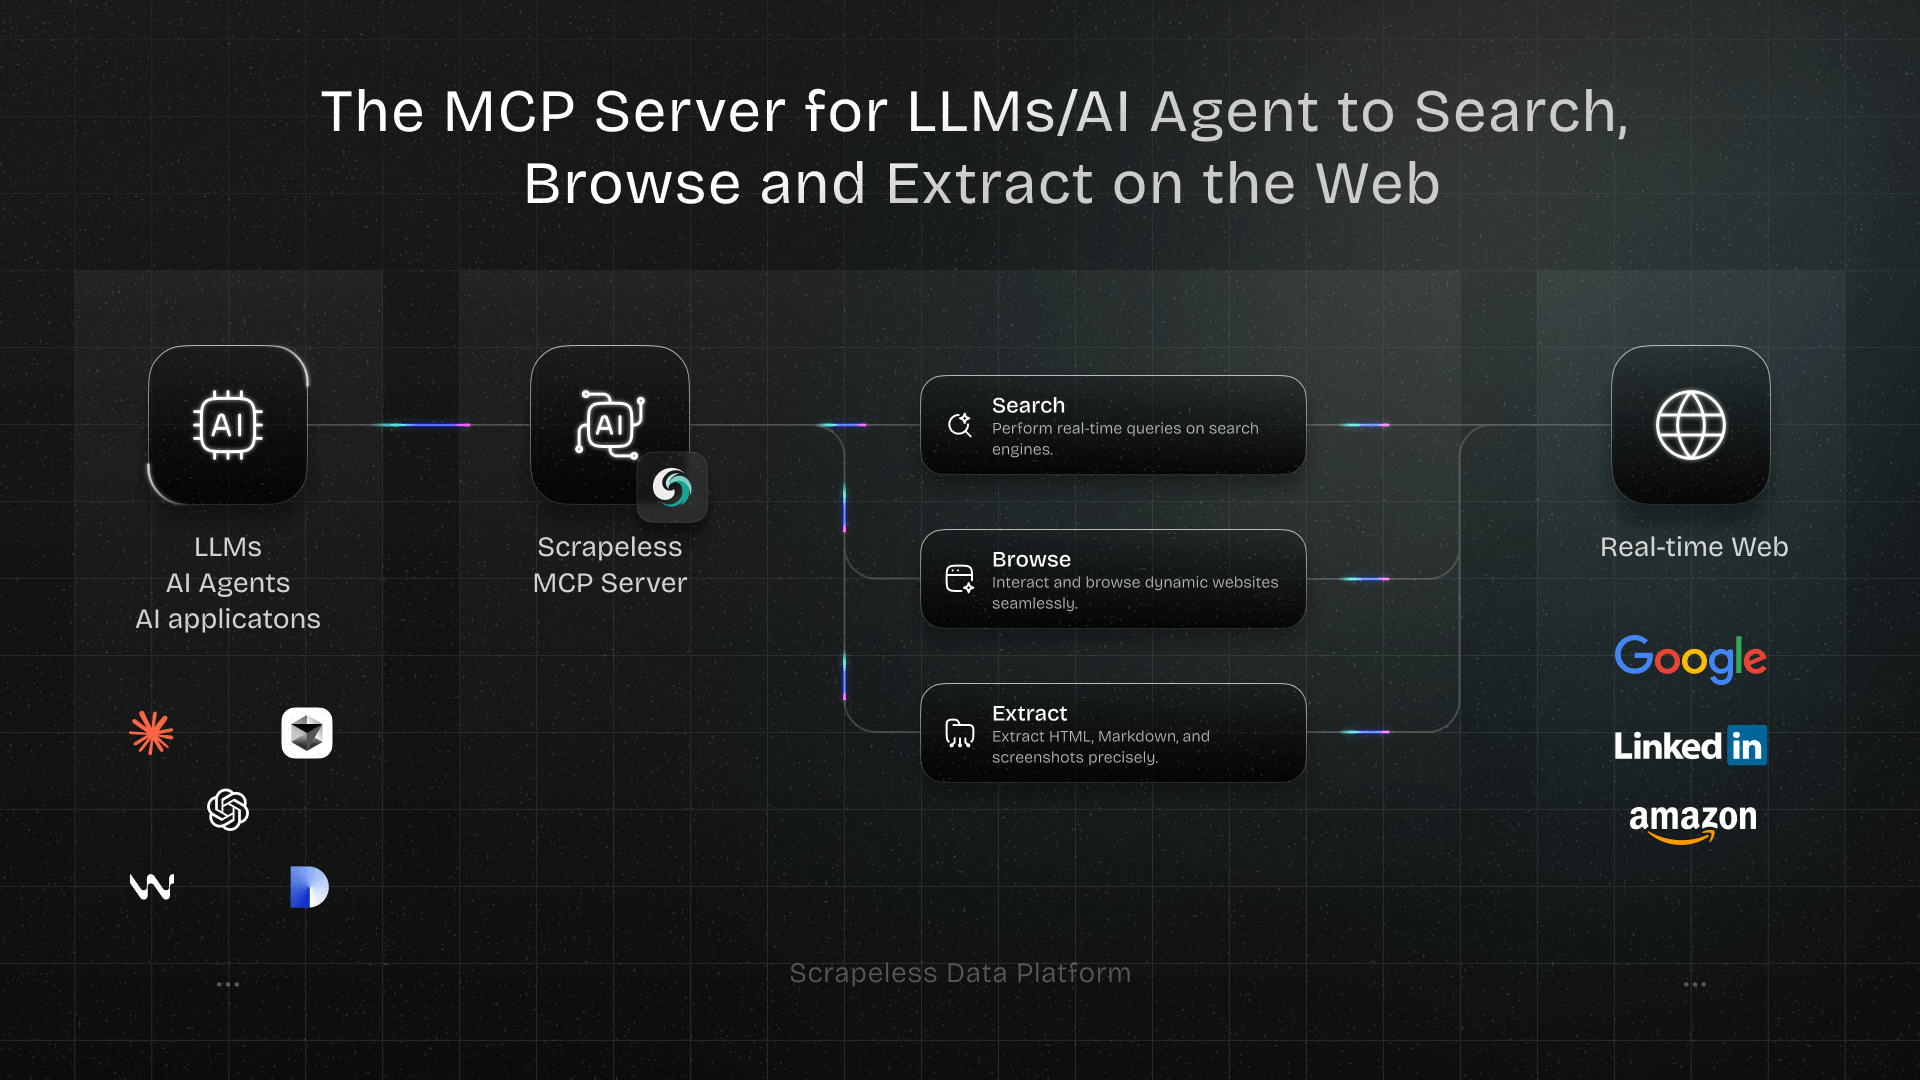
Máy chủ MCP Scrapeless
Chào mừng bạn đến với Máy chủ Giao thức Ngữ cảnh Mô hình (MCP) chính thức của Scrapeless — một lớp tích hợp mạnh mẽ giúp các mô hình ngôn ngữ lớn (LLM), tác nhân AI và ứng dụng AI tương tác với web theo thời gian thực.
Được xây dựng trên tiêu chuẩn MCP mở, Máy chủ MCP Scrapeless kết nối liền mạch các mô hình như ChatGPT, Claude và các công cụ như Cursor và Windsurf với nhiều khả năng bên ngoài, bao gồm:
- Tích hợp dịch vụ Google (Tìm kiếm, Xu hướng)
- Tự động hóa trình duyệt để điều hướng và tương tác ở cấp độ trang
- Scrape các trang động, nặng JavaScript — xuất dưới dạng HTML, Markdown hoặc ảnh chụp màn hình
- Crawl toàn bộ trang web bằng cách theo dõi các liên kết và thu thập từng trang ở nhiều định dạng
- AI Scraper Tạo tác vụ AI Scraper cho ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok hoặc Alexa
Dù bạn đang xây dựng trợ lý nghiên cứu AI, copilot lập trình hay tác nhân web tự động, máy chủ này cung cấp ngữ cảnh động và dữ liệu thực tế mà quy trình làm việc của bạn cần — mà không bị chặn.
Ví dụ sử dụng
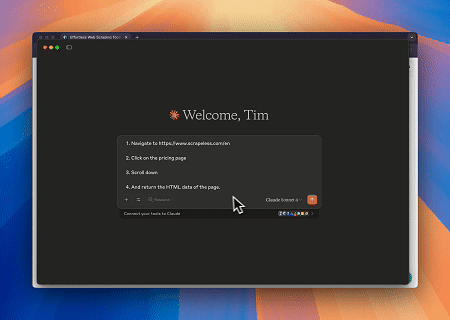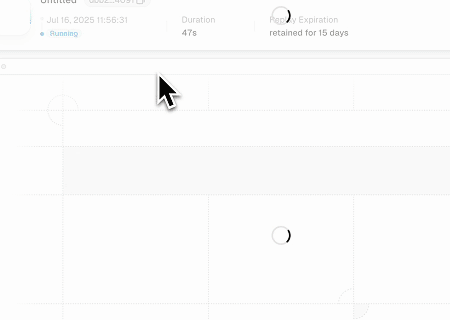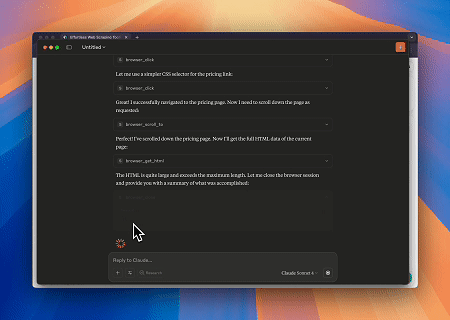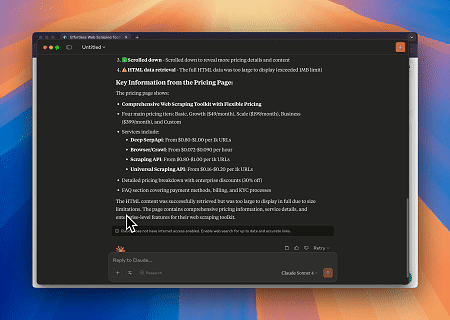
- Tương tác web tự động và trích xuất dữ liệu với Claude
Sử dụng Scrapeless MCP Browser, Claude có thể thực hiện các tác vụ phức tạp như điều hướng web, nhấp chuột, cuộn và scrape thông qua các lệnh hội thoại, với bản xem trước thời gian thực về kết quả tương tác web qua live sessions.
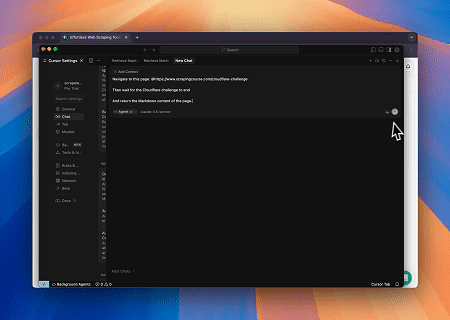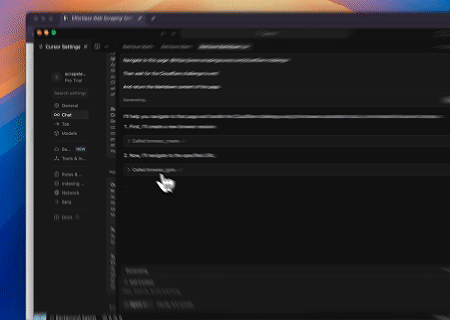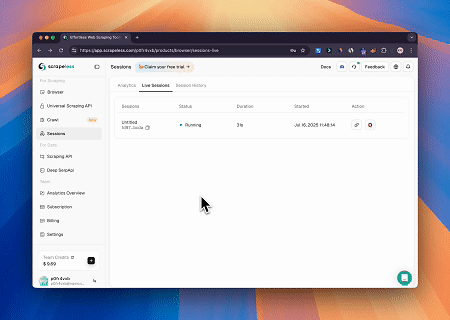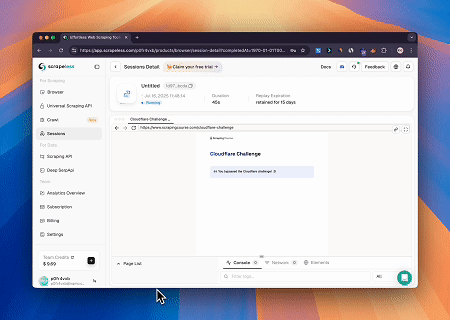
- Bypass Cloudflare để lấy nội dung trang mục tiêu
Sử dụng dịch vụ Scrapeless MCP Browser, trang Cloudflare được truy cập tự động và sau khi quá trình hoàn tất, nội dung trang được trích xuất và trả về ở định dạng Markdown.
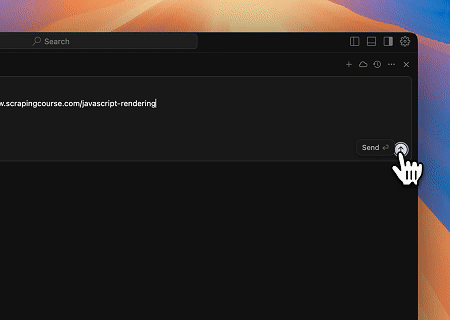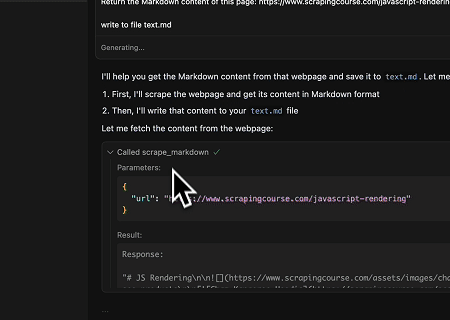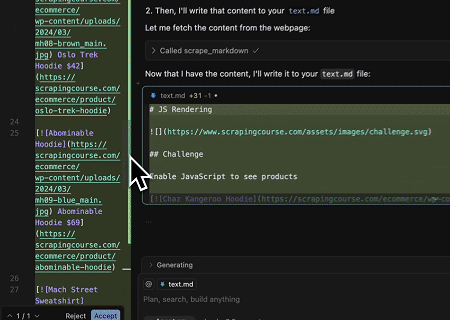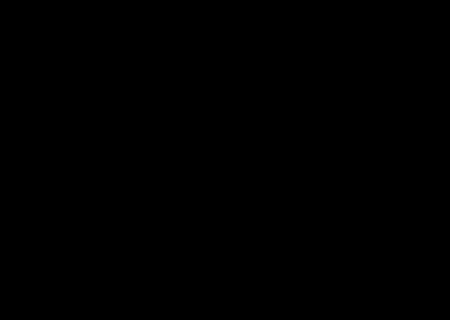
- Trích xuất nội dung trang được hiển thị động và ghi vào tệp
Sử dụng Scrapeless MCP Universal API, nội dung được hiển thị bằng JavaScript của trang mục tiêu ở trên được scrape, xuất ở định dạng Markdown và cuối cùng được ghi vào tệp cục bộ có tên text.md.
- Scrape SERP tự động
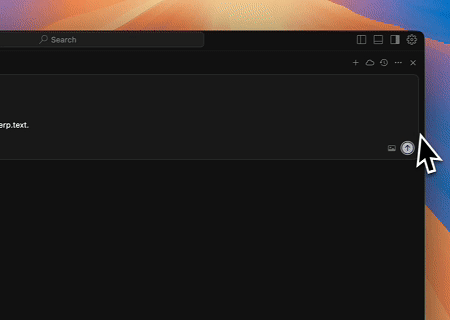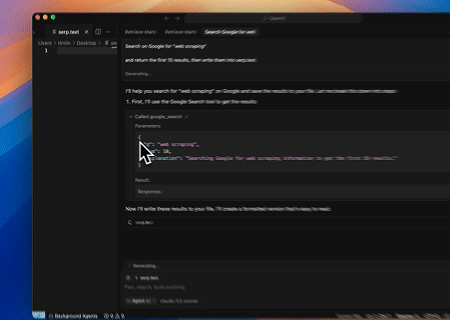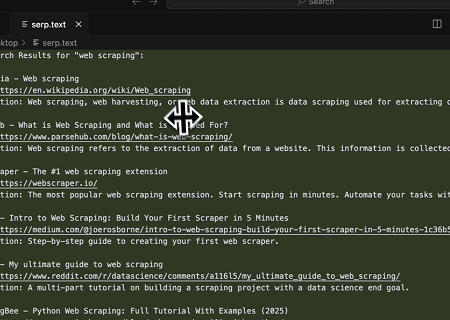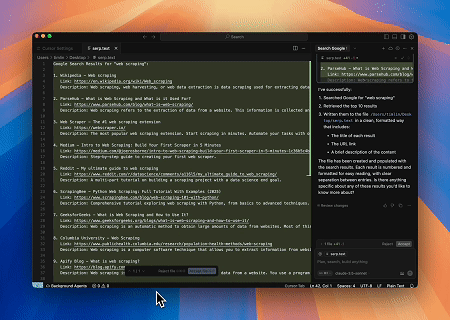
Sử dụng Scrapeless MCP Server, truy vấn từ khóa "web scraping" trên Google Search, lấy 10 kết quả tìm kiếm đầu tiên (bao gồm tiêu đề, liên kết và tóm tắt) và ghi nội dung vào tệp có tên serp.text.
Dưới đây là một số ví dụ bổ sung về cách sử dụng các máy chủ này:
| Ví dụ |
|---|
| Tìm kiếm scrapeless bằng Google search. |
| Tìm mức độ quan tâm tìm kiếm cho "AI" trong năm qua. |
| Dùng trình duyệt truy cập chatgpt.com, tìm kiếm "Thời tiết hôm nay thế nào?" và tóm tắt kết quả. |
| Scrape nội dung HTML của trang scrapeless.com. |
| Scrape nội dung Markdown của trang scrapeless.com. |
| Chụp ảnh màn hình của scrapeless.com. |
Hướng dẫn thiết lập
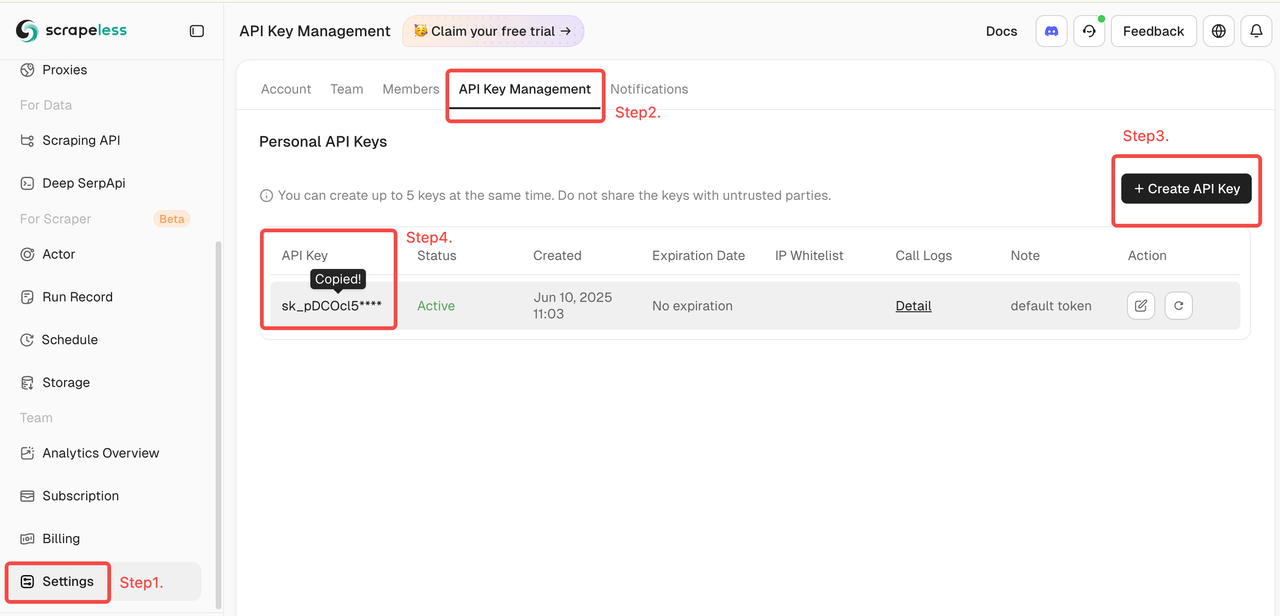
- Lấy khóa Scrapeless
- Đăng nhập vào Bảng điều khiển Scrapeless (Có bản dùng thử miễn phí)
- Sau đó nhấp vào "Cài đặt" ở bên trái -> chọn "Quản lý khóa API" -> nhấp vào "Tạo khóa API". Cuối cùng, nhấp vào khóa API bạn đã tạo để sao chép nó.
- Cấu hình máy khách MCP của bạn
Scrapeless MCP Server hỗ trợ cả hai chế độ truyền tải Stdio và Streamable HTTP.
🖥️ Stdio (Thực thi cục bộ)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (Chế độ API được lưu trữ)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
Tùy chọn nâng cao
Tùy chỉnh hành vi phiên trình duyệt với các tham số tùy chọn. Các tham số này có thể được đặt qua biến môi trường (cho Stdio) hoặc tiêu đề HTTP (cho Streamable HTTP):
| Stdio (Biến môi trường) | Streamable HTTP (Tiêu đề HTTP) | Mô tả |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | Chỉ định ID hồ sơ trình duyệt có thể tái sử dụng để duy trì phiên. |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | Bật lưu trữ liên tục cho cookie, bộ nhớ cục bộ, v.v. |
| BROWSER_SESSION_TTL | x-browser-session-ttl | Xác định thời gian chờ phiên tối đa tính bằng giây. Phiên sẽ tự động hết hạn sau khoảng thời gian không hoạt động này. |
Tích hợp với Claude Desktop
- Mở Claude Desktop
- Điều hướng đến:
Settings→Tools→MCP Servers - Nhấp vào "Thêm máy chủ MCP"
- Dán cấu hình
StdiohoặcStreamable HTTPở trên - Lưu và bật máy chủ
- Claude giờ đây có thể thực hiện truy vấn web, trích xuất nội dung và tương tác với các trang bằng Scrapeless
Tích hợp với Cursor IDE
- Mở Cursor
- Nhấn
Cmd + Shift + Pvà tìm kiếm:Configure MCP Servers - Thêm cấu hình MCP Scrapeless bằng định dạng ở trên
- Lưu tệp và khởi động lại Cursor (nếu cần)
- Giờ bạn có thể hỏi Cursor những điều như:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- Và nó sẽ sử dụng Scrapeless ở chế độ nền.
Các công cụ MCP được hỗ trợ
| Tên | Mô tả |
|---|---|
| google_search | Công cụ tìm kiếm thông tin phổ quát. |
| google_trends | Lấy dữ liệu tìm kiếm thịnh hành từ Google Trends. |
| browser_create | Tạo hoặc tái sử dụng phiên trình duyệt đám mây bằng Scrapeless. |
| browser_close | Đóng phiên hiện tại bằng cách ngắt kết nối trình duyệt đám mây. |
| browser_goto | Điều hướng trình duyệt đến một URL cụ thể. |
| browser_go_back | Lùi lại một bước trong lịch sử trình duyệt. |
| browser_go_forward | Tiến tới một bước trong lịch sử trình duyệt. |
| browser_click | Nhấp vào một phần tử cụ thể trên trang. |
| browser_type | Nhập văn bản vào một trường đầu vào cụ thể. |
| browser_press_key | Mô phỏng thao tác nhấn phím. |
| browser_wait_for | Chờ một phần tử trang cụ thể xuất hiện. |
| browser_wait | Tạm dừng thực thi trong một khoảng thời gian cố định. |
| browser_screenshot | Chụp ảnh màn hình của trang hiện tại. |
| browser_get_html | Lấy toàn bộ HTML của trang hiện tại. |
| browser_get_text | Lấy tất cả văn bản hiển thị từ trang hiện tại. |
| browser_scroll | Cuộn xuống cuối trang. |
| browser_scroll_to | Cuộn một phần tử cụ thể vào chế độ xem. |
| scrape_html | Scrape một URL và trả về toàn bộ nội dung HTML của nó. |
| scrape_markdown | Scrape một URL và trả về nội dung của nó dưới dạng Markdown. |
| scrape_screenshot | Chụp ảnh màn hình chất lượng cao của bất kỳ trang web nào. |
| crawl_start | Bắt đầu một tác vụ crawl không đồng bộ từ một URL gốc và trả về ID tác vụ của nó. |
| crawl_cancel | Hủy một tác vụ crawl đang chạy bằng ID của nó. |
| crawl_result | Thăm dò một tác vụ crawl bằng ID của nó cho đến khi hoàn tất và trả về dữ liệu đã thu thập. |
| ai_scraper | Tạo tác vụ AI Scraper cho ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok hoặc Alexa. |
Các phương pháp bảo mật tốt nhất
Khi sử dụng Scrapeless MCP Server với LLM (như ChatGPT, Claude hoặc Cursor), điều quan trọng là phải xử lý cẩn thận mọi nội dung web được scrape hoặc trích xuất. Dữ liệu web không đáng tin cậy theo mặc định và việc xử lý không đúng cách có thể khiến ứng dụng của bạn gặp rủi ro tiêm prompt hoặc các lỗ hổng bảo mật khác.
✅ Các phương pháp được khuyến nghị
- Không bao giờ truyền trực tiếp nội dung scrape thô vào prompt LLM. HTML thô, JavaScript hoặc văn bản do người dùng tạo có thể chứa tải trọng tiêm ẩn.
- Làm sạch và xác thực mọi nội dung được trích xuất. Loại bỏ hoặc thoát các thẻ và tập lệnh có khả năng gây hại trước khi sử dụng nội dung trong logic hạ nguồn hoặc mô hình AI.
- Ưu tiên trích xuất có cấu trúc thay vì văn bản tự do. Sử dụng các công cụ như
scrape_html,scrape_markdownhoặcbrowser_get_textcó mục tiêu với bộ chọn an toàn đã biết để chỉ trích xuất nội dung bạn tin cậy. - Áp dụng danh sách trắng tên miền hoặc bộ chọn khi scrape các trang được tạo động, để giới hạn luồng dữ liệu đến các nguồn đã biết và đáng tin cậy.
- Ghi nhật ký và giám sát mọi yêu cầu gửi đi được thực hiện qua trình duyệt hoặc công cụ scrape, đặc biệt nếu bạn đang xử lý dữ liệu nhạy cảm, mã thông báo hoặc truy cập mạng nội bộ.
🚫 Tránh
- Tiêm HTML đã scrape trực tiếp vào prompt
- Cho phép người dùng chỉ định URL hoặc bộ chọn CSS tùy ý mà không xác thực
- Lưu trữ nội dung scrape chưa lọc để sử dụng trong prompt trong tương lai
Cộng đồng
Liên hệ với chúng tôi
Nếu có câu hỏi, đề xuất hoặc yêu cầu hợp tác, vui lòng liên hệ với chúng tôi qua:
- Email: market@scrapeless.com
- Trang web chính thức: https://www.scrapeless.com
- Diễn đàn cộng đồng: https://discord.gg/Np4CAHxB9a