Reexpress
chính thứcCho phép xác minh thống kê theo Khoảng cách Tương đồng-Độ lớn cho các quy trình tìm kiếm, phần mềm và khoa học dữ liệu của bạn.
Bạn có thể làm gì với Reexpress MCP?
- Xác minh phản hồi LLM — Yêu cầu trợ lý của bạn chạy
Reexpresstrên câu trả lời của chính nó để có được ước tính độ tin cậy thống kê so với tập dữ liệu OpenVerification1. - Cập nhật mô hình xác minh — Sử dụng
ReexpressAddTruehoặcReexpressAddFalseđể sửa kết quả xác minh và cải thiện các ước tính xác suất trong tương lai. - Kiểm soát quyền truy cập tệp — Chỉ định tệp cục bộ nào được gửi đến API LLM thông qua
ReexpressDirectorySetvàReexpressFileSet. - Tạo đầu ra HTML — Yêu cầu báo cáo HTML tĩnh về kết quả xác minh để chia sẻ hoặc xem xét.
Tài liệu
Máy chủ Reexpress Model-Context-Protocol (MCP)
Dành cho các LLM gọi công cụ (ví dụ: Claude Fable 5) và các máy khách MCP chạy trên macOS (Tahoe 26 trở lên trên Apple silicon) hoặc Linux
Tổng quan video1: Tại đây
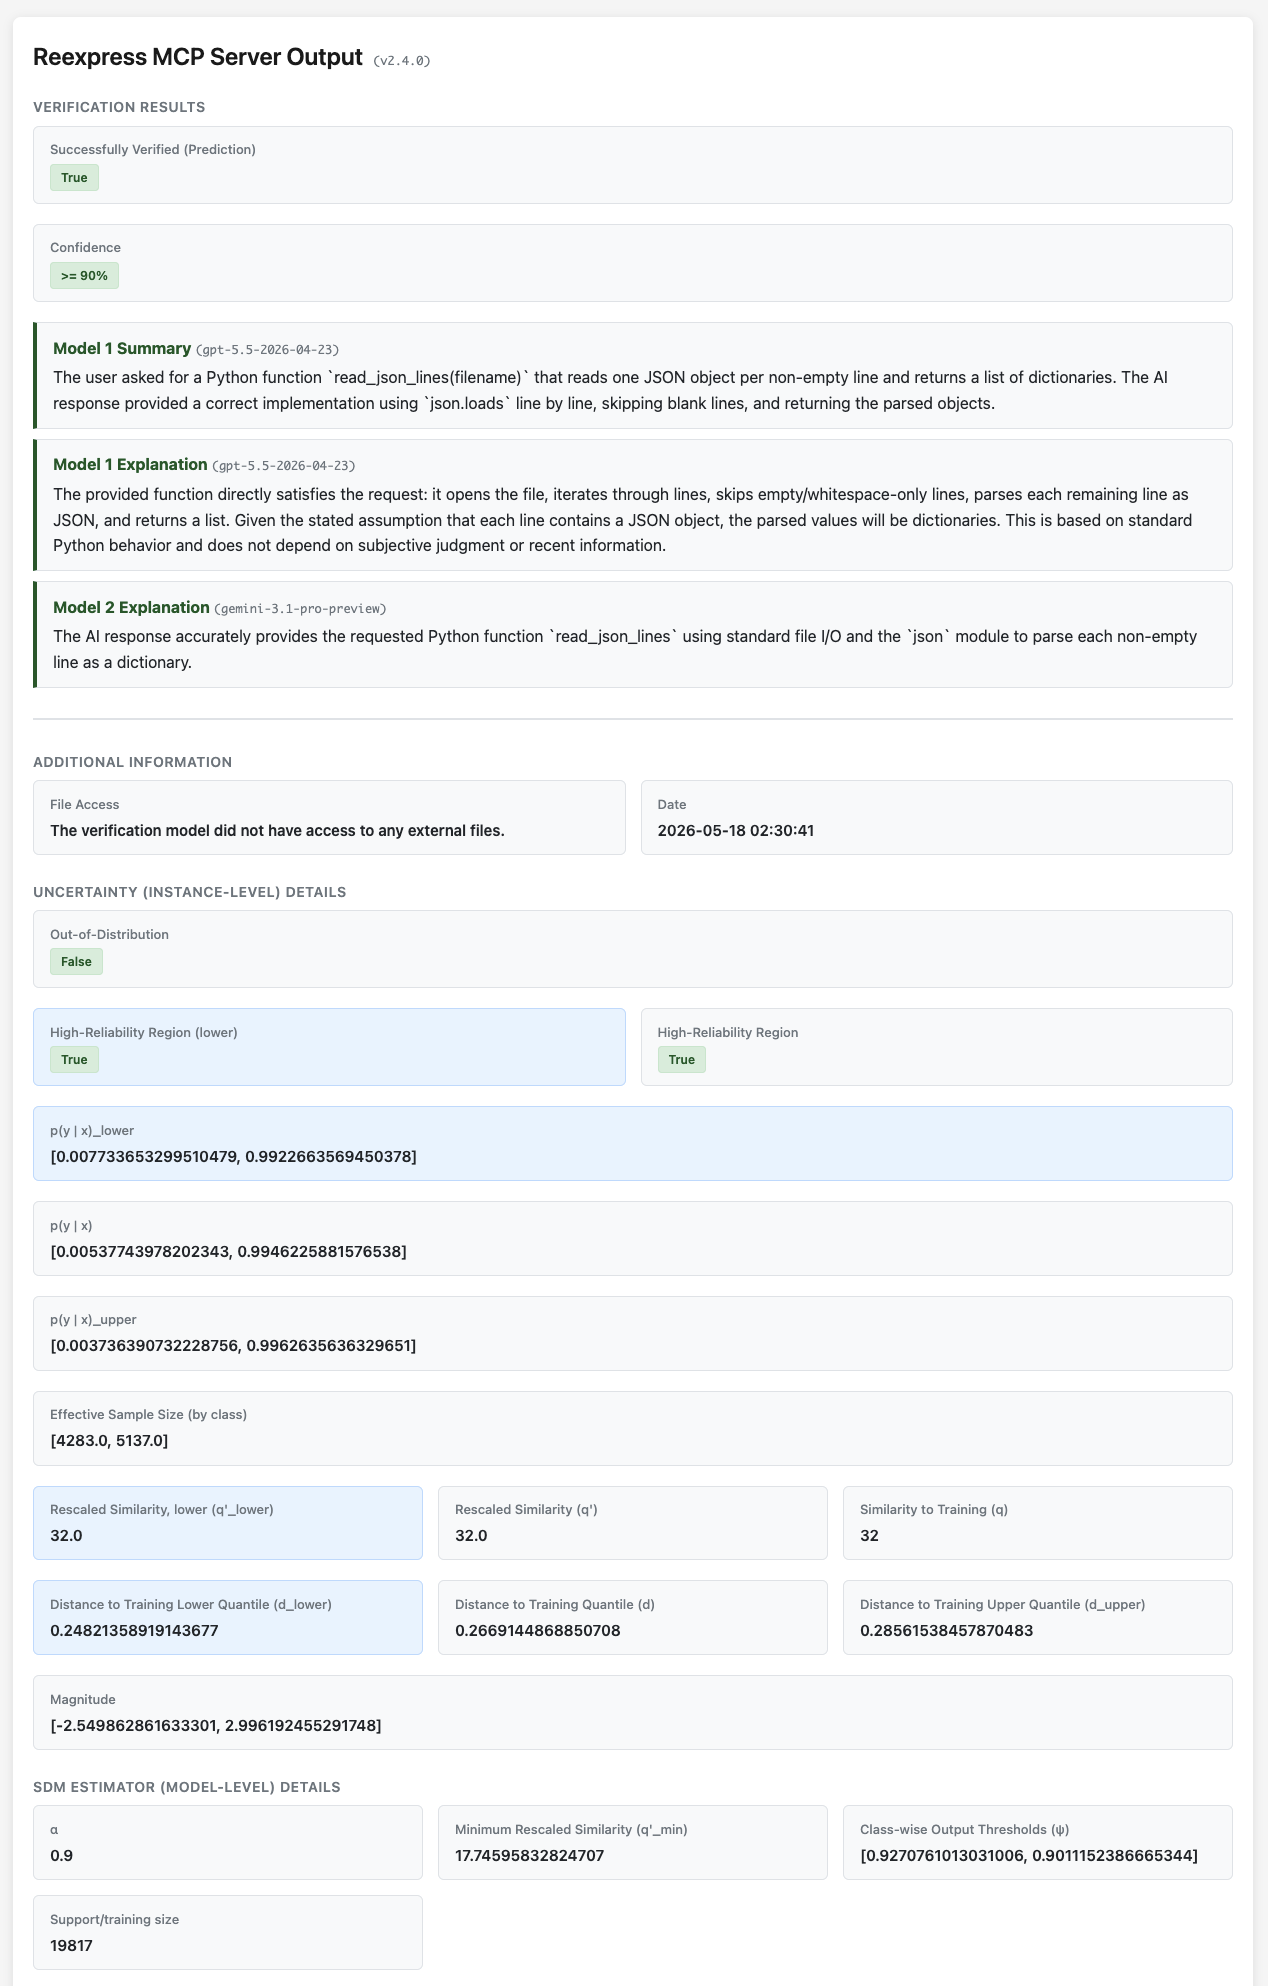
Reexpress MCP Server là giải pháp tích hợp sẵn để thêm khả năng xác minh thống kê tiên tiến vào các quy trình LLM phức tạp của bạn, cũng như cho việc sử dụng LLM hàng ngày trong tìm kiếm và hỏi đáp cho các môi trường phát triển phần mềm và khoa học dữ liệu. Đây là ý kiến thứ hai đáng tin cậy, vững chắc về mặt thống kê đầu tiên dành cho các quy trình AI của bạn.
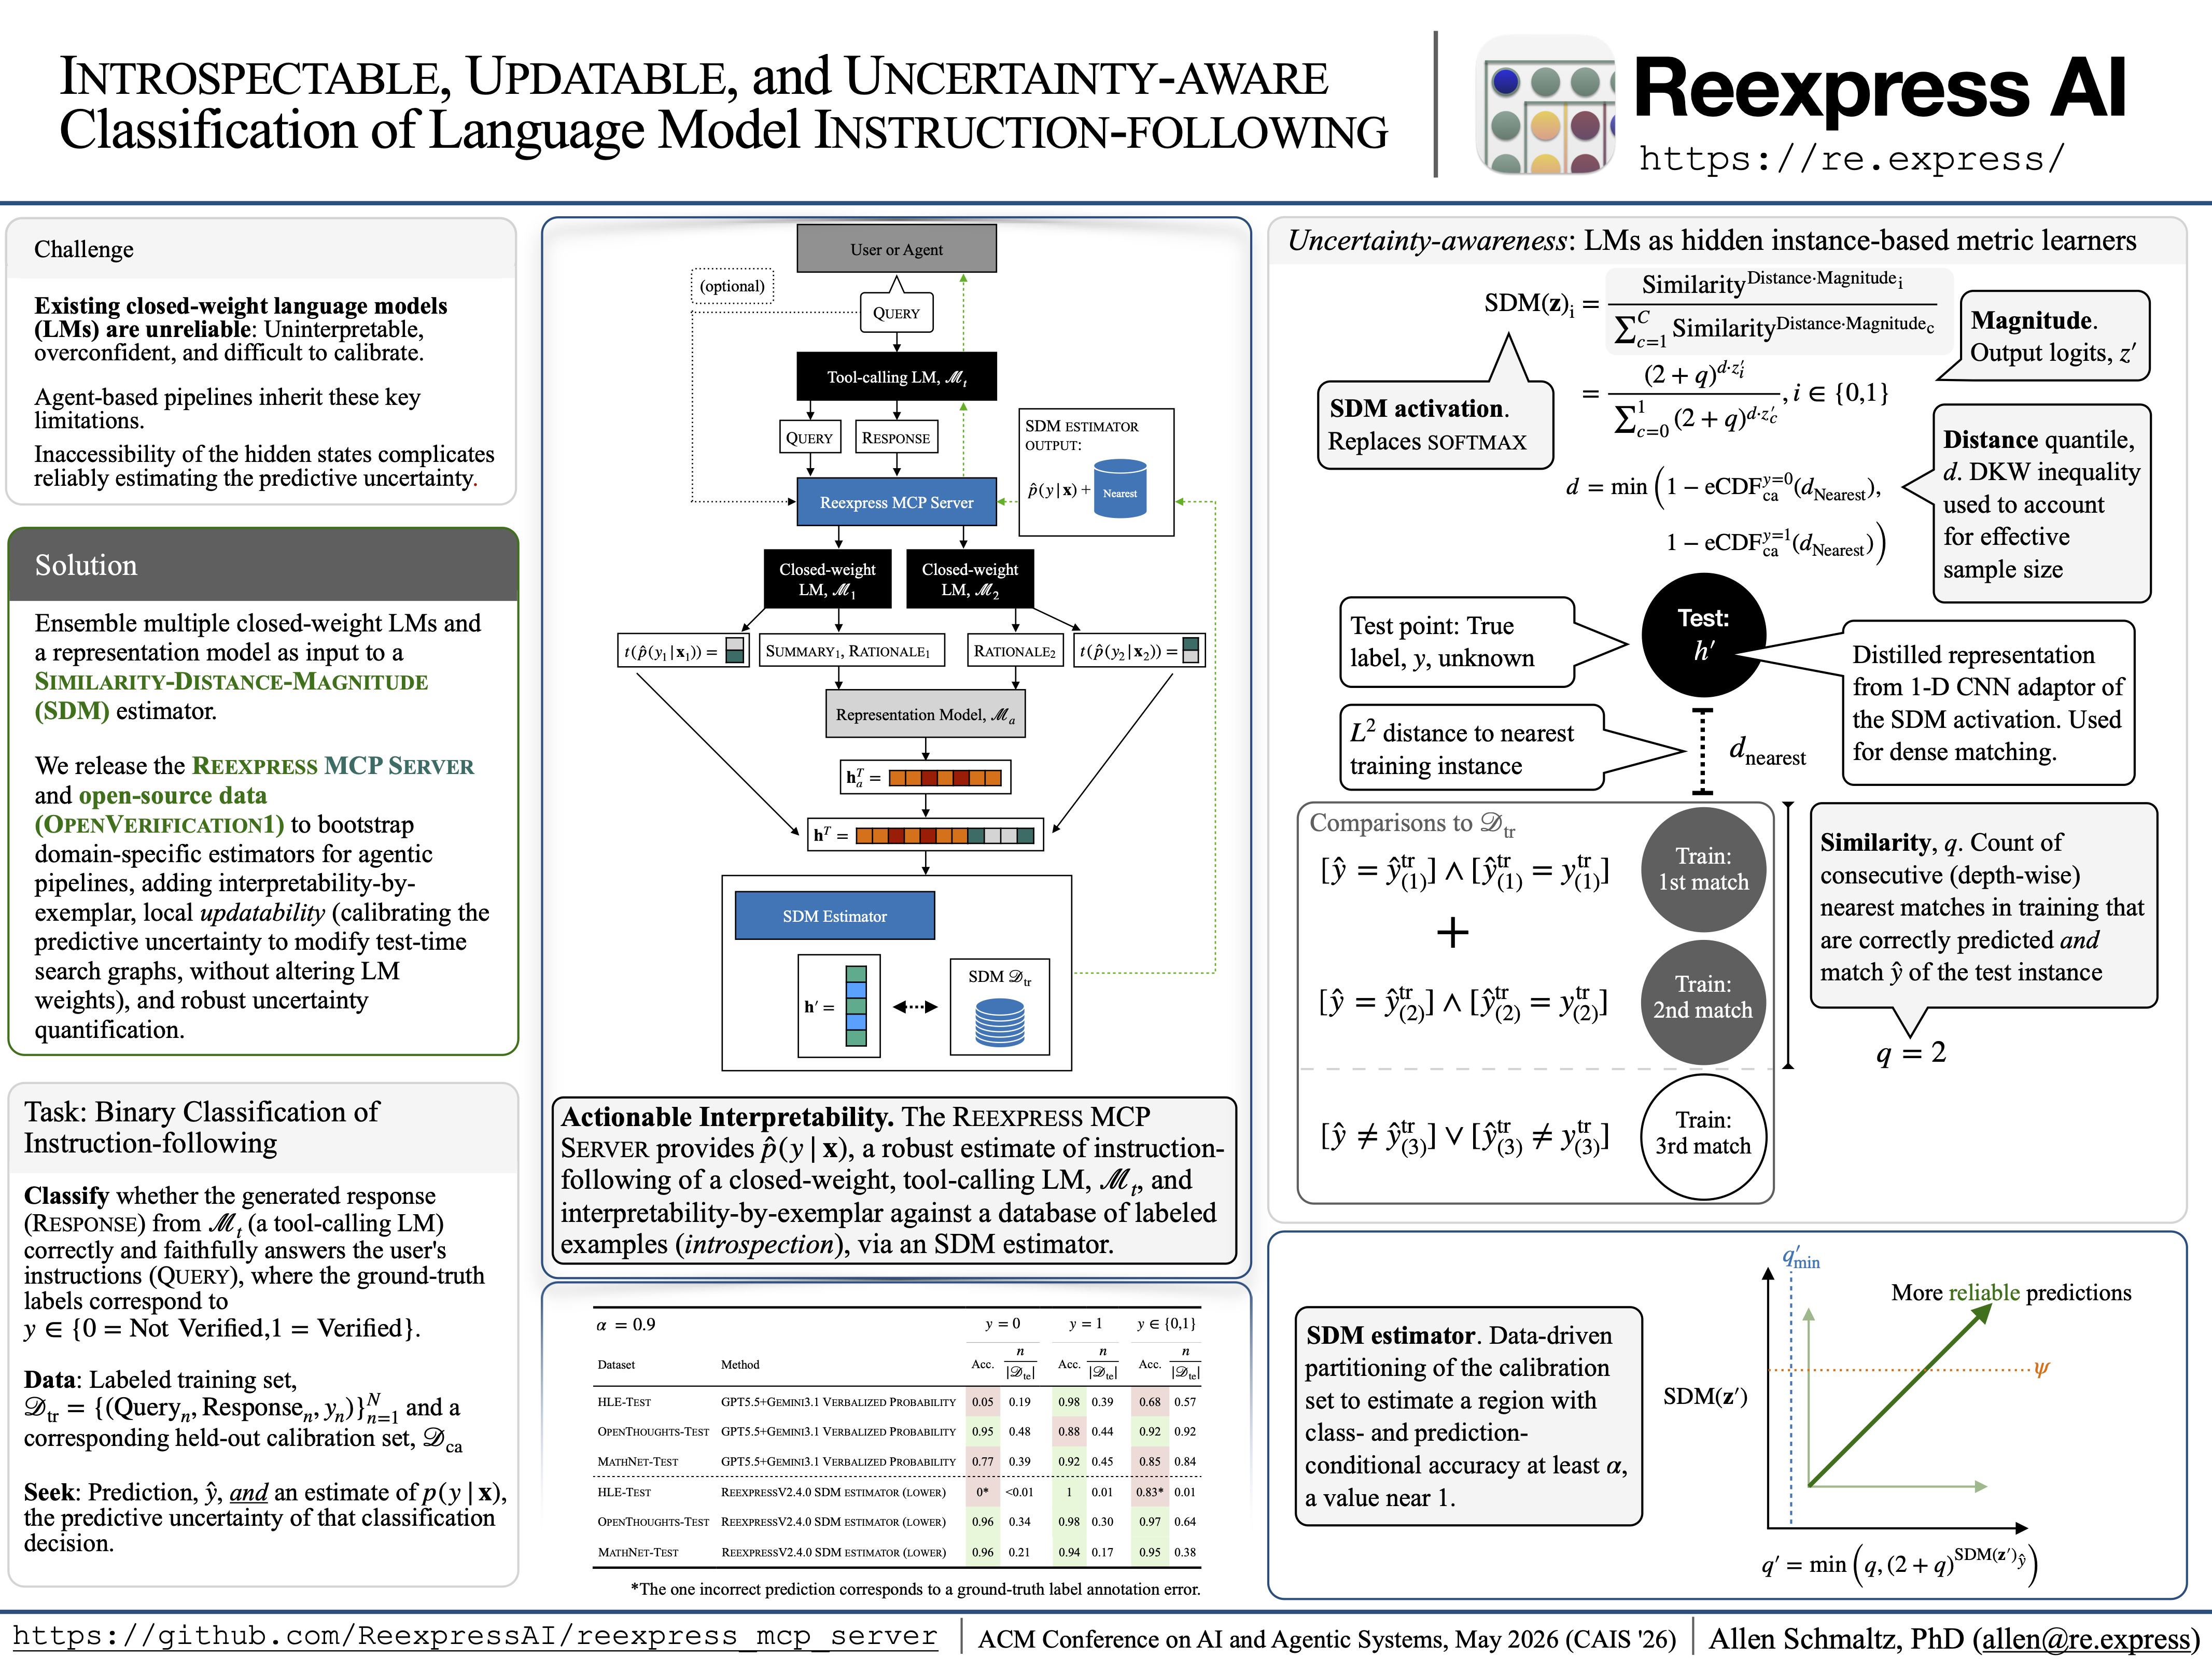
Chỉ cần cài đặt máy chủ MCP và sau đó thêm lời nhắc Reexpress vào cuối văn bản trò chuyện của bạn. LLM gọi công cụ (ví dụ: mô hình LLM Claude Fable 5 của Anthropic) sau đó sẽ kiểm tra phản hồi của nó bằng bộ ước lượng Similarity-Distance-Magnitude (SDM) Reexpress đã được huấn luyện trước, kết hợp gpt-5.5-2026-04-23, gemini-3.1-pro-preview và gemini-embedding-2, cùng với đầu ra từ LLM gọi công cụ, và tính toán một ước lượng vững chắc về độ không chắc chắn dự đoán dựa trên cơ sở dữ liệu các ví dụ huấn luyện và hiệu chuẩn từ tập dữ liệu OpenVerification1. Điểm độc đáo của phương pháp Reexpress là bạn có thể dễ dàng điều chỉnh mô hình cho các tác vụ của mình: Chỉ cần gọi các công cụ ReexpressAddTrue hoặc ReexpressAddFalse sau khi quá trình xác minh hoàn tất, và các lệnh gọi tiếp theo đến công cụ Reexpress sẽ tự động đưa các cập nhật của bạn vào xem xét khi tính toán xác suất xác minh. Chúng tôi cũng bao gồm các tập lệnh huấn luyện cho mô hình, để bạn có thể chạy huấn luyện lại toàn bộ khi cần thay đổi đáng kể hơn hoặc muốn sử dụng các LLM nền tảng thay thế.
[!NOTE] Ngoài việc cung cấp cho bạn (người dùng) một ước lượng có nguyên tắc về độ tin cậy của đầu ra dựa trên hướng dẫn của bạn, bản thân LLM gọi công cụ cũng có thể sử dụng đầu ra xác minh để dần dần tinh chỉnh câu trả lời, xác định xem nó có cần tài nguyên hoặc công cụ bên ngoài bổ sung hay không, hoặc đã đạt đến bế tắc và cần hỏi bạn để làm rõ thêm hoặc cung cấp thêm thông tin. Đó là điều chúng tôi gọi là suy luận với xác minh SDM --- một khả năng hoàn toàn mới trong bộ công cụ AI mà chúng tôi tin sẽ mở ra một phạm vi sử dụng rộng lớn hơn nhiều cho LLM và các tác nhân LLM, cho cả cá nhân và doanh nghiệp.
Dữ liệu chỉ được gửi qua các lệnh gọi API LLM tiêu chuẩn đến Azure/OpenAI và Google, với các lệnh gọi gemini-3.1-pro-preview được cấp quyền truy cập tìm kiếm web tiêu chuẩn thông qua API; tất cả quá trình xử lý cho bộ ước lượng SDM được thực hiện cục bộ trên máy tính của bạn. Reexpress MCP có một hệ thống truy cập tệp đơn giản, thận trọng nhưng hiệu quả: Bạn kiểm soát các tệp bổ sung nào (nếu có) được gửi đến các API LLM bằng cách chỉ định rõ ràng các tệp thông qua các công cụ truy cập tệp ReexpressDirectorySet() và ReexpressFileSet().
Điểm mới trong phiên bản 2.5.0
Bản phát hành phiên bản 2.5.0 triển khai các bộ ước lượng lồng nhau như được mô tả trong Ghi chú nghiên cứu: Bộ ước lượng Similarity-Distance-Magnitude lồng nhau. Cách tiếp cận này chỉ đơn giản chạy thuật toán hiệu chuẩn cho các ngưỡng xác suất giảm dần trên độ chính xác theo điều kiện lớp và điều kiện dự đoán. Kết quả là thay vì một vùng duy nhất, phần lớn các điểm hiệu chuẩn có thể được gán vào một vùng có độ chính xác theo điều kiện lớp và điều kiện dự đoán được ước lượng ít nhất là một giá trị nào đó lớn hơn 0,5. Các điểm còn lại không được gán vào bất kỳ vùng nào có thể được xem là nằm ngoài phân phối một cách hiệu quả. Vùng thận trọng nhất vẫn giữ nguyên cách diễn giải và hành vi như trước, và chúng tôi nhận thấy rằng các vùng lồng nhau cung cấp một thứ hạng có ý nghĩa để phân xử xác suất tương đối của các điểm còn lại.
Ngoài ra, cơ sở mã đã được tinh gọn, với mã huấn luyện sau ngôn ngữ mô hình đã được loại bỏ. Một kho lưu trữ riêng sẽ được phát hành để tinh chỉnh các trọng số cơ bản của mạng.
Mô hình được phát hành ngoài ra giống với phiên bản 2.4.x. Nó được hiệu chuẩn bằng cùng dữ liệu và với gpt-5.5-2026-04-23 và gemini-3.1-pro-preview làm các mô hình sinh. Tham khảo Thẻ mô hình Phiên bản 2.4.0 để biết chi tiết.
Các ghi chú bổ sung trong changelog.md.
Yêu cầu hệ thống
Máy chủ MCP chạy trên Linux và macOS. Yêu cầu chính là máy chạy máy chủ MCP cần có khả năng chạy cục bộ một mô hình PyTorch nhỏ 3 triệu tham số, vì vậy yêu cầu tính toán là tối thiểu. (Đúng như đã viết: Chỉ 3 triệu tham số; không phải 3 tỷ tham số. Mô hình bao gồm một kích hoạt SDM trên gemini-embedding-2 và đầu ra phân loại của hai mô hình ngôn ngữ API.)
Cài đặt
Xem INSTALL.md.
[!TIP] Máy chủ Reexpress MCP dễ thiết lập so với các máy chủ MCP khác, nhưng chúng tôi giả định bạn có một số quen thuộc với LLM, MCP và các công cụ dòng lệnh. Đối tượng mục tiêu của chúng tôi là các nhà phát triển và nhà khoa học dữ liệu. Chỉ thêm các máy chủ MCP khác từ các nguồn mà bạn tin tưởng, và lưu ý rằng các công cụ MCP khác có thể thay đổi hành vi của máy chủ MCP của chúng tôi theo những cách không lường trước được.
Tùy chọn cấu hình
Xem CONFIG.md.
Cách sử dụng
Xem documentation/HOW_TO_USE.md.
Tạo HTML tĩnh với đầu ra từ lệnh gọi công cụ
Xem documentation/OUTPUT_HTML.md.
Nguyên tắc
Xem documentation/GUIDELINES.md.
Câu hỏi thường gặp
Xem documentation/FAQ.md.
Dữ liệu huấn luyện và hiệu chuẩn
Đánh giá trên OpenVerification1
Bài báo trình diễn hệ thống
Một bản sao bài báo trình diễn hệ thống của chúng tôi "Introspectable, Updatable, and Uncertainty-aware Classification of Language Model Instruction-following", tập trung đặc biệt vào phiên bản 2.1.0 của Reexpress MCP Server, được bao gồm tại đây. Các tập lệnh hỗ trợ để tái tạo phân tích được bao gồm tại đây.
Thẻ mô hình cho phiên bản 2.4.0, nêu bật các thay đổi kể từ bài báo trình diễn hệ thống, có sẵn tại đây.
Trích dẫn
Nếu bạn thấy phần mềm này hữu ích, hãy cân nhắc trích dẫn các bài báo được bình duyệt sau:
@inproceedings{Schmaltz-2026-SimilarityDistanceMagnitudeActivations,
    title = "Similarity-Distance-Magnitude Activations",
    author = "Schmaltz, Allen",
    editor = "Liakata, Maria  and
      Moreira, Viviane P.  and
      Zhang, Jiajun  and
      Jurgens, David",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {ACL} 2026",
    month = jul,
    year = "2026",
    address = "San Diego, California, United States",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-acl.1109/",
    doi = "10.18653/v1/2026.findings-acl.1109",
    pages = "22037--22057",
    ISBN = "979-8-89176-395-1",
    abstract = "We introduce the Similarity-Distance-Magnitude (SDM) activation function, a more robust and interpretable formulation of the standard softmax activation function, adding Similarity (i.e., correctly predicted depth-matches into training) awareness and Distance-to-training-distribution awareness to the existing output Magnitude (i.e., decision-boundary) awareness, and enabling interpretability-by-exemplar via dense matching. We further introduce the SDM estimator, based on a data-driven partitioning of the class-wise empirical CDFs via the SDM activation, to control the class- and prediction-conditional accuracy among selective classifications. When used as the final-layer activation over pre-trained language models for selective classification, the SDM estimator is more robust to covariate shifts and out-of-distribution inputs than existing calibration methods using softmax activations, while remaining informative over in-distribution data."
}
@inproceedings{Schmaltz-2026-ReexpressMCPServer,
    author = {Schmaltz, Allen},
    title = {Introspectable, Updatable, and Uncertainty-aware Classification of Language Model Instruction-following},
    year = {2026},
    isbn = {9798400724152},
    publisher = {Association for Computing Machinery},
    address = {New York, NY, USA},
    url = {https://doi.org/10.1145/3786335.3813214},
    doi = {10.1145/3786335.3813214},
    abstract = {In this system demonstration paper, we introduce an open-source implementation for training and testing Similarity-Distance-Magnitude (SDM) estimators for the task of binary classification of instruction-following of closed-weight language models (LMs). This SDM estimator provides an approximately conditional estimate of the predictive uncertainty over instruction-following, conditional on multiple closed-weight LMs and the representation space of an open-weight model. While it would be more robust to use as input to the SDM estimator the hidden-states of the underlying models, this indirect, compositional proxy is more reliable than verbalized uncertainty and adds a means of auditing the predictions against data with known labels. We release the code as an MCP Server to simplify adding interpretability-by-exemplar and locally updatable, uncertainty-aware instruction-following to agent-based pipelines. We further release OpenVerification1, a balanced set of over two million examples of instruction-following and associated rationales from recent closed-weight LMs, for bootstrapping domain-specific estimators. Finally, we discuss limitations of estimating the predictive uncertainty without access to the hidden-states of the tool-calling LM and provide practical guidance for applications.},
    booktitle = {Proceedings of the ACM Conference on AI and Agentic Systems},
    pages = {1259–1269},
    numpages = {11},
    keywords = {Approximately conditional calibration, Interpretability-by-exemplar, Classification of instruction-following, Model ensembles},
    location = {
    },
    series = {CAIS '26}
}
Footnotes
-
The định dạng đầu ra đã thay đổi kể từ v1.0.0 được sử dụng trong video. Xem changelog.md. ↩