New Term Radar
Captura os nomes de novos modelos de IA, produtos e repositórios no X, Hugging Face, GitHub e sitemaps antes que ferramentas de palavras-chave os listem, e dimensiona os termos de busca por trás de cada nome.
Documentação
new-term-radar
Um relatório diário dos nomes que estão começando a disparar em IA: novos modelos, produtos, ferramentas e repositórios, capturados onde são mencionados primeiro, antes de aparecerem em ferramentas de palavras-chave.
Feito para pessoas que criam páginas, posts ou produtos em torno de novos termos: SEO para sites de ferramentas de IA, newsletters, diretórios, qualquer pessoa que queira saber sobre "Strata" ou "Seedance" no dia em que aparecem, e não duas semanas depois.
Por quê
Um novo nome deixa um rastro, nesta ordem:
- Um laboratório ou uma conta muito seguida o menciona no X; um modelo entra na lista de tendências do Hugging Face.
- Um repositório GitHub decola sozinho.
- Diretórios e concorrentes adicionam páginas para ele; alguém registra um domínio para ele e o site começa a ranquear.
- Seu próprio site recebe as primeiras impressões de busca para ele.
- O Google Trends mostra a curva, dias ou semanas depois.
Ferramentas de palavras-chave leem o passo 5. Este radar lê os passos 1 a 4 todos os dias e usa o passo 5 apenas para se verificar.
Um exemplo em torno do qual foi construído: Niko1221/Strata foi criado em 2026-09-24 e tinha 7.700 estrelas nove dias depois. As pessoas buscavam "niko strata" desde 26/09, enquanto nenhum outro repositório carregava o nome e nenhuma ferramenta de palavras-chave o listava. Um único repositório ganhando 800 estrelas por dia é o sinal completo, e é público.
O que ele lê
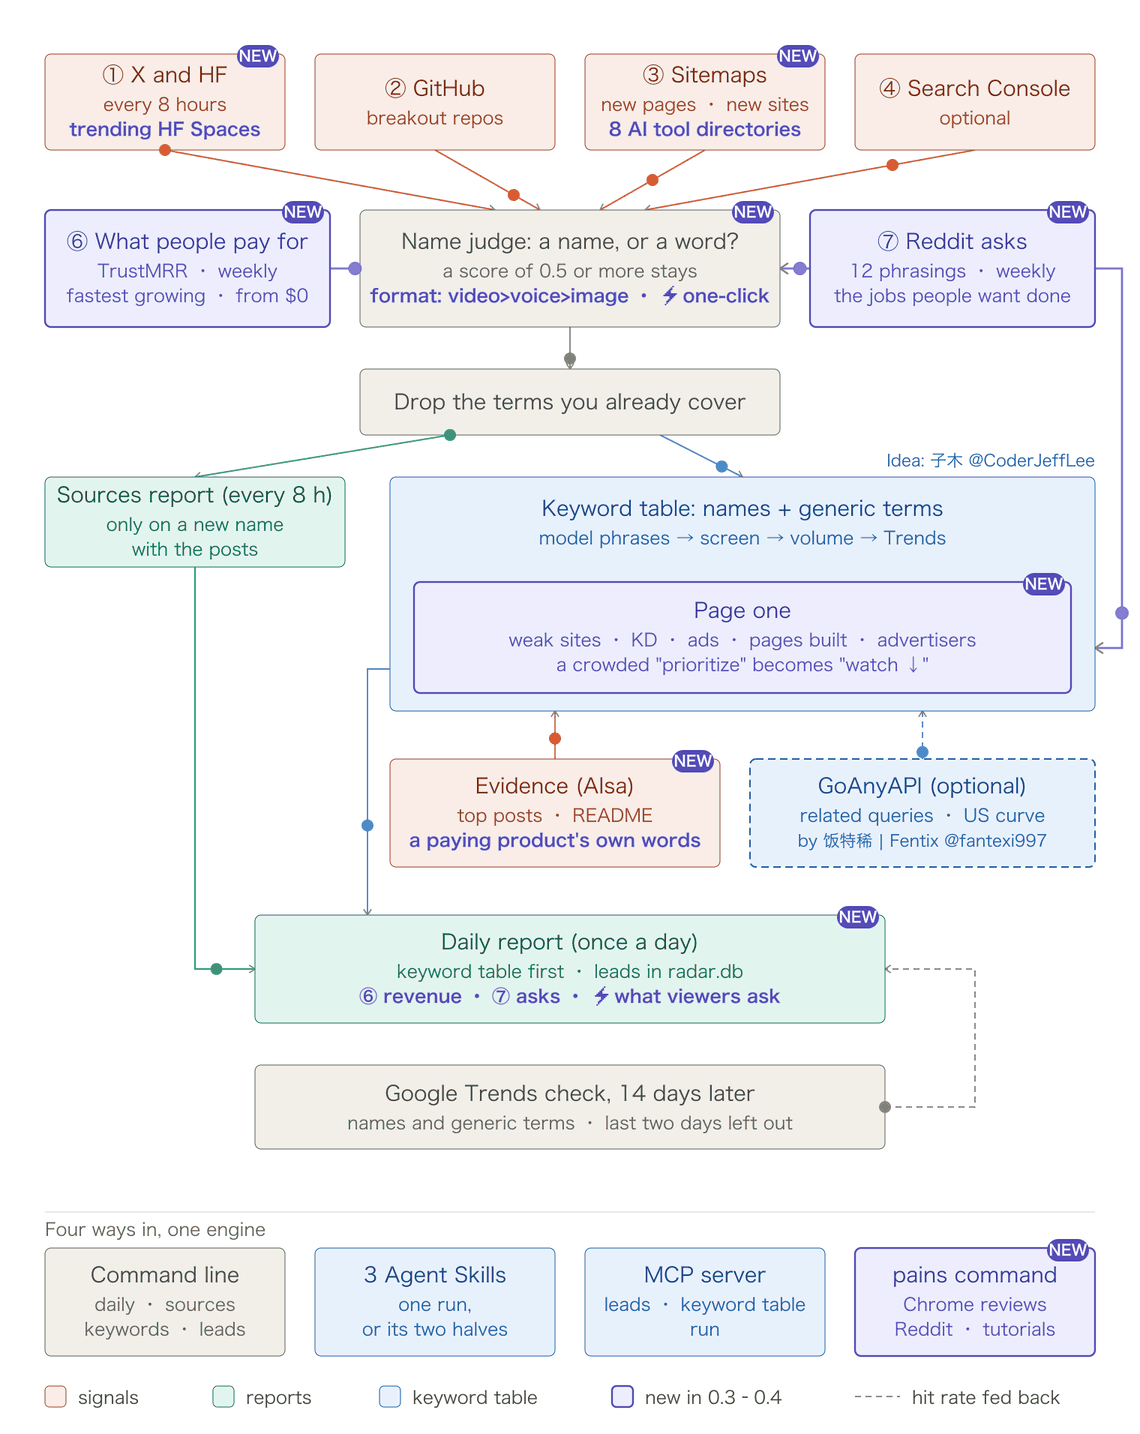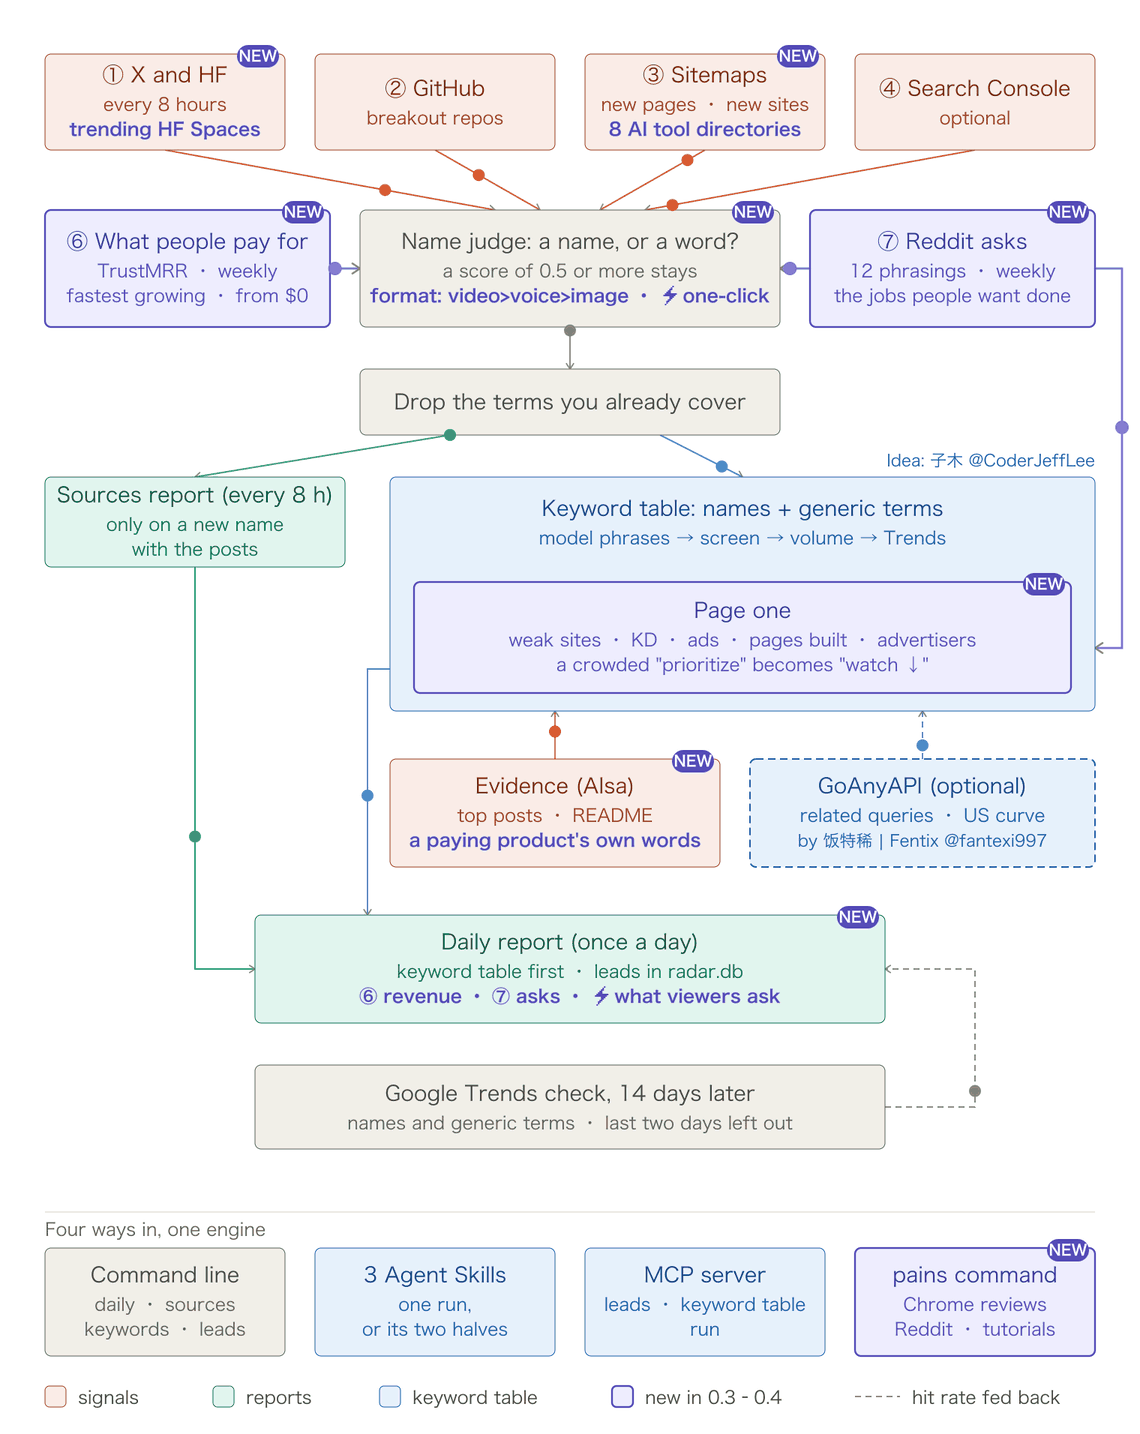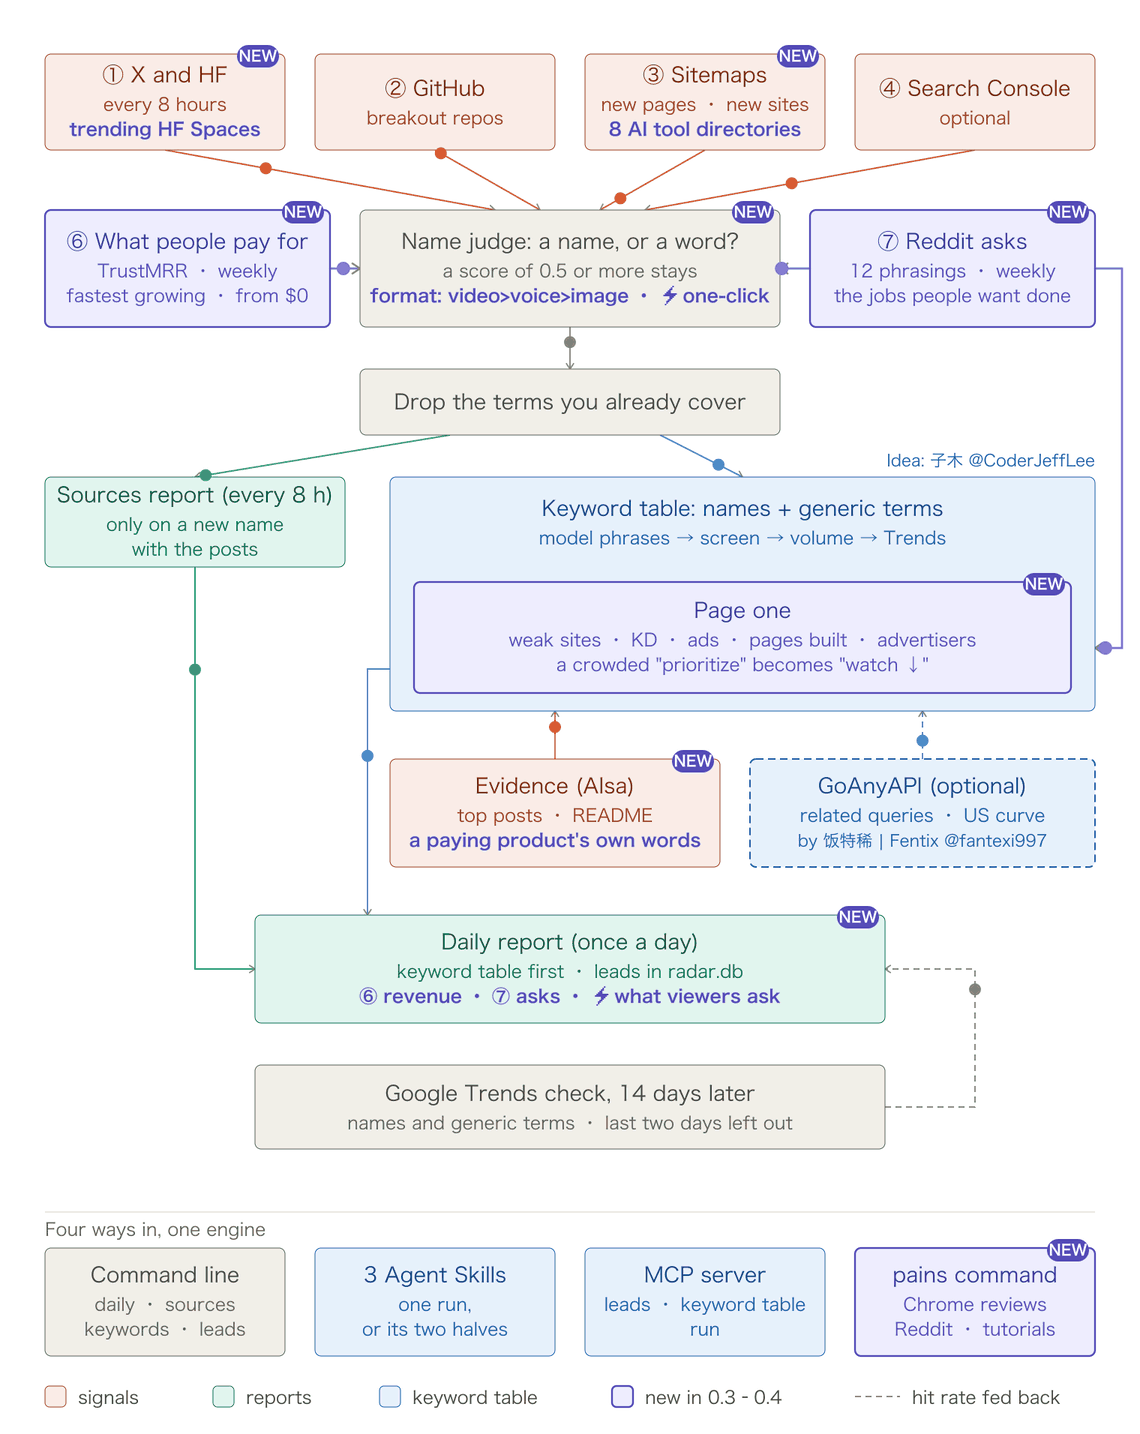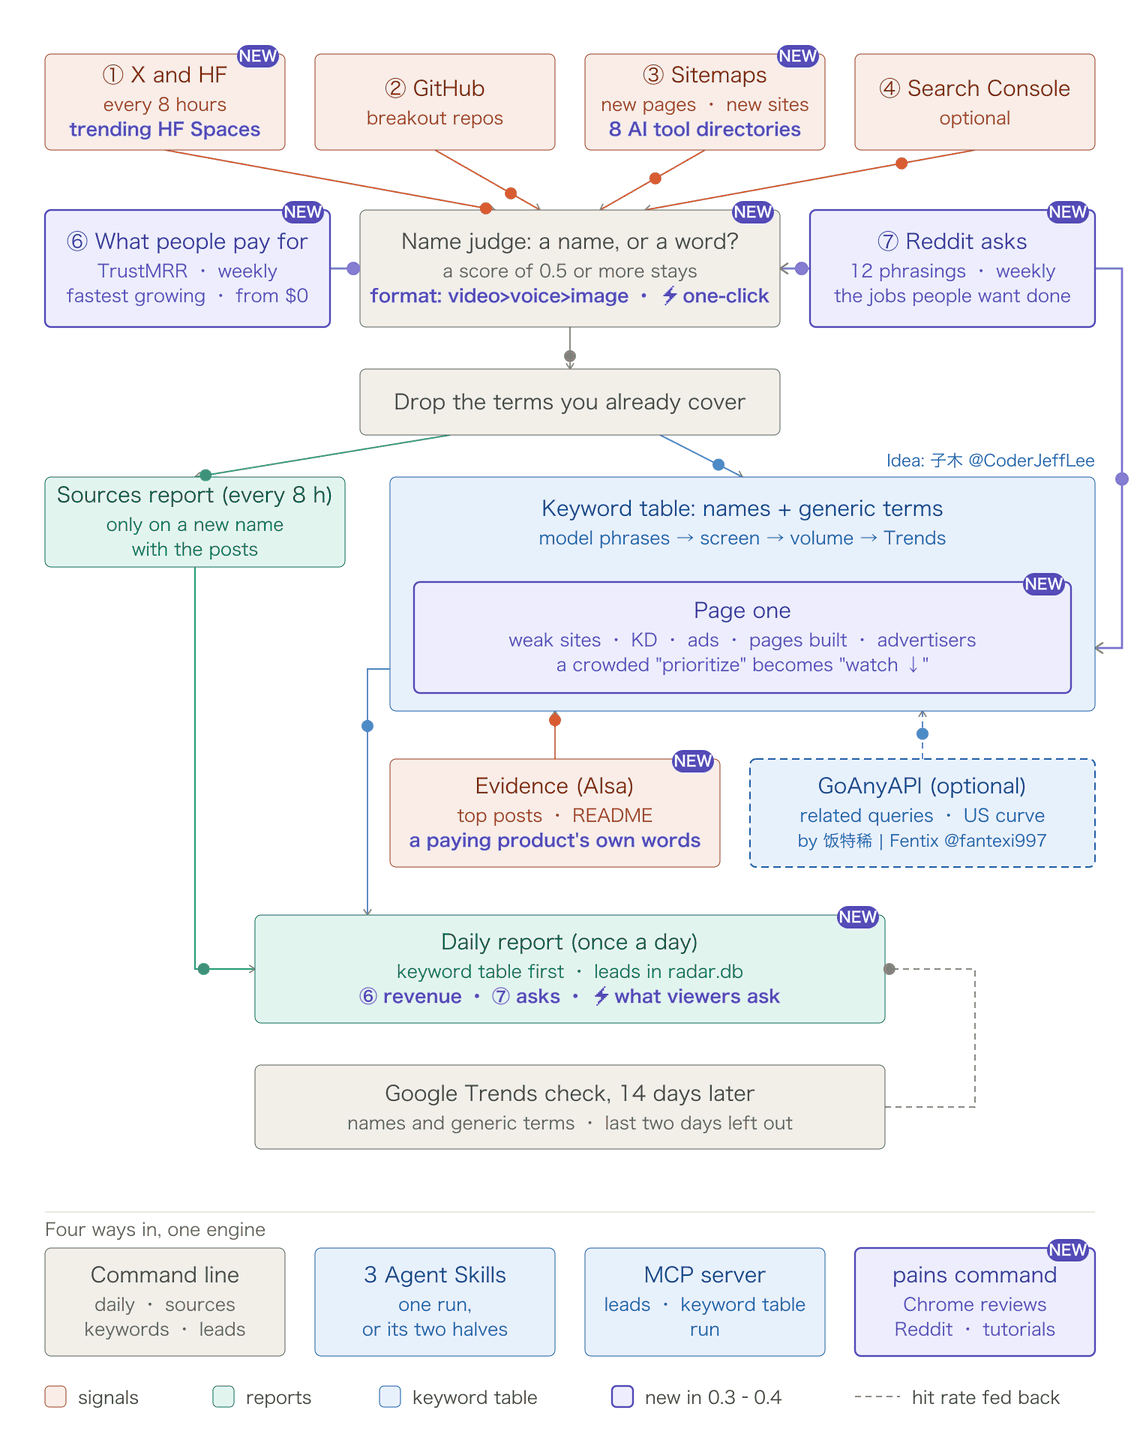
Roxo, marcado como NOVO: o que 0.3 e 0.4 adicionaram (⑥ receita, ⑦ perguntas do Reddit, a verificação da primeira página, o formato e as marcas ⚡, o comando pains).
| Sinal | O que captura | Precisa | Custo |
|---|---|---|---|
| ① X | Nomes que as contas da sua lista usaram pela primeira vez em 60 dias | Chave AIsa | $0,003 por conta por execução |
| ① Hugging Face | Modelos e Spaces (as demonstrações que as pessoas experimentam) novos no top 50 de tendências; cópias quantizadas e a demonstração do próprio modelo agrupadas sob o nome base | nada | grátis |
| ② GitHub breakout | Um repositório com menos de 14 dias com média de 200+ estrelas por dia, ou +400 desde ontem; adiciona as variantes de busca que as pessoas usam ("niko strata") | nada (um token do GitHub aumenta o limite de taxa) | grátis |
| ③ Sitemaps | Palavras que várias URLs novas em um site compartilham e que as URLs mais antigas raramente carregavam. A configuração de exemplo observa oito diretórios de ferramentas de IA (toolify, aixploria, ai-bot.cn, opentools, dang.ai, clipfly, aitoptools, futurepedia) e quatro diretórios de MCP e skills | os sitemaps que você lista | grátis |
| ③ Novos sites | Domínios registrados e indexados pela primeira vez nos últimos 90 dias que já ranqueiam para 20+ palavras-chave | Chave AIsa | cerca de $0,13 por consulta, semanal |
| ⑦ Perguntas | O que as pessoas pedem no Reddit ("existe uma ferramenta de IA que…", doze formulações): um modelo mantém os pedidos e reclamações que uma ferramenta de IA poderia responder e escreve cada tarefa como as pessoas buscariam; tarefas com buscas recebem a verificação da primeira página | Chave AIsa | cerca de $0,12 por semana |
| ⑥ Receita | Produtos pelos quais as pessoas pagam, da receita verificada do TrustMRR: os que crescem mais rápido ($500+ em 30 dias) e as listagens mais novas; um que estava em $0 da última vez e agora está gerando receita é destacado primeiro. Sua própria descrição vai para a tabela de palavras-chave como evidência | Chave TrustMRR | grátis, 6 solicitações, semanal |
| ④ Search Console | Consultas para as quais seu site recebeu impressões, pela primeira vez (dados novos) | seu próprio token do Google | grátis |
| ⑤ Revisão | Cada lead verificado no Google Trends 14 dias depois, contra sua própria linha de base; taxa de acerto e dias de antecedência por sinal | Chave AIsa | $0,0012 por variante de busca |
| Tabela de palavras-chave | Para os novos nomes do dia: os termos de busca genéricos por trás deles (o que as pessoas fazem com a coisa nova), cada um dimensionado, verificado quanto a espaço na primeira página e recebendo uma decisão | Chave AIsa; chave GoAnyAPI opcional | cerca de $0,18 por dia para 5 nomes, $0,30 com GoAnyAPI |
| Avaliador de nomes | Um modelo pequeno pontua cada termo: o nome de uma coisa específica ou uma palavra comum? | Chave AIsa | uma fração de centavo por execução |
Os preços são o que a AIsa cobrou em outubro de 2026. Com a configuração de exemplo (35 contas do X lidas três vezes ao dia, a tabela de palavras-chave para 5 nomes por dia), um mês custa cerca de $15: $10 para as leituras do X, $5 para a tabela de palavras-chave. Leia menos contas, ou leia uma vez por dia, e o custo cai proporcionalmente.
A tabela de palavras-chave
Um nome é metade do que você precisa. "SynthID Detector" tem vida curta como palavra-chave e pertence ao Google; a tarefa que ele faz, "ai image detector", é o que as pessoas continuam buscando, e ninguém a possui. Todos os dias o radar lê os novos nomes mais uma vez e escreve uma tabela com ambos:
| Keyword | Type | Behind | New? | Est. searches/day | Started rising | Peak vs gpts | Peak day | Last 7 days vs the 7 before | Now | Page one | Decision |
| **photocraft** 🖼 | name | — | yes | 12747 | 2026-10-05 | 97 vs 3.1 | 2026-10-09 | — | still rising | — | **prioritize** |
| **claude haiku 5.5** | name | — | yes | 1863 | 2026-10-07 | 100 vs 23.7 | 2026-10-08 | ×6.0 | still rising | — | **prioritize** |
| **ai image detector** 🖼 | generic | synthid detector | no | 2537 | — | 87 vs 31.6 | 2026-10-04 | ×1.2 | flat | — | watch |
| **photoshop alternative** ⚠ | generic | photocraft | no | 244 | — | 61 vs 61.7 | 2026-10-08 | ×1.8 | flat | — | skip |
(uma execução real, 2026-10-12, encurtada; a coluna Primeira página veio depois, veja abaixo)
Como é feita (radar/usecases.py):
- Evidência: os posts mais curtidos que mencionam o nome (busca avançada do X) e, para um repositório, seu README.
- Frases: um modelo lê a evidência e escreve a palavra-chave que uma pessoa comum digitaria para cada tarefa que vê pessoas fazendo, com uma citação que a sustenta. Uma frase construída sobre o nome de outro produto ("photoshop alternative") é mantida e marcada com ⚠: a demanda muitas vezes depende do incumbente, e usar a marca de alguém é sua decisão. Com uma chave GoAnyAPI (opcional, abaixo), o radar também capta as consultas relacionadas do Google Trends para o nome: o que as pessoas realmente buscaram junto com ele. Para SynthID Detector, isso deu "ai photo detector", "google ai detector" e "ai detector"; essas linhas carregam 🔎. Consultas que contêm o nome são listadas como suas caudas longas ("photocraft download", "nano banana 2.1 vs pro"). Consultas que são, elas mesmas, nomes de outras coisas em ascensão ("gpt image 2.5" ao lado de "nano banana 2.1") são mantidas como leads próprios.
- Triagem: uma segunda chamada pontua o quanto o nome responde a cada frase, marca marcas e identifica nomes de outras coisas; os fracamente relacionados são descartados. Para Claude Haiku 5.5, descartou todas as seis propostas ("ai coding assistant", "github copilot alternative"); para SynthID Detector, manteve todas as cinco.
- Volume: buscas mensais do Google Ads para o restante, uma chamada em lote. Frases abaixo de
min_volumesão descartadas; a maioria é. - Tendências, duas vezes por linha: o termo sozinho dá a forma (novo ou não, o dia em que começou a subir, o pico, a última semana contra a anterior, o que está fazendo agora); o termo ao lado de uma palavra-chave de referência (
gptspor padrão) dá o tamanho. - Primeira página, para as linhas que seriam acionadas (no máximo oito): a primeira página do Google (cerca de $0,002 por palavra-chave), a classificação de cada site nela (GoAnyAPI, $0,002 por site, mantido por 30 dias) e a dificuldade da palavra-chave ($0,012 por chamada). Com uma chave GoAnyAPI, também quem já constrói para o termo e quem paga por ele: as páginas que o Google mantém com ele no título do último mês (
pages built) e os domínios que veiculam anúncios do Google nele (advertisers, da transparência de Ads), $0,008 por linha.open= três ou mais dos dez resultados estão em sites avaliados abaixo de 30, ou dificuldade abaixo de 20;crowded= nenhum está e a dificuldade é 40 ou mais;mixedno meio. Abaixo da tabela, nomeia o site mais fraco na primeira página, onde uma nova página pode entrar, e que tipos de páginas a ocupam (ferramentas, listas, artigos, vídeos, fóruns). Anúncios na página significam que alguém paga por aquele clique.
Buscas por dia são estimativas. As de um termo genérico vêm do próprio volume do Google Ads, movidas para hoje ao longo da própria curva de Tendências. A referência é então dimensionada a partir desses termos, e um nome, que ainda não tem dados de volume, é dimensionado contra a referência.
Decisão: priorizar = subiu nos últimos 30 dias, ainda em alta, pelo menos min_daily buscas por dia. observar = subiu, mas menor, cedo demais para ler, ou estável com demanda constante desse tamanho. pular = em queda, ou estável e pequeno. Um prioritize cuja primeira página é crowded torna-se watch ↓: ainda subindo, mas a primeira página pertence a sites fortes. Na primeira semana de um nome, a primeira página ainda está se formando (notícias, as próprias páginas do criador); a segunda leitura, três dias depois, é a que deve ser confiável.
Marcas: 🎬 vídeo, 🎙 voz, 🖼 imagem diz o que a coisa faz, a ordem usual do que os visitantes pagam (vídeo > voz > imagem > texto); leads de igual destaque são ordenados por isso. ⚡ = um post com 1.000 ou mais curtidas percorre um fluxo de trabalho manual ou segue uma tendência: uma ferramenta de um clique que ninguém construiu ainda. Ambas vêm de regras de palavras-chave sobre as próprias palavras e posts do lead; em seis nomes conhecidos (Nano Banana, Veo 3.1, Seedance 2.5, Claude Opus 5.5, ElevenLabs v4, Qwen Image 2.1), o formato saiu certo para todos os seis e ⚡ disparou uma vez, em um tutorial amplamente compartilhado de Opus 5.5 + Blender + Unreal. Leia os posts antes de agir com base em uma marca.
Cada nome é lido duas vezes, no dia em que aparece e três dias depois, porque no dia do anúncio os posts são anúncios e nenhum uso aparece ainda. Os termos genéricos são mantidos como leads e revisados após 14 dias, como os nomes.
O que esperar dele, dos primeiros oito nomes em que o testamos:
- Os nomes subiram; a maioria dos termos genéricos não, dentro de cinco dias. PhotoCraft, Claude Haiku 5.5 e SynthID Detector todos subiram claramente. Dos termos genéricos por trás deles, um se moveu: "photoshop alternative" ficou cerca de 80% acima do seu nível nos EUA por cinco dias após o PhotoCraft aparecer. A série diária mundial que a tabela lê quase não mostrou nada disso (2, 1, 1, 2, 4, 2); uma série diária dos EUA de outra fonte mostrou claramente. Portanto, uma leitura estável da série mundial não prova que um termo não se moveu. Com uma chave GoAnyAPI, as linhas maiores são lidas da série de um único país, onde uma alta é 1,5 vezes o nível anterior mantido por três dias; a mesma execução então mostra "photoshop alternative" como
still rising (US). - O uso confiável da tabela hoje é dizer qual demanda existente uma coisa nova atende e quão grande ela é ("ai image detector", cerca de 2.500 buscas por dia). Se os termos genéricos seguem os nomes é o que a revisão de 14 dias mostrará, e ainda não temos resultado.
- Para lançamentos puros de modelos (Claude Haiku 5.5, Nano Banana 2.1), a evidência eram anúncios e benchmarks, e as frases propostas eram fracas ("ai coding assistant"). Funciona melhor para produtos e repositórios que fazem um trabalho específico.
- Os últimos dois dias do Google Trends não são definitivos. Para termos não relacionados, voltaram como 0 e depois 100, o que parece um pico. Nosso primeiro passe foi enganado exatamente por isso; todo leitor no código agora descarta esses dois dias, e uma alta deve durar dois dias para contar.
- Os volumes do Google Ads ficam cerca de dois meses atrasados. O Trends não lê nada confiável para termos abaixo de algumas centenas de buscas por mês.
Quando uma fonte está ausente ou fora do ar
A tabela ainda é escrita, mas fica mais fina, e diz qual parte está faltando:
| O que acontece | O que a tabela perde | A linha que imprime |
|---|---|---|
Sem GOANYAPI_API_KEY (o padrão) | As linhas 🔎, as caudas longas de cada nome, os outros nomes buscados junto e as leituras (US). As frases vêm apenas do modelo e toda curva da série mundial, onde um movimento real pode parecer estável | "Related queries are off: set GOANYAPI_API_KEY…" |
| O Trends do GoAnyAPI está fora do ar (visto no seu primeiro dia de uso, 2026-10-12) | O mesmo que não ter chave, para aquela execução | "Related queries failed for: …" e "Country series failed, worldwide data used instead: …" |
| A busca de posts da AIsa falha para um nome (timeouts vistos duas vezes em 2026-10-13) | Os posts daquele nome. Um repositório ainda tem seu README; um modelo ou produto sem um fica apenas com as consultas relacionadas, e sem chave GoAnyAPI não recebe termos genéricos naquele dia | "The post search failed; this run used READMEs and related queries only: …" |
| Nem posts nem README para um nome | Seus termos genéricos; a linha do próprio nome permanece | "No posts or README found for: …" |
| Nenhum lead naquele dia é uma coisa com pontuação de nome de 0,8 ou mais | A tabela inteira | "Nothing to read today…" |
| A busca de volume ou de Tendências da AIsa falha | A tabela inteira: essas duas não são substituíveis | o erro, no lugar da tabela |
Uma tabela fina não é um dia tranquilo. Leia as linhas abaixo dela antes de concluir que nada se moveu.
Defina "usecases": {"per_day": 0} ou passe --skip usecases para desativá-la.
⑥ Receita: o que as pessoas já pagam
Um produto que gera dinheiro prova a demanda por trás dele. Com TRUSTMRR_API_KEY definido (no painel de desenvolvedor da TrustMRR), o radar lê uma vez por semana (revenue.weekday, segunda-feira por padrão) os 30 produtos de crescimento mais rápido com pelo menos min_revenue_usd ($500) nos últimos 30 dias e as 30 listagens mais recentes, e guarda o que viu. As listagens mais recentes quase não ganham nada ainda; elas são lidas para registrar onde começam, então um produto que estava em $0 na última vez e agora passa do piso é destacado primeiro. Listagens ocultas ("Anonymous startup") são deixadas de fora, e o nome legal de uma empresa dá lugar ao nome do site ("Talent Tech Global Limited" é lido como gptproto). A descrição de cada produto vai para a tabela de palavras-chave como evidência, então a tabela lê o trabalho pelo qual as pessoas pagam, não apenas a marca. Crescimento acima de 1.000% é lido como "subiu de quase $0": na primeira execução, a maioria dos que mais cresceram tinha começado de quase nada.
Os termos da API da TrustMRR proíbem republicar seus dados e construir páginas públicas de SEO a partir deles. Use os leads para sua própria pesquisa; não publique a lista.
⑦ Pedidos: demanda dita em voz alta
Uma vez por semana, o radar busca no Reddit uma dúzia de maneiras como as pessoas pedem uma ferramenta ("existe uma ferramenta de IA", "queria que existisse uma ferramenta", "como automatizo", em asks.patterns), mantém os posts da última semana com pontuação 2 ou mais, e um modelo pequeno os classifica: um pedido, uma reclamação, uma solução compartilhada ou outro. Para pedidos e reclamações que uma ferramenta de IA poderia atender, ele escreve o trabalho como uma pessoa buscaria ("adicionar b roll automaticamente", "converter slides em notas"). Trabalhos com pelo menos 50 buscas por mês são listados com seus posts e passam pela verificação da primeira página; cada um vira um lead. A maioria dos pedidos é específica demais para já ter buscas: na primeira semana real, 84 posts continham 43 pedidos e apenas dois tinham 50 buscas por mês ("melhor ferramenta de IA para pesquisa", de um tópico r/PhD com 1.034 pontos, e "melhor ferramenta de IA para codificação"). Então os outros com melhor pontuação também são listados, como ideias em vez de palavras-chave. Um mês de posts lidos em um teste continha um pedido por "uma ferramenta de IA para converter slides de PowerPoint em notas", o mesmo trabalho que um curso de ferramentas usa como exemplo prático.
Os posts são para sua própria pesquisa: cite-os, não os republique.
⚡ O que os espectadores de tutoriais pedem
Para até três leads por dia marcados com ⚡ (um tutorial amplamente compartilhado de um fluxo de trabalho manual), o radar encontra os principais vídeos de tutorial para o lead (GoAnyAPI), lê os comentários (AIsa, $0,001 por página) e faz o modelo extrair o que os espectadores pedem: os passos que acham difíceis, o "isso pode ser feito em um clique". Essa lista é a ferramenta de um clique. Precisa de uma chave GoAnyAPI para encontrar os vídeos.
Pontos de dor: python -m radar pains "ai headshot"
O que as pessoas reclamam sobre um tipo de ferramenta, agrupado nas lacunas que uma nova ferramenta pode preencher:
- avaliações com poucas estrelas na Chrome Web Store (1 a 3 estrelas) das extensões que o Google mostra para a palavra-chave, ou das que você nomeia com
--extension ID(GoAnyAPI: 2 créditos para encontrá-las, 3 por página de avaliações); - posts no Reddit que reclamam do trabalho ou das ferramentas ("{palavra-chave} alternativa", "{palavra-chave} frustrante", ...; AIsa);
- comentários sob os principais vídeos de tutorial para a palavra-chave (AIsa).
Um modelo os agrupa em lacunas (falta, difícil demais, qualidade, preço, quer uma ferramenta), cada uma com uma contagem, um exemplo e a frase que alguém com esse problema buscaria. Cerca de $0,05 por palavra-chave. As contagens são do que foi lido, não do mercado.
O que não consegue ler: avaliações da App Store, Google Play e Trustpilot (DataForSEO as serve como tarefas para postar e buscar depois, e AIsa executa apenas chamadas síncronas); o quadro de pedidos do There's An AI For That (um desafio Cloudflare na frente de cada página; passar por ele seria passar pela proteção contra bots deles, então o radar não faz); grupos do Facebook (a Meta fechou a API de Grupos em abril de 2024, e sua biblioteca de pesquisa é aberta apenas para pesquisadores acadêmicos e sem fins lucrativos aprovados).
Uma chave, e uma segunda opcional
Tudo o que o radar precisa passa pelo AIsa: posts do X, Google Trends e dados de domínio (DataForSEO por trás) e os modelos que julgam nomes e propõem frases. Uma chave, pague por chamada, sem assinaturas da API do X ou DataForSEO.
Esse link é um link de referência: cadastrar-se por ele apoia este projeto. O radar funciona igual com uma chave de qualquer lugar em aisa.one.
Opcional: GOANYAPI_API_KEY (goanyapi.com) melhora a tabela de palavras-chave de duas maneiras, por cerca de $0,07 por dia: adiciona as consultas relacionadas do Google Trends para cada nome e lê a curva dos nomes e dos termos genéricos maiores (1.000 buscas por mês ou mais, no máximo oito linhas) a partir de 30 dias de dados diários para um país, consolidados até ontem. Essas linhas mostram o país depois de "Agora", como em still rising (US). Sem a chave, a tabela é construída apenas com as frases do modelo e a série mundial. O serviço é novo (primeiro lançamento em agosto de 2026); em nossos testes, as chamadas levaram de 20 a 55 segundos e cerca de uma em dez falhou, então o radar tenta duas vezes, reporta uma falha na tabela e segue em frente. Esse link também é um link de referência.
Sem uma chave AIsa, os sinais gratuitos ainda funcionam (Hugging Face, GitHub, sitemaps, Search Console); o relatório então lista cada termo sem ordenação, porque nada julga quais são nomes.
Início rápido
Python 3.10 ou mais novo. O radar usa apenas a biblioteca padrão.
git clone https://github.com/zhuyansen/new-term-radar
cd new-term-radar
cp config.example.json config.json      # then edit: your X accounts, sitemaps, topics
export AISA_API_KEY=...                 # from https://go.aisa.one/yansen-zhu; or `aisa login` with the AIsa CLI
python -m radar daily --out report.md
A primeira execução constrói seus instantâneos: o vocabulário de ontem do X, contagens de estrelas e URLs de sitemap ainda não existem, então apenas os destaques do GitHub (que não precisam de ontem) são reportados. A partir da segunda execução, cada sinal reporta o que mudou.
Dois comandos:
python -m radar sources --out sources.md           # ① only: X and Hugging Face. Run every few hours.
python -m radar daily --skip x,hf --out report.md  # everything else, once a day
sources escreve um relatório apenas quando há um nome novo. daily com --skip x,hf lista o que sources guardou nas últimas 24 horas. Se você executar apenas uma vez por dia, use python -m radar daily e não pule nada.
Outras flags: --skip aceita qualquer um de x,hf,breakout,sitemaps,newsites,gsc,review,judge,usecases; --new-sites executa o sinal semanal hoje; --mail envia o relatório (abaixo); --state DIR move o banco de dados e os instantâneos.
Como é um relatório
De uma execução real em 2026-10-12 (resumido):
### Candidate new terms (names first; terms you already cover are marked)

| Term | Signals | Name score | Known | Search variants | Examples |
| **gridcraft** | GitHub breakout storytold/gridcraft ★3178 (626/day) | 0.95 | none | storytold gridcraft | GridCraft: an open-source, cl… |
| **artex** | GitHub breakout mhtsec/ARTEX ★3353 (825/day) | 0.85 | none | mhtsec artex, mht artex | AI 自主渗透测试系统 … |

Other rising terms (judged common words): anatomy, math, iphone use

### ⑤ Review (terms reported 14 days ago: did they rise in Google Trends?)

| Term | First reported | Verdict | Days ahead |
| strata | 2026-09-25 | hit | 3 |
e de sources:
| **qwen image 2.1** | Hugging Face: new at #4, 2 versions | 1.00 | none | Qwen/Qwen-Image-2.1-Turbo (text-to-image, ♥569) |
| **ltx 2.5** | Hugging Face: new at #6 | 0.90 | none | Lightricks/LTX-2.5 (image-to-video, ♥7347) |
daily também escreve report.json ao lado do Markdown, com tudo o que o relatório foi construído.
config.json
| Chave | O que é |
|---|---|
lang | "en" ou "zh": o idioma do relatório |
x_accounts | labs e bloggers: contas do X para ler. Os laboratórios dizem nomes primeiro; escolha os blogueiros por onde os novos termos do seu campo se espalham |
sitemaps | Sites cujas novas páginas você quer ver. index é um sitemap, ou um índice de sitemap quando shards (uma regex) escolhe quais sub-sitemaps ler. pause são os segundos entre requisições para esse site. strip_locale remove /en/, /zh-CN/ prefixos para que uma entrada em vários idiomas conte uma vez |
topics | Nome e regex: cada tópico ganha sua própria seção listando os leads, repositórios e consultas que correspondem |
known_terms | Termos para os quais você já tem uma página, ou que nunca quer reportados. Um lead que contém um, ou está contido em um, é marcado e não é mantido para revisão |
stop_words | Palavras do dia a dia do seu campo, adicionadas à lista embutida (que é ajustada para ferramentas de IA) |
judge | model (qualquer modelo de chat no AIsa) e min_score (0,5) |
breakout | window_days, min_stars, velocity_min (estrelas por dia), delta_min (estrelas desde ontem) |
new_sites | queries: um nome e um padrão SQL LIKE no domínio ("%ai%"), uma consulta paga cada; weekday (0 = segunda-feira) |
review | after_days (14) e per_day (5 leads por dia) |
usecases | A tabela de palavras-chave. per_day (nomes lidos por dia, 0 = desligado), model, benchmark (os tamanhos das palavras-chave são comparados com), min_volume (buscas mensais que uma frase precisa), min_daily (buscas por dia para "priorizar"), recheck_days (3), related (usar consultas relacionadas quando GOANYAPI_API_KEY estiver definido), related_geo (US), country_trends (ler as curvas das linhas maiores desse país), country_min_volume (1000) e country_max (8) |
gsc | site (sc-domain:example.com) e token_file. Deixe {} para desligar o sinal |
Por favor, leia o robots.txt de cada site antes de adicionar seu sitemap e mantenha pause igual ou acima do crawl-delay dele. O config de exemplo faz algumas dezenas de requisições por dia no total, espaçadas por pause.
Search Console (opcional)
pip install google-auth-oauthlib
python scripts/gsc_auth.py gsc_client.json   # opens a browser once, writes gsc_token.json
gsc_client.json é um cliente OAuth do tipo "Desktop app" do Google Cloud Console, em um projeto com a API do Search Console ativada. Depois defina "gsc": {"site": "sc-domain:your-site.com"}. O token é somente leitura e fica na sua máquina; .gitignore já o lista.
E-mail (opcional)
--mail envia o relatório pelo Resend. Defina RESEND_API_KEY, EMAIL_FROM (um endereço em um domínio que você verificou lá) e RADAR_EMAIL_TO (separados por vírgula). pip install markdown para a versão em HTML.
Use com um agente: skills e um servidor MCP
Skills
Três Agent Skills ficam em skills/: uma que faz o trabalho completo e as duas metades para quem quer separadas.
| Skill | O que faz |
|---|---|
new-term-radar | A execução completa: os novos nomes de hoje, depois a tabela de prioridade de palavras-chave para eles. Também aceita nomes que você já tem. Comece aqui |
ai-listening | Coleta o que é novo nas últimas 24 horas entre os sinais, deduplicado, como um relatório de nomes |
seo-new-keywords-research | Aceita nomes, ou texto bruto que os menciona, e retorna a tabela de prioridade de palavras-chave: os termos genéricos por trás de cada nome, filtrados, dimensionados e com uma decisão |
npx skills add zhuyansen/new-term-radar
No Claude Code, as três skills também instalam como um plugin:
/plugin marketplace add zhuyansen/new-term-radar
/plugin install new-term-radar@new-term-radar
Então peça ao seu agente por "novas palavras-chave de IA de hoje", "um relatório de escuta de IA" ou "pesquisa de palavras-chave sobre PhotoCraft e SynthID Detector". As skills clonam este repositório para ~/new-term-radar se não estiver lá, informam o custo antes de qualquer execução paga e avisam quando uma tabela está incompleta.
Servidor MCP
Para clientes que falam MCP (Claude Code, Cursor, Claude Desktop):
pip install "new-term-radar[mcp]"
{
  "mcpServers": {
    "new-term-radar": {
      "command": "new-term-radar-mcp",
      "env": {
        "AISA_API_KEY": "...",
        "RADAR_CONFIG": "/absolute/path/to/config.json",
        "RADAR_STATE": "/absolute/path/to/state"
      }
    }
  }
}
| Ferramenta | O que retorna | Custo e tempo |
|---|---|---|
recent_leads | O que o radar guardou, com vereditos de revisão e a taxa de acerto por sinal | grátis, instantâneo |
keyword_table | A tabela de palavras-chave para nomes que você fornece | cerca de $0,05 por nome mais $0,09 por chamada; 40 a 90 segundos por nome |
run_radar | Uma execução de sources ou daily e seu relatório | pago; minutos. Para uma primeira tentativa: a agenda pertence ao cron ou Actions |
Aponte RADAR_STATE para o diretório onde suas execuções agendadas escrevem e recent_leads mostra os leads delas. Os mesmos dois comandos existem na linha de comando: python -m radar keywords "name" … e python -m radar leads.
Execute no GitHub Actions
.github/workflows/radar.yml executa sources a cada 8 horas e daily uma vez por dia, mantém o estado no cache do Actions e escreve cada relatório no resumo da execução. Está desligado até você optar por ativar:
- Faça um fork do repositório (um fork privado é aceitável).
- Remova
config.jsonde.gitignoree faça commit do seu config. Ele não contém segredos. - Adicione o segredo
AISA_API_KEY; opcionalmenteGOANYAPI_API_KEY,RESEND_API_KEY,EMAIL_FROM,RADAR_EMAIL_TO,GSC_TOKEN_JSON. - Defina a variável do repositório
RADAR_ENABLEDparatrue.
Como as partes decidem
- Nomes em postagens (
radar/terms.py): palavras capitalizadas, palavras com dígito (Qwen3.8) ou maiúsculas internas (HyperFrames); um número após um nome se junta a ele (Opus 5.5). Um nome usado por duas contas conta; um nome usado por uma conta precisa de 100 curtidas e deve ser inconfundivelmente um nome, já que uma palavra capitalizada costuma ser apenas o início de uma frase. - Picos em sitemaps: contados por URL distinta em relação à linha de base do próprio site, então uma página com um slug longo não pode simular uma onda.
- O avaliador (
radar/judge.py): uma chamada de chat por 25 termos, cada um com até três locais onde apareceu. Se a chamada falhar, o relatório ainda é enviado, sem ordenação. - A revisão (
radar/review.py): uma variante "subiu" quando seu pico após o dia em que a reportamos supera sua própria linha de base anterior em 2x e em 10 pontos. Uma palavra com significado mais antigo ("strata": camadas de rocha, direito imobiliário) tem uma linha de base alta e não conta; "niko1221 strata" indo de 0 para algo conta. Os últimos dois dias instáveis das tendências são deixados de fora.
O que medimos, e o que ainda não medimos
- O avaliador de nomes (
gpt-4.1-mini) foi executado em 170 termos que um avaliador anterior havia aprovado como nomes em nosso uso diário. Ele concordou em 149. Dos 21 que rejeitou, a maioria era ruído que o avaliador anterior deixou passar (fragmentos de caminho de sitemap comoio.github.wxt invoice,asd); cerca de três eram nomes reais que ele perdeu (synthid detector,veo,v4.1 flash), em um teste que lhe deu menos contexto do que uma execução real. Ele não aprovou nenhuma das 40 palavras comuns (dashboard,pricing,today). - Taxas de acerto por sinal: ainda não. A revisão precisa de 14 dias por lead e a nossa apenas começou. A única verificação semeada, Strata, voltou como acerto, três dias antes do pico nas Trends. Seu próprio relatório mostra seus números conforme acumulam; trate qualquer sinal como não comprovado até então.
- O sinal X é tão bom quanto a lista de contas. Ele não verá um nome que nenhuma de suas contas menciona.
Problemas conhecidos
- Novos sites (2026-10-12): a validação da AIsa para
post_dataforseo_domains_whois_overview_liveatualmente rejeita o formato de filtro que a DataForSEO exige, então este sinal reporta um erro e o restante do relatório não é afetado. Funcionou até 2026-10-06. Use--skip newsitespara silenciá-lo até que seja corrigido upstream. - As stop words integradas e a limpeza de nomes do Hugging Face são ajustadas para modelos de IA e ferramentas de agentes. Para outro campo, adicione
stop_words. - Os volumes de pesquisa não estão no relatório. O radar informa que um nome é novo; verifique o volume e os principais resultados antes de criar uma página para ele.
Desenvolvimento
pip install pytest markdown
python -m pytest -q tests
Os testes cobrem a lógica (extração de nomes, pontuação, o armazenamento, os relatórios) e não fazem chamadas de rede.
Agradecimentos
- 子木 @CoderJeffLee pela ideia por trás da tabela de palavras-chave: um novo nome e os termos genéricos a jusante dele pertencem a uma única tabela, cada um com uma decisão.
- 饭特稀 | Fentix @fantexi997 pelo GoAnyAPI, a fonte opcional de consultas relacionadas e séries de Trends de um país.
O diagrama é desenhado por docs/make_diagram.py (precisa de rsvg-convert e ffmpeg).
Licença
MIT. Extraído do radar que roda diariamente por trás de agentskillshub.top.