LLM Usage & Cost Tracker
Um medidor de custos local e multi-provedor para uso de LLM, exposto como ferramentas MCP. Captura cada chamada em um registro local SQLite e permite que qualquer agente de codificação consulte gastos, compare provedores e obtenha recomendações — sem nuvem, sem conta. Suporte de primeira classe para provedores chineses (Qwen, DeepSeek) junto com Anthropic e OpenAI.
Documentação
llm-usage-mcp
LLM Usage & Cost Tracker — seu vigia de gastos local-first


English | 中文
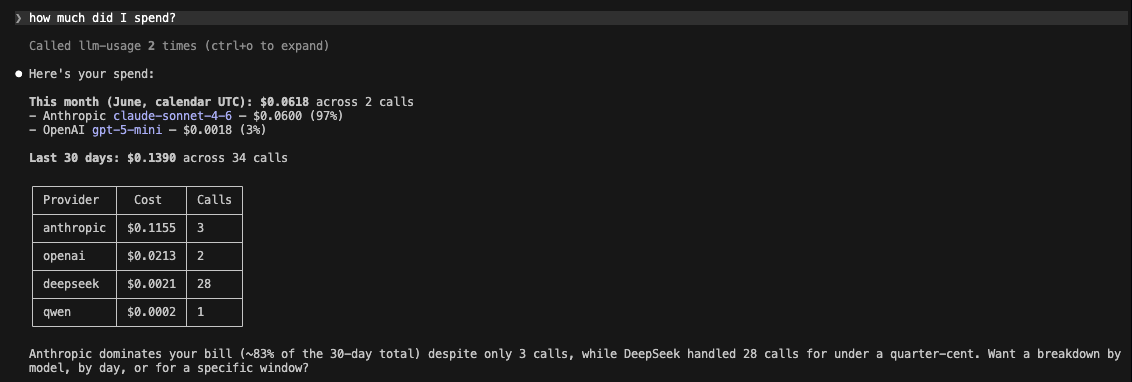
Pare de tratar suas contas de API de LLM como um filme de terror que você só olha pelos dedos no fim do mês. Saiba quanto suas chamadas de LLM realmente custam — em todos os provedores, em um só lugar, na sua própria máquina. Pergunte ao seu agente de codificação (MCP) ou digite um comando (CLI).
É um medidor de custo, não um roteador: ele informa o que você gastou e qual provedor se encaixa em uma carga de trabalho — nunca altera suas chamadas. Funciona bem ao lado de um roteador ou de uma ferramenta de ranking de modelos.
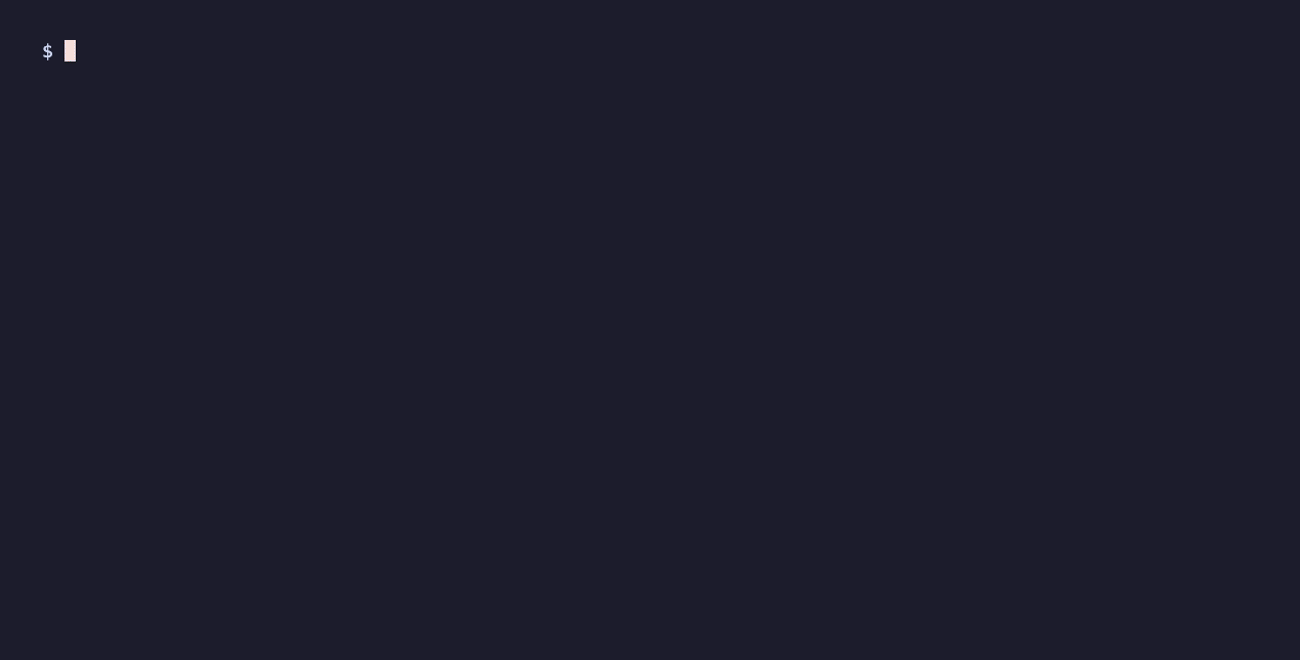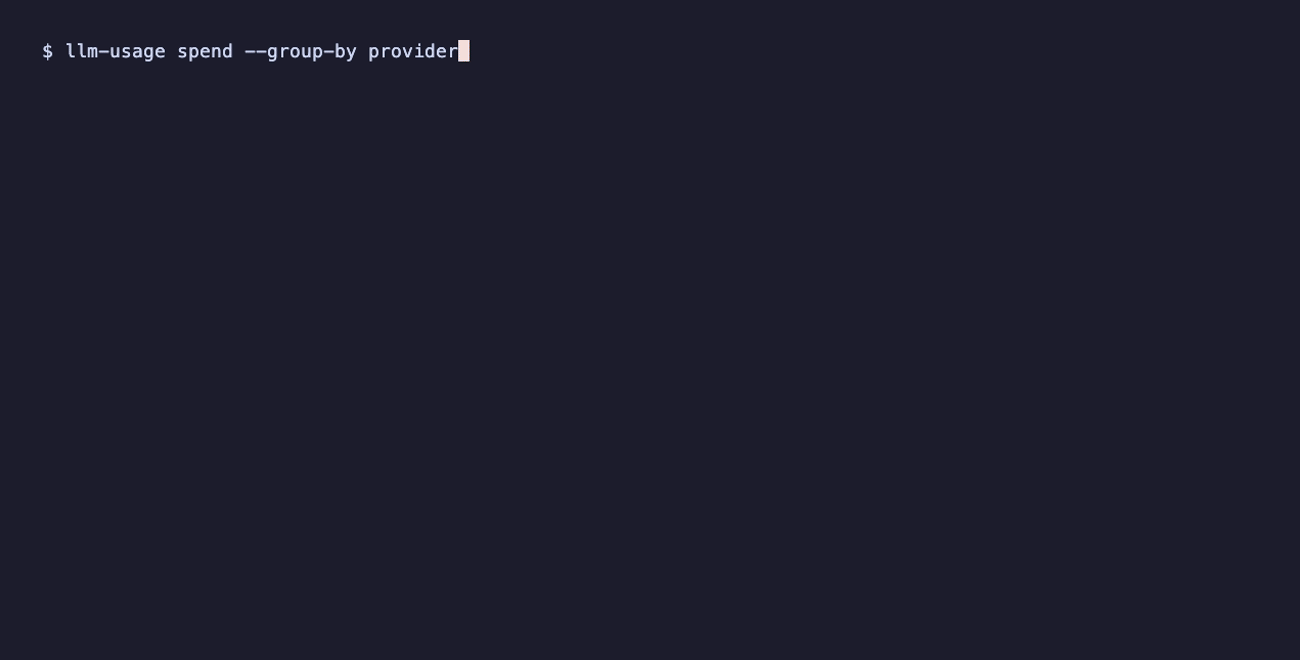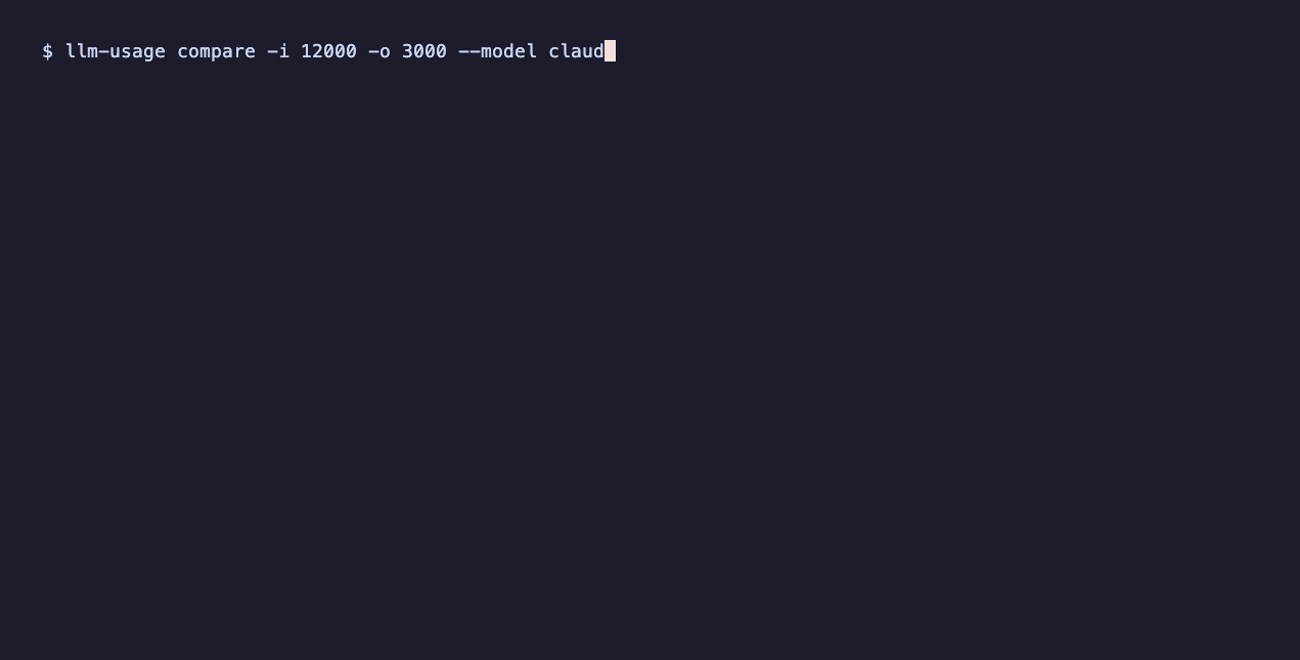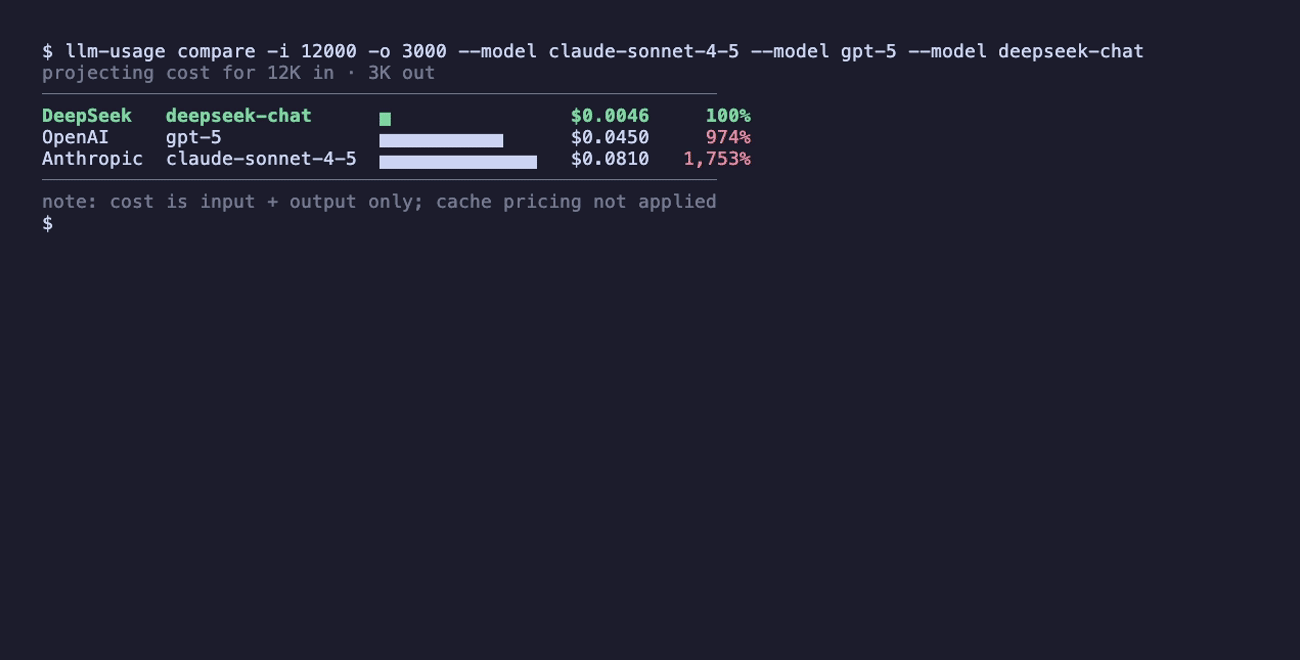
Ou direto do terminal — seus gastos da semana, detalhados por provedor, e uma comparação de custos entre provedores antes de você se comprometer com um modelo:
Por que você vai querer isso
Você está chamando LLMs de vários provedores — Claude, GPT, além de modelos chineses como Qwen e DeepSeek. Cada um cobra no seu próprio painel, na sua própria moeda, com suas próprias regras para o que custa um "token em cache". Então a pergunta mais simples — quanto estou gastando, e com quê? — vira quatro logins no navegador, consulta de taxas de câmbio de RMB para USD, e tentar decifrar o que um "desconto de token de contexto em cache" realmente significa em matemática de madrugada. A maioria das pessoas cruza os dedos e deixa a conta ser uma surpresa no fim do mês.
llm-usage-mcp captura cada chamada que você faz em um armazenamento local, calcula o custo corretamente por provedor no momento em que acontece, e devolve a resposta de duas maneiras:
- Pergunte ao seu agente de codificação. É um servidor MCP, então Claude Code, Cursor ou qualquer cliente MCP pode responder "quanto gastei com Claude esta semana?" ou "qual provedor é mais barato para uma chamada de 10k de entrada / 2k de saída?" em inglês simples.
- Ou digite um comando. Também é uma CLI —
llm-usage spend,llm-usage compare,llm-usage recommend— para quando você prefere não fazer uma ida e volta por um agente.
E ele não atrapalha:
- Local-first. Sem SaaS, sem cadastro, sem telemetria. Apenas um arquivo SQLite em
~/.llm-usage/usage.db. Privacidade é um recurso, não uma configuração. - Multiproveedor, com modelos chineses incluídos. Anthropic, OpenAI, DeepSeek, Qwen — streaming e não-streaming para todos os quatro. DeepSeek e Qwen usam o mesmo caminho de captura que Anthropic e OpenAI, não um complemento improvisado. Mais provedores (Gemini, Bedrock, Moonshot, …) estão a caminho.
Início rápido
Dois minutos de git clone até sua primeira chamada capturada. Esta parte é sobre captura — registrar chamadas. Ler os dados de volta vem em seguida.
1. Instalar
Instale a partir do PyPI com uv (ou pipx) — isso coloca os três scripts de console no seu PATH:
uv tool install llm-usage-mcp # or: pipx install llm-usage-mcp
Prefere mexer no código? Clone e sincronize a partir da fonte:
git clone https://github.com/zhaoyue722/llm-usage-mcp.git
cd llm-usage-mcp
uv sync
De qualquer forma, você obtém três scripts de console:
llm-usage— a CLI de múltiplos comandos. Veja Da linha de comando (CLI) abaixo.llm-usage-mcp— o servidor MCP stdio.llm-usage-proxy— um alias de compatibilidade; idêntico allm-usage proxy.
O Início rápido abaixo usa
uv run …(o fluxo a partir da fonte). Se você instalou via PyPI, os scripts já estão no seuPATH— remova o prefixouv rune registre o servidor MCP comclaude mcp add llm-usage -- llm-usage-mcp.
2. Defina pelo menos uma chave de API
Você só precisa de uma chave para o(s) provedor(es) que realmente usa; o proxy inicia independentemente e as requisições por rota retornam 503 configuration_error para qualquer provedor cuja chave esteja ausente.
export ANTHROPIC_API_KEY=sk-ant-...
# and/or:
export OPENAI_API_KEY=sk-...
export DEEPSEEK_API_KEY=sk-...
export DASHSCOPE_API_KEY=sk-...   # Qwen
Referência completa de variáveis de ambiente: docs/configuration.md (ou copie .env.example para .env e preencha).
3. Execute o proxy de captura
uv run llm-usage-proxy
Ele vincula somente loopback (127.0.0.1:5525) — nunca acessível pela rede. O proxy guarda suas chaves de API no lado do servidor; os clientes nunca precisam delas.
4. Aponte seu agente de codificação para o proxy
O proxy expõe uma rota por provedor. Defina a variável de ambiente *_BASE_URL correspondente no lado do cliente:
| Provedor | Variável de ambiente do cliente | Valor |
|---|---|---|
| Anthropic | ANTHROPIC_BASE_URL | http://127.0.0.1:5525 |
| OpenAI | OPENAI_BASE_URL | http://127.0.0.1:5525/openai/v1 |
| DeepSeek | DEEPSEEK_BASE_URL (ou qualquer substituição de base-url do SDK OpenAI) | http://127.0.0.1:5525/deepseek/v1 |
| Qwen | Base compatível com OpenAI do DashScope | http://127.0.0.1:5525/qwen/v1 |
Exemplo — inicie o Claude Code com chamadas roteadas pelo proxy:
ANTHROPIC_BASE_URL=http://127.0.0.1:5525 claude
5. Confirme que está capturando
Faça uma chamada pelo seu agente (ou qualquer cliente apontado para o proxy) e verifique se ela foi registrada:
uv run llm-usage spend
Cada chamada cai em ~/.llm-usage/usage.db com tokens, custo, latência e um request_id para idempotência — e aparece nesse resumo. Esse é o ciclo completo: captura de um lado, respostas do outro.
Consultando seus gastos
Depois que as chamadas estão sendo capturadas, você as lê de duas maneiras. Mesmos dados, mesmos números — escolha a que se encaixa no momento.
Pergunte ao seu agente de codificação (MCP)
Registre o servidor MCP com o Claude Code:
claude mcp add llm-usage -- uv --directory $(pwd) run llm-usage-mcp
Depois é só perguntar, em inglês simples, dentro dessa sessão:
Quanto gastei com Anthropic hoje? Qual provedor é mais barato para uma chamada de 10k de entrada / 2k de saída?
O Claude escolhe a ferramenta certa e lê os números de volta. Sete ferramentas são expostas via stdio; as formas completas de parâmetros/retornos estão em docs/spec.md.
| Ferramenta | Propósito |
|---|---|
query_spend | Totais + agrupamentos por grupo em uma janela de tempo (agrupar por provedor / modelo / projeto / tag / dia). |
usage_summary | Resumo principal para today / week / month / year — totais, top-N provedores + modelos, maior chamada. |
compare_providers | Dada uma carga de trabalho hipotética (tokens de entrada / saída), classifica todos os modelos precificados por custo. |
recommend_provider | Escolhe o modelo precificado mais barato que se encaixa em um orçamento declarado. |
get_pricing | Inspeciona o snapshot de preços embutido. |
list_providers | Lista provedores + seus modelos + flag de compatibilidade com OpenAI. |
record_usage | Caminho de escrita manual — registra uma chamada quando o proxy de captura não está em cena. |
query_spend e usage_summary usam como padrão include_failed=false para que linhas de stream parcial não poluam os totais; opte por incluir via parâmetro.
Da linha de comando (CLI)
As mesmas perguntas, como CLI — oito subcomandos sob um console llm-usage, para quando digitar é mais rápido do que perguntar ao seu agente.
Os exemplos abaixo assumem que
llm-usageestá no seuPATH— sejasource .venv/bin/activateouuv tool install .. Caso contrário, prefixe cada comando comuv run(ex.:uv run llm-usage spend).
$ llm-usage
 Local-first LLM spend capture + query, exposed over MCP.

 Commands
   proxy      Run the local LLM capture proxy on 127.0.0.1.
   compare    Project the cost of a hypothetical workload across every priced model.
   models     Browse the local pricing catalog.
   recommend  Recommend the cheapest priced model for a workload + budget.
   spend      Show recorded spend over a calendar period.
   status     Snapshot of the local install: DB, proxy, providers, pricing.
   providers  List configured providers with key state, wire-format, model count.
   about      Show version, author, license, and the project homepage.
| Comando | A pergunta que ele responde |
|---|---|
compare | Dada uma carga de trabalho, quem é mais barato? |
models | O que eles realmente cobram por milhão de tokens? |
recommend | Tenho $0,04 sobrando — qual modelo não vai me falir? |
spend | Quanto acabei de gastar? |
status | Está tudo realmente funcionando? |
providers | O que está configurado localmente? |
about | O que é isso e onde reporto um bug? |
proxy | Executa o proxy de captura (igual a llm-usage-proxy). |
Convenções que valem para todos os comandos:
--jsonemite a mesma forma Pydantic que a ferramenta MCP correspondente retorna. Envie direto parajq.--color {auto,always,never}respeitaNO_COLORe detecção de TTY. A paleta é um tema escuro quente e de baixo contraste — fácil para os olhos às 23h.- Flags de filtro (
--provider,--model) são insensíveis a maiúsculas/minúsculas em provedores, sensíveis em modelos, e repetíveis onde atuam como listas de permissão. --version/-Vimprime a versão e sai.--install-completion {bash|zsh|fish|powershell}instala um script de completação por tab — após reiniciar o shell, toda flag é completável com<Tab>.
compare
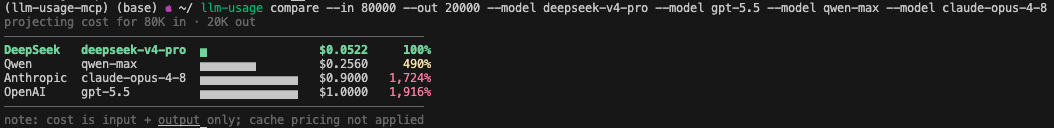
Classifica todos os modelos precificados por custo projetado para uma chamada de n de entrada / m de saída. Mais barato primeiro, percentual em relação ao mais barato. A visualização padrão deduplica por família linhas que compartilham tanto a raiz da família do modelo quanto um preço idêntico — então gpt-5-mini e gpt-5-mini-2025-08-07 colapsam em uma linha com ×2. Passe --all para ver todas as linhas do catálogo.
# How does an 8k-in / 2k-out call price out today?
$ llm-usage compare --in 8000 --out 2000

# Just OpenAI's models:
$ llm-usage compare --in 8000 --out 2000 --model gpt-5-mini --model gpt-5-nano

# Same projection, JSON for a script:
$ llm-usage compare --in 8000 --out 2000 --json | jq '.ranked[0]'
models
Navegador de catálogo. Irmão de compare, mas responde "quanto este modelo cobra?" em vez de "quanto custaria minha carga de trabalho?". Taxas por milhão de tokens, ordenadas alfabeticamente por provedor por padrão; alterne com --sort input ou --sort output para encontrar o mais barato em qualquer eixo. Taxas de cache ficam ocultas até você pedir (--cache) porque a maioria dos modelos não as tem e colunas vazias desperdiçam largura.
# Full catalog, deduped.
$ llm-usage models

# OpenAI's nano models only, with cache rates:
$ llm-usage models --provider openai --match nano --cache

# Cheapest input rate first — quick "what's the floor right now?":
$ llm-usage models --sort input
recommend
Escolhe um. Filtra por --provider, --model e --budget, depois retorna a correspondência mais barata mais dois segundos colocados. A string de raciocínio explica o que foi assumido e o que foi escolhido, para você verificar em vez de confiar cegamente.
# Cheapest priced model, full stop.
$ llm-usage recommend

# Anything Anthropic that fits under one cent for a 1k/1k call:
$ llm-usage recommend --provider anthropic --budget 0.01

# Of these three specific candidates, which wins?
$ llm-usage recommend --model gpt-5-mini --model claude-sonnet-4-6 --model qwen-max
v1 classifica apenas por custo. --task é opcional e aparece no texto de raciocínio; não direciona a seleção (a ferramenta não é um LLM e não pode interpretar texto livre).
spend
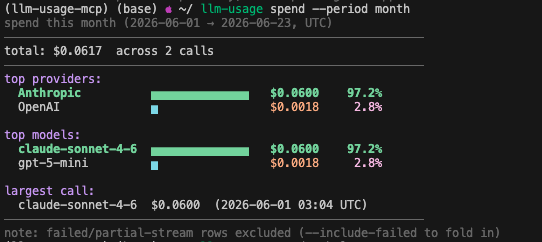
Lê o SQLite. A visualização padrão é um resumo usage_summary — total em dólares, top-3 provedores, top-3 modelos, maior chamada individual. Passe --group-by para alternar para o modo de agrupamento.
# Headline for this week.
$ llm-usage spend

# This month grouped by model, JSON for a dashboard:
$ llm-usage spend --period month --group-by model --json | jq

# Spend on a specific project tag, day-by-day:
$ llm-usage spend --group-by day --project my-side-thing
Limites de período são UTC de calendário: today = desde 00:00 UTC, week = desde segunda-feira, month = desde o dia 1º, year = desde 1º de janeiro. Linhas com falha / stream parcial são excluídas por padrão; opte por incluí-las com --include-failed.
status
Uma tela, quatro seções: Banco de dados, Proxy de captura, Provedores, Preços. O comando "está tudo realmente funcionando?". Somente leitura — executá-lo em uma instalação nova antes de você ter iniciado o proxy ou o servidor MCP imprime database not initialized em vez de criar o arquivo silenciosamente.
$ llm-usage status

# Skip the network probe (offline, CI, slow link):
$ llm-usage status --no-net

# Machine-readable for a healthcheck script:
$ llm-usage status --json
providers
Visualização de configuração por provedor. Mais ampla que o bloco de Provedores do status: adiciona a flag de formato de transmissão (openai-compat: yes/no) e uma expansão opcional --models que lista todos os modelos precificados sob cada provedor.
$ llm-usage providers
$ llm-usage providers --models   # expand each provider with its model list
about
O painel de entrada: versão, autor, licença e a página inicial do projeto. O companheiro voltado para humanos de --version — os campos são lidos dos metadados do pacote instalado, então correspondem ao que o PyPI mostra.
$ llm-usage about

# Machine-readable, for a script or an issue template:
$ llm-usage about --json
Provedores suportados
| Provedor | Autenticação | Não-streaming | Streaming | Preço de cache |
|---|---|---|---|---|
| Anthropic | x-api-key | sim | sim | cache_creation + cache_read |
| OpenAI | Bearer | sim | sim | prompt_tokens_details.cached_tokens aninhado |
| DeepSeek | Bearer | sim | sim | prompt_cache_hit_tokens / _miss_tokens |
| Qwen (DashScope) | Bearer | sim | sim | geralmente omitido no endpoint compatível com OpenAI |
Mais a caminho. Google Gemini, AWS Bedrock, Moonshot (Kimi), Zhipu GLM, MiniMax e outros estão no escopo de docs/post_v1_providers.md.
De onde vêm os preços. Os preços são um snapshot reduzido e incorporado do JSON de preços do LiteLLM, atualizado semanalmente por uma GitHub Action (refresh-pricing.yml). Modelos que o LiteLLM ainda não suporta são preenchidos localmente via pricing_overrides.json.
Configuração
Tudo é variável de ambiente (ou um arquivo .env na raiz do repositório). Os padrões são sensatos — nada é obrigatório para iniciar o proxy. Referência completa: docs/configuration.md. As três que você provavelmente vai ajustar:
| Variável | Padrão | Finalidade |
|---|---|---|
LLM_USAGE_DB_URL | sqlite:///$HOME/.llm-usage/usage.db | Onde o banco de dados local fica. |
LLM_USAGE_PROXY_PORT | 5525 | Porta de captura do proxy (somente loopback). |
LLM_USAGE_<PROVIDER>_BASE_URL | endpoint oficial de cada provedor | Apontar um provedor para um proxy reverso / gateway — útil em regiões com restrição de rede. |
Docker
Um Dockerfile mínimo está incluído apenas para validação automatizada do registro MCP (ex.: Glama), que verifica se o servidor empacotado inicia e responde à introspecção MCP. A forma recomendada de executar o servidor continua sendo uvx llm-usage-mcp localmente — esta é uma ferramenta local-first, não um serviço hospedado.
Licença
MIT.