AginxBrowser
Servidor de navegador agente-first: um único binário Rust com V8, sem Chromium. 14 ferramentas MCP (fetch/search/click/screenshot/download + sessões persistentes), impressões digitais TLS furtivas.
Documentação
AginxBrowser
English | 中文
O navegador para Agentes de IA. Veja a web ao vivo. Leia. Aja. Lembre-se.

Um navegador construído para agentes desde a primeira linha de código — não um navegador humano adaptado para automação. Veja o mundo, leia, pesquise, aja e guarde o que leu: um único binário Rust com V8 embutido, sem necessidade de Chromium.
Humanos têm Chrome. Agentes têm AginxBrowser.
Um único binário, zero dependências, serviço instantâneo. A API HTTP é toda a interface — os agentes conectam e funcionam.
A estrela que chamou nossa atenção: Pierre Tachoire, cofundador da Lightpanda — o navegador headless que nosso benchmark mede — marcou o repositório com estrela. 90 segundos sobre por que isso importava para nós.
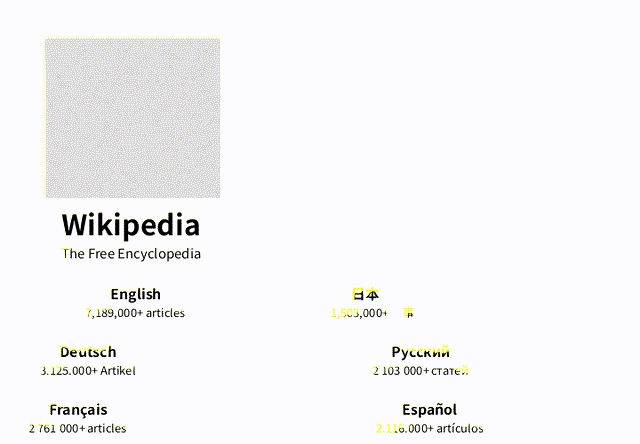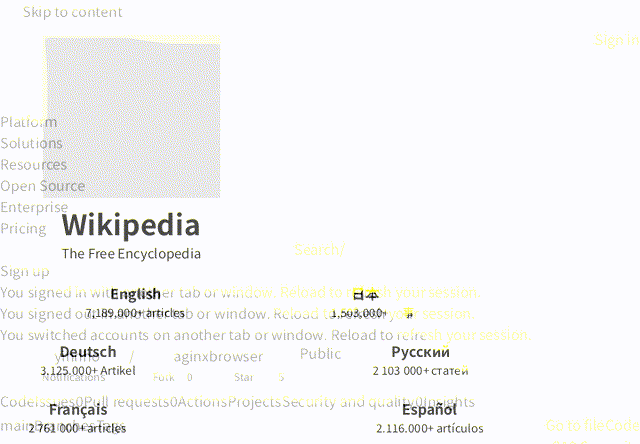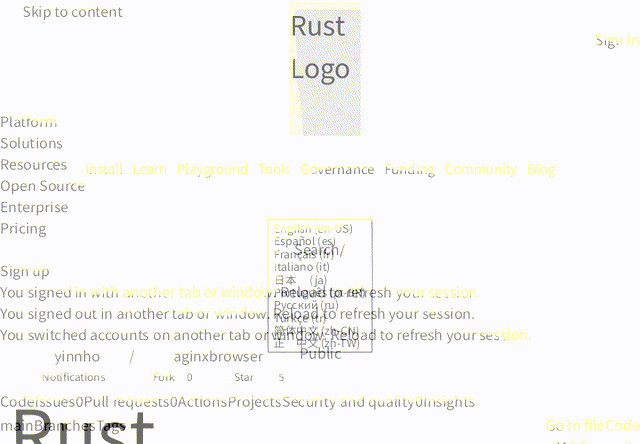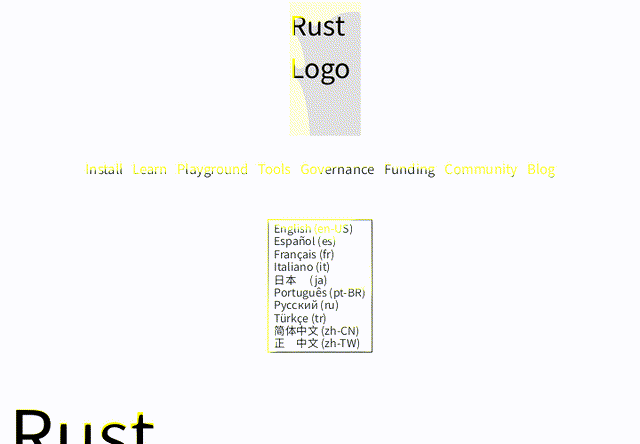
Páginas reais renderizadas pelo mecanismo diting do AginxBrowser (sem Chromium) — Wikipedia, este repositório, Rust. Tire um screenshot você mesmo →
Por que os Agentes Precisam do Próprio Navegador
Medido contra o Chrome headless nas mesmas 20 páginas, mesma rede (benchmark, 2026-08-28): 7,6× mais rápido para texto utilizável por agente (p50 532 ms vs 4 053 ms), ~10× menos memória (227 MB para o processo inteiro vs ~2,1 GB por página do Chrome) e 0 falhas graves onde o --dump-dom do Chrome não produziu DOM em 5 de 40 carregamentos. Reexecutado na v0.5.21 (2026-09-29) em um dia de rede degradada manteve a proporção — 5,4× p50, 468 MB na execução inteira vs 1,75 GB por página — ambos os TSVs brutos estão commitados. O custo total de um agente é eficiência do navegador × eficiência do modelo — esta é a metade do navegador.
A "automação de navegador" existente foi construída para humanos ou para raspagem única — não para agentes:
| AginxBrowser | Puppeteer/Playwright | Firecrawl | Browser-use | |
|---|---|---|---|---|
| Projetado para | Agentes primeiro | Depuração humana | Serviço de raspagem | Wrapper de LLM |
| Dependências | Binário único, sem Chromium | Chromium ~500MB | Docker ~1GB | Chromium |
| Vê (screenshots) | ✅ mecanismo de renderização diting embutido | Precisa de Chromium | ❌ | Precisa de Chromium |
| Lê | markdown + js_extract + recibos de fetch | Faça você mesmo | markdown | Faça você mesmo |
| Escreve documentos | ✅ render_markdown: HTML determinístico + diagramas SVG inline | ❌ | ❌ | ❌ |
| Encontra (busca) | ✅ 20 mecanismos, 7 categorias, mesclados | ❌ | ❌ | ❌ |
| Age | interação de sessão indexada | API DevTools | ❌ | dirigido por LLM |
| Lembra | ✅ cache local de fetch/busca (SQLite FTS5) | ❌ | cache de rastreamento | ❌ |
| Protocolo | HTTP | API Node | HTTP | Python |
| Impressões digitais TLS | ✅ Chrome/Firefox/Safari/Edge | Plugin necessário | ❌ | ❌ |
| CAPTCHA | ✅ detectar + aguardar automaticamente + 2captcha opcional | Faça você mesmo | ❌ | ❌ |
| Sessões interativas | ✅ persistentes | ✅ | ❌ | ✅ |
Mecanismos do mesmo nível, não as ferramentas da tabela acima. As células são capacidades, não velocidade.
| AginxBrowser | Obscura | Blitz | Lightpanda | |
|---|---|---|---|---|
| O que é | Navegador Rust, V8, pintura CSS diting | Navegador headless Rust, V8 | Mecanismo HTML/CSS (Stylo). Não é um navegador de agente | Navegador headless Zig, V8 |
| Screenshot | pintura embutida, build opcional | screenshots, screencast, PDF | pinta uma janela | integração Hermes recorre ao Chrome para screenshots |
| Suíte CSS pública | nenhuma no CI | não publicada como WPT | WPT no CI, incluindo SVG | não publicada como WPT |
| Licença | Apache-2.0 | Apache-2.0 | Apache-2.0 e MIT | AGPL-3.0 |
Um agente precisa de cinco coisas de um navegador: ver, ler, encontrar, agir, lembrar. Um único binário cobre todas — amigável ao systemd, zero dependências.
Vantagem principal: sem Chromium. O AginxBrowser incorpora um mecanismo de navegador completo (V8 + pilha HTTP Rust + o mecanismo de renderização CSS/layout/pintura diting, com a linhagem Blitz/Stylo/Taffy como implementação de referência). Sem Puppeteer, sem Chrome, sem Docker. Um único binário Rust sob systemd é sua infraestrutura de navegação para agentes.
Duas Coisas que Renderizadores Sem Estado Não Conseguem
A maioria dos novos "navegadores de agente" são renderizadores de uso único, sem estado e sem impressão digital — bons para páginas públicas, inúteis contra Cloudflare ou fluxos de login. O AginxBrowser vai na direção oposta:
- 🔐 Impressões digitais TLS reais — o modo furtivo replica os handshakes TLS completos do Chrome145 / Firefox133 / Safari / Edge via BoringSSL (não apenas uma string de UA), alternável por requisição; desafios Cloudflare Turnstile aguardam automaticamente por
cf_clearance. Mecanismos sem impressão digital recebem erros 403 — nós passamos. - 🤝 Sessões interativas com estado — estado de login injetável e exportável (
session_create(cookies=...)↔session_cookies), sobrevivendo à paginação e fluxos de várias etapas;persistent: trueaté sobrevive à desocupação por inatividade e reinicializações do servidor — o mesmo id de sessão volta logado. Mecanismos de uso único descartam o estado.
Ponto de referência: o Kitesurf da Cloudflare explicitamente não oferece negociação real de impressão digital TLS nem sessões de autenticação persistentes — o território anti-bot e de login é exatamente onde o AginxBrowser atua.
Código aberto Apache-2.0, binário único — hospede você mesmo hoje, sem dependência de nuvem.
Cada Fetch é um Recibo
Os agentes agem com base no que um navegador lhes diz, então a resposta relata o que realmente aconteceu — não apenas "obteve um 200":
tier— qual caminho serviu a página: HTTP simples (~100 ms) ou a camada de navegador renderizada por V8. Um agente pode ver por que um fetch foi rápido ou lento.redirected_from— o rastro completo de redirecionamentos.redirected_from[0]é a URL que você pediu,urlé de onde o conteúdo realmente veio — solicitado emparelhado com efetivo, cada salto visível.content_hash+changed_since_prev— cada fetch é hashado; amostras consecutivas da mesma URL podem ser comparadas. Uma origem com limite de taxa servindo o mesmo corpo 200 congelado por dias é lida comochanged_since_prev: false— o detector de deriva mais barato que existe.captcha_event— quando uma página de desafio é detectada (e resolvida, se um resolvedor estiver configurado), a resposta diz isso em vez de entregar uma página de desafio como se fosse conteúdo.
O cache local se baseia na mesma ideia: resultados de busca voltam com prefixos de seção [§ heading] para que um agente saiba onde na página um resultado caiu, e a classificação funde relevância de palavras-chave com atualidade.
Capacidades
- Renderização em camadas: páginas estáticas via HTTP simples (~100ms); V8 só inicia quando a renderização JS é necessária (~1-2s) — 90% do conjunto de páginas do benchmark servido sem iniciar o V8; cada resposta relata qual camada a serviu (campo
tier) - Metabusca multi-mecanismo: web geral (Baidu / Bing / Sogou / WeChat / DuckDuckGo / Wikipedia / Hacker News), notícias (Bing News), código (Stack Overflow, GitHub, MDN), pacotes (npm, PyPI, RubyGems), acadêmico (arXiv, OpenAlex), modelos de IA (Hugging Face) — 20 mecanismos em 7 categorias, consultados simultaneamente, mesclados e deduplicados. Operadores podem conectar um índice Meilisearch privado ao mesmo
/search. Buscar → ler em um passo - Busca de imagens:
categories=imagesacessa os índices de imagens do Baidu/Bing e retorna links binários diretosimage_url(baixáveis diretamente para jpg/png) além da proveniênciasource_url - Sessões interativas: sessões de navegador persistentes com interação indexada (
state/click/input/scroll/eval) — agentes navegam como humanos, esession_exporttransforma o que um agente descobriu em um script de replay curl executável (zero tokens de modelo na reexecução) — ou, comformat=json, em um documento de fluxo (flow_runo reproduz no servidor com substituição{{var}}, portõeswait/expecte saídas salvas; fluxos instalados vivem emworkflow/<name>/flow.json, adicionados sem recompilação). As ferramentas de sessão também cobrem a parte de agir:session_viewportsimula viewports de dispositivos (consultas de mídia respondem),session_waitbloqueia em um seletor ou predicado com timeout,session_screenshotrenderiza o estado ao vivo,session_consolereproduz o anel de console da página, esession_storageexporta/restaura cookies além de localStorage para transferência de login - Sniffer de links de reprodução:
session_network(filter=media)extrai as URLs m3u8/mp4/dash que o player de uma página realmente solicitou em tempo de execução — links encontrados apenas no HTML da página costumam ser iscas, então o log de requisições é a fonte da verdade.GET /session/{id}/harexporta o mesmo tráfego como HAR 1.2 (corpos retidos incluídos) - Download de arquivos: streaming para disco (sem buffer em memória), integridade SHA-256, retomada de transferências interrompidas — para binários, arquivos, conjuntos de dados
- Cache local que lembra: cada fetch/busca vai para SQLite (FTS5) em
~/.aginxbrowser/cache.db— uma nova busca dentro do TTL responde do que o agente já leu em vez de pagar novamente o tempo de rede, com correspondência de substring CJK, trechos cientes de seção[§ heading], hashes de conteúdo por URL para detecção de deriva e escopo por sessão para implantações compartilhadas - Tratamento de CAPTCHA: detecção de tipo com espera automática de desafio Cloudflare e integração opcional com 2captcha — a busca nunca para em páginas de verificação
- Extração de dados JS:
js_extractextraiwindow.__INITIAL_STATE__e outros dados estruturados de SPAs - Geração de documentos:
POST /render_markdowntransforma markdown em um artefato HTML determinístico e autocontido — a camada de documentos, para que agentes nunca escrevam HTML à mão. A prosa usa um shell offline simples (sem fontes, sem scripts); blocos cercadosarchifycarregam JSON de diagrama tipado com coordenadas zero (famílias sequência / fluxo de trabalho / arquitetura / fluxo de dados / ciclo de vida) e renderizam para SVG inline via o mecanismo de layout. Mesma entrada, mesmos bytes — o recibo carrega o sha256 para que o determinismo seja verificável.theme(claro/escuro) epreset(clássico / fluxo de sinal / blueprint / editorial) fixam as cores no momento da geração;quality: "showcase"é o portão de entrega, avaliando cruzamentos de rotas, folga de rótulos e ritmo sem tocar nos bytes do artefato. Abas de visualização guiada além dewindow.agxViewer(focus/ ego /route/reach) tornam o artefato interativo. Fontes Mermaid são trabalho do agente traduzir para JSON archify, não do mecanismo. Vocabulário de diagramas adaptado de archify (MIT) - Renderização de screenshots: endpoint
/screenshot(build--features screenshotopcional) pinta o DOM renderizado por JS com o mecanismo de renderização diting — CPU pura, sem Chromium — para PNG. Entrada de visão para agentes - Vídeo de linha do tempo:
/videorenderiza as linhas do tempo de animação de uma página para MP4 — os scripts da página registram linhas do tempo estilo GSAP emwindow.__timelines(duration()+pause(t)), cada quadro buscat=i/fpse pinta o viewport, e os quadros vão para o ffmpeg (H.264, yuv420p). Determinístico por construção: sem relógio de parede nos valores de pixel, mesma renderização duas vezes = mesmo MP4. Precisa de ffmpeg no PATH - Conjunto de páginas (PDF/PNG/PPTX/DOCX):
/pdfcorta uma página renderizada em páginas e as empacota — o modo de impressão pagina nos limites de blocos de nível superior (padrão A4 @96dpi, sem texto cortado ao meio onde uma quebra pode cair na borda de um bloco), o modo de slides faz uma página por correspondência de seletor CSS dimensionada ao elemento (um deck HTML com um.slidepor página exporta como um deck real). PDF baseado em imagem: JPEG por página via DCTDecode, escritor PDF 1.4 feito à mão, zero novas dependências. PPTX empacota as mesmas páginas como um slide por página; DOCX como uma seção do tamanho de página por página — ambos OOXML feito à mão (escritor ZIP armazenado, timestamps fixos), byte-determinísticos, zero novas dependências - Falsificação de impressão digital TLS: o modo furtivo personifica Chrome145/Firefox133/Safari/Edge, alternável por requisição
- Compatível com Firecrawl: endpoint
/v1/scrape— clientes Firecrawl existentes migram mudando a URL base - Proteção contra rebinding de DNS: guarda SSRF embutida + validação de IP pós-resolução
Um Navegador, Não um Rastreador
O AginxBrowser existe para recuperação em tempo real: um agente chega com uma pergunta, lê algumas páginas, sai com a resposta. Não é uma ferramenta de rastreamento — e o produto é moldado para que não possa silenciosamente se tornar uma:
- robots.txt não é nosso portão. O verificador RFC 9309 vem embutido, mas uma camada de consulta em tempo real não é um rastreador e não faz etiqueta de rastreador por padrão; operadores que quiserem definem
AGINXBROWSER_HONOR_ROBOTS=1. - Sem API de varredura de sites. Não há endpoint de rastreamento nem recursão de seguir links — cada carregamento de página acontece porque um agente pediu aquela página.
- Orçamentos embutidos. Por domínio: 20 páginas/minuto. Por sessão interativa: 200 páginas. Alternados via
AGINXBROWSER_DOMAIN_RATE_PER_MIN/AGINXBROWSER_SESSION_PAGE_LIMIT(0desativa na sua própria instância). Generoso para um agente percorrendo documentação ou um console; fatal para o padrão de rastreamento página após página, incluindo rotação de subdomínios (um domínio registrável, um orçamento). - A instância hospedada (browser.aginx.net) executa orçamentos mais rígidos. Todo usuário compartilha um único IP de saída, e manter os sites confortáveis com esse IP faz parte do serviço. Auto-hospede se quiser números diferentes.
- Precisa rastrear um site em massa? Use um rastreador. Este não é um, e não vai se tornar um.
Para Que Serve
Não demonstrações — trabalhos reais que agentes de navegador fazem hoje:
- Percorrer consoles administrativos — AWS / App Store Connect / Google Play, dezenas de camadas de menu por tarefa. Deixe o agente clicar; ele só volta quando autorização é necessária.
- Ações em lote atrás de login — preencher carrinhos, vasculhar histórico de pedidos, verificar páginas que só renderizam logado. Injete cookies, opere, exporte para reutilização.
- Atravessar muros anti-bot — proteção Cloudflare, desafios Turnstile, verificações de impressão digital TLS. O modo furtivo avança em vez de recuar no 403.
- A internet chinesa — meta-busca Baidu / Sogou / WeChat em 5 mecanismos, renderização correta de páginas chinesas. Não é só web em inglês.
- Scripts no momento — o agente lê a página, escreve JS, executa: tabelas de comparação destacadas, conteúdo reformatado, filtros de produto em parâmetros ocultos. GreaseMonkey turbinado.
- Visão multimodal — capturas de tela como entrada visual para fluxos de olhar-e-julgar: escolher assentos, reconhecer layouts, verificar renderização.
Onde Se Encaixa na Pilha de Uso de Computador
Agentes de uso de computador vêm em duas camadas. Pilhas de camada de GUI (Cua, agentes CUA de desktop) dirigem uma máquina inteira: capturas de tela de um display como entrada, eventos de mouse/teclado X11 como saída, uma VM ou contêiner por sessão. Navegadores de camada de motor pulam o desktop — a própria página é a máquina. AginxBrowser é a camada de motor:
| Camada de GUI (CUA de desktop) | AginxBrowser (camada de motor) | |
|---|---|---|
| Espaço de ação | pixels de tela → eventos de entrada do SO | DOM: clique por coordenadas ou seletor, despacho de eventos real |
| Leitura de estado | captura de tela de um display | DOM estruturado / árvore de acessibilidade, captura de tela opcional |
| Custo por sessão | Xvfb + VM/contêiner | um processo, sem servidor de display |
| Frames | achatados em pixels | primeira classe: hit-testing desce em iframes, evaluate com escopo de frame |
| Replay | melhor esforço (timing do compositor) | logs de ação exportam como curl executável / JSON de fluxo |
Início Rápido
Instalação completa em um comando (superfície de gatilho SKILL.md + verificação):
# Download -> inspect the contents -> run only after review (never blind-run network scripts)
curl -fsSL https://raw.githubusercontent.com/yinnho/aginxbrowser/main/skill.sh -o skill.sh
less skill.sh
bash skill.sh
Instale a superfície de gatilho da skill via skills.sh:
npx skills add yinnho/aginxbrowser
Ou apenas entregue este bloco ao seu agente de IA — ele se configura sozinho:
Set up aginxbrowser as your web access layer:
1. Install it locally and verify it is healthy:
   brew trust yinnho/aginxbrowser   # Homebrew 7+ tap-trust gate; older brew skips this
   brew install yinnho/aginxbrowser/aginxbrowser
   aginxbrowser doctor   # then start: aginxbrowser (listens on 0.0.0.0:8089)
   curl http://127.0.0.1:8089/health
2. From now on, route web tasks through http://127.0.0.1:8089 instead of raw curl:
   - read a page / scrape a URL  -> POST /fetch {"url":...}        (markdown output, Cloudflare bypassed by default)
   - search the web              -> POST /search {"q":...,"fetch_top":3}
   - see a page                  -> POST /screenshot {"url":...}
   - login / form / click-through-> POST /session/create -> /session/{id}/state -> /input /click -> /close
Auto-hospedagem:
# macOS / Linux via Homebrew (7+ needs the trust line first)
brew trust yinnho/aginxbrowser
brew install yinnho/aginxbrowser/aginxbrowser
aginxbrowser doctor   # features + fonts + egress self-check

# Or the prebuilt binary (platform detect + sha256 + mirror fallback + doctor self-check)
# macOS / Linux / Windows (git-bash; prebuilt Windows ships from v0.3.1, full `stealth`+`screenshot` feature set from v0.4.0)
# Cautious: download -> inspect -> run (never blind-run network scripts)
curl -fsSL https://browser.aginx.net/install.sh -o install.sh
less install.sh && bash install.sh
# Or straight in, if you trust the repo:
#   curl -fsSL https://browser.aginx.net/install.sh | sh
# GitHub slow/blocked? AGINXBROWSER_GH_PROXY=https://ghfast.top/ bash install.sh
aginxbrowser doctor   # features + fonts + egress self-check

# Or build from source (--features stealth,screenshot or you lose both)
cargo build --release --features stealth,screenshot

# Start the service
./target/release/aginxbrowser
# → Listening on 0.0.0.0:8089

# Verify
curl http://127.0.0.1:8089/health
# → {"status":"ok","engine":"diting"}

# Fetch a page
curl -sS -X POST http://127.0.0.1:8089/fetch \
  -H "Content-Type: application/json" \
  -d '{"url":"https://example.com"}'

# Search (snippets only by default; fetch_top grabs page bodies for the top N)
curl -sS -X POST http://127.0.0.1:8089/search \
  -H "Content-Type: application/json" \
  -d '{"q":"macbook price","max_results":5,"fetch_top":2,"max_chars_per":2000}'

# Create an interactive session
curl -sS -X POST http://127.0.0.1:8089/session/create \
  -H "Content-Type: application/json" \
  -d '{"url":"https://example.com"}'
# → {"session_id":"s_1","url":"https://example.com/"}
Rotas REST
Toda capacidade é HTTP puro — sem SDK necessário. Não há /openapi.json (as rotas são poucas o suficiente para listar aqui); campos completos de requisição/resposta para cada rota estão em docs/API.md.
| Método | Caminho | O que faz |
|---|---|---|
| GET | /health | Liveness + commit de build, UA, TLS, capacidades |
| GET | /doctor | Autoverificação profunda: motores ativos, fontes, egress |
| GET | /engines | Catálogo de mecanismos de busca com estado de suspensão ao vivo |
| POST | /fetch | Buscar uma página → texto/markdown/html. Params: render_tier (auto/http/browser), max_chars, capture_xhr, … |
| POST | /search | Meta-busca multi-motor. Params: engines, categories, max_results, time_range (day/week/month/year), fetch_top, max_chars_per, wait_secs |
| POST | /click | Clicar em um seletor CSS em uma página |
| POST | /eval | Avaliar JavaScript em uma página |
| POST | /download | Transmitir um arquivo para disco (sha256, retomar) |
| POST | /screenshot | Renderizar página → PNG (recurso screenshot) |
| POST | /video | Renderizar linhas do tempo de animação → MP4 (recurso screenshot) |
| POST | /pdf | Paginar página → PDF/PNG/PPTX/DOCX (recurso screenshot) |
| POST | /v1/scrape | Scrape compatível com Firecrawl (+ actions) |
| POST | /flow/run | Executar um fluxo JSON gravado/editado até a conclusão — zero tokens de modelo (name executa um workflow/<name>/flow.json instalado, flow é inline, vars substitui {{placeholders}}, session_id compõe com estado de login importado) |
| POST | /session/create | Iniciar uma sessão interativa (cookies/UA transportados entre chamadas) |
| POST | /import/curl | Criar uma sessão logada a partir de "Copiar como cURL" do DevTools |
| GET | /session/list | Sessões ao vivo |
| POST | /session/{id}/navigate · /state · /click · /click_xy · /drag · /input · /scroll · /eval · /wait · /dialog · /viewport · /screenshot · /clone · /close | Ações de sessão |
| GET | /session/{id}/cookies · /storage · /console · /network · /har · /export | Inspeção de sessão |
| POST | /render_markdown | Markdown → artefato HTML autocontido determinístico (+ diagramas SVG inline) |
Toda capacidade está a um POST de distância — sem SDK, sem adaptador de protocolo.
Estrutura do Projeto
aginxbrowser/
├── ARCHITECTURE.md       # Layering legislation (authoritative)
├── Cargo.toml            # Workspace root (members = crates/diting)
├── crates/
│   └── diting/           # Engine crate: DOM/CSS/layout/paint/JS/net/Page
│       ├── build.rs      # V8 snapshot generation
│       ├── js/           # bootstrap.js + companion scripts
│       └── src/          # diting_{dom,css,net,js,layout,fonts,browser}
├── workflow/             # Flow + recipe assets (drop-in, no rebuild)
├── README.md
├── docs/
│   └── API.md            # Full API reference (HTTP)
├── bench/                # Benchmark harness + results (vs headless Chrome)
│   ├── README.md         #   methodology + numbers
│   ├── pages.txt         #   fixed 20-page set
│   ├── run.py            #   harness
│   ├── summarize.py      #   TSV → results table
│   └── results/          #   raw run data
└── src/
    ├── main.rs              # HTTP/CLI assembly (thin face)
    ├── routers/             # HTTP handlers: acquisition/sessions/outputs/render
    ├── server/              # Acquire façade by job: browser/fetch/outputs/search
    ├── session/             # Interactive sessions (manager/interact/state/…)
    ├── flow/                # Flow interpreter + install
    ├── search/              # Metasearch orchestration + per-engine adapters
    ├── store/               # Local fetch/search cache (SQLite FTS5)
    ├── docgen/              # Document layer: markdown → HTML + SVG diagrams
    ├── screenshot.rs        # Eye-side HTML→PNG (keep monolithic)
    ├── render.rs            # Tiered rendering (HTTP direct → diting)
    ├── download.rs          # Streaming file download (sha256, resume)
    ├── robots.rs            # RFC 9309 robots.txt checker (opt-in gate)
    ├── rate.rs              # Per-domain + per-session budgets
    ├── captcha.rs           # CAPTCHA detection & auto-solve
    ├── firecrawl_compat.rs  # Firecrawl-compatible /v1/scrape endpoint
    ├── video.rs             # Timeline video pump (__timelines → ffmpeg → MP4)
    ├── pages.rs             # Page pump (print/slides → PDF/PNG)
    ├── ooxml.rs             # OOXML containers (PPTX/DOCX)
    ├── doctor_cli.rs        # `aginxbrowser doctor` self-check
    ├── browser.rs           # Product Page adapter: Browser, BrowserBuilder
    ├── page.rs              # Product Page/Element wrapper over diting
    ├── config.rs            # BrowserConfig
    ├── cookie.rs            # Cookie helpers
    └── error.rs             # Error types
Build
# Standard build (no stealth; TLS fingerprint features inactive)
cargo build --release

# With stealth (requires go + cmake + C++ toolchain; enables TLS fingerprint spoofing)
cargo build --release --features stealth

# With screenshot rendering (enables /screenshot; adds the rendering stack, +30-40MB)
cargo build --release --features screenshot

# Full featured (recommended for production)
cargo build --release --features stealth,screenshot
Requisitos: Rust 1.78+; a biblioteca estática V8 baixa automaticamente no primeiro build. O recurso furtivo adicionalmente precisa de go, cmake e um compilador C++. O recurso de captura de tela vem com um subconjunto de fontes CJK embutido (GB2312 + símbolos comuns) — sem fontes de sistema necessárias para renderização correta de chinês.
Se sua rede não alcançar o CDN do rusty_v8 (build trava com zero progresso após "downloading v8"), pré-preencha ~/.cache/rusty_v8 com o librusty_v8.a.gz para sua versão (busque de qualquer mirror/host alcançável e gunzip no lugar) e o script de build pula o download.
Variáveis de Ambiente em Tempo de Execução
| Variável | Padrão | Descrição |
|---|---|---|
AGINXBROWSER_BIND | 0.0.0.0:8089 | Endereço de escuta |
AGINXBROWSER_STEALTH | habilitado | 0 desativa o modo furtivo (para diagnósticos) |
AGINXBROWSER_UA | Linux Chrome145 | User-Agent falsificado |
AGINXBROWSER_ACCEPT_LANGUAGE | zh-CN,zh;q=0.9,en;q=0.8 | Cabeçalho Accept-Language |
AGINXBROWSER_PROXY | nenhum | Proxy de fallback opcional. Mecanismos de fonte bloqueada (Wikipedia, Bing News, Hugging Face, RubyGems) conectam diretamente primeiro e caem neste proxy apenas quando a tentativa direta falha — implantações no exterior não precisam de proxy algum; use_proxy:true por requisição também roteia fetch/busca através dele. Navegações de navegador/sessão para domínios conhecidamente bloqueados (wikipedia.org, github.com, …) roteiam através dele automaticamente. HTTP_PROXY/HTTPS_PROXY/ALL_PROXY padrão são deliberadamente ignorados pelo motor (defina-os para outras ferramentas livremente); o log de inicialização avisa quando vê um |
AGINXBROWSER_NAV_CHAIN_LIMIT | 10 | Limite de cadeia de navegação JS: documentos que uma página pode encadear via location/saltos de formulário antes que a navegação aborte. A contagem inclui o documento solicitado (10 = doc inicial + 9 saltos). Aumente para cadeias longas legítimas (handover SSO entre provedores); redirecionamentos HTTP 3xx são orçados separadamente (20, conforme especificação Fetch / paridade de navegador) |
AGINXBROWSER_CACHE_TTL_SECS | 600 | TTL de cache /fetch, 0 desativa |
AGINXBROWSER_HONOR_ROBOTS | não definido | robots.txt não é consultado por padrão em /fetch, /screenshot, /download; defina 1 para optar (escolha do operador) |
AGINXBROWSER_ALLOW_FILE_ACCESS | não definido | Optar por leituras file:// — navegação, subrecursos, /fetch. Igual ao flag CLI --allow-file-access. Desligado por padrão: o servidor vincula 0.0.0.0, então um portão aberto entrega arquivos locais a qualquer um que alcance a porta. Defina em uma instância de dev local, não em uma hospedada |
AGINXBROWSER_ALLOW_PRIVATE_NETWORK | não definido | Optar por fetches de loopback/RFC1918/link-local (o portão SSRF). Igual ao flag CLI --allow-private-network — apenas máquinas de dev |
AGINXBROWSER_ALLOW_NETWORK | não definido | Alternativa com escopo: allowlist CIDR separada por vírgulas (ex.: 10.20.0.0/16,192.168.1.0/24) que abre apenas esses intervalos — endpoints de metadados de nuvem (169.254.169.254, 100.100.100.200) e todo o resto permanecem bloqueados. Igual a --allow-network <cidrs> |
AGINXBROWSER_FONT_DIR | não definido | Diretório de fontes extras (.ttf/.otf/.ttc) carregadas como fallbacks de cauda para scripts que o subconjunto CJK embutido não cobre (coreano, tailandês, árabe, …). Igual ao flag CLI --font-dir <path>. Faces que o pacote já cobre mantêm renderização do pacote — fontes do diretório são caudas de cobertura, não substituições de família nomeada |
AGINXBROWSER_ROBOTS_TTL_SECS | 3600 | TTL de cache de política robots.txt por host |
AGINXBROWSER_DOMAIN_RATE_PER_MIN | 20 | Orçamento de páginas por domínio registrável por minuto (subdomínios compartilham um orçamento); requisições acima do orçamento recebem 429 com a mensagem de postura. 0 desativa. Veja "Um Navegador, Não um Rastreador" |
AGINXBROWSER_SESSION_PAGE_LIMIT | 200 | Total de páginas que uma sessão interativa pode percorrer (cliques que causam navegação contam); navegações acima do orçamento são recusadas, a página atual permanece interativa. 0 desativa |
AGINXBROWSER_STORE | ligado | Cache local de fetch/busca; 0/false/off desativa |
AGINXBROWSER_STORE_PATH | ~/.aginxbrowser/cache.db | Localização do banco de dados SQLite (criado 0600) |
AGINXBROWSER_STORE_TTL_HOURS | 720 | TTL de página em cache |
AGINXBROWSER_STORE_SEARCH_TTL_HOURS | 168 | TTL de conjunto de resultados de busca em cache |
AGINXBROWSER_STORE_SCOPE | global | session define o escopo do cache por sessão em vez de um pool compartilhado |
CAPTCHA_SOLVER_API_KEY | nenhum | Chave de API 2captcha; habilita resolução automática de CAPTCHA |
CAPTCHA_SOLVER_SERVICE | 2captcha | Provedor de resolução de CAPTCHA |
AGINXBROWSER_MEILI_URL | nenhum | URL base Meilisearch; defina para habilitar o motor de índice privado |
AGINXBROWSER_MEILI_INDEX | nenhum | UID do índice Meilisearch para consultar |
AGINXBROWSER_MEILI_KEY | nenhum | Chave Bearer opcional para a instância Meilisearch |
AGINXBROWSER_CAPTCHA_BACKOFF_SECS | 300,600,1800,3600 | Escada de suspensão de CAPTCHA (segundos). Valor único = duração fixa para cada acerto |
AGINXBROWSER_CAPTCHA_POLICY | suspend | suspend = escada cronometrada; demote/skip = avalia o motor pela vida do processo após um CAPTCHA |
AGINXBROWSER_DISABLE_ENGINES | nenhum | Nomes de mecanismos separados por vírgulas para deixar não registrados (ex.: bing_news) |
AGINXBROWSER_BING_NEWS | ligado | 0/false/off desativa a perna bing_news (ruído de caminho duplo Object-moved da CN) |
Documentação da API
Referência completa da API → docs/API.md
Notas de auditoria de segurança → docs/skills-sh-audit.md — por que skills.sh mostra "Critical Risk", e a qual recurso real do produto cada aviso corresponde
Cobre:
- Todos os endpoints HTTP (
/fetch,/search,/screenshot,/video,/pdf,/download,/render_markdown,/v1/scrape,/flow/run,/doctor, os endpoints de sessão) - Variáveis de ambiente, códigos de erro, exemplos de scraping por site
Integrando com Outros Sistemas
AginxBrowser é infraestrutura pura de anexação paralela — como um navegador real, ele roda como um serviço independente que qualquer coisa pode chamar, sem incorporar código do host ou poluir a configuração do host. Implante uma instância por máquina (sob systemd) e todos os aplicativos que precisam de capacidade de "renderizar + raspar" a compartilham.
O ponto de anexação é HTTP — /fetch, /search, /screenshot, /download, /render_markdown para qualquer linguagem com um cliente HTTP.
Integração: leia a variável de ambiente AGINXBROWSER_URL=http://127.0.0.1:8089. Não definida → comportamento inalterado; definida → sites com controle de risco automaticamente roteiam pelo AginxBrowser para renderização, com fallback gracioso em caso de falha.
Limitações Conhecidas
- Capturas de tela são opcionais:
/screenshotrequercargo build --release --features screenshot(adiciona a pilha de renderização diting). O mecanismo de renderização padrão (e único) nessa compilação é o diting — nossa própria pilha de CSS+layout+pintura, zero código Blitz/Stylo. O pipeline de referência Blitz de revisão fixa é um opt-in separado,--features blitz-reference, para renderizações de comparação e os testes de verificação cruzada de dois mecanismos. O CSS de sites complexos é aproximado em ambos (não pixel-perfect como o Chromium) - Coordenadas de elementos suportadas:
/screenshotcomselectorretorna coordenadas de página do elemento (selector_rects, px CSS);selectorsozinho recorta diretamente para esse elemento. Elementos inline (<a>text</a>) também recebem um retângulo no mecanismo diting padrão — uma união de seu conteúdo inline achatado, expandido por strut para o próprioline-heightdo elemento, como o Chrome relata para inlines somente substituídos (<a><img></a>→ altura da caixa de linha, não a altura da imagem). Inlines vazios ainda não têm retângulo — escolha um ancestral de bloco nesse caso - Interação JS funciona amplamente; páginas com fingerprint pesado podem ainda falhar: A delegação de eventos React/Vue funciona normalmente (atributos de reflexão de URL como
src/hrefresolvem para URLs absolutas, então Next.js/webpack hidratam e cliques disparam manipuladores). Páginas de autenticação com fingerprint pesado (WorkOS/Cloudflare) que sondamnavigator.plugins, canvas WebGL etc. podem ainda quebrar até que a cobertura de fingerprint furtivo seja concluída - Suporte a proxy: HTTP/HTTPS/SOCKS5 via
AGINXBROWSER_PROXY - Sites com controle de risco difícil: Baidu Wenku não suportado; artigos do Zhihu precisam de um
__zse_ckválido
Histórico de Estrelas
Se o AginxBrowser salvou você de uma frota de headless-Chrome ou de uma dor de cabeça com raspagem, uma estrela é como outros agentes (e seus humanos) encontram o projeto.
Licença
Apache-2.0.