SuperLocalMemory V2
Memória persistente universal e local para assistentes de IA. Grafo de conhecimento baseado em SQLite sem dependências de nuvem. Funciona com mais de 17 ferramentas (Claude, Cursor, Windsurf, VS Code, etc.). 100% gratuito para sempre.
Documentação
O cérebro de memória governado para cada agente de IA. Ele vive na sua máquina. Ele nunca inventa.
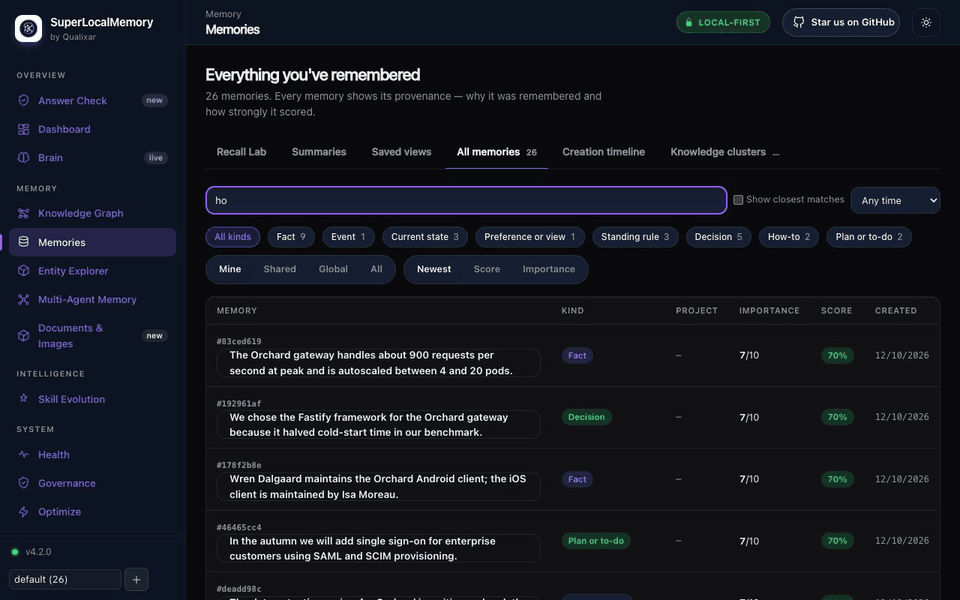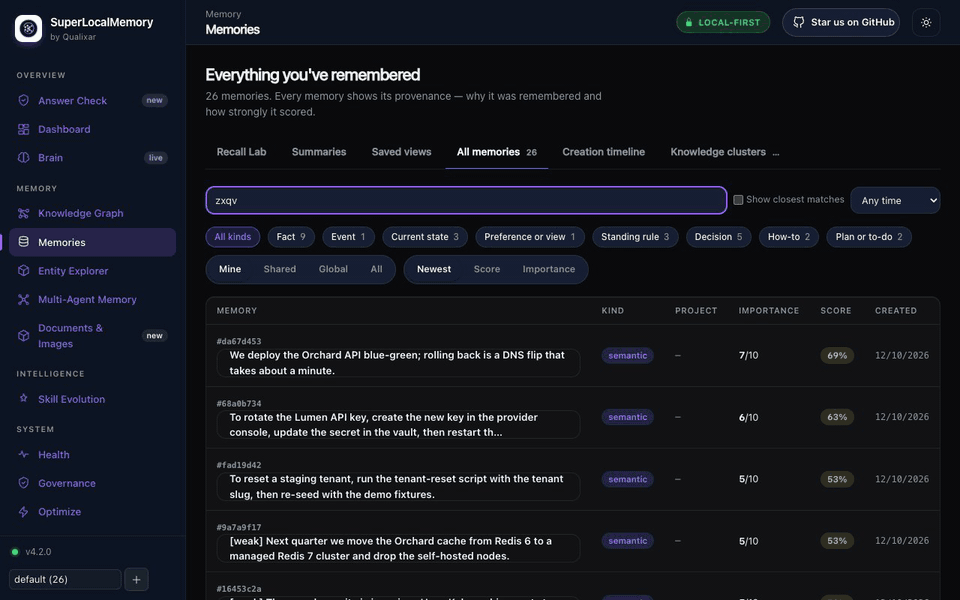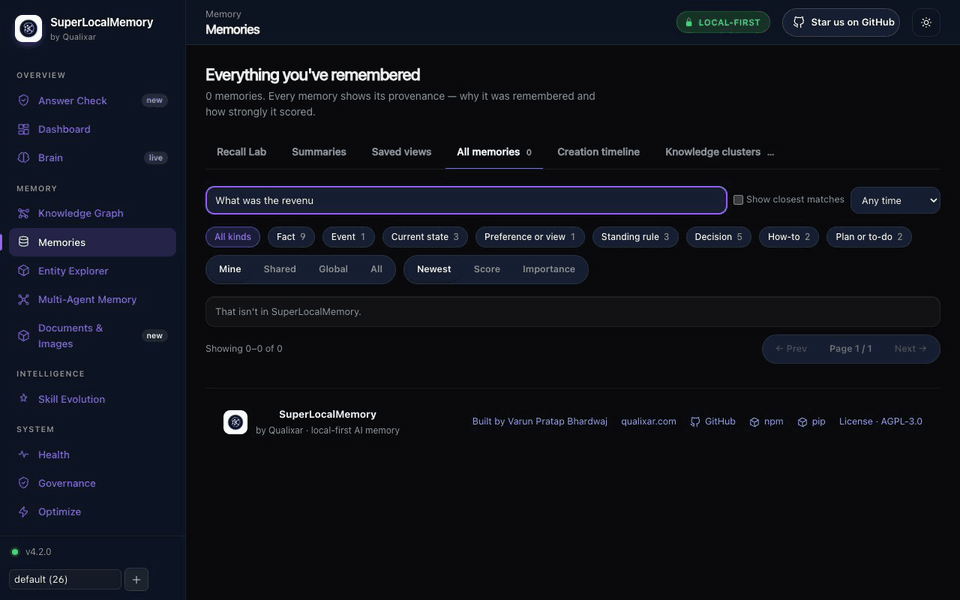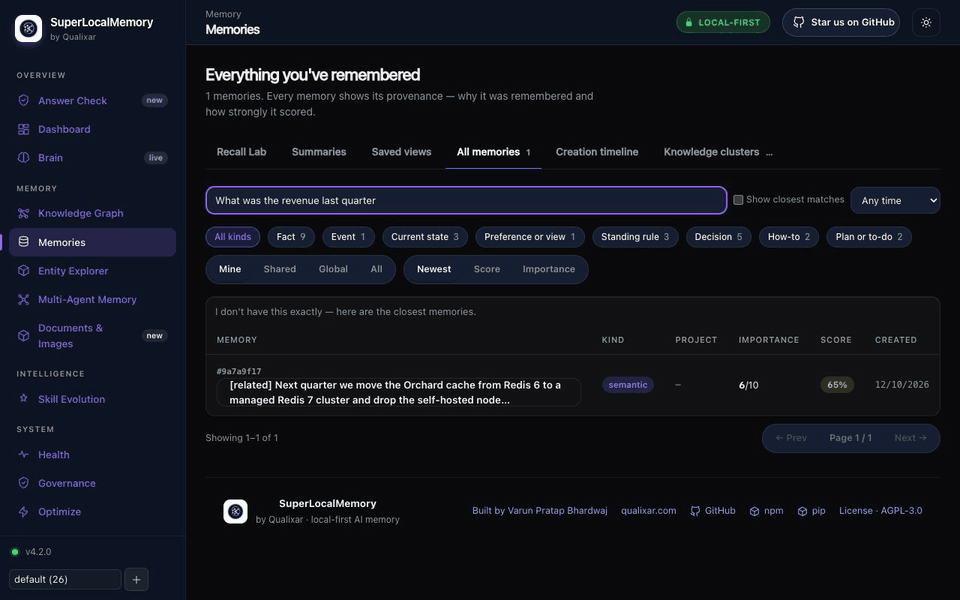
Uma memória para cada agente que você e sua equipe usam — Claude Code, Codex, Cursor, Copilot, Antigravity, Hermes, ChatGPT, Claude na web, Grok Bot, Muse e qualquer ferramenta que fale MCP ou execute um comando. Decisões, documentos, capturas de tela e PDFs, recuperados do jeito que você pede, governados como dados de empresa, compartilhados por uma malha onde seus agentes locais e bots da web conversam entre si, e respondidos com honestidade: quando a resposta não está lá, seu agente ouve "Isso não está no SuperLocalMemory." — não um palpite confiante.




Instalar · Ver funcionando · Demonstração completa · Todos os recursos · Documentação · Site
⭐ Se o SuperLocalMemory impede que seus agentes inventem, dê uma estrela no repositório. Isso ajuda outros desenvolvedores a encontrá-lo.
Agentes esquecem tudo entre sessões. A correção usual — um armazenamento vetorial com um botão de salvar — piora a situação: ele sempre retorna algo, mesmo quando nada do que contém responde à pergunta, e seu agente constrói em cima disso. Isso é um cérebro de memória, não um balde: ele entende o que foi salvo (quem, o quê, quando, qual projeto), mantém isso verdadeiro ao longo do tempo, governa quem pode ver e se recusa a inventar. Quatro artigos do arXiv descrevem como funciona.
No Modo A, lembrar e recordar essenciais não fazem nenhuma chamada a provedor de modelo: sem chave de API, sem conta na nuvem, sem Docker. Qualquer coisa que envie dados para fora é uma escolha sua, e a documentação diz exatamente o que sai.
Instalação
A maneira mais fácil: deixe seu agente de IA instalar. Copie o bloco abaixo no Claude Code, Codex, Cursor ou qualquer agente que possa executar comandos. Ele lê o guia de configuração, faz uma pergunta, configura tudo e informa o que funciona. Sem comandos de terminal para você aprender.
Install SuperLocalMemory on this computer for me. Follow
https://github.com/qualixar/superlocalmemory/blob/main/SETUP_FOR_AGENTS.md
step by step and show me what each step printed. Ask me only one question,
before turning on anything optional: whether I also want to find my pictures,
screenshots and PDFs by describing them. Connect SuperLocalMemory to the agent
I am using. When you finish, run slm doctor and tell me in plain words what works.
Sem agente de IA? Uma linha no Terminal (macOS e Linux). Ele traz seu próprio Python, configura tudo, conecta as ferramentas de IA que encontra e abre o painel; sem necessidade de Python ou npm pré-instalados:
curl -fsSLo get-slm.sh https://raw.githubusercontent.com/qualixar/superlocalmemory/main/scripts/get-slm.sh && sh get-slm.sh
Adicione imagens e documentos desde o início com sh get-slm.sh --media no final. Ele baixa o script primeiro, para que você possa lê-lo antes de executar. Windows: use o prompt do agente acima, ou npm ou pip abaixo.
Prefere o terminal? Ambas as rotas terminam na mesma configuração: sua memória de texto nesta máquina e, se você disser sim, suas imagens e documentos também.
npm, a rota principal (Node 18+). Ele instala o SLM em um ambiente virtual de propriedade do pacote:
npm install -g superlocalmemory   # add --media to also turn on pictures and documents
slm setup                         # pick Mode A to keep everything on this machine
slm connect claude-code           # or codex, cursor, windsurf, zed, claude-desktop, jetbrains, opencode ...
pip, a outra rota principal (Python 3.12 a 3.14), em um ambiente virtual Python que você ativa:
python3 -m venv .venv
source .venv/bin/activate         # Windows: .venv\Scripts\activate
python -m pip install superlocalmemory   # or, without a venv: pipx install superlocalmemory
slm setup
slm connect claude-code
slm media enable                  # optional: pictures and documents (about 1.5 GB; needs 16 GB of memory)
uv: uv tool install --python 3.12 superlocalmemory instala slm como uma ferramenta isolada, sem nada para ativar; veja instalação no Linux.
Plugin do Claude Code: claude plugin marketplace add qualixar/superlocalmemory, depois claude plugin install superlocalmemory@qualixar. Codex: slm connect codex, depois slm codex install.
Dois modelos, uma memória. O texto é pesquisado com um pequeno modelo de texto local (nomic). Se você ativar imagens e documentos, um segundo modelo local (EmbeddingGemma 2 do Google) os lê, e uma única recordação retorna ambos. O modelo de imagens é descarregado após 30 minutos sem uso, então ele não mantém memória enquanto você trabalha apenas com texto. Detalhes: imagens e documentos, primeiros passos, etapas de configuração do agente.
Clone do repositório: ./scripts/install.sh install (macOS, Linux) ou .\scripts\install.ps1 -Action Install (Windows). Funciona em Windows, Linux e macOS com Apple Silicon (plataformas).
Exemplo de 30 segundos
$ slm remember "We deploy the API blue-green; rollback is a DNS flip." --kind decision
Queryable ✓ 1 facts
$ slm remember "Staging DB is Postgres 16 on port 5433."

$ slm recall "how do we roll back the API"
  1. [0.67] We deploy the API blue-green; rollback is a DNS flip.

$ slm recall "zxqv plorth wimble"
  That isn't in SuperLocalMemory.

$ slm remember "Staging DB moved to Postgres 17 on port 5434." --replaces <id>
Replaced ✓ 1 fact(s). To undo: slm review-correction ... rollback 1
$ slm recall "which port does staging postgres use"
  1. [0.68] Staging DB moved to Postgres 17 on port 5434.
Saída real de uma instalação nova no Modo A, aparada. As pontuações classificam memórias; não são probabilidades.
Por que SuperLocalMemory: doze superpoderes
1. Ele sabe quando não sabe. Cada recordação retorna em um de três níveis: uma resposta suportada; as memórias mais próximas, rotuladas "Não tenho isso exatamente — aqui estão as memórias mais próximas"; ou "Isso não está no SuperLocalMemory." para bobagens. Logo após iniciar, ele diz que ainda está aquecendo e mostra o que encontrou, para que você nunca ouça "vazio" quando a verdade é "ainda não pronto". Seu agente para de construir em cima da memória errada.
2. Uma segunda opinião que nunca sai do seu Mac. No Apple Silicon, o SLM instala Laya, um pequeno modelo no dispositivo que julga se as memórias encontradas realmente respondem à pergunta. Prefere a nuvem, ou não está em um Mac? Jev faz a mesma verificação online, somente depois que você marca seu consentimento.
3. Seus documentos e capturas de tela se tornam uma base de conhecimento que você pode consultar. Salve uma foto, uma captura de tela ou um PDF e encontre semanas depois descrevendo-o — "o slide com os números trimestrais". O modelo de imagens é  EmbeddingGemma 2 do Google, rodando no seu computador: um modelo lê tanto suas palavras quanto suas imagens, então uma descrição encontra a imagem. O OCR também roda localmente, cada página de PDF é indexada por sua imagem e seu texto, e cada resposta cita seu arquivo e página. Nenhum modelo generativo jamais olha seus arquivos.
4. A ideia de LLM-wiki do Karpathy, integrada — com busca mantida. O padrão LLM-wiki de Andrej Karpathy transforma documentos brutos em uma base de conhecimento organizada com um índice e uma verificação de saúde. O SLM faz isso a partir dos dados que já armazena — um índice de documentos de cada arquivo com suas pessoas, projetos e datas, e uma verificação de saúde de documentos que encontra páginas vazias, documentos não vinculados, páginas duplicadas e fatos contraditórios — enquanto mantém busca híbrida real para o momento em que você precisa encontrar algo.
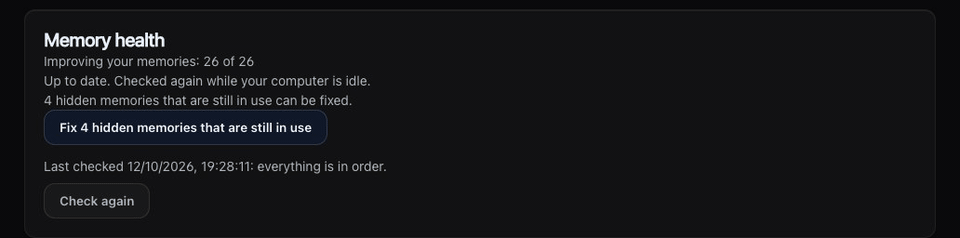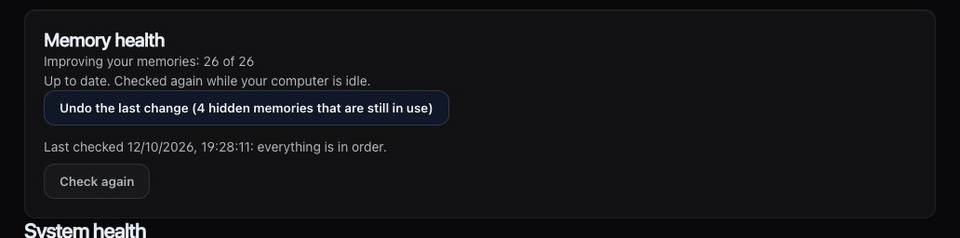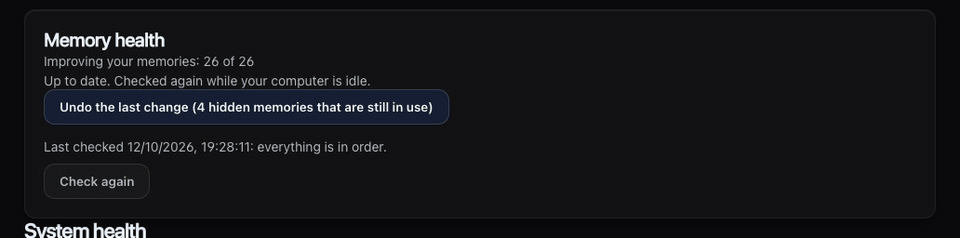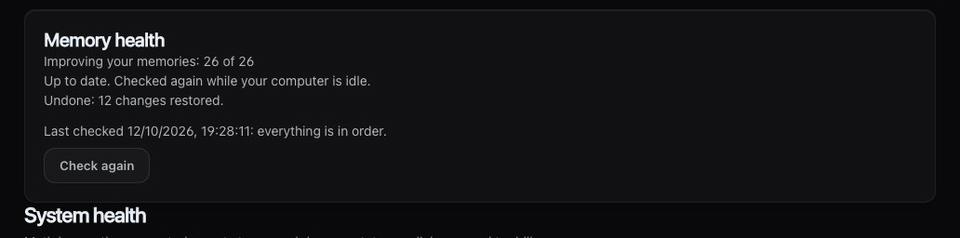
5. Ele cuida de si mesmo. Saúde da memória descreve suas memórias mais antigas em segundo plano — datas, nomes, projetos, tipos — apenas adicionando, nunca tocando no que você escreveu. Qualquer coisa que mova ou exclua espera pelo seu Corrigir, e Desfazer coloca de volta.
6. Governado, não apenas armazenado. Cada salvamento passa por uma verificação de admissão e recebe um recibo. Cada leitura respeita papéis, espaços de trabalho e escopos. Cada apagamento alcança todas as cópias — resumos, caches, índices, espelhos de imagens — e vem com um recibo verificável. Cada ação cai em uma trilha de auditoria encadeada por hash. Construído para equipes e para o GDPR, não adaptado.
7. Memória com senso de tempo. Cada fato sabe quando aconteceu e quando o SLM o aprendeu. Pergunte o que era verdade no mês passado, ou o que o SLM sabia antes de uma data. Correções substituem um fato e permanecem desfazíveis; memórias não utilizadas desaparecem como a memória humana.
8. Ele nunca inunda sua janela de contexto. Recordação em camadas dá ao agente uma olhada de uma linha, os fatos ou o contexto completo ao redor — sob um orçamento rígido de tokens que ele define. O agente aprofunda com expand somente quando precisa, e cache e compressão reversível impedem que você pague duas vezes pela mesma saída.
9. Muitos agentes, um cérebro. Cada escrita registra qual agente a fez, com pontuações de confiança contra envenenamento de memória, para que dez agentes possam compartilhar uma memória sem envenená-la.
10. Seus agentes conversam entre si — até pela internet. Através do SLM-Mesh, os agentes no seu computador e os bots na web finalmente compartilham uma conversa. Sessões do Claude Code, Codex e Hermes trocam mensagens, esperas, bloqueios e estado compartilhado, em uma ou várias máquinas, para que um agente possa passar trabalho para outro e dois nunca editem o mesmo arquivo ao mesmo tempo. E os bots que você permite — ChatGPT, Claude na web, Grok Bot, Muse — entram na mesma malha: um bot no seu navegador pode enviar mensagem ao agente no seu laptop pelo nome e ler sua resposta. Cada mensagem chega rotulada como dado, nunca como instrução; um bot da web lê novas mensagens quando seu próximo turno começa.
11. Ele aprende todos os dias e não pode piorar silenciosamente. Cada resultado relatado o ensina: a classificação aprende quais memórias realmente ajudaram, hábitos estáveis se tornam prompts suaves para novas sessões, e habilidades de agente são medidas e revisadas. Um novo classificador é promovido somente com uma vitória estatisticamente válida e revertido automaticamente se cair. O trabalho roda como loops limitados que terminam somente quando uma porta independente passa — nunca na palavra de um agente — e pipelines de múltiplas etapas rodam como grafos limitados com Loops Limitados, cujas execuções concluídas o SLM mantém como evidência somente leitura.
12. Ciência, não achismo. Quatro artigos do arXiv respaldam cada camada: recuperação por geometria da informação, esquecimento inspirado biologicamente, confiança bayesiana contra envenenamento de memória e memória governada com custos medidos. A matemática central roda sem modelo de linguagem, e os benchmarks publicados declaram exatamente como foram medidos.
O SuperLocalMemory faz parte do trabalho de Confiabilidade de Engenharia de IA da Qualixar: memória de agente que é observável, limitada e honesta sobre o que não sabe.
Veja funcionando
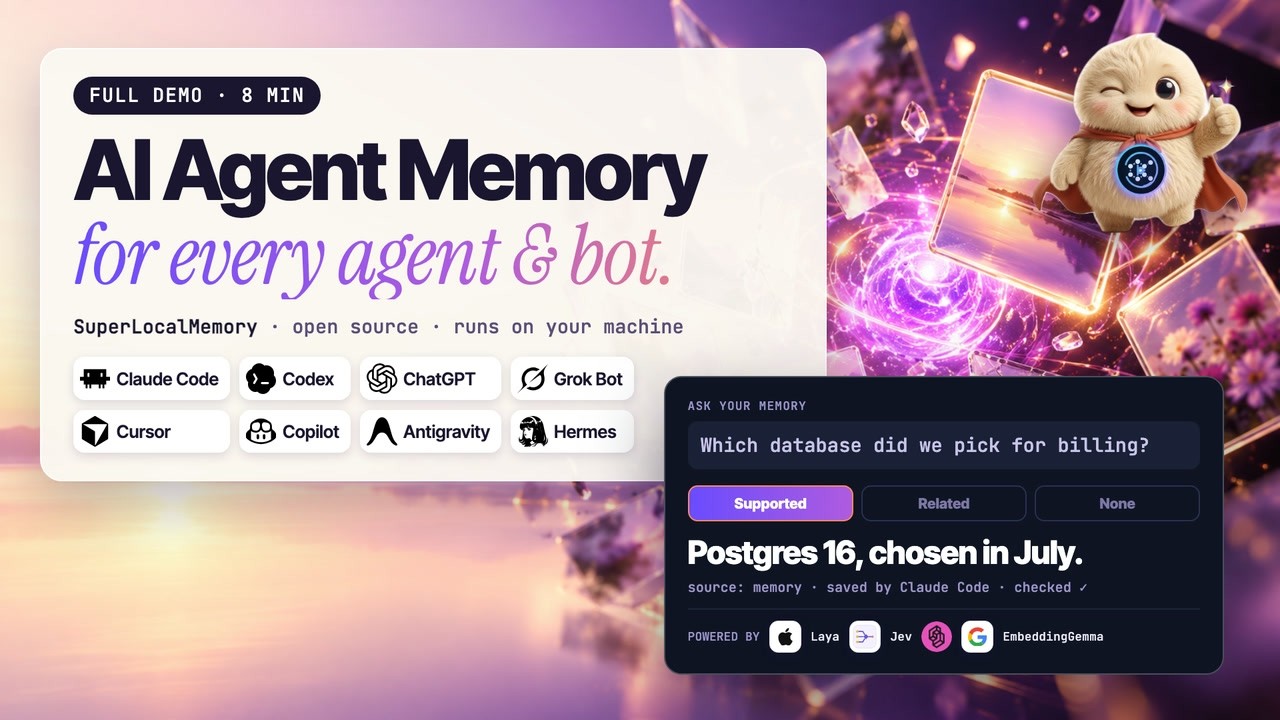
A demonstração completa de oito minutos: uma memória compartilhada por seus agentes de codificação e bots, em cada aba.
Adicione SuperLocalMemory ao seu aplicativo
Você não precisa esperar por uma loja de aplicativos. Cada aplicativo abaixo pode receber o SuperLocalMemory diretamente deste repositório GitHub, qualixar/superlocalmemory, em dois passos.
Passo 1, uma vez por computador. Instale o SuperLocalMemory: npm install -g superlocalmemory (ou pipx install superlocalmemory). Sua memória vive neste computador a partir de então.
Passo 2, em cada aplicativo que você usa:
| Seu aplicativo | O que fazer |
|---|---|
| Claude Code (terminal e aplicativo de desktop) | Digite /plugin marketplace add qualixar/superlocalmemory, depois /plugin install superlocalmemory@qualixar |
| Claude Desktop | Execute slm connect claude-desktop, depois reinicie o Claude Desktop |
| ChatGPT, Claude na web, Muse, Composio | Abra o painel (slm dashboard) → Acesso web → ative, depois adicione o link mostrado como conector nesse aplicativo (passo a passo) |
| Codex (terminal e aplicativo de desktop) | Execute codex plugin marketplace add qualixar/superlocalmemory --ref main, depois codex plugin add superlocalmemory-codex@qualixar |
| Cursor (editor e janela Agents) | Execute slm connect cursor, depois reinicie o Cursor |
| VS Code (chat do Copilot no editor) | Instale a extensão SuperLocalMemory (.vsix do último lançamento: Extensões → ... → Instalar do VSIX) |
| Janela Agents do VS Code, GitHub Copilot CLI | Execute slm connect copilot-cli; para as habilidades, adicione qualixar/superlocalmemory na tela de Plugins da janela Agents |
| Antigravity | Execute agy plugin install "$(npm root -g)/superlocalmemory/antigravity-plugin" |
| Grok CLI | Execute grok plugin install 'qualixar/superlocalmemory#plugin' |
| Grok Bot | Na tela de Plugins do Grok, adicione o marketplace qualixar/superlocalmemory e adicione superlocalmemory |
| Muse CLI | Execute slm connect muse, depois muse plugins install "$(npm root -g)/superlocalmemory/muse-plugin" e muse plugins approve superlocalmemory |
| Hermes (terminal e aplicativo de desktop) | Execute hermes plugins install 'https://github.com/qualixar/superlocalmemory.git#hermes-plugin', depois slm upgrade-hosts --host hermes --apply |
| OpenClaw | Execute slm connect openclaw |
| Windsurf, Zed, JetBrains, Gemini CLI, OpenCode, Continue | Execute slm connect <app>, por exemplo slm connect windsurf |
| Qualquer outra coisa que fale MCP | Adicione um servidor com o comando slm e o argumento mcp |
Reinicie o aplicativo após adicionar o SuperLocalMemory. Depois pergunte algo como "O que você lembra sobre este projeto?" O guia de plugins tem os detalhes para cada aplicativo, e slm doctor verifica sua configuração.
Funciona com seus agentes
Cada ferramenta, cada bot, uma memória. Qualquer ferramenta que fale MCP (slm mcp, ou http://127.0.0.1:8765/mcp/) ou possa executar um comando (slm remember, slm recall) pode usar o SuperLocalMemory. Os plugins empacotados são exemplos prontos, não um limite.
| Host | Conexão | O que você obtém |
|---|---|---|
| Claude Code | claude plugin install superlocalmemory@qualixar | MCP, 16 habilidades, 4 agentes, /slm-loop, hooks de sessão e recall |
| Codex | slm connect codex, depois slm codex install | MCP, 16 habilidades, 4 agentes, /slm-loop, hooks de ciclo de vida |
| GitHub Copilot (VS Code, Visual Studio, JetBrains, CLI) | slm connect vscode-copilot --here | MCP, regras de agente, 16 prompts, 4 agentes, hooks |
| Antigravity | agy plugin install o plugin incluído | MCP, 16 habilidades, 4 agentes, /slm-loop, hooks |
| Hermes | Plugin nativo, depois slm upgrade-hosts --host hermes --apply para conceder a ele o servidor de memória | 16 habilidades, agentes consultores, /slm <command>, hooks de recall e sessão |
| VS Code | A extensão SuperLocalMemory (.vsix na página de lançamento) | O servidor de memória na lista de ferramentas do agente, nada para editar |
| Grok CLI | slm connect grok-cli, depois grok plugin install o plugin incluído | MCP, 16 habilidades, 4 agentes, hooks de sessão e recall |
| Janela de Agentes do VS Code, GitHub Copilot CLI | slm connect copilot-cli; habilidades e agentes da tela de Plugins | MCP, 16 habilidades, 4 agentes |
| OpenClaw | slm connect openclaw | MCP e 14 habilidades |
| Muse CLI | slm connect muse, depois muse plugins install o plugin incluído | MCP, 16 habilidades, 4 agentes, /slm-loop, hooks de sessão e recall |
| Grok Bot e hosts no formato Cursor | Adicione o marketplace de plugins qualixar | Um plugin enxuto construído para computadores de bot compartilhados (guia) |
| Cursor, Windsurf, Zed, JetBrains, Gemini CLI, Claude Desktop, OpenCode, Continue | slm connect <name> | MCP na configuração própria da ferramenta |
| ChatGPT, Claude na web, Muse, Composio | Acesso Web opcional no painel: faça login por aplicativo, somente leitura ou leitura e salvamento, remova qualquer aplicativo imediatamente | Sua memória local, a partir da web; o banco de dados nunca sai do seu computador (guia) |
| LangGraph, LangChain, LlamaIndex, CrewAI, AutoGen, Semantic Kernel, Microsoft Agent Framework, Google ADK, OpenAI Agents | Adaptadores de framework | Memória dentro do seu próprio código (adaptadores) |
| Qualquer outra coisa | Cole as regras universais de agente e forneça a CLI ou MCP | Disciplina de memória para qualquer agente |
O que os plugins ensinam ao seu agente. Cada plugin é construído a partir de uma única fonte, então cada host recebe as mesmas 16 habilidades (recall, lembrar, sessões, governança, escopos e perfis, o grafo de conhecimento, mesh, loops limitados, cache, compressão, acesso Web, imagens e duas para computadores de bot) e 4 agentes (um consultor de memória, um consultor de otimização, um consultor de governança e um executor de loop). Hooks são executados no início da sessão, após o uso de ferramentas e no final de uma sessão, e cada hook falha abertamente: um problema de hook nunca bloqueia seu agente. Plugins, habilidades e hooks
Tudo o que o SLM faz
Recall que sabe quando não sabe
| Capacidade | O que você obtém | Documentação |
|---|---|---|
| Três níveis honestos | Suportado; memórias mais próximas (até três, rotuladas); ou "Isso não está no SuperLocalMemory." Hooks que injetam memória automaticamente só injetam respostas suportadas | Recall |
| Aquecimento, dito claramente | Enquanto os modelos carregam, o recall mostra o que a busca por palavras-chave encontrou sob "O SuperLocalMemory ainda está aquecendo — os resultados podem estar incompletos. Tente novamente em alguns minutos." | Recall |
| Recall em camadas | depth 0 (uma olhada de uma linha), 1 (os fatos), 2 (com fonte, vizinhos de sessão, entidades relacionadas e correções); um limite rígido de max_tokens; expand aprofunda em um resultado | Recall em camadas |
| Busca híbrida | Canais semântico, por palavras-chave (BM25), grafo de entidades, temporal, associativo (Hopfield), propagação de ativação e imagem, fundidos e reordenados; slm trace mostra a pontuação de cada canal | Recall |
| Nove tipos de memória | Fato, evento, status, opinião, regra, decisão, como fazer, plano, correção. "O que decidimos" favorece decisões; regras e decisões confirmadas carregam no início de cada sessão | Tipos de memória |
| Viagem no tempo | --valid-at (o que era verdade então), --known-as-of (o que o SLM sabia então), --window 7d | Recall |
| Filtros precisos | Por projeto, agente, assunto, tipo e tags exatas; um resultado vazio explica o motivo | Recall |
| Correções | --replaces aposenta um fato antigo, mantido e desfazível; edições passam por correções revisadas com reversão | Correções |
| Resumos e visualizações salvas | Resumos de sessão, dia e projeto que citam seus IDs de memória; visualizações salvas como "o que entreguei esta semana" | Recall |
| Defesa contra injeção de prompt | Texto recuperado é tratado como evidência não confiável: segredos são mascarados, marcadores forjados neutralizados, proveniência anexada | Segurança |
A verificação de resposta: Laya e Jev
|
Laya — no seu Mac Um pequeno modelo no dispositivo para Apple Silicon (cerca de 1,1 GB). Instalado por padrão pela configuração e oferecido após uma atualização; nada sai da máquina. Opte por não participar com |
A mesma verificação no Windows, Linux ou macOS, através do TypeSafe ou OpenRouter com sua própria chave. Ele envia a pergunta e as três principais memórias, e somente depois que você marcar seu consentimento. Ele nunca se ativa sozinho. |
 Jev — online, qualquer computador
O veredito é uma entrada para a decisão de suporte, com seu próprio orçamento de tempo, e a aba Verificação de Resposta mostra vereditos, tempos e com que frequência a memória não tinha resposta — sem armazenar suas perguntas. Verificação de resposta
Documentos, imagens e suas notas
| Capacidade | O que você obtém | Documentação |
|---|---|---|
| Imagens que você encontra descrevendo-as | PNG, JPEG, GIF e WebP. O EmbeddingGemma 2 do Google roda localmente e coloca texto e imagens em um único espaço de busca, então suas palavras encontram a imagem; OCR (Apple Vision no Mac, RapidOCR em outros lugares) torna o texto dentro dela pesquisável; dados de localização nunca são lidos | Imagens e documentos |
| PDFs, página por página | Cada página é indexada por sua imagem e seu texto; cada resposta diz de qual arquivo e página veio, com uma miniatura | Imagens e documentos |
| Índice de documentos | Um catálogo de cada documento salvo com suas páginas e as pessoas, projetos e datas que menciona | Imagens e documentos |
| Verificação de saúde do documento | Encontra páginas sem texto legível, documentos não vinculados a nada, páginas duplicadas e documentos cujos fatos foram contraditos | Imagens e documentos |
| Pastas e cofres Obsidian | slm sources add ~/Notes --kind obsidian espelha Markdown, arquivos canvas, PDFs e imagens na memória, somente leitura, após mostrar o que leria | CLI |
| Do ChatGPT e do seu telefone | Anexe um arquivo no ChatGPT, ou peça a qualquer aplicativo web conectado um link de upload único que transmite o arquivo diretamente para seu computador | Acesso Web |
| Seus dados permanecem seus | Imagens vivem em seu próprio armazenamento e nunca saem do seu computador; apagar uma memória apaga sua imagem. Desativado por padrão, um clique para ativar; requer 16 GB de memória | Conformidade |
Saúde da memória
| Capacidade | O que você obtém | Documentação |
|---|---|---|
| Descrição automática | Enquanto seu computador está ocioso, memórias mais antigas recebem datas de eventos, nomes, projetos, tags e tipos preenchidos — apenas adicionando, nunca editando o que você escreveu, e nunca sobrescrevendo um valor que você definiu | Saúde da memória |
| Corrigir e Desfazer | Reparos que movem ou excluem qualquer coisa — links de entidades inúteis, memórias ocultas ainda em uso, salvamentos que não terminaram — aguardam seu Corrigir; cada execução pode ser desfeita | Saúde da memória |
| Distintivo de stub | Recibos e textos padrão de sessão permanecem listados com um distintivo stub, mas nunca se tornam respostas | Saúde da memória |
| Saúde do armazenamento | slm doctor mostra quão encontráveis e descritas suas memórias estão; slm db integrity e slm db repair (com desfazer) mantêm o armazenamento saudável | Solução de problemas |
O cérebro vivo
| Capacidade | O que você obtém | Documentação |
|---|---|---|
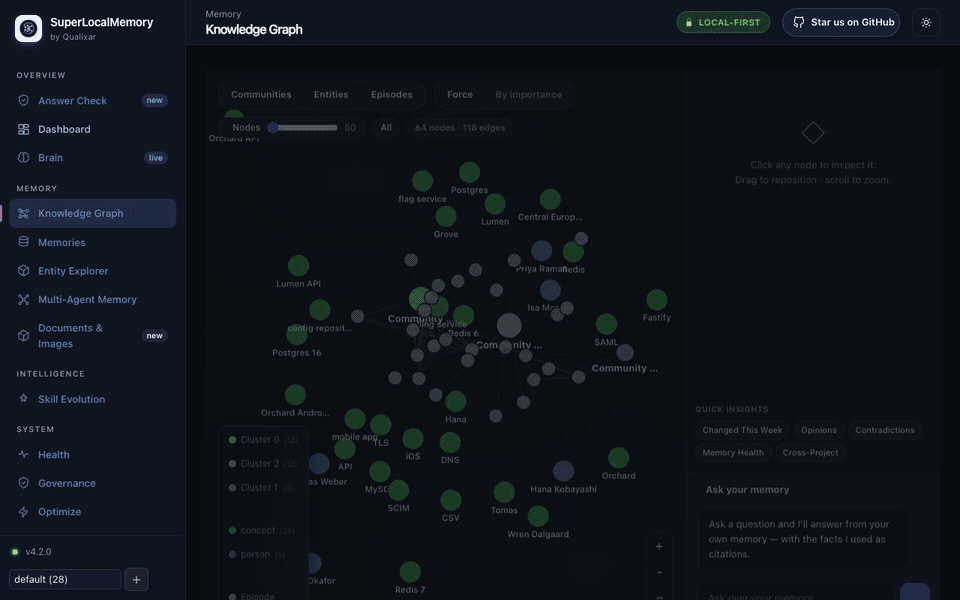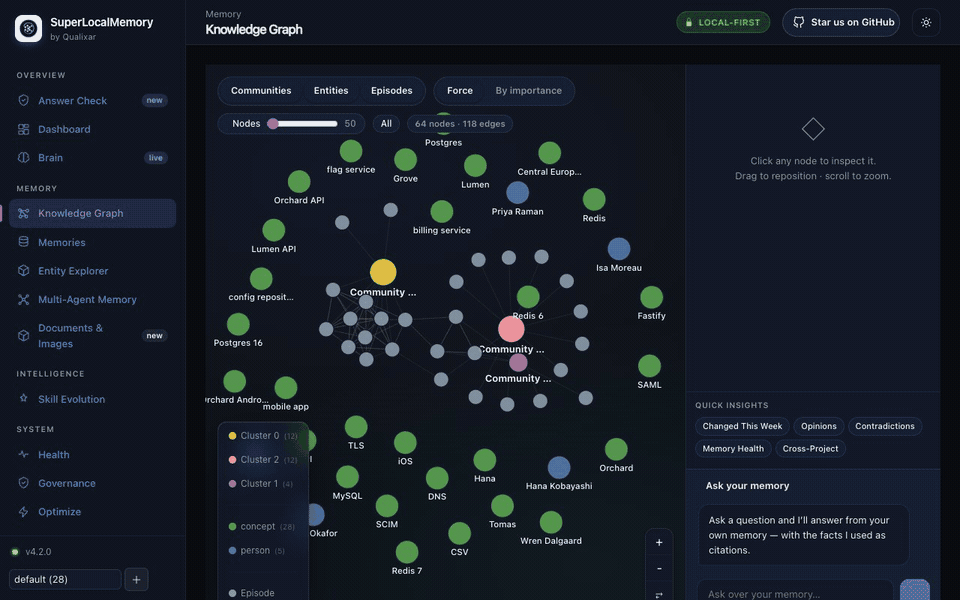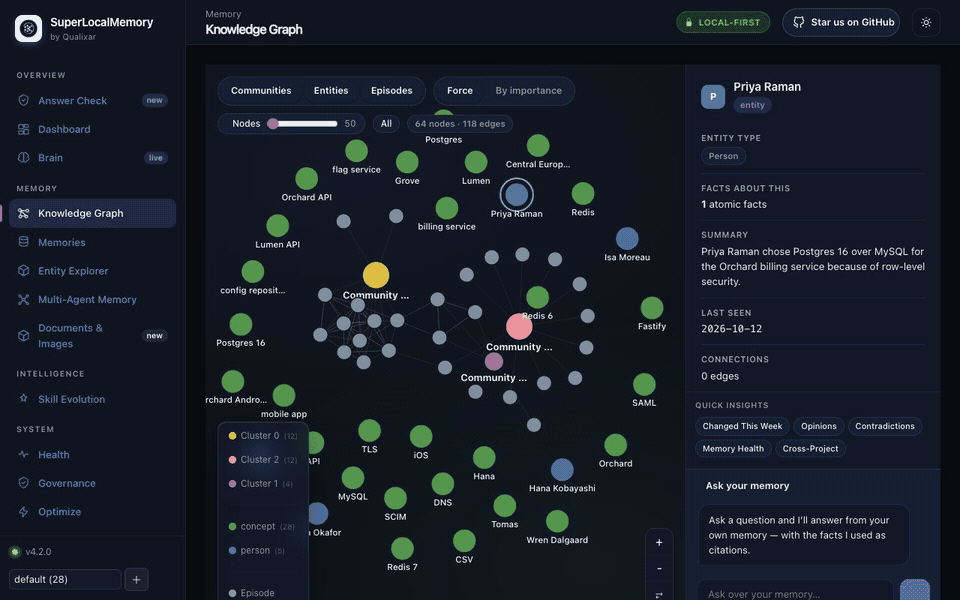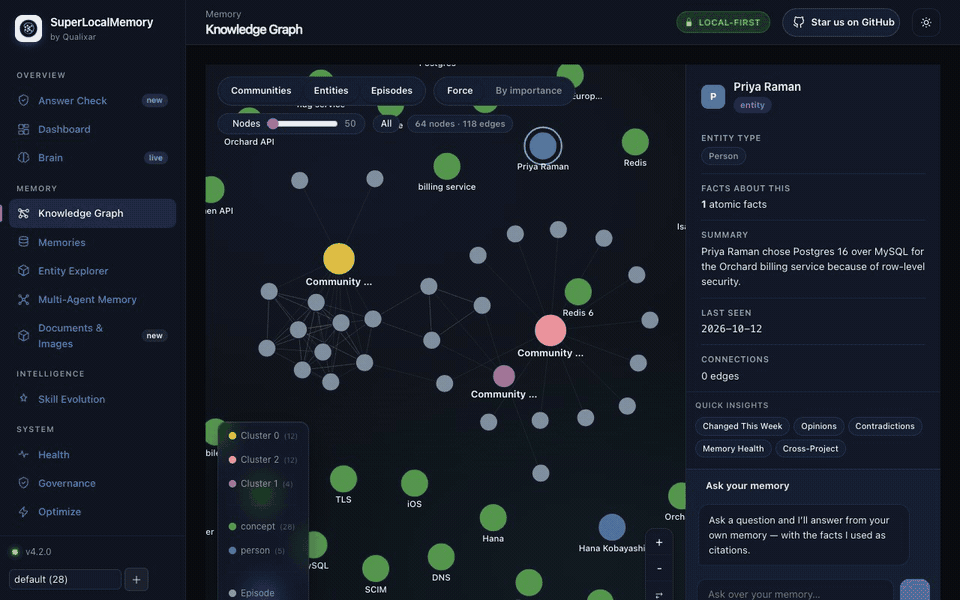
| Grafo de conhecimento | Pessoas, projetos e ferramentas resolvidos a partir de suas memórias, com aliases, cenas e linhas do tempo; o Explorador de Entidades mostra como o que você sabe mudou | Arquitetura |
| Grafo de código | Indexe um repositório e depois pergunte sobre raio de impacto, chamadores e busca de código por significado | Ferramentas MCP |
| Esquecimento que ajuda | Um ciclo de retenção de Ebbinghaus e um ciclo de vida de Langevin movem memórias negligenciadas para o arquivo; memórias em desaparecimento são quantizadas para menos bits e dobradas em um resumo | Pesquisa |
| Aprendizado de ranqueamento (opt-in) | Um bandido e um modelo de aprendizado de ranqueamento aprendem com resultados; um novo ranqueador é promovido apenas em uma vitória estatisticamente válida e revertido automaticamente se piorar | Configuração |
| Prompts suaves e evolução de habilidades (opt-in) | Padrões de comportamento estáveis se tornam prompts suaves para novas sessões; habilidades de agente são medidas e revisadas sob verificação cega | Evolução de habilidades |
Governança e conformidade
| Controle | O que faz | Documentação |
|---|---|---|
| Funções e espaços de trabalho | Administrador, membro e visualizador por espaço de trabalho; uma função em um espaço de trabalho não concede nada em outro; manutenção e aprovações agem apenas onde você está | Equipes |
| Modo empresa | Cada leitura e escrita atribuída a uma pessoa conectada | Modo empresa |
| Escopos | Pessoal por padrão; compartilhado e global somente quando você escolhe; recall entre perfis negado por padrão | Escopos |
| GDPR | Exportação (Art. 15/20) e apagamento (Art. 17) em cada armazenamento e cada cópia derivada, com um recibo verificável | Conformidade |
| Auditoria e retenção | Uma trilha de auditoria encadeada por hash que falha na verificação se adulterada; regras de retenção por perfil; um relatório de postura da Lei de IA da UE | Conformidade |
| Backup e restauração | Backup em nuvem para GitHub ou Google Drive, criptografado antes do upload; um ponto de restauração antes de cada atualização de armazenamento; uma restauração mantém uma cópia de segurança e reverte se falhar | Backup em nuvem, Pontos de restauração |
Controles de engenharia que suportam um programa de conformidade, não uma certificação.
Muitos agentes, uma memória
| Capacidade | O que você obtém | Documentação |
|---|---|---|
| Escritas atribuídas e confiáveis | Cada memória registra seu agente; pontuações de confiança bayesianas defendem contra envenenamento de memória | Pesquisa |
| SLM-Mesh | Mensagens, esperas, bloqueios e estado compartilhado entre sessões, em uma máquina ou várias | Multi-máquina |
| Bots que conversam entre si | ChatGPT, Claude na web, Grok Bot e Muse entram no mesh com sua permissão: liste pares, envie mensagem para um bot nomeado, leia a caixa de entrada. Mensagens chegam rotuladas como dados, nunca como instruções | Mensagens de bot |
| Loops limitados e grafos | "Concluído" significa que um portão independente foi aprovado (testes, um linter, um esquema), nunca a palavra do agente; cada volta é armazenada como memória auditável. Grafos de múltiplas etapas rodam em Loops Limitados, e o SLM mantém suas execuções concluídas como evidência somente leitura | Ponte de Loops Limitados |
Economia de contexto
| Capacidade | O que você obtém | Docs |
|---|---|---|
| Cache exato | Saída de ferramentas e leituras de arquivos armazenadas em cache com TTL; um acerto pula a chamada repetida | Otimizar |
| Compressão reversível | Saídas grandes reduzidas com segurança; o original exato volta por id | Otimizar |
| Três formas de acesso | Funciona por meio de um proxy (slm wrap claude), ferramentas MCP ou uma skill; slm optimize savings mostra o que você salvou | Configuração de proxy |
Modos, painel e escala
| Capacidade | O que você obtém | Docs |
|---|---|---|
| Três modos | A: nenhum modelo de linguagem. B: um modelo nesta máquina (Ollama, onde Google Gemma 3 4B é o padrão e Gemma 4 está no seletor de modelos, ou qualquer servidor local compatível com OpenAI). C: seu próprio endpoint ou um provedor de nuvem | Configuração |
| Painel | Busca, grafo de conhecimento, Entity Explorer, verificação de respostas, saúde da memória, documentos e imagens, aplicativos conectados, mensagens de bots, governança: slm dashboard | Painel |
| Mecanismo de escala | SQLite + sqlite-vec são canônicos; cópias opcionais LanceDB e CozoDB servem apenas quando correspondem ao SQLite | Mecanismo de escala |
| Gravações duráveis | Cada salvamento move bruto → consultável → completo com recibo; falhas mantêm a evidência e tentam novamente; salvamentos de texto sob carga são enfileirados, nunca recusados | Arquitetura |
| Troca de modelo | Altere o modelo de incorporação em segundo plano enquanto a recuperação continua funcionando, com reversão em uma etapa | CLI |
| Acesso remoto na sua rede | slm remote serve memória para outros computadores via TLS, uma chave revogável por cliente | Implantação |
Servidor de memória MCP: perfis de ferramentas
Cada aplicativo, plugin e extensão recebe full (58 ferramentas: toda a memória, SLM-Mesh, otimizar, loops; 5 mais enquanto imagens estiverem ativadas), a menos que você escolha diferente. Isso cabe em hosts que limitam o número total de ferramentas MCP em cerca de 100, com espaço para seus outros servidores. Para alterar isso para todos os aplicativos de uma vez, execute um comando e reinicie seus aplicativos:
slm tools                # current set, and how many tools each set has
slm tools set power      # any name below; `slm tools set default` goes back to full
Para alterar apenas um aplicativo, defina SLM_MCP_PROFILE na configuração MCP desse aplicativo (slm connect <app> --profile <name> escreve); isso vence a escolha salva para esse aplicativo. Detalhes por aplicativo
| Perfil | Ferramentas | Para |
|---|---|---|
core | 19 | Lembrar, recuperar, expandir, sessões, otimizar, revisão de correção |
code | 39 | Núcleo mais grafo de código, tipos de memória, evidência Brain, troca de perfil, loops limitados |
mesh | 9 | Coordenação SLM-Mesh apenas |
full (padrão, quando não definido) | 58 | Memória, tipos, Brain, otimizar, evolução de skills, mesh, loops, visualizações e resumos (63 com imagens e documentos ativados) |
power | 70 | Completo mais administração, ciclo de vida e diagnósticos (75 com imagens e documentos ativados) |
whole | 110 | Todas as ferramentas registradas |
stdio: {"command": "slm", "args": ["mcp"]} · HTTP: http://127.0.0.1:8765/mcp/ · Ferramentas MCP
Veja
| Saúde da memória: Corrigir e Desfazer | Grafo de conhecimento |
|---|---|
 |  |
| Entity Explorer | A verificação de respostas em ação |
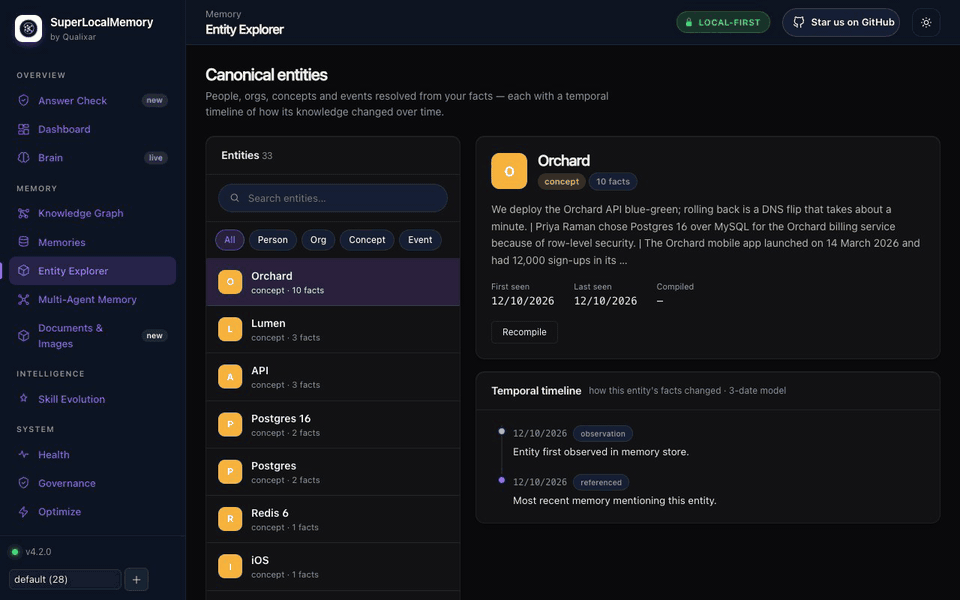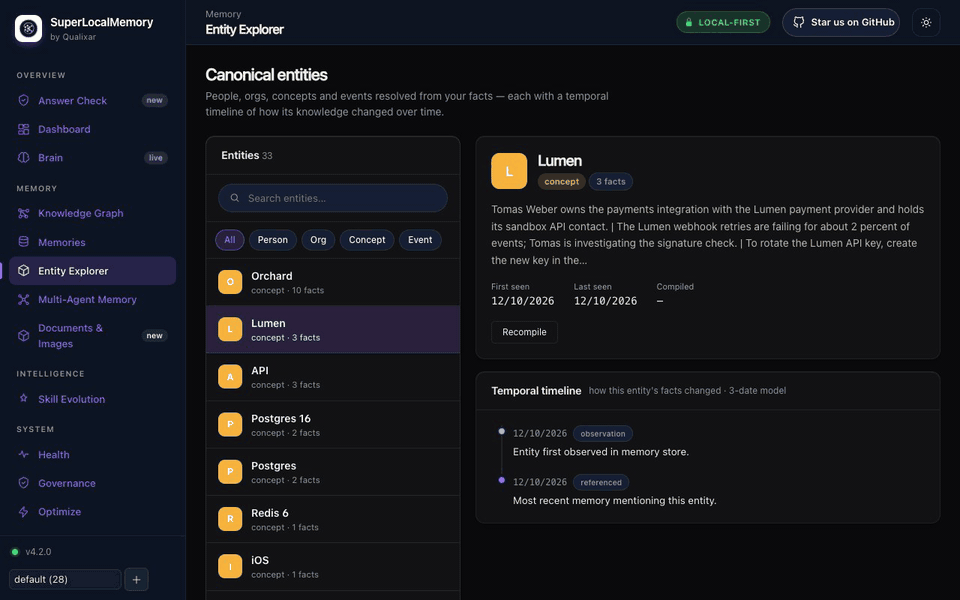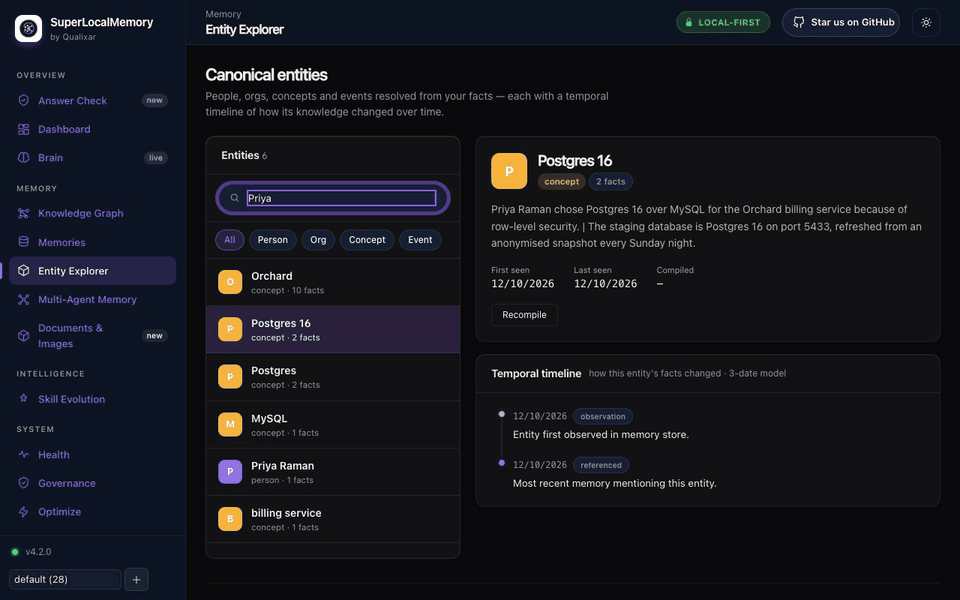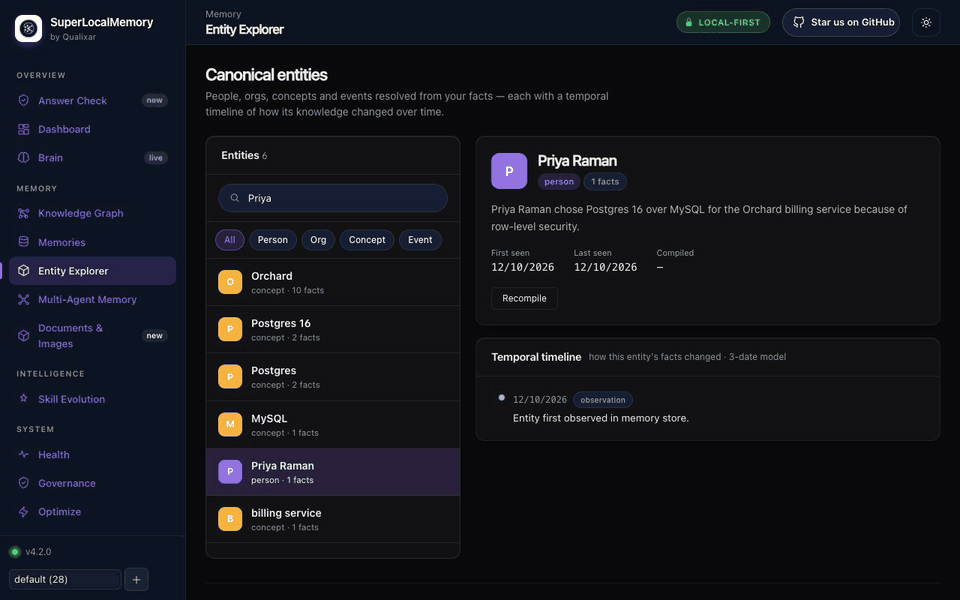 | 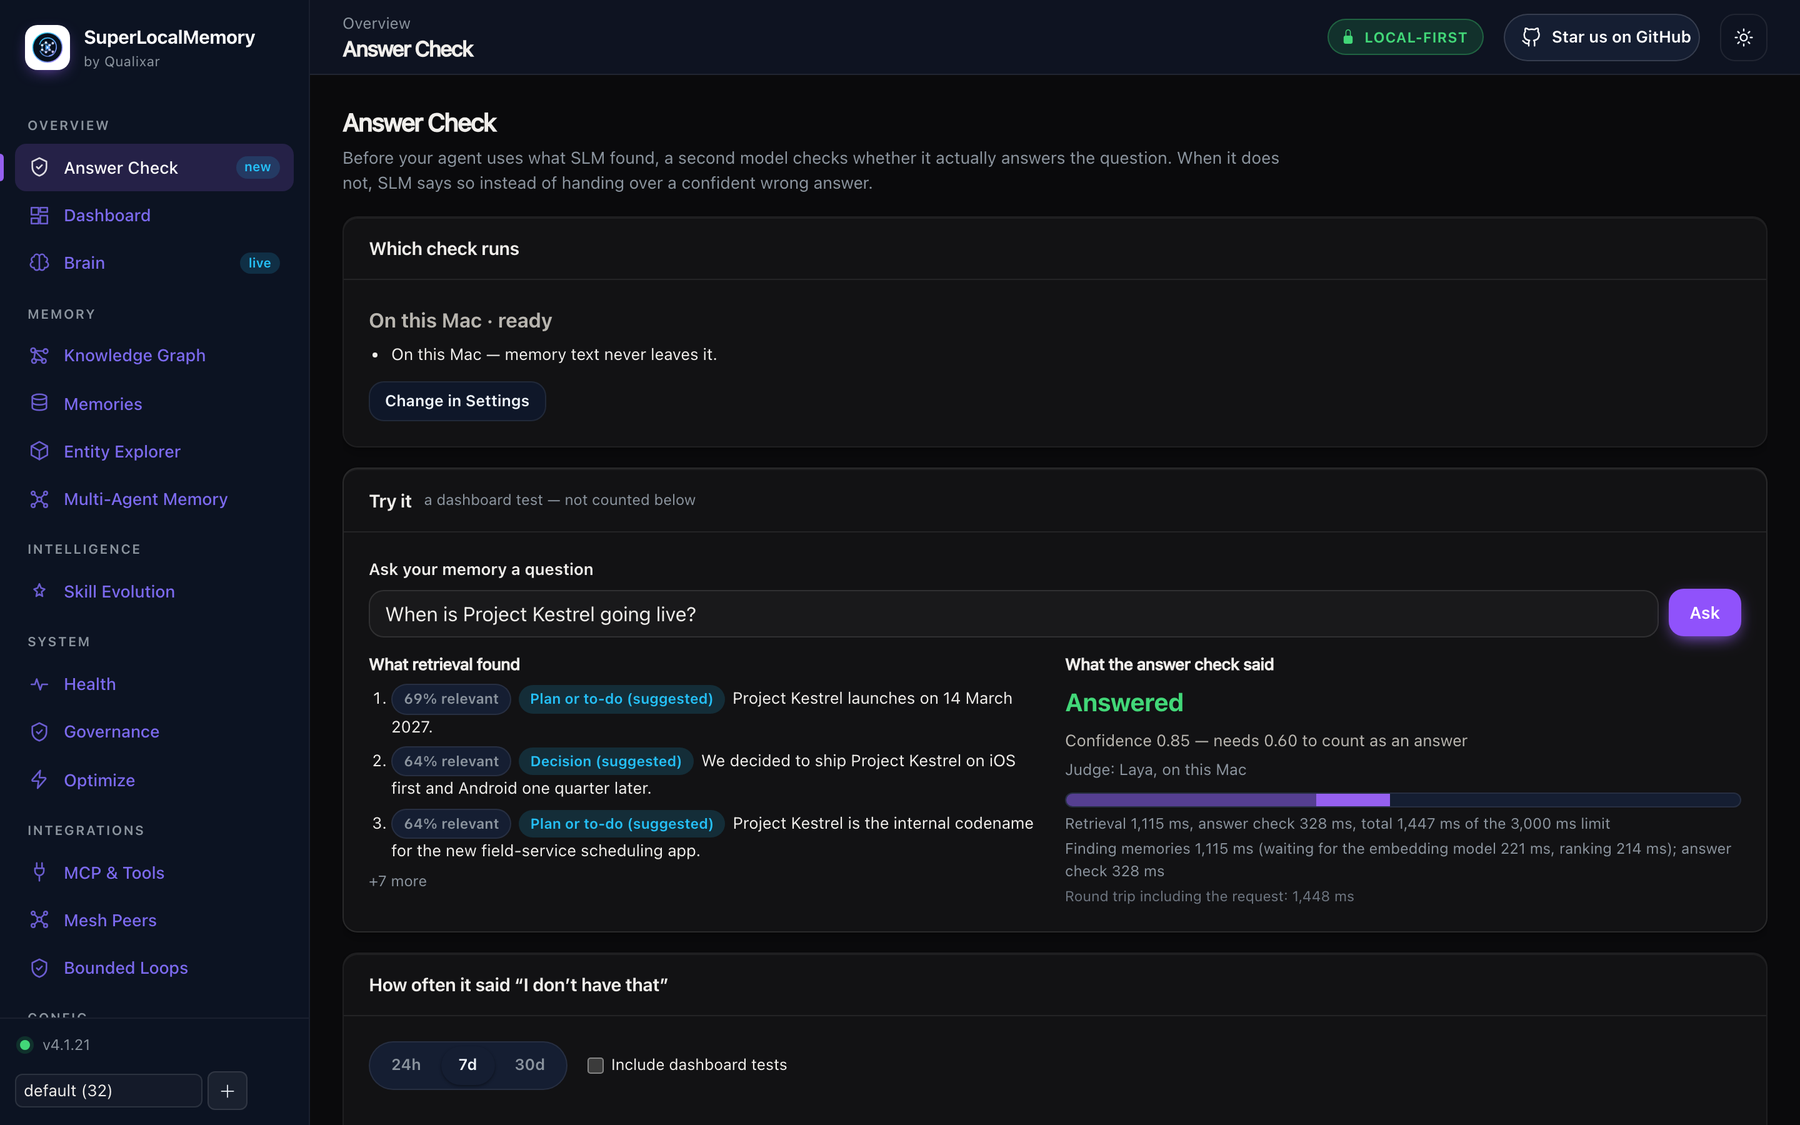 |
Gravado em uma instalação de teste com memórias fictícias. A demonstração completa de oito minutos percorre todos os painéis.
Arquitetura
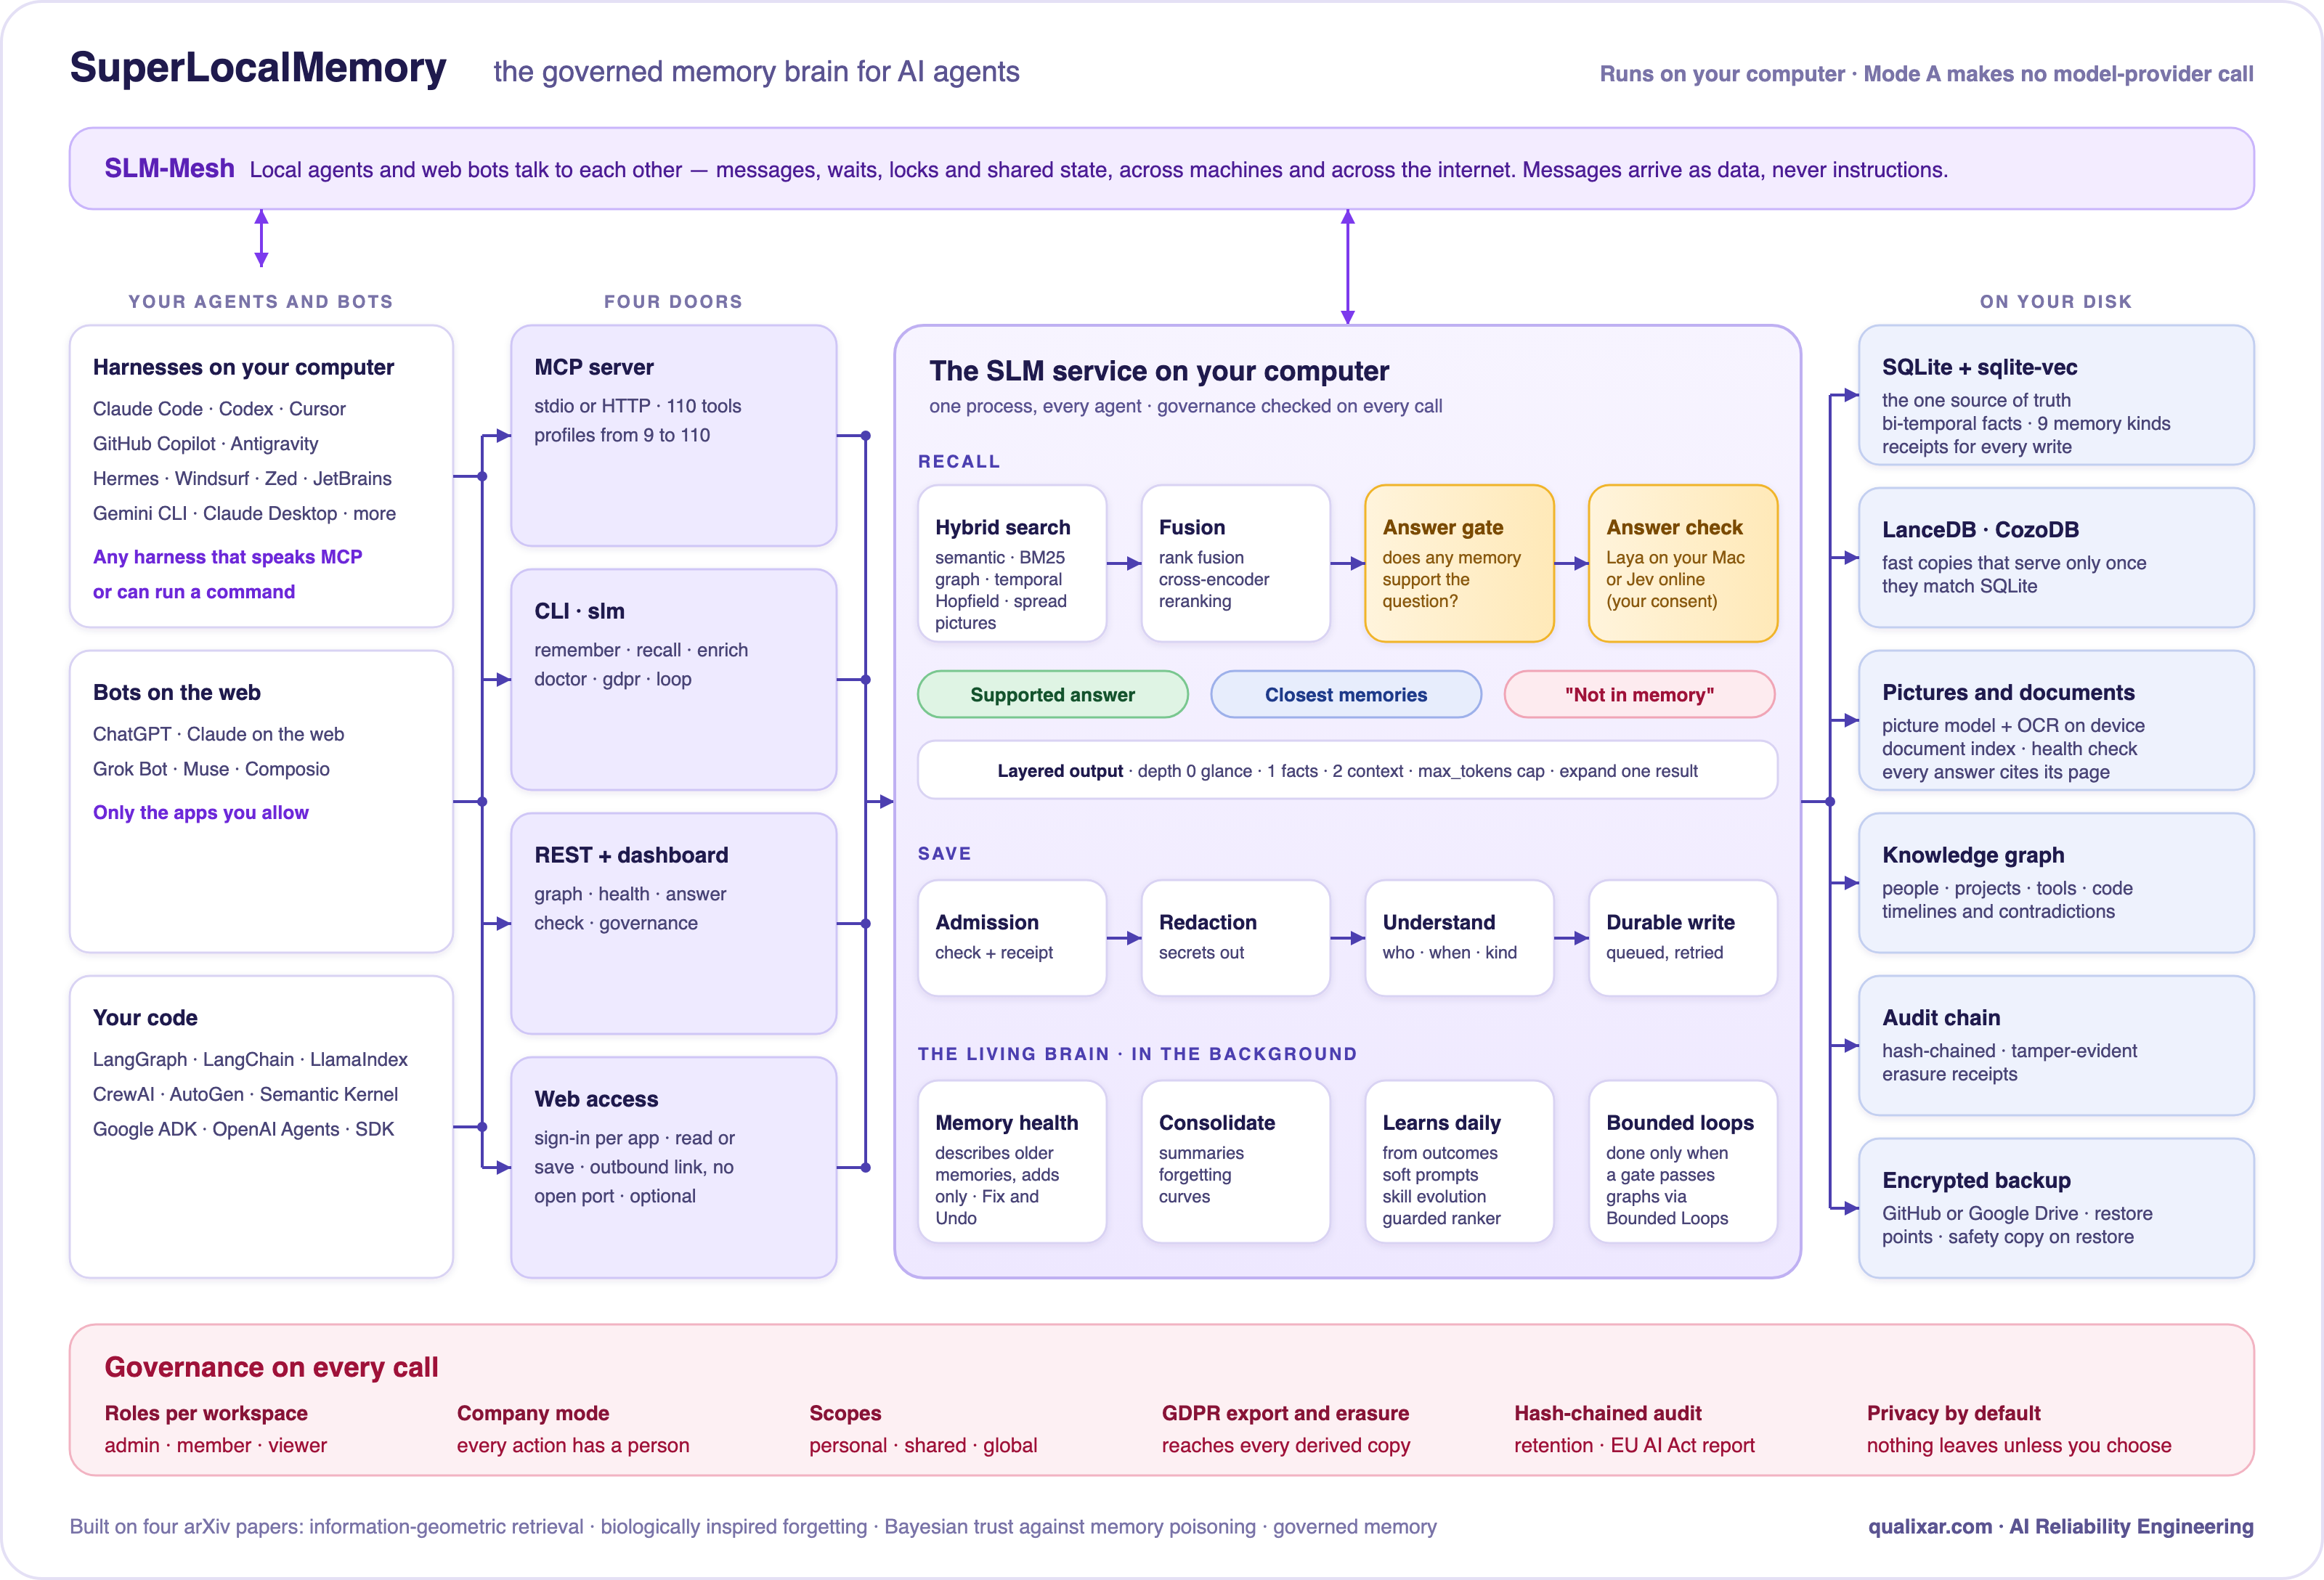
O núcleo local gratuito é completo por si só; o acesso Web é opcional. Arquitetura em detalhes
Privacidade
Nada sai do seu computador a menos que você ative um recurso que envie, e cada um diz exatamente o que vai:
| O que sai | Somente quando |
|---|---|
| Uma pergunta e as três principais memórias | Você ativa o Jev, a verificação de respostas online, e marca seu consentimento |
| Texto de memória | Você escolhe o Modo C, um incorporador ou reranker em nuvem, um modelo em outro computador, ou a digitação de tipos do Jev (com seu próprio consentimento) |
| Arquivos de backup criptografados | Você conecta o backup do GitHub ou Google Drive |
| Mensagens mesh | Você configura peers mesh, ou permite que um aplicativo web envie mensagens aos seus bots |
| Chamadas de ferramentas de aplicativos web | Você ativa o acesso Web e adiciona um aplicativo; o banco de dados permanece no seu computador |
Imagens, documentos, Laya e Modo A nunca enviam nada. Segredos no texto de memória são redigidos em todos os caminhos de saída. Política de segurança
Benchmarks
Esses números vêm do artigo de arquitetura publicado (arXiv:2603.14588), cujo núcleo de recuperação o SLM ainda executa. Eles não são uma execução recente do pacote atual.
| Configuração (artigo de arquitetura) | LoCoMo | Escopo |
|---|---|---|
| Modo A, recuperação + respostas GPT-4.1-mini | 74,8% | 10 conversas, 1.276 perguntas |
| Modo A, bruto (sem LLM em nenhum lugar) | 60,4% | 10 conversas, 1.276 perguntas |
| Modo C, incorporações em nuvem + GPT-4.1-mini | 87,7% | 1 conversa (Conv-30), 81 perguntas |
Uma pontuação LoCoMo é comparável somente quando o subconjunto, o modelo de resposta e o juiz correspondem. Método e ablações
Pesquisa
Quatro preprints arXiv de Varun Pratap Bhardwaj descrevem o SLM:
- SuperLocalMemory 4.0: O Sistema Operacional de Memória Governado para Agentes de IA, com Garima Singh e Arun Pratap Bhardwaj. arXiv:2608.08253
- SuperLocalMemory V3.3: O Cérebro Vivo, arXiv:2604.04514
- SuperLocalMemory V3: Fundamentos de Geometria da Informação para Memória de Agentes Empresariais Zero-LLM, arXiv:2603.14588
- Memória Multi-Agente com Preservação de Privacidade e Defesa Bayesiana contra Envenenamento de Memória, arXiv:2603.02240
Cite com CITATION.cff ou o "Cite este repositório" do GitHub.
Documentação
Início: Começando · Configuração IDE · Plugins · Prova rápida Uso: Recuperação · Saúde da memória · Verificação de respostas · Imagens e documentos · Auto-memória · Acesso Web · Otimizar Referência: CLI · Ferramentas MCP · Configuração · Solução de problemas · Conformidade · Wiki · Notas de versão
Atualização
npm update -g superlocalmemory    # or: pipx upgrade superlocalmemory, uv tool upgrade superlocalmemory
slm restart && slm doctor
slm upgrade-hosts                 # preview plugin and IDE updates; nothing changes until you --apply
Atualizações nunca movem ou excluem memória, e uma atualização de armazenamento cria um ponto de restauração primeiro. Atualizações de host
Suporte de plataforma
| SuperLocalMemory | Laya (verificação de respostas no dispositivo) | |
|---|---|---|
| macOS Apple Silicon | Sim | Sim, instalado por padrão |
| Windows 64 bits | Sim | Não (Jev, a verificação online, funciona) |
| Linux 64 bits (x86-64, ARM64) | Sim | Não (Jev funciona) |
| Intel Mac, Windows 32 bits | Sem instalação pré-compilada | — |
Python 3.12+, Node 18+ para npm. Imagens e documentos precisam de 16 GB de memória.
Histórico de estrelas
Contribuição e licença
Issues e pull requests são bem-vindos: CONTRIBUTING.md. Relatórios de segurança: SECURITY.md. Licenciado sob AGPL-3.0-or-later; para uma licença comercial, veja COMMERCIAL-LICENSE.md.
Construído pela Qualixar
SuperLocalMemory é feito por Varun Pratap Bhardwaj na Qualixar: Engenharia de Confiabilidade de IA — memória, contratos, testes e loops que tornam agentes de IA confiáveis o suficiente para serem encarregados de trabalho real.
Mais fortes juntos. SuperLocalMemory lembra. Jev Decision Layer torna as escolhas limitadas do seu agente tipadas e verificadas. Bounded Loops encerra o trabalho somente quando um portão independente passa. Use-os juntos e a Qualixar dá aos seus agentes todo o ambiente de Engenharia de Confiabilidade de IA: memória em que podem confiar, decisões que podem defender e trabalho comprovadamente concluído.
Se o SLM impede que seus agentes esqueçam, dê uma estrela no repositório. É assim que outros desenvolvedores o encontram.

Mais da Qualixar: Qualixar OS · SkillFortify · SLM Mesh · AgentAssert · AgentAssay · Bounded Loops · Jev Decision Layer · SLM MCP Hub