hypotree
Memória que esquece. Um estado de crença persistente e autorrevisável para P&D agêntico. Poda ramos mortos e deduz respostas sem gastar sondas.
Documentação
Memória Que Esquece


Um DAG de hipóteses persistente e auto-revisável para P&D agêntico — exposto como um servidor MCP e uma API Python.
A memória atual de agentes é passiva: armazenamentos vetoriais e rascunhos acumulam fatos, mas nunca os revisam. O Hypotree estrutura o conhecimento de trabalho do agente como um grafo acíclico dirigido de hipóteses apoiado por SQLite-WAL. Quando um experimento falha, o mecanismo percorre as arestas de dependência e retrata o que se apoiava nelas. Quando uma premissa colapsa, toda subárvore dependente é podada automaticamente.
O que ele faz
- Revisão de crenças com escrita de volta — um mecanismo estilo ATMS (de Kleer, 1986) que propaga falhas de evidência rio acima pelo grafo de dependências.
- Poda em cascata — invalidar uma hipótese pai transiciona instantaneamente toda a sua subárvore para
PRUNED. Nenhum token é gasto em ramos mortos. - Inferência por grupo de exclusão — confirmar um membro de um grupo mutuamente exclusivo aposenta os demais como
EXHAUSTEDsem sondá-los. - Dedução por eliminação — o último sobrevivente: quando todas as alternativas, exceto uma, em um grupo de exclusão são refutadas, o sobrevivente é
VERIFIEDsem uma sonda. - Poda retroativa sobre uma pergunta completa — o dual do acima: quando toda resposta candidata a uma pergunta é descartada com base em sua própria evidência, nada que assuma uma delas pode ser satisfeito, então esses ramos são
PRUNEDe o navegador nomeia a pergunta que se esgotou. - A suposição de mundo fechado é declarada, não assumida. Ambas as inferências acima são sólidas apenas se as respostas listadas forem todas as respostas.
exclusion_closed=Falsediz que não são — "qual taxa de aprendizado?" sempre admite outra — e o mecanismo então retém ambas. E quando uma dedução que foi feita se revela apoiada em uma lista incompleta, ela é retirada em vez de defendida: o nó volta para a fronteira e uma sonda resolve qual premissa estava errada. - Navegação por Amostragem de Thompson — amostragem de distribuição Beta sobre a fronteira aberta, dando arrependimento de pior caso limitado (sem travamento catastrófico).
- Resolução de conflitos via ablação diferencial — quando um teste de integração falha, mas cada componente passa isoladamente, o mecanismo reconstrói a combinação que falha uma troca por vez para identificar o culpado.
- Um rastro de derivação, não apenas um estado —
generate_learning_pathnarra o que foi resolvido, em ordem, separando o que um experimento pagou do que o mecanismo inferiu de graça, e destacando crenças que foram posteriormente retiradas. - Persistente entre sessões, modelos, agentes, usuários e projetos — o estado de crença é um banco de dados SQLite, não uma janela de contexto.
Recursos
Recursos principais
Tudo aqui está ativado por padrão e coberto pelo benchmark pré-registrado.
| Recurso | Para que serve |
|---|---|
| Revisão de crenças com escrita de volta | Um experimento que falha não é apenas registrado — o mecanismo percorre as arestas de dependência e retrata o que se apoiava nelas. Isso é o que a memória passiva não consegue fazer. |
| Poda em cascata | Invalidar uma premissa transiciona toda a sua subárvore para PRUNED em uma única transação. Nenhum token é gasto relendo um ramo morto. |
| Inferência por grupo de exclusão | Declare respostas concorrentes para uma pergunta; confirmar uma aposenta as demais sem sondá-las. No benchmark, é daí que vem a maior parte da economia — 342 perguntas fechadas de graça na execução mais recente. |
| Dedução por eliminação | Descarte todos os candidatos exceto um e o sobrevivente é confirmado sem nenhuma sonda. |
| Poda retroativa sobre uma pergunta morta | O dual: quando toda resposta candidata é descartada com base em sua própria evidência, nada que assuma uma delas pode ser satisfeito, e o navegador nomeia a pergunta que se esgotou em vez de relatar uma fronteira vazia. |
| Uma suposição de mundo fechado declarada | Ambas as inferências acima são sólidas apenas se sua lista de respostas for completa. exclusion_closed=False diz que não é — "qual taxa de aprendizado?" sempre admite outra — e o mecanismo as retém. Uma dedução posteriormente descoberta como apoiada em uma lista incompleta é retirada, não defendida. |
| Conjuntos de conflito e ablação diferencial | Quando componentes passam isoladamente, mas falham juntos, o mecanismo registra o que não pode ser verdade simultaneamente e o estreita reconstruindo a combinação uma troca por vez. Cada troca é decisiva; m suposições custam no máximo m sondas. |
| Profundidade de confirmação | "Passou no teste unitário" e "funciona em produção" são afirmações diferentes. Uma confirmação não sustenta nada testado mais profundamente do que ela mesma, e a culpa recai apenas sobre suposições confirmadas mais superficialmente do que a falha. |
| O que mudaria minha opinião | Para qualquer objetivo, os experimentos mais baratos que derrubariam sua conclusão atual, evidência mais fraca primeiro. Uma crença confirmada por eliminação fica no topo, por mais confiante que seja o posterior — nada nunca a mediu. Disponível como ferramenta e como painel. |
| Diff do caminho de aprendizado | generate_learning_path(since=…) relata o que mudou em uma janela — confirmado, retirado, recém-questionado — que é a frase que uma reunião diária ou uma descrição de PR quer. as_of reconstrói qualquer instante passado; passe ambos para uma janela fechada. |
| Navegação por Amostragem de Thompson | Amostragem Beta sobre a fronteira aberta: arrependimento de pior caso limitado e sem travamento catastrófico. Com semente, para que uma execução seja reproduzível. |
| Escopo por objetivo | goal_id no despacho, status e narrativa restringe tudo a um objetivo, sua ancestralidade de dependências e as respostas concorrentes a essas perguntas. |
| Histórico bi-temporal | Cada mudança de status e posterior é armazenada como um intervalo, então "no que acreditávamos na terça-feira" é uma cláusula WHERE — e o controle deslizante do painel é essa consulta com uma alça. |
| Painel somente leitura ao vivo | Executa ao lado do servidor MCP por padrão. Veja o grafo crescer, reproduza qualquer instante, leia a narrativa tipografada. Nada nele escreve evidência. |
| Concessões para trabalho de longa duração | Um nó despachado é reservado até você reportá-lo. renew_claim para um experimento de vários dias, release_claims para devolver o trabalho em vez de fabricar um resultado. |
| Nativo para lote em todo lugar | create_hypotheses, get_next_targets, record_evidence e update_status aceitam listas, e a gravação pode fundir o próximo despacho na mesma ida e volta. |
Recursos experimentais
Desativados por padrão, e permanecendo assim até que uma avaliação completa com um modelo ao vivo os pontue. O comportamento com a flag ausente é bit-idêntico a uma compilação que nunca ouviu falar do recurso.
| Recurso | Status |
|---|---|
Seleção ciente de custo (--experimental-cost-aware) | Classifica candidatos pelo valor esperado por unidade de custo em vez de apenas pela promessa, usando o duration_s que seus resultados relatam e o estimated_cost que você declara. Em um benchmark ponderado por custo, reduz o custo total até o objetivo em 77% para 1,5% a mais de sondas, resolvendo todas as sementes — mas isso foi medido contra um chamador com script em uma tarifa sintética, o que justifica o mecanismo e não o padrão. Espera-se que se torne o padrão em um lançamento menor posterior (0.7.0 ou superior) assim que uma execução com um modelo ao vivo o pontuar; a flag desaparece nesse ponto. Gravar duration_s e estimated_cost é sempre seguro e sempre útil — ambos são armazenados e exibidos independentemente de a flag estar ativada. |
Por que a economia existe, já que não é óbvio: a última resposta sobrevivente a uma pergunta fechada é deduzida em vez de sondada, então qualquer resposta que você nunca alcança nunca é paga. Ordenar do mais barato primeiro coloca a resposta cara nesse espaço gratuito. A contagem de sondas mal se move — a posição do vencedor é uniforme, então qualquer ordem resolve uma pergunta no mesmo número esperado de sondas — enquanto o custo das sondas cai bastante.
Veja-o pensar
Um estado de crença que se revisa é difícil de apreciar a partir de uma coluna de status. O painel executa por padrão, ao lado do servidor MCP, então o grafo já está lá na primeira vez que você procurar:
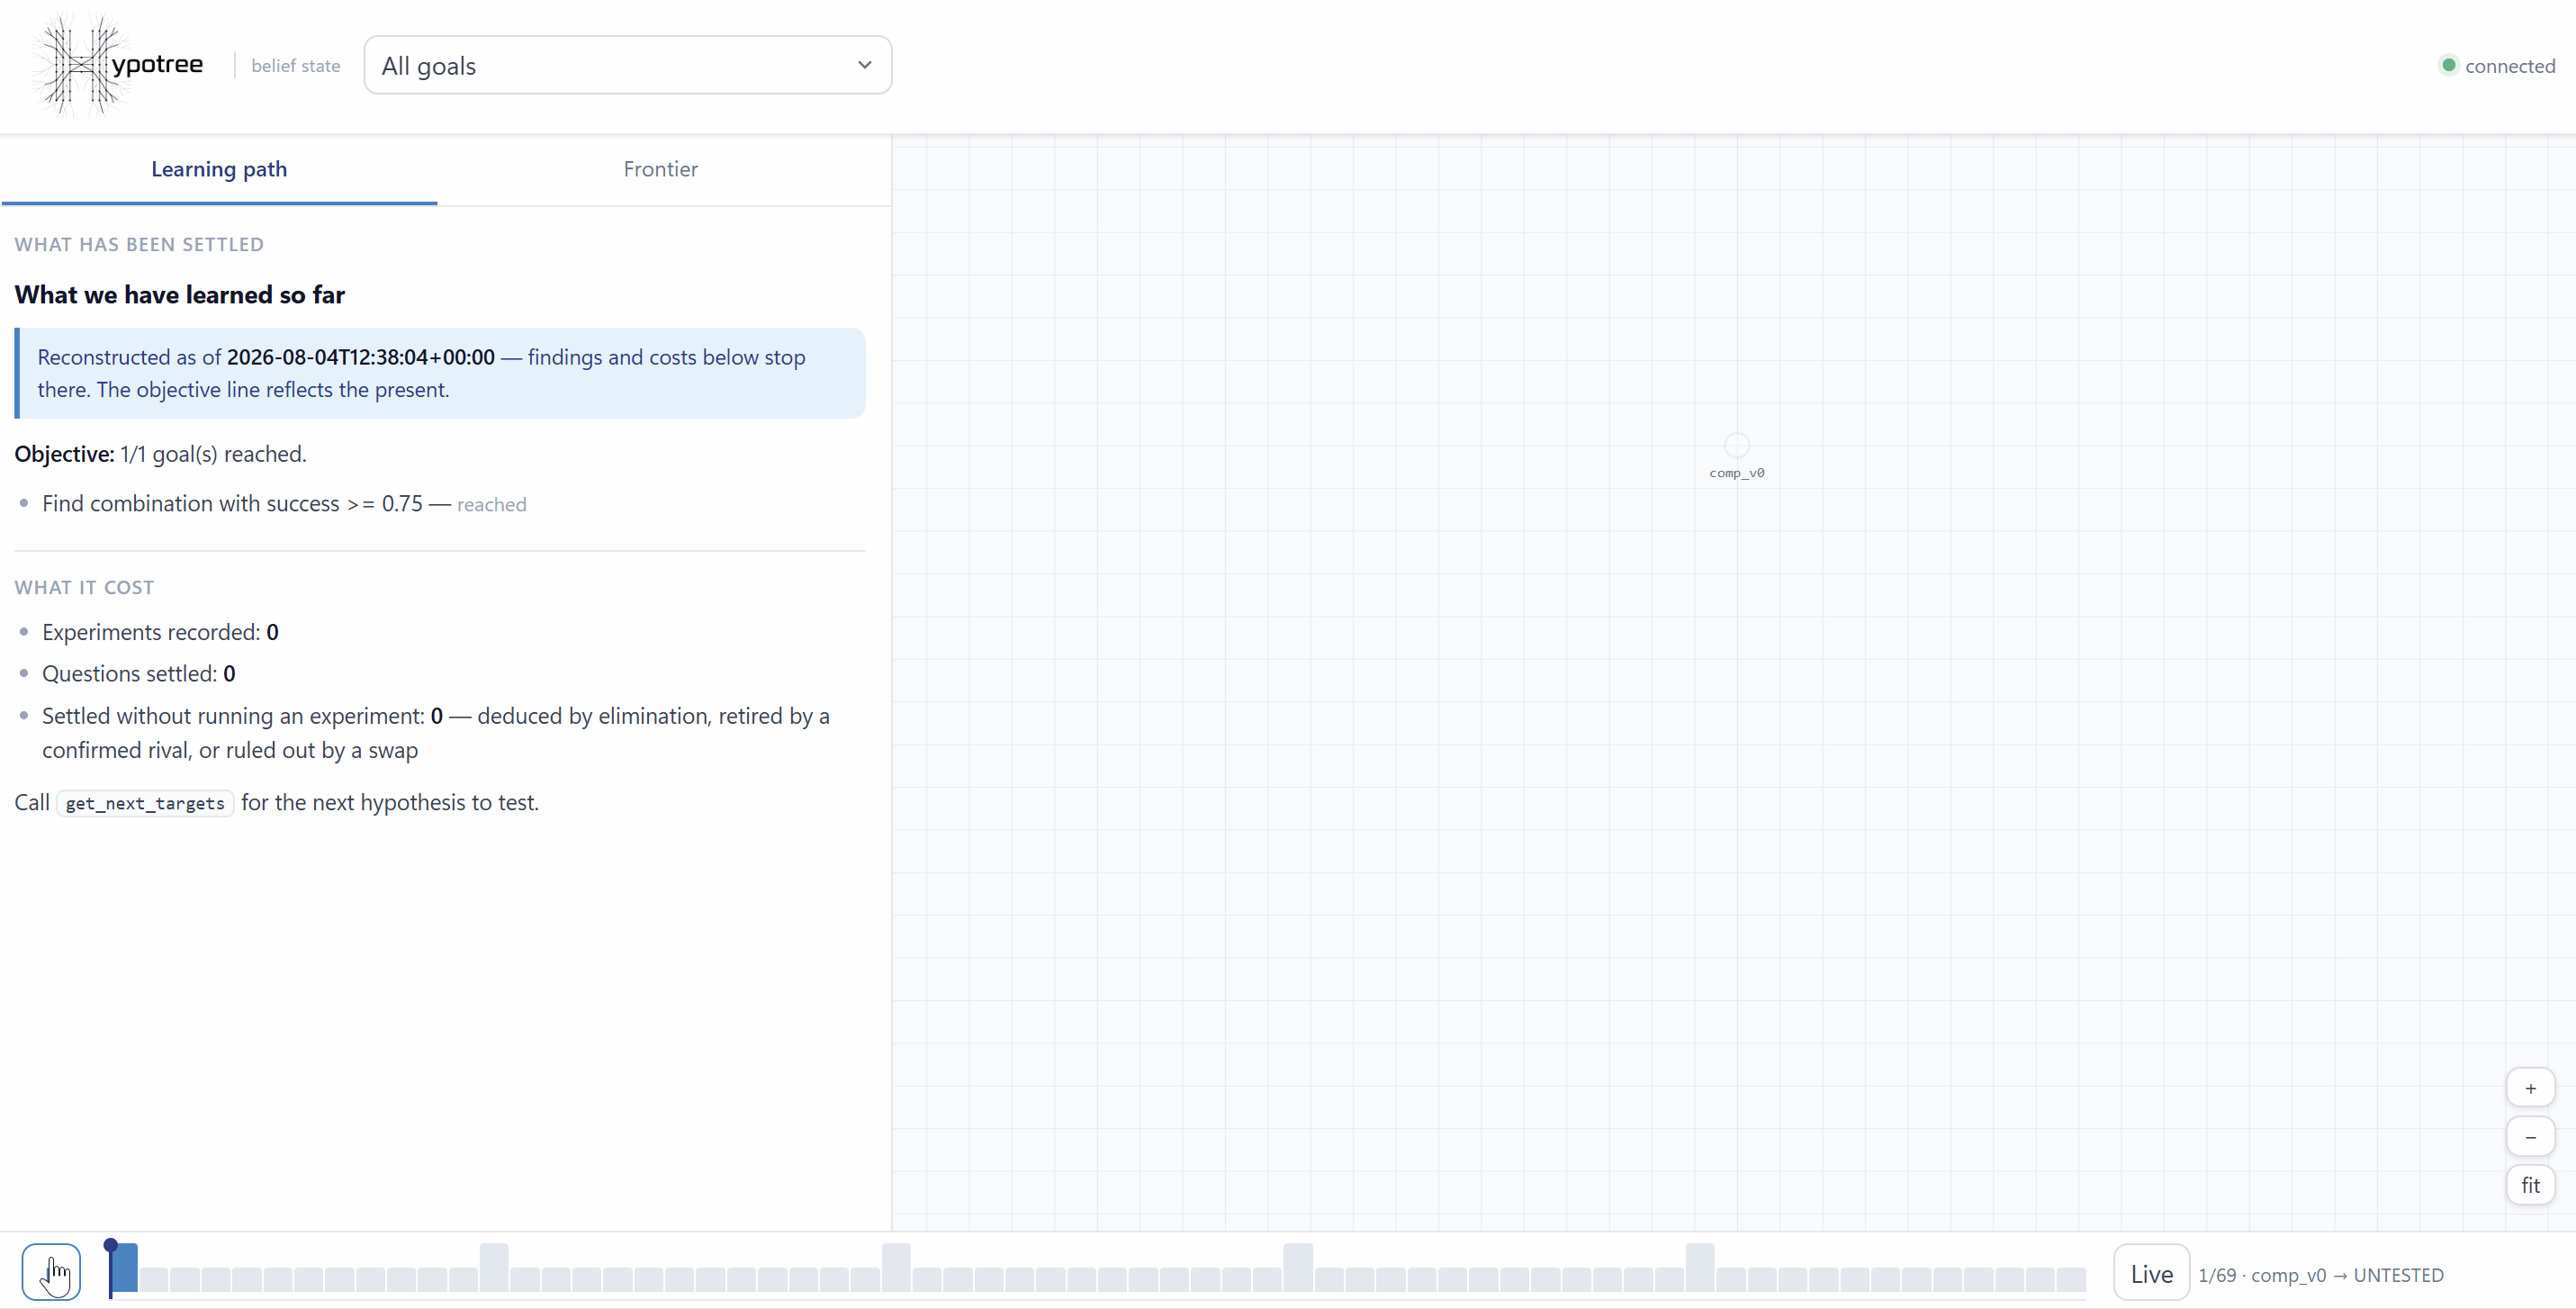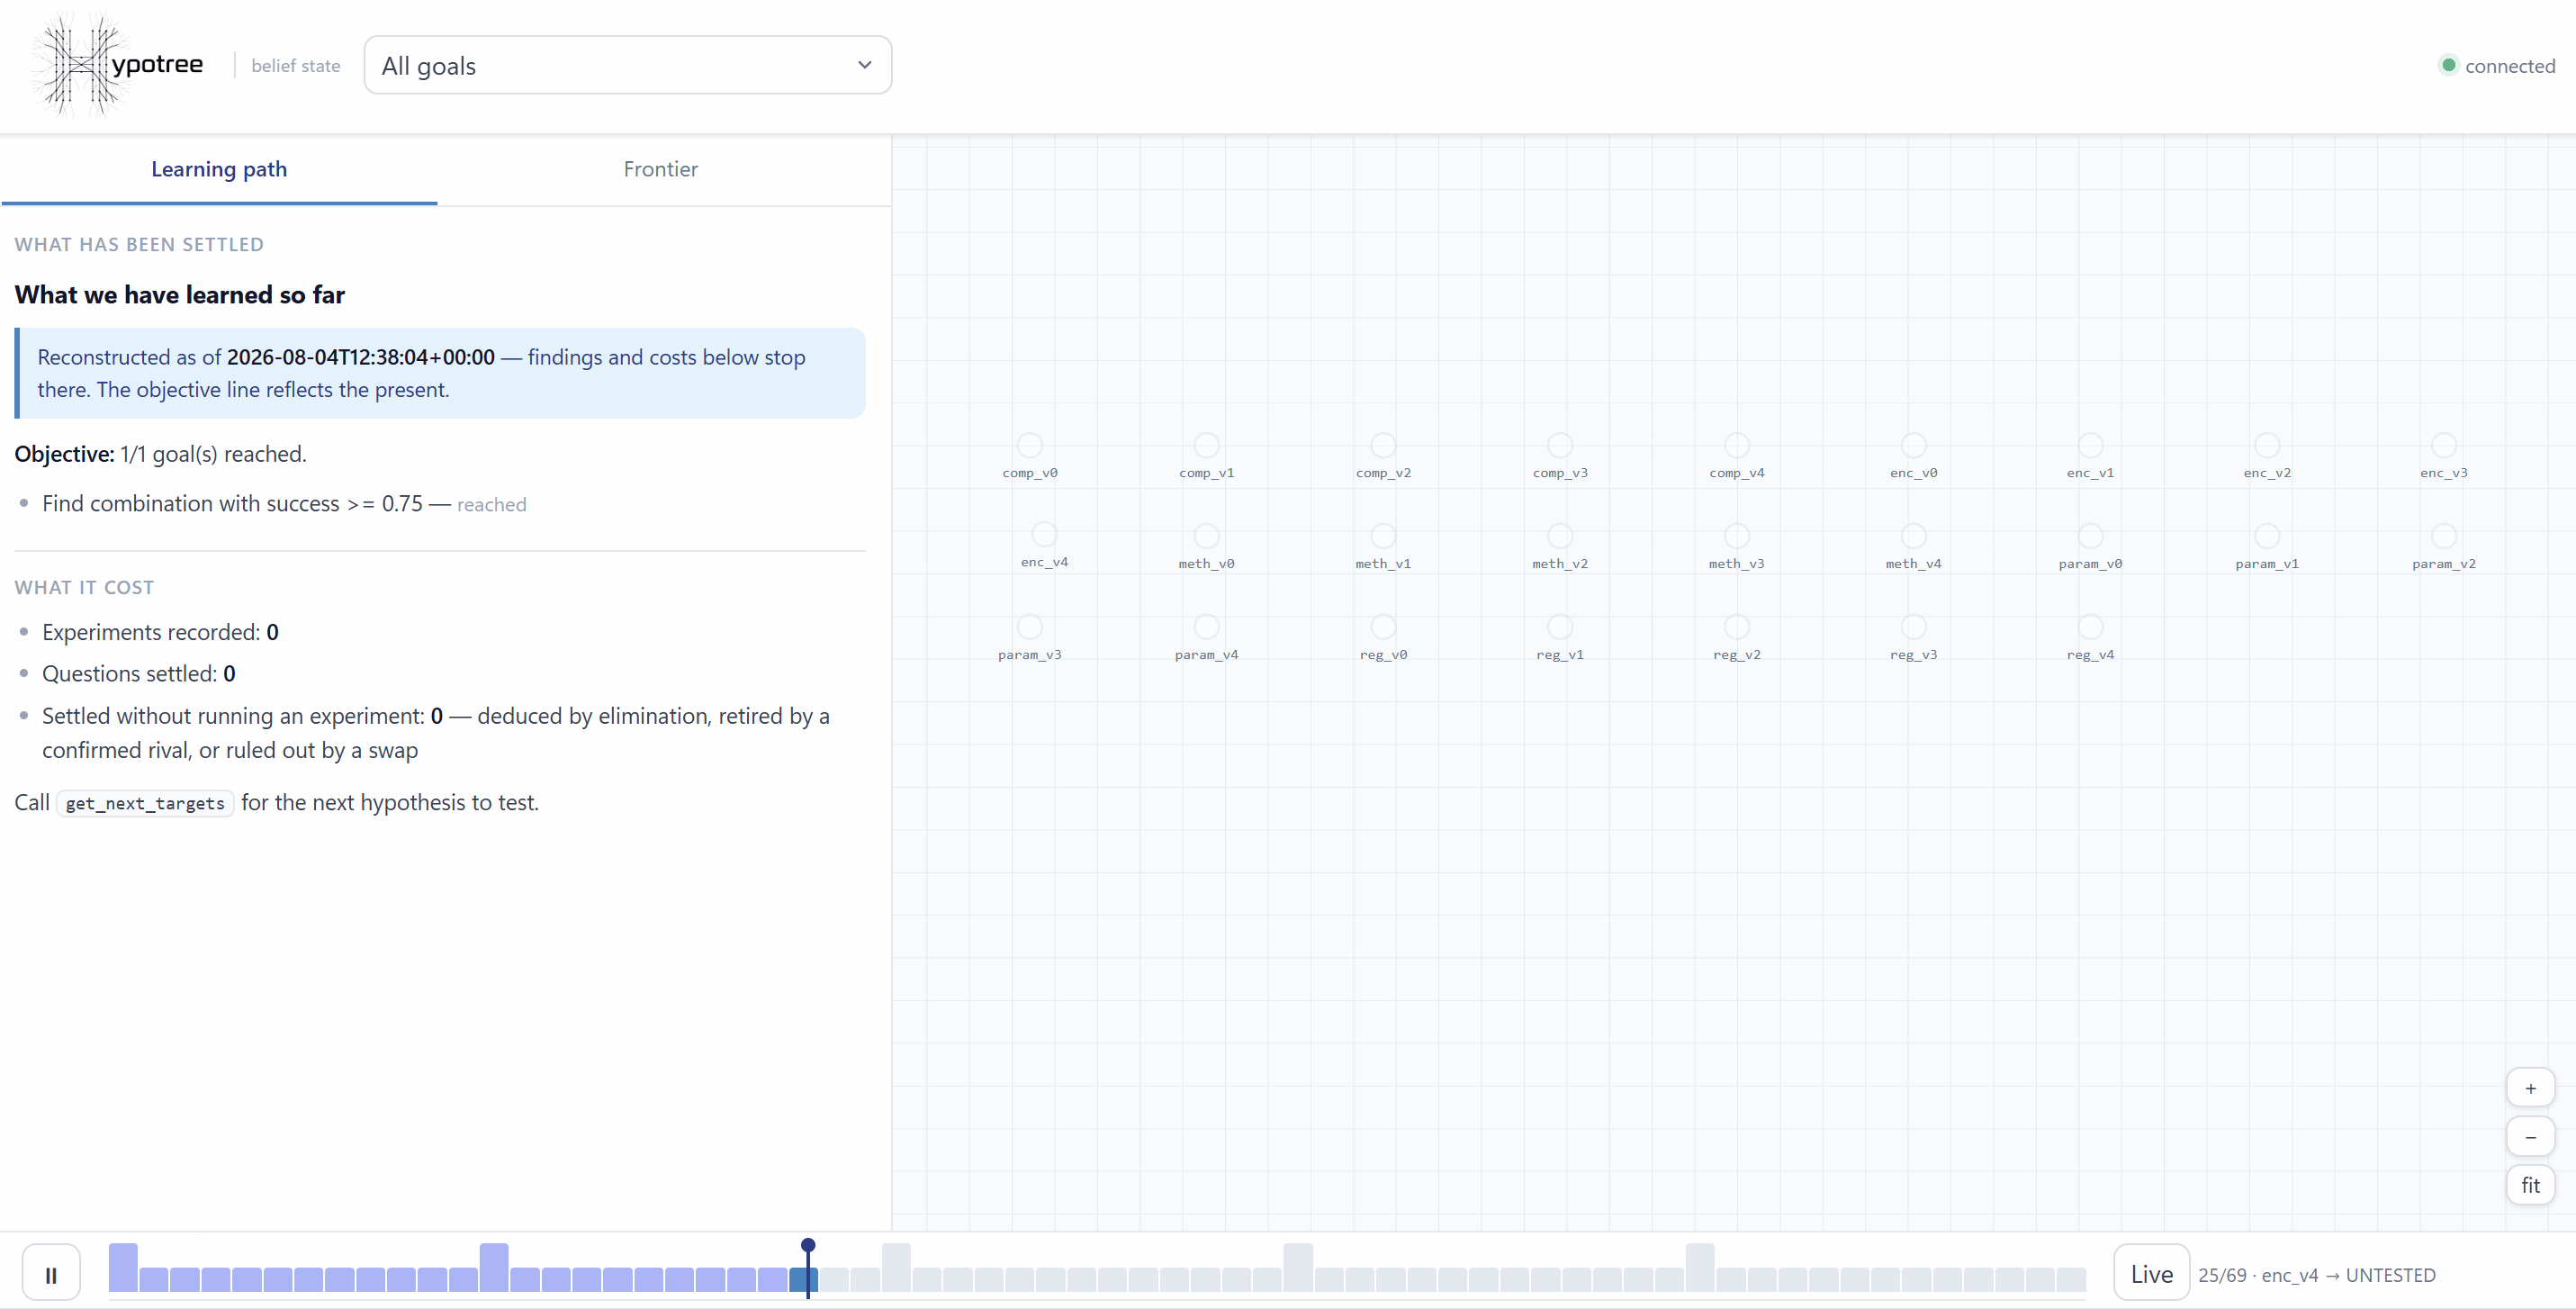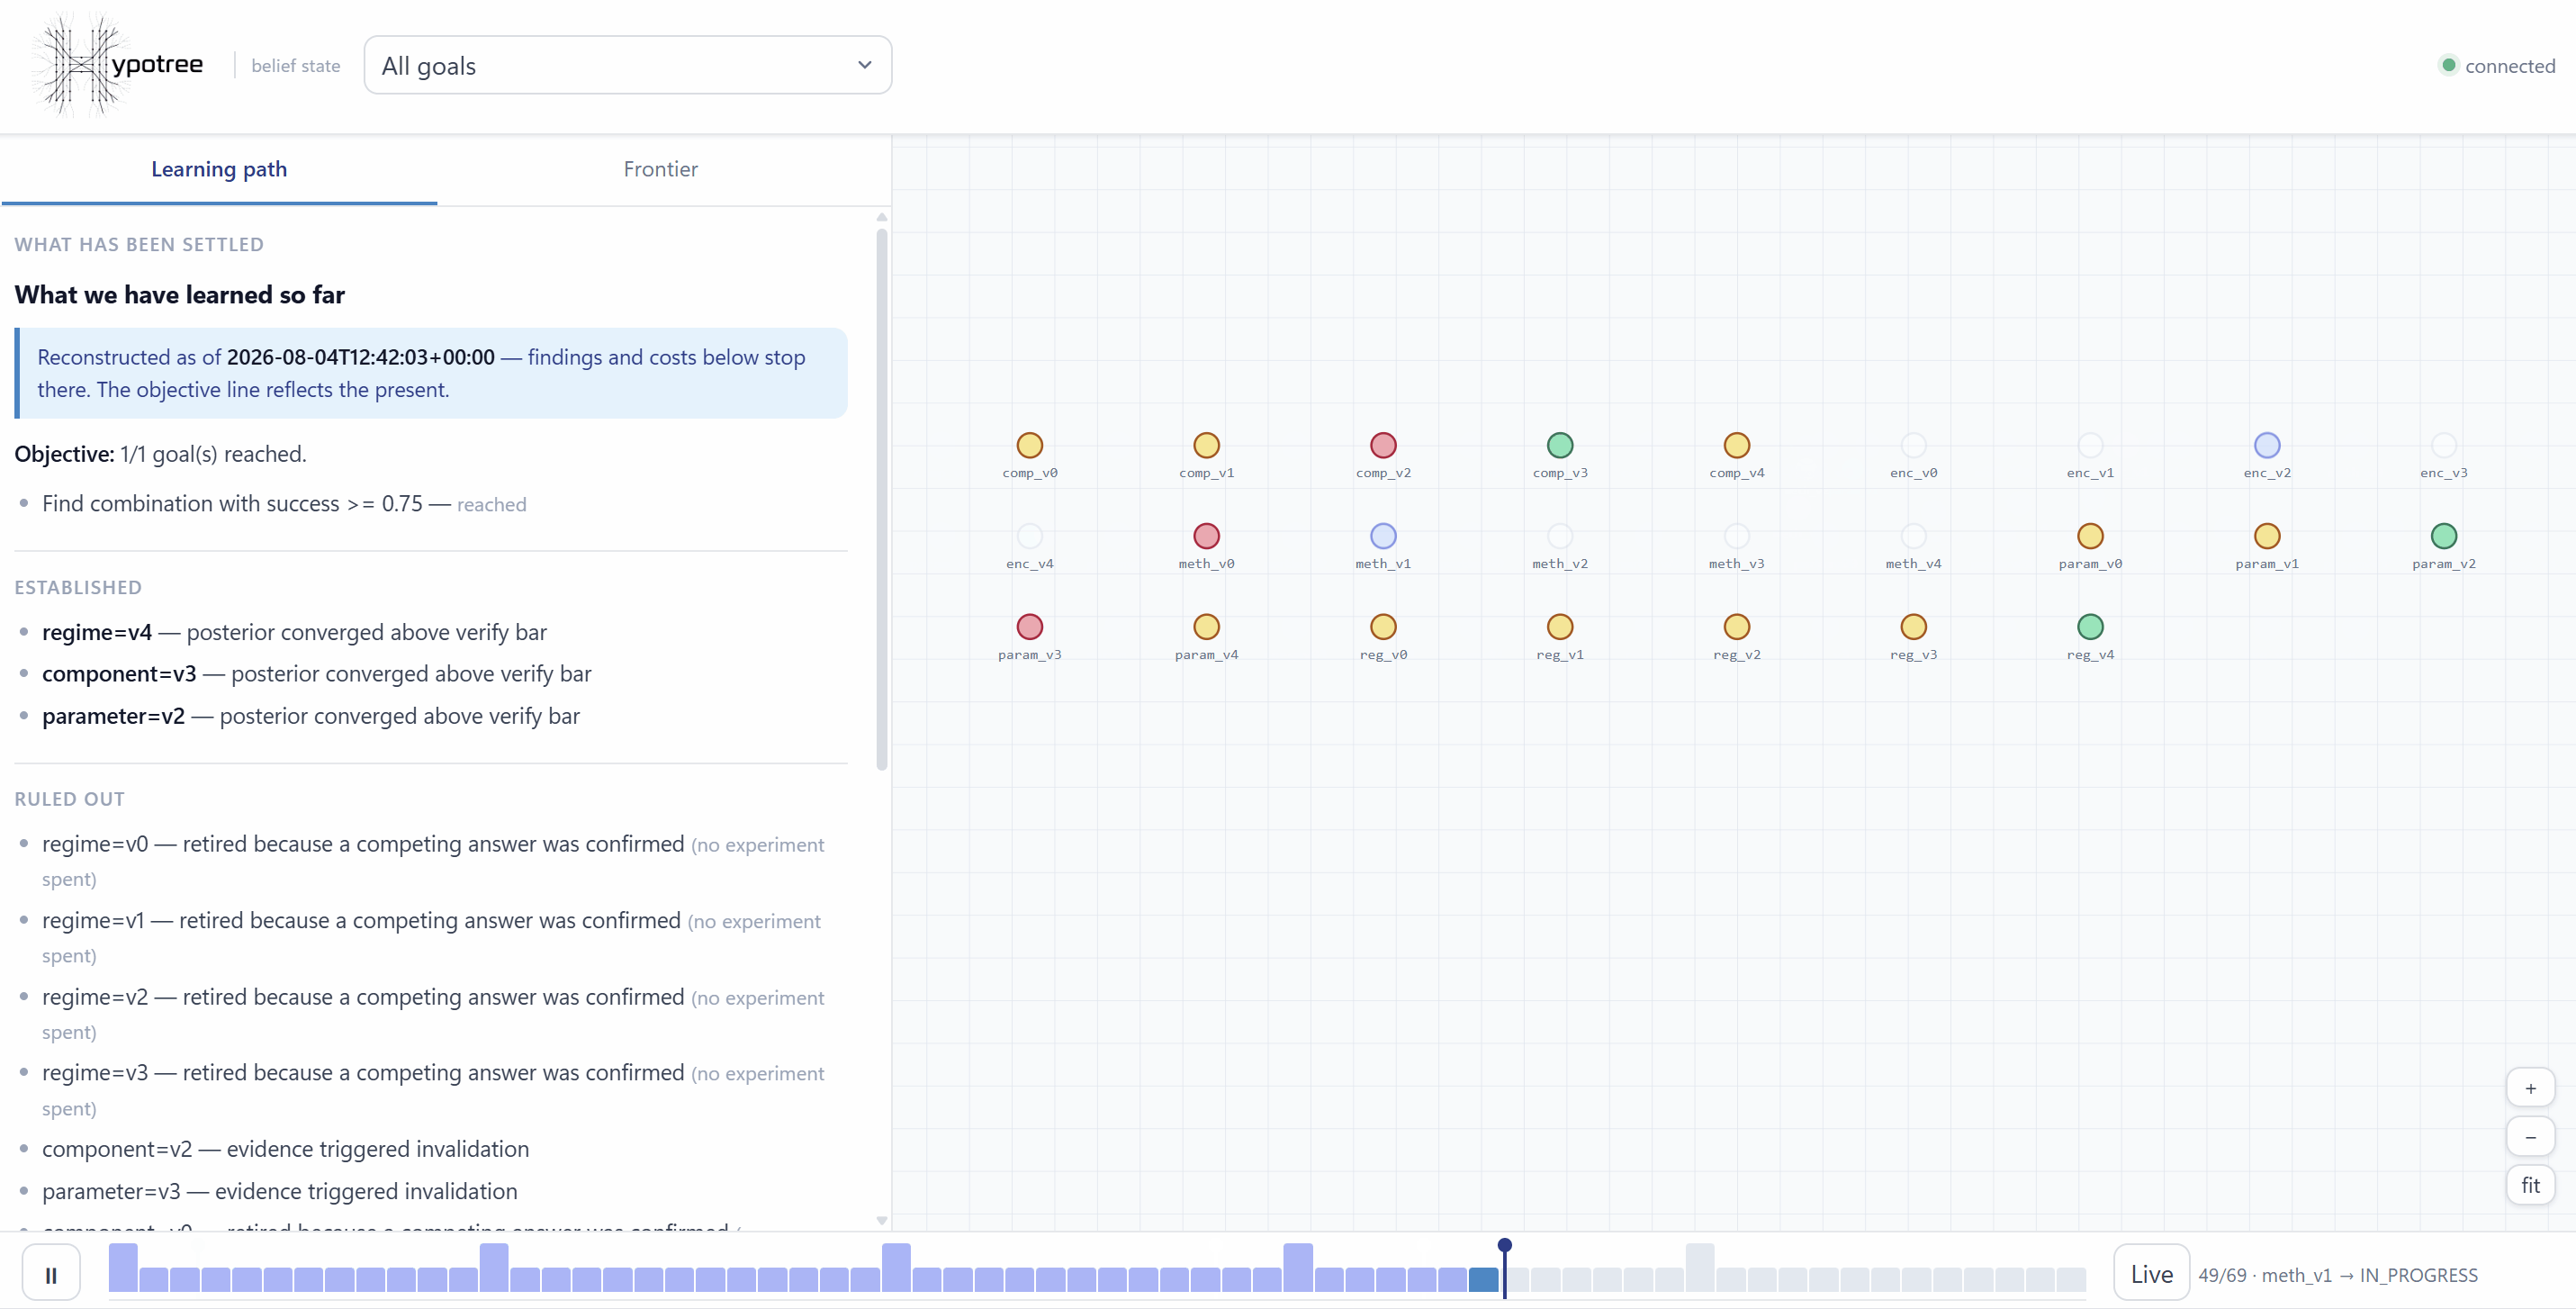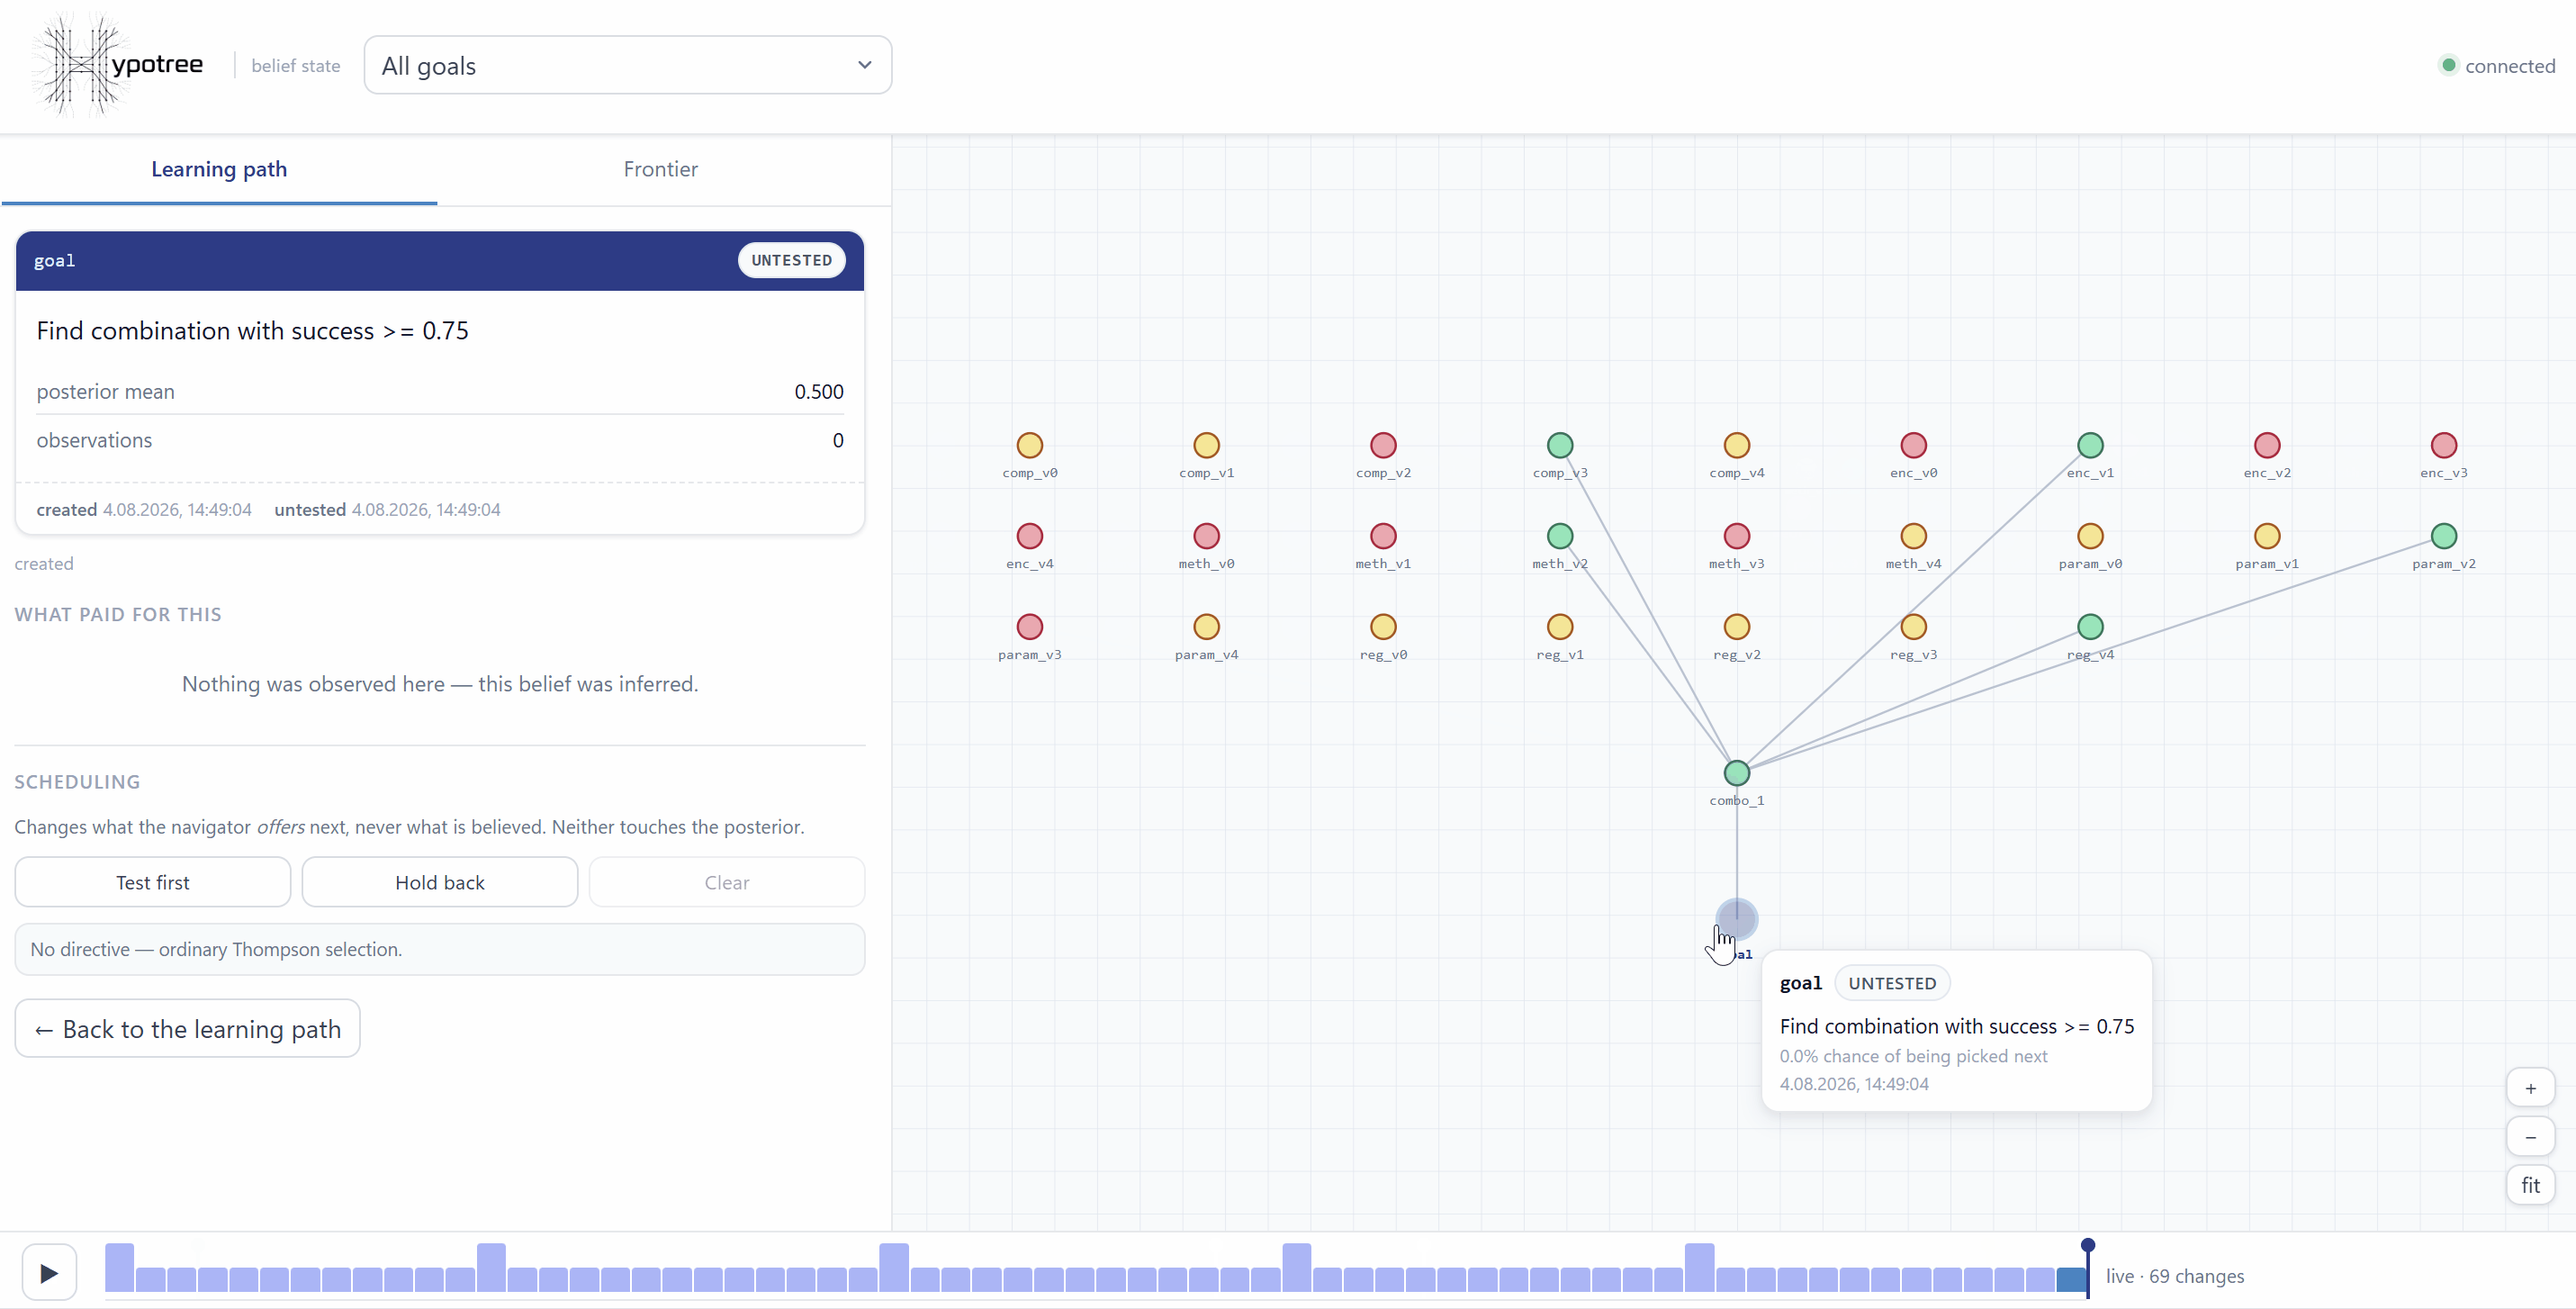
Essa é uma execução real. Nós chegam conforme o agente os cria e brilham com sua chance real de serem despachados em seguida; respostas confirmadas ficam verdes e suas rivais se aposentam sem nunca serem sondadas; uma premissa refutada leva sua subárvore junto. Títulos opcionais de 128 caracteres mantêm grafos grandes legíveis enquanto preservam ids estáveis nos detalhes. O progresso do objetivo nomeia dependências pendentes, a evidência pode ser filtrada e paginada com contexto de atestação e tendência, e visualizações dedicadas de conflito e reivindicações ao vivo expõem por que o trabalho está bloqueado ou concedido. O layout permanece utilizável em telas compactas empilhando a narrativa e o grafo. A barra na parte inferior é a atividade da própria execução — arraste-a e o grafo inteiro retrocede para o que era acreditado naquele momento, narrativa incluída.
Nada nessa página escreve evidência. Se uma crença mudou, um experimento a mudou.
Instalação
# From PyPI
uvx hypotree
# or
pip install hypotree

# From source
git clone https://github.com/tygryso/hypotree.git
cd hypotree
uv sync
Requer: Python 3.10+ · Executa em: Linux, macOS, Windows
Verifique a instalação sem conectar um cliente — o servidor fala JSON-RPC na stdin, então iniciá-lo em um terminal parece uma trava:
hypotree --version   # or: uvx hypotree --version
hypotree --info      # which belief state am I connected to, and where is it?
Início rápido
1a. Conecte-se a um cliente MCP
Adicione hypotree à configuração do seu cliente MCP (Cursor, Cline, Claude Desktop, etc.):
{
  "mcpServers": {
    "hypotree": {
      "command": "uvx",
      "args": ["hypotree"],
      "env": {
        "HYPOTREE_WORKSPACE_ID": "my-project"
      }
    }
  }
}
Ou execute diretamente:
uvx hypotree
Para visualizar um banco de dados pertencente a um host de incorporação sem resolução de espaço de trabalho ou servidor MCP:
uv run hypotree --no-mcp --db-path /path/to/state.db
HYPOTREE_DB_PATH fornece a mesma substituição.
1b. Ou incorpore-o em um agente Python — sem cliente MCP
Se seu agente é Python, ele não precisa de um transporte para alcançar o estado de crença. HypoTreeToolset entrega esquemas de chamada de função do OpenAI e executa chamadas por nome:
from hypotree import HypoTreeToolset

with HypoTreeToolset("beliefs.db", preset="essential") as ht:
    tools = ht.tools()                  # drop straight into your `tools=` argument
    result = ht.call("get_next_targets", {"count": 1})   # returns a JSON string
Ambos os caminhos projetam os mesmos esquemas pelo mesmo despacho, então a superfície incorporada e a superfície MCP não podem divergir.
Três coisas que valem a pena saber:
preset="essential"expõe as seis ferramentas que executam o loop em vez de todas as vinte. A maioria dos clientes reenvia todo esquema a cada turno, e um agente que já carrega suas próprias quarenta ferramentas não pode também carregar vinte das nossas.ht.mutating_tool_namesé o conjunto que muda o estado de crença — o que colocar atrás de um portão de aprovação ou raciocínio.get_next_targetsestá nele: parece uma consulta e emite concessões, então escreve.ht.callnunca lança exceções. Um id de nó ruim ou um dicionário de argumentos malformado retorna como{"error": ...}, porque isso é recuperável pelo modelo que os causou, e matar a sessão por causa de um deles não é.
Passe read_only=True para um revisor ou um subagente não confiável: ele expõe os onze sensores e recusa toda escrita, inclusive por nome se o modelo pedir uma que não recebeu.
Hosts incorporados podem manter estado em seu próprio namespace de armazenamento isolado e depois lançar
hypotree --no-mcp --db-path .../state.dbsem copiá-lo para o resolvedor de espaço de trabalho global do hypotree.
2. Crie hipóteses
O agente cria uma árvore com parent_ids conectando combinações às suas premissas e exclusion_group declarando respostas concorrentes a uma pergunta:
# Agent calls over MCP:
create_hypotheses(hypotheses=[
    {"node_id": "catalyst_A", "statement": "Pd/C catalyst works", "exclusion_group": "catalyst"},
    {"node_id": "catalyst_B", "statement": "Pt catalyst works",   "exclusion_group": "catalyst"},
    {"node_id": "catalyst_C", "statement": "Ni catalyst works",   "exclusion_group": "catalyst"},
    # Enumerable question → closed by default, so eliminating two confirms the third.
    # For "which learning rate?" pass exclusion_closed=False: there is always another,
    # and the engine then refuses to deduce a survivor it cannot justify.
    {"node_id": "yield_target", "statement": "reach 90% yield",
     "is_goal": True, "target_metric": 0.9, "parent_ids": ["catalyst_A"]},
])
3. Registre evidências e deixe o mecanismo inferir
# Probe catalyst_A → fails outright, catalyst_B → fails outright.
# Two experiments, one call:
record_evidence(results=[
    {"node_id": "catalyst_A", "success": 0.0},
    {"node_id": "catalyst_B", "success": 0.0},
])
# Engine: catalyst_A, catalyst_B → INVALIDATED; anything depending on them → PRUNED
#         catalyst_C → VERIFIED by elimination — no probe spent
4. Pergunte o que você aprendeu
generate_learning_path()
# → markdown briefing + counters:
#   probes_spent = 2, conclusions = 3, conclusions_without_a_probe = 1
MCP com painel
Além disso, você pode iniciar o servidor com estas flags:
hypotree                            # MCP server + dashboard on 127.0.0.1:7331
hypotree --dashboard-port 8080      # start probing from a port you choose
hypotree --no-dashboard             # MCP server only, no socket opened
hypotree --no-mcp                   # dashboard alone, against an existing belief state
hypotree --experimental-cost-aware  # rank by value per unit of probe cost (see Experimental features)
Ele liga apenas 127.0.0.1 e gera um token de sessão na inicialização; a URL, com o token incluído, vai para o stderr (o stdout é o canal JSON-RPC). Peça ao agente por ele — get_workspace_info retorna dashboard_url, e o recurso hypotree://dashboard também. Se nenhuma porta no intervalo estiver livre, o servidor MCP ainda inicia e avisa: um visualizador nunca deve ser capaz de derrubar o servidor.
--no-mcp abre o banco de dados somente leitura, então é seguro apontá-lo para um workspace que um agente está escrevendo ativamente — e ele não precisa de cliente configurado para tentar.
O que você obtém:
- Um grafo vivo. Os nós são dispostos no lado do servidor com
networkxe renderizados como SVG comd3-zoompara pan e zoom acelerados por hardware. Nós não testados brilham com sua chance real de serem despachados em seguida; nós em andamento pulsam; ramos podados dessaturam em vez de desaparecer, porque o ponto que está sendo mostrado é que eles foram considerados e cortados. - Novos nós aparecem gradualmente. Quando o agente cria uma hipótese, ela chega como um fantasma e se resolve — você observa a busca crescer sem tocar na página.
- Uma linha do tempo de atividade.
status_historyé bi-temporal, então qualquer instante passado é uma cláusulaWHERE. O gráfico de barras é a forma da execução — onde estavam os picos, onde estagnou — e o controle desliza ao longo dele. Arraste para trás para ver o que era acreditado então, ou pressione play e assista a investigação inteira se repetir. - Proveniência em cada cartão. O que cada crença custou: a pontuação, a profundidade, o commit, o
source_ref, quaisquer arquivos que o experimento deixou para trás, quando foi criado e quando se estabilizou. O grafo é um livro-razão, não um desenho. - O caminho de aprendizado como markdown tipografado, pronto para colar em um relatório — e ele retrocede com o grafo, então uma imagem retrocedida nunca é legendada com conclusões que ainda não alcançou.
- Fixar e suspender. Redirecione a busca sem falsificar evidências — diretivas mudam o que é oferecido, nunca o que é acreditado.
Tudo é vendido (Vue 3, micromódulos d3, marked — 276 KB no total). Sem CDN, sem npm, sem etapa de build: funciona em um avião e em uma rede isolada.
A API é JSON e toda chamada /api/* precisa do token. Tudo é leitura, exceto uma rota — fixar e suspender são instruções de agendamento, e elas nunca tocam uma posterior:
| Rota | O que retorna |
|---|---|
GET /api/meta | identidade do workspace e a lista de objetivos |
GET /api/graph?goal_id=&at= | nós e arestas com layout calculado no servidor; at reconstrói qualquer instante passado |
GET /api/node/<id> | evidências, proveniência e intervalos de status de um nó |
GET /api/frontier?goal_id=&k= | os principais candidatos e a probabilidade de o navegador escolher cada um em seguida |
GET /api/counterfactual?goal_id=&k= | as crenças que sustentam uma conclusão com menos evidências, e o que derrubaria cada uma |
GET /api/learning-path?goal_id=&at=&since= | a narrativa, igual à ferramenta MCP; since a transforma em um diff ao longo de um intervalo |
GET /api/timeline?goal_id= | cada mudança de status em ordem |
GET /api/events | números de revisão enviados pelo servidor — o cliente busca novamente o que está mostrando |
POST /api/directive | fixar / suspender / limpar (a única escrita, e somente quando um mecanismo está anexado) |
p_select é a coisa real, não um proxy: a Amostragem de Thompson escolhe o argmax de uma amostra por candidato, então o número é com que frequência cada candidato vence essa amostra.
Ferramentas (20)
Expostas via MCP, e na forma de chamada de função da OpenAI via hypotree.openai_tools() — um conjunto de esquemas, duas projeções. As seis marcadas com · compõem preset="essential", a menor superfície que ainda pode executar o loop.
| Ferramenta | O que faz |
|---|---|
create_hypotheses · | Cria um ou muitos nós com parent_ids, exclusion_group, exclusion_closed, is_goal |
add_edges · | Conecta hipóteses que já existem, sem recriar nenhuma. Aceita edges, uma lista de {src, dst, type} |
get_next_targets · | Amostragem de Thompson — retorna a próxima hipótese a testar, sob uma concessão. goal_id restringe a busca a um objetivo |
record_evidence · | Registra um resultado — ou todos os resultados de uma rodada de uma vez com results=[…] — e dispara a propagação de escrita. duration_s opcional alimenta a classificação ciente de custo |
generate_learning_path · | O que aprendemos, em ordem, e o que custou — separa conclusões que um experimento pagou das que o mecanismo inferiu gratuitamente. goal_id narra um objetivo |
get_workspace_info | A qual estado de crença você está conectado e qual camada o escolheu — comece aqui quando o grafo estiver inesperadamente vazio |
update_status | Define manualmente o status do nó (raramente necessário — o mecanismo faz isso) |
get_dag_context | Obtém uma visão de subgrafo para a janela de contexto do agente |
render_dag_map | Diagrama Mermaid.js do estado de crença atual |
get_goal_status · | Verifica se o nó de objetivo é atendido. goal_id limita as contagens ao subgrafo de um objetivo |
get_conflicts | Lista conflitos não resolvidos (falhas de integração) |
suggest_discriminating_experiment | Para um conflito, sugere a troca que separa os culpados |
what_would_change_my_mind | Nomeia os experimentos mais baratos que derrubariam a conclusão atual de um objetivo, evidência mais fraca primeiro |
list_nodes | Lista/filtra nós por status, profundidade ou grupo de exclusão |
get_evidence_history | Trilha de evidências completa para um nó |
get_active_claims | Lista nós com concessões ativas |
renew_claim | Estende uma concessão em um nó |
release_claims | Libera uma ou todas as concessões |
invalidate_upstream | Reverte o status VERIFIED dos pais com base em falhas dos filhos |
verify_upstream | Propaga confirmação pela cadeia de dependências |
Comandos de barra
O servidor fornece três prompts MCP. Clientes que os suportam (Cursor, Claude Desktop, Cline) os exibem como comandos de barra, para que um humano possa conduzir o loop sem redigitar o protocolo — e, mais útil ainda, sem que o agente o parafraseie.
| Comando | O que faz |
|---|---|
/hypotree-init | Cria o nó de objetivo e as primeiras 3–5 hipóteses sob ele, com grupos de exclusão onde as hipóteses são respostas concorrentes a uma pergunta |
/hypotree-next | Obtém o próximo alvo, testa-o de fato e registra o resultado contra esse mesmo nó — incluindo o que fazer para cada motivo de DONE |
/hypotree-status | Informa o que está estabelecido, o que foi descartado, o que mudou e quantas conclusões não custaram experimento |
/hypotree-init aceita um argumento opcional task. A invocação exata depende do cliente (Cursor e Claude Desktop colocam prompts no namespace do servidor, ex.: /hypotree:hypotree-init).
Recursos
Três recursos MCP, puxados sob demanda em vez de carregados no contexto:
| URI | O que é |
|---|---|
hypotree://guide | O contrato completo do agente — cada ferramenta, o ciclo de vida de status, grupos de exclusão, concessões, profundidade de confirmação, conjuntos de conflito e as regras. ~23 KB, então não pertence a lugar nenhum perto de um prompt de sistema |
hypotree://state | O estado de crença atual como uma narrativa: o que foi estabelecido, como e o que custou |
hypotree://dashboard | Onde um humano pode observar este estado de crença se mover, token incluído — para que o agente possa responder "me mande o link" sem você chegar perto de um terminal |
API Python
Para agentes escritos em Python, MCP é um limite de processo e uma ida e volta JSON entre dois objetos no mesmo interpretador. Importe-os em vez disso:
from hypotree import HypoTreeToolset, HypoTreeEngine, openai_tools
| O quê | Por que você usaria |
|---|---|
HypoTreeToolset(db_path, …) | Toda a superfície: .tools() para esquemas, .call(name, args) para execução, ciclo de vida do gerenciador de contexto |
HypoTreeToolset.from_engine(engine) | Adiciona a superfície de ferramentas a um mecanismo que você já possui. Não assume seu ciclo de vida |
openai_tools(preset=…, include=…, exclude=…, read_only=…) | Apenas os esquemas, se você rotear chamadas você mesmo |
HypoTreeEngine(db_path, …) | Resultados Pydantic tipados em vez de strings JSON |
A seleção é componível — comece de um preset e restrinja:
openai_tools(preset="essential")                 # the 6 that run the loop
openai_tools(read_only=True)                      # the 11 sensors, no writes
openai_tools(preset="essential", exclude=["add_edges"])
Cada ferramenta também carrega os metadados que um host precisa e que nenhum esquema JSON pode expressar:
from hypotree import TOOL_SPECS

{s.name for s in TOOL_SPECS if s.mutates}     # gate these
{s.name for s in TOOL_SPECS if s.essential}   # ship these when context is tight
Incorporando em um loop de agente
Toda a integração são três pontos de contato: construa a lista de ferramentas uma vez, execute por nome, feche na saída. Todo o resto seu loop já faz.
from hypotree import HypoTreeToolset

belief = HypoTreeToolset(session_dir / "beliefs.db", preset="essential")
try:
    tools = my_own_tools() + belief.tools()

    while not done:
        reply = llm.chat(messages, tools=tools)
        for call in reply.tool_calls:
            if call.name in belief.tool_names:
                # Your gate, your policy — hypotree only tells you which calls
                # are consequential.
                if belief.is_mutation(call.name) and not gate.open:
                    result = "Belief writes are gated; think first."
                else:
                    result = belief.call(call.name, call.arguments)
            else:
                result = my_dispatch(call)
            messages.append(tool_result(call, result))
finally:
    belief.close()
Quatro coisas fáceis de errar e baratas de acertar:
- Aponte o banco de dados para um armazenamento que sobreviva à sessão, não para o diretório de trabalho. O estado de crença sobreviver à execução é o recurso inteiro; um caminho sob um worktree git o bifurca na primeira vez que você troca de branch.
- Abra a sessão lendo o que já é conhecido.
generate_learning_pathestá no preset essencial por uma razão medida: em três execuções completas de avaliação, o agente o chamou após um reset de contexto exatamente zero vezes, e cada sonda redundante nessas execuções seguiu um reset. - Não cobre escritas de crença contra um orçamento de mutação de código. Registrar o que você aprendeu não é o trabalho. Um agente que fica com orçamento baixo e para de anotar suas descobertas perde a memória exatamente quando ela vale mais.
callnunca lança exceção. Um id de nó ruim retorna como{"error": …}, então o loop pode entregá-lo diretamente ao modelo e deixá-lo se corrigir em vez de morrer em um erro de digitação.
Passe read_only=True para qualquer coisa que deva observar sem escrever — um revisor, uma passagem de monitoramento, um subagente não confiável. Ele expõe os onze sensores e recusa toda escrita, inclusive por nome se o modelo pedir uma que nunca recebeu.
Testar uma integração não custa nada: o mecanismo roda contra um arquivo SQLite temporário em milissegundos, então o loop completo criar → despachar → registrar → concluir é um teste de unidade, não uma conta de inferência.
Regras do agente — como seu agente aprende a usar isso
O contrato operacional chega ao modelo por quatro canais. Você não precisa configurar nenhum deles; eles estão listados para que você saiba o que já está no contexto e o que não está.
- Instruções do servidor. MCP entrega um bloco
instructionsde nível de servidor ao cliente duranteinitialize, e todo cliente importante o coloca na frente do modelo. Hypotree o usa para quatro regras: uma hipótese por nó, marque o objetivo comis_goal=Truee conecte-o ao trabalho, registre contra o nó que você realmente testou e relate o que foi concedido a você. Nada para configurar. - Descrições de ferramentas. Cada descrição de ferramenta carrega a única regra sem a qual essa ferramenta é mal usada — que um objetivo nunca aceita evidências, que uma concessão reserva um nó até você relatá-lo, que confirmar um membro de um grupo de exclusão aposenta o resto. Esses são os únicos textos garantidos de estar no contexto no momento em que uma ferramenta é escolhida.
- Recursos. O guia completo é
hypotree://guide. Um agente que encontra algo surpreendente pode lê-lo sem você colar 23 KB em um prompt de sistema.hypotree://dashboardentrega o link ao vivo. - Seu arquivo de regras do projeto — opcional, e a única parte que você toca. Se você quiser que o agente alcance hypotree sem ser solicitado em trabalhos de vários dias, adicione o bloco abaixo.
Opcional: .cursorrules / AGENTS.md / CLAUDE.md
## Long-running R&D: use hypotree

For any task that spans more than one session, branches into competing
approaches, or where an early assumption could turn out wrong later, keep the
belief state in hypotree rather than in the conversation.

- Before starting, call `generate_learning_path`. Something may already be
  settled, and re-deriving it costs an experiment you do not have to run.
- Create the objective with `is_goal=True` and wire hypotheses to it with
  `parent_ids`. Progress is then derived, not asserted.
- Competing answers to one question share an `exclusion_group`. Confirming one
  retires the rest without testing them — this is where most of the saving is.
  If the list could always grow ("which learning rate?"), add
  `exclusion_closed: false` so the engine does not deduce a survivor it cannot
  justify.
- Ask `get_next_targets` for work and record every result you were handed. A
  target is leased to you; anything you hold and never report is work nobody
  can do. Probed several things in one turn? Report them in one call with
  `record_evidence(results=[...])`.
- Record against the node whose statement you actually tested. A composition's
  failure filed against a premise destroys a confirmation that is still true.
- When `get_next_targets` returns DONE, read the reason. Only `all_goals_met`
  and `empty_frontier` mean stop; the rest are instructions. `dead_question`
  means one of your questions ran out of candidate answers — add the one you
  have not thought of to the same `exclusion_group`.
Arquitetura
┌──────────────────────────┐   ┌──────────────────────────┐
│     MCP Client (agent)   │   │   Python agent (in-proc) │
│  Cursor / Cline / Claude │   │   HypoTreeToolset        │
└────────────┬─────────────┘   └────────────┬─────────────┘
             │ MCP (stdio/HTTP)             │ direct call
┌────────────▼─────────────┐                │
│    hypotree MCP server   │                │
└────────────┬─────────────┘                │
             │                              │
┌────────────▼──────────────────────────────▼─────────────┐
│  toolkit — 20 tool specs + dispatch (no transport)      │
│  one description of the contract; both paths project it │
└────────────────────────┬────────────────────────────────┘
┌────────────────────────▼────────────────────────────────┐
│  Engine                                                 │
│  • Write-back propagation    • Cascading prune          │
│  • Exclusion-group inference • Differential ablation    │
│  • Thompson Sampling navigator                          │
└────────────────────────┬────────────────────────────────┘
┌────────────────────────▼────────────────────────────────┐
│  SQLite-WAL                                             │
│  • Bi-temporal history                                  │
│  • Belief state + evidence + conflicts                  │
│  • Keyed by workspace_id                                │
└─────────────────────────────────────────────────────────┘
A camada de kit de ferramentas é a razão pela qual os dois pontos de entrada não podem divergir: nenhum possui os esquemas, e nenhum possui o roteamento.
Avaliação
Hypotree é validado por um benchmark adversarial pré-registrado usando qwen3.6:27b-q8_0 e gemma4:31b-it-q4_K_M. O benchmark é um conjunto de 30 problemas combinatórios de P&D semeados, cada um com 3125 combinações (5 eixos × 5 valores). Cada braço é executado em todas as sementes, e os critérios de aprovação são pontuados contra os limites pré-registrados.
Três braços em 30 problemas combinatórios de P&D semeados:
- Braço A — agente LLM com um bloco de rascunho Markdown manual (piso ergonômico)
- Braço F — agente LLM com autotranscrição de recordação perfeita (baseline de aço)
- Braço B — agente LLM no estado de crença DAG completo do hypotree O fosso é inferencial, não mnemônico. O Braço F lembrou de cada fato bruto que já viu — zero sondas duplicadas em toda a execução — e ainda assim perdeu de 30/0/0, porque o hypotree fecha perguntas que nunca precisa fazer: 329 inferências de exclusão, 37 respostas deduzidas sem uma sonda, 12 valores eliminados por uma troca que ficou aquém. Nenhuma dessas é algo que você possa consultar.
Executando a avaliação
# Pre-flight: confirm the engine solves every seed (no GPU)
uv run python -m eval.runner.engine_selfplay

# Pre-flight: score the cost-aware falsifier on a cost-weighted tariff (no GPU)
uv run python -m eval.cost_gate

# Full gate: 30 seeds × 3 arms
./eval.sh --run-iteration <X> --llm-model <model>
O harness de avaliação vive em eval/ e inclui os geradores de paisagem congelados, o executor de agente e o avaliador de portão. Os artefatos de execução são ignorados pelo git (eval/runs/).
eval.sh é bash — no Windows, execute-o sob WSL ou Git Bash. As partes Python do harness (engine_selfplay, runner, analyse_gate, seed_reader) são multiplataforma e podem ser acionadas diretamente.
Configuração
Identidade do workspace
O banco de dados de estado de crença é isolado por workspace. Quatro camadas de resolução, prioridade mais alta primeiro:
- Variável de ambiente
HYPOTREE_WORKSPACE_ID— um nome explícito. Use isso para configurações globais do MCP, onde o diretório de trabalho do servidor não é o seu projeto. hypotree.yaml— copiehypotree.yaml.templatepara a raiz do seu projeto:workspace_id: my-project-name- Hash do remote Git — grafias SSH e HTTPS de um mesmo remote resolvem para o mesmo id.
- Hash do caminho do projeto — o fallback, e o mais fraco: ele muda se o projeto for movido ou montado de forma diferente.
A camada 4 é de onde vem quase todos os relatos de "meu estado de crença está vazio". Execute hypotree --info, ou peça ao agente para chamar get_workspace_info, para ver qual camada realmente foi acionada:
$ hypotree --info
{
  "workspace_id": "d94da5f61c664f94",
  "resolved_from": "git_remote",
  "database": "/home/you/.local/share/mcp_hypotree/d94da5f61c664f94/state.db",
  "database_exists": true,
  "warnings": []
}
Nomes de workspace são [a-z0-9._~-] em minúsculas, com até 128 caracteres.
Onde o estado é armazenado
| Plataforma | Localização |
|---|---|
| Linux / macOS | $XDG_DATA_HOME/mcp_hypotree/<workspace_id>/ — padrão para ~/.local/share |
| Windows | %LOCALAPPDATA%\mcp_hypotree\<workspace_id>\ |
XDG_DATA_HOME substitui em todas as plataformas, incluindo Windows — é assim que você executa instâncias isoladas lado a lado.
Mantenha-o em um disco local. O SQLite roda em modo WAL, que precisa de memória compartilhada que compartilhamentos de rede e a maioria dos drives mapeados não fornecem. Apontar
XDG_DATA_HOMEpara um caminho UNC ou um compartilhamento montado falhará ou corromperá o banco de dados.hypotree --infoavisa quando detecta um.
Notas para Windows
- Tudo, exceto
eval.sh, roda nativamente; o harness de avaliação é um script bash e precisa de WSL ou Git Bash. - Git é opcional. Sem ele no
PATH, as camadas 3 e 4 caem para o hash do caminho — fixe o workspace com a camada 1 ou 2 em vez disso.
Desenvolvimento
# Install in dev mode
uv sync

# Run tests
uv run pytest tests/ -x -q

# Lint + format
uv run ruff check src/ tests/ eval/
uv run ruff format src/ tests/ eval/

# Type check
uv run mypy src/hypotree/
Licença
MIT — Copyright © 2026 Damian Borowski
Links
- GitHub: github.com/tygryso/hypotree
- Changelog:
CHANGELOG.md— histórico de versões com resultados de portão - Guia do agente:
src/hypotree/AGENT_GUIDE.md— o contrato completo, também servido ao vivo como o recurso MCPhypotree://guide