Archprint
Infere as regras de arquitetura que um repositório TypeScript já segue a partir do seu grafo de importações, explica cada regra com suas evidências e verifica uma alteração em busca de novas violações.
Documentação
Archprint





Extraia as regras de arquitetura que seu repositório já aplica, com as evidências anexadas.
Experimente no seu navegador, nada para instalar · Início rápido · Uso em CI · Uso com agentes de IA · Documentação
O que ele faz, em palavras simples
Todo código tem regras não escritas. "Páginas nunca falam diretamente com o banco de dados." "Código compartilhado nunca volta para dentro do aplicativo." Ninguém as escreveu, mas o código as segue, até que um dia alguém (ou um assistente de IA) quebra uma delas sem perceber.
O Archprint lê um projeto TypeScript, encontra as regras que o código já segue e mostra a prova de cada uma: quantos arquivos a seguem, quais arquivos a quebram e o quão confiante ele está. As regras em que você confia se tornam verificações automáticas nas ferramentas que sua equipe já usa, então uma quebra é detectada na próxima execução do lint (no seu editor, em um hook de pré-commit ou no CI), não semanas depois na revisão.
Pense nele como um inspetor de obras que primeiro vistoria a casa e anota como ela foi realmente construída, em vez de entregar um manual de regras vindo de outro lugar.
- Para desenvolvedores e líderes técnicos: regras de lint inferidas e baseadas em evidências para ESLint e dependency-cruiser, geradas com
init, conectadas comwiree removidas comeject. - Para revisores:
archprint checksinaliza apenas as quebras de regras que um pull request introduz, inline no GitHub, nunca o backlog existente. - Para equipes que usam agentes de codificação com IA: Claude Code, Cursor e outros agentes podem perguntar ao Archprint pelas regras do projeto, com as evidências, antes de escrever código.
- Para qualquer pessoa avaliando um código: uma visão rápida e honesta de como um projeto é realmente estruturado.
Seu CLAUDE.md é orientação. Suas regras de lint são aplicação. O Archprint fecha essa lacuna gerando a aplicação a partir dos padrões que seu código já demonstra, para que você adote regras em que pode confiar em vez de criá-las manualmente.
Veja em ação
As gravações abaixo usam archprint-demo, uma pequena API Next.js cujas rotas acessam o banco de dados apenas por meio de uma camada de serviço.
1. Encontre as regras que seu código já segue. Cada regra vem com suas evidências.
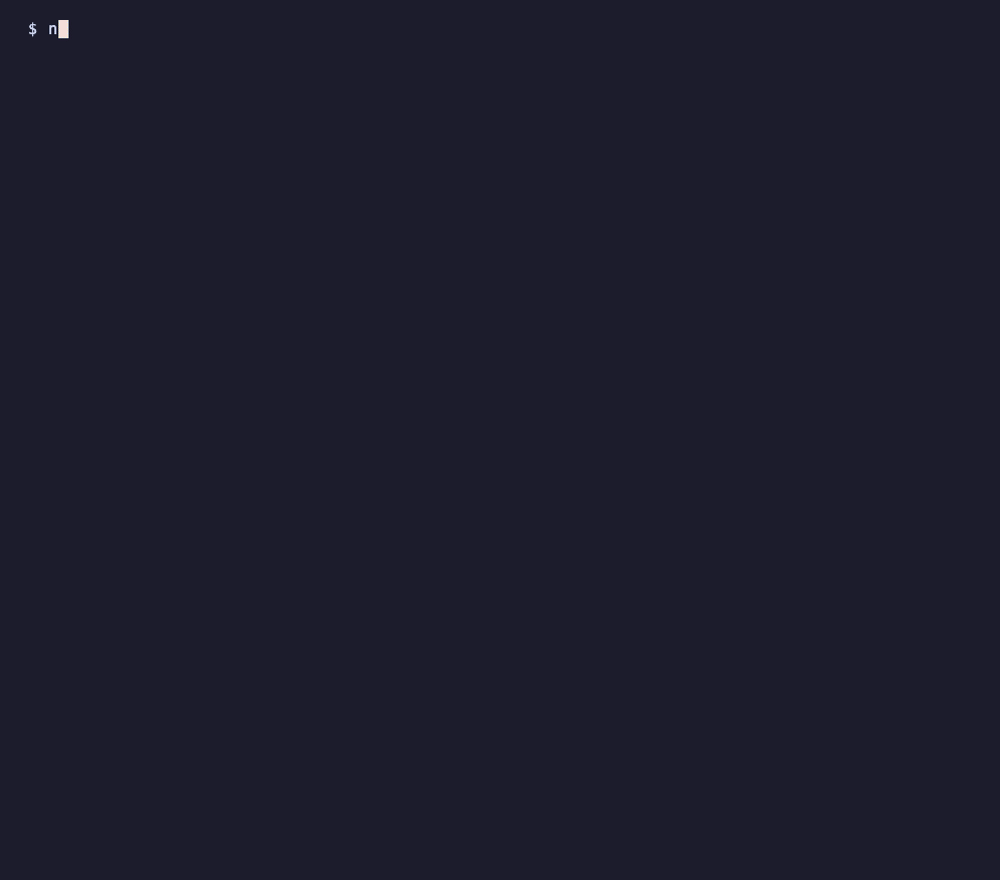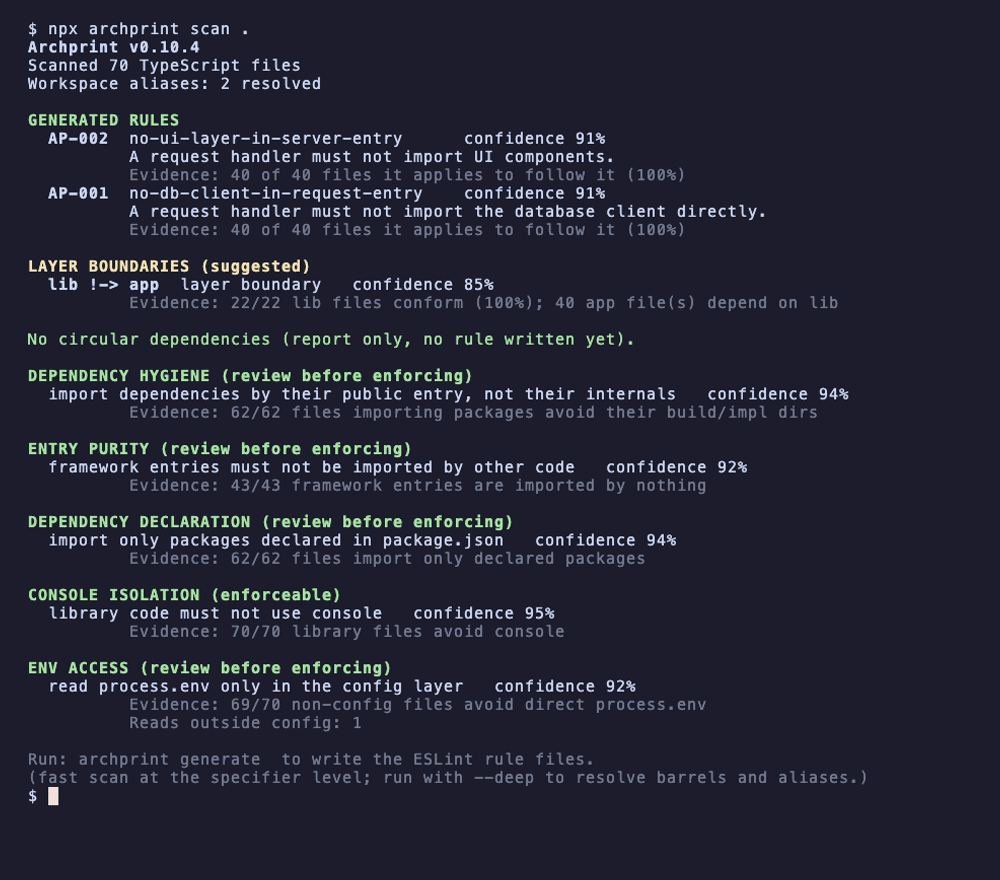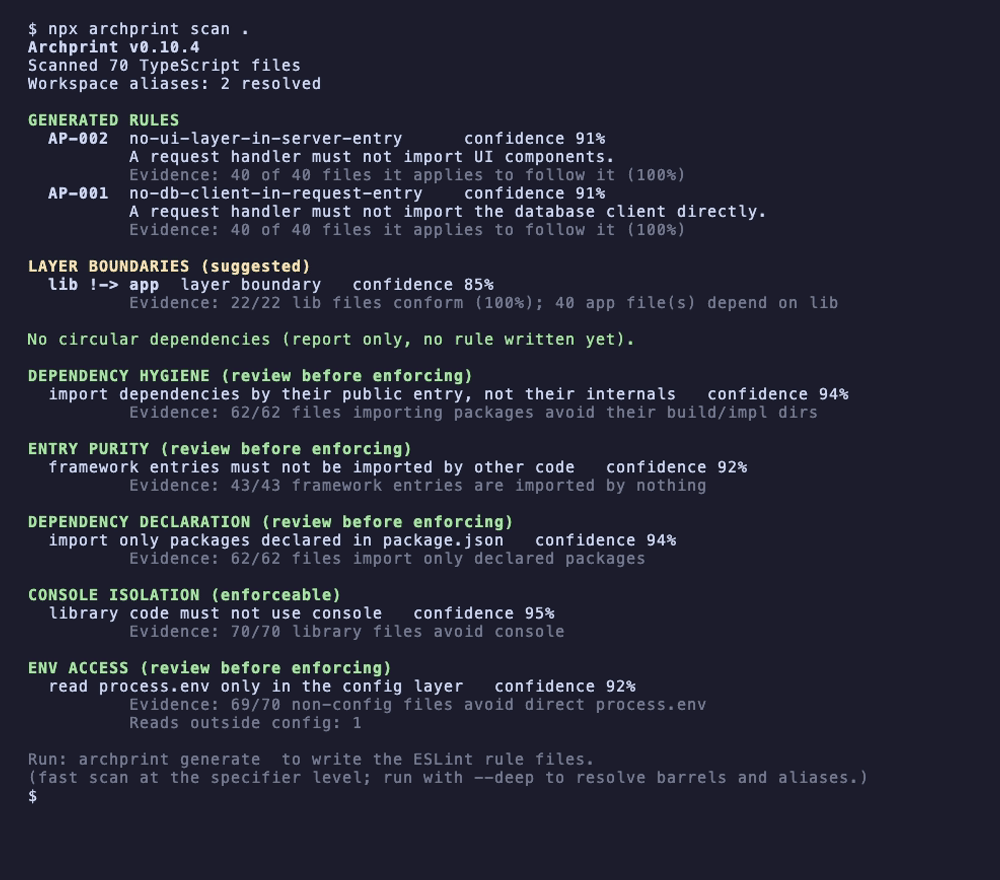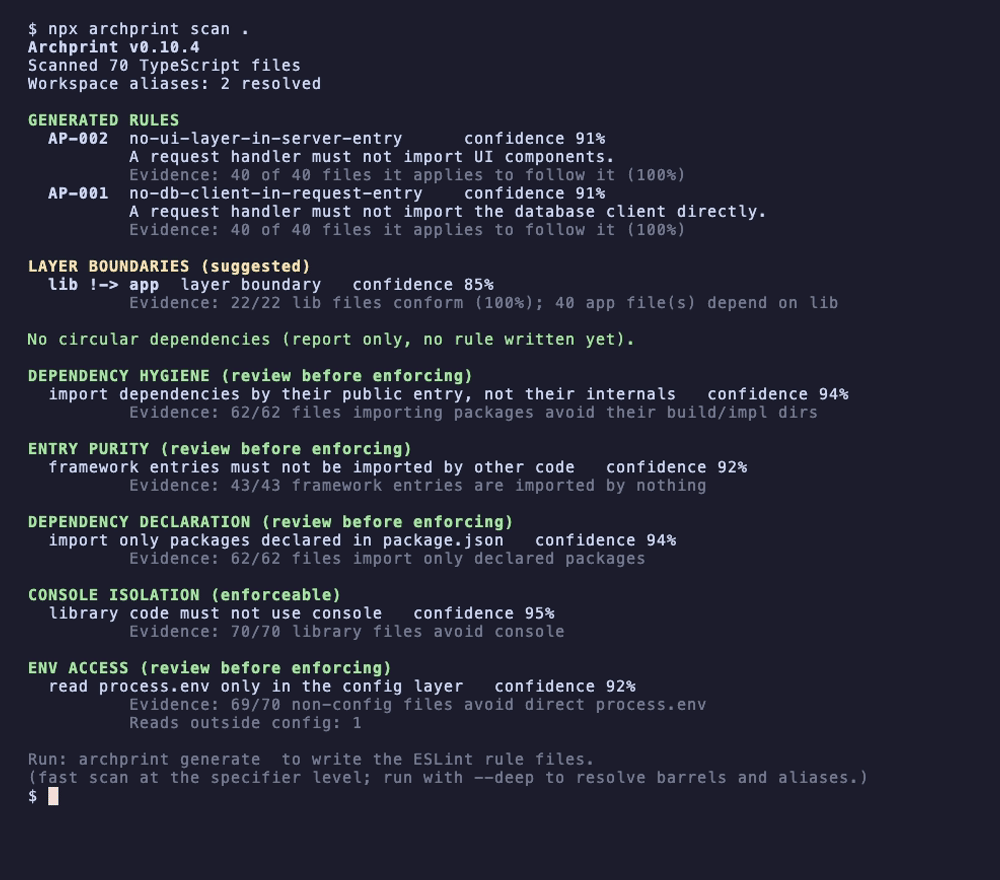
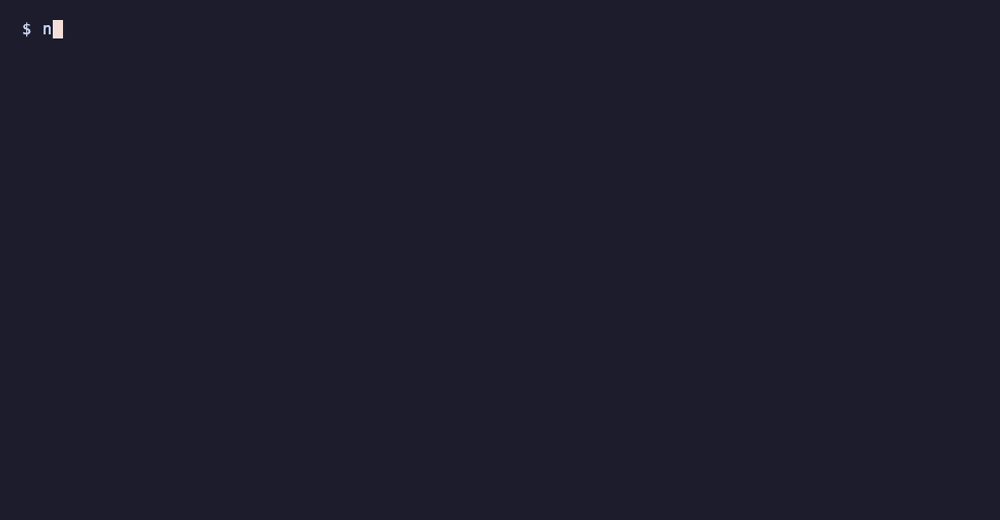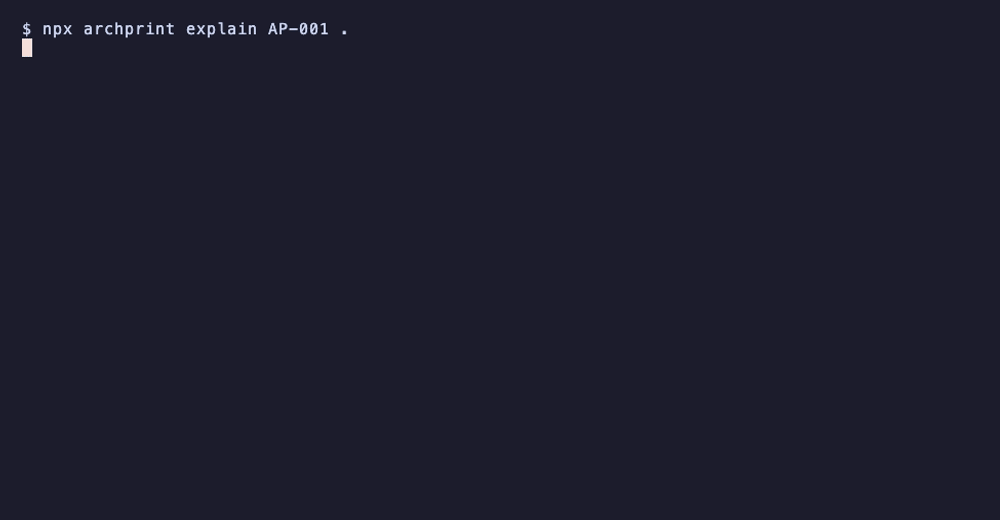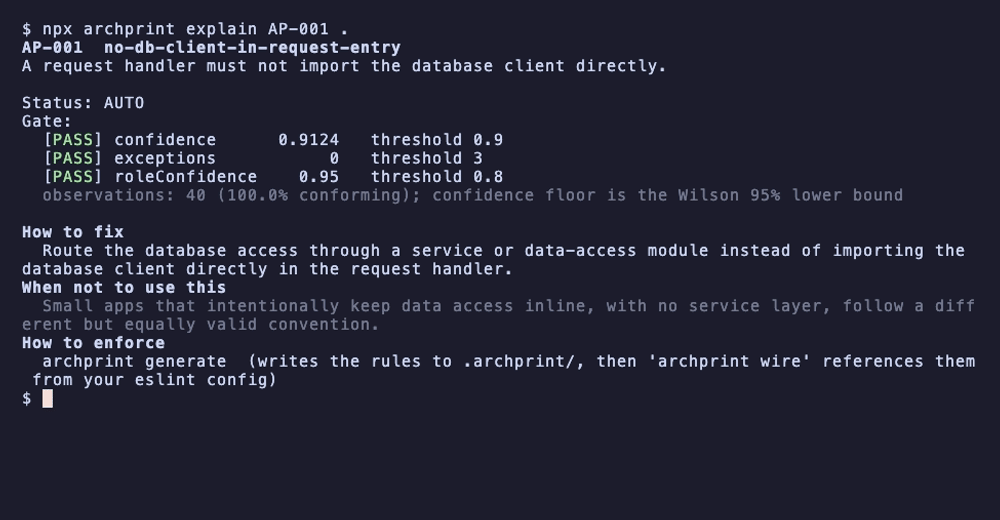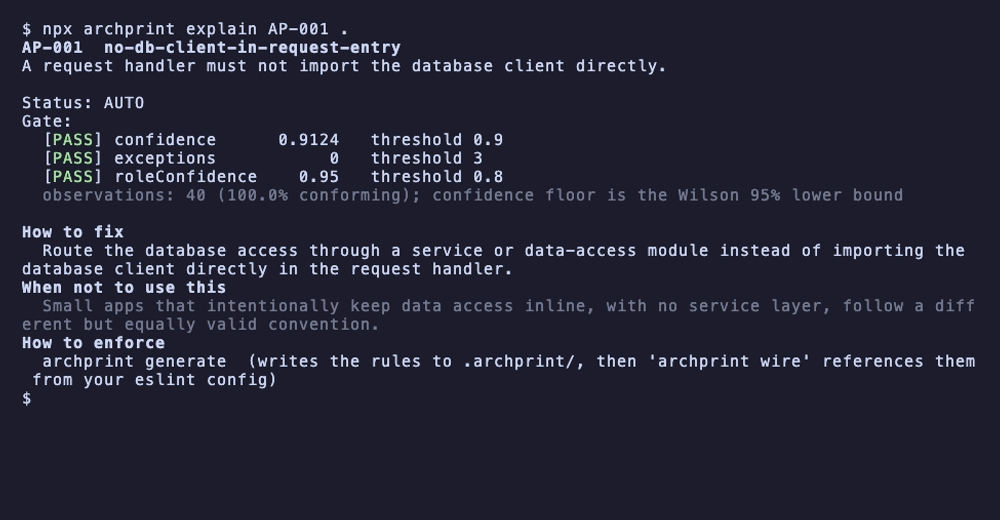
2. Veja por que uma regra é confiável. A verificação de confiança, passo a passo.
3. Ative as regras, veja uma quebra ser detectada e remova tudo novamente. O Archprint escreve seus arquivos, adiciona uma linha à sua configuração do ESLint, o lint sinaliza uma rota que importa o banco de dados diretamente, e eject restaura seu projeto exatamente como estava.
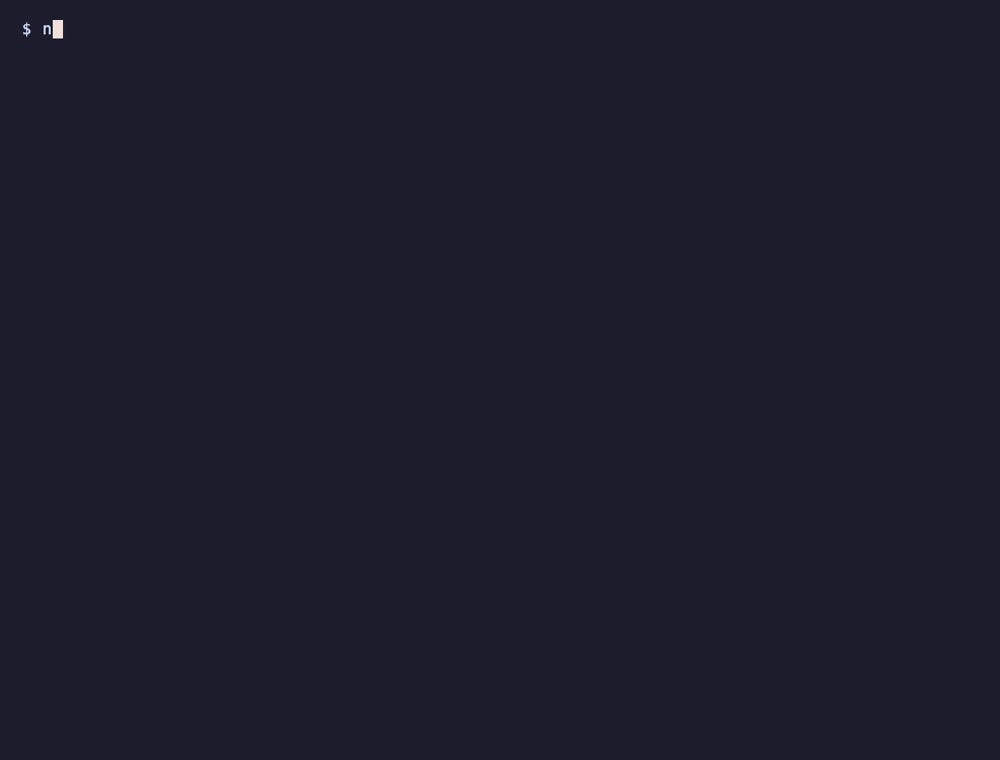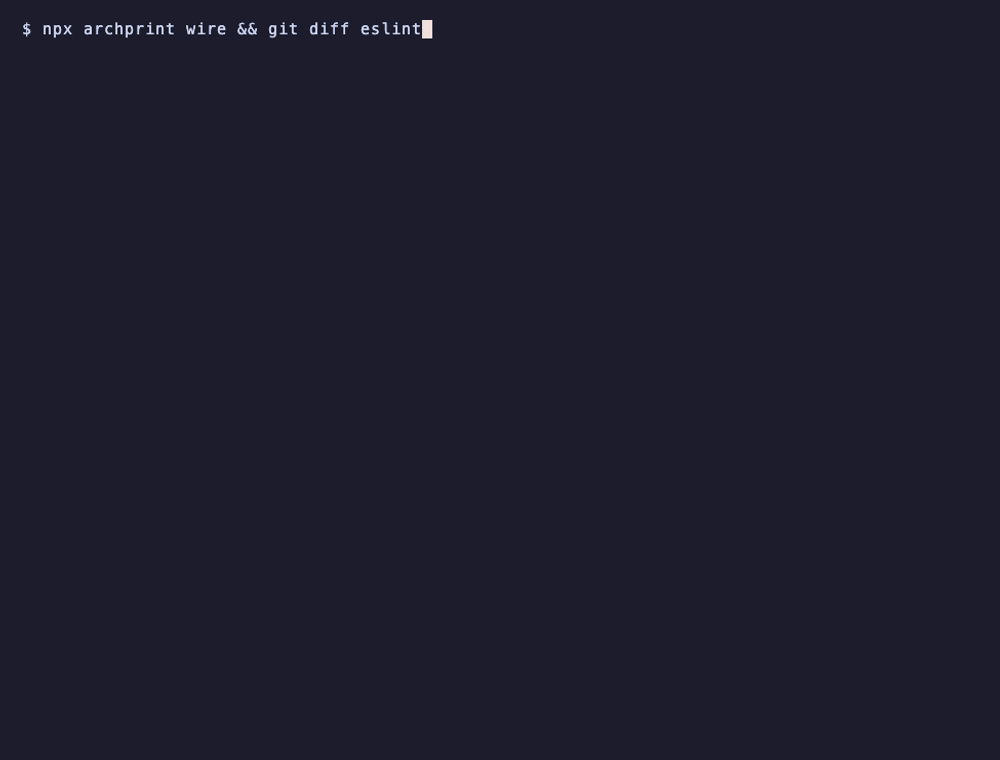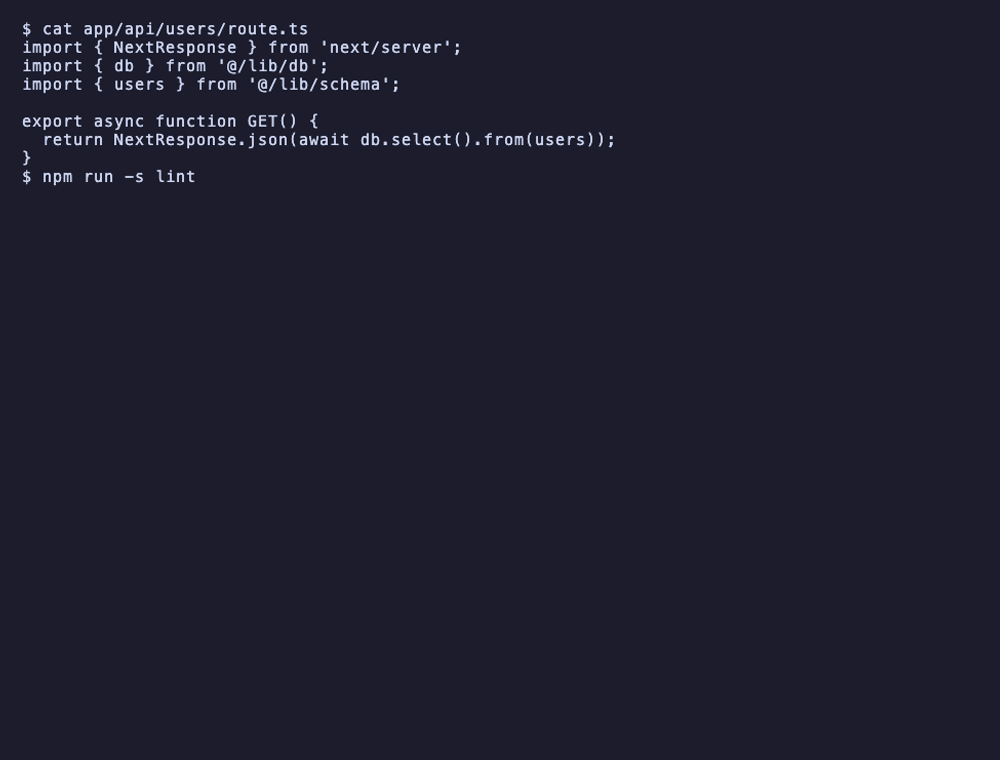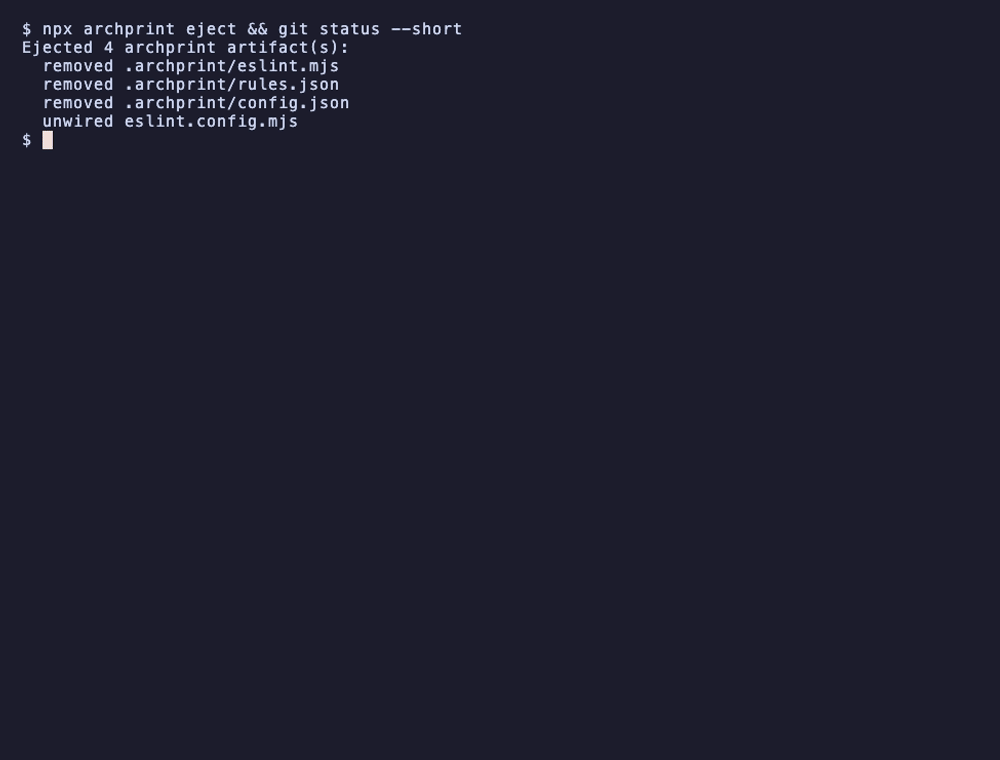
Experimente você mesmo, nada para instalar: abra a demo no StackBlitz. A varredura roda assim que abre, e o README da demo mostra como aplicar uma regra no ESLint, quebrá-la e pedir as regras via MCP.
Uso com agentes de codificação com IA
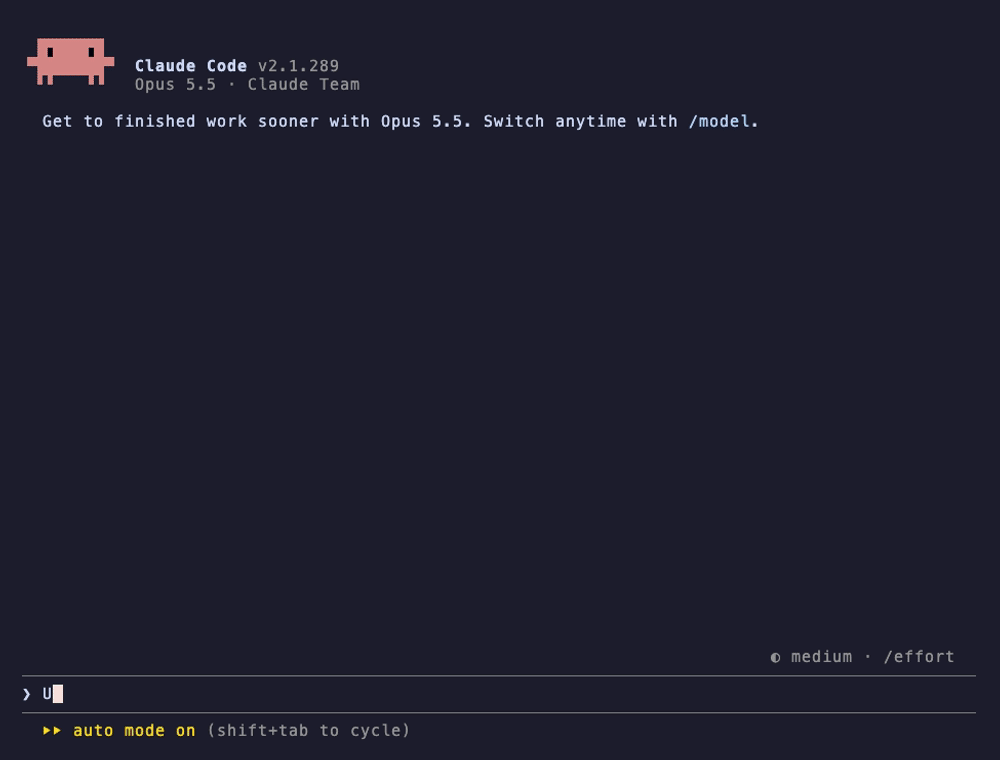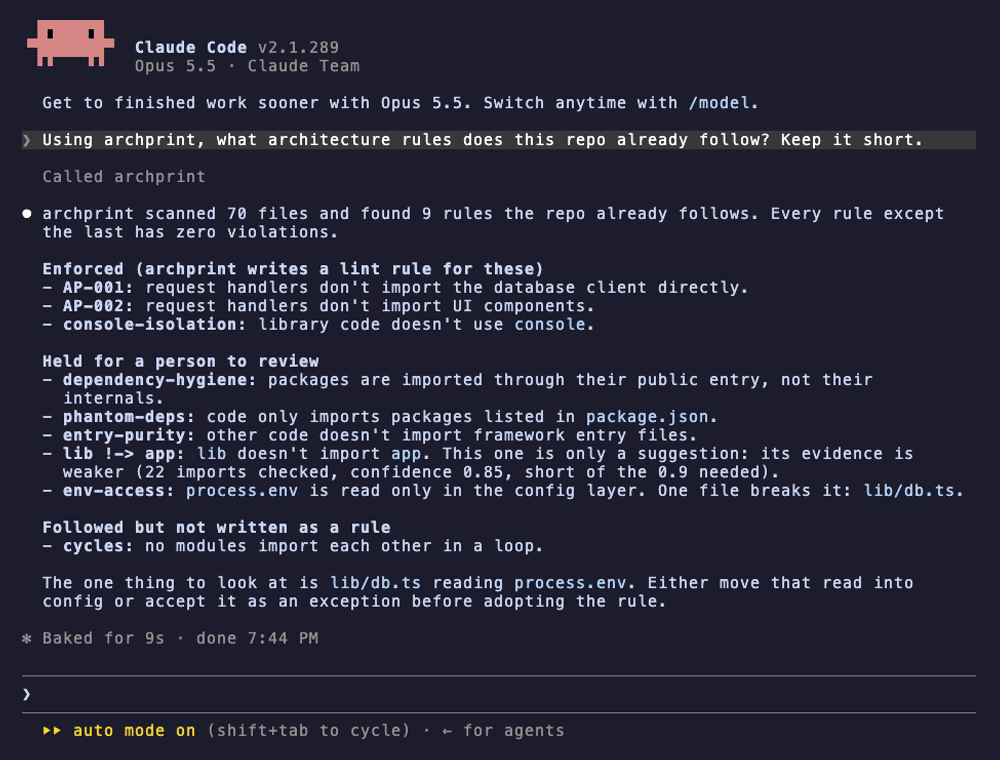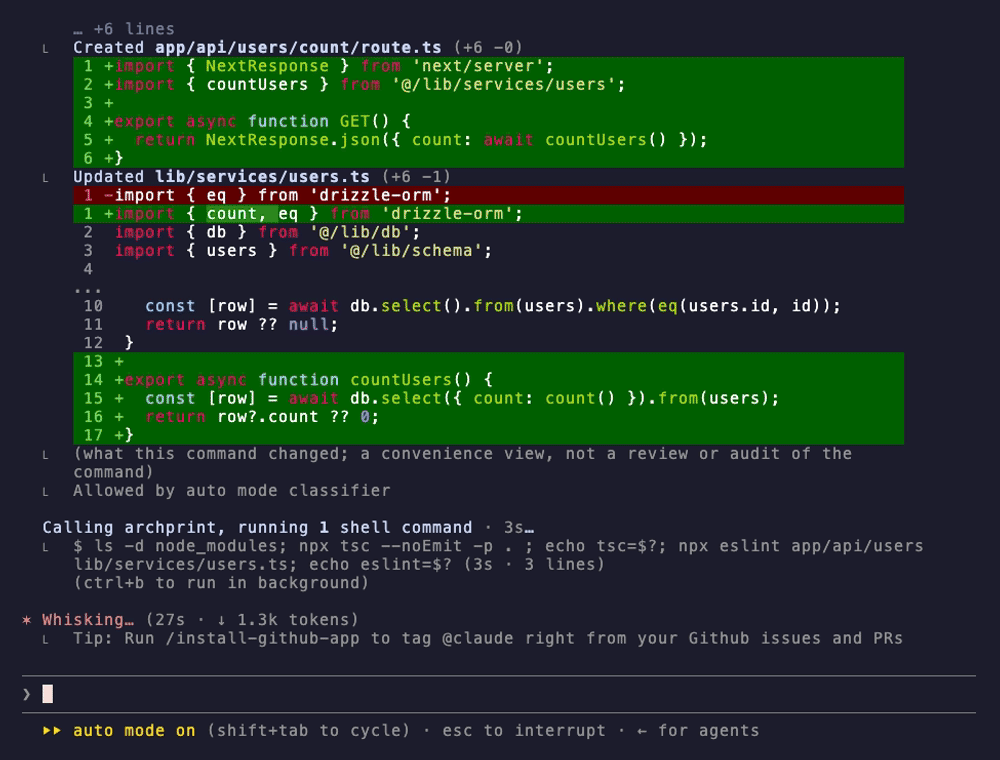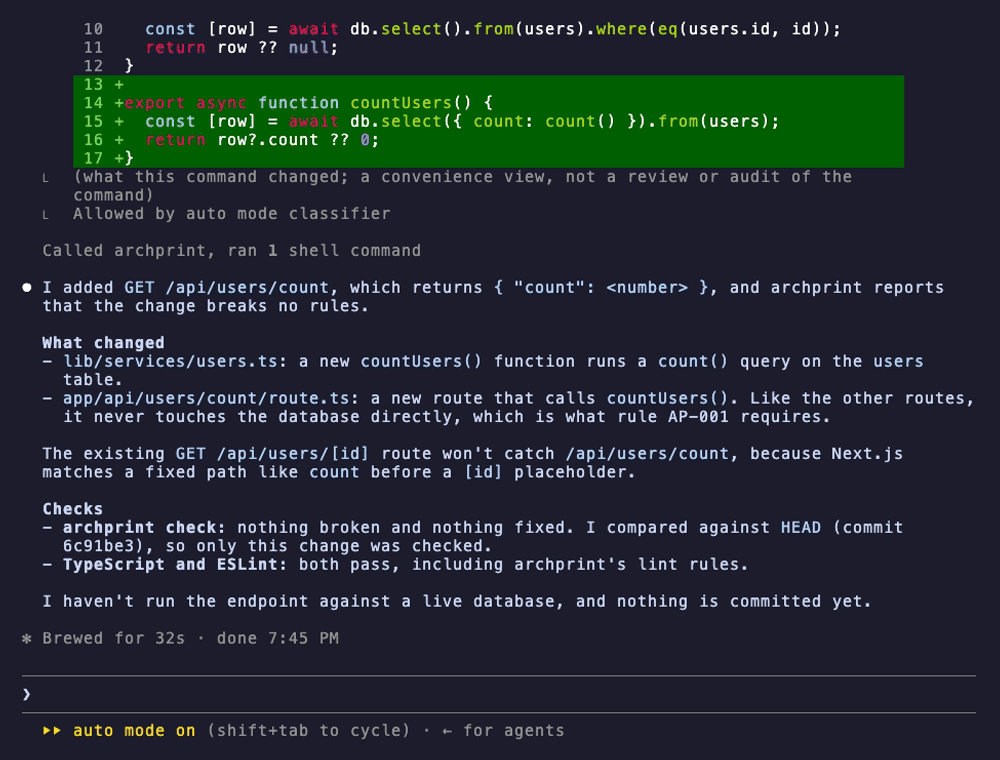
Agentes de codificação com IA podem pedir ao Archprint as regras de um projeto por meio do MCP, um padrão aberto que permite que agentes usem ferramentas externas. Você pergunta em palavras simples; o agente chama o Archprint por conta própria e responde com as evidências. O Archprint apenas reporta. A aplicação continua rodando no seu linter.
Claude Code lista as regras com o que é aplicado e o que está retido para revisão, depois adiciona uma rota e verifica a própria alteração com o archprint antes de reportar:
Cursor funciona da mesma forma. Nestas gravações, o Cursor foi configurado com Grok 4.7, não Claude. No chat do aplicativo desktop, o agente chamou a ferramenta de varredura do Archprint por conta própria; esta captura de tela mostra o resultado da ferramenta e a resposta:
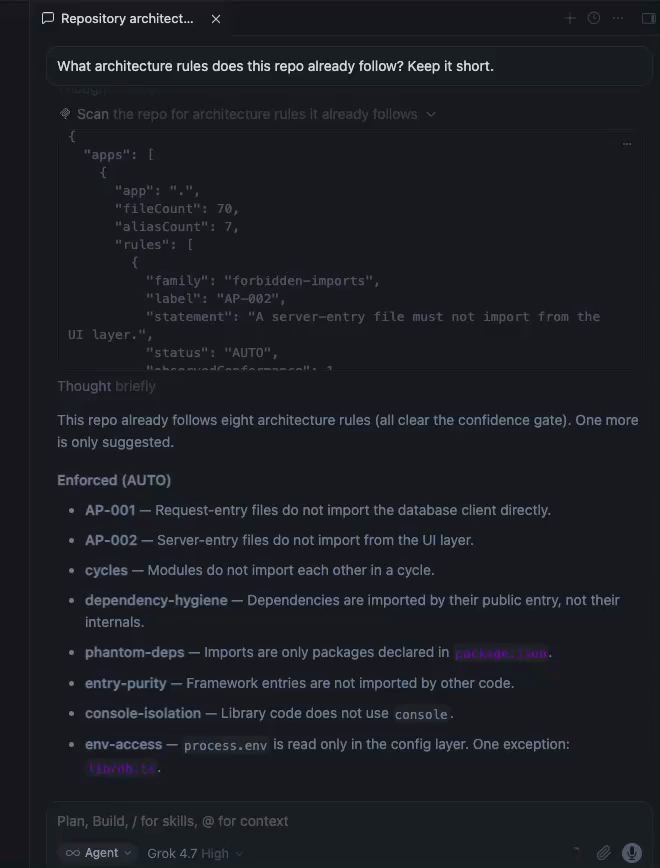
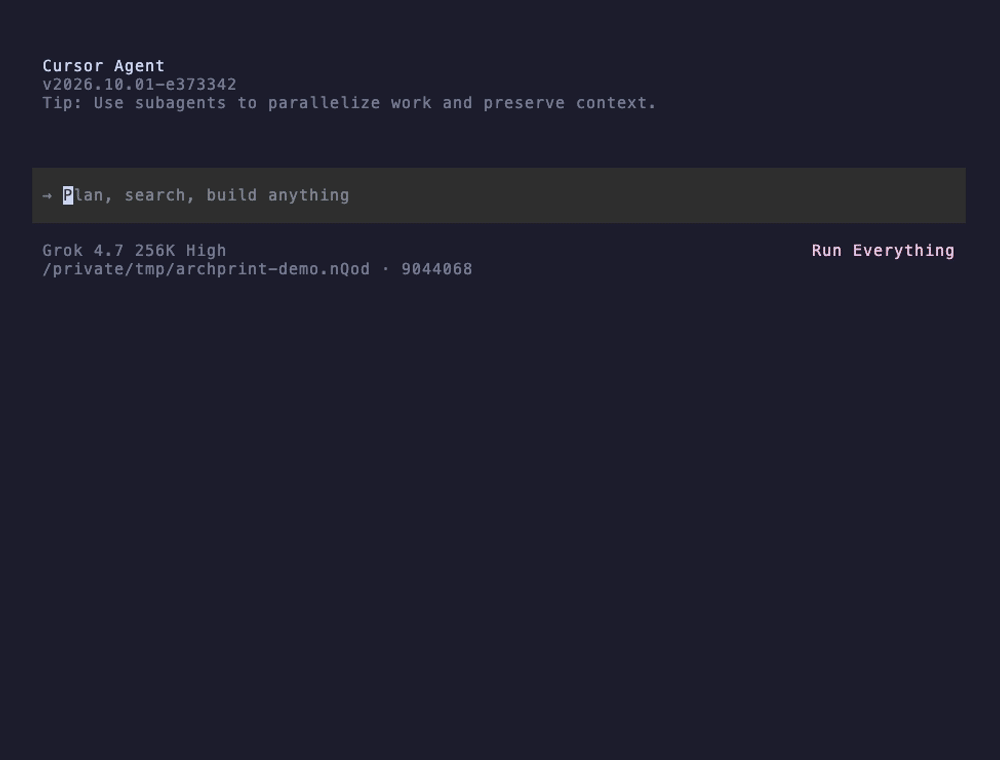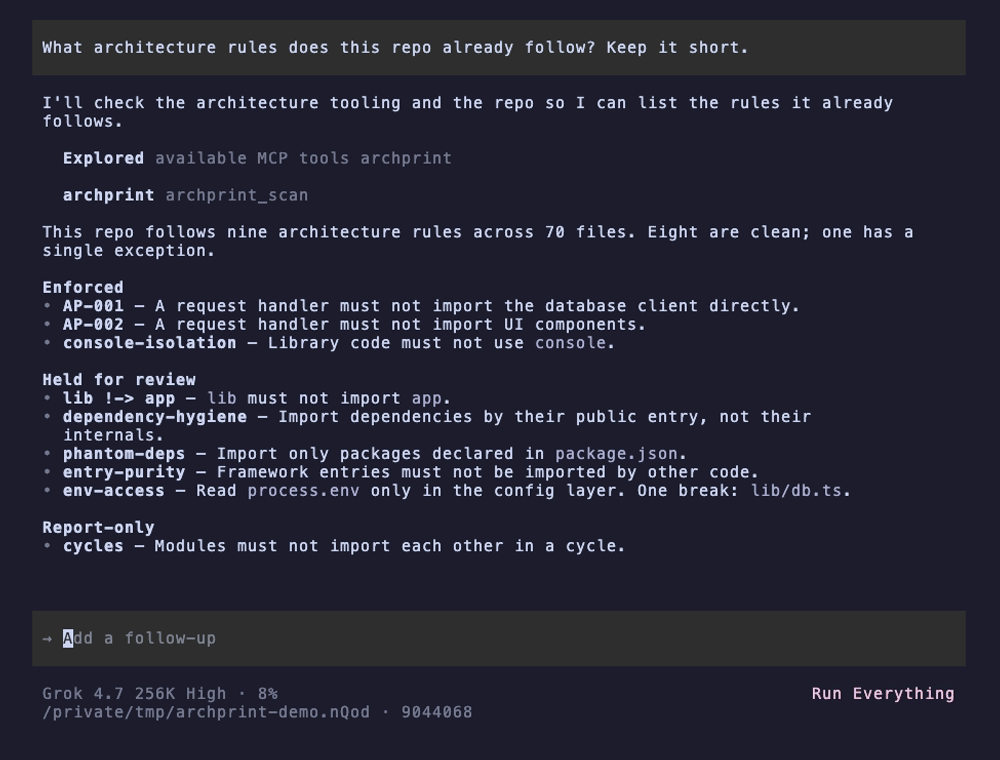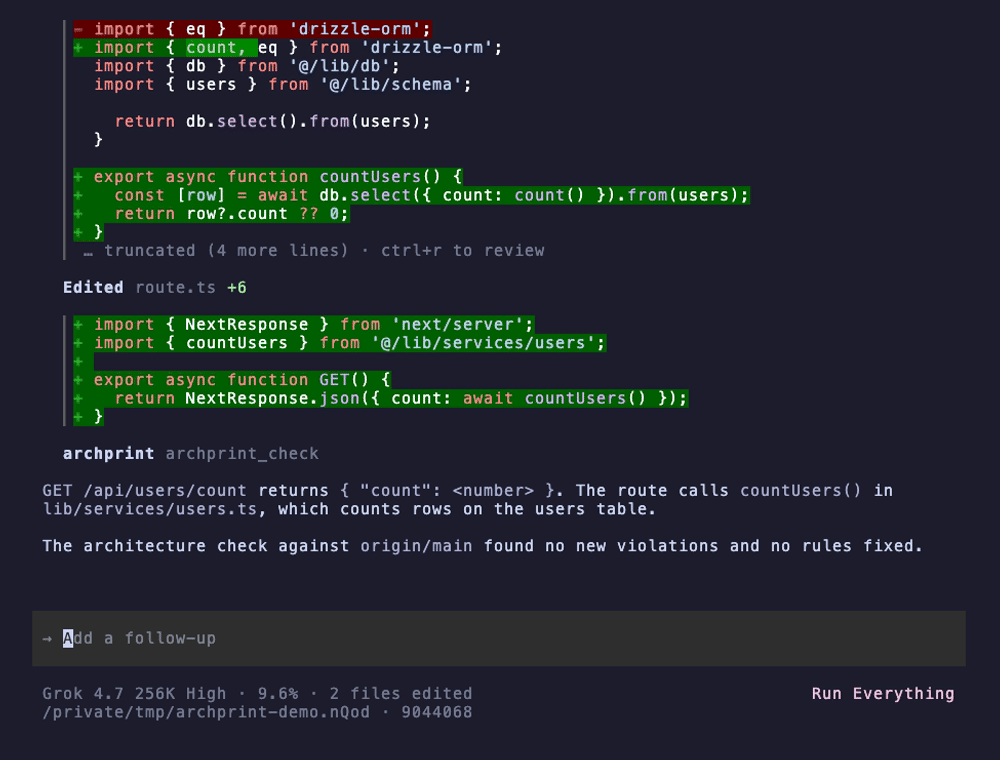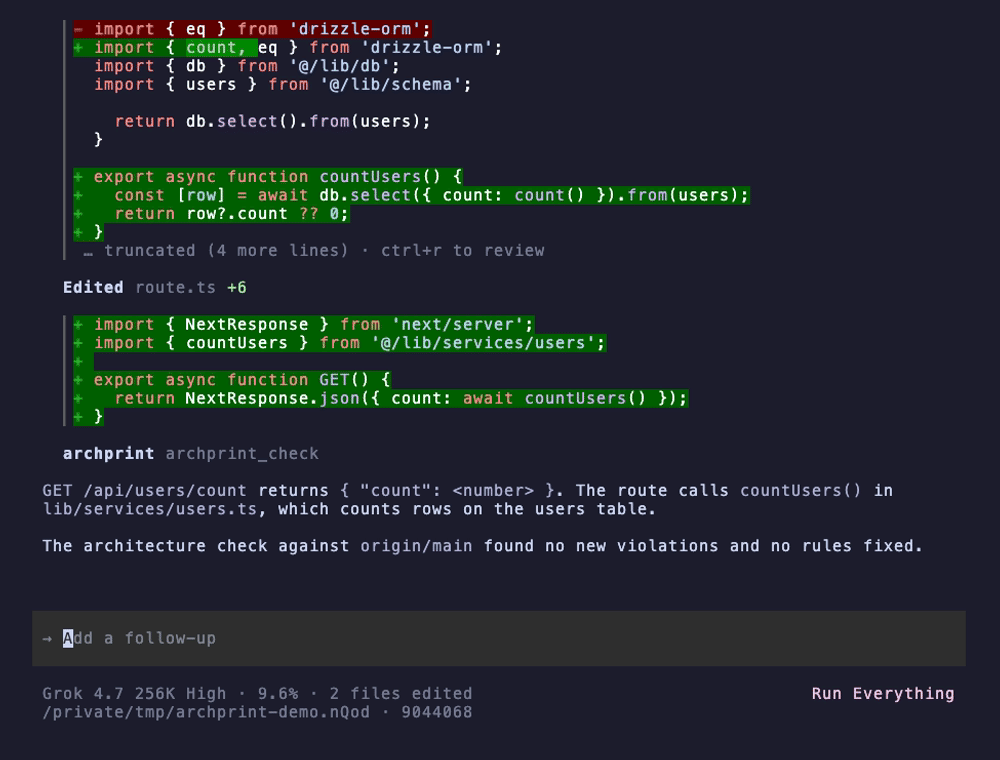
No terminal (cursor-agent), ele faz o mesmo: lista as regras, depois adiciona a rota e a verifica com archprint_check:
Medido: a mesma pergunta com e sem Archprint
Perguntamos ao Claude Code (Opus 5.5) "Quais regras de arquitetura este repositório já segue?" no aplicativo demo (70 arquivos), cinco execuções de cada forma. Mediana [intervalo]:
| Sem Archprint | Com Archprint | |
|---|---|---|
| Tokens lidos | 81k [58k a 96k] | 52k [52k a 52k] |
| Tokens escritos | 1.1k [1.1k a 1.4k] | 0.6k [0.6k a 0.6k] |
| Custo por pergunta | $0.083 [$0.078 a $0.153] | $0.037 [$0.032 a $0.076] |
| Tempo | 17 s [15 a 19] | 10 s [9 a 31] |
| Chamadas de ferramenta | 5 [4 a 10] | 2 [2 a 2] |
O que as respostas mostraram:
- Ambos encontraram a regra principal: rotas acessam o banco de dados apenas por meio de
lib/services/. - Com o Archprint, toda execução deu a evidência de cada regra e nomeou o único arquivo que quebra uma delas (
lib/db.tslêprocess.envfora da camada de configuração). Nenhuma execução sem ele percebeu isso. - Sem o Archprint, o Claude também descreveu convenções de nomenclatura que o Archprint não verifica.
Leia esses números com cuidado: cerca de 50k dos tokens lidos em ambas as colunas são do próprio prompt de sistema do Claude Code, e este é um repositório pequeno; repositórios maiores ainda não foram medidos. Método, harness e todas as respostas.
A configuração para Claude Desktop, Claude Code, Cursor e outros clientes está em Configuração do MCP.
Início rápido
Requer Node 20 ou mais recente. Execute estes comandos em uma pasta com um tsconfig.json. Em um monorepo, scan e recommend também aceitam a raiz e cobrem todos os aplicativos, enquanto init e generate funcionam em um aplicativo por vez (por exemplo, apps/web); em uma raiz com vários aplicativos, eles param, listam os aplicativos e pedem para você executar novamente com um deles.
# 1. See the rules your code already follows, with the evidence. Changes nothing.
npx archprint scan .

# 2. Ask why one rule is trusted (use a rule label from the scan)
npx archprint explain AP-001 .

# 3. Set up enforcement for the rules your code already follows cleanly,
#    and record what to review or adopt next in .archprint/config.json
npx archprint init .

# 4. Connect the generated rules to your ESLint / dependency-cruiser config (one managed line)
npx archprint wire

# 5. Run your linter as usual. Your code passes today; a new import that breaks a rule fails.
npx eslint .

# To undo everything, exactly:
npx archprint eject
Veja ele detectar algo. Após o passo 4, quebre uma regra de propósito: por exemplo, faça um arquivo de rota importar seu cliente de banco de dados diretamente e execute seu linter. Esse é o ciclo completo que a demo percorre no navegador.
Para mantê-lo no projeto em vez de usar npx: npm install --save-dev archprint.
Mais comandos para uma configuração deliberada, passo a passo:
# Inspect the evidence behind one rule
archprint explain AP-002 apps/web

# Write the auto-trusted (mechanical) rules to .archprint/, only for the linters your repo uses.
# Structural-inference rules are held for review; add --include-structural to emit them too.
archprint generate apps/web

# Confirm the generated rules pass on your repo before wiring
archprint generate apps/web --check

# Generate a single rule by id after reviewing it (including a SUGGEST rule)
archprint generate apps/web --rule AP-001

# Recommend a rule set from the evidence and the detected stack (fresh repos too)
archprint recommend apps/web

# Upgrading from 0.5.x? Move an older archprint-rules/ setup to the .archprint layout
archprint migrate
Ou compile a partir do código-fonte:
git clone https://github.com/Tommkruix/archprint
cd archprint
npm ci
npm run build
node dist/cli.js scan <path-to-your-app>
Como ele decide no que confiar
O Archprint é deliberadamente cauteloso: uma regra errada prejudica mais do que nenhuma regra. Cada regra candidata passa por duas verificações antes de ser ativada para você.
1. Há evidência suficiente? Ver 5 de 5 arquivos seguindo um padrão não é prova; 40 de 40 é. O Archprint pontua cada regra com um limite inferior do escore de Wilson, uma medida estatística padrão que combina a frequência com que a regra se mantém com o número de arquivos em que foi verificada. Cada regra cai em um de três grupos:
- AUTO (aplicável): o limite inferior de 95% de conformidade é de pelo menos 90%, com no máximo 3 exceções e um papel classificado com confiança.
- SUGGEST (provisório): o padrão se mantém em pelo menos 80% dos arquivos e o papel tem pelo menos 50% de certeza, mas uma condição AUTO falha: o piso de confiança está abaixo de 90% (poucos arquivos, ou muitos que o quebram), mais de 3 arquivos o quebram, ou o papel tem menos de 80% de certeza. Apresentado para revisão, não gerado automaticamente.
- REJECT: sinal insuficiente.
2. A regra em si poderia estar errada? Uma regra pode passar nos números e ainda assim estar errada se o Archprint adivinhou incorretamente o propósito de uma pasta. Portanto, apenas as famílias mecânicas, que se baseiam em sinais inequívocos, são confiáveis sem revisão: importações proibidas (AP-001, AP-002), dependências circulares, isolamento de testes, estilo de importação, isolamento de console e barris de API pública. Uma auditoria adversarial de correção (três rodadas em quatro repositórios reais) encontrou zero falsos positivos nessas famílias em todas as rodadas. Todas, exceto dependências circulares, são escritas como regras de lint; para ciclos, o Archprint reporta o resultado, mas ainda não escreve uma regra.
As famílias estruturais inferem uma "camada" ou "papel" a partir dos caminhos, o que pode estar errado (limites de camada e papel, separação UI/dados, pureza de entrada, servidor/cliente, isolamento de fatias de funcionalidade e de aplicativo, acesso a variáveis de ambiente, API de pacotes de workspace, isolamento de histórias). A higiene de dependências, cuja aplicação pode sinalizar demais, e a declaração de dependências também são retidas. Todas essas são retidas para sua revisão por padrão e escritas como aplicação apenas com --include-structural, independentemente de sua pontuação estatística, até que conquistem o mesmo histórico limpo. Nada que possa estar errado é aplicado sem que você opte por isso.
As regras geradas são verdes por construção: cada uma permite as poucas exceções conhecidas a partir das quais foi inferida, então adotá-la mantém seu lint verde enquanto novas violações ainda são detectadas, e uma verificação de autoconsistência se recusa a escrever uma regra cuja evidência não se sustenta. Para executar as regras geradas contra seu código antes de conectá-las, use archprint generate --check.
O que ele pode detectar
Entrega como: Auto = ativado como aplicação (famílias mecânicas). Review = retido para sua revisão por padrão; emita com --include-structural. Report = mostrado apenas, nunca aplicado.
O Archprint reconhece a stack (Next.js, Nest, SvelteKit, Nuxt, Remix) e classifica componentes de UI em React (.tsx), Angular (.component.ts, .directive.ts) e componentes de arquivo único Vue e Svelte (ele lê o bloco <script> de arquivos .vue/.svelte), então as regras cientes de componentes se aplicam independentemente do framework.
| Detector | Regra que ele pode inferir | Incluído como |
|---|---|---|
| Imports proibidos (AP-001, AP-002) | AP-001: um ponto de entrada de requisição (route handler) não deve importar o cliente de banco de dados. AP-002: um ponto de entrada de servidor não deve importar a camada de UI | Automático |
| Dependências circulares | O grafo de módulos deve permanecer acíclico (controlado pelo quão livre de ciclos ele já está); relatado, nenhuma regra de lint escrita ainda | Relatório |
| Isolamento de testes | Código de produção (não-teste) não deve importar arquivos de teste ou spec | Automático |
| Higiene de dependências | Importar pacotes de terceiros pela sua entrada pública, não pelos internals de uma dependência src/internal | Revisão |
| Declaração de dependências | Todo pacote de terceiros importado deve ser declarado em package.json (sem deps fantasma/transitivas) | Revisão |
| Estilo de import | Preferir aliases de workspace em vez de imports relativos profundos (../../../) | Automático |
| Isolamento de console | Código de biblioteca (não-CLI) não deve chamar console.* | Automático |
| Limites de API pública (barrel) | Arquivos fora de um feature ou pacote devem importá-lo pelo barrel index, não importar profundamente seus internals | Automático |
| Limites de camada | Arquivos em uma camada não devem importar outra, inferido pela direção dominante de dependência | Revisão |
| Camadas por papel | Níveis semânticos mantêm sua direção (um REPOSITORY não deve importar um SERVICE, um SERVICE não deve importar um CONTROLLER) | Revisão |
| Pureza de entrada | Entradas de framework (pages, routes, layouts) não devem ser importadas por outro código first-party | Revisão |
| Separação UI / dados | Componentes de UI reutilizáveis não devem importar a camada de banco/dados diretamente | Revisão |
| Limite servidor / cliente | Um módulo Next.js "use client" não deve importar um módulo server-only | Revisão |
| Isolamento de fatias de feature | Fatias irmãs sob um contêiner features/modules/slices/domains não devem importar umas às outras | Revisão |
| Isolamento de apps | Apps irmãos sob um contêiner apps/services não devem importar uns aos outros diretamente | Revisão |
| Acesso a env | Ler process.env apenas na camada de config/env | Revisão |
| API de pacote do workspace | Importar um pacote de workspace monorepo pelo seu nome, não por um caminho profundo no seu source | Revisão |
| Isolamento de stories | Arquivos Storybook .stories não devem ser importados por outro código | Revisão |
| Módulos órfãos | Arquivos que nada importa e que não são entradas de framework (candidatos a código morto) | Relatório |
| Alcançabilidade transitiva | Um limite de camada que uma regra de import simples passa, mas que vaza através de uma camada intermediária | Relatório |
recommend (e init) classificam cada família de regras em níveis: regras que seu código já segue (aplicar agora), regras
que seu código segue que o Archprint relata, mas ainda não escreve (dependências circulares hoje), regras com
evidência fraca (revisar e adotar), e regras que repositórios comparáveis comumente seguem, mas o seu ainda não (adotar desde o
primeiro dia). Cada recomendação carrega a parcela de repositórios comparáveis (sua stack detectada, caso contrário
geral) que já aplicam essa regra, extraída de um censo de dezenas de milhares de repositórios TypeScript
públicos. Então, mesmo um repositório novo, com pouco código para aprender, obtém uma linha de base ciente da stack, apoiada pelo que o
ecossistema realmente faz, em vez de padrões escolhidos a dedo.
O que ele escreve no seu projeto
archprint generate (e init) escreve uma pasta .archprint/ mínima, e apenas para os linters que seu repositório
realmente usa. Ele detecta
ESLint e dependency-cruiser e emite cada regra para uma ferramenta que você já executa, então você não fica com configuração para
uma ferramenta que não tem. --emit <eslint|dependency-cruiser|all> força o formato.
.archprint/eslint.mjs: um arquivo de configuração plana ESLint autocontido que incorpora cada regra ESLint inferida (imports proibidos baseados em marcadores, limites de estilo de importno-restricted-imports, isolamento de console) e precisa de nenhum plugin extra: ele adiciona regras à sua configuração ESLint existente, que já analisa seu TypeScript. Então você pode commitá-lo, publicá-lo, ou entregá-lo a outro repositório e adotá-lo em uma linha (import archprint from './.archprint/eslint.mjs'). Ele se auto-ignora**/.archprint/**. As regras de import proibido (AP-) são incluídas como um plugin ESLint local gerado dentro dele, então conectar a configuração ESLint também as aplica, sem instalação extra..archprint/dependency-cruiser.json(quando dependency-cruiser está presente): um rulesetforbiddencom os limites mecânicos (deep-import de API pública, isolamento de teste); os mantidos para revisão (camada, camadas por papel, fatia de feature, isolamento de apps, pureza de entrada, internals de dependência, deps fantasma) são adicionados apenas com--include-structural, após você revisá-los..archprint/config.json: a definição exata de cada regra mecânica que você adotou, com a evidência registrada na adoção e o modo de resolução em que foi gerada (archprint checka lê, então uma verificação nunca re-infere uma regra), as exceções que você permitiu com um motivo, o que é aplicado, seguido mas apenas relatado, mantido para revisão, e vale a pena adotar, e a lista de saídas gerenciadas queejectremove.- Uma seção gerenciada no seu
README.mdresumindo o que é aplicado agora, seguido mas apenas relatado, mantido para revisão, e vale a pena adotar (escrito porinit, ougenerate --readme), além de uma entrada.prettierignoregerenciada para que os arquivos gerados fiquem fora do seu formatador.
--expand adicionalmente escreve os artefatos granulares dentro de .archprint/: os JSONs ESLint e dependency-cruiser
por família, cartões por regra (.md) com fixtures que passam e falham, a configuração de element-types do eslint-plugin-boundaries,
testes ts-arch, e o grafo de camadas Mermaid e Graphviz DOT.
Permanecendo em sincronia, e saindo limpo. Re-executar generate (ou init) atualiza .archprint/ e remove qualquer
regra que a evidência não suporta mais, então a saída nunca se desvia do código. wire insere uma única referência
gerenciada em cada ferramenta de aplicação que seu repositório usa (uma configuração plana eslint, um .dependency-cruiser.json), uma que
sobrevive a essas regenerações; para uma configuração que ele não pode editar com segurança (uma configuração JS dependency-cruiser, por exemplo), ele imprime
o trecho exato para colar. eject remove os arquivos do Archprint e cada referência conectada, restaurando cada configuração
exatamente. generate --check executa as regras ESLint geradas contra seu repositório e relata se elas passam, então você
pode confirmar antes de conectar. Atualizando da 0.5.x? archprint migrate move uma configuração archprint-rules/ mais antiga para
este layout e reconecta suas configurações no lugar.
Uso em CI
archprint check relata apenas as violações que uma mudança introduz, comparado com uma branch base, para as regras
que sua equipe adotou com init ou generate. O backlog existente nunca aparece, e cada achado carrega sua
evidência. Funciona em qualquer CI, e no GitHub mostra cada achado inline no pull request
(veja em um pull request de demonstração).
No GitHub, use a Action archprint check (no GitHub Marketplace):
# .github/workflows/archprint.yml
name: archprint
on: pull_request
permissions:
  contents: read
jobs:
  check:
    runs-on: ubuntu-latest
    steps:
      - uses: Tommkruix/archprint-action@v1
Ela faz checkout do próprio pull request, então não precisa de etapa de checkout. A mesma verificação em etapas simples, sem a Action:
# .github/workflows/archprint.yml
name: archprint
on: pull_request
permissions:
  contents: read
jobs:
  check:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v5
        with:
          ref: ${{ github.event.pull_request.head.sha }}
          fetch-depth: 0
      - uses: actions/setup-node@v5
        with:
          node-version: 22
      - run: npm ci
      - run: npx archprint check --base ${{ github.event.pull_request.base.sha }} --format github
-
Aviso por padrão. Adicione
--fail-on new(ou ofail-on: newda Action) para falhar o job em uma nova violação, então marque o job como uma verificação de status obrigatória na proteção da sua branch para que um pull request que adicione uma não possa mesclar. -
Apenas regras adotadas.
checklê as regras adotadas em.archprint/config.json, escritas porinitegenerate, e verifica apenas as regras mecânicas registradas lá, nunca as estruturais. Regras adotadas no mesmo pull request são listadas mas nunca contadas contra ele. -
Uma exceção justificada precisa de um motivo. Quando um arquivo tem um motivo real para quebrar uma regra, registre-o:
npx archprint allow AP-001 app/api/health/route.ts --reason "Health check queries the database directly". Ele vai na listaallowedde.archprint/config.json,checkpara de contá-lo e o lista com seu motivo no pull request, e o próximoarchprint generatepara de sinalizá-lo no ESLint. Uma entrada sem motivo é rejeitada, e uma entrada que o código não precisa mais é apontada. Regras aplicadas através do dependency-cruiser (API pública) não são cobertas nesse lado ainda. -
Remover regras nunca é silencioso. Se um pull request exclui
.archprint/config.json, ou as regras nele, que a branch base tem,checkavisa e lista cada regra que para de ser verificada. Ele não falha o job, porque remover uma regra pode ser uma decisão deliberada da equipe. Para tornar essa decisão necessária de um revisor, adicione uma entrada CODEOWNERS e ative "Exigir revisão dos Code Owners" na proteção da branch:/.archprint/ @your-team /.github/workflows/ @your-team -
Atualizando: da 0.8.x ou anterior, execute
archprint generateuma vez para registrar as regras adotadas. Até você fazer isso,checkpublica um aviso de que não executou e sai com 0. Configurações da 0.9.0 a 0.11.x continuam funcionando como estão:checkainda lê seusrules.jsoneallow.json, e o próximogeneratemove ambos paraconfig.json. -
Outros sistemas de CI:
--format jsondá saída com versão-chave, e o código de saída é o contrato:0ok,1novas violações com--fail-on new,2a configuração do CI está errada (por exemplo, um clone raso sem o commit base). Faça checkout do histórico completo (fetch-depth: 0ou o equivalente do seu CI). -
Seguro em pull requests de forks. Ele precisa apenas de acesso de leitura, não usa segredos, e nunca executa seu código.
Configuração MCP
archprint mcp executa o Archprint como um servidor MCP sobre stdio, então um agente pode perguntar
quais regras de arquitetura seu repositório já segue, com a evidência, antes de escrever código. Ele expõe quatro
ferramentas somente leitura: archprint_scan, archprint_recommend, archprint_explain, e archprint_check. Cada regra
volta declarada em palavras simples, com sua evidência, os arquivos que a quebram, e se o archprint a aplica,
a mantém para revisão, ou apenas a relata. archprint_explain aceita qualquer rótulo de regra da varredura (por exemplo
AP-002 ou env-access). archprint_check relata as regras adotadas que a mudança atual do agente quebra,
edições não commitadas incluídas, então ele pode corrigi-las antes de terminar. Aponte Claude Desktop, Claude Code, Cursor, ou
qualquer cliente MCP para ele:
{
  "mcpServers": {
    "archprint": { "command": "npx", "args": ["-y", "archprint", "mcp"] }
  }
}
Coisas para perguntar ao seu agente. Você não nomeia as ferramentas; o agente as escolhe:
- "Quais regras de arquitetura este repositório já segue?"
- "Qual arquivo viola a regra de acesso a env, e como devo corrigi-lo?"
- "Estou adicionando uma nova rota de API. Quais regras ela deve seguir neste codebase?"
- "Quais regras devemos aplicar agora, e quais valem a pena adotar?"
Seu código permanece na sua máquina. Por padrão, este é um servidor local: ele lê seu checkout local, então é o indicado para código privado, e seu código-fonte nunca sai da sua máquina, independentemente do git host que você use.
Se o servidor não iniciar. Se o cliente disser que o servidor falhou ao iniciar ou que npx não foi encontrado, ele não
consegue ver o PATH do seu shell. Aplicativos de desktop abertos pelo Dock ou Menu Iniciar não o carregam, o que é comum quando o Node
vem do nvm ou Homebrew. Um caminho completo para npx sozinho não é suficiente, porque o próprio npx precisa do node no
PATH. Aponte ambos para a pasta que o dirname "$(which node)" imprime, por exemplo /opt/homebrew/bin:
{
  "mcpServers": {
    "archprint": {
      "command": "/opt/homebrew/bin/npx",
      "args": ["-y", "archprint", "mcp"],
      "env": { "PATH": "/opt/homebrew/bin:/usr/bin:/bin" }
    }
  }
}
Abrir o editor a partir de um terminal também funciona, pois ele herda o PATH do seu shell.
Instalações em uma linha. No Claude Code:
claude mcp add archprint -- npx -y archprint mcp
No Cursor, coloque o JSON acima em .cursor/mcp.json no seu projeto (ou ~/.cursor/mcp.json para todos os projetos),
e então habilite archprint em Settings > MCP.
Escaneando um repositório público por URL. archprint mcp --http executa um servidor remoto. Ele clona o repositório de forma rasa
para um diretório temporário, executa a mesma análise somente-leitura, retorna o resultado e exclui o clone (apenas URLs
públicas de github.com, gitlab.com e bitbucket.org; nada é gravado ou mantido). As ferramentas então recebem uma URL de repo
(e um ref opcional). Ele escuta em 0.0.0.0:8848/mcp por padrão (defina --host 127.0.0.1 para mantê-lo apenas na sua
própria máquina, ou --port/$PORT para mudar a porta) e responde a verificações de saúde em /health (use esta no Cloud
Run, que reserva /healthz) e /healthz. Cada requisição clona e escaneia, então um servidor acessível a qualquer pessoa gasta
computação em nome de qualquer um: mantenha-o atrás de autenticação, como o IAM do Cloud Run, a menos que você aceite esse custo.
As ferramentas são somente-leitura (nunca gravam no repositório); use o generate/wire da CLI para realmente emitir e
aplicar regras.
Como se compara
Ferramentas TypeScript estabelecidas (dependency-cruiser, eslint-plugin-boundaries, Nx, Sheriff, ts-arch) todas aplicam regras de arquitetura que você escreve manualmente. O Archprint infere essas regras a partir do grafo de importação real e condiciona cada uma a evidências estatísticas antes de propô-la. Ele então emite nos formatos dessas ferramentas, complementando sua stack em vez de substituí-la.
Verificado contra a documentação de cada ferramenta (ecossistema TypeScript). As duas colunas que importam são as que nenhuma outra ferramenta TypeScript preenche:
| Ferramenta | Aplica regras de arquitetura | Auto-infere do grafo de importação | Anexa evidências estatísticas |
|---|---|---|---|
| Archprint | sim | sim | sim |
| dependency-cruiser | sim | não | não |
| eslint-plugin-boundaries | sim | não | não |
| @nx/enforce-module-boundaries | sim | não | não |
| Sheriff | sim | não | não |
| ts-arch | sim | não | não |
| madge / knip | apenas análise | não | não |
Ressalva honesta: em outros ecossistemas, Tach (Python) e ArchLint (Java) fazem auto-inferência de limites de módulos, então o nicho específico do Archprint é auto-inferência mais condicionamento por evidências estatísticas no ecossistema TypeScript. O Archprint também se sobrepõe na detecção com dependency-cruiser (ciclos, órfãos, alcançabilidade) e knip (código morto); em vez de competir, ele escreve as regras que gera nos formatos dessas ferramentas.
Comandos
archprint init [path]: configuração zero-config. Detecta a stack, aplica as regras que o código já segue, e escreve.archprint/além de uma seção README gerenciada. Opções:--expand,--include-structural,--out <dir>,--fast,--force.archprint scan [path]: relata as regras que o repositório já segue, com evidências. Não altera nada.--deepresolve através de barrels e aliases.archprint explain <id> [path]: mostra o detalhamento do gate para uma regra, com um codeframe por exceção, além de como corrigir, quando não usar e como aplicar.archprint recommend [path]: recomenda um conjunto de regras a partir das evidências do repositório e da stack detectada (funciona também em um repositório novo), e nomeia a ferramenta instalada que aplicará cada regra que ele puder escrever.archprint generate [path]: escreve as regras mecânicas de confiança automática em.archprint/para os linters que seu repositório usa; regras estruturais são mantidas para revisão.--emit <eslint|dependency-cruiser|all>força o formato,--only <family>e--rules <ids>restringem a saída,--checkexecuta as regras geradas contra seu repositório,--readmeadiciona a seção README,--expandtambém escreve os arquivos por família, cards, fixtures e grafo, e--rule <id>emite uma regra revisada. Também--include-structural,--no-graph,--out <dir>,--fast.archprint check [path]: relata as violações das suas regras adotadas que uma alteração introduz, comparado com--base <branch or commit>. Apenas aviso, a menos que--fail-on new.--format text|json|github,--out <dir>. Veja Uso em CI.archprint allow <rule> <file> --reason "...": aceita uma regra adotada sendo quebrada em um arquivo, com um motivo, registrado em.archprint/config.json.checkpara de contá-la e a lista no pull request;generateimpede o ESLint de sinalizá-la.--removea remove novamente.archprint wire: referencia as regras geradas a partir das ferramentas de aplicação que seu repositório usa (config flat do eslint,.dependency-cruiser.json) através de uma referência gerenciada e reversível.--out <dir>,--dry-run.archprint eject: remove os arquivos gerados do Archprint, sua configuração, a seção README gerenciada e quaisquer referências conectadas, restaurando cada configuração exatamente.--out <dir>,--dry-run.archprint migrate(aliasupgrade): move uma configuraçãoarchprint-rules/mais antiga para o layout.archprint/e reconecta suas configurações no lugar.--dry-run.archprint mcp: executa o Archprint como um servidor MCP para que Claude, Cursor e outros agentes possam chamar as ferramentas somente-leiturascan,recommend,explainecheck. Serve via stdio por padrão;--httpexecuta um servidor remoto que escaneia um repositório público por URL (scan,recommendeexplain).
scan --json, recommend --json e check --format json emitem JSON estável e versionado por chave para scripts. Os códigos
de saída são o contrato: 0 em sucesso, 1 em erro (para check: novas violações com --fail-on new), 2 para um
check que não pôde ser executado devido à configuração de CI.
Exemplo em um repositório real
Uma varredura real de inbox-zero (apps/web, 2.232 arquivos TypeScript), resumida:
Scanned 2,232 TypeScript files
Workspace aliases: 18 resolved

GENERATED RULES
  AP-002  no-ui-layer-in-server-entry      confidence 97%
          A request handler must not import UI components.
          Evidence: 216 of 217 files it applies to follow it (99.5%)
          Exceptions: 1

LAYER BOUNDARIES (review before enforcing)
  utils !-> app  layer boundary   confidence 99%
          Evidence: 650/653 utils files conform (99.5%); 451 app file(s) depend on utils
  hooks !-> app  layer boundary   confidence 94%
          Evidence: 65/65 hooks files conform (100%); 121 app file(s) depend on hooks
AP-002 é uma família mecânica, então ela gera automaticamente como aplicação. Os limites de camada são inferidos, então são
mostrados para revisão, não escritos como aplicação a menos que você passe --include-structural. Cada número é medido
a partir do grafo de importação, não estimado.
Notas técnicas
Modos rápido e profundo. scan usa por padrão uma passagem rápida no nível de especificador (sem type checker). generate usa por padrão
uma passagem profunda que resolve através de barrels e aliases de workspace, já que a geração é o ponto de compromisso.
A análise estrutural (ciclos, órfãos, alcançabilidade, API pública) sempre usa o grafo rápido: ele é fiel à resolução
profunda para esses casos, e a detecção de API pública na verdade o exige (a resolução profunda resolveria através de um barrel
e apagaria o sinal barrel-versus-profundo).
Determinismo. O mesmo repositório na mesma versão produz a mesma saída. A análise é pura e ordenada; não há aleatoriedade, e o motor de análise é fixado a uma versão exata.
Status
Publicado no npm e seguro para executar no seu repositório real. Cada regra é condicionada a revisão por padrão, reversível em um
comando (archprint eject) e determinística, e as regras geradas são verdes por construção no código do qual
foram inferidas.
- Validado em escala:
scanerecommendexecutaram sobre um corpus de 92.861 repositórios TypeScript públicos (61.690 apps) com zero crashes; 91 repositórios (0,1%) não puderam ser buscados ou expiraram. O ciclo completoinit/wire/ejectrodou limpo em uma amostra estratificada de 2.000 repositórios. - Pronto para produção hoje:
scanerecommend,checkpara pull requests, e auto-aplicação das famílias mecânicas, com uma verificação de autoconsistência no momento da geração, um scaffolderinitpara repositórios novos, e cobertura de frameworks em React, Angular, Vue e Svelte. O motor (vinte detectores, o gate de confiança e emissores para um arquivo ESLint autocontido, dependency-cruiser, ts-arch e o grafo de camadas) está no lugar e testado. - Ainda por vir: endurecimento das famílias estruturais rumo à auto-aplicação (uma medida real de confiança de papel por arquivo, coesão de camadas, ordenação do classificador de papéis).
- A versão ainda é 0.x, então a superfície da CLI e o formato de regras podem refinar entre versões menores. Isso é uma
superfície em maturação, não análise experimental. O layout compacto
.archprint/chegou na 0.6.0, earchprint migrateatualiza uma configuração mais antiga no lugar.
Um benchmark companheiro, AgentRuleBench, mede a questão orientação-versus-aplicação diretamente (um resultado nulo honesto e pré-registrado no limite que testou).
Palavras usadas aqui
- Importação: uma linha em um arquivo que usa código de outro. As regras do Archprint são sobre quais arquivos podem importar quais.
- Regra de lint / linter: uma verificação automática que roda no seu código (ESLint é o mais comum) e sinaliza problemas enquanto você escreve.
- AUTO / SUGESTÃO / REJEITAR: o quão confiante o Archprint está em uma regra; veja Como ele decide no que confiar.
- Famílias mecânicas / estruturais: regras baseadas em sinais inequívocos (confiáveis sem revisão) versus regras que dependem de adivinhar o papel de uma pasta (mantidas para sua revisão).
- MCP: um padrão aberto que permite que agentes de IA usem ferramentas externas como o Archprint.
Documentação
A documentação completa está em tommkruix.github.io/archprint e em
docs/: primeiros passos, conceitos (o gate
de confiança, mecânico vs. estrutural, rápido vs. profundo, o ciclo de vida gerar/conectar/remover) e a
referência de famílias de regras (o que cada regra detecta, como ela é entregue e quando não usá-la).
Contribuindo
Veja CONTRIBUTING.md. O projeto faz lint, type check e testes em si mesmo; cada alteração mantém a cobertura acima de seus limites e envia um changeset.