Radar
Servidor MCP de observabilidade e diagnóstico para Kubernetes, focado em saúde do cluster, diagnóstico de workloads, logs, eventos, topologia, descobertas de auditoria e ações de remediação.
Documentação
Radar

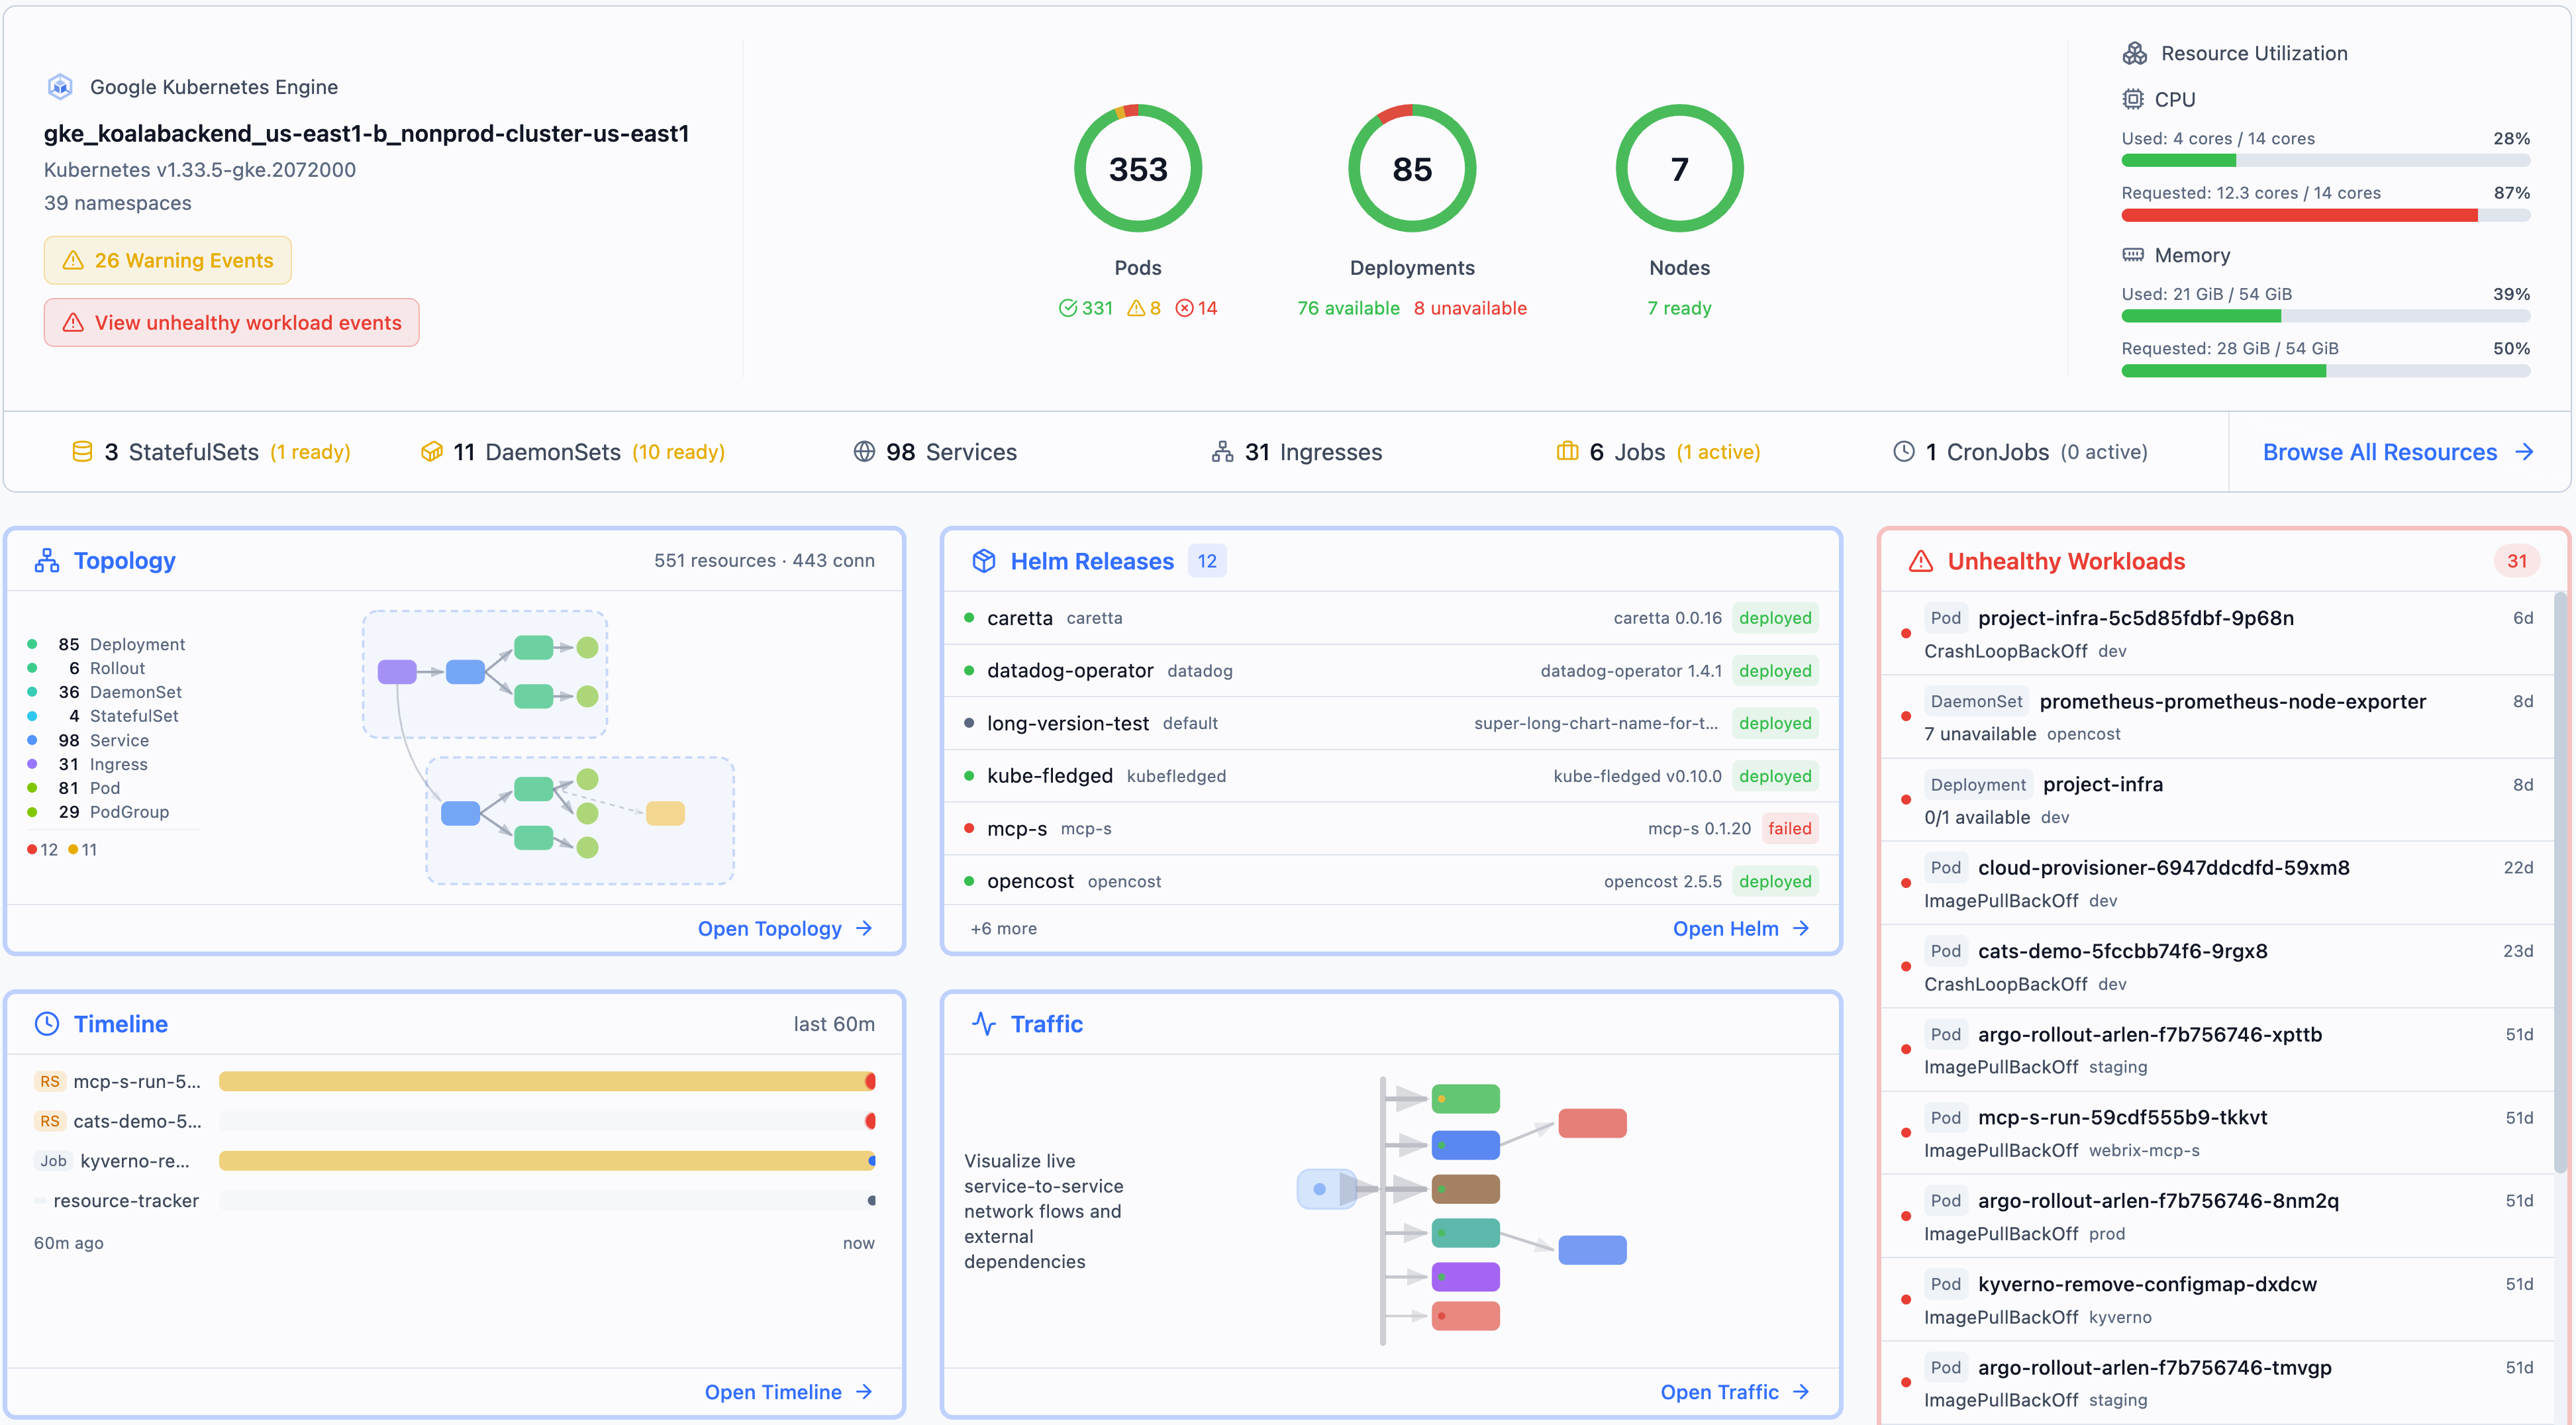
A interface de Kubernetes open-source que faltava.
Binário único. Sem necessidade de conta. Gratuito para sempre.
🌐 radarhq.io · Documentação · Releases
Topologia, recursos, Helm, GitOps, tráfego, auditoria, impacto de upgrades e contexto MCP para agentes de IA — do seu laptop ou dentro do cluster.




Sumário
- Por que Radar?
- Instalação
- Uso
- Visões — Topologia · Recursos · Sistema de Arquivos de Imagem · Linha do Tempo · Helm · Comparar · TLS · GitOps · Tráfego · Custo · Auditoria · Impacto de upgrades · RBAC · MCP · Auth
- Recursos Suportados
- Atalhos de Teclado
- Segurança
- Desenvolvimento · Contribuindo
Instale e execute em 30 segundos:
curl -fsSL https://get.radarhq.io | sh && kubectl radar
Por que Radar?
- Zero instalação no seu cluster — roda no seu laptop, fala diretamente com a API do K8s
- Binário único — sem dependências, sem agentes, sem CRDs
- Rápido em clusters grandes — testado com dezenas de milhares de pods, com visões responsivas e atualizações em tempo real sob mudanças reais no cluster
- Privado por design — os dados do seu cluster permanecem na sua máquina. Sem conta, sem agentes, sem sincronização em nuvem. O relatório de uso fica desativado a menos que você opte por ativá-lo, e então envia apenas contagens anônimas de uso e fatos básicos do cluster: versão do Kubernetes, plataforma, faixa de número de nós, integrações conhecidas (o que o Radar envia)
- Compatível com ambientes isolados — roda como um binário único contra a API do Kubernetes e funciona em ambientes restritos com egress de saída bloqueado
- Tempo real — observa seu cluster via informers, envia atualizações ao navegador via SSE
- Funciona em qualquer lugar — GKE, EKS, AKS, minikube, kind, k3s ou qualquer cluster conforme
- Pronto para IA — servidor MCP integrado permite que agentes de IA inspecionem, investiguem e operem seu cluster através do Radar
- Opção dentro do cluster — implante com Helm para acesso compartilhado da equipe com permissões limitadas por RBAC
"Tenho o Radar implantado no trabalho. Dos dashboards de Kubernetes que existem, este é um dos melhores." — u/TheRealNetroxen
Instalação
Instalação rápida:
curl -fsSL https://get.radarhq.io | sh
Homebrew:
brew install skyhook-io/tap/radar
Em seguida, execute: kubectl radar. A instalação rápida, PowerShell, Homebrew e Scoop também configuram o atalho radar. Krew e downloads diretos usam kubectl radar a menos que você adicione seu próprio symlink radar.
Mais opções de instalação — Aplicativo Desktop (macOS/Linux/Windows), Krew, Scoop, Helm no Cluster
CLI
Krew (gerenciador de plugins do kubectl):
kubectl krew install radar
Scoop (Windows):
scoop bucket add skyhook https://github.com/skyhook-io/scoop-bucket
scoop install radar
PowerShell (Windows):
irm https://get.radarhq.io/install.ps1 | iex
Local de instalação personalizado (macOS/Linux):
curl -fsSL https://get.radarhq.io | INSTALL_DIR="$HOME/.local/bin" sh
A instalação rápida grava em /usr/local/bin a menos que INSTALL_DIR indique o contrário. O diretório é criado se não existir e precisa estar no seu PATH para que radar e kubectl radar sejam resolvidos.
Download direto — GitHub Releases para macOS, Linux ou Windows.
Aplicativo Desktop
Aplicativo desktop nativo — sem necessidade de terminal.
Homebrew (macOS):
brew install --cask skyhook-io/tap/radar-desktop
Debian/Ubuntu — baixe o .deb do GitHub Releases e então:
sudo apt install ./radar-desktop_*.deb
Fedora/RHEL — baixe o .rpm do GitHub Releases e então:
sudo rpm -i radar-desktop_*.rpm
Scoop (Windows):
scoop bucket add skyhook https://github.com/skyhook-io/scoop-bucket
scoop install radar-desktop
Windows (download direto) — GitHub Releases.
Implantação no Cluster
Implante no seu cluster para acesso compartilhado da equipe:
helm repo add skyhook https://skyhook-io.github.io/helm-charts
helm install radar skyhook/radar -n radar --create-namespace
Consulte o Guia de Implantação no Cluster para exposição via Gateway API e ingress, autenticação e configuração de RBAC.
Uso
# Opens browser automatically
kubectl radar

# Quick install, PowerShell, Homebrew, and Scoop also set up the bare command
radar
Para inspecionar uma instalação do Radar Cloud no cluster sem alterá-la:
radar cloud status
radar cloud status --context my-cluster
radar cloud status --context my-cluster --namespace radar --release radar
O comando relata a propriedade da instalação, chart e imagem, prontidão do agente
e configuração do Cloud sem imprimir o token de conexão. Passar tanto
--namespace quanto --release seleciona uma instalação exata. O status do túnel ao vivo
é relatado pelo Radar Cloud usando o token no Secret do Kubernetes referenciado.
Se o Secret ou o Hub estiver indisponível, os diagnósticos locais de instalação ainda são executados.
Terminais interativos usam cores de status contidas; defina NO_COLOR (ou canalize a
saída) para texto simples. URLs, tokens e comandos sugeridos permanecem sem estilo.
Flags da CLI
A tabela abaixo cobre as flags de inicialização comuns. Consulte a referência completa da CLI; radar --help é a fonte autoritativa para a versão instalada.
| Flag | Padrão | Descrição |
|---|---|---|
--kubeconfig | ~/.kube/config | Caminho para o arquivo kubeconfig principal |
--kubeconfig-dir | Diretórios separados por vírgula contendo arquivos kubeconfig adicionais | |
--namespace | (todos) | Filtro de namespace inicial (suporta multi-seleção na interface; também usado como fallback de RBAC para usuários com escopo de namespace) |
--namespaces | (todos) | Filtros de namespace iniciais como uma lista separada por vírgulas, ex.: --namespaces ns1,ns2,ns3. Use isto quando sua identidade pode listar recursos em namespaces específicos, mas não pode listar namespaces em todo o cluster. |
--namespace-scope | false | Fixa os caches de informer com escopo de namespace a um único namespace para clusters grandes (escopo para múltiplos namespaces ainda não é suportado). Requer --namespace, um namespace de contexto do kubeconfig ou uma seleção salva de namespace único local. O modo local pode reconstruir o cache ao alternar namespaces; o modo auth/cloud trava o cache compartilhado no namespace de inicialização. |
--port | 9280 | Porta do servidor |
--listen-address | 127.0.0.1 | Endereço IP de escuta HTTP (IPv4 ou IPv6), ou localhost. Vincule um IP local específico ou use 0.0.0.0 para todas as interfaces. Acesso não-loopback requer autenticação e controles de rede. |
--base-path | Sirva o Radar sob um prefixo de URL como /radar. Use quando um ingress encaminha um subcaminho sem removê-lo — tudo, incluindo /api/health, move-se sob o prefixo. Não suportado com --cloud-url. | |
--no-browser | false | Não abrir o navegador automaticamente |
--browser | Navegador a usar ao abrir a interface, ex.: firefox, google-chrome ou Google Chrome no macOS | |
--timeline-storage | memory | Backend de armazenamento da linha do tempo: memory, sqlite ou postgres |
--timeline-db | ~/.radar/timeline.db | Caminho para o banco de dados SQLite (ao usar armazenamento sqlite) |
--timeline-max-size | 1Gi | Tamanho máximo do SQLite DB + WAL antes de podar os eventos mais antigos (ex.: 800Mi, 8Gi; 0 desativa) |
--history-limit | 10000 | Máximo de eventos a reter na linha do tempo (somente memória) |
--disable-exec | false | Desativa o terminal e o shell de depuração |
--disable-helm-write | false | Desativa operações de escrita do Helm |
--disable-local-terminal | false | Desativa o terminal local do host |
--debug-image | busybox:latest | Imagem para containers de depuração efêmeros e pods de depuração de nós. Se o PodSecurity restrito integrado rejeitar o container de depuração de pod padrão, o Radar tenta novamente com um contexto de segurança Linux compatível com restrições usando o UID não-root do alvo/pod, ou UID 65532 por padrão; aponte para um espelho compatível para clusters isolados / com registro privado. |
--list-page-size | 0 (desativado) | Pagina a LIST inicial de tipos de alta cardinalidade (Pods, ReplicaSets) neste tamanho. Ajuda clusters muito grandes que falham ao sincronizar; usado apenas quando o streaming WatchList não está disponível. Tente 2000. |
--context-switch-timeout | 30s | Tempo máximo que uma troca de contexto do kubeconfig pode levar. Aumente em planos de controle de alta latência — consulte Ajuste para clusters lentos. Env: RADAR_CONTEXT_SWITCH_TIMEOUT. |
--first-paint-backstop | 5m | Limite superior rígido para a espera de sincronização inicial do cache crítico antes que o Radar recorra a uma renderização com dados parciais. Env: RADAR_FIRST_PAINT_BACKSTOP. |
--namespace-list-timeout | 5s | Timeout para a LIST de namespaces em todo o cluster usada para decidir se o usuário tem restrição de namespace por RBAC. Um timeout em um plano de controle lento é relatado incorretamente na interface como "Lista limitada — RBAC". Env: RADAR_NAMESPACE_LIST_TIMEOUT. |
--max-scope-candidates | 20 | Limite no fanout da sonda de fallback de namespace (usado por contas que podem listar namespaces em todo o cluster, mas não podem listar um tipo específico em todo o cluster). Aumente acima de 20 para clusters com mais de 20 namespaces. Env: RADAR_MAX_SCOPE_CANDIDATES. |
--prometheus-url | (descoberta automática) | URL de consulta PromQL-compatível manual, incluindo Prometheus, VictoriaMetrics, Thanos ou Mimir (pula a descoberta automática) |
--prometheus-single-cluster | false | Substituição opcional de escopo de métricas de carga de trabalho: afirma que o backend contém apenas este cluster. Substitui a correspondência automática de identidade; não limita o escopo de rightsizing ou outros recursos de métricas. Escopo e vida útil. |
--prometheus-cluster-label | (correspondência automática) | Substituição opcional de métricas de carga de trabalho para um backend compartilhado, ex.: cluster=production (repetível, combinado com AND). Alternativa a --prometheus-single-cluster; deixe ambos não definidos para correspondência automática. Não persistido. |
--prometheus-header | Cabeçalho HTTP enviado com cada requisição ao Prometheus, formato Key=Value (repetível). Necessário para backends protegidos por autenticação. | |
--prometheus-header-from-env | Cabeçalho HTTP enviado com cada requisição ao Prometheus, originado de uma variável de ambiente, formato Key=ENV_VAR (repetível). | |
--beyla-job-selector | (vazio) | Fragmento de correspondência do Beyla Live Traffic (vazio corresponde a jobs Beyla/Alloy lá). Os gráficos de carga de trabalho o usam apenas com uma substituição explícita de escopo e aceitam um job de igualdade ou regex. A correspondência automática de carga de trabalho descobre jobs personalizados sem ele. Detalhes. |
--opencost-currency | (detecção automática, depois USD) | Substitui o rótulo de moeda ISO 4217 para valores do OpenCost. O Radar rotula os valores, mas não os converte. |
--auth-mode | none | Modo de autenticação: none, proxy ou oidc (detalhes) |
--no-mcp | false | Desativa o servidor MCP para integração com ferramentas de IA |
--mcp-catalog-stdio | false | Inicia apenas o catálogo MCP via stdio para introspecção de registro |
--version | Mostra a versão e sai |
Consulte o Guia de Configuração para detalhes sobre precedência de conexão ao cluster, múltiplos arquivos kubeconfig e troca de contexto.
Ajuste para clusters lentos ou de alta latência
Os prazos padrão (30 s para troca de contexto, 5 m de limite para a primeira renderização, 5 s para LIST de namespaces, 20 candidatos de escopo) são ajustados para clusters saudáveis alcançados por conexões rápidas e de baixa latência. Eles são apertados demais para clusters alcançados por túneis SSH, planos de controle geograficamente distantes ou contas sujeitas a limitação do servidor de API, onde aparecem como um de três sintomas:
- Notificações "Context switch timed out" quando o cache eventualmente sincroniza
- "Limited list — RBAC doesn't allow listing all namespaces" mesmo que a conta tenha permissão de listagem em todo o cluster (o LIST expirou, não o RBAC)
- Kinds silenciosamente marcados como negados porque o namespace em que vivem ficou além do limite de 20 entradas do candidato
Amplie as quatro flags via CLI ou por meio das variáveis de ambiente correspondentes
(RADAR_CONTEXT_SWITCH_TIMEOUT, RADAR_FIRST_PAINT_BACKSTOP,
RADAR_NAMESPACE_LIST_TIMEOUT, RADAR_MAX_SCOPE_CANDIDATES) — as variáveis de ambiente
mantêm segredos fora do ps e permitem que implantações no cluster obtenham os valores
de um ConfigMap:
# CLI
kubectl radar \
  --context-switch-timeout=120s \
  --first-paint-backstop=10m \
  --namespace-list-timeout=30s \
  --max-scope-candidates=200

# Environment (e.g. in a Deployment manifest)
RADAR_CONTEXT_SWITCH_TIMEOUT=120s \
RADAR_FIRST_PAINT_BACKSTOP=10m \
RADAR_NAMESPACE_LIST_TIMEOUT=30s \
RADAR_MAX_SCOPE_CANDIDATES=200 \
  kubectl radar
Os padrões são preservados quando nem a flag nem a variável de ambiente estão definidas, portanto implantações existentes não são afetadas.
Views
Topology
Grafo interativo mostrando como seus recursos Kubernetes estão conectados em tempo real.
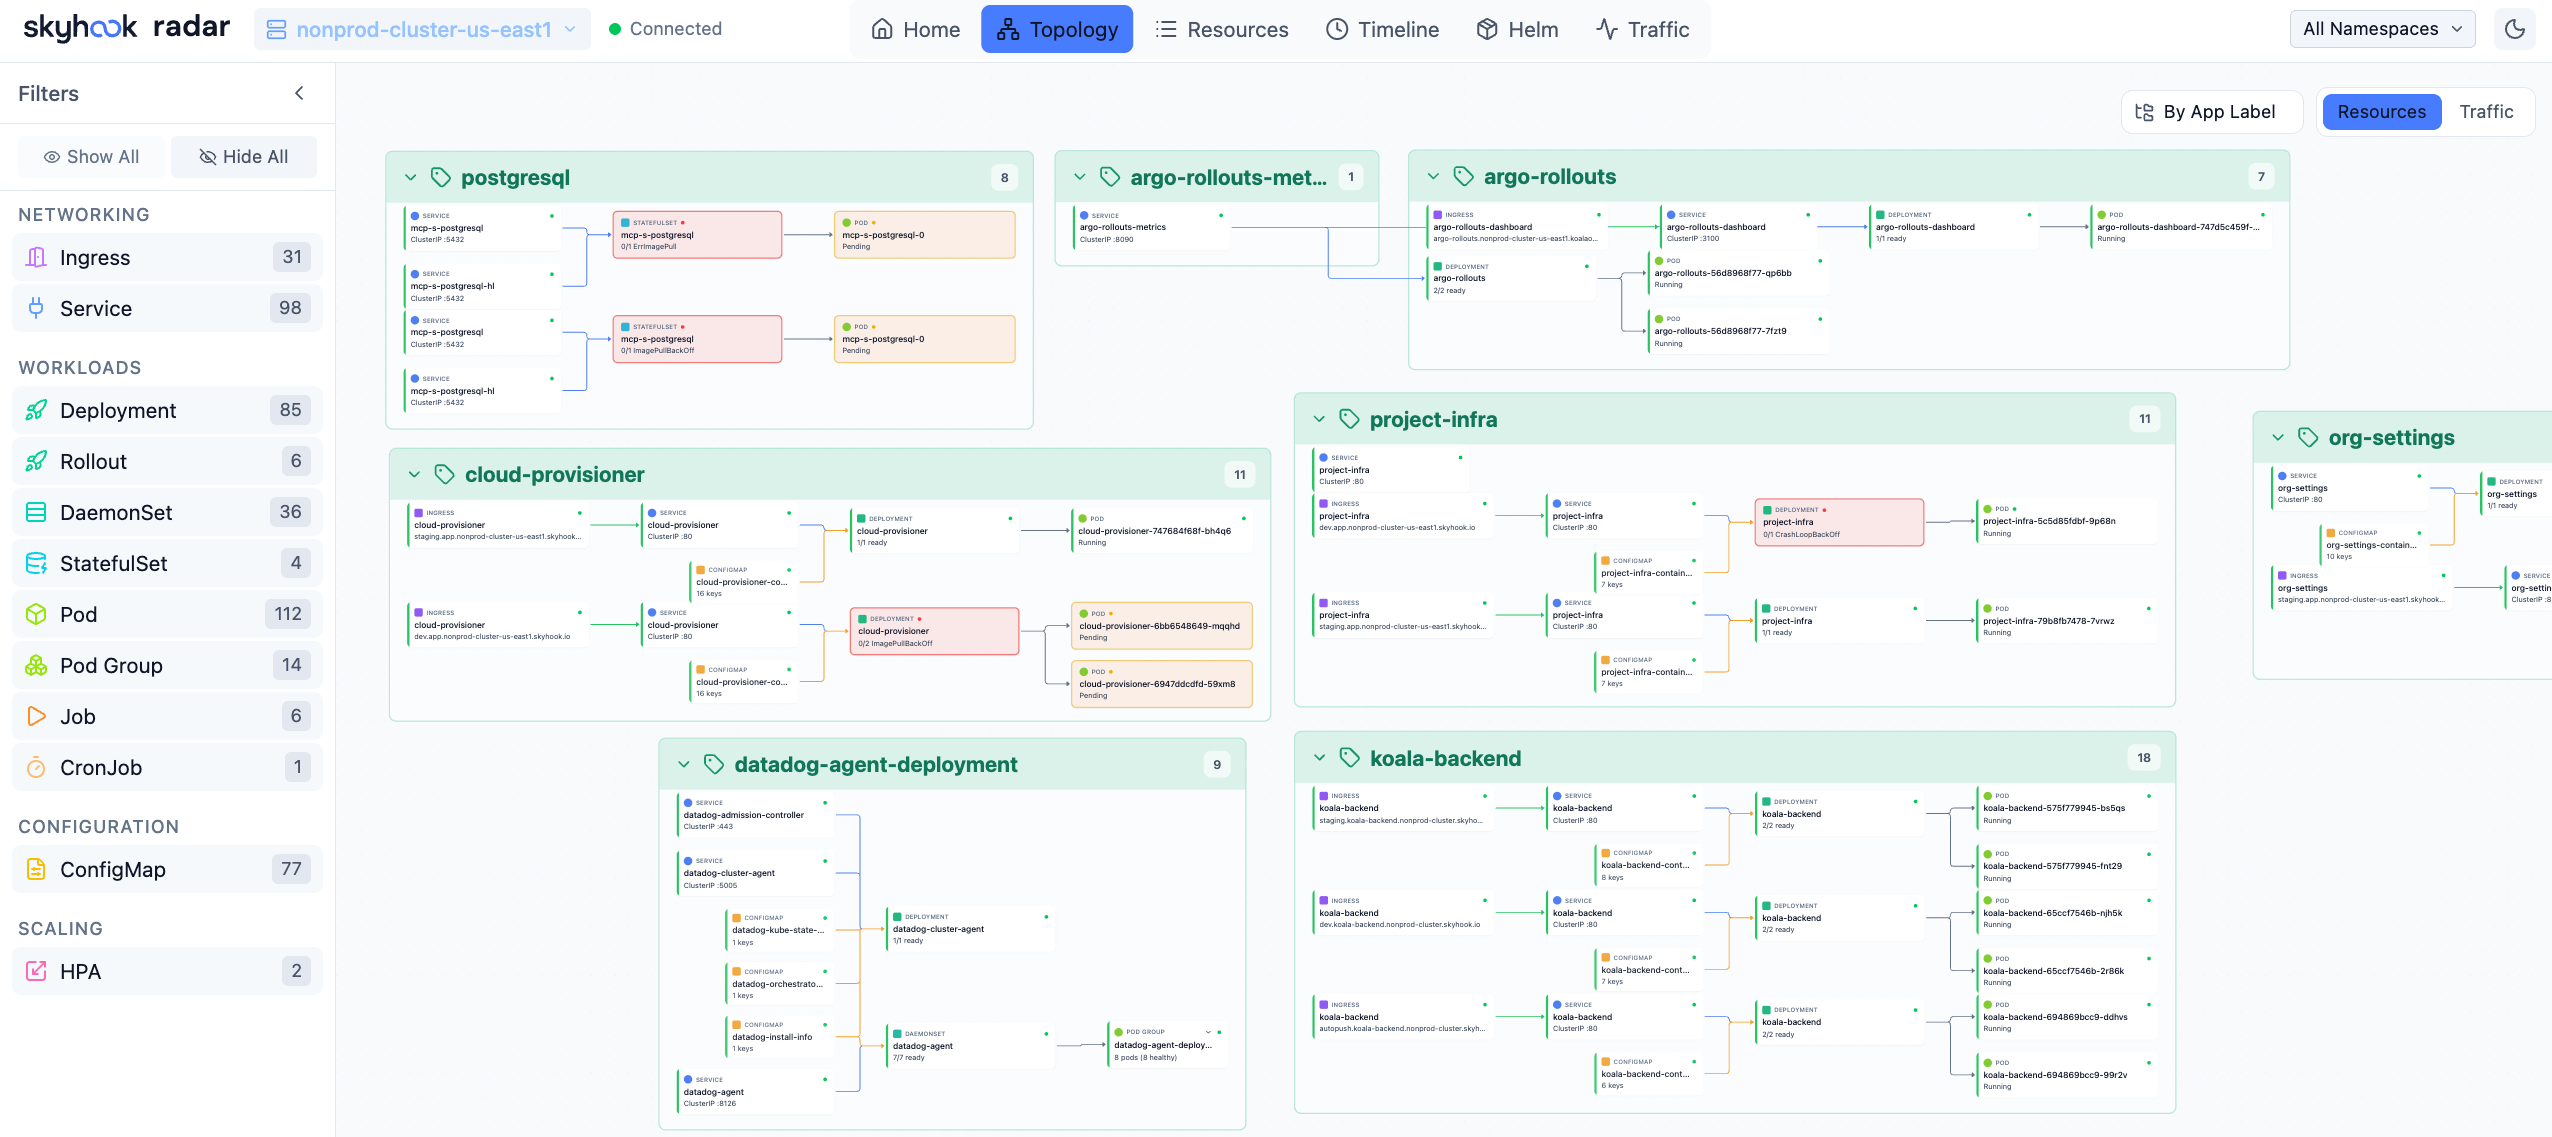
Topology View — Visualize resource relationships
- Dois modos: Resources (hierarquia completa) e Traffic (caminho do fluxo de rede)
- Agrupar por namespace, label de aplicativo ou visualizar sem agrupamento
- Filtrar por tipo de recurso — clique em qualquer nó para detalhes completos
- Layout automático com ELK.js, atualizações ao vivo via SSE
Resources
Navegador de recursos baseado em tabela com colunas inteligentes por tipo de recurso.
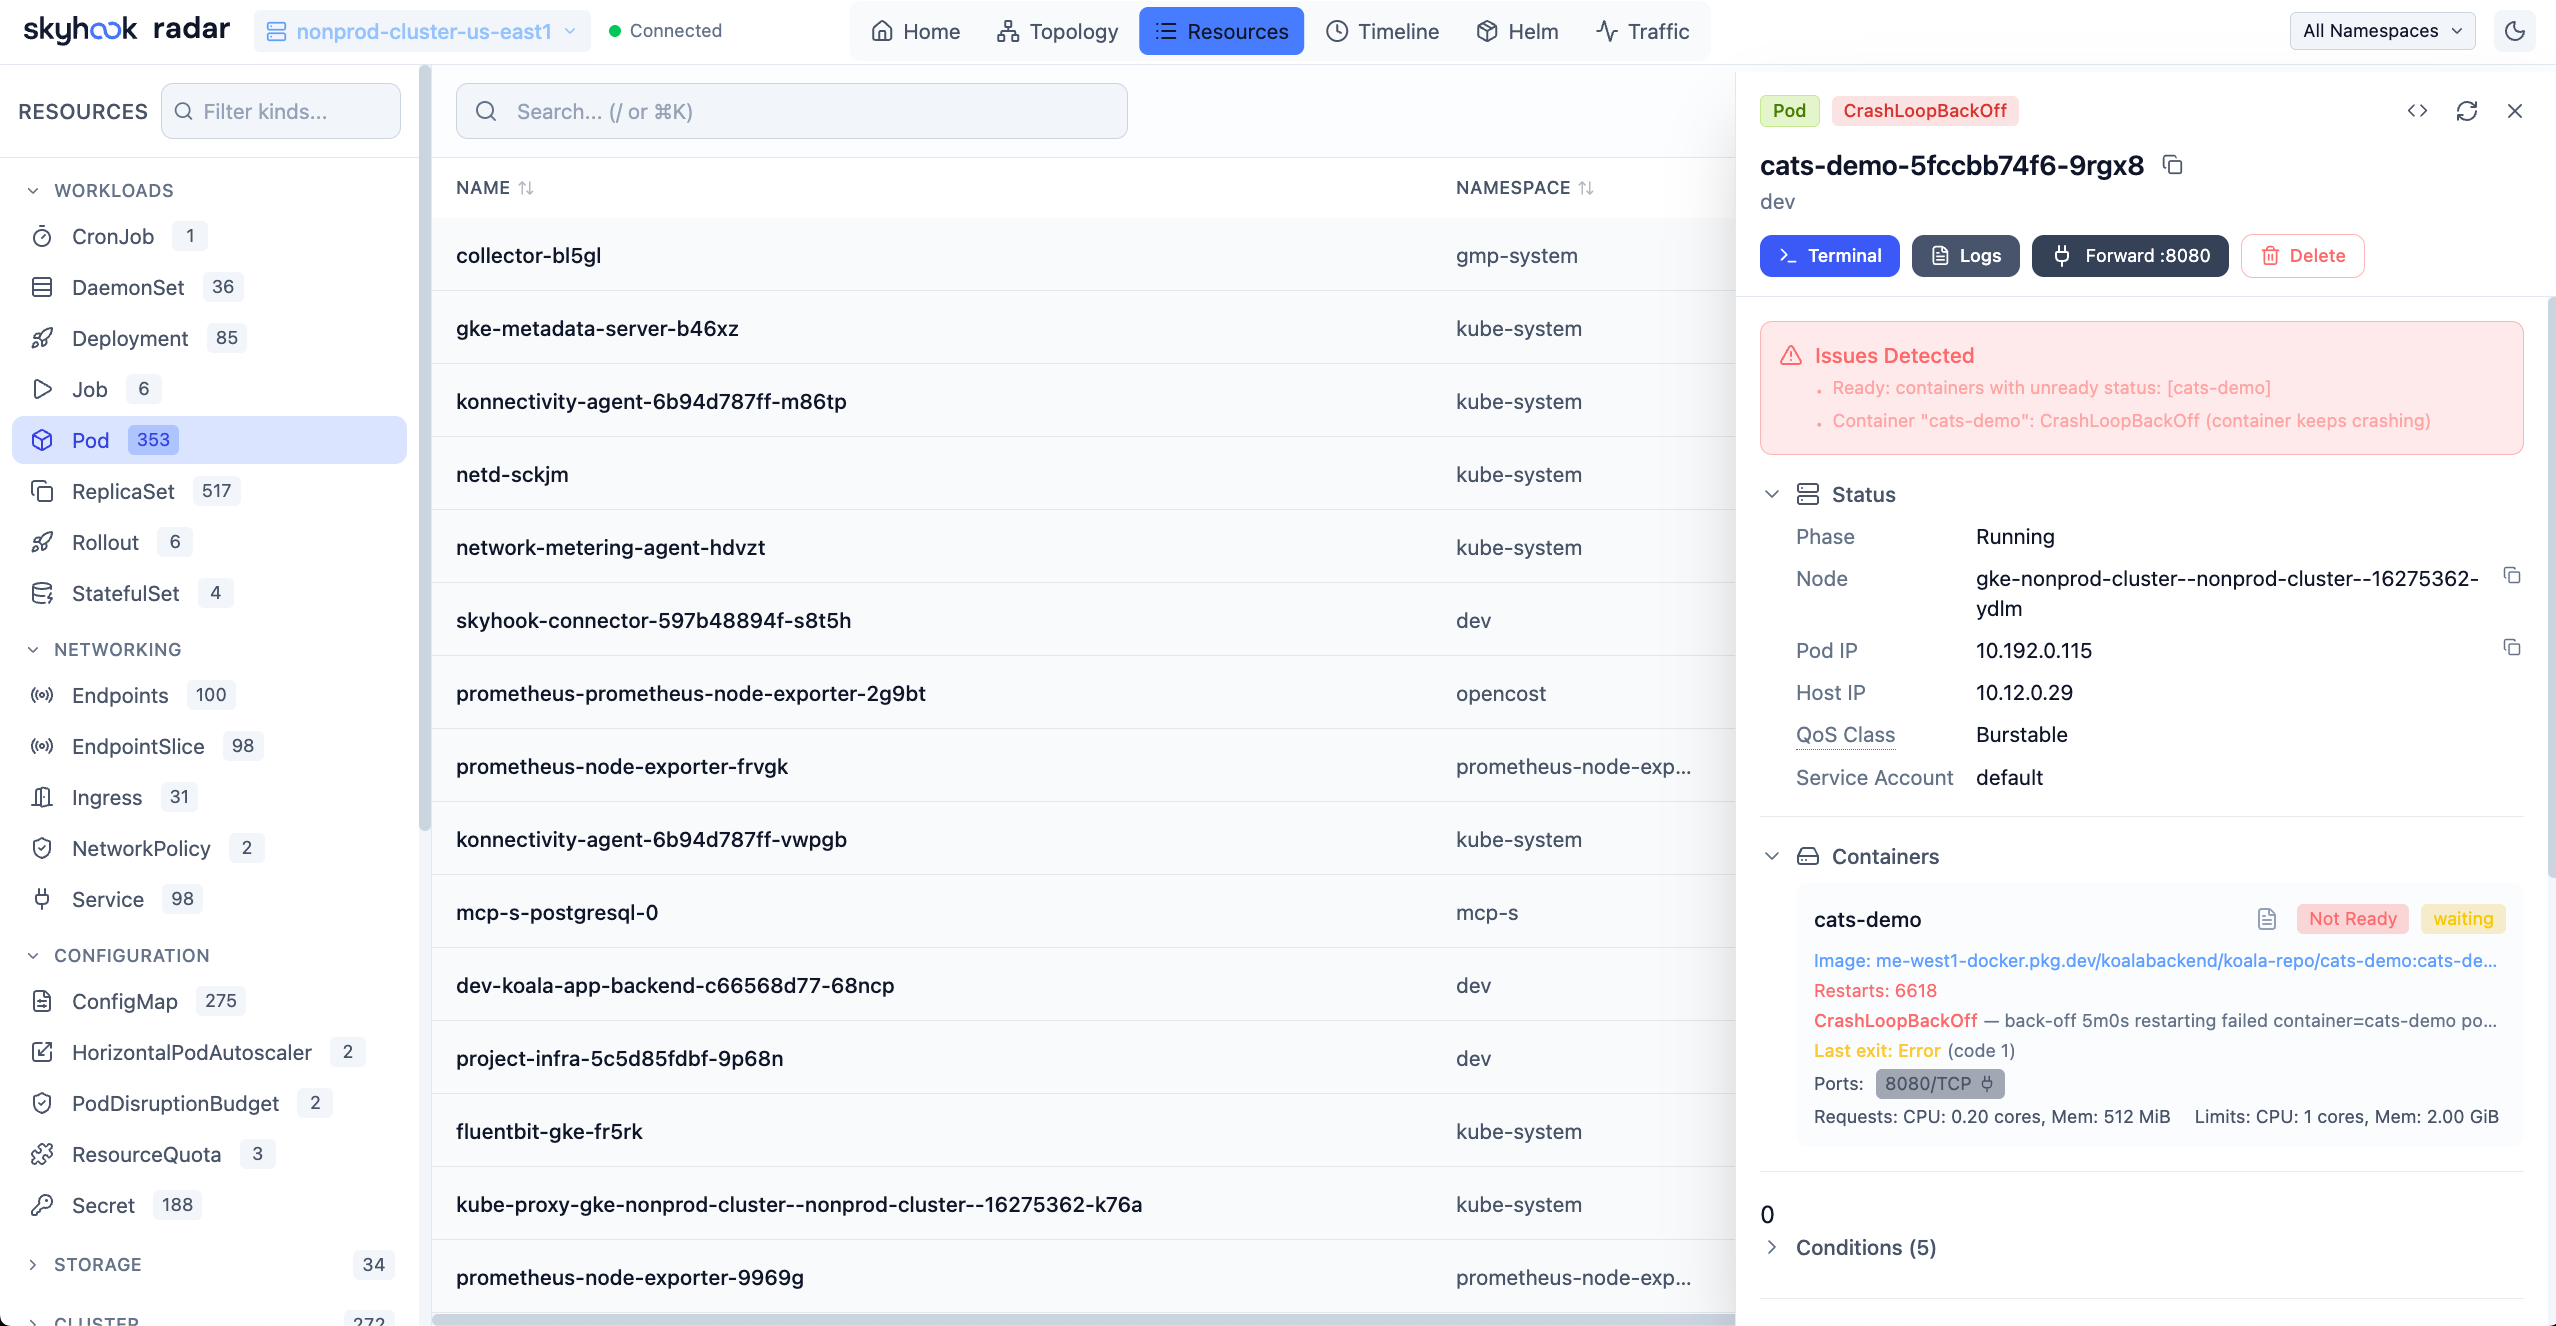
Resources View — Browse and filter all cluster resources
- Navegue por todos os tipos de recursos, incluindo CRDs
- Pesquise por nome, filtre por status ou problemas (CrashLoopBackOff, ImagePullBackOff, etc.)
- Adicione colunas personalizadas a partir de qualquer label ou anotação — classificáveis, filtráveis e redimensionáveis
- Clique em qualquer recurso para ver o manifesto YAML, recursos relacionados, logs e eventos
- Defina imagens de contêiner regulares ou init em Deployments, StatefulSets, DaemonSets e Argo Rollouts, com progresso de rollout ao vivo em tabelas, gavetas, visualizações de workloads e Applications
Image Filesystem Viewer
Inspecione sistemas de arquivos de imagens de contêiner diretamente da visualização de Pod — sem necessidade de puxar imagens localmente ou executar comandos dentro dos contêineres.
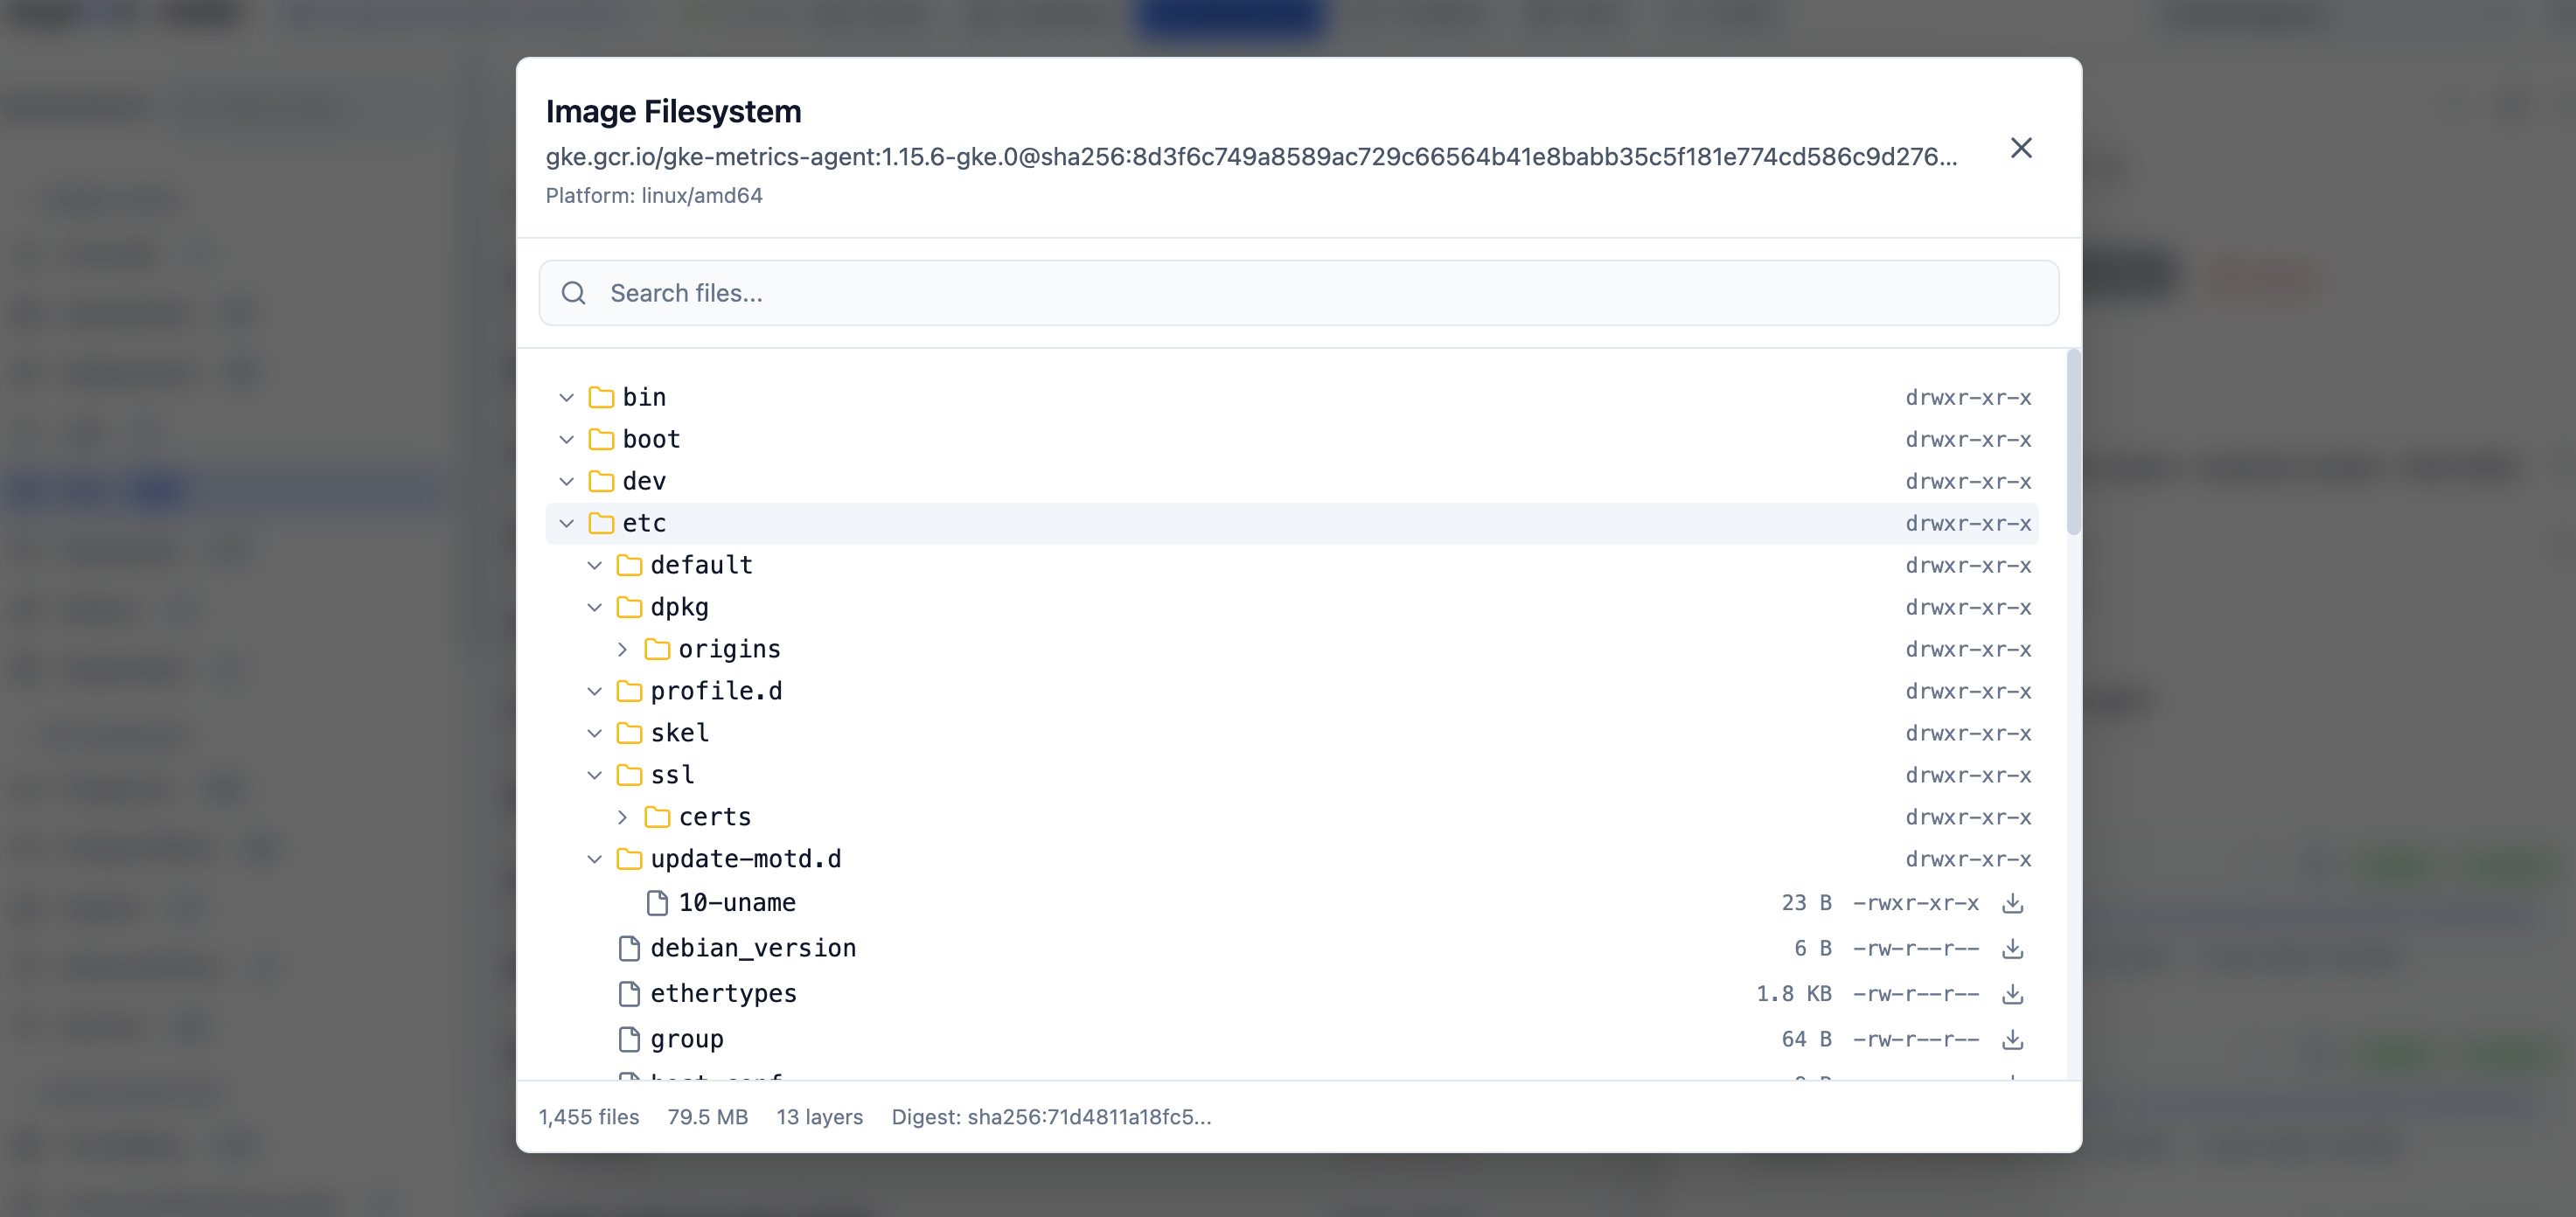
Image Filesystem Viewer — Browse container image contents
- Clique em qualquer imagem de contêiner em um Pod para navegar pelo sistema de arquivos completo
- Visualização em árvore com tamanhos de arquivo, permissões e alvos de symlink
- Pesquise arquivos por nome em toda a imagem
- Baixe arquivos individuais para inspeção
- Funciona com imagens públicas (Docker Hub, Quay, GHCR) e registries privados (GCR, ECR, ACR) usando os ImagePullSecrets do seu cluster
- Cache de camadas em disco para acesso repetido rápido
Timeline
Linha do tempo unificada de eventos Kubernetes e mudanças de recursos.
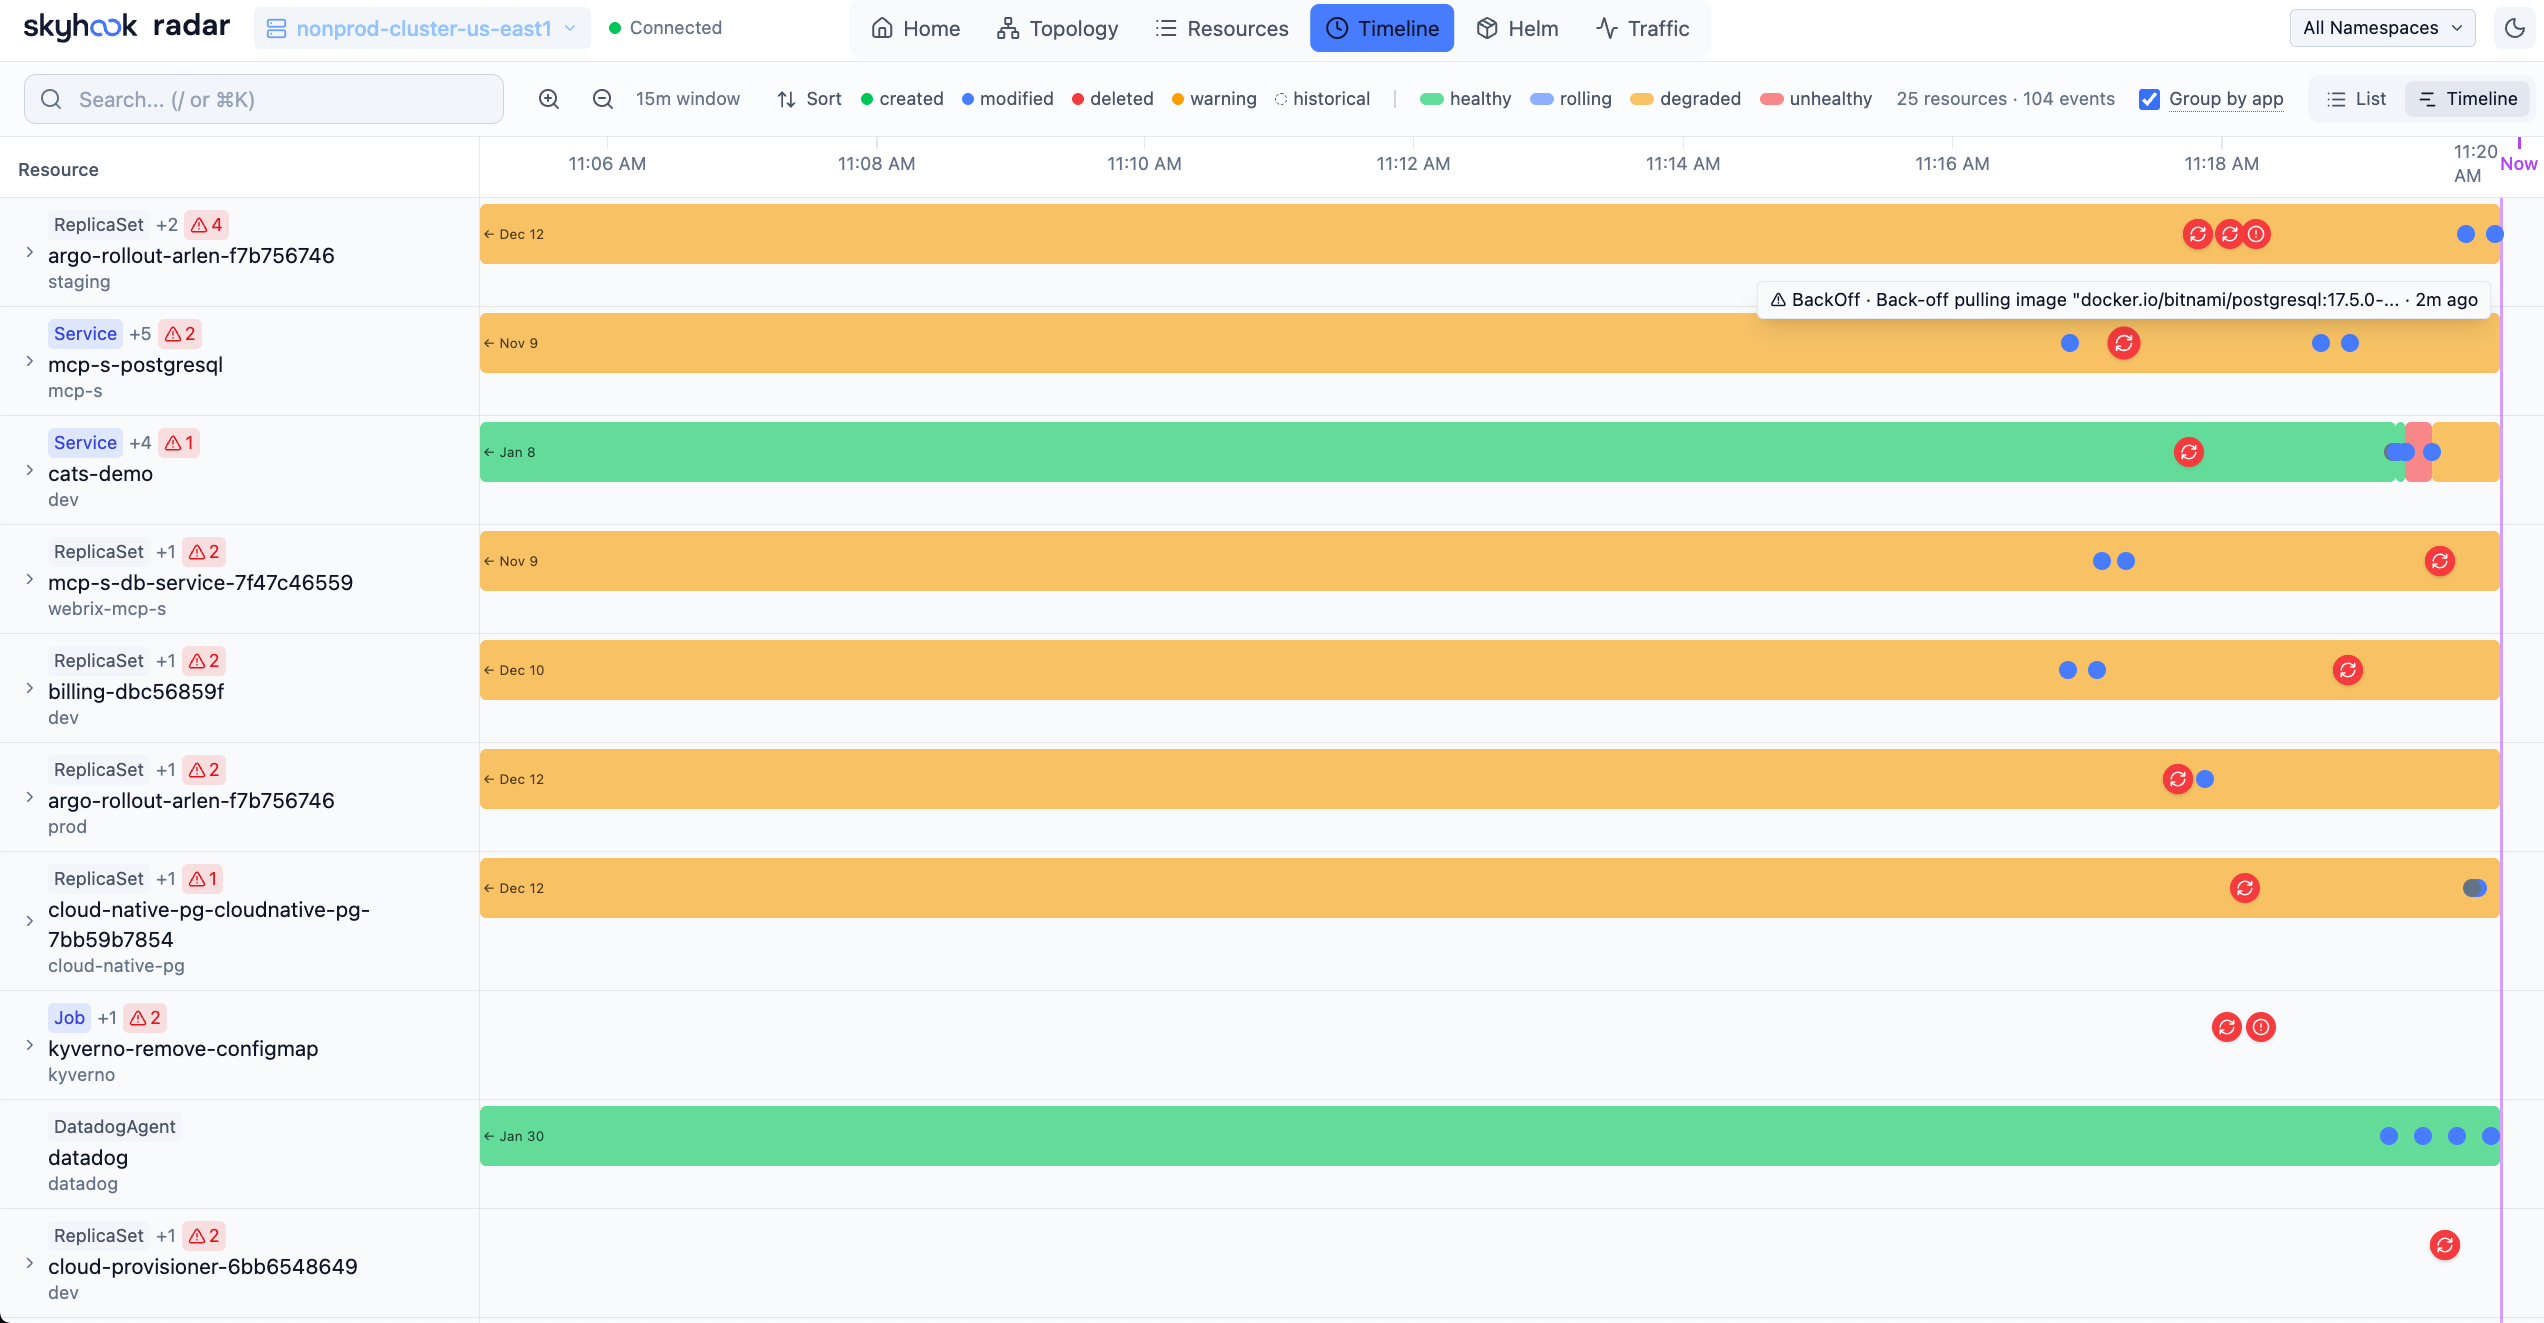
Timeline View — Track cluster activity in real-time
- Filtre por tipo de evento (todos ou apenas avisos)
- Diffs de mudanças de recursos mostrando o que mudou (réplicas, imagens, etc.)
- Atualizações em tempo real conforme novos eventos ocorrem
Helm
Gerencie releases Helm implantados no seu cluster — inspecione valores e manifestos renderizados, compare revisões, identifique upgrades com falha e padrões de rollback-após-falha, diagnostique hooks com falha, faça upgrade, rollback e uninstall. O Radar rastreia upgrades de chart disponíveis (dos seus repositórios configurados ou dos seus próprios registries OCI) e permite que você escolha uma versão alvo específica. Veja Helm Support para o comportamento detalhado e limites.
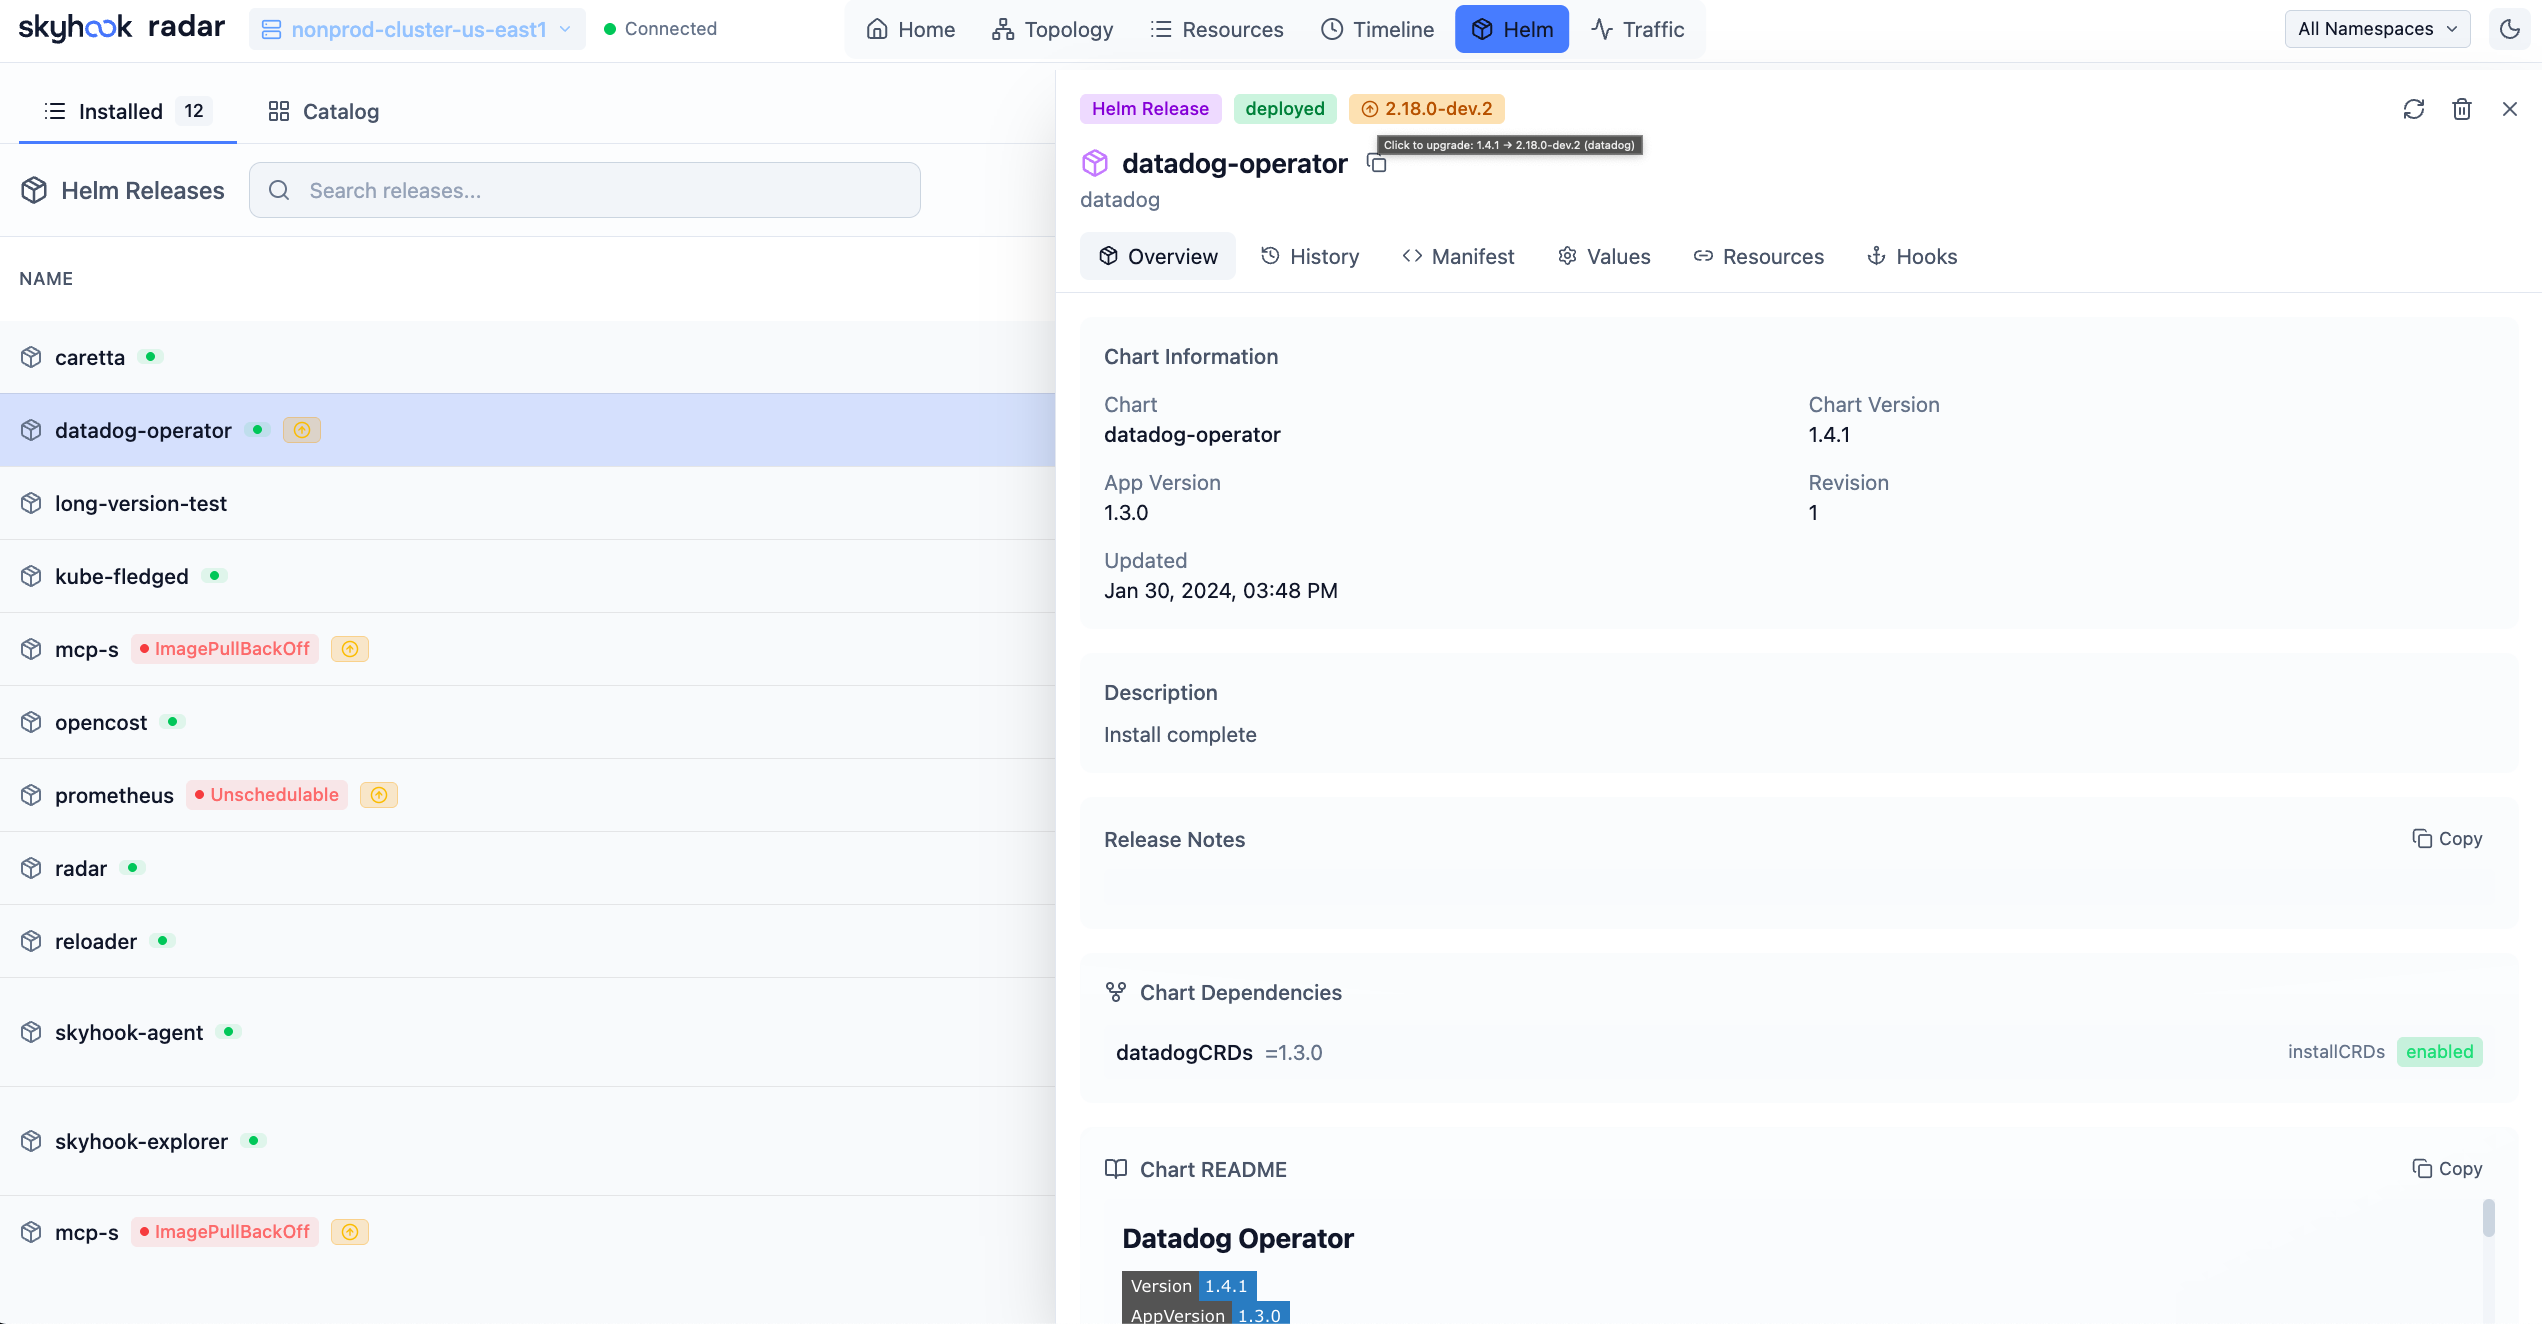
Helm View — Manage your Helm deployments
- Veja todos os releases em todos os namespaces com status, versão do chart, versão do app, saúde dos recursos, namespace de armazenamento e propriedade do Flux
- Inspecione valores, compare revisões entre valores/manifestos/notas/recursos e veja o histórico de releases
- Superficie upgrades com falha, operações pendentes travadas, histórico de rollback e rollbacks atômicos inferidos
- Correlacione hooks com falha/em execução com evidências restantes de Jobs, Pods, Events e logs editados
- Faça upgrade, rollback ou uninstall de releases diretamente da interface
Compare Resources
Compare dois recursos Kubernetes do mesmo tipo lado a lado — como comparar um Deployment de staging com seu equivalente de produção, ou dois pods que deveriam ser idênticos mas não são.
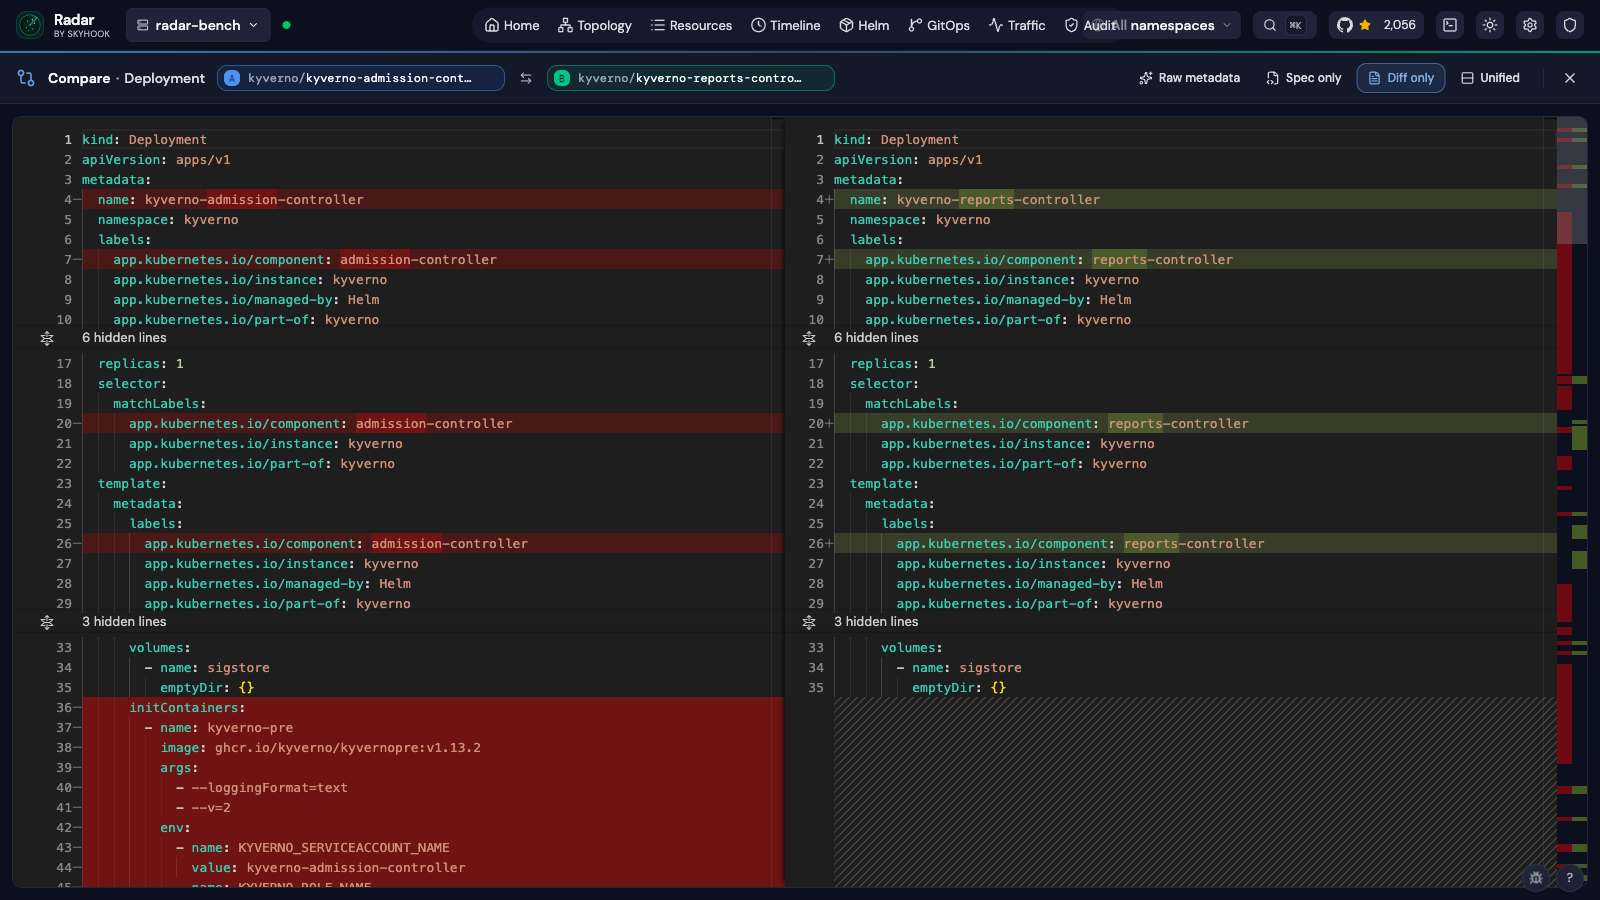
Compare View — Side-by-side YAML diff with field-level highlighting
- Dois pontos de entrada: um botão
Comparena gaveta de detalhes do recurso, ou o modo de comparação na tabela de recursos (alterne, selecione duas linhas, clique em Compare) - Visualização lado a lado ou unificada, com troca de A ↔ B em um clique
- Modo somente-diff recolhe regiões inalteradas para que você veja apenas o que difere
- Modo somente-spec remove campos
statuspara focar na intenção em vez do estado observado - Ruído atribuído pelo servidor (
managedFields,resourceVersion,kubectl.kubernetes.io/last-applied-configuration) é removido automaticamente para que o diff mantenha o sinal — ative Raw metadata se quiser realmente vê-lo - Candidatos do mesmo namespace aparecem primeiro no seletor — geralmente o recurso com o qual você deseja comparar
- URLs compartilháveis:
/compare?kind=&apiGroup=&a=ns/name&b=ns/name
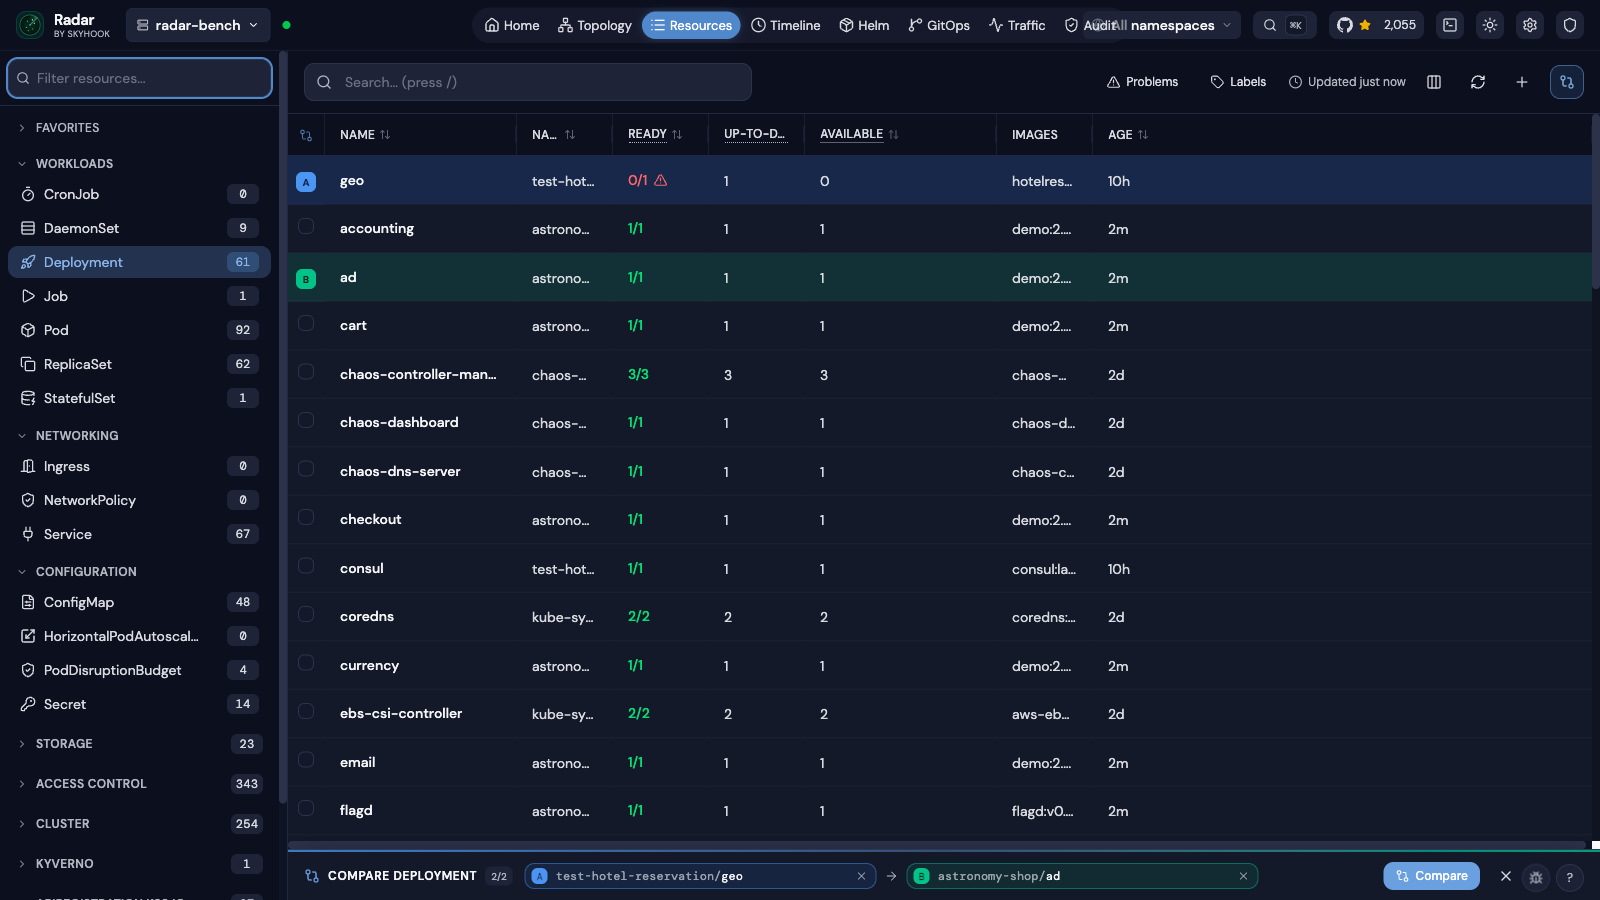
Compare mode in the resource table — pick two rows, hit Compare
TLS Certificate Management
Veja detalhes de certificados TLS e datas de expiração em todos os namespaces — detecte certificados expirando antes que causem indisponibilidades.
- Analisa secrets TLS para mostrar assunto do certificado, emissor e período de validade
- Visão geral de expiração de certificados no nível do dashboard
- Disponível na visualização de detalhes do recurso para qualquer Secret do tipo TLS
GitOps
Monitore, diagnostique e gerencie recursos FluxCD e ArgoCD a partir de um workspace GitOps dedicado.
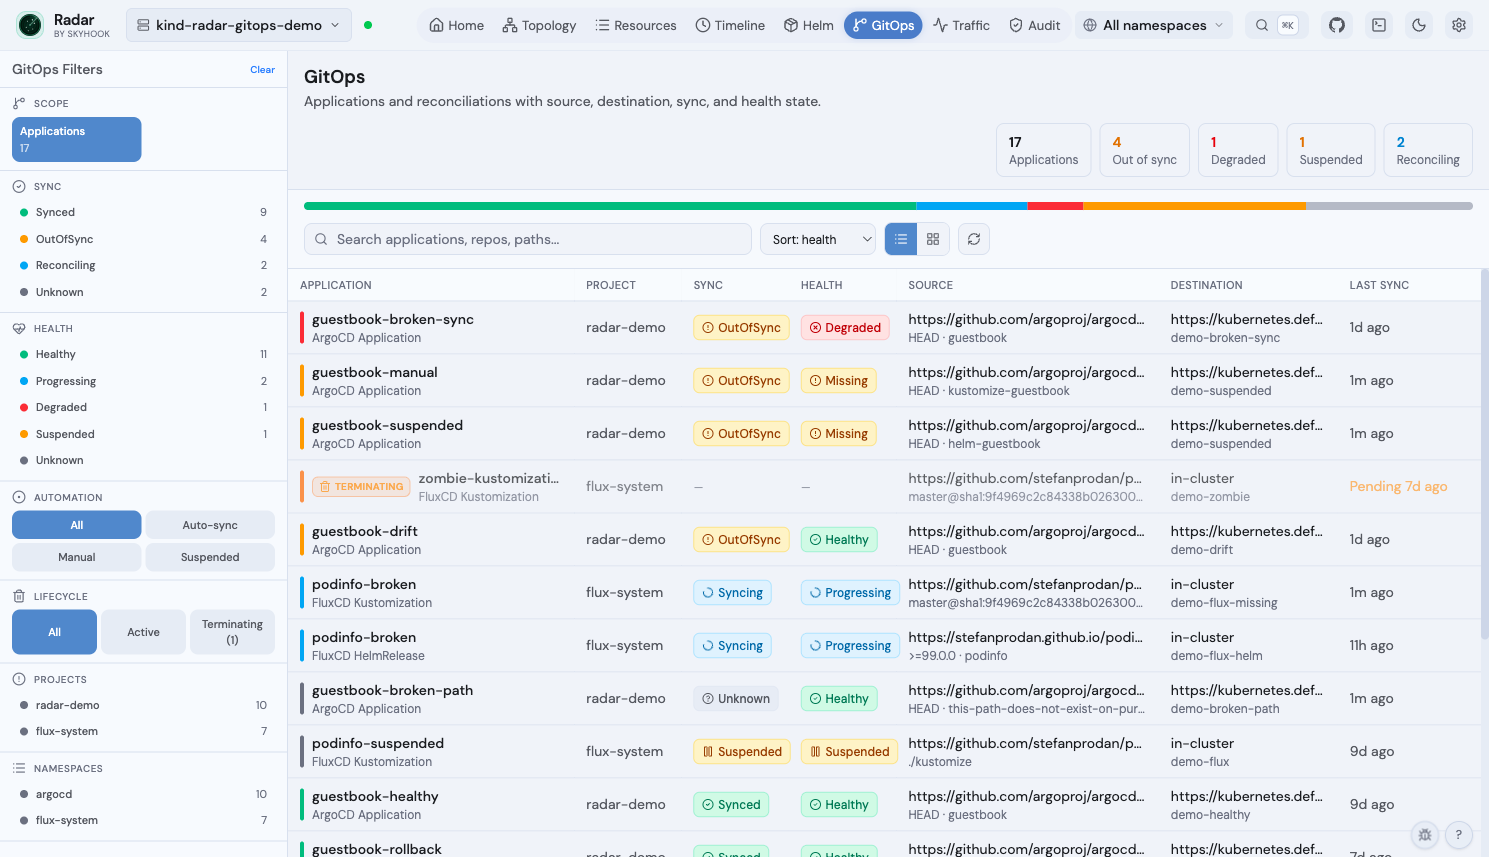
GitOps fleet view — Argo + Flux applications side-by-side with sync, health, source, destination, and lifecycle state
- Visão de frota + página de detalhes por aplicativo (abas Topology / Changes / Activity) para ArgoCD (
Application,ApplicationSet,AppProject) e FluxCD (GitRepository,OCIRepository,HelmRepository,Bucket,Kustomization,HelmRelease,Alert) - Pipeline de diagnóstico — drift em nível de campo, eventos recentes por recurso, detecção de loop de drift travado, falhas de operação analisadas, remediação estruturada em um clique
- Consciência de ciclo de vida — chip
Terminatingsubstitui badges obsoletos de Sync/Health; a gravidade aumenta com a idade da exclusão; operações de mutação recusam em zumbis - Vinculado ao restante do Radar — chip
Managed bynas gavetas de recursos, roteamento GitOps a partir de Topology + Timeline + Helm view, painelConsumed byem CRs de fonte do Flux - Integração MCP —
manage_gitopsexpõe sync / suspend / resume / reconcile / rollback com recusa consciente do ciclo de vida
Veja o GitOps guide para a matriz completa de recursos, requisitos de RBAC, cluster de demonstração e notas de escopo de cluster único.
Traffic
Visualize tráfego de rede ao vivo entre serviços usando Hubble, Caretta, Istio ou Beyla.
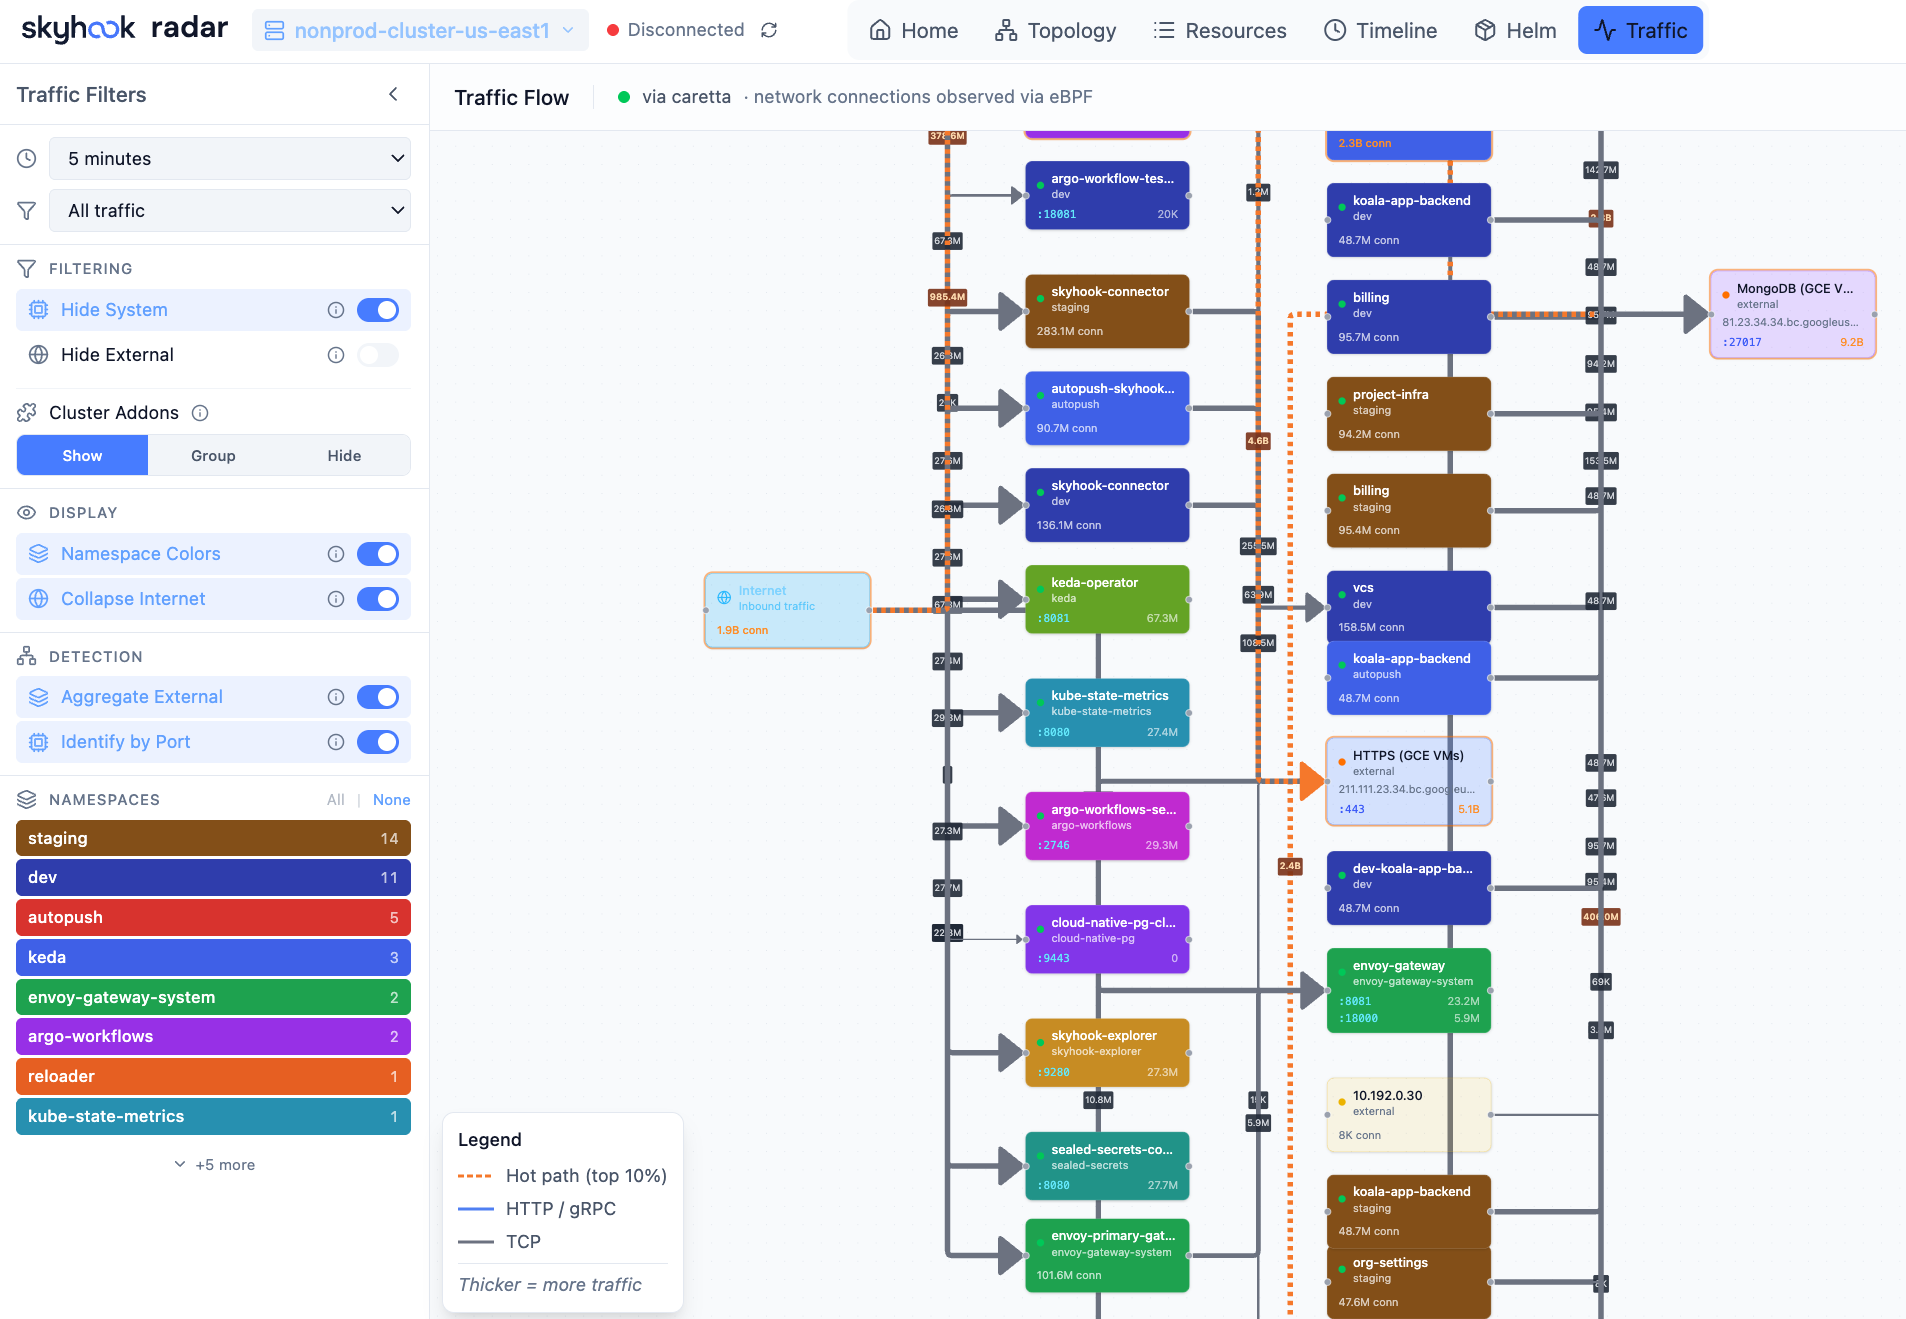
Traffic View — See how services communicate in real-time
- Detecta automaticamente Hubble (Cilium), Istio, Caretta ou Grafana Beyla como fontes de dados de tráfego
- Beyla (autônomo ou via Grafana Alloy) fornece visibilidade eBPF L4 + HTTP sem service mesh, lido do Prometheus
- Beyla precisa do recurso
networkhabilitado, e bordas por porta adicionalmente precisam dedst.portetransportnomeados emattributes.select— ambos estão desativados por padrão, e o Radar informa isso na visualização Traffic em vez de mostrar bordas parciais silenciosamente - Grafo de fluxo animado mostrando requisições por segundo entre serviços
- Filtre por namespace, protocolo ou código de status
- Assistente de configuração para instalar uma fonte de tráfego se nenhuma for detectada
Workload Metrics
Abra a aba Metrics de um Deployment, StatefulSet ou DaemonSet para investigar taxa de requisições, erros HTTP, latência, CPU, memória e throttling. O Radar lê um backend compatível com Prometheus existente; gráficos de recursos não exigem instrumentação HTTP, e gráficos de requisições usam observações suportadas do Beyla ou Istio.
- O histórico do workload inclui réplicas anteriores quando métricas e propriedade são mantidas
- Compare Pods atuais para encontrar outliers de recursos
- Descoberta automática e verificações de identidade, com dados ausentes ou parciais rotulados explicitamente
Veja Workload metrics para capturas de tela, pré-requisitos, configurações suportadas e limitações de configuração multi-cluster local.
Capacity (Karpenter)
Diagnóstico somente leitura para frotas gerenciadas por Karpenter — por que meu pod está pendente, qual NodePool poderia aceitá-lo, por que meus nós não estão entrando, o que a disrupção está fazendo com minha frota? Aparece automaticamente quando NodePools do Karpenter são detectados (controlado por RBAC).
- Overview — KPIs da frota com detalhes do ciclo de vida de claims, barra de capacidade de agendamento do cluster (requisições vs alocável, em voo além da borda, demanda pendente como contagem honesta fora de escala), sinais operacionais priorizados e inventário de NodePools
- NodePool detail — ledger de capacidade (limite configurado, provisionado, headroom, alocável, requisições agendadas, não alocado, uso real), ciclo de vida de claims, composição da frota e atribuição de workloads
- Demand — pods pendentes agrupados por assinatura de agendamento, cada grupo avaliado contra as restrições declaradas de cada NodePool com evidência por predicado; filtrável por estado, pool e workload
- Activity — episódios de provisionamento / disrupção / interrupção classificados a partir do vocabulário exato de eventos do Karpenter, com confiança por evidência
- Cada quantidade carrega certeza por valor (
= ≥ ≤ ?) — indisponível nunca é renderizado como zero, parcial nunca é renderizado como exato - Issues, gavetas de Pods pendentes e o card de postura da Home fazem deep-link para o diagnóstico correto
Veja docs/capacity.md para a referência completa.
Cost Insights
Acompanhe gastos com Kubernetes a partir de métricas OpenCost em um backend compatível com PromQL ou um Kubecost 3 Aggregator. O modo automático mantém métricas de custo do Prometheus funcionando e depois descobre um Kubecost Aggregator local; um cluster federado somente-agente pode usar a URL do Aggregator central em Settings, config ou Helm. O Radar lê a moeda configurada de um workload OpenCost ou Kubecost em execução quando disponível e caso contrário usa USD. Mudanças de fonte são testadas e aplicadas separadamente da preferência de moeda de exibição, que pode ser salva mesmo quando uma fonte está indisponível. O Radar rotula valores, mas não os converte.
- Custo alocado de workload com escopo de namespace destacado separadamente do custo de capacidade de nós em todo o cluster
- Gráficos de tendência de custo com seletor de intervalo 6h/24h/7d quando o histórico do Prometheus está disponível
- Detalhamentos de custo por namespace e workload com pontuação de eficiência
- Custos de nós com tipo de instância e preço por região
- Aparece automaticamente quando métricas Prometheus compatíveis ou dados de alocação atual do Kubecost são detectados
Cluster Audit
Scanner proativo de melhores práticas com 31 verificações em segurança, confiabilidade e eficiência — inspirado em Polaris, Kubescape, Trivy e diretrizes NSA/CISA. Executa instantaneamente contra dados em cache com zero instalação no lado do cluster.
- Segurança: contêineres privilegiados, escalonamento de privilégios, capabilities perigosas/inseguras, namespaces de host, montagens de socket do runtime de contêiner, caminhos sensíveis do host, segredos em ConfigMaps, tokens de conta de serviço montados automaticamente
- Confiabilidade: probes ausentes, tag de imagem
latest, deployments de réplica única, PDB/espalhamento de topologia ausentes, risco de HA de pod (todas as réplicas no mesmo nó), services/ingresses órfãos, versões de API obsoletas - Eficiência: requests e limits de CPU/memória ausentes, ConfigMaps/Secrets órfãos
- Fila de remediação agrupada por verificação com busca e filtros por categoria, severidade e framework; expanda uma verificação para ver os recursos afetados
- Cada descoberta inclui descrição e orientação de remediação, com ações de ocultação inline para uma verificação ou categoria
- Configurável: namespaces ignorados (com padrões curinga), verificações desabilitadas, persistidos entre sessões
- Rótulos de framework: NSA/CISA, benchmarks CIS
- Ferramenta MCP (
get_cluster_audit) para análise de cluster assistida por IA
Diagnóstico de Caminho de Rede
Diagnóstico ordenado por saltos para Service, Ingress, HTTPRoute, GRPCRoute e Gateway — respondendo "se o tráfego for enviado para este recurso, ele alcança um processo saudável e, se não, qual salto quebra primeiro?"
- Compõe as detecções que o Radar já executa (Service de backend ausente, incompatibilidades de porta, endpoints sem readiness, rota não Aceita pelo Gateway pai, probe de readiness apontando para a porta errada) em uma forma de caminho ordenada ao longo do fluxo de tráfego
- Upstreams (Ingresses / Rotas apontando para um Service) são julgados independentemente — um Ingress quebrado não condena os outros caminhos de entrega
- O primeiro salto crítico é nomeado explicitamente para que o operador localize a quebra sem ler a lista inteira; cada descoberta inclui um reprodutor kubectl
- Teste de alcançabilidade opcional de uma única execução executa probes DNS / TCP / TLS / HTTP contra o caminho declarado — TCP direto quando o Radar está no cluster, proxy do servidor de API K8s quando executado de um laptop — para que o mesmo botão funcione independentemente de onde o Radar executa. Probes nunca substituem o veredito estático; eles adicionam evidências.
- NetworkPolicies que selecionam os pods do sujeito são avaliadas estaticamente quanto às suas regras de ingresso independentes do chamador: uma predição WARNING de "bloquearia" quando nenhuma regra admite a porta do caminho, um aviso restrito por origem ou uma nota de egress de saída. É uma predição, nunca um veredito — o CNI é a única autoridade de aplicação, então o probe ativo no cluster confirma ou rebaixa isso
- O trace estático são funções puras sobre o cache informer em memória. A sondagem ativa de um laptop usa o RBAC normal do cluster (
get services/proxy,get pods/proxy); o modo no cluster vai diretamente ao caminho de dados. - Exposto via a aba Reachability na visualização de detalhes do recurso (e via o ramo de rede da ferramenta MCP
diagnosepara consumidores de IA) — veja docs/reachability.md
Impacto de Upgrade do Kubernetes
Abra Checks → Upgrade impact antes de atualizar o plano de controle. O Radar compara o cluster atual com um minor do Kubernetes alvo e ordena verificações evidenciadas de compatibilidade, saúde, admissão, drenagem, runtime e configuração por ação necessária. Verificações específicas de release aparecem apenas quando seu minor do Kubernetes está no caminho de upgrade selecionado; o catálogo atual é revisado até o Kubernetes 1.37.
- Encontra bloqueadores como versões minor puladas, APIs removidas no release alvo, skew de kubelet ou kube-proxy não suportado, PodDisruptionBudgets sobrepostos, o driver de volume
gitRepodesabilitado no Kubernetes 1.36 e feature gates removidos ou bloqueados do Kubernetes 1.37 ou objetosscheduling.k8s.io/v1alpha2 - Sinaliza impacto operacional provável, como exposição de FlexVolume e métricas renomeadas do plano de controle, como avisos, enquanto configuração dependente de intenção, como Service
externalIPsobsoleto, permanece em revisão - Inspeciona recursos ativos, disponibilidade de API agregada, manifests de release Helm, configuração last-applied do kubectl, métricas de uso do servidor de API e expressões PrometheusRule
- Distingue Passed, Review, Warning, Blocked, Incomplete e Not applicable em vez de achatar descobertas consultivas, impacto provável e evidências ausentes em um único estado
- Escaneia cada namespace que a identidade atual pode ler; o seletor de namespace do cabeçalho permanece um filtro de navegação e não estreita a análise de upgrade
- Mostra o limite do catálogo agrupado e o escopo de evidências para dados amostrados ou indisponíveis
Veja o guia de impacto de upgrade do Kubernetes para o catálogo de verificações, semântica de cobertura e notas de RBAC.
Controle de Acesso (visibilidade RBAC)
Inspecione o que qualquer ServiceAccount pode realmente fazer — sem três chamadas kubectl describe.
- Detalhe do ServiceAccount: bindings diretos, permissões efetivas (visão plana por binding e deduplicada), concessões herdadas via grupos implícitos (
system:authenticated,system:serviceaccounts) e "Usado por Pods" fechando o ciclo - Detalhe do Pod: seção "Permissions" mostrando as regras mais permissivas que o SA do Pod concede, além de um alerta de raio de explosão quando o SA tem curingas, cluster-admin, verbos de escalonamento ou
create podsem todo o cluster - Detalhe da Workload (Deployment / StatefulSet / DaemonSet): mesma seção Permissions enquadrada no nível da workload — cada Pod que a workload gera herda essas concessões
- Detalhe do Namespace: resumo de RBAC com RoleBindings configurados aqui + ClusterRoleBindings cujos sujeitos referenciam este namespace
- Detalhe de Role / ClusterRole: quem está vinculado a esta role, com resumos de sujeitos inline
- Detalhe do RoleBinding: pré-visualização inline das regras que o binding concede + avisos quando os sujeitos incluem grupos amplos (
system:authenticated,system:unauthenticated,system:masters) - Painel "My Permissions":
SelfSubjectRulesReviewativo com escopo de namespace para o usuário atual — para depuração rápida de "por que não posso fazer X" - MCP: a ferramenta
get_subject_permissionsexpõe os mesmos dados a agentes de IA para consultas "este SA está com privilégios excessivos?" / "raio de explosão se comprometido?"
Visibilidade somente leitura é entregue primeiro; os acompanhamentos considerados (verificações de auditoria RBAC, matriz verb × resource, explorador de sujeitos, visualização de grafo, edições na UI, consultas "can-i") são rastreados em #1090.
Integração de IA (MCP)
O Radar inclui um servidor Model Context Protocol (MCP) integrado que permite que agentes de IA — Claude Code, Codex, Cursor, GitHub Copilot (VS Code e CLI), OpenCode, Google Antigravity e qualquer outro cliente MCP — inspecionem, investiguem e operem seu cluster através do Radar.
Em vez de saída bruta de kubectl (YAML verboso que queima janelas de contexto de LLM), sua IA recebe dados pré-processados e otimizados por token: grafos de topologia, avaliações de saúde, eventos deduplicados e logs filtrados. O diagnóstico é somente leitura por padrão; a sondagem de rota opcional no cluster usa pods de sonda de curta duração e autodeletáveis. Operações de escrita, como restart, scale, apply e rollback, são identificadas para confirmação do cliente e aplicadas através do RBAC do Kubernetes.
Habilitado por padrão. Desabilite com --no-mcp. Veja o Guia MCP para instruções de configuração.
Autenticação
Para implantações compartilhadas no cluster, o Radar suporta autenticação de usuário opcional com RBAC do Kubernetes por usuário.
- Modo proxy — funciona com oauth2-proxy, Pomerium, Cloudflare Access ou qualquer proxy de autenticação que defina cabeçalhos encaminhados
- Modo OIDC — login integrado via Google, Okta, Dex, Keycloak ou qualquer provedor OIDC
- Escopo de namespace por usuário e autorização de escrita via impersonação K8s
- A UI se adapta automaticamente — os botões só aparecem se o usuário tiver permissão RBAC
Sem autenticação por padrão (uso local). Veja o Guia de Autenticação para configuração.
Recursos Suportados
O Radar descobre automaticamente qualquer CRD no seu cluster. Ferramentas populares recebem integrações dedicadas com arestas de topologia, visualizações de detalhes e resumos de IA.
O RBAC padrão do chart cobre os tipos Kubernetes integrados listados abaixo — Workloads, Networking (incluindo NetworkPolicies e PodDisruptionBudgets), Configuration, Storage (PersistentVolumes, PersistentVolumeClaims, StorageClasses), HorizontalPodAutoscalers, ServiceAccounts, LimitRanges, ResourceQuotas, Nodes, Namespaces e Events. No Kubernetes 1.37, o Radar também exibe as APIs Workload, PodGroup, CompositePodGroup, PodCertificateRequest e ClusterTrustBundle quando o servidor de API as anuncia; as APIs de agendamento são controladas por feature gates, enquanto as APIs de certificado são estáveis e habilitadas por padrão. Elas usam o navegador de recursos genérico em vez de renderizadores dedicados. Objetos RBAC (Roles, ClusterRoles, RoleBindings, ClusterRoleBindings) são opt-in via rbac.viewRBAC=true. Integrações baseadas em CRD (Gateway API, VerticalPodAutoscaler, Calico, ArgoCD, FluxCD, cert-manager, etc.) precisam tanto do CRD instalado no seu cluster quanto de acesso de leitura concedido — a maioria dos grupos é habilitada por padrão sob rbac.crdGroups.<name> (por exemplo, gatewayApi, verticalPodAutoscaler, calico); verifique values.yaml ou adicione regras personalizadas via rbac.additionalRules.
O impacto de upgrade também obtém acesso somente de listagem a CSIStorageCapacities, FlowSchemas, PriorityLevelConfigurations e PodSecurityPolicies em clusters onde esses tipos são servidos. Essas leituras inspecionam evidências de manifestos de origem e não adicionam os tipos ao navegador de recursos do Radar.
| Categoria | Recursos |
|---|---|
| Workloads | Deployments, DaemonSets, StatefulSets, ReplicaSets, Pods, Jobs, CronJobs |
| Networking | Services, Ingresses, NetworkPolicies, Endpoints, EndpointSlices, PodDisruptionBudgets |
| Configuração | ConfigMaps, Secrets (apenas nomes, valores ocultos), LimitRanges, ResourceQuotas |
| Armazenamento | PersistentVolumeClaims, PersistentVolumes, StorageClasses |
| Autoscaling | HorizontalPodAutoscalers, VerticalPodAutoscalers |
| Cluster | Nodes, Namespaces, ServiceAccounts, Events |
| Outras APIs do Kubernetes | Workloads, PodGroups, CompositePodGroups, PodCertificateRequests, ClusterTrustBundles (somente quando servidas pelo cluster) |
| GitOps (FluxCD) | GitRepository, OCIRepository, HelmRepository, Kustomization, HelmRelease, Alert |
| GitOps (ArgoCD) | Application, ApplicationSet, AppProject |
| Argo Rollouts | Rollout |
| Argo Workflows | Workflow, WorkflowTemplate |
| Reflector | Detalhes de reflexão de ConfigMap/Secret, relações de origem e espelho, evidências de cópias registradas |
| cert-manager | Certificate, CertificateRequest, Order, Challenge, Issuer, ClusterIssuer |
| Gateway API | Gateway, GatewayClass, HTTPRoute, GRPCRoute, TCPRoute, TLSRoute |
| Istio | VirtualService, DestinationRule, Gateway, ServiceEntry, PeerAuthentication, AuthorizationPolicy |
| Traefik | IngressRoute, IngressRouteTCP, IngressRouteUDP, Middleware, MiddlewareTCP, TraefikService, ServersTransport, ServersTransportTCP, TLSOption, TLSStore |
| Contour | HTTPProxy |
| Knative Serving | Service, Configuration, Revision, Route, DomainMapping |
| Knative Eventing | Broker, Trigger, EventType, Channel, InMemoryChannel, Subscription |
| Knative Sources | PingSource, ApiServerSource, ContainerSource, SinkBinding |
| Knative Flows | Sequence, Parallel |
| Knative Networking | Ingress, Certificate, ServerlessService |
| Karpenter | NodePool, NodeClaim (+ NodeClasses específicos do provedor via descoberta automática) |
| KEDA | ScaledObject, ScaledJob, TriggerAuthentication, ClusterTriggerAuthentication |
| Prometheus Operator | ServiceMonitor, PodMonitor, PrometheusRule, Alertmanager |
| Segurança (Trivy) | VulnerabilityReport, ConfigAuditReport, ExposedSecretReport, ClusterComplianceReport, SbomReport, RbacAssessmentReport, InfraAssessmentReport |
| Strimzi | Evidências de falha do KafkaConnector (status do conector/tarefa) |
| Velero | Backup, Restore, Schedule, BackupStorageLocation, VolumeSnapshotLocation |
| External Secrets | ExternalSecret, ClusterExternalSecret, SecretStore, ClusterSecretStore |
| CloudNativePG | Cluster, Backup, ScheduledBackup, Pooler |
| Crossplane | Managed Resources (qualquer provedor), Composite Resources, Claims, Provider, ProviderConfig, Function, Configuration, Composition, CompositionRevision, XRD |
| Kyverno | Policy, ClusterPolicy, PolicyReport, ClusterPolicyReport |
| Sealed Secrets | SealedSecret |
| Alocação Dinâmica de Recursos | ResourceClaim, ResourceClaimTemplate, DeviceClass, ResourceSlice (resource.k8s.io, K8s 1.32+) |
| NVIDIA GPU Operator | ClusterPolicy, NVIDIADriver |
| Calico | NetworkPolicy, GlobalNetworkPolicy, StagedNetworkPolicy, StagedGlobalNetworkPolicy, StagedKubernetesNetworkPolicy, IPPool, HostEndpoint, Tier |
| Kueue | ClusterQueue, LocalQueue, Workload, ResourceFlavor, AdmissionCheck (+ ProvisioningRequest do Cluster Autoscaler) — básico |
| KubeRay | RayCluster, RayJob, RayService, RayCronJob — básico |
| KServe | InferenceService, ServingRuntime, ClusterServingRuntime, InferenceGraph, TrainedModel, LLMInferenceService — básico |
| Inference Gateway | InferencePool (grupos v1 + alpha), InferenceObjective — básico |
| Batch | LeaderWorkerSet, JobSet, Volcano (Job/Queue/PodGroup/JobFlow/JobTemplate), Kubeflow (PyTorchJob/TFJob/MPIJob/TrainJob) — básico |
| KAI Scheduler | Queue, PodGroup — básico |
| Model serving | KAITO (Workspace, RAGEngine), NVIDIA NIM (NIMService/NIMCache/NIMPipeline), AMD GPU Operator (DeviceConfig) — básico |
| Custo (OpenCost / Kubecost) | Custo por namespace/workload/node via métricas Prometheus compatíveis ou o Kubecost 3 Aggregator (sem CRDs) |
| CRDs | Qualquer Custom Resource Definition no seu cluster (descoberta automática) |
Atalhos de Teclado
| Atalho | Ação |
|---|---|
g seguido de uma letra | Alternar visualização — g h Home, g r Resources, g i Issues, g t Topology, g a Applications, g l Timeline, g f Traffic, g m Helm, g o GitOps, g u Checks, g c Cost |
t | Alternar tema escuro/claro |
? | Mostrar atalhos de teclado |
⌘K | Abrir paleta de comandos |
/ | Focar na busca (sensível ao contexto) |
f | Ajustar topologia à tela |
+ / - / 0 | Aumentar zoom / diminuir / redefinir (topologia) |
j / k | Navegar linhas (recursos, helm) |
g g / G | Ir para a primeira / última linha |
Enter / d | Abrir detalhes do recurso selecionado |
y | Abrir visualização YAML |
l | Abrir logs (pods/workloads) |
[ / ] | Tipo de recurso anterior / próximo |
Escape | Fechar painel/modal/busca |
Topologia: Arrastar (pan), Zoom (scroll), Selecionar (clique), Multi-seleção (Shift+clique)
Segurança
O Radar lê seu cluster através das suas próprias credenciais e mantém os dados do cluster localmente. Ele não envia manifests, logs, eventos, métricas ou dados de recursos para a Skyhook, e não requer conta, agente ou backend em nuvem. Encontrou uma vulnerabilidade? Por favor, reporte-a de forma privada para security@skyhook.io — veja SECURITY.md para o processo e prazos de resposta.
Desenvolvimento
Consulte o Guia de Desenvolvimento para compilar a partir do código-fonte e contribuir. Para automação e integrações, veja a referência da API HTTP.
Início rápido:
git clone https://github.com/skyhook-io/radar.git
cd radar
make deps

# Terminal 1: Frontend with hot reload (port 9273)
make watch-frontend

# Terminal 2: Backend with hot reload (port 9280)
make watch-backend
Contribuindo
Contribuições são bem-vindas! Leia nosso Guia de Contribuição para detalhes sobre o fluxo de trabalho de desenvolvimento, processo de pull request e padrões de codificação.
Dúvidas ou ideias? GitHub Discussions é o lugar — ou venha dizer oi em radarhq.io/community.
Sobre
O Radar é construído e mantido pela Skyhook (YC W23) e é open source sob Apache-2.0. A versão OSS é totalmente completa e é a forma recomendada de executar o Radar.
Para equipes que desejam Radar multi-cluster hospedado com SSO e dashboards compartilhados, também oferecemos o Radar Cloud.
Licença
Apache 2.0 — veja LICENSE
Open source. Gratuito para sempre.
Construído por Skyhook