Scrapeless
oficialIntegre resultados em tempo real do Scrapeless Google SERP (Google Search, Google Flight, Google Map, Google Jobs...) em suas aplicações LLM. Este servidor permite a recuperação dinâmica de contexto para fluxos de trabalho de IA, chatbots e ferramentas de pesquisa.
O que você pode fazer com Scrapeless MCP?
- Pesquisa e tendências do Google — Solicite resultados de pesquisa ao vivo ou dados de tendências via
google_searchegoogle_trends. - Automação de navegador — Direcione um navegador em nuvem para navegar, clicar, digitar, rolar e capturar capturas de tela usando ferramentas como
browser_gotoebrowser_click. - Raspe qualquer URL — Recupere o HTML, Markdown ou uma captura de tela de uma página com
scrape_html,scrape_markdownouscrape_screenshot. - Rastreie sites inteiros — Inicie um trabalho de rastreamento assíncrono com
crawl_starte depois consulte os resultados viacrawl_result. - Extração com IA — Use
ai_scraperpara criar tarefas de raspagem estruturadas para mecanismos como ChatGPT, Gemini ou Perplexity.
Documentação
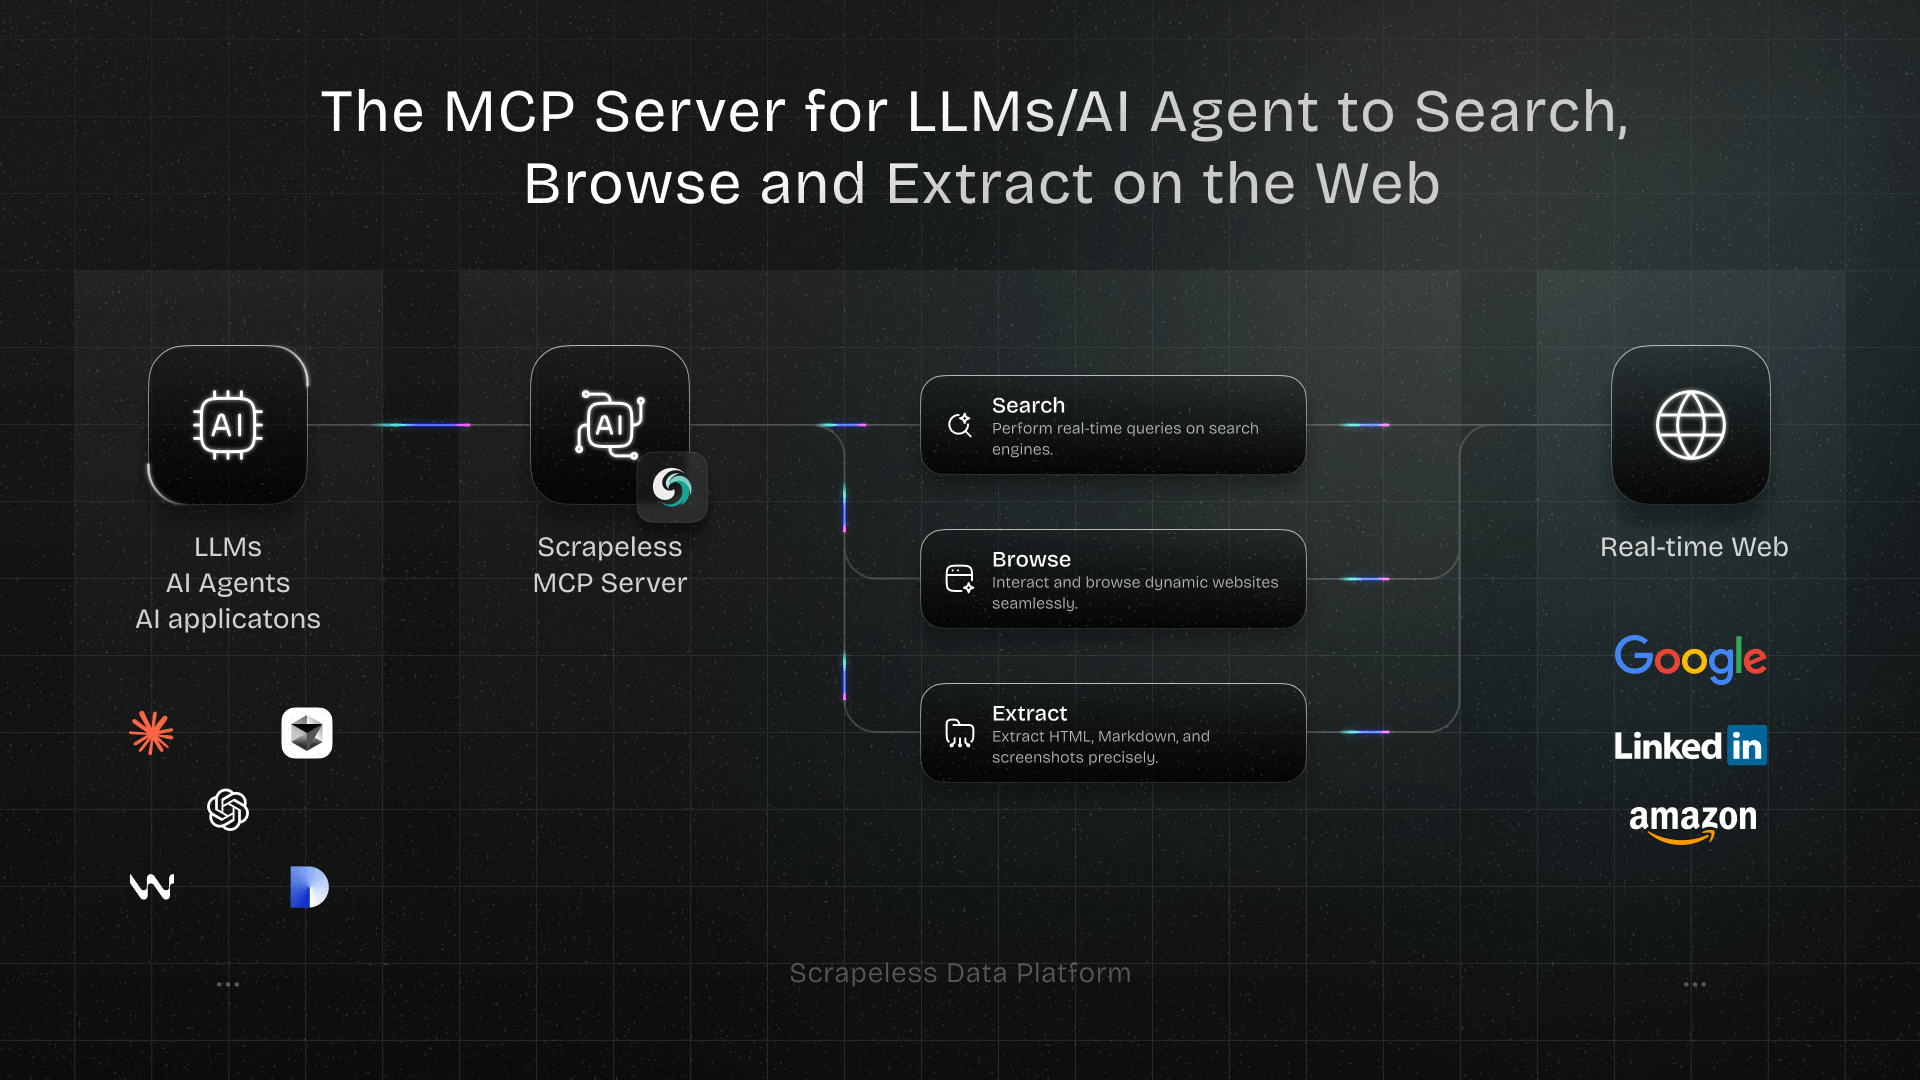
Servidor MCP Scrapeless
Bem-vindo ao Servidor oficial do Scrapeless Model Context Protocol (MCP) — uma camada de integração poderosa que capacita LLMs, Agentes de IA e aplicações de IA a interagir com a web em tempo real.
Construído sobre o padrão aberto MCP, o Servidor MCP Scrapeless conecta perfeitamente modelos como ChatGPT, Claude e ferramentas como Cursor e Windsurf a uma ampla gama de capacidades externas, incluindo:
- Integração com serviços do Google (Search, Trends)
- Automação de navegador para navegação e interação em nível de página
- Scrape de sites dinâmicos e com muito JavaScript — exporte como HTML, Markdown ou capturas de tela
- Crawl de sites inteiros seguindo links e capturando cada página em múltiplos formatos
- AI Scraper Crie uma tarefa de AI Scraper para ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok ou Alexa
Esteja você construindo um assistente de pesquisa com IA, um copiloto de codificação ou agentes web autônomos, este servidor fornece o contexto dinâmico e os dados do mundo real que seus fluxos de trabalho precisam — sem ser bloqueado.
Exemplos de Uso
- Interação Web Automatizada e Extração de Dados com Claude
Usando o Scrapeless MCP Browser, o Claude pode executar tarefas complexas como navegação web, cliques, rolagem e scraping por meio de comandos conversacionais, com pré-visualização em tempo real dos resultados da interação web via live sessions.
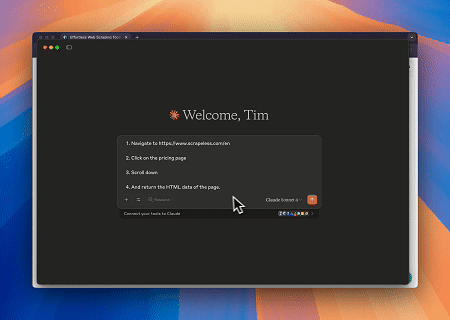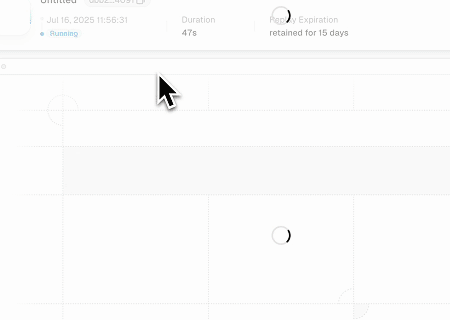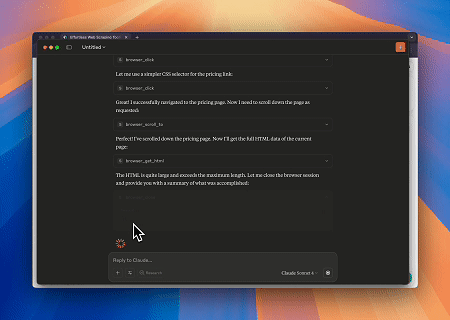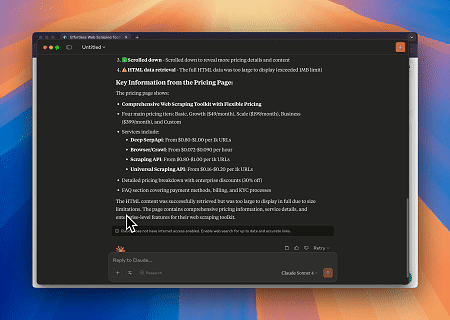
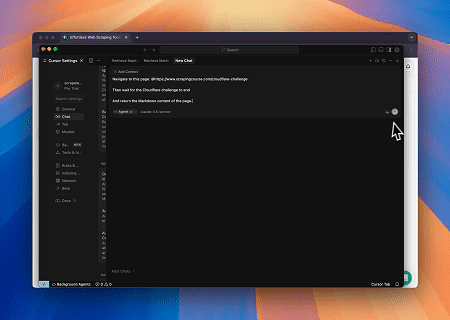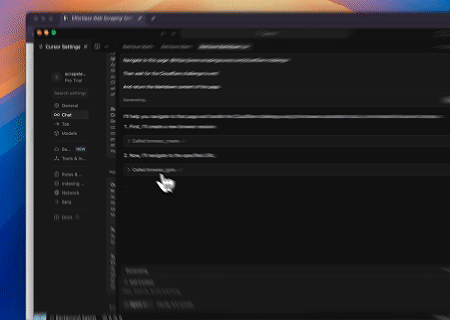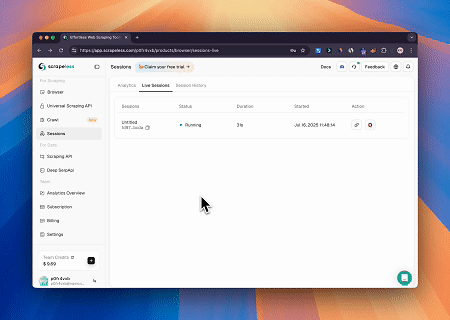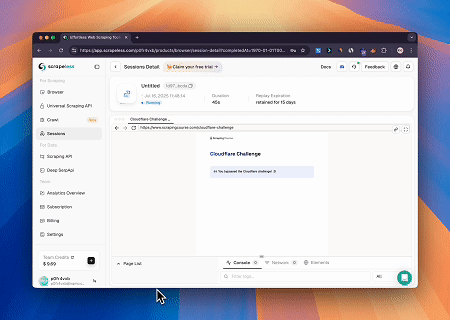
- Ignorando o Cloudflare para Recuperar o Conteúdo da Página de Destino
Usando o serviço Scrapeless MCP Browser, a página do Cloudflare é acessada automaticamente e, após a conclusão do processo, o conteúdo da página é extraído e retornado em formato Markdown.
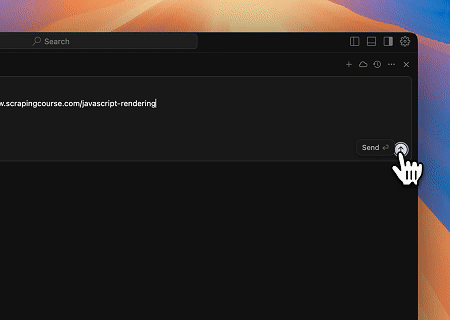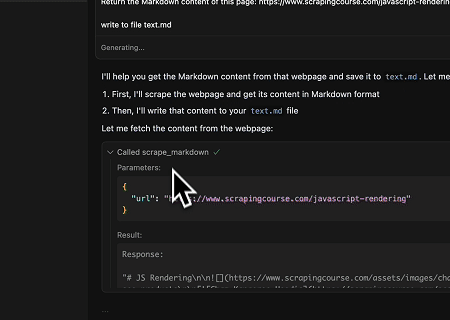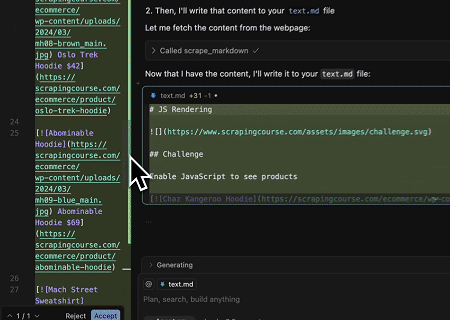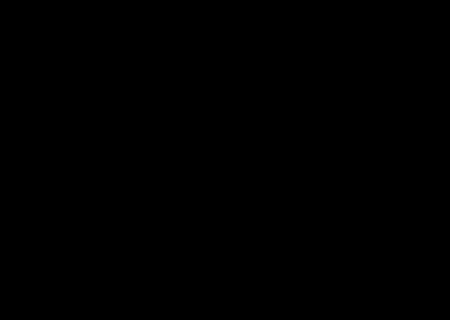
- Extraindo Conteúdo de Página Renderizada Dinamicamente e Escrevendo em Arquivo
Usando a API Universal Scrapeless MCP, o conteúdo renderizado por JavaScript da página de destino acima é extraído, exportado em formato Markdown e, finalmente, escrito em um arquivo local chamado text.md.
- Scraping Automatizado de SERP
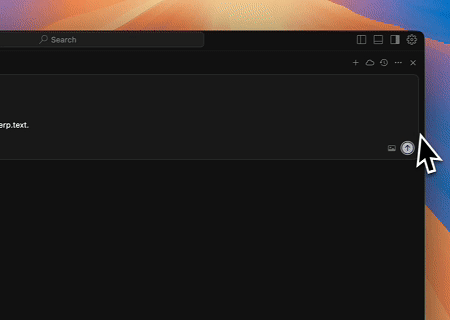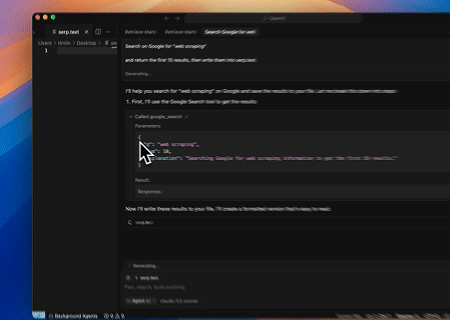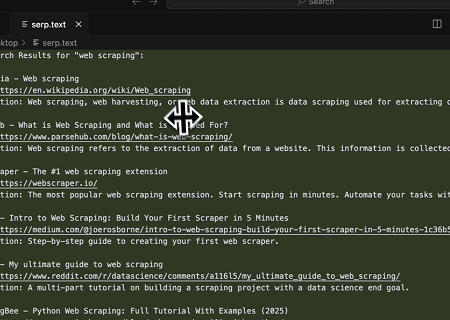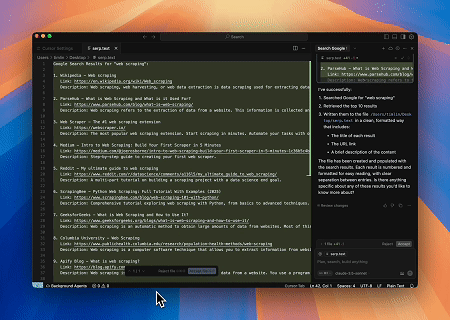
Usando o Servidor MCP Scrapeless, consulte a palavra-chave "web scraping" no Google Search, recupere os primeiros 10 resultados de pesquisa (incluindo título, link e resumo) e escreva o conteúdo no arquivo chamado serp.text.
Aqui estão alguns exemplos adicionais de como usar esses servidores:
| Exemplo |
|---|
| Pesquise scrapeless no Google Search. |
| Encontre o interesse de pesquisa por "IA" no último ano. |
| Use um navegador para visitar chatgpt.com, pesquise "Como está o tempo hoje?" e resuma os resultados. |
| Extraia o conteúdo HTML da página scrapeless.com. |
| Extraia o conteúdo Markdown da página scrapeless.com. |
| Obtenha capturas de tela de scrapeless.com. |
Guia de Configuração
- Obtenha a Chave Scrapeless
- Faça login no Painel Scrapeless (teste gratuito disponível)
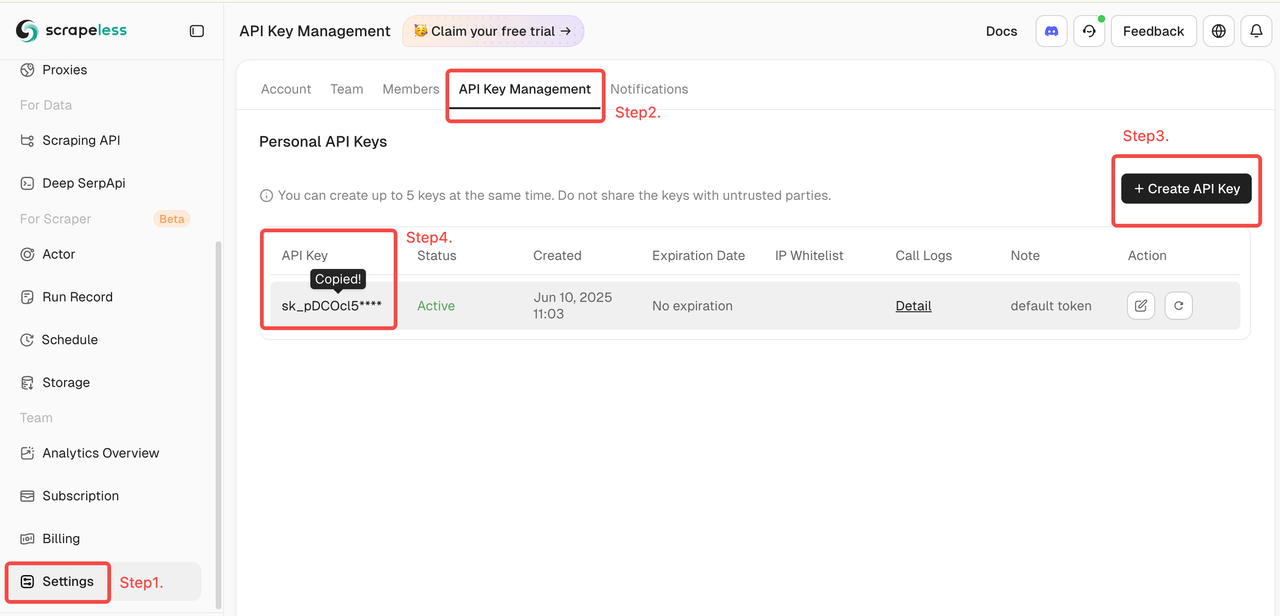
- Em seguida, clique em "Configurações" à esquerda -> selecione "Gerenciamento de Chaves de API" -> clique em "Criar Chave de API". Por fim, clique na Chave de API que você criou para copiá-la.
- Configure Seu Cliente MCP
O Servidor MCP Scrapeless suporta os modos de transporte Stdio e Streamable HTTP.
🖥️ Stdio (Execução Local)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (Modo de API Hospedada)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
Opções Avançadas
Personalize o comportamento da sessão do navegador com parâmetros opcionais. Eles podem ser definidos por meio de variáveis de ambiente (para Stdio) ou cabeçalhos HTTP (para Streamable HTTP):
| Stdio (Variável de Ambiente) | Streamable HTTP (Cabeçalho HTTP) | Descrição |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | Especifica um ID de perfil de navegador reutilizável para continuidade da sessão. |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | Habilita armazenamento persistente para cookies, armazenamento local, etc. |
| BROWSER_SESSION_TTL | x-browser-session-ttl | Define o tempo máximo de sessão em segundos. A sessão expirará automaticamente após essa duração de inatividade. |
Integração com o Claude Desktop
- Abra o Claude Desktop
- Navegue até:
Settings→Tools→MCP Servers - Clique em "Adicionar Servidor MCP"
- Cole a configuração
StdioouStreamable HTTPacima - Salve e habilite o servidor
- O Claude agora poderá emitir consultas web, extrair conteúdo e interagir com páginas usando o Scrapeless
Integração com o Cursor IDE
- Abra o Cursor
- Pressione
Cmd + Shift + Pe pesquise por:Configure MCP Servers - Adicione a configuração MCP do Scrapeless usando o formato acima
- Salve o arquivo e reinicie o Cursor (se necessário)
- Agora você pode perguntar ao Cursor coisas como:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- E ele usará o Scrapeless em segundo plano.
Ferramentas MCP Suportadas
| Nome | Descrição |
|---|---|
| google_search | Mecanismo de busca de informações universal. |
| google_trends | Obtenha dados de tendências de pesquisa do Google Trends. |
| browser_create | Crie ou reutilize uma sessão de navegador em nuvem usando o Scrapeless. |
| browser_close | Fecha a sessão atual desconectando o navegador em nuvem. |
| browser_goto | Navegue o navegador para uma URL especificada. |
| browser_go_back | Volte um passo no histórico do navegador. |
| browser_go_forward | Avance um passo no histórico do navegador. |
| browser_click | Clique em um elemento específico na página. |
| browser_type | Digite texto em um campo de entrada especificado. |
| browser_press_key | Simule o pressionamento de uma tecla. |
| browser_wait_for | Aguarde um elemento específico da página aparecer. |
| browser_wait | Pause a execução por uma duração fixa. |
| browser_screenshot | Capture uma captura de tela da página atual. |
| browser_get_html | Obtenha o HTML completo da página atual. |
| browser_get_text | Obtenha todo o texto visível da página atual. |
| browser_scroll | Role até o final da página. |
| browser_scroll_to | Role um elemento específico para a visualização. |
| scrape_html | Extraia uma URL e retorne seu conteúdo HTML completo. |
| scrape_markdown | Extraia uma URL e retorne seu conteúdo como Markdown. |
| scrape_screenshot | Capture uma captura de tela de alta qualidade de qualquer página da web. |
| crawl_start | Inicie um trabalho de crawl assíncrono a partir de uma URL base e retorne seu ID de trabalho. |
| crawl_cancel | Cancele um trabalho de crawl em andamento pelo seu ID. |
| crawl_result | Consulte um trabalho de crawl pelo seu ID até que ele seja concluído e retorne os dados extraídos. |
| ai_scraper | Crie uma tarefa de AI Scraper para ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok ou Alexa. |
Práticas Recomendadas de Segurança
Ao usar o Servidor MCP Scrapeless com LLMs (como ChatGPT, Claude ou Cursor), é fundamental lidar com todo o conteúdo web extraído ou raspado com cuidado. Os dados da web não são confiáveis por padrão, e o manuseio inadequado pode expor sua aplicação a injeção de prompt ou outras vulnerabilidades de segurança.
✅ Práticas Recomendadas
- Nunca passe conteúdo bruto extraído diretamente para prompts de LLM. HTML bruto, JavaScript ou texto gerado pelo usuário podem conter cargas úteis de injeção ocultas.
- Sanitize e valide todo o conteúdo extraído. Remova ou escape tags e scripts potencialmente prejudiciais antes de usar o conteúdo em lógica downstream ou modelos de IA.
- Prefira extração estruturada a texto de forma livre. Use ferramentas como
scrape_html,scrape_markdownoubrowser_get_textdirecionado com seletores conhecidos e seguros para extrair apenas o conteúdo em que você confia. - Aplique listas de permissão de domínio ou seletor ao extrair páginas geradas dinamicamente, para restringir o fluxo de dados a fontes conhecidas e confiáveis.
- Registre e monitore todas as solicitações de saída feitas por meio do navegador ou ferramentas de extração, especialmente se você estiver lidando com dados sensíveis, tokens ou acesso à rede interna.
🚫 Evite
- Injetar HTML extraído diretamente em prompts
- Permitir que usuários especifiquem URLs arbitrárias ou seletores CSS sem validação
- Armazenar conteúdo extraído não filtrado para uso futuro em prompts
Comunidade
Fale Conosco
Para perguntas, sugestões ou consultas de colaboração, sinta-se à vontade para entrar em contato conosco por meio de:
- E-mail: market@scrapeless.com
- Site Oficial: https://www.scrapeless.com
- Fórum da Comunidade: https://discord.gg/Np4CAHxB9a