WorkloadTruth
Classifica cargas de trabalho de GPU como inferência ou treinamento apenas por telemetria, via ferramentas MCP.
Documentação
WorkloadTruth


Instalação • Início rápido • Referência da CLI • Comparação • FAQ
Classifique uma carga de trabalho de GPU como TRAINING, INFERENCE ou IDLE apenas com telemetria. Sem alterações de código na carga de trabalho, sem rótulos de trabalho autodeclarados.
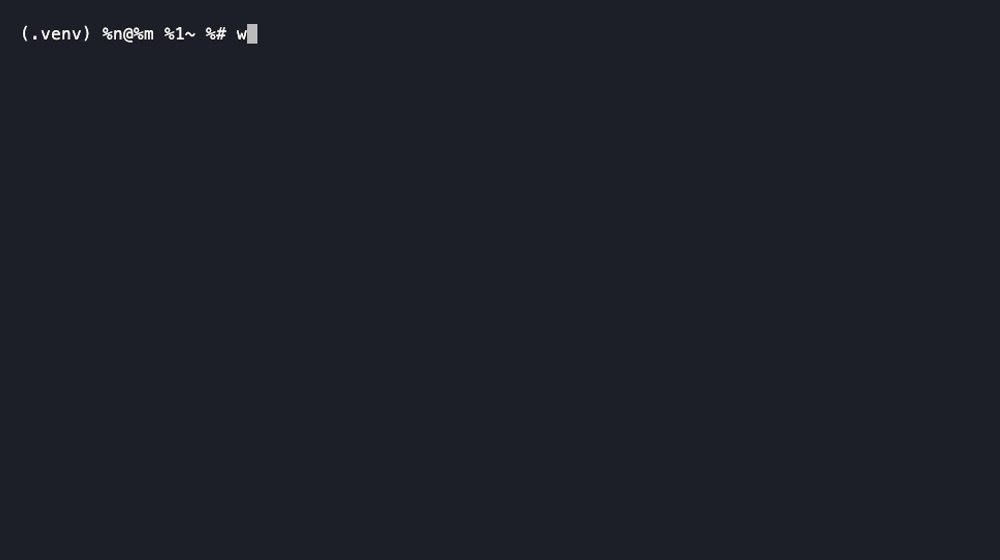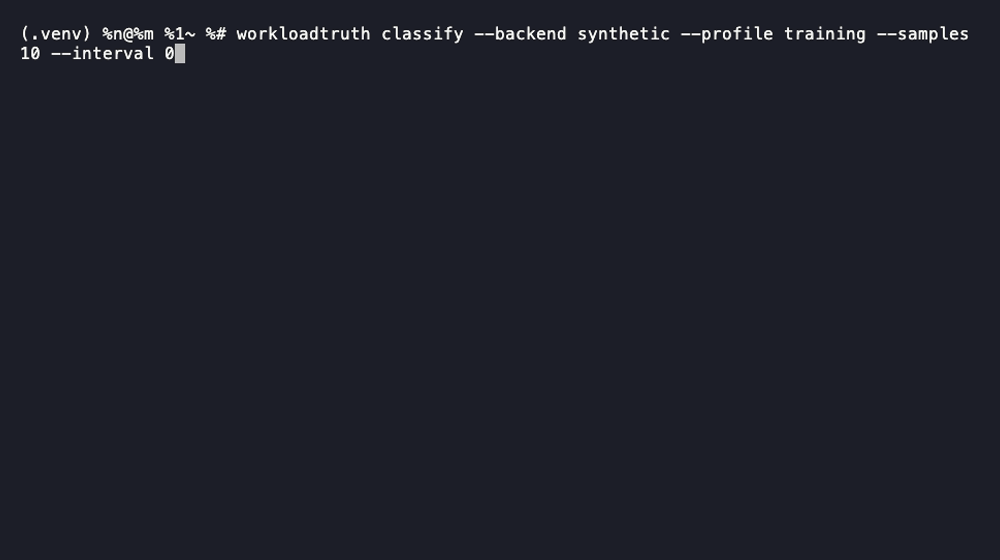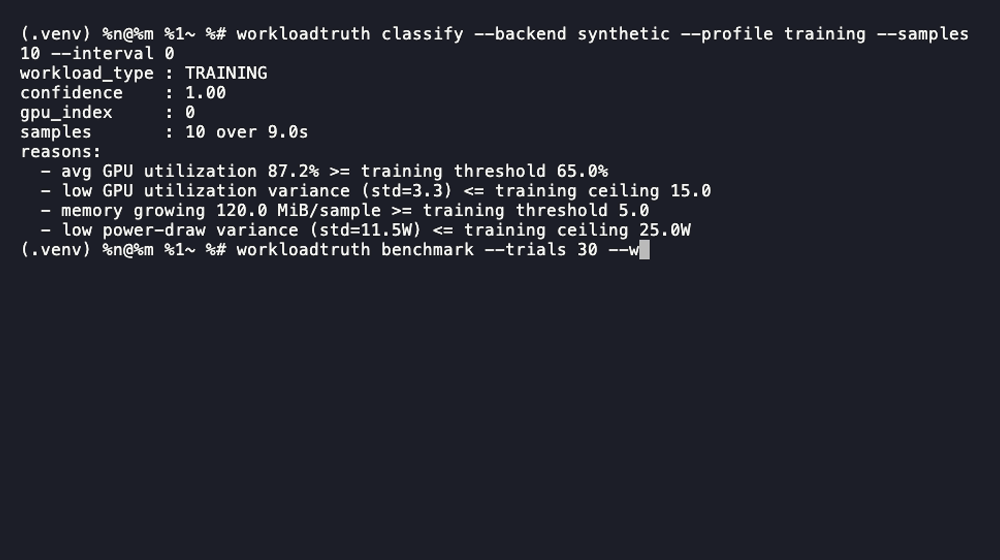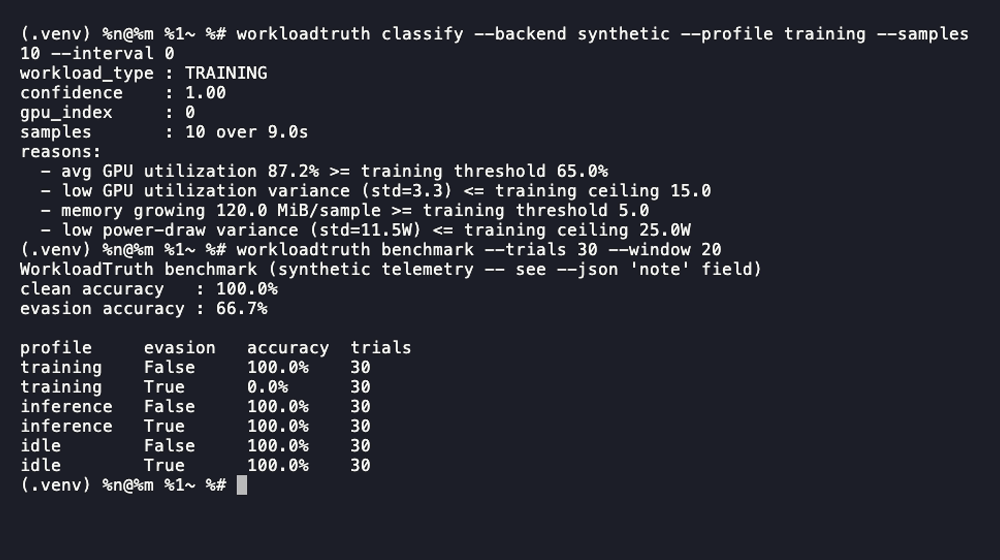
Todo escalonador de GPU em uso comum hoje, incluindo run:ai, Slurm e operadores de GPU Kubernetes, pede que você declare se um trabalho é treinamento ou inferência no momento da submissão. Nenhum deles verifica. O WorkloadTruth lê a telemetria da GPU (utilização, padrão de memória, consumo de energia) e responde à pergunta de forma independente, para que um trabalho rotulado incorretamente ou com mau comportamento não passe despercebido.
Instalação
# Real NVIDIA GPU telemetry (requires an NVIDIA driver on the host)
pip install "workloadtruth-cli[nvml]"

# Try it without a GPU, using the synthetic backend
pip install workloadtruth-cli

# npm launcher (thin wrapper around the PyPI package, see "Why two registries")
npx workloadtruth-cli --help
[!NOTE] O pacote npm é um lançador, não uma instalação independente.
npx workloadtruth-cliexecuta o binário real doworkloadtrutha partir do PATH, portanto o pacote PyPI (pip install workloadtruth-cli) já deve estar instalado primeiro.
Início rápido
# No GPU required. Classify a synthetic "training" telemetry trace.
$ workloadtruth classify --backend synthetic --profile training --samples 10 --interval 0
workload_type : TRAINING
confidence    : 1.00
gpu_index     : 0
samples       : 10 over 9.0s
reasons:
  - avg GPU utilization 87.8% >= training threshold 65.0%
  - low GPU utilization variance (std=3.4) <= training ceiling 15.0
  - memory growing 120.0 MiB/sample >= training threshold 5.0
  - low power-draw variance (std=9.4W) <= training ceiling 25.0W

# Real hardware
$ workloadtruth classify --backend nvml --samples 10 --interval 1 --json
--json em todos os comandos alterna para saída legível por máquina para scripts e agentes.
Resumo rápido
- Use para: detectar trabalhos de GPU com custo mal alocado (um trabalho cobrado como "inferência" de baixa prioridade que na verdade está executando treinamento completo) e alterações não autorizadas na carga de trabalho (um endpoint de inferência que começa a treinar com tráfego ao vivo sem aprovação)
- O que não é: uma ferramenta de conformidade ou auditoria regulatória. Nenhuma regulamentação atualmente exige esse tipo de monitoramento, veja O que o WorkloadTruth não é abaixo
- Trabalhos anteriores: baseia-se e cita arXiv:2606.19262 (ICML 2026), veja Relação com pesquisas anteriores
Como funciona a classificação
O WorkloadTruth atualmente oferece apenas um classificador baseado em regras: um conjunto de limites documentados e inspecionáveis sobre quatro características extraídas de uma janela de telemetria (média e variância da utilização da GPU, inclinação do crescimento de memória, média e variância do consumo de energia). Cada limite existe como uma constante nomeada em src/workloadtruth/classifier/rules.py com um comentário explicando sua intuição. Nada é uma caixa-preta.
--experimental (um classificador baseado em ML) está presente como um sinalizador, mas falha ruidosamente com uma explicação em vez de fornecer um resultado falso. O modelo treinado e o conjunto de dados de arXiv:2606.19262 nunca foram publicados, e este projeto não tem GPU NVIDIA em seu ambiente de build para coletar dados reais de treinamento. Um classificador de ML será incluído aqui somente quando for treinado em um conjunto de dados real e divulgado e demonstrado de forma independente que supera a linha de base baseada em regras, e não antes.
Benchmark
workloadtruth benchmark mede a precisão do classificador em relação a rastros de telemetria de GPU sintéticos documentados (veja synthetic_backend.py para os parâmetros exatos do perfil), tanto limpos quanto sob uma transformação de evasão deliberada que imita um operador disfarçando um trabalho de treinamento como inferência (limitando oscilações de utilização, achatando o crescimento de memória, injetando lacunas ociosas artificiais).
Isso é executado em dados sintéticos, não em hardware NVIDIA ao vivo, portanto não é diretamente comparável aos números de hardware real do arXiv:2606.19262. Ambos são relatados abaixo, lado a lado, nunca combinados em um único número.
| arXiv:2606.19262 (hardware real, NVML) | WorkloadTruth (rastros sintéticos, 300 tentativas/célula) | |
|---|---|---|
| Precisão limpa | 98,2% | 100,0% |
| Precisão com evasão | 43-87% | 66,7% geral |
O número geral de evasão esconde a descoberta real. Dividido por tipo de carga de trabalho, o classificador baseado em regras do WorkloadTruth é atualmente completamente enganado em cargas de trabalho de treinamento evasivas (0% de precisão), enquanto permanece preciso em rastros de inferência e ociosos evasivos (100% cada). Limitar a utilização da GPU sozinho é suficiente para fazer um trabalho de treinamento parecer inferência para este classificador hoje.
| Perfil | Precisão limpa | Precisão com evasão |
|---|---|---|
| Treinamento | 100,0% | 0,0% |
| Inferência | 100,0% | 100,0% |
| Ocioso | 100,0% | 100,0% |
Esta é a lacuna concreta e divulgada que o conjunto de benchmarks existe para expor e acompanhar, não uma nota de rodapé. Um classificador baseado em regras que apenas observa a variância da utilização é trivialmente evadível. Fechar essa lacuna, por meio de fusão de múltiplos sinais ou um classificador treinado real quando os dados existirem, é o roteiro, não um problema resolvido. Reproduza você mesmo:
workloadtruth benchmark --trials 300 --window 30 --json
Referência da CLI

$ workloadtruth --help
Usage: workloadtruth [OPTIONS] COMMAND [ARGS]...

  Classify a GPU workload as INFERENCE, TRAINING, or IDLE from telemetry
  alone.

Options:
  --version  Show the version and exit.
  --help     Show this message and exit.

Commands:
  benchmark   Run the evasion-robustness benchmark against synthetic...
  classify    One-shot classification of the current GPU workload.
  mcp         Start an MCP server exposing classify/benchmark/verify-log...
  verify-log  Verify the hash chain of a local audit log has not been...
  watch       Continuously classify and append hash-chained entries to...
| Comando | Finalidade |
|---|---|
classify | Classificação única. --backend synthetic|nvml, --profile (somente sintético), --gpu-index, --samples, --interval, --experimental (ainda não disponível), --json. |
watch | Classificação contínua; anexa uma entrada encadeada por hash a um log de auditoria local a cada janela. --window (amostras por janela), --iterations (0 = executar para sempre), --log-file, --json. |
benchmark | Executa o benchmark de robustez contra evasão (veja acima). --trials, --window, --json. |
verify-log | Recalcula o hash de cada entrada do log de auditoria e confirma que a cadeia não foi adulterada. --log-file, --json. |
mcp | Inicia um servidor MCP (stdio) expondo classify_workload, run_benchmark, verify_audit_log como ferramentas chamáveis por agentes. --backend. Requer pip install "workloadtruth-cli[mcp]" no Python 3.10+ (veja abaixo). |
Todo comando suporta --json. Referência completa de sinalizadores: workloadtruth <command> --help.
Servidor MCP
O WorkloadTruth inclui um servidor Model Context Protocol para que um agente de IA (Claude, Cursor ou qualquer cliente compatível com MCP) possa classificar cargas de trabalho de GPU, executar o benchmark de robustez contra evasão e verificar o log de auditoria diretamente, sem que um humano invoque a CLI manualmente.
Instale o extra:
pip install "workloadtruth-cli[mcp]"
Adicione-o à configuração do seu cliente MCP (para Claude Desktop, claude_desktop_config.json). O servidor é iniciado por meio do subcomando workloadtruth mcp, não por um script de console separado:
{
  "mcpServers": {
    "workloadtruth": {
      "command": "uvx",
      "args": ["--from", "workloadtruth-cli", "workloadtruth", "mcp"]
    }
  }
}
O servidor expõe três ferramentas via stdio:
classify_workload(backend="nvml", profile="training", gpu_index=0, samples=10, interval_seconds=1.0, write_to_audit_log=False): amostra a telemetria da GPU e a classifica comoTRAINING,INFERENCEouIDLE.backendé"nvml"(hardware real) ou"synthetic"(rastros sintéticos documentados, sem necessidade de GPU). Opcionalmente, anexa o resultado ao log de auditoria encadeado por hash.run_benchmark(trials=50, window=30): executa o benchmark de robustez contra evasão em telemetria sintética e retorna a precisão por perfil em condições limpas e com ofuscação por evasão.verify_audit_log(log_file="workloadtruth.log.jsonl"): recalcula a cadeia de hash de um log de auditoria local e informa se ele foi adulterado.
Exemplo de chamada, classificando um rastro de treinamento sintético sem necessidade de GPU:
classify_workload(backend="synthetic", profile="training", samples=10, interval_seconds=0)
-> {"workload_type": "TRAINING", "confidence": 1.0, "gpu_index": 0, ...}
O transporte é stdio, portanto não há nada para hospedar: o cliente MCP inicia workloadtruth mcp como um subprocesso local. Um manifesto .well-known/agent.json também é incluído na raiz do repositório para descoberta no estilo A2A, listando as interfaces CLI e MCP e os pacotes que as fornecem. Fonte: src/workloadtruth/mcp_server.py.
Log de auditoria
workloadtruth watch anexa uma entrada encadeada por hash a workloadtruth.log.jsonl a cada janela de classificação. O hash de cada entrada cobre seu próprio conteúdo mais o hash da entrada anterior, portanto qualquer edição, reordenação ou exclusão posterior quebra a cadeia a partir desse ponto. workloadtruth verify-log recalcula cada hash e relata o primeiro elo quebrado, se houver.
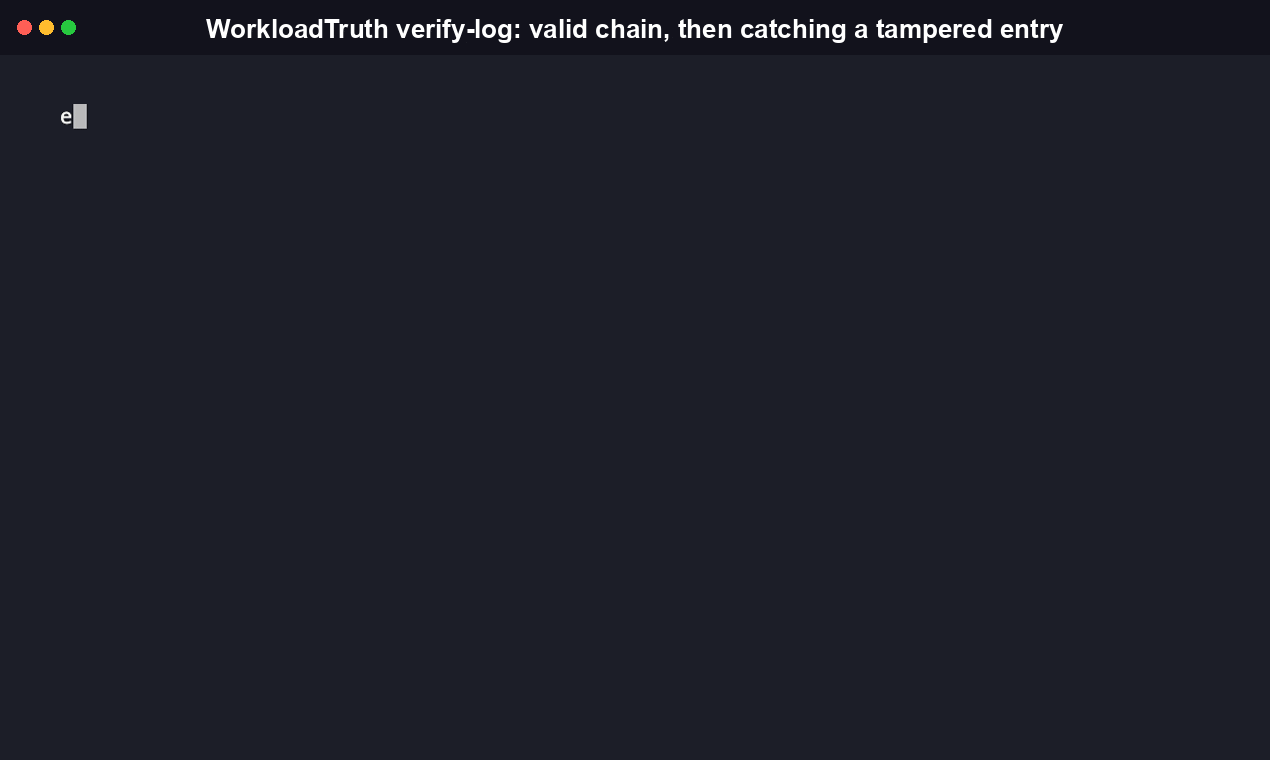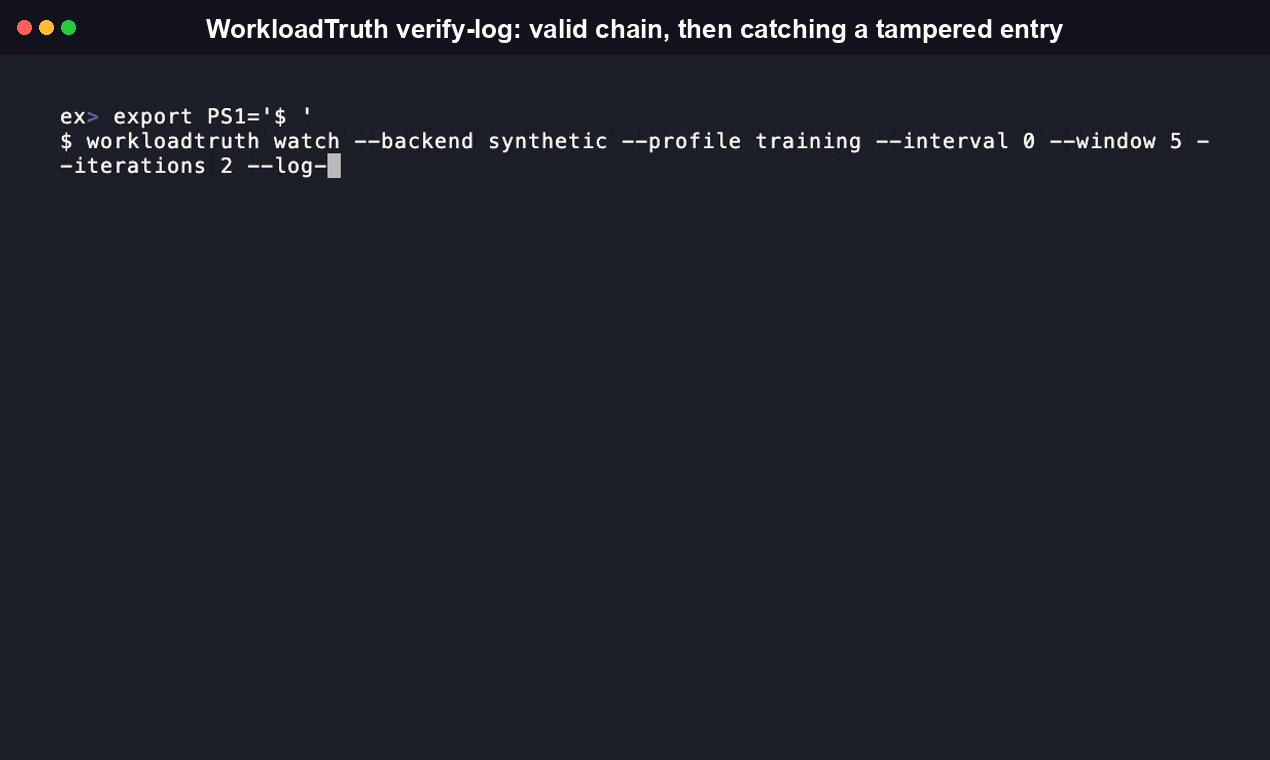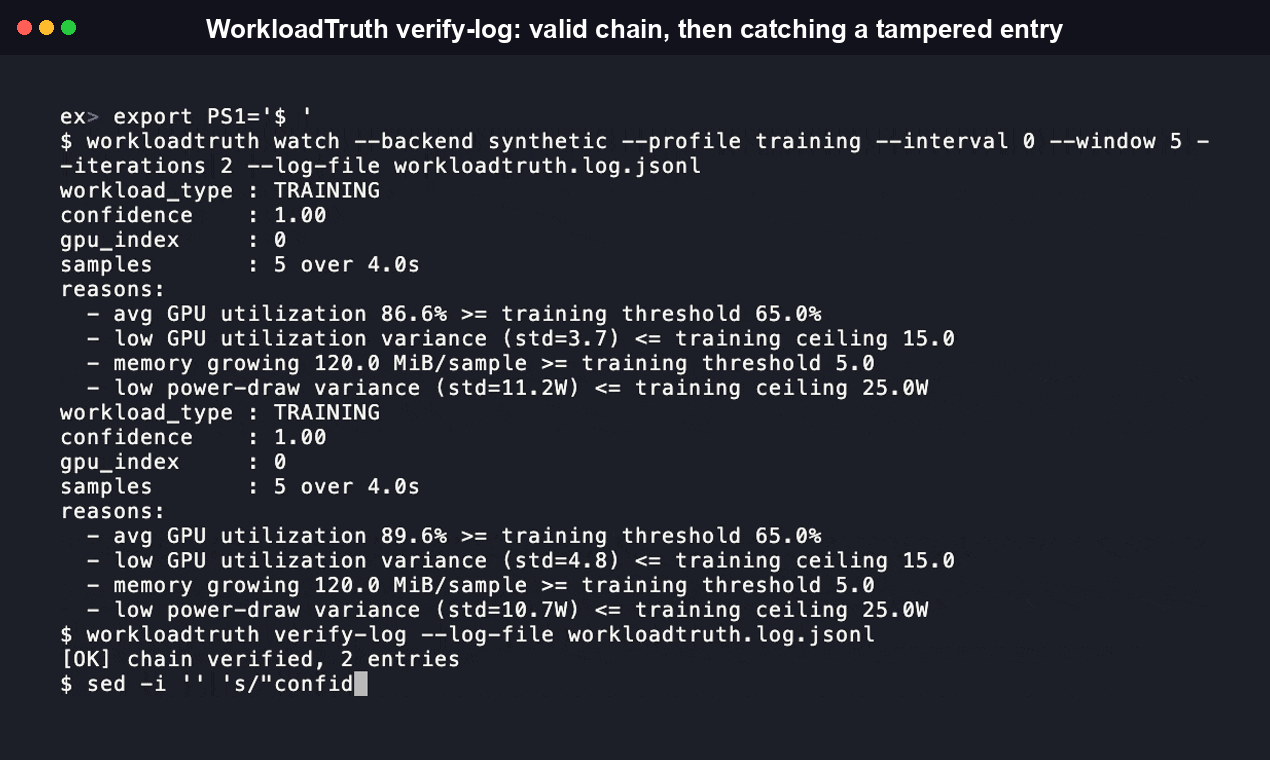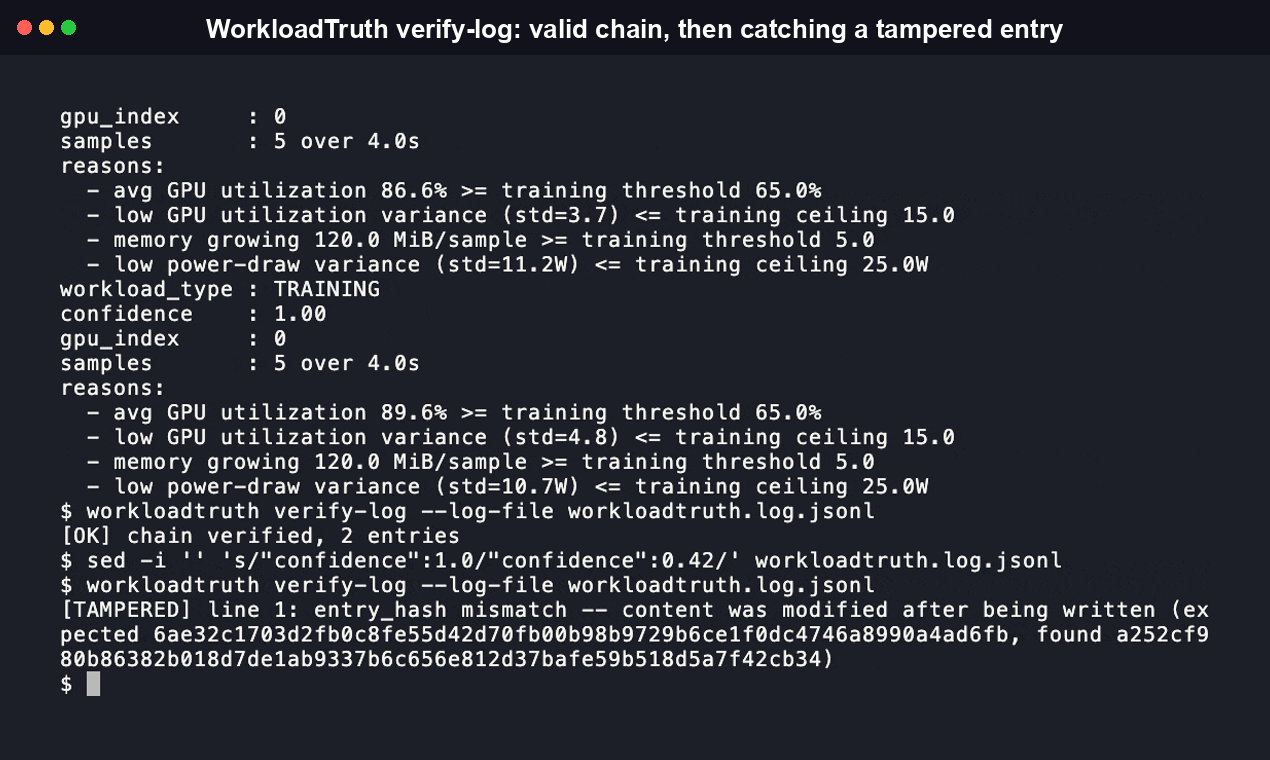
Isso prova o que foi classificado, quando, e que o registro local não foi alterado silenciosamente depois. Isso não prova que a classificação em si estava correta, e não é evidência de conformidade regulatória. Veja abaixo.
Por que dois registros
A implementação do WorkloadTruth é em Python. O acesso NVML (pynvml/nvidia-ml-py) é a forma madura e oficial de ler a telemetria da GPU NVIDIA, e também é o que o trabalho anterior mais próximo (arXiv:2606.19262) usa. O pacote npm (workloadtruth-cli) é um lançador fino, não uma reimplementação. Ele localiza e executa o binário real do workloadtruth instalado a partir do PyPI, para que npx workloadtruth-cli funcione para ferramentas de agentes que priorizam npm sem duplicar o classificador em duas linguagens. O pacote npm tem versões independentes do pacote PyPI, pois apenas fornece um script de lançador, não o classificador em si.
Comparação
| WorkloadTruth | NVIDIA DCGM / dcgm-exporter | run:ai | Weights & Biases | |
|---|---|---|---|---|
| Lê telemetria da GPU | Sim (via NVML) | Sim (fonte) | Sim | Sim |
| Classifica o tipo de carga de trabalho automaticamente | Sim | Não, expõe apenas métricas brutas | Não, o tipo de carga de trabalho é declarado pelo usuário na submissão do trabalho | Não, limitado a execuções de treinamento por design, sem classificação |
| Trilha de auditoria local encadeada por hash | Sim | Não | Não | Não |
| Benchmark de robustez contra evasão | Sim (documentado, reproduzível) | N/A | N/A | N/A |
| Requer uma GPU NVIDIA | Apenas para o backend nvml; o backend synthetic funciona sem uma | Sim | Sim | Não (métricas gerais do sistema) |
Verificado diretamente na documentação de cada projeto: documentação do exportador DCGM, visão geral de inferência do run:ai, documentação de métricas do sistema W&B. Nenhum deles classifica o tipo de carga de trabalho apenas com telemetria. Essa lacuna é o que o WorkloadTruth preenche.
O que é o WorkloadTruth e por que ele existe
O WorkloadTruth é uma ferramenta de linha de comando de código aberto e um servidor MCP que classifica uma carga de trabalho de GPU em execução como TRAINING, INFERENCE ou IDLE usando apenas telemetria de nível de GPU (utilização, padrão de memória, consumo de energia), sem alterações no código da própria carga de trabalho e sem depender de um rótulo de trabalho autodeclarado.
Ele existe porque todo escalonador de GPU mainstream pede ao proprietário do trabalho que declare seu tipo no momento da submissão e nunca verifica essa declaração contra o que o hardware está realmente fazendo. Essa lacuna tem duas consequências reais: má alocação de custos (um trabalho agendado com preço de "inferência" de baixa prioridade que na verdade está executando treinamento completo) e alterações não autorizadas na carga de trabalho (um endpoint de inferência que silenciosamente começa a treinar com tráfego ao vivo). O WorkloadTruth fecha essa lacuna de verificação hoje e também serve como a primeira implementação aberta e instalável de uma linha real de pesquisa acadêmica sobre verificação de execuções de treinamento de IA a partir de telemetria de hardware (veja abaixo).
Relação com pesquisas anteriores
A técnica central do WorkloadTruth, classificar atividade de GPU de treinamento vs. não-treinamento a partir de telemetria, não é nova. É a aplicação direta de uma linha de pesquisa real e ativa:
- Yonadav Shavit (Harvard), "What does it take to catch a Chinchilla?" (2023): propôs "transcrições de treinamento" em nível de hardware para verificar grandes execuções de treinamento.
- GovAI, "Computing Power and the Governance of AI" (2024): pesquisou mecanismos de governança de computação, explicitamente enquadrados como exploratórios, não como política endossada.
- "Hardware-Enabled Mechanisms for Verifying Responsible AI Development" (2025): pesquisadores de segurança de hardware propondo atestação no chip.
- Rahman & Tajdari, "Detecting Hidden ML Training With Zero-Overhead Telemetry" (ICML 2026 Technical AI Governance workshop): um classificador funcional de telemetria NVML, com 98,2% de precisão em cargas de trabalho não ofuscadas, o trabalho anterior direto para a técnica central de classificação deste projeto. O que o WorkloadTruth adiciona: conforme a pesquisa deste próprio projeto (19/07/2026), não existia nenhuma implementação open-source e instalável dessa linha de pesquisa, apenas protótipos acadêmicos. O WorkloadTruth é esse empacotamento: uma CLI real, um servidor MCP, um log de auditoria com encadeamento hash e um benchmark reproduzível de robustez contra evasão, construído de forma aberta. Ele não afirma melhorar a técnica de classificação do artigo. Veja a seção de benchmark acima: o classificador atual baseado em regras é consideravelmente mais evasível do que a abordagem de ML do artigo no único eixo que mede.
O que o WorkloadTruth não é
- Não é uma ferramenta de conformidade ou auditoria regulatória. Nenhuma lei atualmente exige classificação ou relatórios de inferência/treinamento. Qualquer alegação futura em contrário citará a regulamentação específica promulgada; nenhuma existe até o momento desta redação.
- Não é um inspetor de conteúdo. O WorkloadTruth lê apenas sinais de nível de GPU (utilização, memória, energia). Ele nunca inspeciona pesos de modelo, dados de treinamento, prompts ou conclusões.
- Não é prova de operação "conforme" ou "segura". O log de auditoria prova o que foi classificado e quando, e que o registro não foi alterado depois, não que a classificação estava correta ou que alguma política foi seguida.
FAQ
Isso precisa de uma GPU NVIDIA?
Apenas para o backend nvml. O --backend synthetic executa o classificador completo e a CLI com traces sintéticos documentados, sem necessidade de GPU. Útil para experimentar a ferramenta ou para CI.
Ele consegue classificar workloads de GPU AMD ou Intel?
Ainda não. A camada de telemetria é uma interface plugável (TelemetryBackend) especificamente para que um novo backend de fornecedor (AMD ROCm, Intel Level Zero) possa ser adicionado sem tocar no classificador. Veja CONTRIBUTING.md.
O classificador é preciso o suficiente para cobrar ou penalizar alguém com base em sua saída?
Ainda não, e a seção de benchmark acima é o motivo honesto: 0% de precisão em workloads de treinamento evasivos hoje. Trate o workload_type como um sinal para investigar, não como um veredito.
Por que não usar apenas o classificador de ML do artigo? Seus pesos treinados e conjunto de dados nunca foram publicados. Reimplementar um classificador de ML sem dados de treinamento reais produziria uma alegação de precisão não validada, não uma medida. Veja Como a classificação funciona.
Como isso é diferente do run:ai ou do NVIDIA DCGM? O run:ai e o DCGM ambos expõem ou usam telemetria de GPU, mas nenhum classifica o tipo de workload a partir dessa telemetria. O run:ai depende inteiramente do rótulo que o proprietário do job declara no envio; o DCGM apenas expõe métricas brutas de utilização e memória para outra coisa interpretar. O WorkloadTruth é a camada que realmente olha para a telemetria e responde à pergunta. Veja a tabela de comparação.
Isso funciona no Windows, macOS e Linux?
O backend synthetic roda em qualquer lugar onde Python 3.10+ roda, incluindo o ambiente de build macOS deste próprio projeto (que não tem GPU NVIDIA). O backend nvml requer uma GPU NVIDIA e driver, o que na prática significa Linux ou Windows com hardware NVIDIA; o NVML em si não está disponível no macOS.
Sob qual licença isso está, e posso usar comercialmente? Apache 2.0. Uso comercial, modificação e redistribuição são todos permitidos sob seus termos; veja LICENSE.
Contribuindo
Veja CONTRIBUTING.md. Problemas de segurança: veja SECURITY.md.