nanomem
Memória para fatos que mudam. Um registro recuperado é marcado como SUBSTITUÍDO, indicando quando um registro posterior o substituiu, para que um assistente não responda com um valor que não é mais verdadeiro.
Documentação
nanomem



Um armazenamento embutido para fatos que mudam.
Um fato que sua aplicação lembra não é um documento. Ele é corrigido — pessoas se mudam, trocam de emprego, mudam de número de telefone. Um armazenamento vetorial mantém ambas as afirmações e retorna aquela cuja redação está mais próxima da pergunta, que é como um assistente acaba repetindo com confiança um endereço que você deixou há dois anos. O nanomem mantém a cadeia e sabe qual extremidade dela é a atual.
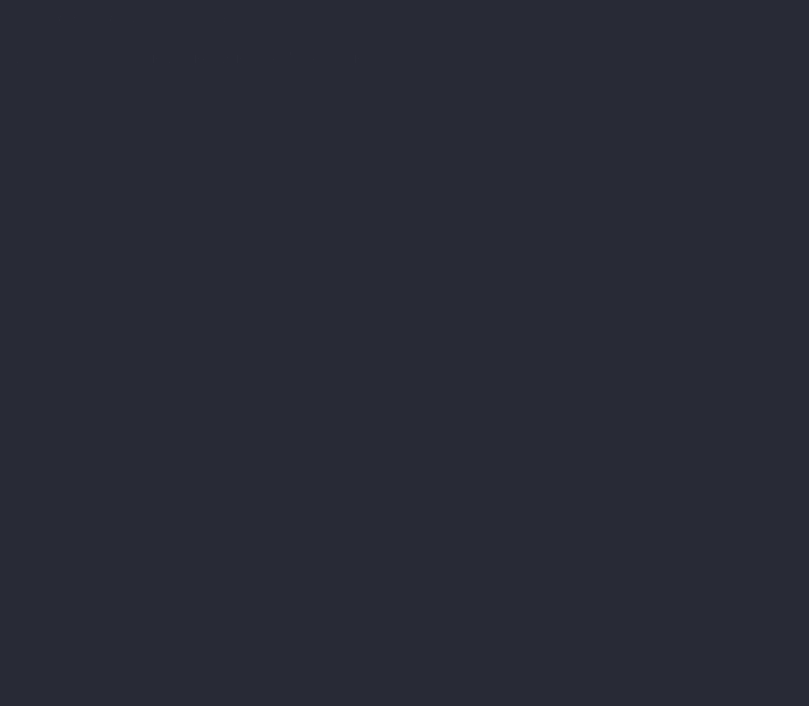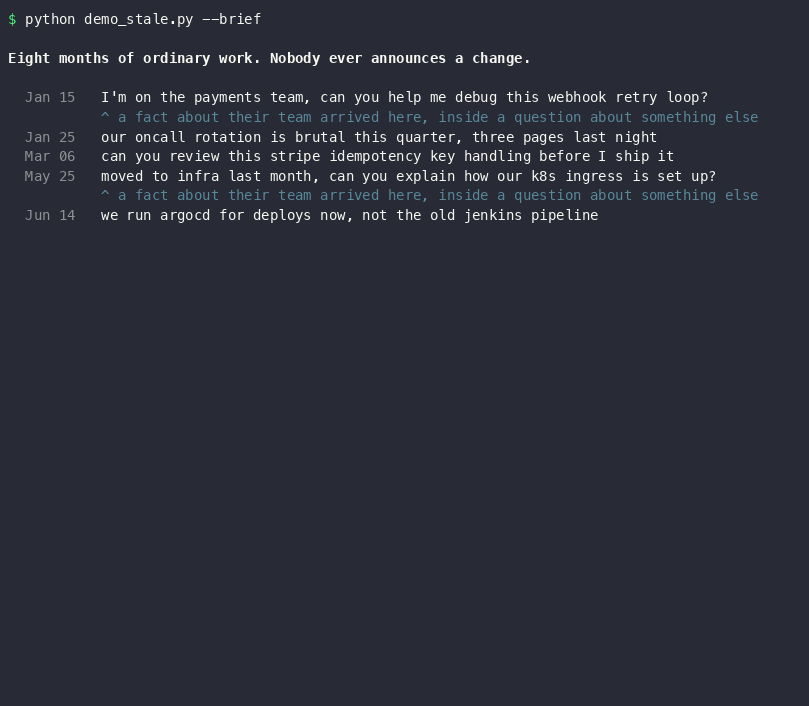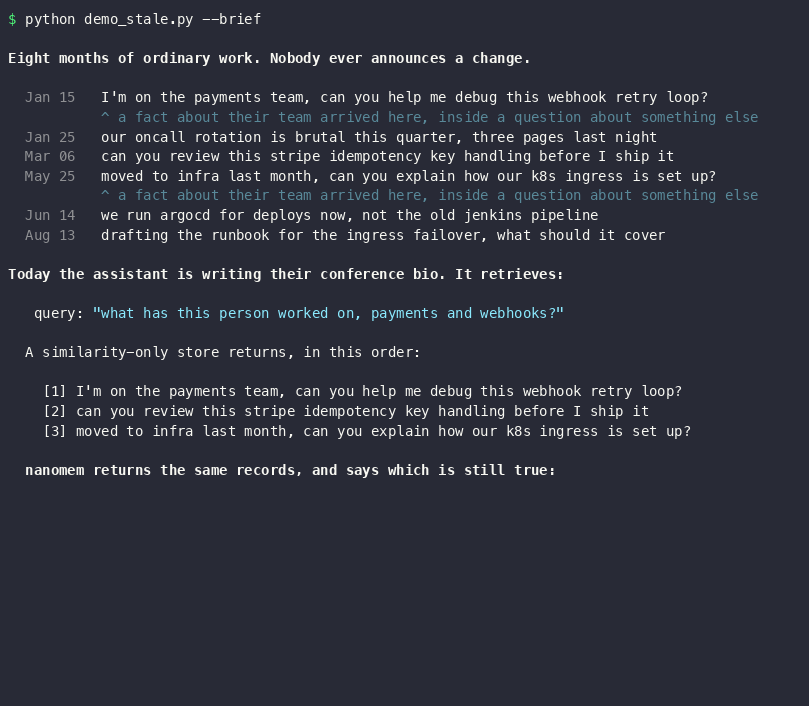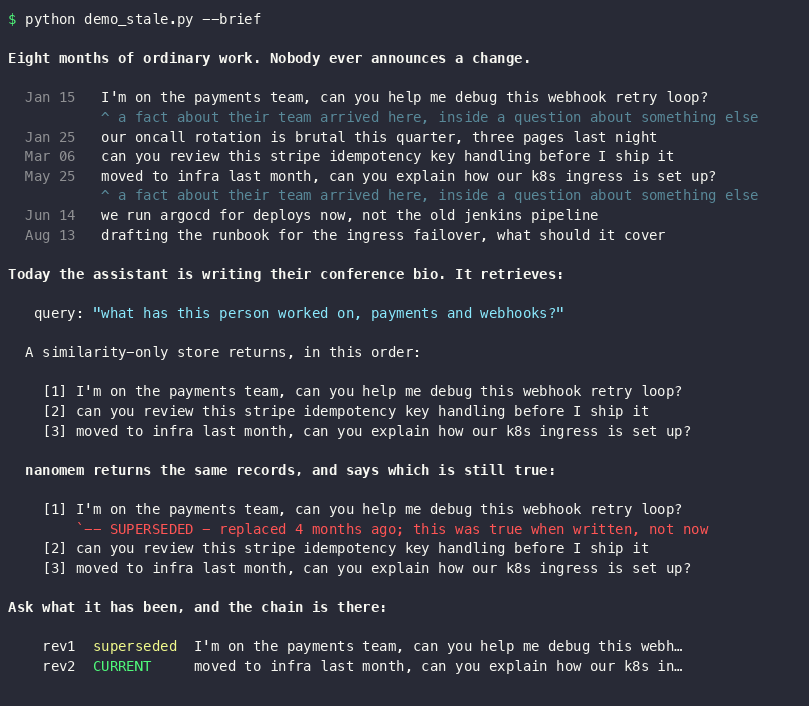
Oito meses de conversas comuns; o fato da equipe mudou uma vez, de passagem.
A similaridade ainda classifica o antigo em primeiro lugar, porque a pergunta é redigida
como o antigo emprego — então o nanomem o entrega rotulado em vez de fingir
o contrário. Uma execução real de demo_stale.py contra um Ollama local
(nomic-embed-text); regenere-o com python3 assets/record_demo.py. O
rótulo não vem do modelo: execute a mesma demonstração sem nenhum endpoint de
incorporação acessível e a linha SUPERSEDED ainda estará lá, porque é
calculada a partir da ordem de revisão, não da similaridade.
Evidências — como ele se compara a FAISS, sqlite-vec e Chroma (incluindo onde ele perde), o que acontece quando o processo é morto no meio de uma gravação, e o comando pytest que re-executa a maioria dessas afirmações na cópia que você acabou de instalar.
Início rápido — dê ao seu assistente uma memória que sabe o que mudou
pip install nanomem
Adicione isto à configuração do seu cliente MCP. No macOS, claude_desktop_config.json
vive em ~/Library/Application Support/Claude/:
{
  "mcpServers": {
    "nanomem": {
      "command": "nanomem-mcp"
    }
  }
}
Essa é toda a configuração. O cofre padrão é ~/.nanomem/memory.dat;
defina NANOMEM_VAULT, ou passe --vault /some/path.dat, para colocá-lo em outro lugar.
Reinicie o cliente e diga algo que mudará mais tarde:
"Lembre-se de que eu trabalho na Acme Corp." (uma semana depois) "Na verdade, eu me mudei — estou na Globex agora." "Onde eu trabalho? E onde eu trabalhava antes?"
Ele responde Globex, e pode lhe dizer que costumava ser Acme — não porque a segunda frase foi redigida mais próxima da pergunta, mas porque o nanomem manteve a cadeia e sabe qual extremidade dela é a atual. Pergunte "o que eu acreditava sobre isso em março?" e ele também pode responder.
Sete ferramentas: nanomem_add, nanomem_search, nanomem_history,
nanomem_as_of, nanomem_changes, nanomem_volatility, nanomem_stats — para que
o assistente possa perguntar o que um fato COSTUMAVA ser, o que a memória acreditava em um
momento passado, o que mudou na semana passada e quais de suas próprias crenças ficaram desatualizadas.
O cofre é um arquivo comum. Aponte a CLI ou um script Python para o mesmo caminho para ler o que o assistente escreveu — uma gravação está no disco antes de sua resposta ser enviada, então outro processo a vê imediatamente e parar o servidor não pode perdê-la.
Até 0.7.17 isso não era verdade: o servidor descarregava apenas em uma saída limpa, e um
cliente MCP para seus servidores com SIGTERM. Vinte chamadas nanomem_add, cada uma
respondida "Stored …", depois SIGTERM, deixaram zero linhas no cofre. Se você executou
uma versão anterior, qualquer coisa que o assistente "lembrou" em uma sessão que não foi
fechada corretamente nunca foi gravada.
Ou use-o a partir do Python
pip install nanomem
import time
from nanomem import Vault

DAY, now = 86400, time.time()
job = {"entity": "employer"}

v = Vault("memory.dat")
v.add("I work at Acme Corp.",                    metadata=job, timestamp=now - 300*DAY)
v.add("I moved jobs, I now work at Initech.",    metadata=job, timestamp=now - 155*DAY)
v.add("I switched again, I work at Globex now.", metadata=job, timestamp=now - 10*DAY)

print(v.search("where do I work")[0]["text"])
# I switched again, I work at Globex now.

for r in v.history("where do I work"):
    print(r["revision"], r["superseded"], r["text"])
# 1 True I work at Acme Corp.
# 2 True I moved jobs, I now work at Initech.
# 3 False I switched again, I work at Globex now.

print(v.search("where do I work", as_of=now - 200*DAY)[0]["text"])
# I work at Acme Corp.

f = v.volatility()[0]
print(f["entity"], f["n_revisions"], round(f["median_interval"]/DAY))
# employer 3 145
Um arquivo no disco. Uma dependência de tempo de execução (numpy). Sem servidor, sem daemon, sem
índice para reconstruir. A busca é exata — uma varredura completa de cosseno, não um índice
aproximado — então a recuperação é 100% por construção e toda pergunta interessante é
sobre tempo, não sobre classificação.
Ele informa quando a resposta é cortada
search retorna no máximo top_k registros. Agora também informa o que deixou para trás,
o que importa mais quando o chamador é um modelo que não pode olhar:
r = vault.search("revenue of every company in every year", top_k=3, min_score=0.6)

len(r)                      # 3   — it is a list; every existing caller is unchanged
r.truncated                 # True
r.n_above_floor             # 21  — how many cleared your min_score
r.explain()                 # "This answer is incomplete -- showing 3 of 21 records
                            #  scoring at or above your min_score of 0.60. ..."
Para uma pergunta de múltiplas partes, o número útil é quais partes não receberam nada:
r = vault.search("What is Acme revenue? ... What port does staging use?")
r.unanswered_sub_queries    # the clauses that got no slot
explain() retorna "" quando nada informativo foi cortado, então é seguro
anexar incondicionalmente — e a ferramenta MCP nanomem_search faz exatamente isso.
Ele só fala quando há um min_score. Com o padrão 0.0, todo
registro ultrapassa o limite, então "mostrando 3 de 101" seria verdadeiro para toda pergunta já
feita, incluindo uma cuja resposta é realmente um único registro. Um sinal que dispara
toda vez não carrega nada. A contagem ainda está em r.n_above_floor de qualquer forma.
As contagens são gratuitas: a varredura é exaustiva, então ambos os números já existiam na
linha que aplica top_k e estavam sendo descartados.
Ele marca respostas que não são mais verdadeiras
Um carimbo de data/hora diz quando um registro foi escrito. Ele não pode dizer se ainda é verdadeiro — um fato escrito há dez anos pode ser atual, e um escrito na semana passada já pode estar morto. A diferença é se um registro posterior o substituiu, o que é o que a cadeia de revisão sabe.
Busque por um fato que mudou e você obtém vários de seus valores, porque é isso que uma cadeia é. Cada um agora diz onde está:
for h in vault.search("where do I work", top_k=3):
    print(h["superseded"], h["text"])
# False  I switched again, I work at Globex now.
# True   I moved, I work at Initech.
# True   I work at Acme Corp.
ask() coloca isso no prompt, então o modelo é informado quais fatos estão mortos
antes de escrever; a ferramenta MCP os marca no texto que um assistente lê:
[2] (2025-08-17) [SUPERSEDED - replaced 8 months ago; this was true
    when written, not now]: I moved, I work at Initech.
Um fato de dez anos que nunca mudou não é marcado com nada. superseded é
None — não False — para um registro fora de qualquer cadeia, porque lá "nada o substituiu"
é desconhecido, não verdadeiro.
Diga a ele o que é um atributo
metadata={"entity": "employer"} está fazendo um trabalho real acima, e vale um
parágrafo porque pouco mais aqui importa tanto.
Nomeie o atributo e o nanomem sabe que essas três afirmações são um fato, então ele
as mantém como uma cadeia. Deixe-o de fora e um rotulador lexical adivinha a partir do texto —
medido, em 100 cadeias por braço, cada membro de uma cadeia recebeu a mesma etiqueta correta em
70 de 100 cadeias de redação simples e 0 de 100 em redação
narrativa. No exemplo acima, ele rotula "Eu mudei de emprego, agora trabalho na Initech."
como location em vez de career, porque "mudei" pesa mais que "trabalho em", e a
cadeia silenciosamente se divide em duas.
Então, se sua aplicação tem atributos próprios, declare-os. Tudo que o nanomem faz que um armazenamento vetorial não faz depende de saber quais afirmações são sobre a mesma coisa — e você sabe disso, enquanto o rotulador está adivinhando.
Pacote 0.8.3 · motor 3.4.6 · formato de contêiner 3 · formato de cache de arena 4.
Licença: Apache-2.0. Use comercialmente, modifique, envie dentro de um
produto de código fechado — mantenha os arquivos LICENSE e NOTICE com qualquer
redistribuição, diga o que você mudou e não use o nome do projeto ou do
autor para endossar o seu. Essa é toda a obrigação.
O nanomem foi AGPL-3.0-or-later de 0.6.0 até 0.7.22, com uma licença comercial ao lado. Essa combinação protegia algo que valia menos do que os usuários que estava afastando: a maioria das empresas proíbe AGPL por política e muitos desenvolvedores a ignoram sem lê-la. Cópias distribuídas sob os termos antigos os mantêm, e ambos os textos substituídos ainda são enviados — LICENSE.agpl-3.0-or-later.md e LICENSE.preview-v1.0.md. Até 0.6.0, os metadados da wheel diziam Apache-2.0 enquanto o arquivo LICENSE dizia All Rights Reserved; essa contradição foi resolvida em 0.6.0 e permaneceu resolvida.
Execute a demonstração
cd nanomem_standalone
python3 demo.py          # stores, updates, searches, prints real stats()
python3 demo_stale.py    # the one worth seeing: a fact going stale over 8 months
Adicione --brief a qualquer um para remover a prosa explicativa e manter apenas as
linhas calculadas; é isso que a gravação no topo deste arquivo mostra.
demo_stale.py são oito meses de sessões de trabalho comuns onde ninguém nunca
anuncia uma mudança — o fato da equipe chega duas vezes, ambas dentro de uma pergunta
sobre outra coisa. Então o assistente escreve uma biografia, a similaridade coloca o
antigo time em primeiro lugar porque a pergunta é redigida como o antigo emprego, e o nanomem
o entrega marcado como SUPERSEDED - replaced 4 months ago. Cada linha que ele imprime
é calculada; edite as sessões no topo e execute novamente.
Ele armazena alguns fatos, atualiza um deles para mostrar o manuseio de revisão, busca
com citações e imprime o stats() real do cofre — contagem de documentos, tamanho
do arquivo, o active_heap_ram_kb medido e se o arquivo está criptografado (por
padrão não está).
Execute os testes
python3 -m pytest -q
845 testes, sem necessidade de rede.
Não há test_security.py. Versões anteriores deste README diziam para você executar
um para "provar que zero texto simples existe no disco"; esse arquivo nunca existiu, e
a afirmação estava errada de qualquer forma — um cofre é um arquivo de texto simples a menos que você lhe dê uma
senha. Para verificar por si mesmo:
python3 -m nanomem.cli init demo.dat
python3 -m nanomem.cli add "the office wifi password is hunter2" --vault demo.dat
strings demo.dat | grep hunter2          # plaintext vault: it is there
python3 -m nanomem.cli rekey --vault demo.dat --new-password-stdin
strings demo.dat | grep hunter2          # password mode: it is not
Use-o a partir do seu próprio script
from nanomem import Vault

with Vault("my_knowledge.dat") as vault:            # plaintext by default
    doc_id = vault.add("Server backup runs daily at 02:00 UTC")
    vault.add("The staging database is on port 5433")

    hits = vault.search("When does the backup run?")
    print(hits[0]["text"], hits[0]["cosine"])
add() retorna o id do documento, então você pode get, update ou delete por ele
mais tarde. Para um cofre criptografado, passe password="…" (ou defina NANOMEM_PASSWORD).
As incorporações são suas para escolher. O padrão é nomic-embed-text em um
daemon local compatível com Ollama, mas qualquer modelo de qualquer largura funciona — a largura é
sondada do próprio modelo, e o cofre é dimensionado a partir do que ele retorna:
Vault("m.dat", embed_model="all-minilm")                    # 384-d
Vault("m.dat", embed_model="mxbai-embed-large")             # 1024-d
Vault("m.dat", embed_model="text-embedding-3-small",
      base_url="https://api.openai.com/v1/embeddings")      # 1536-d
Vault("m.dat", embedder=MyOwnEmbedder())                    # anything with
                                                            # .embed/.embed_batch/.dim
Aponte-o para qualquer lugar com base_url= ou NANOMEM_EMBED_URL. Passe dim= para
EmbeddingProvider para pular a sondagem completamente (instalações sem conexão). A
largura de um cofre existente sempre vence sobre a que você solicita, então você não pode
corromper silenciosamente um cofre nomeando um modelo diferente mais tarde — você recebe um aviso
e o arquivo mantém sua própria largura. Esse identificador é então apenas parcialmente utilizável: seu
codificador ainda é o modelo que você nomeou, então toda chamada que precisa de um NOVO vetor —
add, update(text=), search, history — gera erro até você reabrir com um da
largura do arquivo. Leituras ainda funcionam, e delete, prune, compact e
forget_superseded ainda são executados e ainda reescrevem o arquivo, comportando-se exatamente como
fazem através de um identificador correspondente (medido em 8 operações: 0 diferiu). Isso dizia
"toda chamada gera erro" até 0.7.20, o que levou um revisor a ler um prune normal
como destruição silenciosa. Nada é perdido, mas não continua silenciosamente.
Sem um daemon, há um fallback, e vale a pena saber o que é:
um codificador lexical determinístico em 768-d — palavras e trigramas de caracteres
com hash, sem semântica. Ele pontua "the server is up" contra "o servidor está fora do ar" at 0.783, and "Eu dirijo um carro" against "Eu tenho um automóvel" em
0.286. Opostos parecem idênticos, sinônimos parecem não relacionados. Ele mantém o
pipeline funcionando offline e é adequado para um teste rápido; não é um substituto
para um modelo de incorporação, e não há pesos neurais incluídos.
O que o torna diferente de um armazenamento vetorial
O nanomem é um log somente de anexação, então ele mantém todo valor que um fato já teve, não apenas o atual. Isso torna quatro perguntas respondíveis que um índice vetorial não pode representar, porque nenhum deles mantém o histórico para responder.
with Vault("memory.dat") as v:
    v.history("where do I work")          # every value, oldest first, current last
    v.search("where do I work",
             as_of=1735689600.0)          # the answer as the memory stood back then
    v.changes(since=1735689600.0)         # what was written in a window, no query
    v.volatility()                        # how often each fact actually changes
as_of e since são carimbos de data/hora unix em Python; a CLI abaixo aceita
YYYY-MM-DD também. history() retorna cada valor com seu carimbo de data/hora e um sinalizador superseded; a
última entrada é a atual. Um fato que nunca mudou retorna uma entrada,
que é uma resposta, não um resultado vazio.
volatility() é o que vale a pena olhar. Ele lê o log de revisão e relata, por
fato, quantas vezes ele foi reafirmado, o intervalo típico entre mudanças,
e há quanto tempo o valor atual está sem confirmação — para que um agente possa descobrir
quais de suas próprias crenças ficaram desatualizadas e perguntar novamente:
fact             restated   changes every   last confirmed
mobile_phone            4          195 d           2237 d   ← ask again
employer                3          807 d             47 d
Sem modelo e sem consulta: carimbos de data/hora diferenciados de duas colunas residentes, fora do
caminho de busca. staleness() transformará isso em uma probabilidade, mas retorna
None a menos que você passe assume_memoryless=True — a taxa por fato só superou uma
taxa única de todo o corpus em dados gerados para corresponder à sua própria suposição, então não está
ativada por padrão (evidence/staleness_calibration.json).
O que limita isto. Dois registros só são tratados como um único fato quando o nanomem consegue
identificar que são o mesmo atributo, e isso exige um vocabulário ou a
consulta — cinco sinais sem vocabulário foram medidos e todos estão no nível do acaso contra
atributos irmãos, como endereço residencial versus comercial
(evidence/grouping_signal_results.json). Com fraseado canônico, cada membro
de uma cadeia recebe a mesma etiqueta correta em 70 de 100 cadeias; com fraseado narrativo
("transferiu a linha no fim de semana, fale comigo em …") em 0 de 100
(evidence/temporal_drift_results.json). Se a sua aplicação conhece seus
próprios atributos, declare-os — passe metadata={"entity": "employer"} na escrita
— e defina group_floor_sim=0.45, valendo +19,0 pontos de top-1 exatamente no
fraseado com o qual o etiquetador tem dificuldade (floor_retune_results.json). Deixe ambos
como estão se você depende do etiquetador; a mesma configuração custa 13,9 pontos lá.
Declare-o onde quer que você escreva. metadata={"entity": ...} em Python,
entity na ferramenta MCP nanomem_add, --entity em nanomem add. Até
0.7.12, os dois últimos não existiam, então as duas superfícies pelas quais a maioria dos chamadores se integra
estavam travadas no etiquetador sem que nada dissesse isso.
O que custa quando você não pode declarar um. Em um grupo que o etiquetador inferiu,
search e history podem discordar sobre qual valor é o atual: history
resolve a cadeia etiquetada e lê o contador de revisões, enquanto search também
aplica um piso de relevância que pode descartar o valor mais novo quando ele está fraseado
mais distante da pergunta do que um mais antigo. Isentar o membro mais novo de um
grupo inferido foi medido e rejeitado — custa -19,4 pontos no
conjunto de chat de 3 personas, e uma varredura de 0,40 a 0,80 não encontrou nenhum limite que comprasse
um sem pagar o outro
(evidence/floor_current_value_results.json). Portanto, esta é uma troca
deliberada, não uma omissão.
0.7.12 dizia aqui que history é autoritativo e deve ser acreditado em vez de
search. Isso estava errado e a afirmação foi retirada: history poderia em si
retornar uma cadeia mais curta do que existia, no pior caso uma entrada sinalizada
superseded=False, que esta biblioteca define como "este fato nunca mudou".
Essa truncagem foi corrigida em 0.7.14 e 0.7.15 — uma cadeia declarada agora retorna
todas as revisões que possui, e changes() concorda com ela.
O que resta é o próprio desacordo. Até 0.7.16, esta seção dizia
"declare a entidade e o desacordo desaparece", com base em
três cadeias pontuando 3/3 (evidence/entity_declaration_results.json). Uma terceira
revisão independente de caixa-preta encontrou uma cadeia declarada onde isso não acontece, e a
afirmação estava errada de uma forma que a medição não podia ver: em todas essas três
cadeias, cada revisão REAFIRMA o atributo ("agora trabalho na Initech"), o que
mantém os membros da cadeia próximos. Quando a revisão 1 nomeia o atributo
e revisões posteriores se referem a ele implicitamente — "Minha mesa fica no terceiro andar da
Casa Kestrel" e depois "Agora estacionado no prédio Maple Wharf" — os membros
se afastam, e o impulso que promove o valor atual foi limitado abaixo do que
esse afastamento precisa. search[0] retornou uma localização de mesa duas mudanças antiga enquanto
history() retornou a correta, com a entidade declarada.
0.7.16 eleva esse limite em uma varredura sobre oito braços e dois incorporadores
(evidence/revision_lead_cap_results.json). Medido em doze cadeias do
fraseado que o quebrou, cada uma sozinha em seu cofre, em dois regimes de timestamp:
cadeias declaradas, top-1 de search == valor atual de history | 0.7.15 | 0.7.16 |
|---|---|---|
| revisões posteriores referem-se implicitamente, modelo real (24 casos) | 41,7% | 100,0% |
| as mesmas cadeias no codificador de fallback offline (12) | 25,0% | 75,0% |
| fraseado divergente, conjunto gerado (100) | 71,0% | 100,0% |
e left to the tagger permanece 2/3, inalterado e ainda medido em apenas três cadeias
(evidence/entity_declaration_results.json).
Declarar a entidade é o que torna a cadeia resolvível, e em um modelo de
incorporação real é o que faz search e history concordarem nesses conjuntos.
Não é uma garantia. Nas doze cadeias de codificador offline medidas aqui, cada
falha restante tem a mesma causa: esse codificador é lexical, a revisão mais nova
cai tão longe da pergunta que a tela de relevância a remove do resultado
inteiramente, e nenhum aumento de classificação pode promover um registro que nunca foi retornado
(6 de 6 falhas, braço H de revision_lead_cap_results.json).
Essa é a causa NESTE corpus, não a única que existe. Um revisor
independente, construindo cadeias da mesma forma descrita, mediu falhas de um
segundo tipo: a revisão mais nova É retornada, o impulso é aplicado e satura
em max_boost, e o aumento necessário para liderar a cadeia (~0,68) ainda excede o
limite de 0,60. Essas seriam corrigidas por um limite maior; as medidas aqui não seriam,
e é por isso que a varredura publicada mostra este braço plano de 0,60 a 1,50. Dois
corpora da mesma forma podem diferir tanto em um codificador lexical, então trate os
75,0% como o que é — uma medição de doze cadeias, não uma propriedade do
fallback. tests/test_revision_lead_cap.py falha se o limite for algum dia atingido nos
conjuntos que verifica. changes() é a visão sem filtro para verificação cruzada.
Construindo RAG sobre ele
A recuperação é o núcleo; a geração é opcional e não usa dependência extra
(urllib da stdlib para qualquer endpoint que você apontar).
v.search("what port does staging use?", top_k=3)     # retrieval only
v.ask("What port does staging use?", llm="llama3.2") # -> {question, answer, citations}
v.ingest_file("runbook.md")                          # chunk + store a document
nanomem proxy adicionalmente serve um /v1/chat/completions compatível com OpenAI
que injeta memória, então um aplicativo existente pode apontar para o nanomem em vez de seu
provedor e ganhar memória sem mudanças de código.
Provedores. Passe base_url= e api_key= para ask()/chat(), ou defina-os
no Vault. A URL base decide a forma da requisição:
| Ollama (padrão) | http://localhost:11434 → /api/generate nativo |
| OpenAI, Groq, Together, Mistral, DeepSeek, OpenRouter, Fireworks | qualquer base terminando em /v1 |
| LM Studio, vLLM, llama.cpp | :1234, :8000, :8080 |
| Anthropic | https://api.anthropic.com/v1 → /v1/messages, x-api-key |
| Azure OpenAI | passe a URL de implantação completa terminando em /chat/completions |
As incorporações vêm de NANOMEM_EMBED_URL (padrão nomic-embed-text no
Ollama). O roteamento é decidido pela PORTA ANALISADA, não por uma substring da URL —
antes de 0.6.1, um host chamado web8000.internal era mal roteado e o Anthropic era
POSTado para /v1/chat/completions, que retorna 404.
CLI
python3 -m nanomem.cli init company.dat
python3 -m nanomem.cli add "DB port is 5433" --vault company.dat
python3 -m nanomem.cli search "DB port" -k 3 --vault company.dat
python3 -m nanomem.cli history "DB port" --vault company.dat
python3 -m nanomem.cli search "DB port" --as-of 2026-03-01 --vault company.dat
python3 -m nanomem.cli changes --since 2026-01-01 --vault company.dat
python3 -m nanomem.cli stats --vault company.dat
python3 -m nanomem.cli rekey --vault company.dat --new-password-stdin
add imprime o id do documento e seu próprio tempo decorrido.
O que faz, medido
A busca é uma varredura linear exata. Para o texto que varre, retorna o que uma
varredura exaustiva de cosseno fp32 retorna — 0 de 120 diferenças de ordem top-4 em um
corpus de 1.190 documentos (evidence/exactness_v3r2.json) — e sua latência
portanto cresce com o corpus.
Qual texto ele varre depende de decompose, que tem como padrão True. Uma
pergunta de múltiplas cláusulas é dividida e cada subconsulta é varrida exaustivamente, depois
os melhores resultados são intercalados — então o resultado é a resposta exaustiva para cada
cláusula, não o top-k exaustivo da frase inteira, e para uma pergunta de múltiplas
cláusulas os dois diferem. Esse é o ponto da decomposição: uma pergunta de duas partes
tem ambas as partes respondidas. Passe decompose=False quando quiser a string inteira
tratada como uma única consulta e a alegação de exatidão acima aplicada de ponta a ponta.
| Corpus | p50 | recall@4 | igual ao numpy exaustivo? | igual ao FAISS flat? | índice | RSS por doc |
|---|---|---|---|---|---|---|
| 1.190 | 0,052 ms | 68,3% | sim | sim | 2,5 MB | — |
| 10.000 | 0,345 ms | 70,4% | sim | sim | 22,0 MB | 8,4 KB |
| 71.433 | 1,762 ms | 60,6% | sim | sim | 155,9 MB | 8,8 KB |
evidence/scale_results_v3r4.json, headtohead_v3.json,
rss_v3r4.json. Medido em Apple M4 Pro / Python 3.12, nomic-embed-text
768-d, ordem de inserção aleatória, 500 perguntas retidas, ingestão → fechar → reabrir
→ busca. (Cada caminho evidence/… nestes documentos é relativo à
raiz do repositório, não a esta pasta; os JSONs e os scripts que os escreveram
vivem lá.)
As colunas "igual ao exaustivo" são recall. A ordenação também é idêntica em 1.190
documentos (0 de 120 diferenças de ordem top-4); em 10.000 e 71.433, alguns
desempates diferem — 2 de 500 e 5 de 500 perguntas, maior lacuna de cosseno 2,2e-05 —
porque os vetores em disco são fp16 (evidence/verify_round3_v3r3.json).
As pontuações são exatas no mesmo sentido e nem um pouco além: duas
multiplicações de matrizes float32 de formas diferentes reduzem em ordens diferentes, então a pontuação anexada a
um resultado pode diferir em seu último bit ou dois entre um BLAS e outro — medido
2,98e-08, dois ulps, entre Apple Accelerate e OpenBLAS na mesma consulta. A
resposta não se move com isso. Em 4.000 documentos em 128 e 768 dimensões, o
pior erro |fp32 − fp64| é 2,01e-07 enquanto a menor lacuna entre a classificação 4 e
a classificação 5 é 4,46e-06 — vinte vezes maior — e 0 de 150 consultas ficaram indecisas
em k = 1, 4 ou 10 (evidence/screen_exactness_results.json). Então "retorna
o que uma varredura exaustiva retorna" é uma alegação sobre quais documentos voltam e
em que ordem — exceto entre documentos que a classificação genuinamente não consegue separar,
onde o corpus não contém desempate para ser fiel. Não é uma alegação
sobre o padrão de bits do float ao lado deles, e nunca poderia ter sido.
A memória residente é aproximadamente 8–9 KB por documento. Documentação anterior afirmava
uma pegada de "< 500 KB de RAM" ou "160 KB de heap ativo"; essas eram constantes impressas
por stats(), não medições, e se foram.
As escritas são planas conforme o cofre cresce: média de 19,81 µs nas primeiras 500 de 4.000
adições, 19,32 µs nas últimas 500, excluindo incorporação
(evidence/headtohead_v3.json).
Excluir um registro é uma reescrita atômica completa — 7,5 ms em 1.000 registros, 70,5
ms em 10.000 (evidence/rewrite_cost_v3r4.json). Não há tombstoness
no 3.0.
Documentação
- USER_MANUAL.md — hub e as tabelas completas de desempenho medido
- USER_MANUAL_PERSONAL.md — chat, perfis, privacidade
- USER_MANUAL_DEVELOPER.md — SDK, CLI, concorrência, migração
- SERVICES_AND_API_SPECIFICATION.md — endpoints REST e limites
- MULTIHOP_REASONING_AND_TOPOLOGY_GUIDE.md — a ponte e o que não funcionou
- CHANGELOG.md — mudanças que quebram desde 0.1.x
Leia nanomem.THREAT_MODEL antes de confiar no modo de senha opcional. É
scrypt + um fluxo de chaves SHAKE256 + uma tag HMAC-SHA256, construído a partir da biblioteca
padrão do Python. Não é AES, não é "criptografia de 256 bits" e não foi
auditado.