trace-mcp
Servidor de inteligência de código com reconhecimento de frameworks que constrói um grafo de dependências entre linguagens a partir do código-fonte — 53 integrações de frameworks em 68 linguagens, mais de 100 ferramentas para navegação, análise de impacto, refatoração e memória de sessão com até 97% de redução de tokens.
Documentação


FUNCIONA COM · Claude Code · Cursor · Codex · Windsurf · Zed · qualquer cliente MCP
trace-mcp indexa o que seu agente fica relendo e entrega a resposta no lugar.
72,7% menos tokens de entrada para revisar um pull request — mediana em 60 pull requests mesclados em repositórios open-source que não são nossos.
Nós mudamos configurações que você mesmo poderia mudar. Não alteramos o binário do seu cliente, não interceptamos o tráfego dele nem reescrevemos seus arquivos. Uma exceção recusável: o pareamento tweakcc do nível Max executa um patcher de terceiros para você.


npm install -g trace-mcp   # MCP server, no app
trace init                 # wire it into your agent, once per machine
trace add                  # index the repo you are in
72,7% menos tokens de entrada para revisar um pull request — mediana em 60 PRs mesclados em seis repositórios que não são nossos, 13.595 → 3.291 por pull request. Método e reprodução →
Medido no trace-mcp 3.23.2 (cb8ab30c) em 7 de setembro de 2026 — um resultado daquela build, não uma afirmação sobre a atual. O que se propôs a medir, a meta que precisava superar e o veredito: pré-registro.
Mais barato não é o mesmo que melhor, então os mesmos 60 pull requests foram revisados duas vezes e pontuados às cegas. O braço com trace-mcp entendeu a mudança em 67% deles contra 65% para carregamento ingênuo de arquivos, com 0,80 falsos positivos por PR contra 0,58. Metade de qualidade do benchmark →
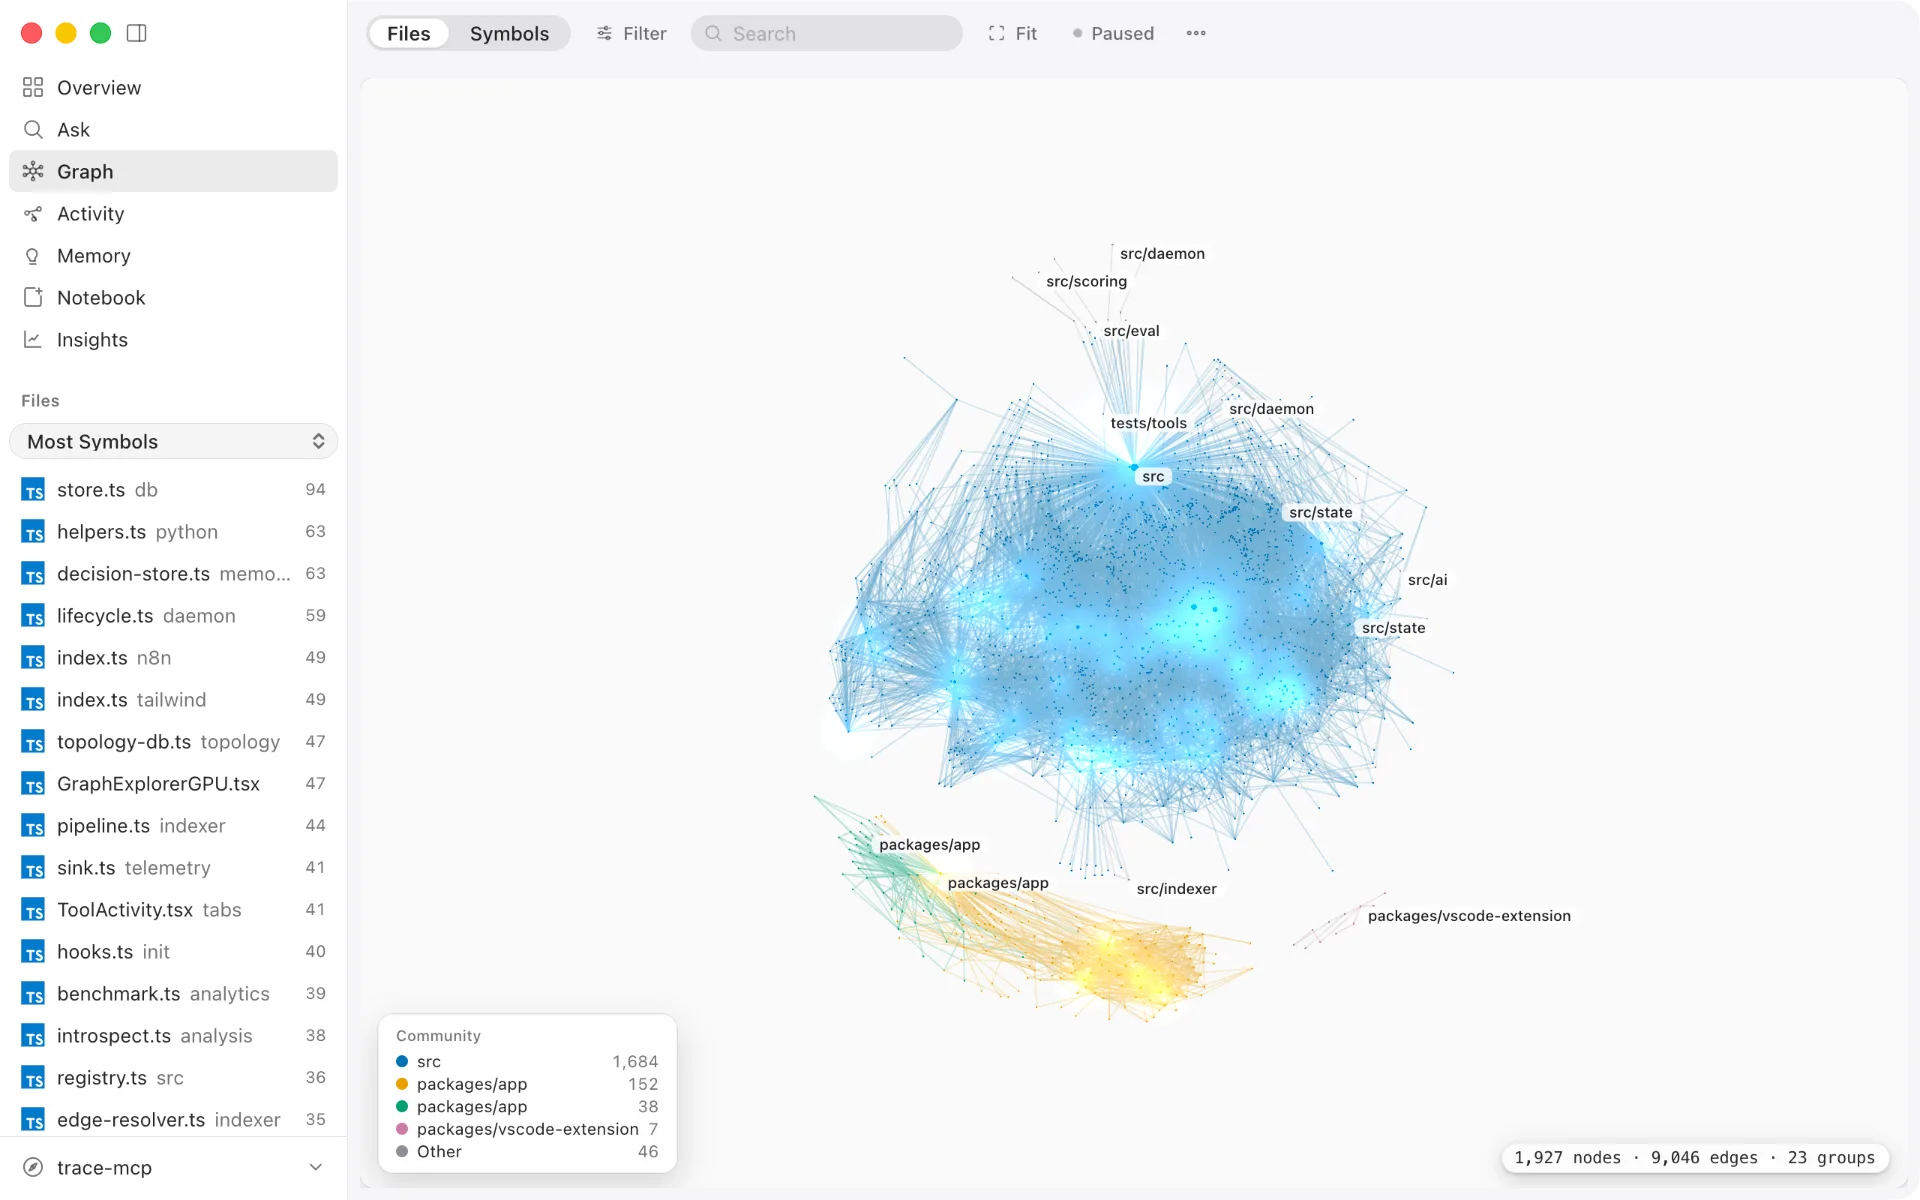
O app desktop: um explorador de grafos com GPU sobre o mesmo índice que o servidor MCP serve.
O problema
Agentes de IA pagam repetidamente por trabalho que já fizeram. A cada turno, o agente relê os mesmos arquivos, percorre novamente as mesmas dependências e reinfla a janela de contexto com estrutura que descobriu cinco passos atrás. Esse trabalho repetido é a maior parte do custo de uma sessão longa em tokens e latência.
trace-mcp constrói um grafo do seu código-fonte ciente de frameworks uma vez e o serve via MCP, para que o agente raciocine a partir de uma estrutura pré-computada em vez de ler o repositório por força bruta. Pergunte "o que quebra se eu mudar este modelo?" — em vez de 80 chamadas Grep e 190 leituras de arquivo, o agente chama get_change_impact uma vez e obtém o raio de impacto em PHP, Vue, migrações e DI. 88 integrações de frameworks em 81 linguagens, 182 ferramentas.
A restrição determinante é a recomputação, não a capacidade do modelo: contas de tokens, latência e alucinações crescem com o tamanho do projeto, em vez de crescerem com a complexidade da tarefa. trace-mcp fecha o vazamento de recomputação. O grafo é construído uma vez, mantido incrementalmente atualizado e servido a todo agente que perguntar — para que o mesmo trabalho não seja pago repetidamente.
- Menor custo — menos tokens por resposta bem-sucedida, na média e no pico
- Menor latência — menos chamadas de ferramentas sequenciais, menos idas e voltas ao modelo
- Maior precisão — menos ruído no contexto significa menos alucinações e primeira resposta mais correta
- Estabilidade de produção — o crescimento do contexto acompanha a complexidade da tarefa, não o tamanho do repositório
Começamos com inteligência de código, onde a repetição é mais cara, e o mesmo motor agora indexa cofres de conhecimento em markdown (Obsidian, Logseq, MD puro) como domínio equivalente. Wikilinks, tags, frontmatter e embeds viram arestas do grafo e metadados de símbolo; search, find_usages, get_change_impact e apply_rename funcionam de forma idêntica sobre ambos.
O que trace-mcp faz por você
| Você pergunta | trace-mcp responde | Como |
|---|---|---|
| "O que quebra se eu mudar este modelo?" | Raio de impacto entre linguagens + pontuação de risco + decisões arquiteturais vinculadas | get_change_impact — grafo de dependências reversas + memória de decisões |
| "Por que a autenticação foi implementada assim?" | O registro real da decisão com raciocínio e tradeoffs | query_decisions — busca no grafo de conhecimento de decisões vinculado ao código |
| "Estou começando uma nova tarefa" | Subgrafo de código ótimo + decisões passadas relevantes + avisos de becos sem saída | plan_turn — roteador de abertura com enriquecimento de decisões |
| "O que discutimos sobre GraphQL no mês passado?" | Fragmentos verbatim de conversas com referências a arquivos | search_sessions — busca FTS5 em todo o conteúdo de sessões passadas |
| "Mostre o fluxo de requisição da URL até a página renderizada" | Rota → Middleware → Controller → Service → View com mapeamento de props | get_request_flow — travessia de arestas ciente de frameworks |
| "Encontre todo código sem teste neste módulo" | Símbolos classificados como "não alcançados" ou "importados mas nunca chamados em testes" | get_untested_symbols — mapeamento teste-para-fonte |
| "Qual o impacto desta mudança de API em outros serviços?" | Chamadas de clientes entre subprojetos com pontuações de confiança | get_subproject_impact — travessia do grafo de topologia |
| "Quais notas vinculam a este conceito?" | Backlinks no cofre, com contexto de seção e alias | find_usages em um símbolo note:<basename> |
| "O que quebra se eu renomear esta nota?" | Todo [[wikilink]] e [text](path.md) que a referenciam | get_change_impact — grafo reverso ciente de wikilinks |
Quatro capacidades raras entre ferramentas adjacentes:
-
Arestas cientes de frameworks — trace-mcp entende que
Inertia::render('Users/Show')conecta PHP a Vue, que@Injectable()cria uma dependência de DI, que$user->posts()significa uma tabelapostsvinda de migrações. 88 integrações de frameworks. -
Memória de decisões vinculada ao código — quando você registra "escolhi PostgreSQL por suporte a JSONB", isso é vinculado a
src/db/connection.ts::Pool#class. Quando alguém executaget_change_impactnaquele símbolo, vê a decisão. MemPalace armazena decisões como texto; trace-mcp as amarra ao grafo de dependências. -
Inteligência entre sessões — sessões passadas são mineradas em busca de decisões e indexadas para busca. Quando você inicia uma nova sessão,
get_wake_updá orientação em ~300 tokens;plan_turnmostra decisões passadas relevantes para sua tarefa;get_wake_up { scope: "resume" }carrega contexto estrutural de sessões anteriores. -
Código e conhecimento em um único grafo — aponte trace-mcp para um cofre markdown (Obsidian, Logseq, MD puro) e o mesmo motor o indexa: cada nota vira um símbolo
note:<basename>, cabeçalhos viram seções aninhadas,[[wikilinks]]e![[embeds]]viram arestas do grafo, frontmatter e#tagsviajam nos metadados. PageRank, ranqueamento por Signal Fusion, embeddings e refatoração de renomeação se aplicam sem mudanças. O agente não aprende uma segunda ferramenta: é o mesmo grafo, contendo tanto o código quanto as notas.
Por que agentes ficam relendo
Agentes de IA de codificação recomputam o mesmo trabalho a cada turno — e são cegos a frameworks enquanto fazem isso.
Eles releem UserController.php e depois releem de novo no turno seguinte. Não sabem que Inertia::render('Users/Show', $data) conecta um controller Laravel a resources/js/Pages/Users/Show.vue. Não sabem que $user->posts() significa que a tabela posts foi definida três migrações atrás. Não conseguem rastrear uma requisição da URL até o pixel renderizado — então rastreiam de novo, e de novo, a cada sessão.
O resultado: 5–15× leituras repetidas de arquivos quentes em uma única tarefa, janelas de contexto usadas como bancos de dados improvisados e agentes que ficam mais caros quanto maior o projeto — em vez de mais capazes.
A solução
trace-mcp constrói um grafo de dependências entre linguagens a partir do seu código-fonte e o expõe via Model Context Protocol — o formato de plugin que Claude Code, Cursor, Windsurf e outros agentes de IA de codificação falam. Qualquer agente compatível com MCP ganha entendimento em nível de framework de imediato.
| Sem trace-mcp | Com trace-mcp |
|---|---|
| Agente lê 15 arquivos para entender um recurso | get_task_context — subgrafo de código ótimo em uma única chamada |
| Agente não sabe qual página Vue um controller renderiza | Arestas routes_to → renders_component → uses_prop |
| "O que quebra se eu mudar este modelo?" — agente adivinha | get_change_impact percorre dependências reversas entre linguagens |
| Schema? Agente precisa de um banco rodando | Migrações analisadas — schema reconstruído a partir do código |
| Incompatibilidade de props entre PHP e Vue? Descoberta em produção | Detectada no momento da indexação — dados PHP vs. defineProps |
App desktop
trace-mcp acompanha um app desktop Electron opcional (packages/app) que oferece uma superfície visual sobre o mesmo índice que o servidor MCP usa. Ele gerencia múltiplos projetos, conecta clientes MCP e fornece um explorador de grafos acelerado por GPU — tudo sem abrir um terminal.
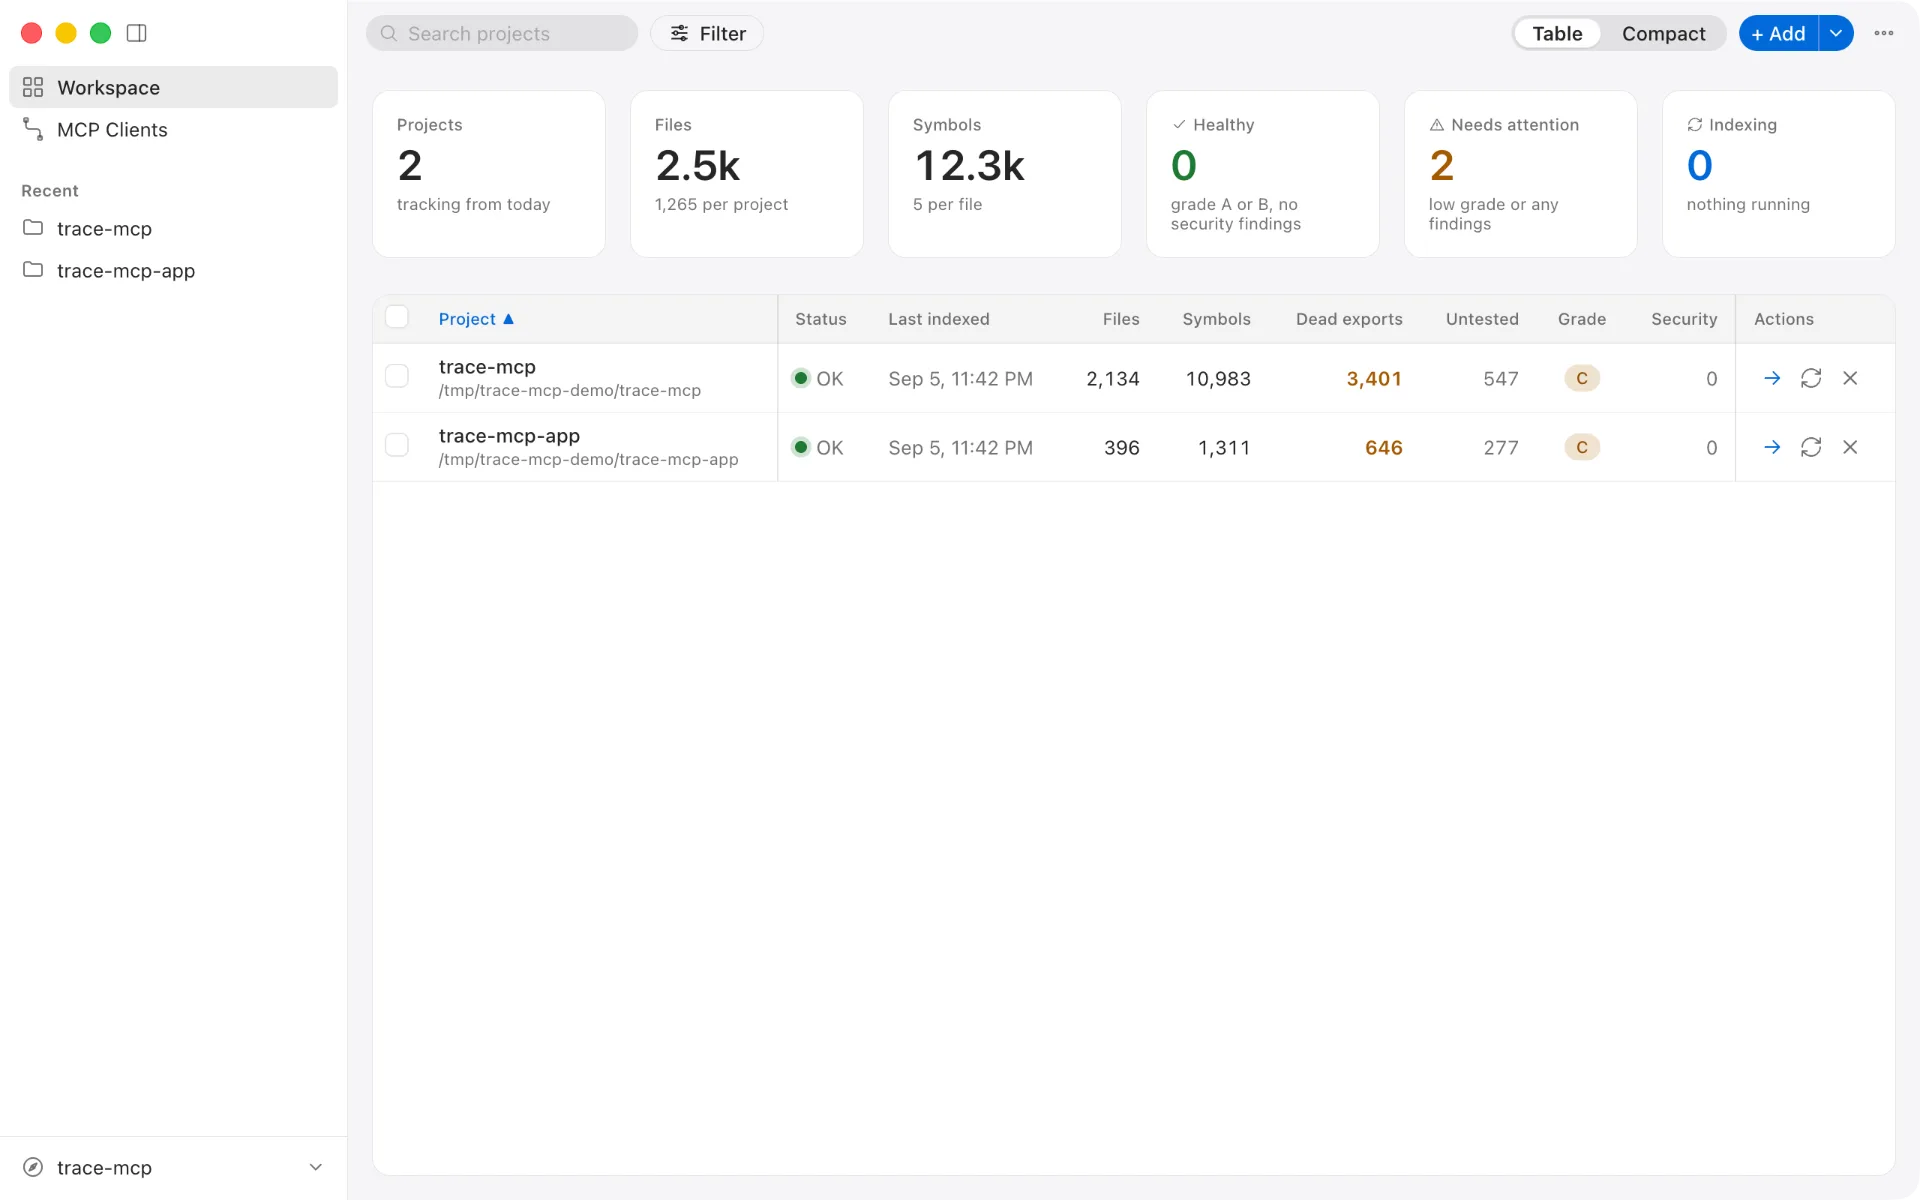
Projetos e clientes. A janela de menu lista projetos indexados com status ao vivo (Ready / indexando / erro) e controles de reindexar / remover. A aba Clientes MCP detecta clientes instalados (Claude Code, Claw Code, Claude Desktop, Cursor, Windsurf, Continue, Junie, JetBrains AI, Codex, AMP, Warp, Factory Droid) e conecta trace-mcp a eles com um clique, incluindo o nível de aplicação (Base / Standard / Max — somente CLAUDE.md, + hooks, + tweakcc e regras de comportamento do agente; recursos do nível Max são específicos do Claude Code). Warp e JetBrains AI exigem colagem manual no IDE porque o armazenamento de configuração deles é somente via GUI.
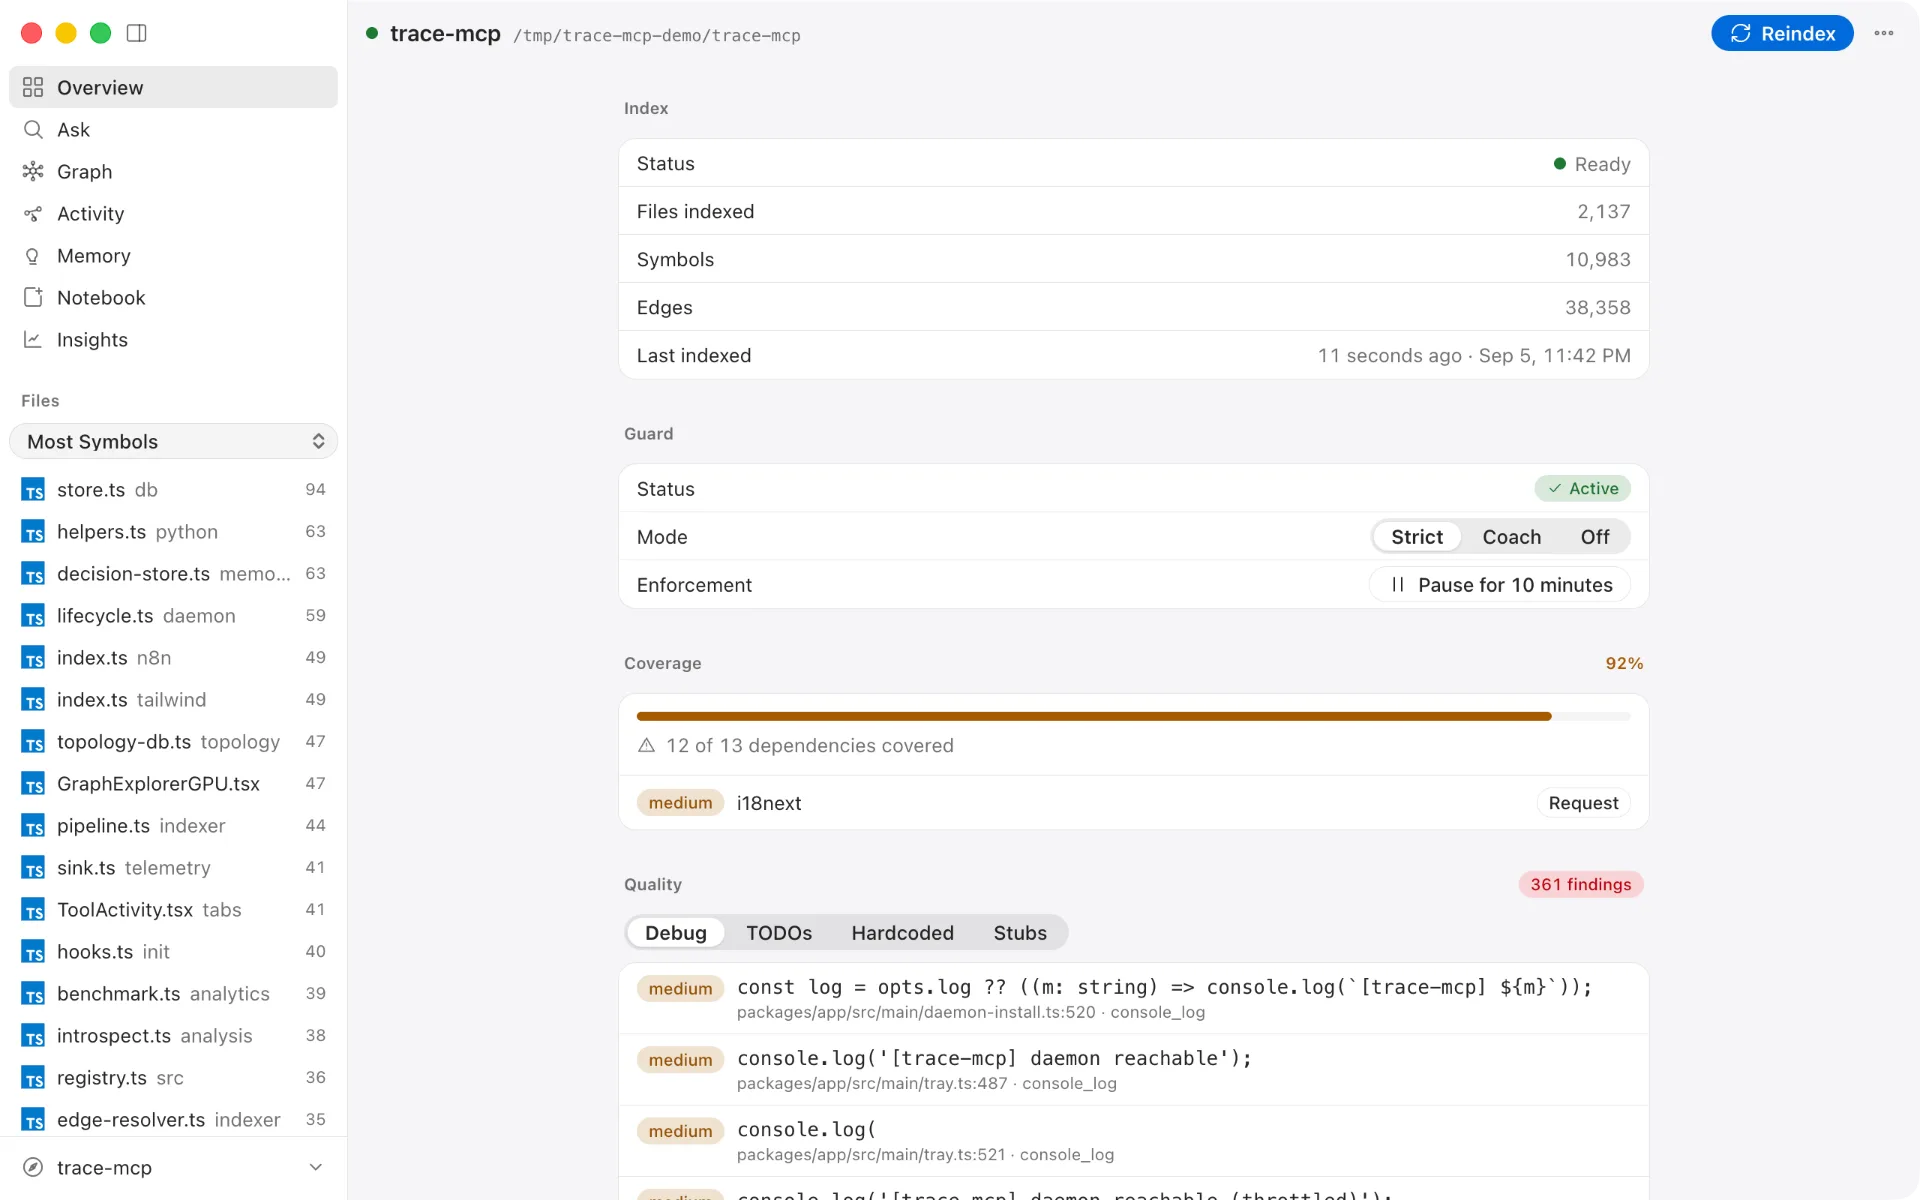
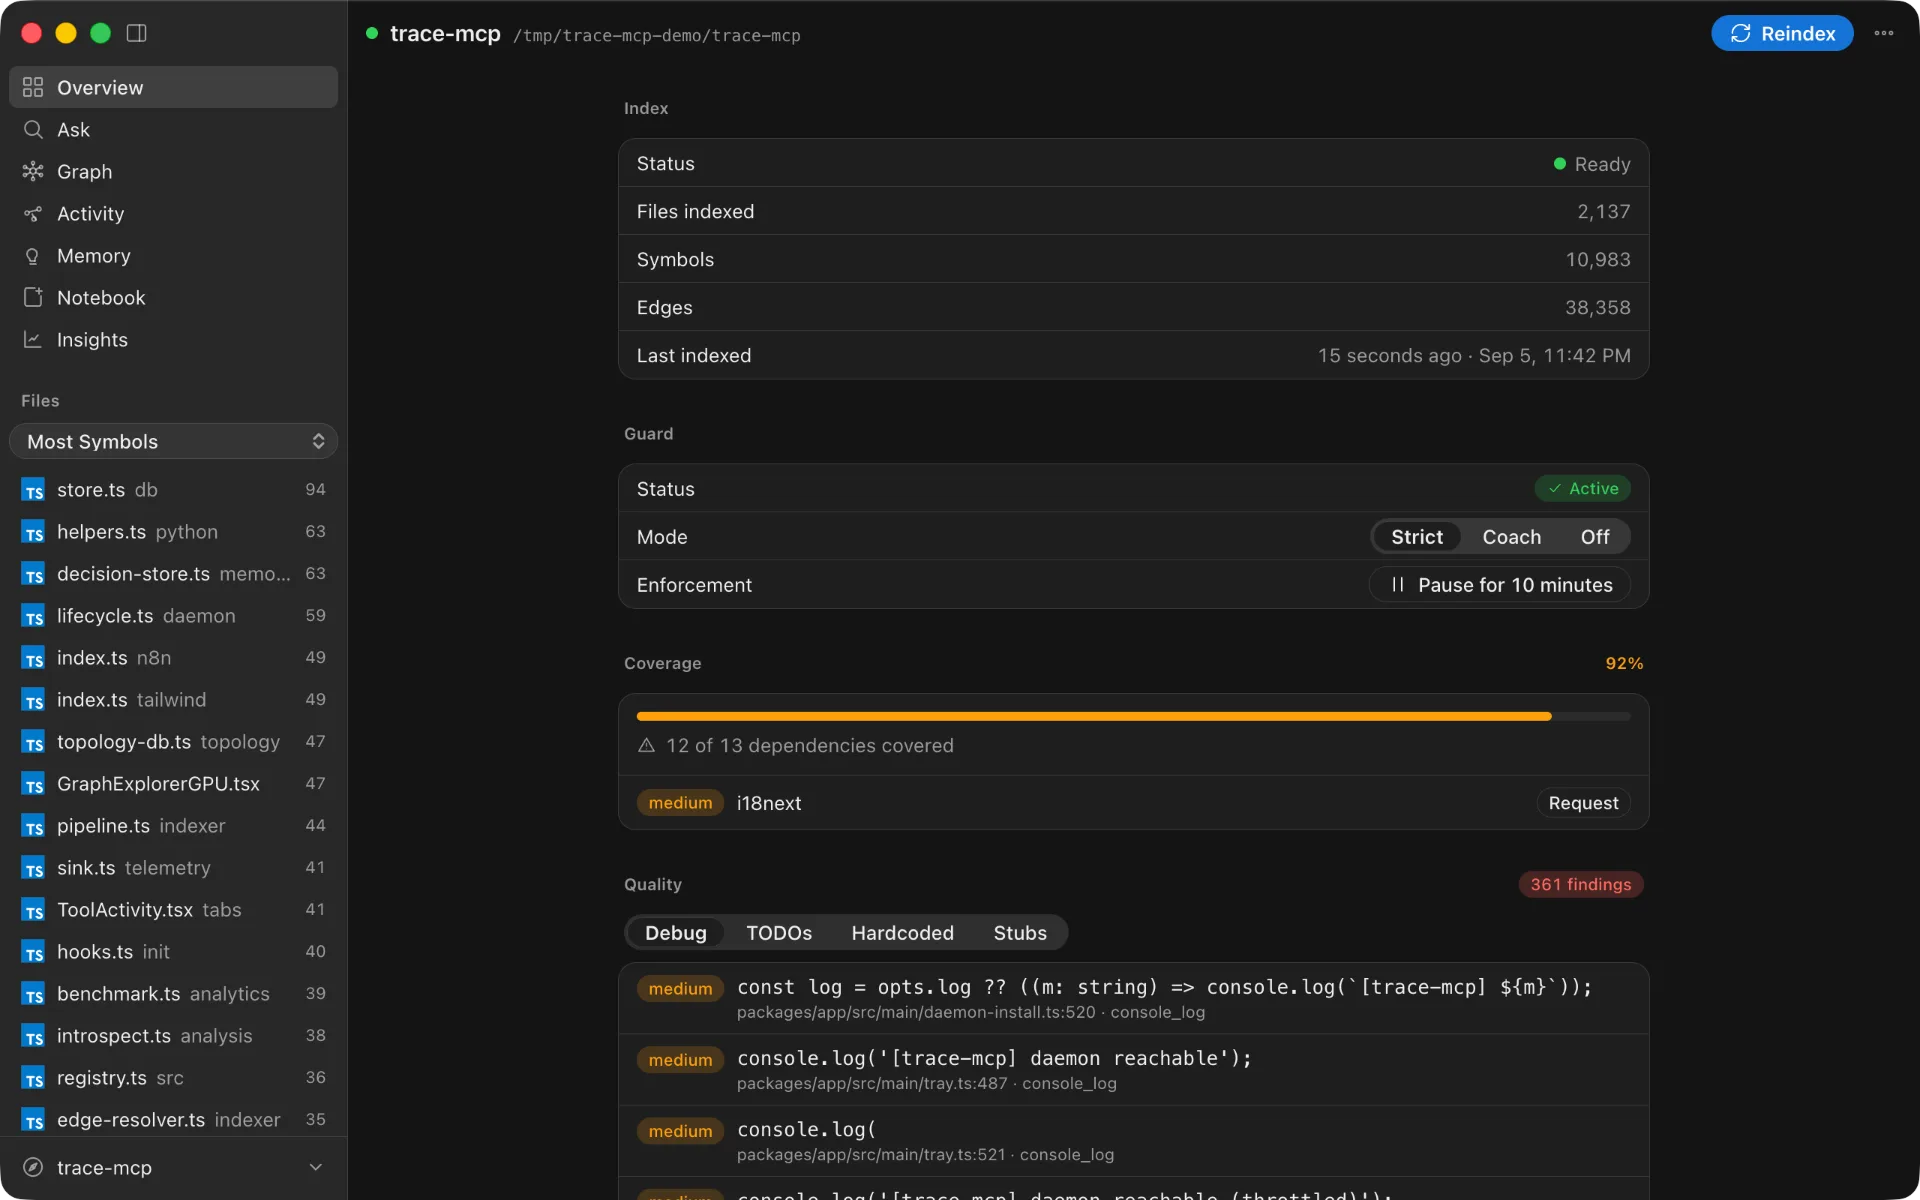
Visão geral por projeto. Cada projeto abre em sua própria janela com abas: Visão geral (arquivos, símbolos, arestas, cobertura, serviços vinculados, reindexar), Perguntar (consulta em linguagem natural sobre o índice) e Grafo. A Visão geral também exibe arquivos Most Symbols, o timestamp da última indexação e o medidor de cobertura de dependências.
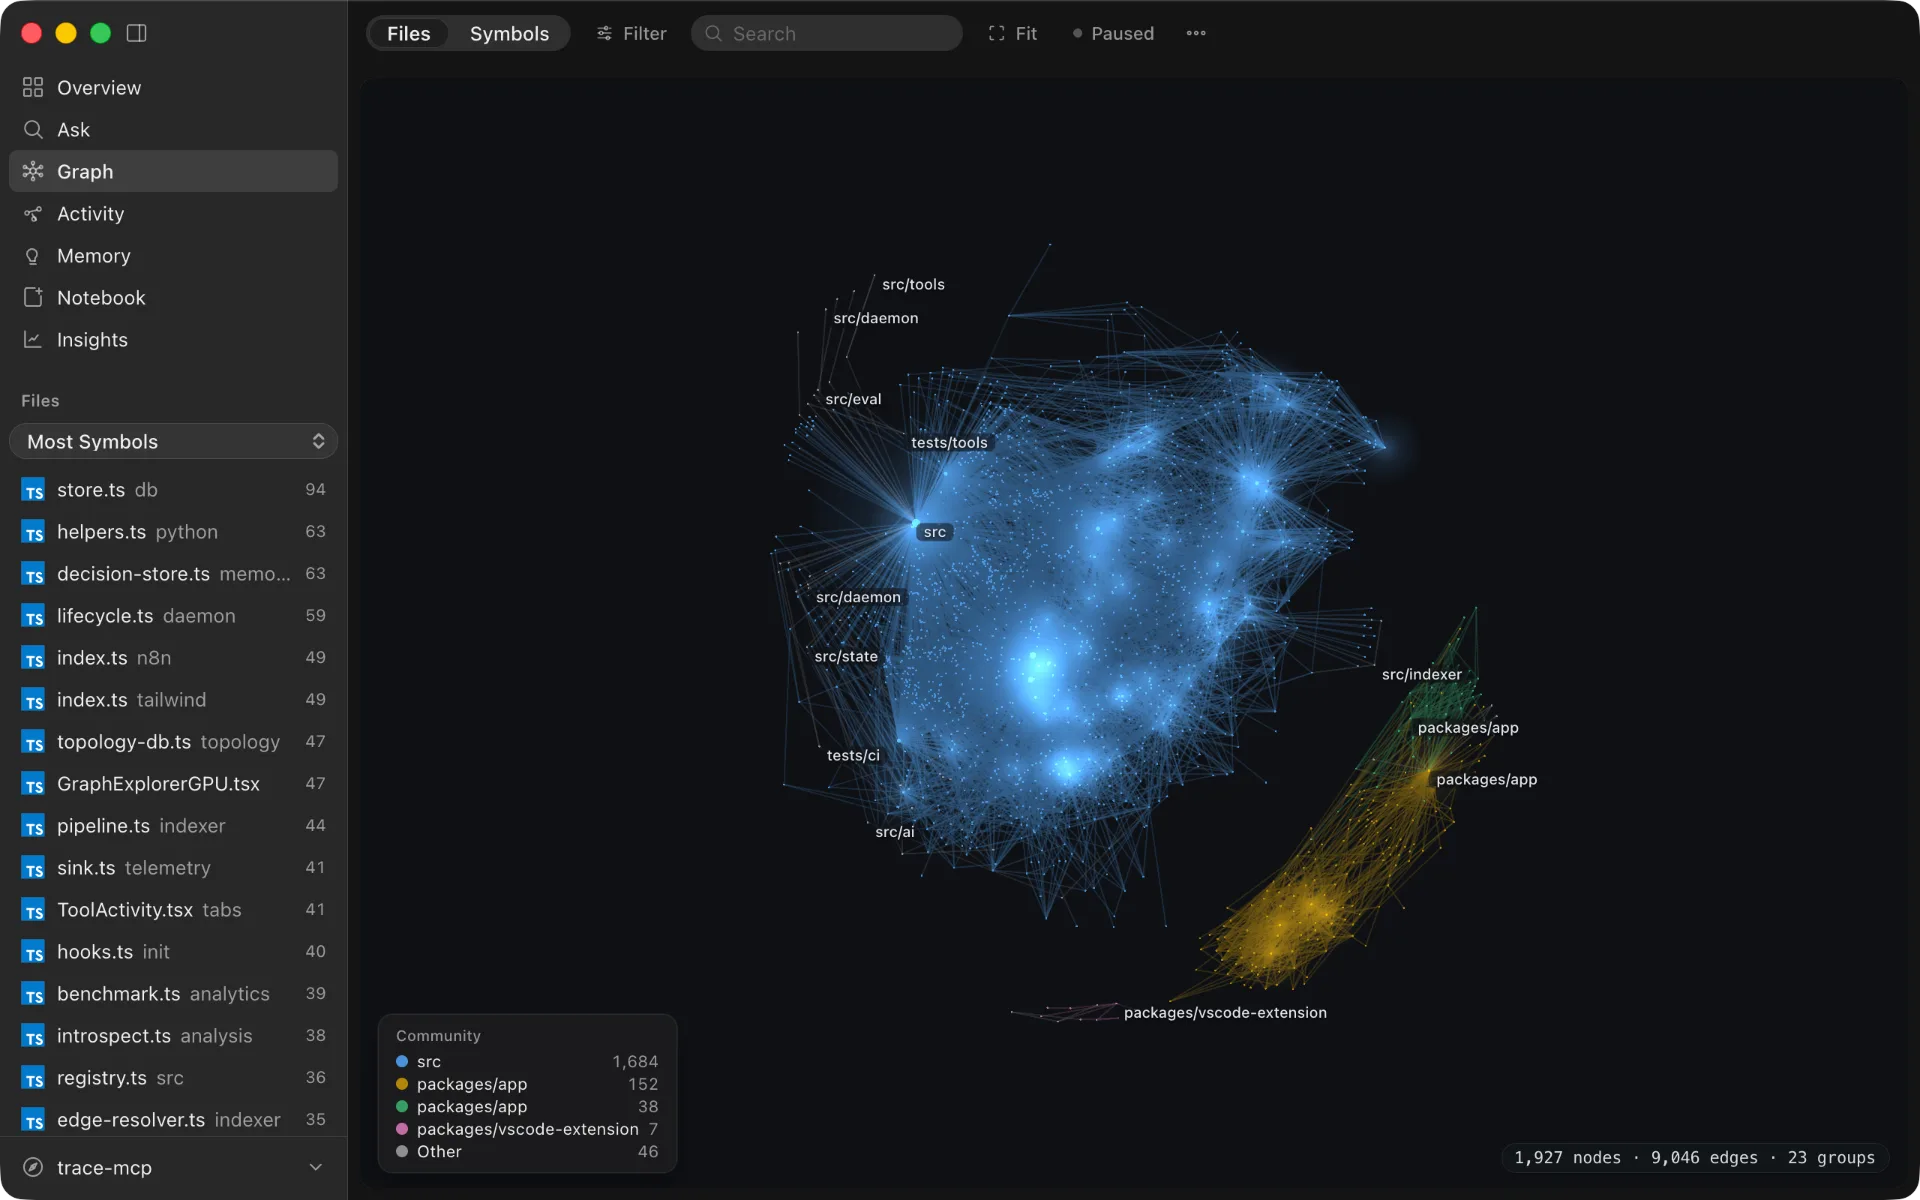
Explorador de grafos com GPU. A aba Grafo renderiza o grafo de dependências completo na GPU via cosmos.gl — dezenas de milhares de nós/arestas em taxas de quadros interativas. Filtre por Arquivos / Símbolos, sobreponha comunidades detectadas, destaque grupos, alterne rótulos/FPS e percorra a profundidade do grafo. Ótimo para sentir o acoplamento, os pontos quentes e como um código-base é realmente moldado antes de mergulhar nas ferramentas.
Instalação no macOS: Baixe o .dmg — abra-o e arraste trace-mcp para Aplicativos. O botão no site escolhe Apple Silicon ou Intel para você; se preferir escolher você mesmo, ambas as builds estão na página de Releases. O app é assinado com Developer ID e notarizado pela Apple, então abre sem aviso — se o macOS algum dia avisar sobre uma build do trace-mcp, esse aviso é real e o download não deve ser confiado.
Instalação no Windows: execute trace-mcp.Setup.<version>.exe a partir de Releases.
Atualizador do aplicativo travado em uma versão antiga? As versões 3.10.0 e anteriores do aplicativo no macOS/Windows não conseguem se atualizar sozinhas — "Verificar atualizações…" mostra Cannot set properties of undefined (setting 'autoDownload') e não faz nada, um bug corrigido na 3.11.0 que as versões afetadas não conseguem corrigir por conta própria. Reinstale manualmente: baixe o .dmg (macOS) ou pegue o trace-mcp.Setup.<version>.exe mais recente em Releases (Windows) — ou, se você tiver a CLI instalada, execute trace-mcp install-app.
O aplicativo fala com o mesmo daemon trace-mcp (http://127.0.0.1:3741) que os clientes MCP usam, então tudo o que você indexar pelo aplicativo fica imediatamente disponível para Claude Code / Cursor / etc. Se você quiser apenas o servidor MCP e a CLI, não precisa do aplicativo — npm install -g trace-mcp é a instalação completa.
Como o trace-mcp se compara
O trace-mcp combina navegação por grafo de código, memória entre sessões e compreensão de código em tempo real em uma única ferramenta. A maioria dos projetos adjacentes resolve apenas um desses problemas — o trace-mcp unifica os três e é o único com arestas entre linguagens cientes de frameworks (88 integrações de frameworks) e memória de decisões vinculada ao código.
- vs. exploração eficiente em tokens (Repomix, jCodeMunch, cymbal) — o trace-mcp adiciona arestas de frameworks, refatoração, segurança e subprojetos além da busca por símbolos.
- vs. ferramentas de memória de sessão (MemPalace, claude-mem, ConPort) — o trace-mcp vincula decisões a símbolos/arquivos específicos, para que apareçam automaticamente na análise de impacto.
- vs. RAG / geração de documentação (DeepContext, smart-coding-mcp) — o trace-mcp responde "mostre-me o caminho de execução, dependências e testes", não "encontre código semelhante a esta consulta".
- vs. servidores MCP de grafo de código (Serena, Roam-Code) — o trace-mcp tem a maior cobertura de linguagens (81 linguagens) e é o único com arestas entre linguagens cientes de frameworks.
Tabelas completas lado a lado com estrelas do GitHub, linguagens e cobertura por capacidade: trace-mcp vs. outros servidores MCP de inteligência de código.
Confronto direto: vs Repomix · vs Serena · vs codegraph · vs codebase-memory-mcp · vs modo de contexto do Claude Code · vs code-review-graph · Repomix vs codegraph.
Redução de tokens — o que medimos
Agentes de IA queimam tokens recalculando o que já descobriram na rodada anterior — relendo arquivos, percorrendo dependências novamente, reinflando o contexto. O trace-mcp substitui isso por contexto de precisão: apenas os símbolos, arestas e assinaturas relevantes para a consulta, servidos a partir de um grafo calculado uma única vez.
Comece pela medição que não é nossa. Todo o resto nesta seção é o trace-mcp medido no próprio repositório do trace-mcp — a primeira linha da tabela contra respostas reais, tudo abaixo dela pelos próprios estimadores sintéticos do trace-mcp. O benchmark de contexto de revisão de PR é a exceção: montar o contexto de revisão para 60 pull requests mesclados em seis repositórios de código aberto — hono, axios, express, requests, flask, got — custou uma mediana de 3.291 tokens de entrada contra 13.595 para carregar o diff mais todos os arquivos que ele toca, 72,7% menos, contados com gpt-tokenizer em vez de estimados. Os SHAs base e head estão fixados em benchmarks/pr-context/dataset.json, npx tsx scripts/bench-pr-context.ts o reexecuta, e os 56 pull requests onde o índice não compensou são publicados junto com as vitórias — 13 que custaram mais do que ler os arquivos diretamente, e 42 onde o orçamento de tokens do pacote não entregou o corpo de todos os símbolos alterados, uma deficiência que o benchmark não conseguia ver até esta execução fazê-lo pontuar a entrega em vez de listar.
O que esperar — por carga de trabalho:
| Carga de trabalho | Redução típica |
|---|---|
| Produção real mista (respostas de ferramentas medidas vs. as leituras de arquivo que substituem) | 67,4% menos tokens |
| Tarefas estruturadas de navegação de código (busca de símbolos, análise de impacto, hierarquia de tipos, grafo de chamadas) | até 99% menos processamento redundante — estimativa sintética |
| Consultas direcionadas de pesquisa/planejamento (tarefas compostas que substituem ~10 operações sequenciais) | até ~40× em chamadas individuais — estimativa sintética |
| Cargas de trabalho não relacionadas a código (texto bruto, dados não estruturados) | Fora do escopo hoje |
Os 67,4% são o número honesto para planejar, e o motivo de ele ter mudado não é que o produto ficou mais rápido. Costumávamos divulgar "~40–50% em média". Esse número descendia de um contador que pontuava cada chamada antes de a ferramenta rodar — RAW_COST_ESTIMATES[tool] × 0.15, uma constante sem variância — que encontramos e corrigimos nós mesmos em #915. As substituições honestas leram 29,3%, depois 21,1%, depois 21,0% conforme a cobertura cresceu para 97,2% das chamadas registradas. Então descobrimos que três ferramentas que carregam 76% do peso eram precificadas a partir de uma amostra cada, e que quatro maneiras defensáveis de escolher essas amostras precificam a mesma build em 21,0%, 30,7%, 56,0% e 67,4%. Então o quadro de amostragem agora é gerado, congelado e commitado antes da execução que o usa, com cada afirmação sobre como foi construído reverificada contra o repositório no CI (pré-registro). 67,4% é o que o quadro registrado mede; leia o salto de 21% como uma mudança de quadro, não uma mudança de produto. Ele pondera contagens reais de o200k_base de respostas reais por 18.329 chamadas registradas de uma única máquina (tabela por ferramenta, gerada em docs/_data/response_tokens.json). Três ressalvas o acompanham: a metade da linha de base — o que um Read/Grep teria custado em vez disso — ainda é uma estimativa escrita à mão; quatro das vinte e três ferramentas medidas retornam mais tokens do que substituem, e o contador antigo registrava uma economia para elas mesmo assim; e mais duas ferramentas (register_edit, reindex) não substituem nenhuma leitura de arquivo, então agora recebem crédito zero e são contadas como sobrecarga — com elas no lado do gasto, o número geral é 66,5%. Os picos abaixo (até 99% em chamadas estruturadas individuais) são uma estimativa sintética, por chamada, não por sessão.
Medido no trace-mcp 3.31.0 (76996eb9) em 21 de setembro de 2026. Seu pré-registro o publica como a primeira passada da meta de 25% que declaramos antes de medir — e diz na mesma frase que a passada veio de registrar um quadro de amostragem, não de lançar um produto mais rápido. A previsão escrita antes dessa execução nomeou um intervalo em que o resultado ficou acima; ela estava errada e permanece na página.
Benchmark Lab — a mesma pergunta, feita pelo aplicativo. A aba Benchmark Lab do aplicativo desktop executa uma bateria fixa de 8 fixtures de recall em três braços e salva cada execução em ~/.trace/benchmark-runs. Medido no trace-mcp 3.33.0 (4e1ac4fd) em 26 de setembro de 2026: o controle de leitura de arquivos gastou 82.412 tokens em 13 chamadas (8/8 respondidas); o braço mínimo respondeu 7 de 8 com 512 tokens (−99,4%); o braço padrão respondeu 8 de 8 com 13.657 tokens (−83,4%). A falha do braço mínimo é uma medição real — search_text bruto não classifica src/indexer/pipeline.ts em seu top 10 — publicada em vez de reexecutada até passar. Método, hash da bateria e reexecução →
Benchmark: o próprio codebase do trace-mcp (694 arquivos, 3.831 símbolos → 929 arquivos, 5.197 símbolos na v1.30):
Task                    Without trace-mcp    With trace-mcp    Reduction
───────────────────────────────────────────────────────────────────────────
Symbol lookup                42,518 tokens       1,162 tokens       97.3%
File exploration             27,486 tokens         855 tokens       96.9%
Search                       22,860 tokens       8,000 tokens       65.0%
Find usages                  11,430 tokens       1,720 tokens       85.0%
Context bundle               12,847 tokens       3,485 tokens       72.9%
Batch overhead               16,831 tokens       8,299 tokens       50.7%
Impact analysis              49,141 tokens       1,856 tokens       96.2%
Call graph                  178,345 tokens       9,285 tokens       94.8%
Type hierarchy               94,762 tokens         855 tokens       99.1%
Tests for                    22,590 tokens       1,150 tokens       94.9%
Composite task              223,721 tokens      14,245 tokens       93.6%
───────────────────────────────────────────────────────────────────────────
Total                       702,532 tokens      50,812 tokens       92.8%
Em 11 categorias de tarefas estruturadas, a recomputação cai em até ~99% por chamada quando o agente reutiliza o grafo em vez de reler arquivos. Leia isso como um resultado de pico em tarefas estruturadas em um codebase TS/Vue bem suportado, não um número que você deve esperar em todo projeto. Em produção, em cargas de trabalho mistas, espere 67,4% — o número medido acima, não este sintético. Menos ruído no contexto também significa menos alucinações e melhor precisão na primeira resposta — um benefício de qualidade que você não vê nas contagens de tokens.
A economia escala com o tamanho do projeto — argumentado, não medido. Sem o trace-mcp, o agente lê mais arquivos errados antes de encontrar o certo, enquanto a travessia do grafo permanece O(arestas relevantes) em vez de O(total de arquivos). Não temos medição por tamanho de projeto para sustentar isso, então este README não cita mais uma; o número de tokens por sessão que costumava ficar aqui veio do mesmo estimador pré-#915 que o "40–50%".
Tarefas compostas entregam as maiores vitórias. Uma única chamada de get_task_context substitui uma cadeia de ~10 operações sequenciais (busca → get_symbol × 5 → Read × 3 → Grep × 2). Isso é uma ida e volta em vez de dez, que é de onde vem a maior parte da economia de latência.
Execute você mesmo
npx trace-mcp benchmark .
Economia de tokens por categoria contra seu repositório real em ~5 minutos — sem instalação, sem cadastro, tudo local. Ele lê um índice existente, então execute trace-mcp index . primeiro se o projeto ainda não estiver registrado. Os números acima são do próprio codebase TypeScript/Vue do trace-mcp (929 arquivos, 5.197 símbolos) sob benchmarks estruturados; a redução em produção em cargas de trabalho mistas é menor (67,4% medidos, veja acima), mas os padrões por tarefa valem para qualquer stack bem suportado.
Esta é uma estimativa sintética, não economia medida: o lado "sem trace-mcp" é calculado a partir dos tamanhos de arquivo no índice, e o lado "com trace-mcp" a partir de multiplicadores por cenário — não de chamadas reais de ferramentas. Mostra o teto teórico. Para medir a economia real do seu próprio uso, execute o trace-mcp por um tempo e então:
trace-mcp analytics savings   # real sessions: reads vs. what trace-mcp would have cost
trace-mcp analytics optimize  # recommendations based on your actual usage
Veja Analytics de sessão e rastreamento de economia de tokens para detalhes.
Metodologia
Estimado usando benchmark_project — ele percorre onze categorias de tarefas (busca de símbolos, exploração de arquivos, busca de texto, encontrar usos, pacote de contexto, sobrecarga de lote, análise de impacto, travessia de grafo de chamadas, hierarquia de tipos, testes-para, contexto de tarefa composta) sobre o projeto indexado. Nenhuma ferramenta do trace-mcp é invocada. Cada número em ambos os lados é uma heurística sintética específica de cenário, e as heurísticas diferem por cenário. Elas se baseiam em três tipos de entrada, misturados de forma diferente em cada um:
- Valores reais do índice —
byte_lengthde arquivo, tamanhos de fonte e assinatura de símbolos. Eles carregam a linha de base para busca de símbolos, exploração de arquivos, análise de impacto e travessia de grafo de chamadas. - Formatos de resultado assumidos para operações sem equivalente indexado — ex.: as linhas de base de busca de texto e encontrar usos assumem um rendimento fixo de grep (correspondências × linhas de contexto × 80 caracteres),
get_tests_foré assumido para responder em ~400 caracteres, e o cenário de sobrecarga de lote adiciona constantes fixas de tokens de enquadramento / dica / metadados de MCP por chamada. - Uma fração fixa da linha de base, entre 0,05 e 0,45, onde nenhum dos acima se aplica.
Contagens de caracteres são convertidas em tokens por um estimador calibrado contra cl100k_base quando gpt-tokenizer está instalado, e por uma proporção fixa de caracteres por token de 4,0 caso contrário. O resultado é um limite superior da redução, não uma medição dela — as mesmas ressalvas são impressas na saída da ferramenta e documentadas no topo de src/analytics/benchmark.ts.
Reproduza você mesmo:
# Via CLI (no install)
npx trace-mcp benchmark /path/to/project

# Or via MCP tool
benchmark_project  # runs against the current project
Principais capacidades
- Rastreamento de fluxo de requisições — URL → Rota → Middleware → Controller → Service, em frameworks de backend
- Árvores de componentes — hierarquia de renderização com props / emits / slots (Vue, React, Blade)
- Schema a partir de migrações — sem necessidade de conexão com banco de dados
- Cadeias de eventos — Event → Listener → Job fan-out (Laravel, Django, NestJS, Celery, Socket.io)
- Análise de impacto de mudanças — travessia reversa de dependências entre linguagens, enriquecida com decisões arquiteturais vinculadas
- Contexto de tarefa ciente de grafo — descreva uma tarefa de desenvolvimento → obtenha o subgrafo de código ideal (caminhos de execução, testes, tipos) + decisões passadas relevantes, adaptado à intenção de correção de bug/feature/refatoração
- Grafo de chamadas e árvore de DI — grafos de chamadas bidirecionais com confiança de resolução em 4 níveis, enriquecimento opcional com LSP para precisão de nível compilador, injeção de dependência NestJS
- Contexto de modelo ORM — relacionamentos, schema, metadados para 7 ORMs
- Detecção de código morto e lacunas de teste — encontre exports/símbolos não testados (com classificação "não alcançado" vs "importado_mas_não_chamado"), código morto, alcance de teste por símbolo na análise de impacto
- Varredura de segurança — varredura de padrões OWASP Top-10 e análise de taint (fluxo de dados origem→destino). Contexto de segurança do servidor MCP exportável para skill-scan
- Busca semântica, offline por padrão — embeddings ONNX incluídos funcionam imediatamente, sem chaves de API; alterne para Ollama/OpenAI para sumarização com LLM
- Memória de decisões — extraia decisões de sessões, vincule-as a símbolos/arquivos, exiba automaticamente na análise de impacto
- Subprojetos multi-serviço — vincule grafos entre serviços via contratos de API; impacto entre serviços + decisões com escopo de serviço
- Relatórios de impacto de mudanças em CI/PR — raio de explosão automatizado, pontuação de risco, detecção de lacunas de teste, violações de arquitetura em cada PR
Stack suportada
Linguagens: PHP, TypeScript, JavaScript, Python, Go, Java, Kotlin, Ruby, Rust, C, C++, C#, Swift, Objective-C, Objective-C++, Dart, Scala, Groovy, Elixir, Erlang, Haskell, Gleam, Bash, Lua, Perl, GDScript, R, Julia, Nix, SQL, PL/SQL, HCL/Terraform, Protocol Buffers, GraphQL, Prisma, Vue SFC, HTML, CSS/SCSS/SASS/LESS, XML/XUL/XSD, YAML, JSON, TOML, Assembly, Fortran, AutoHotkey, Verse, AL, Blade, EJS, Zig, OCaml, Clojure, F#, Elm, CUDA, COBOL, Verilog/SystemVerilog, GLSL, Meson, Vim Script, Common Lisp, Emacs Lisp, Dockerfile, Makefile, CMake, INI, Svelte, Astro, Markdown, MATLAB, Lean 4, FORM, Magma, Wolfram/Mathematica, Ada, Apex, D, Nim, Pascal, PowerShell, Solidity, Tcl
Frameworks: Laravel (+ Livewire, Nova, Filament, Pennant), Django (+ DRF), FastAPI, Flask, Express, NestJS, Fastify, Hono, Next.js, Nuxt, Rails, Spring, tRPC
ORMs: Eloquent, Prisma, TypeORM, Drizzle, Sequelize, Mongoose, SQLAlchemy
Frontend: Vue, React, React Native, Blade, Inertia, shadcn/ui, Nuxt UI, MUI, Ant Design, Headless UI
Outros: GraphQL, Socket.io, Celery, Zustand, Pydantic, Zod, n8n, React Query/SWR, Playwright/Cypress/Jest/Vitest/Mocha
Cofres de conhecimento: Obsidian, Logseq, markdown simples — [[wikilinks]], ![[embeds]], [text](path.md), frontmatter (YAML), #tags, cabeçalhos ATX. Cada nota se torna um símbolo note:<basename> com seções aninhadas dentro; wikilinks resolvem para arestas references / embeds entre notas. Misture cofre e código em um projeto — aponte root para um diretório que contenha ambos e execute um único find_usages neles.
Detalhes completos: Frameworks suportados · Todas as ferramentas
Início rápido
Veja seu desperdício primeiro — 5 minutos, sem configuração, sem cadastro:
npx trace-mcp benchmark .
Indexa o projeto, executa 11 benchmarks de tarefas estruturadas (busca de símbolos, análise de impacto, grafo de chamadas, hierarquia de tipos, …) e imprime o custo estimado de tokens por tarefa — sem trace vs. com. Você verá exatamente onde seu agente recalcula trabalho que poderia reutilizar. É uma estimativa sintética calculada a partir do seu índice, não um registro de chamadas de ferramentas reais (veja o bloco Metodologia em "Redução de tokens" acima); para economias medidas de suas próprias sessões, use trace-mcp analytics savings.
Em seguida, conecte-o ao seu agente de IA:
npm install -g trace-mcp
trace init        # one-time global setup (MCP clients, hooks, CLAUDE.md)
trace add         # register current project for indexing
init— configura seu cliente MCP (Claude Code, Cursor, Windsurf, Claude Desktop, …), instala o hook de proteção, adiciona regras de roteamento ao~/.claude/CLAUDE.md.add— detecta frameworks, cria o índice por projeto, registra o projeto. Execute novamente em cada projeto que você quiser que o trace entenda.
(O pacote npm ainda se chama trace-mcp — apenas o comando que ele instala é abreviado. trace-mcp init, trace-mcp add e qualquer outra invocação de trace-mcp … continuam funcionando.)
Todo o estado vive em ~/.trace/ (com fallback automático de ~/.trace-mcp/) — seu diretório de projeto permanece limpo, a menos que você opte por .traceignore ou .trace/.config.json.
Usando Claude Code ou Codex CLI? Após npm install -g trace-mcp, pule a etapa de configuração do cliente de trace init e instale o plugin diretamente — sem necessidade de git clone de qualquer forma:
# Claude Code
claude plugin install @nikolai-vysotskyi/trace-mcp

# Codex CLI
codex plugin marketplace add nikolai-vysotskyi/trace-mcp
codex plugin install trace-mcp@nikolai-vysotskyi-trace-mcp
Ambos registram o servidor MCP trace-mcp mais o hook de proteção Bash em uma única etapa. Detalhes: .claude-plugin/README.md · .codex-plugin/README.md.
Em seguida, no seu cliente MCP:
> get_project_map to see what frameworks are detected
> get_task_context("fix the login bug") to get full execution context for a task
> get_change_impact on app/Models/User.php to see what depends on it
Indexando um cofre de markdown (Obsidian / Logseq / MD simples). Aponte trace add para a raiz do cofre — .md/.mdx/.markdown são detectados por padrão. Cada nota se torna um símbolo note:<basename>, cabeçalhos se aninham como seções, [[wikilinks]] e ![[embeds]] resolvem para arestas do grafo, aliases: do frontmatter tornam nomes alternativos resolvíveis, e #tags agregam para que cada nota com #sgr esteja a um find_usages de distância.
> find_usages on note:my-concept     // backlinks across the vault
> find_usages on tag:sgr             // every note tagged #sgr
> get_change_impact on note:legacy   // what breaks if I rename or delete it
> search "schema-guided reasoning"   // PageRank + embeddings over the vault
Prefere uma GUI? O aplicativo desktop cuida da instalação, indexação, configuração do cliente MCP e reindexação sem tocar em um terminal.
Indo além: adicionando mais projetos / atualizando / configuração manual · configuração stdio vs HTTP (por repositório ou equipe) · busca semântica (ONNX local) · indexação e observador de arquivos · .traceignore.
Migração de trace-mcp para trace
O projeto ainda é trace-mcp. O comando agora é trace. A renomeação vive exatamente nesse limite e em nenhum outro lugar — o pacote npm, este repositório, o domínio e a entrada do registro mantêm o nome trace-mcp. A razão é ergonômica, no mesmo formato de rg para ripgrep ou kubectl para kubernetes — não economia de tokens: a economia medida do prefixo de ferramenta MCP mais curto é real, mas pequena, 66–366 tokens por turno dependendo do tokenizador e predefinição, 0,74–1,23% de uma lista de ferramentas que já custa 8k–45k tokens.
O nome do pacote npm não muda. Ainda é trace-mcp, e sempre será — trace no npm é um pacote não relacionado de outro autor. Instale com npm install -g trace-mcp ou npx -y trace-mcp@latest.
O que muda e o que permanece:
- Nome do comando —
trace <cmd>é a nova grafia.trace-mcp <cmd>permanece como alias permanentemente — no macOS,/usr/bin/traceé o própriotrace(1)da Apple, então continue usandotrace-mcpem scripts, CI ou qualquer PATH que você não controla. - Entradas do cliente MCP —
trace initetrace upgraderenomeiam uma entradamcpServers["trace-mcp"]existente paramcpServers["trace"]e a apontam para o novo comando. Nada é excluído; uma entrada deixada comotrace-mcpcontinua funcionando, apenas custa mais tokens. - Diretório de estado —
~/.trace/, com fallback para~/.trace-mcp/quando o antigo existe e o novo não. Índices não são reconstruídos. - Configuração do projeto —
.trace.jsoné lido primeiro,.trace-mcp.jsondepois. Arquivos existentes continuam funcionando onde estão. - Identificadores de plugin e registro — inalterados:
@nikolai-vysotskyi/trace-mcppara o plugin Claude Code,io.github.nikolai-vysotskyi/trace-mcpno registro MCP.
Uma coisa que init não pode fazer por você. O prefixo da ferramenta MCP também muda — mcp__trace-mcp__search se torna mcp__trace__search. init migra a entrada mcpServers que possui, mas não o texto que você escreveu: listas de permissão do Claude Code, correspondências de hooks ou suas próprias menções a mcp__trace-mcp__* em prosa CLAUDE.md/AGENTS.md. Se um hook parar de corresponder ou uma ferramenta na lista de permissão começar a solicitar novamente após a atualização, faça grep na sua própria configuração por mcp__trace-mcp__ e substitua por mcp__trace__. Todo o resto acima acontece automaticamente na próxima vez que você executar trace init ou trace upgrade — detalhes: Configuração.
Local-first por design
trace-mcp executa inteiramente na sua máquina. Nada sobre seu código-fonte é enviado e não há conta para criar.
- A indexação acontece localmente. O servidor MCP é um processo Node que você mesmo executa — stdio ou
http://127.0.0.1:3741. - O índice vive em
~/.trace/(com fallback para~/.trace-mcp/se for o que você já tem), nunca dentro do seu projeto e nunca enviado. Seu diretório de repositório permanece limpo, a menos que você opte por.traceignoreou.trace/.config.json. - A busca semântica é offline por padrão — embeddings ONNX incluídos, sem chaves de API, sem chamadas externas. Alterne para Ollama (local) ou OpenAI (opt-in) via configuração.
- Sem telemetria sobre seu código, consultas ou uso. A única coisa que sai da sua máquina é descrita abaixo e na página de privacidade — nada mais é enviado.
- O que seu cliente de IA vê é governado pelo seu cliente de IA. trace-mcp retorna resultados de grafo via MCP; como Claude Code / Cursor / Codex / Windsurf os encaminham para um modelo depende do modelo de privacidade desse cliente.
- O daemon confia em loopback e nada mais.
serve-httpnão é autenticado por design: um chamador em127.0.0.1já é você. Um--hostnão-loopback é, portanto, recusado, a menos que você passe--allow-remotee proteja a porta com sua própria autenticação — veja Configuração. - Para apagar tudo, exclua
~/.trace/(ou~/.trace-mcp/em uma instalação que ainda não migrou) — esse diretório é toda a pegada.
Telemetria de uso
trace-mcp envia no máximo um ping anônimo por dia, por instalação, para que possamos contar instalações ativas: versão, SO, cliente MCP e contagens agregadas. Sem código, sem caminhos, sem endereço IP e sem identificador por instalação além de um UUID gerado localmente na sua máquina. É suprimido em CI, e suas credenciais GA4 são enviadas como texto simples no pacote publicado para que você possa verificar para onde o ping vai.
Desative com TRACE_MCP_TELEMETRY=off, ou com "telemetry": { "usage_ping": false } em ~/.trace/.config.json.
A lista completa de campos, ambas as opções de exclusão e como excluir o estado local estão na página de privacidade. Fonte: src/telemetry/usage-ping.ts.
Para ambientes sensíveis à segurança, revise SECURITY.md antes do uso.
Obtendo o máximo de trace-mcp
trace-mcp funciona em três níveis para fazer agentes de IA usarem suas ferramentas em vez de leitura bruta de arquivos:
Nível 1: Automático (funciona imediatamente)
O servidor MCP fornece instruções e descrições de ferramentas com dicas de roteamento que dizem aos agentes de IA quando preferir trace-mcp em vez de Read/Grep/Glob nativos. Isso funciona com qualquer cliente compatível com MCP — sem necessidade de configuração.
Nível 2: CLAUDE.md (recomendado)
trace-mcp init adiciona um bloco de Política de Navegação de Código ao ~/.claude/CLAUDE.md (ou ao CLAUDE.md do seu projeto) que informa ao agente qual ferramenta trace-mcp preferir em vez de Read/Grep/Glob para cada tipo de tarefa. Se você pulou o init, veja Roteamento de prompt do sistema para o bloco completo e como ajustar a aplicação.
Nível 3: Aplicação de hook (somente Claude Code)
Para aplicação rígida, trace-mcp init instala um hook de guarda PreToolUse que bloqueia Read/Grep/Glob em arquivos de código e redireciona o agente para as ferramentas trace-mcp (arquivos não-código, Read-before-Edit e comandos Bash seguros passam). Gerencie manualmente com trace-mcp setup-hooks --global / --uninstall. Detalhes: Roteamento de prompt do sistema.
Nível 4: Camada máxima — reescritas do prompt do sistema + regras de comportamento do agente
Escolher Max durante trace-mcp init (o padrão) adiciona mais dois amplificadores:
- Reescritas do prompt do sistema tweakcc corrigem as descrições das ferramentas principais do Claude Code para que o modelo internalize "use a busca trace-mcp" em vez de "use Grep" desde o início. Somente Claude Code.
agent_behavior: "strict"fornece um conjunto compacto de regras de disciplina via instruções MCP — sem bajulação, discorde de premissas erradas, nunca invente, execução orientada a objetivos, higiene de sessão com 2 avisos, sem refatorações por impulso. Multi-cliente (Claude Code, Cursor, Codex, Windsurf) e atualiza automaticamente emnpm upgrade trace-mcpsem reexecutarinit.
Esta é a configuração para aplicar as mesmas regras de disciplina ao agente de cada colega de equipe sem pedir que ninguém configure. Ajuste ou desative via tools.agent_behavior em ~/.trace/.config.json — veja Exposição de ferramentas e comportamento do agente.
Memória de decisões
Decisões, tradeoffs e descobertas de conversas com agentes de IA geralmente desaparecem quando a sessão termina. O trace-mcp as captura e vincula cada decisão ao código ao qual ela se refere — para que, quando alguém executar get_change_impact em src/db/connection.ts::Pool#class mais tarde, a decisão "escolhemos PostgreSQL por causa do JSONB" apareça automaticamente.
- Minerar —
mine_sessionsexamina os logs JSONL do Claude Code / Claw Code e extrai decisões por correspondência de padrões (0 chamadas de LLM). Tipos: arquitetura, escolha de tecnologia, causa raiz de bug, tradeoff, convenção. - Vincular — cada decisão é anexada a um símbolo ou arquivo; suporta decisões com escopo de serviço para subprojetos.
- Superfície — as decisões enriquecem automaticamente
get_change_impact,plan_turneget_wake_up. A validade temporal (valid_from/valid_until) torna possíveis consultas como "o que era verdade em 15/01/2025?". - Buscar —
query_decisions(FTS5 + filtros) para decisões;search_sessionspara conteúdo bruto de conversas em todas as sessões passadas.
trace memory mine                           # extract decisions from sessions
trace memory search "GraphQL migration"     # search past conversations
trace memory timeline --file src/auth.ts    # decision history for a file
Lista completa de ferramentas, CLI, validade temporal, escopo de serviço: Memória de decisões.
Subprojetos
Um subprojeto é qualquer repositório no ecossistema do seu projeto — microsserviço, frontend, biblioteca compartilhada, ferramenta CLI. O trace vincula grafos de dependência entre subprojetos: se o serviço A chama um endpoint no serviço B, alterar o endpoint em B aparece como uma mudança que quebra A.
A descoberta é automática. Em cada indexação, o trace detecta subprojetos (Docker Compose, workspaces planos/agrupados, fallback de monólito), analisa contratos de API (OpenAPI, GraphQL SDL, Protobuf/gRPC), examina o código em busca de chamadas de clientes HTTP (fetch, axios, Http::, requests, http.Get, stubs gRPC, operações GraphQL) e vincula as chamadas aos endpoints conhecidos.
cd ~/projects/my-app && trace add
# → auto-detects user-service (openapi.yaml) and order-service
# → links order-service → user-service via /api/users/{id}

trace subproject impact --endpoint=/api/users
# → [order-service] src/services/user-client.ts:42 (axios, confidence: 85%)
Subprojetos externos podem ser adicionados manualmente com trace subproject add --repo=... --project=.... Ferramentas MCP: get_subproject_graph, get_subproject_impact, get_subproject_clients, subproject_add_repo, subproject_sync.
CLI completa, modos de detecção, referência de ferramentas MCP, configuração de topologia: Configuração — topologia e subprojetos.
Relatórios de impacto de mudanças em CI/PR
trace ci-report --base main --head HEAD produz um relatório em markdown ou JSON por pull request: resumo, raio de impacto (travessia reversa de dependências em profundidade 2), lacunas de cobertura de testes (hasTestReach por símbolo), análise de risco (30% complexidade + 25% churn + 25% acoplamento + 20% raio de impacto), violações de arquitetura (detecta automaticamente predefinições limpas/hexagonais) e novas exportações mortas.
Use --fail-on high para bloquear merges em mudanças de alto risco. Veja .github/workflows/ci.yml para uma GitHub Action pronta para uso que executa build → test → impact-report e publica um comentário fixo no PR a cada push.
Programa piloto — para equipes que executam LLM em produção
Se você está lançando recursos de IA em produção — copilotos internos, assistentes voltados ao cliente, RAG sobre uma base de código ou conhecimento — e está atingindo limites de custo, latência ou qualidade, executaremos um piloto focado com você.
Formato: 2–4 semanas. Integração mínima. Um ou dois casos de uso reais de produção — não uma demonstração.
O que medimos (antes/depois):
- Tokens por resposta bem-sucedida
- Precisão da primeira resposta (% de consultas resolvidas sem nova tentativa)
- Novas tentativas e chamadas de fallback
- Latência de ponta a ponta
- Taxa de sucesso do usuário em um conjunto fixo de avaliação
O que você recebe: um relatório claro, antes/depois, sobre se a otimização de contexto move as métricas que importam para sua stack — e um caminho para escalar o uso com confiança em vez de limitá-lo por custo.
O alvo é um sistema que permaneça previsível à medida que o uso cresce, não um corte de custo único: as equipes geralmente querem primeiro alcançar produção confiável e depois expandir sua pegada de LLM.
Entre em contato: abra uma issue em github.com/nikolai-vysotskyi/trace-mcp/issues marcada com pilot, ou fale com @nikolai-vysotskyi.
Como funciona
Source files (PHP, TS, Vue, Python, Go, Java, Kotlin, Ruby, HTML, CSS, Blade)
    │
    ▼
┌──────────────────────────────────────────┐
│  Pass 1 — Per-file extraction            │
│  tree-sitter → symbols                   │
│  integration plugins → routes,           │
│    components, migrations, events,       │
│    models, schemas, variants, tests      │
└────────────────────┬─────────────────────┘
                     │
                     ▼
┌──────────────────────────────────────────┐
│  Pass 2 — Cross-file resolution          │
│  PSR-4 · ES modules · Python modules    │
│  Vue components · Inertia bridge         │
│  Blade inheritance · ORM relations       │
│  → unified directed edge graph           │
└────────────────────┬─────────────────────┘
                     │
                     ▼
┌──────────────────────────────────────────┐
│  Pass 3 — LSP enrichment (opt-in)       │
│  tsserver · pyright · gopls ·           │
│  rust-analyzer → compiler-grade         │
│  call resolution, 4-tier confidence     │
└────────────────────┬─────────────────────┘
                     │
                     ▼
┌──────────────────────────────────────────┐
│  SQLite (WAL mode) + FTS5               │
│  nodes · edges · symbols · routes       │
│  + embeddings (local ONNX by default)   │
│  + optional: LLM summaries              │
└────────────────────┬─────────────────────┘
                     │
                     ▼
┌──────────────────────────────────────────┐
│  Decision Memory (decisions.db)         │
│  decisions · session chunks · FTS5      │
│  temporal validity · code linkage       │
│  auto-mined from session logs           │
└────────────────────┬─────────────────────┘
                     │
                     ▼
          MCP server (stdio or HTTP/SSE)
          182 tools · 10 resources
Incremental por padrão — os arquivos são hashados por conteúdo; arquivos inalterados são ignorados na reindexação.
Arquitetura de plugins — plugins de linguagem (extração de símbolos) e plugins de integração (arestas semânticas) são carregados com base na detecção do projeto, organizados em categorias: framework, ORM, view, API, validação, estado, tempo real, testes, ferramentas.
Detalhes: Arquitetura e sistema de plugins — como a indexação funciona
Documentação
A documentação completa está em trace-mcp.com (mesmo conteúdo que docs/ neste repositório).
| Documento | Descrição |
|---|---|
| Frameworks suportados | Lista completa de linguagens, frameworks, ORMs, bibliotecas de UI e o que cada um extrai |
| Referência de ferramentas | Todas as 182 ferramentas MCP com descrições e exemplos de uso |
| Migração da 1.x | As sete ferramentas aposentadas na 2.0 (get_dead_exports, get_session_resume, …) e a chamada que substitui cada uma |
| Configuração | Opções de configuração, configuração de IA, variáveis de ambiente, configurações de segurança |
| Arquitetura | Como a indexação funciona, sistema de plugins, estrutura do projeto, stack de tecnologia |
| Memória de decisões | Grafo de conhecimento de decisões, mineração de sessões, busca entre sessões, contexto de ativação |
| Analytics | Analytics de sessão, rastreamento de economia de tokens, relatórios de otimização, benchmarks |
| Portões de qualidade | Limiares de complexidade, segurança e acoplamento, e como quality_gates.rules substitui os padrões da CLI |
| Economia de TOON | Economia de tokens medida do formato de saída TOON em chamadas reais de ferramentas |
| Telemetria | Spans compatíveis com OpenTelemetry para cada chamada de provedor de IA e chamada de ferramenta MCP |
| Roteamento de prompt do sistema | Integração opcional com tweakcc para aplicação máxima de roteamento de ferramentas |
| Comparações | Tabelas lado a lado completas vs. outras ferramentas de inteligência de código / memória / RAG |
| Desenvolvimento | Compilação, testes, contribuição, adição de novos plugins |
| Sistema de design | O sistema de design macOS 26 do aplicativo desktop — tokens, tipografia, geometria, materiais, primitivas, pisos de acessibilidade |
Histórico de estrelas
Saúde do projeto



Licença
Construído por Nikolai Vysotskyi