distil
Otimização de contexto para agentes de LLM: registro de ferramentas, mascaramento de resultados, orçamento e compactação.
Documentação



claude mcp add distil -- npx -y @munhq/distil
Sem conta, sem chave de API, nada para configurar. O pacote é um pequeno wrapper que
busca o binário para a sua plataforma e o verifica contra os checksums publicados;
install.sh e um binário pré-compilado permanecem para quem não tem Node.
Escritas de cache são 2% dos seus tokens e 28% da sua conta
Isso não é uma afirmação, é uma medição: 13.814 sessões reais de agente, 410.742 turnos de assistente, reexecutados em 2026-08-29. Cada token único nelas foi cobrado 550 vezes, porque uma requisição reenvia todo o histórico.
O que significa que a jogada óbvia — comprimir o histórico — geralmente é a errada. Editar o histórico invalida o prefixo em cache a partir da edição e converte leituras a 0,1x em escritas a 1,25x ou 2,0x. Você não pode comprimir seu caminho para fora do custo de contexto. Você só pode recusar admitir tokens.
Toda ferramenta neste espaço publica uma porcentagem de economia medida em seus
próprios fixtures. O que nenhuma publica é o denominador: qual parcela de uma sessão
real ela tem permissão de tocar, e quanto essa parcela custa uma vez que o preço de
cache de prompt é aplicado. distil mede ambos em transcrições que um agente
realmente escreveu.
O que é estado da arte, e o que não é. A aritmética de cache abaixo não é uma
descoberta. Os https://platform.claude.com/docs/en/build-with-claude/context-editing da Anthropic
afirmam que limpar resultados de ferramentas invalida o prefixo em cache, e enviam
clear_at_least para que uma limpeza só dispare quando for grande o suficiente para
pagar por isso. A regra de ponto de equilíbrio também é publicada: em um cache de 5
minutos, tokens limpos vezes requisições-antes-da-próxima-limpeza devem exceder 11,5
vezes os tokens que você mantém. A tabela neste README reproduz essa regra
exatamente — foi derivada independentemente, o que é uma verificação da aritmética,
não uma contribuição.
A lacuna é empírica. Toda fonte diz para calibrar contra sua própria carga de
trabalho, e nenhuma envia uma maneira de fazer isso ou publica quais são os valores.
É para isso que este crate serve: medir os números que você precisa para escolher
clear_at_least, ou para decidir não limpar nada.
A medição completa
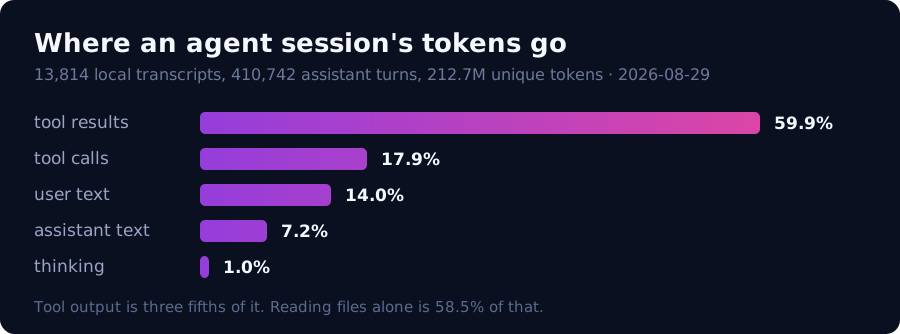
Medido em 2026-08-29 em 13.814 transcrições locais de Claude Code — 410.742
turnos de assistente, 212,7M de tokens de texto único. Reproduza em seu próprio
corpus com distil-bench ~/.claude/projects; um corpus cresce, então a data importa
mais do que os decimais.
| tokens | parcela | |
|---|---|---|
| resultados de ferramentas | 127.371.430 | 59,9% |
| chamadas de ferramentas | 38.065.121 | 17,9% |
| texto do usuário | 29.818.536 | 14,0% |
| texto do assistente | 15.402.077 | 7,2% |
| pensamento | 2.076.716 | 1,0% |
Esses 212,7M de tokens únicos foram cobrados como 116,9 bilhões de tokens de entrada — cada token pago 550 vezes, porque uma requisição reenvia todo o histórico.
Precifique isso com multiplicadores de cache reais (leitura 0,1x, escrita 1,25x para o TTL de 5 minutos e 2,0x para o de 1 hora):
| parcela de tokens | parcela de custo | |
|---|---|---|
| leitura de cache | 97,9% | 71,8% |
| escritas de cache | 2,0% | 27,6% |
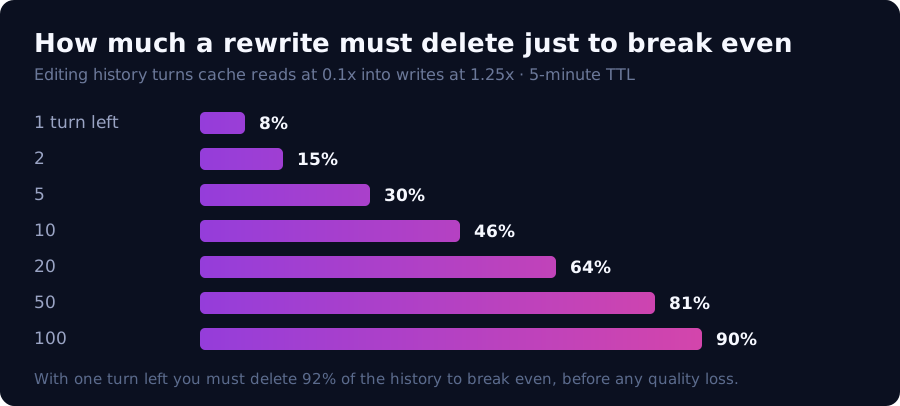
Escritas de cache são 2% dos tokens e 28% da conta. Editar o histórico invalida o prefixo em cache a partir da edição, convertendo leituras a 0,1x em escritas a 1,25x ou 2,0x. Então uma reescrita deve encolher o que invalida abaixo de:
| turnos restantes | TTL 5m | TTL 1h |
|---|---|---|
| 1 | 8,0% | 5,0% |
| 10 | 46,5% | 34,5% |
| 20 | 63,5% | 51,3% |
| 100 | 89,7% | 84,0% |
Essa tabela é a regra de ponto de equilíbrio publicada em outra forma: em cada
linha, cleared x turns / kept é igual a 11,5 para o nível de 5 minutos. Use-a para escolher
um valor de clear_at_least, e use distil-bench para encontrar a contagem de
turnos e o tamanho da cauda para colocar nele — essas são propriedades da carga de
trabalho, e são a parte que ninguém publica.
Por unidade de histórico, com 10 turnos restantes: mantê-lo custa 1,00, comprimi-lo custa 2,15, e nunca admiti-lo custa 0. Você não pode comprimir seu caminho para fora do custo de contexto. Você só pode recusar admitir tokens.
O que isso significa para usar este crate
Camadas que não tocam o histórico estão do lado certo dessa aritmética:
CacheAlignLayer (ordena o conteúdo para que o prefixo estável permaneça em cache) e
ScratchpadLayer (mantém o estado de trabalho fora da janela).
Camadas que reescrevem o histórico — MaskingLayer, SummarizationLayer,
CompactionLayer — custam mais do que economizam no caso comum. Alcance-as
em apenas um limite: estouro de contexto, onde a alternativa é uma requisição
falha e o preço de cache deixa de ser a comparação. BudgetLayer existe para
exatamente esse momento.
RegistryLayer e CodeModeLayer são anteriores à Ferramenta de Busca de
Ferramentas e à Chamada Programática de Ferramentas da Anthropic, que fazem os
mesmos trabalhos nativamente e melhor. Prefira os recursos nativos.
Para limpar resultados antigos de ferramentas, prefira a edição de contexto
clear_tool_uses do provedor em vez de MaskingLayer: ela roda no lado do
servidor, aceita clear_at_least, e é um parâmetro de API contra uma dependência.
Alcance uma camada aqui apenas quando precisar de comportamento que a API não
oferece.
Medição
cargo build --features bench --release

# Where tokens are, what they cost, and the break-even table
./target/release/distil-bench ~/.claude/projects --json baseline.json

# Sessions that called a given tool, against those that did not
./target/release/distil-bench ~/.claude/projects --split-by-tool mcp__codeindex__

# Export real traffic so other compressors run on the same input
./target/release/distil-bench ~/.claude/projects --export-sessions ./sessions --min-turns 40
Veja bench/README.md para a comparação de ferramentas externas,
as regras de justiça, e os dois erros de harness que produziram números errados
primeiro.
Retenção
Uma economia só é uma economia se o modelo ainda puder responder o que o contexto original poderia responder.
# No LLM judge: file paths checked against ground truth from the transcript
python bench/artifact_retention.py ./sessions 12

# LLM-graded probes (recall / artifact / continuation / decision)
cargo build --features probe --release
./target/release/distil-probe <session.jsonl> --probes 6 --model qwen2.5:3b
A taxonomia de sondas é da Factory.ai;
o artigo deles a define e não envia harness. O juiz é um Completer,
nunca um Summarizer — um sumarizador pode impor enquadramento de sumarização,
o que reescreve tanto o formato da sonda quanto a instrução de avaliação.
Usando como biblioteca
use distil::{CacheAlignLayer, Ctx, EstimateCounter, Pipeline};

let pipeline = Pipeline::builder()
    .counter(EstimateCounter)
    .layer(CacheAlignLayer::generic())
    .build();

let mut ctx = Ctx::new(messages, tools, turn);
let result = pipeline.optimize(&mut ctx);
println!("{result}");
Este exemplo é mantido compilável como
examples/readme_quickstart.rs — execute-o com
cargo run --example readme_quickstart.
Cada camada implementa Layer e reporta tokens_before, tokens_after e uma
linha de detalhe, para que cada uma possa ser medida por conta própria.
Recursos
| recurso | o que adiciona |
|---|---|
corpus | carregador de transcrições (sem dependências extras) |
bench | distil-bench, precisa de tiktoken |
probe | distil-probe, precisa de proxy para o juiz HTTP |
tiktoken | contagens BPE precisas em vez da estimativa chars/3.5 |
proxy | servidor HTTP distil-proxy |
mcp | servidor MCP distil-mcp |
metrics | /metrics Prometheus |
Instalação
./install.sh                       # binaries, the skill, and the MCP server
/plugin marketplace add munhq/distil
/plugin install distil             # Claude Code: skill and server in one step
install.sh instala ambos os binários, coloca a skill em cada home do Claude que
encontra, e registra o servidor MCP no escopo do usuário. Quando o plugin já está
instalado, instala apenas o binário, já que o plugin declara o servidor e
envia a skill por conta própria.
O plugin inicia o servidor com npx -y @munhq/distil, então precisa de Node.
Não pode usar um caminho relativo ao plugin: Claude Code expande ${CLAUDE_PLUGIN_ROOT}
e nada mais faz, então um plugin que declara um entrega a todos os outros clientes um
caminho literal que não existe. install.sh e os binários pré-compilados permanecem
para quem não tem Node.
Suporte de plataforma
| plataforma | binários | scripts |
|---|---|---|
| Linux x86_64 / arm64 | lançados, testados | sim |
| macOS x86_64 / arm64 | lançados, compilados no CI | sim |
| Windows x86_64 / arm64 | lançados, compilados no CI | precisa de um shell: Git Bash, MSYS2 ou WSL |
O lançamento publica seis alvos e plugin/test_platform.sh mantém tanto o
instalador quanto o launcher do plugin nessa matriz, para que um nome de asset e o
nome solicitado não possam divergir. install.sh e o launcher são scripts bash,
então no Windows precisam de um shell — cmd e PowerShell não podem
executá-los. Os binários Linux são builds musl estáticos, então não precisam de um
glibc correspondente.
Ressalvas
O corpus é a máquina de um desenvolvedor. As proporções são a descoberta; os
totais absolutos são pessoais. As contagens usam cl100k_base, que aproxima
o tokenizador do Claude dentro de alguns por cento. O modelo de ponto de equilíbrio
assume um único ponto de interrupção de cache, então uma reescrita confinada à cauda
custa menos do que a tabela mostra — isso a refina, não a reverte.
Contribuindo
Instruções de build e teste, as regras que uma mudança de benchmark deve seguir, e o
que um pull request precisa antes da revisão: CONTRIBUTING.md.
Reporte uma vulnerabilidade em privado — SECURITY.md.
Licença
MIT. Veja LICENSE.