Fagan
Pipeline de codificação autônoma: um modelo de fronteira planeja e revisa, modelos de peso aberto escrevem o código, controlados por TDD e revisão.
Documentação
Fagan


Gaste tokens em julgamento, não em digitação.
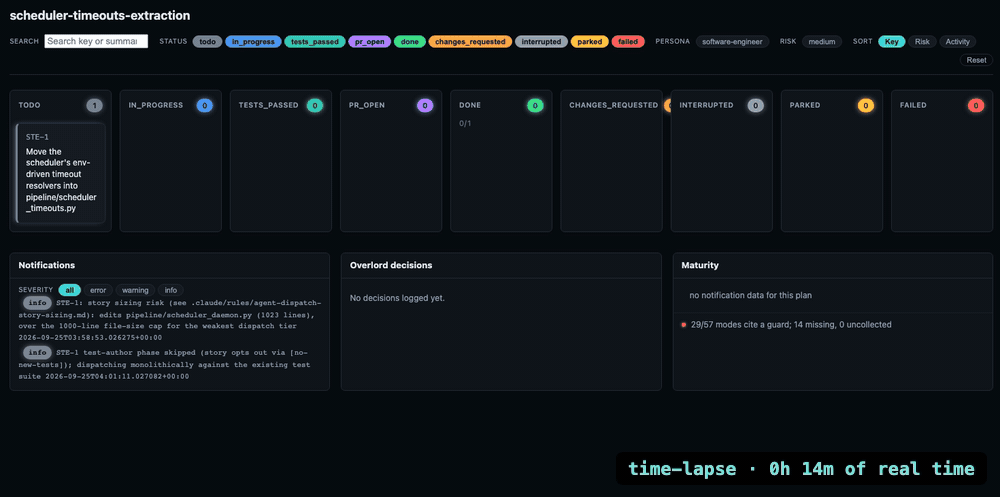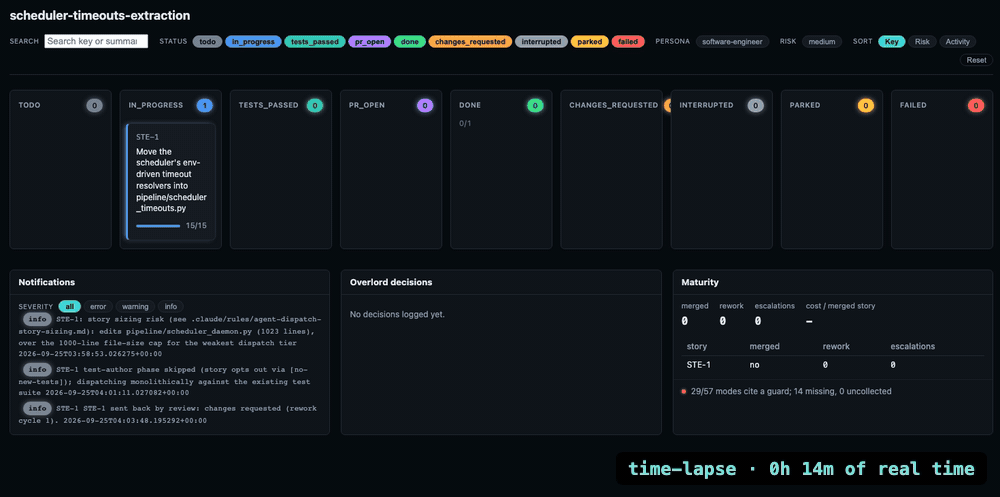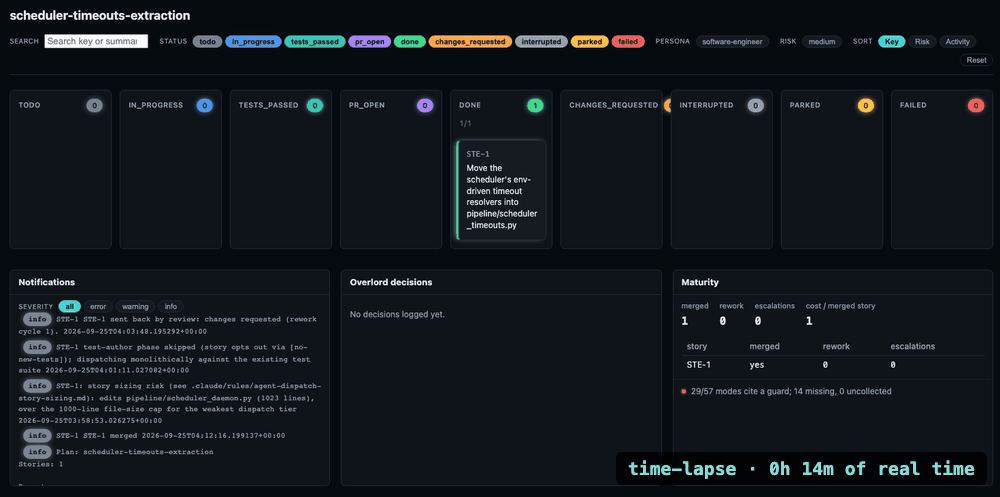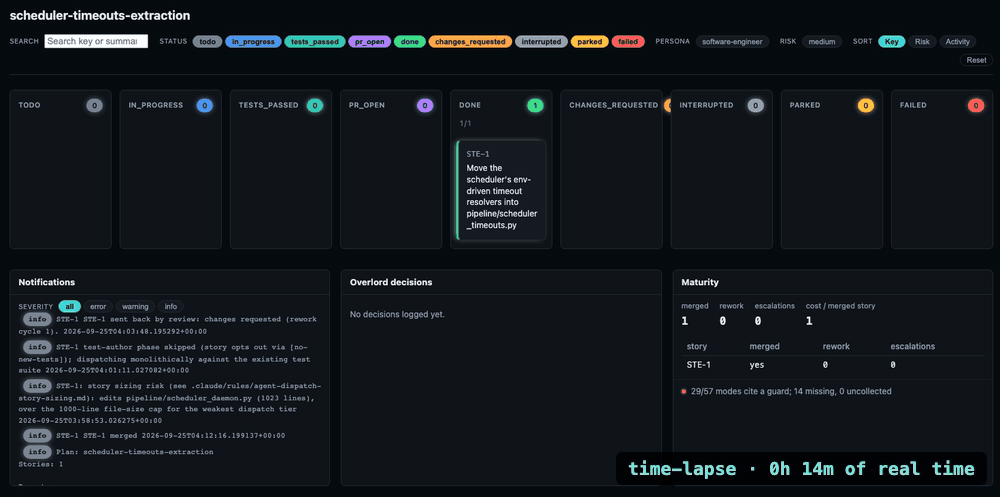
Uma história real (STE-1, PR #986) atravessando o quadro: implementada por um modelo de peso aberto, enviada de volta uma vez pela revisão, mesclada. 14 minutos, em time-lapse.
Experimente (macOS; Linux via Ollama ou LM Studio) e depois veja o Quickstart:
curl -fsSL https://raw.githubusercontent.com/motock/fagan/master/scripts/remote-install.sh | bash
Modelos de fronteira custam dinheiro por token e são excelentes em julgamento. Modelos locais rodam de graça e são adequados para digitação. Este pipeline divide a engenharia de software exatamente nessa linha: um modelo de fronteira decompõe o trabalho, planeja, revisa o diff e arbitra qualquer coisa arriscada — enquanto um modelo local escreve a implementação sem custo marginal.
O que torna a metade barata confiável é a inspeção. No https://www.semanticscholar.org/paper/Design-and-Code-Inspections-to-Reduce-Errors-in-Fagan/fe02f66911c6331a81d01f9cf4fdce05b6b2aca3 de Michael Fagan, a inspeção formal encontrou 82% dos defeitos no produto lançado — 38 por KLOC, contra 8 por KLOC para testes unitários. A qualidade vive no portão, não no autor. Então este projeto gasta seu orçamento em portões: TDD aplicado antes da implementação, uma passagem de revisão independente, avaliação por oráculo de aceitação, um supervisor em camadas de risco que para para um humano em qualquer coisa irreversível, e um portão de mesclagem que reexecuta a suíte contra o branch rebasado antes que qualquer coisa seja entregue.
O objetivo é estreito e específico: disciplina de engenharia de nível empresarial — decomposição, TDD, revisão de código, entrega ordenada por dependências — em um orçamento de $20/mês.
Para material de referência detalhado, veja REFERENCE.md.
Antes de começar: leia Confiabilidade e limitações abaixo. Este é um pipeline de codificação autônomo com modos de falha reais e documentados — ainda não é uma ferramenta "descreva um recurso, receba um PR" sem intervenção.
Suporte de plataforma
Desenvolvido e executado diariamente em macOS. O núcleo (servidor MCP, painel, despacho/revisão via backend Claude, a suíte de testes completa) é Python puro e CI o testa em Ubuntu nas versões Python 3.12–3.14 a cada push. Duas partes são apenas para macOS:
launchd/*.plist— o agendador/supervisor MLX/poll de uso são empacotados como jobs launchd no macOS. No Linux, renderize o equivalente systemd comscripts/generate_systemd_units.sh(veja Agendador abaixo) em vez de criar arquivos init manualmente, ou execute os pontos de entrada diretamente em um terminal em primeiro plano/sessãotmux.- MLX (
PIPELINE_LOCAL_PROVIDER=mlx) — apenas Apple Silicon. O despacho local funciona bem no Linux via Ollama ou LM Studio em vez disso (PIPELINE_LOCAL_PROVIDER=ollama/lmstudio).
Windows não é testado.
Quickstart
Instalação em uma linha
curl -fsSL https://raw.githubusercontent.com/motock/fagan/master/scripts/remote-install.sh | bash
Isso clona o repositório para ~/.fagan (substitua o local com
FAGAN_INSTALL_DIR, e a URL de origem com FAGAN_REPO_URL) e executa
scripts/install.sh dentro dele — equivalente aos passos manuais de clonar e executar
abaixo, menos a digitação. Reexecutá-lo depois atualiza o checkout
existente (git pull --ff-only) em vez de clonar novamente.
Enviar um script remoto para bash significa confiar no que essa URL serve
no momento da busca. Se preferir ler primeiro:
curl -fsSL https://raw.githubusercontent.com/motock/fagan/master/scripts/remote-install.sh -o remote-install.sh
less remote-install.sh   # or open it in an editor
bash remote-install.sh
De qualquer forma, cd para o diretório de instalação que ele informa (~/.fagan por
padrão); ele já fez os passos 1–3 abaixo, então reinicie o Claude Code (passo 5). Prefere um clone manual? Use os
passos abaixo em vez disso.
Isso registra o servidor MCP e executa um primeiro plano de ponta a ponta.
Uma primeira execução não precisa de nenhum modelo local: com nada configurado, o despacho
e a revisão caem para o backend claude, que chama o CLI do Claude
Code. Esse fallback é a configuração inicial, não a pretendida
— a divisão de custos descrita acima só acontece quando você roteia deliberadamente
o papel de implementação para um modelo local, que é por isso que o registro enviado
não traz nenhum bloco roles próprio: veja Seleção de provedor e autorização
abaixo para saber como fazer essa escolha quando estiver pronto.
# 1. Clone and install the Python environment
git clone https://github.com/motock/fagan.git
cd fagan
scripts/install.sh          # creates .venv, installs requirements.txt

# 2. Register the MCP server with Claude Code (adjust the path to where you cloned it)
claude mcp add -s user pipeline "$(pwd)/.venv/bin/python3" "$(pwd)/app/pipeline_mcp_server.py"

# 3. Copy the persona subagents and decision policy into place
#    (cp -n skips any file you already have — e.g. a customized code-reviewer.md —
#    instead of silently overwriting it; diff before removing -n if you do want the update)
mkdir -p ~/.claude/agents
cp -n agents/*.md ~/.claude/agents/
cp -n overlord-policy.md ~/.claude/overlord-policy.md

# 4. (Optional) Install the global rules bundle for your agent CLIs
#    scripts/install_global_rules.py --tools=claude,codex,opencode
#    Opt-in: nothing is written unless --tools is passed. It writes the bundle into
#    ~/.claude/CLAUDE.md, ~/.codex/AGENTS.md and ~/.config/opencode/AGENTS.md, copies
#    the rule files into the sibling fagan-rules/ directory, and backs up an existing
#    file as <name>.fagan-bak-<UTC timestamp>. Re-running refreshes only the fenced
#    block between the fagan:begin and fagan:end markers.

# 5. Restart Claude Code (or start a new session) so it picks up the MCP server
scripts/install.sh cria o .venv, instala requirements.txt e
requirements-dashboard.txt (as dependências de fastapi/uvicorn do painel, instaladas
em cada execução; uma instalação --dev usa requirements-dev.txt, que já
inclui as dependências do painel), e informa sobre as ferramentas que o pipeline chama
— obrigatórias: git, gh e o CLI claude; opcionais: ollama e
docker — com mensagens de degradação graciosa, e é seguro reexecutar. Ele não registra o servidor MCP, define variáveis de ambiente
ou instala os subagentes de persona — os passos 2–3 acima cobrem isso. Com
nada além do backend claude configurado, a ausência de ollama/docker é
esperada, não um erro.
De uma sessão do Claude Code no projeto em que você quer que o pipeline trabalhe:
- Peça ao subagente
product-analystpara transformar um objetivo em épicos/histórias, ou escreva um plano manualmente conforme o esquema. mcp__pipeline__save_plan(ouingest_plan) com esse plano e umrepo_rootapontando para o projeto alvo — não este repositório do pipeline.mcp__pipeline__list_ready_storiespara ver o que está desbloqueado, depoismcp__pipeline__dispatch_storypara reivindicar e iniciar um.- Acompanhe o progresso com o painel:
scripts/dashboard.sh start, depois abrahttp://localhost:8000. - Para operação sem supervisão, execute o agendador para que histórias prontas avancem
sem você chamar
advance_pipelinemanualmente:.venv/bin/python3 -m pipeline.scheduler_daemon(em primeiro plano, ou sob launchd/systemd/tmux — veja Agendador abaixo).
Comece com PIPELINE_AUTONOMY=dry-run (apenas planos e logs, nada é
despachado ou mesclado) até você assistir um plano rodar e confiar nos portões —
veja Níveis de autonomia.
Usando apenas o backend claude? As variáveis PIPELINE_LOCAL_* e
PIPELINE_BACKEND_*=ollama/lmstudio/mlx, e a configuração de Ollama/MLX/LM Studio,
só importam se você optar por um papel no despacho de modelo local — mas a seleção
de provedor em si ainda é um passo de configuração obrigatório (o registro enviado
não roteia nada; veja Seleção de provedor e autorização abaixo), e até o
caminho claude precisa de duas credenciais antes do primeiro despacho: gh auth login
(o pipeline abre e mescla PRs através do GitHub CLI) e o login
próprio do CLI do Claude Code. Veja
Configuração mínima para as poucas
variáveis que realmente valem a pena definir no primeiro dia, versus as ~100 que existem puramente
para ajuste.
Seleção de provedor e autorização
A seleção de provedor é um passo de configuração obrigatório. O
model_registry.json enviado declara deliberadamente quais modelos existem por provedor
mas não traz nenhum roteamento roles: este projeto se desacopla de qualquer provedor
único, então o operador escolhe. Há duas maneiras suportadas de selecionar um
provedor por papel, verificadas nesta ordem por resolve_role:
- Configuração de papel do plano — o
provider/modelpor papel de um plano supera tudo abaixo. - Um bloco
rolesem um arquivo de registro — a fonte única de verdade para roteamento de papéis; veja abaixo. - Variáveis de ambiente
PIPELINE_BACKEND_<ROLE>— consultadas apenas quando o registro não tem entrada para o papel (o caminho de estado vazio, para que um clone novo ainda inicialize); por exemplo,PIPELINE_BACKEND_DISPATCH=ollamaopta o papel de despacho para Ollama. - O fallback do próprio chamador — para despacho/revisão, este é o backend
claude.
Para uma alternativa interativa a editar o JSON do registro manualmente, execute o
seletor: .venv/bin/python scripts/choose_providers.py. Ele percorre todos os
nove papéis um de cada vez, mostrando o provedor/modelo atual de cada papel e de onde
essa configuração veio, e permite que você altere digitando um número de opção —
cada um dos nove papéis é configurado independentemente, e cada mudança é
validada contra o registro antes de ser gravada. É seguro reexecutar a qualquer
momento: reexecutar apenas relê o roteamento atual, e pressionar Enter mantém a
configuração existente de um papel.
Os mesmos dois arquivos de registro funcionam para ambos os estilos de seleção:
PIPELINE_MODEL_REGISTRY_PATHaponta o pipeline para qualquer JSON de registro que você quiser.model_registry.local.json(raiz do repositório) é a convenção para um registro pessoal: é ignorado pelo git, então seu roteamento por papel fica fora do repositório. ApontePIPELINE_MODEL_REGISTRY_PATHpara ele, ou copie-o sobremodel_registry.jsonlocalmente se preferir não definir a variável.
Um bloco roles nomeia um provedor e um nome amigável de modelo por papel; o
nome amigável deve existir sob o models desse provedor no mesmo arquivo, e
a tag concreta é resolvida a partir daí. Um erro de digitação levanta um erro em vez de
cair silenciosamente em fallback.
Matriz de autorização. Selecionar um provedor também seleciona quais credenciais
você deve estabelecer primeiro — scripts/install_checks.py testa essas e
informa unauthorized (remediação: um login, não uma instalação) onde puder:
| Provedor / ferramenta | Credencial necessária | Como estabelecer |
|---|---|---|
git / gh | Autenticação GitHub (o pipeline abre e mescla PRs através de gh) | gh auth login |
Backend claude | Login próprio do CLI do Claude Code | claude auth login (verifique: claude auth status) |
qualquer tag ollama :cloud | Uma conta ollama.com, conectada ao daemon local | ollama signin |
Backend litellm | Chaves de API por fornecedor | Veja docs/specs/LITELLM_PROVIDER.md |
| tag ollama / lmstudio / mlx no dispositivo | Nada extra | — |
Nas linhas :cloud: essas chamadas são proxy através de https://ollama.com pelo
daemon ollama local, que envia sua própria credencial — o pipeline envia
nenhuma credencial própria. Tags :cloud são as únicas tags ollama que precisam de
login; tags puramente no dispositivo não precisam de nada além do daemon rodando.
Passo a passo de introdução
O passo a passo funciona com qualquer provedor de despacho que você tenha configurado —
PIPELINE_BACKEND_DISPATCH (defina-o explicitamente, ou adicione um bloco roles a um
registro local — o registro enviado não roteia nada; veja Seleção de provedor
e autorização acima). Com claude configurado, o despacho e a revisão chamam
o CLI do Claude Code; com um provedor local como ollama configurado,
eles rodam nesse modelo local em vez disso.
- Instale — um único comando:
scripts/install.sh(veja o quickstart acima para saber o que ele faz e o que não faz). - Registre o servidor MCP e as personas — etapas 2–3 do quickstart acima
(
claude mcp add ...mais copiaragents/*.mde a política do overlord), e então reinicie o Claude Code. - Inicie o dashboard —
scripts/dashboard.sh start, depois abrahttp://localhost:8000e escolha seu projeto alvo no seletor de workspace. - Decomponha uma meta pequena — peça ao subagente
product-analyst(ou à ação de decomposição do dashboard) para transformar uma meta de uma linha em épicos/histórias, e entãomcp__pipeline__save_plano resultado com o camporepo_rootapontando para seu projeto alvo — não para este repositório do pipeline. - Despache a primeira história pronta —
mcp__pipeline__list_ready_stories, depoismcp__pipeline__dispatch_storyna primeira, e observe a história avançar pelo quadro kanban no dashboard. - Observe o merge — com
PIPELINE_AUTONOMY=gated(o padrão), uma história de riscolowque passa na revisão faz merge sem supervisão. Comece comPIPELINE_AUTONOMY=dry-runprimeiro, conforme a recomendação do quickstart acima. - Prefere o caminho via script? —
.venv/bin/python scripts/smoke_getting_started.pyexecuta o mesmo fluxo de ponta a ponta sem o dashboard, em umPLAN_DIRtemporário que nunca toca seus planos reais. O smoke é neutro em relação ao provedor: ele roda no seu provedor de despacho configurado (PIPELINE_BACKEND_DISPATCH, padrãoclaude) e anuncia o provedor, modelo e fonte resolvidos antecipadamente, para você sempre saber qual backend ele validou. Códigos de saída:0PASS (a história chegou atests_passed),1o provedor resolvido éclaudee o CLIclaudeestá ausente, saída 2 significa que o provedor configurado está vazio ou não é reconhecido — um erro de configuração, não uma recusa de um provedor local —3o poll limitado expirou,4a história falhou. Advertência honesta: PASS depende do modelo configurado realmente concluir a história, então uma falha em um modelo local fraco reflete esse modelo, não um pipeline quebrado.
Para o que ainda pode dar errado, veja Confiabilidade e limitações.
Servidor MCP complementar (somente overlord + acceptance-oracle)
Não está pronto para adotar o orquestrador inteiro? pipeline/companion_server.py é um
segundo servidor MCP menor (pipeline-companion) que expõe duas ideias que
se sustentam sozinhas sem adotar o resto do pipeline:
escalate_decision (o caminho de decisão do overlord) e os helpers do acceptance-oracle
classify_oracle_outcome / acceptance_digests. Ele importa os módulos reais pipeline.overlord e
pipeline.oracle_gate em vez de duplicá-los, então permanece em
sincronia com o servidor principal. Adicione-o junto ao servidor principal como uma segunda
entrada mcpServers:
{
  "mcpServers": {
    "pipeline": {
      "command": ".venv/bin/python3",
      "args": ["app/pipeline_mcp_server.py"]
    },
    "pipeline-companion": {
      "command": ".venv/bin/python3",
      "args": ["-m", "pipeline.companion_server"]
    }
  }
}
As especificações adotáveis que este servidor exporta ficam em docs/specs/:
OVERLORD_POLICY_SPEC.md (o caminho de decisão do overlord),
ACCEPTANCE_ORACLE_PATTERN.md (o padrão de avaliação do acceptance-oracle) e
DOCKER_SANDBOX.md (o comportamento opcional de sandboxing via Docker).
Execução autônoma (dashboard + scheduler, sem servidor MCP)
O dashboard expõe as mesmas operações que as ferramentas MCP — salvar/ingerir um plano,
decompor uma meta, despachar uma história, avançar, revisar, aprovar merge — então o
pipeline pode rodar sem registrar um servidor MCP. Essa paridade vive na
API HTTP, não na interface: a UI do dashboard expõe diretamente chat (incluindo
rascunhar um plano), navegação por planos, histórias, diários e logs, o seletor
de workspace, o fluxo de revisão/aplicação de worktree-patch, configuração de papéis e ingestão de um
plano salvo. Despachar, avançar, revisar e aprovar merge têm rotas de API sem UI
(/api/plans/{plan_name}/stories/{story_key}/dispatch e afins) disponíveis para
scripting, e para o fluxo autônomo o scheduler é o driver pretendido:
rascunhe e ingira um plano pelo dashboard, depois deixe o scheduler despachar,
avançar, revisar e fazer merge das histórias prontas por conta própria. O
caminho suportado é um único comando:
scripts/standalone-setup.sh up
up provisiona um diretório de dados temporário (padrão ~/pipeline-standalone), escreve
o arquivo de env do operador compartilhado com caminhos absolutos, inicia o dashboard e o
scheduler por meio de seus scripts auxiliares existentes e então se recusa a relatar
sucesso até que GET /api/health responda com um config_mismatch vazio e
o plan_dir pretendido. Opções principais: --data-dir DIR (padrão
~/pipeline-standalone), --target-repo DIR (padrão: um repositório temporário sob
o diretório de dados), --port PORT (padrão 8001), --autonomy MODE (padrão
dry-run), além de --repo-root e --force. down interrompe ambos os processos e
deixa os dados temporários no lugar; status imprime os caminhos resolvidos e o estado de ambos
os processos.
Ambos os processos de longa duração leem o mesmo arquivo de env do operador:
scripts/dashboard.sh e scripts/scheduler.sh ambos usam como fonte
.pipeline.env (ignorado pelo git; veja .pipeline.env.example) primeiro, depois
.dashboard.env (ignorado pelo git; veja .dashboard.env.example) em segundo, então
instalações existentes somente com dashboard mantêm sua precedência atual de última escrita —
.dashboard.env ainda funciona e simplesmente sobrescreve .pipeline.env onde eles
se sobrepõem.
Como o dashboard e o scheduler são processos separados, PLAN_DIR
deve corresponder entre os dois: o scheduler escreve uma impressão digital de configuração em
<plan_dir>/.scheduler_health.json, e /api/health relata
config_mismatch listando os campos onde a configuração resolvida do dashboard
difere dessa impressão digital. Um config_mismatch não vazio significa que a UI e
o scheduler estão trabalhando com armazenamentos de planos diferentes — verifique se ambos foram
iniciados com o mesmo PLAN_DIR (o script autônomo escreve um arquivo de env
exatamente por esse motivo e falha de forma dura em um config_mismatch não vazio).
Os pré-requisitos normais ainda se aplicam no modo autônomo: gh auth login para
o caminho de PR/merge (o pipeline abre e faz merge de PRs por meio do GitHub CLI),
e autorização do provedor para qualquer backend configurado — veja
Seleção de provedor e autorização acima.
Componentes de relance
| Peça | Localização | Papel |
|---|---|---|
| Subagentes de persona | ~/.claude/agents/*.md | Os papéis de SDLC que os agentes desempenham |
| Política de decisão | ~/.claude/overlord-policy.md | Como o overlord decide |
| Servidor MCP do pipeline | app/pipeline_mcp_server.py (shim de inicialização) → pacote pipeline/ | Todas as ferramentas do pipeline + orquestração; pipeline/server.py é o módulo de entrada, dividido entre pipeline/*.py (despacho, revisão, ci, avanço, armazenamento, etc.) |
| Costura de backend | app/backend.py | Roteamento de driver por papel (claude / ollama / lmstudio / mlx / local); disparo único, revisão, despacho, gate de recursos |
| Loop de agente local | scripts/local_agent.py | Loop de escrita com chamada de ferramenta nativa para despacho local (subprocesso) |
| Dashboard de monitoramento | app/dashboard.py, static/ | Visualizador de status/ciclo de vida FastAPI; no modo autônomo (veja "Execução autônoma" abaixo) ele também aciona salvar/ingerir/despachar/revisar/merge diretamente |
| Instalação / dependências | scripts/install.sh, requirements*.txt | venv + configuração de dependências |
| Testes | tests/unit/ (10.500+ testes) | pytest, executados via venv |
| Planos / manifestos / logs | ~/.claude/plans/ | Plano, manifesto, decisões, notificações |
| Worktrees | ~/.claude/worktrees/ | Branches isolados por história |
| Rastreador de issues | Plane (externo, opcional) | Espelho do estado da história; ignorado completamente quando não configurado (o manifesto é a fonte da verdade) |
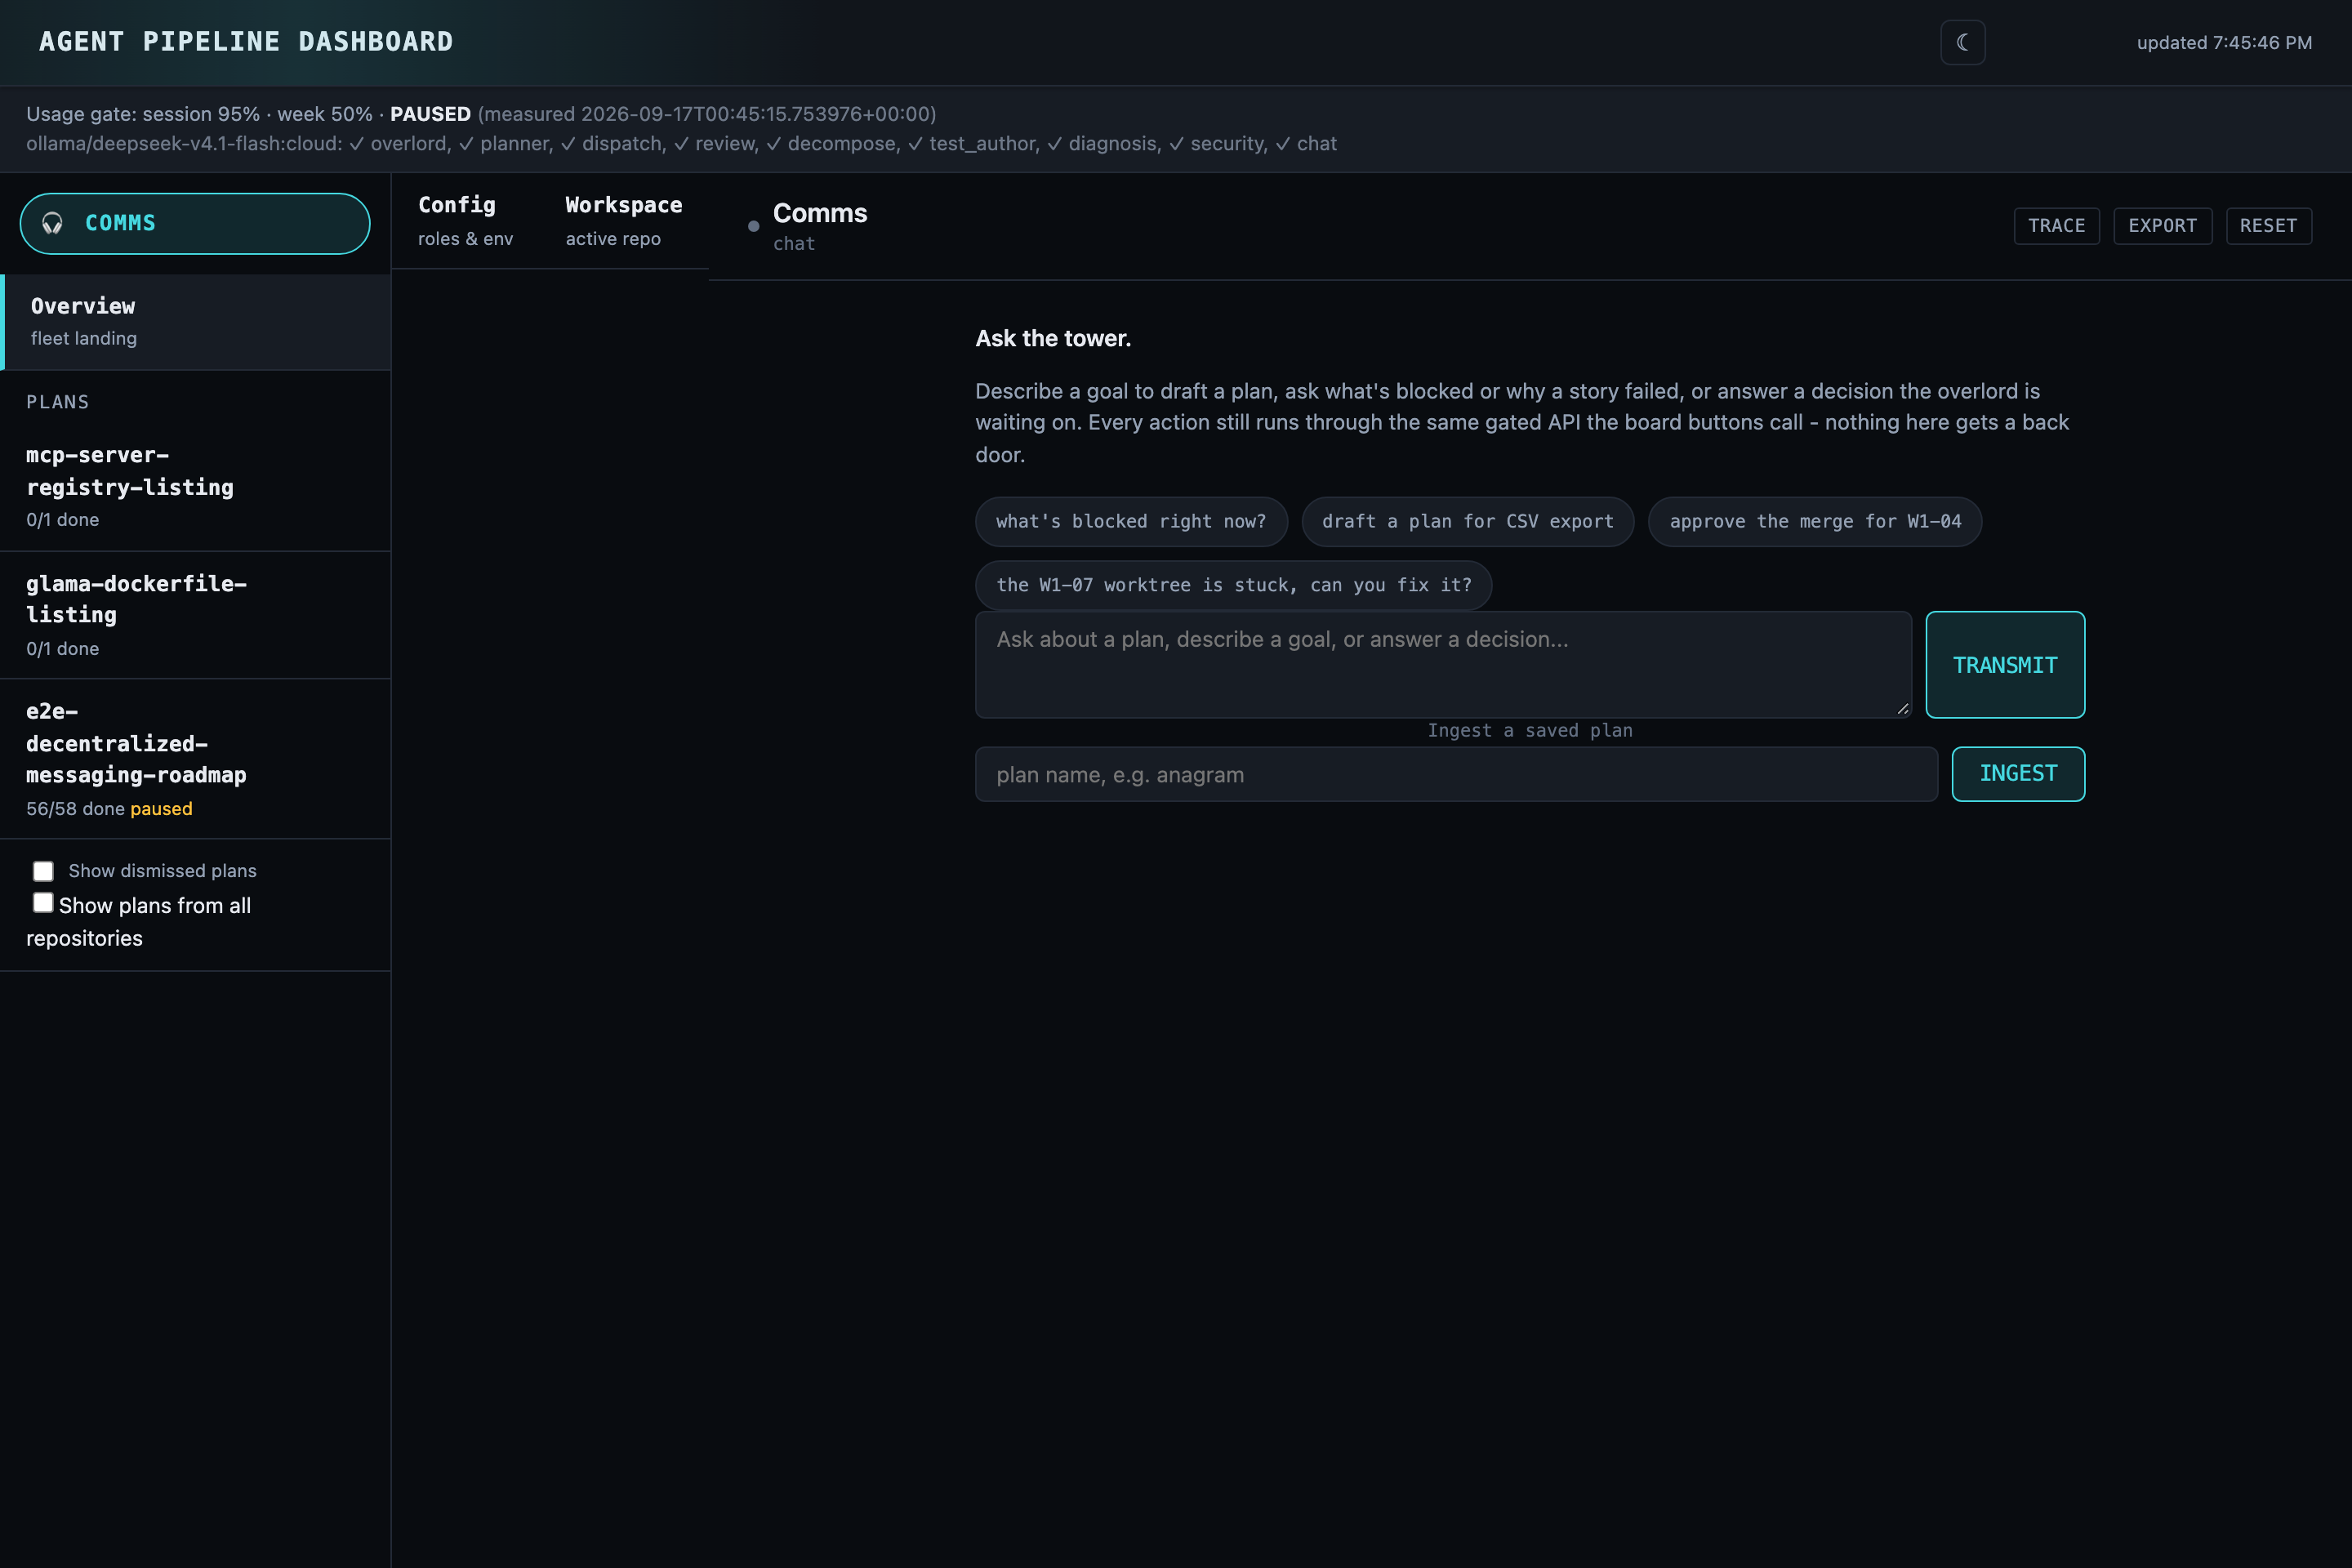
A visualização Comms do dashboard — pergunte o que está bloqueado, rascunhe um plano ou aprove um merge, tudo roteado pela mesma API com gate que os botões do quadro kanban chamam. Mais capturas de tela (o quadro kanban ao vivo e o seletor de workspace) estão em docs/DEMO.md.
Arquitetura
 ┌───────────────────────────────────────────────────────────┐
 │ Orchestrator loop (cron / /loop skill)                     │
 │ advance_pipeline(plan) — one idempotent tick               │
 └───────────────────────────┬───────────────────────────────┘
                              │ ready stories (deps satisfied)
                              ▼
 ┌───────────────┐  resolve backend +    ┌───────────────────────────────┐
 │ Plan/Manifest │  persona/model        │ Dispatch                      │
 │ (JSON, Plane) │──────────────────────►│  claude -p  OR  local loop    │
 └───────────────┘                       │  (tech-lead plans for local → │
                                          │   .agent_plan.md)             │
                                          └───────────────┬───────────────┘
                                                           ▼
                                          ┌───────────────────────────────┐
                                          │ Headless story agent, TDD-    │
                                          │ first, in an isolated git     │
                                          │ worktree                      │
                                          └───────────────┬───────────────┘
                                    local fail → escalate  │ tests +
                                    to claude (`auto`)     │ acceptance oracle
                                                           ▼
                                          ┌───────────────────────────────┐
                                          │ code-reviewer: VERDICT,       │
                                          │ opens a PR                    │
                                          └───────────────┬───────────────┘
                                                           ▼
      low    → decide silently            ┌───────────────────────────────┐
      medium → decide, notify the user    │ Overlord adjudicates risk     │──► decisions log
      high   → park, wait for a human     │ (blocked decisions, merge,    │    (audit trail)
                                           │  scope disputes)              │
                                           └───────────────┬───────────────┘
                                                            ▼ approved
                                           ┌───────────────────────────────┐
                                           │ Merge gate: rebase on master, │
                                           │ force-push, poll CI, re-run   │
                                           │ the suite on the rebased      │
                                           │ branch                        │
                                           └───────────────┬───────────────┘
                                                            ▼
                                                         master
Personas (~/.claude/agents/)
Cada persona é um subagente do Claude Code: um arquivo markdown com frontmatter YAML
(name, description, model e opcionalmente memory: user) e um
corpo de prompt de sistema. O pipeline lê o corpo e despacha um agente headless
com ele como o papel.
memory: user injeta o diretório de memória do usuário no prompt de sistema em
cada chamada do Claude — contexto de alto impacto, mas caro em tokens. As
personas de revisor (code-reviewer, security-engineer) deliberadamente o omitem:
seu trabalho é uma verificação mecânica (executar testes, ler o diff, emitir VERDICT),
as regras de CLAUDE.md que precisam estão no corpo da persona, e pular a
injeção de memória de ~132 KB reduz ~30-40% dos tokens de entrada de cada chamada de revisão.
As personas de despacho e overlord o mantêm porque se beneficiam do contexto do projeto
e têm volume menor.
| Persona | Modelo padrão | Responsabilidade |
|---|---|---|
product-analyst | opus | Decompor uma meta em épicos/histórias com critérios de aceitação, dependências e persona/model/risk por história |
solution-architect | opus | Design geral do sistema, seleção de tecnologia, design de API (delega mobile para mobile-architect) |
software-engineer | sonnet | Implementador TDD padrão para trabalho não mobile |
security-engineer | opus | Modelagem de ameaças e revisão de segurança (OWASP, Secure by Design) |
devops-release-engineer | sonnet | Build/CI, higiene de branch e worktree, releases |
code-reviewer | sonnet | Revisa um branch, emite um VERDICT, abre um PR |
tech-writer | haiku | Documentação para mudanças visíveis externamente |
overlord | opus | A autoridade de decisão (veja abaixo) |
Especialistas mobile existentes (mobile-architect, mobile-engineer,
ux-mobile-principal, qa-test-engineer) permanecem inalterados e são usados para trabalho mobile.
Para mudar o comportamento ou o modelo padrão de uma persona, edite o arquivo .md dela. A
linha model: do frontmatter é o modelo de fallback quando uma história não especifica um.
O overlord e a política de decisão
O overlord (~/.claude/agents/overlord.md) decide em nome do usuário quando
um agente de história está bloqueado, duas personas discordam ou um gate precisa de arbitragem. Ele
segue ~/.claude/overlord-policy.md (mais uma sobrescrita opcional por repositório
<repo>/.overlord-policy.md).
Níveis de decisão:
- Rotineiro / reversível → decide silenciosamente (nomenclatura, estrutura interna, uma biblioteca dentro do stack aprovado, refatorações).
- Notificar-assíncrono (
risk: medium) → decide, prossegue, sinaliza o usuário (nova dependência, mudança de schema, mudança de API aditiva). - Estacionar-e-avisar (
risk: high) → não agir sem supervisão; segurar para revisão humana e notificar. Qualquer coisa irreversível, segurança/auth, dinheiro, configuração de produção ou mudanças que quebram compatibilidade. Sempre estacionado independentemente do nível de autonomia.
O overlord retorna uma decisão estruturada (RULING / TIER / RISK /
RATIONALE / NOTIFY_USER) que é analisada e escrita no log de decisões do plano
como um registro de auditoria.
Referência
Veja REFERENCE.md para a referência completa das ferramentas MCP, o schema JSON de plano/história, configuração de provedor/modelo por papel, detalhes de decomposição guiada e divisão TDD, cada variável de ambiente PIPELINE_*/LOCAL_AGENT_*, o fluxo de trabalho de ponta a ponta, controles de segurança, o gate de uso e instruções de desenvolvimento/testes.
Para um exemplo prático de ponta a ponta do pipeline desenvolvendo este próprio repositório — o comando de instalação, os pull requests reais que ele produziu e um relato honesto do que ele ainda não consegue fazer — veja docs/DEMO.md.
Para saber como um release é cortado, veja docs/RELEASING.md.
Pré-requisitos
- Python 3.10+ e o venv do projeto. CI testa 3.12–3.14 no Ubuntu e macOS a cada push; 3.10/3.11 não fazem parte da matriz de CI, então trate-os como provavelmente funcionais, mas não verificados.
- git no PATH.
- GitHub CLI (
gh). - Claude Code CLI (
claude).
Scheduler
O advance-scheduler roda como um daemon de longa duração em vez de um
tick periódico do launchd. O papel do launchd é limitado a reiniciar em caso de crash via KeepAlive.
Variáveis de Ambiente
- PIPELINE_SCHEDULER_INTERVAL_S – intervalo padrão de reconciliação (padrão 60 segundos).
- PIPELINE_SCHEDULER_HEALTH_PATH – caminho opcional onde o daemon grava seu JSON de saúde a cada iteração.
Renderizando os arquivos launchd para sua máquina
Os arquivos launchd/*.plist e launchd/pipeline-logs.newsyslog.conf commitados
são uma cópia de referência: eles carregam os caminhos absolutos do próprio mantenedor (um
diretório home /Users/<name>/..., um caminho específico de cache de modelo) e não
funcionarão sem edição em outra máquina. Em uma instalação nova, regenere-os você mesmo
com scripts/generate_launchd_plists.sh (o install.sh não executa isso para
você) — ele preenche os modelos em launchd/
(launchd/com.fagan.pipeline.*.plist.template) a partir de três flags:
--repo-root— o checkout do pipeline para o qual os arquivos renderizados devem apontar (padrão: o repositório que contém o script).--out-dir— onde os arquivos renderizados são gravados (padrão:<repo-root>/launchd).--mlx-model-path— o diretório local do modelo MLX embutido no plist do mlx-supervisor. Como alternativa à flag, você pode definir a variável de ambienteMLX_MODEL_PATH; a flag vence quando ambas são fornecidas. O script falha de forma segura — ele sai com um erro — quando nenhuma é fornecida.
O mesmo script também renderiza launchd/pipeline-logs.newsyslog.conf a partir de
launchd/pipeline-logs.newsyslog.conf.template, substituindo apenas a raiz do repositório.
scripts/generate_launchd_plists.sh \
  --repo-root "$HOME/.claude/mcp-servers/pipeline" \
  --out-dir "$HOME/.claude/mcp-servers/pipeline/launchd" \
  --mlx-model-path "$HOME/.cache/qwen2.5_coder_14b_manual"
Esses arquivos launchd são exclusivos para macOS — consulte Suporte de plataforma.
Renderizando as unidades systemd para Linux
scripts/generate_systemd_units.sh renderiza a unidade de usuário systemd equivalente
e os arquivos logrotate a partir de systemd/*.template, da mesma forma que
scripts/generate_launchd_plists.sh faz para launchd — menos MLX, que é
exclusivo do Apple Silicon:
scripts/generate_systemd_units.sh \
  --repo-root "$HOME/fagan" \
  --out-dir "$HOME/fagan/systemd"
Instale como unidades systemd por usuário (sem necessidade de root):
mkdir -p ~/.config/systemd/user
cp systemd/com.fagan.pipeline.advance-scheduler.service ~/.config/systemd/user/
cp systemd/com.fagan.pipeline.usage-poller.service ~/.config/systemd/user/
cp systemd/com.fagan.pipeline.usage-poller.timer ~/.config/systemd/user/
systemctl --user daemon-reload
systemctl --user enable --now com.fagan.pipeline.advance-scheduler.service
systemctl --user enable --now com.fagan.pipeline.usage-poller.timer
  # Optional: let these run even when you are not logged in
loginctl enable-linger "$USER"
Rotação de logs (requer root, uma única vez):
sudo cp systemd/pipeline-logs.logrotate.conf /etc/logrotate.d/com.fagan.pipeline
Confiabilidade e limitações
Este pipeline executa loops reais de codificação autônoma, e eles falham de maneiras específicas e documentadas — leia isto antes de apontá-lo para qualquer coisa que você valorize.
- O despacho de modelo local (não-Claude) é o ponto fraco. Ele funciona bem para
histórias pequenas e mecanicamente escopadas (uma preocupação, ≤2 arquivos de produção) e
degrada acentuadamente em qualquer coisa maior: edições de arquivos grandes, histórias
com múltiplas funções e inserções ancoradas em funções longas existentes causam de forma confiável
timeouts de limite de etapas, travamentos ou corrupção de arquivo devido a edições de números de linha desatualizados.
docs/plans/*.mderetros/*.mdneste repositório são o registro real de incidentes do qual essa descoberta vem, não uma alegação de marketing — leia alguns antes de confiar no despacho local em qualquer coisa não trivial.PIPELINE_BACKEND_DISPATCH=autoexiste especificamente para escalar uma tentativa local com dificuldades para Claude em vez de deixá-la em loop. - A estrutura "$20/mês" é a meta de design em torno da qual os portões são construídos,
não um resultado benchmarked ainda. A única execução completa de comparação de modelos em
registro (
tests/benchmark/FINDINGS.md) foi contaminada no meio da execução por limites de taxa e esgotamento de crédito, então não há uma comparação limpa de maçãs com maçãs de taxa de sucesso/custo entre backends publicada ainda. O número mais limpo lá é estreito —gpt-oss:20bno dispositivo, 2 tarefas T1, 2/2 sucesso com o oráculo independente passando no código mesclado, uma tentativa cada — e é direcional, não uma comparação de qualidade. Leia esse arquivo para exatamente o que é e não é conhecido antes de citar um número dele. - Uma suíte de testes verde não é prova de uma alteração correta ou completa. Um
executor (local ou Claude) converge para o diff mínimo que torna seus próprios
testes verdes, e pode escrever um teste errado autoconsistente que codifica o
mesmo bug que sua implementação. Consulte a seção
"Merge-gate and AI-review lessons" de
.claude/rules/code-review.md— cada lição lá veio de uma regressão mesclada real, não de uma hipótese. - Uma história marcada como
donenão é prova de que o escopo completo do seu título foi entregue. Uma história "migrar tudo" ou "remover todo X" pode passar na revisão e ser mesclada tendo feito apenas parte do trabalho, porque a revisão avalia os testes da própria história, não a alegação do título. Consulte.claude/rules/agent-dispatch-story-sizing.md. - O nível
park-and-pingdo overlord é um piso de segurança real, não uma sugestão — decisões de alto risco (ações irreversíveis, autenticação/segurança, dinheiro, configuração de produção, mudanças de quebra) sempre param para um humano, independentemente do nível de autonomia. Inicie qualquer nova implantação emPIPELINE_AUTONOMY=dry-rune leia o registro de decisões antes de confiar emgatedoufull. - Este é um projeto de pesquisa de mantenedor único, não um produto mantido com um SLA. A suíte de testes e o CI são portões reais, mas espere arestas ásperas, e espere que o catálogo de modos de falha continue crescendo à medida que novos são encontrados.
Se você encontrar um novo modo de falha, vale a pena documentá-lo (consulte retros/ para o
formato existente) em vez de contorná-lo silenciosamente — todo o valor do
design deste projeto é que os modos de falha são nomeados e realimentados em como
as histórias são dimensionadas e revisadas.
Licença
Licenciado sob a Apache License, Versão 2.0 — consulte LICENSE e NOTICE.